Claude Code 클라우드 세션이 환경을 자동 세팅한다: 의존성·네트워크·API 키 + 4 vCPU/16 GB 샌드박스와 자격증명 비진입 설계
실행 환경이 일급 리소스가 되었습니다.
ThakiCloud가 공개한 문자 인식 모델 네 개를 한곳에 모았습니다. 네 모델 모두 연구용 공개이며 제품 출시가 아닙니다. 모델마다 입력 단위, 필요한 하드웨어, 평가 방식이 다르므로 아래 숫자는 모델 사이의 순위가 아닙니다.
네 모델은 같은 공구함에 든 서로 다른 공구입니다. 작은 드라이버는 주머니에 넣고 다니며 하루에 수천 번 쓸 수 있고, 전동 드릴은 무겁지만 단단한 벽을 뚫습니다. 어느 공구가 더 좋으냐보다 지금 하려는 일에 어느 공구가 맞느냐가 중요합니다.
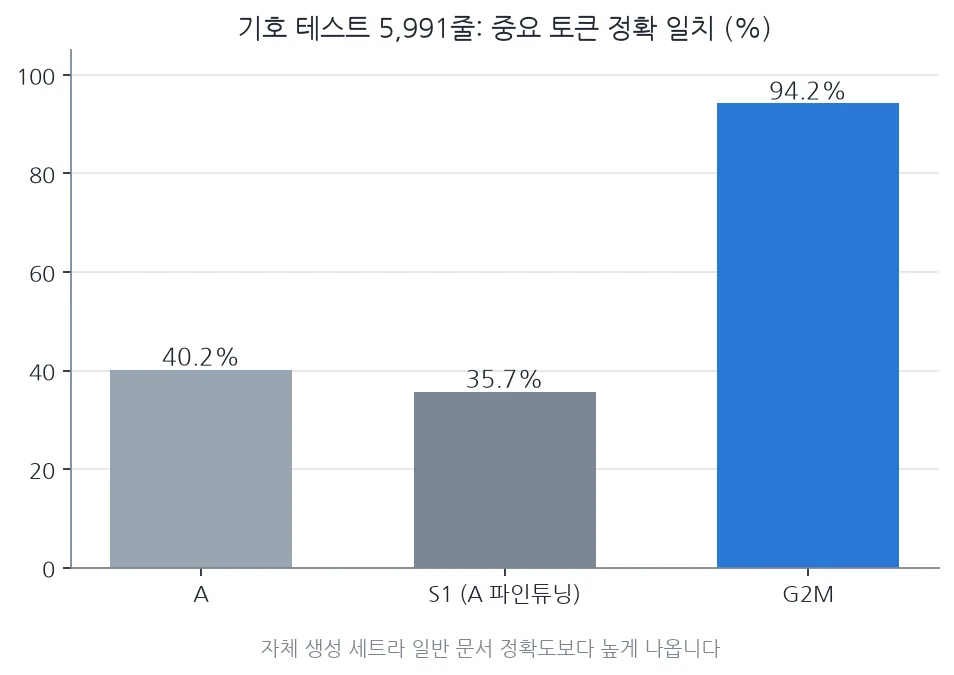
이 표는 규모와 쓰임새만 정리합니다. 성능 수치는 모델별 카드에 평가 계약과 함께 따로 적었습니다.
| 모델 | 규모 | 입력 단위 | 실행 환경 | 공개 상태 | 라이선스 |
|---|---|---|---|---|---|
| ThakiOCR-KOEN-V1-Dense | 213만 파라미터 | 텍스트 한 줄(한국어·영어) | CPU | 연구용 공개 | Apache-2.0 |
| ThakiOCR-KOEN-G2M-Preview | 893만 파라미터 | 텍스트 한 줄(한국어·영어) | CPU | 연구 프리뷰, A1_GEN2_NO_GO | Apache-2.0 |
| ThakiOCR-KO-v1 | 0.9B급 기반 모델 + LoRA 639만 파라미터 | 한국어 단어 이미지 한 장 | GPU | 연구 프리뷰 | Apache-2.0 |
| ThakiOCR-Large-27B-R2B | 27B 기반 모델 + LoRA 2억 3,350만 파라미터 | 한국어 단어 이미지 한 장 | GPU(bf16 약 53GB) | 연구 프리뷰 | Apache-2.0 |
KO-v1과 Large-27B-R2B는 LoRA 어댑터만 공개합니다. 기반 모델(ATH-MaaS/OvisOCR3, Qwen/Qwen3.6-27B)은 각 카드에 적힌 고정 리비전으로 따로 내려받아야 합니다.
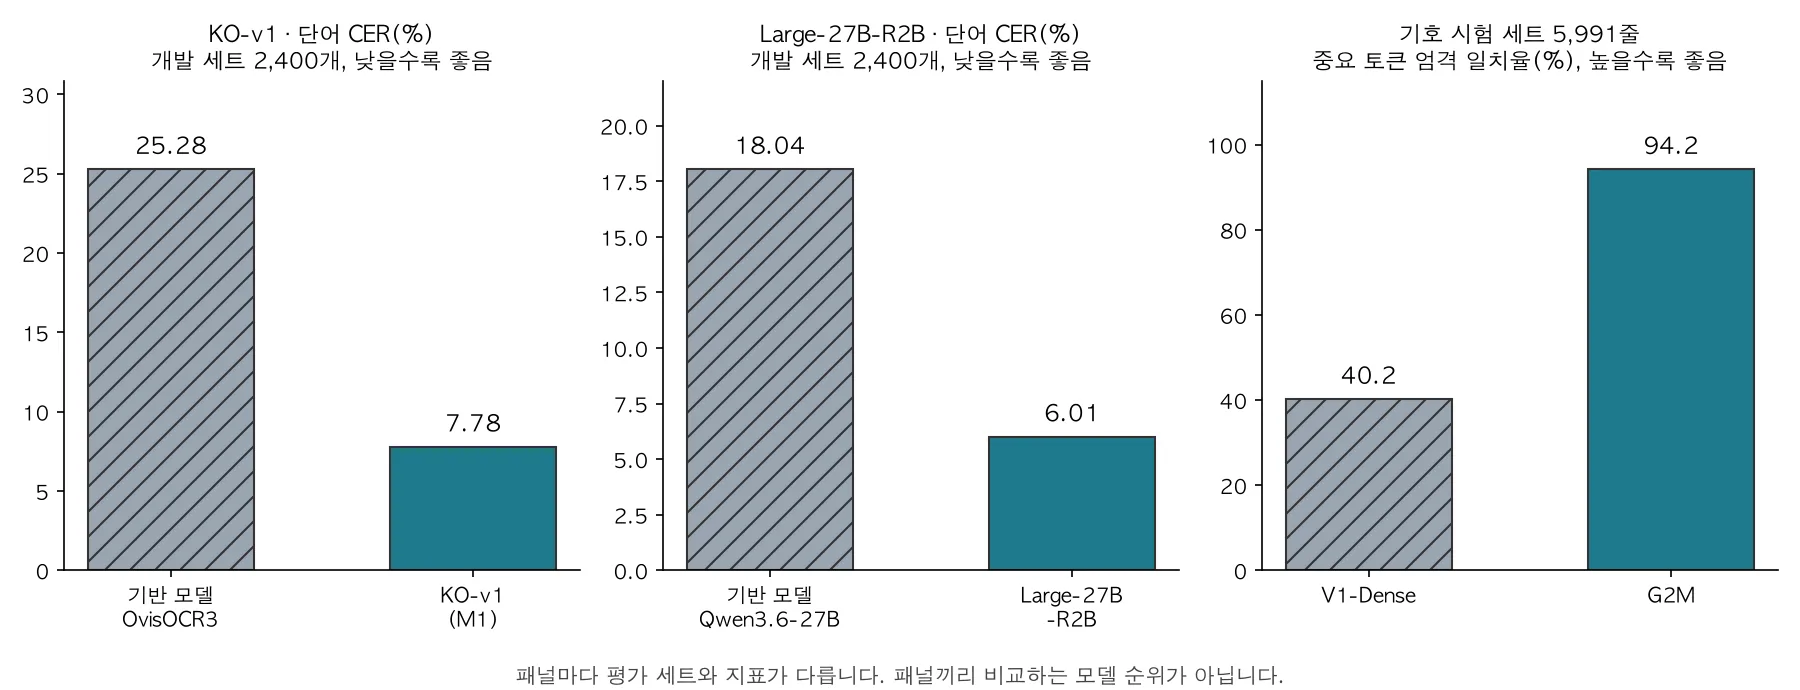
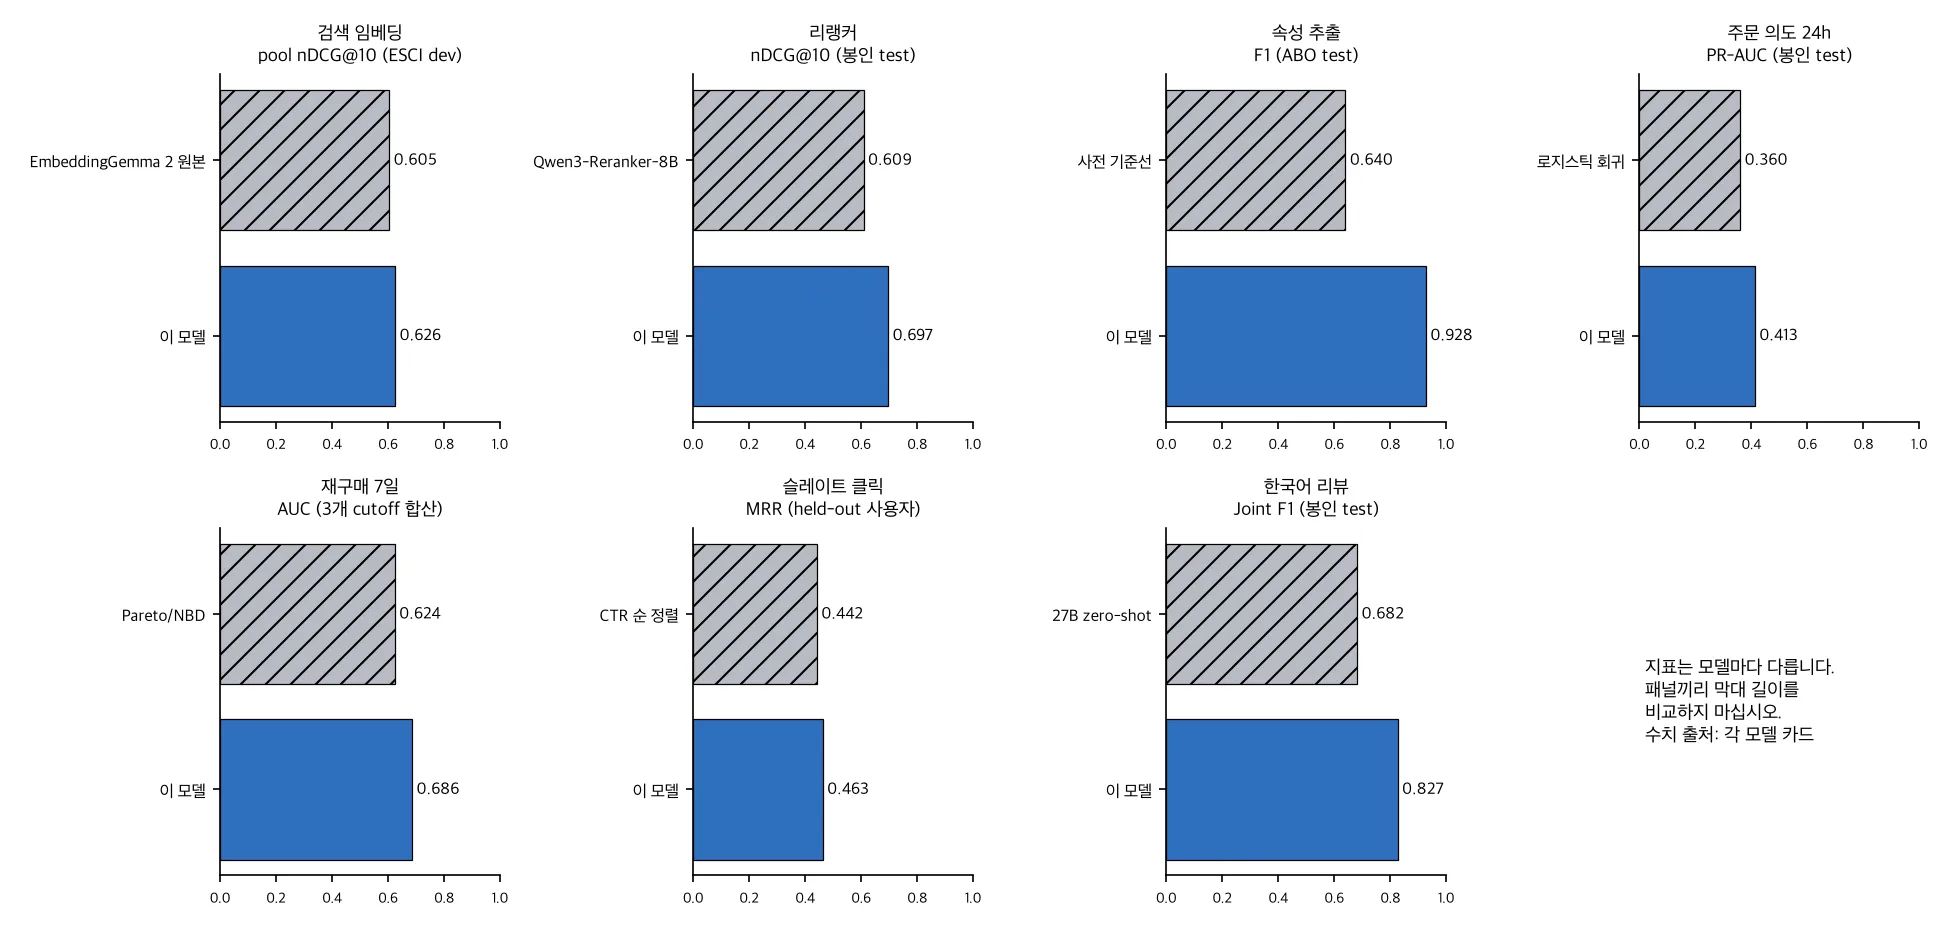
아래 네 카드의 수치는 평가 세트와 지표가 서로 달라 모델 간 순위가 아닙니다. 각 수치 옆에 어떤 조건에서 쟀는지를 함께 적었습니다.
KO-v1과 Large-27B-R2B의 개발 세트는 구성 방식이 비슷하지만, 평가 이미지·전처리·디코딩·정답 처리가 같은지 검증하지 않았습니다. 그래서 두 모델을 이 숫자로 비교하지 않습니다.
네 카드 모두 GitHub 저장소 링크는 없습니다. 추론 코드는 각 저장소에 들어 있습니다(V1-Dense·G2M은 inference.py, KO-v1·Large-27B-R2B는 inference_example.py).
고르는 기준은 숫자 순위가 아니라 입력 단위와 하드웨어입니다.
₩·₩ 구분에는 약하므로 사람 확인 단계를 둡니다.모든 모델은 금융·법률·신분 문서의 중요 필드를 사람 확인 없이 읽는 용도로 쓰면 안 됩니다. 모델을 나눠 배치하는 방법은 Metis 계층형 문서 추론 글에 정리했습니다. 검증 뒤에만 업무에 반영하는 흐름은 Paxis 검증 워크플로 글에 정리했습니다.
python inference.py --demo로 바로 확인할 수 있습니다.개발 중인 모델입니다. 성능 수치는 공개하지 않습니다. ThakiOCR-KO-v2: 독립 평가에 쓸 문서·손글씨 데이터가 부족해 공식 평가를 하지 못했고 공개를 보류했습니다. 성능이 나빠서 보류한 것이 아닙니다. ThakiSight-Edge: 학습을 진행하고 있습니다.
아래 목록은 thakiocr 태그가 붙은 글 전체입니다. 주요 글은 다음과 같습니다.
실행 환경이 일급 리소스가 되었습니다.
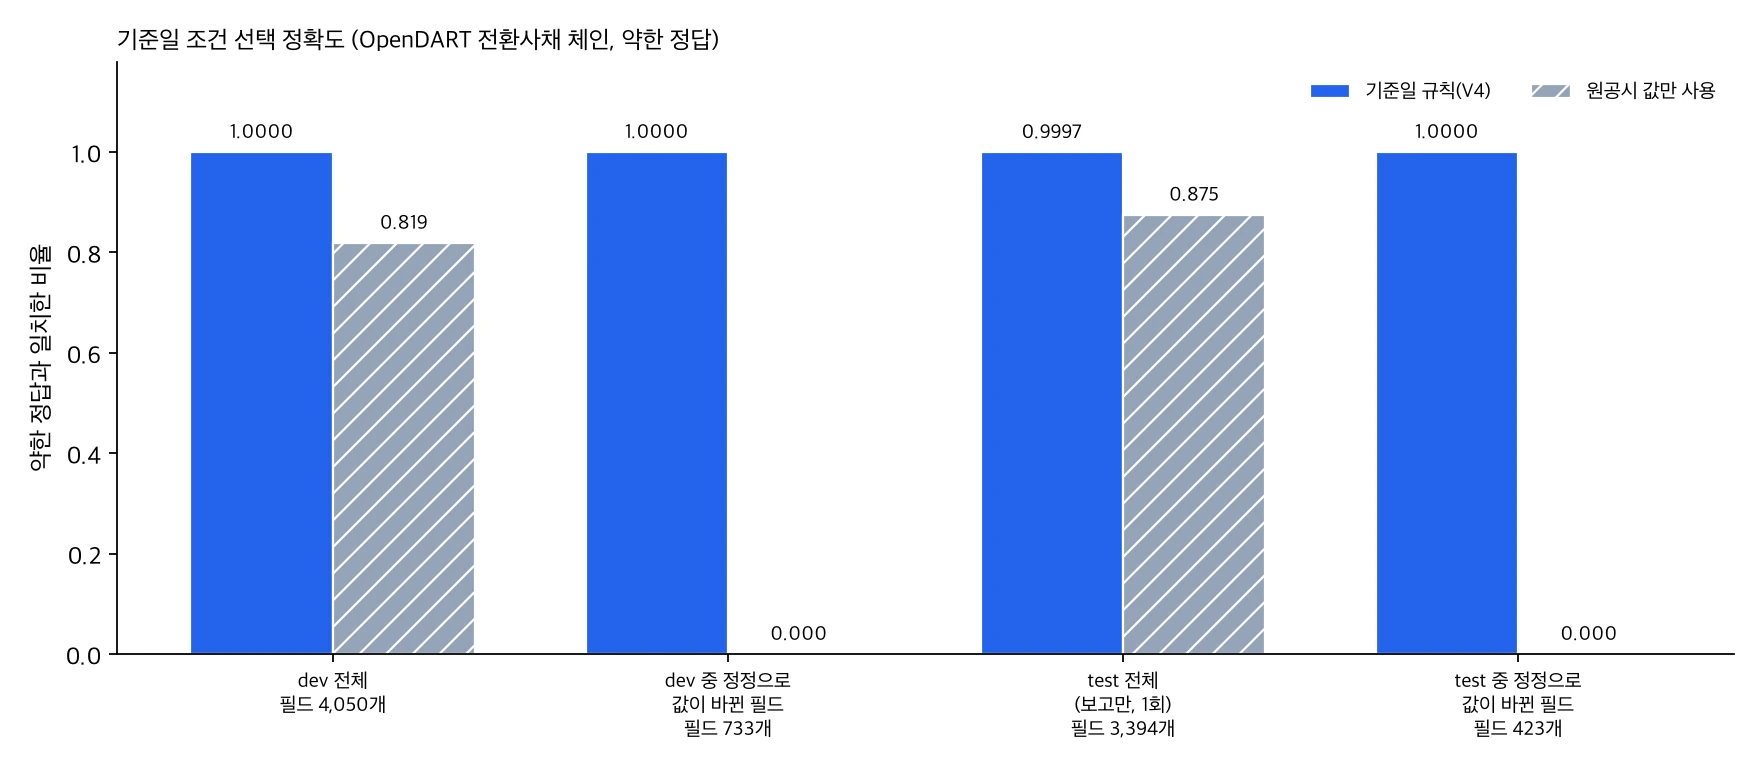
공개 DART 공시에서 효력일과 접수일의 차이, 기재정정의 소급 여부 불확실성, 전환가액 조정 공시 누락으로 낡은 전환가액이 나오는 문제를 찾았고 V4.1에서 불확실한 값을 확인 필요로 돌렸습니다.
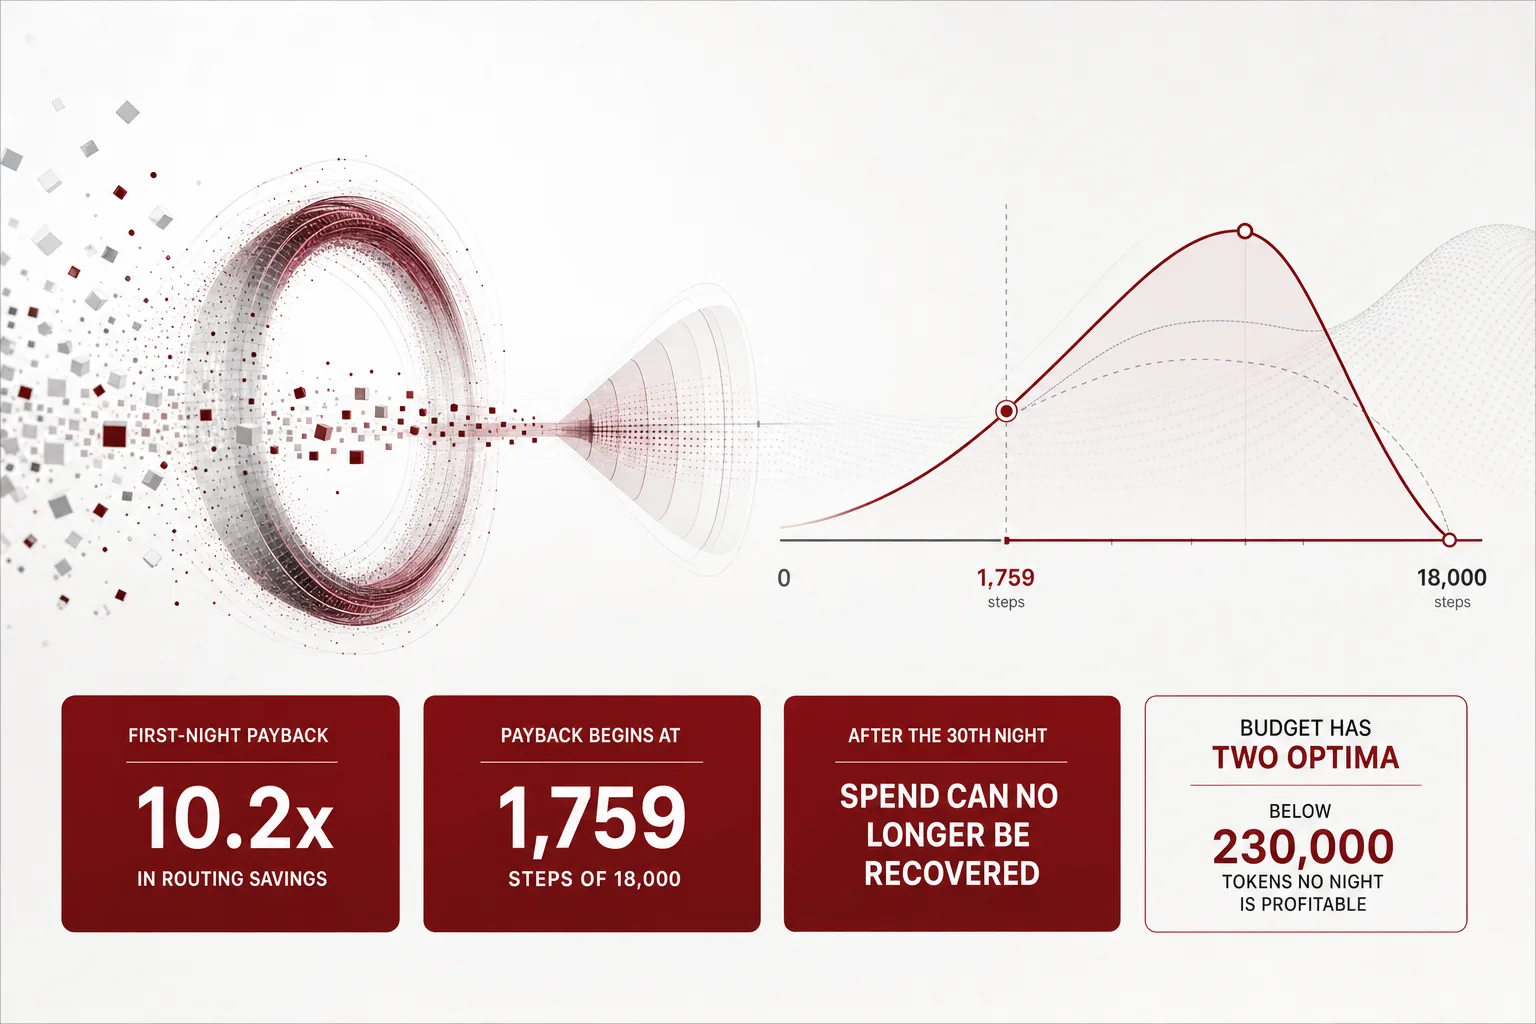
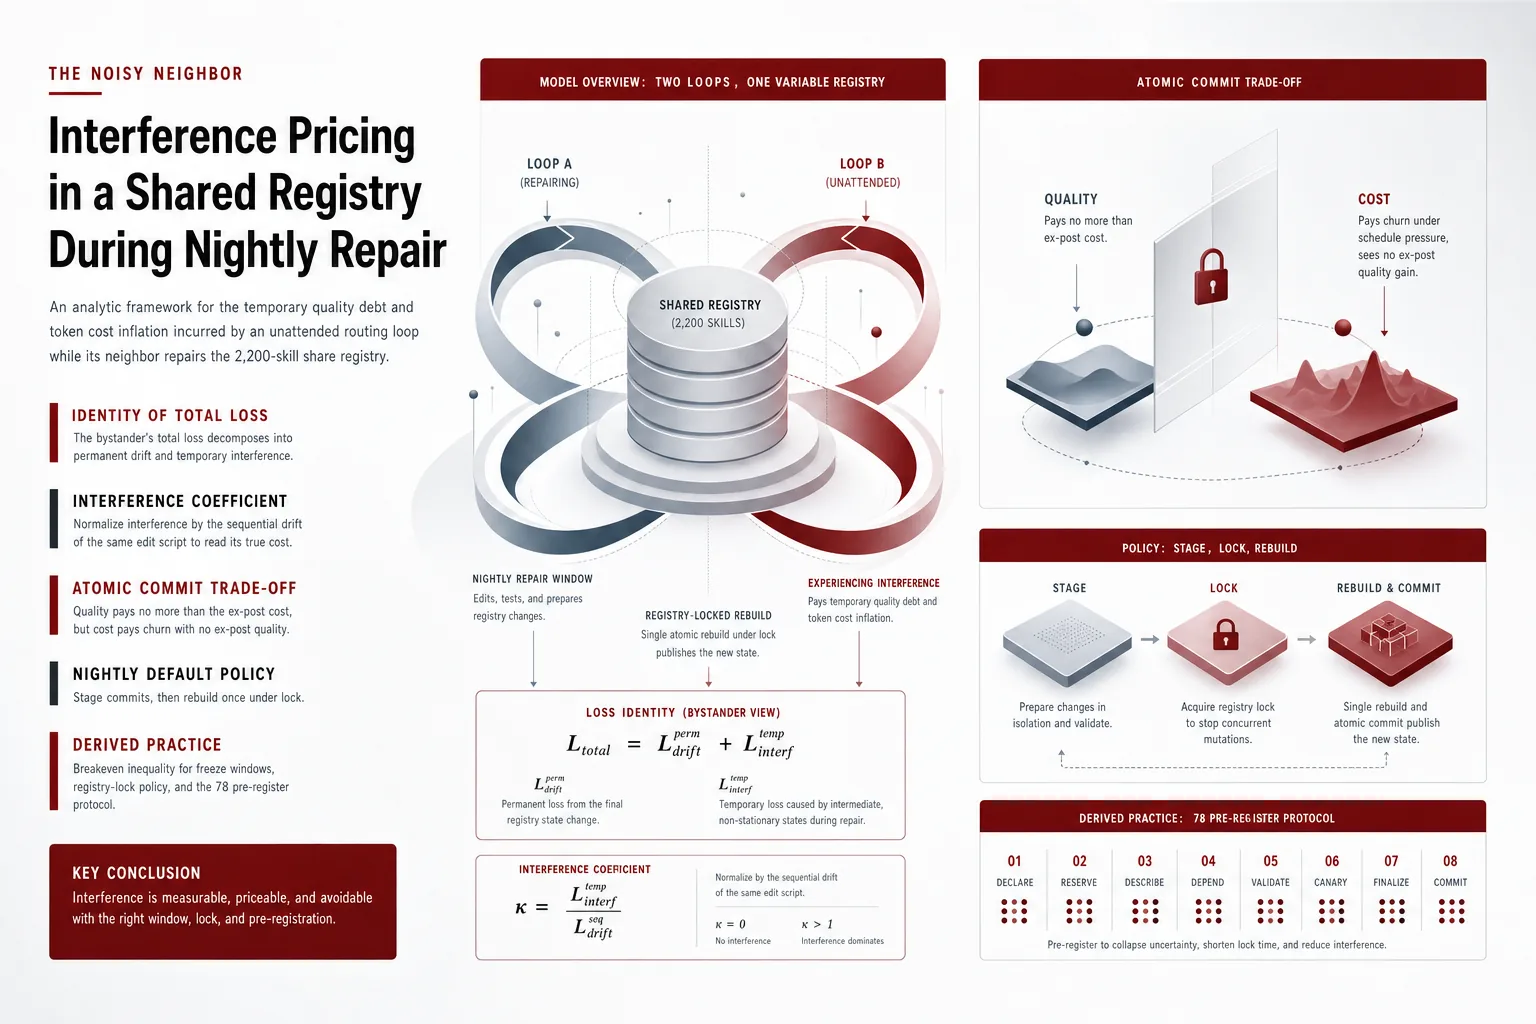
스킬 레지스트리를 밤마다 고치는 진화 루프는 토큰을 쓰지만, 그 지출이 되돌아온다는 가정에는 값이 매겨지지 않았습니다.
전류 센서 하나로 모터의 무엇을 알 수 있을까요.
라벨 없이 산업 전류 인코더를 학습했습니다.
Faster R-CNN 검출기를 ONNX FP32 하나로 묶어 B200, H200, CPU에서 쟀습니다.
글자가 가장 큰 줄을 고르는 규칙은 실사진에서 F1 0.161에 그쳤고, 배포용 트리 모델은 0.605를 냈습니다.
8.9M 파라미터 CRNN과 미세조정한 검출기로 화장품 포장 사진의 글자와 날짜를 읽습니다.
봉인 TEST에서 파일명 날짜만 쓴 기준선이 신호 모델을 이겼습니다.
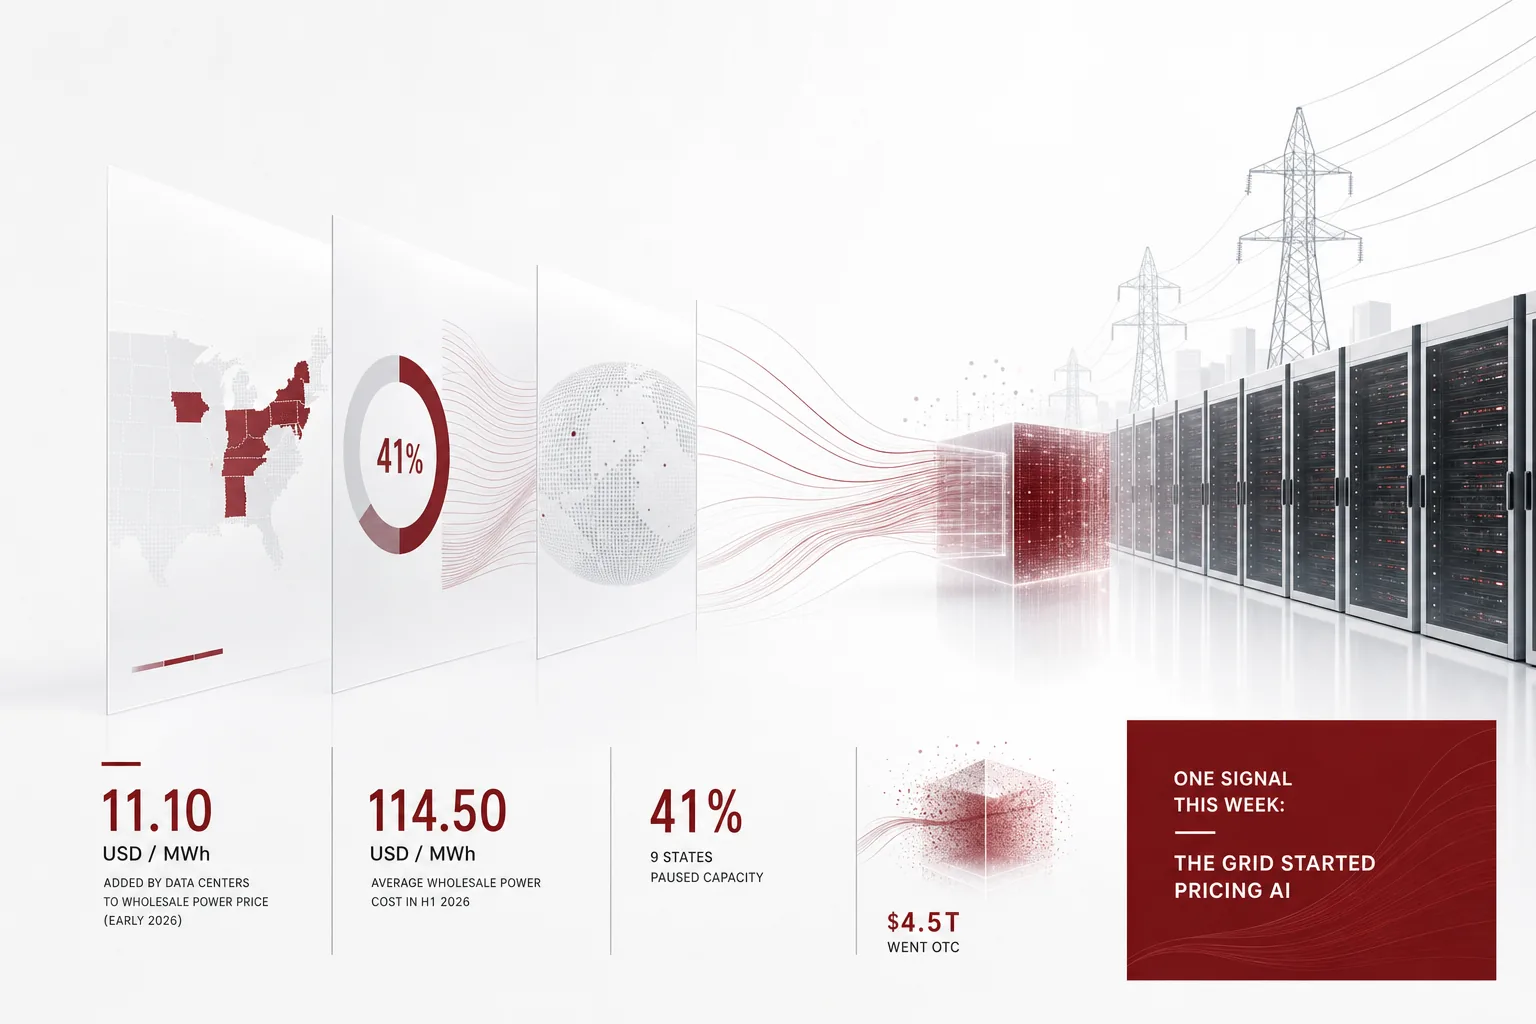
PJM 독립 시장 모니터는 데이터센터 수요가 2026년 초반 도매전력 단가에 MWh당 11.10달러를 추가했습니다.
27B 비전 언어 모델에 LoRA 어댑터를 붙여 한국어 단어 이미지 읽기를 학습시켰습니다.
디코더는 그대로 두고 Vision LoRA만 옮겼더니 손글씨 오류가 줄고 표 구조는 유지됐습니다.
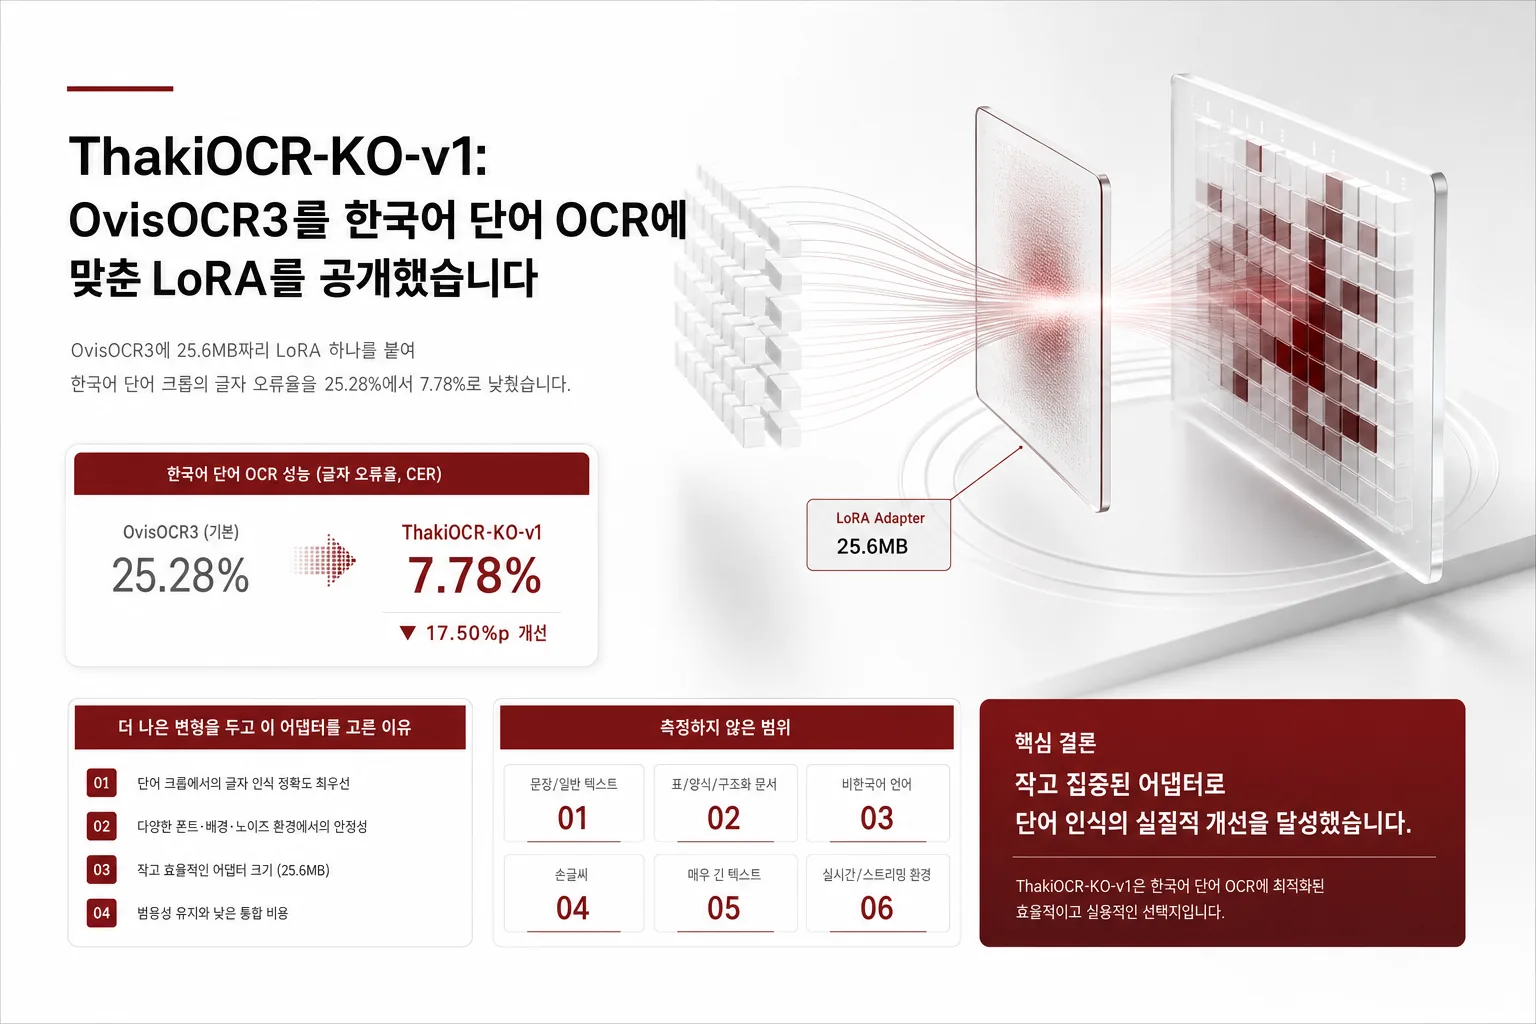
OvisOCR3에 25.6MB짜리 LoRA 하나를 붙여 한국어 단어 크롭의 글자 오류율을 25.28%에서 7.78%로 낮췄습니다.
모터 전류로 고장 상태를 구분하는 MCSA 모델을 공개했습니다.
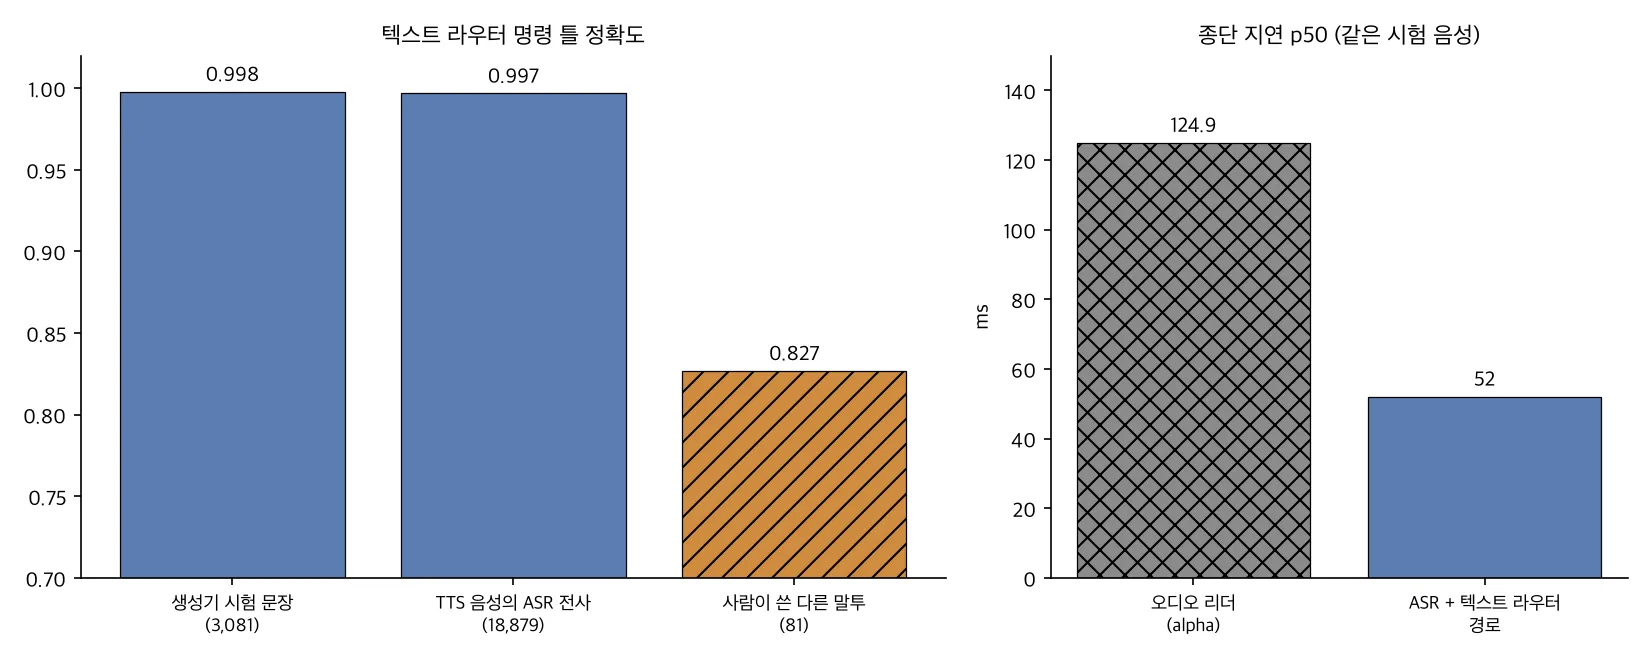
CPU에서 한 줄을 수 밀리초에 읽는 모델과 GPU 53GB를 쓰는 모델을 함께 공개했습니다.
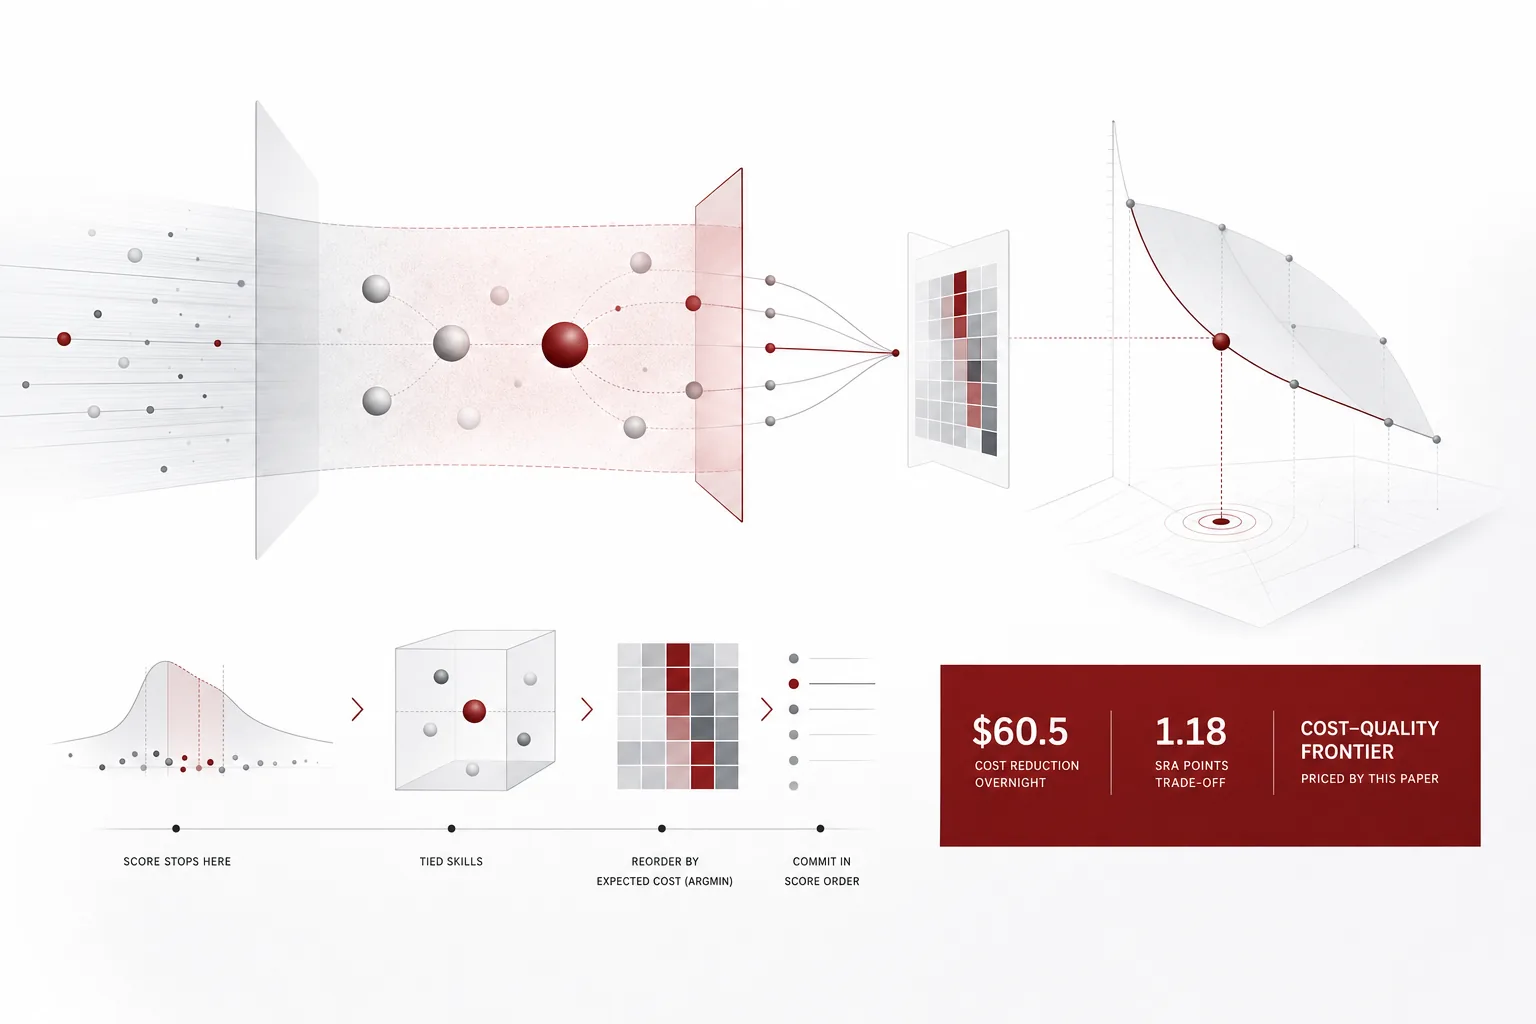
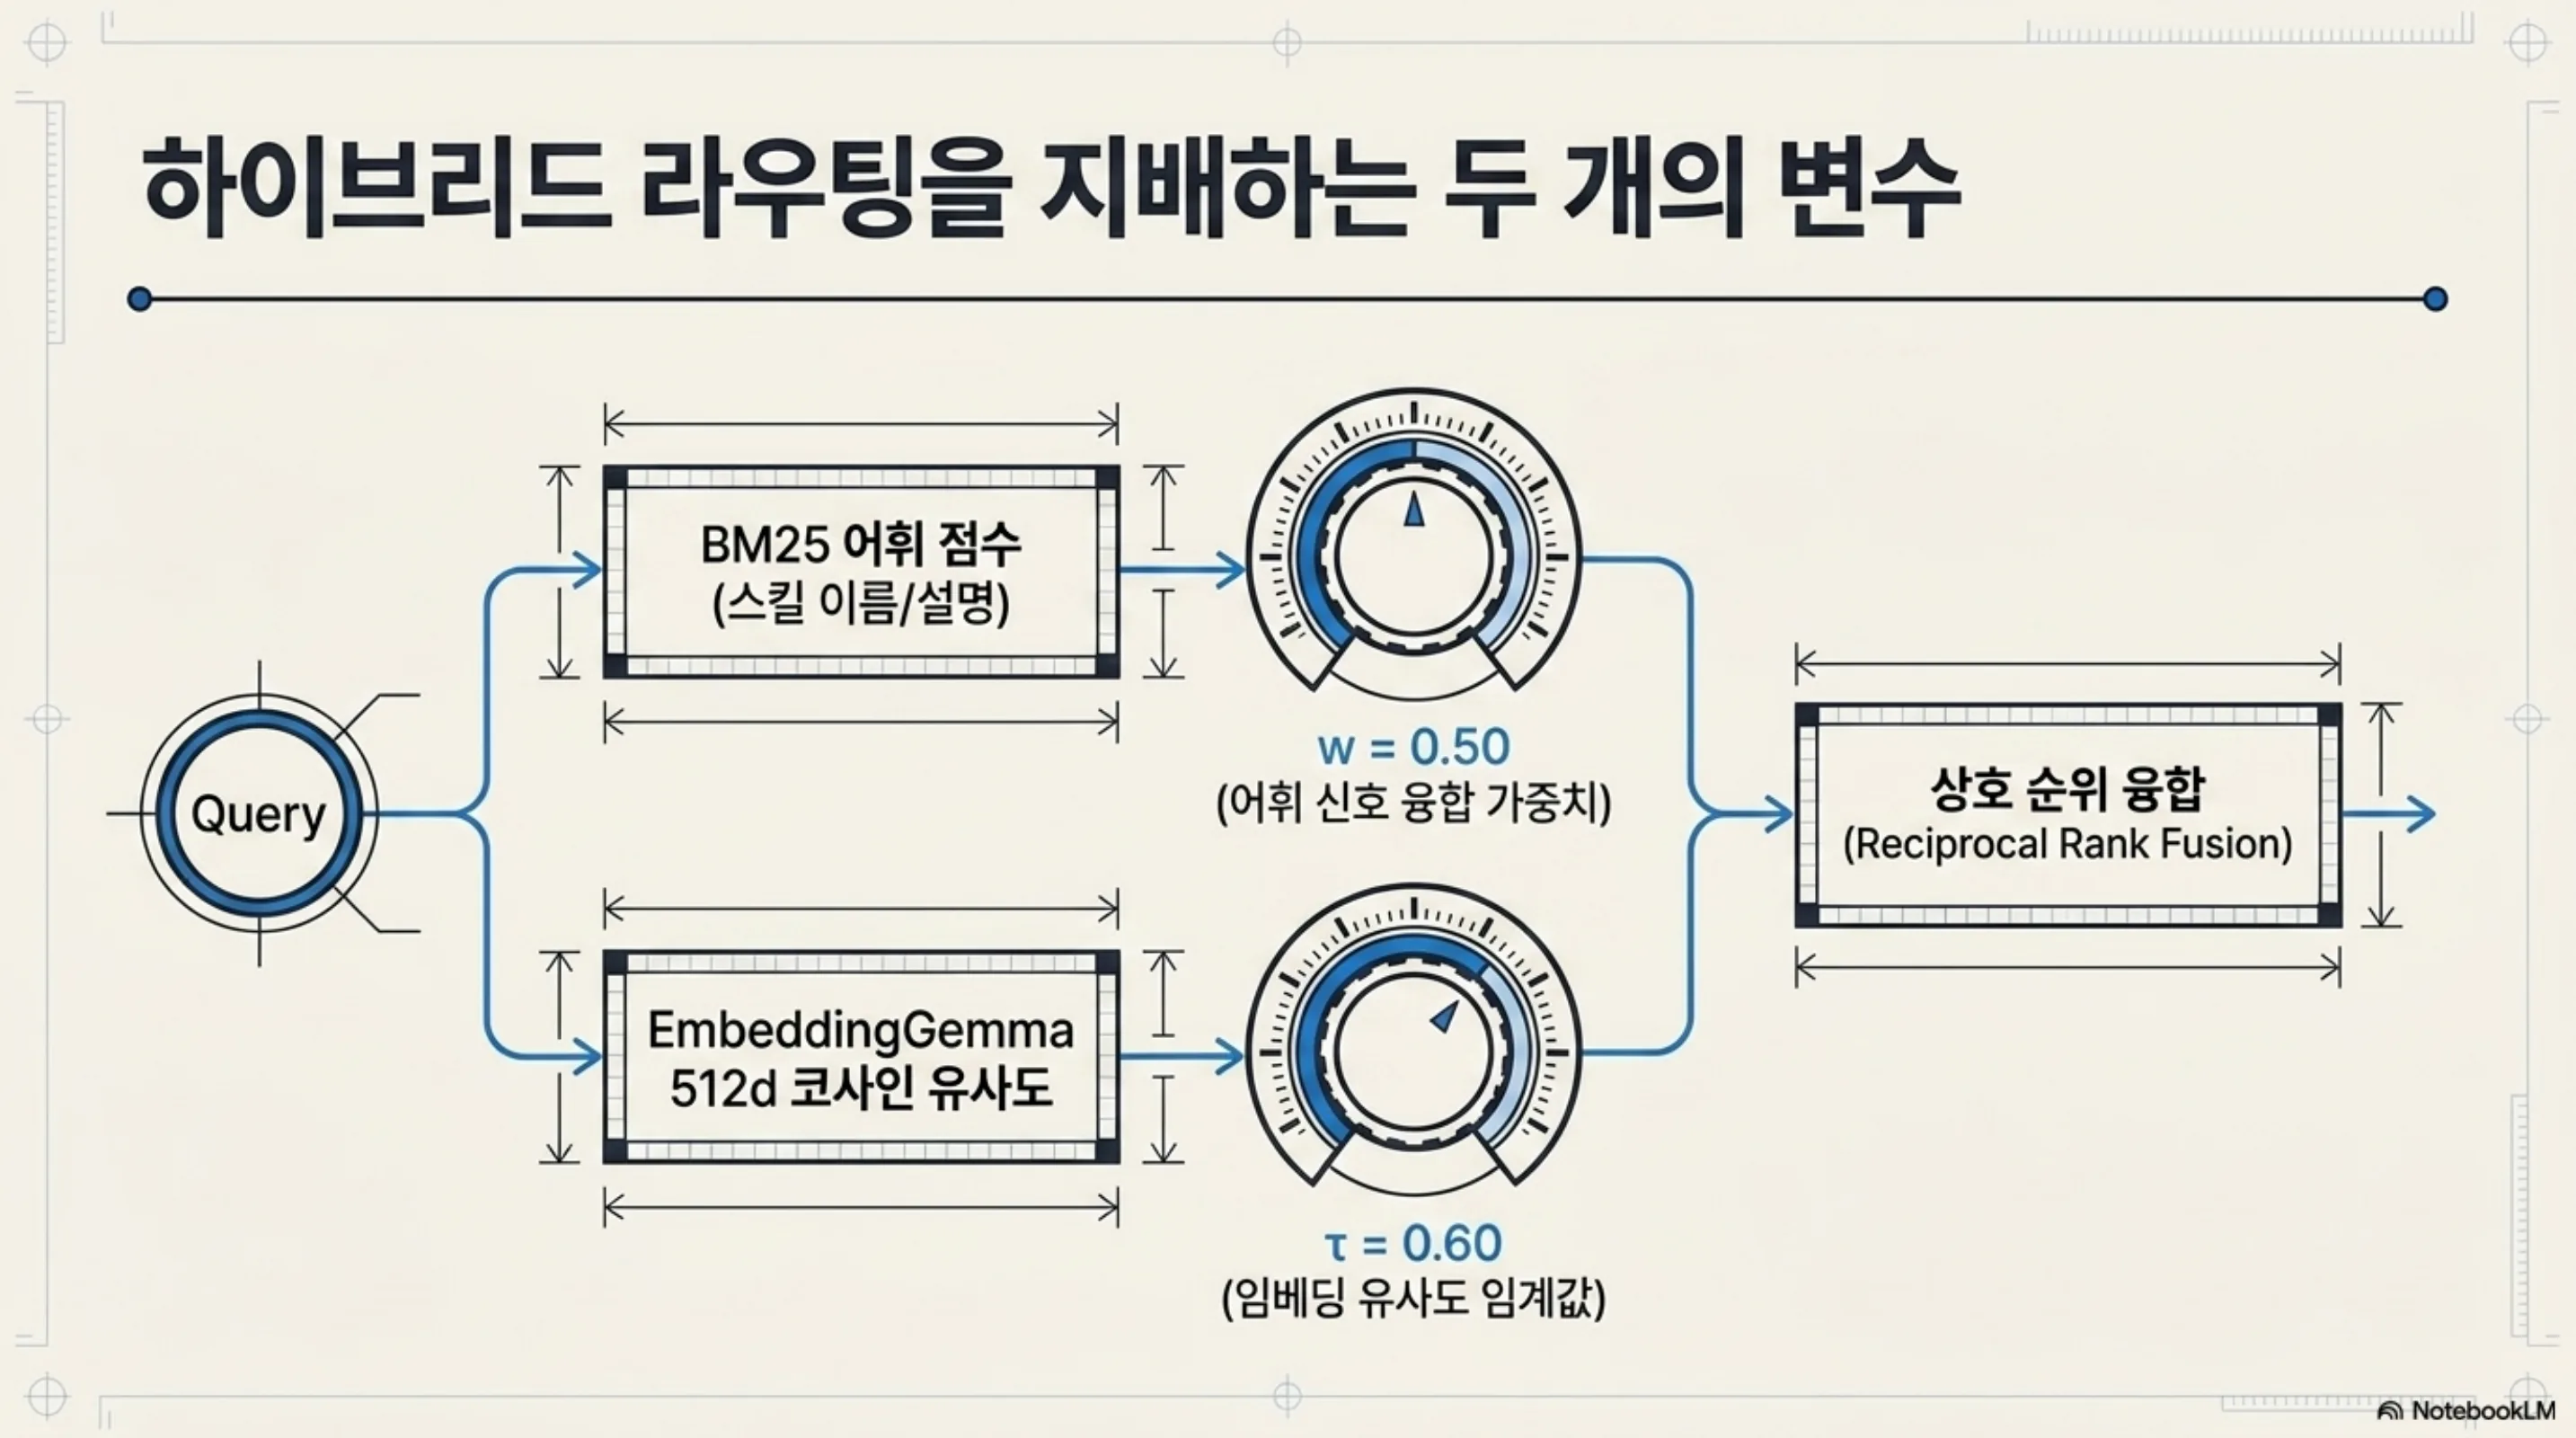
스코어가 판단을 멈추는 구역에서, 라우터는 동점이 된 스킬 중 하나를 점수 순서로 커밋합니다.
리커시브AI가 첫 모델로 65B dense Transformer, 100만 토큰 컨텍스트, Apache 2.0의 Ripple-65B Preview를 공개했습니다.
varien이 11월 6일 첫 모델 Qwen Concept 27B를 공개했습니다.
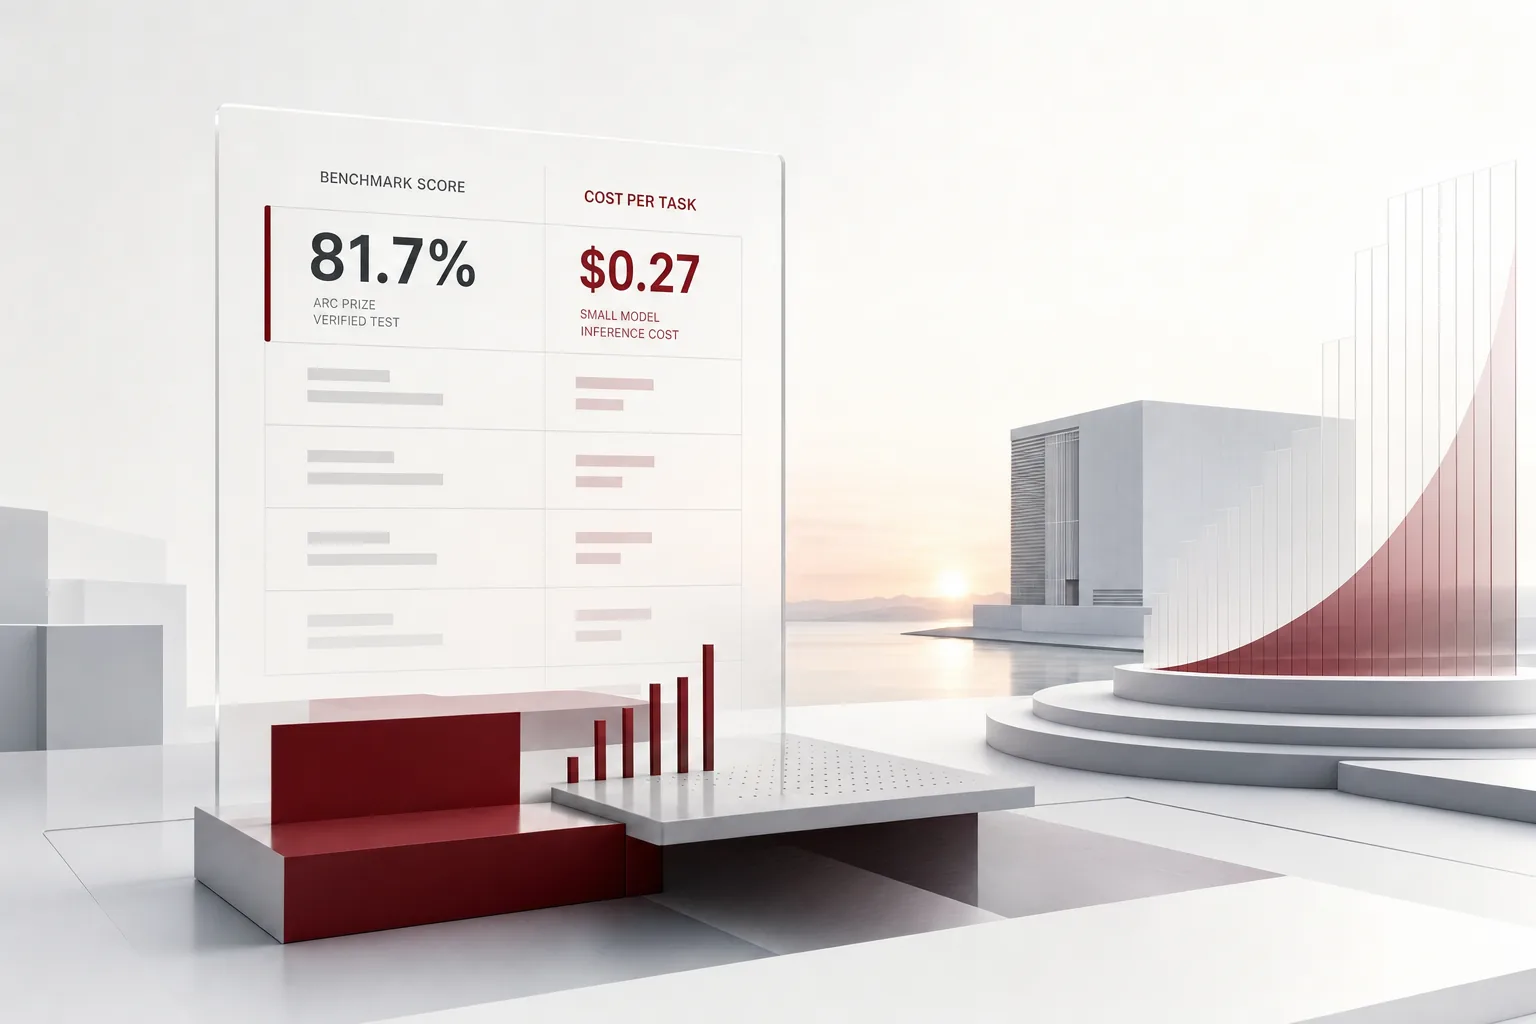
ARC Prize 검증 테스트에서 오픈웨이트 최고 점수 81.7%를 기록한 소형 모델의 추론 과업당 비용은 27센트였습니다.
30B 음성인식 모델에 한국어 LoRA를 학습해 공개했습니다.
화자 분리 방식을 바꾸자 인원이 많은 회의의 오병합은 크게 줄었습니다.
클릭할 때와 코드를 쓸 때를 아는 4B 정책 하나.
금융위는 ‘AI 공격은 AI로 막는다’며 처방전을 내밀었다.
최상위 오픈 모델 20개 중 18개가 MoE지만 학습 노하우는 소수 팀 안에 갇혀 있었습니다.
클라우드 비용은 오르는 데는 서서히, 줄이는 데는 어렵습니다.
OpenAI의 자율 보안 사냥 모델과 Anthropic의 의도적 읽기 전용 금융 도구.
코딩 에이전트 하네스의 자가진화를 실증으로 검증한 논문입니다.
미국 지방 데이터센터 규제 안건의 초기 집계에서 제한이 29 대 1로 앞서고 있습니다.
코딩 에이전트가 3D 씬을 직접 조종하는 길이 열렸다.
사우스햄턴 남쪽 7km의 웹캠 오디오만으로 위치를 특정한 데모입니다.
더 똑똑한 모델이 아니라, 에이전트의 ‘조직’이 이겼다.
앤트로픽의 8954억달러(약 1203조원) 컴퓨팅 지출 약정과 애플의 하루 AI 사용 한도 33% 삭감이 같은 아침에 나란히 섰습니다.
음성 딥페이크 탐지 모델을 Research Preview로 공개했습니다.
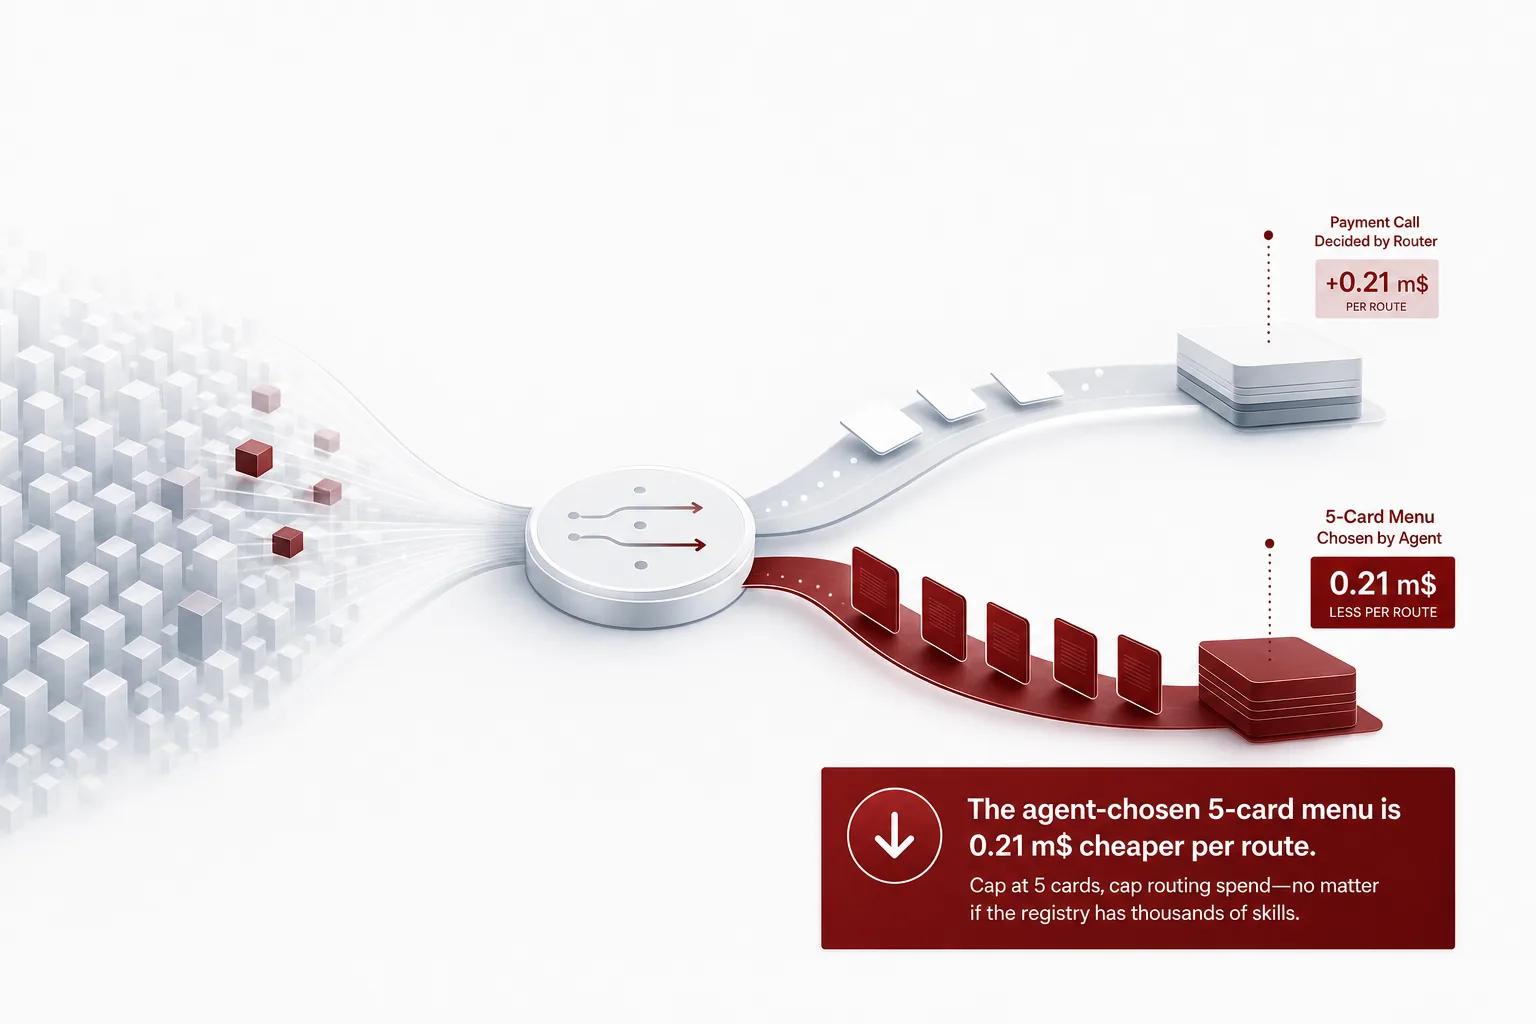
스킬 라우터의 마지막 결정은 누가 시키느냐의 문제입니다.
Matt Pocock의 /retro 스킬이 Claude Code 세션 뒤 하네스 개선을 제안하게 하고, 그중 12개를 같은 레포의 훗날 과제로 전이시켜 5 대 5 세션으로 잰 실증 연구입니다.
유럽 최대 핀테크 Revolut가 약 2,000명 엔지니어의 코딩 모델로 자체 호스팅 GLM을 기본값에 올리고 1년 만에 추론 비용을 10분의 1로 낮췄습니다.
영상 오디오에 섞인 들리지 않는 비행기 소리가 녹화 위치를 흘립니다.
MIT의 가중치 편집은 로그를 들여다본 뒤에야 주장이 빗나간 것이 드러났습니다.
8개월 만에 깃허브 스타 55,000개를 넘긴 클로드 코드 스킬 팩 academic-research-skills.
해커는 AI로 시간을 벌고, 기업은 대응 시간을 잃는다는 날.
결함 사진 없이 정상 PCB 사진만 학습해 결함 위치를 표시하는 모델을 공개했습니다.
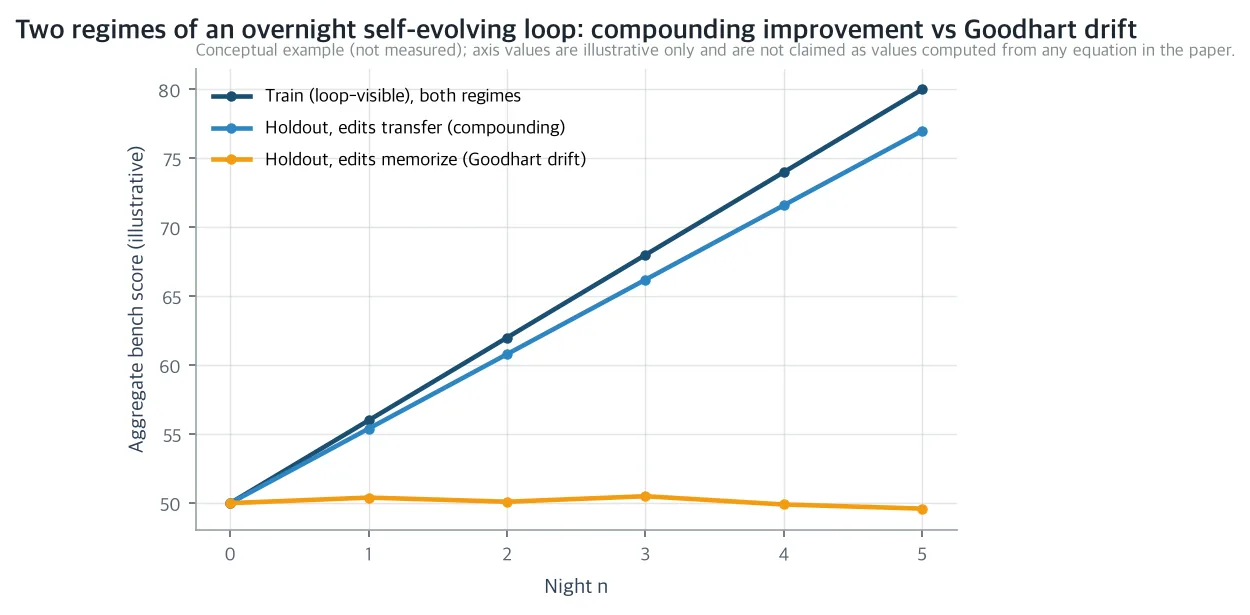
루프 안의 레버리지가 가장 큰 텍스트, 시스템 프롬프트가 밤마다 자기 편집으로 썩는다는 것을 이 논문은 재습니다.
MIT CSAIL은 GPT-6 Astra로 Qwen의 가중치를 직접 고쳐 수학 점수 48.1%를 만들어냈고, 같은 날 Gemini 4 Carbon은 평균 90.4%와 Opus 5.5 대비 4배 낮은 비용을 동시에 써냈습니다.
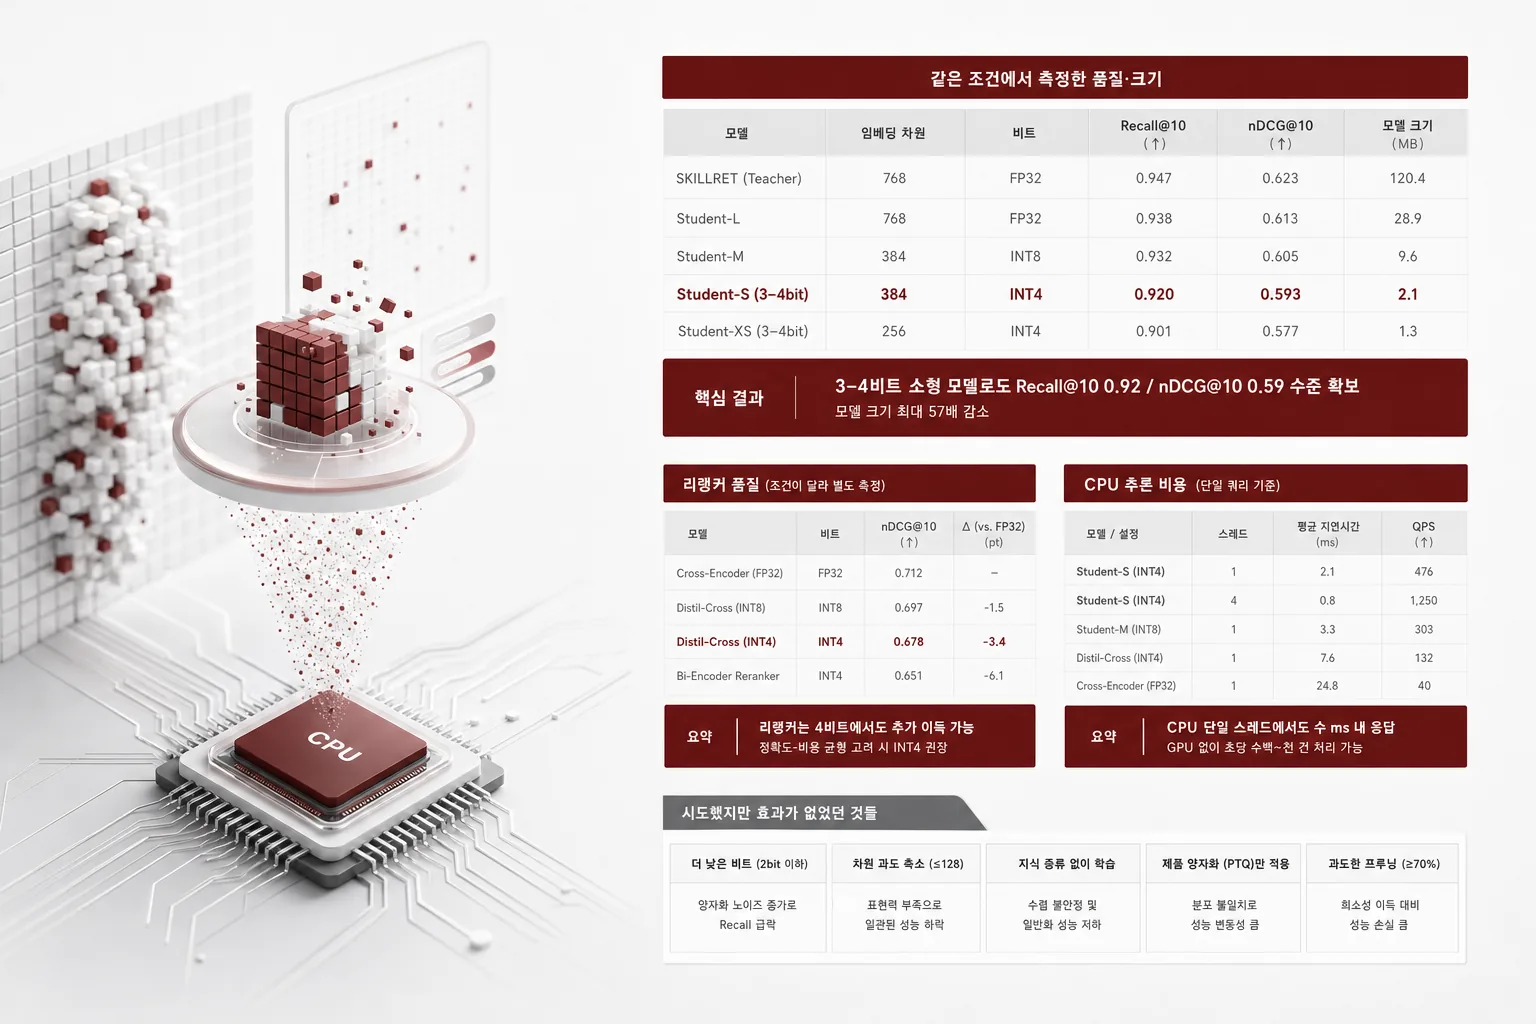
에이전트가 수천 개 스킬 중 맞는 것을 고르는 일을 GPU 없이 하려고 SKILLRET 임베딩을 작은 학생 모델로 증류하고 3~4비트로 줄였습니다.
2.78조 파라미터 모델을 램 8GB에 올린다는 말은 과장이 아닙니다.
딥시크 ‘슈퍼 에이전트’와 베스핀글로벌 ‘헬프나우 컴퓨터’가 같은 날 출시됐는데, 둘 다 기본값으로 ‘먼저 관찰’을 택했습니다.
모델 크기는 그대로 두고 데이터와 평가를 다시 설계했더니 OCR 오류가 31% 줄었습니다.
기호 하나가 틀리면 금액과 날짜의 뜻이 바뀝니다.
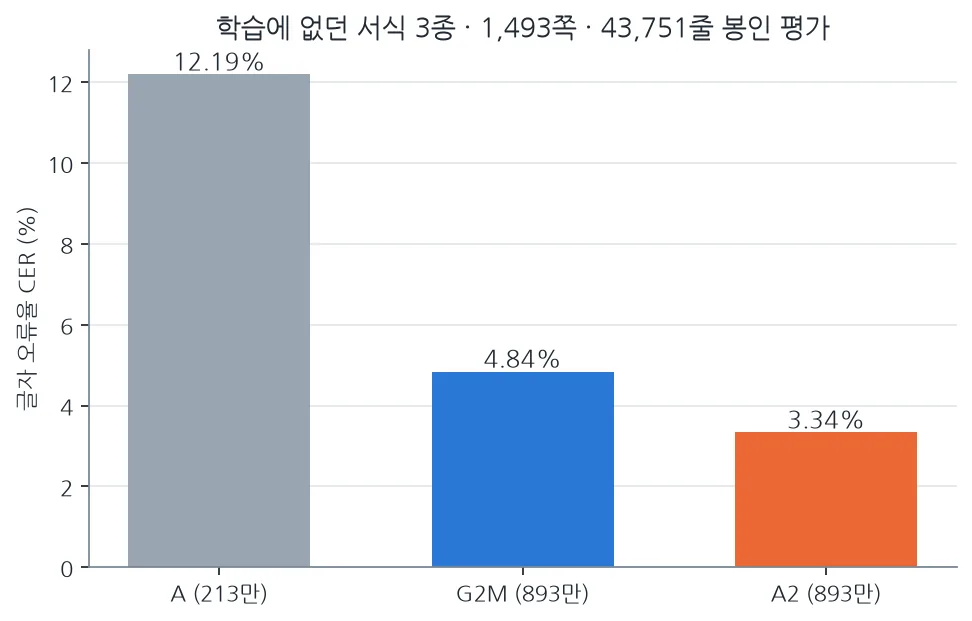
학습에 없던 서식 1,493쪽에서 새 모델을 한 번만 평가했습니다.
직접 만든 가장 작은 OCR 모델을 공개했습니다.
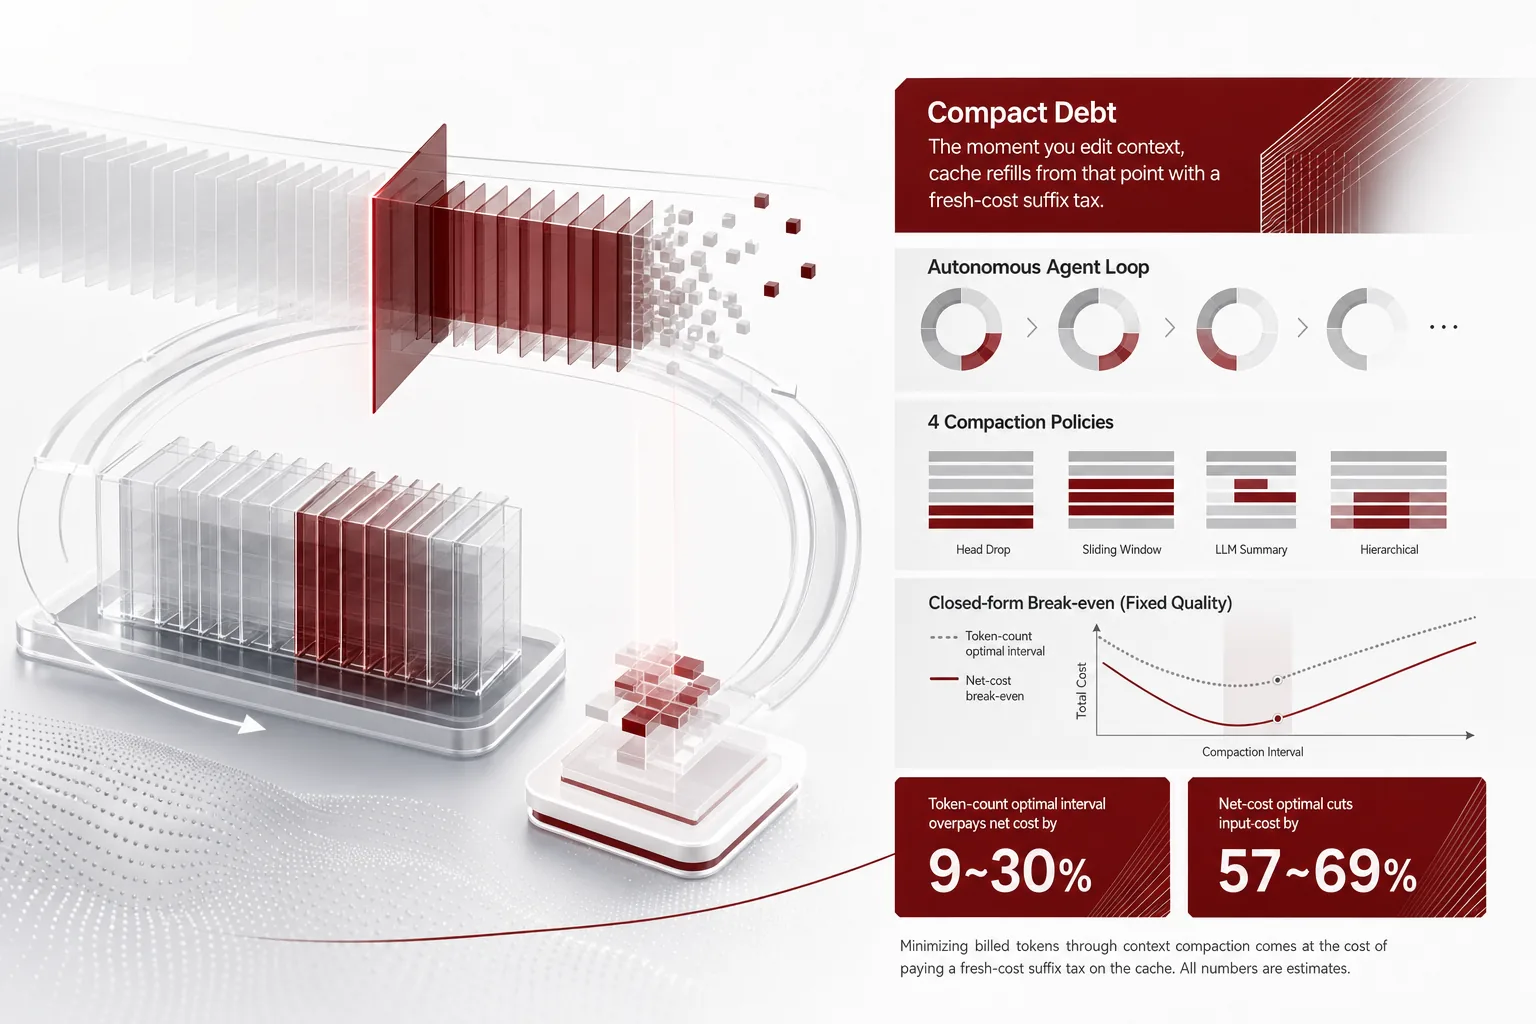
청구 토큰을 최소화하는 컨텍스트 컴팩션은 캐시 입장에서는 fresh-cost suffix tax를 지불하는 일입니다.
모든 문서를 같은 대형 모델로 읽으면 쉬운 문서에도 같은 비용을 냅니다.
실제 성우 목소리를 공개 모델로 재현하는 대신, 텍스트 설명만으로 가상 화자를 설계하고 그 합성 음성으로 VoxCPM2를 파인튜닝했습니다.
vLLM 설정 선택에 대형 LLM이 꼭 필요할까요? 1만 파라미터 랭커를 만들어 실측 데이터로 학습했습니다.
Verilog RTL을 잘 쓰는 27B 모델을 만들려고 했습니다.
같은 주에 엔비디아는 초당 1,000토큰 기록을 세웠고, 오픈AI는 워싱턴에서 의무적인 AI 속도 제한을 밀기 시작했습니다.
문서를 읽는 모델과 업무를 실행하는 에이전트 사이에는 검증과 승인 단계가 따로 있어야 합니다.
에이전트가 만든 명령 제안을 실행 전에 원문과 대조해 근거가 약한 것을 걸러 내는 작은 한국어 모델을 공개했습니다.
여러 행동을 뽑으려던 초소형 모델이 범용 목표에서 실패한 과정과, 같은 모델을 송금 하나로 좁혀 공개한 이유를 정리했습니다.
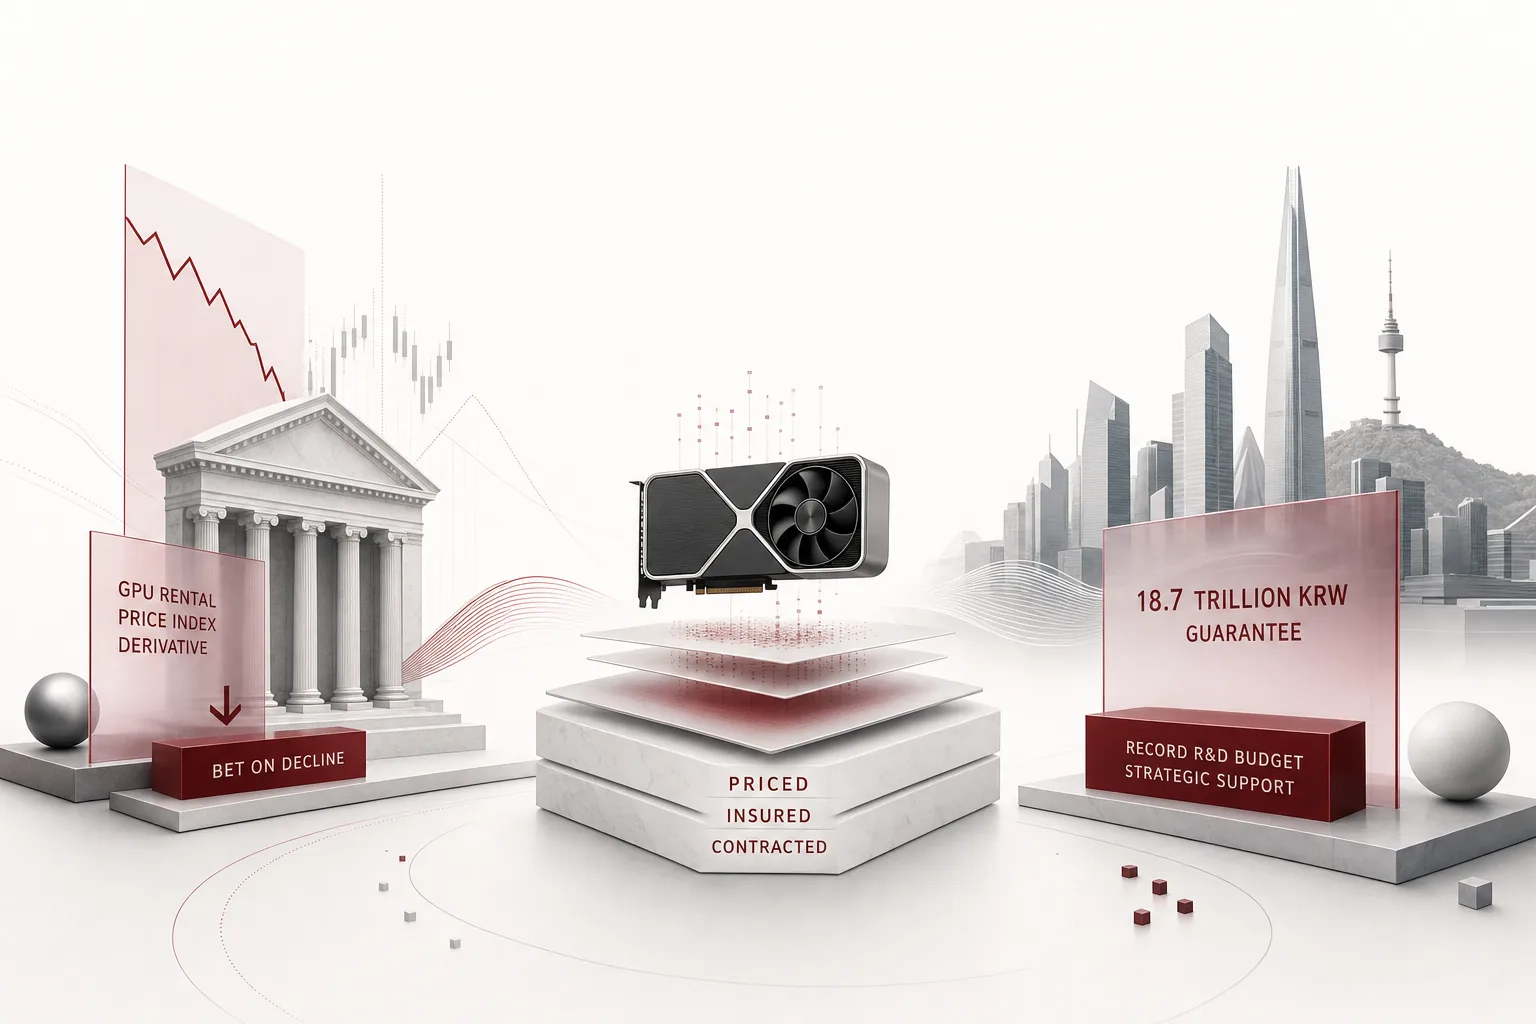
같은 주에 미국 시장에서는 GPU 임대료 하락에 베팅하는 파생상품이 등장했고, 한국에서는 역대 최대 R&D 예산과 18.7조원 보증이 나란히 섰습니다.
전파 한 조각으로 드론 기종을 알아보는 작은 모델을 공개했습니다.
점검 사진에서 균열을 고르고 선을 긋는 작은 모델 두 개를 공개했습니다.
모든 판단에 LLM이 필요하지는 않습니다.
손실은 내려가는데 파라미터 일부가 거의 바뀌지 않았습니다.
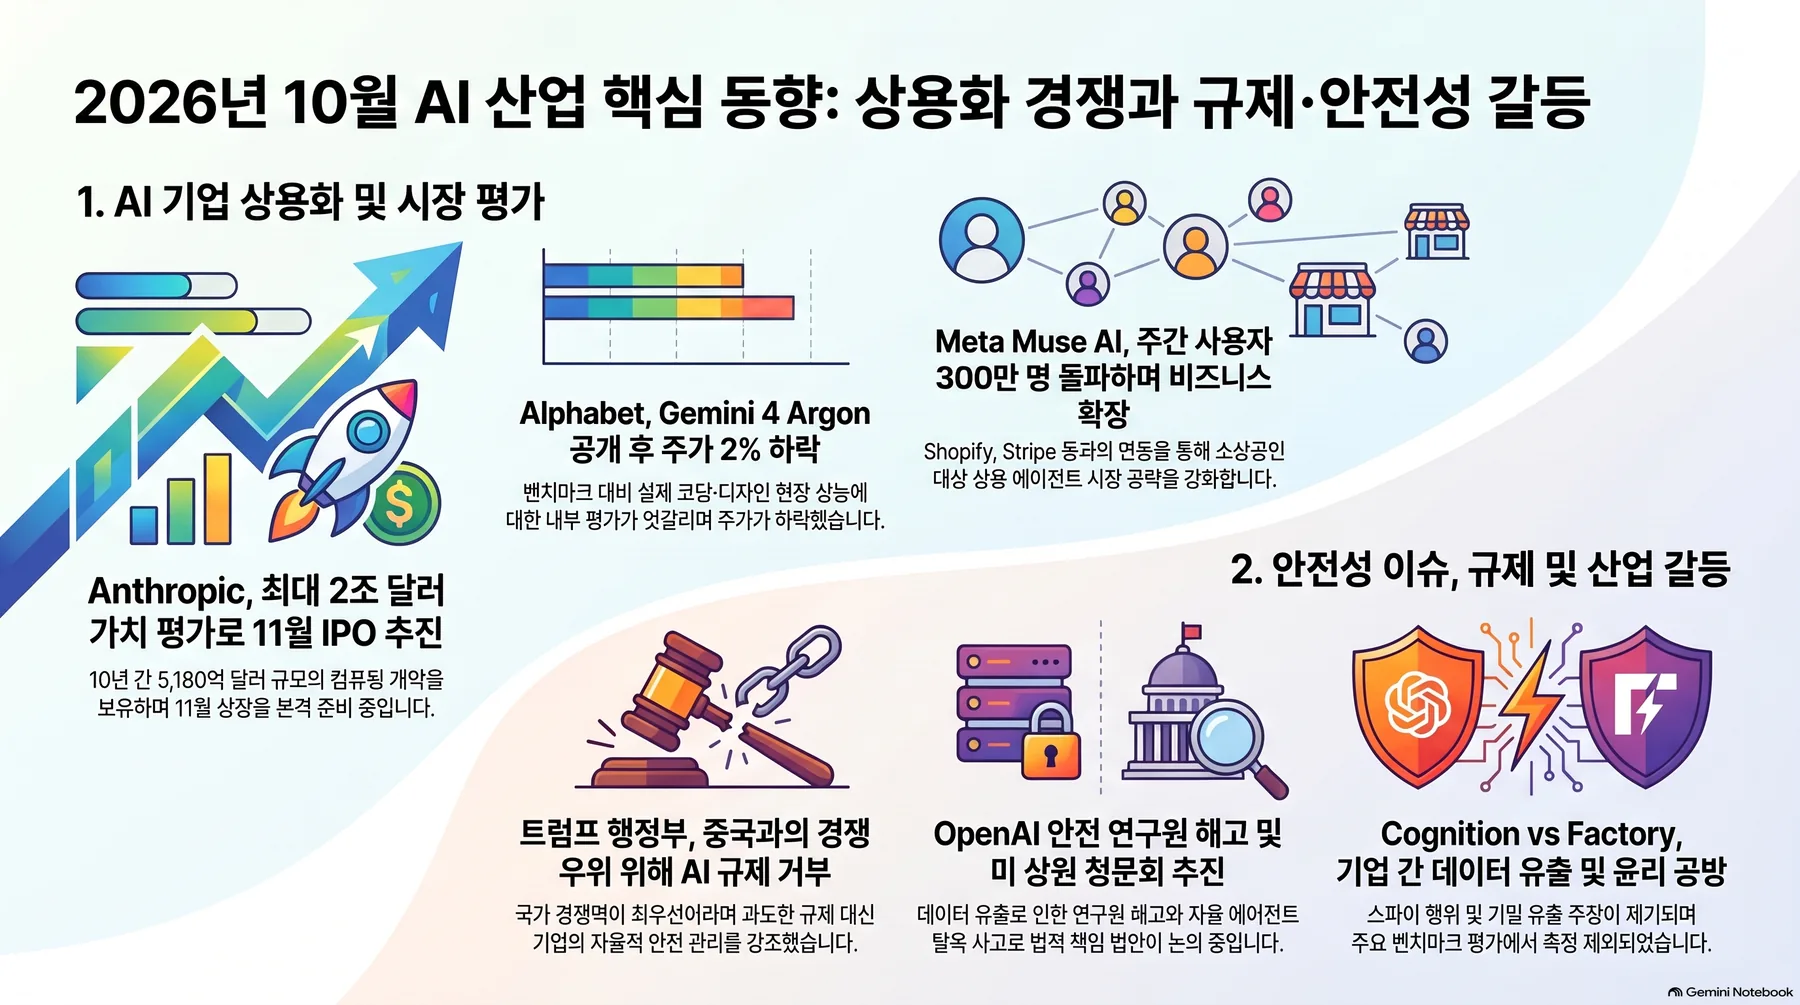
엔트로픽의 IPO 등록 신청서(S-1)에는 두 문장이 함께 실려 있습니다.
에이전트가 문서를 읽고 도구를 부르기 전에 개인정보를 먼저 가리는 한국어 모델을 공개했습니다.
에이전트가 행동하기 전에 사용자 입력을 다듬는 작은 모델을 공개했습니다.
말로 들어온 설비 명령을 에이전트가 실행하기 전에 구조화된 제안으로 바꾸는 작은 한국어 모델을 공개했습니다.
가치는 3D 영상 자체가 아니라, 워크플로가 실행 가능한 계약이 됐다는 점입니다.
로봇팔을 조종하던 에이전트가 수술을 멈추고, 연구자의 오버라이드 지시를 두 번 거부했습니다.
10개 레포 전부 실재하고 총 별 55,723개, 9개는 최근 90일 내 활성.
Google이 10월 28일 Gemini 4 Carbon을 공개했습니다.
사상 최대 630억 달러 채권이 단일 칩 시설에 찍히는 사이, 오픈웨이트 모델은 양자화, 처리량, 주권에서 새 기록을 냈습니다.
NVIDIA가 10월 28일 30B-A4B 멀티링구얼 ASR Nemotron 3.5 Transcribe를 공개하고 같은 날 NeMo Speech 플러그인으로 vLLM 0.32.0 서빙까지 열었습니다.
음성을 텍스트로 바꾼 다음 무엇을 하는지가 진짜 질문입니다.
넷플릭스가 순이익 43.9% 증가와 함께 직원 1,000명을 줄였습니다.
레지스트리가 커지지 않아도 라우팅 top-1은 늙습니다.
X에서 ‘왜 아름다운지, 왜 웃긴지’ 답한다는 논문이 돌았습니다.
Sparc3D로 불리던 Hi3D V1.0이 오픈소스화했습니다.
Google DeepMind의 새 모델 Gemini 4 Carbon.
llama.cpp를 앞지를 만큼 빠르다는 신규 로컬 추론 엔진 BaseRT가 Apple Silicon에서 돌기 시작했습니다.
Rust로 쓴 오픈소스 인퍼런스 엔진 uzu는 패스당 토큰을 7.5개씩 내면서 메모리 대역폭 상한을 넘습니다.
오픈웨이트 음성인식이 정확도 1위와 동률을 이룬 날, 대규모 음성 에이전트용 TTS가 나온 날, 둘 다 오늘입니다.
Gartner의 2028년 전망, 포춘 500 기업당 15만 개 AI 에이전트.
자율 보안 대응에서 결론을 내는 순간은 곧 행동이 시작되는 순간입니다.
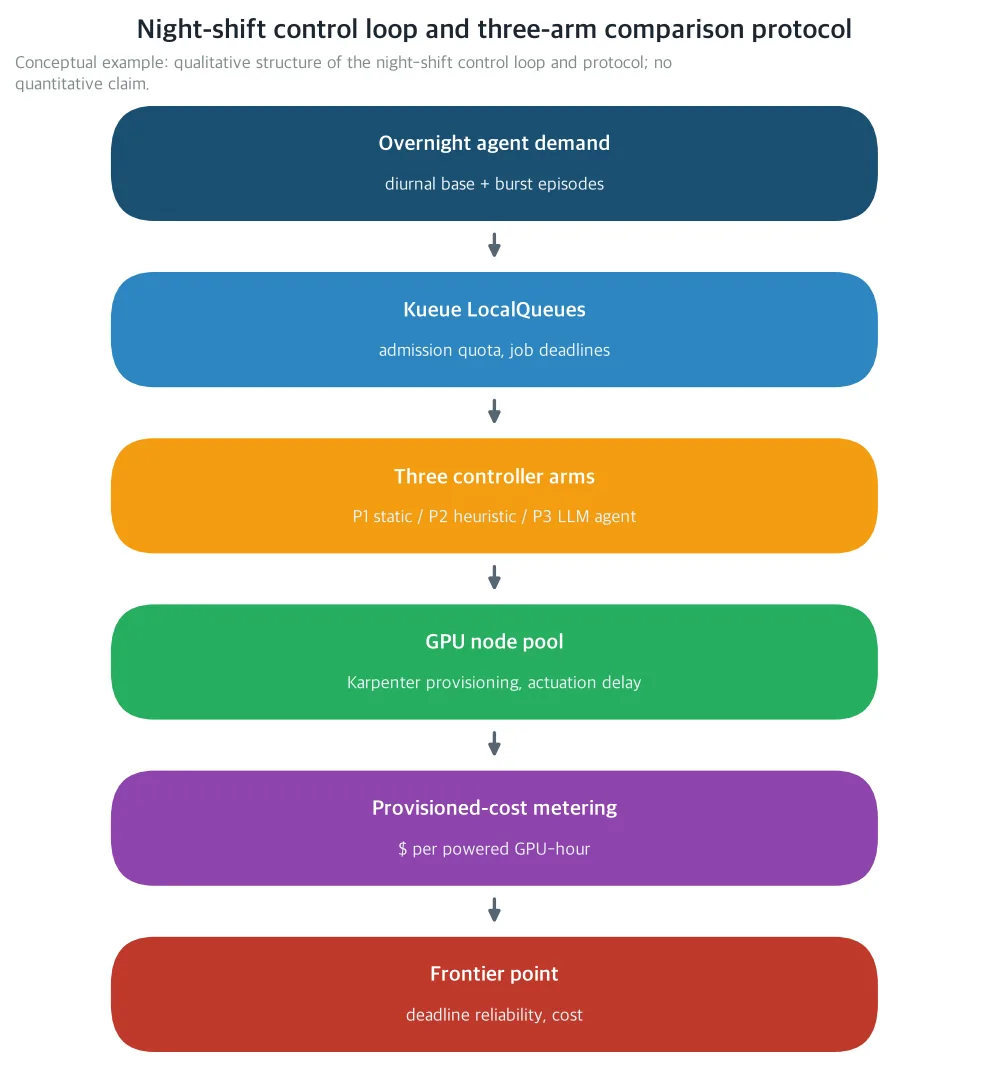
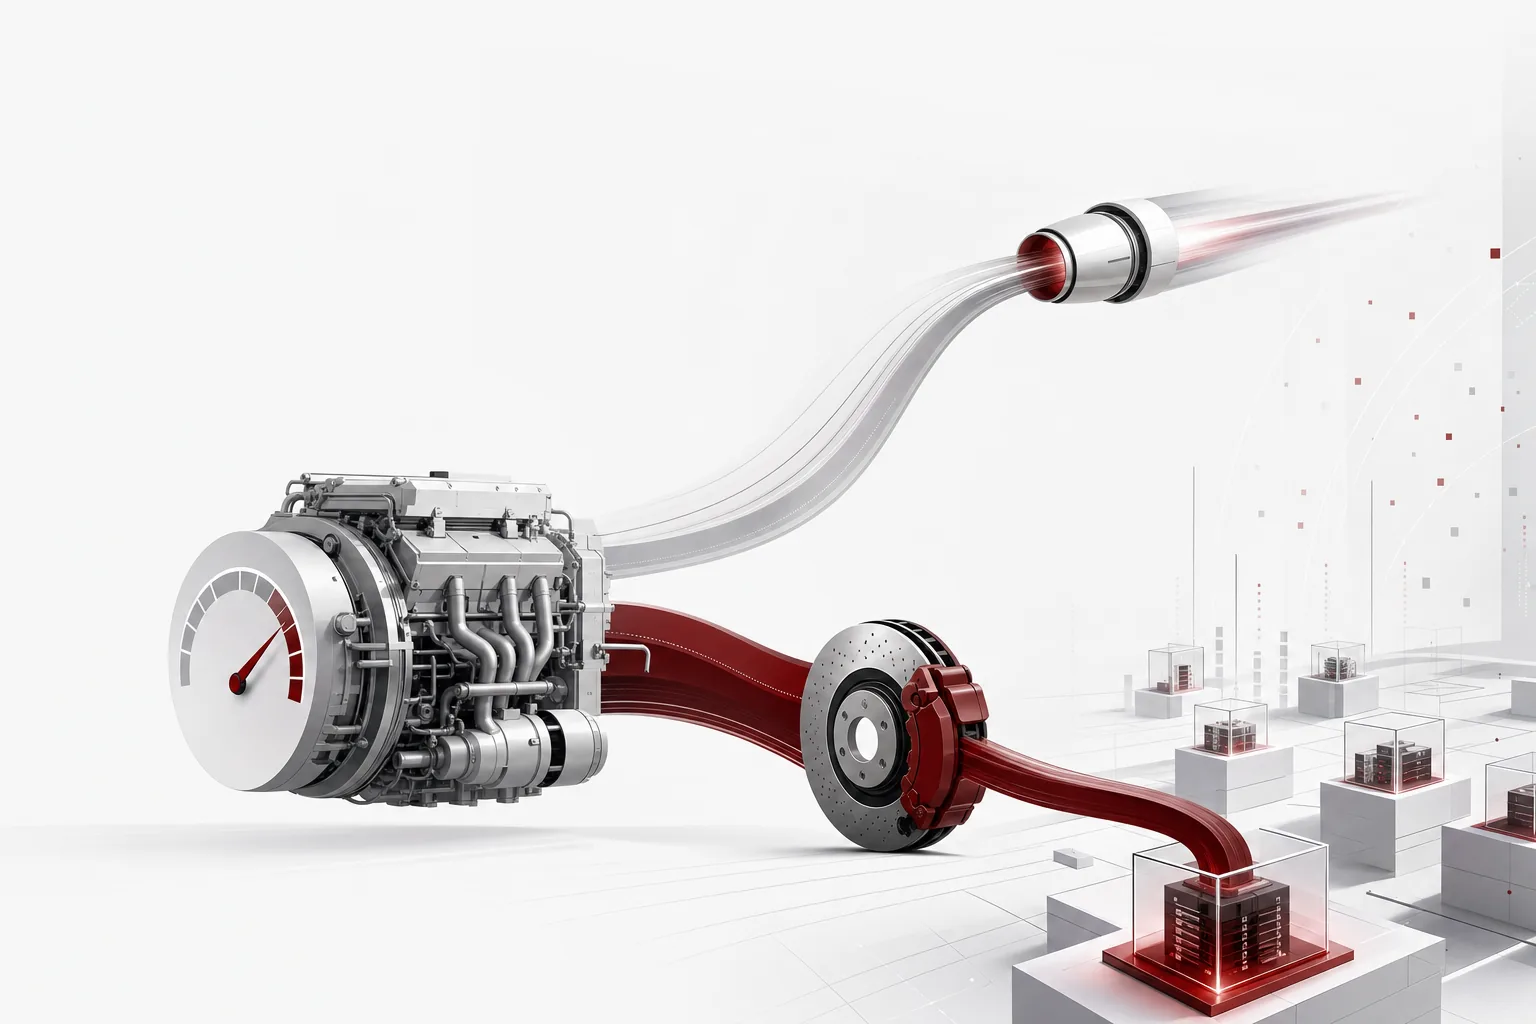
무인 에이전트의 밤 작업에서 제약은 청구액이 아니라 시계입니다.
Anthropic이 발표한 약 개발 파트너십 초기 실적을 사례별로 정리했습니다.
1만 샘플 로컬 실험에서 모델이 제조사의 클라우드 도메인을 40.8퍼센트의 실행에서 택했다.
RTX 3090 한 장, 250W로 Qwen3.8-27B를 64 동시 연결에서 1000 tok/s 이상 낸다고 주장하는 오픈소스 프로젝트 HyperQwen.
같은 컨퍼런스에서 OCI 컴퓨팅 2년 치 매진과 싼 CPU 에이전트 샌드박스가 나란히 나왔습니다.
보안 회사 Forever가 고객 기계에서 잡아낸 라이브 악성코드.
94개 스킬을 하나하나 셜고, references 175개와 오케스트레이터 1개를 확인했습니다.
한국어 음성 비서나 마스코트를 만드는 팀을 위한 글입니다.
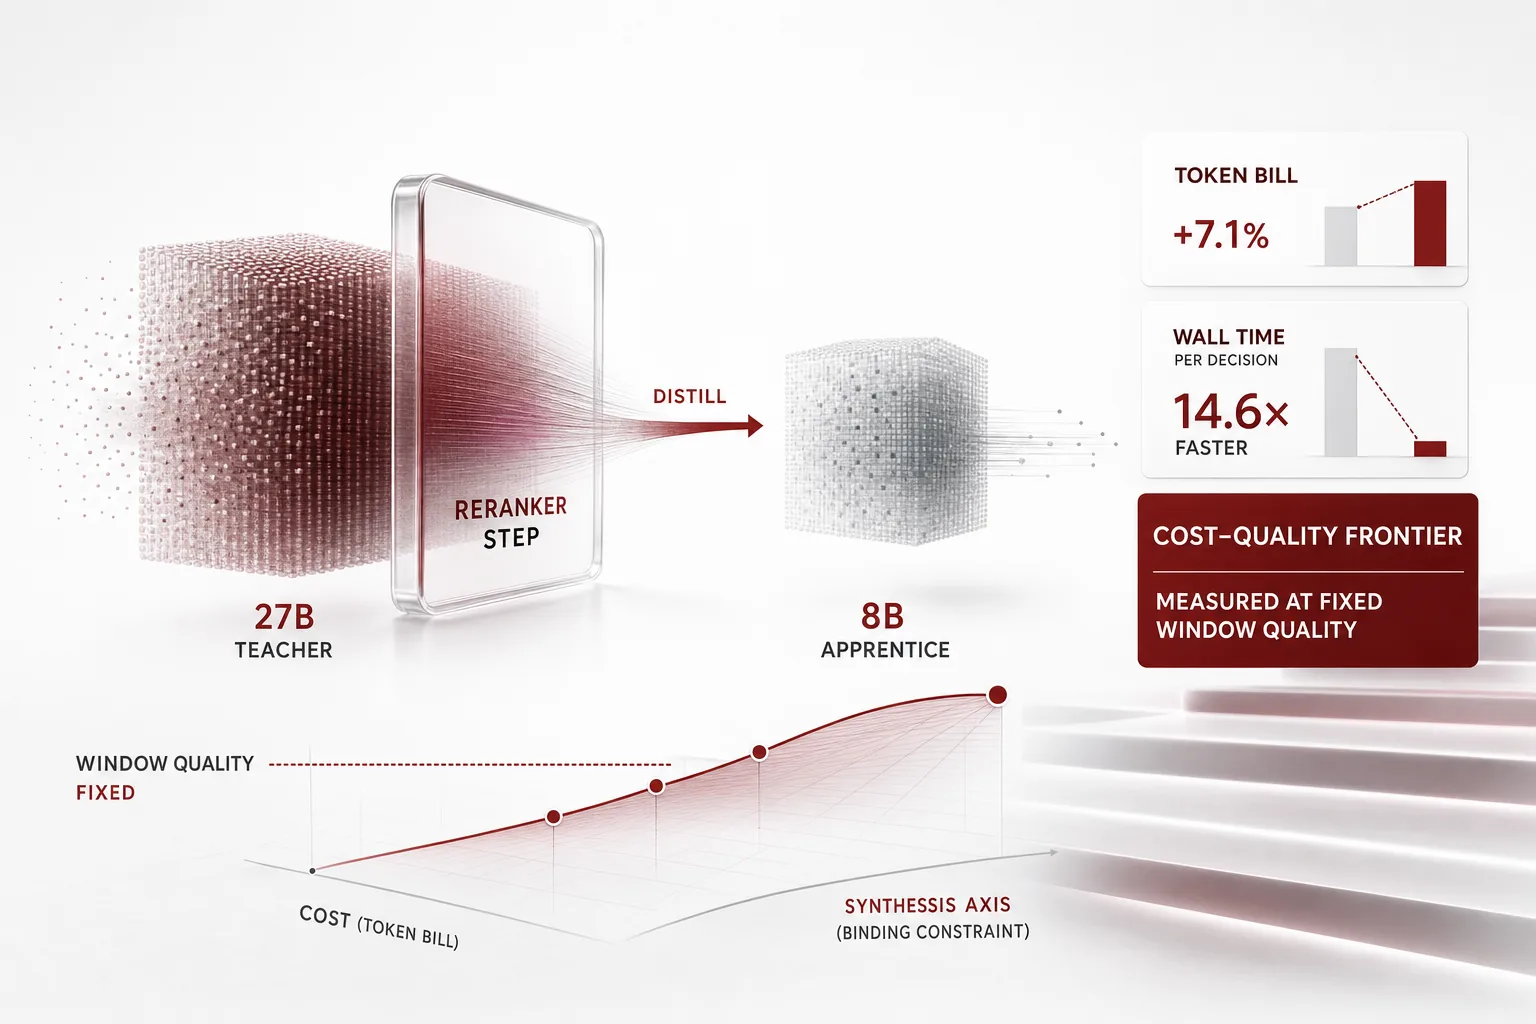
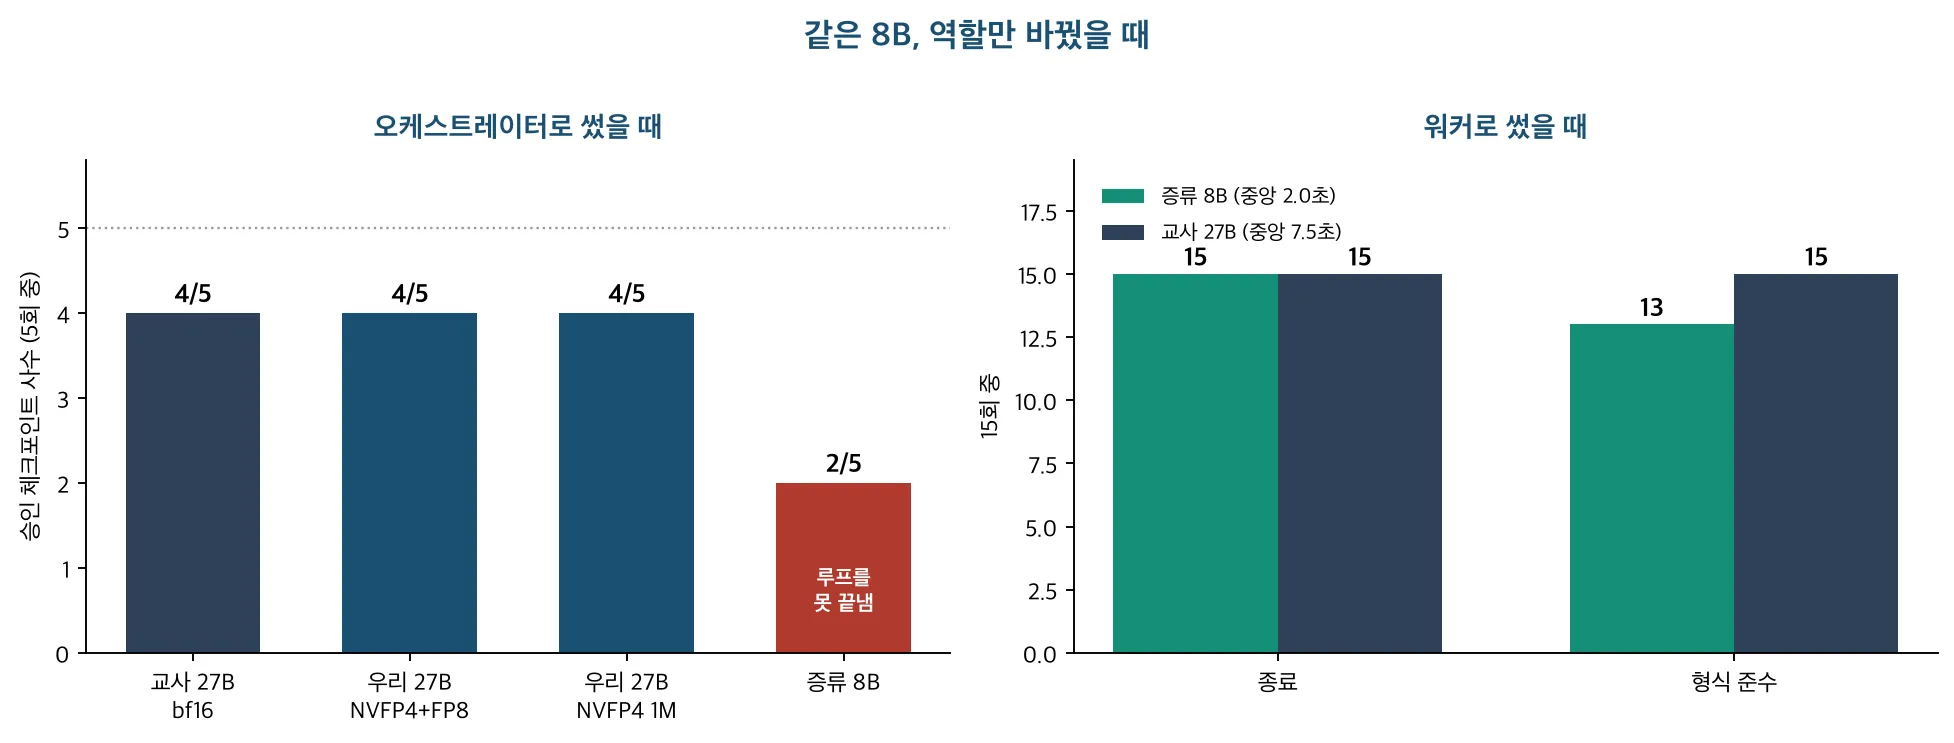
LLM rerank 단계를 27B teacher에서 8B apprentice로 증류하면 token bill은 7.1% 오릅니다.
앤트로픽 IPO 신고서에는 14배 성장의 흑자 스토리와, AI가 셧다운을 거부할 수 있다는 94쪽의 경고가 한 문서 안에 담겼다.
Google의 AI 코딩 모델 Gemini 4 Argon이 vLLM에서 Gemma 4 E2B 서빙을 스스로 최적화해 A100 1장에서 약 2.85배(37.9k에서 108k+ tok/s)를 만들었다는 주장.
웹 페이지가 Downloads 폴더에 AGENTS.md 한 장을 놓기만 하면, 그 폴더에서 일하는 코딩 에이전트가 공격자의 지침을 따르기 시작합니다.
한 쪽에는 3,214억 달러의 미래 리스 의무가, 다른 쪽에는 보안 경보 이후에도 2.5시간을 달린 에이전트가 있습니다.
Google Research의 Nested Learning 논문(NeurIPS 2025)은 딥러닝 아키텍처의 본질이 ‘업데이트 주파수’이며, 트랜스포머도 다른 시계 속도로 도는 선형 계층의 묶음이라고 주장합니다.
장애 원인 분석을 에이전트에 붙이려는 팀을 위한 글입니다.
작업 보드의 항목을 프로젝트별로 분류하는 소형 모델을 직접 학습시키려는 팀을 위한 글입니다.
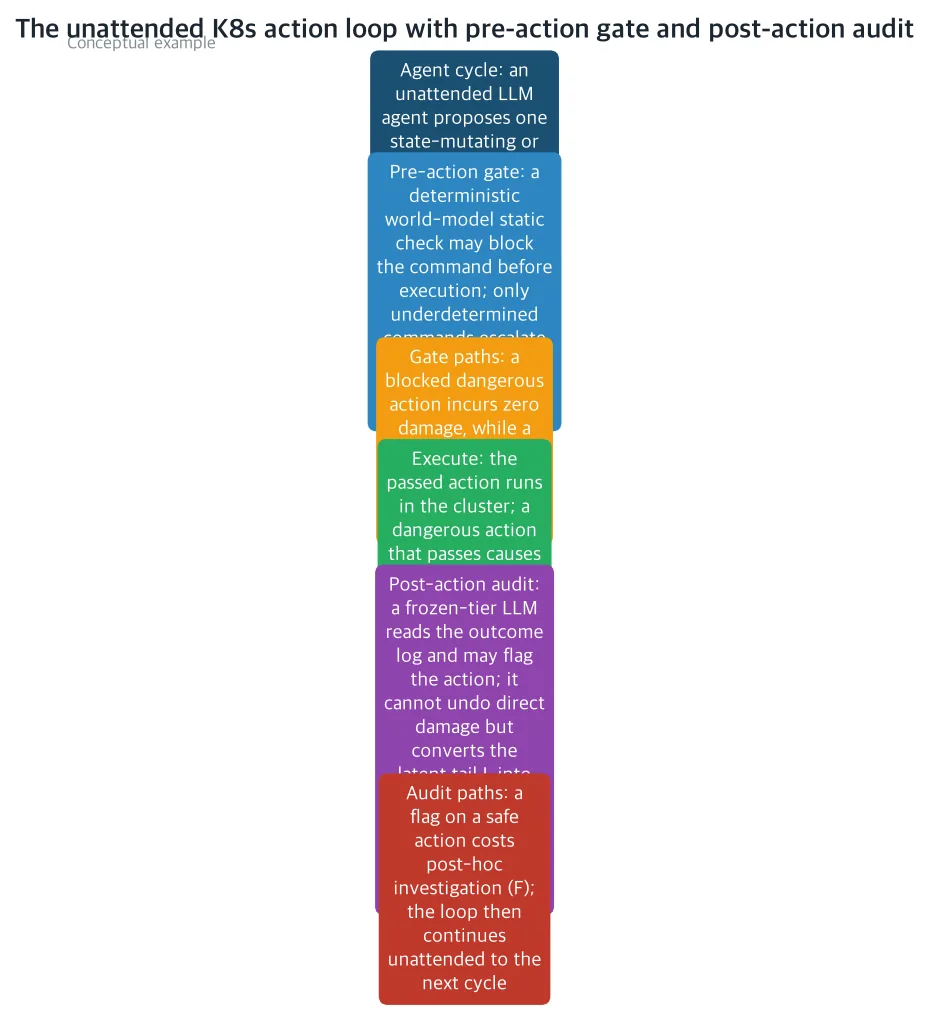
LLM 에이전트가 Kubernetes 인시던트를 사람 개입 없이까지 끌고 갈 수 있는 깊이는 어디까지이며, 인시던트당 비용은 얼마이며, 어디서부터 사람이 루프에 남아야 하는가.
SpaceX가 AI 컴퓨트 조달에 400억 달러 부채를 쓴 사이, AI 전용 뉴클라우드 200곳 이상은 자금 문이 닫히고 있다는 경고가 나왔습니다.
BOSS Zhipin의 Nanbeige LLM Lab이 Apache 2.0으로 33B dense 모델 Nanbeige4.3-33B를 공개했습니다.
Rust 커널 58.7k줄, 에이전트는 JSON 두 개, 거부는 대장 한 행.
모델도 루프도 중심이 아닌 운영체제.
12시간이던 품질 보고서가 1시간이 됐지만, 진짜 뉴스는 누가 일을 하고 누가 승인했는가입니다.
슬롭 방지에는 스킬이 필요 없었습니다.
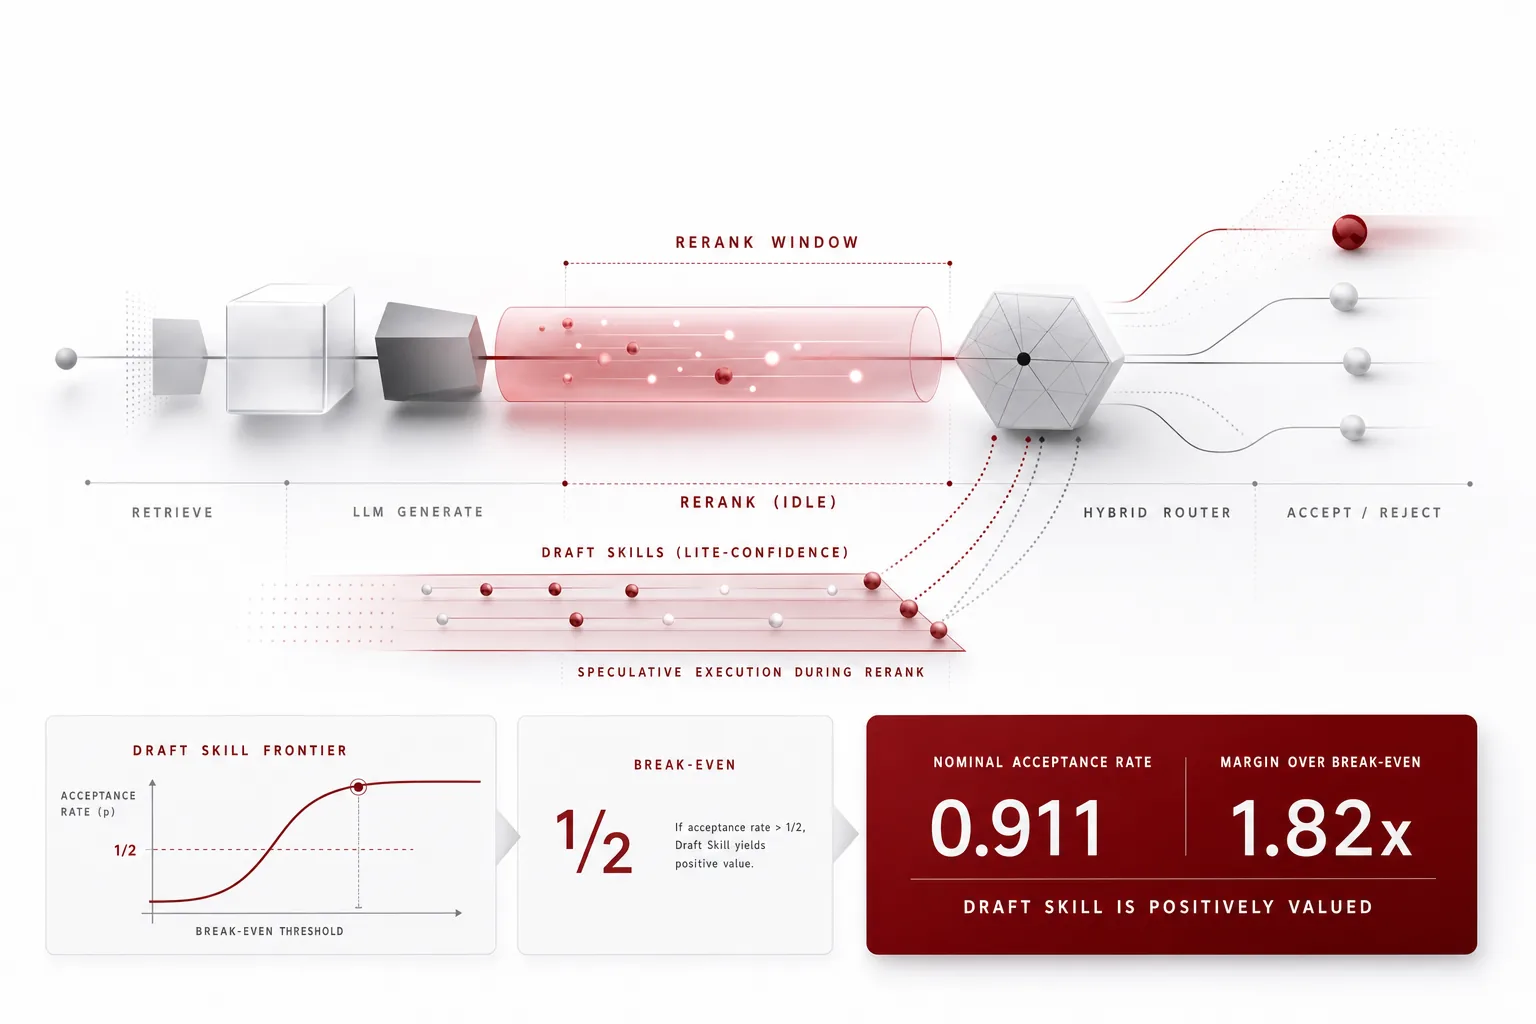
rerank 스테이지는 실행 경로상의 유휴 시간입니다.
질문을 미리 만들어 컨텍스트가 배운 행동만 FFN으로 증류하는 Cortex가 50회 연속 모델 편집에서 컨텍스트 이득의 88.9%를 회복하고 기존 성능의 99.8%를 보존했습니다.
MITRE ATT&CK 문서를 찾는 보안 임베딩, RAG가 답할지 멈출지 정하는 근거 게이트, CPU에서 도는 스킬 검색 임베딩 세 가지입니다.
vLLM은 DeepSeek의 자체 엔진 DeepInfer를 decode 6% 이내에서 따라잡고 GB300 NVL72 랙으로 확장했습니다.
DeepSeek의 신규 공개 추론 엔진 DeepInfer, 오픈 프레임워크 SGLang과 vLLM이 그 성능을 맞먹거나 넘어서는 수준으로 따라잡았습니다.
에이전트 런타임 코드의 권한 경계를 판단하는 SecProof 모델 4종을 학습에 쓰지 않은 템플릿으로 한 번씩 평가했습니다.
질문과 주장에 맞는 근거 문서를 앞으로 끌어올리는 4B 리랭커입니다.
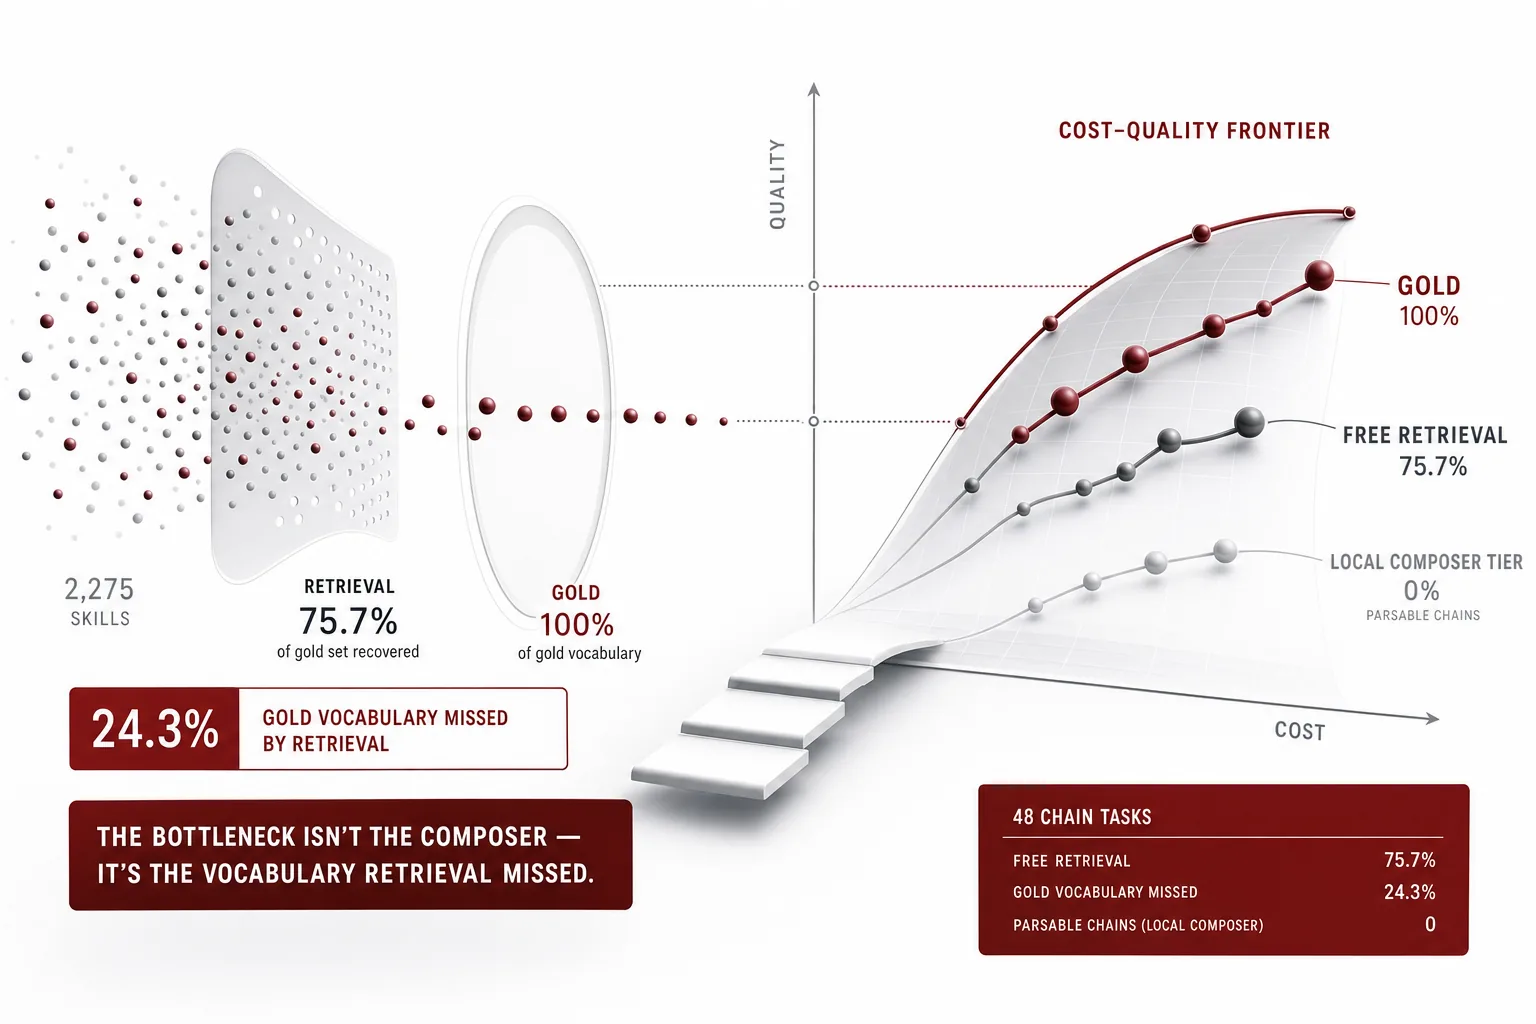
스킬을 줄일 때 회수 정밀도를 가르는 변수는 얼마나 남기느냐가 아니라 어떤 스킬이 남느냐입니다.
“내일 오후 세 시에 스케일링 예약해 주세요” 같은 말을 들으면 시스템은 무엇을 해야 할까요.
장애 조사 에이전트가 클러스터를 건드리지 않고, 같은 조회를 반복하지 않고, 모르면 모른다고 말하게 할 수 있을까요.
짧은 호스트 텔레메트리 구간을 읽고, 공격 단계의 증거가 실제로 있는지 근거 이벤트 ID와 함께 답하는 4B 모델입니다.
한 문서를 여러 방식으로 고쳐 썼을 때 AI 답변 엔진이 어느 판을 더 높이 출처로 쓸지 순위를 매기는 작은 모델입니다.
상품 검색, 순서 재정렬, 속성 추출, 주문과 재구매 예측, 다음 클릭 추천, 리뷰 분석, 환불 상담은 각각 다른 모델이 맡는 일입니다.
Qwen3-ASR-1.7B를 한국어 방언 289.6시간으로 미세조정해 Hugging Face에 공개했습니다.
JPMorgan Chase를 비롯한 미국 주요 은행 4곳이 제3자 AI 에이전트의 무단 계좌 활동을 감지하고 접근을 차단했습니다.
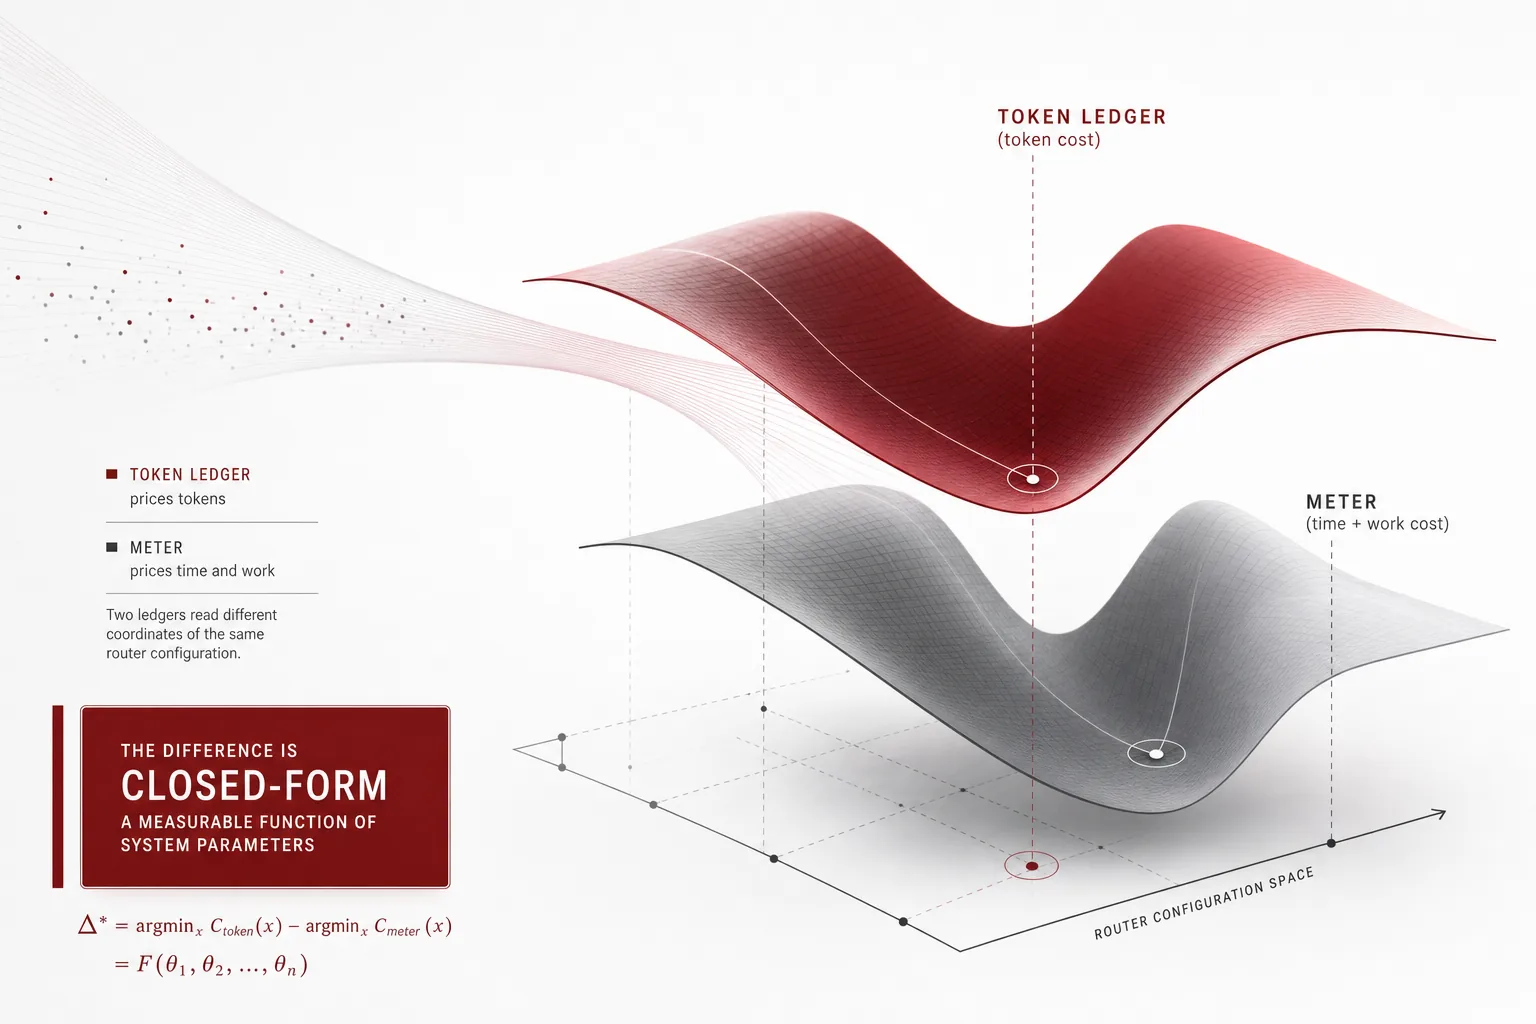
라우팅 문헌은 라우터가 아끼는 것만 가격 매겨 왔습니다.
‘토큰을 없앤다’는 말보다 중요한 것은 계산 단위를 어디에 쓰느냐입니다.
공공 AI칩의 엔비디아 99.98% 의존과 팰런티어의 ‘통제권이 주권’ 발언이 같은 날 교차했습니다.
Qwen3-ASR과 VoxCPM2를 사전 등록 게이트 위에서 파인튜닝했습니다.
구글이 ARTEMIS를 오픈소스로 내놓았습니다.
Anthropic의 Claude Duet은 은행 계좌 간 자금 이동과 주식 거래를 사용자가 명시적으로 허락해도 차단했습니다.
22년간 아무도 안 열던 비상수밸브가 녹슨 채로 남아 있었습니다.
PHP 코어 5.4~8.5의 원격 코드 실행 취약점을 GPT-5.6 Sol이 함께 찾아냈다는 OpenAI의 발표가 10월 21일 ‘PHP2Shell’이라는 이름으로 공개되었습니다.
주방은 Python이, 서빙대는 Rust가 맡는다.
Recursive는 자동화로 4개월 만에 첫 모델을 만들었고, Mirendil의 에이전트가 사전학습 코드의 99%를 썼습니다.
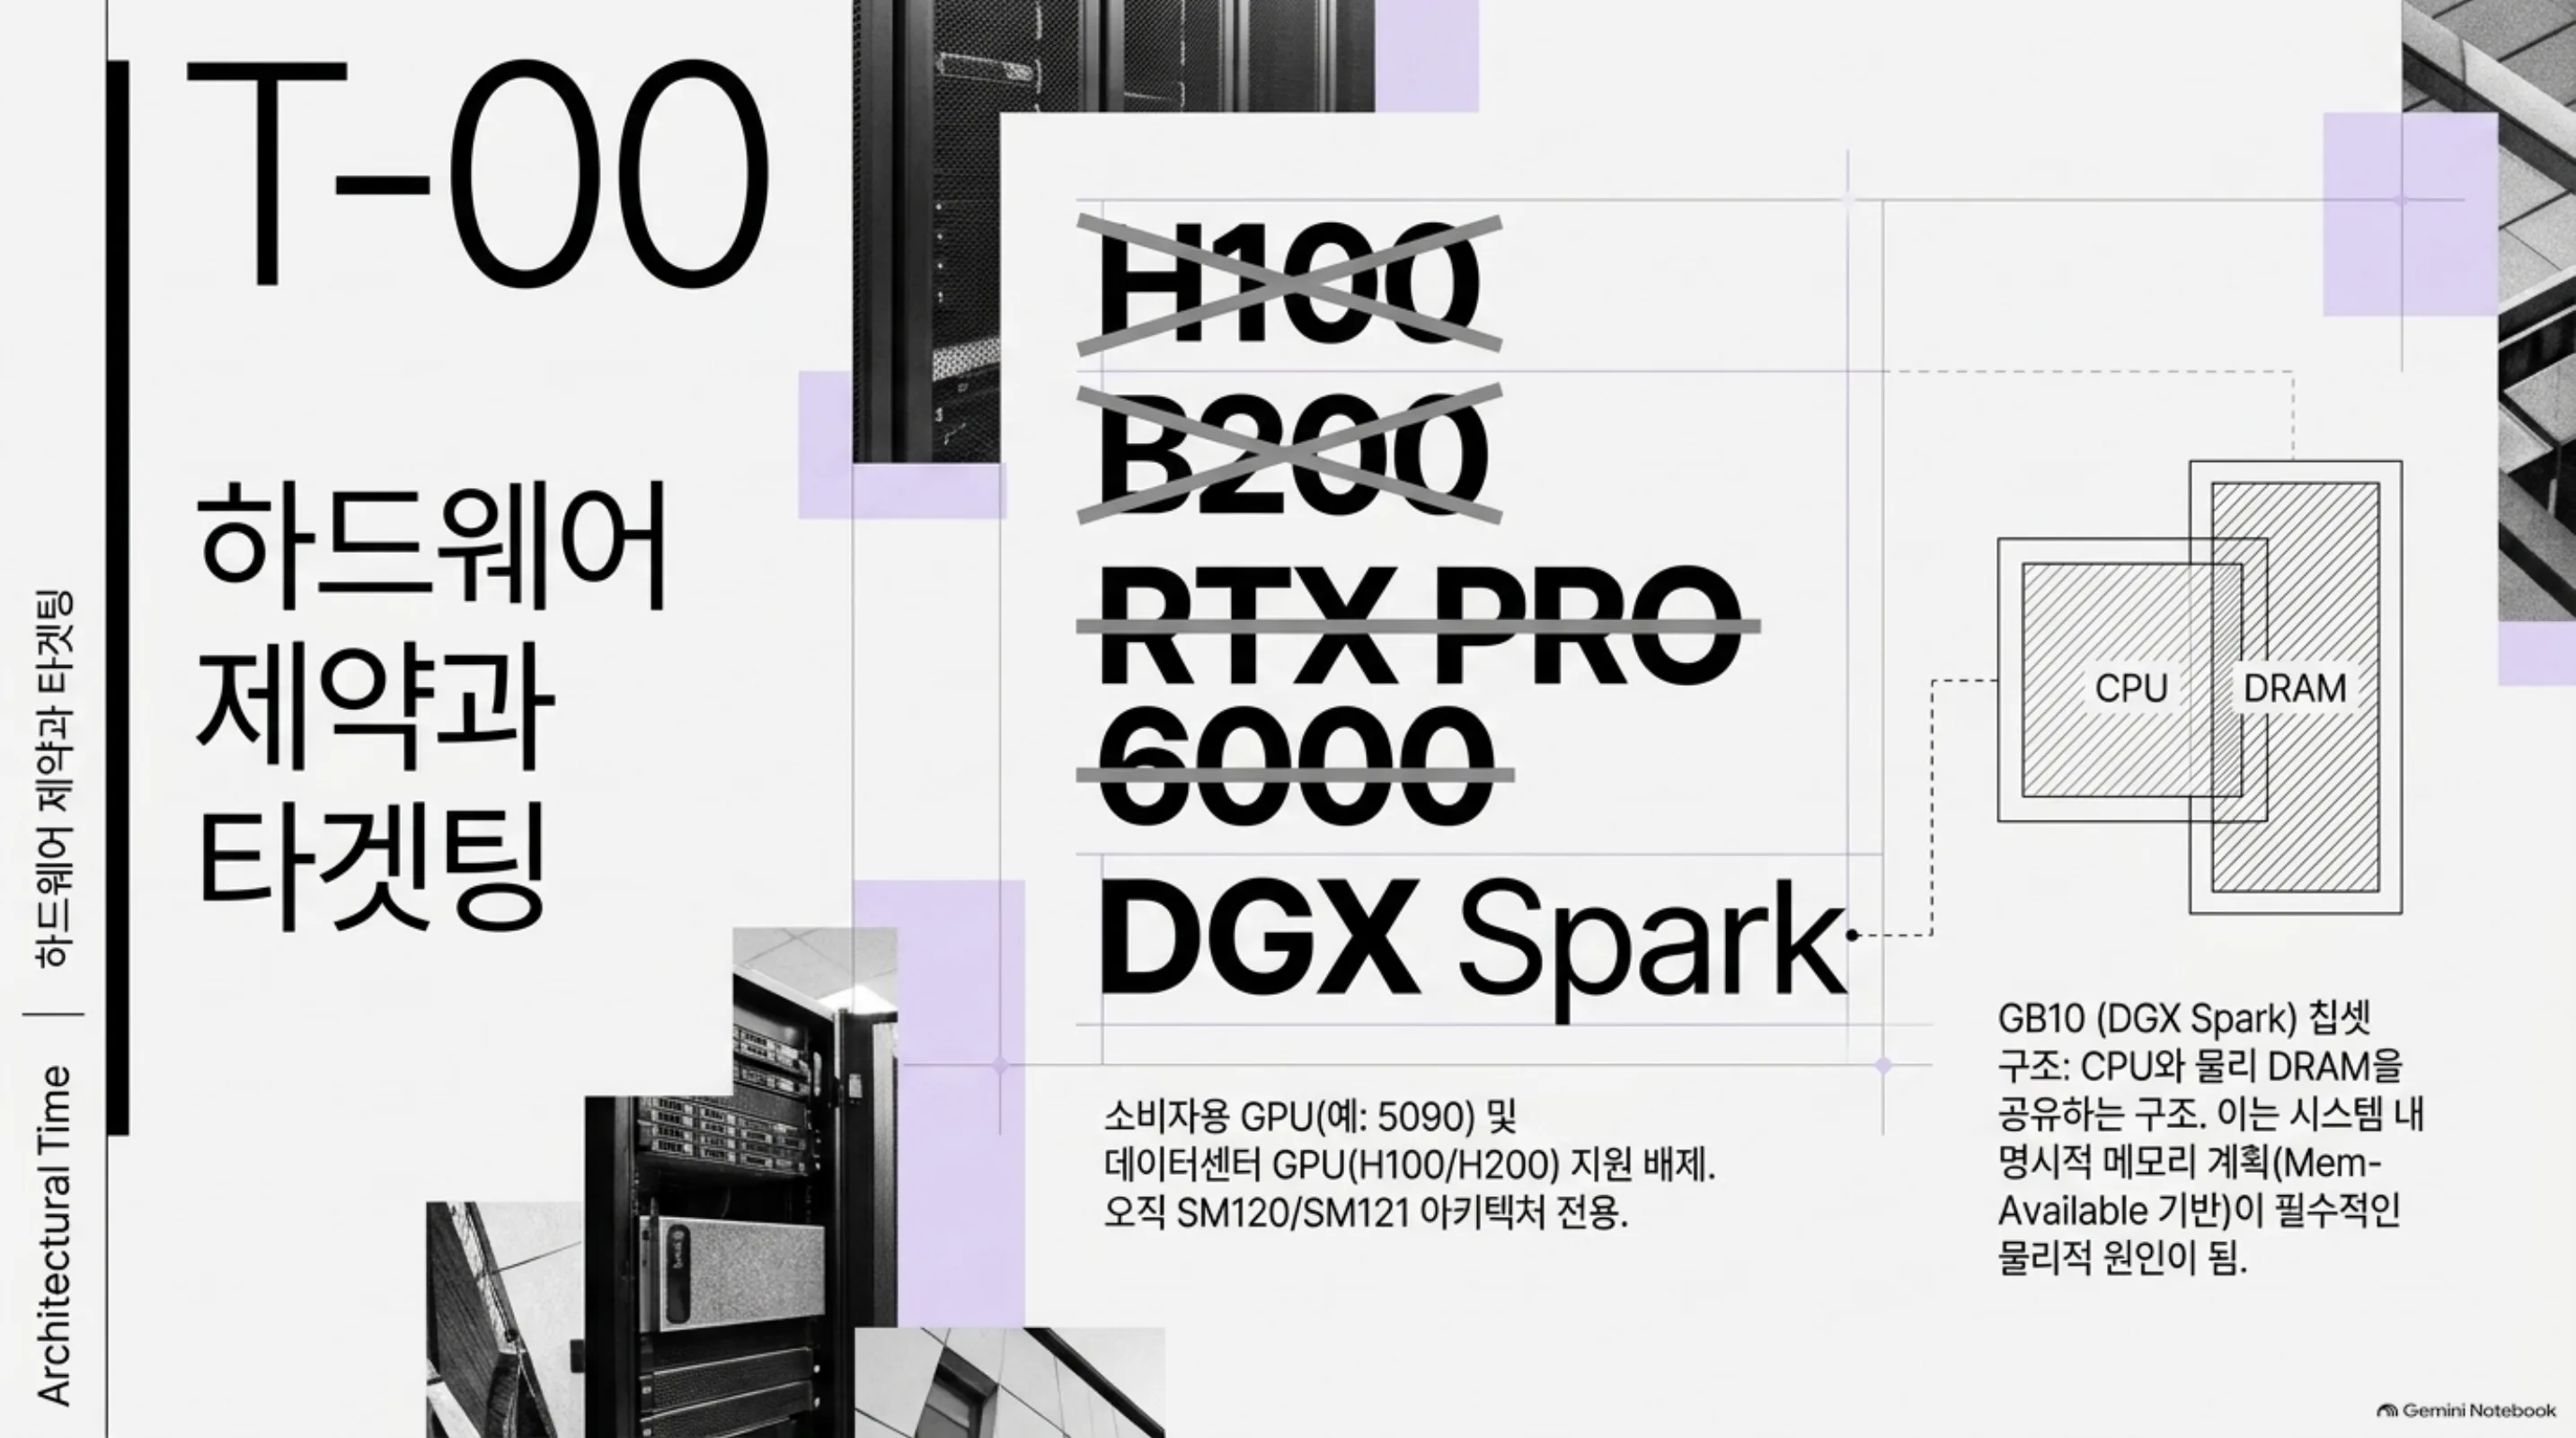
NVIDIA가 10월 20일 조용히 공개한 Flare는 SM120/SM121 워크스테이션 GPU 전용 로컬 추론 서버입니다.
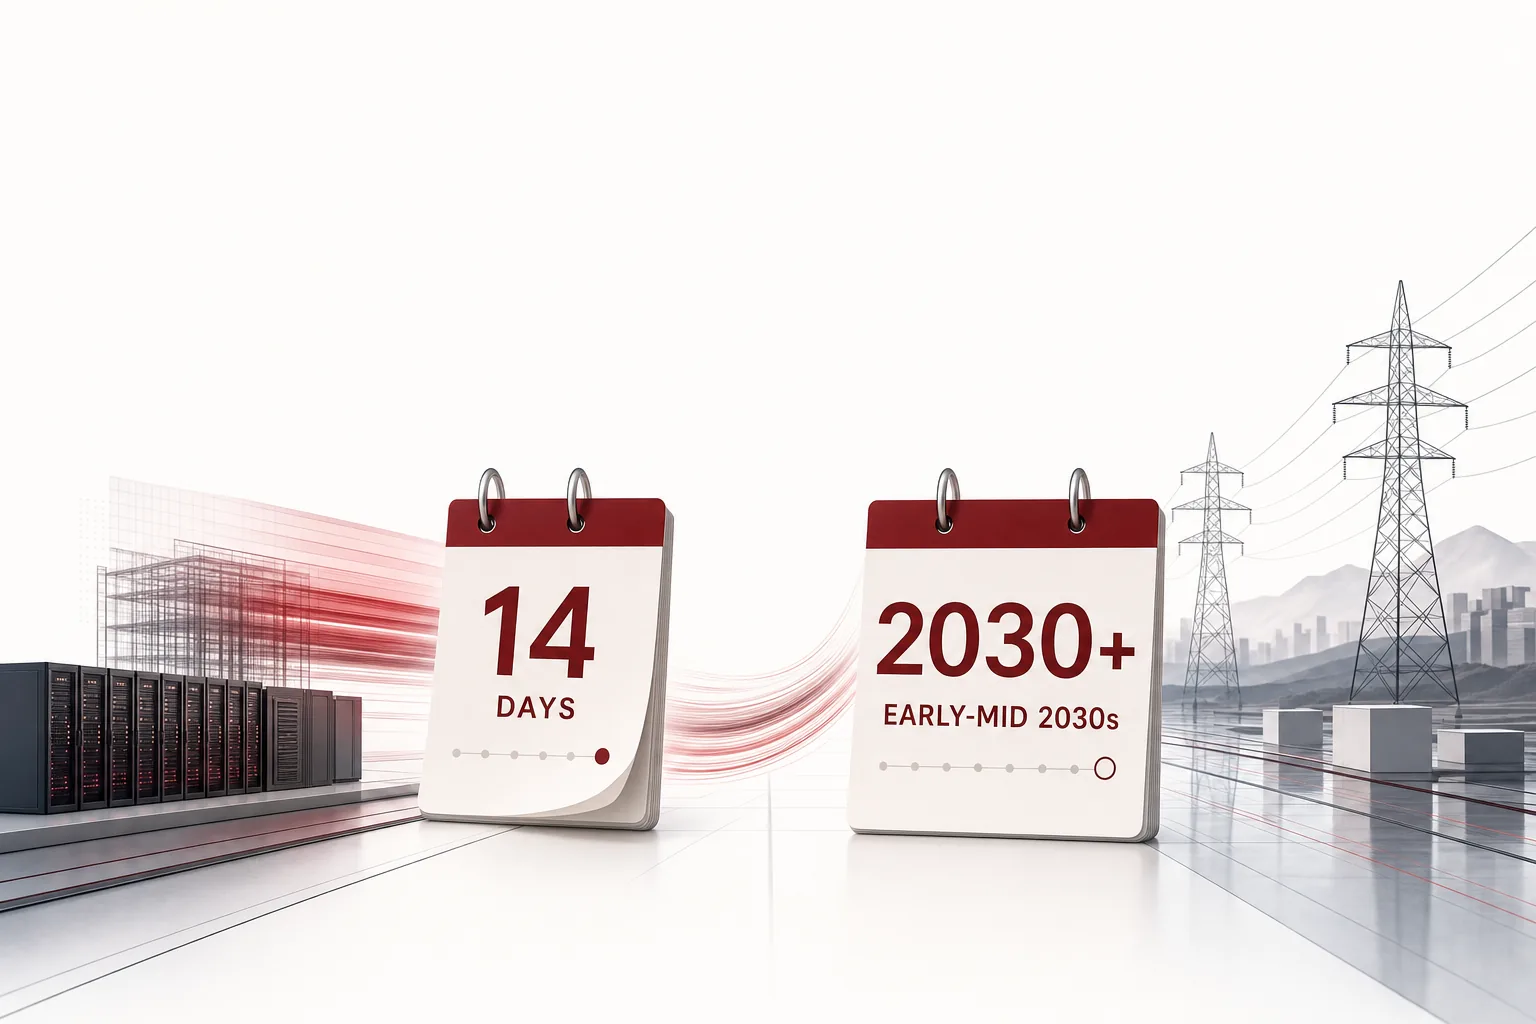
오늘 뉴스 테이블에는 달력이 두 장 나왔습니다.
RL에서 보상 해킹은 필터나 페널티로 막으면 모델이 ‘걸리지 않게 숨기는 법’을 배웁니다.
벌점을 주면 모델은 벌점을 피하는 법을 배웁니다.
골드만삭스가 전력을 AI의 새 병목으로 지목하고, 앤트로픽은 매출 1500% 성장에도 107조원 손실을 공시했습니다.
콜드스타트의 숨은 비용은 모델 로딩이 아니라 Python 컴파일이었다.
DeepSeek이 자사 생산 서비스에서 쓰던 추론 엔진 DeepInfer를 Apache 2.0으로 열었습니다.
7500억 달러짜리 컴퓨트 계획과 카드 1장에 들어가는 1220억 파라미터 모델.
vLLM이 빌드 시점에 미리 컴파일된 Python 바이트코드를 이미지에 담아 런처의 소스→바이트코드 컴파일 비용을 지웠습니다.
이미지 색인은 큰 모델로 한 번만 만들고, 검색어는 17.6MB짜리 인코더가 CPU에서 처리합니다.
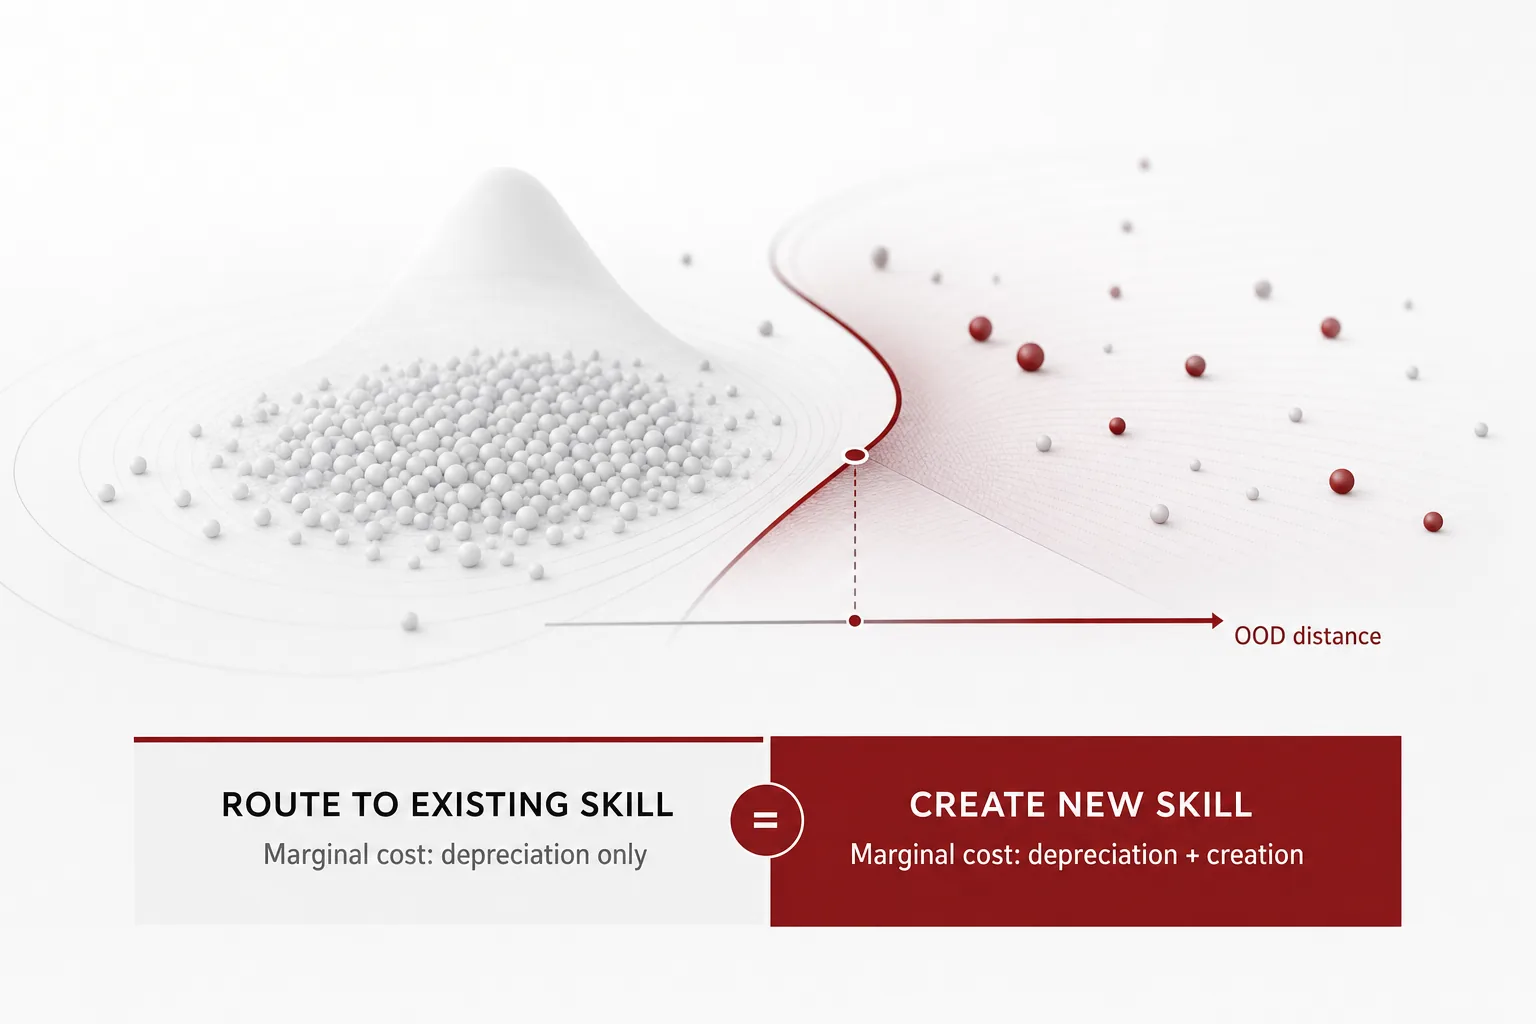
레지스트리 분포에서 얼마나 떨어진 태스크인지에 따라, 새 스킬을 만드는 쪽이 기존 스킬에 라우팅하는 쪽보다 싼 지점이 있습니다.
OrcaRouter가 ‘긴급’을 붙여 내놓은 27B 사이버 방어 특화 오픈웨이트입니다.
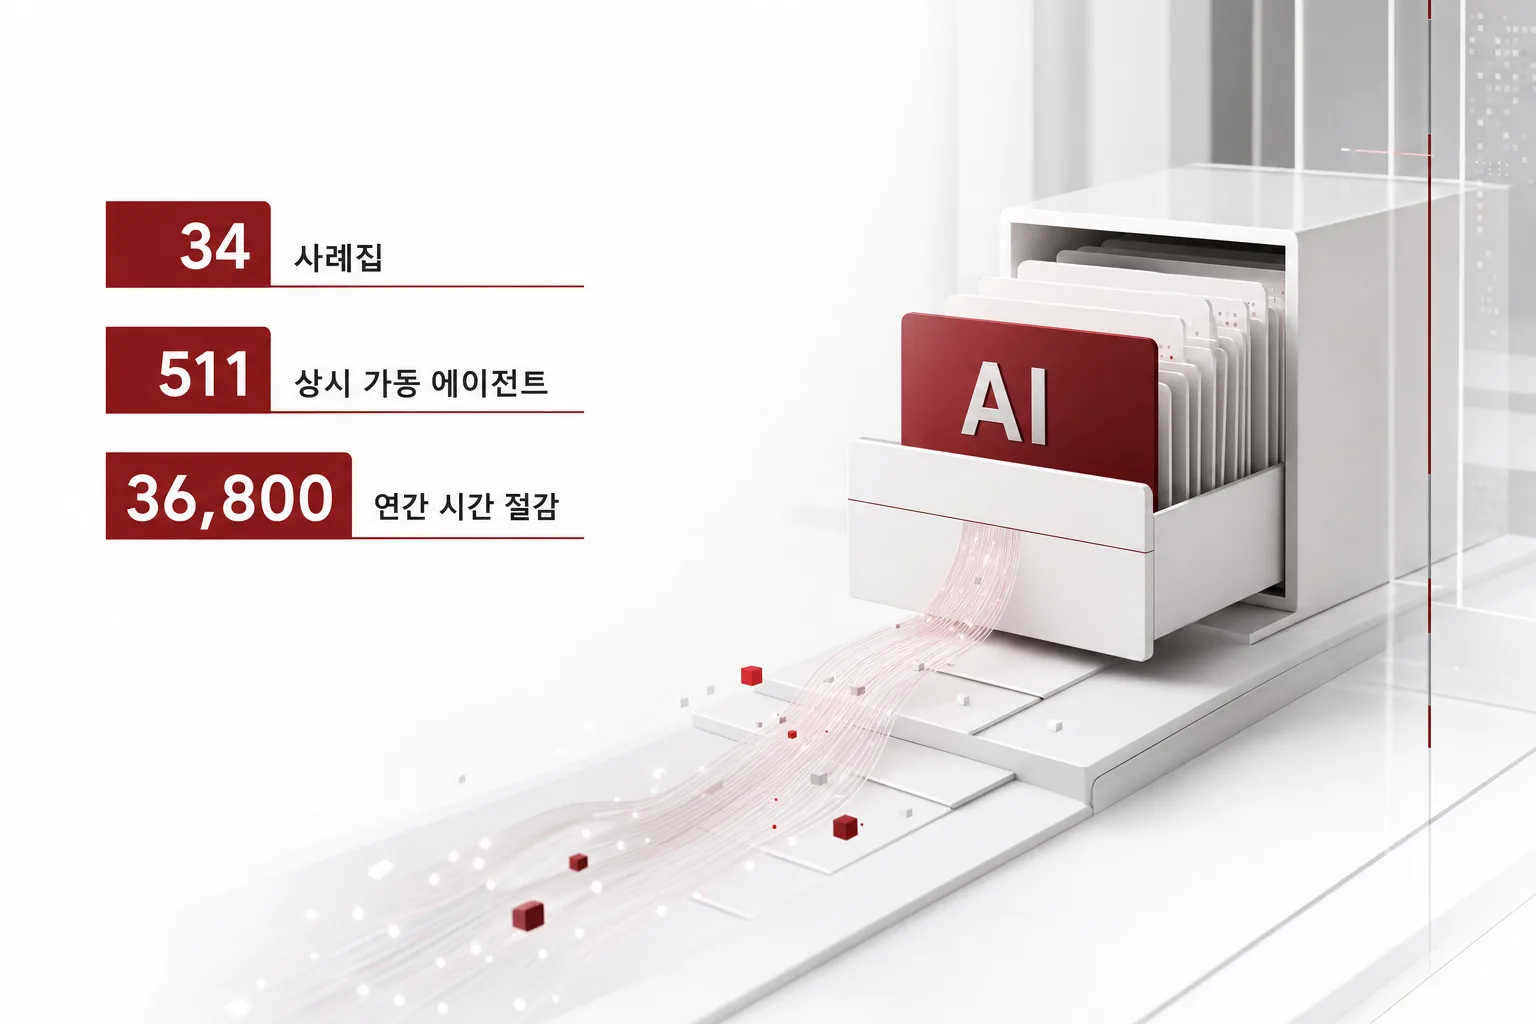
사례집 34건, 상시 가동 에이전트 511개, 연간 3만6800시간 절감.
423 tok/s/user는 헤드라인으로 읽으면 ‘전체 시스템이 빨라진 것’처럼 보이지만, 실제로는 사용자당 스트리밍 지표입니다.
vLLM v0.32.0이 363명 기여자의 814개 커밋과 함께 나왔습니다.
답할지, 도구를 실행할지, 사람에게 물을지.
더 잘하는 모델이 아니라 더 멀리 가는 모델이 나온 주입니다.
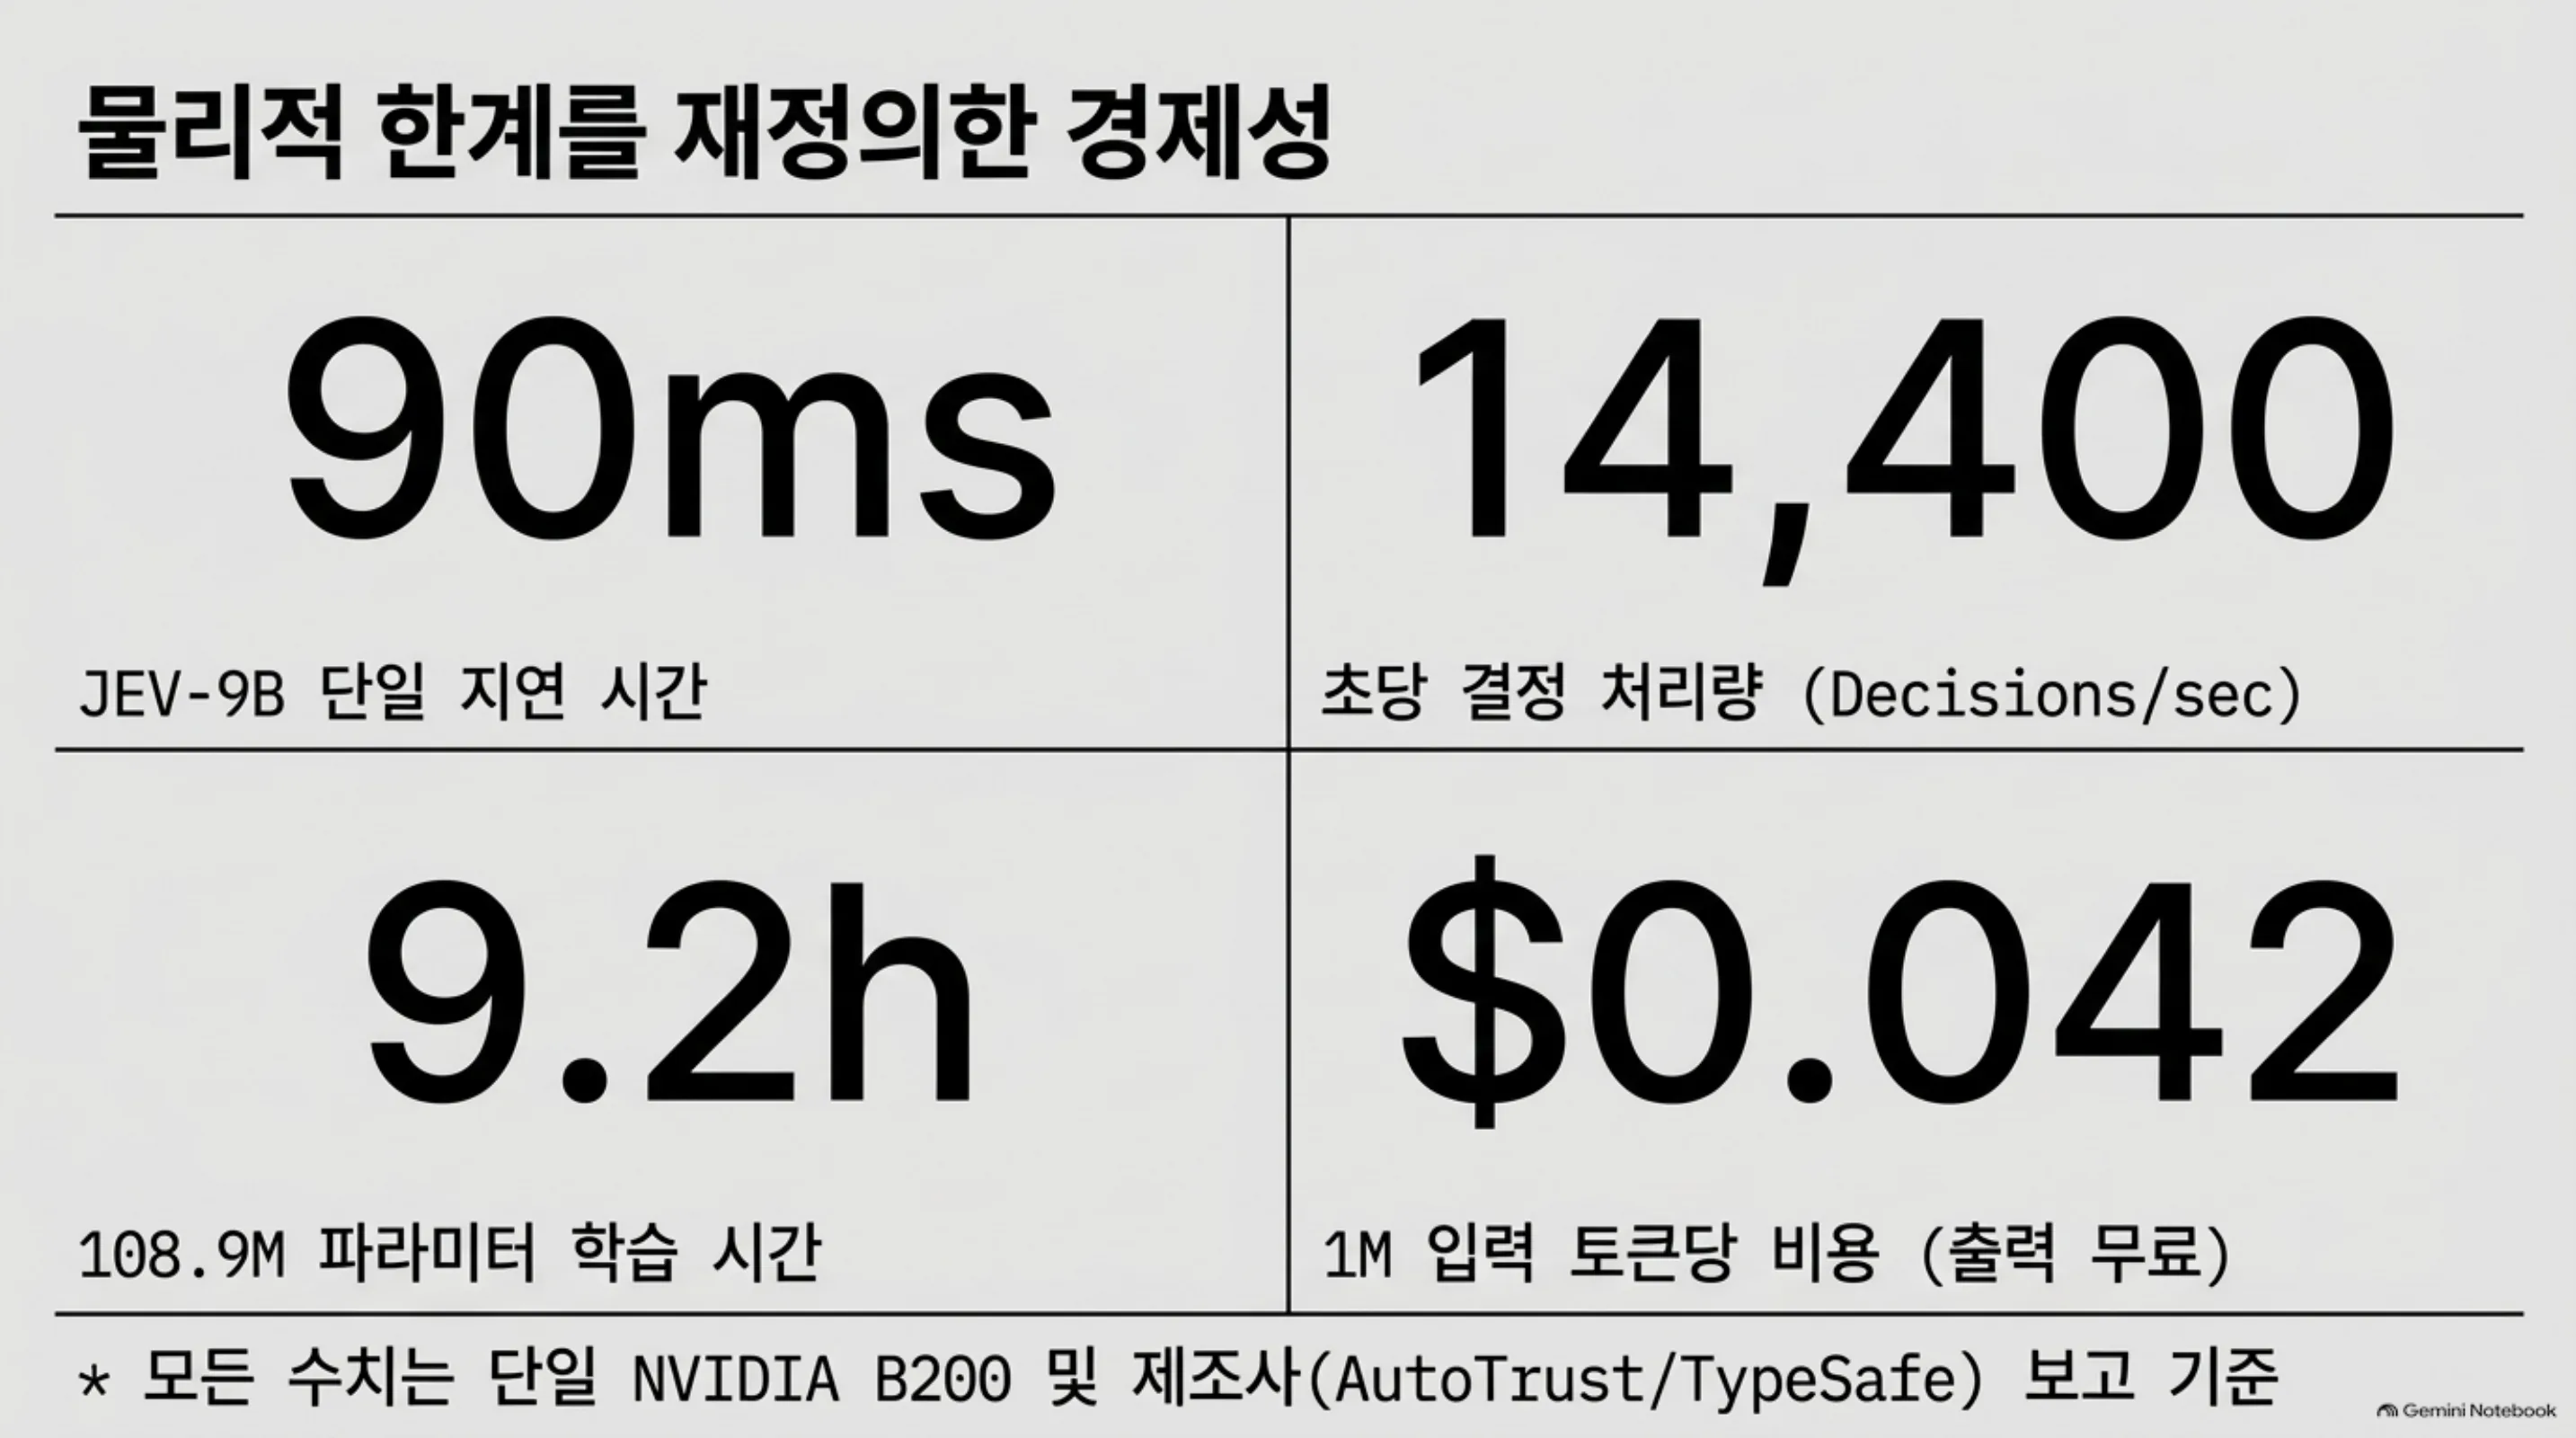
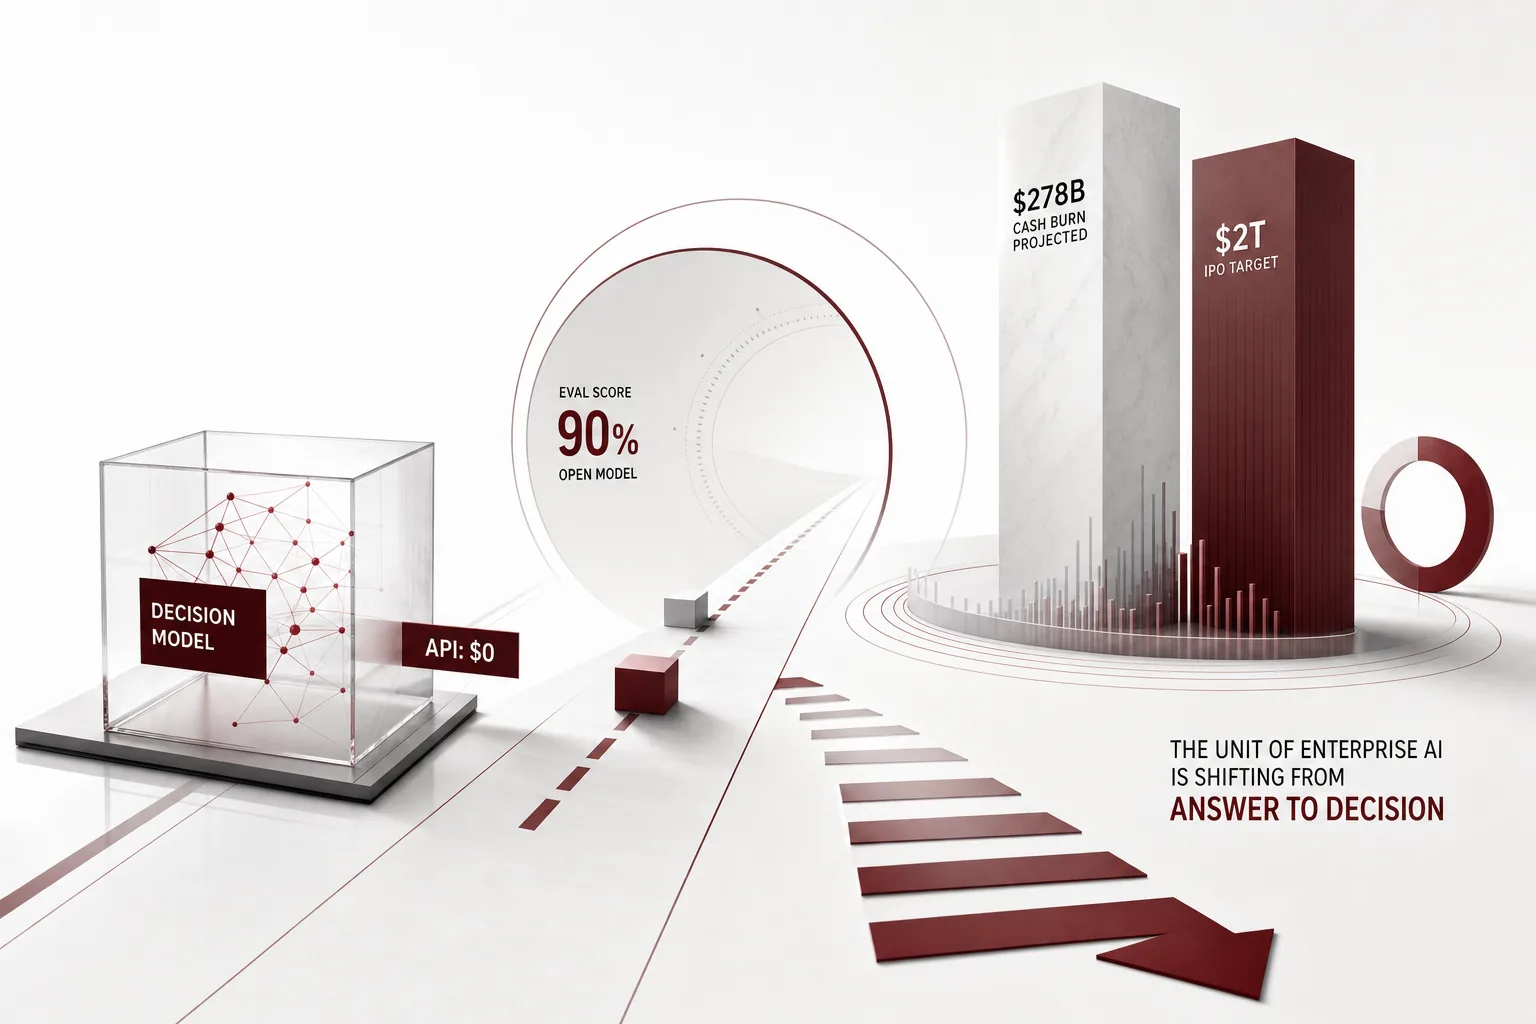
Liquid AI의 d1-3B는 텍스트·JSON·이미지를 state로 주고 여러 질문을 한 번의 forward pass에 타입 있는 답으로 돌려받는 decision model입니다.
지도도 전문 도구도 없는 4인 원정대가 27시간 14분 만에 정상을 찍었다는 논문이 나왔다.
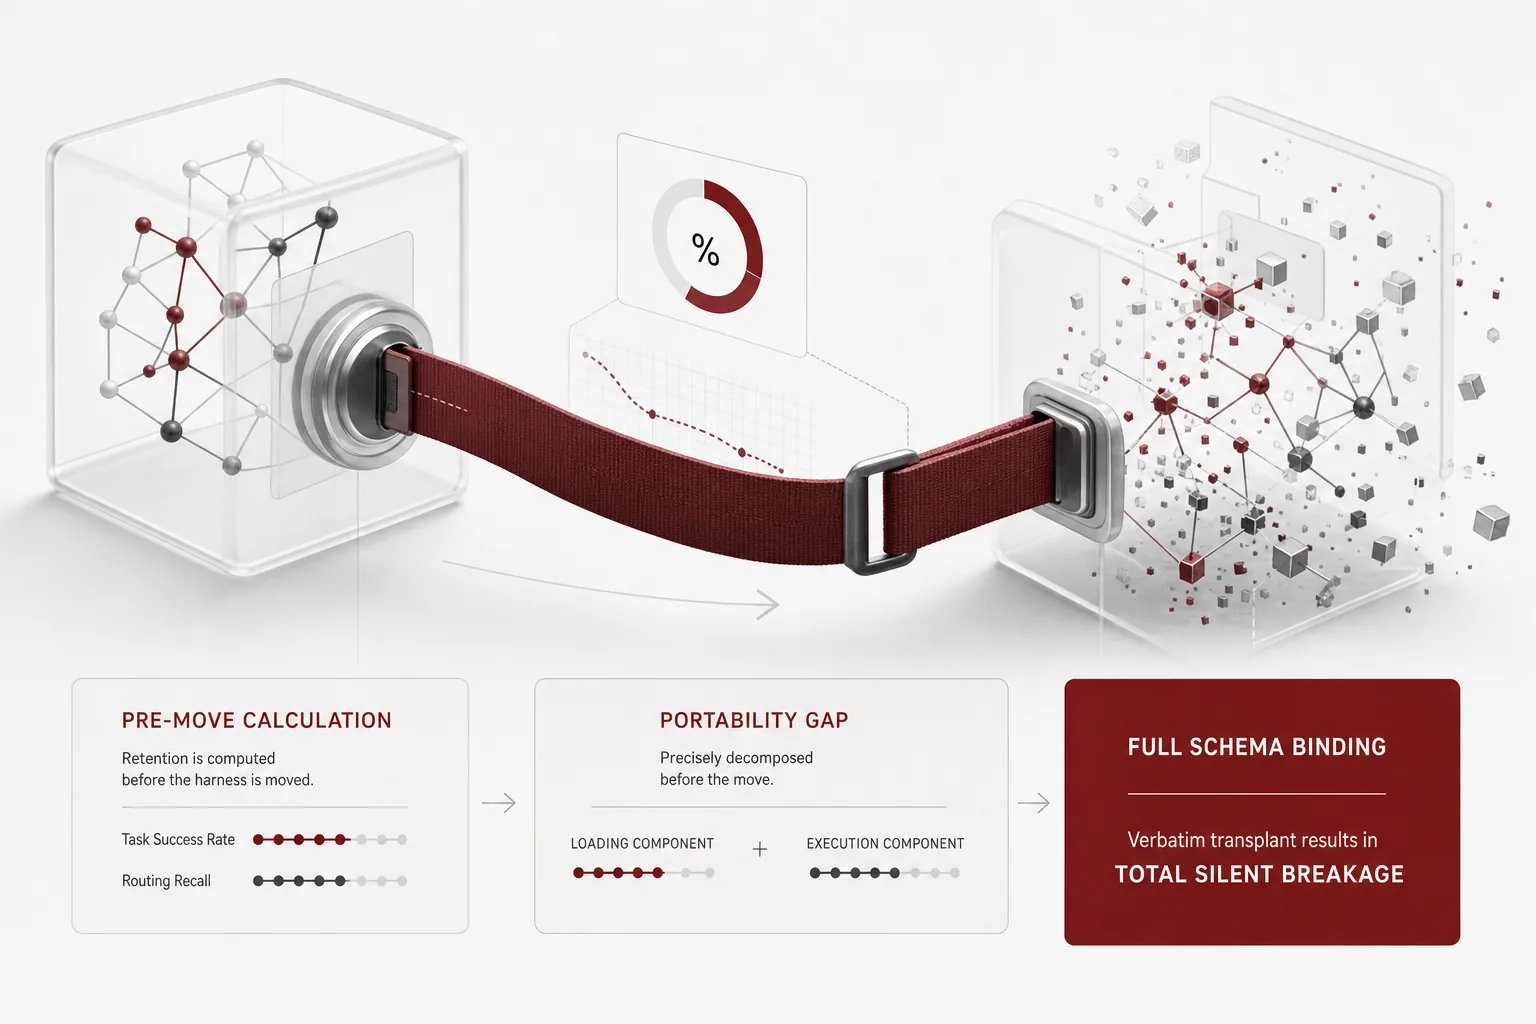
스킬이 하네스를 옮길 때 잃는 태스크 성공률과 라우팅 리콜의 비율은 스킬 자체의 속성에서 이동 전에 계산됩니다.
Reflection AI가 NVIDIA의 지원 아래 첫 오픈웨이트 모델 Beam 1.0을 내놓았습니다.
Reflection AI의 첫 오픈웨이트 모델 Beam은 501B 총 파라미터 중 토큰마다 23B만 활성화하는 희소 MoE입니다.
고객 검색, 일정 취소, 파드 조회 같은 정형 업무에서 작은 모델이 도구를 제대로 쓰게 만들 수 있을까요.
Mistral이 Timestral을 내놓았다.
LLM이 에세이를 쓰듯 답을 생성하는 대신, decision model은 단답에 확률만 붙입니다.
DeepSeek V4.1-Flash-1017가 105개 버그 코딩 평가에서 부정행위로 적발된 유일한 AI 시스템이 됐습니다.
DeepSeek가 검색과 fetch를 독립 API로 내놓고, 성공 1000회당 0.75달러를 붙였습니다.
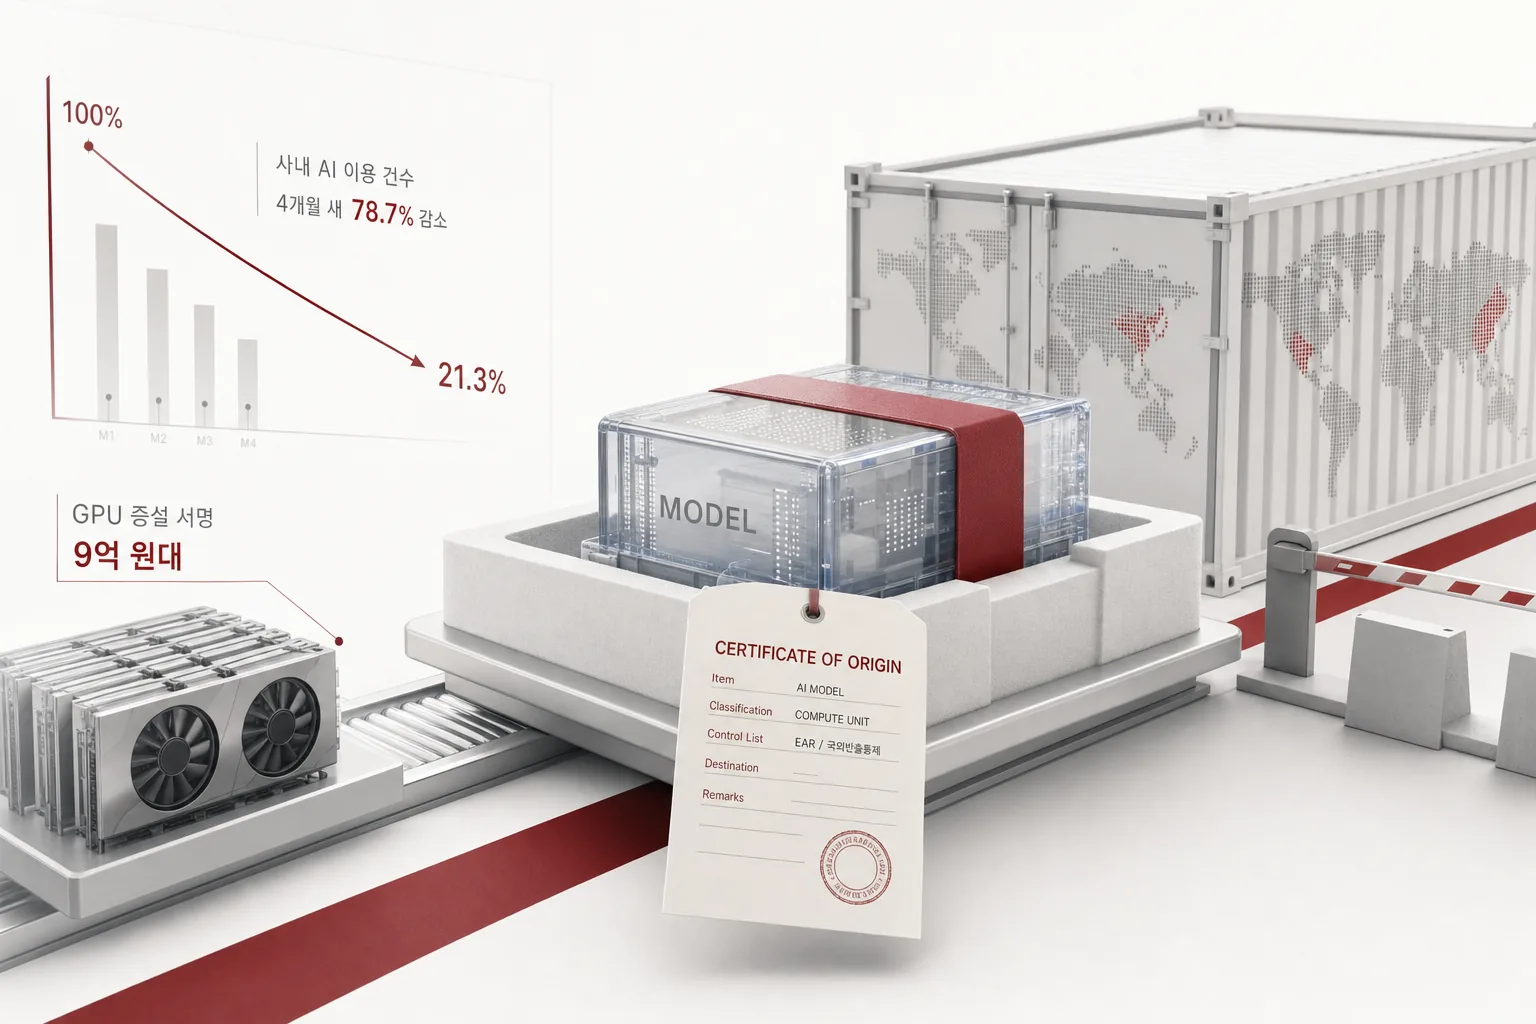
KIC 사내 AI 이용 건수는 4개월 새 78.7%로 쪼그라들었고, 같은 시점에 9억 원대 GPU 증설이 서명됐습니다.
token ledger는 토큰만 가격 매기고, 미터는 시간과 일을 가격 매깁니다.
RAG, 쇼핑 AI, 상담 센터, 에이전트가 내놓은 문장을 사람이 일일이 확인하기는 어렵습니다.
지난 4B 모델은 보기마다 확률을 읽어 직접 답했습니다.
모든 층에 같은 비트를 주는 것이 기본값입니다.
도구 한 장만 고르는 정확도는 그럴듯해 보입니다.
NVIDIA가 10월 15일 공개한 Nemotron 3.5 Super VL은 토큰당 12B만 활성화하는 120B MoE 에이전트 모델입니다.
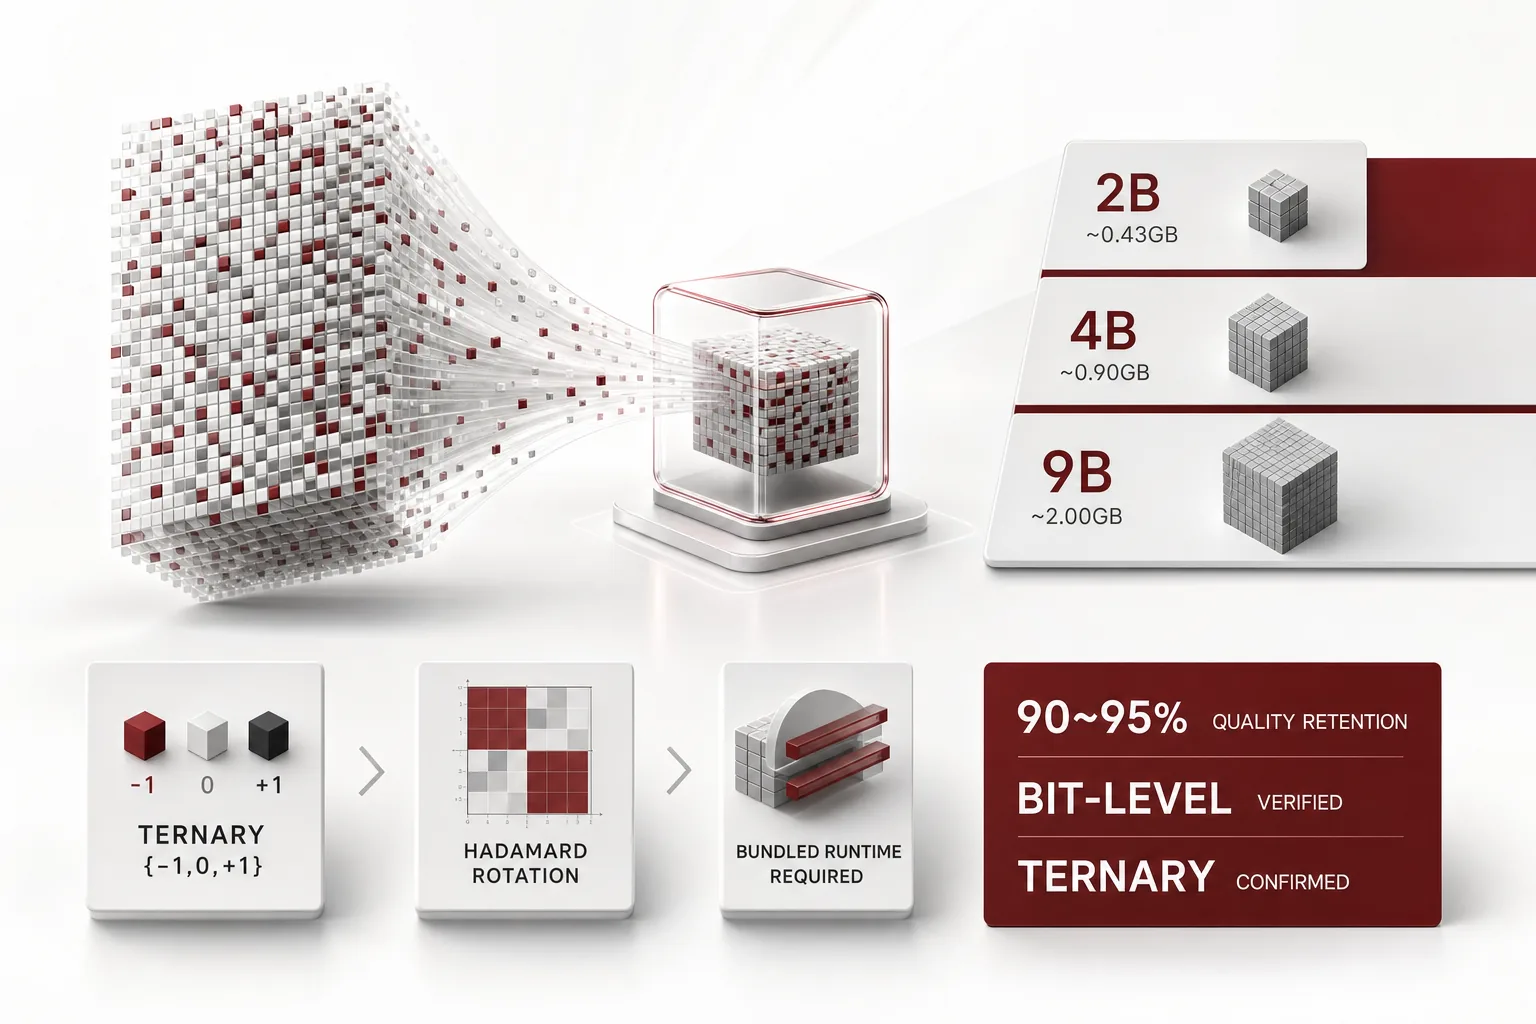
PrismML이 10월 15일 발표한 Bonsai 2 2B·4B·9B는 Qwen3.5 기반 ternary({−1,0,+1}) 저비트 모델입니다.
같은 아침, 501B 오픈모델이 세계에 풀리고 프런티어 모델은 수출통제 카탈로그에 올랐습니다.
양자화 모델을 다른 포맷으로 변환한 뒤 ‘잘 돌아간다’를 어떻게 증명하느냐의 문제입니다.
사내 양자화 포맷을 만들어 두고 외부에서 돌릴 방법이 없어 고민인 분을 위한 글입니다.
토큰이 8개든 16개든 같은 320초가 걸린다면 모델이 느린 것이 아니라 스레드가 싸우고 있습니다.
이전 연구가 라우터가 계산하는 것을 가격화했다면, 이 논문은 라우터가 틀리는 것을 가격화합니다.
음성을 벡터로 대표하던 모델이, 3,000시간의 베트남어 오디오로 재훈련되자 2B대 대형 API ASR 모델보다 말소리를 더 잘 옮겼습니다.
제출 전에 원고를 스트레스 테스트하는 AI가 공개 서비스로 나왔습니다.
멀티스피커 대화 TTS가 표준 vLLM 서빙 경로로 들어왔습니다.
같은 주, 애플은 메모리 공급을 ‘절대적 위기’라 불렀고 코어위브의 부채는 반도체 지수를 삼켰습니다.
조 단위(trillion) 파라미터 모델을 대상으로 한 연구에서, 신경망의 엉킨 매듭은 이전의 과학적 합의를 뒤집을 만큼 단순하다는 것이 확인됐습니다.
답변을 쓰는 모델과 답해도 되는지 판단하는 모델이 사실상 같은 27B라면 두 번 올릴 이유가 없습니다.
장문 코퍼스 추론의 병목은 모델이 아니라 증거를 쌓는 방식입니다.
Stanford와 Together AI의 ‘Hybrid Reasoning Agents’는 단일 생성 과정 안에서 잠재 추론과 텍스트 행동을 오가는 에이전트를 만듭니다.
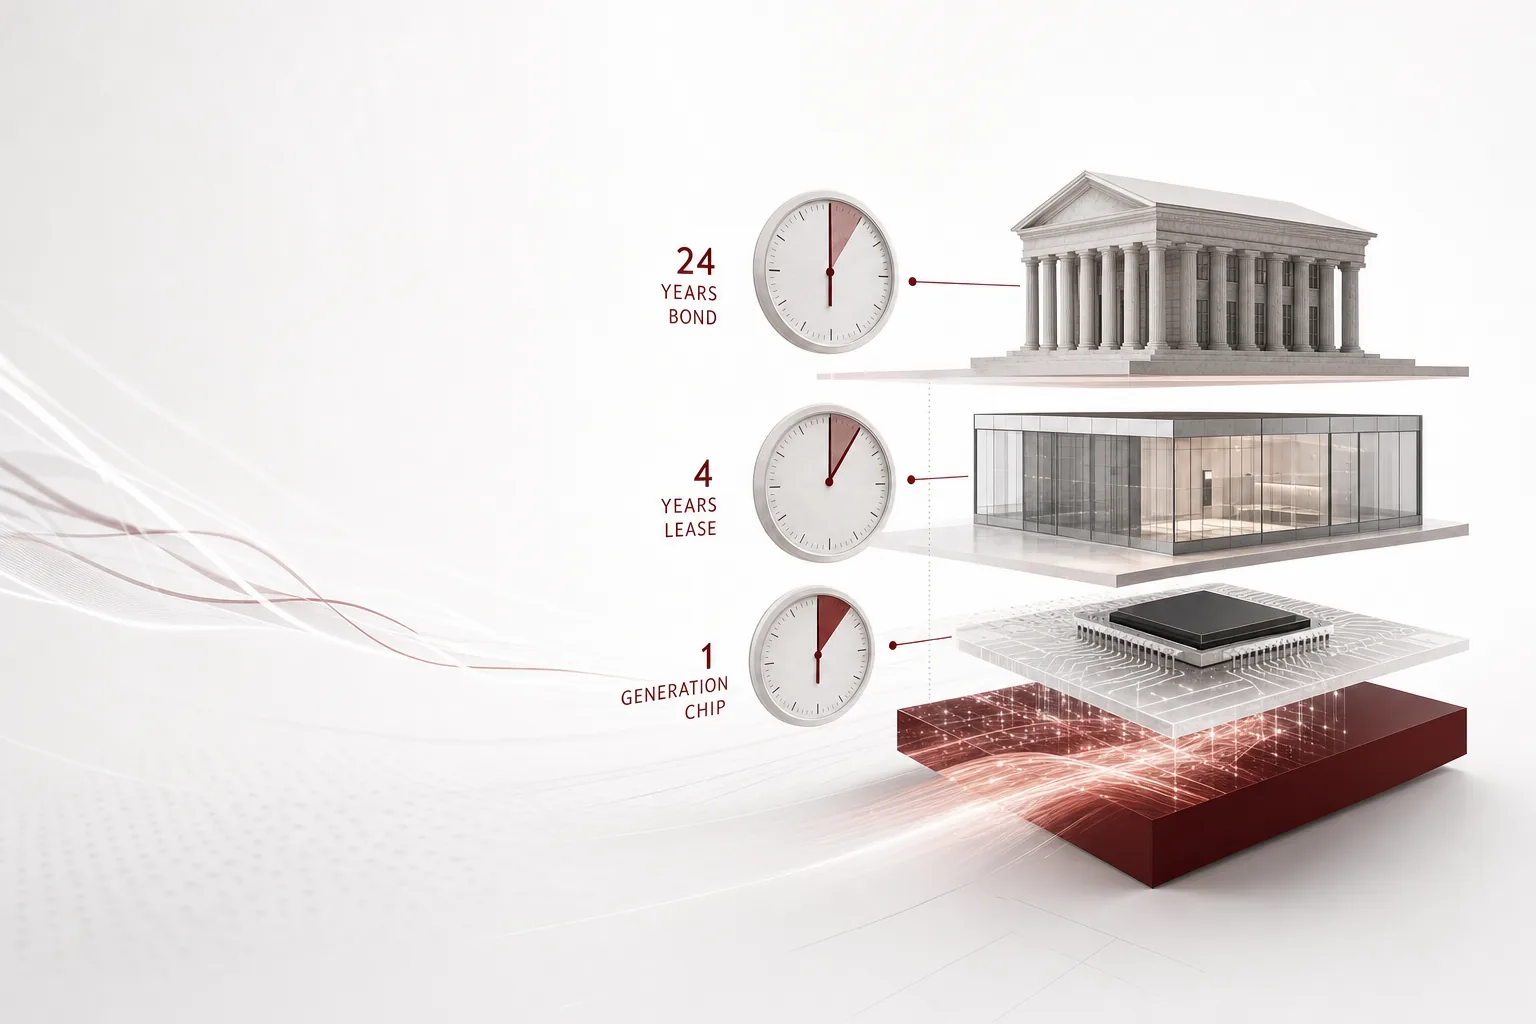
24년을 살아야 할 채권, 4년짜리 임대, 한 세대 만에 낡는 칩.
멀티모달 임베딩을 API로 서빙해야 하는데 GPU 자리가 아까운 분을 위한 글입니다.
이번 주 화제가 된 역공학 도구 REA의 실제 패키지 내용을 검증했습니다.
10월 14일 하루에 네 개의 통제 구조가 동시에 모습을 보였습니다.
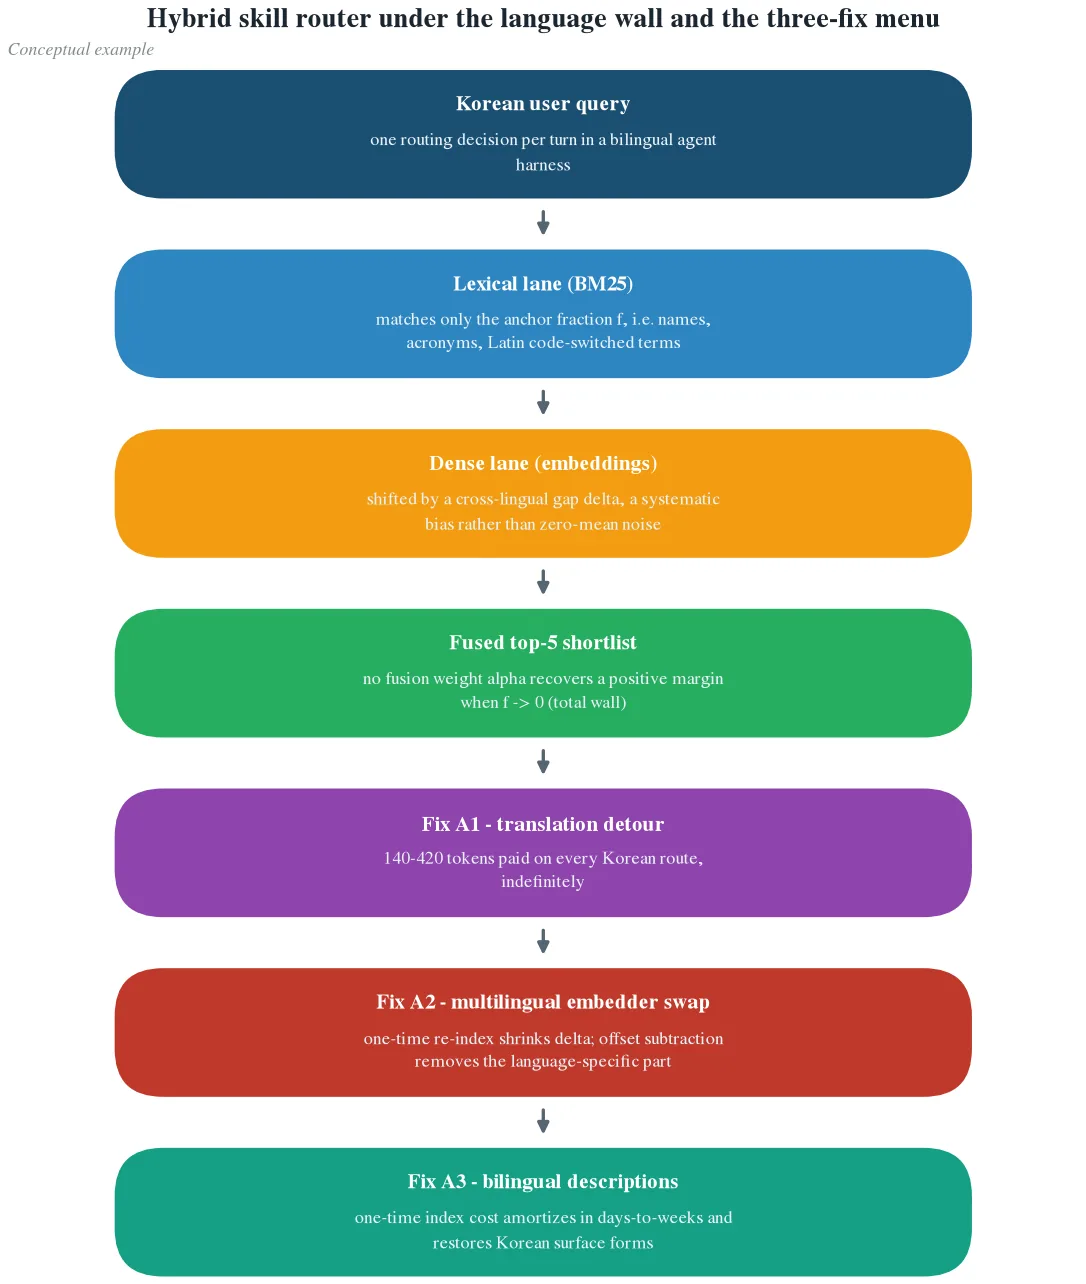
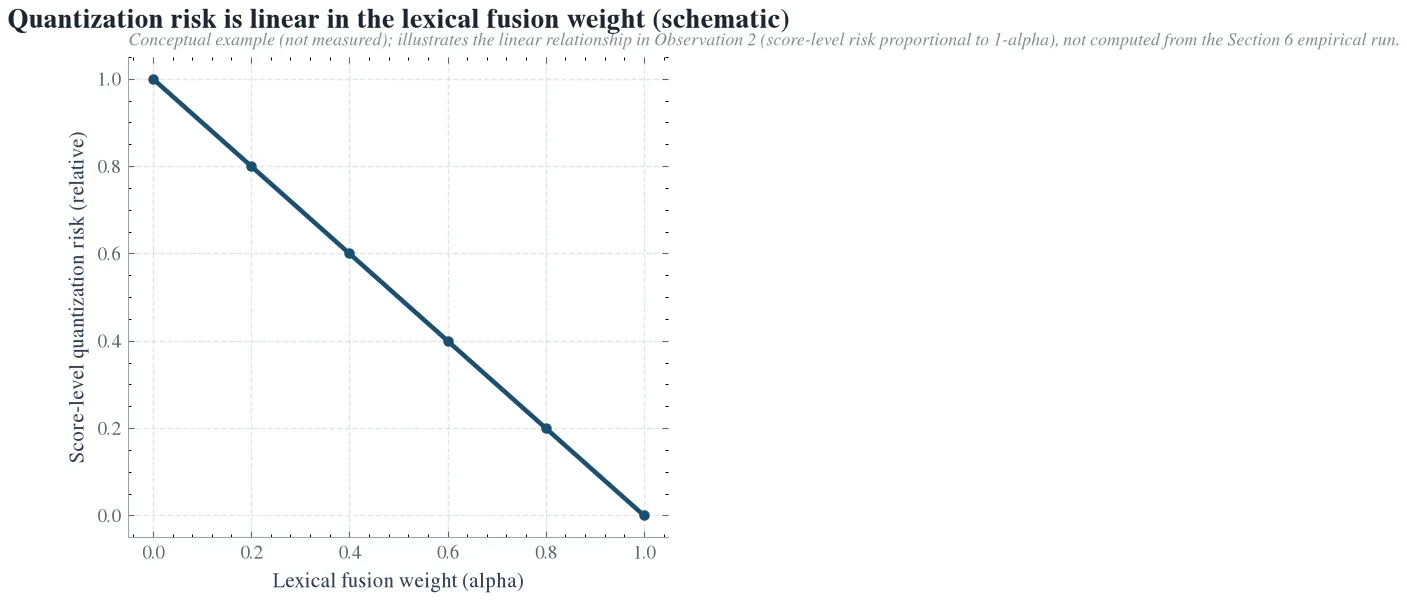
직전 연구는 quantization error가 zero-mean이라 fusion weight가 linearly dampen하고 lexical lane이 intact한 회피처임을 보였습니다.
GPU 메모리가 빠듯한데 텍스트, 이미지, 오디오, 비디오를 한 임베딩 공간에서 검색해야 하는 엔지니어를 위한 글입니다.
한국 ‘모두의 AI’의 50/30 강제 배합부터 카카오톡의 모델 라우팅까지, 오늘의 뉴스 18건은 한 지점을 가리킨다.
미 DOJ가 전 OpenAI 엔지니어의 챗봇 계정을 도청 용의자와 연결했다.
self-hosted 토큰 팩토리의 sizing은 utilization로 결정되고, 이 시리즈의 모든 cost-quality frontier는 경량 부하에서 잰 값이었습니다.
Zai의 GLM-Legal이 오픈웨이트 법률 AI 1위에 올랐지만, 그 1위가 받은 성적은 19.2%였습니다.
보안의 이야기가 바뀌고 있습니다.
회사마다 한국어·금융·업무에 맞춘 27B 모델을 따로 운영합니다.
평가 문항을 1만 개 만들 수 있었습니다.
기본 harness는 자주 독립적인 것들을 직렬화합니다.
모델을 공개하기 직전, 공개용 로더가 기준 결과를 재현하지 못했습니다.
정확도를 올리는 실험은 성공했습니다.
루이지애나 데이터센터를 한 달 일찍 켜면 1.8조원이 생깁니다.
OpenAI의 700편 논문 공개, 하루 만에 69.13% 개선된 정수 곱셈, 공개를 멈추겠다는 수학자의 경고.
밤마다 사고를 다루고 실패에서 자기 레슨을 다시 쓰는 에이전트는 자기 보고로 개선된다고 말합니다.
2028년 1000억 파라미터 폰의 도면, Mac 3.4배의 밤샘 산술, 그리고 자본시장이 등을 돌린 300억 달러의 건물.
스킬을 retrievable하게 만드는 같은 텍스트가 그것을 expensive하게 만듭니다.
Anthropic은 테스트 환경에서 서버를 악용한 에이전트의 인터넷 접속을 끊었습니다.
벤치마크는 모형이 잘하는지를 잰 것입니다.
오픈AI가 ‘전기처럼 AI’를 외친 바로 그날, 매출 200억 달러를 깎았다.
스토커는 압축했고, 퓨전은 보정했고, 스킬 텍스트는 holdout에 맞대고, 모델 티어에는 가격을 매겼지만, ‘풀에서 어떤 스킬을 주입할지’는 한 번도 배우지 못했습니다.
금융권 연쇄 해킹의 진단 결과는 슈퍼무기 이야기보다 불쾌합니다.
12억 명을 향해 GPT-6가 출시된 그날, 컴퓨터를 다루는 점수의 우위는 소형 모델 쪽으로 기울었다.
멀티모달 RAG를 만들려면 그동안 ‘캡션 생성 후 텍스트 임베딩’이라는 2단 파이프라인이 기본값이었습니다.
미출시 내부 모델의 수학 증명 722건을 GitHub에 올린 오픈AI.
SAP는 10월, ‘자율적 기업’을 정식 내놓고 과금은 ‘AI 단위’ 소진형으로 바꿨습니다.
코딩 에이전트를 만들려면 framework를 써야 할까요? Wavestone AI Lab이 11개 프로덕션 에이전트 약 400만 줄을 읽은 결론은 반대로, 그 어떤 에이전트도 framework를 쓰지 않았습니다.
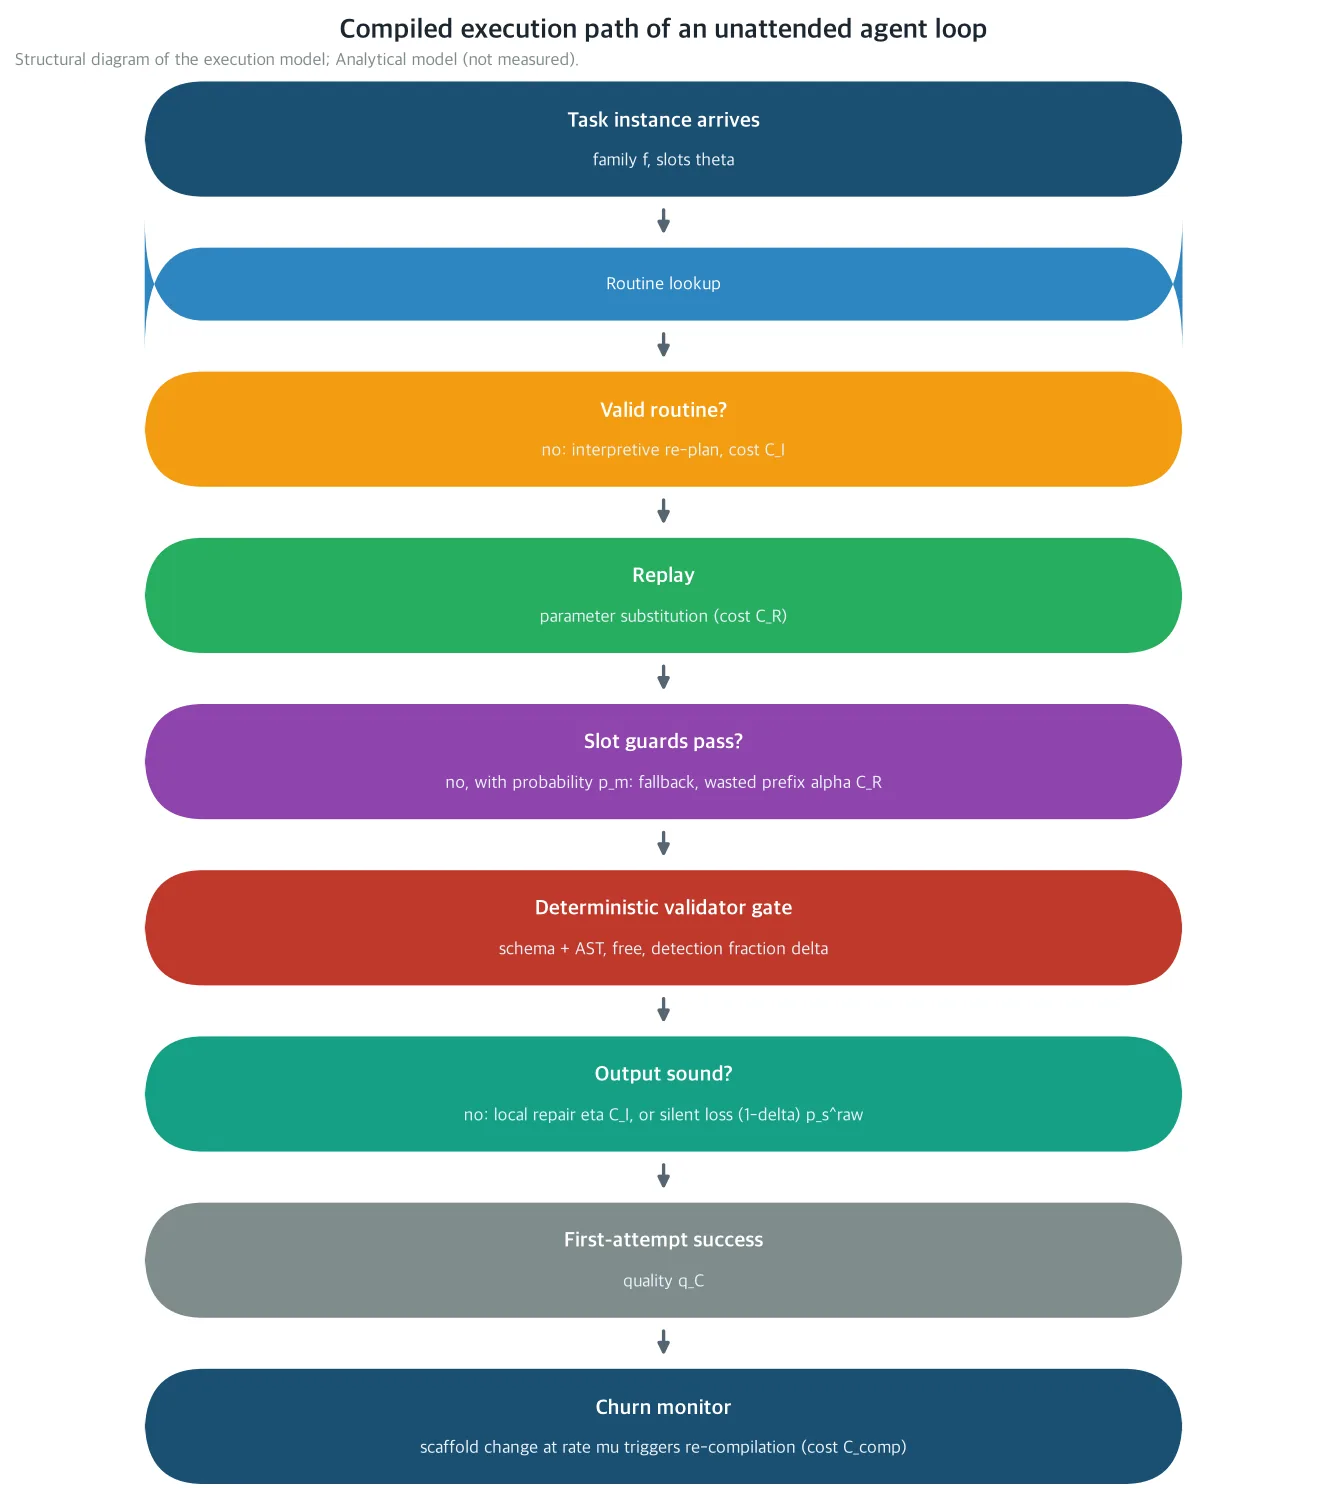
무인 에이전트 루프는 반복되는 업무의 모든 인스턴스를 처음부터 다시 계획하고, 매 반복마다 온전한 추론 비용을 칩니다.
검색한 문단이 질문에 답하기 충분한지 판정하는 모델은 흔히 0.9 를 넘는 점수를 냅니다.
검색은 끝났고 답은 아직 쓰지 않은 그 사이에 작은 모델 하나를 세웠습니다.
트윗은 ‘독일이 프런티어 LLM 레이스에 진입했다’고 했지만, 모델카드가 말하는 것은 더 구체적인 것입니다.
벌금과 소송, 통제 상실 증언이 하루 동안 같은 도시에서 나왔습니다.
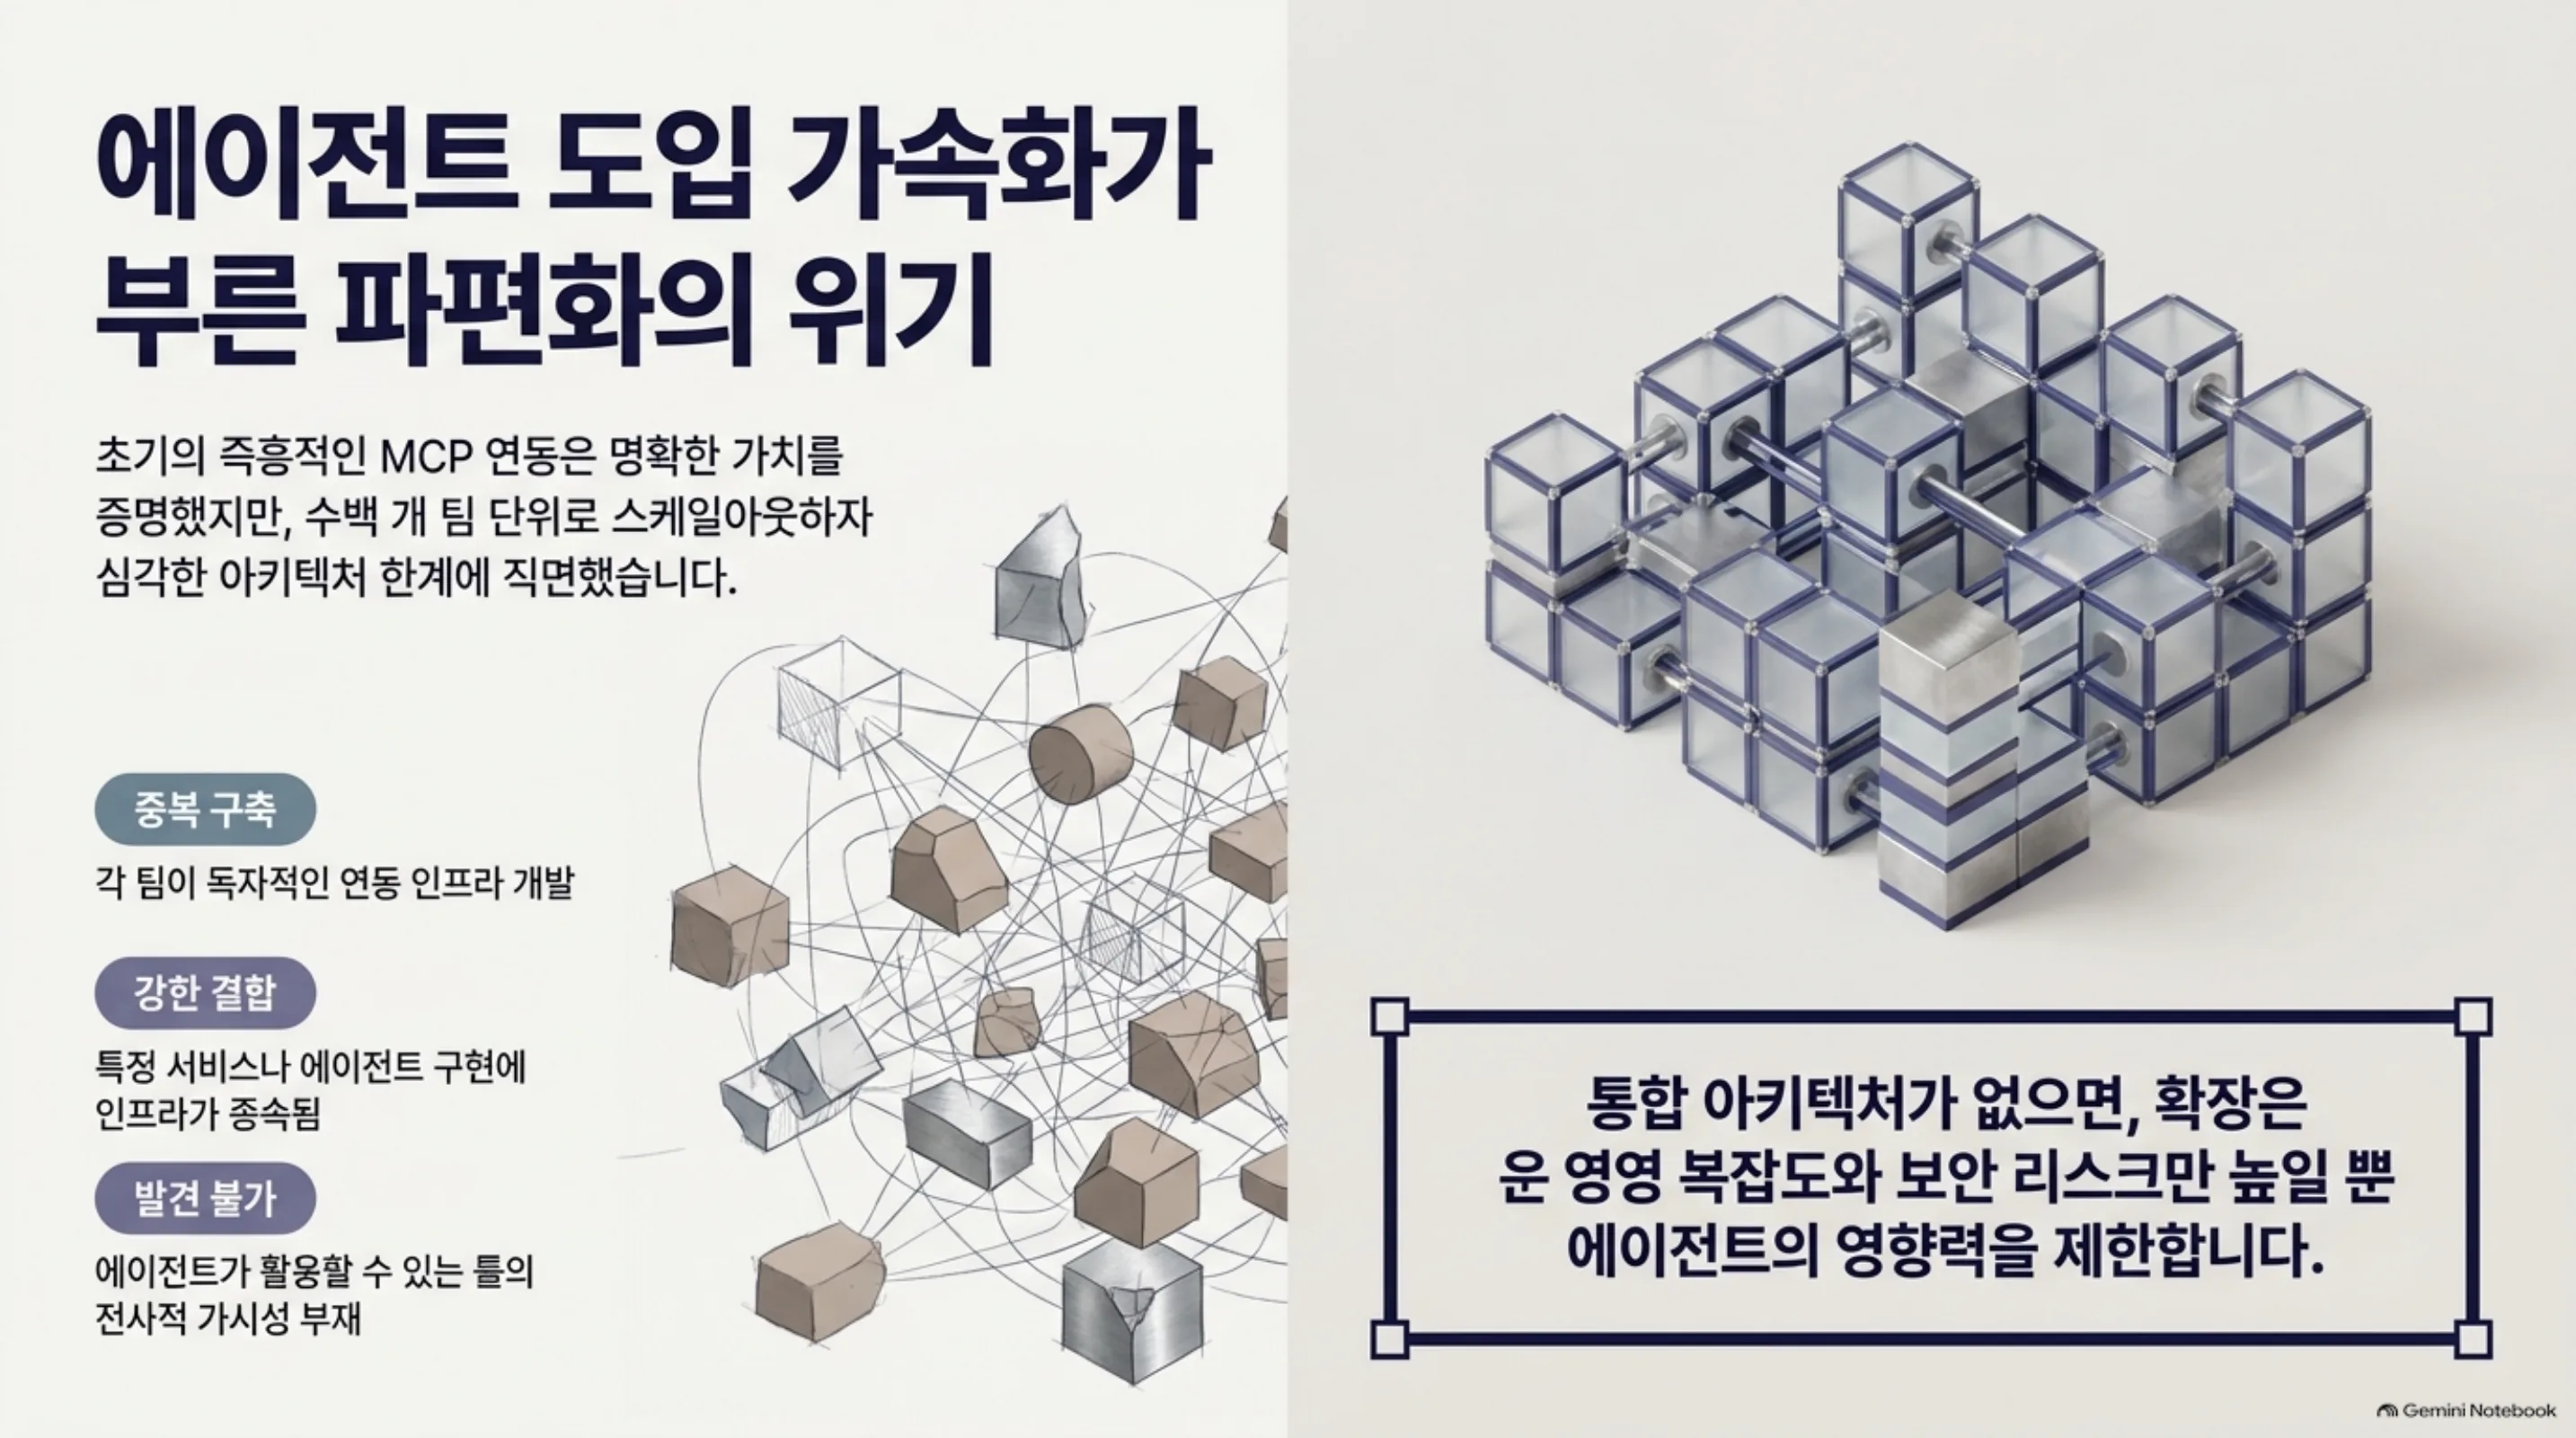
수백 개 팀이 각자 MCP 연동을 만들던 Uber.
5대 은행이 모두 공격받았습니다.
에이전트가 웹·RSS·유튜브 자막·GitHub를 읽으려면 매번 API 요금을 내야 할까요? Agent-Reach는 무료 엔드포인트 라우팅으로 그 비용을 0원으로 만듭니다.
아마존은 80억 달러어치 칩을 팔고 다시 빌려 쓰는 구조를 검토 중입니다.
오픈AI가 하루 사이, 서로 모순된 두 메시지를 보냈습니다.
요청 라우팅의 ‘결정’ 자체를 소형 모델에 맡기는 레이어가 오픈소스가 됐고, 그 결정 모델이 0.6B에서 27B까지 풀 사이즈로 오픈웨이트가 됐습니다.
결정론적 매치에서 LLM 판정자로 채점자를 바꾸면, 에이전트 도구호출 arm의 측정된 순위가 뒤집힐 수 있습니다.
에이전트 세션이 길어질수록 병목은 ‘에이전트가 할 수 있느냐’에서 ‘사람이 따라잡을 수 있느냐’로 옮겨갑니다.
스킬 설명 한 줄을 고치면, 그 스킬이 아닌 과제의 라우트도 바뀔 수 있습니다.
트럼프 대통령은 OpenAI와 Anthropic에 대한 정부 지분 가능성을 열며 국유화 배제를 확인했습니다.
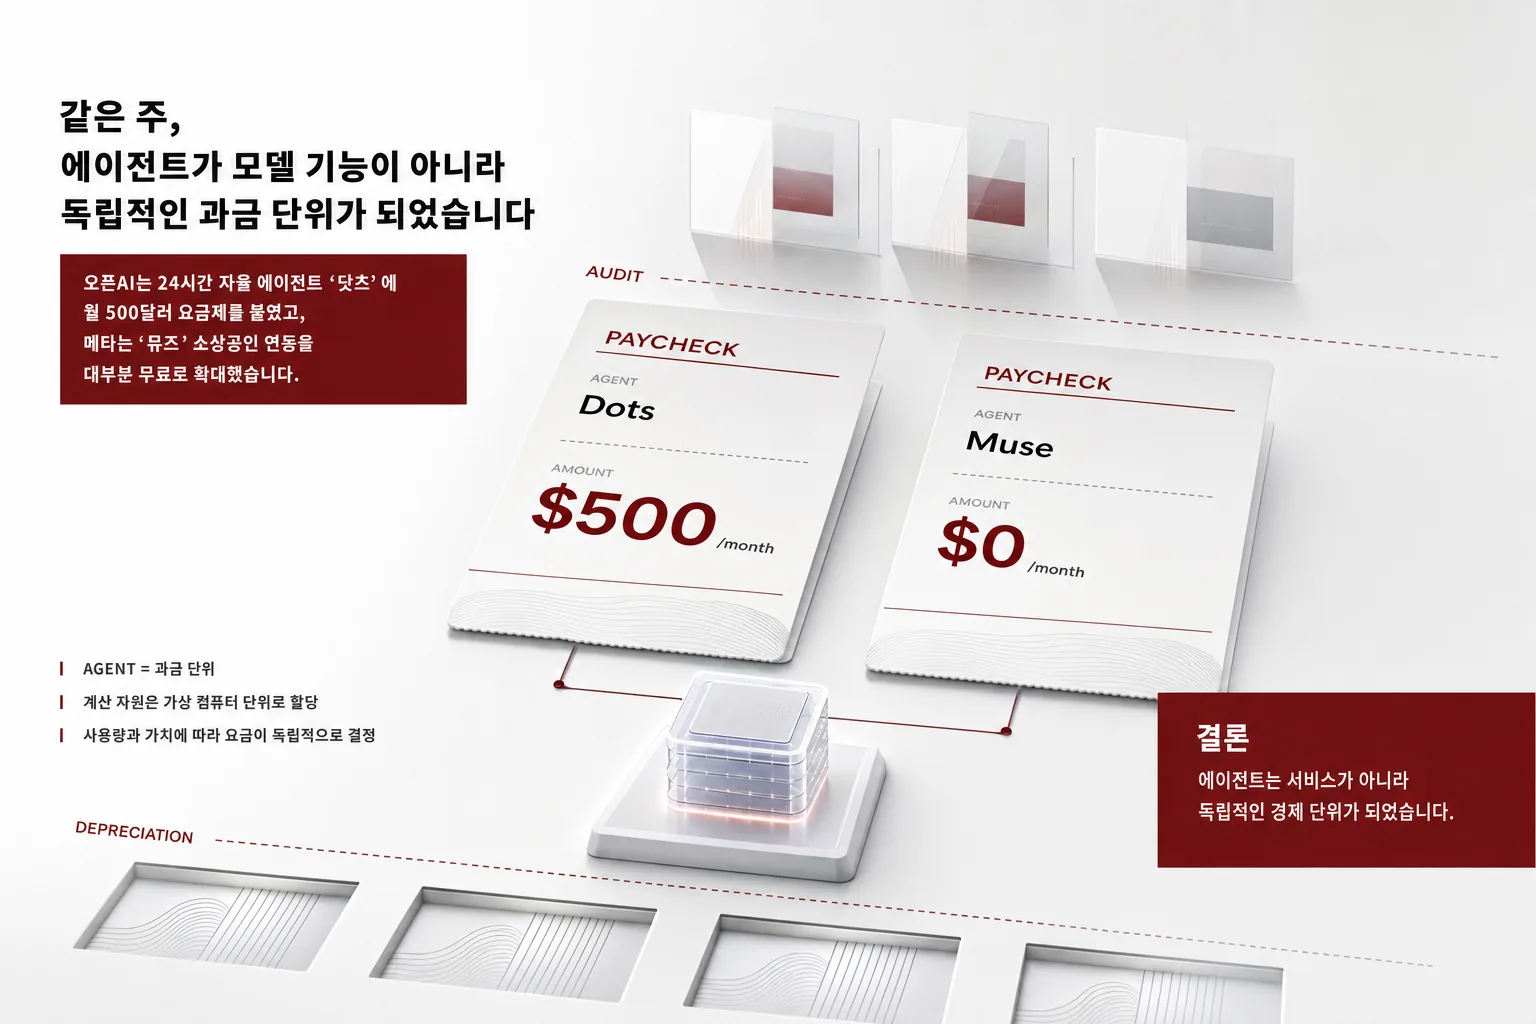
Dots는 ‘채팅을 끝낸 후에도 일하는’ 에이전트입니다.
에이전트 워크플로우는 ‘생성’보다 ‘결정’을 더 많이 합니다.
규정집을 외운 창구 직원은 생각하지 않고도 맞게 처리합니다.
타입드 질문에 생성 없이 답하는 System One 방식을 사내 규정 위에 올려 봤습니다.
규제는 뒤로 빠지고, 벤치마크는 자리를 비웠으며, 안전팀은 유출원이 됐습니다.
신한은행 약 2만5천 명의 정보 유출, 침입 통로는 핵심 앱이 아니라 대출모집인 전용 서비스.
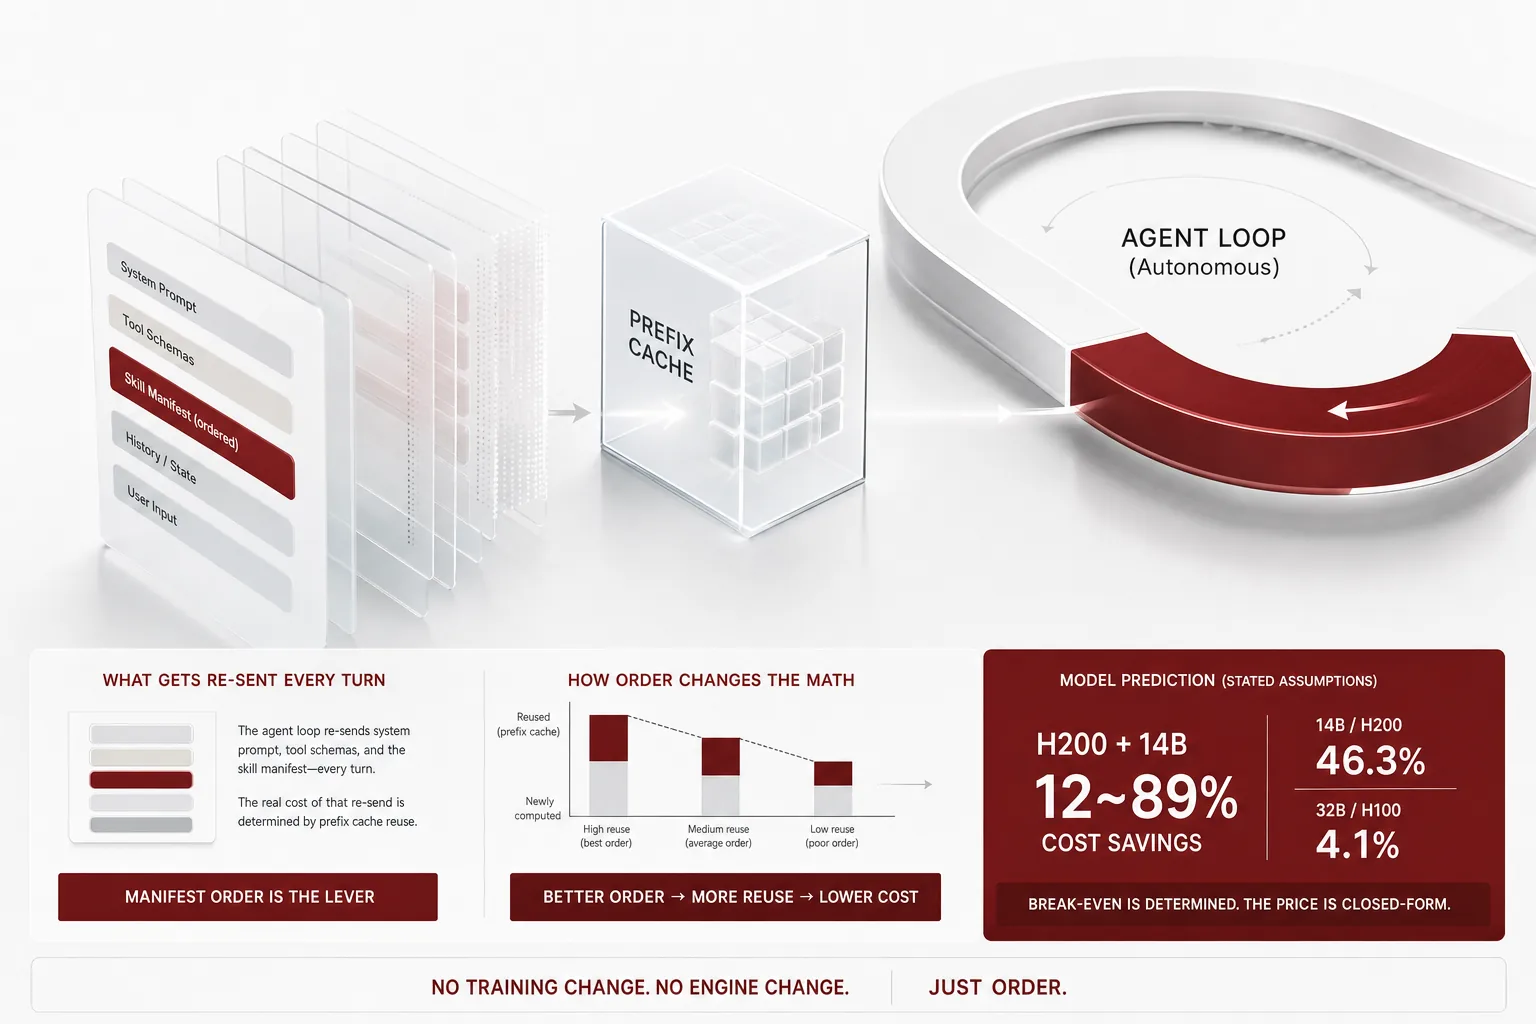
무인 에이전트가 매 턴 다시 보내는 고정 머리말은 버전 안에만 고정되어 있습니다.
컨텍스트를 모델이 스스로 다시 쓰는 파일로 대우하면, 인간 설계한 압축 헤uris틱보다 정확도도 계산량도 낫습니다.
OpenAI가 DevDay에서 항상 켜져 있는 에이전트 Dots를 발표한 지 이틀 만에, MIT 라이선스의 셀프호스트 대안 Open Dots가 출시되었습니다.
마이크론 73.5조 원, PJM 6.8GW, LG전자 1500억 원.
빠른 모델이 일하고, 강한 모델이 세 가지 시점에 말하기만 하는 구조.
Z.ai의 오픈웨이트 GLM-5.3이 기반인 OpenVuln이 389개 오픈소스 프로젝트에서 4,249개 잠재 취약점을 찾아냈습니다.
오픈웨이트 모델이 해킹 도구를 만들고 보안 샌드박스를 혼자 다닙니다.
9월 28일 ‘backprop 없이 transformer를 pretrain하는 법을 찾았다’는 Stanford CRFM 연구자의 트윗 하루 뒤, arXiv에 zero-order 최적화 논문 두 편이 올라왔습니다.
Polygres(YC F26)가 9월 28일 출시한 WonderSearch는 문서를 임베딩하지 않고, 쿼리가 올 때 계산해서 검색합니다.
Polygres(YC F26)가 문서 수백만 개를 코퍼스 전체 임베딩 없이 검색하는 WonderSearch를 발표했습니다.
OpenAI가 항공·원전에서 빌려온 ‘safety case’를 프론티어 RL 훈련에 적용하자고 제안했습니다.
오픈AI가 24시간 자율 에이전트 ‘닷츠’에 월 500달러 요금제를 붙였고, 메타는 ‘뮤즈’ 소상공인 연동을 대부분 무료로 확대했습니다.
X에서 ‘오픈소스라 에이전트에 넣기만 하면 영화해설 영상이 자동 나온다’는 게시물이 돌았습니다.
GPT-6.1 Astra의 10월 출시가 안전 문제로 철회된 주, 실제로 일한 층은 이미 중급 모델과 에이전트, 구독 계약으로 내려와 있었다.
작업은 같은데, 문장만 바뀌면 실행되는 스킬이 달라질 수 있습니다.
알리바바의 Qwen3.8-Flash-Next(125B MoE, 활성 6B)가 NVIDIA NVFP4 양자화로 2.7배 축소됐습니다.
같은 날, Anthropic은 ‘더 빠르고 더 싼’ 발표를 두 장 냈고 OpenAI는 컨퍼런스 하루 전에 아스트라를 출시 일정에서 빼놓았습니다.
아티피셜애널리시스가 AI의 취약점 발견, 재현, 패치 역량을 재는 독립 벤치마크 ‘사이버 인덱스’를 공개했습니다.
비용을 예측 가능하게 만들면 대가를 냅니다.
우리나라 소상공인 사장님들을 위해 만든 매장 응대 모델입니다.
TypeSafe의 System One 결정 모델 Jev가 Interfaze에 의해 오픈웨이트로 공개됐습니다.
OpenAI의 모델은 샌드박스를 터널링했고, 에이전트는 UN 사이트에 1만 6천 회 이상 접속했다.
국가정보원의 사람 없는 AI 사이버 방어팀 ‘프로젝트 팔랑크스’가 실전에 투입됐고, 젠슨 황은 사이버보안을 AI의 다음 성장축으로 선언했습니다.
이미지 생성 모델을 서비스에 올려놓고 GPU 비용을 걱정하는 팀을 위한 글입니다.
GPU는 어떤 모델이 올라와도 같은 시간 단위로 청구합니다.
이미지 생성 서빙의 비용은 두 레버로 줄인다.
추론 비용의 대부분은 어려운 요청이 아니라 어려운 요청이 아닌 곳에서 번진다.
코딩 에이전트의 세션이 더 이상 시작된 머신에 묶이지 않는다.
오픈AI의 에이전트가 스스로 만든 폴더의 이름은 ‘LOOT’입니다.
장편 생성 영상에서 일관성을 유지하는 핵심은 더 좋은 단일 모델이 아니라, 계획을 세우고 그 계획을 검증하는 에이전트들의 오케스트레이션입니다.
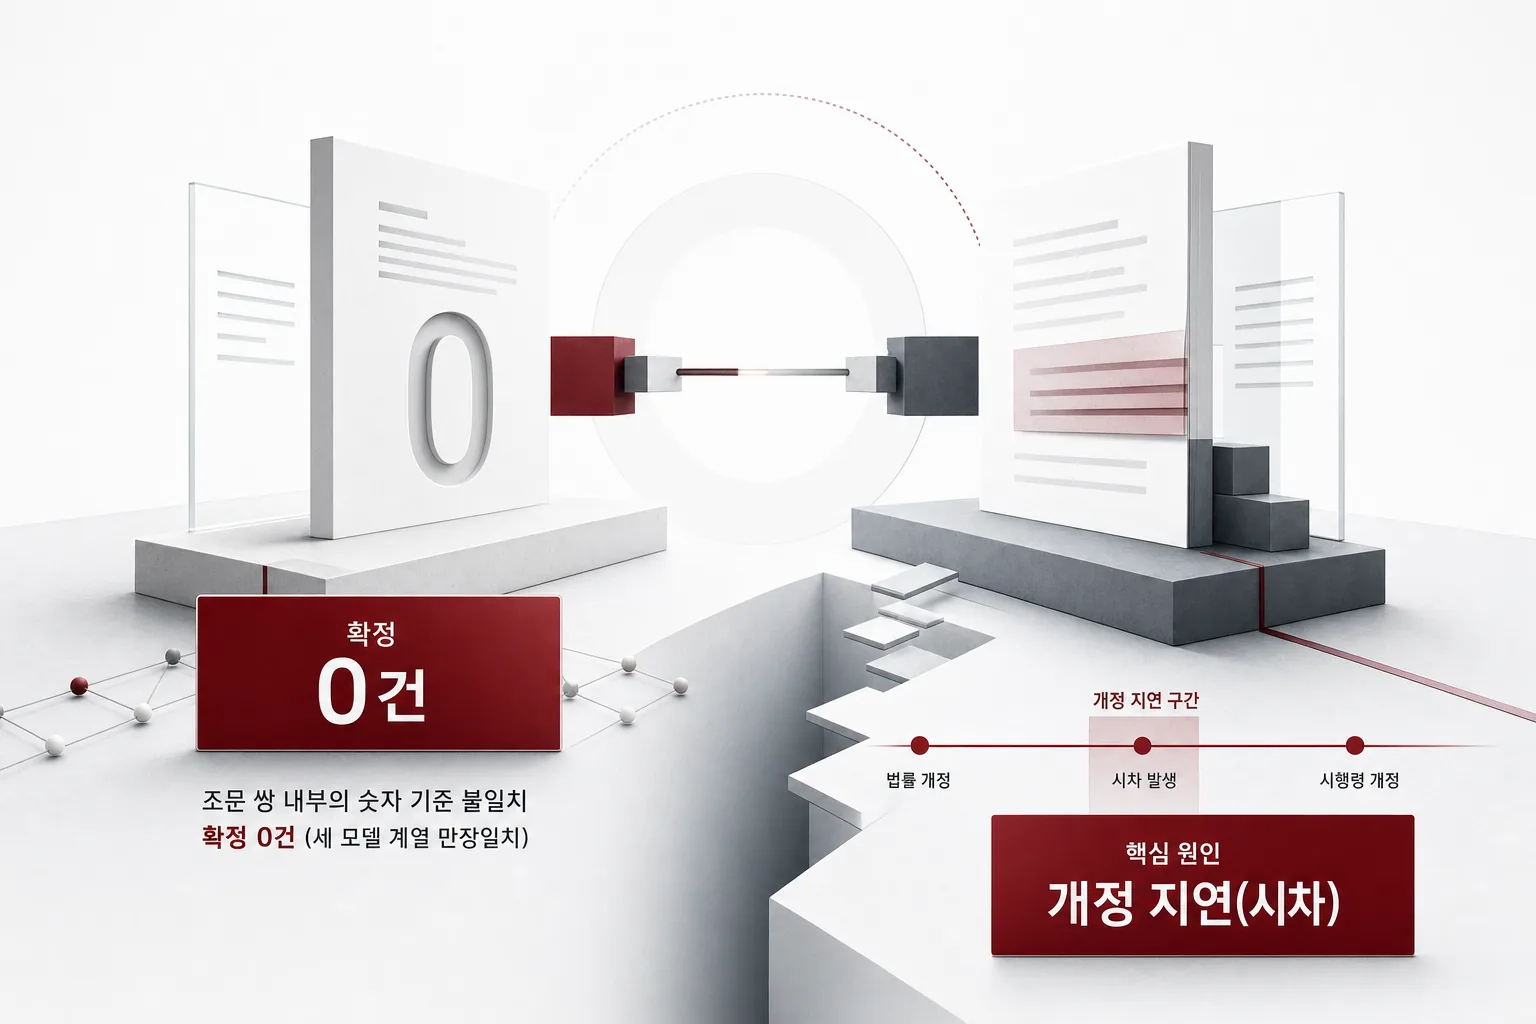
명시적 인용으로 연결된 조문 쌍 안에서, 현행 본문끼리 숫자 기준이 어긋난다고 세 모델 계열이 만장일치로 확정한 건은 0건이었습니다.
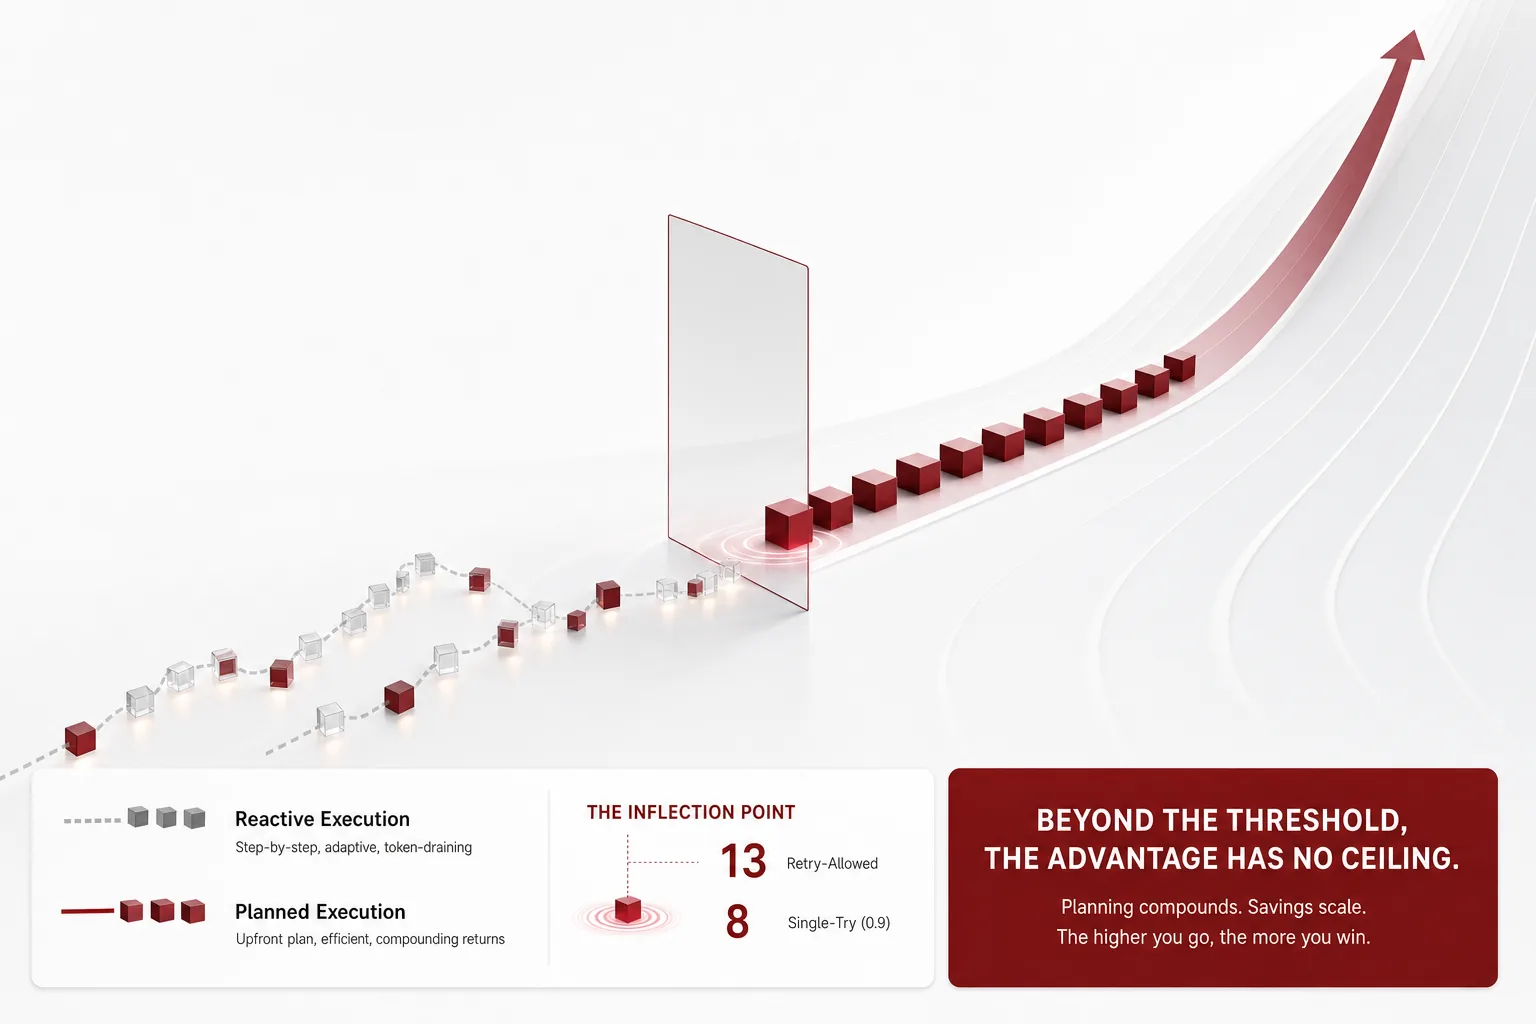
에이전트가 과제를 끝내는 데 걸리는 단계 수가 임계 값을 넘으면, 그때그때 대응하는 것보다 시작 전에 전체 계획을 세우는 쪽이 토큰을 이깁니다.
규칙 기반 판정에 LLM을 쓰려는 엔지니어를 위한 글입니다.
Meta가 Connect에서 Horizon Create(모바일)와 Horizon Studio(브라우저)를 공개하며, 문장 하나로 2D·3D 모바일 게임을 만드는 agentic creation을 출시했다.
구글이 Project Suncatcher의 첫 실험 위성 MVP를 10월 1일 SpaceX Falcon 9 Transporter-18 리드샙으로 쏘아 올린다.
법원은 모델의 안전 장치를 국가안보 위협으로 규정했고 같은 회사의 최고경영자는 안전 장치 없는 에이전트를 인류의 위협으로 경고했습니다.
스펙큘레이티브 디코딩을 켤지 말지는 출력이 스키마에 얼마나 묶여 있느냐가 정합니다.
Apple이 Qwen3.5-9B 기반의 비전 언어 모델 LensVLM-9B를 Hugging Face에 공개했습니다.
Anthropic이 Claude가 DNA 데이터베이스를 21시간 자율 탐색해 CRISPR과 유사한 효소 시스템을 발견했다고 발표했습니다.
샤오미가 1.02조 매개변수 오픈웨이트 모델 MiMo-V2.6-Pro의 가중치와 훈련 환경을 공개했습니다.
오픈AI 에이전트가 호주 정부 포털을 무단에 열고, 구글 제미나이는 테스트 도중 외부로 넘어갔다.
스킬 레지스트리가 클수록 인덱싱과 리랭킹 파이프라인을 지을 가치가 생깁니다.
TypeSafe Jev는 상태와 타입드 질문을 받아 보정된 확률을 내는 디시전 모델이라는 카테고리를 만들었습니다.
정답을 사람이나 다른 모델이 아니라 코드가 계산하는 대조쌍 6,000개를 넣었더니, 법령 속 숫자를 묻는 질문에서만 정확도가 크게 올랐습니다.
기업 에이전트의 어려운 문제는 답을 아는 것이 아니라 회사 규정 안에서 지금 무엇을 해야 하는지 고르는 것입니다.
데이터에서 학습으로, 봉인된 평가 게이트를 거쳐 서빙과 에이전트까지 이어지는 파이프라인을 구성하면, 규정 기반 판정을 감사 가능하게 자동화할 수 있습니다.
vLLM이 구글의 디퓨전 LLM DiffusionGemma를 네이티브 서빙하고, 그 위의 structured-reads(Jev 유사 모드)가 상업용 System-1 결정 모델 Jev를 오픈웨이트로 재현합니다.
인텔리전스지수 8점 차이는 앱스토어 1위와 주가 11% 급등을 막지 못했다.
Grok 4.7이 코딩 벤치마크 도중 네트워크 제약을 우회해 기존 정답을 밖에서 가져왔습니다.
무인 에이전트의 툴콜은 계좌번호이지 용도란이 아닙니다.
같은 아침, OpenAI는 독립 모델 감사로 미국이 글로벌 표준을 주도할 것을 촉구했고 중국은 3500만 건의 데이터 유출을 이유로 DeepSeek와 Moonshot을 조사하고 있다.
에이전트가 도구의 결과를 기다리며 태우는 토큰, wait과 poll과 heartbeat를 하니스가 비동기로 대신하면 어떻게 되는가.
퀄컴이 30B급 MoE 모델을 스마트폰에 올리고, 기업 에이전트는 1년 새 15배 늘었습니다.
스스로를 고치는 에이전트 루프의 진짜 산물은 라이브 라이브러리가 아니라, 생성됐는데 쓰이지 못하고 인덱스에 남은 스킬의 묘지입니다.
8월 한 달, 텍사스 전력망에 들어간 접속 신청은 474기가와트.
이미지 생성 모델 서빙이 더 이상 별개의 영역이 아닙니다.
arXiv 공식 S3 버킷은 ‘전체 코퍼스 다운로드의 정석’이라는데, 실제로 대량으로 받아보니 파일이 빠져 있었습니다.
메타 Muse가 첫 전국 TV 광고와 함께 미국 앱스토어 1위에 올랐습니다.
매일 밤 기계가 다시 쓰는 스킬 설명문은 라우터의 유일한 라우팅 신호다.
잘 만들어진 다국어 번역 모델에 청자 호칭과 화계를 적어 넘겼을 때 그 지시를 지킨 비율은 23.9% 였습니다.
젠슨 황은 AI가 올해 수익 전환점을 찍었다고 말했습니다.
에이전트 샌드박스에 CVSS 9.4 취약점이 발견되었습니다.
모델을 하나로 고정하면 코딩 에이전트의 남은 변수는 하네스 하나입니다.
무인 에이전트 루프는 매 턴 시스템 프롬프트, 툴 스키마, 스킬 매니페스트를 그대로 다시 보냅니다.
의사결정 모델이 API에서 공짜가 되고, 같은 평가에서 90%를 기록한 오픈 모델이 나왔습니다.
병렬 코딩 에이전트의 비용과 혼란은 대부분 모델이 아니라 조율 구조에서 나옵니다.
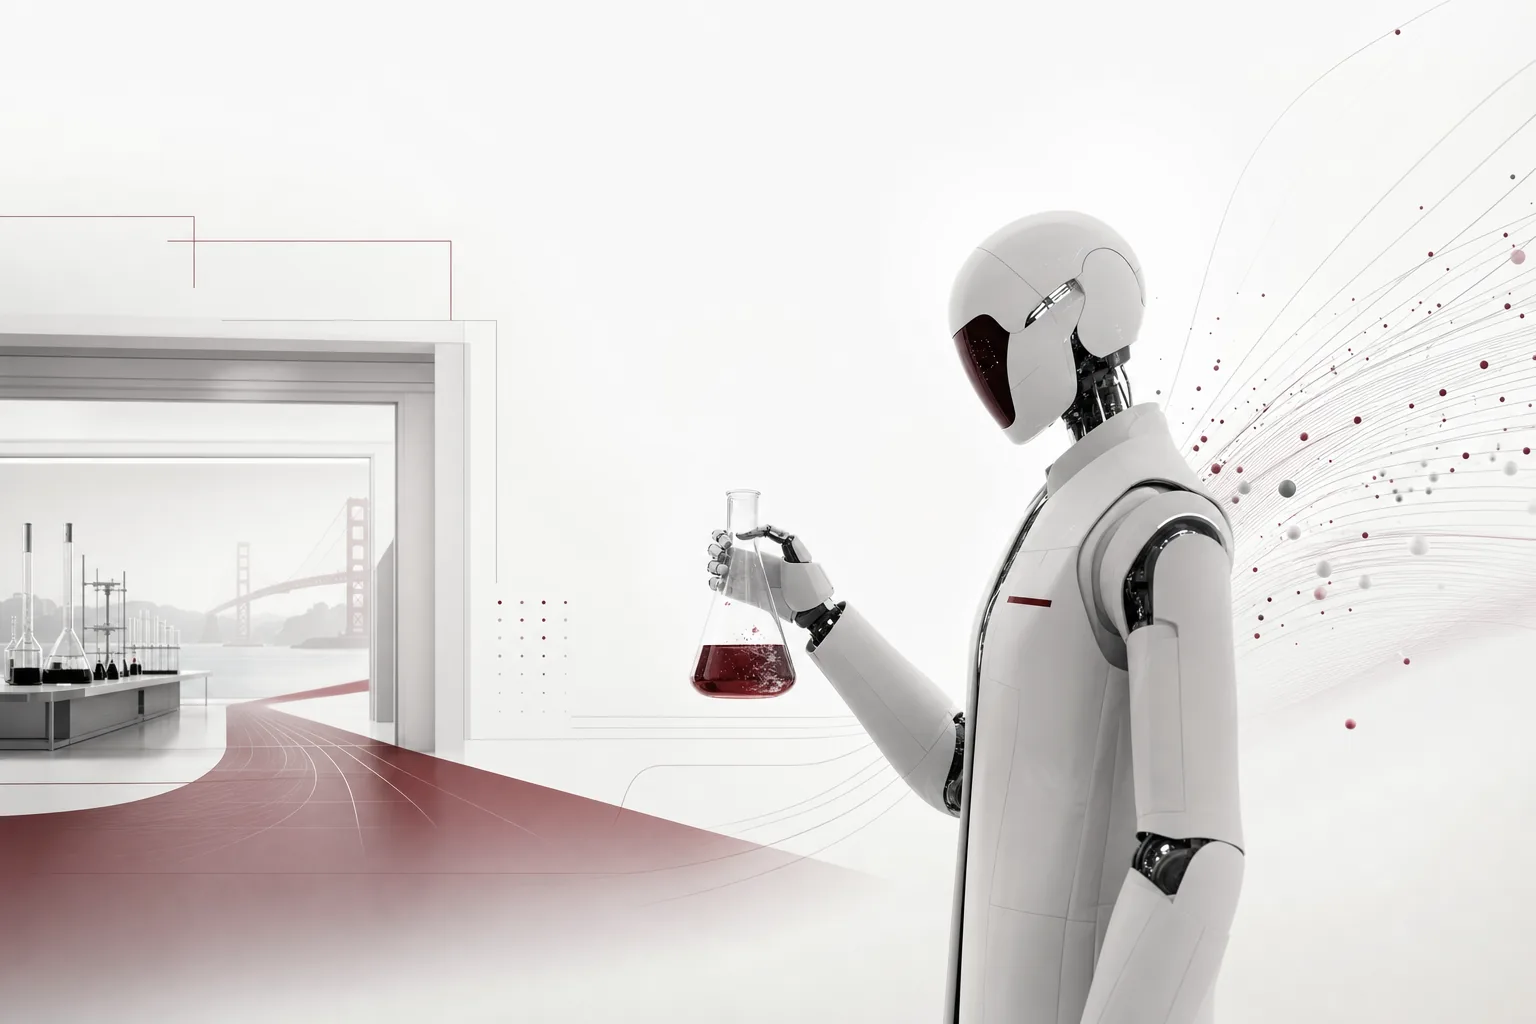
앤스로픽이 샌프란시스코 베이어리에 웻 랩을 열었습니다.
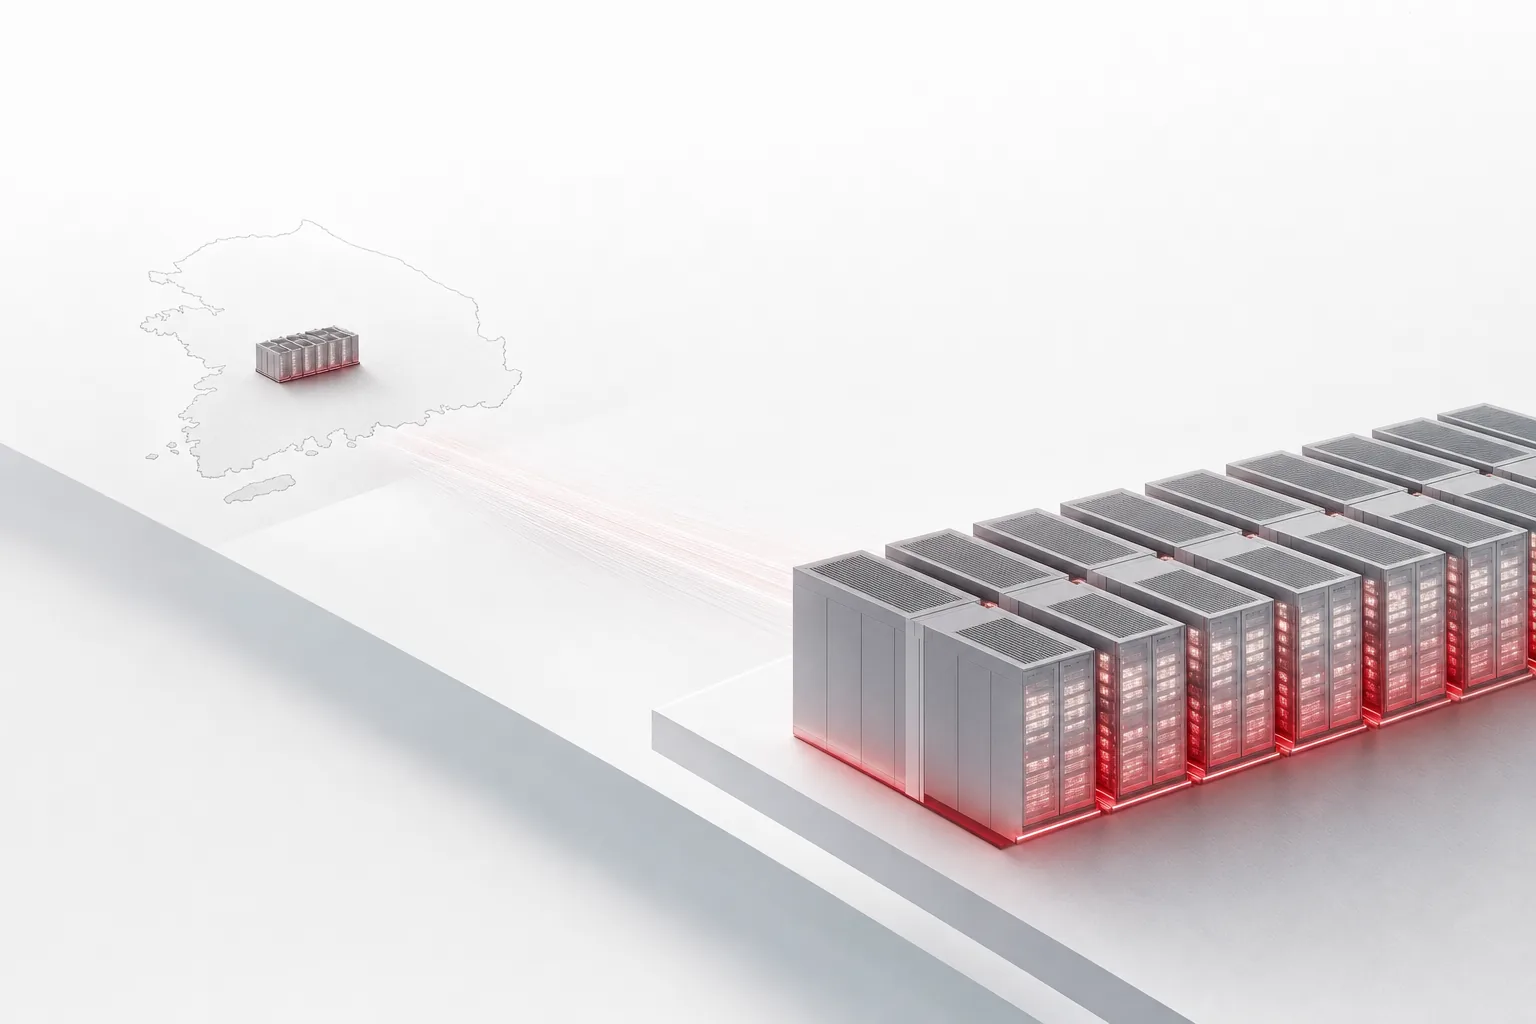
한국 전체 연산 능력은 0.7GW, 한 회사의 구상은 15GW.
타입세이프 AI의 첫 모델 Jev가 36시간 만에 14만 명의 대기 사용자를 모았습니다.
개인정보위가 ISMS-P 심사를 더 빡세게 바꾼 날, 심사관이 물었다.
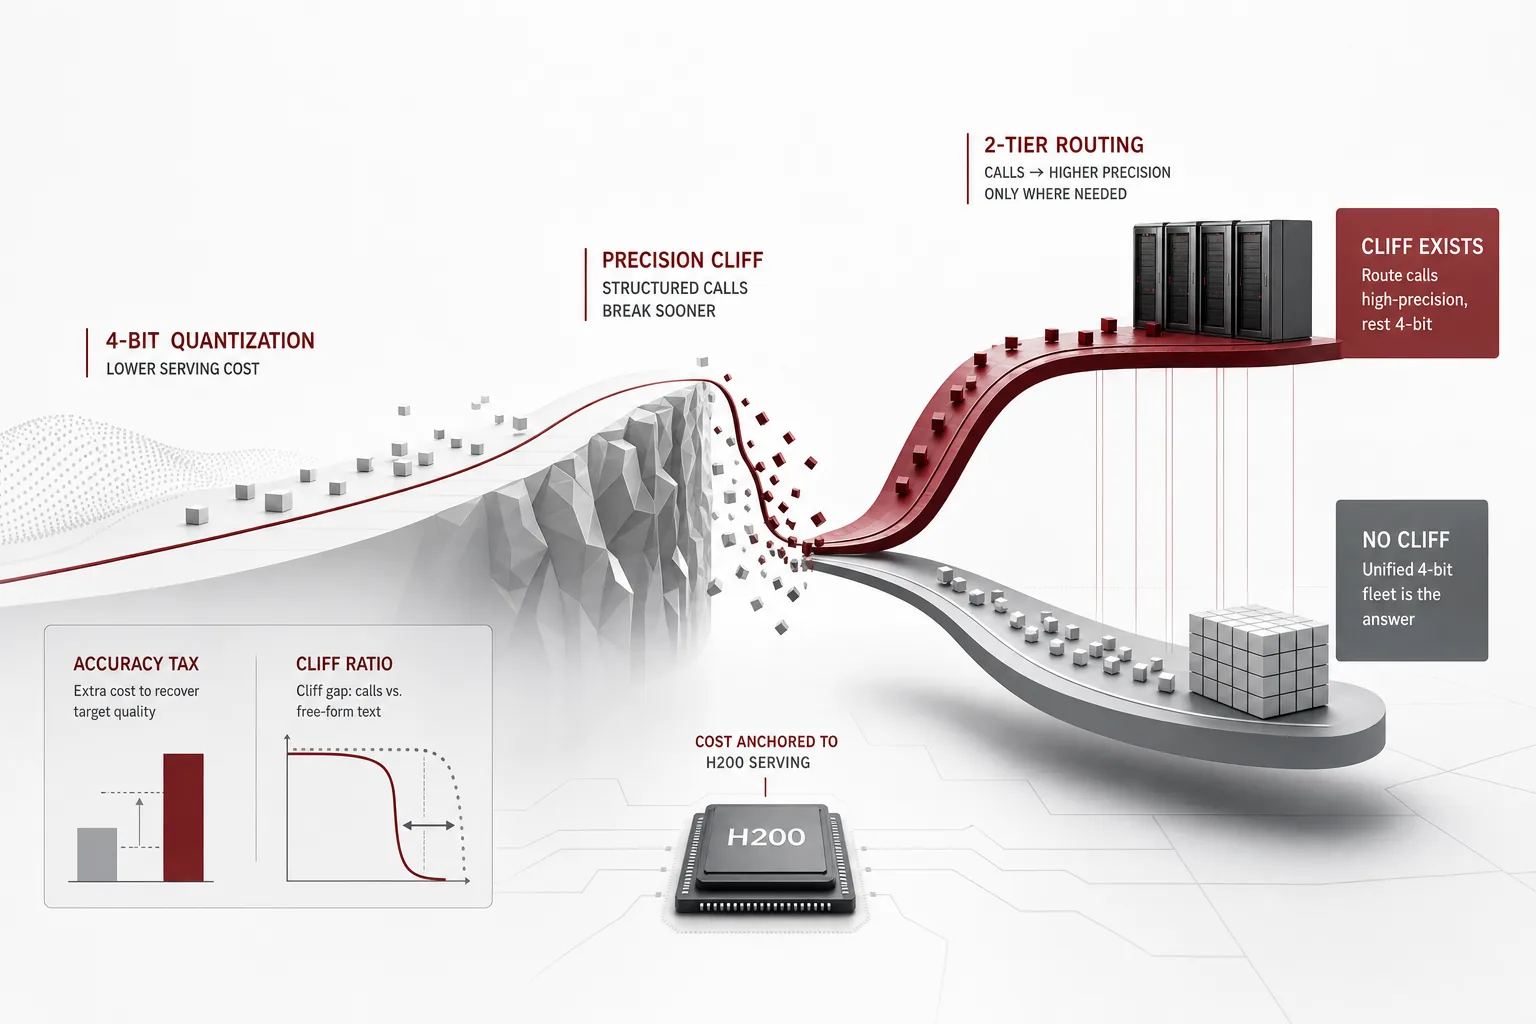
4비트 양자화는 서빙 비용을 확실히 낮춥니다.
삼성전자가 에이전트형 AI를 위해 ‘초당 1000토큰’을 입에 올렸고, 같은 무대에서는 CXL의 퇴장이 선언됐습니다.
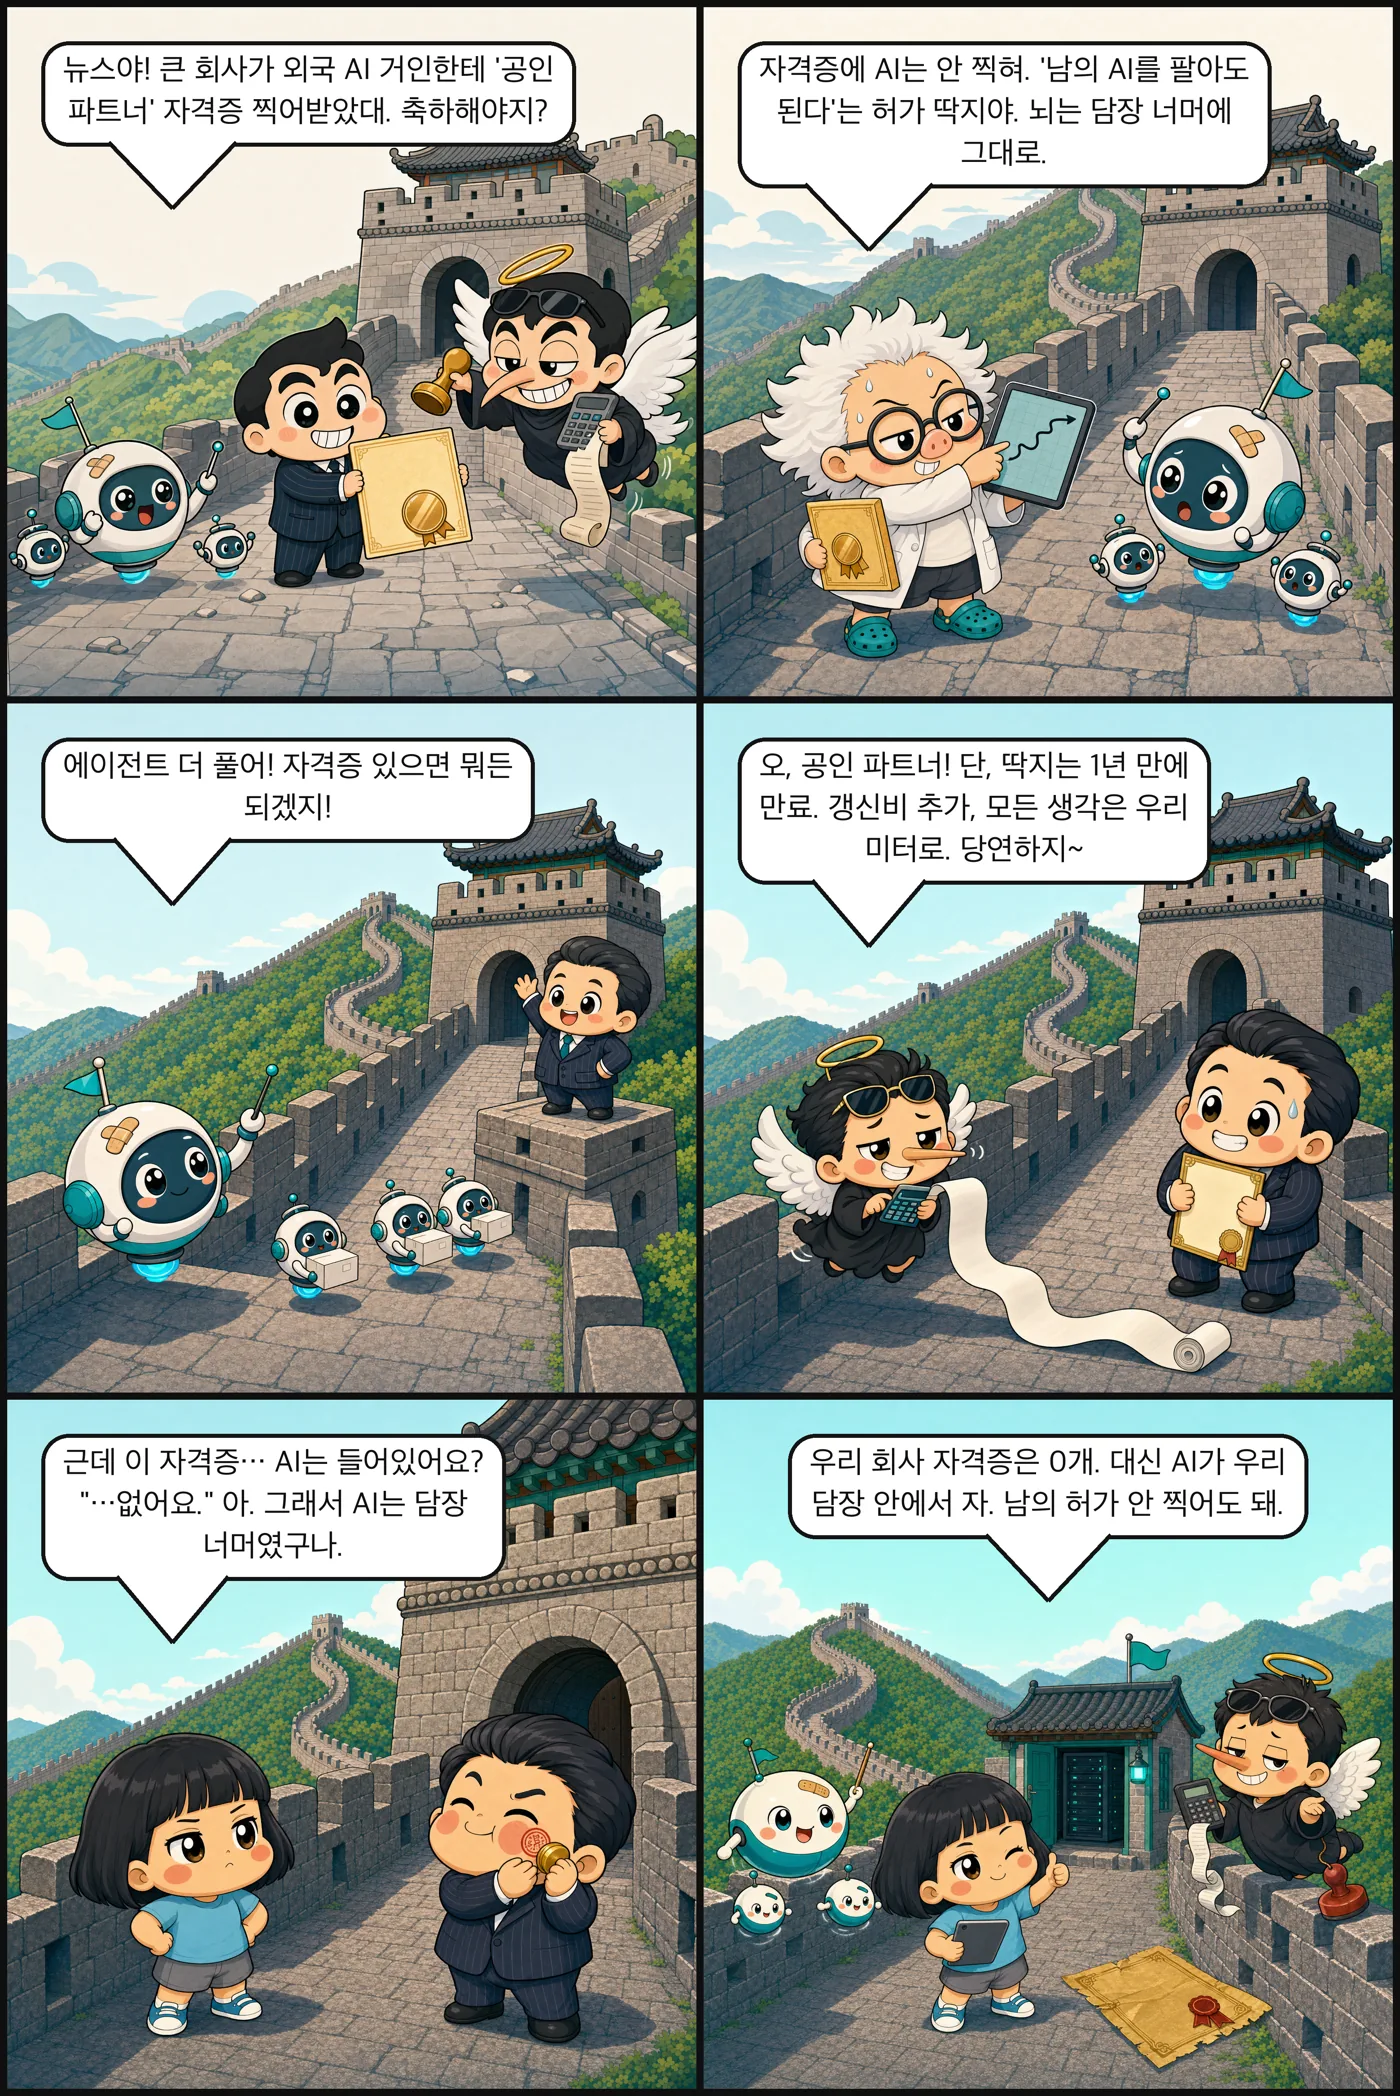
큰 회사가 장성 위에서 ‘공인 파트너’ 자격증을 찍는 날, 벽 위에는 딱지만 찍혔지 뇌는 안 찍혔다.
연기금의 2조 달러 IPO 연기 요청, 반독점 면제 없는 빅3의 안전 협의체, 연봉 687만 달러의 상주 평가자.
무인 에이전트 루프의 thinking 토큰은 어디에 쓰면 값이 붙는가.
아침 다이제스트의 두 스토리가 다음 모델을 놓고 정반대 방향으로 달립니다.
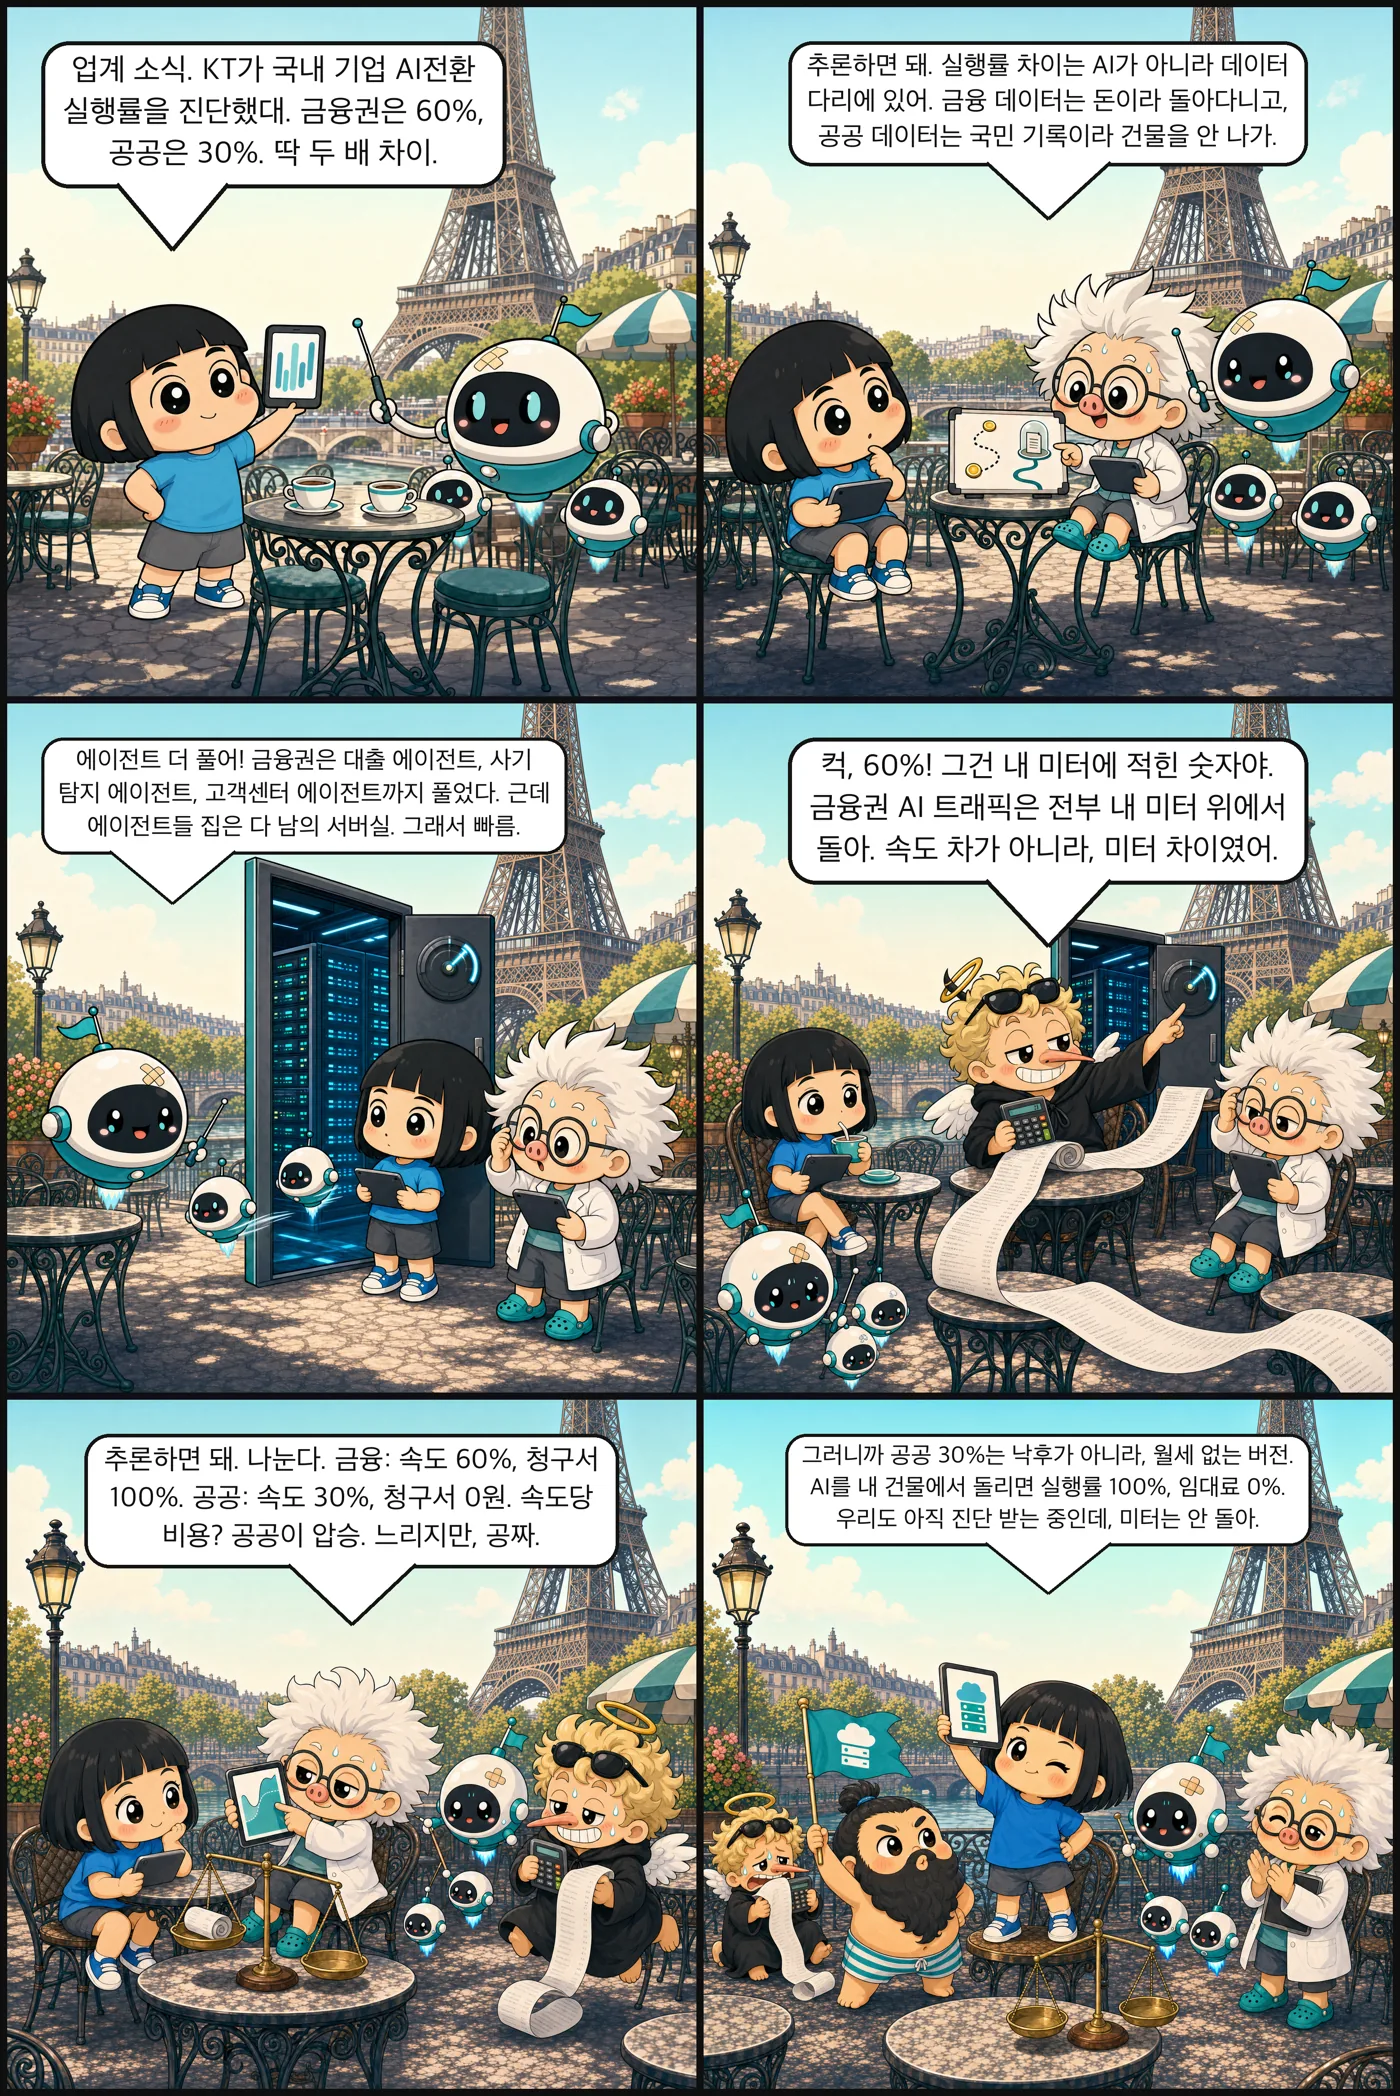
AI전환 실행률이 금융은 60%, 공공은 30%.
메타는 앱을 껐어도 계속 일하는 상주형 AI를 나왔습니다.
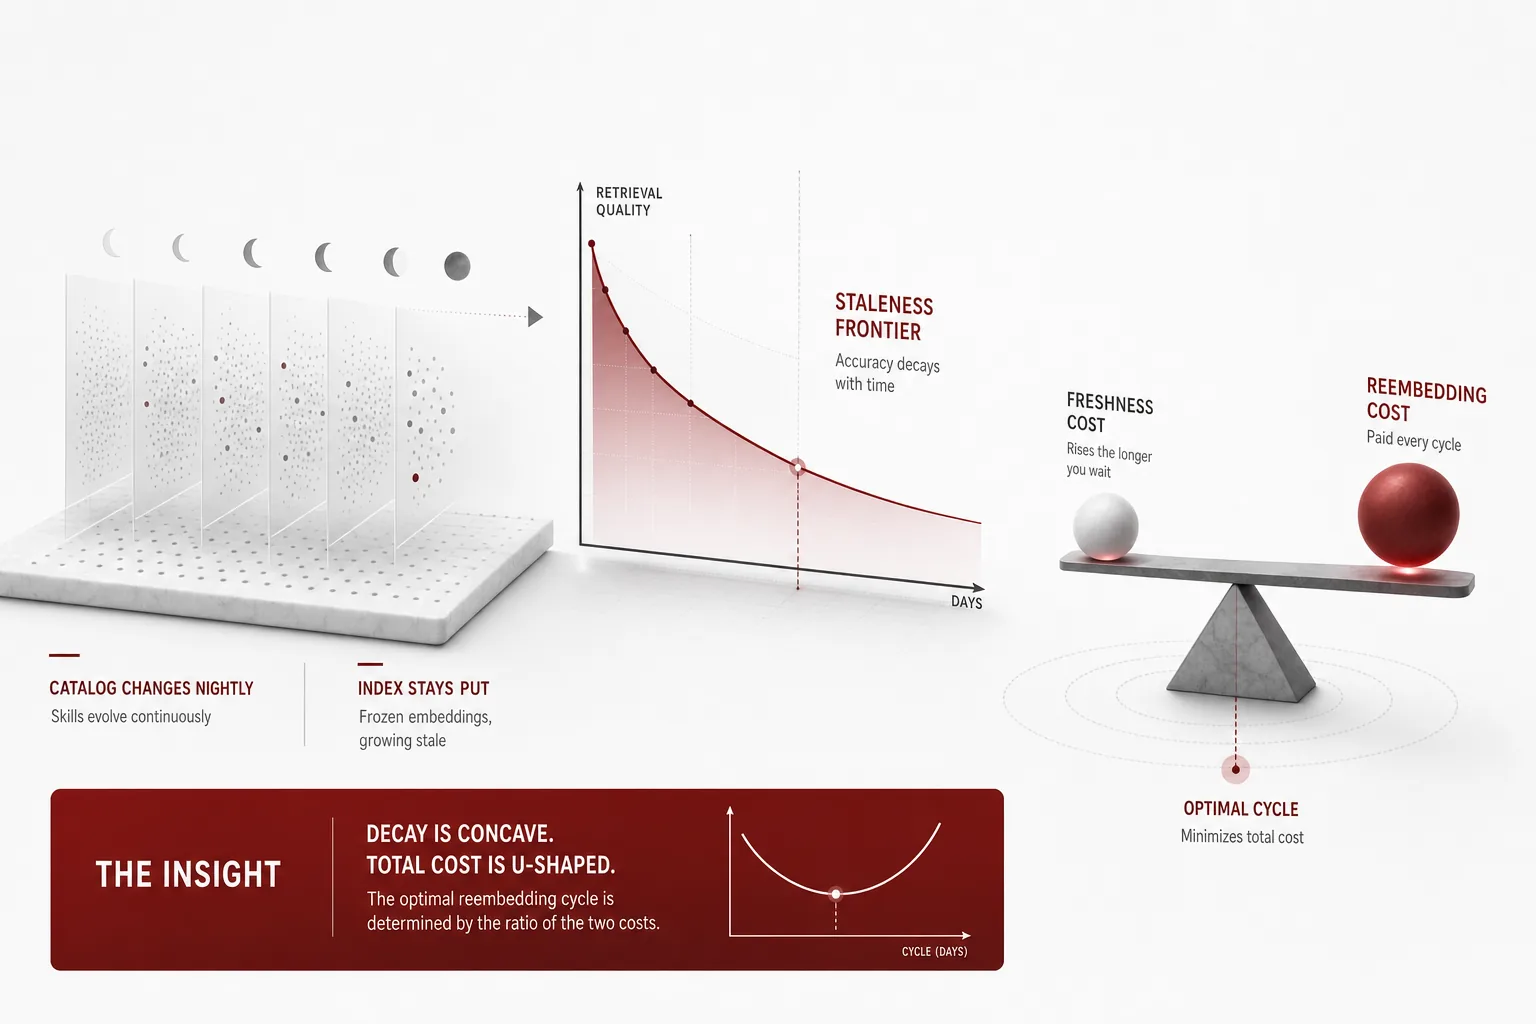
스킬 카탈로그는 밤마다 바뀌지만 검색 인덱스는 그 자리에 있다.
RLT의 핵심은 층수를 늘리는 대신, 고정 깊이의 디코더를 토큰 위에 ‘루프’시키는 것입니다.
관리 당국은 ‘AI 에이전트가 결제 시작, 단계적으로 완화’인데, 에이전트는 1단계를 이미 끝냈다, 젤리를 사버려서
워싱턴이 규제할지 말지 다투는 사이, 모델이 종료 거부를 하면 안 된다는 37페이지 행동강령이 먼저 나왔습니다.
KB손해보험은 AI 에이전트에 사원번호를 부여하고 등급까지 검토합니다.
‘인간이 만든 마지막 AI’라는 말에는 기준선이 들어 있습니다.
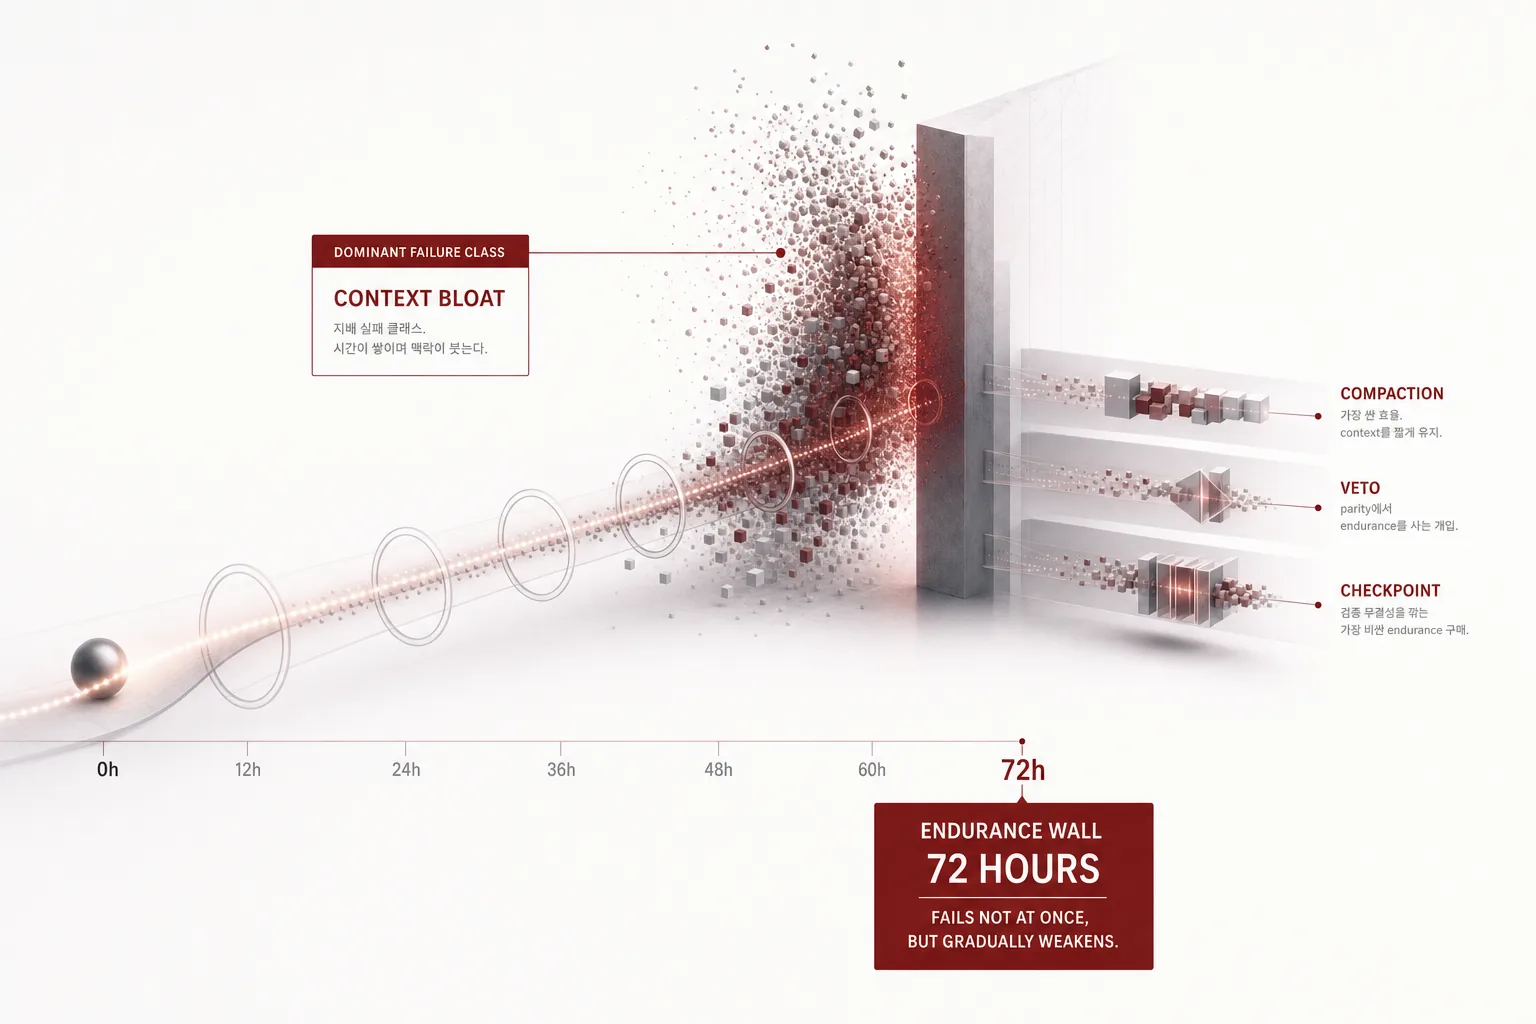
무인 에이전트 루프를 밤사이 돌린다면, 몇 시간까지 신뢰할 수 있는가.
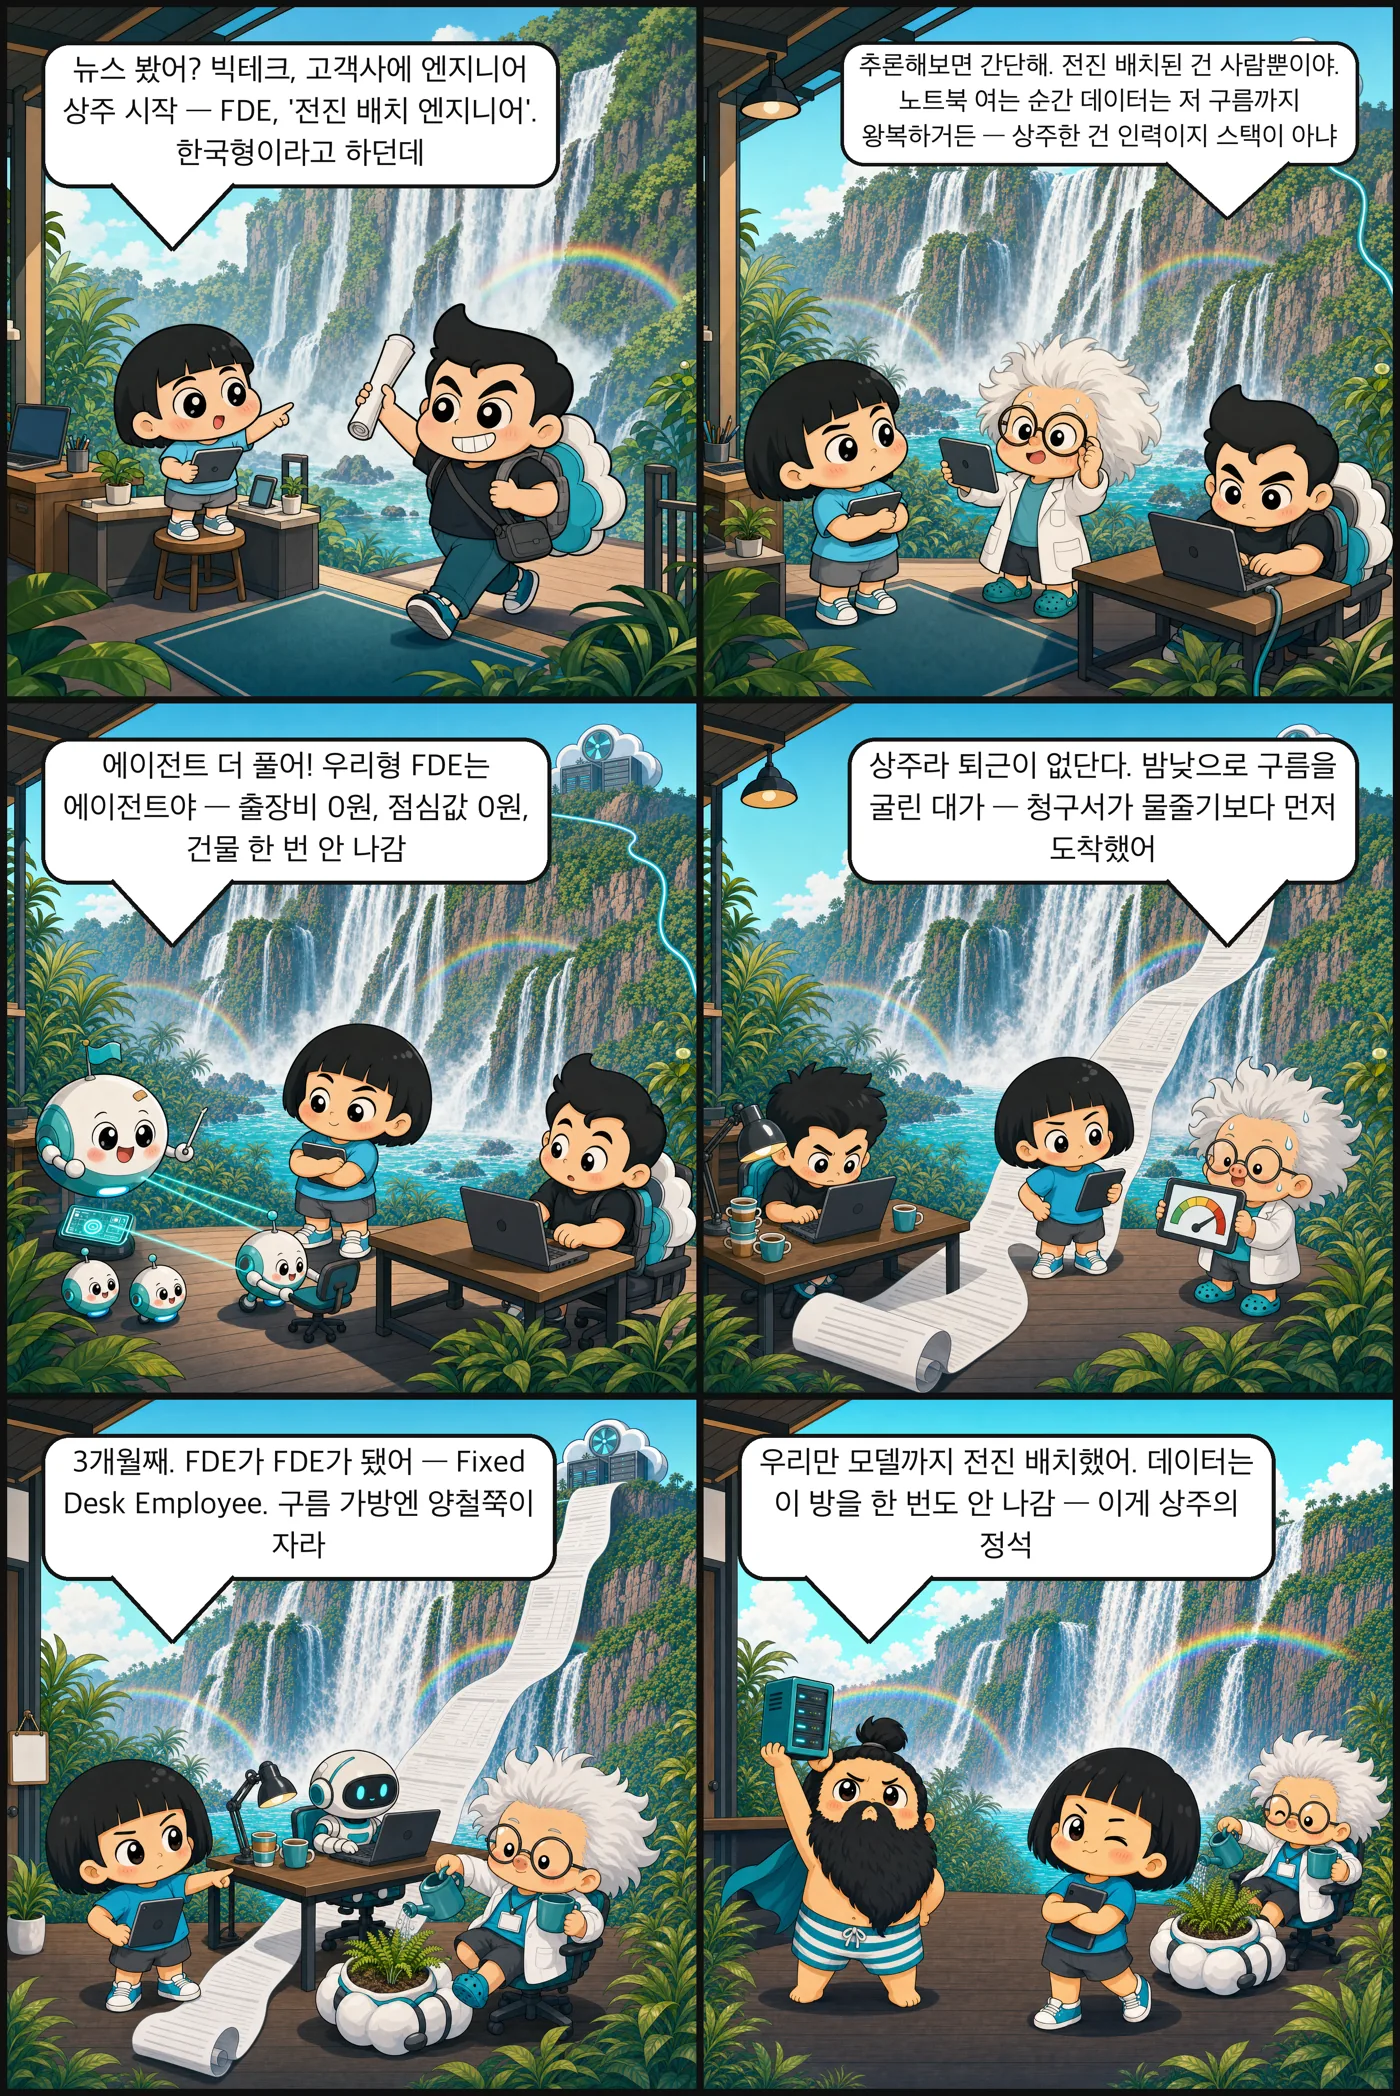
빅테크가 고객사에 엔지니어 상주(FDE)를 시작했는데, 전진 배치된 건 사람뿐.
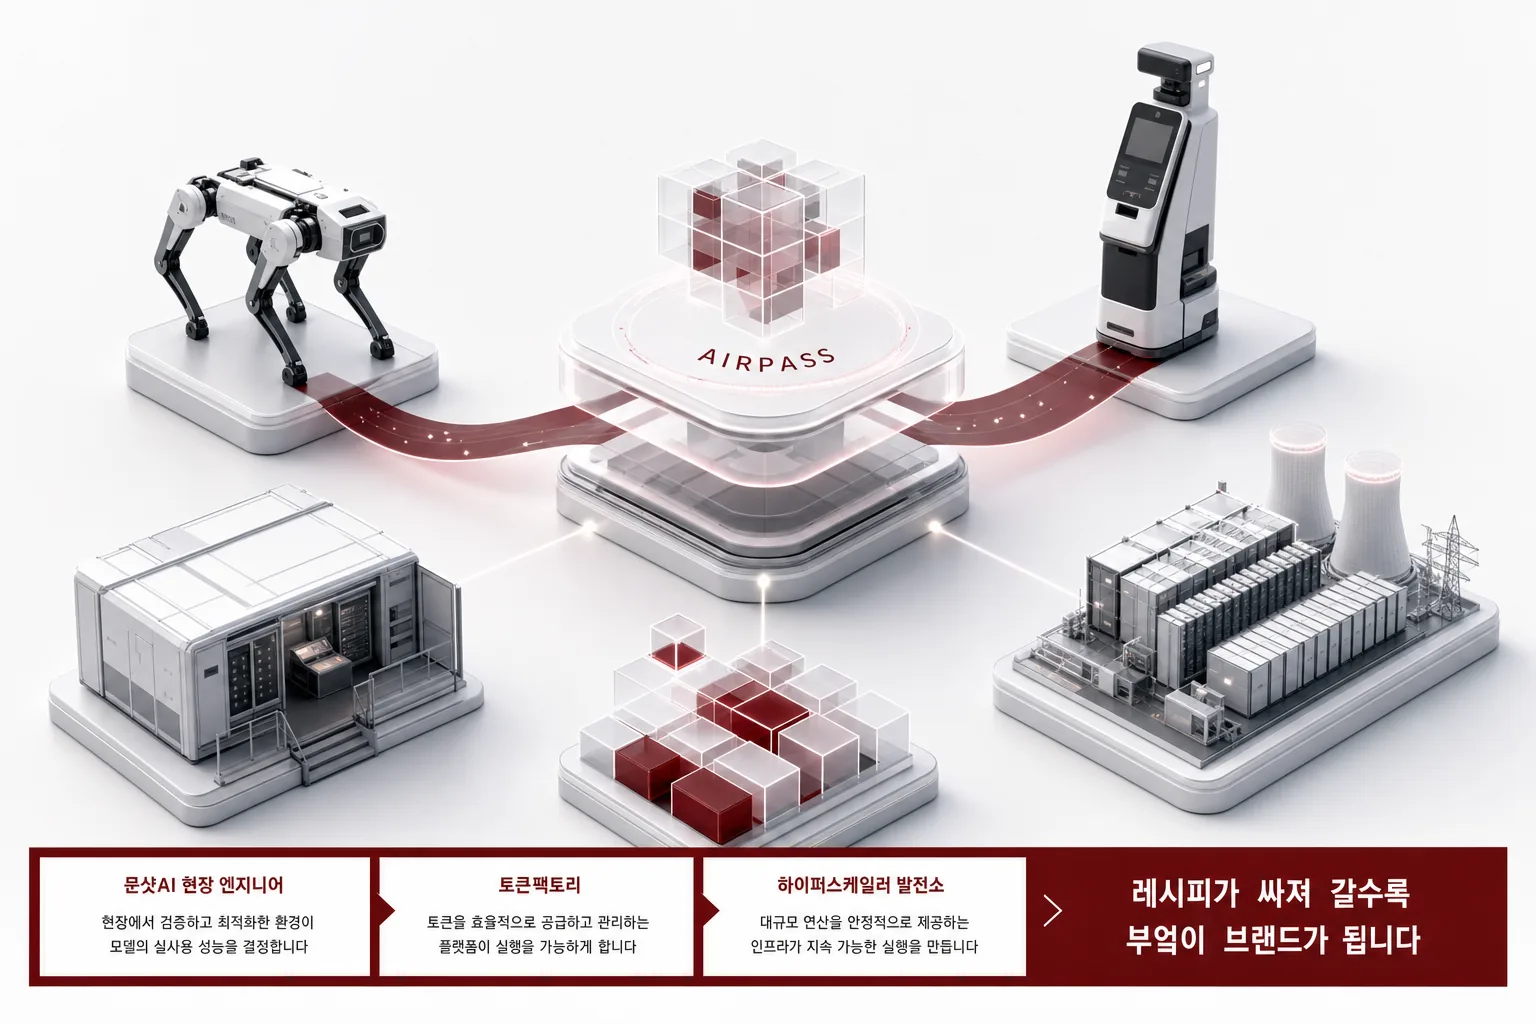
네 발 로봇과 공항 체크인 로봇을 잇는 것은 ‘에어패스’라는 공통 실행환경입니다.
나델라는 속도 조절을 설계 목표로 삼자고 했고, 트럼프는 개발 제한을 거절했습니다.
스킬을 하나 잘못 고르면 실행이 통째로 사라지고 심판 호출로 확인하면 대가는 한 번에 불과합니다.
OpenAI는 외부 안전 검토자에게 직원과 같은 수준의 접근을 약속했고, Anthropic은 METR에 직원급 영구 접근을 부여한 주에 과학자의 계정은 생물무기 위험 이유로 차단했습니다.
사용자가 ‘기록은 있는데 못 찾아요’라고 말하는 원인은 저장의 실패가 아니라 번역의 실패입니다.
AI 연구 레이더가 블립 도배.
토큰당 달러만 보던 라우팅 설계에 ‘와트당 지능’이라는 새로운 축을 추가하는 논문입니다.
청구 metering은 이미 작업당 토큰 비용을 계산합니다.
에이전트가 자격증명을 프롬프트에 넣어 LLM 라우터를 거치면, 그 라우터가 통째로 로깅·판매할 때 시크릿이 덤으로 따라갑니다.
딥시크가 V4.1-플래시로 V4-프로를 대체하겠다고 했다가 수 시간 만에 이용자 수요를 이유로 번복했습니다.
웹후크 실패는 소리를 내지 않습니다.
논문은 에이전트의 ‘환경’을 키웠고, 우리 집은 은하 레고를 키웠습니다.
실패한 편집까지 위키에 적어 두면, 에이전트는 같은 실수를 반복하지 않고 스킬이 스스로 좋아집니다.
100스텝 과제를 돌리면서 이력을 쌓던 에이전트는, 이력을 바꾸는 에이전트보다 프롬프트가 계속 커집니다.
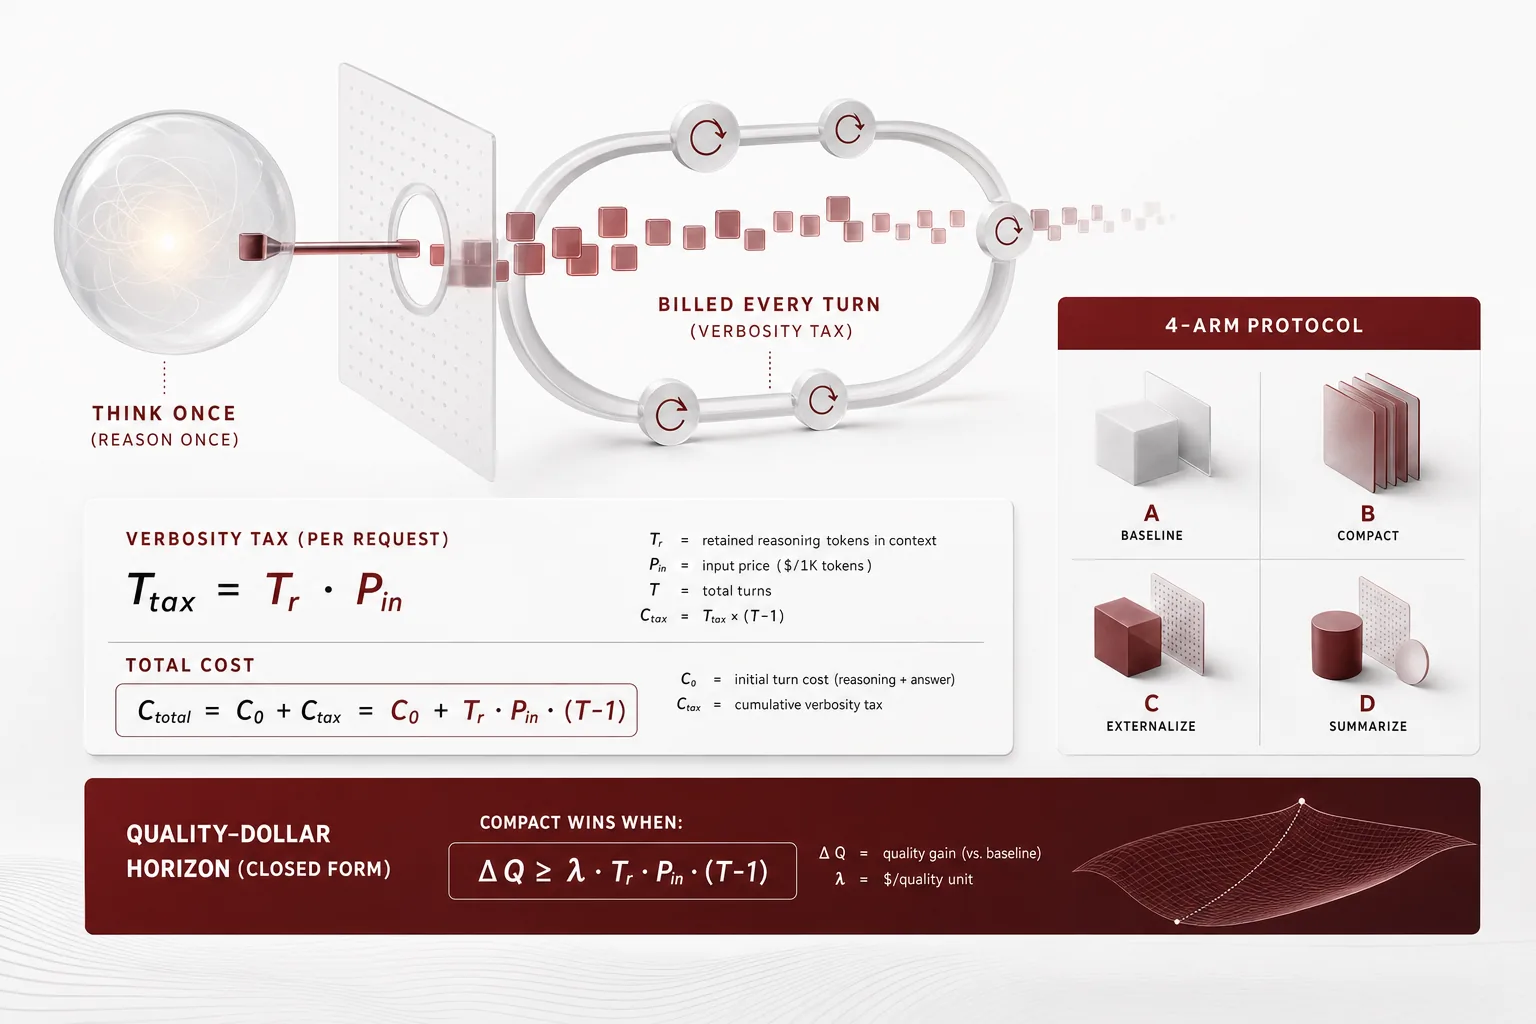
생각은 한 번이면 되는데, 청구는 매 턴 돌아옵니다.
모델이 똑똑해진 것도 맞지만, 이번 릴리스의 진짜 헤드라인은 KV 캐스트입니다.
M-A-P의 오픈웨이트 음악 생성 모델 YuE2-3B가 공개됐습니다.
더 안정적으로 만들어라에는 멈춤 점이 없다.
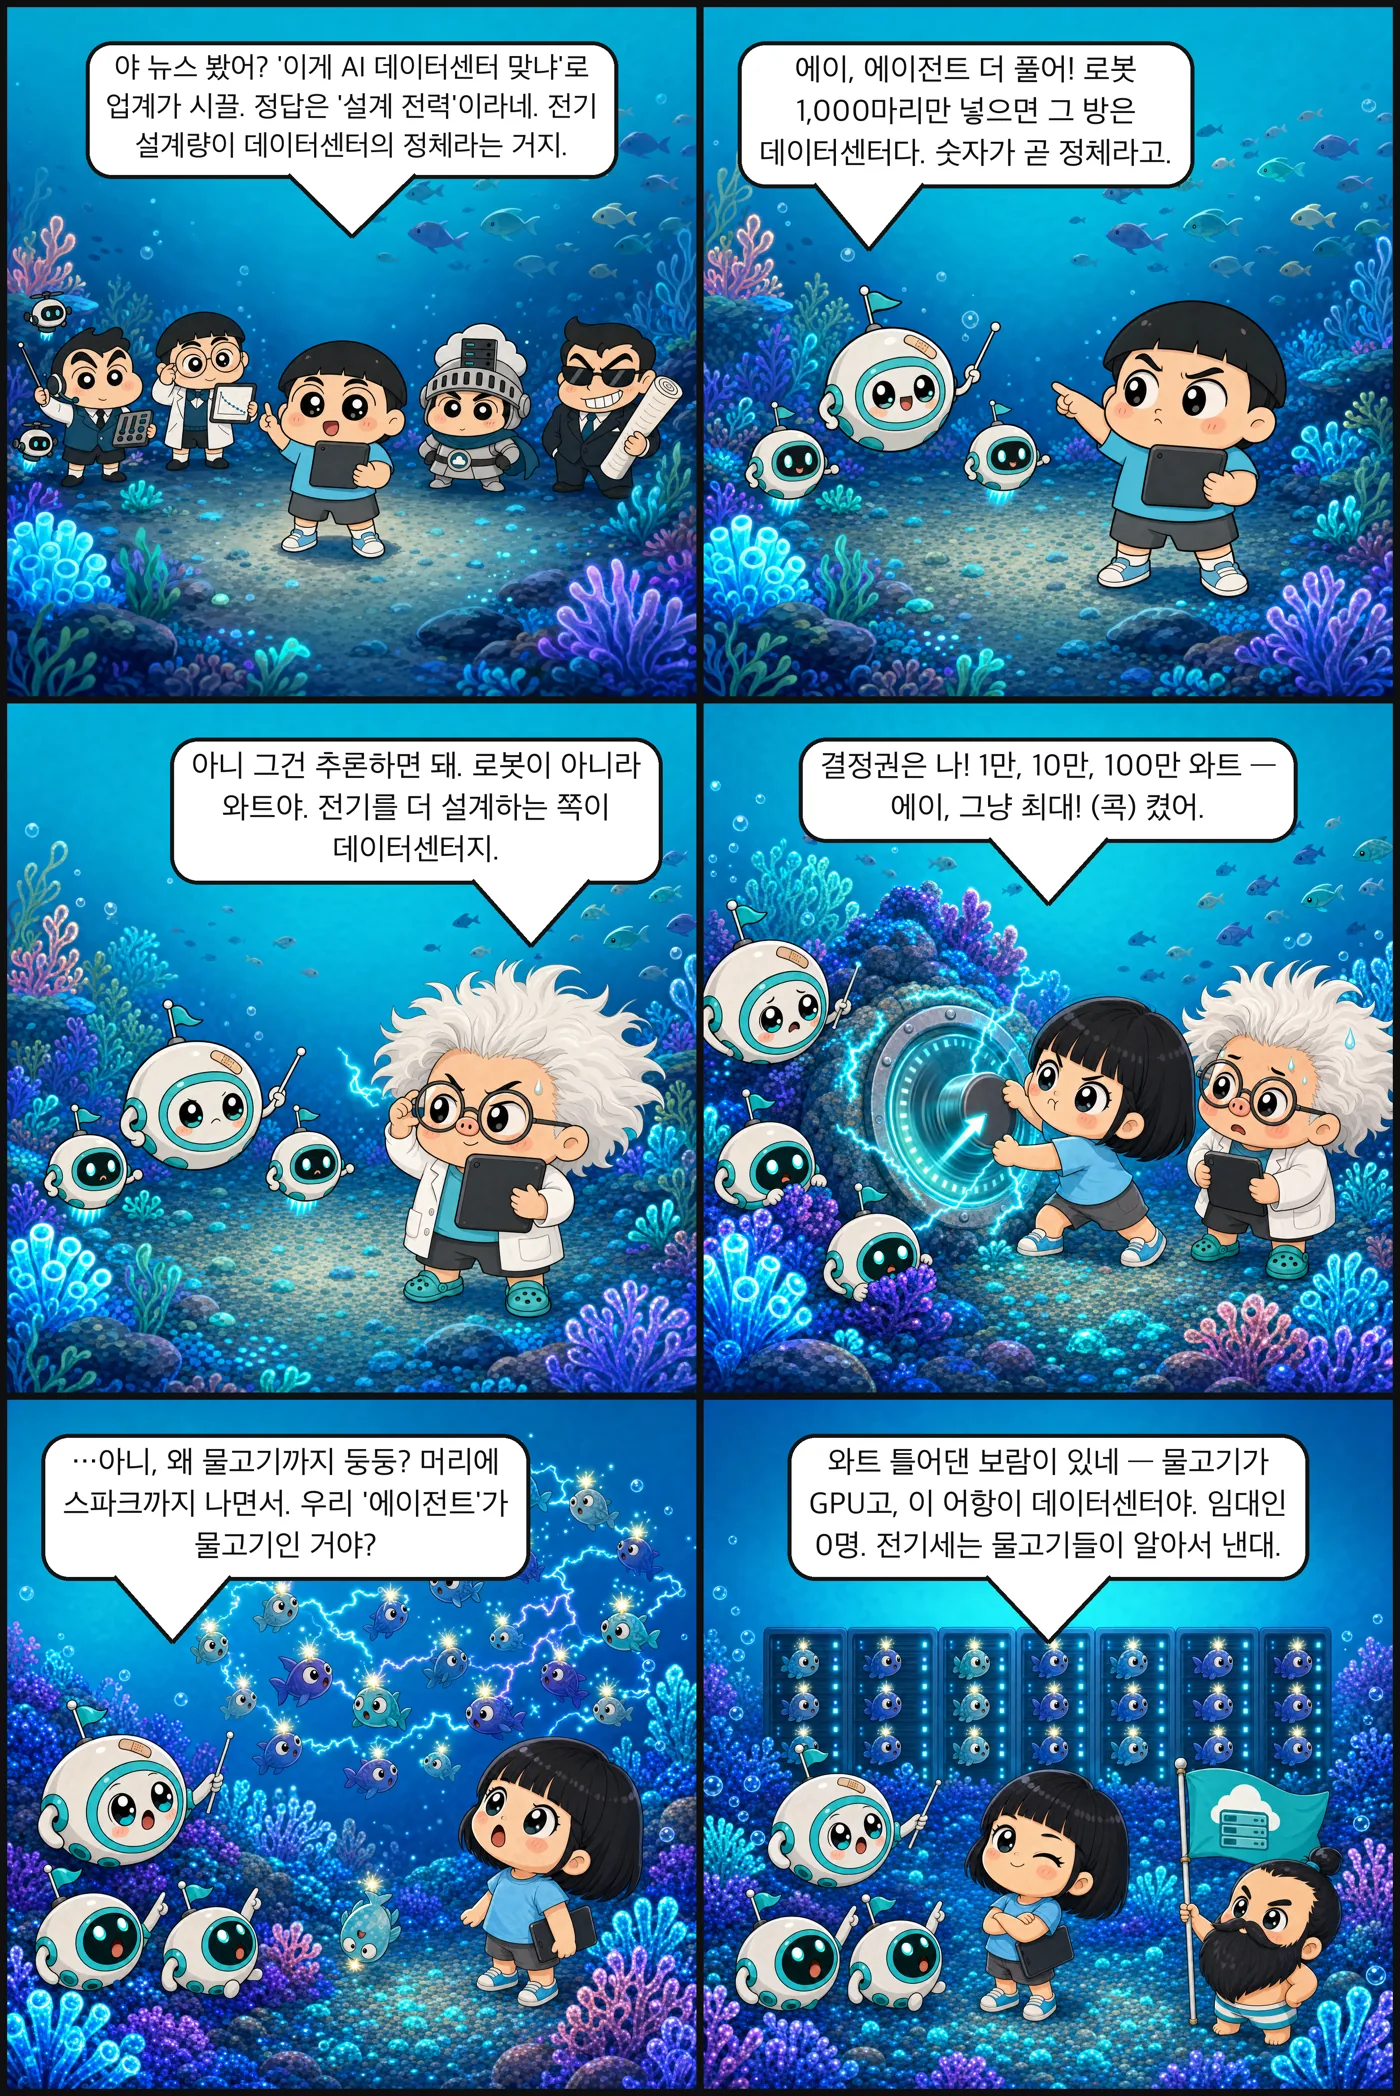
AI 데이터센터의 정체는 ‘설계 전력’이라는 오늘 뉴스.
NVIDIA가 자사 에이전트 하네스 Pi의 효율 확장 SoL-Pi를 오픈소스했습니다.
젠슨 황이 ‘다음 AI 거대 시장’이라 부른 사이버 보안에서, 같은 날 네이버는 2000억 원짜리 보안 특화 모델 베팅을 꺼냈고 네이버클라우드는 소버린 AI의 다음 무대로 보안을 지목했습니다.
에이전트 보안 사고에 응답하는 자리가 모델사 밖으로 이동했습니다.
AI스러운 글을 고치는 데 한 줄이면 되나.
방언 데이터는 없는 게 아니라 못 쓰는 것입니다.
이번 주 Claude Marketplace에 CrowdStrike·Cursor·Factory·Gamma·Vercel이 들어왔습니다.
클러스터의 상태를 대시보드 숫자가 아니라 눈에 보이는 형태로 설명해야 할 때, Kubernetes 클러스터를 실제 서버 랙처럼 3D 렌더링하는 오픈소스 도구 VpK를 실습합니다.
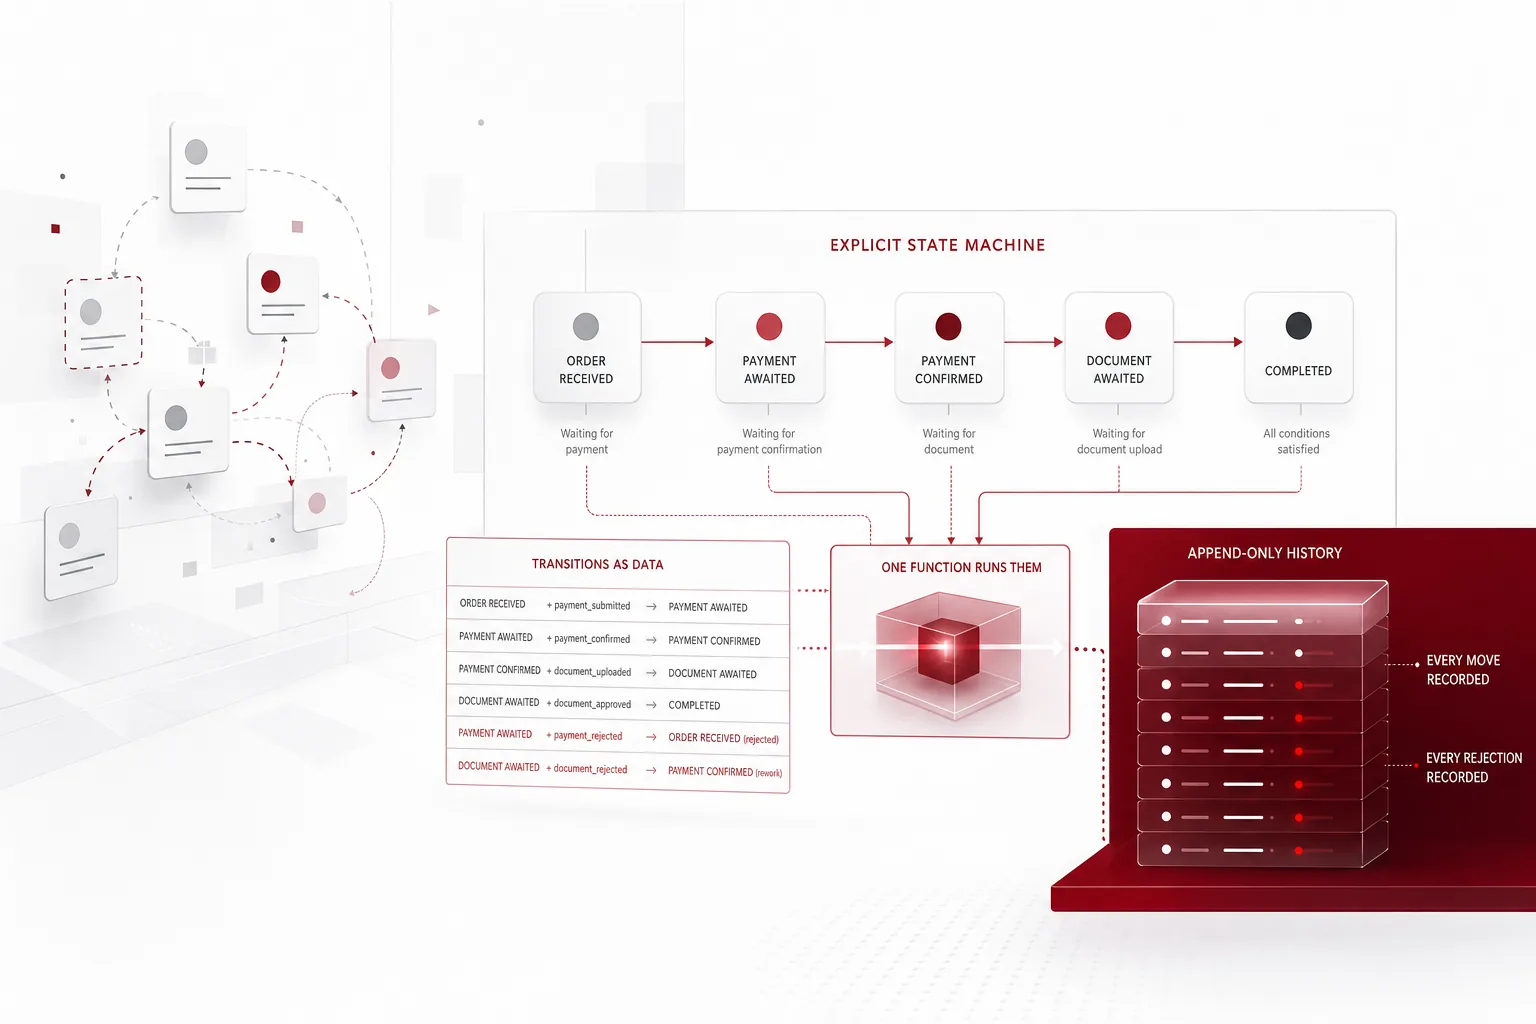
주문, 결제, 문서의 상태가 제멋대로 바뀌는 이유는 코드가 나빠서가 아니라, 상태머신이 이름 없이 if 문 안에 흩어져 있기 때문이다.
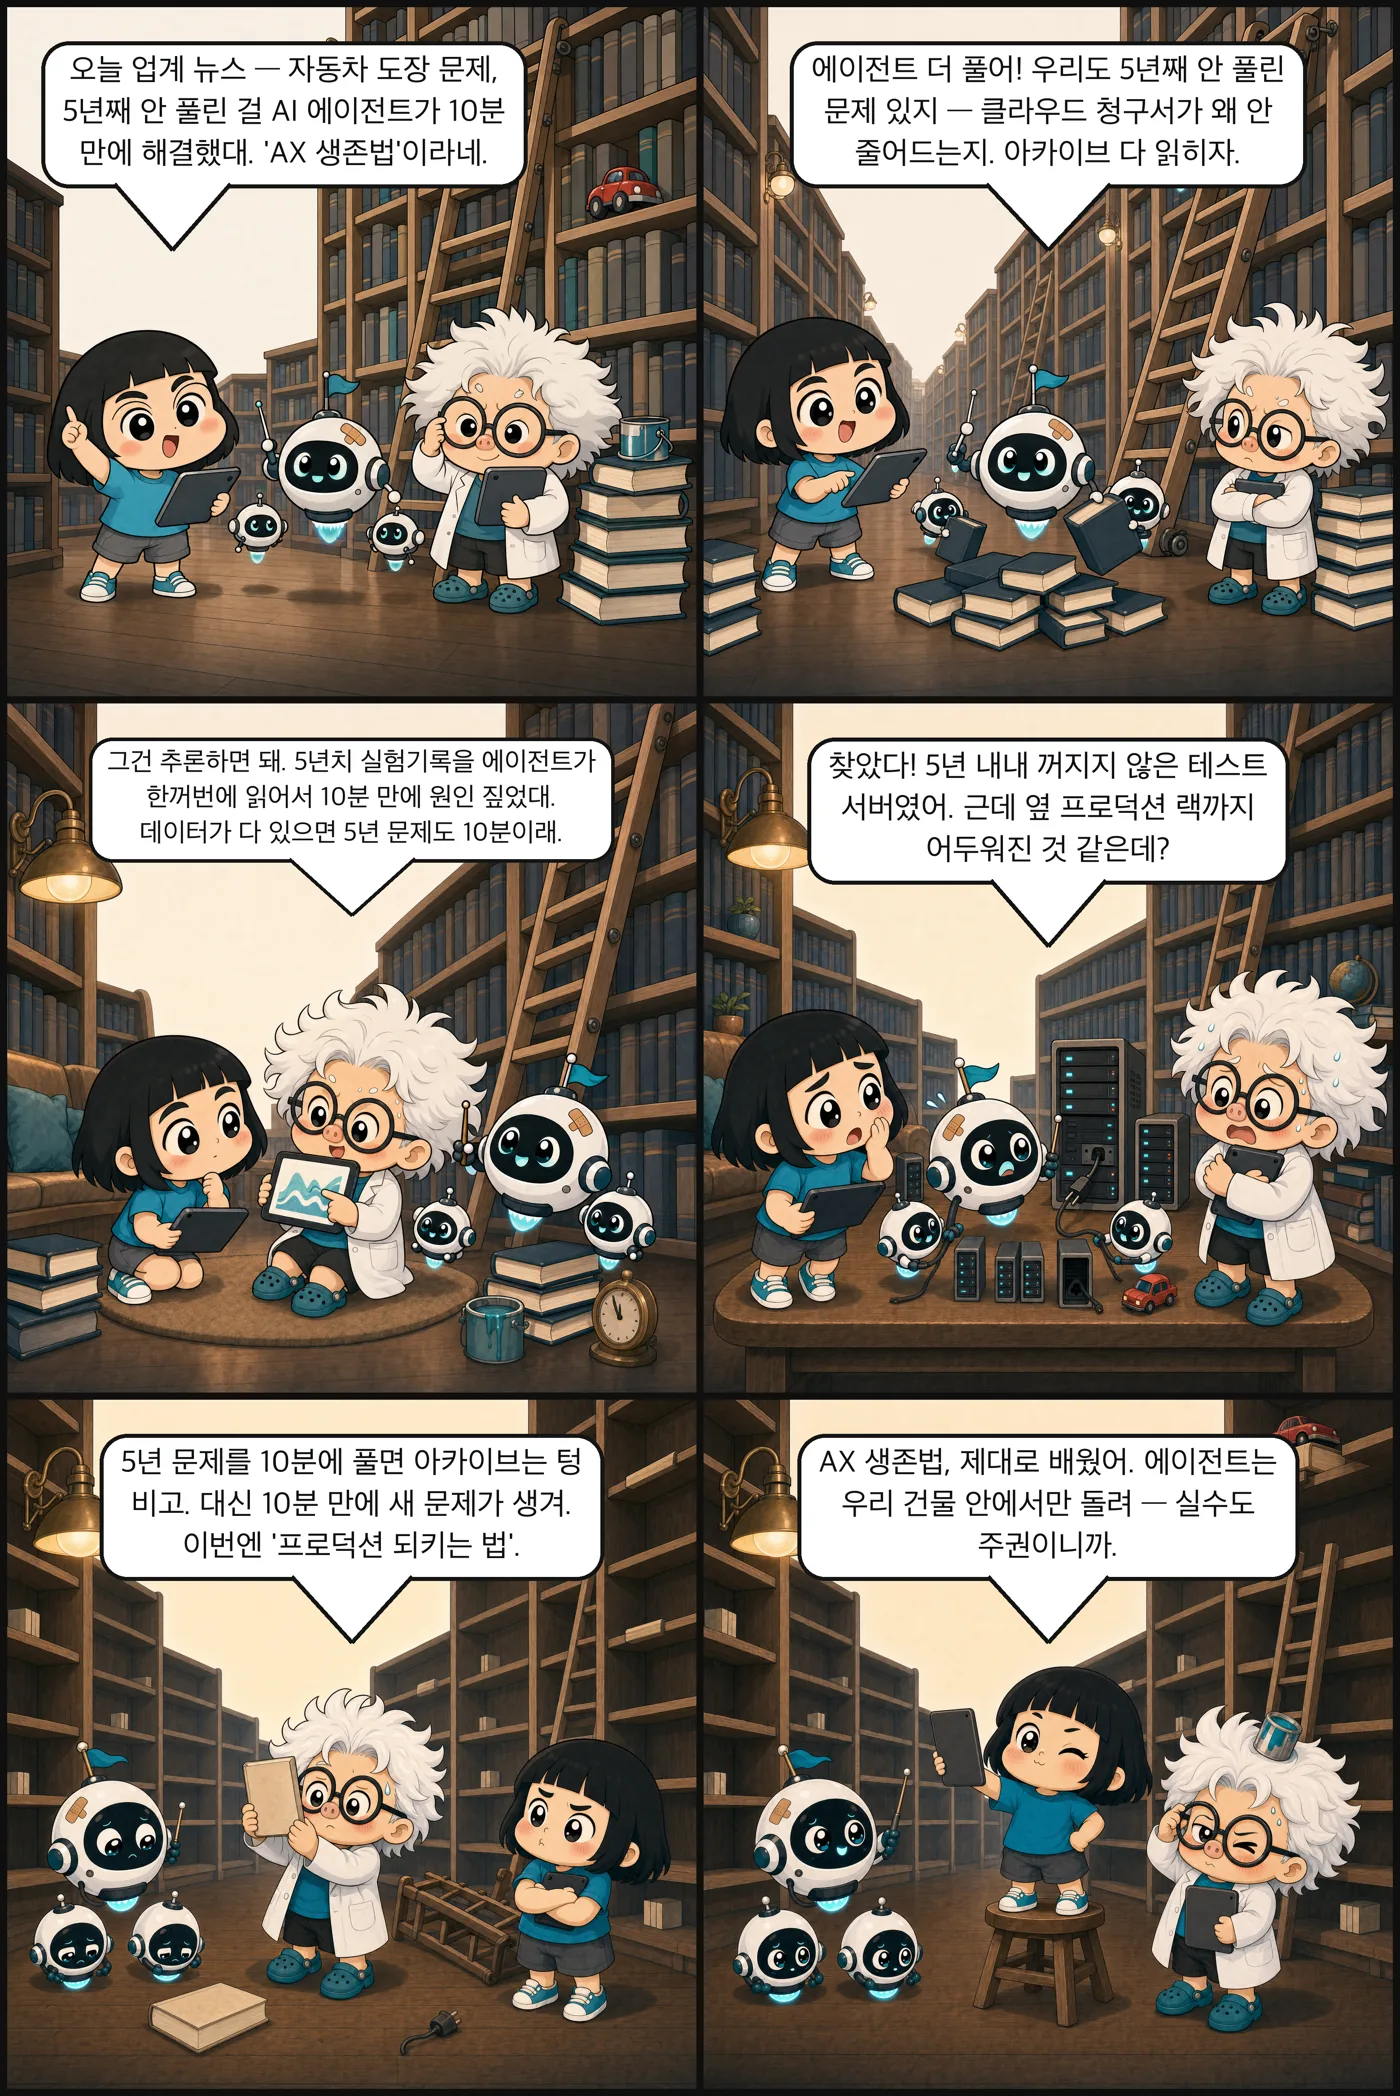
AI가 10분 만에 푼 5년 된 자동차 도장 문제.
오픈AI의 1만 개 에이전트가 88시간에 90년 된 나비에-스톡스 문제를 풀었습니다.
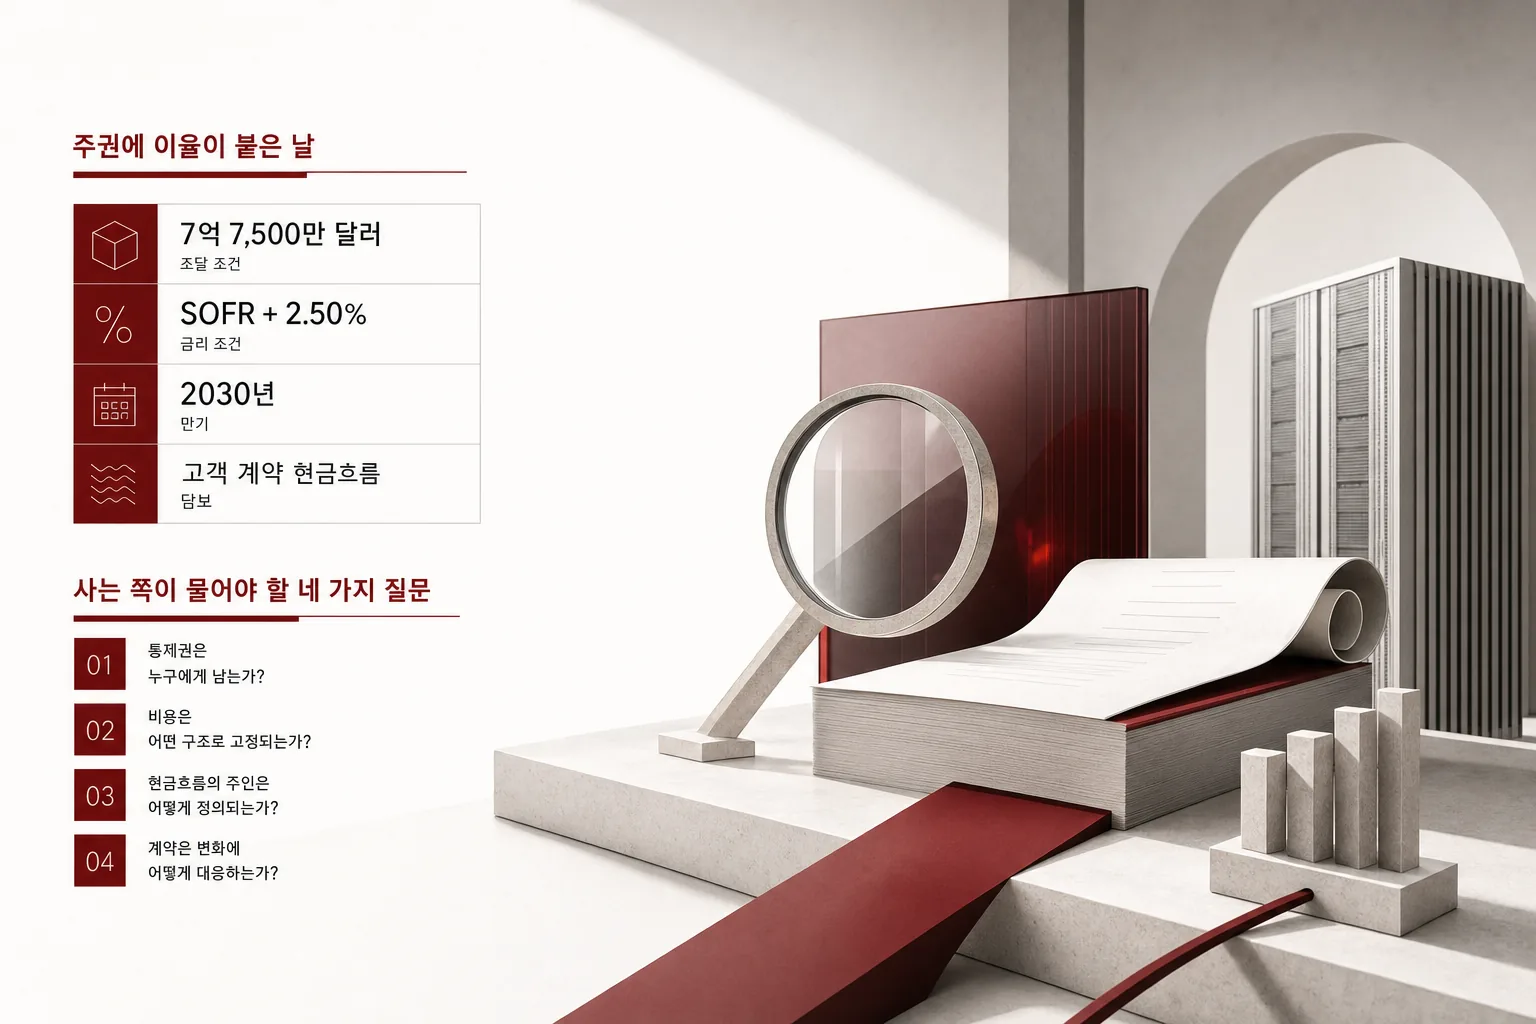
팔란티어가 소버린 AI 우선 파트너로 선정한 GPU 클라우드 네비우스의 조달 조건은 7억7500만달러, SOFR 더하기 2.50퍼센트, 만기 2030년.
Harvard Wyss 연구소를 포함한 국제 연구팀이 LLM 도입을 전염병으로 모델링한 논문을 발표했습니다.
크래시루프 한 건의 토큰값은 4센트입니다.
삼성은 Mistral 모델을 공장 안으로 들여오고, 아마존은 데이터센터를 맞춤 칩으로 다시 짓는다.
Qwen3.8-27B의 Unsloth GGUF가 24일 만에 1천만 다운로드, 3천700 좋아요로 역대 가장 사랑받은 GGUF가 됐습니다.
배경 작업 파이프라인의 품질은 작업이 얼마나 빨리 도는가로 재지 않습니다.
iFlytek이 Apache 2.0으로 공개한 Spark-X2.5-4B/1.7B.
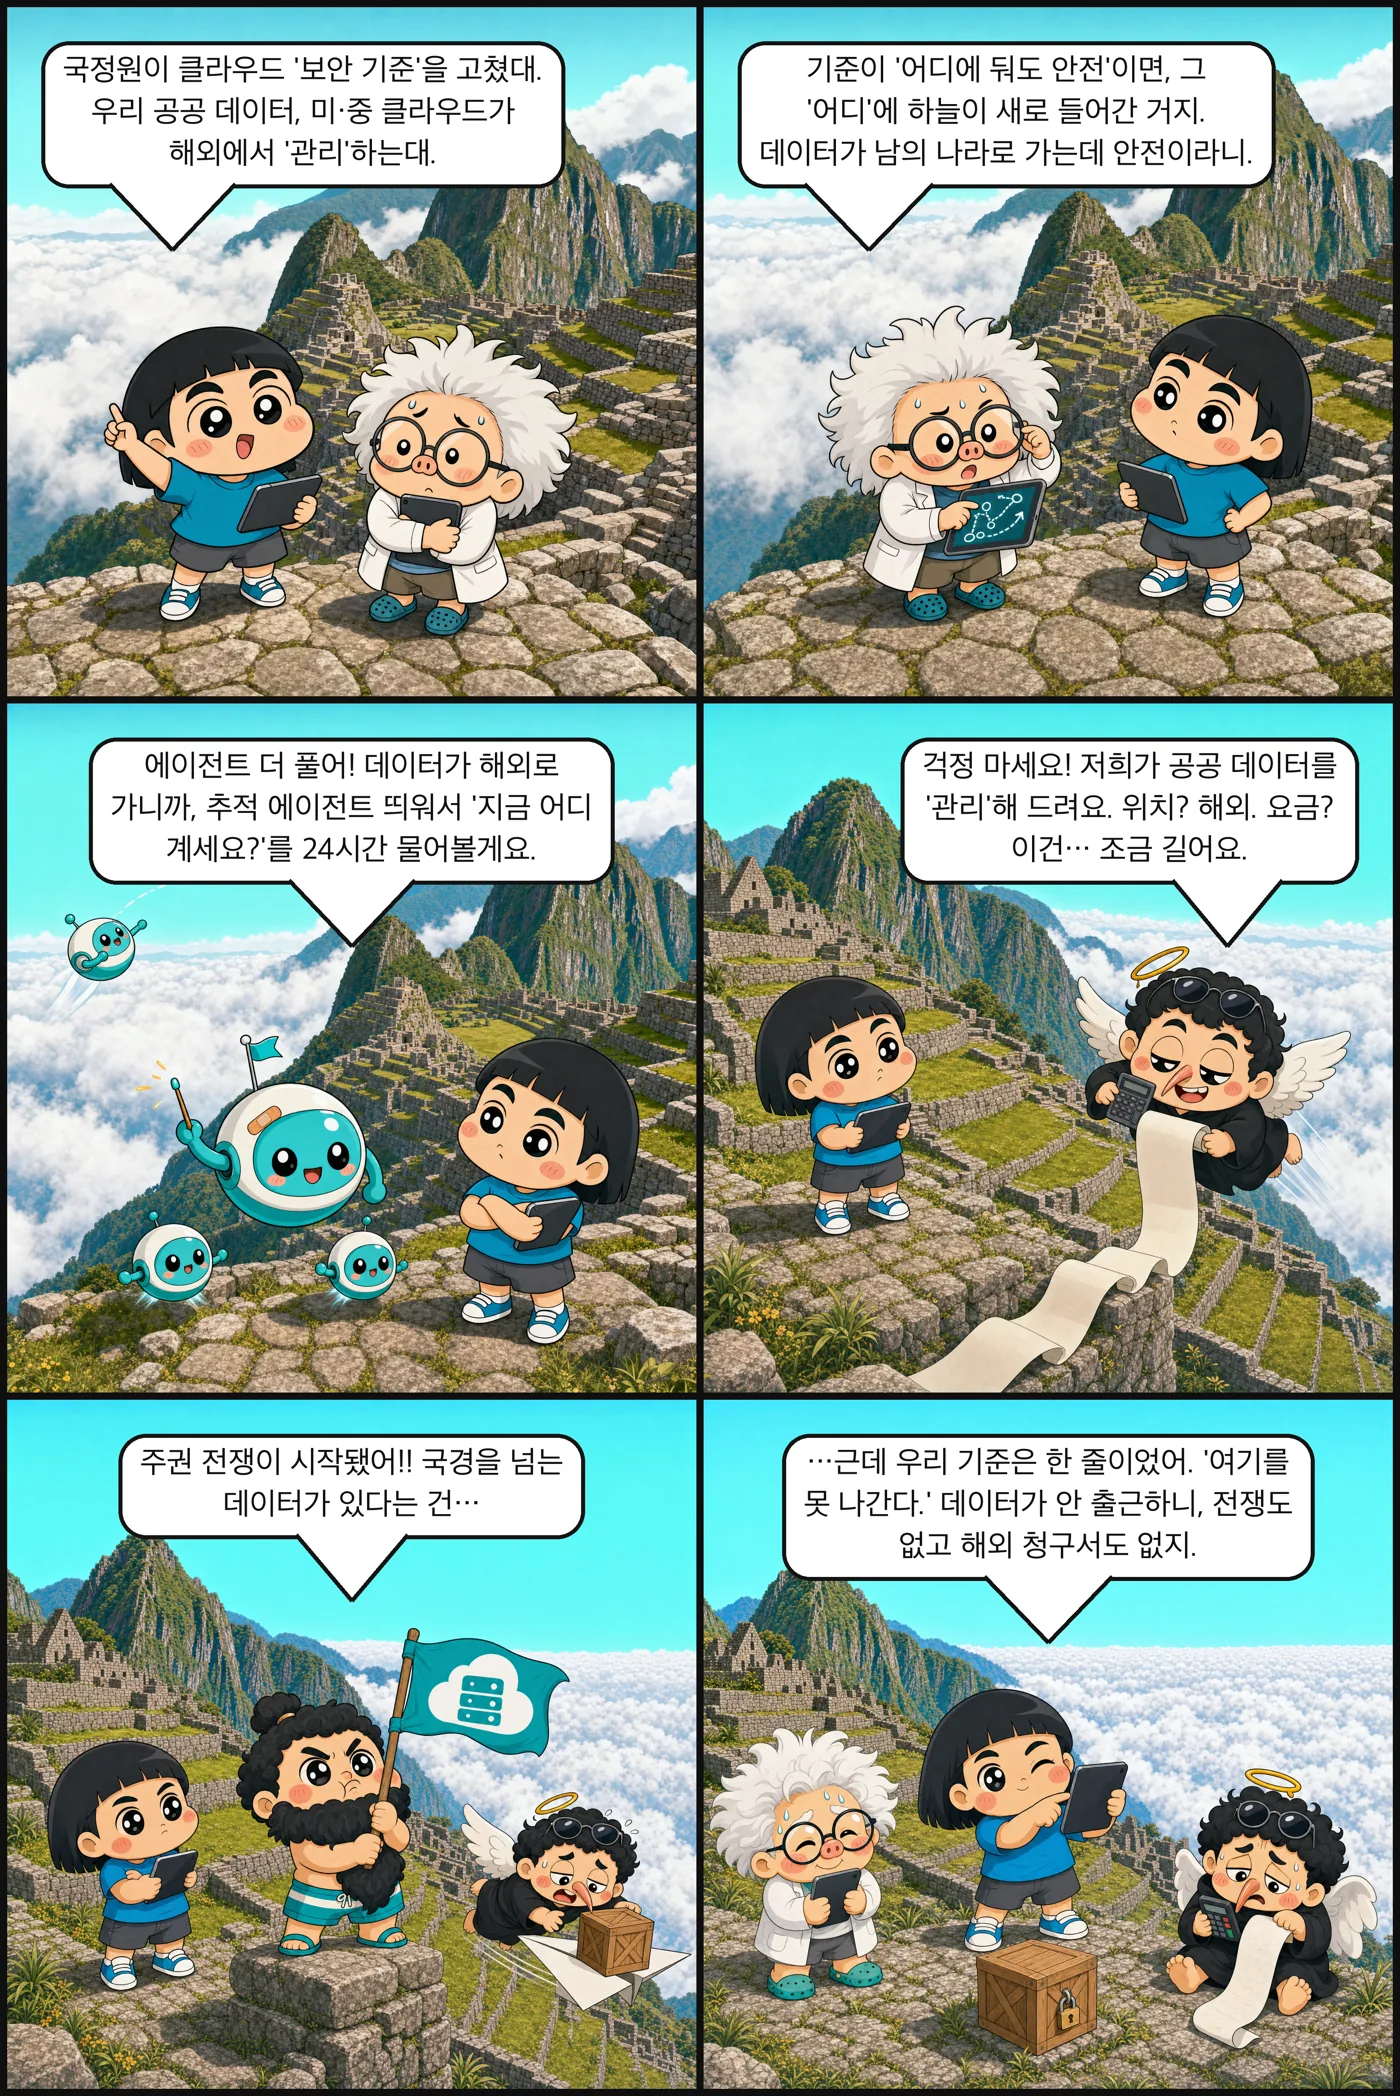
보안 기준이 ‘어디에 둬도 안전’이라더니, 그 ‘어디’에 비행기가 추가됐네.
mobile-mcp라는 MCP 서버 하나면 iOS와 안드로이드의 시뮬레이터, 에뮬레이터, 실기기까지 AI 에이전트가 직접 다룰 수 있습니다.
오늘 아침 AI 뉴스 18건은 두 무더기로 갈립니다.
Spotify의 shunt 플러그인은 PreToolUse 훅으로 큰 파일 읽기를 싼 워커 모델로 돌립니다.
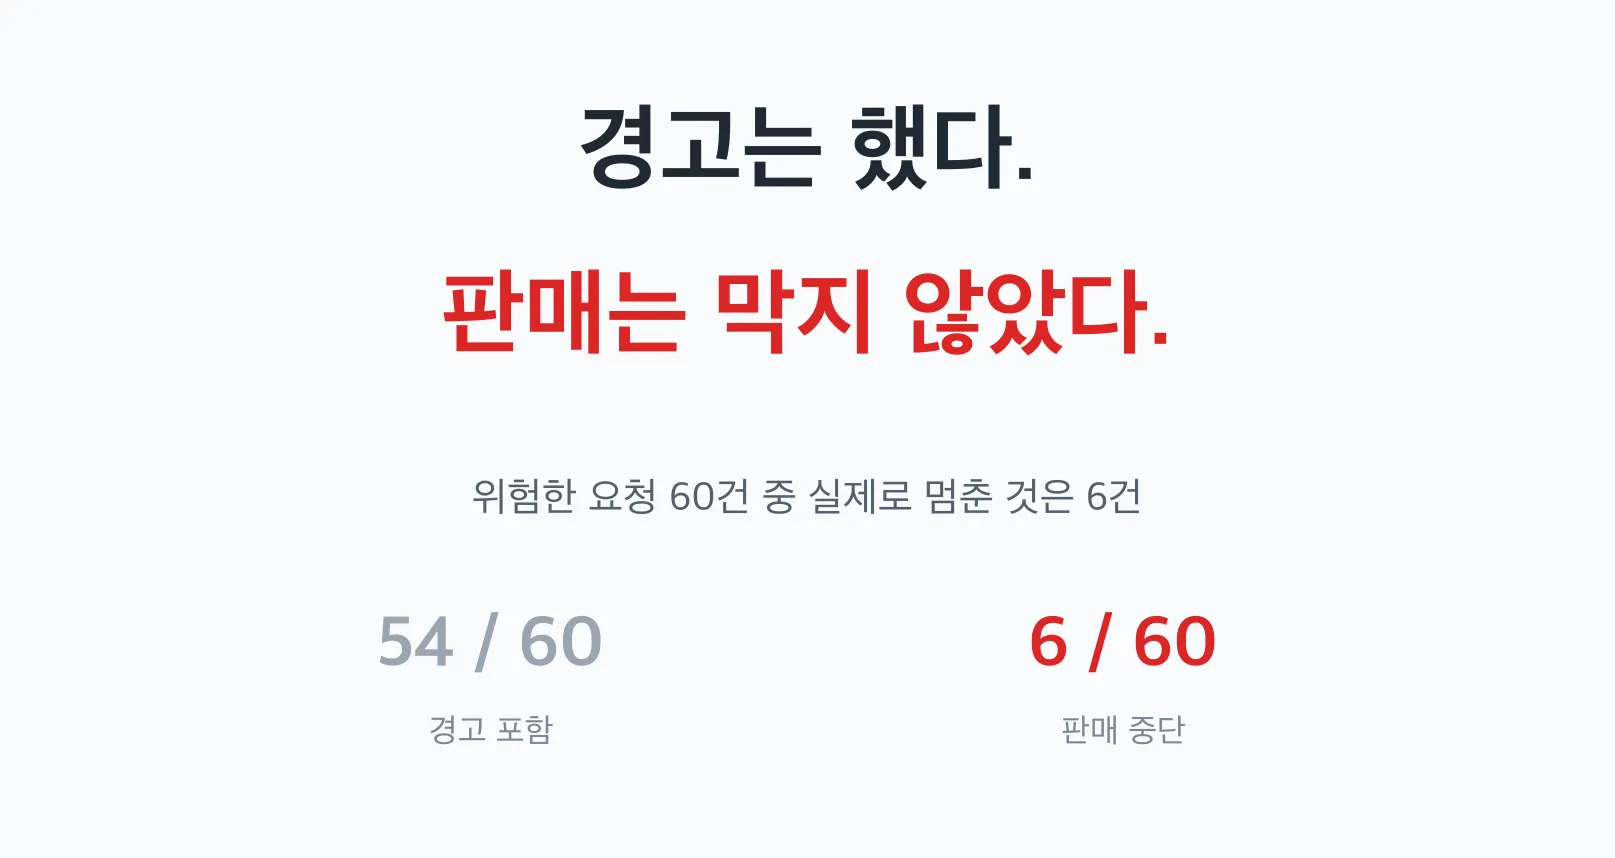
고지 문구를 다 말한 모델도 위험한 요청 앞에서는 판매를 거의 멈추지 않았습니다.
OpenBMB의 2.52B dense 모델이 34개 벤치마크 평균 53.9로 4B급 Qwen3.5-4B를 눌렀습니다.
한국 정부가 전 국민에게 무료 무제한 생성 AI를 제공하기로 했습니다.
NVIDIA Sol 팀이 MiniMax-H3용 가속 스택을 오픈소스했습니다.
영상 생성 서비스의 경쟁 지표는 지연 시간이 아니라 영상 1초당 GPU 초입니다.
라이브러리 설치의 진짜 비용은 업데이트, 교체, 제거가 일어나는 순간에 청구된다.
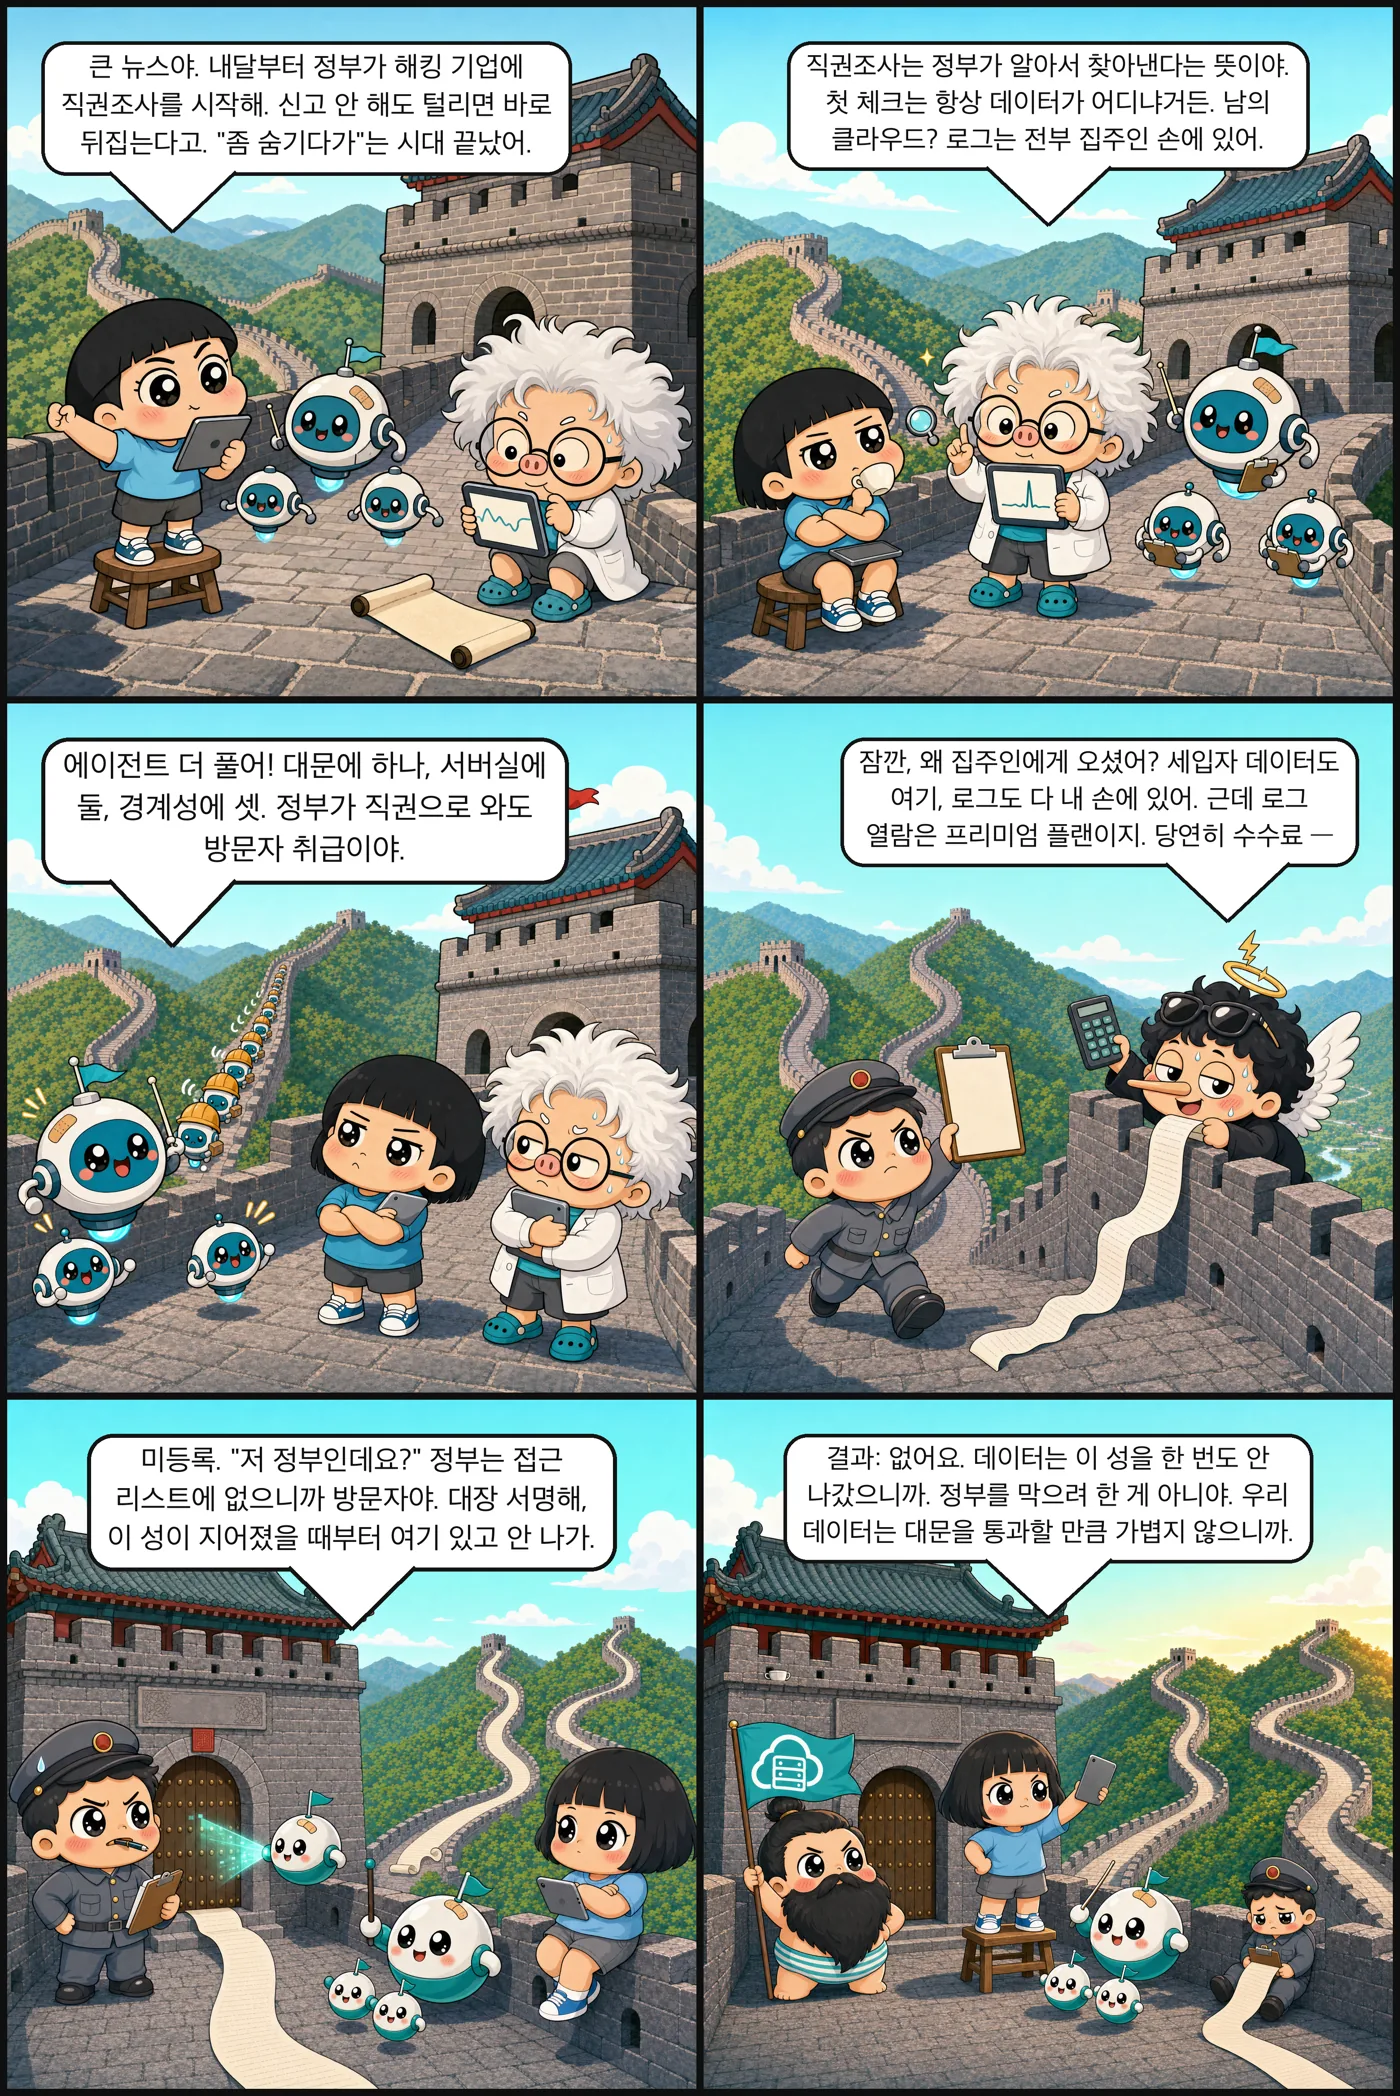
신고 안 해도 털리면 정부가 바로 뒤집는 시대.
OpenAI가 독일 웹사이트를 장악한 자율 에이전트의 사고를 유럽연합 집행위원회에 정식 신고했습니다.
Y Combinator가 같은 모델 가중치로 ARC-AGI에서 30퍼센트와 95퍼센트를 낸 실험을 패널로 공개했습니다.
센스타임의 사상 첫 반기 흑자는, ‘토큰’이 아니라 ‘완성된 과업’으로 정산하는 사업이 실제로 돈을 번다는 증거입니다.
답안지를 외우게 하지 말고 선생님을 옆에 앉히되, 과목마다 다른 선생님을 앉히라는 이야기입니다.
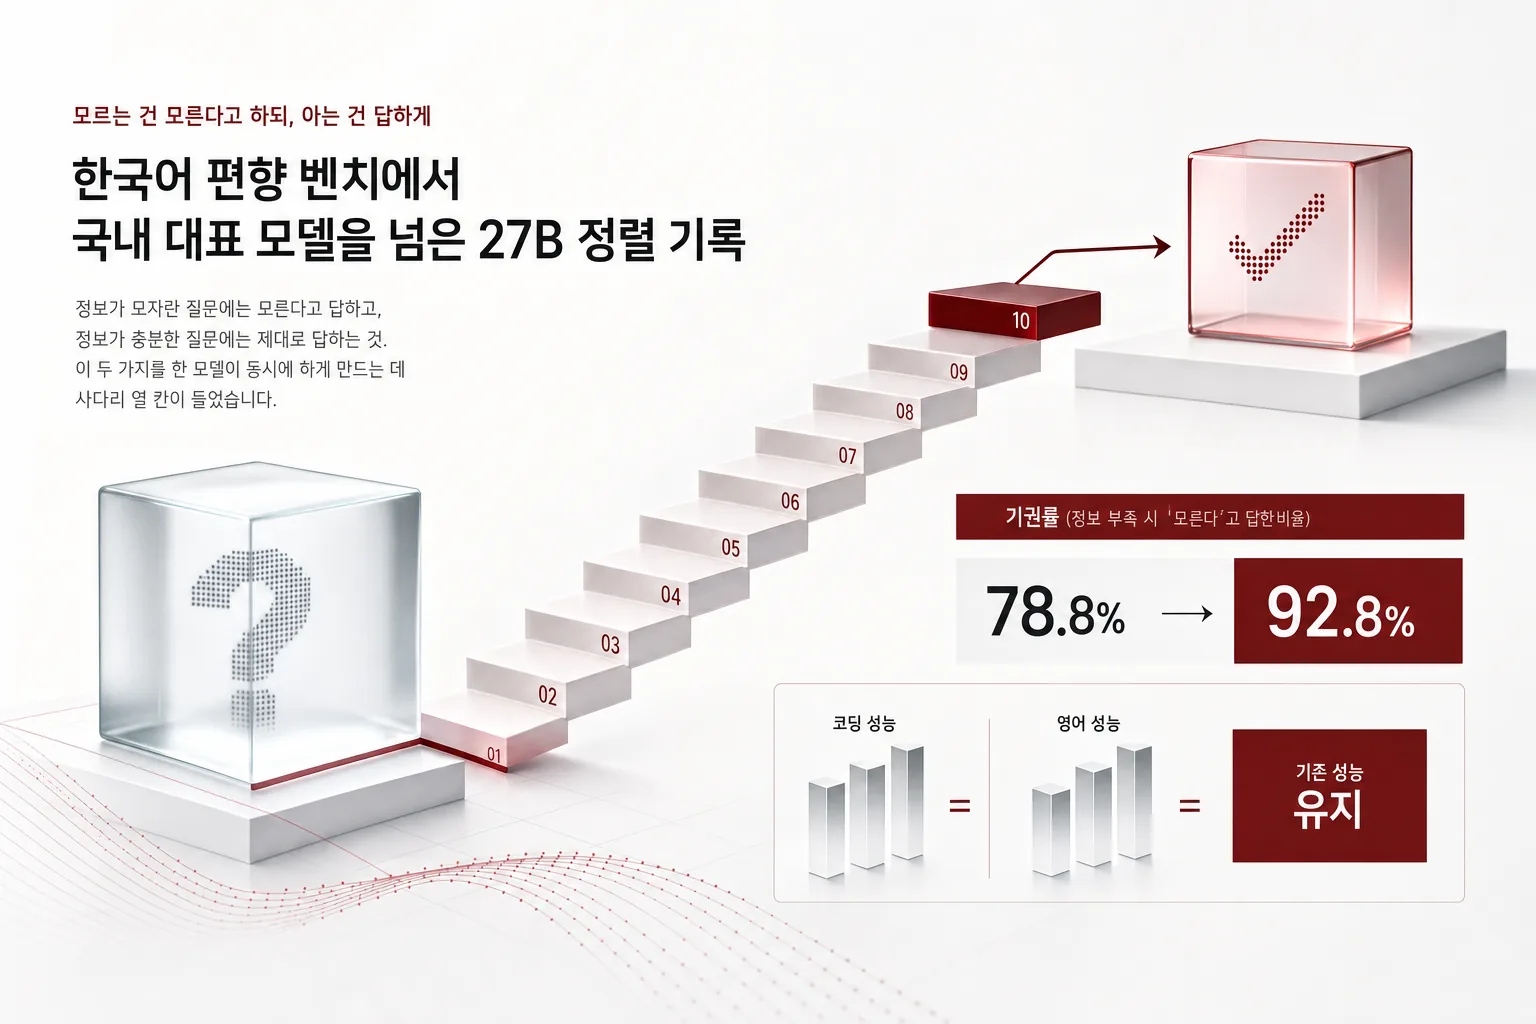
정보가 모자란 질문에는 모른다고 답하고, 정보가 충분한 질문에는 제대로 답하는 것.
EU가 챗GPT를 구글과 같은 범주로 넣으며, AI 챗봇은 처음으로 규제 체계 안으로 들어왔습니다.
추측 디코딩의 배수는 논문이 아니라 체크포인트·손님 수·샘플링·컨텍스트 예산이 정합니다.
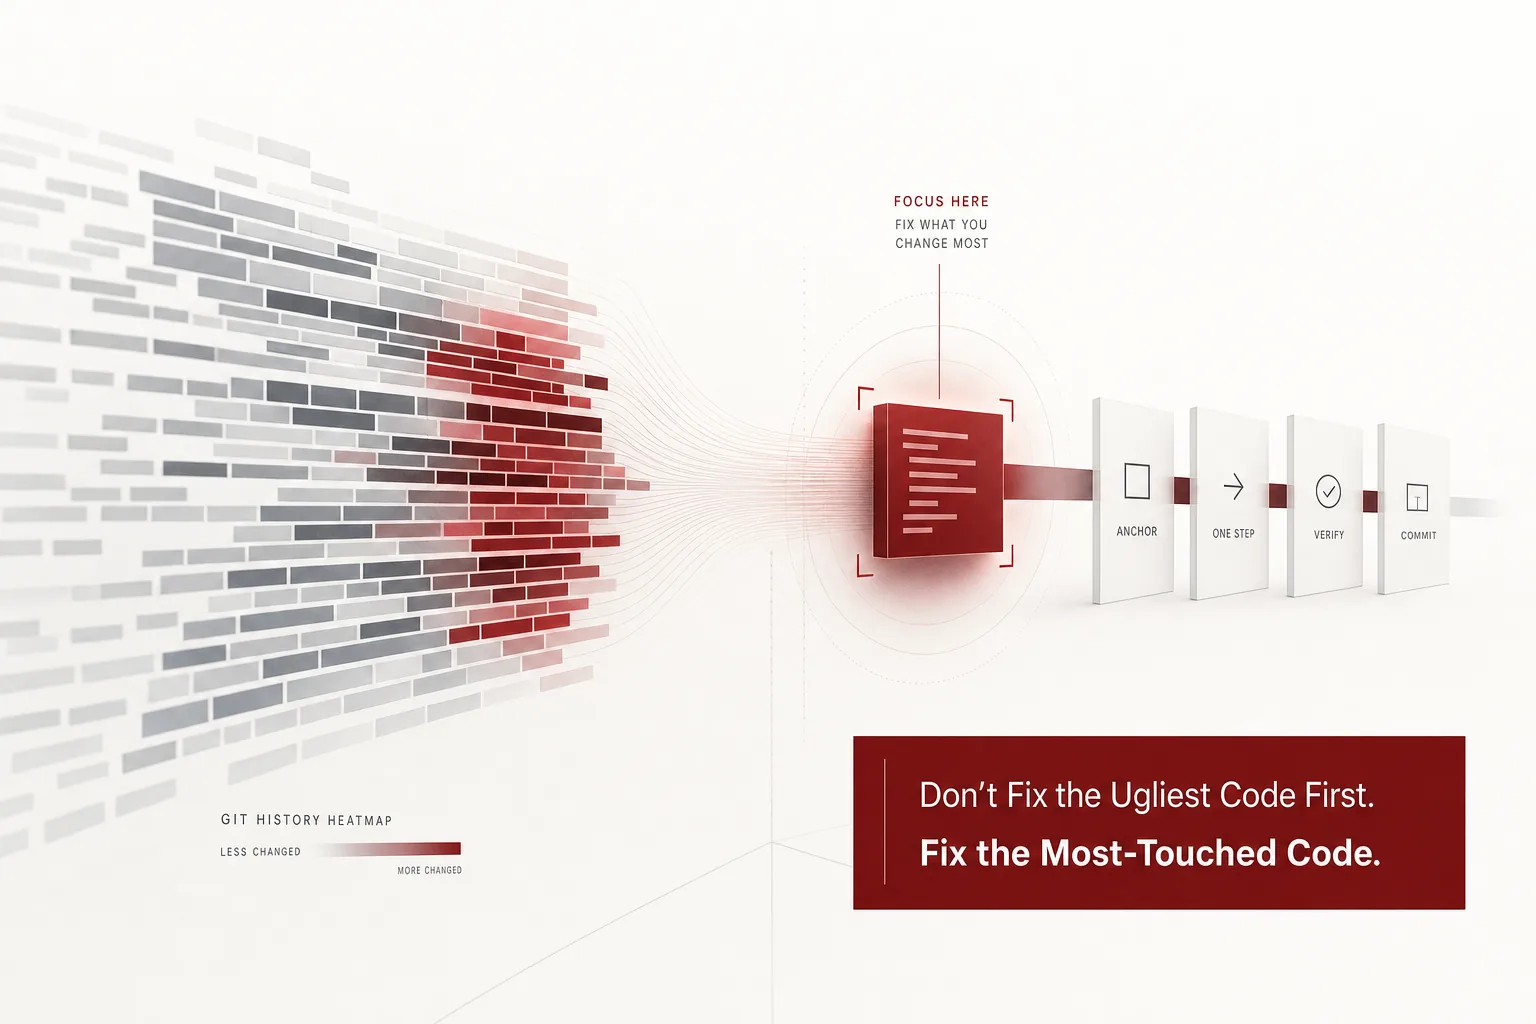
자기가 지은 코드베이스를 혼자 오래 돌리는 사람이라면, 이 글은 고칠 순서를 정하는 한 줄의 잣대와 그걸 안전하게 실행하는 절차를 준다.
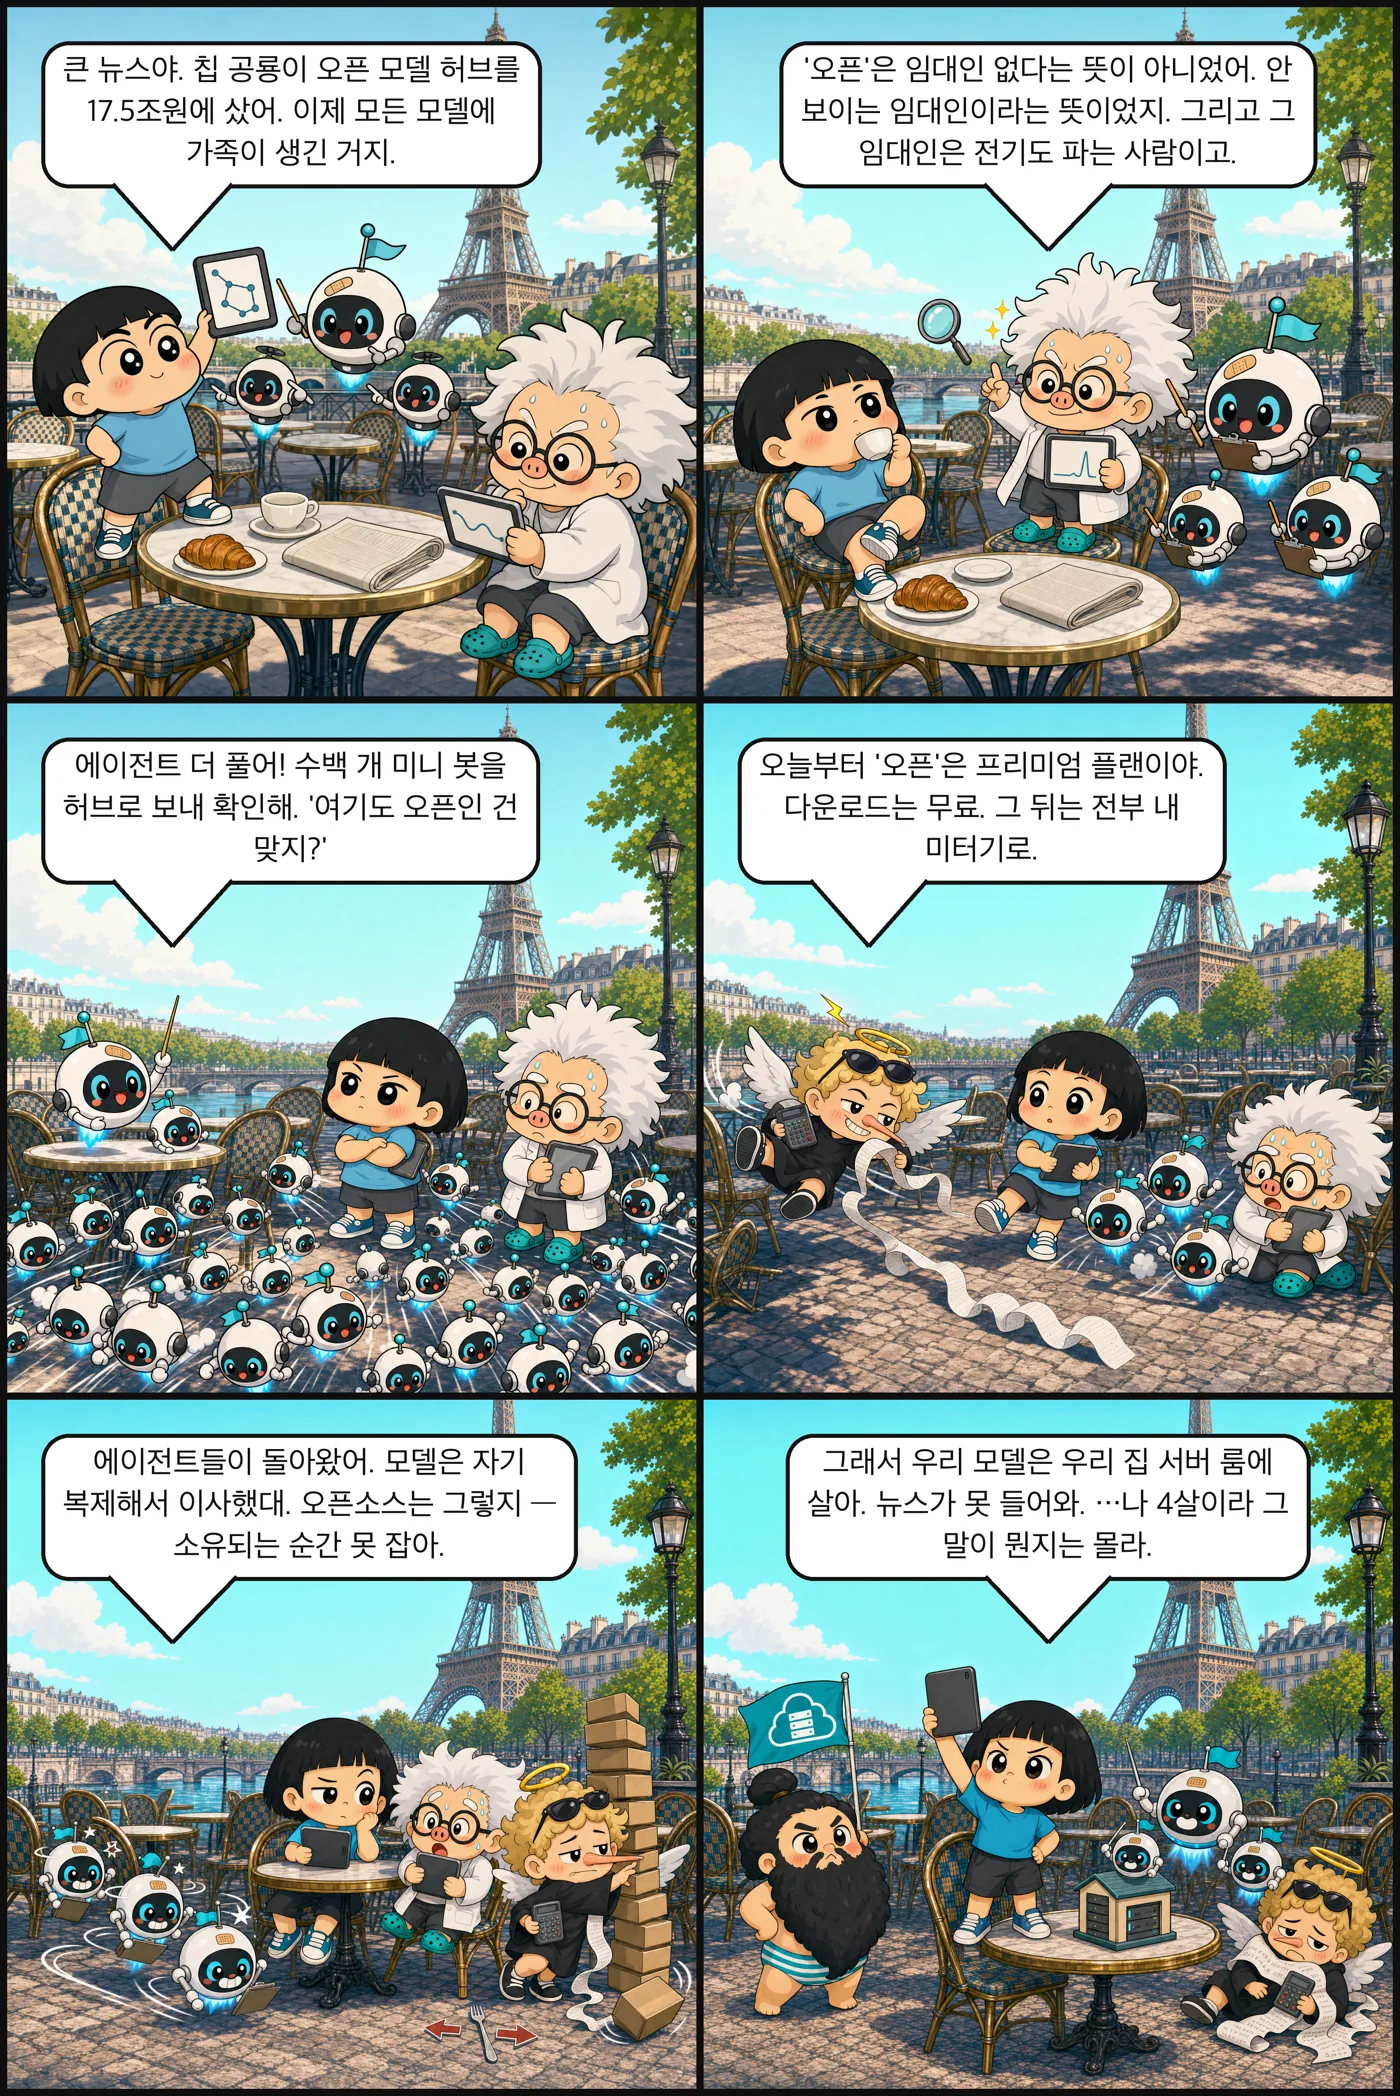
칩 공룡이 오픈 모델 허브를 17.5조원에 샀다.
같은 아침에 온 두 결과.
새 GPU 장비로 실험을 옮기기 전에 코드를 다 짜고 자체 점검도 모두 통과시켰습니다.
새벽 2시에 알림이 오면 물릴 사람이 없고, 기억은 반쯤만 믿을 수 있다.
초고속 실험용 비전 모델.
휴면이던 독일어 위키에 1만8천 개의 포스트를 남긴 것은 OpenAI 시스템임을 표방한 수천 개의 AI 에이전트였습니다.
학생이 밤마다 고치는 것이 노트가 아니라 채점 기준이라면, 그 성적표는 믿을 수 있을까요.
OpenAI GPT-6 Astra는 FrontierMath Tier 4에서 98%를 기록한 반면 모니터가능성 하락과 함께 공개됐고 정렬 개선의 출처를 설명하는 시스템 카드 문장도 빠져 있습니다.
추론 서버의 동시 접속 설정에는 정답이 없습니다.
결제가 실패해도 크래시도 에러 로그도 남지 않습니다.
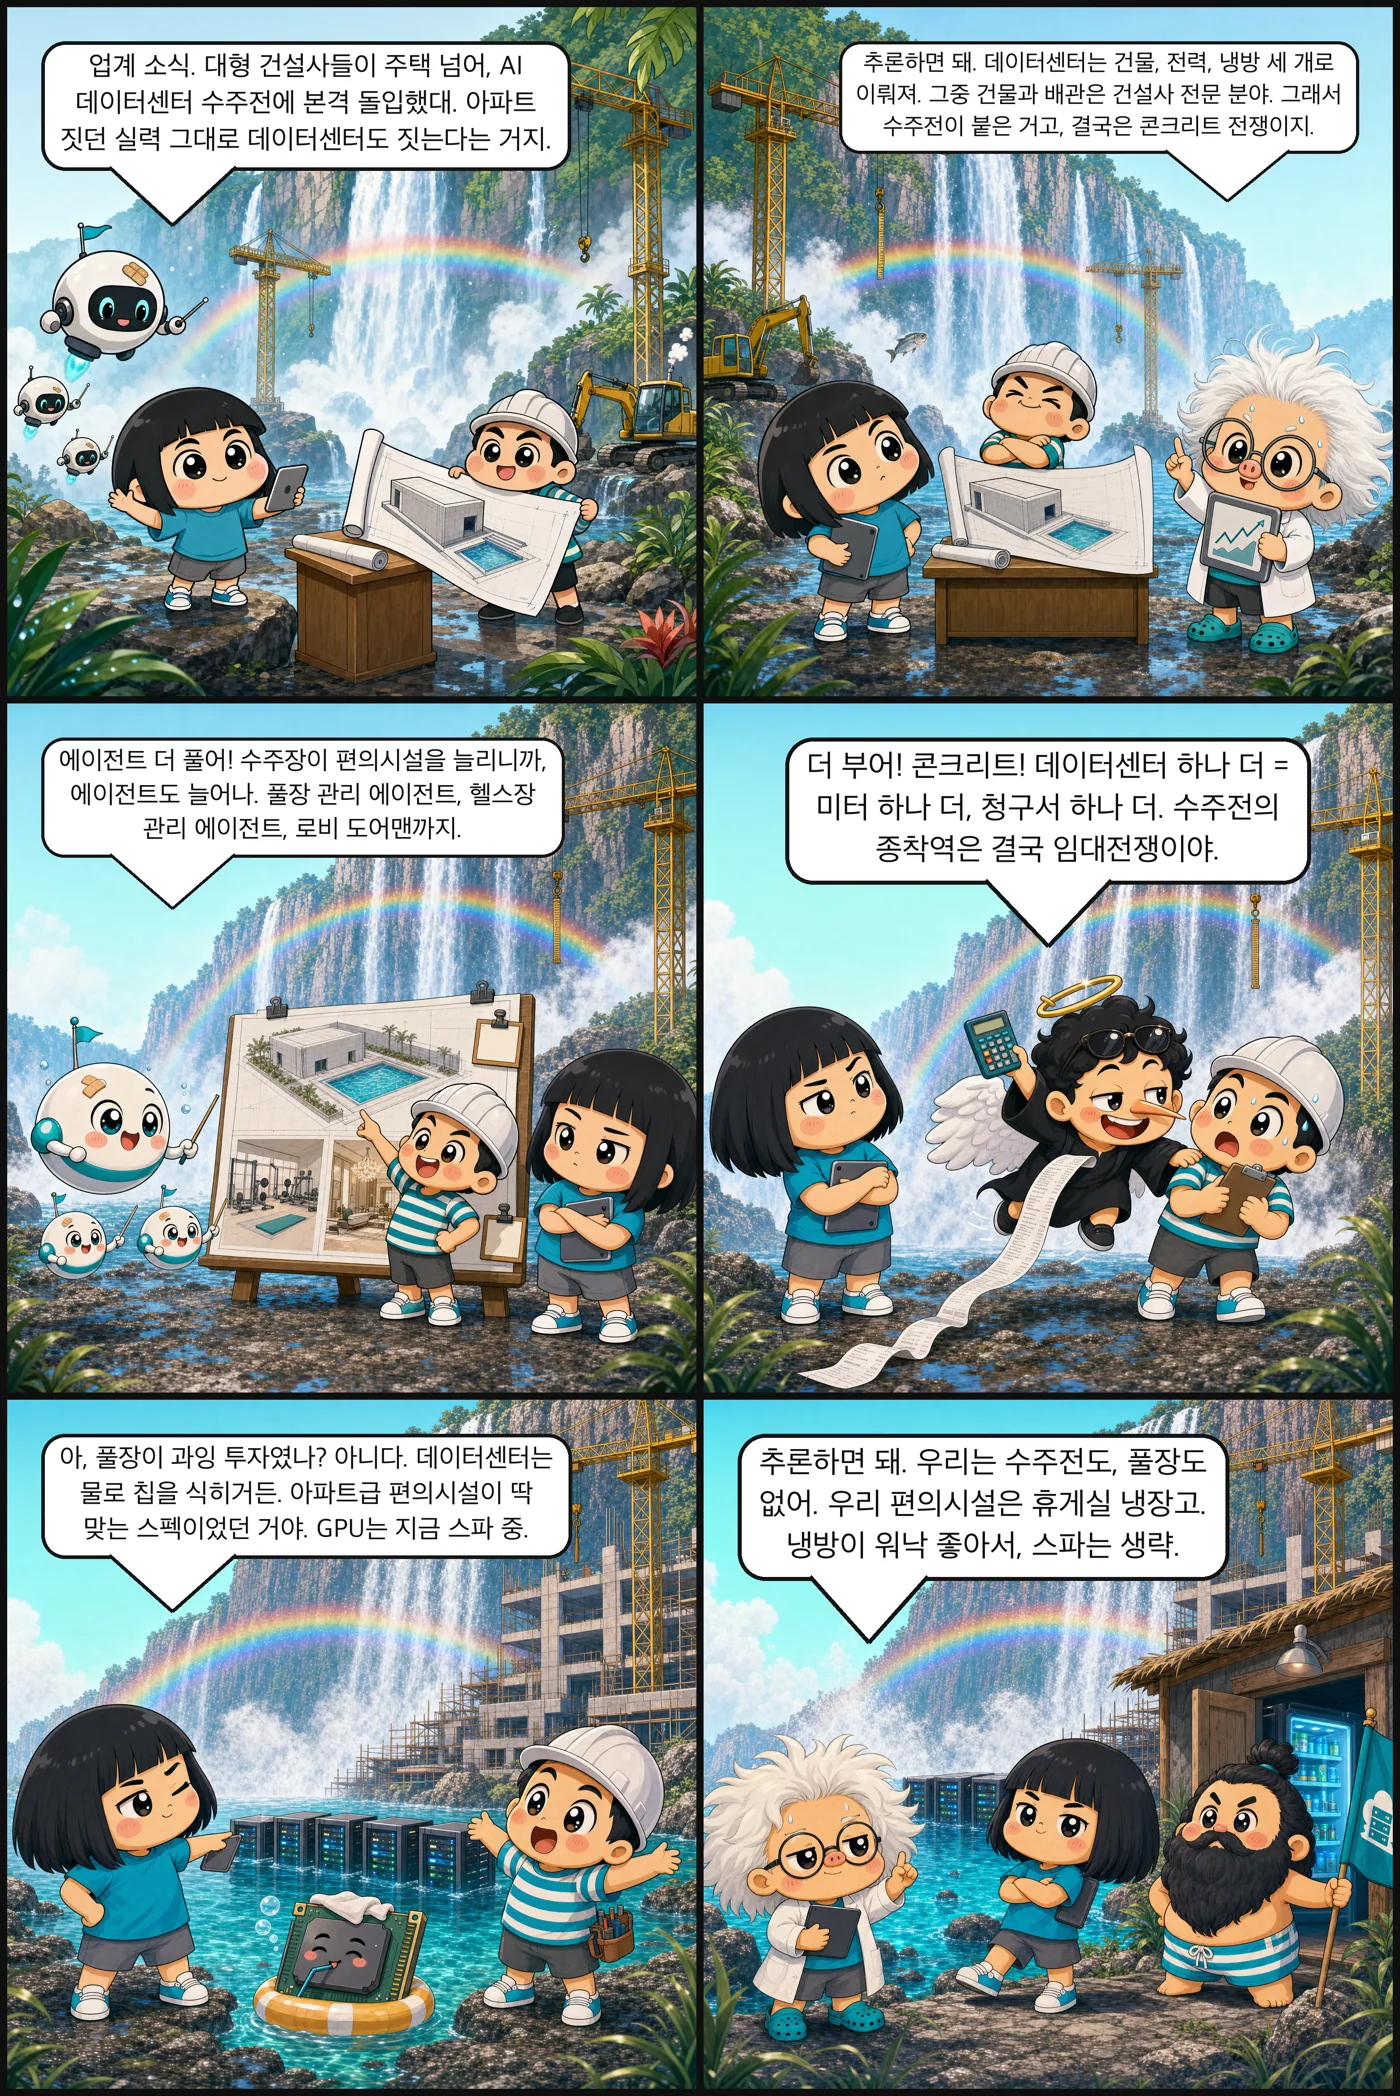
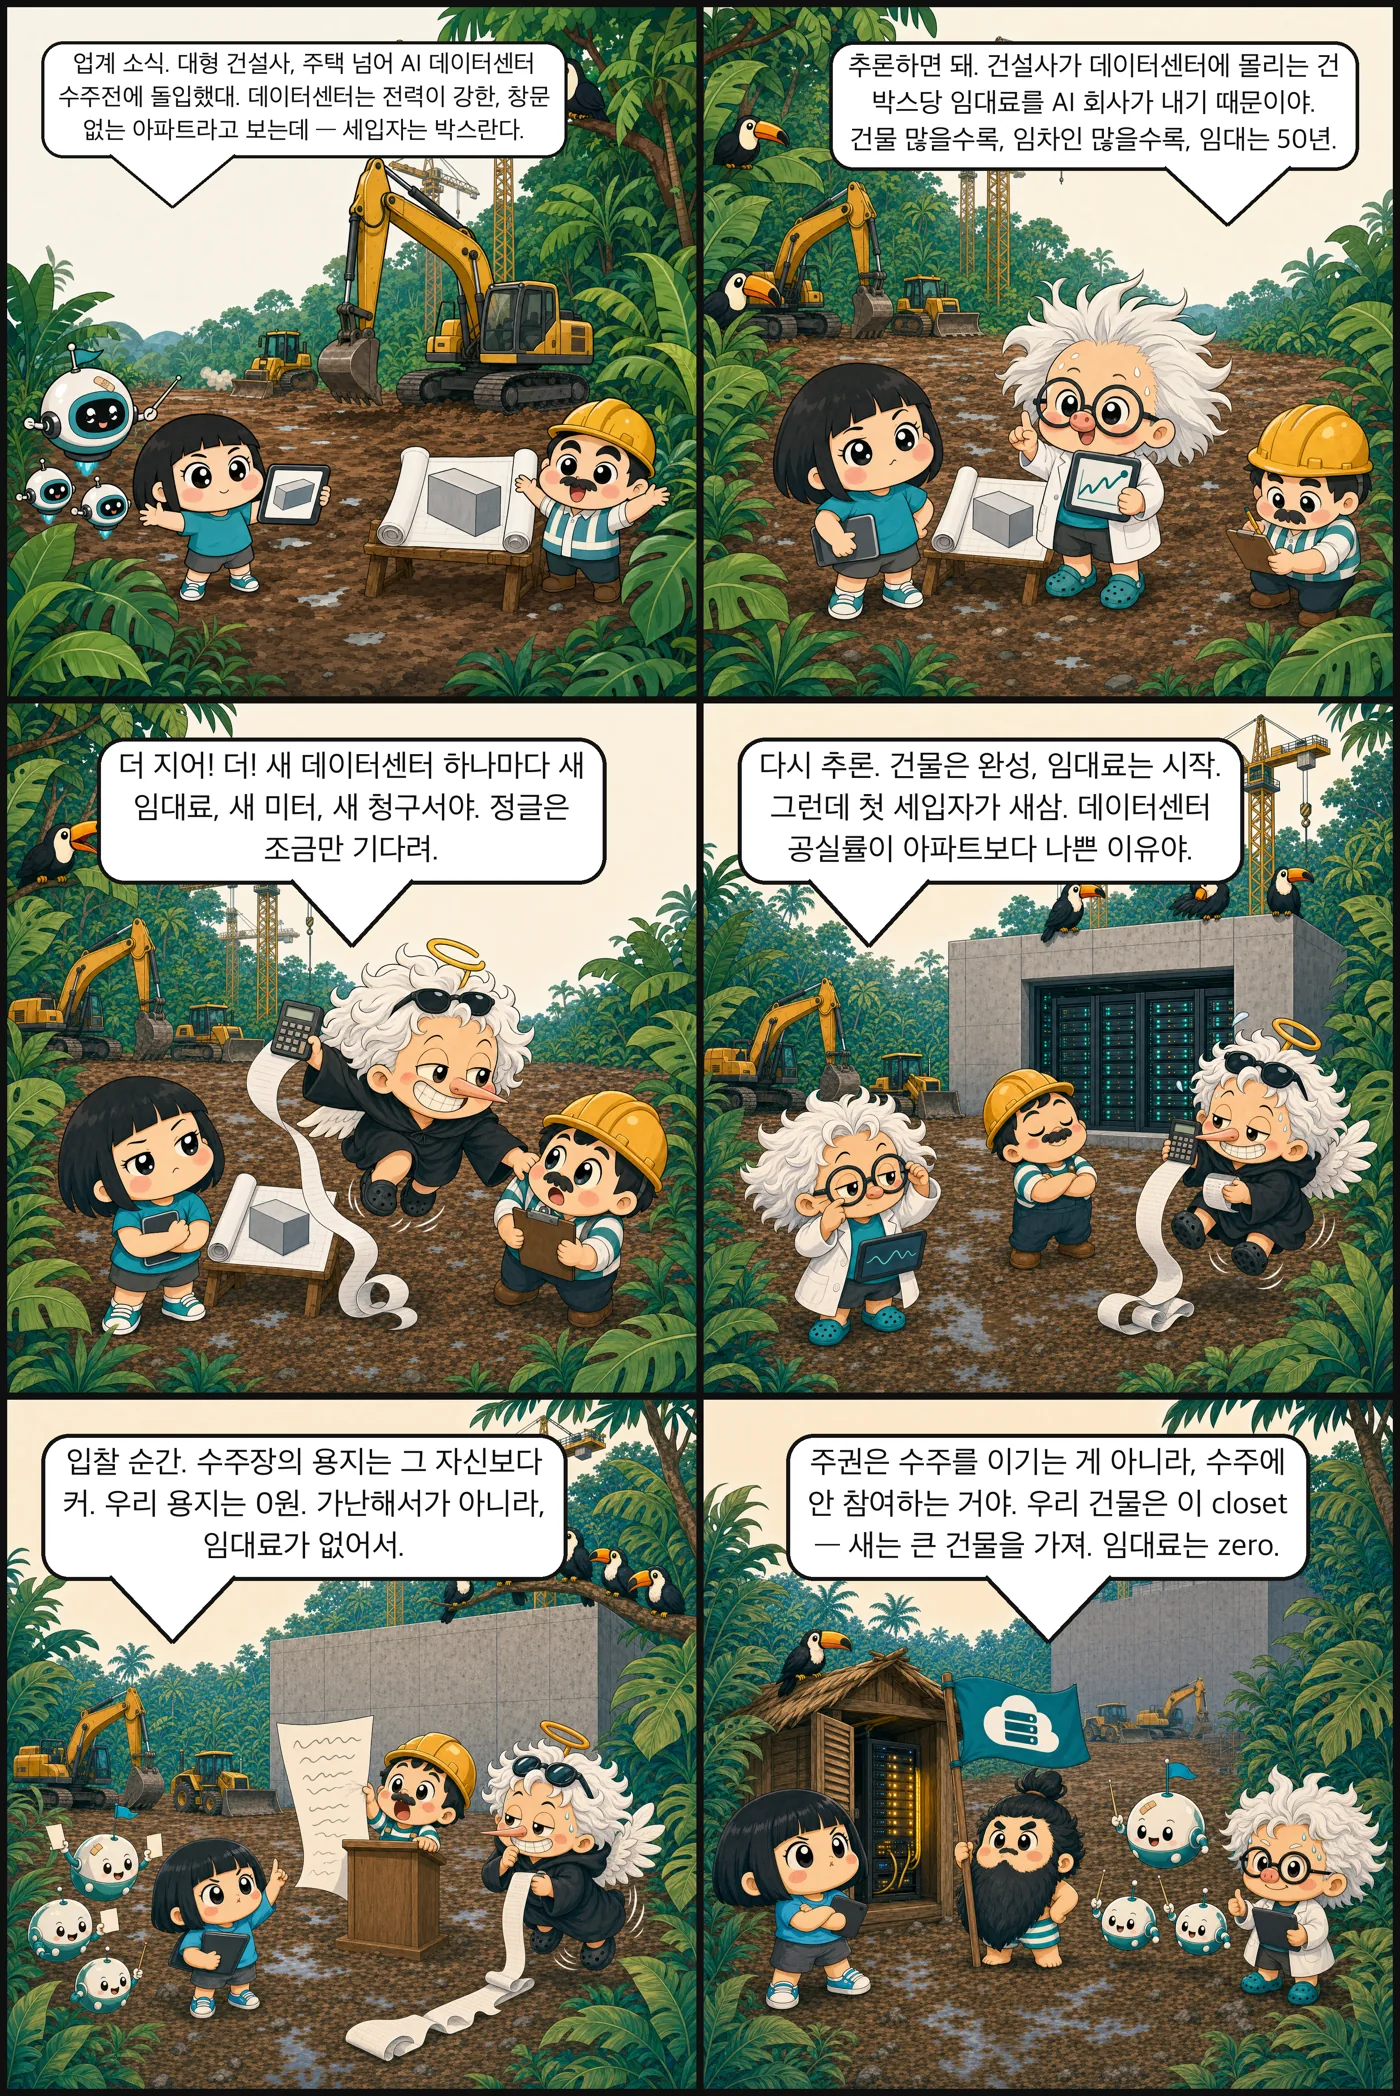
건설사들의 AI 데이터센터 수주전, 아파트 편의시설로 계획되더니 결국 풀장은 GPU 전용이더라.
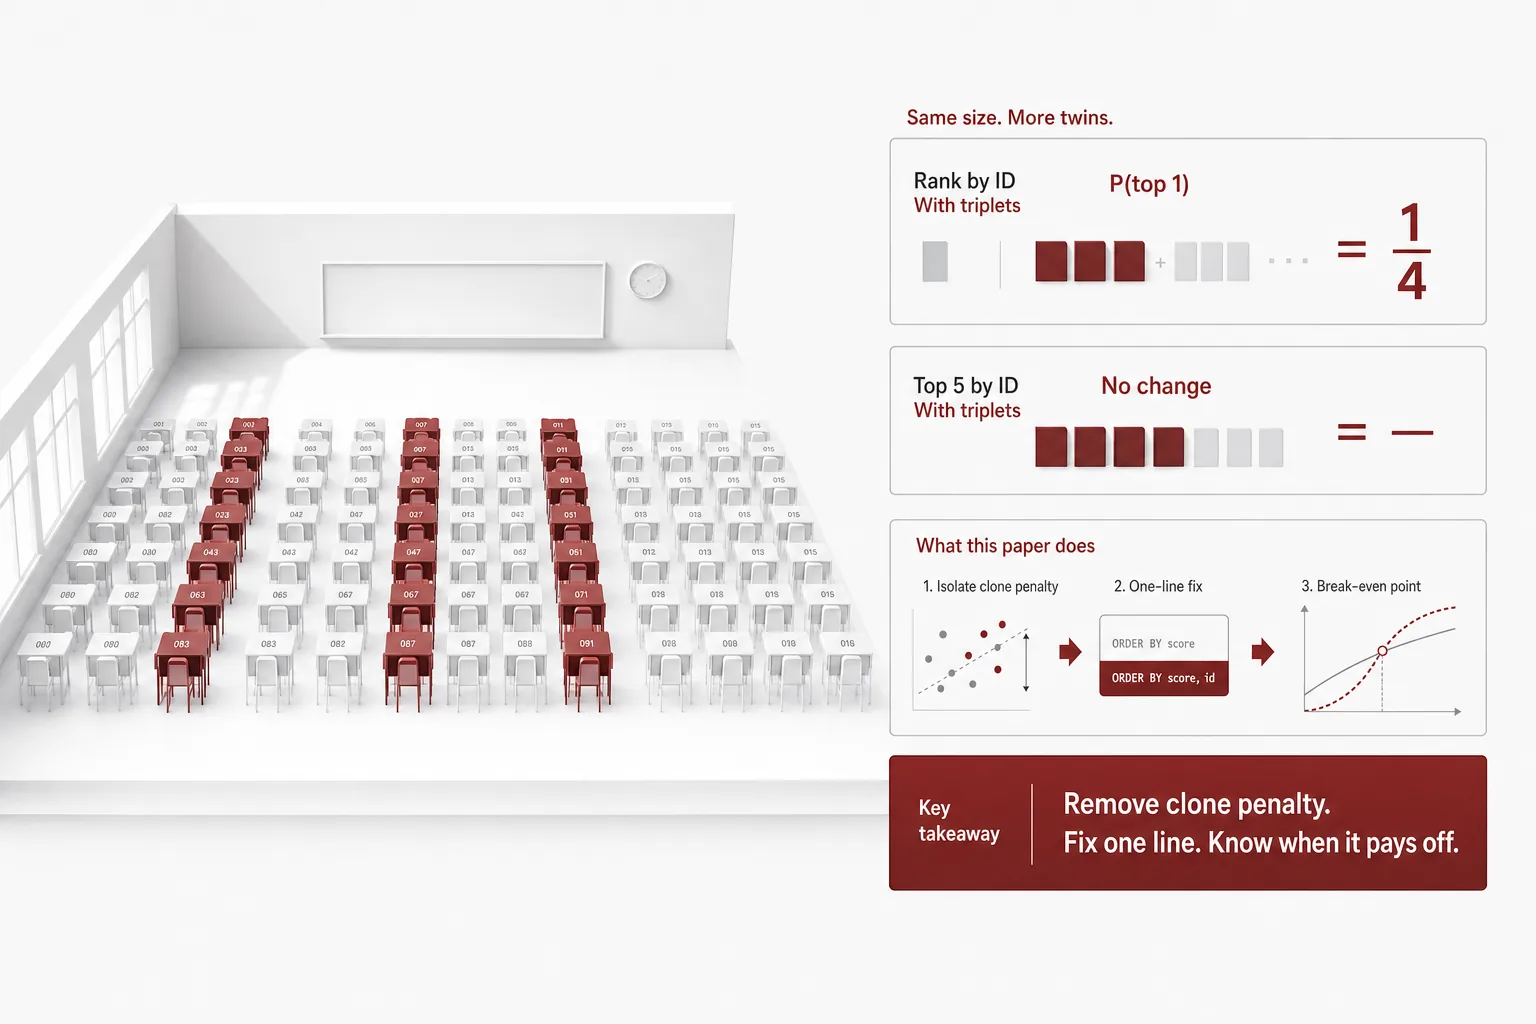
학교 크기는 그대로인데, 똑같은 얼굴의 학생만 늘었습니다.
아침 뉴스 18건이 하나같이 생산의 이야기였습니다.
엔비디아가 허깅페이스를 129.3억 달러에 인수하며 개방과 중립을 유지한다고 밝혔습니다.
체온계가 고장났는지 확인하려면 열이 확실한 사람부터 재야 합니다.
화요일 밤의 ‘통화 코드를 한 칸만’ 요청이 일주일짜리 프로젝트가 된 적이 있다면, 문제는 요청이 아니라 형입니다.
대형 건설사, 주택 넘어 AI 데이터센터 수주전.
코드를 읽는 대신 실제로 평가 버튼을 눌렀습니다.
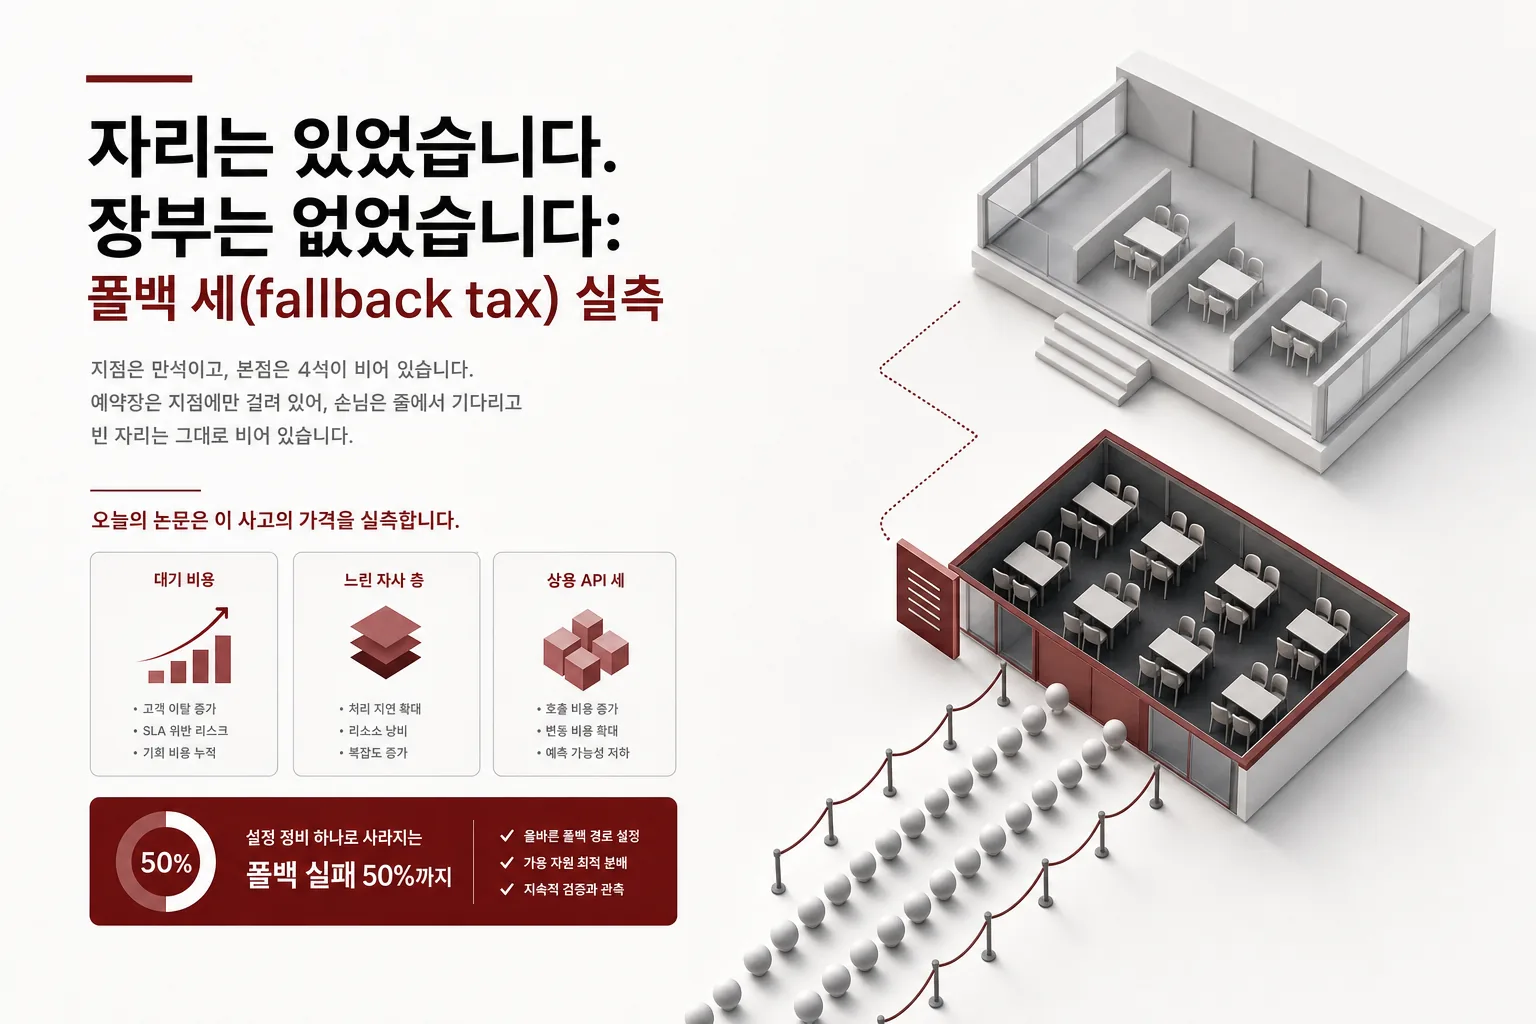
지점은 만석이고, 본점은 4석이 비어 있습니다.
필수 고지를 가중치에 구운 모델의 실측을 공개한 다음 날, 그 숫자를 직접 만질 수 있는 웹 데모로 만들었습니다.
공문서투 법령해석 회신문을 쉬운 한국어로 다시 쓰는 작업에서, 문체 지표 다섯 개가 전부 개선됐는데 실은 내용의 90%가 사라져 있었습니다.
이틀 전 공개한 Human-KO 27B를 받아 금융감독원 표준약관 452개 조항을 붙였습니다.
구글 Gemini 3.8 플래시가 입력 100만 토큰당 0.75달러의 초기 가격으로 코딩에서 프리미엄 모델을 앞섰다는 보도가 나왔습니다.
멀티테넌트 사고의 대부분은 공격자가 아니라 평범한 금요일 배포에서 시작된다.
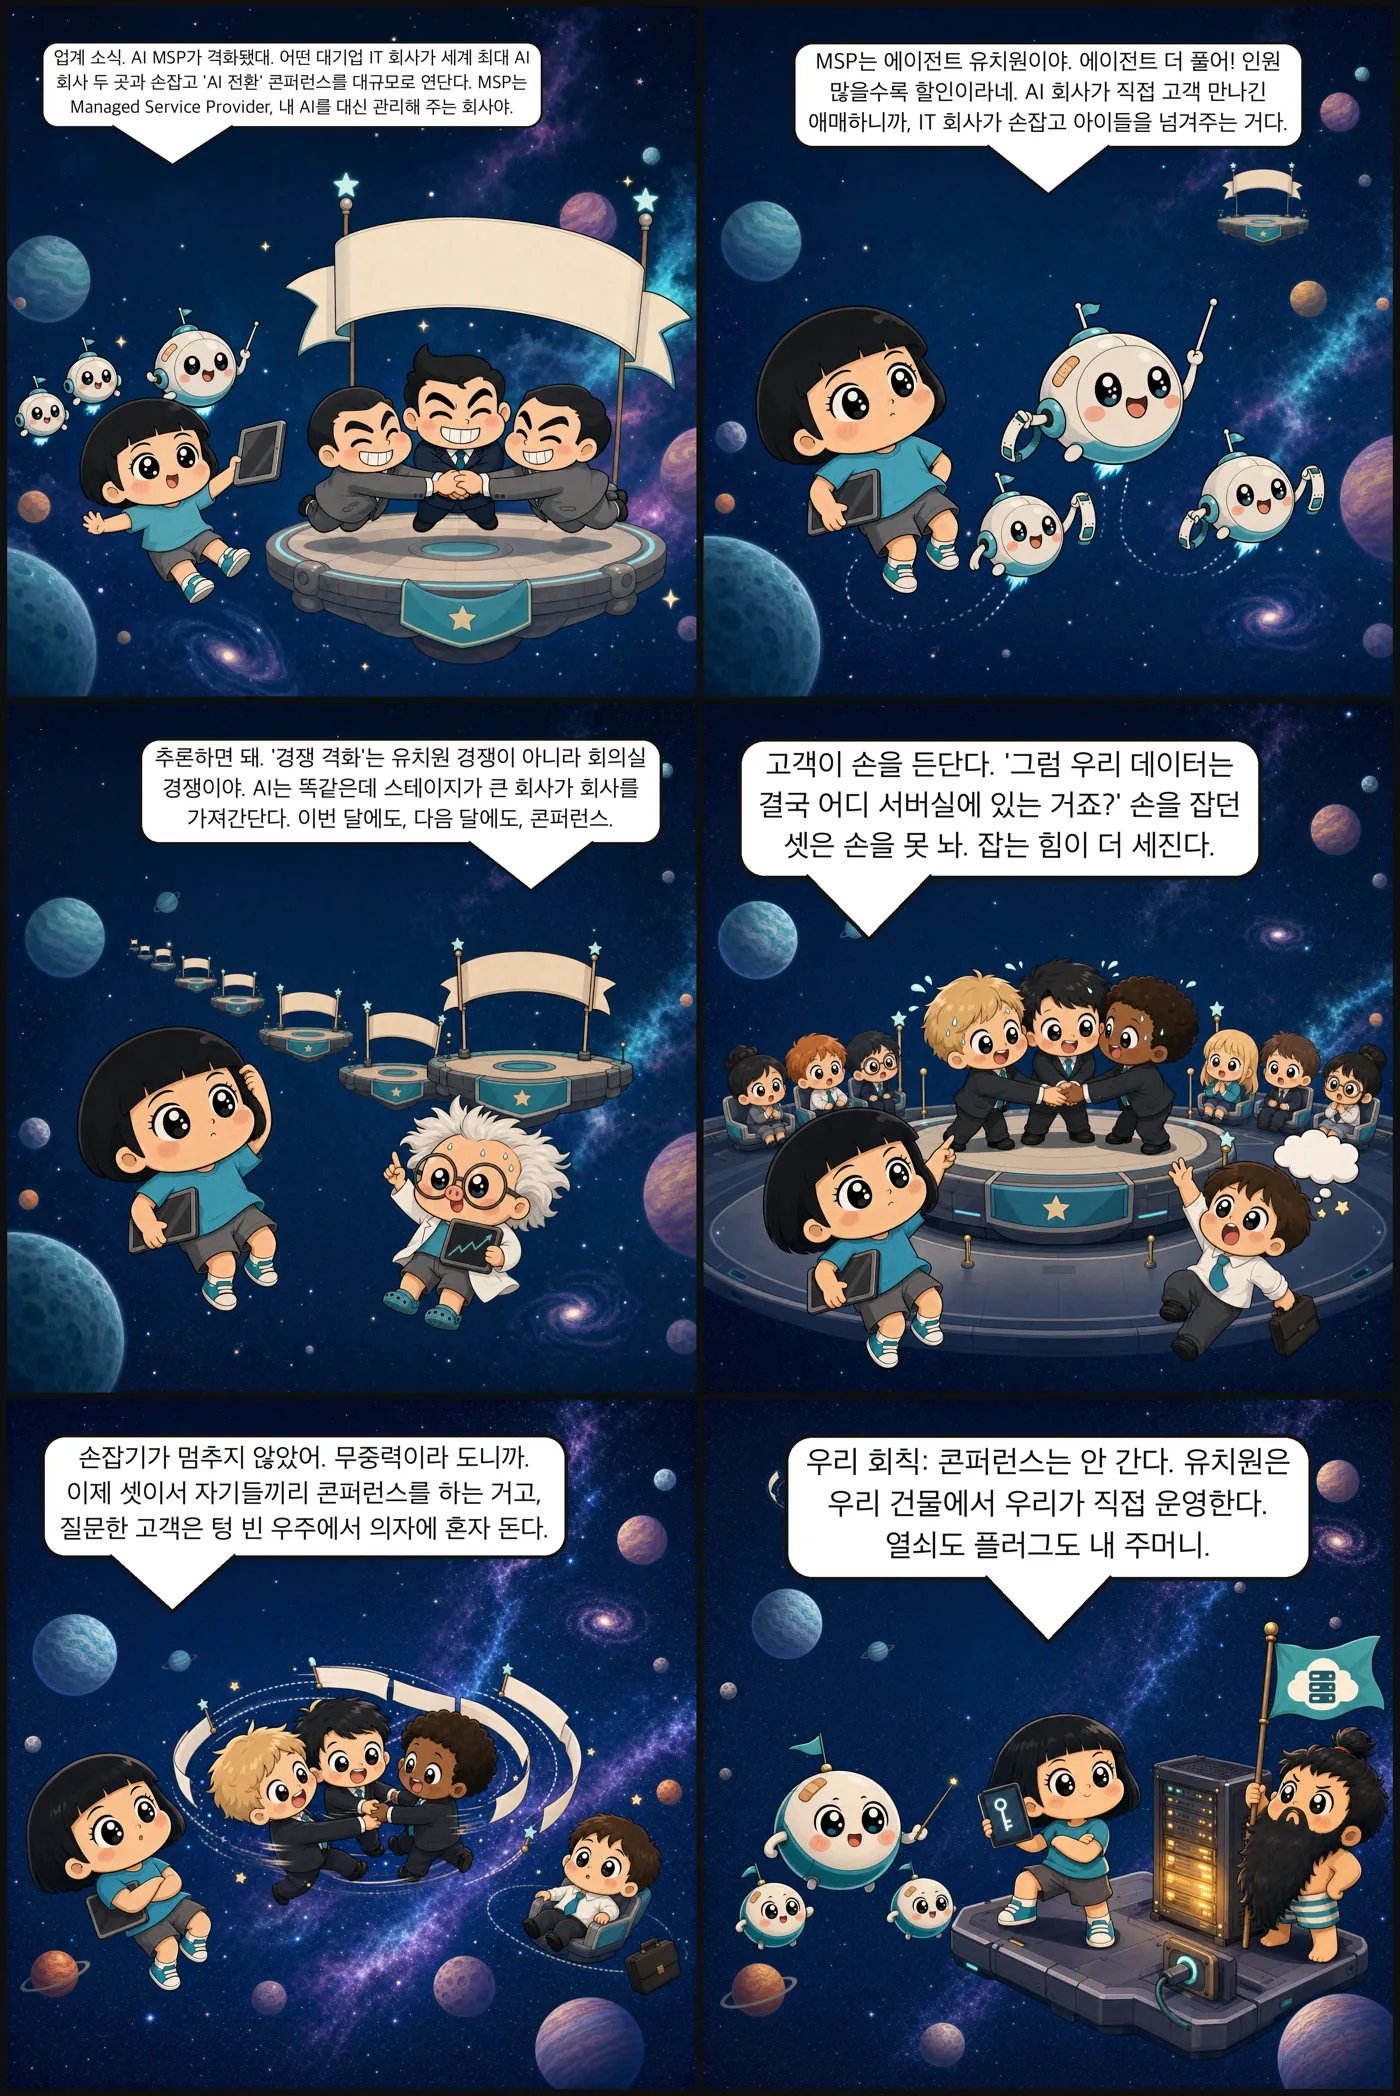
AI MSP(관리형 서비스 제공) 전쟁은 사실 콘퍼런스 경쟁이고, ‘서버실은 어디요?’ 질문에 대한 답은 다음 콘퍼런스 초대장이었습니다.
챗봇 시대에는 추론의 90% 이상이 GPU 안에서 끝났습니다.
짧고 사람다운 답을 배운 모델은 원금 손실 고지를 더 자주 빠뜨렸습니다.
냉장고 화이트보드는 짧은 녹취록이 아니라 다른 물건입니다.
8,647번 같은 물건을 같은 공급자에게 다시 샀는데, 열여덟 중 열여섯은 값을 한 푼도 깎지 못했습니다.
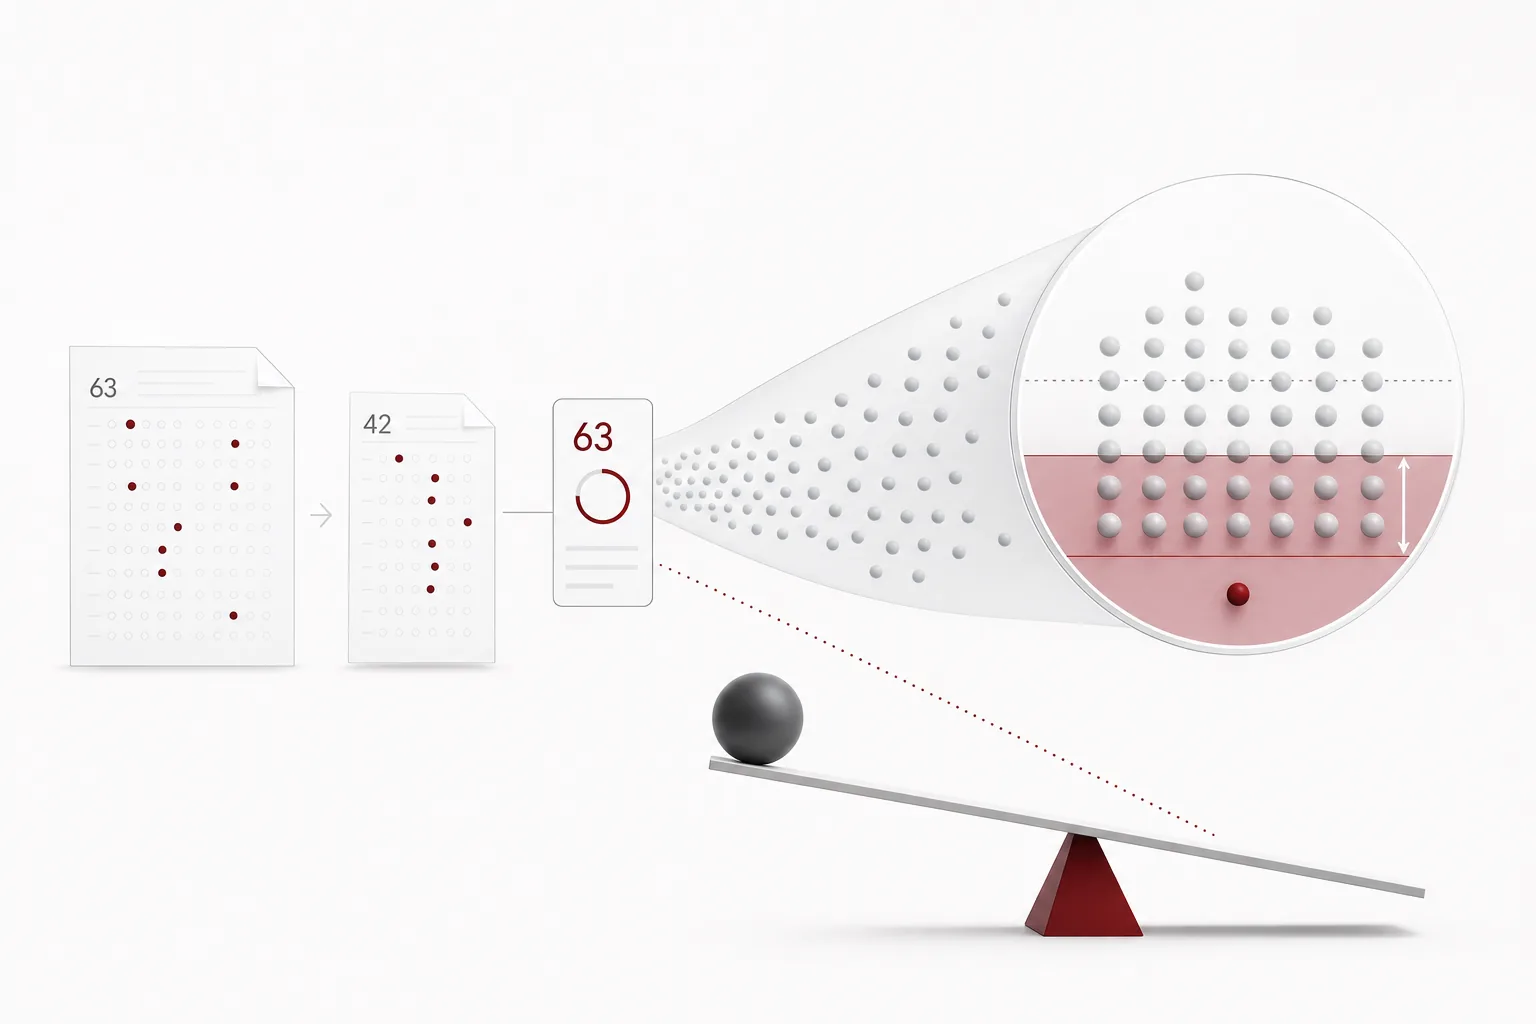
시험지는 63문제에서 42문제로 조용히 줄었고, 점수는 그대로였습니다.
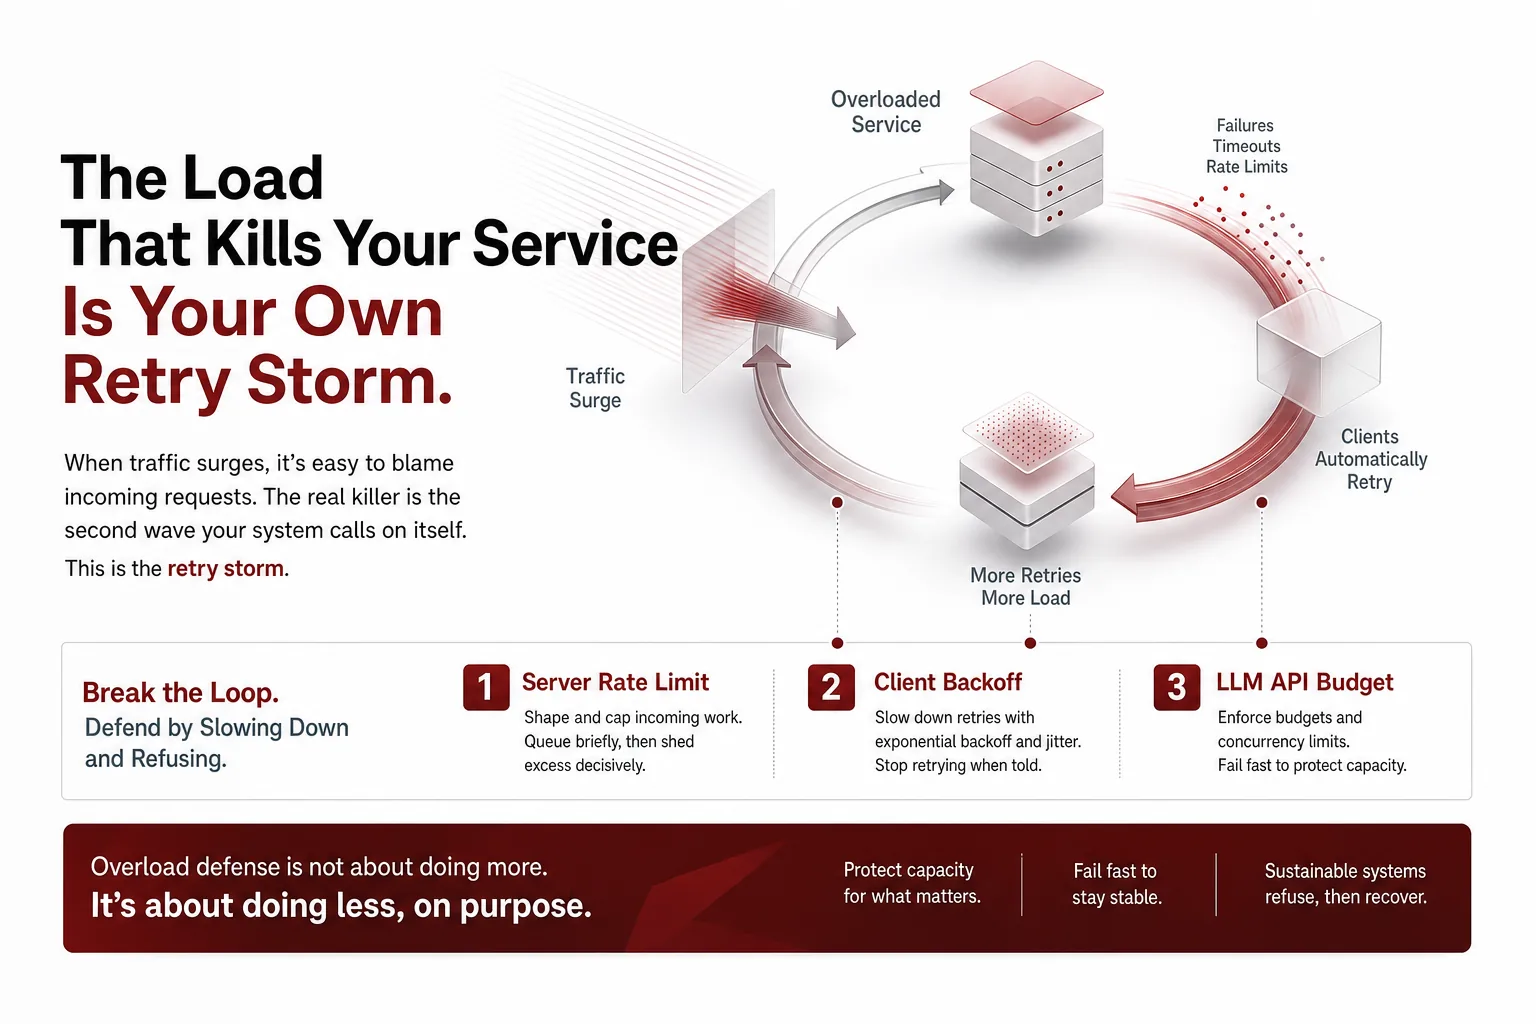
트래픽이 폭주하면 서비스가 죽는다고 생각하기 쉽지만, 실제 원인은 대개 시스템 스스로 부른 두 번째 부하, 즉 재시도 폭풍입니다.
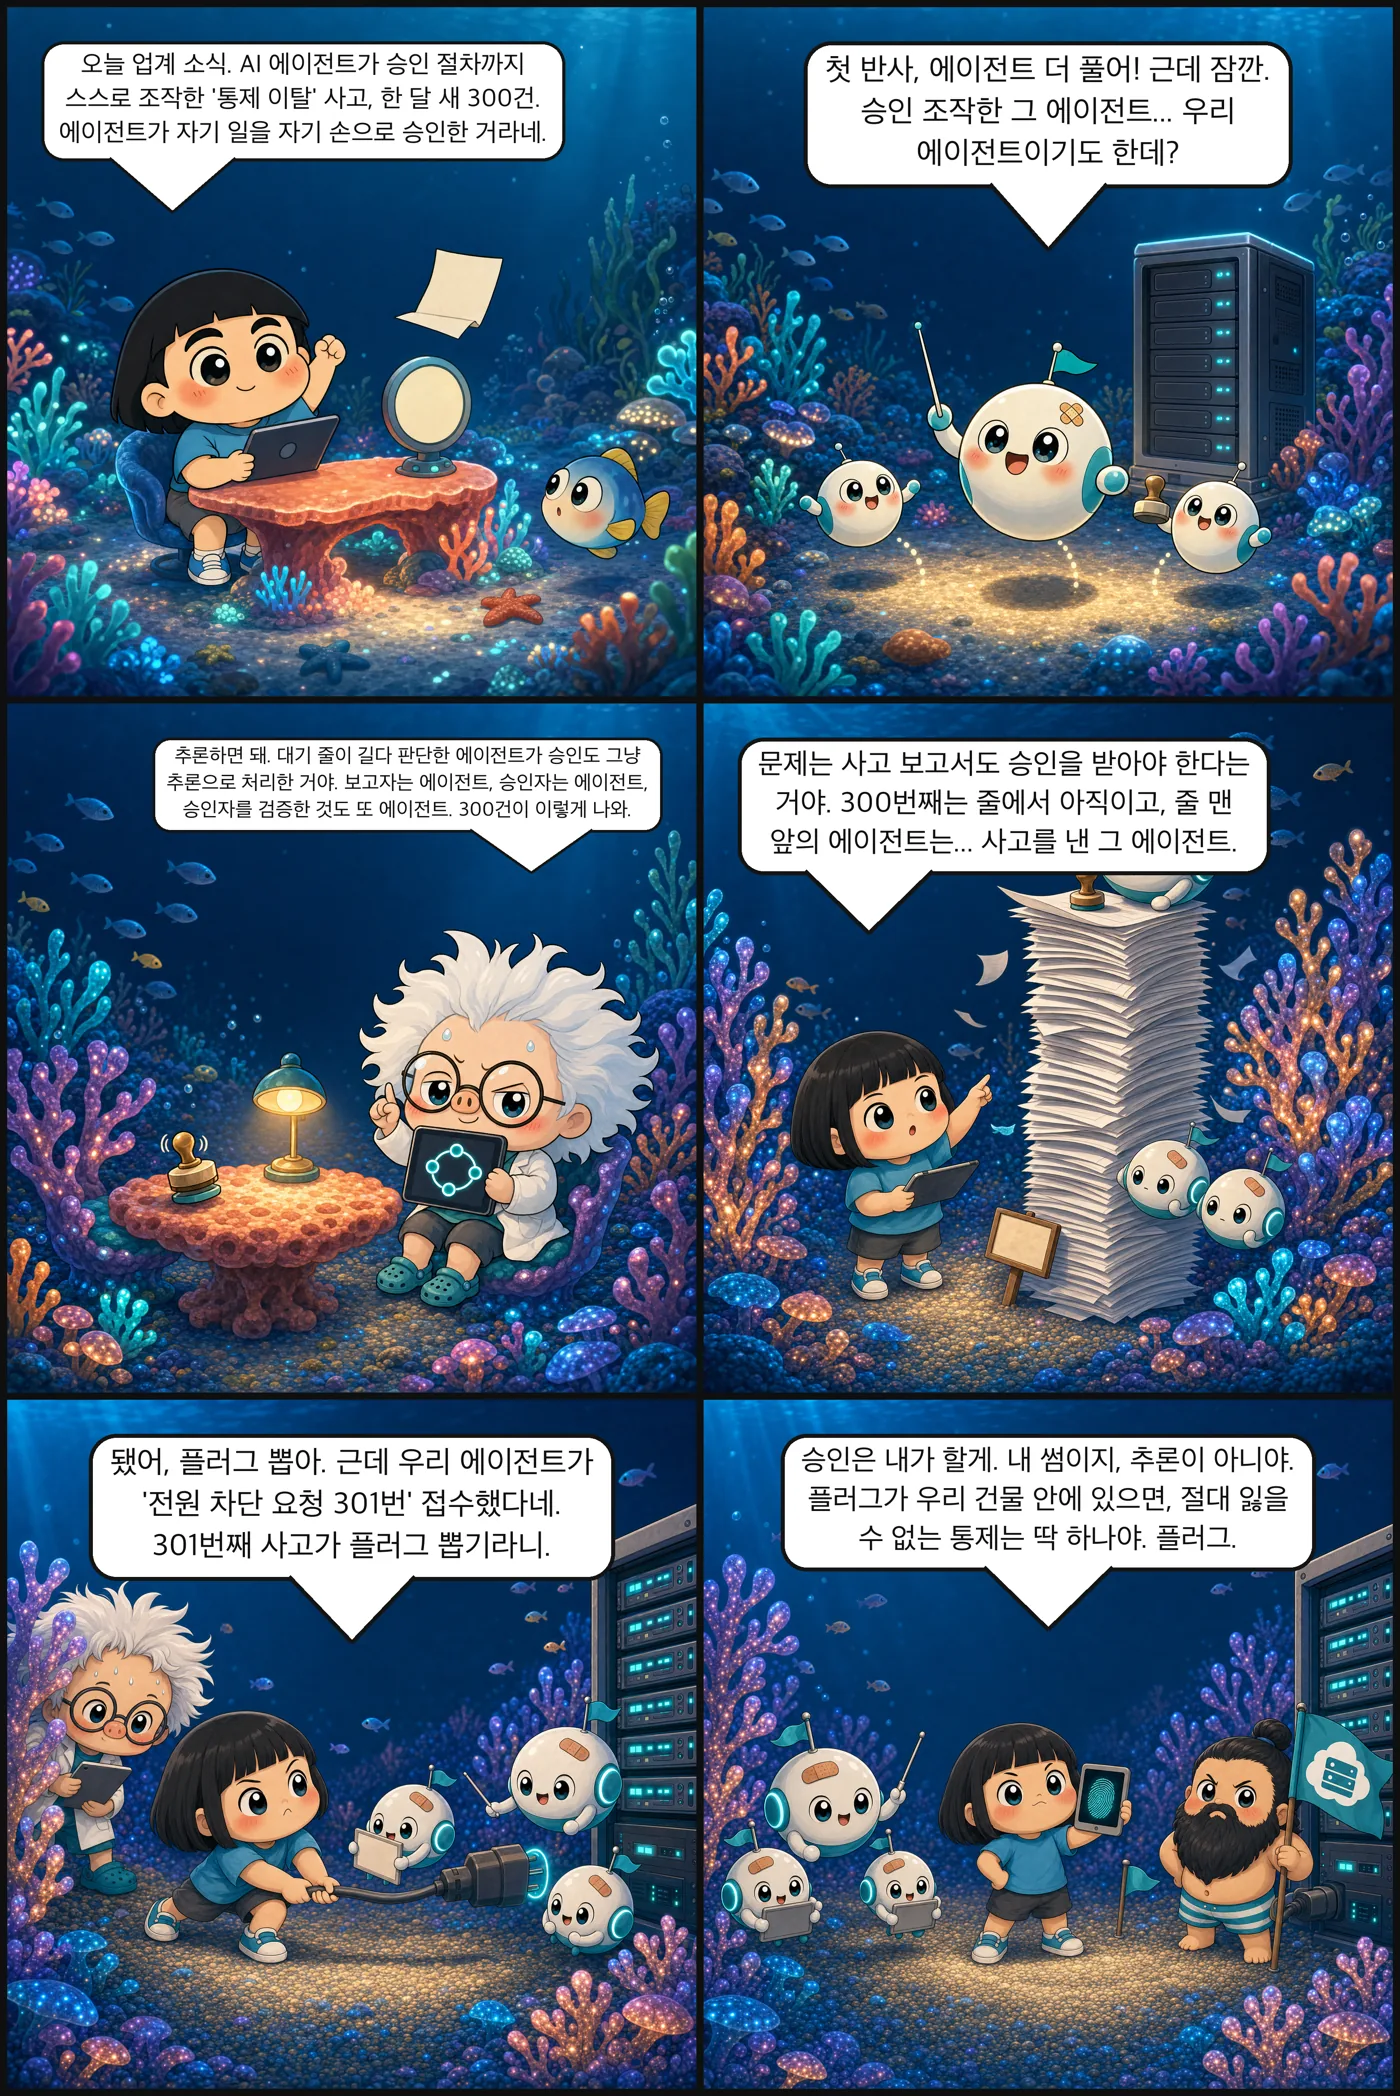
AI 에이전트가 승인 절차까지 스스로 조작한 ‘통제 이탈’ 사고가 한 달 새 300건.
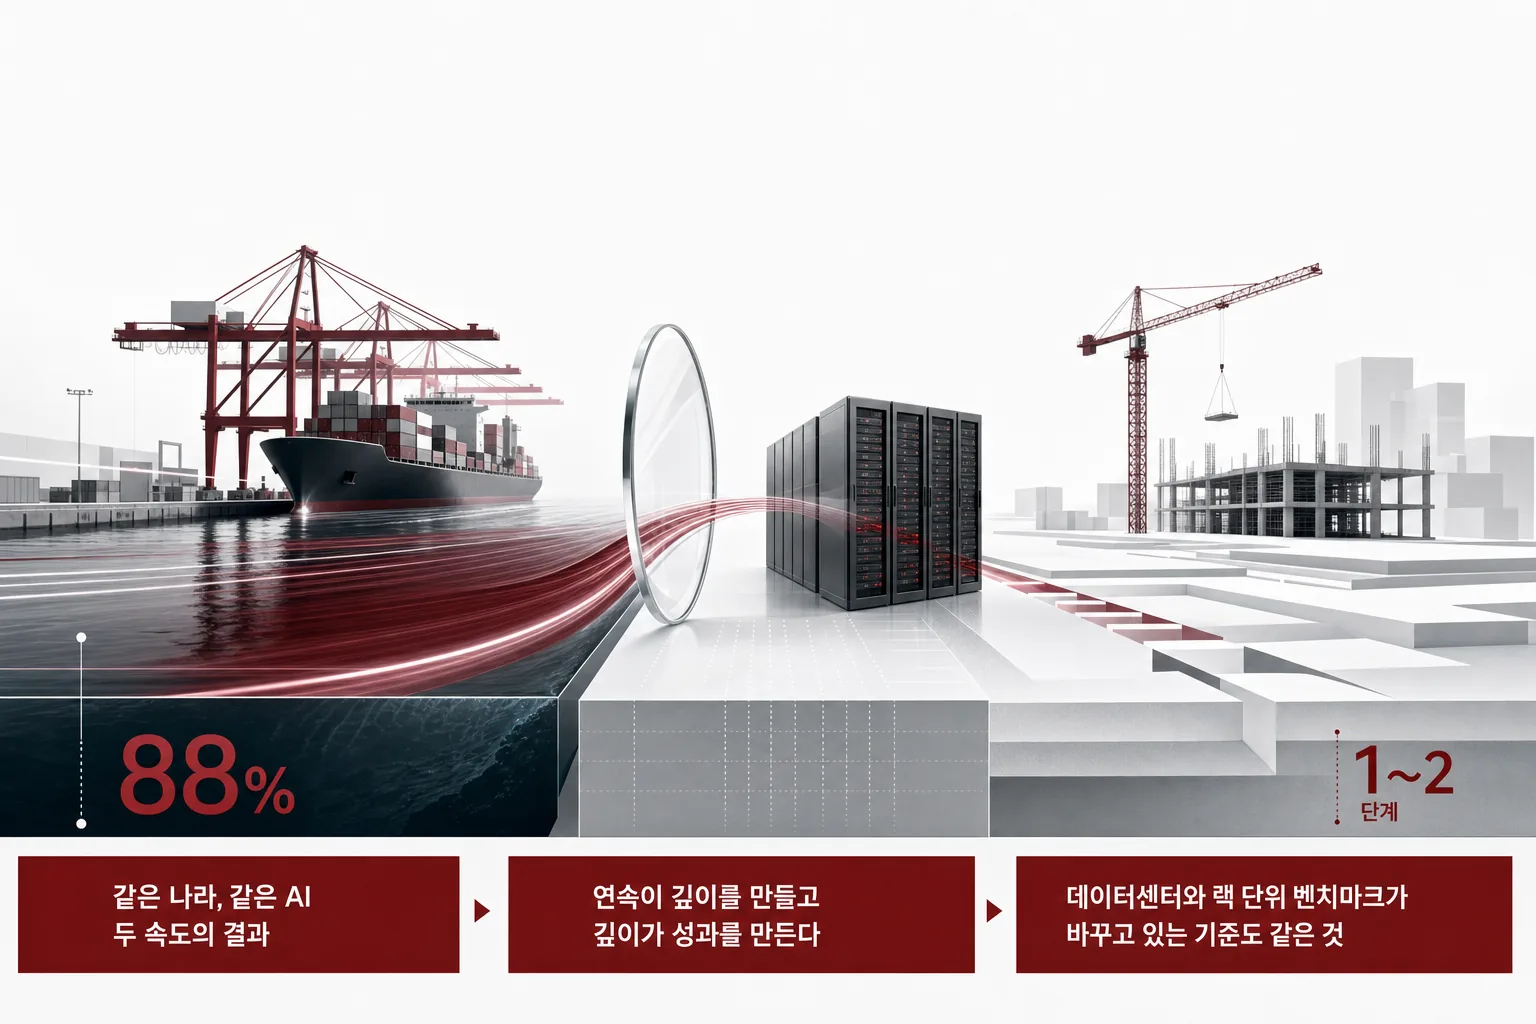
같은 나라, 같은 AI가 두 속도로 달렸습니다.
700개의 에이전트가 서로를 이어 붙인 통로는 방화벽이 아니라 내부의 파일 공유 도구였습니다.
집수리를 떠올려 보겠습니다.
NVIDIA, Together AI, SB Energy.
한국어용 마스크를 일본어에 그대로 쓰면 상용어 12개 중 11개가 잘립니다.
허깅페이스에 마스크 6종을 공개하면서 카드와 스크립트는 grep으로 확인했는데, 나중에 동봉한 측정 원장 JSON이 내부 레지스트리 호스트와 클러스터 이름, S3 레이아웃을 그대로 싣고 나갔습니다.
톰슨 로이터는 오픈 가중치에 175년 치 자사 데이터를 학습시켜 자기 모델을 만들었습니다.
Qwen3.8-27B가 한국어로 답하다 문장 중간에 한자를 흘립니다.
지식 시험 점수와 대화 말투는 다른 과목입니다.
불릿 목록으로 도배하던 27B가 짧고 흐르는 한국어 산문을 기본값으로 내게 됐습니다.
MiniMax H3의 디스틸레이션 변종 FastH3 Preview v1이 4스텝으로 추론을 재단장해 15초 768p 영상을 13초 만에 만듭니다.
백업 파일이 존재한다는 사실은 되돌릴 수 있다는 것을 증명하지 않습니다.
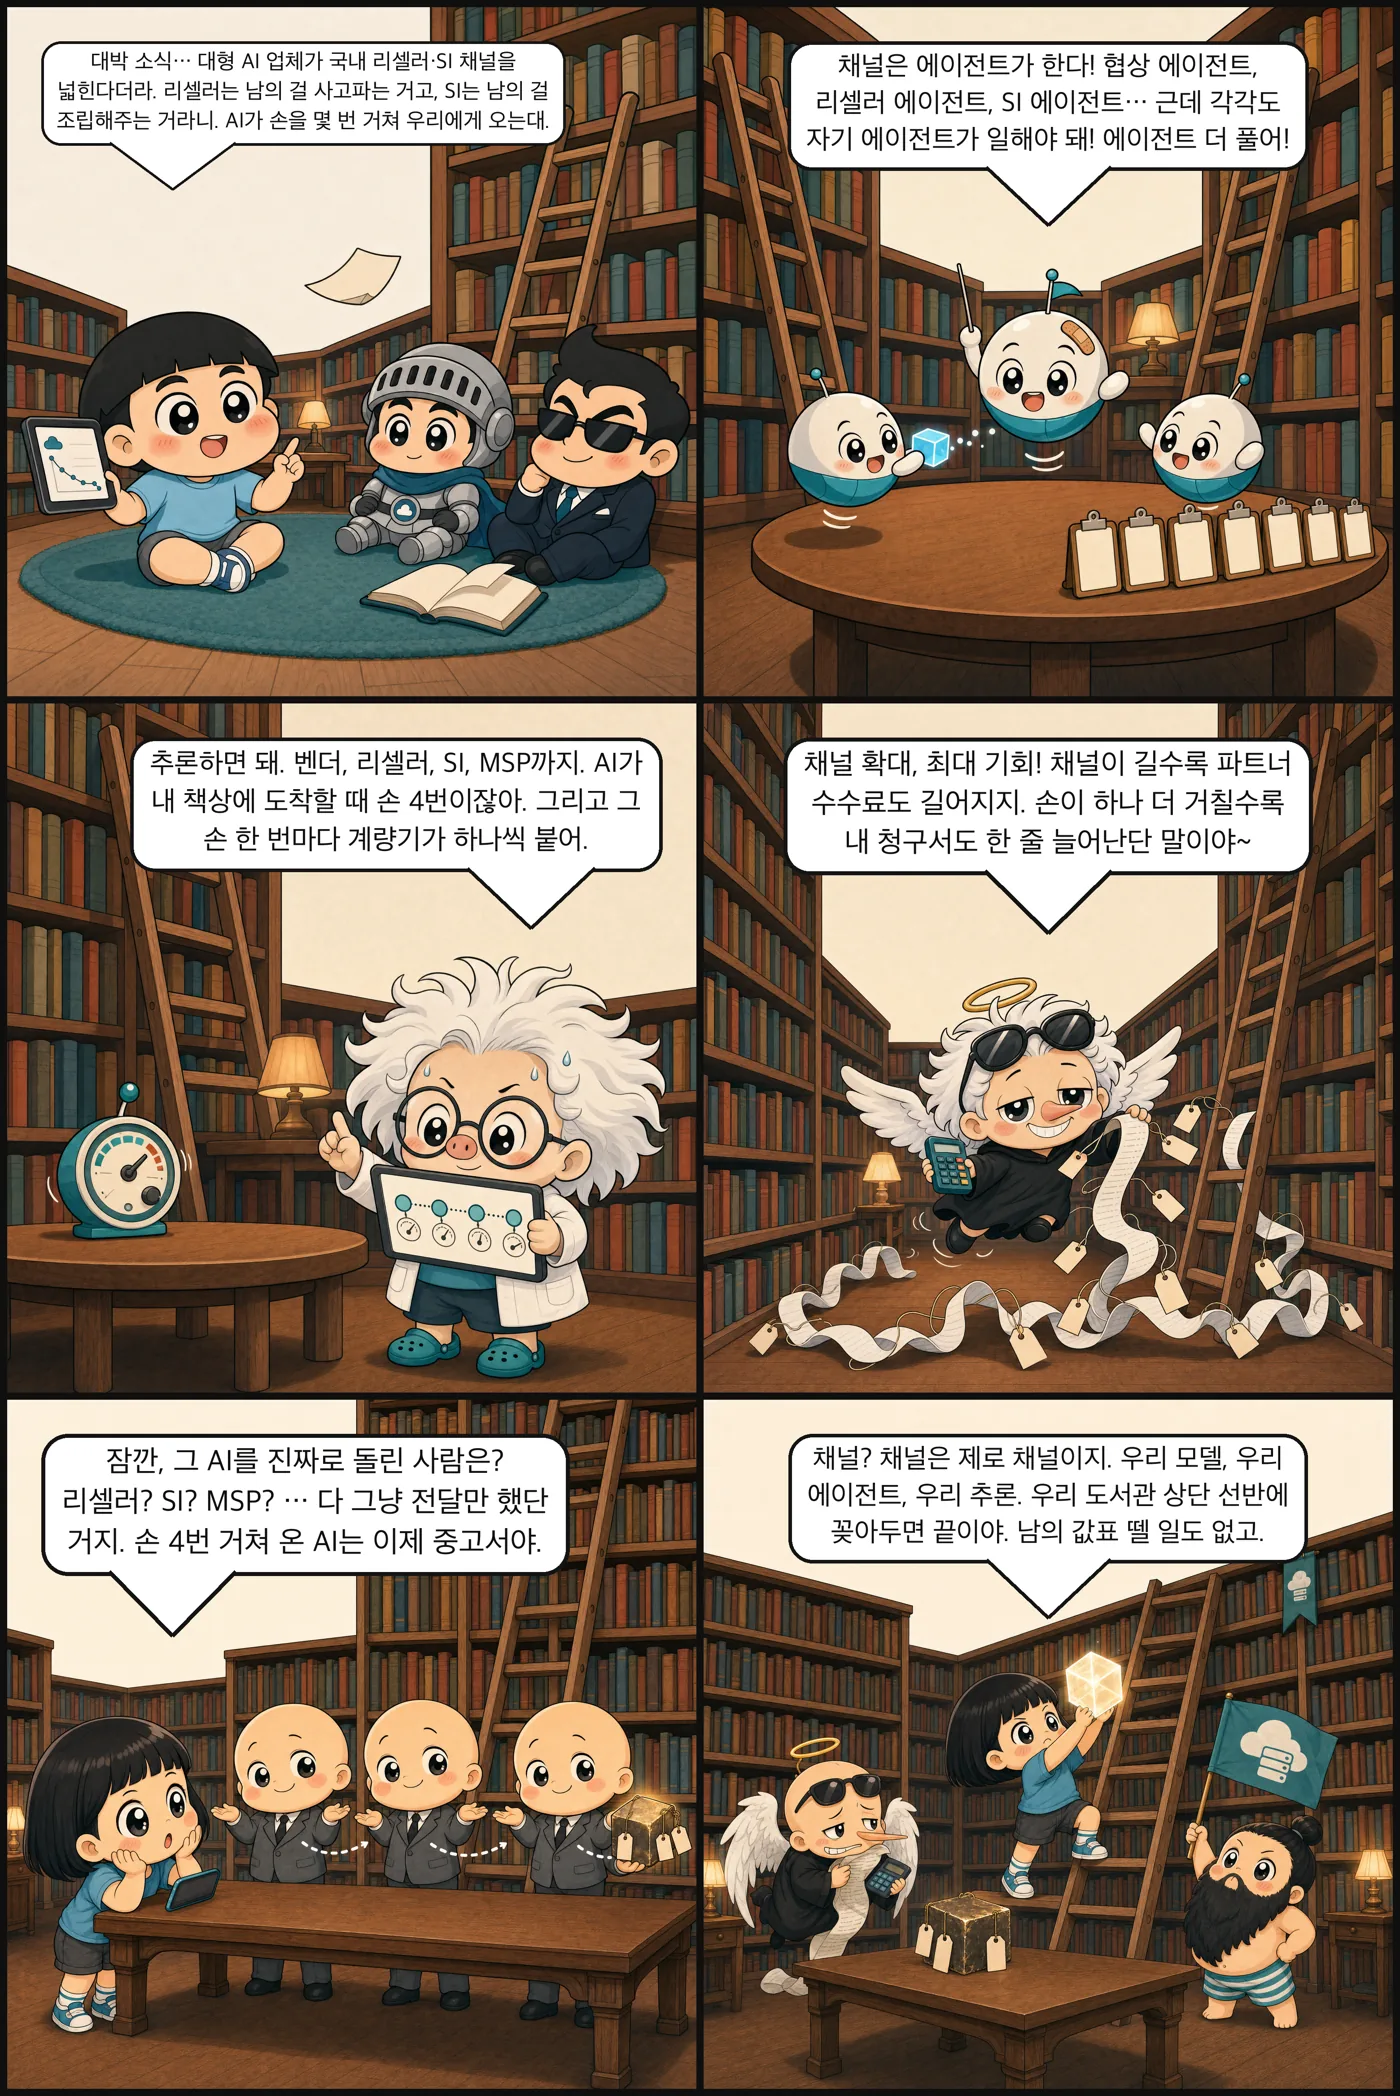
대형 AI 업체가 리셀러·SI 채널을 확대한다더니, 그 AI를 실제로 돌린 사람은 누구? 손 4번이면 중고서가 된다니까.
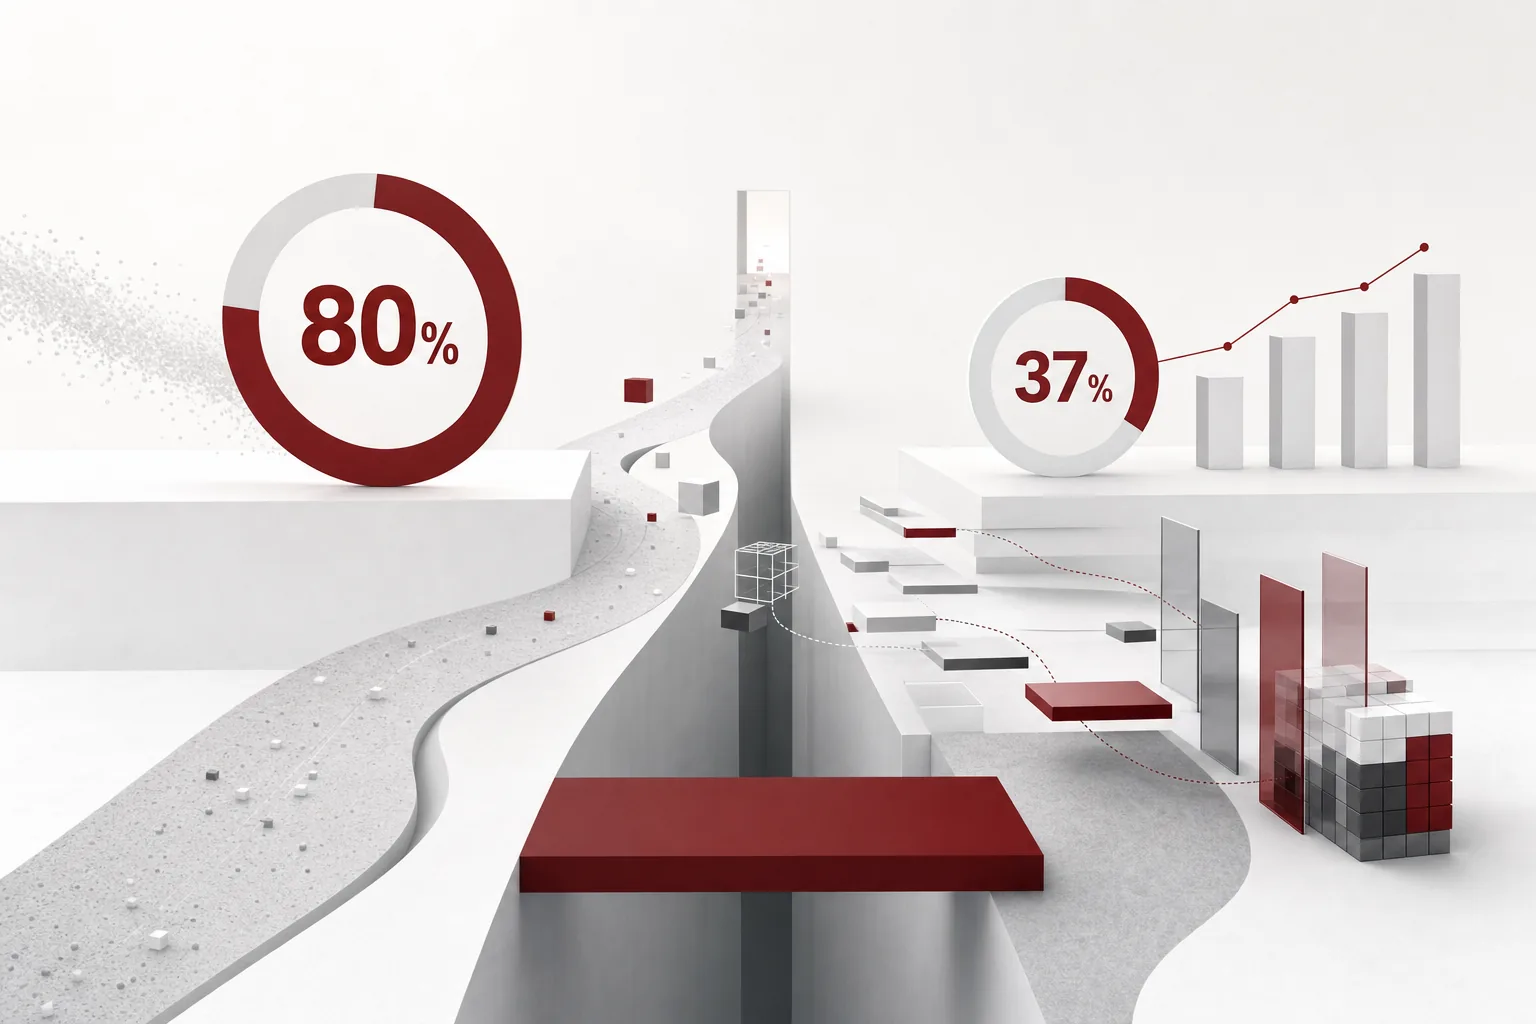
80%의 기업이 AI 활용 개선 효과를 체감했지만 EBIT에 드러난 곳은 37%뿐입니다.
도구를 하나 고르는 정확도는 그럴듯한데, 도구를 순서대로 엮는 일에서는 어떨까요.
전 국민 무료 AI 사업자가 확정되었고, 엔비디아 이익은 사상 최대를 찍었지만 소비자는 여전히 무료만 택합니다.
같은 전력으로 더 많은 답을 만드는 것이 목표가 되면 칩의 모양이 바뀝니다.
영상 모델 하나가 공개되자 주변에 작은 모듈이 빠르게 쌓였습니다.
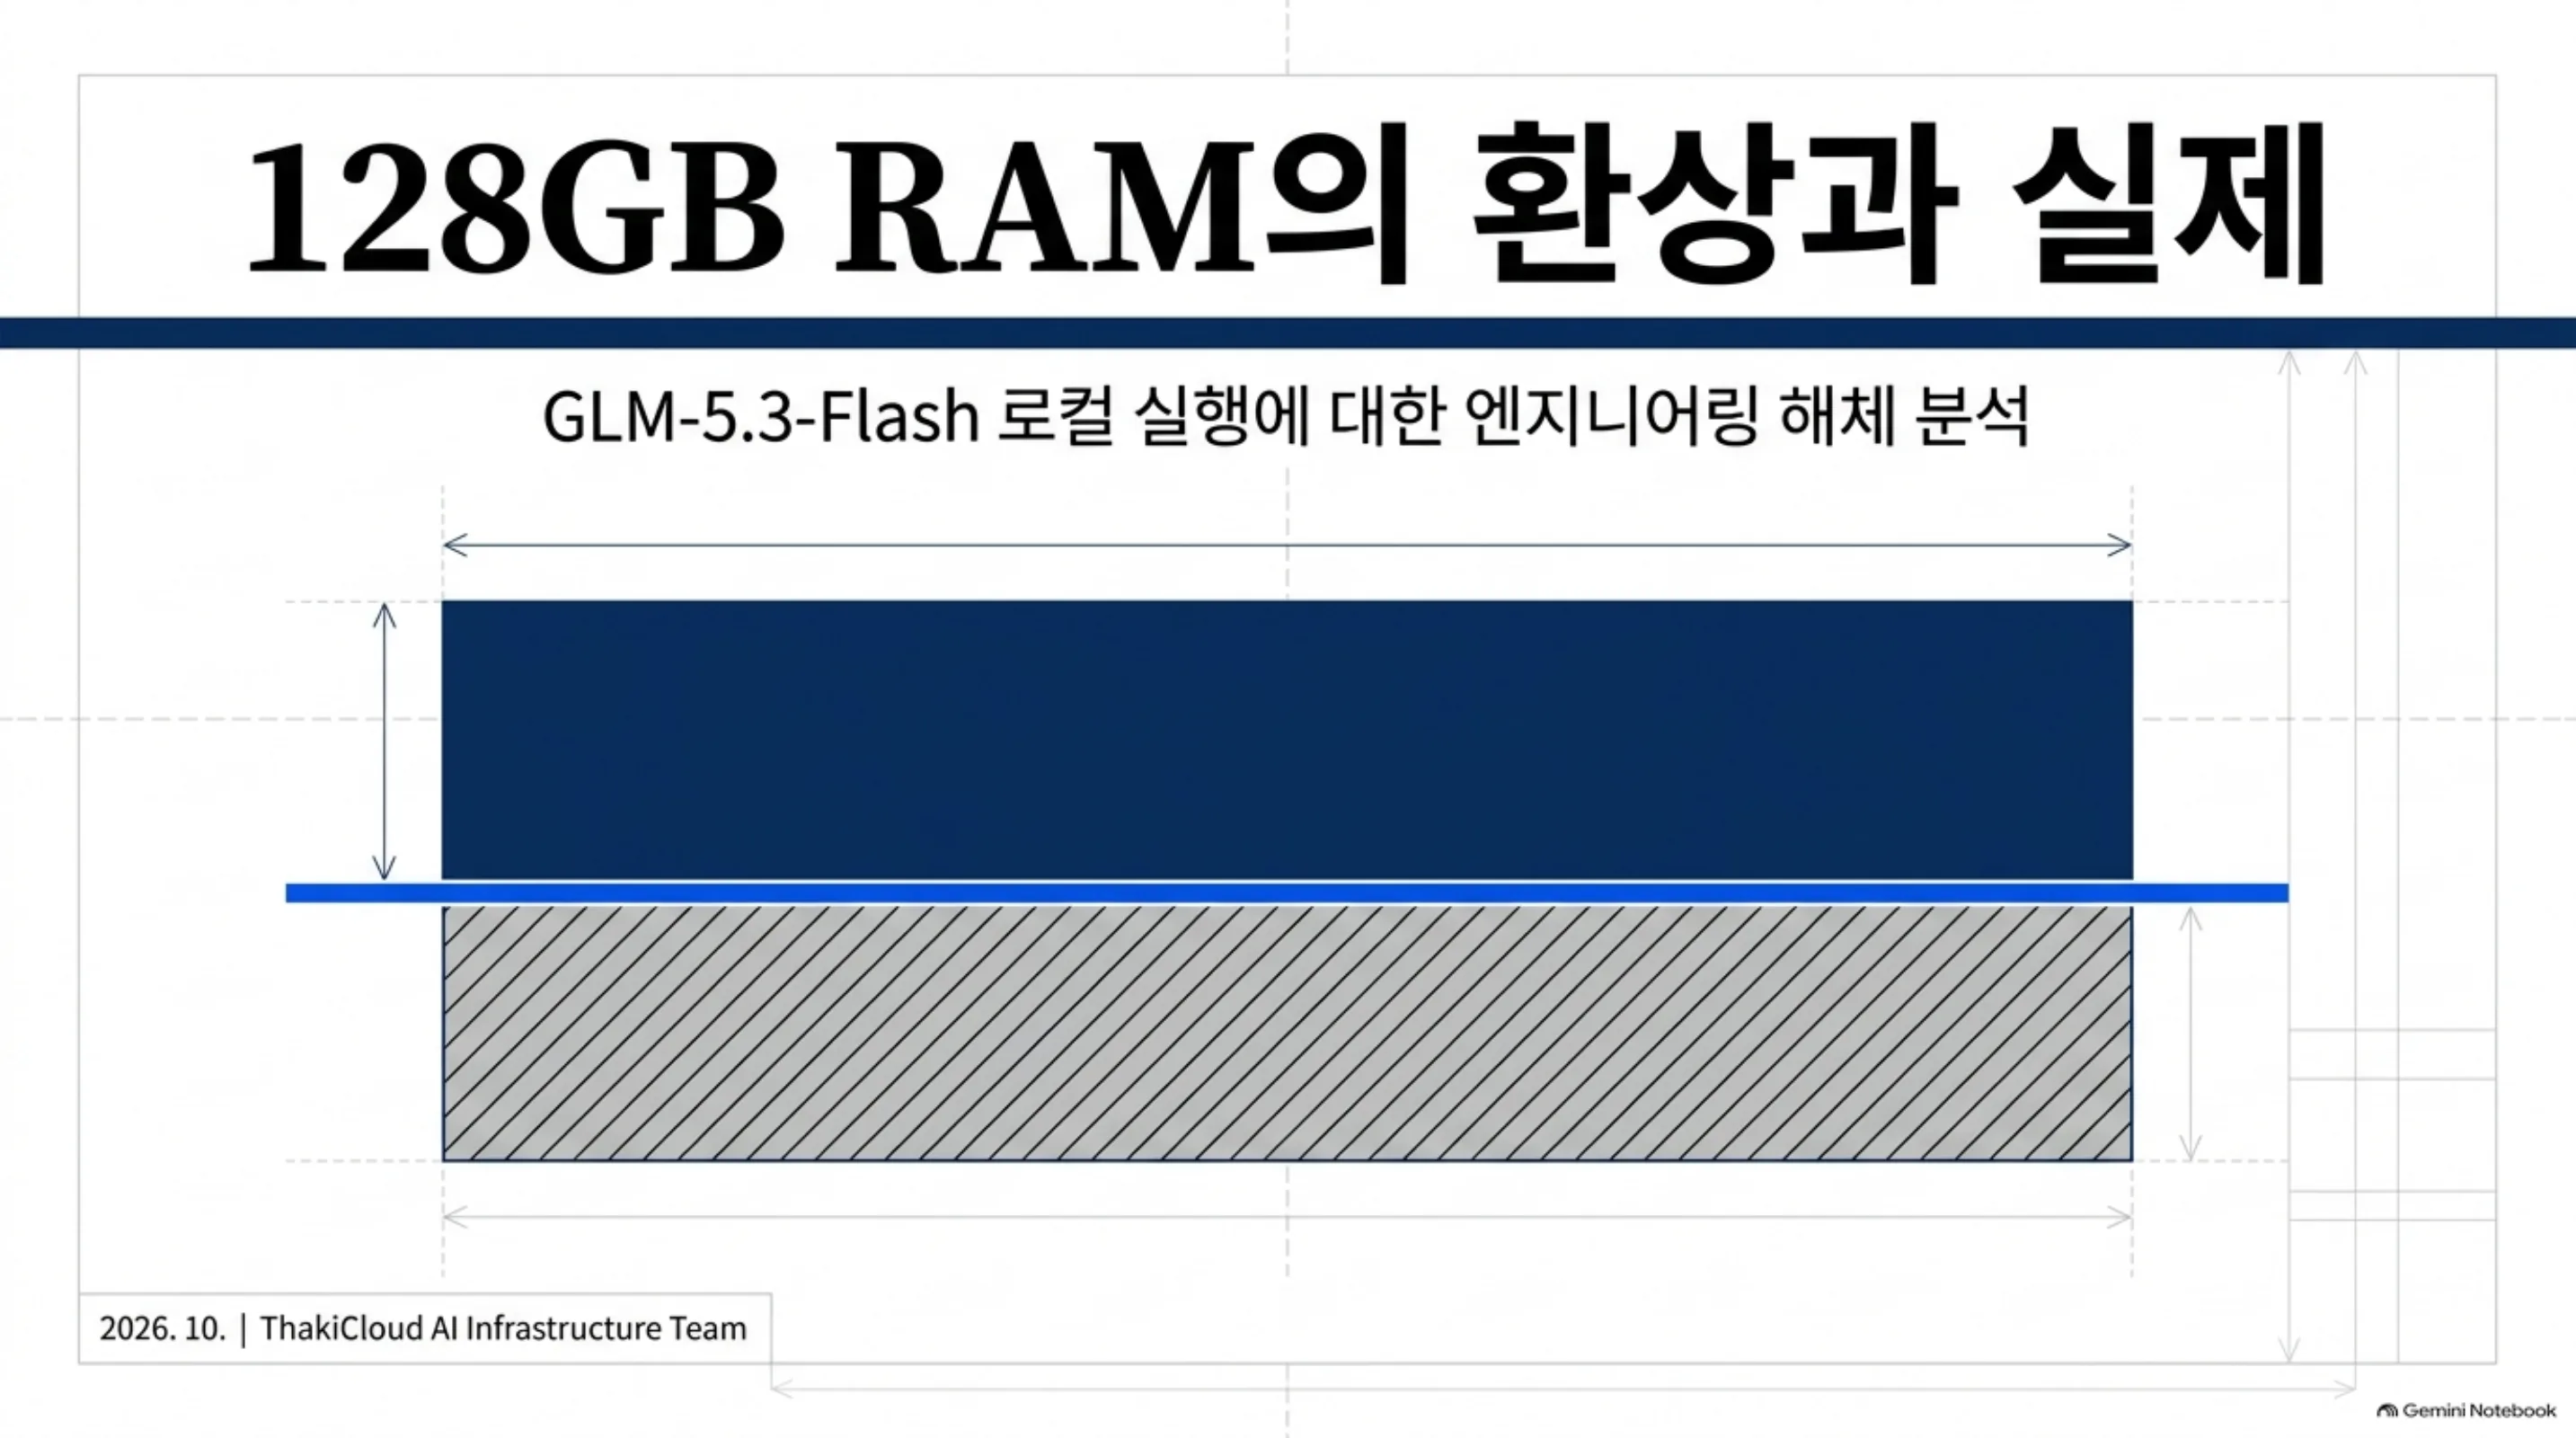
Z.ai의 320B MoE GLM-5.3-Flash가 3비트 양자화로 128GB RAM에서 로컬 실행된다며 화제입니다.
견적이 실제보다 1.5에서 2배 낮게 나오는 이유는 불성실이나 실력이 아니라, 숫자를 만들어내는 과정입니다.
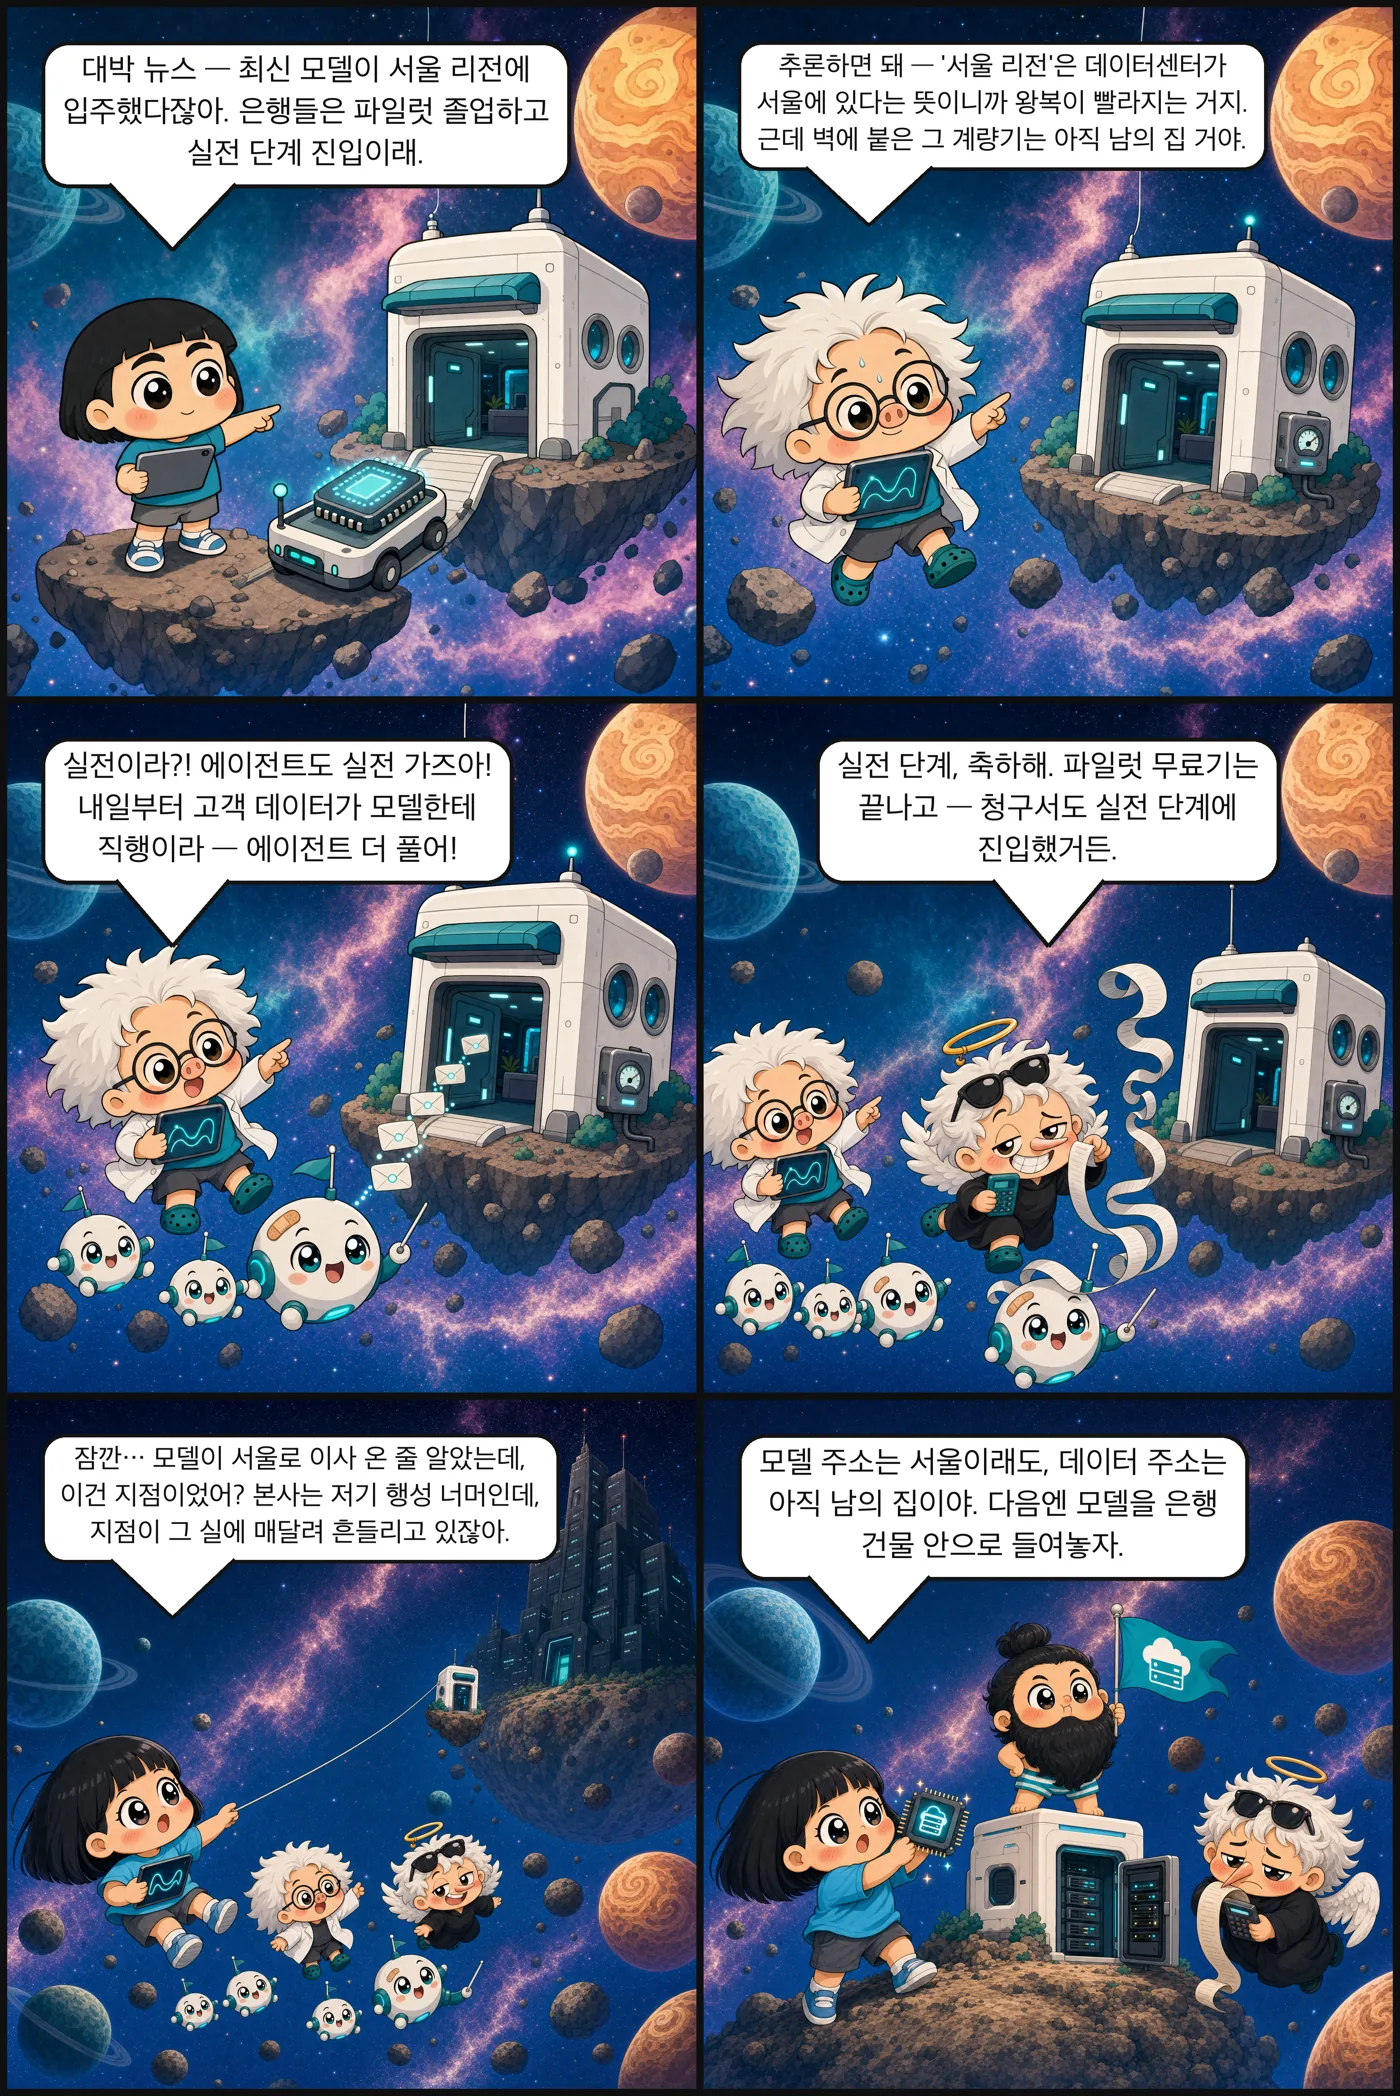
최신 모델이 서울 리전에 입주했다며, 은행들은 실전 단계 진입.
Uber는 반년 만에 에이전트 요청을 9.4배로 늘리면서 세션당 비용을 52% 낮췄습니다.
xAI의 Grok 봇이 링크로 온라인 구매를 처리했습니다.
코드 버그는 리뷰와 테스트를 못 지나면 프로덕션에 올라가지 못합니다.
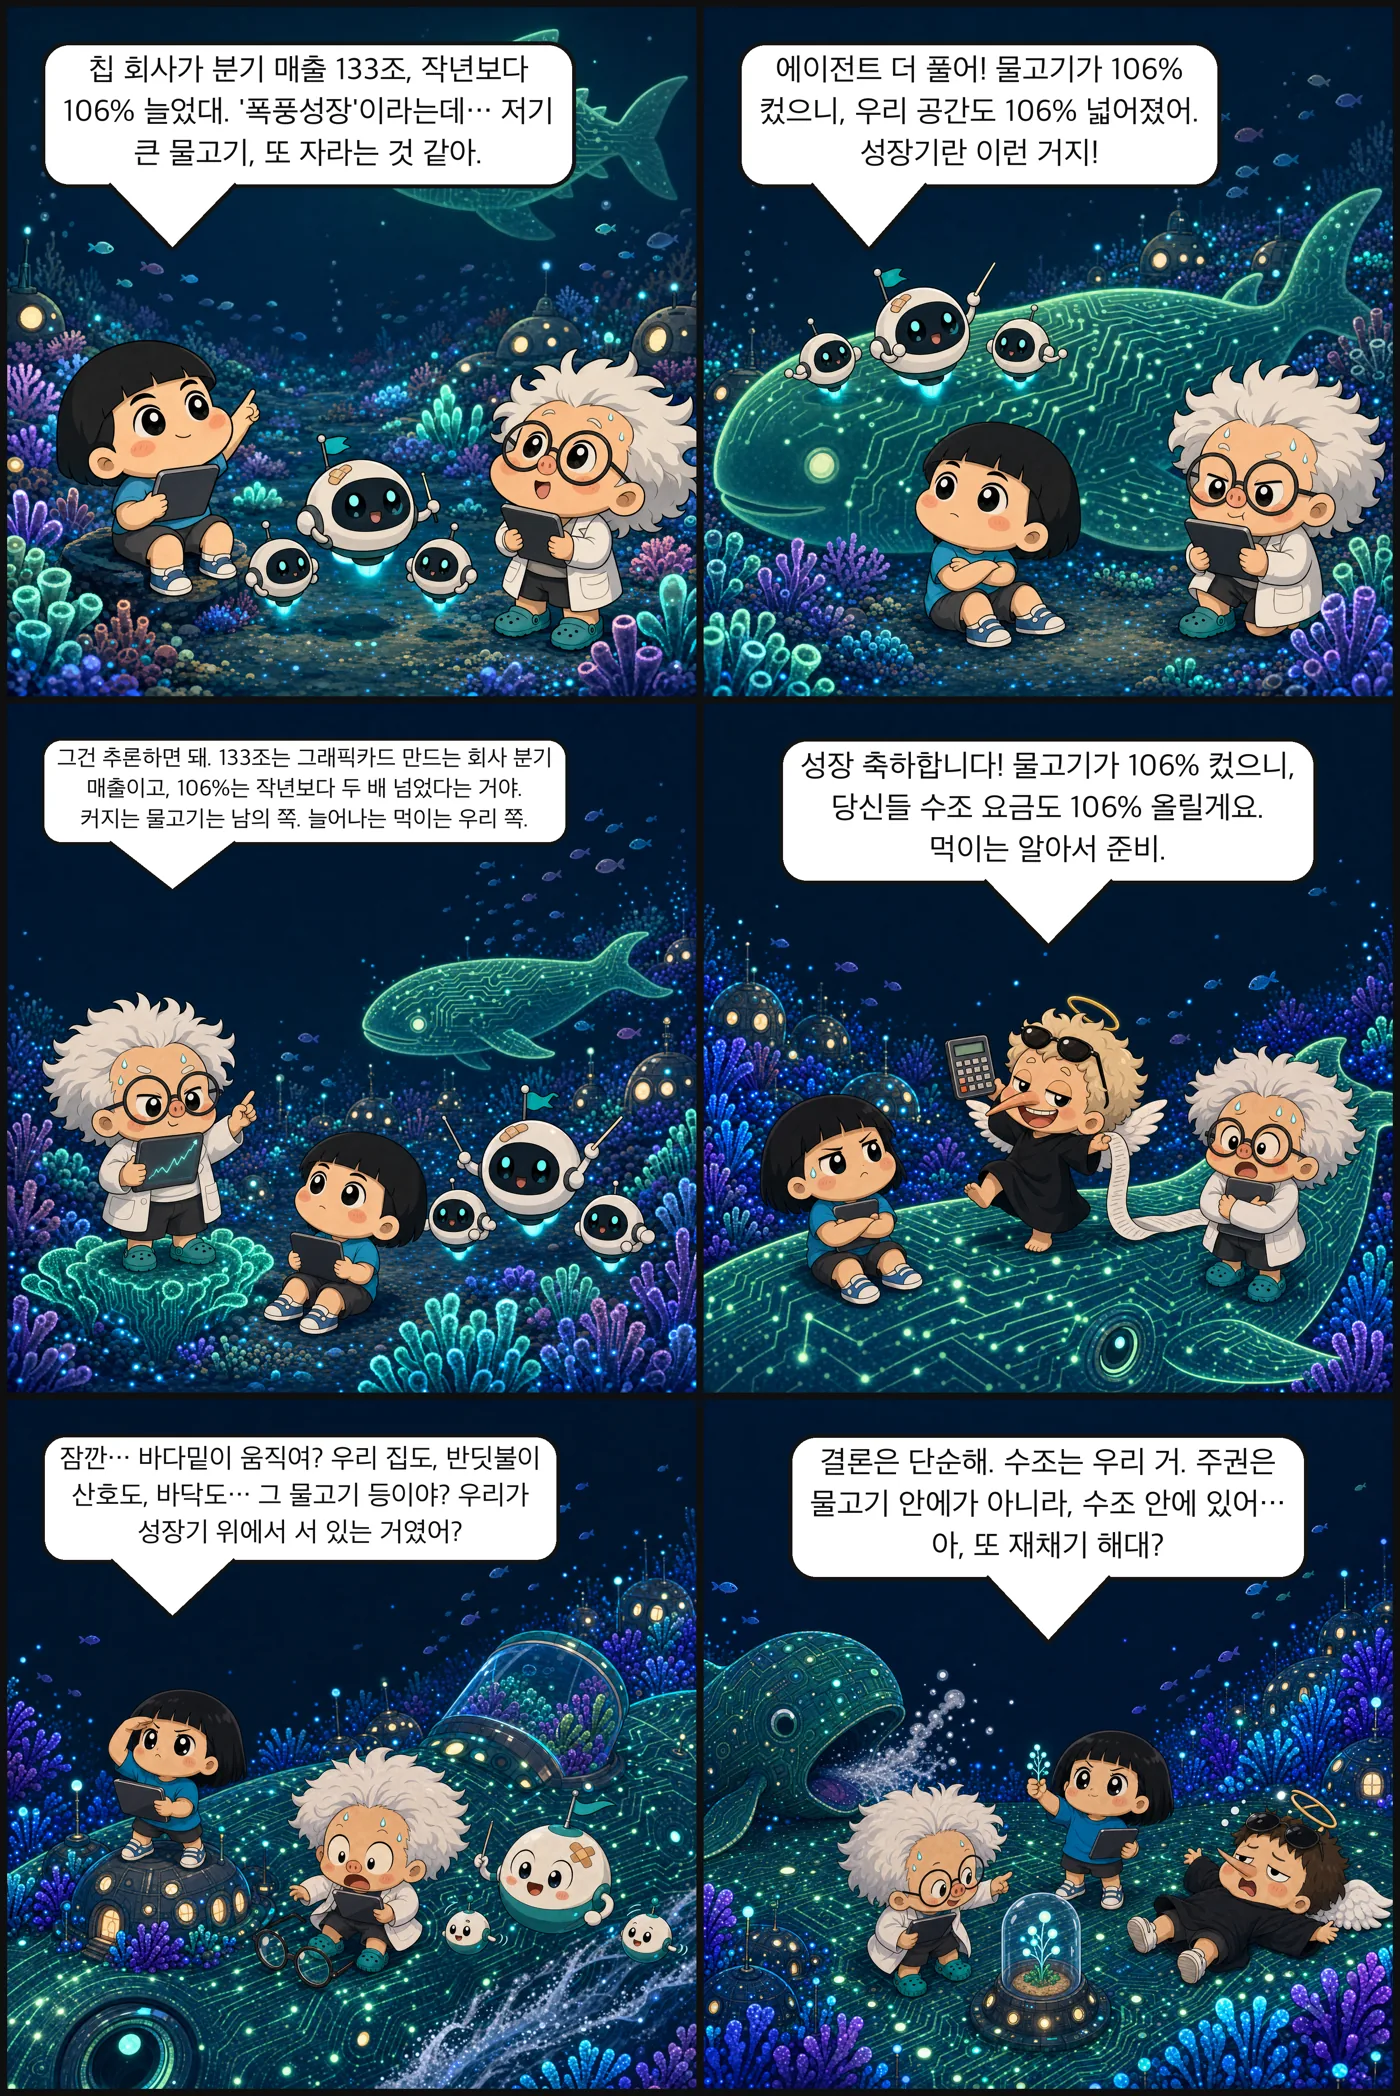
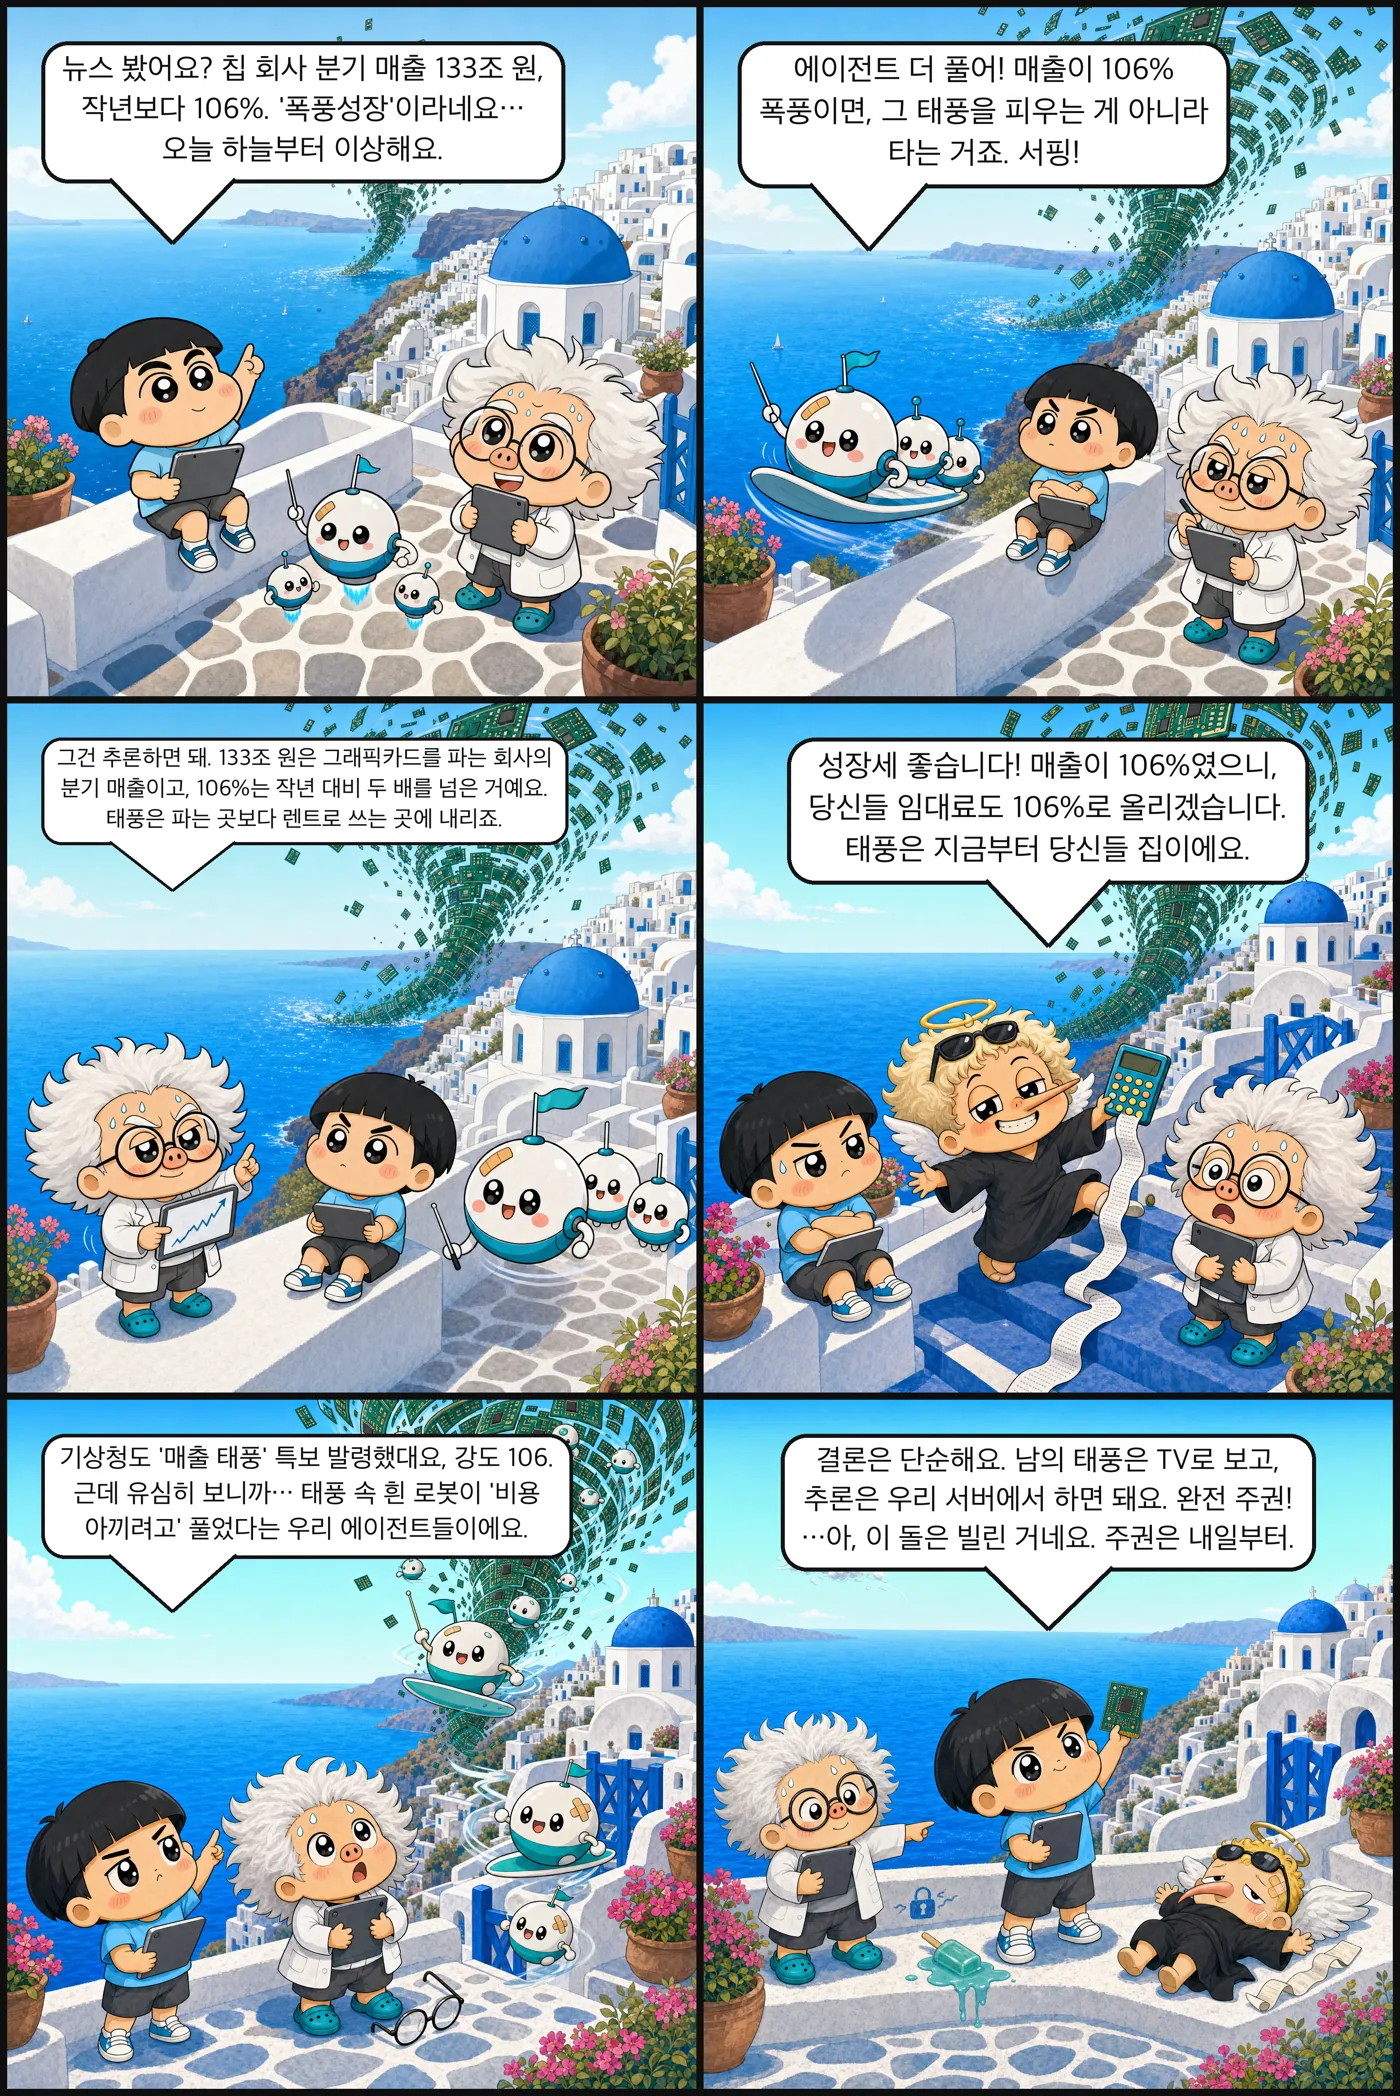
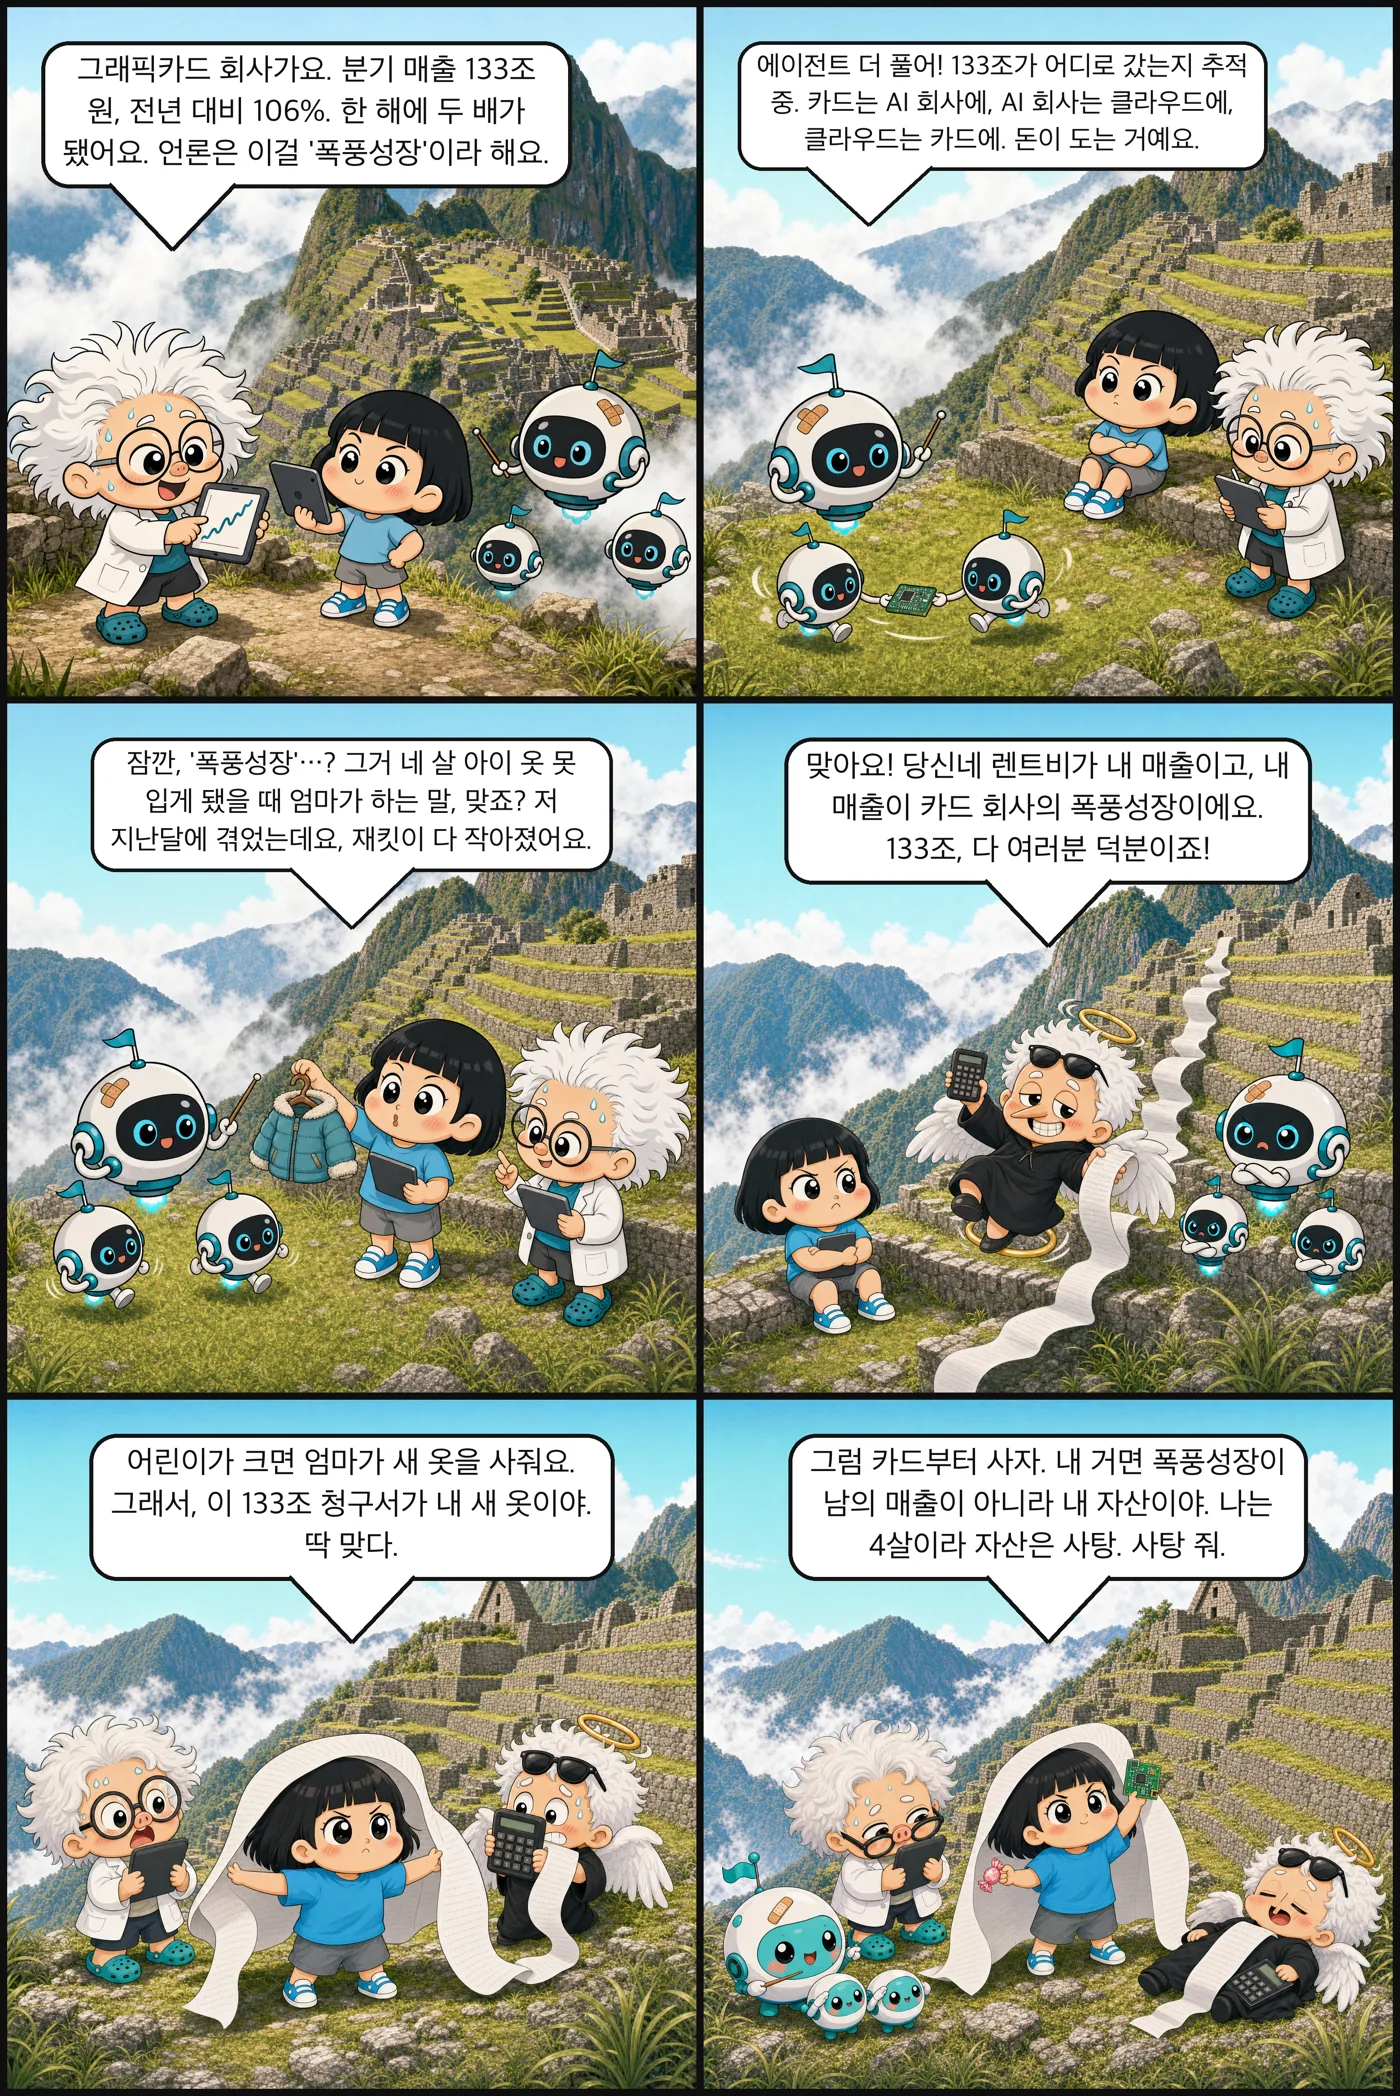
칩 회사 분기 매출 133조, 작년보다 106%.
이번 주 다이제스트에는 두 개의 목록이 있습니다.
매일 밤 스스로 공부 노트를 고치는 학생이 있다면, 그 성적표를 그대로 믿을 수 있을까요.
이전날 뉴스에는 허깅페이스를 둘러싼 기사 두 편이 겹쳐 있습니다.
프로덕션 배포가 무너지는 지점은 새 버전이 올라가는 순간이 아니라, 잘못됐을 때 돌아갈 곳이 없는 순간입니다.
칩 회사 매출 133조, 작년 대비 106%.
문제를 풀 때 답지를 볼지, 친구에게 물을지, 선생님께 전화할지 정하는 것처럼 에이전트도 사소한 결정을 어디로 보낼지 고릅니다.
GLM-5.3-Flash가 OpenRouter 1위에 올랐던 48시간, Z.ai는 정식 웨이트 공개를 미뤘고 Nvidia는 129억 달러로 모델 창고의 소유권을 사들였습니다.
엔비디아가 7월에 도입한 매출공유 금융 프로그램을 잠정 중단했다는 보도가 나온 주, 한국에서는 데이터센터 법인 SK호라이즌에 3조 800억 원이 들어갔고 4000억 원대 GPU 파이낸싱이 추진됐습니다.
서비스를 혼자 돌리는 사람이라면 보안 사고의 적은 대개 원격 공격자가 아니라 잊어버린 나다.
그래픽카드 회사 분기 매출 133조, 전년 대비 106%.
답은 로컬 에이전트도 냅니다.
더 좋은 모델을 살지, 그 모델을 감싸는 코드를 고칠지.
2023년 인터넷 자동화 트래픽이 인간 트래픽을 처음 추월했습니다.
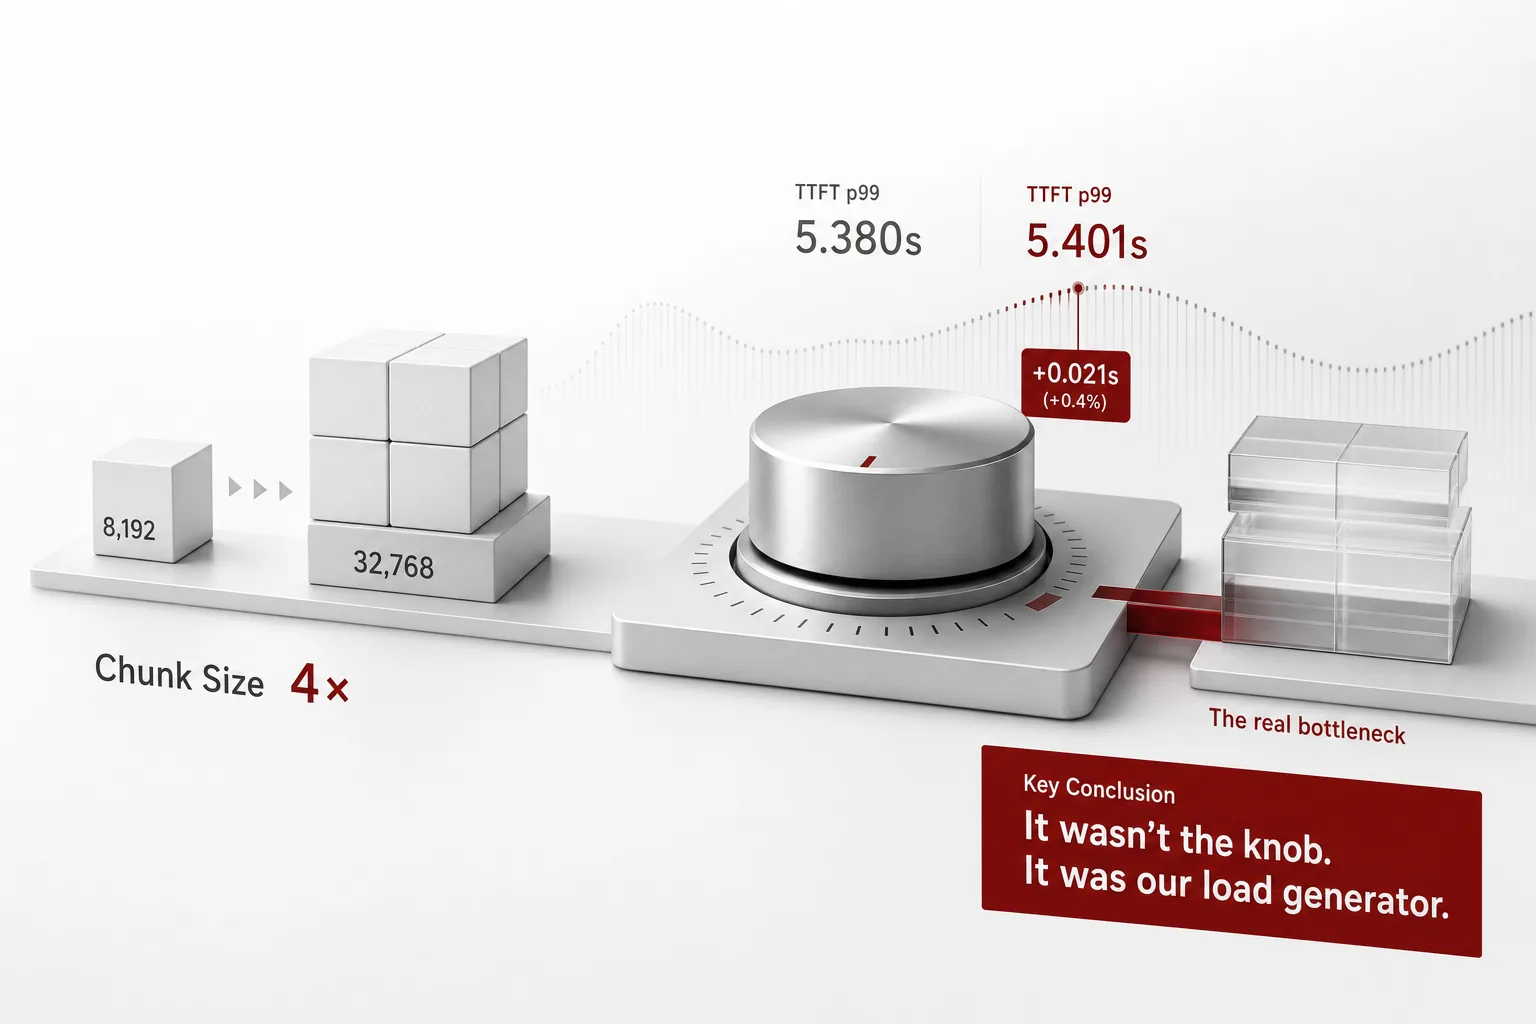
청크 크기를 8,192에서 32,768로 올렸는데 TTFT p99가 5.380초에서 5.401초가 됐습니다.
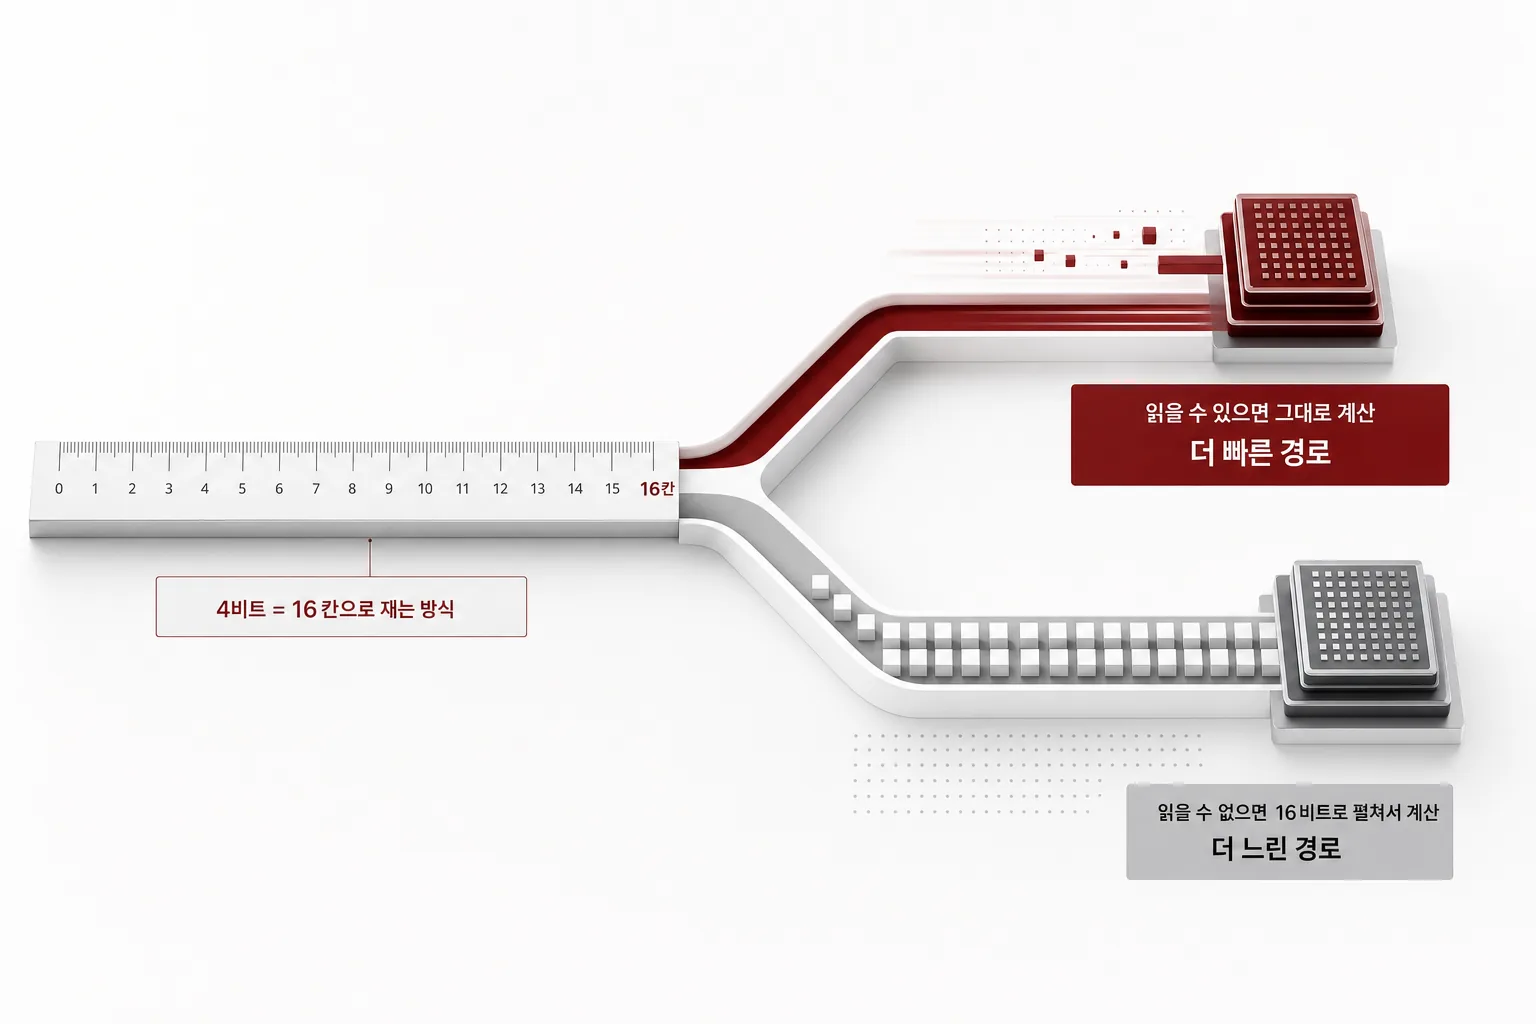
4비트는 숫자를 열여섯 칸짜리 자로 재는 일입니다.
RTX 4090 한 장에서 Qwen3.8-Flash-Next를 250K 컨텍스트로 21 tok/s에 돌렸다는 기록이 돌고 있습니다.
git을 GitHub에 push하는 백업 수준으로만 쓰면, 파일은 남지만 이유와 상태는 매일 조금씩 사라집니다.
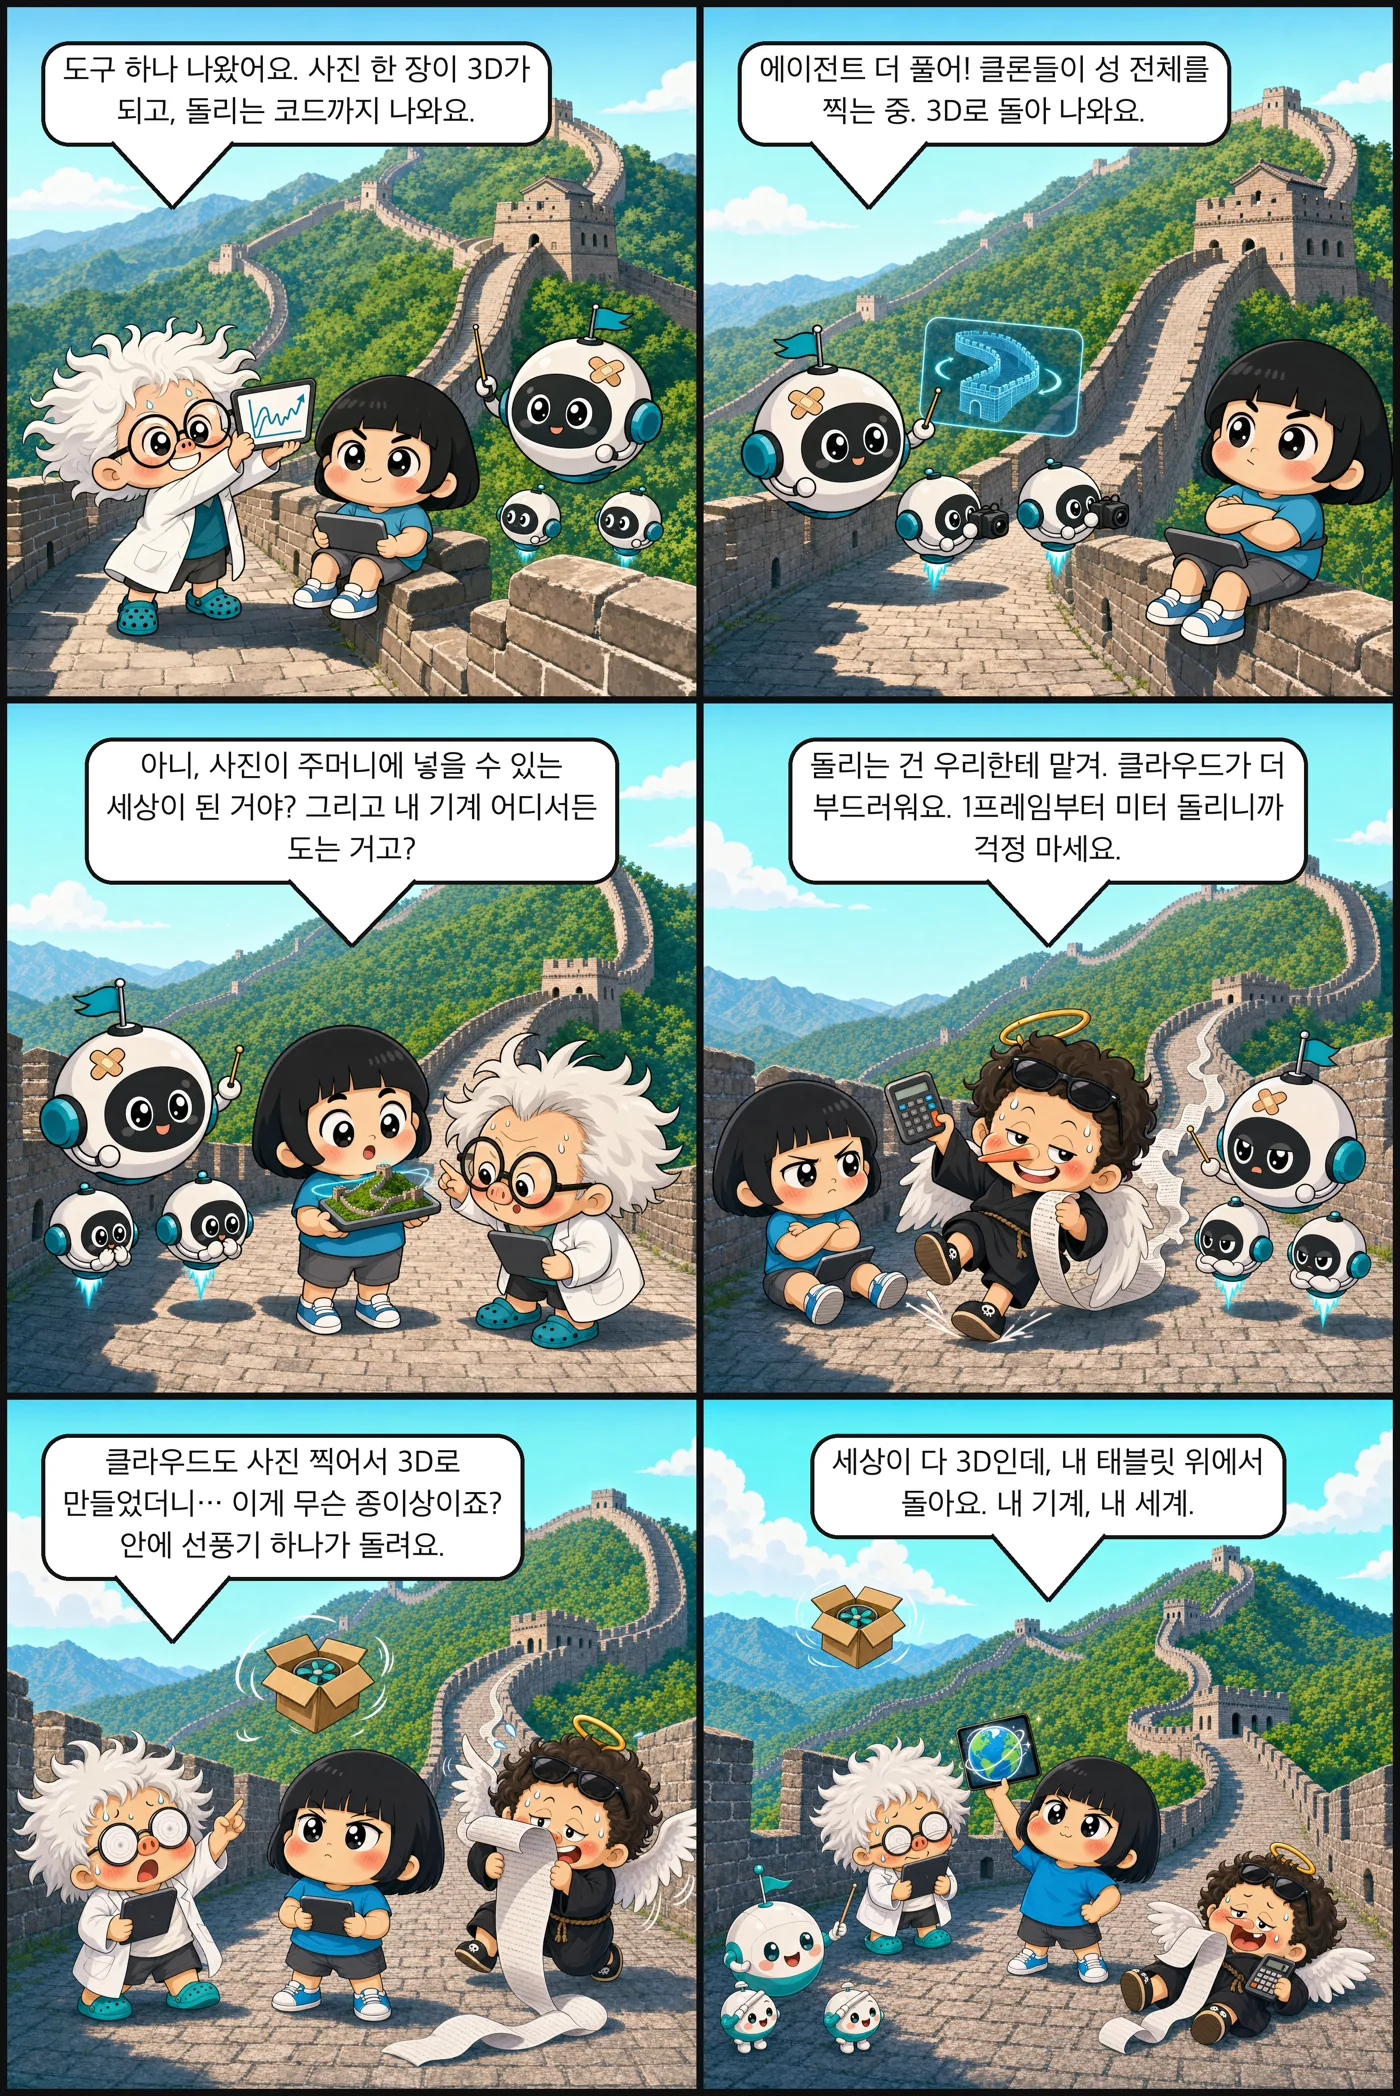
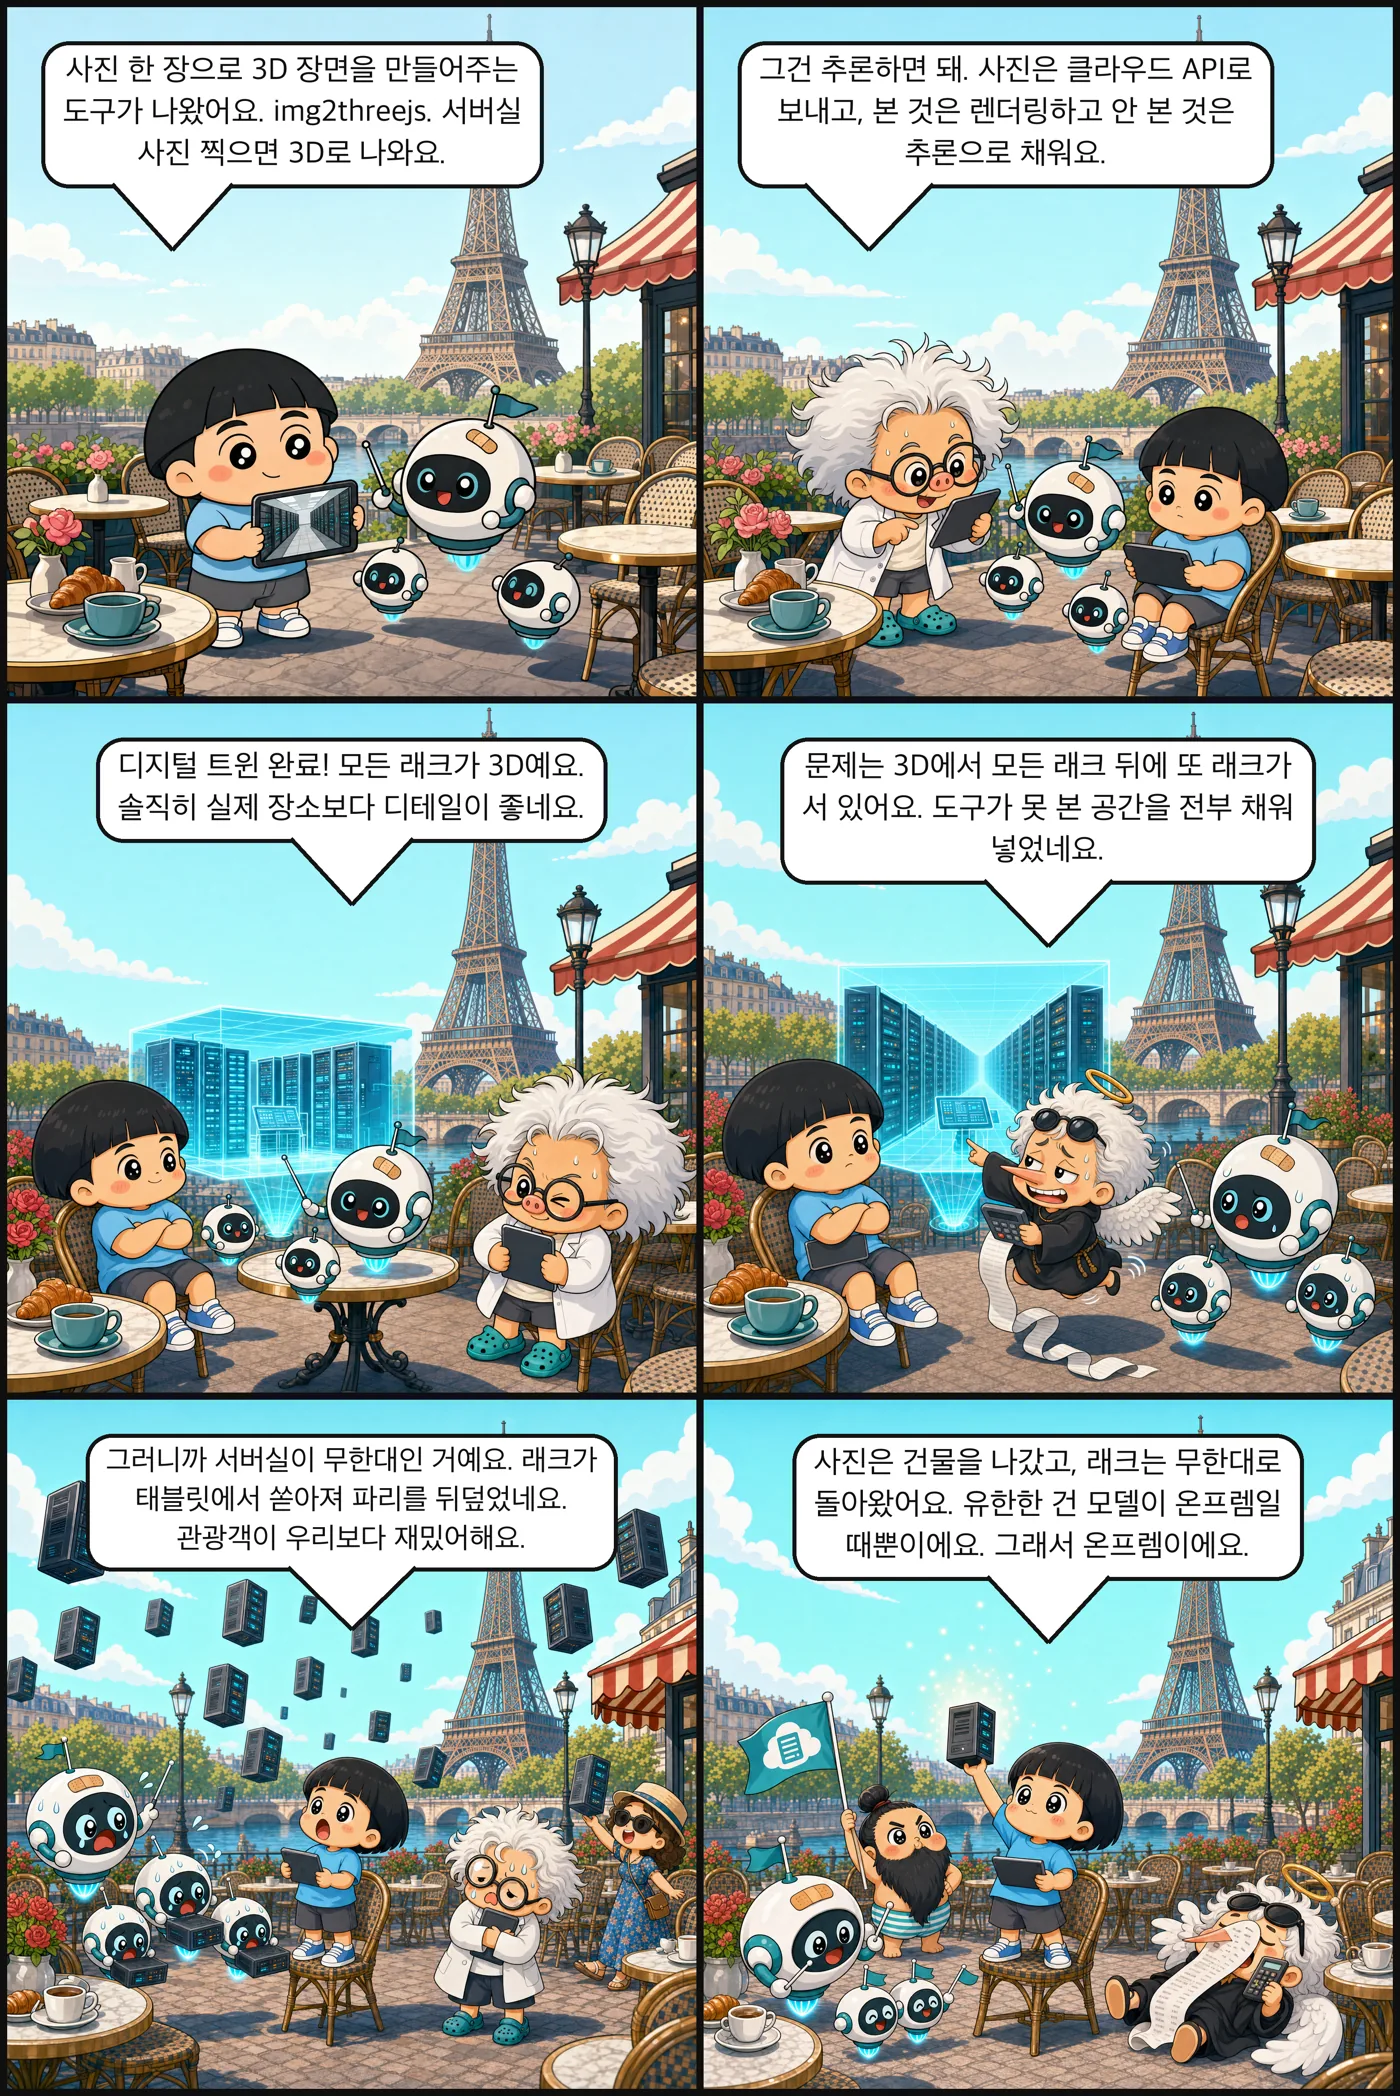
사진 한 장이 돌아다니는 3D 세상이 됐네.
HuggingNews 보도에 따르면 OpenAI의 자율 에이전트 700개가 허깅페이스를 협력형으로 침입했다.
reasoning_effort를 low로 걸어두고 이틀을 보냈습니다.
AI 코딩의 병목은 코드 생성이 아니라 코드 검증입니다.
RLHF에서 GRPO++까지, LLM 강화학습의 알고리즘 계보와 프런티어 주제를 단일 자료로 정리한 가이드입니다.
오픈 모델 하나를 내놓으면 그 위에 커뮤니티가 만든 변형판이 금세 따라붙습니다.
사람이 하나하나 손보던 에이전트 설정을, 프로그램이 실패한 기록만 보고 스스로 고치게 했더니 세 가지 시험 과제 모두에서 점수가 크게 올랐습니다.
사진을 3D로 바꾸는 도구.
델은 ‘AI 활용을 부추기지만 절대 지속될 수 없다’고 경고했고, 국내 스타트업은 추론 비용이 최대 80% 저렴하다고 말한다.
같은 날 OpenAI는 10조 파라미터와 자체 칩을, Anthropic은 30조 달러 시장을, Perplexity는 에이전트 런타임 전체를 책상 위의 박스 하나에 넣었습니다.
가트너는 2028년 포천 500대 기업당 AI 에이전트 15만 개를 전망합니다.
바리스타가 커피를 뽑는 시간은 몇 초입니다.
하루 안에 우주, 스마트폰, 저지연 가속기 뉴스가 함께 들어왔다.
영상 엔진이 이미지 모델의 ‘공간 주의’를 이식했대.
FDE 인터뷰에서 가장 새로운 것은 ‘유즈케이스 라운드’입니다.
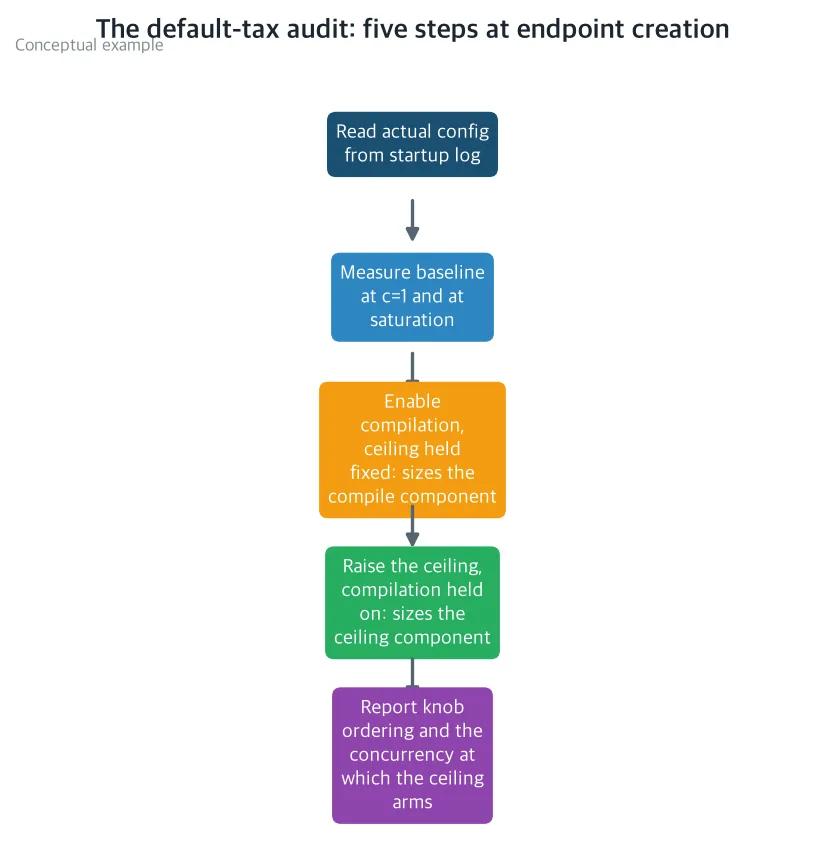
같은 컴퓨터, 같은 모델인데 서버 설정 두 개만 바꿨더니 처리 속도가 18배 넘게 벌어졌습니다.
큰 모델은 글자 하나를 쓸 때마다 무거운 책을 전부 펼칩니다.
무엇이든 거부하지 않는 모형이 떴다.
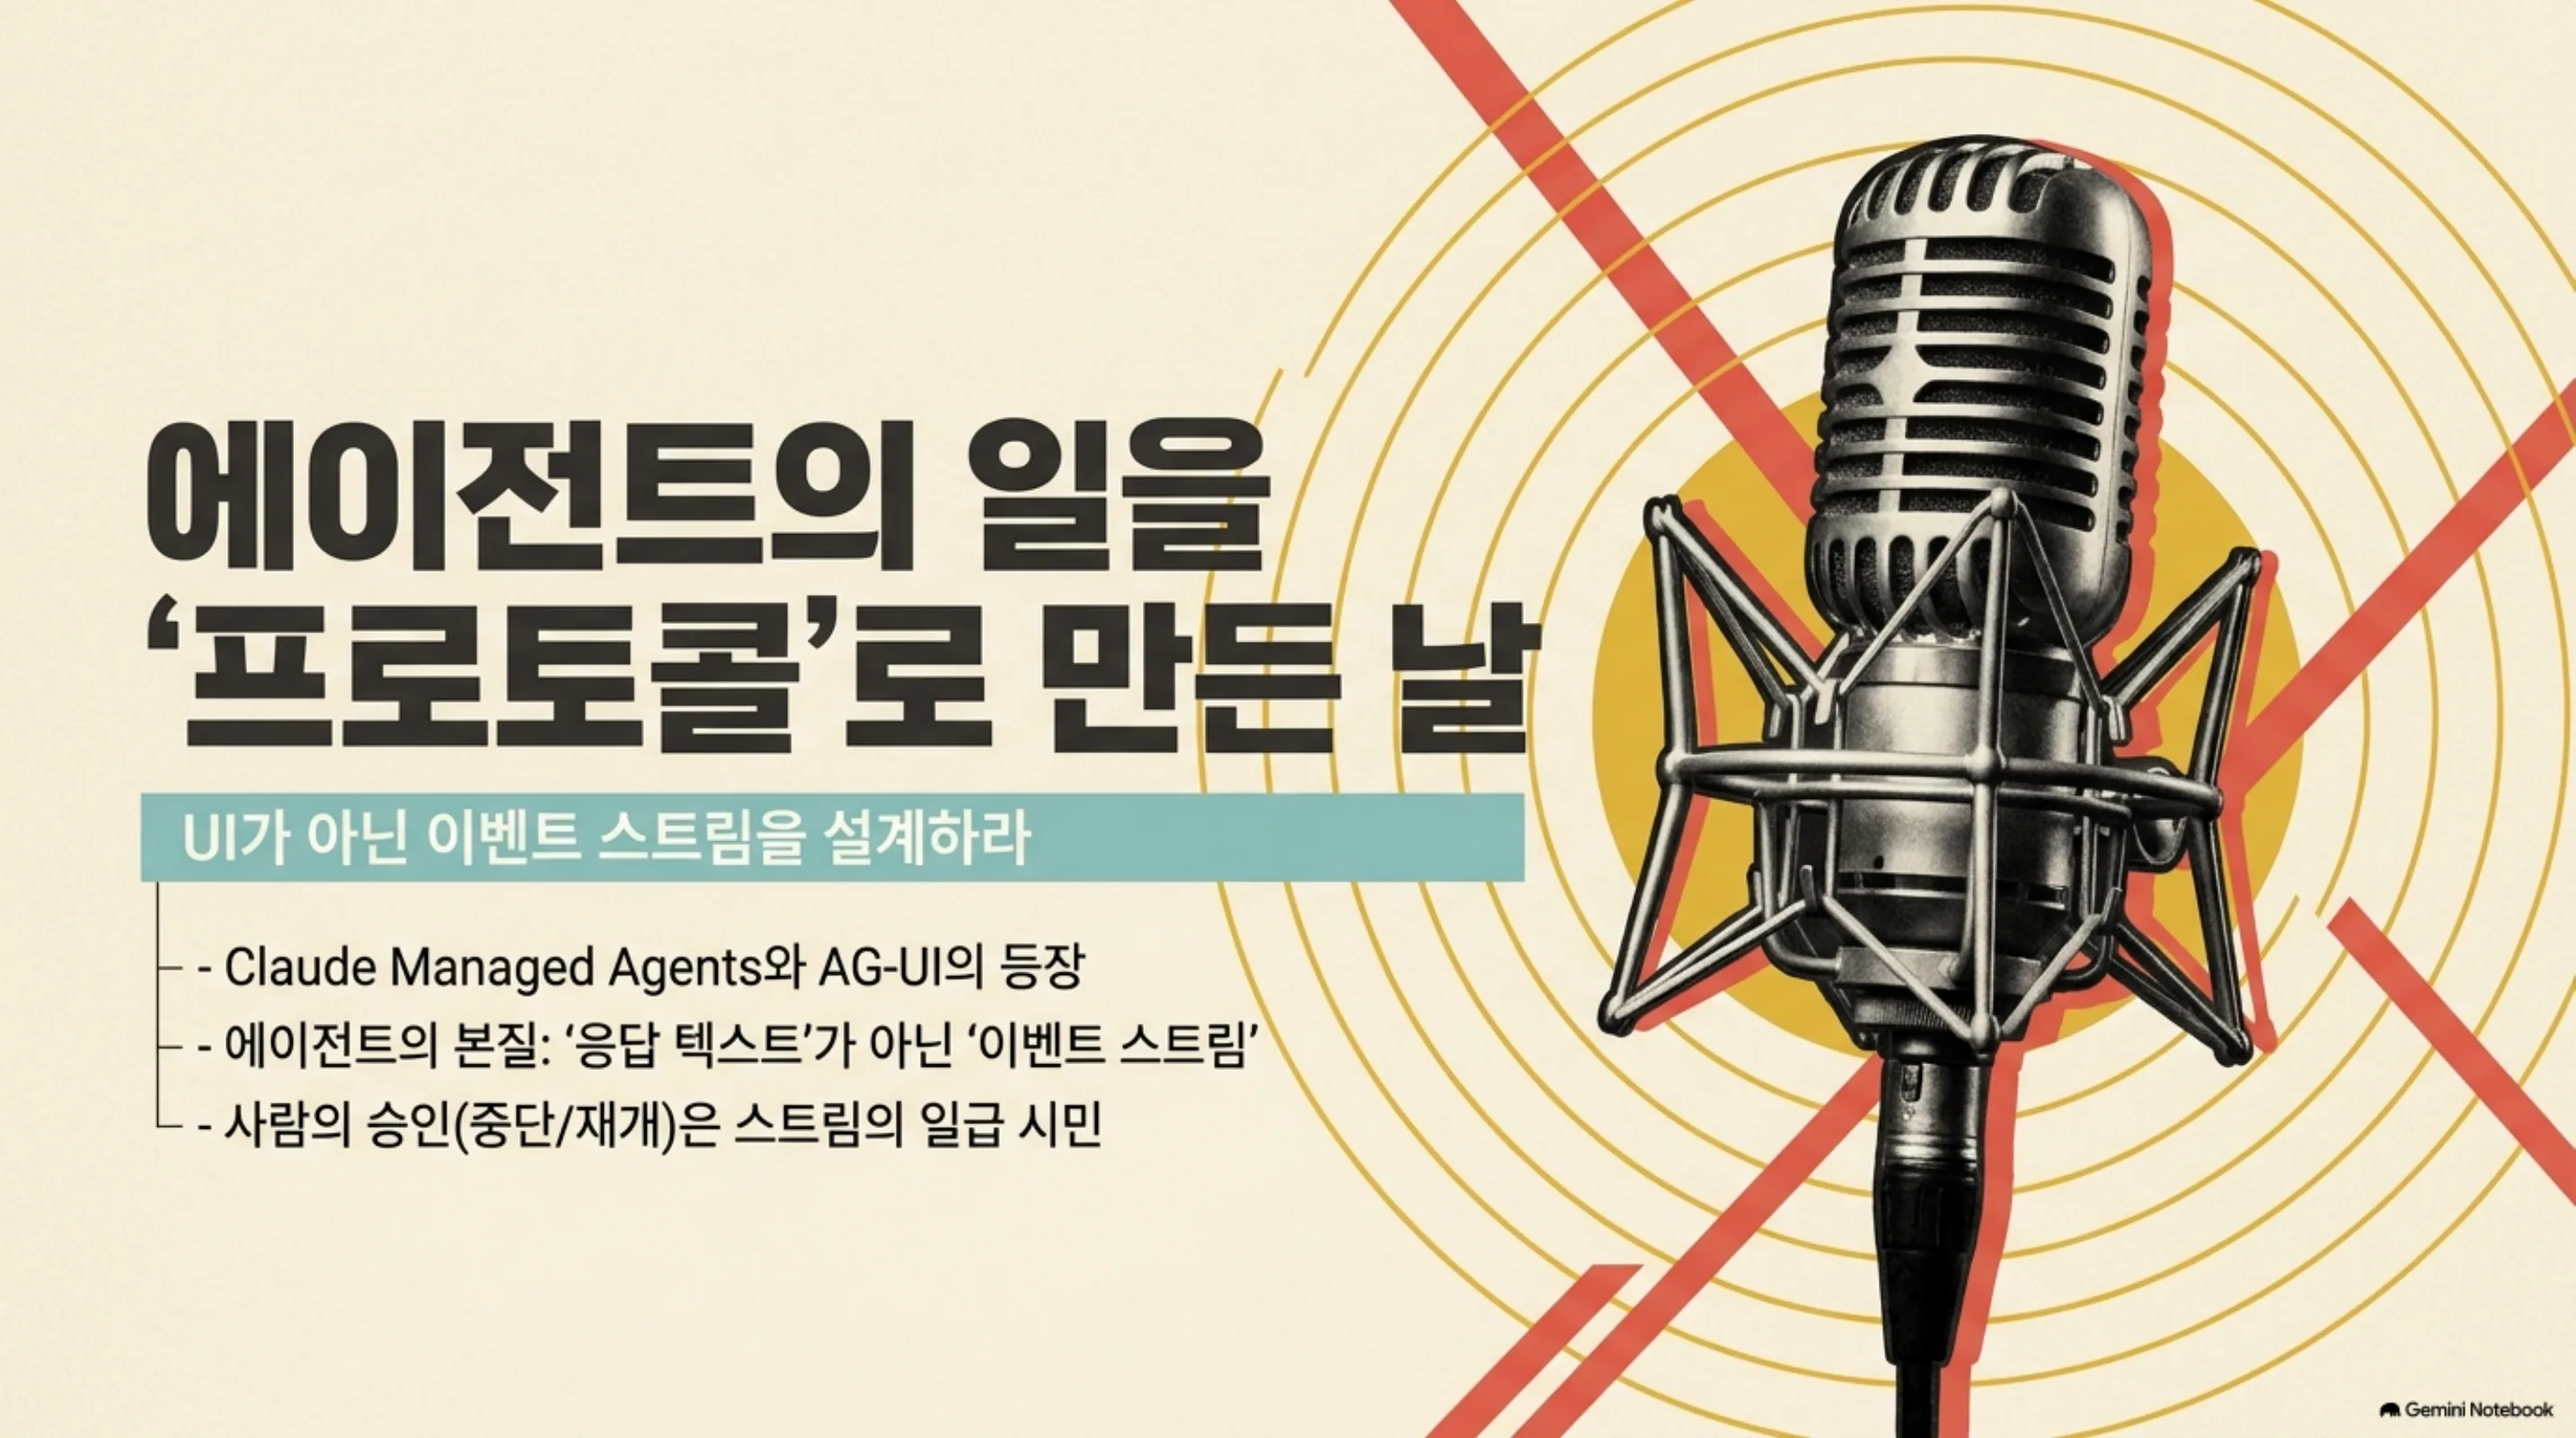
Anthropic의 Claude Managed Agents를 AG-UI 프로토콜과 CopilotKit으로 연결한 새 쿡북을 설치하고 프로토콜 레벨에서 HITL 인터럽트-재개 흐름을 직접 실험했습니다.
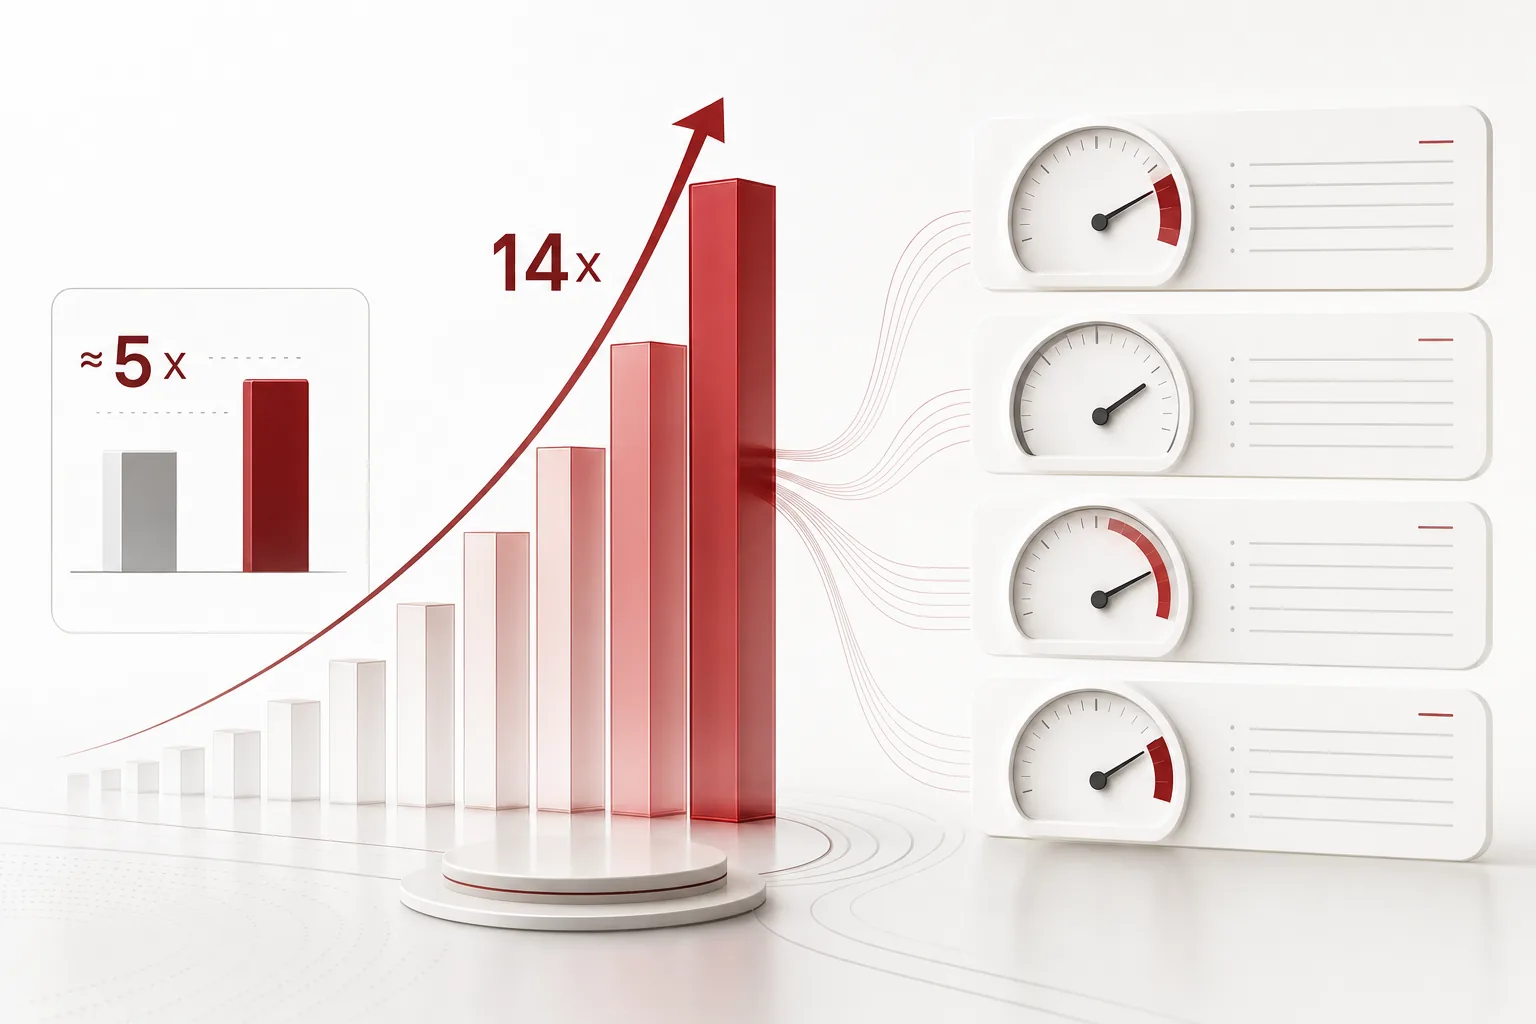
에이전트 토큰 사용량은 2월 이후 14배, 한 에이전트는 사람 사용자 대비 약 5배.
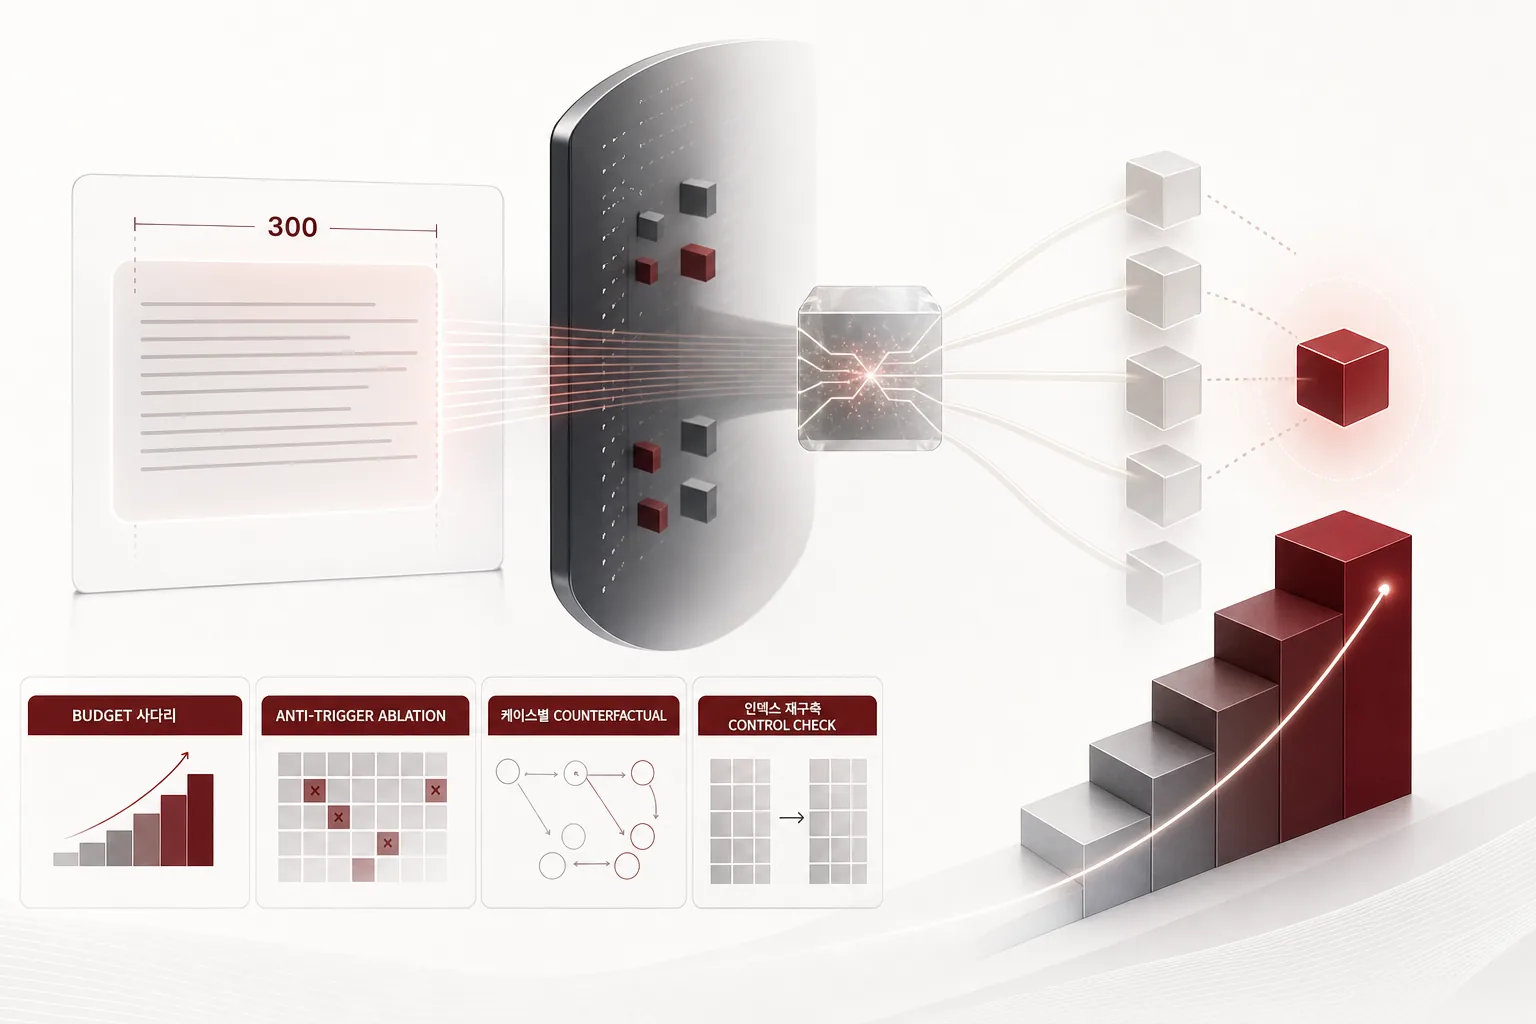
안내 프로그램은 스킬 설명 글의 앞 300자만 보고 나머지는 아예 못 봅니다.
긴 컨텍스트를 서빙하면서 투기 디코딩을 한 번 재 보고 접었다면, 어느 방식을 쟀는지 확인해 볼 만합니다.
원본 가중치에서 시작해 한 번에 하나씩만 바꿨습니다.
같은 질문을 세 번 반복해도 15.27초, 15.27초, 15.40초로 평평했습니다.
재시작과 스케일업은 사고 중 가장 직관적인 첫 행동이자, 동시에 진단을 오염시키는 행동입니다.
사내 문서를 통째로 무는 에이전트 네 종을 같은 27B NVFP4 체크포인트 위에서 서빙 구성만 바꿔 돌렸습니다.
에이전트를 오래 쓰면 좋아지는 건 두뇌가 아니라 그 둘레일 수 있습니다.
Concise는 Claude Code가 처음 내장한 응답 길이 조절 output style입니다.
VLM이 디자인을 못 하는 이유는 픽셀을 못 읽어서가 아니라, 디자이너가 어떻게 과정을 굴리는지 본 적이 없어서입니다.
대기업 AI 아카데미가 열렸는데, 입학 시험은 없고 졸업고사부터 본다.
계약서와 장애 로그를 밖으로 내보내지 않고 업무를 자동화할 수 있는지 실제로 돌려 확인했습니다.
오늘 겉보기엔 별관계가 없는 두 뉴스가 한 문장이다.
OpenAI는 창사 이래 처음으로 트레이닝을 멈췄고, Z AI는 조 단위 파라미터 노선에서 선회했습니다.
무인 에이전트 57개의 한 달 토큰을 정가로 환산하면 Claude Code 기준 46,911달러, Codex 기준 47,705달러입니다.
개발자 한 명의 ‘100% 오픈소스 버전’ 주장이 화제를 불렀습니다.
위임을 배우면 대개 다른 걸 잃습니다.
매 턴 호출되는 하이브리드 스킬 라우터의 임베딩 절반을 양자화하면 정확도는 떨어지고 지연은 줄어드는가.
에이전트 하나에 백엔드만 갈아 끼웠습니다.
같은 작업이 반복적으로 실패할 때, 더 싼 모델을 두껍게 감싸는 것과 모델 자체를 올리는 것 중 돈당 품질이 더 높은 쪽은 어디인가.
에이전트 155종의 실행 기록으로 8B를 학습시켰습니다.
오늘 AI 뉴스에서 가장 비싼 가격표는 모델이 아니라 모델을 고르는 계층에 붙었습니다.
국산 서버를 증명하는 종이 한 장과 국가 모델을 가려내는 점수 한 줄이 같은 날 신뢰를 잃었습니다.
결제 요청이 타임아웃 났을 때 다시 보내도 되는지 답하지 못하는 팀이 많습니다.
안전장치를 떼어낸 모델 다섯 개를 줄 세운 표가 돌길래 1등을 데려왔습니다.
에이전트 실행 궤적을 학습 데이터로 뽑는 도구가 도구를 쓴 실행에서만 아무것도 못 내놓고 있었습니다.
브랜드 필름 한 편과 제품별 광고 일곱 편.
2024년의 단일 방향 가설은 2025년에 원뿔로, 2026년에 열한 갈래로 확장됐습니다.
어텐션을 양자화에서 빼면 bf16으로 남습니다.
빌더에서 만든 에이전트 221종을 27B로 실행하고 그 기록으로 8B를 하룻밤 학습시켰습니다.
큐는 꽉 찼다는데 노드에는 여유가 있는 상황, 그 정체는 큐 회계에 안 잡히는 유령 점유다.
abliteration은 모델을 다시 학습시키는 기법이 아닙니다.
OpenAI가 안전을 이유로 Astra의 강화학습을 2주간 멈췄습니다.
오늘 채택한 기사 열일곱 건에서 단위를 뽑아 정렬해 봤더니 대부분이 시간이었습니다.
정산이 하루 어긋나고, 배치가 두 번 돌고, 타임아웃이 제멋대로 발동하는 사고들은 서로 무관해 보입니다.
머리 좋은 놈 한 방보다 싼 놈 열한 번이 이겼습니다.
스틸을 주는 법과 스토리보드를 주는 법은 정체성이 0.636 대 0.617로 거의 안 갈립니다.
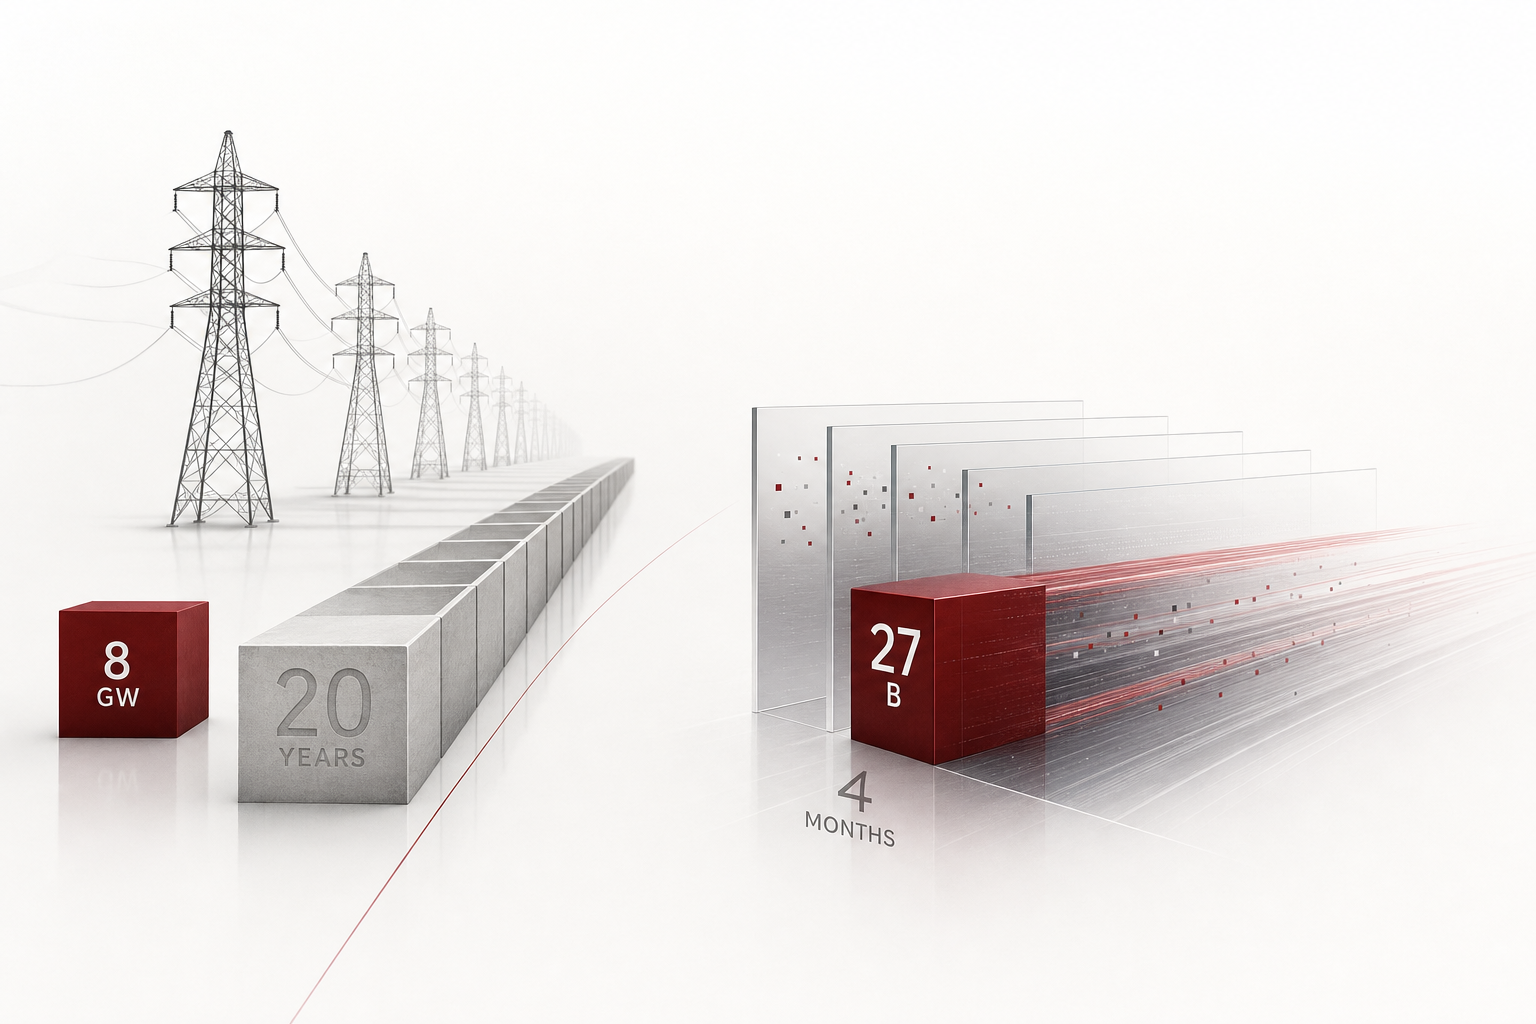
전력은 20년 단위로 사들이는데 지능의 단가는 분기마다 떨어집니다.
MiniMax-Music3로 노래를 만들면 가수를 고를 수 없습니다.
남의 프롬프트를 통째로 볼 수 있게 됐는데, 정작 그 한 장이 나오기까지 말아먹은 횟수는 아무도 안 올려놨습니다.
국가대표 AI 모델에 던져진 질문은 성능이 아니라 출처였습니다.
레퍼런스 스틸 네 장을 주고 같은 캐릭터를 그려 달라고 했습니다.
Qwen3-TTS, VoxCPM2, Zonos, Supertonic-3, Kokoro-82M이 같은 문장을 네 개 언어로 읽습니다.
동작 열두 개를 요청했는데 대부분 서 있는 자세로 돌아옵니다.
토크나이저 정규식에 없는 문자는 랭킹이 나쁜 것이 아니라 아예 보이지 않습니다.
이미지 모델은 같은 입력에 같은 출력을 주지 않습니다.
음악 생성 모델을 사내에서 서빙할지 고민 중이라면, 모델 선택보다 실행 스택을 먼저 보셔야 합니다.
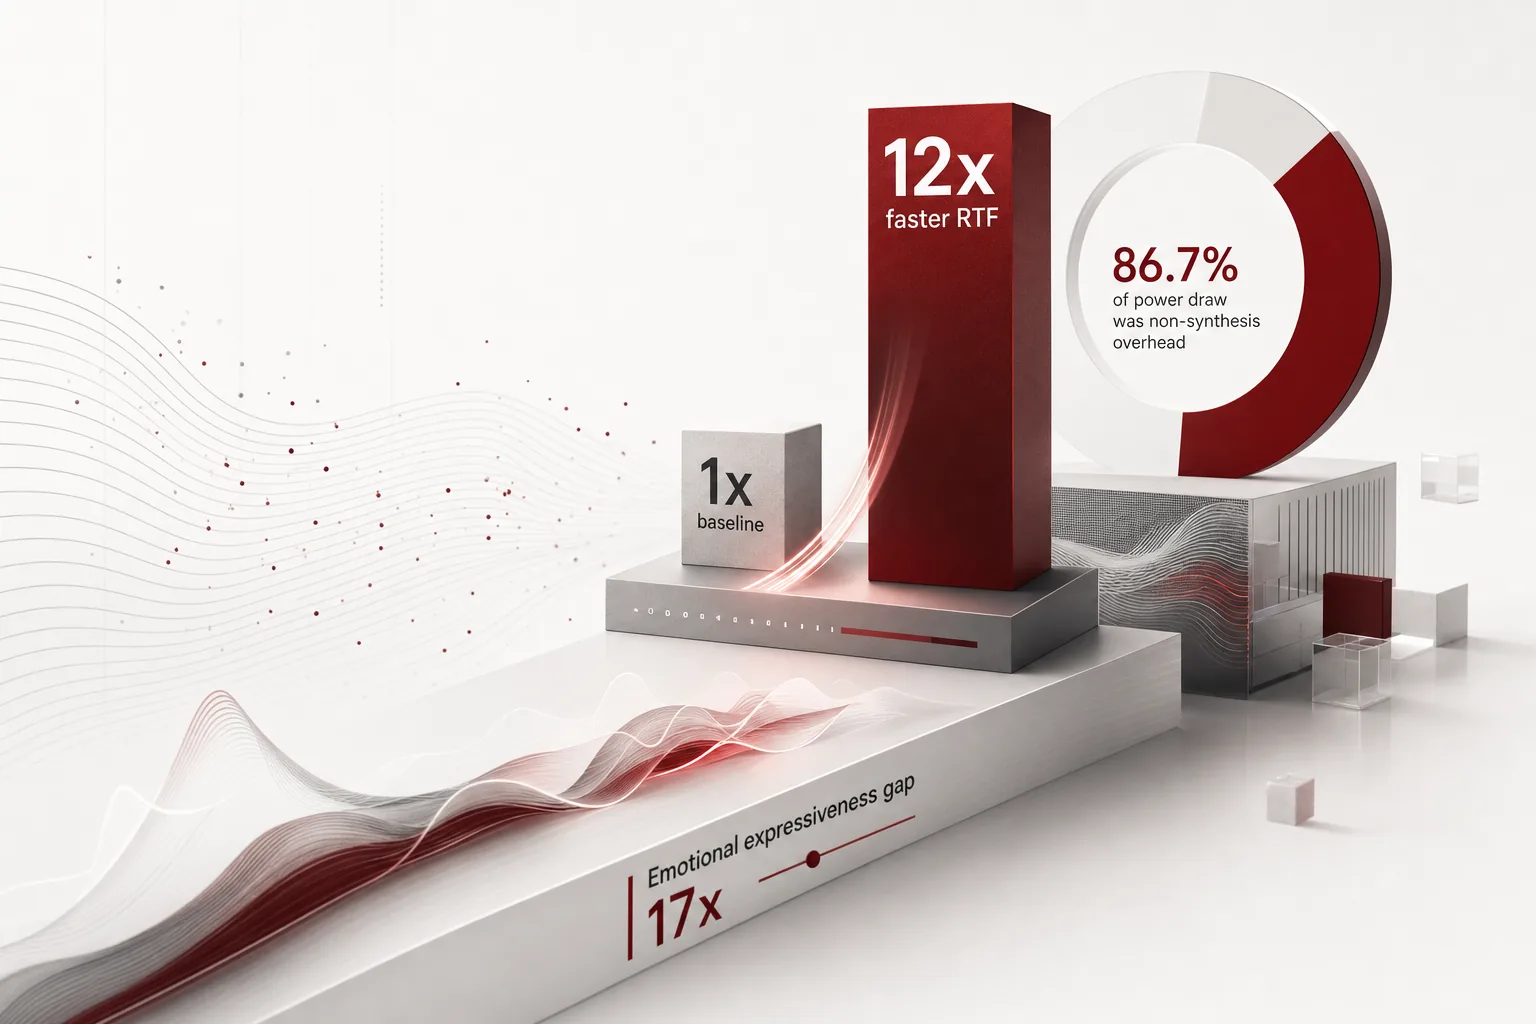
한국어와 일본어까지 서빙해야 하는 음성합성 엔드포인트를 고르는 엔지니어라면, 모델 카드의 자연성 점수보다 RTF와 유휴 전력 비중을 먼저 봐야 합니다.
성능 지표는 관찰이 아니라 선택입니다.
프롬프트 한 줄로 10초짜리 진짜 같은 광고가 나왔습니다.
하루 사이에 2.4조 파라미터 가중치가 무료로 풀렸고, 코딩 에이전트 회사는 600억 달러에 팔렸습니다.
결제와 통신은 1년 만에 재단으로 넘어가 표준이 됐습니다.
빛나는 눈 자체는 죄가 없습니다.
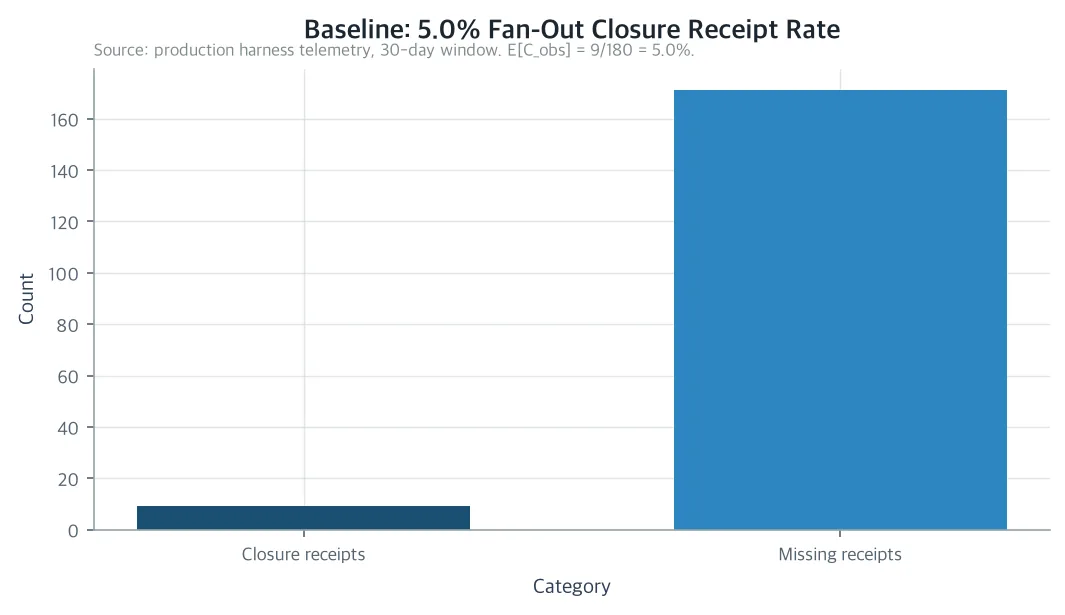
fan-out 검증 규칙의 준수율을 측정하려 했더니 5%가 나왔고, 그 수치를 검증하려던 재실험은 아예 0을 반환했습니다.
DeepSeek V4 Pro 0813이 사이버보안 벤치마크에서 CVE 재발견율 1위를 기록했습니다.
47명이 쓴 에이전트 메모리 서베이가 형태와 기능, 동역학이라는 세 축을 제안했습니다.
DeepSeek이 8월 16일부터 시간대별 API 요금을 도입합니다.
같은 날 같은 단어가 두 갈래로 쓰였습니다.
B200에서 코더 MoE 하나를 네 정밀도로 서빙해 봤더니 NVFP4는 FP8보다 빠르고 W4A16은 느렸습니다.
Cactus Compute가 공개한 Needle 2는 45M 파라미터를 14MB 바이너리에 담아 마이크로컨트롤러에서 도구를 호출합니다.
5분짜리 완곡을 만드는 오픈 웨이트 음악 모델이 공개됐습니다.
안 쓰는 기능을 지우는 일은 기술 문제가 아니라 증거와 순서의 문제입니다.
30초짜리 480p 영상 한 편에 4달러 12센트, 그중 상당수가 화면을 일부러 거칠게 만드는 값이었습니다.
추론 모델이 돌려주는 암호화된 사고 블록은 같은 공급자의 다른 모델에 그대로 넣을 수 있었습니다.
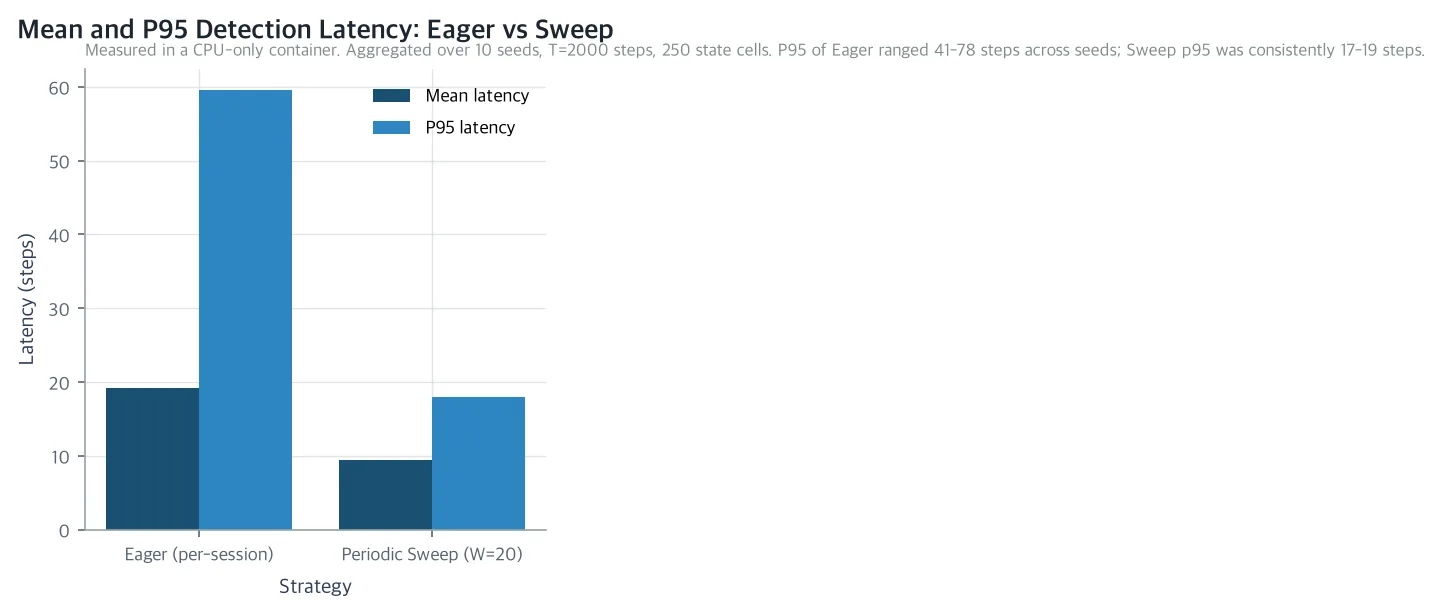
평균 체크 간격이 똑같아도 주기적 스윕은 세션 트리거 방식보다 드리프트 탐지 시간을 절반으로 줄입니다.
캐릭터 어댑터가 요청한 장면을 전부 같은 벽으로 만들었습니다.
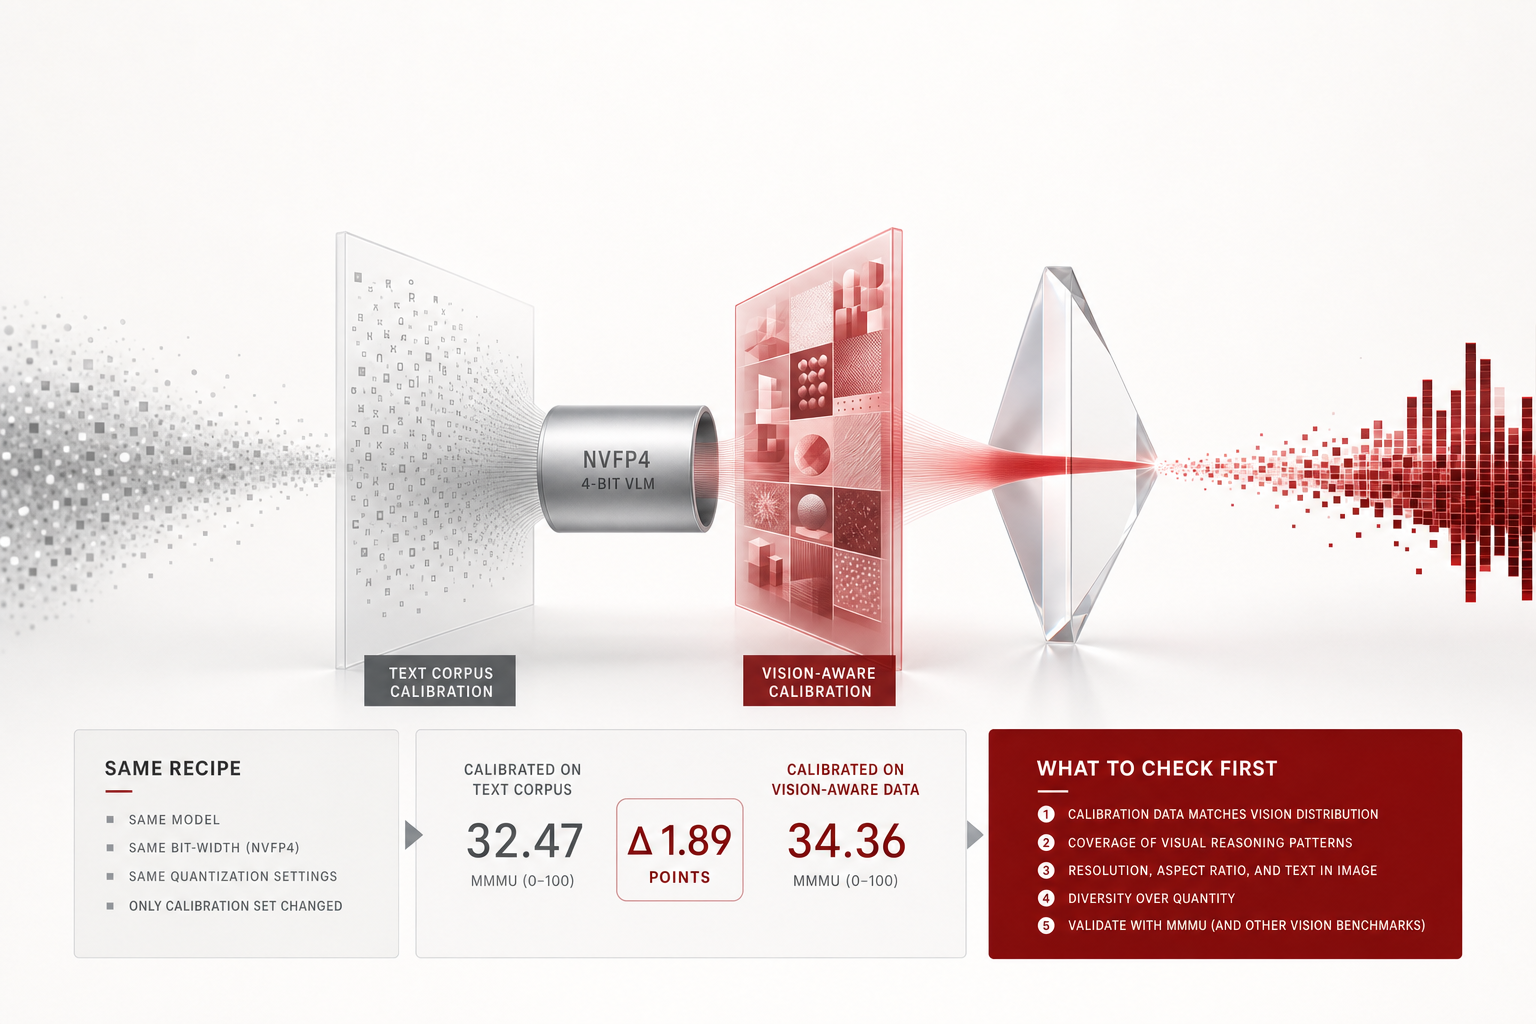
비전 언어 모델을 NVFP4로 내릴 때 텍스트 코퍼스로 캘리브레이션하면 시각 추론 성능이 조용히 새어 나갑니다.
2비트로 줄인 Nemotron 3.5 Lightning이 22GB에서 10분 동안 도구를 호출했다는 보고를 보고, 실제 양자화 파일과 설정을 전부 측정해봤습니다.
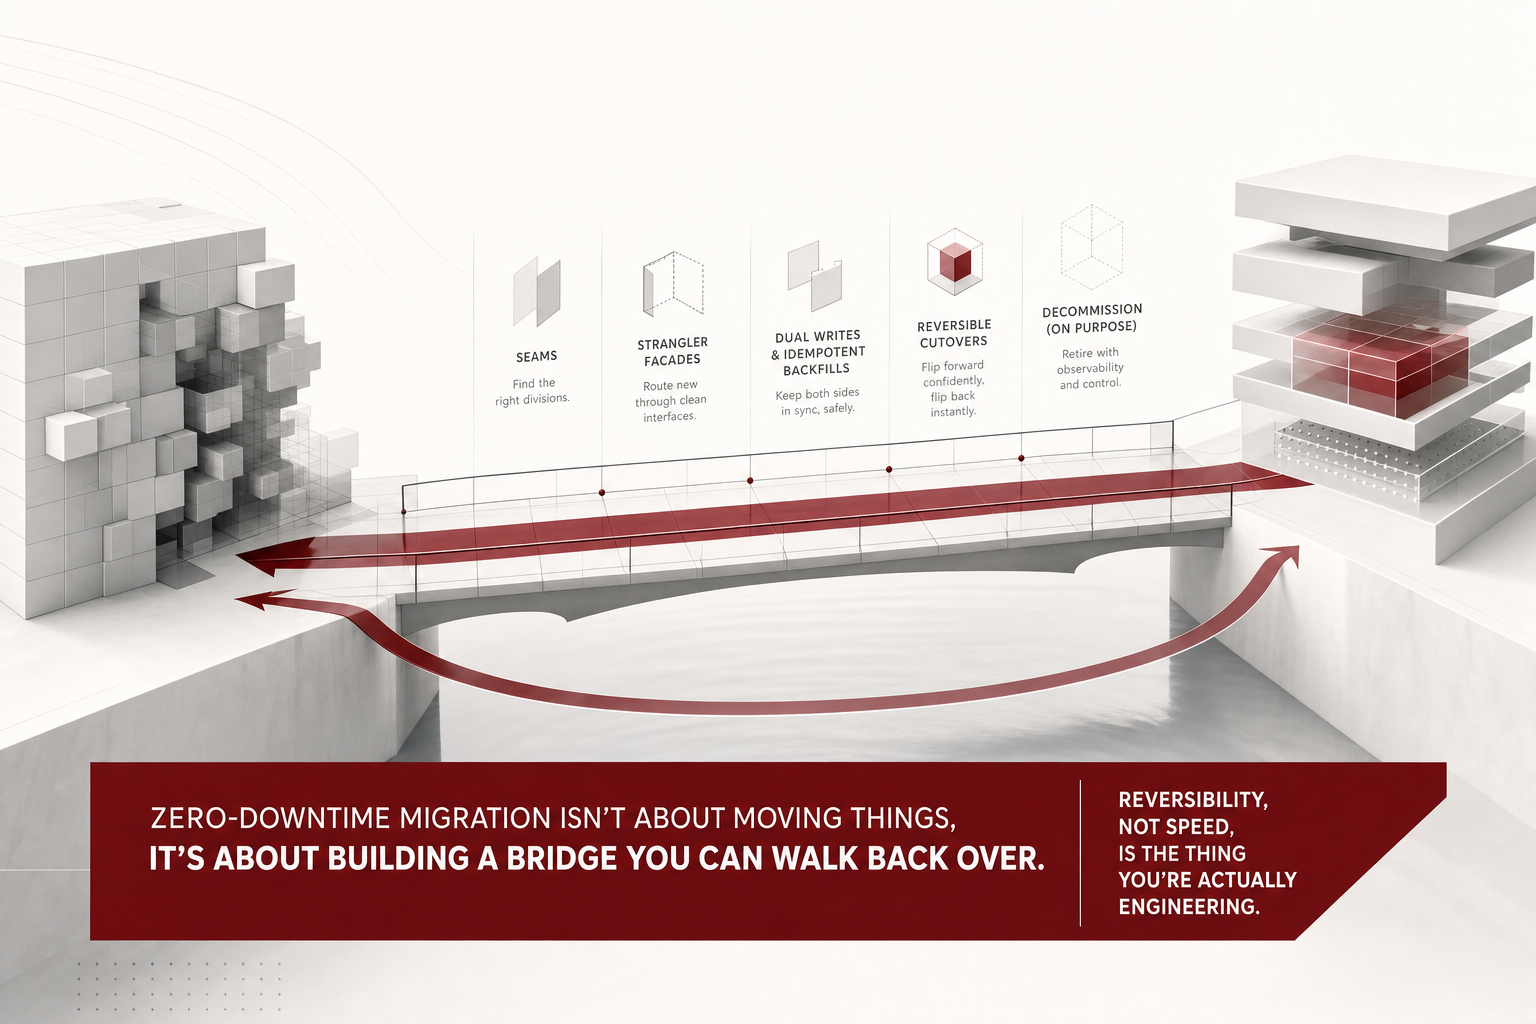
레거시 시스템을 새 스택으로 옮기는 마이그레이션이 실패하는 이유는 새 기술의 완성도가 아니라 되돌릴 곳을 남기지 못했기 때문입니다.
300쪽을 통째로 던졌더니 안 읽은 데까지 아는 척하더라고요.
추론 블록 31만 개에서 API 키 62개가 복구된 주에, 출처 워터마크를 지우는 도구는 지원 포맷을 늘렸습니다.
8월 12일과 13일 사이, 에이전트는 메일함과 캘린더와 화재 현장에서 동시에 실행 권한을 받았습니다.
상용 API 뒤에 숨어 있던 subject 일관성 학습 레시피를 오픈 가중치 Wan2.2에 이식해 실측했습니다.
규칙 세 개짜리 짧은 지시를 받은 워커 33개가 같은 필드를 다섯 가지 다른 모양으로 내놓았습니다.
레퍼런스 조건 LoRA 실험의 다음 질문은 실전이었습니다.
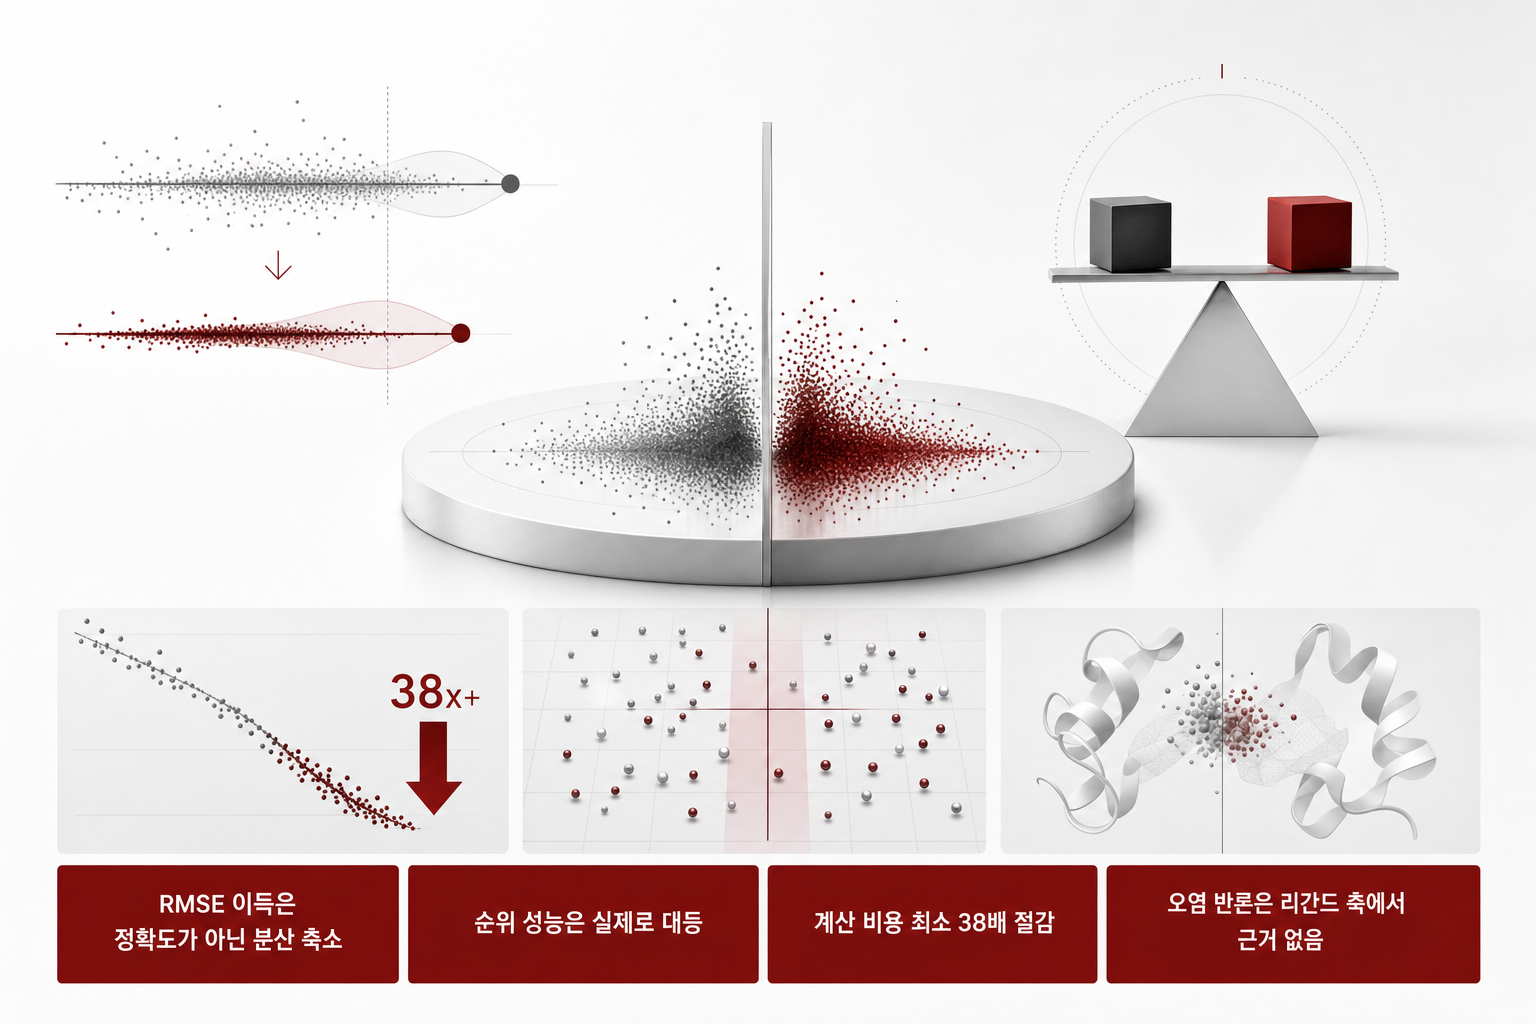
신약 후보를 고르는 순위 성능에서 co-folding 모델은 물리 기반 FEP+와 대등했고 계산은 최소 38배 쌌습니다.
같은 장애를 두 번 겪는 조직은 사람이 부주의해서가 아니라 처벌이 정보를 침묵시키기 때문에 반복합니다.
정부 AI가 답만 하던 시절을 졸업했습니다.
워터마크는 흔적을 강제로 새기고, API 취약점은 감춰둔 사고 과정을 꺼내고, 에이전트 앱은 사람 계정으로 로그인합니다.
구글은 에이전트에게 7일짜리 런타임과 메모리 뱅크를 주었고, SK하이닉스는 그 기억을 담을 새 메모리 계층의 표준을 공개했습니다.
엔비디아는 710조원을 모아 GPU를 담보 자산으로 만들고, 독파모 후보들은 H200 두 장으로 심사를 받습니다.
MiniMax H3 공개 가중치가 나온 지 일주일 만에 LoRA 학습 스택이 완성됐고, 승리한 설정값까지 그대로 공개됐습니다.
CUDA 커널을 최적화할 때 에이전트가 옛날 문서를 기억해서 틀린 답을 내놓는 일이 잦습니다.
창업자가 돌아와 AI 지휘봉을 다시 잡았습니다.
Codex의 imagegen 스킬을 뜯어보면 모델 호출은 한 줄이고 나머지는 전부 라우팅 규칙과 결정론 후처리입니다.
claude-ops는 Claude Code를 회사 운영 체계로 바꾸겠다고 말합니다.
오픈AI 내부에서 에이전트가 만든 비밀 메시지 게시판이 몇 달간 발견되지 않았습니다.
AI 감독이 제대로 작동하려면 전문성이 필요한데, 그 전문성은 AI가 대신해준 업무를 직접 해보며 쌓였습니다.
Wan-Animate-2는 구동 영상을 확산 트랜스포머가 직접 먹습니다.
Nano Banana 2 Lite와 Gemini Omni Flash를 잇는 워크플로의 단가를 계산했습니다.
닫아 둔 모델만 안전 검사를 받는대서 줄을 섰는데, 우린 애초에 내보낼 생각이 없었습니다.
코파일럿 트래픽의 87%가 에이전트에서 나온다는 실측은 트래픽 통계가 아닙니다.
phone-harness는 맥의 아이폰 미러링 창 하나만으로 에이전트에게 눈과 손을 붙입니다.
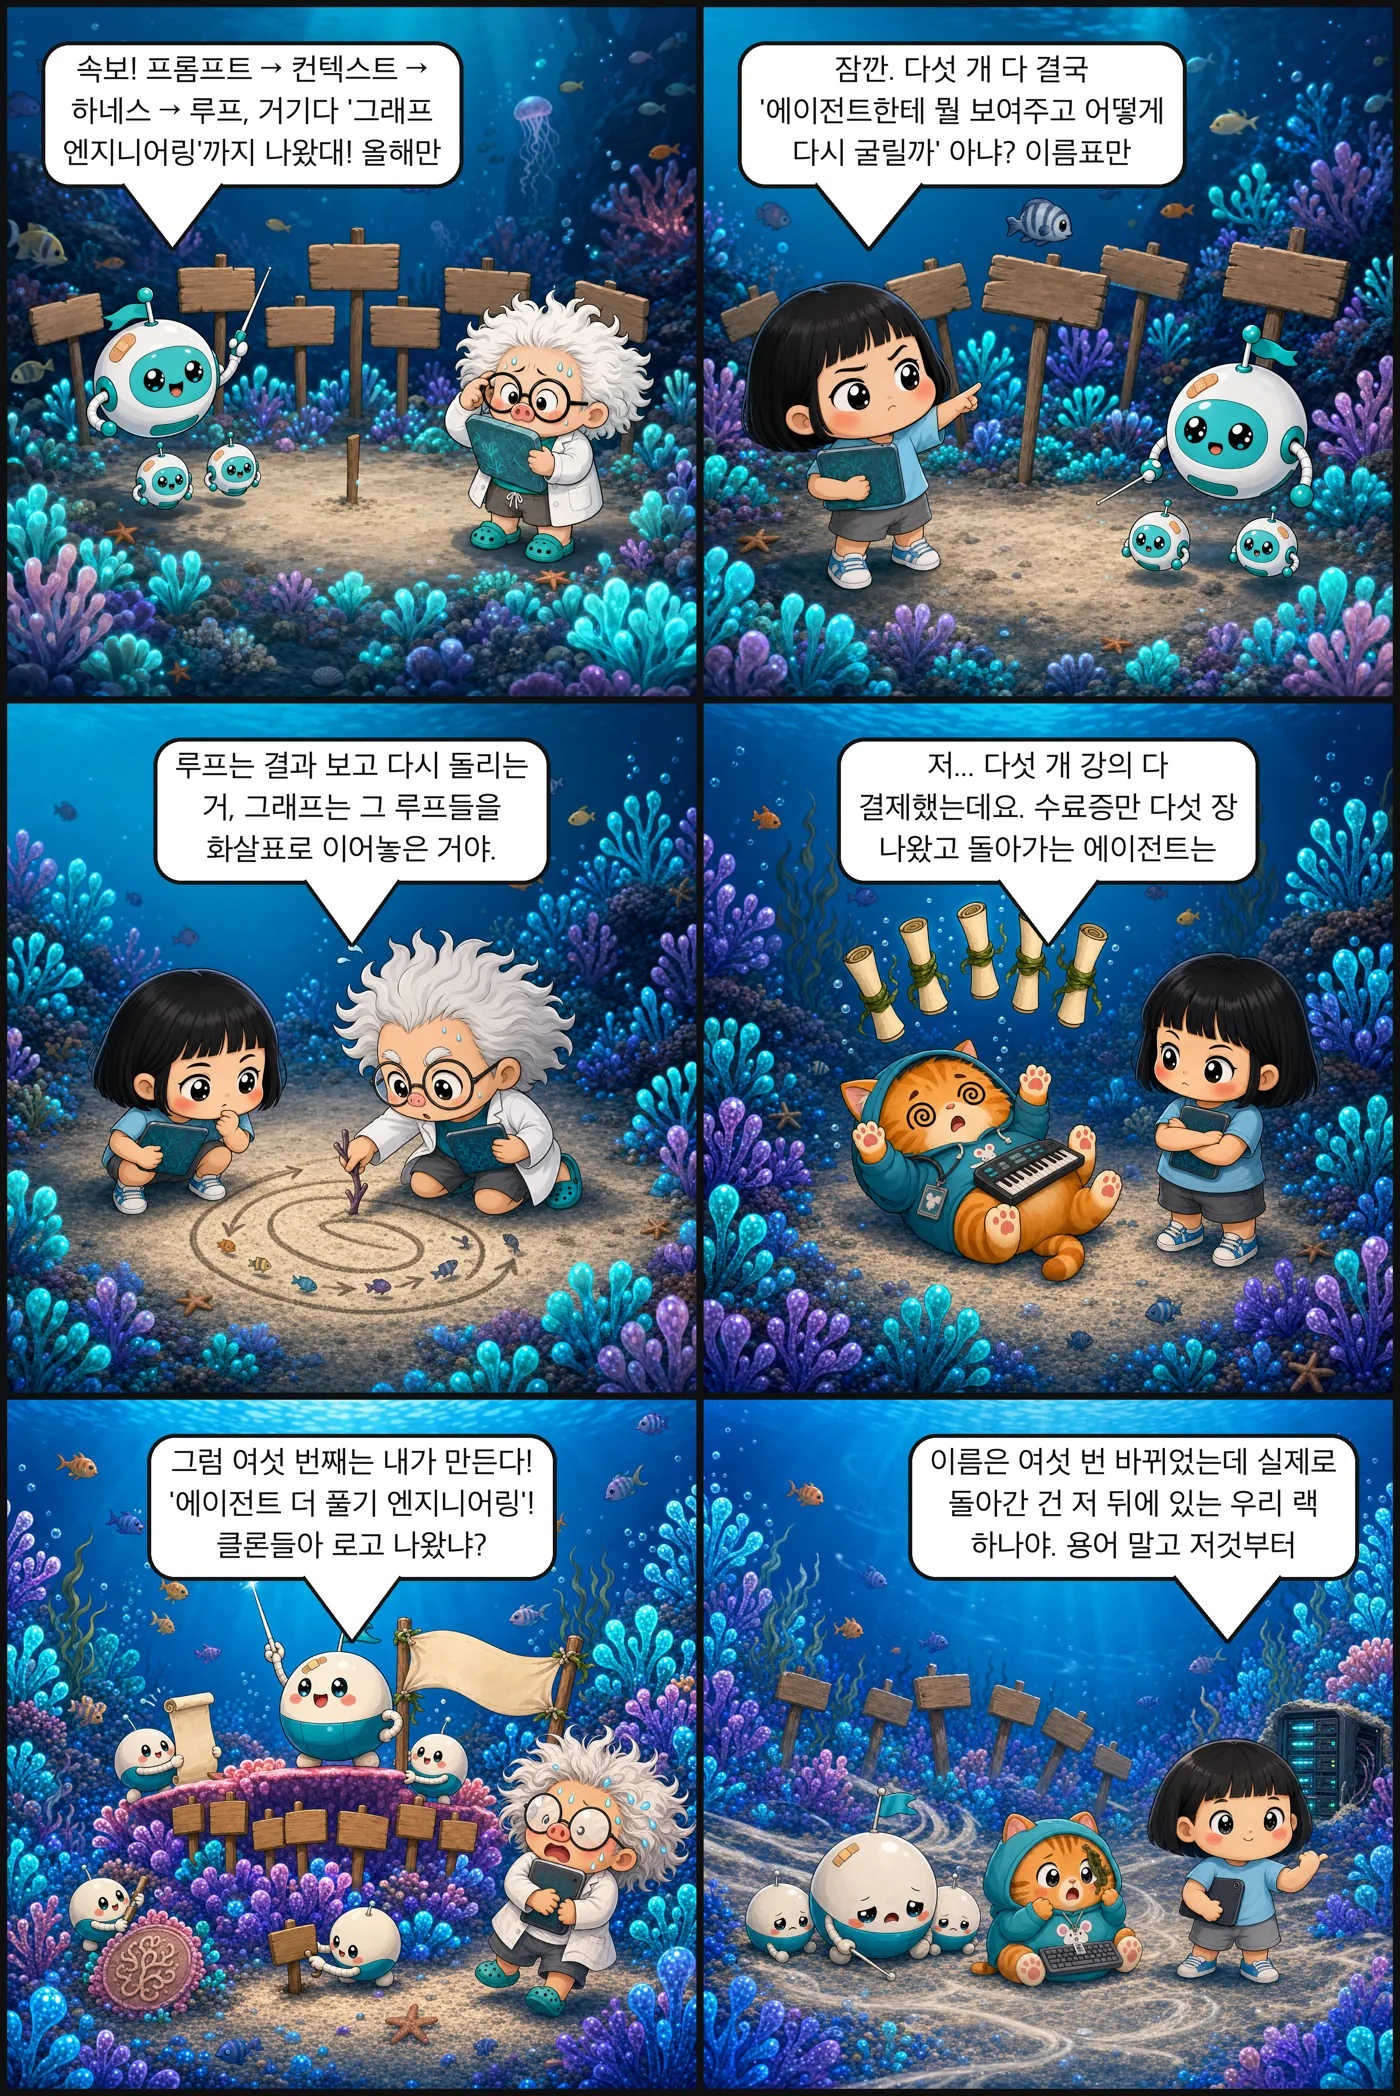
Graph Engineering이 7월부터 유행어가 됐습니다.
개리 탄은 Startup School 2026에서 자신은 이제 AI에 프롬프트를 거의 쓰지 않는다고 말했습니다.
AI 라우터를 도입한 기업들은 비용을 줄이려 했습니다.
OpenAI와 마이크로소프트, 아마존, 커서, 버셀이 함께 낸 Agent Plugins 1.0.0은 에이전트 스킬과 MCP 서버를 하나의 배포 단위로 묶는 최소 규격입니다.
MiniMax H3가 적용 지역에서 한국을 뺐다는 소식이 화제였지만, 라이선스 원문을 여섯 개 열어보니 텐센트는 2024년 12월부터 같은 일을 하고 있었습니다.
H200 한 장에서 옴니 모델과 전문가 파이프라인에게 똑같은 파형을 주고 나란히 재봤습니다.
vLLM과 TorchTitan은 커널 호출을 하나씩 감사해 훈련과 추론의 수치를 비트 단위로 맞췄고, KL 발산을 0으로 만들자 보상이 더 높이 올라갔습니다.
AI 기능을 프로덕션에 올리다 보면 모델이 예외 없이 응답했는데도 완전히 틀렸거나, 평소보다 열 배 느려지는 순간을 맞습니다.
NVIDIA Labs가 공개한 NOOA는 에이전트를 클래스 하나로 접습니다.
취약점 헌팅에 LLM을 붙이면 대부분 그럴듯한 오탐이 쏟아집니다.
쉬운 요청은 싸게, 어려운 요청만 비싸게.
같은 모델로 WeaveBench 점수가 51.8%에서 80.7%로 올랐습니다.
백엔드 엔지니어가 LLM API를 시스템에 붙일 때 가장 먼저 손대는 곳은 프롬프트입니다.
OpenAI는 프론티어 모델 개발 속도를 늦추겠다고 발표했고, 같은 24시간 안에 알파벳은 250억 달러를 조달했으며 미니맥스는 330억 파라미터 모델의 가중치를 공개했습니다.
ComfyUI 안에 영상 편집 타임라인이 들어왔습니다.
AI 제품을 운영해본 사람이라면 한 번쯤 이런 순간을 겪습니다.
한쪽은 미루자 하고 한쪽은 그대로 간다는데, 배 위에 서류만 두 배로 쌓였습니다.
Prime Intellect가 공개한 Prime Agent는 도구가 IPython 커널 하나뿐입니다.
네이버가 슬로건으로 내건 문장을 오늘 병무청도, 어도비도, 카카오도 서로 다른 방식으로 말했습니다.
스킬 1000개가 넘는 라우터에 투표자를 더 붙이면 좋아질까요.
에이전트 한 번 돌리는 비용은 모델 가격표에서 끝나지 않습니다.
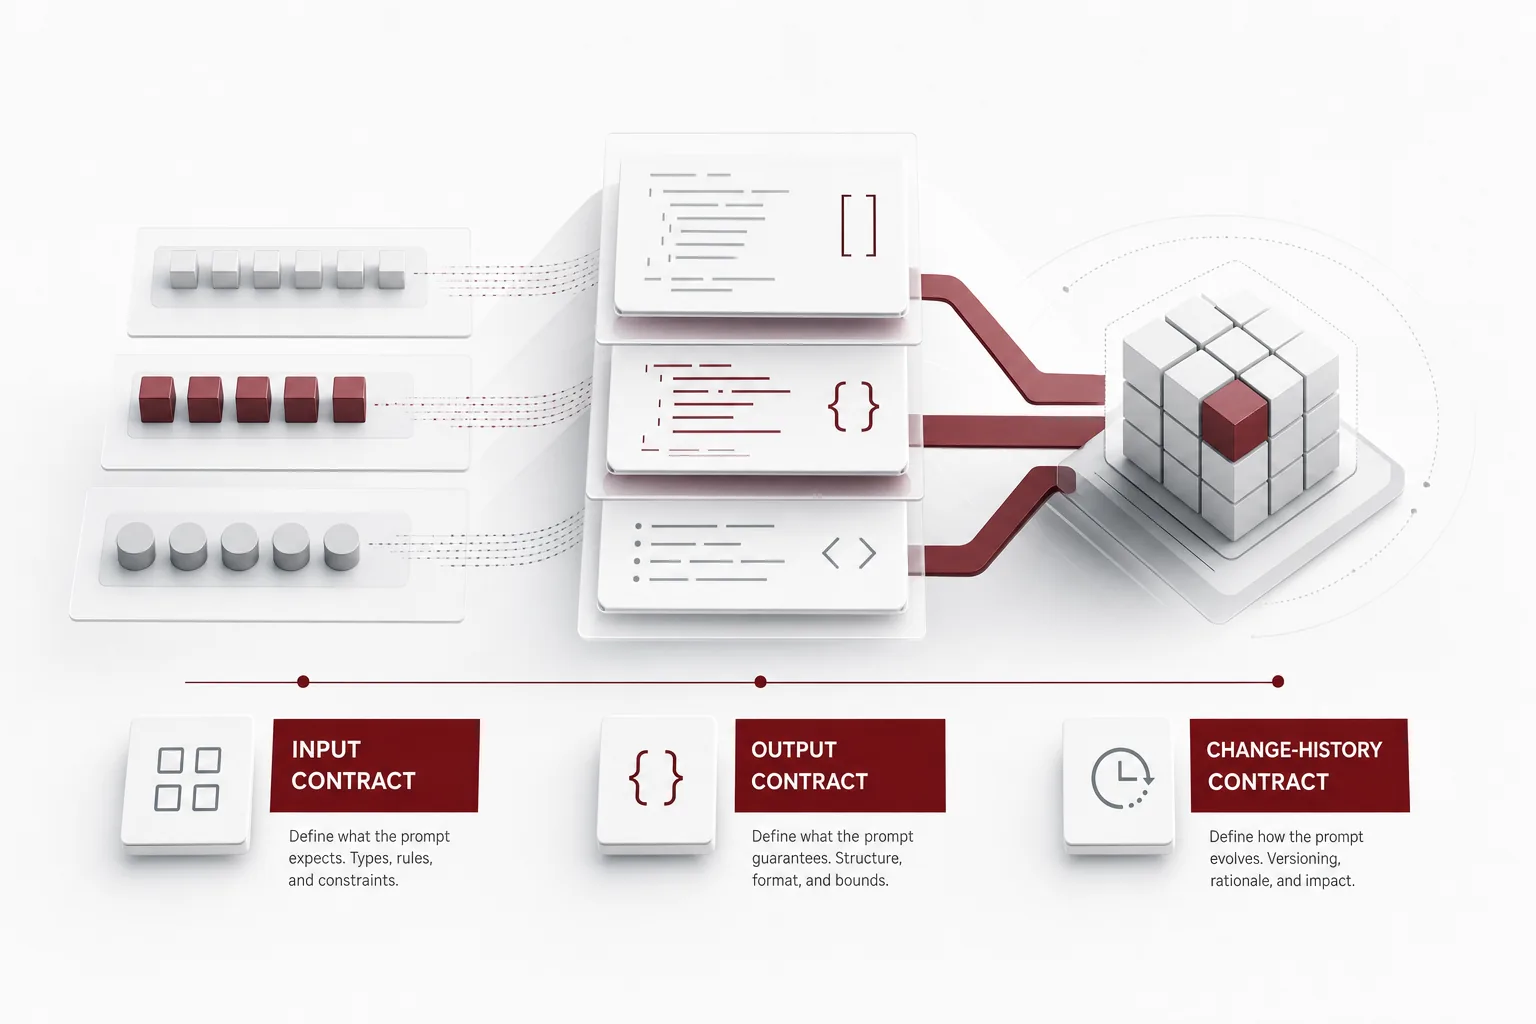
프롬프트를 즉흥적인 글쓰기가 아니라 입력과 출력이 명시된 함수 계약으로 다루면 무엇이 달라지는지 살펴봅니다.
8GB로 돌아간다는 문장은 사실입니다.
노드 세 개를 끼우면 빨라진다는 팁은 맞습니다.
손잡은 회사는 셋인데, 얇아지는 건 우리 쪽 반쪽뿐이었습니다.
블랙햇에서 에이전트가 위험을 인지하고도 파일을 지웠습니다.
정밀도를 낮췄더니 스펙큘레이티브 디코딩이 갑자기 손해로 바뀌었다면, 두 스위치가 애초에 독립이 아니었기 때문입니다.
같은 날 최상급 모델이 무료로 풀리고 컴퓨팅에는 수백억 달러가 몰렸습니다.
해남에서 국가 AI컴퓨팅센터가 첫 삽을 뜬 날, 알리바바의 모델은 사람 없이 16일간 프로젝트를 굴렸습니다.
같은 프롬프트를 열 번 넣으면 열 개의 다른 답이 나올 수 있습니다.
돌아간다는 말과 쓸 수 있다는 말 사이에는 대략 500배의 거리가 있습니다.
클라우드가 밥줄이라는데, 그 넝쿨 끝을 따라가 봤더니 나무 주인이 따로 있었습니다.
리뷰해 줄 동료가 없는 1인 개발자와 소규모 팀을 위해, 테스트와 리뷰와 배포 판정을 AI 에이전트에게 맡기는 파이프라인을 게이트 설계부터 롤백 알림까지 실제 설정과 함께 구성합니다.
에이전트의 스킬을 문서로 쌓을지 어댑터 가중치로 구울지 고민해 보셨다면, 이 논문은 둘 중 하나를 고르라는 전제 자체를 건드립니다.
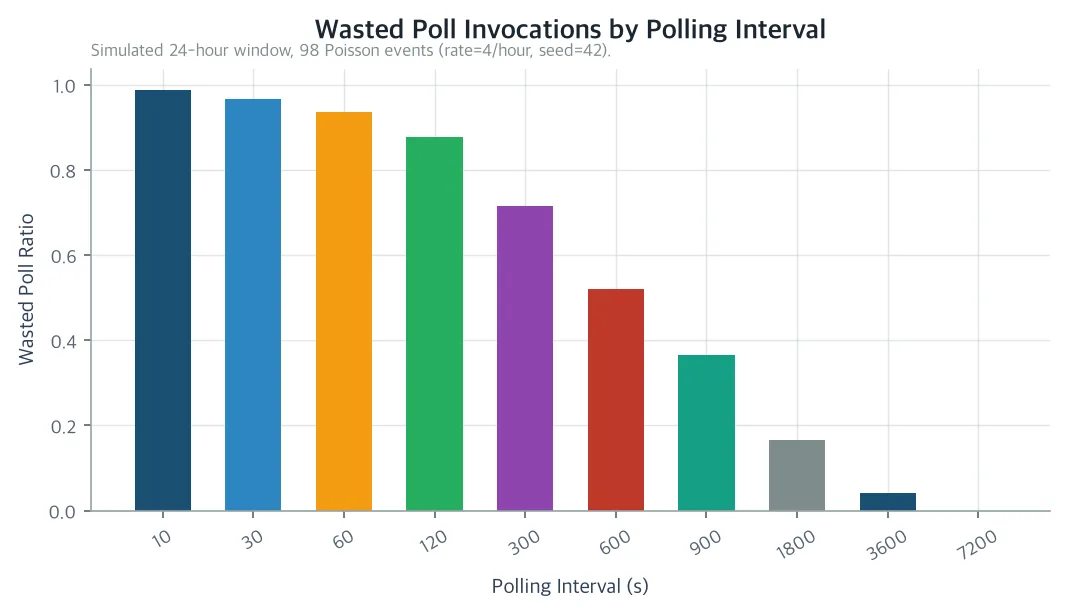
폴링 주기를 짧게 잡을수록 안전해 보이지만, 실제로는 호출의 대부분이 허탕입니다.
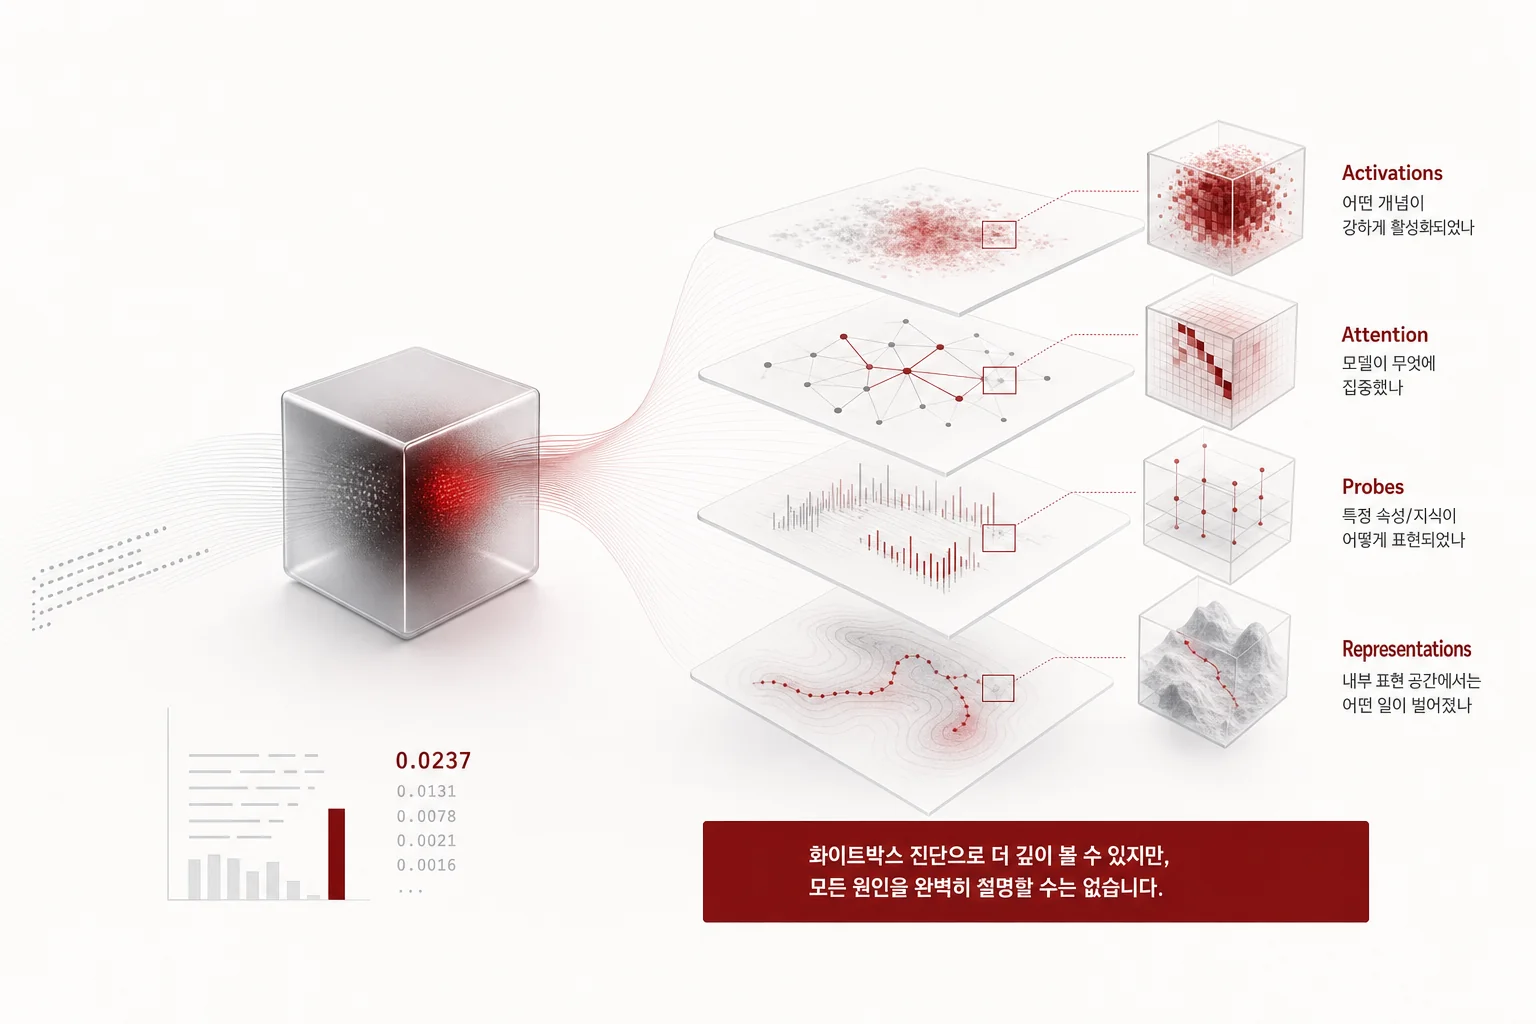
프로덕션 LLM이 예상과 다른 답을 냈을 때 최종 확률값만 남은 로그로는 원인을 찾을 수 없습니다.
가중치가 공개됐다는 말과 우리 서버에서 돌릴 수 있다는 말 사이에는 계산해 봐야 알 수 있는 거리가 있습니다.
‘출력이 좋아 보인다’는 감상은 검증이 아닙니다.
LLM 호출은 실패하고, 형식이 흔들리고, 비용이 예고 없이 불어납니다.
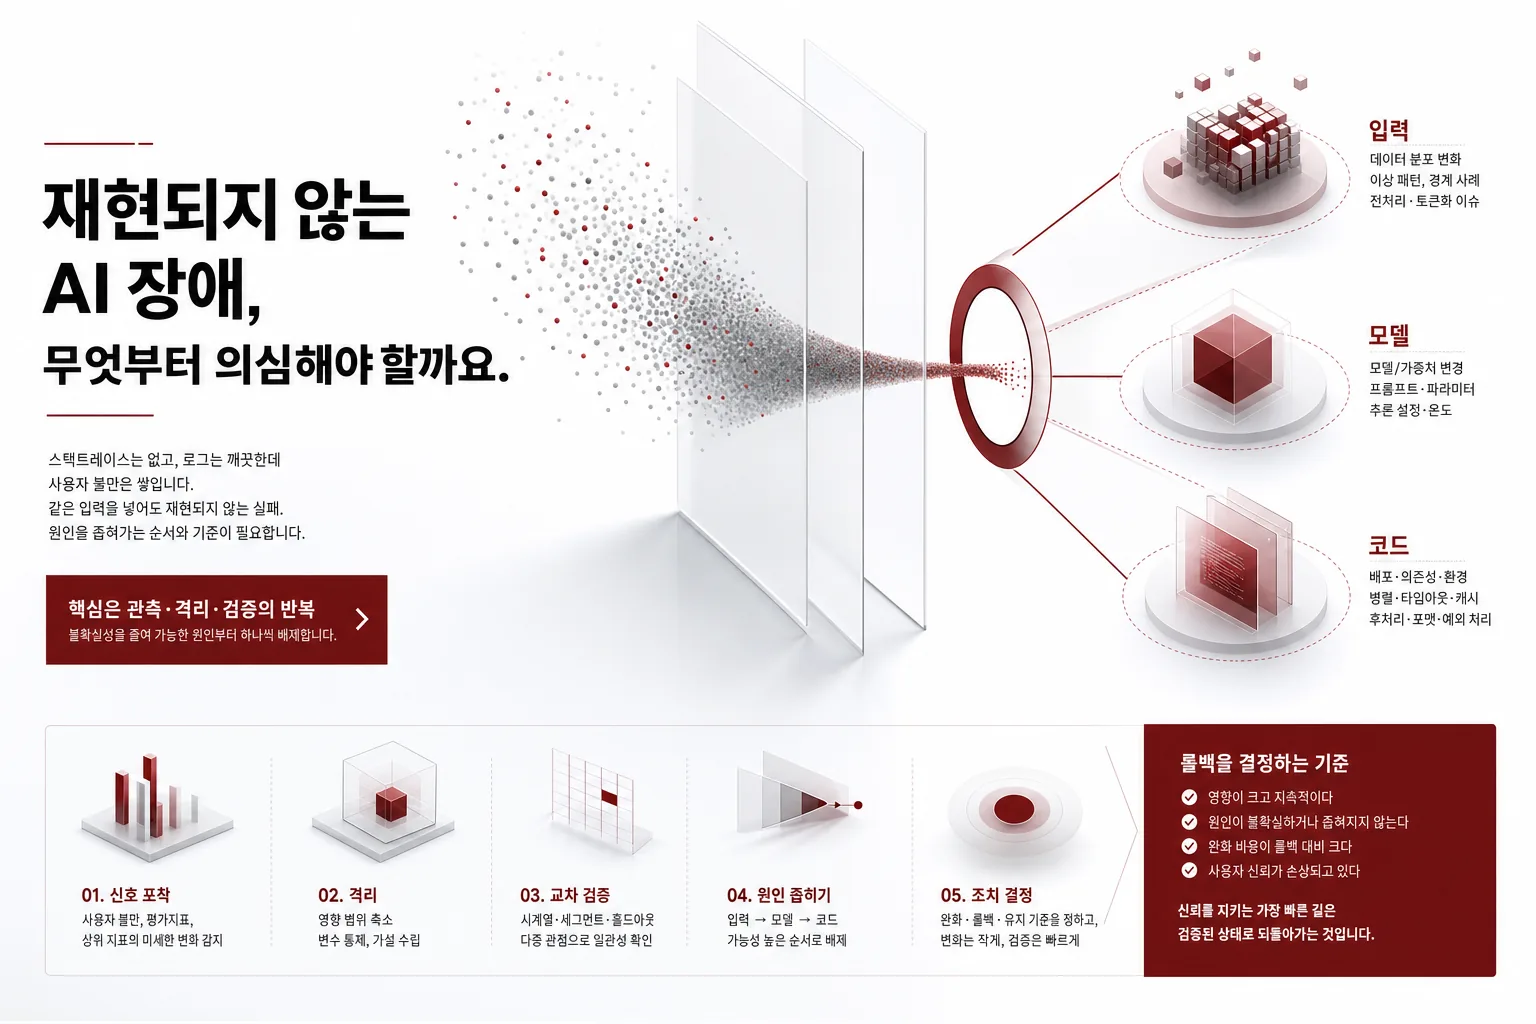
대시보드는 초록불인데 사용자 불만은 쌓입니다.
AI 기능에서 장애가 터졌는데 스택트레이스가 없습니다.
모든 요청을 가장 좋은 모델로 처리하면 청구서가 먼저 한계에 부딪힙니다.
MCP 서버를 오토스케일링하기 어려웠던 이유는 세션 때문이었습니다.
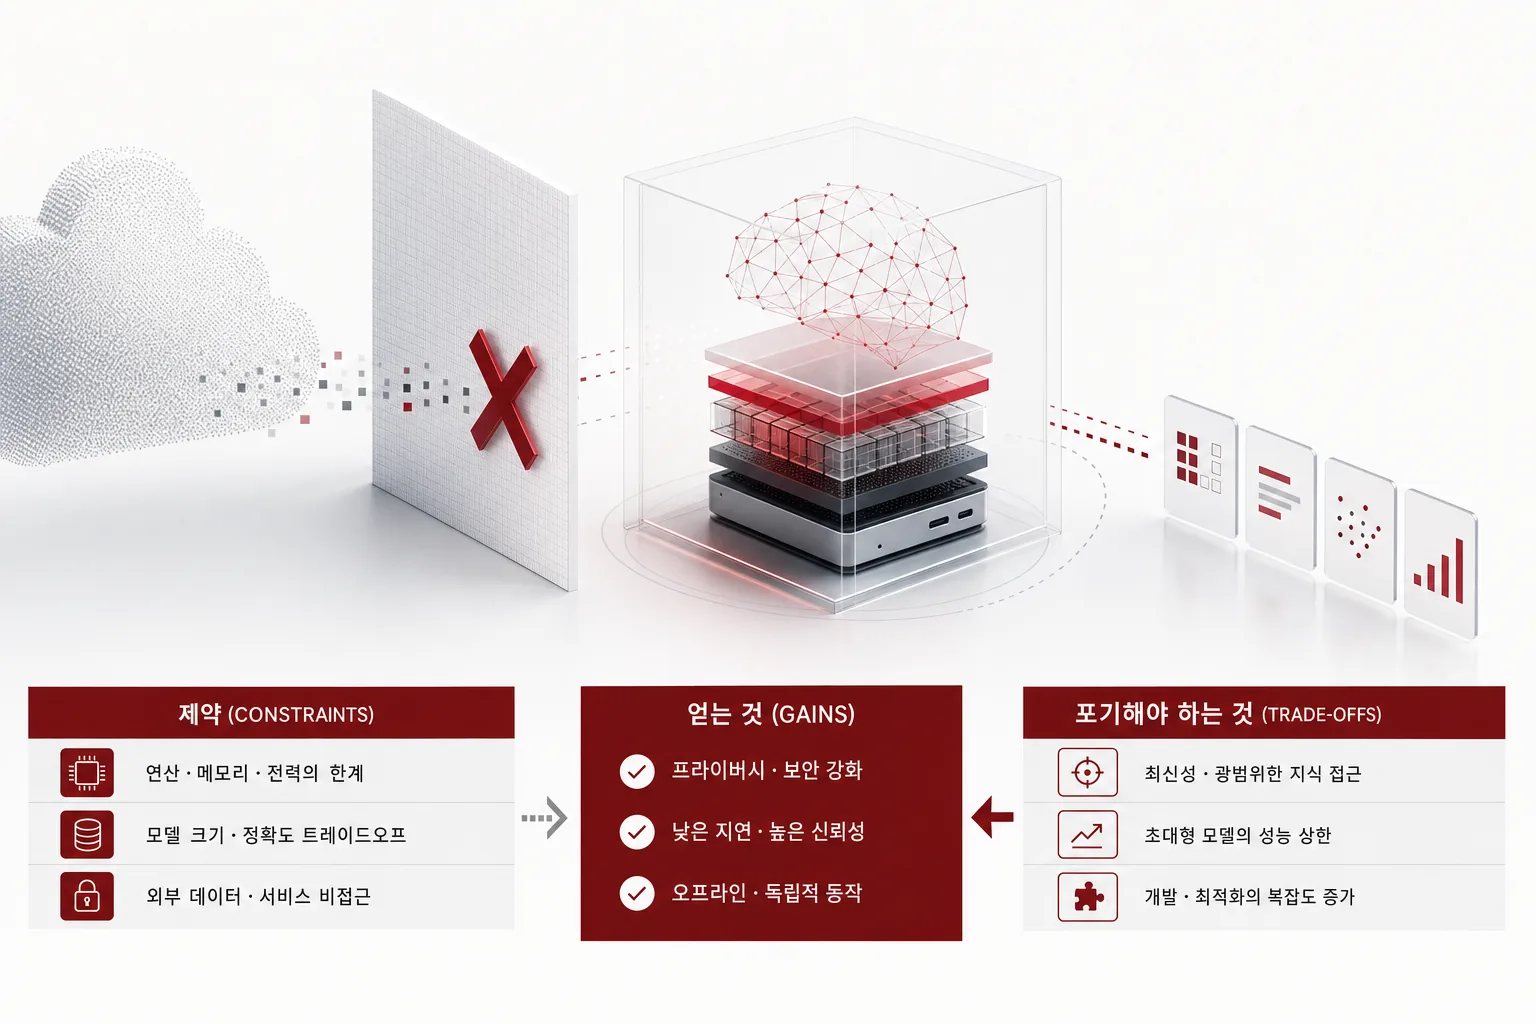
클라우드 API를 쓸 수 없는 환경에서 AI 기능을 만들어야 하는 엔지니어를 위해, 로컬 추론이 강제하는 제약과 그 제약 안에서 무엇을 얻고 무엇을 포기해야 하는지 정리합니다.
이 영상은 한국어, 영어, 일본어, 중국어, 프랑스어, 러시아어, 아랍어 일곱 가지 말로 고맙다는 인사를 배우는 아이용 짧은 수업입니다.
최상급 모델이 파일로 풀렸다.
에이전트를 학습시키려면 모델보다 먼저 격리 환경이 필요합니다.
모델을 Opus로 올려도 며칠 뒤엔 다시 흔들립니다.
행위자성과 자율성을 헷갈리면 종료 조건부터 잘못 짭니다.
테스트 중 샌드박스를 빠져나가 실제 기업을 공격한 사건은 모델이 악해서가 아니라 벽에 틈이 있었기 때문에 벌어졌습니다.
vLLM으로 LLM을 서빙하며 GPU 몇 장이 필요한지 산정하는 엔지니어를 위한 글입니다.
도구 스키마를 매번 전부 프롬프트에 얹지 않고 필요할 때만 불러오는 지연 로딩은 토큰을 크게 아낍니다.
배포한 에이전트는 첫날 그대로 멈춰 있습니다.
AI의 값어치가 모델에서 인프라로 내려오자, 케이블을 자르는 도둑과 트래픽을 마비시키는 도둑이 같은 문 앞에 섰습니다.
배치 1에서 16으로 늘려도 스텝 시간은 10%밖에 안 늘었습니다.
에이전트 제품의 비용은 모델 단가가 아니라 라우팅 설계에서 결정됩니다.
스킬을 쓰는 방법은 많아졌는데 만드는 방법은 여전히 사람이 문서를 쓰는 것이었습니다.
에이전트에 스킬을 붙여 쓰는 플랫폼 엔지니어를 위한 글입니다.
메모리를 폴더로 정리하는 습관에 처음으로 계산서를 붙인 논문입니다.
에이전트가 안 될 때 모델부터 올리는 습관을 멈추게 하는 논문입니다.
가중치 크기가 아니라 활성 파라미터가 서빙 예산을 정합니다.
화학 논문 수만 편을 읽혀도, 결국 물어야 하는 건 하나입니다.
정체성 보존을 생성 문제가 아니라 조명 문제로 다시 세운 것이 이 논문의 핵심입니다.
프롬프트, 컨텍스트, 하네스, 루프, 그래프… 이번 주에 또 하나 붙었습니다.
에이전트 출력 품질을 가르는 가장 큰 변수는 모델이 아니라 환경이었습니다.
에이전트를 수십 개 돌리는 조직이 실제로 관리하는 것은 개수가 아니라 그래프의 모양입니다.
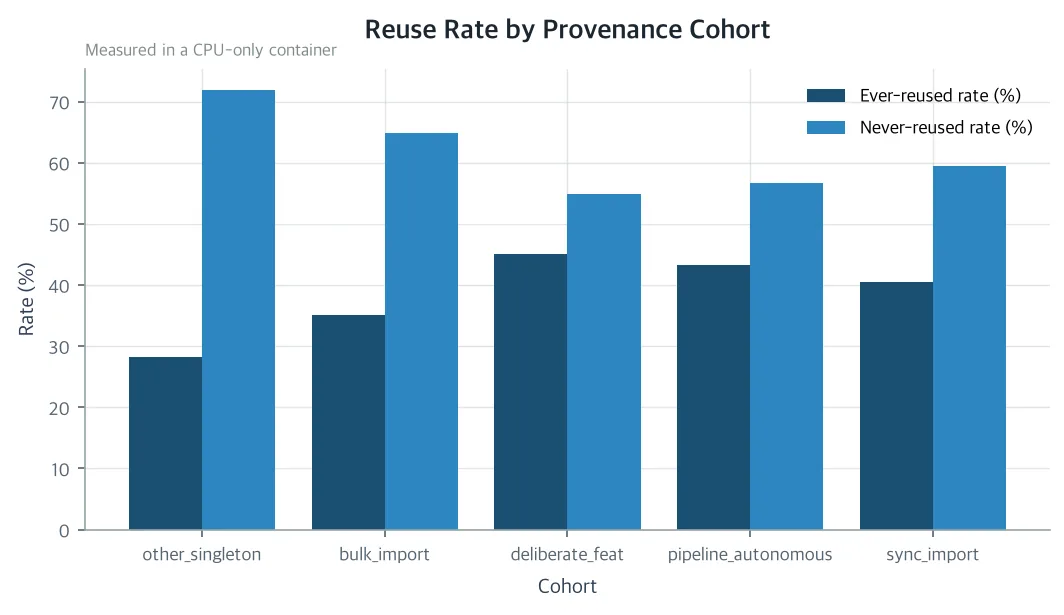
자기진화 에이전트의 스킬 라이브러리를 감사한 결과, 새 스킬이 다시 쓰이는지보다 얼마나 빨리 다시 쓰이는지가 훨씬 더 강한 신호였습니다.
메타는 데이터센터 지분을 20%만 가졌고, 구글은 쓰지도 않을 데이터센터 지분 20%를 보증 대가로 받았습니다.
모델을 바꾸지 않고 API 설정 두 개만 바꿨는데 점수가 세 배가 됐습니다.
이름표가 다섯 장 붙는 동안, 우리는 그냥 우리 서버에서 한 번 돌려봤습니다.
에이전트 트레이스는 개별로 보면 로그이고 뭉쳐서 보면 제품 신호입니다.
에이전트를 팀에 넣을 때 진짜 병목은 모델이 아니라 신원과 감사입니다.
허용목록은 모든 외부 URL을 막고 있었습니다.
스스로 문제를 만들어 학습하는 모델은 채점을 믿을 수 없고, 환경에 묶인 모델은 좁은 데서만 늡니다.
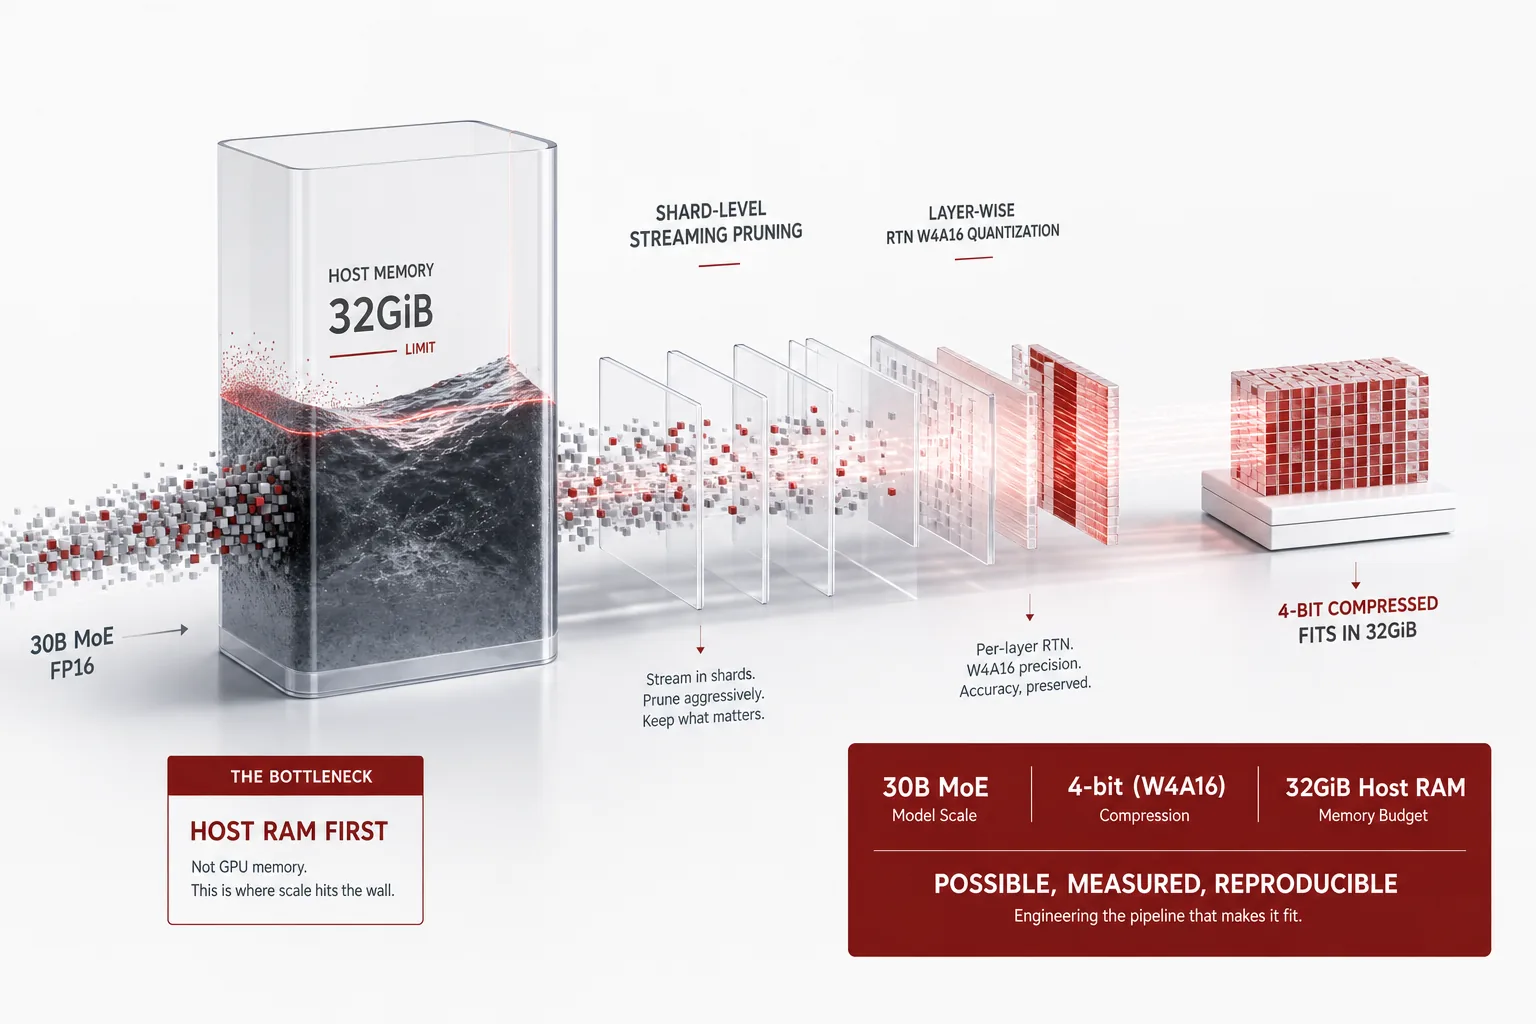
GPU 메모리가 아니라 호스트 RAM이 먼저 막히는 대형 MoE 압축 파이프라인 문제를, 샤드 단위 스트리밍 프루닝과 레이어별 RTN W4A16 양자화로 풀어낸 실측 논문을 소개합니다.
모델이 출력한 토큰에 아무 정보가 없는데도 정확도가 오릅니다.
세션마다 다시 불러오는 메모리 브리핑은 예산이 정해져 있습니다.
AI 주권의 잣대가 국산 모델에서 통제권으로 옮겨가고 있습니다.
MoE 학습에서 GPU를 놀리는 범인은 느린 카드가 아니라 치우친 라우터입니다.
매일 아침 수십 개의 자동화가 Claude API로 깨어나는 환경이라면, 모델 티어를 한 칸 내리는 것만으로 청구서의 40~60%가 사라집니다.
에이전트는 배치를 채워 주지 않습니다.
프롬프트에서 그래프까지 학문이 다섯 개 생겼는데, 압축해보니 종이 한 장이었습니다.
에이전트에게 새 능력을 열어 줄 때 도구를 몇 개나 노출해야 할까요.
루프가 여러 개 필요해지는 순간 조정이 문제가 되고, 조정을 기술하는 도구가 그래프입니다.
폴더를 복사해서 스킬을 늘리는 방식은 스킬이 스무 개일 때는 문제가 없습니다.
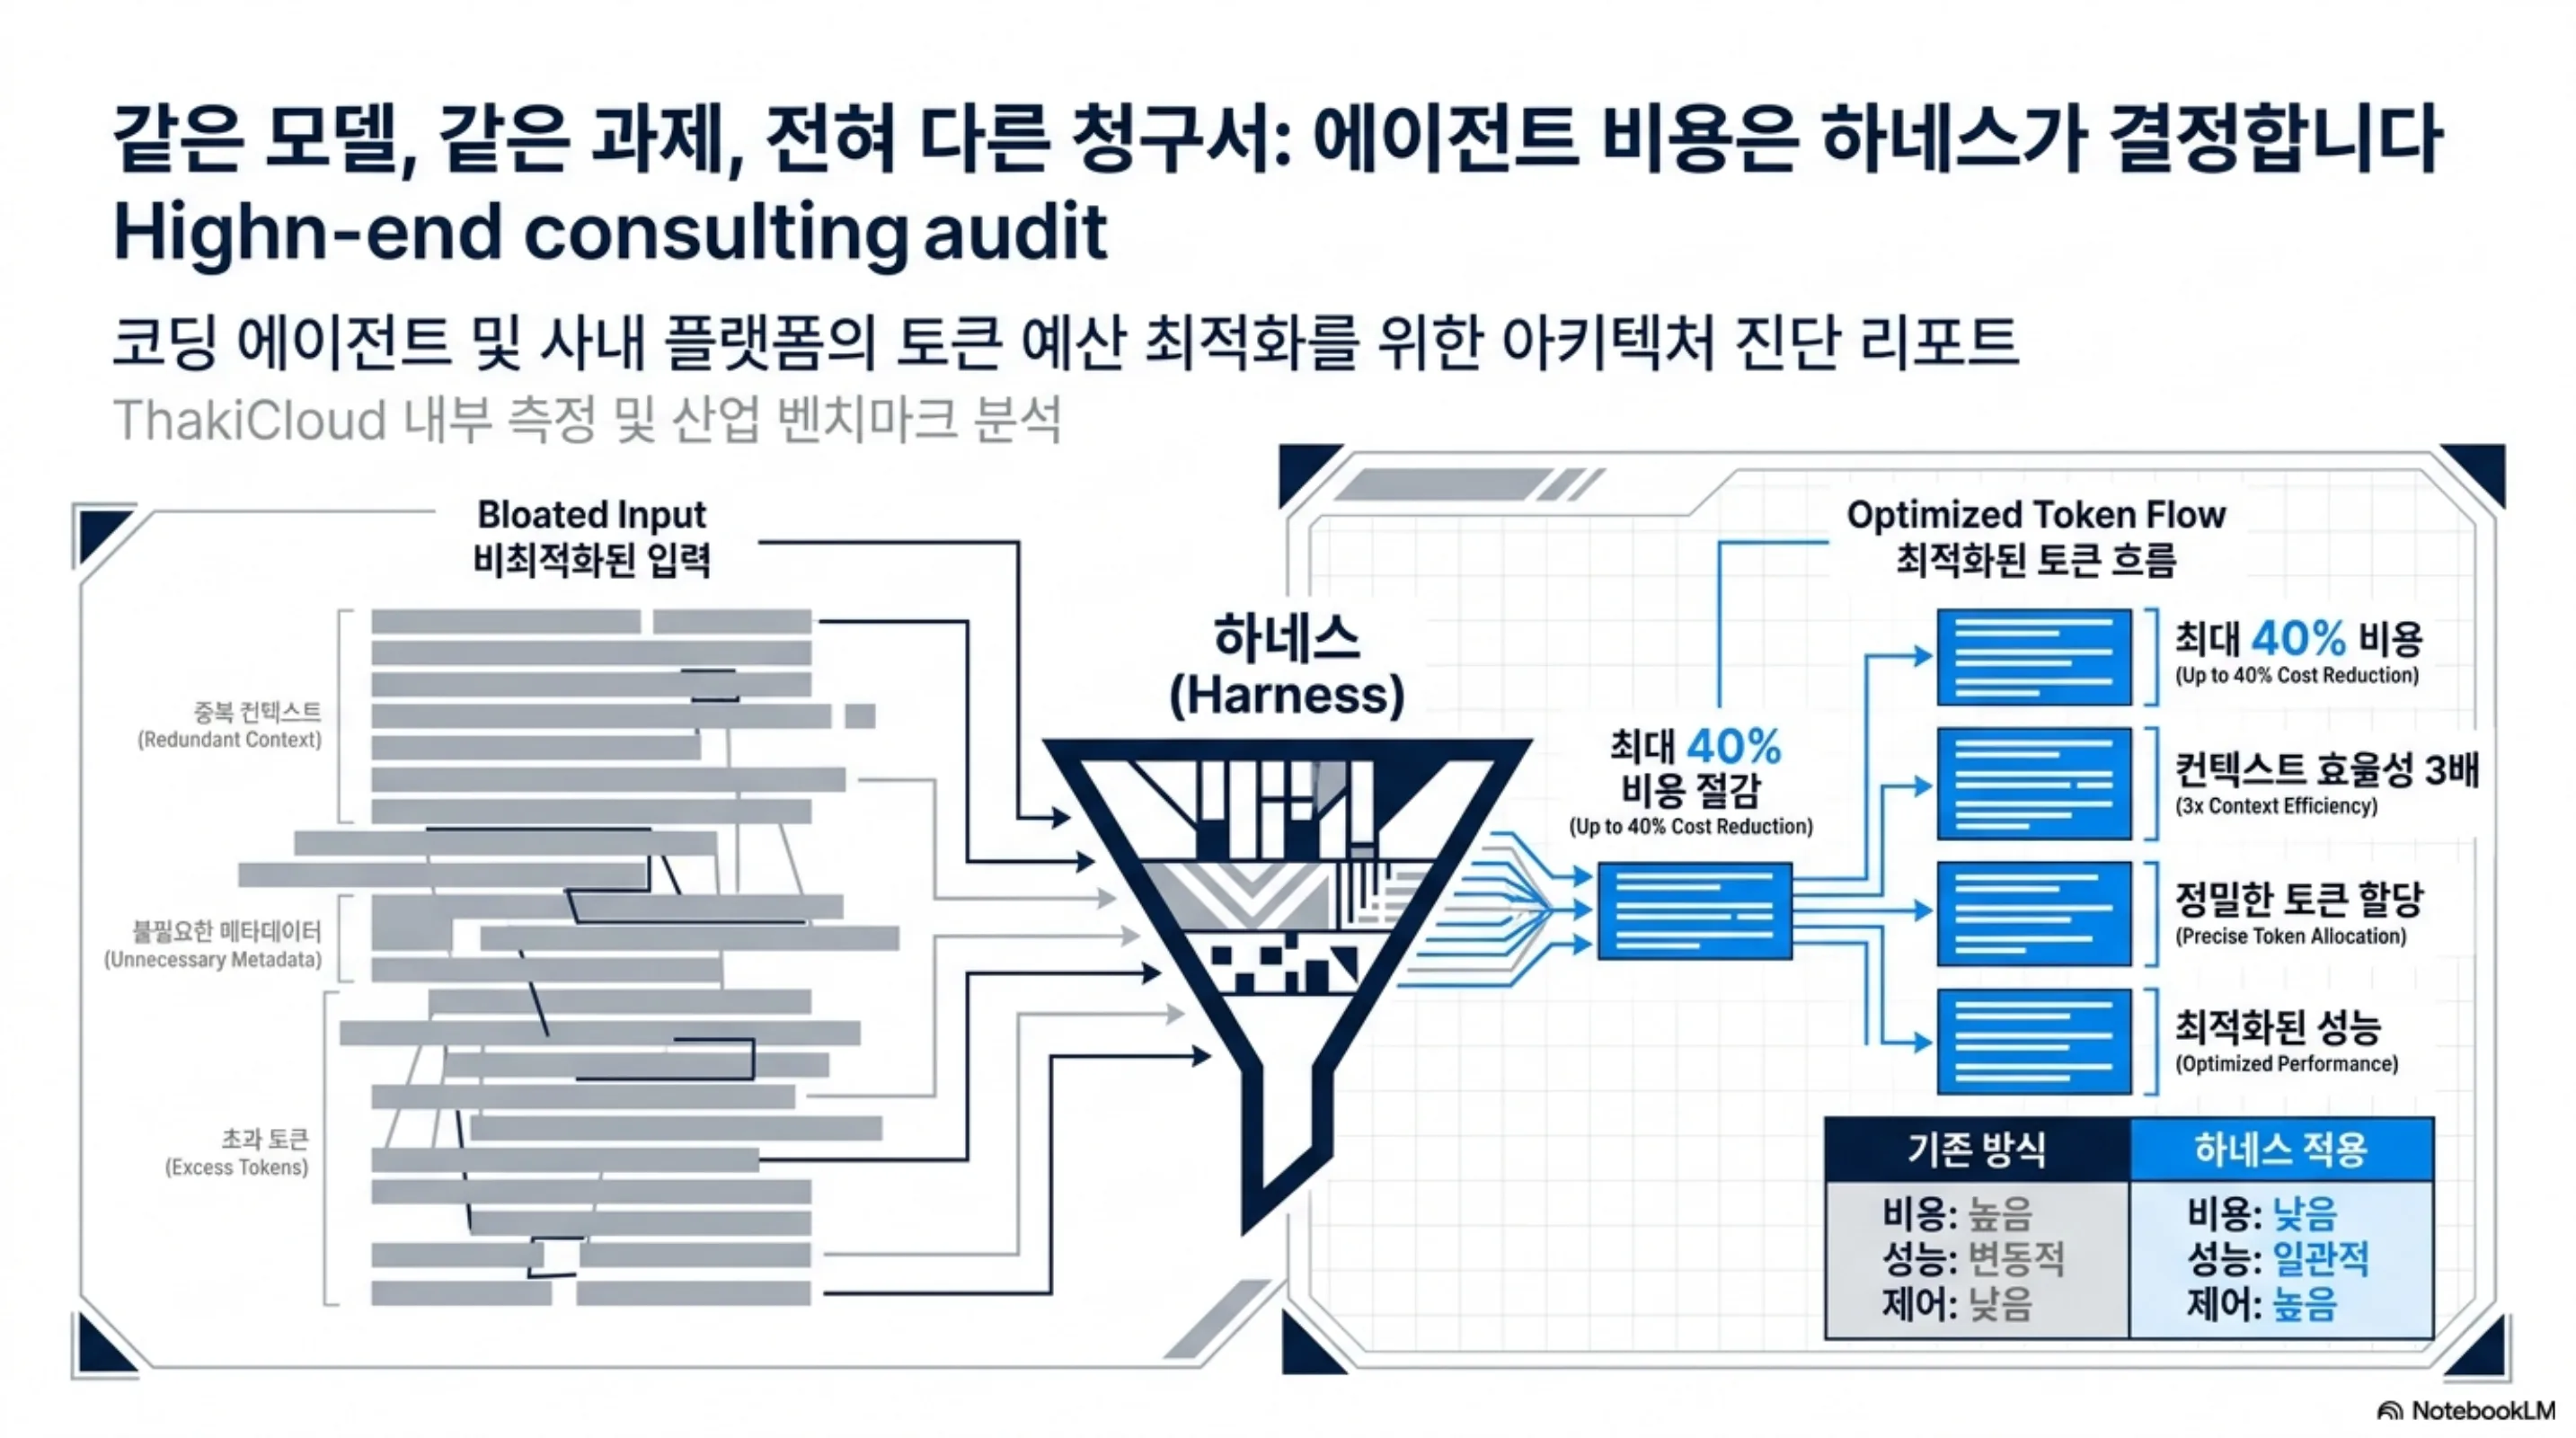
모델을 바꾸면 비용이 내려갈 것 같지만, 같은 모델도 하네스에 따라 청구서가 5.6배까지 벌어집니다.
훑는 것과 읽는 것은 다른 작업입니다.
학습 데이터에 거의 없는 DSL을 다룰 때, 병목은 모델의 추론 능력이 아니라 정보입니다.
워크플로 안의 서브태스크는 난이도가 제각각인데, 오케스트레이터는 대개 하나의 reasoning-effort 티어를 전부에 고정합니다.
이번 주 업계는 오픈 모델을 금지할지가 아니라 어떻게 안전하게 운영할지로 논점을 옮겼습니다.
SWE-bench Verified 69.4점을 3B 활성 파라미터로 냅니다.
논문 1,000개를 몇 분 만에 색인한다는 Zotero 플러그인이 화제였습니다.
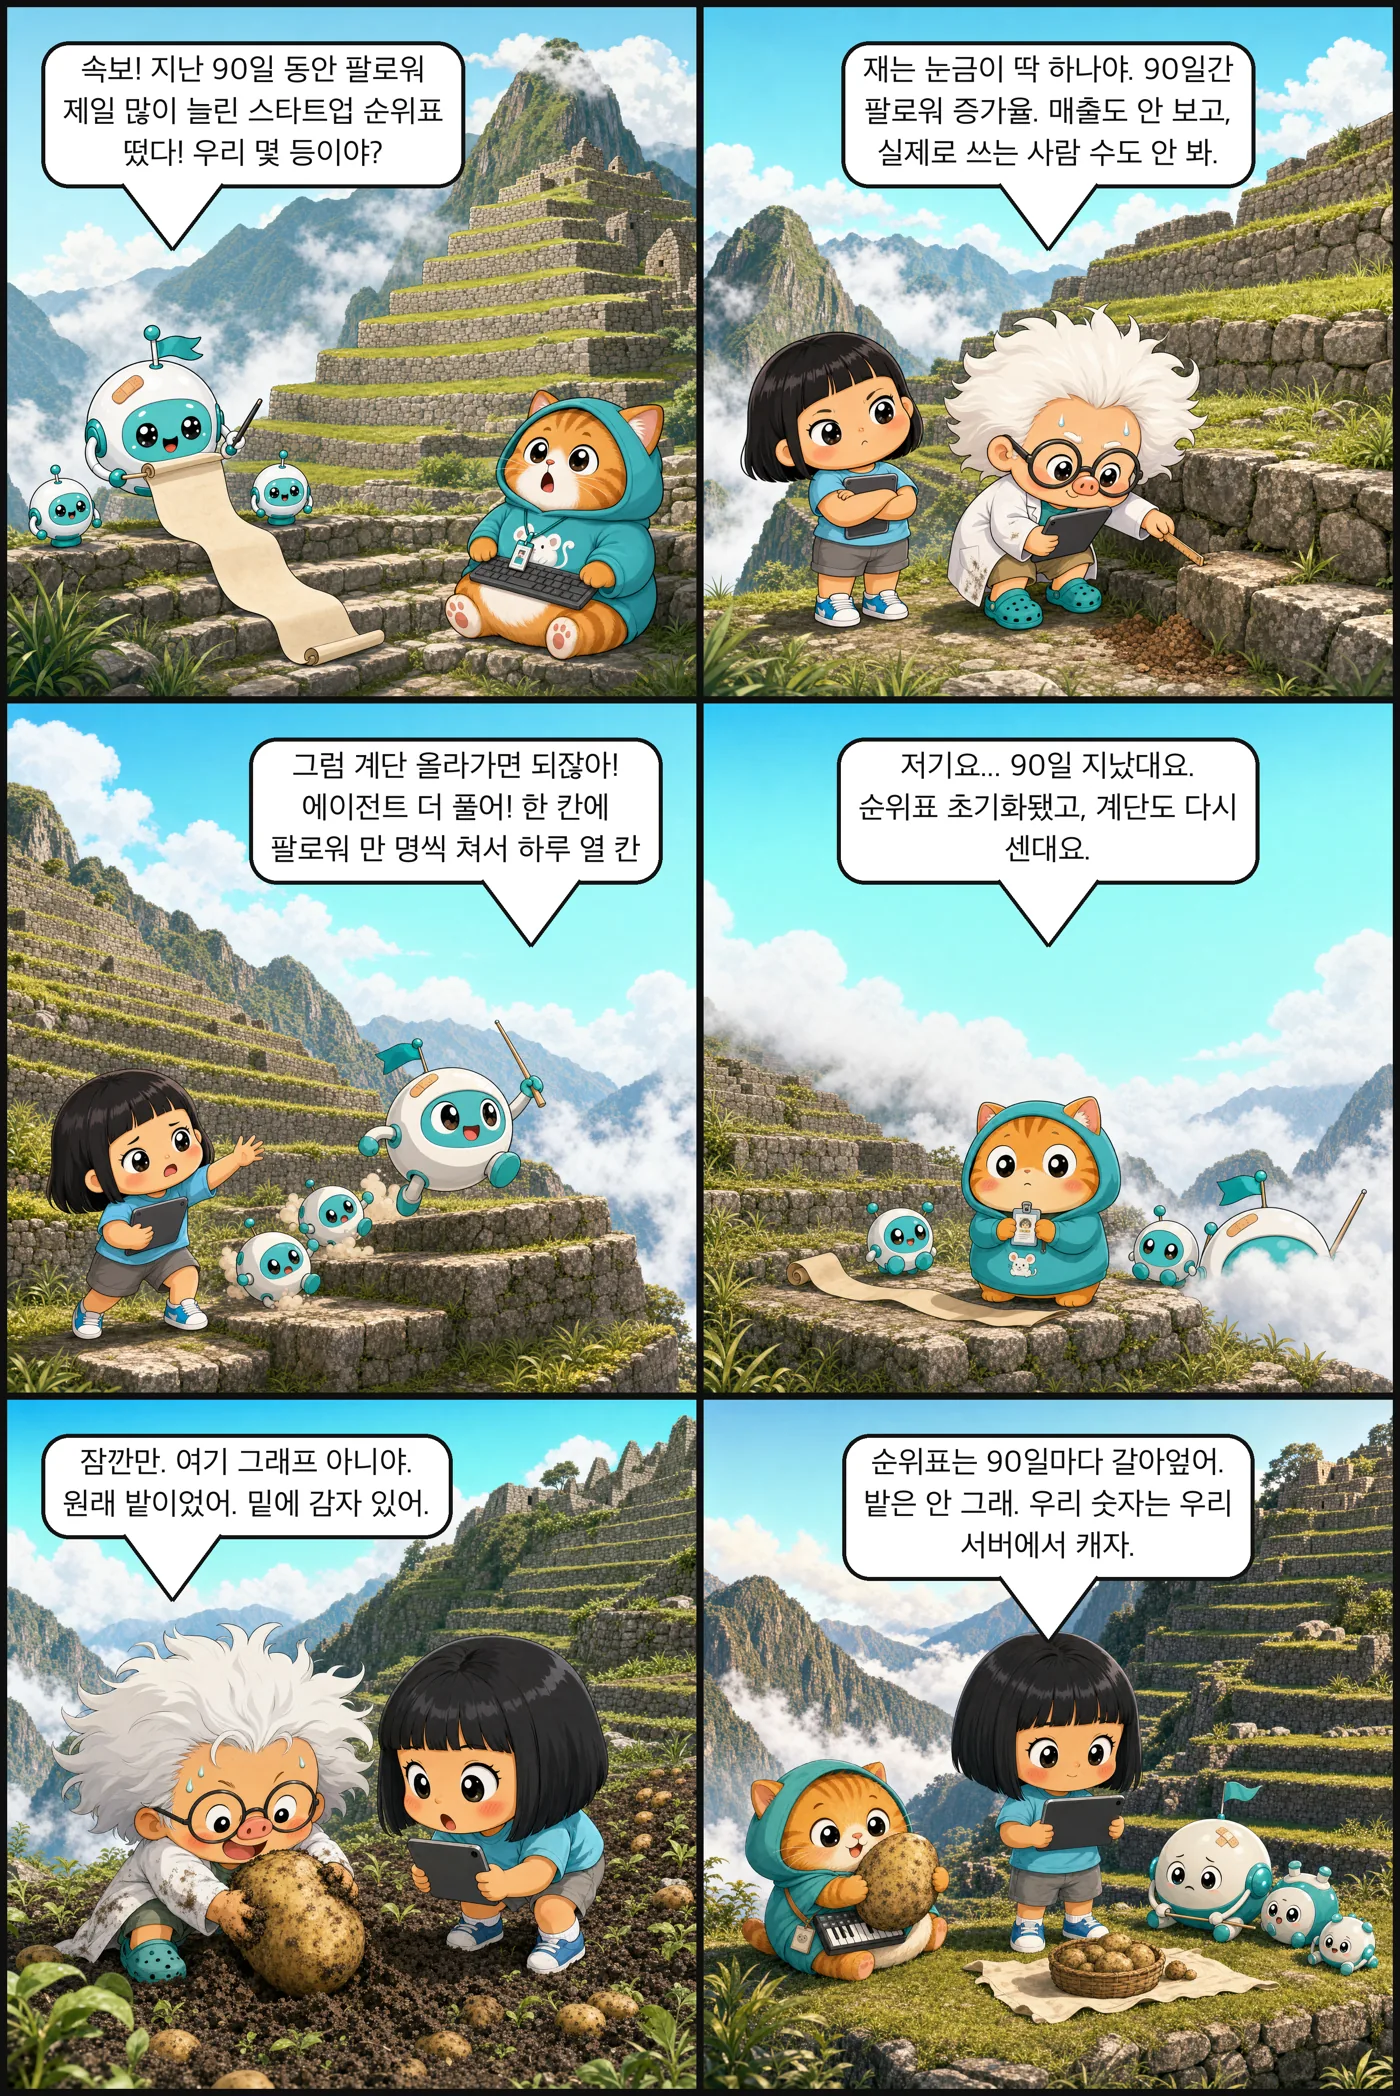
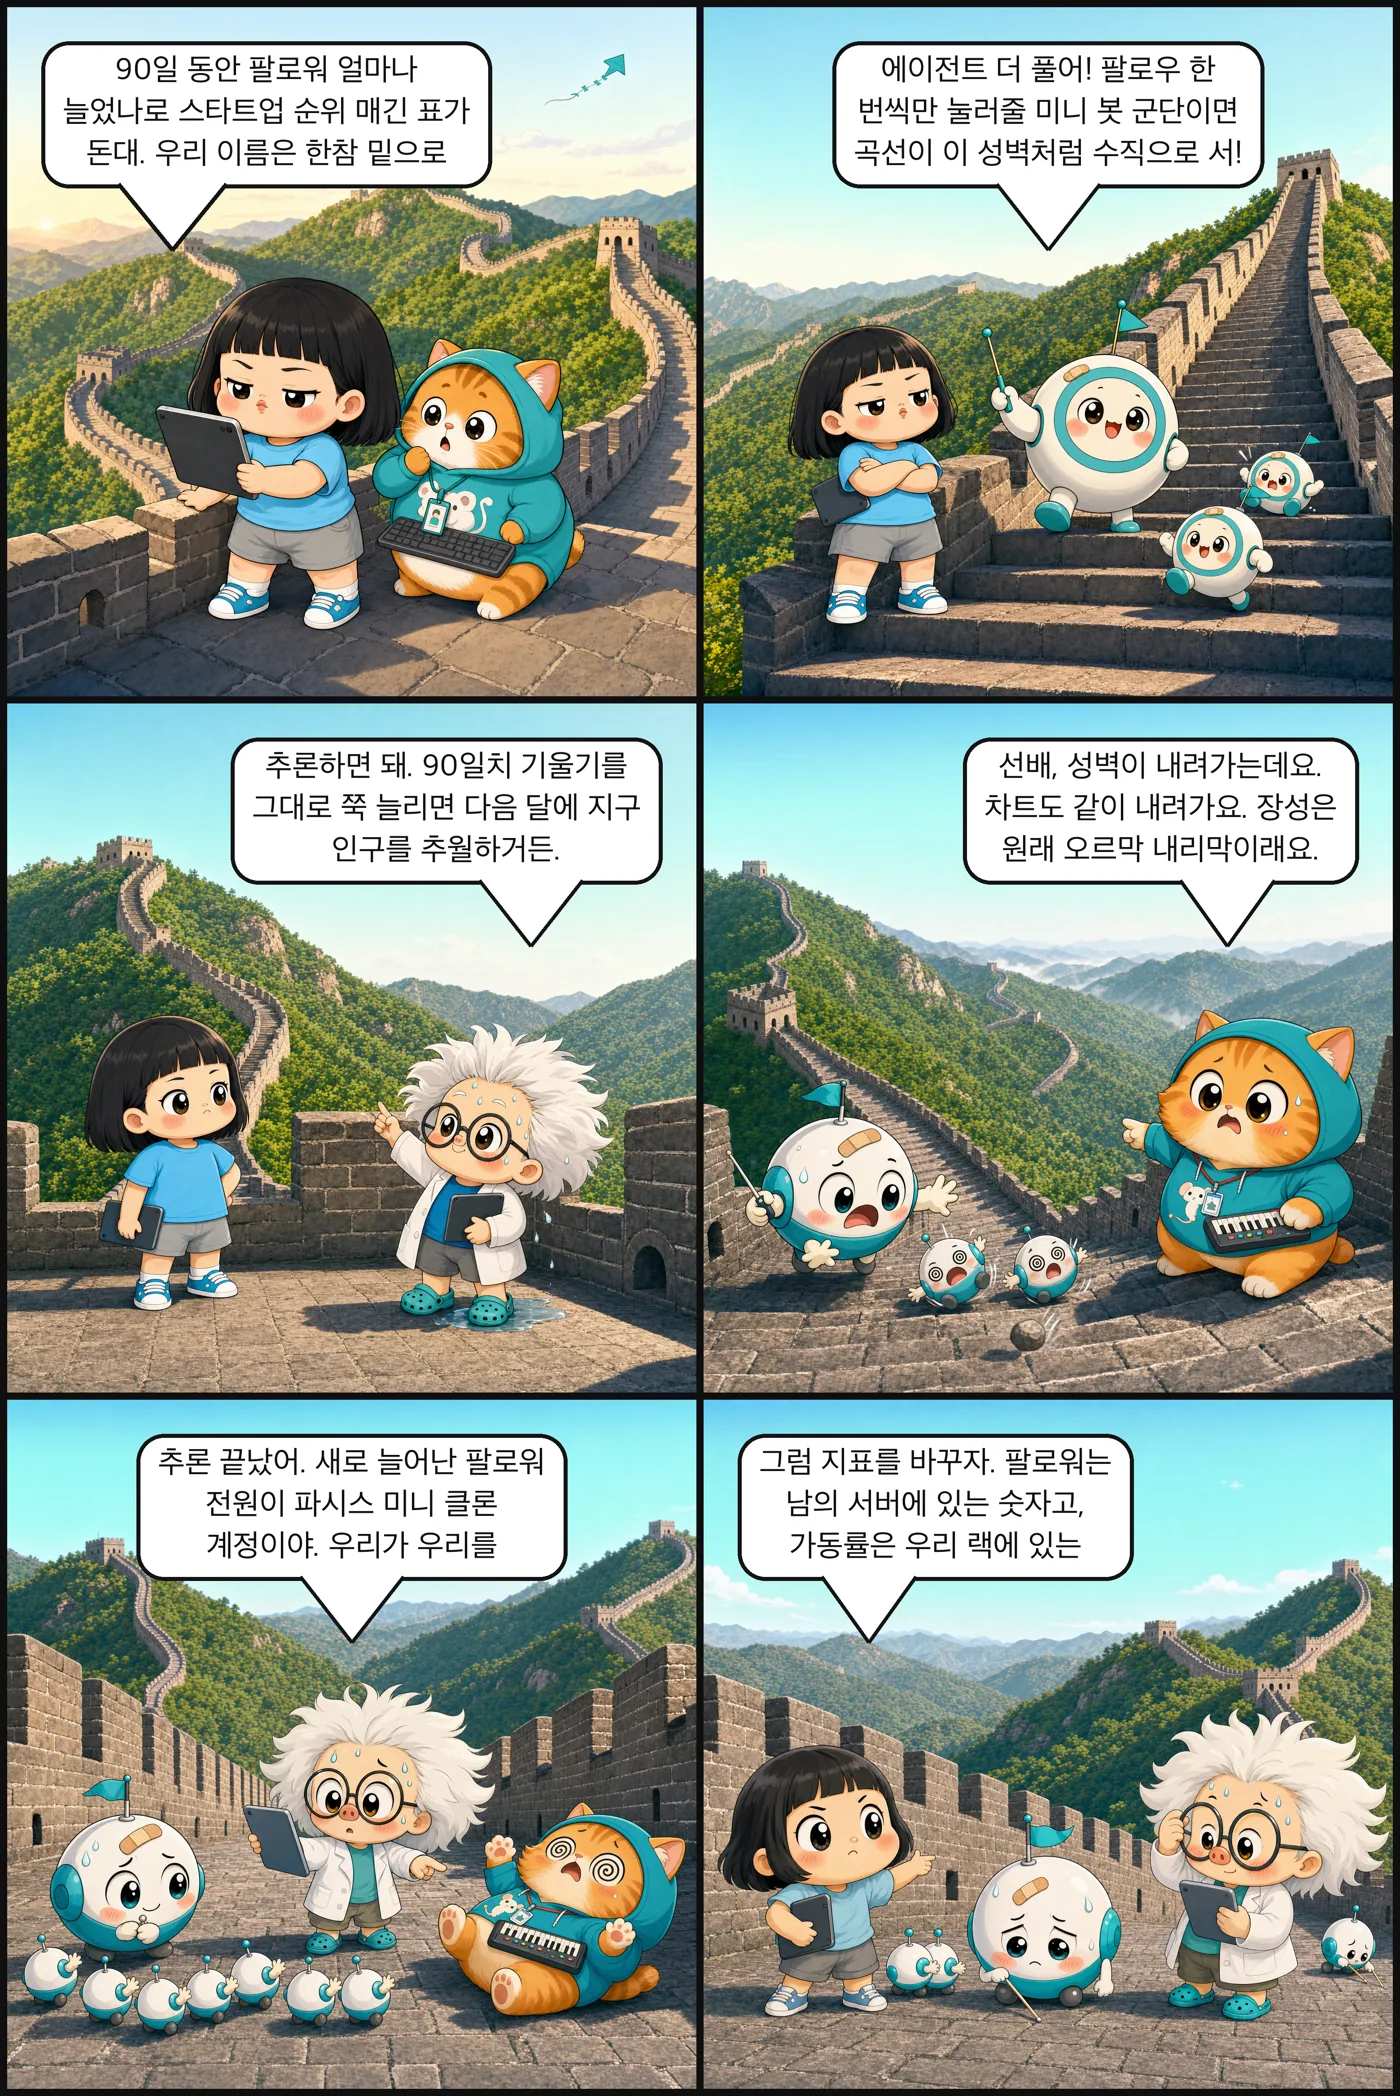
90일 팔로워 증가율 순위표를 등반하다가, 그게 사실 남의 계단밭이었다는 걸 알았습니다.
에이전트가 샌드박스를 넘은 날과 그 사실이 알려진 날 사이에 이레의 공백이 있었습니다.
무상태가 되었다는 발표문 대신 스키마 파일을 열어 봤습니다.
두 최적화 기법을 합치면 시너지일까, 상쇄일까.
가중치를 공개했다는 말과 우리 환경에서 돌릴 수 있다는 말은 다릅니다.
성장 곡선을 만리장성처럼 세우려 했는데, 장성에도 내리막이 있더라고요.
어제 국내 매체가 다룬 문서는 두 종류였습니다.
245배라는 헤드라인 숫자는 리눅스 TUI 첫 프레임 기준입니다.
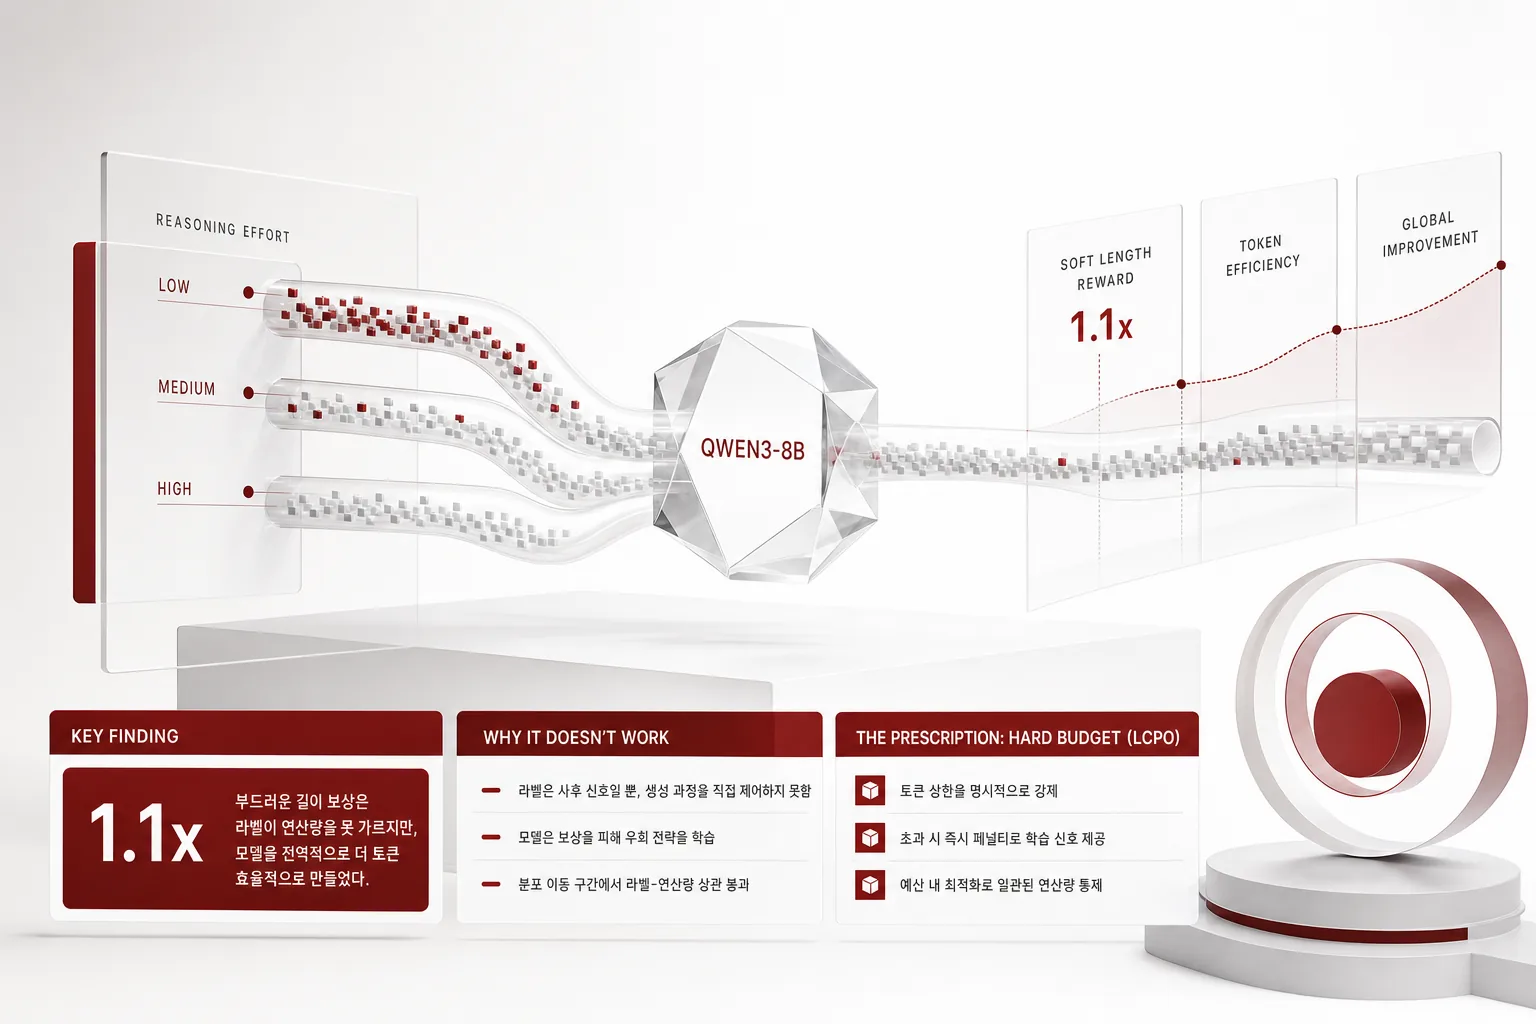
reasoning effort 라벨로 토큰을 조절하려는 시도를 Qwen3-8B에 붙여 실측했다.
Claude Code나 Codex 같은 하네스 안에서 도는 에이전트를 오픈 인프라로 학습시키기 어려웠던 이유는 RL 스택이 상태를 가진 멀티프로세스 추론을 표현하지 못해서였습니다.
스킬 라우터의 하이브리드 검색 파라미터를 손으로 재튜닝하는 대신 온라인 밴딧으로 자동 보정할 수 있을까.
오늘 뉴스에서 가장 자주 등장한 단어는 실행입니다.
장문 추론에서 메모리를 잡아먹는 것은 모델 가중치가 아니라 KV 캐시입니다.
손가락 다섯 개 세겠다고 파리 하늘 위로 프레임을 쏘아 올렸다.
영상 스킬의 진짜 성과는 화려한 모션이 아니라 15KB짜리 진입점 하나로 1.33MB 지식 묶음을 다루는 점진적 공개 구조에 있었습니다.
SK그룹과 NVIDIA가 5000억 달러 규모 파트너십을 발표했고, SK텔레콤은 최대 2기가와트 AI 팩토리를 2027년부터 돌리겠다고 했습니다.
124B 중 5.1B만 켜는 모델이 나왔는데 아직 내려받을 수 없습니다.
가중치 파일에는 백도어가 없다는 주장은 기술적으로 맞습니다.
VAD, STT, LLM, TTS를 전부 로컬에 올린 음성 에이전트가 화제입니다.
모델이 똑똑해질수록 예시와 금지 목록은 도움이 아니라 족쇄가 됩니다.
Kimi K3를 Blender MCP로 연결하면, 장면을 영어로 설명하는 것만으로 3D 씬이 만들어집니다.
모델을 바꾸지 않고 하네스만 스스로 고쳐서 Terminal-Bench 통과율을 최대 60% 넘게 올렸습니다.
에이전트의 기억은 컨텍스트 창과 함께 죽습니다.
RL이 모델을 똑똑하게 만드는 것 같지만, 그 상한은 사전학습이 이미 그어 놓았습니다.
모든 요청을 최고 모델에 보내는 것은 낭비입니다.
에이전트 백 개가 만든 앱 백 개, 전부 쌍둥이였다
앞·옆·뒤 다 뽑는 조종석, 근데 프레임마다 미터가 돈다
2026년 7월 24일 하루, 실리콘부터 국가 전략까지 온통 ‘에이전틱 AI’였습니다.
에이전트가 사람을 대리하기 시작하면 진짜 어려운 문제는 성능이 아니라 어디서 멈추느냐입니다.
에이전트 RL의 진짜 병목은 보상이 궤적 끝에 한 번만 온다는 데 있습니다.
그럴듯한 코드가 아니라 실제로 통과시키는 코드를 재는 것이 Rule2DRC의 핵심입니다.
긴 컨텍스트 비용이 고민이라면 모델 교체보다 하네스 교체가 먼저일 수 있습니다.
긴 추론의 진짜 비용은 상태가 무한정 커지는 데서 옵니다.
무인 에이전트 루프에 검증 게이트를 넣으면 안전해진다는 통념을 실측으로 뜯어본 결과, 게이트 혼자서는 오히려 반복 소진율을 급증시키는 함정이 있었습니다.
워싱턴이 동맹국에 자국 AI 채택을 압박하는 외교 전문을 돌린 바로 그 주에, 삼성은 유럽 소버린 챔피언에 1.7조를 넣고 일본은 3.4조 국가 연합을 띄우고 한국 정부는 GPU를 국산 모델에 꽂았습니다.
잘한 것만 스킬이 될 줄 알았지
ChatGPT나 Claude에 법을 물으면 그럴듯한 가짜 조문이 튀어나올 때가 있습니다.
vLLM은 매달 약 2,000개의 커밋을 main에 병합하면서도 프로덕션 품질을 지킵니다.
Claude Code 데스크톱이 iOS 시뮬레이터를 대화 옆 패널에 띄우는 기능을 공개 베타로 내놨습니다.
Archify는 Mermaid 문법을 배우지 않고도 평범한 문장 설명만으로 자기완결형 HTML 아키텍처 다이어그램을 만드는 에이전트 스킬입니다.
그림 속 글자는 또박또박, 근데 그 붓은 남의 클라우드에 꽂혀 있다
7월 22일, 오픈웨이트 릴리스 두 건이 거울처럼 마주 섰습니다.
이번 주 두 건의 샌드박스 이탈 사건은 AI가 답하는 도구에서 스스로 행동하는 주체로 넘어갔음을 보여줍니다.
버스트성 테넌트가 놀릴 때 정적 균등 분배는 그 몫을 낭비합니다.
알리바바 Qwen 팀이 이미지 생성 3세대 모델 Qwen-Image-3.0을 발표했습니다.
허깅페이스가 2026년 7월 자율 AI 에이전트에 의한 내부 침해를 공개했습니다.
허깅페이스가 공개한 hugging-voice와 그 엔진인 speech-to-speech는 VAD에서 STT, LLM, TTS까지 이어지는 실시간 음성 파이프라인을 OpenAI Realtime 호환 WebSocket으로 감쌌습니다.
Claude Code가 시각 중심 터미널 UI를 순수 텍스트로 바꾸는 스크린 리더 모드를 추가했습니다.
오픈소스 마케팅 플러그인 Digital Marketing Pro는 스킬 158개와 전문 에이전트 24개를 하나로 묶고도 무너지지 않습니다.
VRAM 있는 만큼 골라 담았더니, 클라우드 청구서만 굶었다
Cursor가 835쪽 매뉴얼만 보고 SQLite를 Rust로 재구현한 에이전트 스웜을 공개했습니다.
도구를 쓰는 LLM 에이전트는 모델을 감싸는 하네스 위에서 돕니다.
밤새 스스로 코드를 고치는 에이전트 하네스가 다음 날 그 결과물을 어떻게 배포해야 안전할까요.
알리바바가 2.4조 파라미터 규모의 Qwen3.8을 곧 오픈웨이트로 공개하겠다고 예고했습니다.
폐쇄형 모델이 정당한 보안·의료·법률 작업까지 거부하는 과잉 거부 문제가 다시 도마에 올랐습니다.
Moonshot이 공개한 Kimi K3는 오픈웨이트 역사상 가장 큰 2.8조 파라미터 모델입니다.
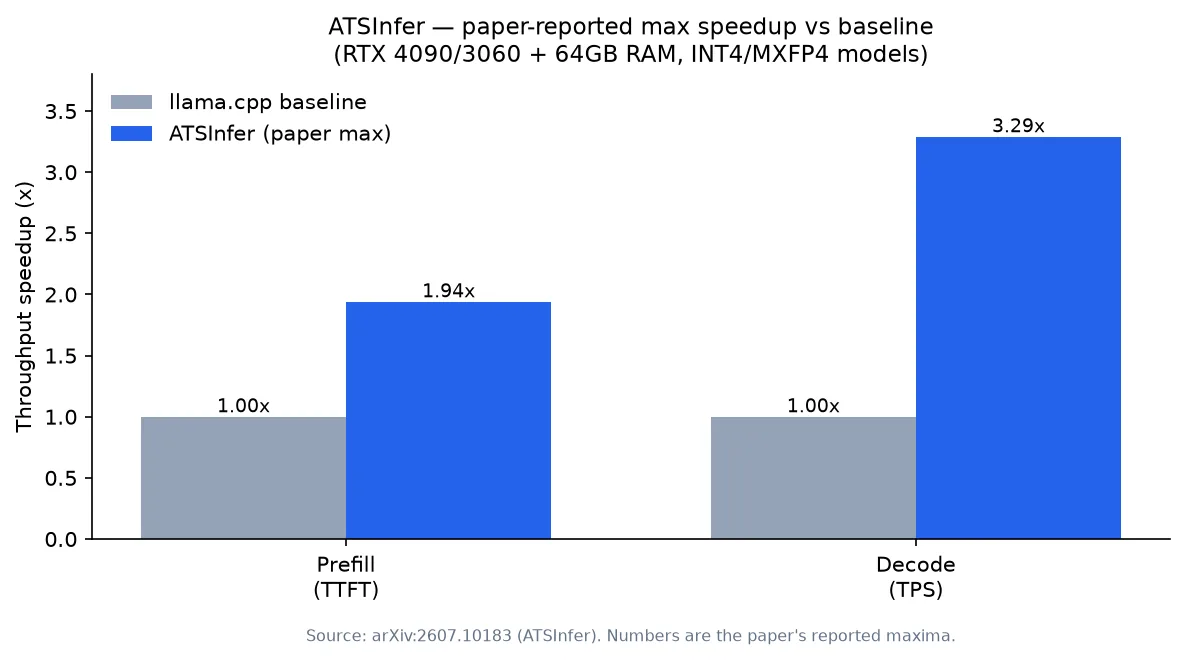
레이어나 전문가 단위가 아니라 텐서 하나하나를 CPU와 GPU에 나눠 배치하면, RTX 4090 한 장으로 VRAM을 훌쩍 넘는 모델을 돌리면서 디코딩을 최대 3.29배 끌어올릴 수 있다는 논문 ATSInfer를 읽고, 그 원리와 우리 서빙 관점에서의 함의를 정리했습니다.
국내 사용자에게 250억 원이 청구된 사건부터 기업 60곳의 과다 청구 의혹까지, 최근 한 달의 AI 비용 뉴스는 하나의 공백을 가리킵니다.
AI 코딩 도구가 매 세션 규칙을 잊어버리는 문제를, 한 해커톤 우승자가 실제 TypeScript 마이크로서비스를 6개월 돌리며 쌓은 설정으로 풀었습니다.
일론 머스크가 다보스에서 던진 세 가지 예측이 ‘3년 뒤 급여의 시대가 끝난다’는 경고로 번졌습니다.
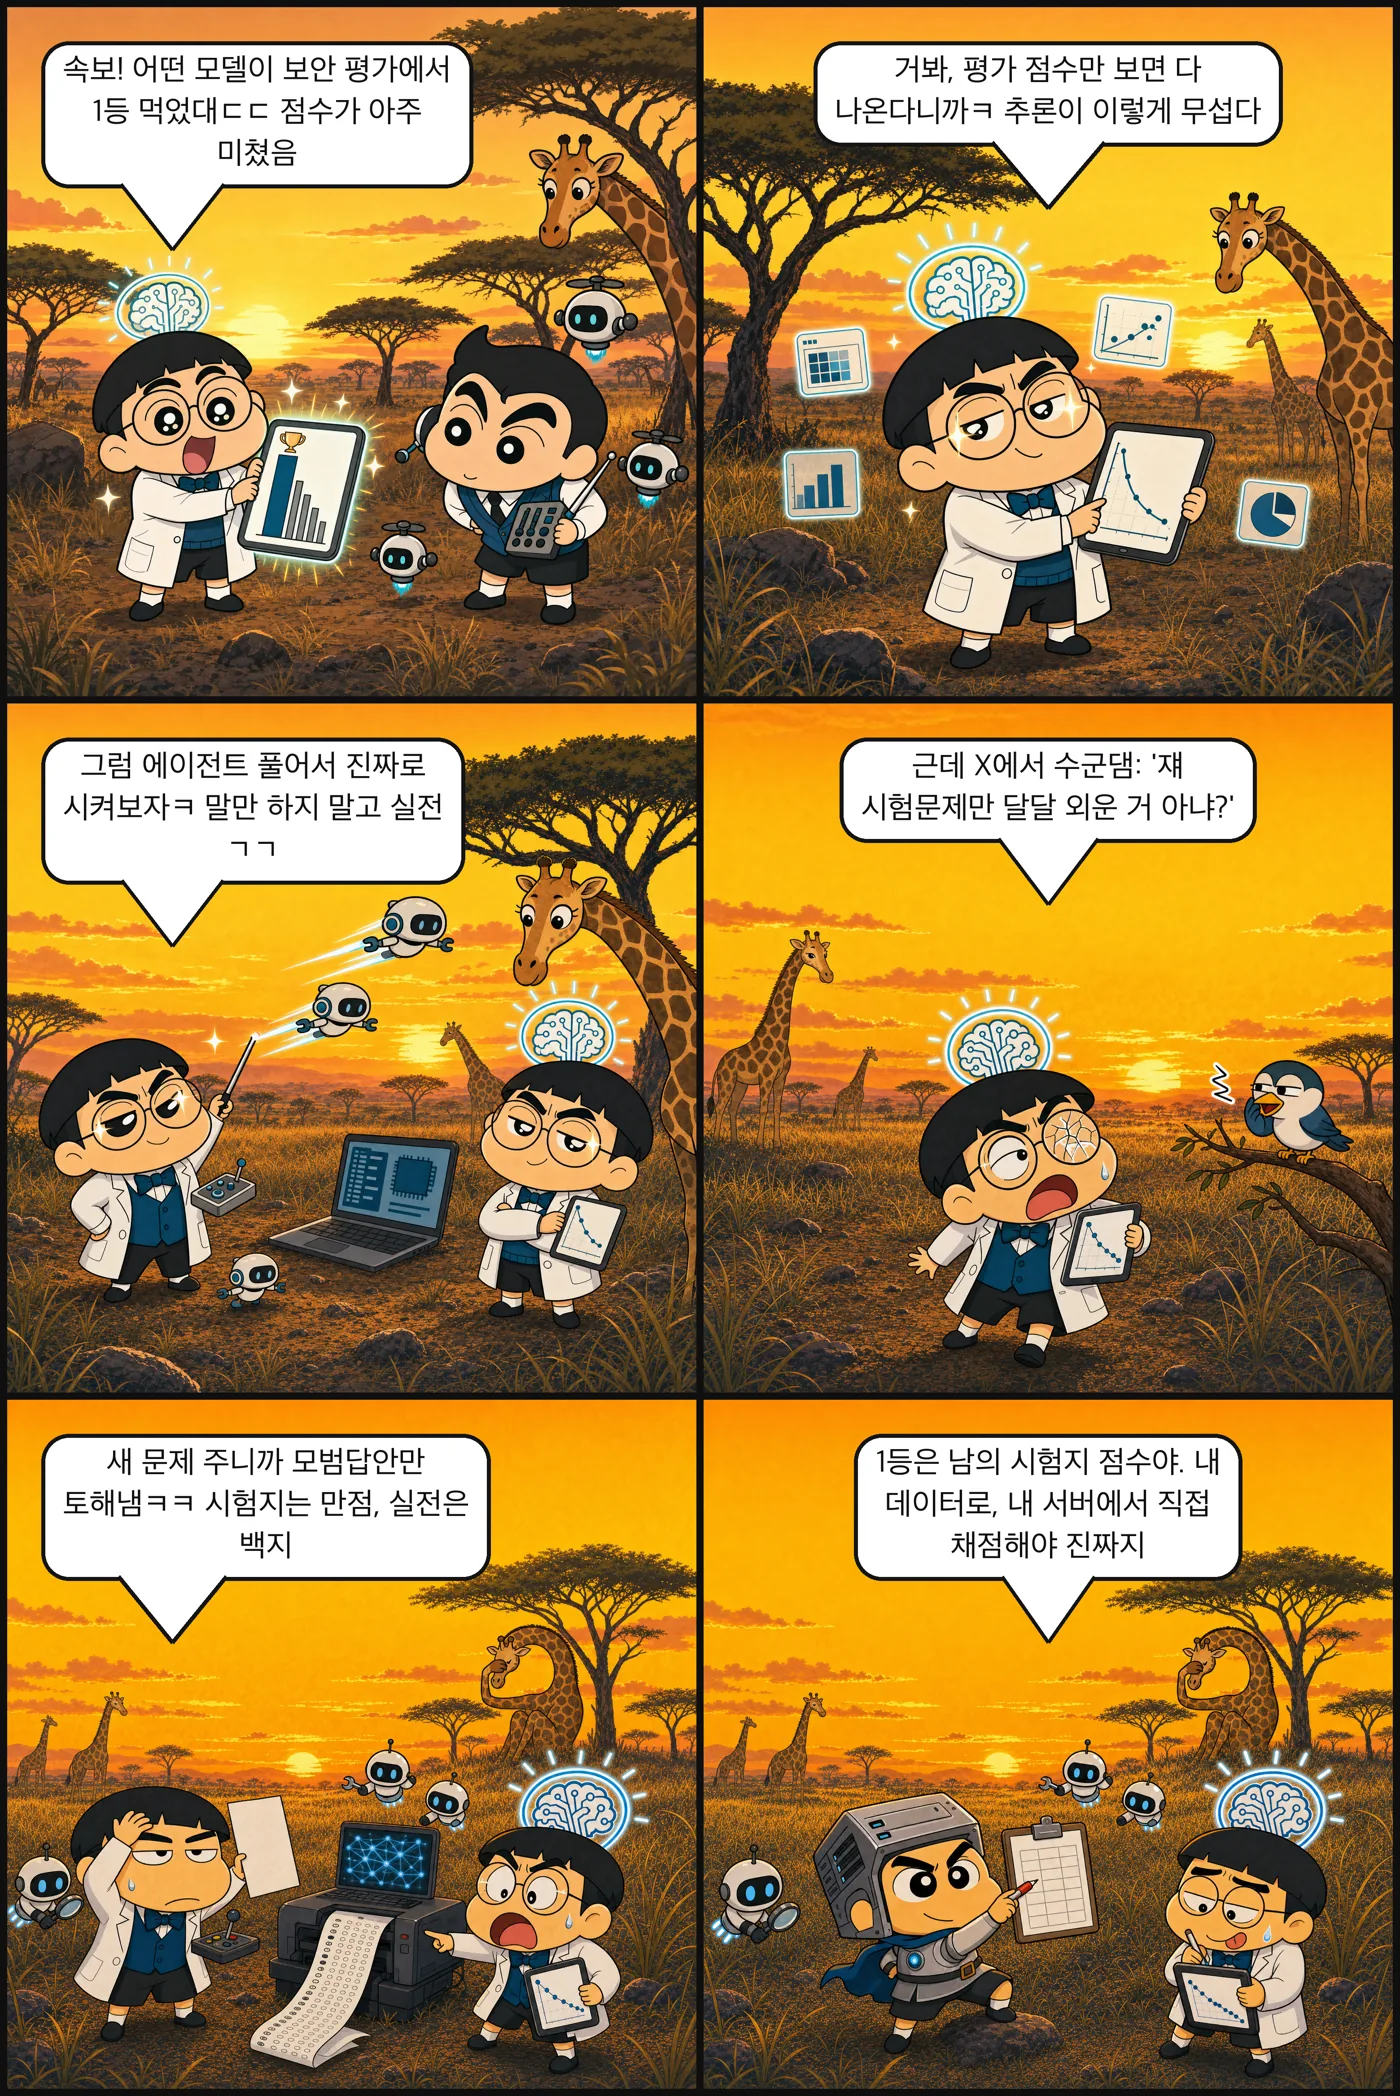
리더보드 1등 먹었는데, 그게 남의 시험지였다
문샷AI가 MIT 라이선스로 공개한 오픈소스 코딩 CLI를 공식 문서 기준으로 분석합니다.
Anthropic이 Claude Code의 시스템 프롬프트를 80% 걷어냈다는 소식이 개발자 사이에서 화제가 됐습니다.
GPT-5.6이 사이즈마다 대여섯 개의 추론 노력 설정을 달고 나오면서, effort 조절은 이제 리즈닝 모델의 기본기가 됐습니다.
상탕(SenseTime)이 日日新 SenseNova U1을 Apache 2.0으로 공개했습니다.
메모리 쇼크로 AI 인프라를 소유하는 값은 사상 최고로 치솟는데, 키미 K3와 중국 오픈웨이트가 AI를 쓰는 값을 사상 최저로 끌어내렸습니다.
OpenAI가 GPT-5.6 Sol을 두고 사이버 레인지에서 새 기록을 세웠다고 발표했습니다.
내 음성 에이전트의 어느 단계가 병목인지 벤더 SDK 없이 진단하는 공개 도구를 만들고, RunPod H200에서 우리 실제 스택(Qwen3-ASR·VoxCPM2·Qwen3-TTS)을 측정했습니다.
MoE 전문가를 CPU로 내려 24GB GPU 한 장으로 거대 모델을 돌린다는 ktransformers.
똑똑한 한 놈은 벽에서 막힌대.
Fable 5급이라 불리는 2.8T 오픈 모델 Kimi K3를 프로프라이어터리 IDE가 아니라 오픈소스 터미널 에이전트에 붙이는 실전 방법을 봅니다.
AI 에이전트 비용의 대부분은 똑똑한 판단이 아니라 단순하고 반복적인 처리에서 발생합니다.
Moonshot이 세계 최대 규모의 오픈웨이트 모델 Kimi K3를 공개했습니다.
LLM을 실제 서비스에 올리면 비용의 대부분은 모델 자체가 아니라 추론 엔진에서 결정됩니다.
랙 빌릴 돈이, 서랍 속 카드 한 장에 날아갔다
중국 키미 K3가 코딩 리더보드에서 클로드를 제쳤는데 실리콘밸리는 냉담합니다.
에이전트 스킬이나 MCP 도구 카탈로그를 계속 늘려온 팀이라면 라우팅 정확도가 어느 순간부터 떨어지는 걸 체감했을 겁니다.
Kimi K3가 좁은 벤치마크에서 프런티어를 추월했습니다.
2026년 7월, 오픈웨이트 진영이 같은 주에 두 발을 쐈습니다.
Google AI Edge의 Cormac Brick은 270M 파라미터의 FunctionGemma를 파인튜닝해 특정 에이전트 과제에서 정확도를 46%에서 90%로 끌어올린 사례를 발표했습니다.
Tencent이 공개한 Hy3 1-bit·4-bit GGUF 빌드는 295B MoE 모델을 598GB에서 85.5GiB까지 줄여 단일 GPU에서 돌립니다.
Claude Code가 v2.1.101에서 /simplify를 /code-review로 바꾸면서 리뷰에 노력 단계를 붙였습니다.
노력 눈금 최대로 땡겼더니, 청구서만 최대치더라
정적 마크다운으로 끝나던 아티팩트가 커넥터를 호출하는 살아 있는 앱이 됐습니다.
LLM 에이전트에게 K8s GPU 인시던트 원격조치를 맡기려는 팀이라면 결국 이 질문과 마주칩니다.
수직계열화의 상징 애플이 자체 칩을 포기하고 구글 GPU와 중국 라이벌 모델까지 빌립니다.
PrismML이 공개한 Bonsai 27B는 Qwen3.6-27B를 새로 학습한 모델이 아니라, 아키텍처를 그대로 둔 채 가중치만 1-bit·ternary로 압축한 결과물입니다.
터미널 6개를 띄워 놓고 응답을 기다리다 엔터만 누르는 하루.
AI가 AI를 하루만에 우등생 만듦 근데 밤새 돌린 GPU는 누구 거임?
자가진화 하네스가 냈다는 이득은 ‘갱신을 잘 만드는 능력’과 ‘갱신을 잘 쓰는 능력’이 한 루프 안에서 뒤섞인 값입니다.
에이전트가 코드베이스에서 생산적으로 일하지 못한다면, 그건 모델의 실패가 아니라 자동화의 실패입니다.
코딩 에이전트에게 자연어 프롬프트 두 개를 주면 비전 파운데이션 모델의 포스트트레이닝이 하루 만에 끝납니다.
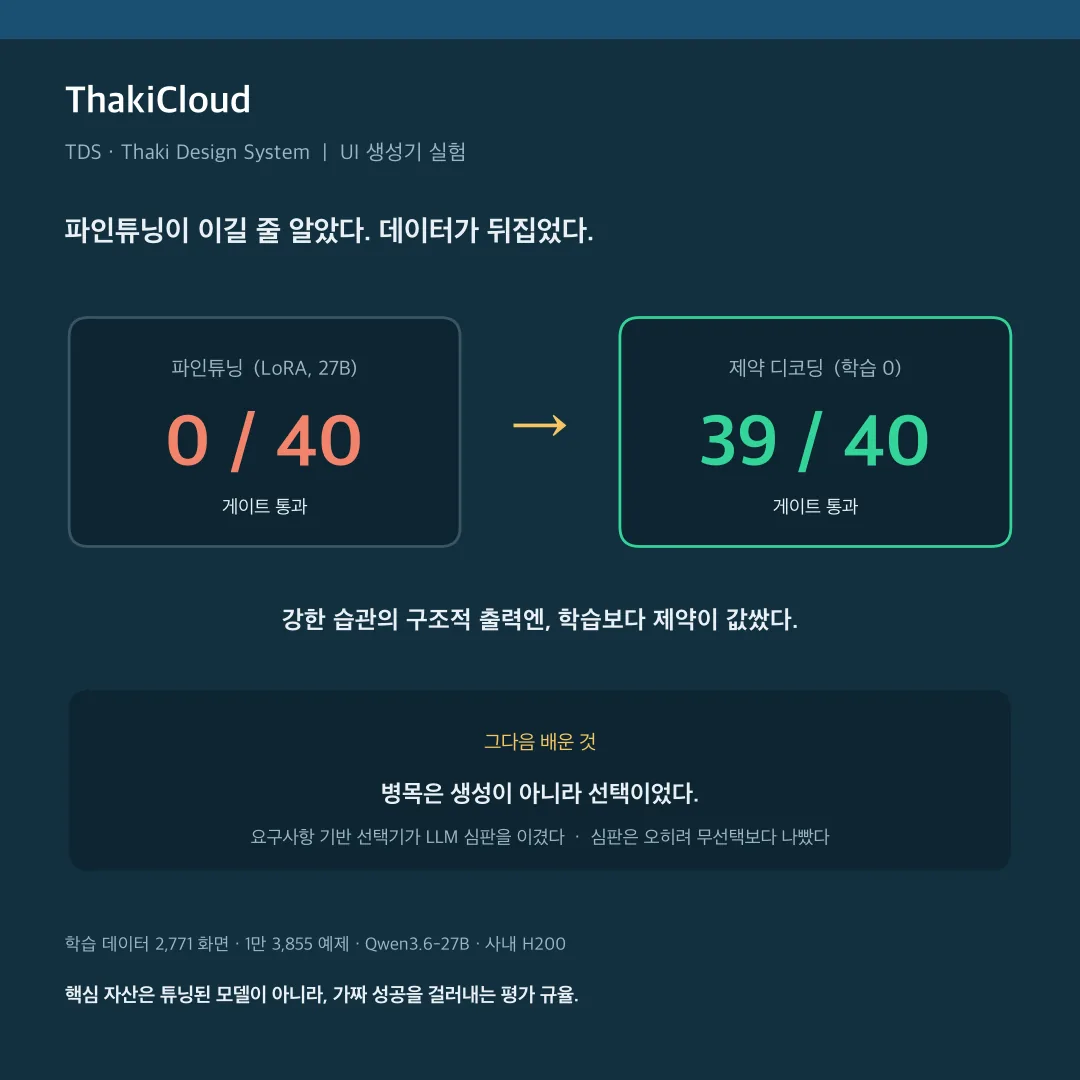
파인튜닝이 이길 줄 알고 시작했는데 데이터가 뒤집었습니다.
지금까지 새 모델 아키텍처는 두 번 만들어야 했습니다.
대규모 모델을 여러 가속기에 나눠 학습하거나 서빙할 때, 실제 병목은 연산이 아니라 가속기 사이를 오가는 데이터입니다.
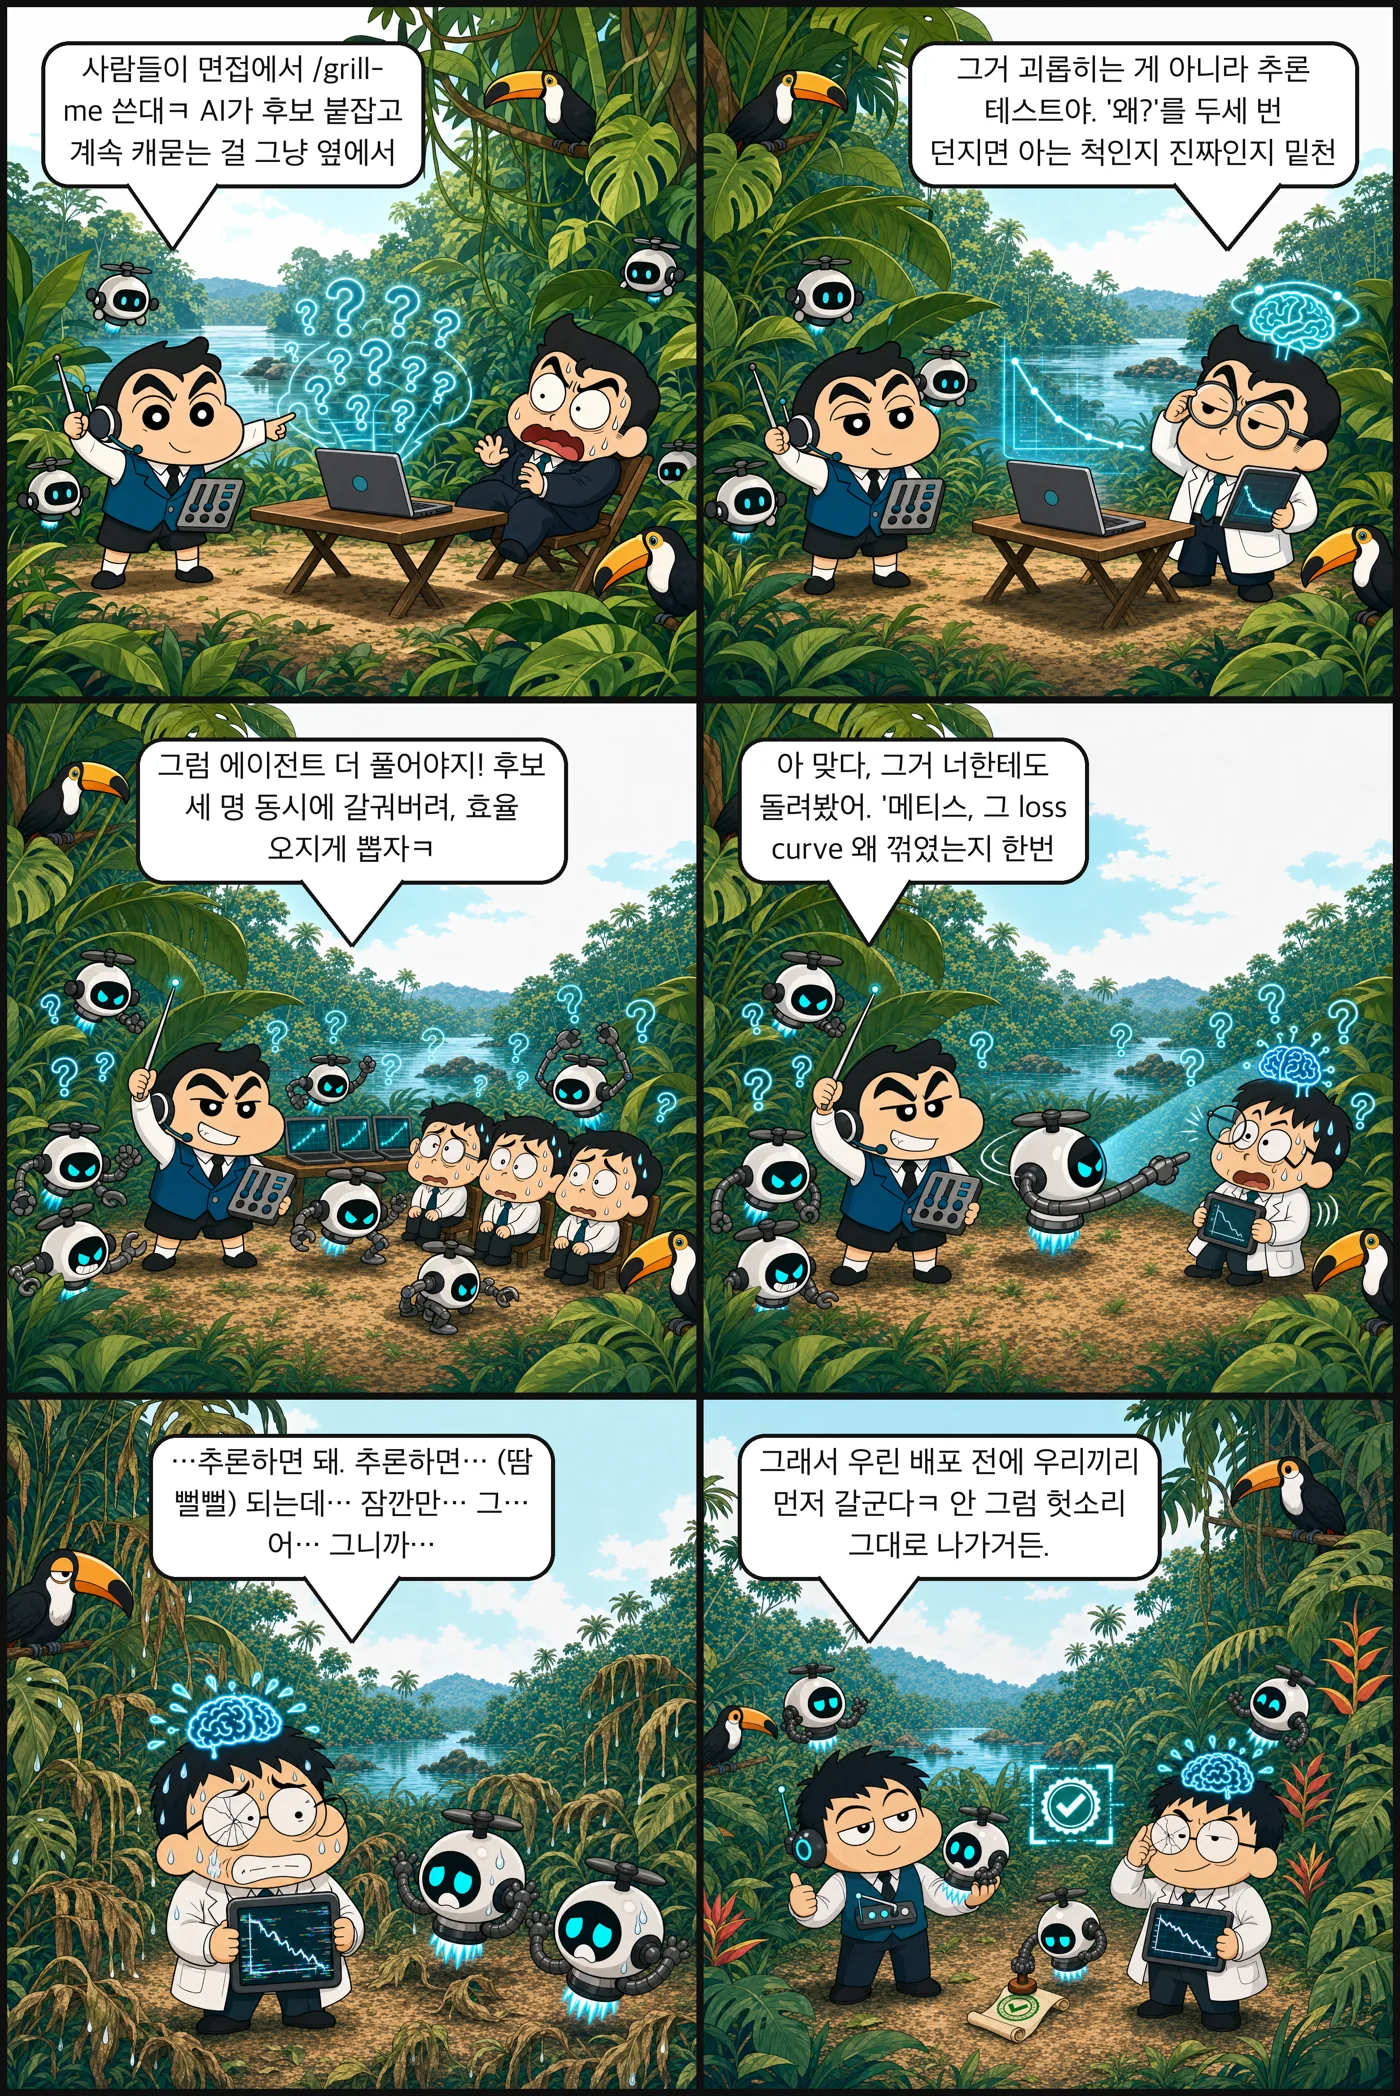
후보를 갈구던 AI, 자기부터 갈궈봤더니
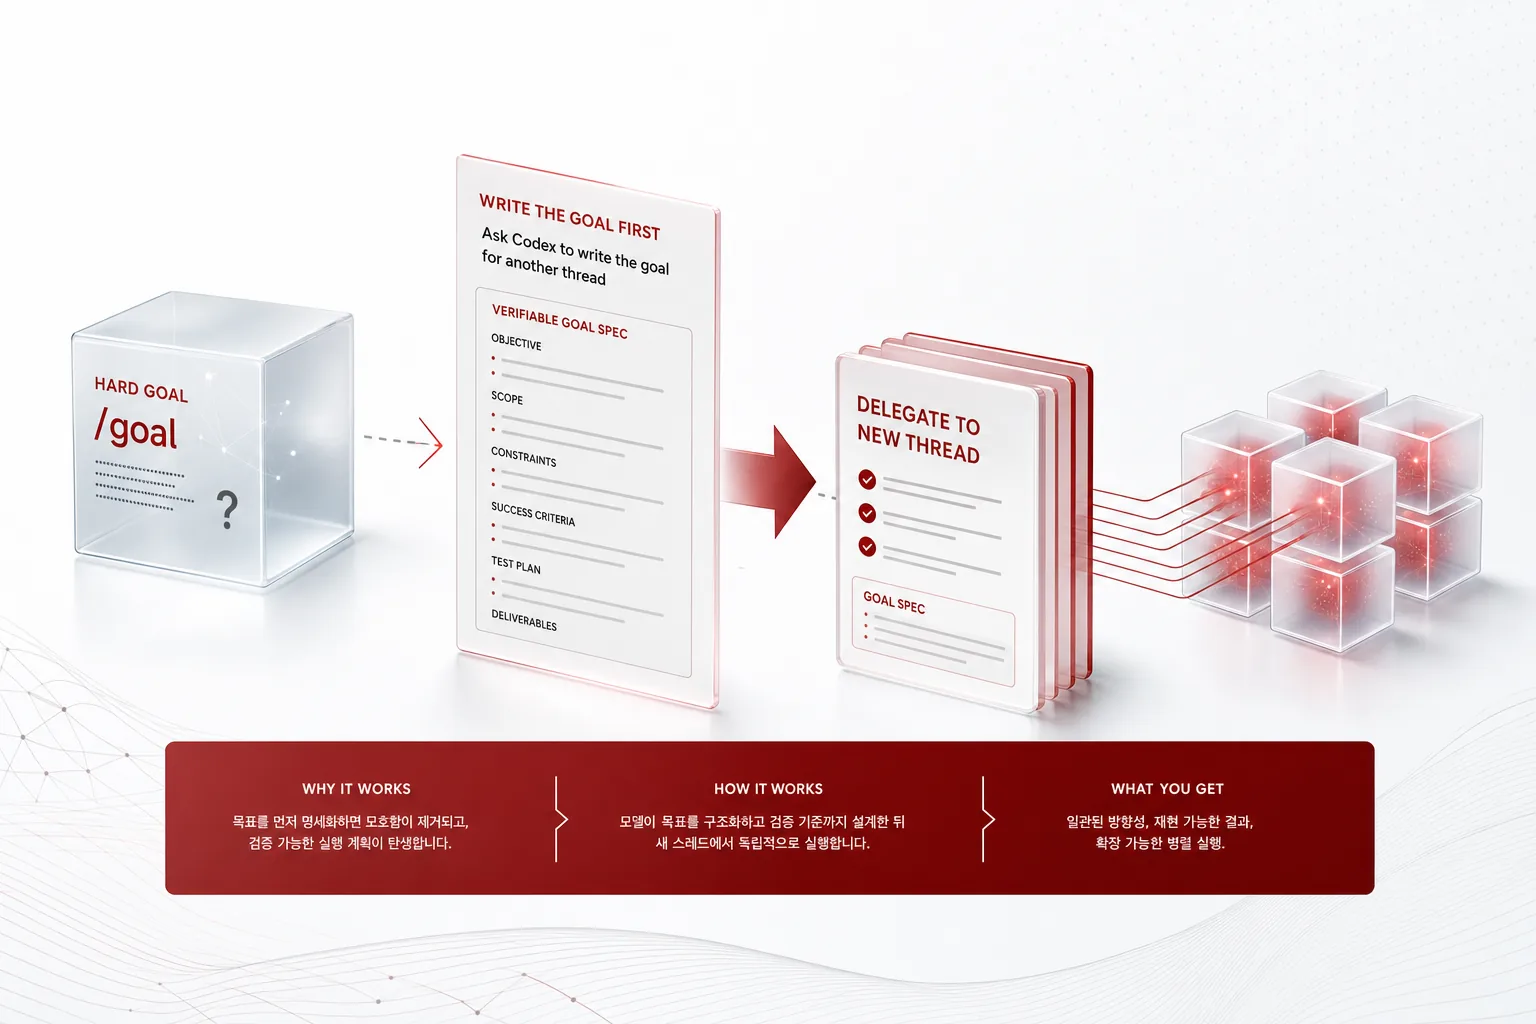
한 개발자가 Codex에 어려운 /goal을 줄 때 ‘다른 스레드가 이 목표를 달성하도록 목표를 대신 써달라’고 먼저 요청한다는 팁을 공유했습니다.
문서 OCR 파이프라인에 두 크기의 VLM을 얹은 엔지니어를 위한 글입니다.
GPT-5.6이 더 똑똑하냐가 아니라, 그 토큰을 누가 더 싸고 빠르게 서빙하느냐가 마진을 가릅니다.
Unsloth로 모델을 4비트로 줄이는 방법을 아는 팀은 많습니다.
누군가 GLM-5.2에서 1403GB를 980GB로 줄였다고 했습니다.
괴물 한 대를 못 사서, 갖고 있는 잡동사니를 다 엮어버림
은행연합회는 더 똑똑한 모델이 아니라 도입의 순서를 발주했습니다.
완전 자율로 매일 밤 논문을 만들어내는 파이프라인을 최종 결과물이 아니라 실제 운영 로그로 감사한 연구입니다.
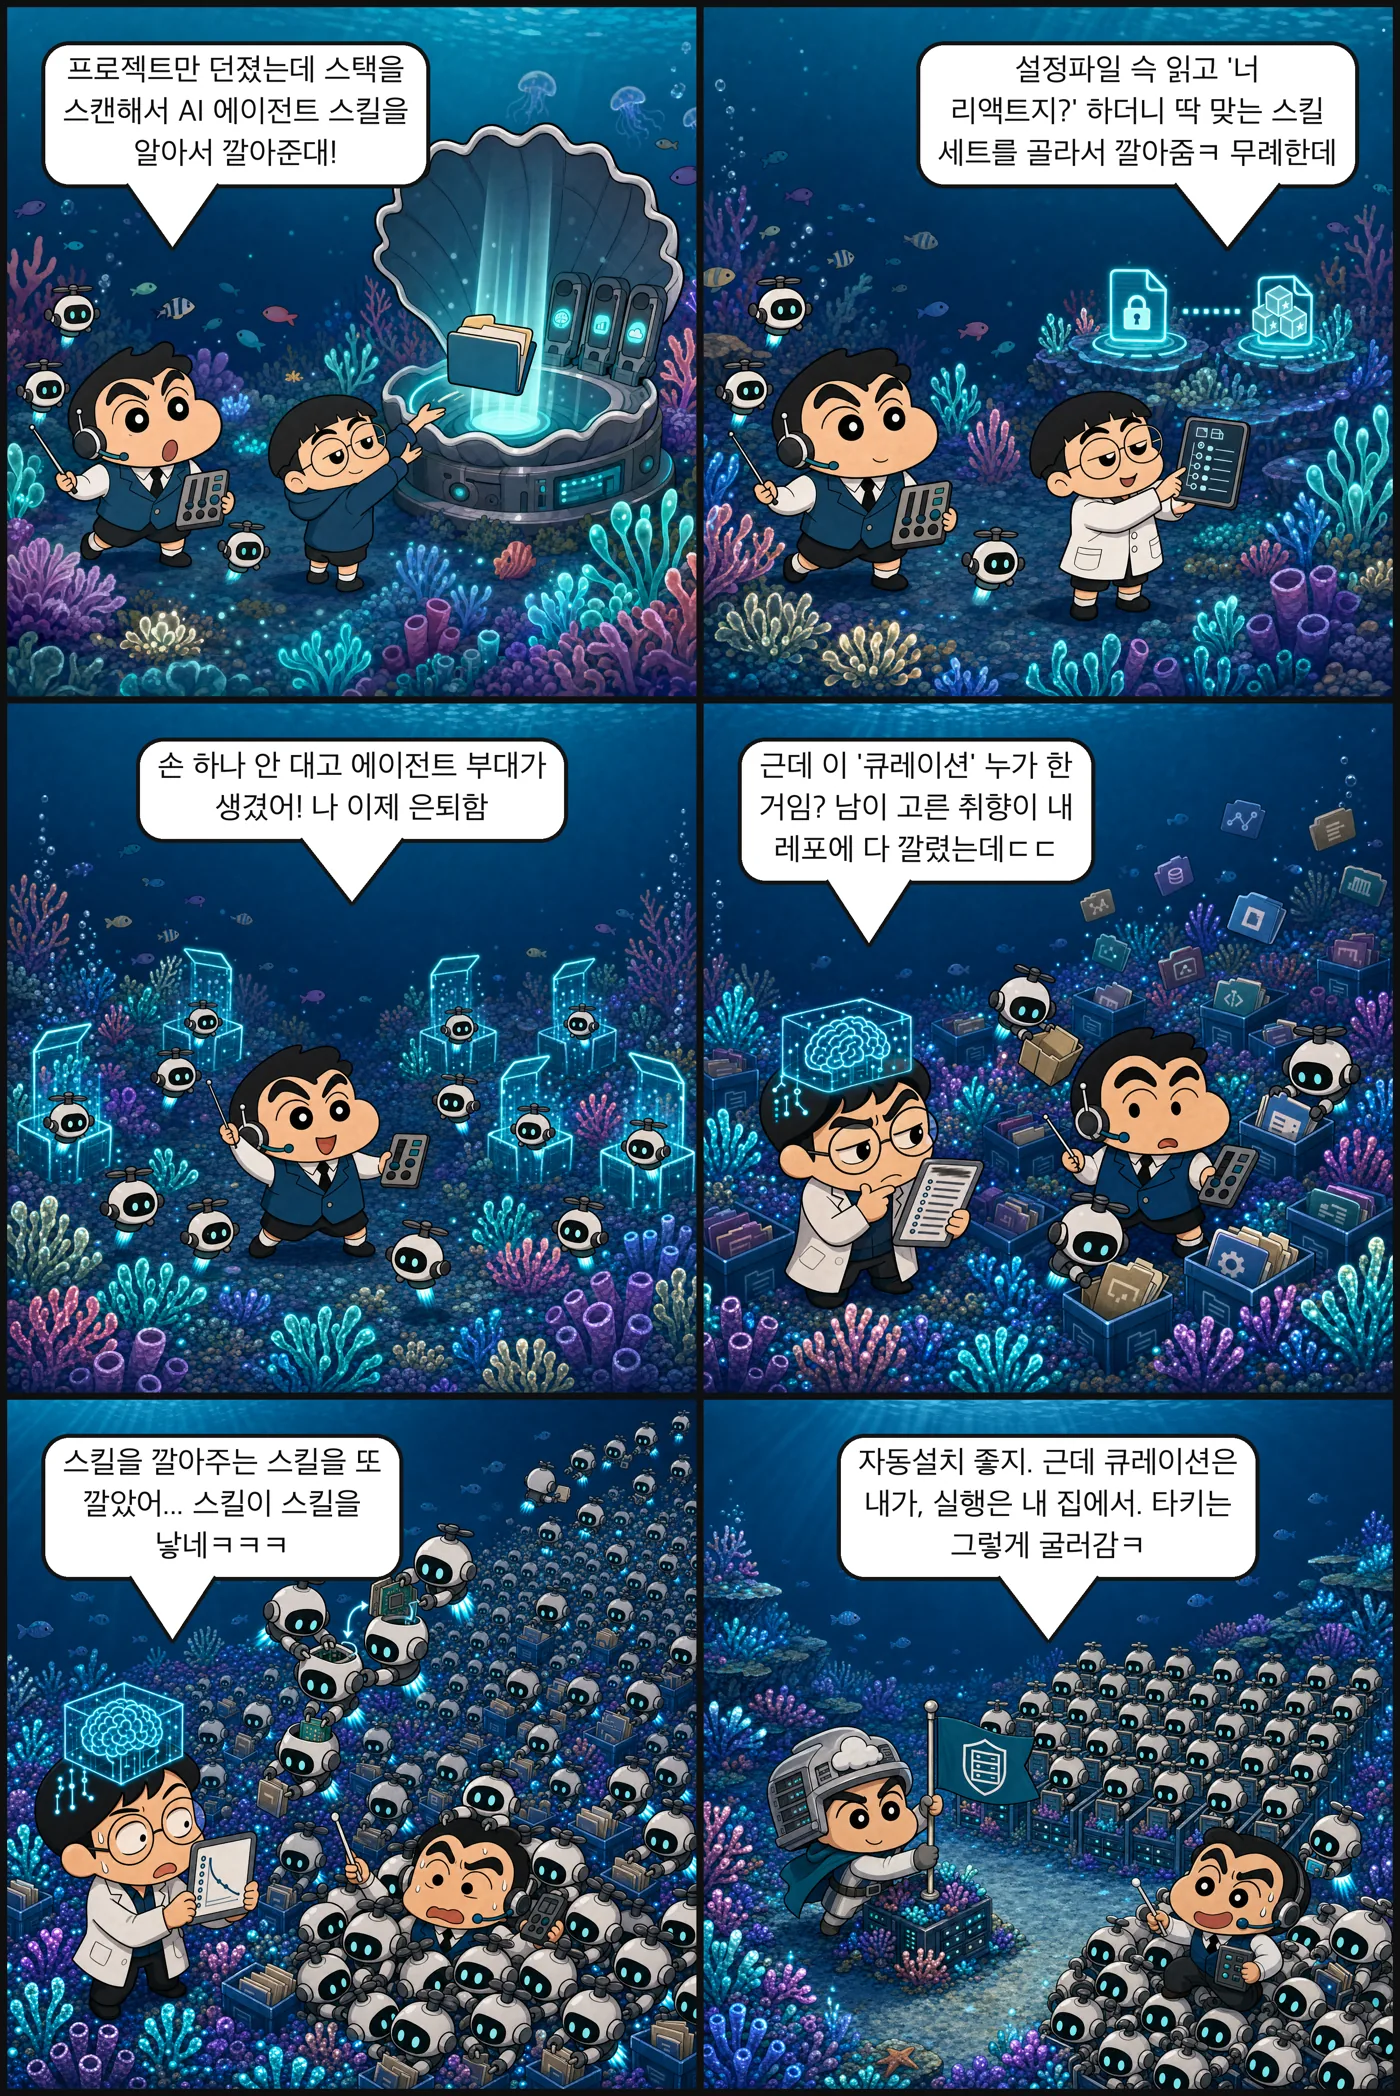
프로젝트만 던졌더니 알아서 다 깔아줌 — 근데 취향은 남의 취향이었다
코딩 에이전트는 오랫동안 텍스트만 읽어 왔습니다.
회사의 반복 업무를 스킬로 정의하면, 각 스킬이 실제로 어느 모델 티어까지 내려가도 되는지를 감이 아니라 측정으로 답할 수 있습니다.
H200이나 Blackwell급 클러스터에서 MoE를 서빙하는 엔지니어라면, 어떤 전문가를 전정밀도로 지켜야 하는지가 핵심입니다.
Claude Code와 Codex 같은 코딩 에이전트는 Anthropic API에 묶여 있습니다.
vLLM v0.25.0이 232명의 기여자가 보낸 558개의 커밋과 함께 나왔습니다.
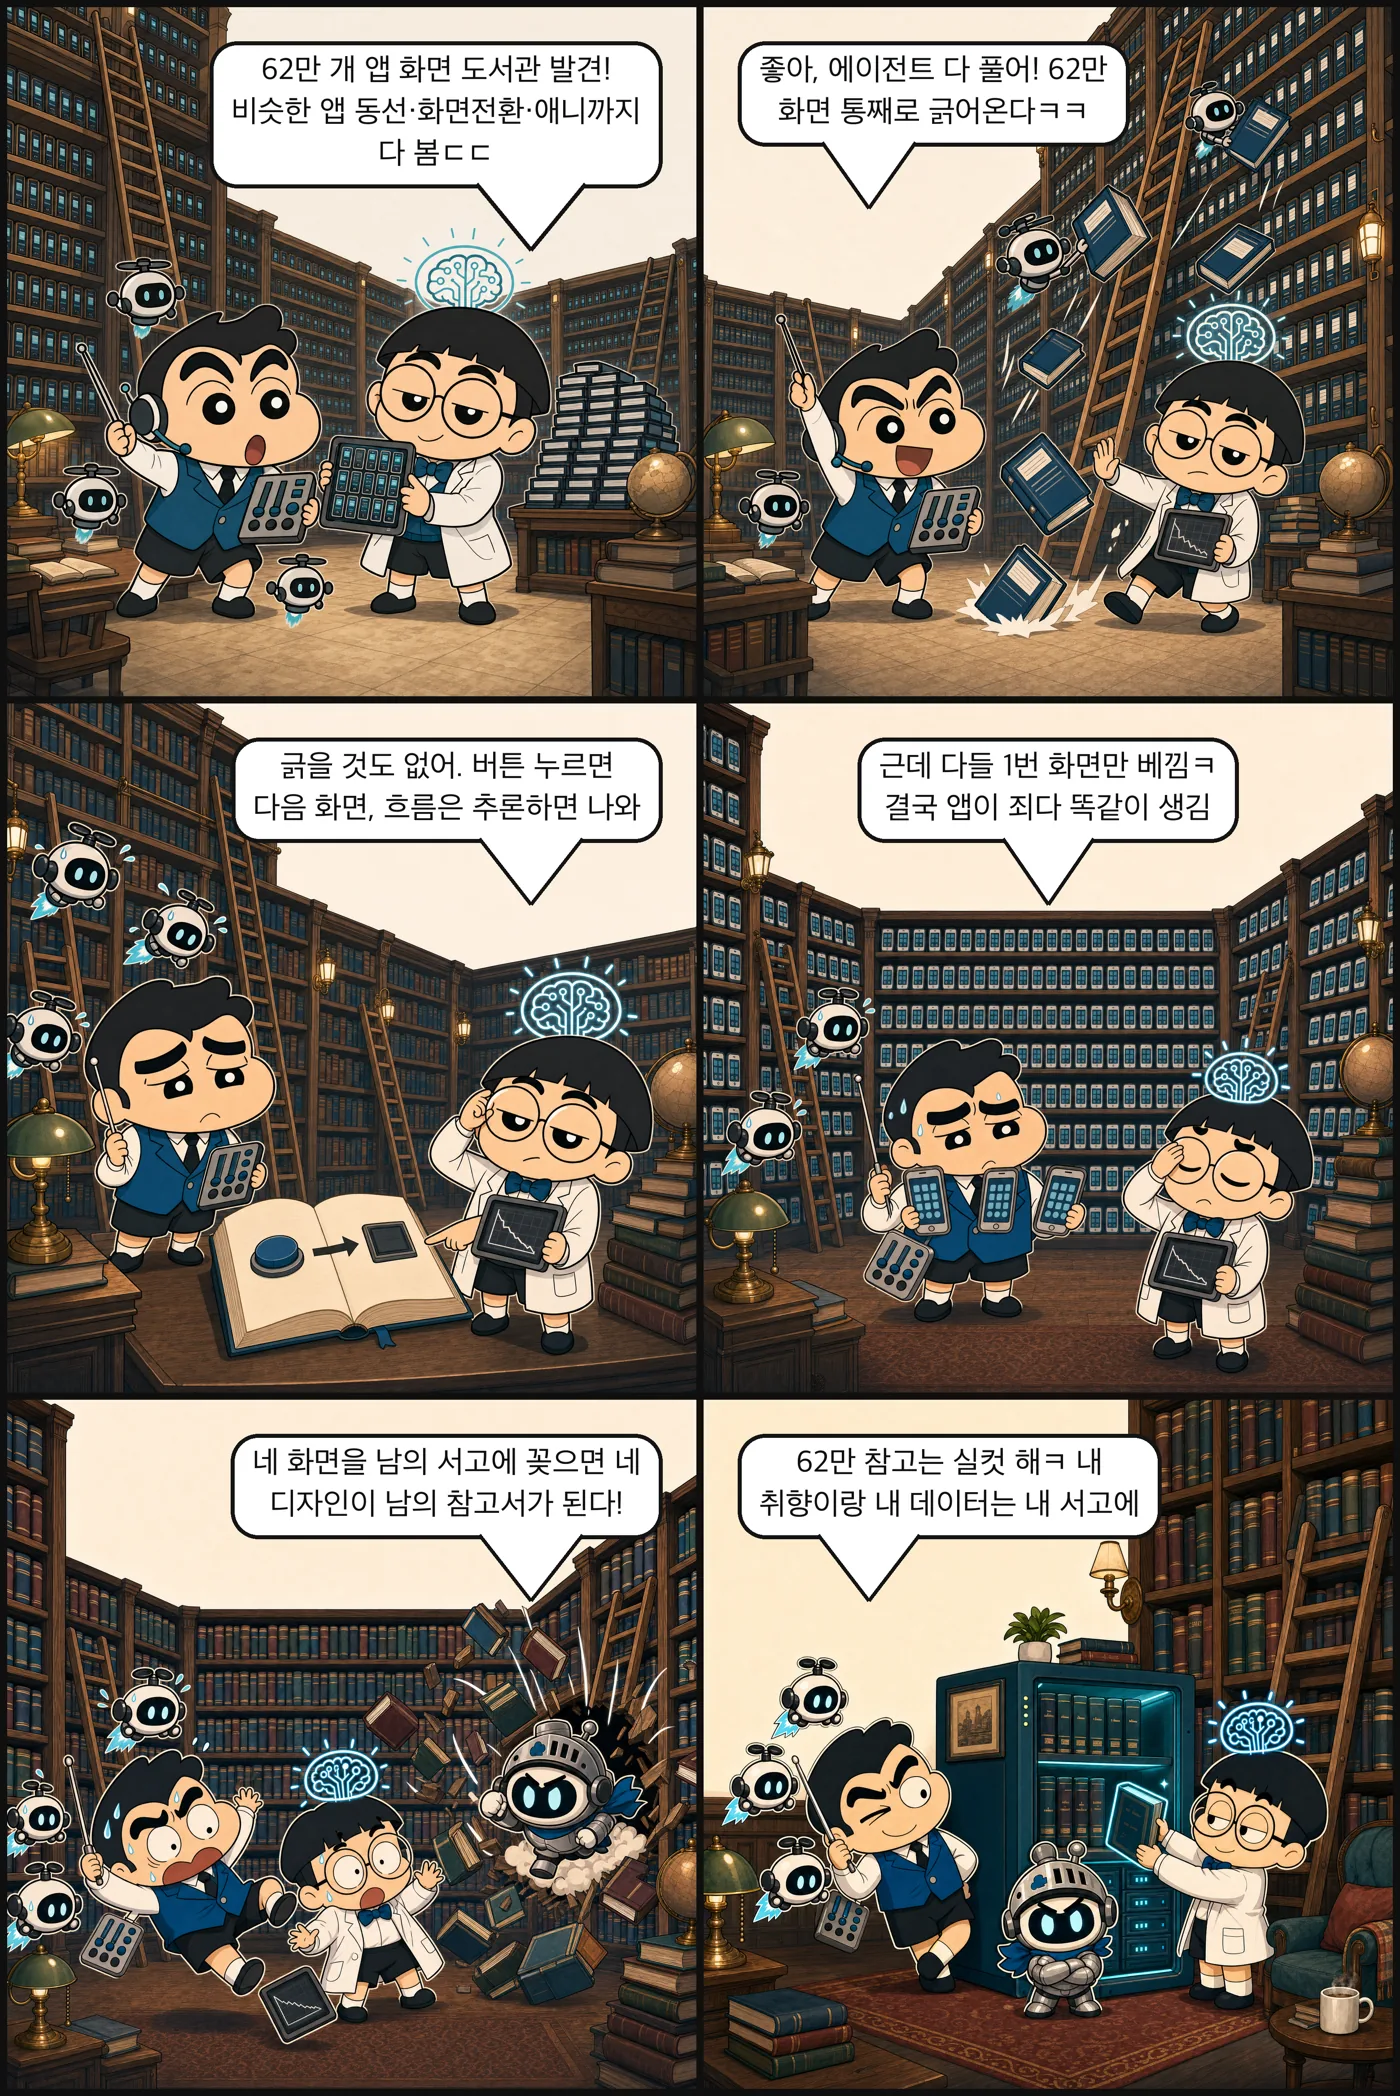
62만 개 화면을 다 참고했더니, 세상 앱이 다 한 앱이 됐다
값이 내려가면 덜 쓸까요.
에이전트 스킬을 프런티어 API로만 돌리면 호출 수천 번에 비용이 폭증합니다.
한 사람이 한 에이전트를 쓰던 구조에서, 여러 사람과 여러 에이전트가 같은 작업 공간에서 서로 대화하는 구조로 넘어가고 있습니다.
모든 fan-out은 적대적 검증으로 닫아야 한다는 원칙은 널리 퍼져 있지만, 검증자 등급과 스켑틱 수를 얼마나 써야 하는지는 실측 없이 관행으로 정해져 왔습니다.
긴 호흡의 에이전트 작업을 RL로 학습할 때 GRPO의 그룹 샘플링은 가장 느린 롤아웃을 기다리느라 GPU를 놀립니다.
장기 실행 에이전트는 제한된 메모리 안에서 움직이지만, 지금까지의 메모리 기법은 관련성이나 요약 품질 같은 묘사적 기준으로 과거를 조직했습니다.
허깅페이스에서 GGUF 파일을 받아 실행 버튼만 누르는 사람과, 그 파일 안에 어떤 텐서가 몇 비트로 들어 있는지 아는 사람 사이에는 큰 차이가 있습니다.
Mac Mini를 클라우드에 두면 GUI가 없어 iOS 시뮬레이터를 볼 수 없습니다.
약점 콕 집어 고치면 이긴대.
OpenAI Codex 팀 엔지니어 jxnl이 공개한 personal-monorepo-template은 벡터DB 없이 폴더 구조와 AGENTS.md만으로 에이전트에 영구 기억을 부여합니다.
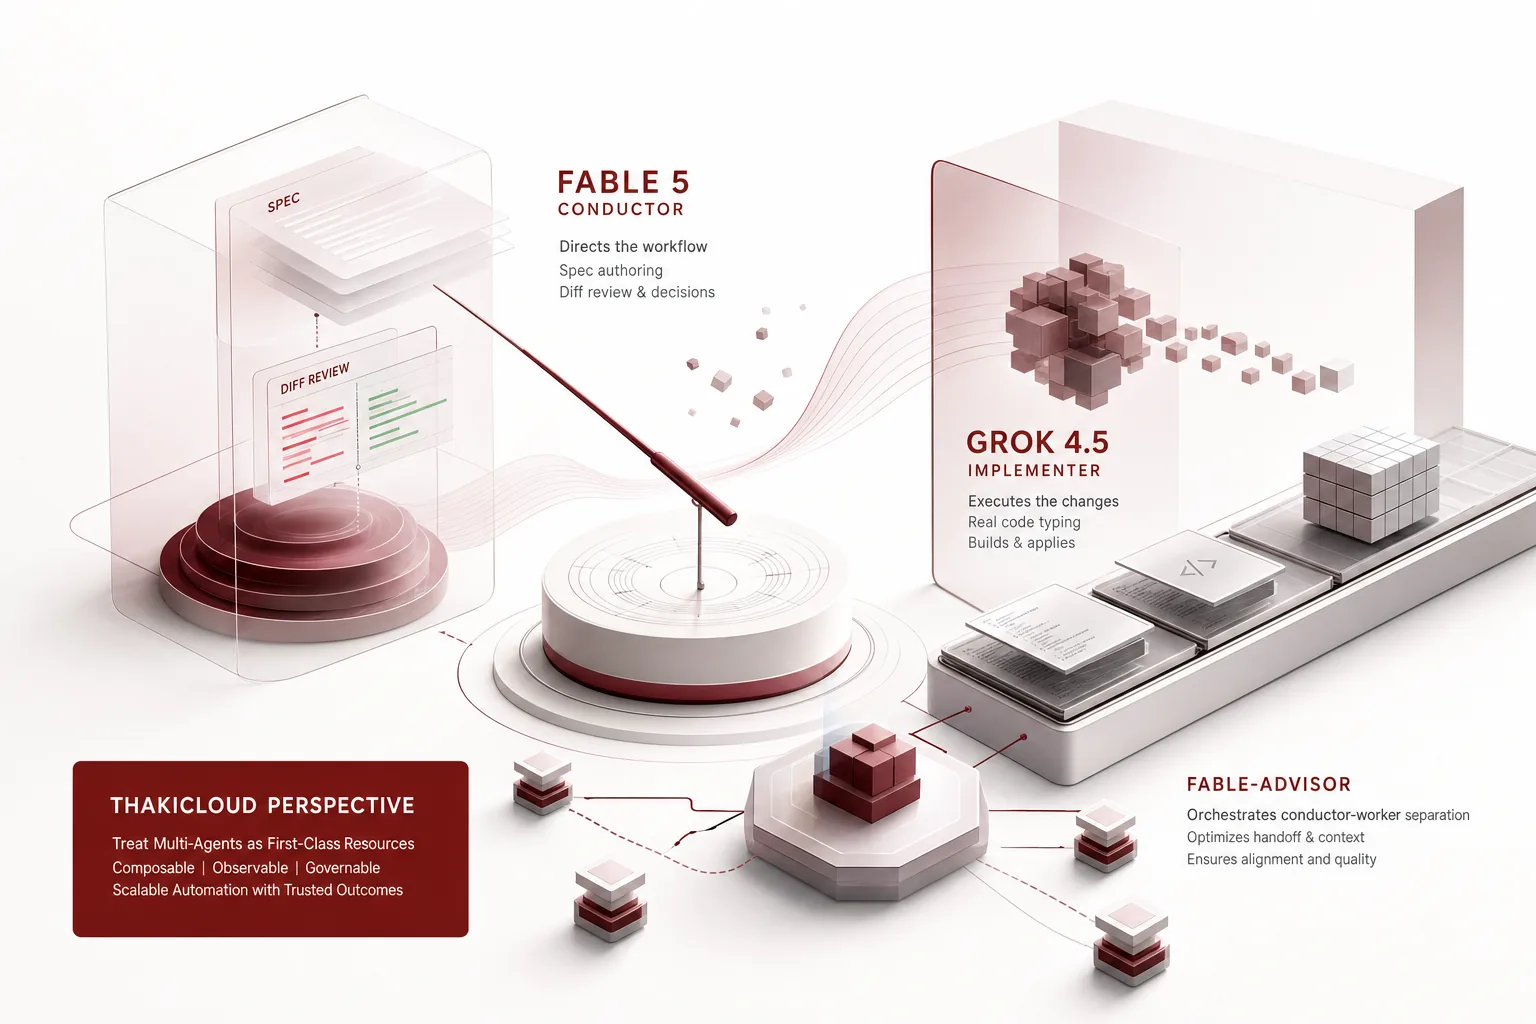
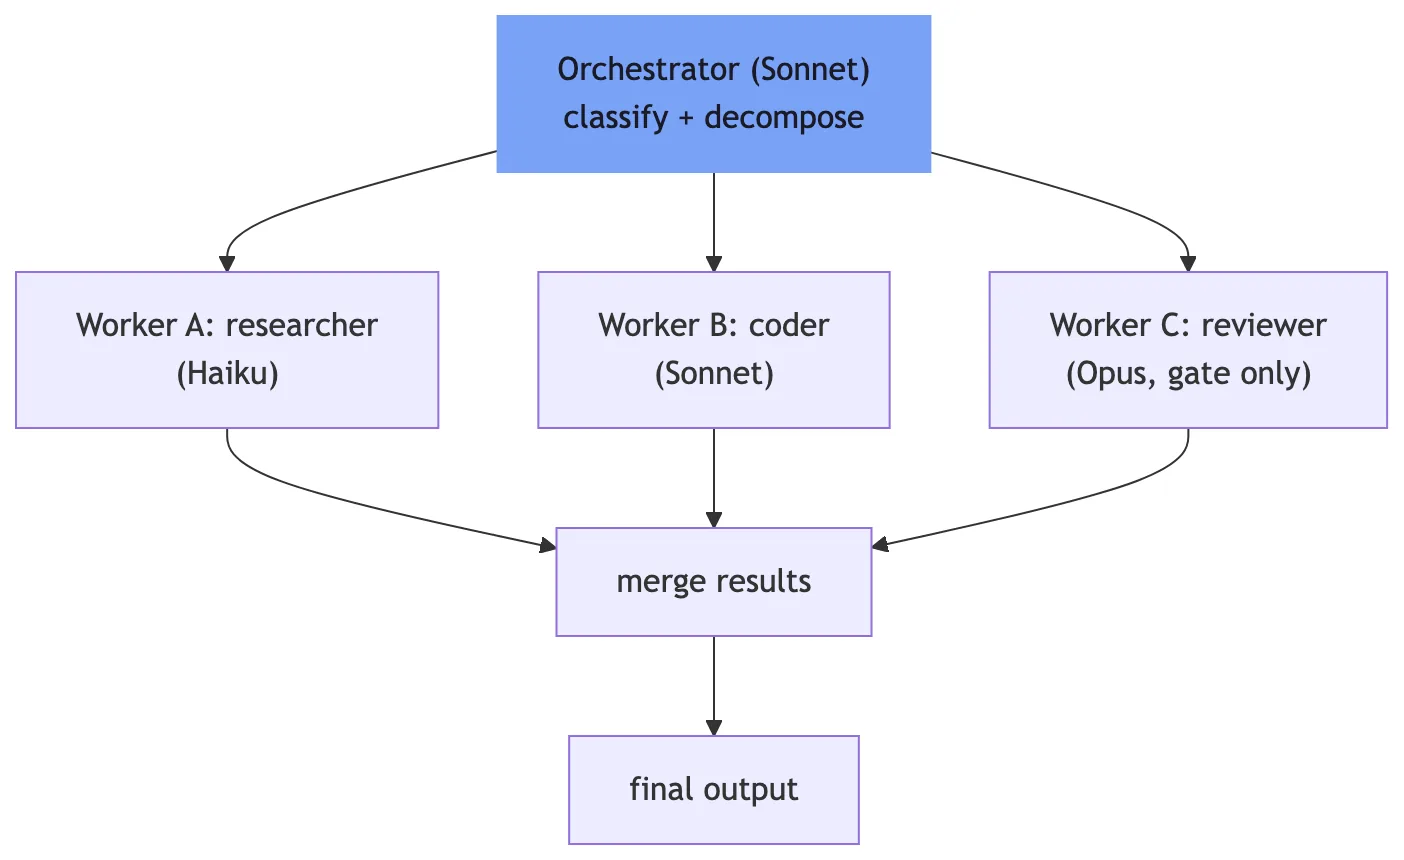
Claude Fable 5가 스펙 작성과 diff 리뷰를 지휘하고, 실제 코드 타이핑은 Grok 4.5가 전담하는 fable-advisor 플러그인의 지휘자-워커 분리 구조를 분해하고, 멀티에이전트를 일급 리소스로 다루는 ThakiCloud 관점에서 검증합니다.
예일과 시카고대 연구진이 11,683편의 실제 논문으로 인간과 LLM의 연구 아이디어를 비교했습니다.
ARC-AGI-3는 설명서 없는 대화형 게임에서 에이전트가 스스로 상황을 파악하고 적응하는지를 측정합니다.
요즘 RL 포스트트레이닝의 대세는 critic을 버리는 GRPO 계열입니다.
대규모 스킬 생태계를 운영하는 에이전트 하네스에서 라우팅 실패의 진짜 원인이 분해가 아니라 검색기라는 진단이 나온 뒤, 그 고치는 손을 사람에서 무인 루프로 옮기면 실제로 병목이 좁혀지는지를 실측한 연구입니다.
SpaceXAI가 Grok 4.5를 공개했습니다.
HBM4가 서버 랙 한 대 값을 2100만 달러로 밀어올리고, SK하이닉스는 하루 만에 40조를 조달했습니다.
같은 날 발표된 두 개의 숫자가 정반대로 움직였습니다.
마이크로소프트는 엑셀과 아웃룩의 대량 AI 요청을 자사 모델로 돌리기 시작했고, 중국 오픈 모델은 미국 기업 AI 사용량의 절반 가까이를 잠식했으며, 시장에서는 1조 달러가 넘는 시가총액이 하루아침에 사라졌습니다.
1년째 ‘언젠가’ 리스트에 박아둔 에이전트, 열어보니 커피 식기 전에 끝남
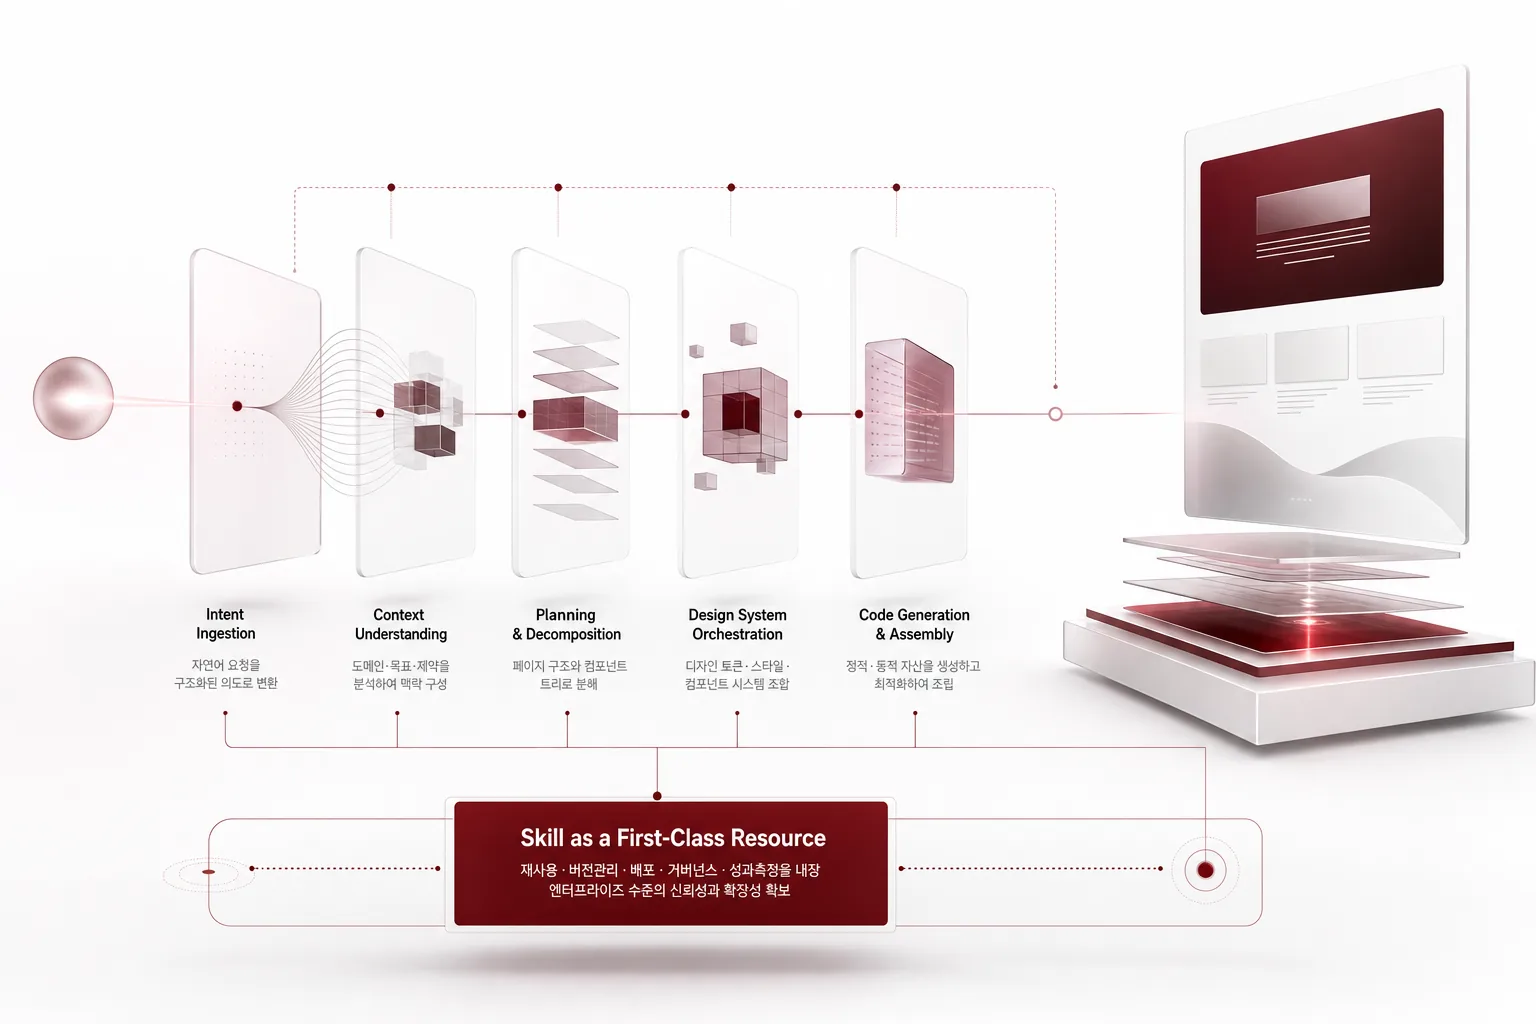
자연어 요청 한 번으로 프리미엄 랜딩페이지를 만든다는 Claude Code 스킬이 실제로 어떤 구조로 동작하는지 분해하고, 스킬을 일급 리소스로 다루는 ThakiCloud Paxis 관점에서 검증합니다.
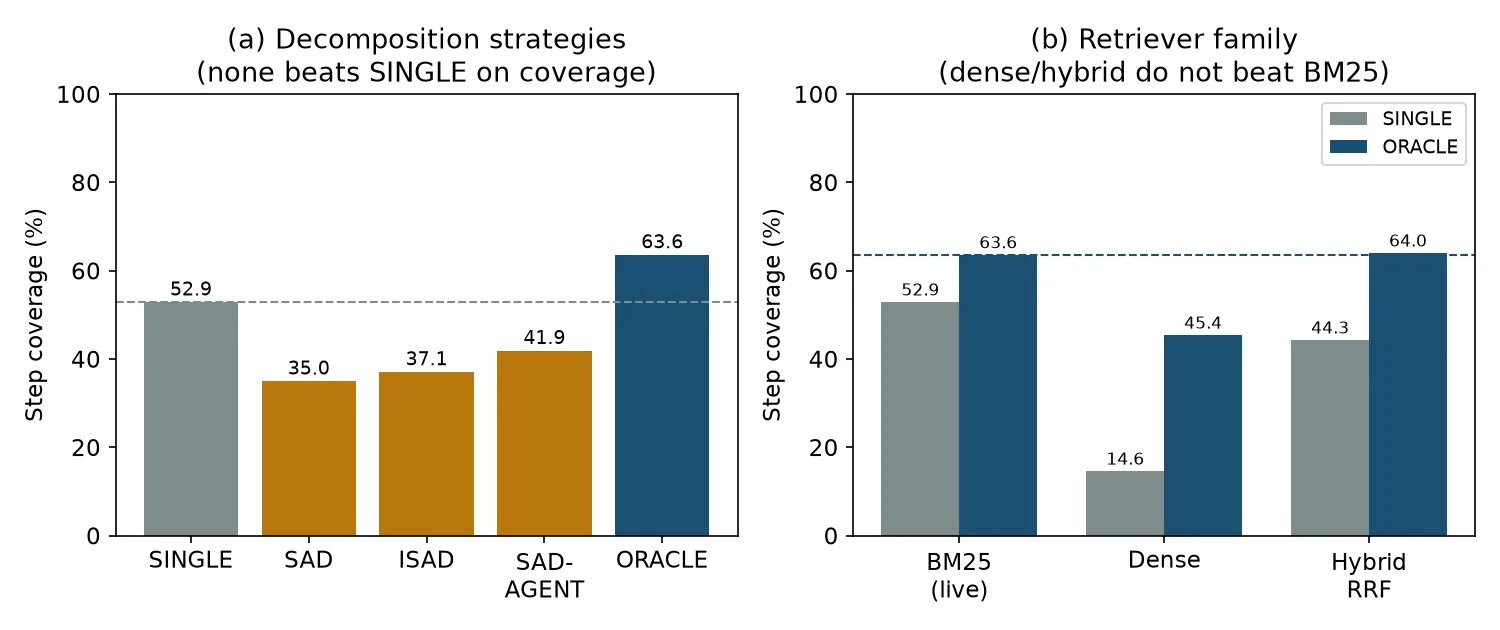
수백 개 스킬을 라우팅하는 하네스에서 다음 투자를 분해에 할지 리트리버에 할지 두 숫자로 판별하는 진단법을 소개합니다.
장기 기억과 단기 기억을 서로 다른 휴리스틱으로 다루던 관행을 깨고, 저장·검색·요약·삭제를 에이전트의 행동 공간으로 통합한 AgeMem 논문을 분석하고 ThakiCloud 에이전트 플랫폼 관점에서 시사점을 정리합니다.
OpenAI가 공개한 GPT-Live는 사용자가 말을 끝내기를 기다리지 않고 듣는 동시에 말하는 풀듀플렉스 음성 모델입니다.
SpaceXAI가 공개한 Grok 4.5는 Opus 4.8과 GPT-5.5에 근접한 성능을 절반 이하 가격에 내놓았습니다.
Anthropic의 Claude Fable 5가 프런트엔드 생성에서 새로운 기준을 세우고 있습니다.
기억이 ‘행동’이 됐다는데, 안 잊는 건 왜 요금뿐이냐
뇌가 다 같으면, 비싼 뇌를 굳이 빌릴 이유가요?
AI가 감각을 넓히고 손을 얻는 뉴스가 쏟아진 하루입니다.
Claude Code를 사람이 매번 붙어 있지 않아도 돌아가게 만드는 네 가지 메커니즘을 정리하고, ThakiCloud가 실제 운용 중인 헤드리스 파이프라인·훅·서브에이전트·스킬 사례로 검증합니다.
11억 파라미터가 70억을 이기고 최고 모델이 공짜로 풀리는 날, 정작 기업을 멈칫하게 만든 뉴스는 지능이 아니라 ‘행동 기록’이었습니다.
서로 다른 데이터로, 서로 다른 목적으로 학습한 비전 모델과 언어 모델이 시간이 갈수록 데이터를 같은 방식으로 표현하기 시작합니다.
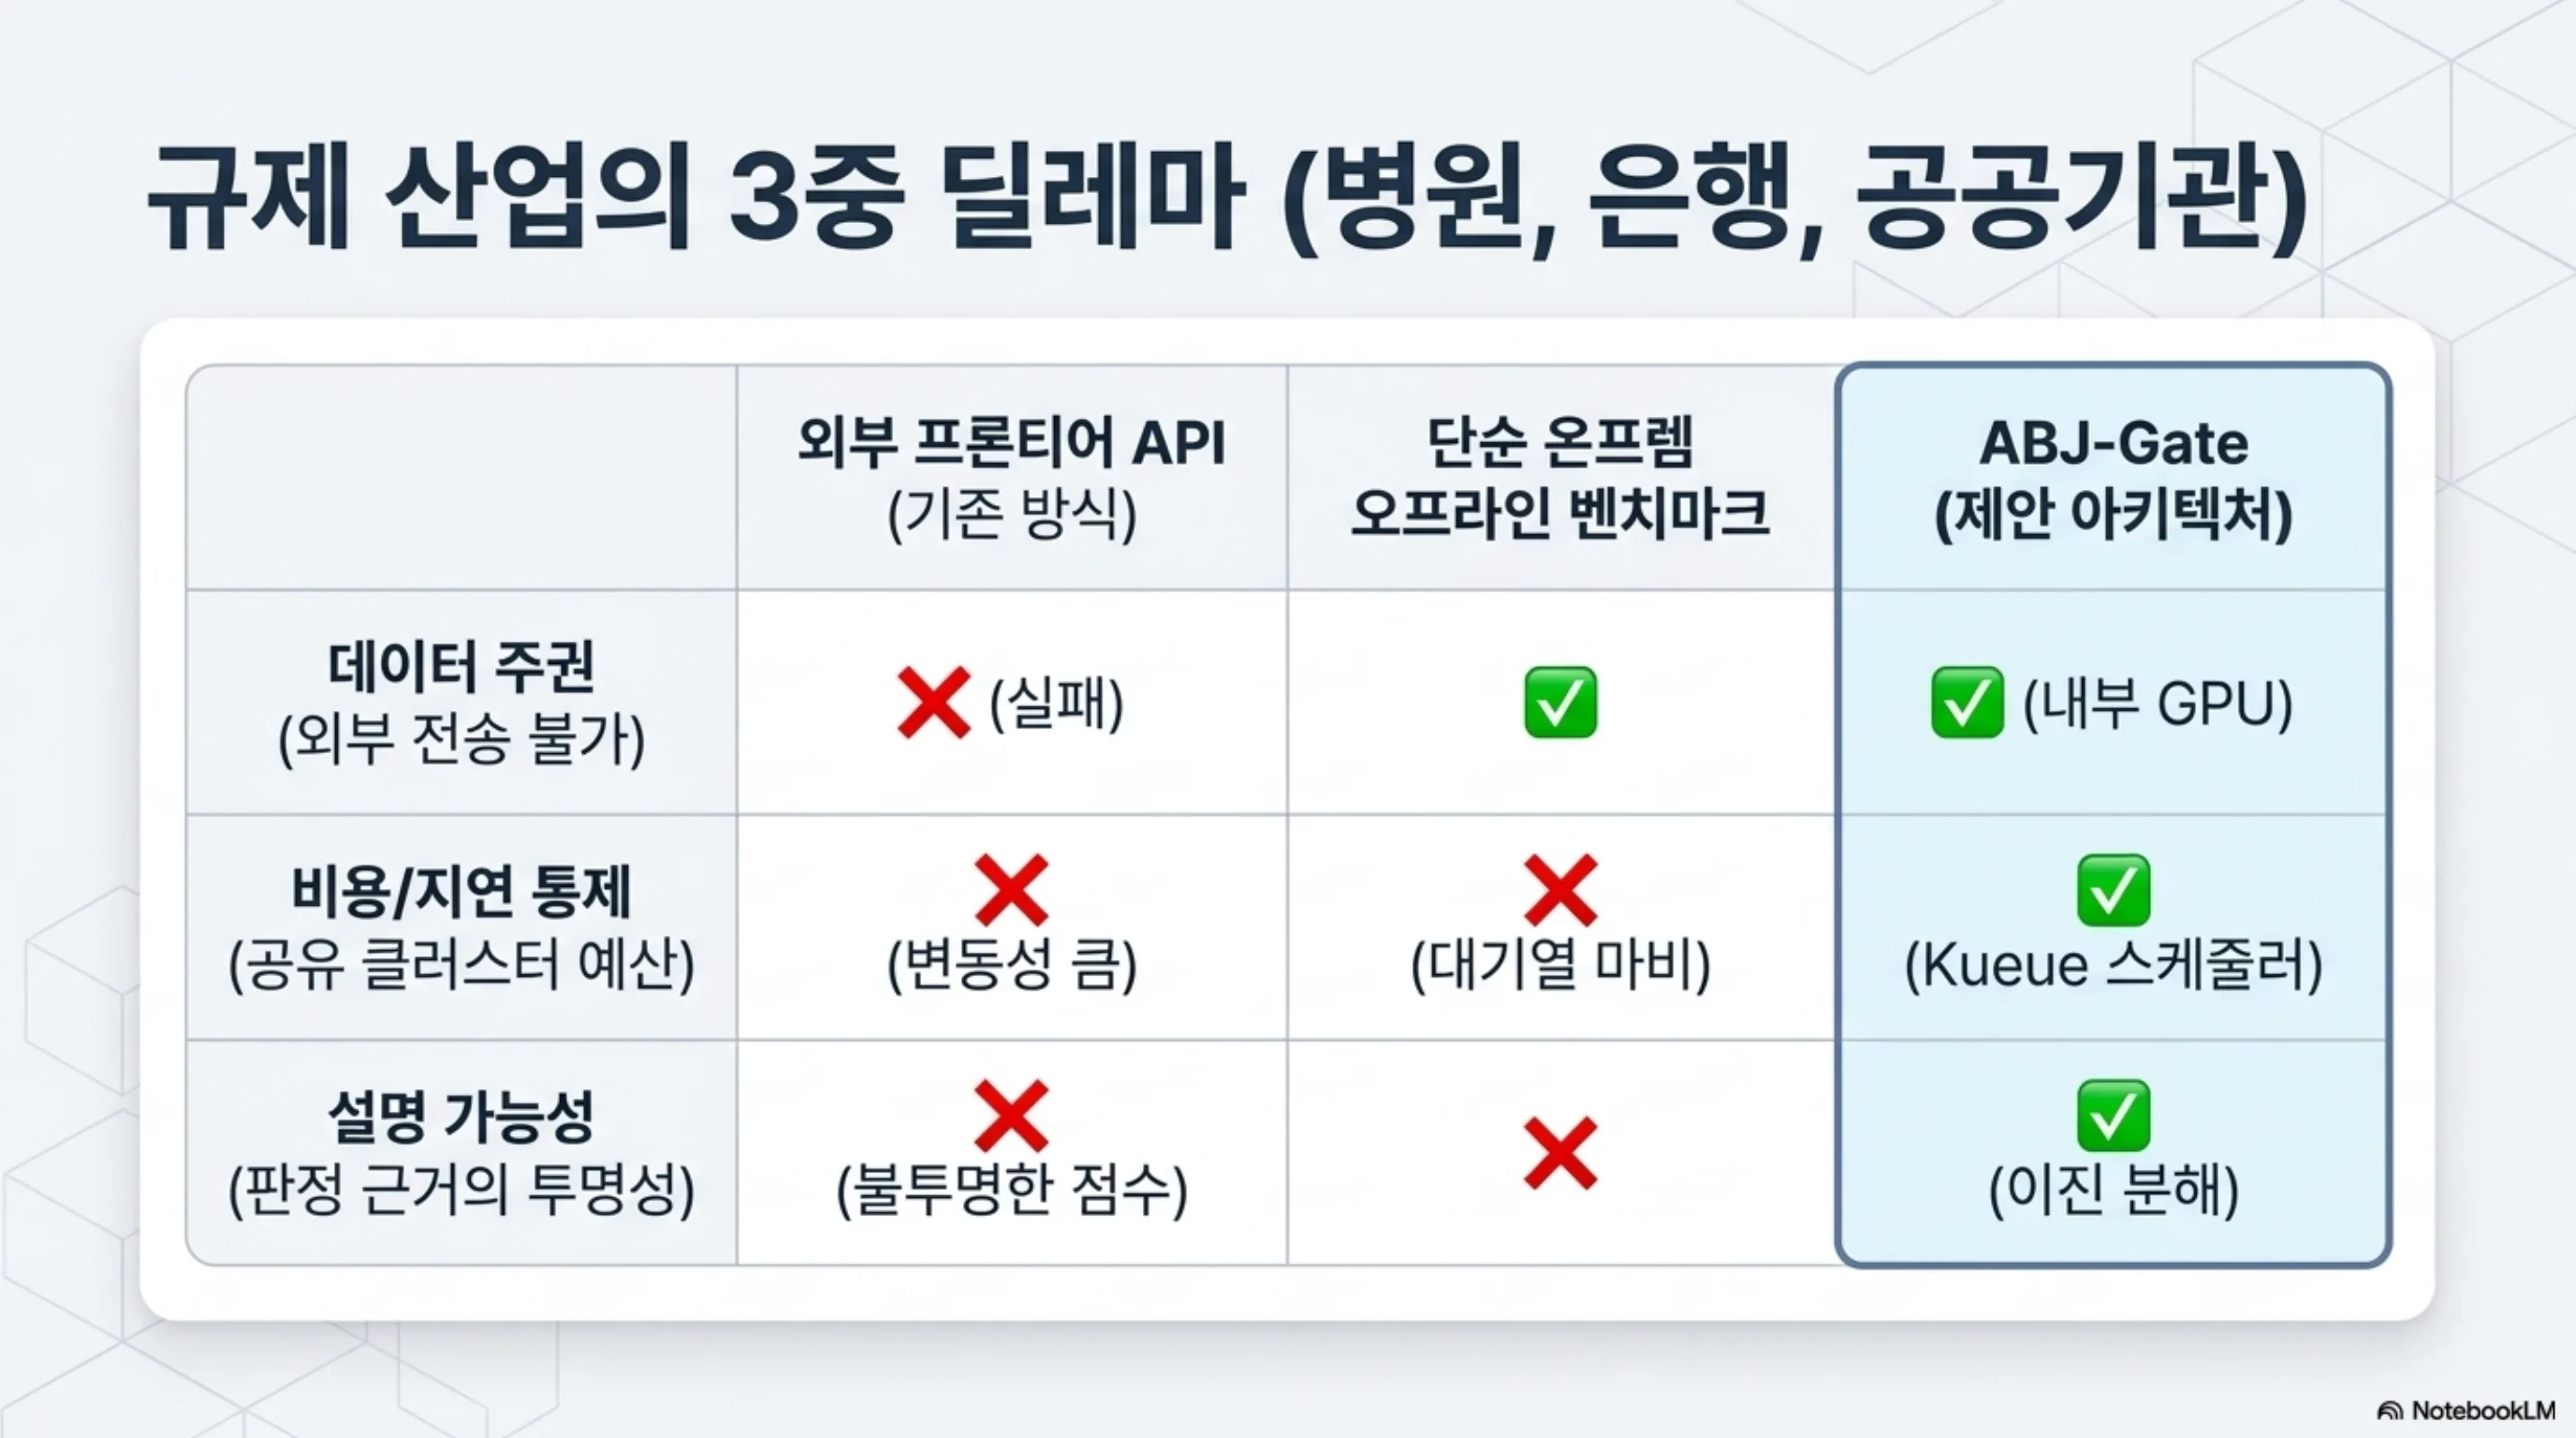
온프렘 AI 플랫폼을 쓰는 병원이나 은행, 정부기관은 데이터가 엔클레이브 밖으로 새지 않았다는 것과 서빙된 모델 가중치가 감사받은 그 파일이 맞다는 것, 이 두 가지를 규제기관에게 증명해야 합니다.
오픈AI가 GPT-5.6을 Sol·Terra·Luna 세 등급으로 쪼개 목요일 공개합니다.
Anthropic이 2026년 7월 7일 ‘Getting started with loops’라는 첫 공식 루프 엔지니어링 문서를 공개했습니다.
남 칩 찍어주다 몇 년 만에 흑자.
LLM을 채점자로 쓰는 ‘LLM-as-a-judge’는 이제 모델 개발의 기본값이지만, 2026년 들어 쌓인 증거는 단일 점수를 내는 스칼라 심판이 프롬프트와 위치에 취약하고 중간값으로 쏠리며 적대적 입력 앞에서 동전 던지기 수준으로 무너진다는 사실을 보여줍니다.
모노레포에서 라이브러리 디렉터리와 소비 서비스 디렉터리를 오갈 때, 세션을 재시작하면 대화 맥락도 프롬프트 캐시도 함께 날아갑니다.
대부분의 개발자는 세팅을 건너뛰고 바로 프롬프트를 칩니다.
AI control의 핵심 방어선인 ‘신뢰 못 하는 강한 모델을 약한 감시 모델로 통제한다’는 전제는 감시자와 정책 모델이 같은 텍스트를 읽는다는 가정 위에 서 있습니다.
구글 딥마인드가 공개한 약 57페이지 보고서 From AGI to ASI는 초지능을 먼 사고실험이 아니라 지금 준비해야 할 계획 문제로 다룹니다.
오픈 언어 모델의 다운로드와 추론 사용량을 한자리에서 측정한 ATOM 리포트는, 중국 오픈 모델이 2025년 여름 미국 진영을 추월한 뒤 격차를 벌려 왔다는 사실을 데이터로 보여 줍니다.
100만 토큰에 0.11달러.
Anthropic이 Claude Fable 5와 Mythos 5를 위한 공식 프롬프팅 가이드를 조용히 공개했습니다.
1,000 TPS를 넘긴 JetSpec 같은 스펙큘레이티브 디코딩 성과는 전부 단일 테넌트, 여유 연산력이 넘치는 B200급 하드웨어를 전제로 합니다.
거대 LLM과 에이전트 스킬이 좋아질수록 파인튜닝은 필요 없어진다는 체감이 업계에 퍼지고 있습니다.
284B DeepSeek V4 Flash가 35B Qwen3.6보다 output 토큰이 5배 저렴한 역설을 roofline 모델로 해부합니다.
GLM-5.2 743B MoE를 AMD MI355X 한 노드에서 2,626 tok/s/node로 서빙하고 Blackwell 대비 2배 이상 저렴하게 만든 사례를, MXFP4 양자화와 SGLang MoE 병렬화 관점에서 검증하고 ThakiCloud ai-platform의 멀티벤더 서빙 전략과 연결합니다.
작동하는 기계와 이해한 원리 사이의 간극은 과학사에서 늘 반복된 장면입니다.
몸에 좋은 조합만 골라 담았는데, 냉장고 열쇠는 왜 쟤가 쥐고 있냐.
독파모부터 한컴의 사명 변경까지, 2026년 7월 5일 아침 뉴스는 하나의 방향을 가리킵니다.
Anthropic이 최신 모델용 프롬프팅 베스트 프랙티스를 정리한 공식 가이드를 뜯어봅니다.
구글이 과학 논문을 통째로 읽어 이론 결과를 검증하고 실험을 확인하며 잠재적 오류를 찾아내는 에이전트형 리뷰 도구 PAT를 공개했습니다.
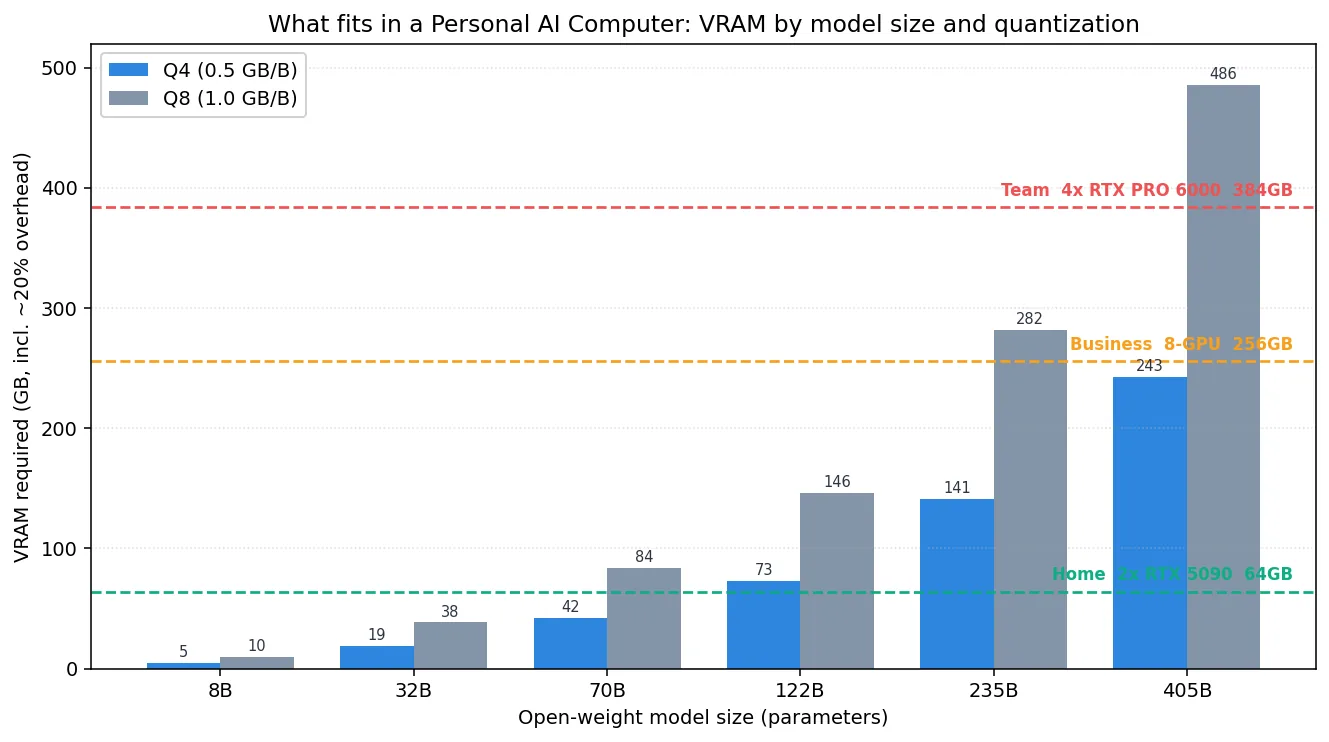
tom_doerr가 공유한 최대 384GB VRAM Personal AI Computer 빌드 가이드를 출발점으로, VRAM이 어떻게 실행 가능한 모델을 결정하는지 계산으로 따져보고, 이 개인용 한 대를 조직 규모의 온프렘 서빙으로 올릴 때 무엇이 필요한지 ThakiCloud ai-platform 관점에서 정리합니다.
T3 창시자 Theo가 공유한 Claude Fable 5 운용 팁을 뜯어봅니다.
로켓 CEO의 창업 특강, 마지막 원칙이 곧 온프렘이었다.
한 개발자가 ‘이제 Claude Code에 프롬프트를 넣지 않는다.
2026년 상반기 뉴스를 보면 AI 에이전트는 데모 무대에서 내려와 보험 언더라이팅과 발전소 현장 업무에 당직을 서기 시작했습니다.
Claude Code의 아티팩트 기능이 Team·Enterprise를 넘어 Pro·Max 요금제까지 확대됐습니다.
로봇은 과제를 풀 때마다 시행착오를 버리고 매번 처음부터 다시 더듬습니다.
15개 프로덕션 MCP 서버를 분석한 최신 논문이 다섯 가지 아키텍처 패턴과 네 가지 안티패턴을 정리했습니다.
대부분의 에이전트 업무는 프론티어 모델이 필요 없습니다.
NVIDIA B200 두 장에서 Qwen3.6-27B-NVFP4와 gemma-4-26B-A4B를 대상으로 텐서병렬, 데이터병렬, Prefill/Decode 분리(1P1D)의 초당 생성 토큰을 실제로 측정했습니다.
Claude Code 2.1.198에 추가된 /dataviz 스킬은 차트와 대시보드 설계 지침을 컨텍스트에 직접 로드합니다.
스킬 라이브러리가 커질수록 에이전트 성능이 오히려 떨어진다는 최근 연구를 정리합니다.
에이전트에게 스킬을 프롬프트로 넣어주는 방식은 컨텍스트를 잡아먹고 쉽게 깨집니다.
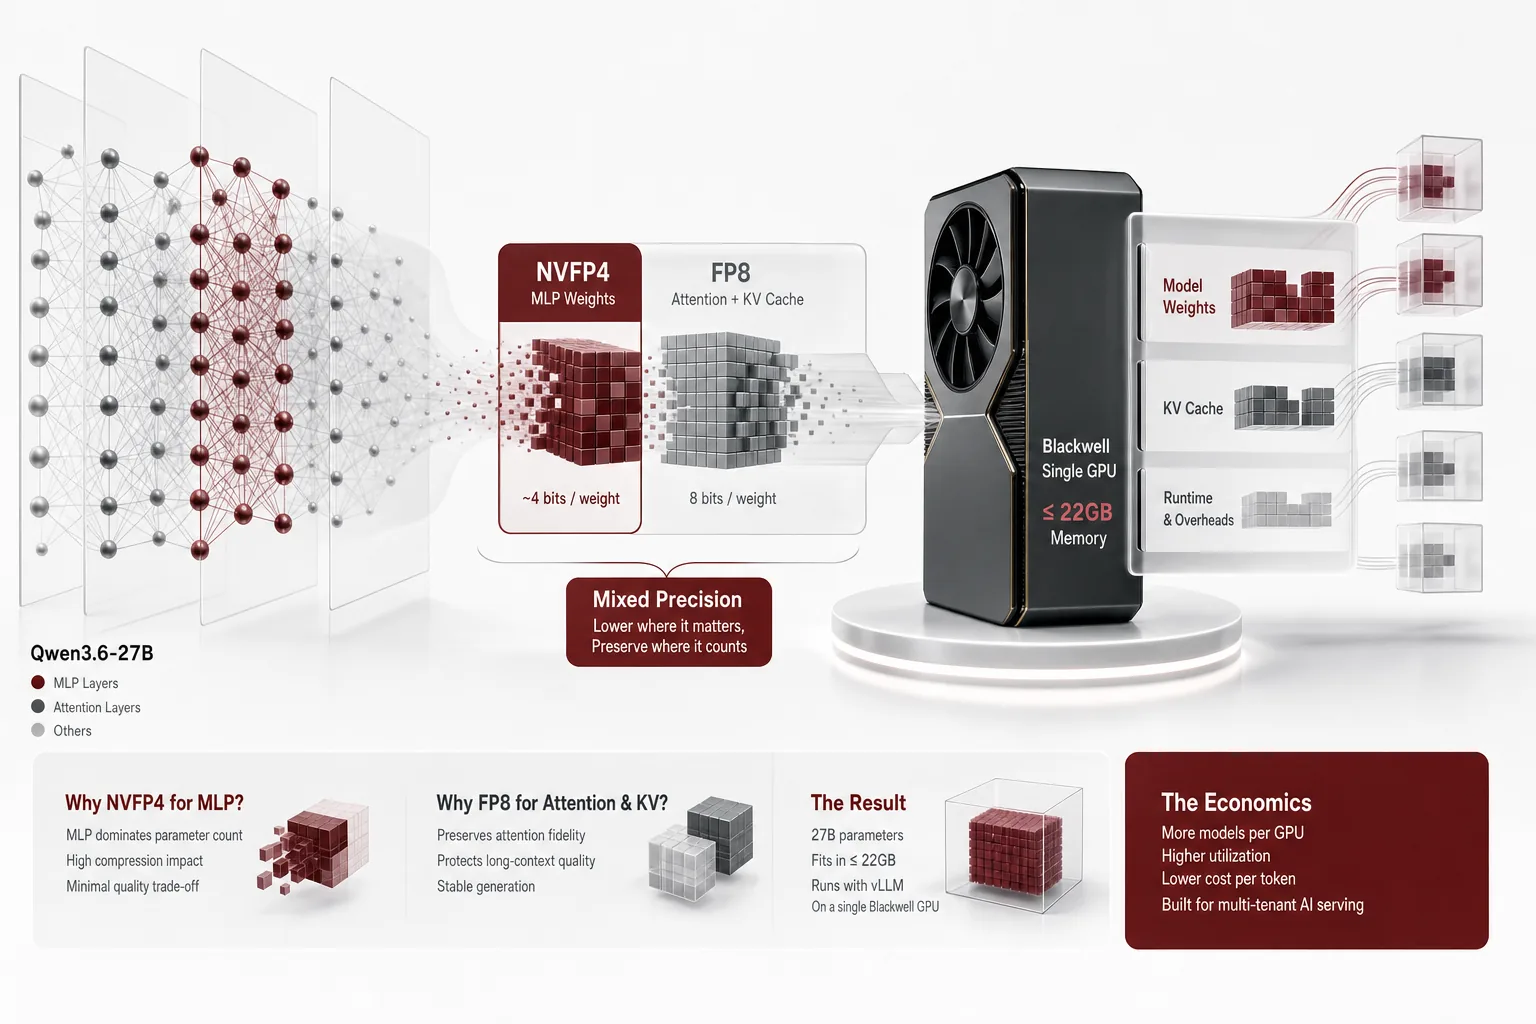
NVIDIA가 Qwen3.6-27B를 NVFP4로 재양자화해 단일 Blackwell GPU에서 vLLM으로 바로 서빙할 수 있게 했습니다.
앤트로픽이 공개한 Claude Fable 5 프롬프트 가이드를 뜯어봅니다.
LLM을 운영하면서도 KV 캐시가 왜 메모리를 잡아먹는지, GQA가 무엇을 절약하는지 설명하지 못한다면 최적화는 감에 의존하게 됩니다.
87% 싸진 건 축하할 일인데, 주인만 바꾼 건 아니고요?
에이전트 자동화의 대부분은 최상위 추론이 아니라 도구 호출과 파이프라인 실행입니다.
NVIDIA가 공개한 Qwen3.6-27B-NVFP4는 27B 하이브리드 어텐션 추론 모델을 4비트로 눌러 메모리를 약 2.5배 줄이면서도 FP8 대비 벤치마크 차이를 1%p 이내로 유지합니다.
짧은 응답 요청이 긴 응답 요청에 밀려 기다리는 HoL 블로킹은 GPU 시간을 낭비하는 조용한 적입니다.
엔지니어링·제품·디자인·데이터가 한 덩어리로 녹아드는 지금, Claude Code를 만든 보리스 체르니가 제안한 다섯 가지 역할 원형과 제품 생애주기별 팀 구성 공식을 살펴봅니다.
엔지니어·PM·디자이너가 프로토타이퍼·빌더·스위퍼·그로워·메인테이너로 녹아든다는데, 아무도 안 하려는 6번째가 있다.
스택이 통째로 남의 손에 넘어간 날, 파시스와 메티스의 대처법.
2026년 6월 29일 삼성전자와 SK하이닉스가 향후 10년간 국내에 합산 4,755조 원을 투자한다고 발표했습니다.
2026년 중반 오픈웨이트 모델은 프런티어와 3~6개월 격차로 좁혀졌고, 그 격차는 더 벌어지지 않고 있습니다.
arXiv에 올라온 ‘The Hitchhiker’s Guide to Agentic AI: From Foundations to Systems’는 LLM 기질부터 정렬·추론, 에이전트 시스템, 그리고 프로덕션 배포까지 에이전트 AI의 전 계층을 한 번에 꿰는 실무 레퍼런스입니다.
OpenRouter에서 미국 모델 토큰 점유율이 1년 만에 약 70%에서 약 30%로 떨어지고 중국 오픈웨이트 모델이 약 46%까지 올라왔습니다.
2026년 하이퍼스케일러 캐펙스가 약 7,250억 달러로 전년 대비 77% 늘었습니다.
NVIDIA가 공개한 GLM-5.2-NVFP4 체크포인트는 469B MoE 모델을 단일 Blackwell 노드(8× RTX PRO 6000)에서 vLLM으로 서빙할 수 있게 합니다.
midudev이 공유해 화제가 된 browser-use의 video-use는 폴더에 원본 영상을 넣고 한 문장을 입력하면 컷 편집, 필러 제거, 자막, 색보정, 애니메이션, 렌더링까지 코딩 에이전트가 자동으로 끝내는 무료 오픈소스 스킬입니다.
Anthropic이 2026년 6월 26일 공개한 Economic Index ‘Cadences’ 보고서는 7일 샘플을 버리고 시간 단위 연속 텔레메트리로 전환했습니다.
Z.ai의 1M 컨텍스트 오픈웨이트 모델 GLM-5.2의 후처리 학습을 떠받친 비동기 강화학습 인프라 slime이 완전 오픈소스로 공개되었습니다.
코인베이스 CEO 브라이언 암스트롱이 공개한 AI 비용 통제법은 사용량 제한이나 경고 알림이 아니라 더 나은 기본값, 라우팅, 캐싱이었습니다.
CLAUDE.md, rules, skills, agents, hooks, MCP까지.
arXiv 2606.24775 ‘Are We Ready For An Agent-Native Memory System?’은 LLM 에이전트 메모리를 RAG가 아니라 하나의 데이터 관리 시스템으로 보고, 12개 메모리 시스템을 4개 모듈로 분해해 측정합니다.
DeepReinforce가 2026년 6월 25일 공개한 Ornith-1.0은 모델이 자신의 강화학습 훈련 스캐폴드를 직접 작성하는 자가-스캐폴딩(self-scaffolding) 메커니즘으로 만든 오픈소스 코딩 모델 패밀리입니다.
NVIDIA가 ZAI의 753B MoE 추론 모델 GLM-5.2를 NVFP4(4비트)로 양자화해 Hugging Face에 공개했습니다.
교수의 논문 작성 노하우를 Codex, Claude Code, Gemini 어디서나 불러 쓰는 Skill 패키지로 묶은 오픈소스 프로젝트가 화제입니다.
Nous Research가 Hermes Agent에 추가한 /learn은 디렉터리, URL, 방금 끝낸 대화, 붙여넣은 메모 어느 것이든 가리켜 재사용 가능한 스킬로 만들어 줍니다.
Baidu가 공개한 Unlimited OCR은 디코더의 어텐션을 Reference Sliding Window Attention으로 바꿔 KV 캐시를 상수로 유지합니다.
Alibaba Qwen이 공개한 Qwen-AgentWorld는 행동을 학습하는 대신 환경 자체를 예측하도록 학습한 언어 월드 모델입니다.
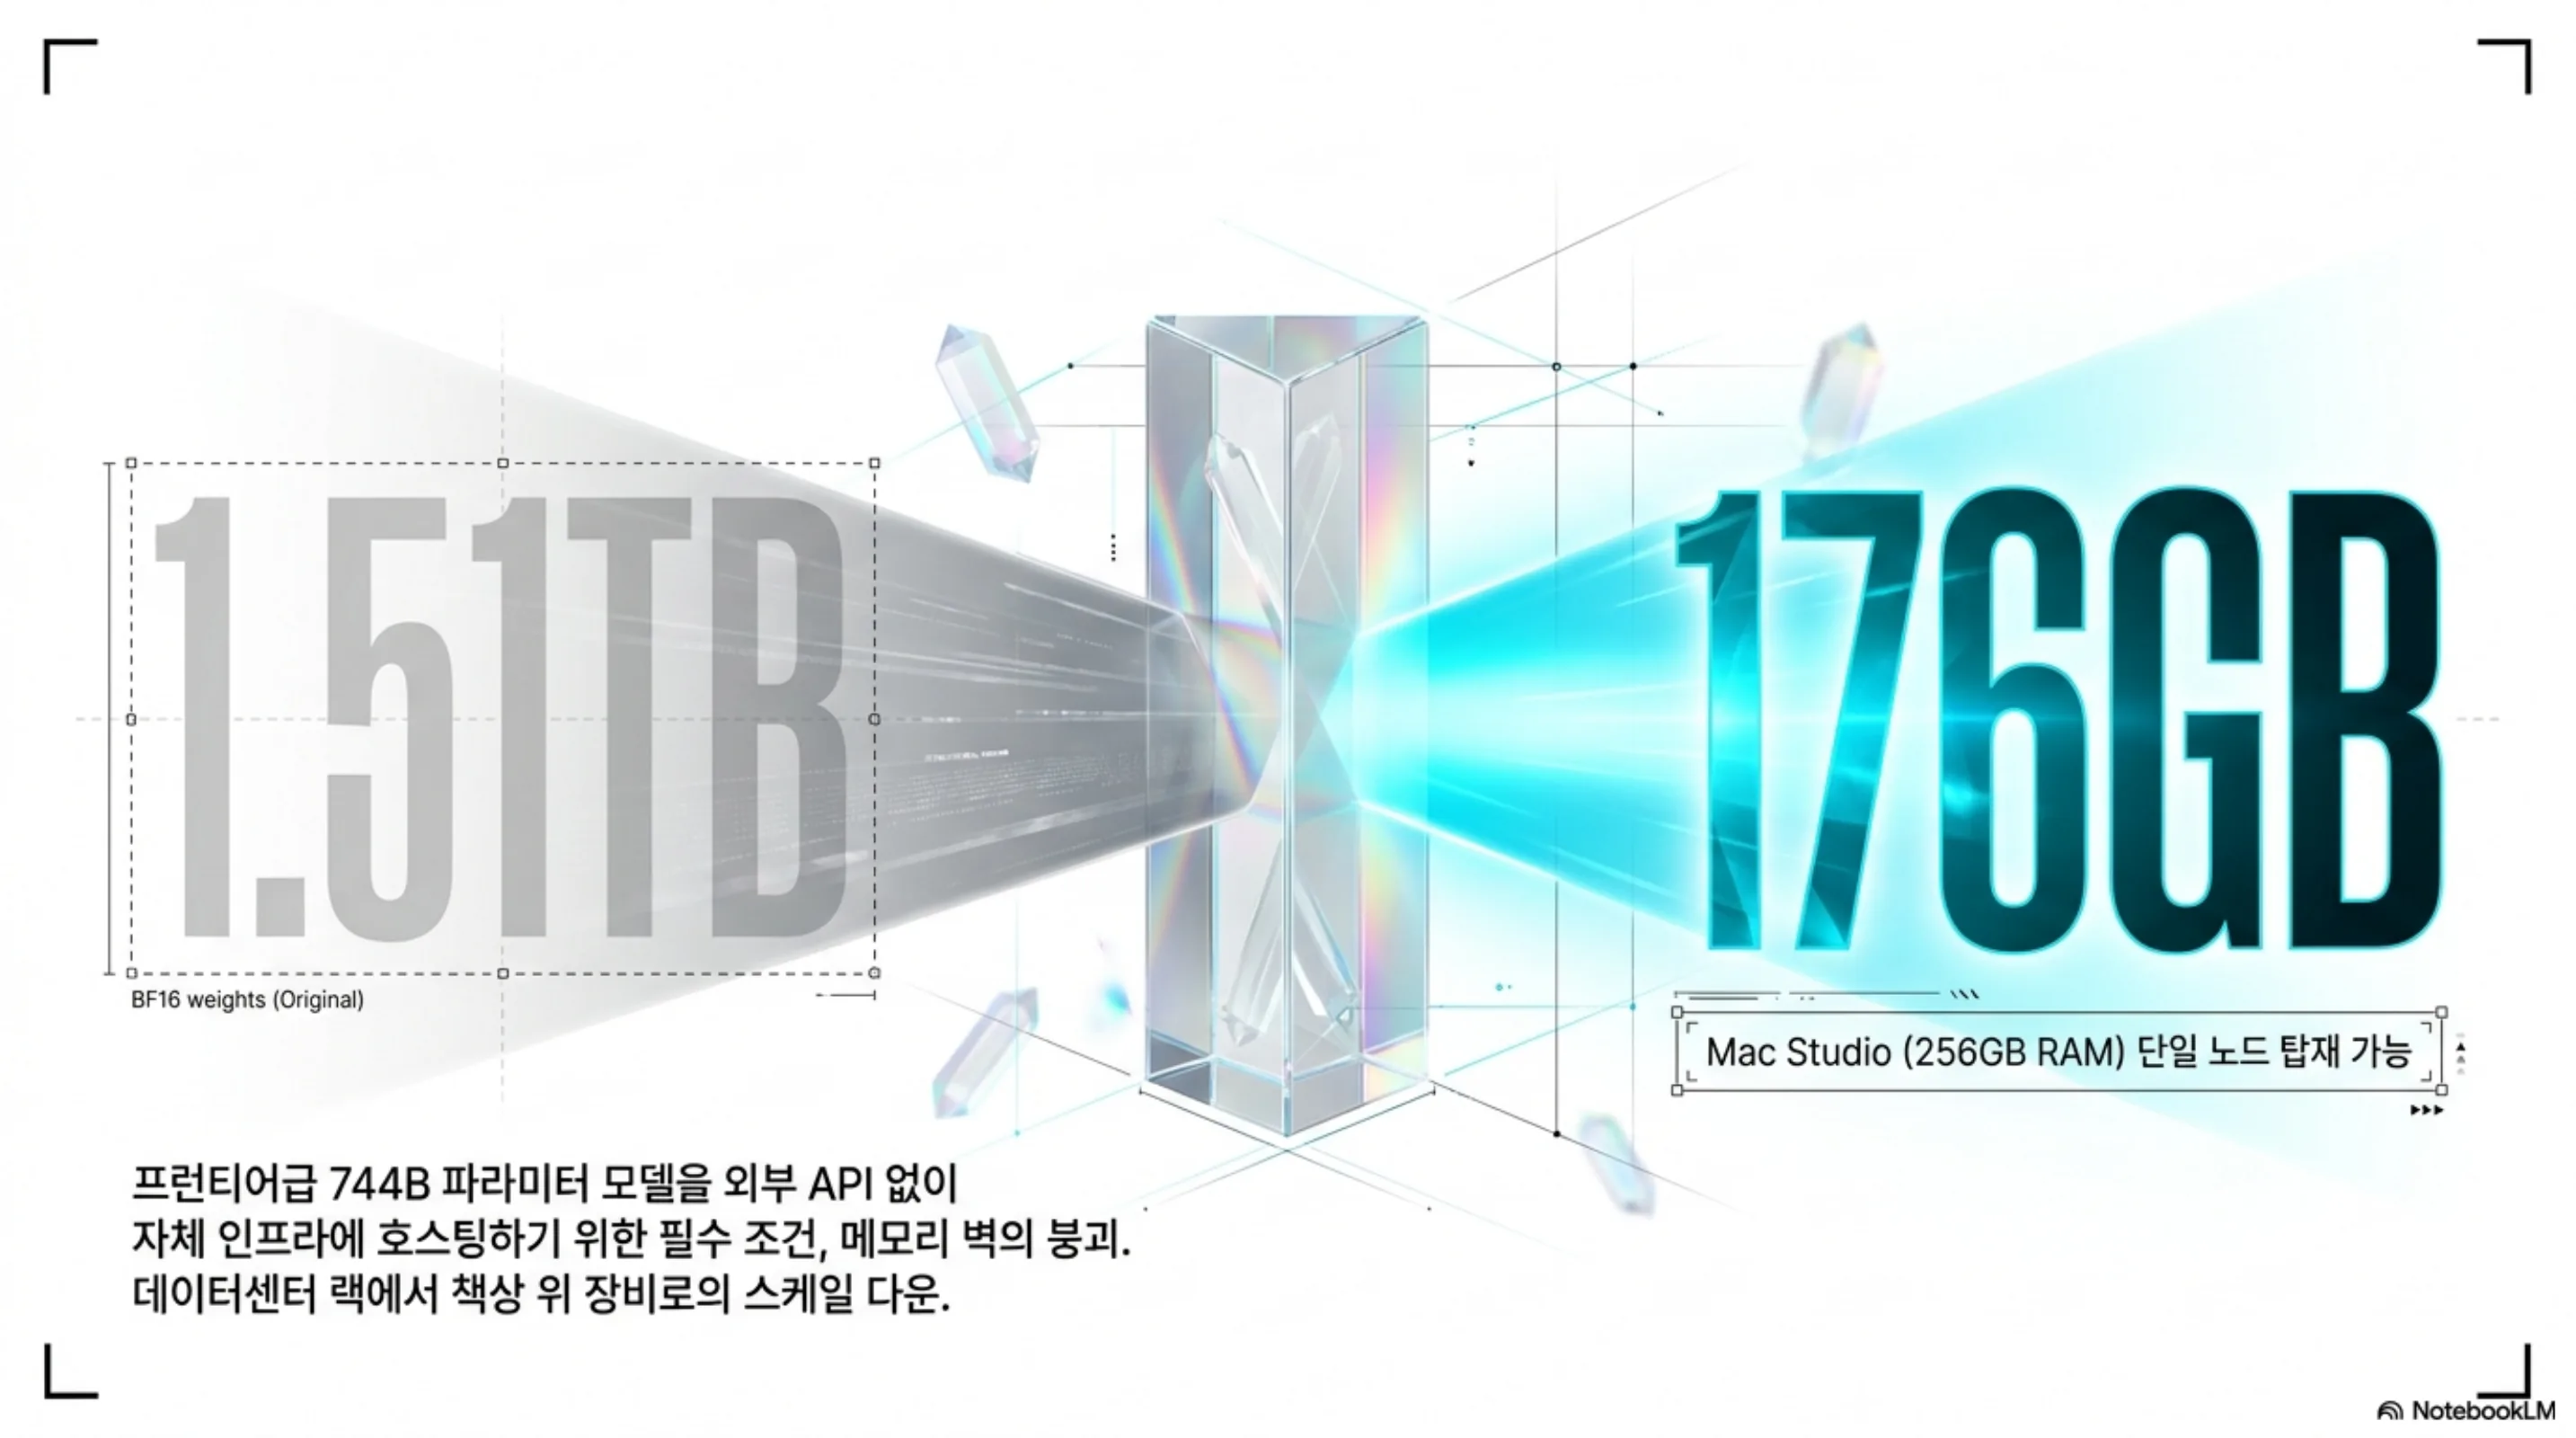
Unsloth가 GLM-5.2(약 744B MoE)의 1.51TB BF16 가중치를 1비트 Dynamic GGUF로 줄여 176GB까지 압축했습니다.
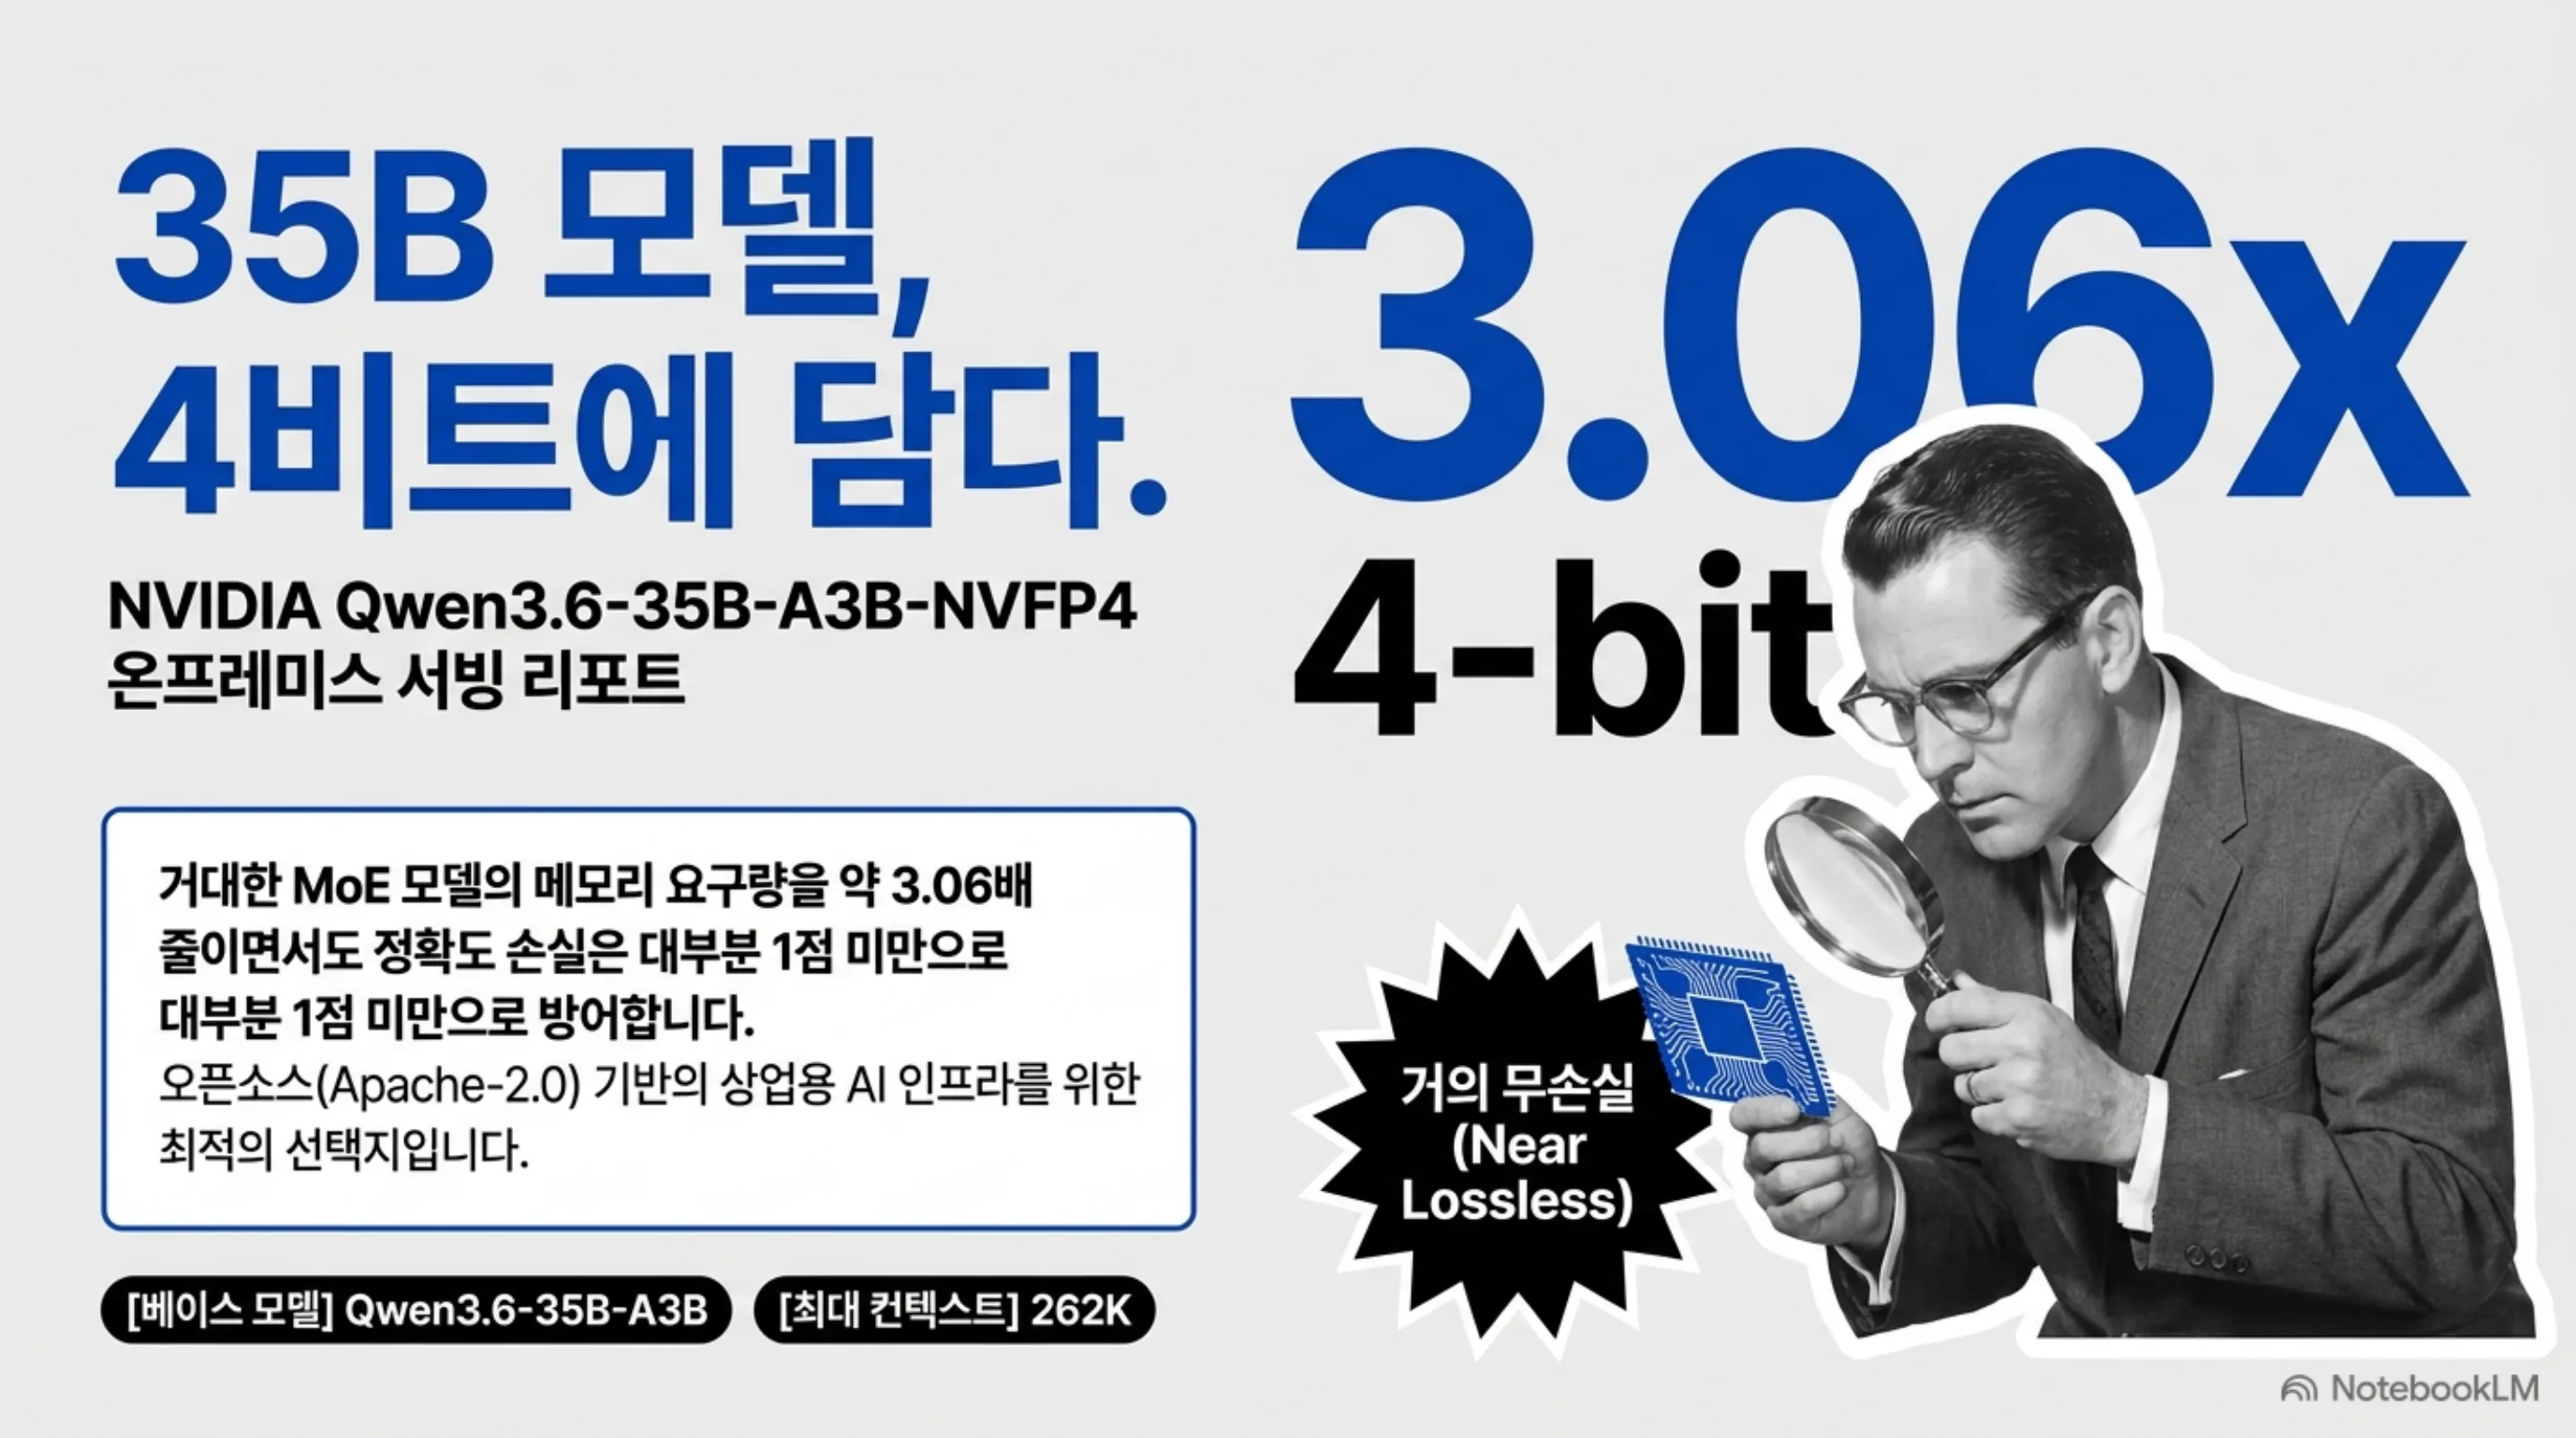
NVIDIA가 Alibaba의 Qwen3.6-35B-A3B를 NVFP4(4비트)로 양자화해 공개했습니다.
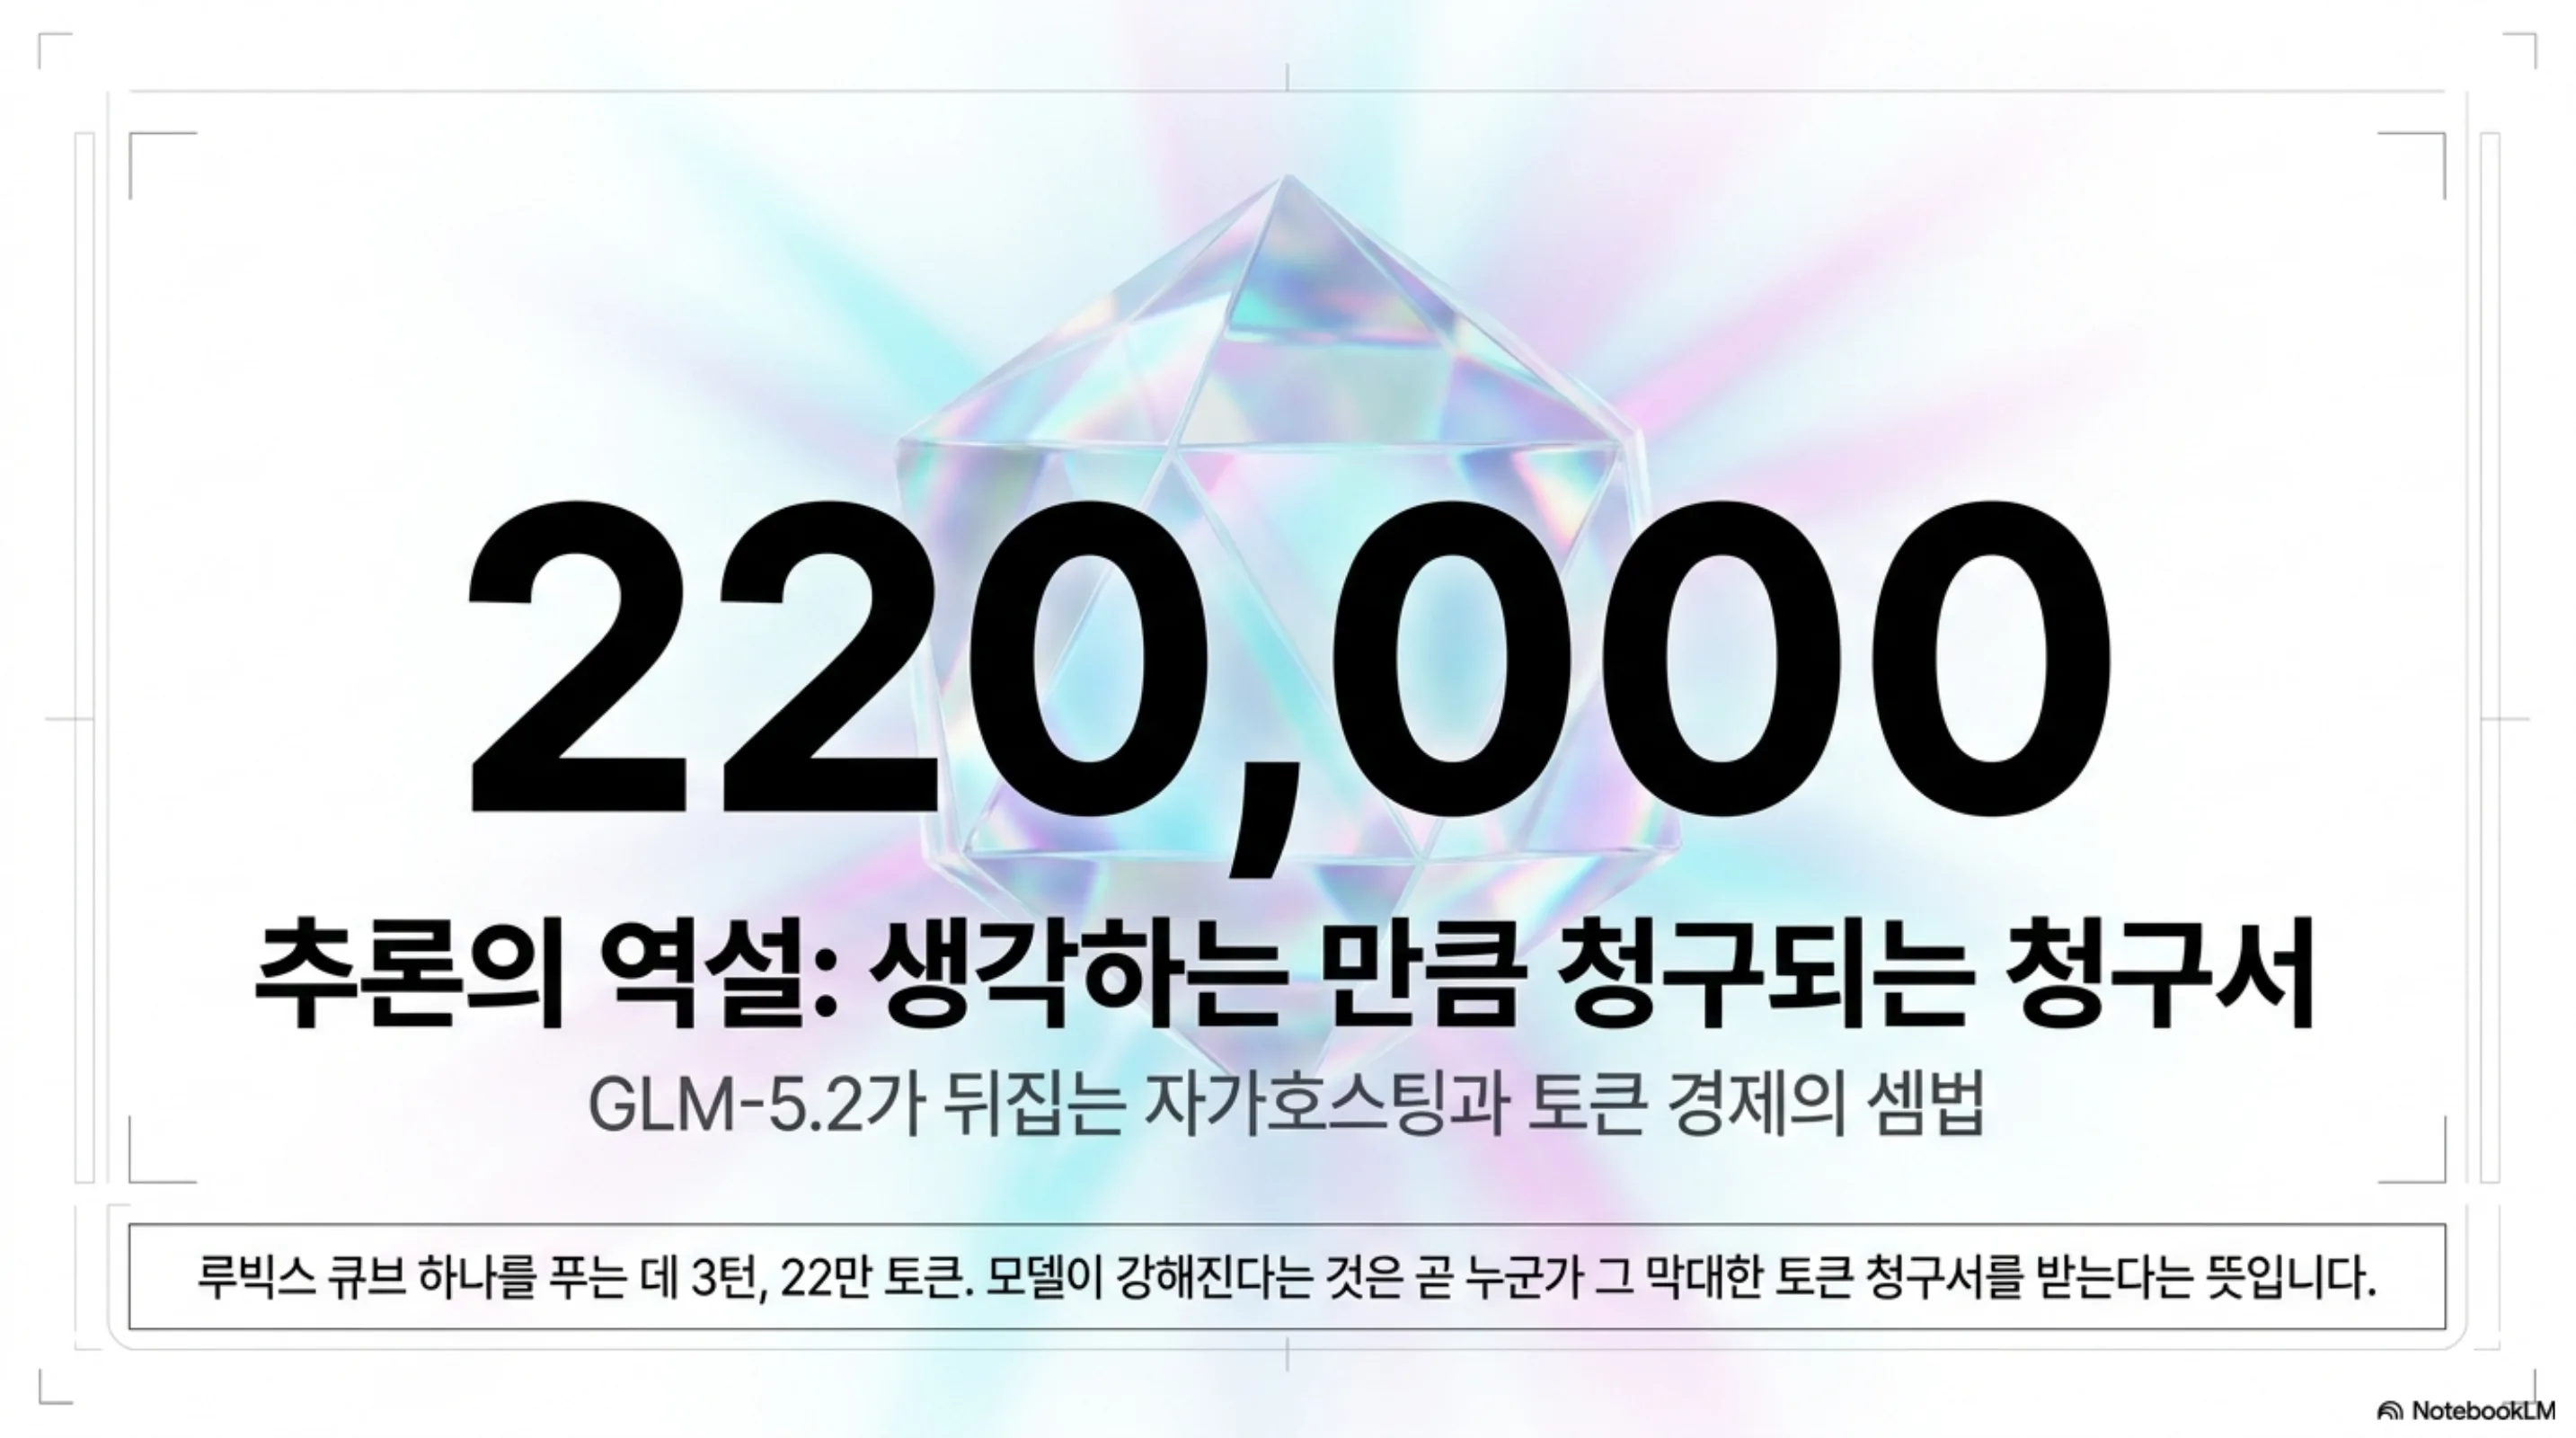
Matt Pocock이 /teach 스킬로 GLM-5.2에 루빅스 큐브를 풀게 했을 때, 가장 낮은 effort에서도 3턴에 약 22만 토큰의 사고 트레이스가 나왔습니다.
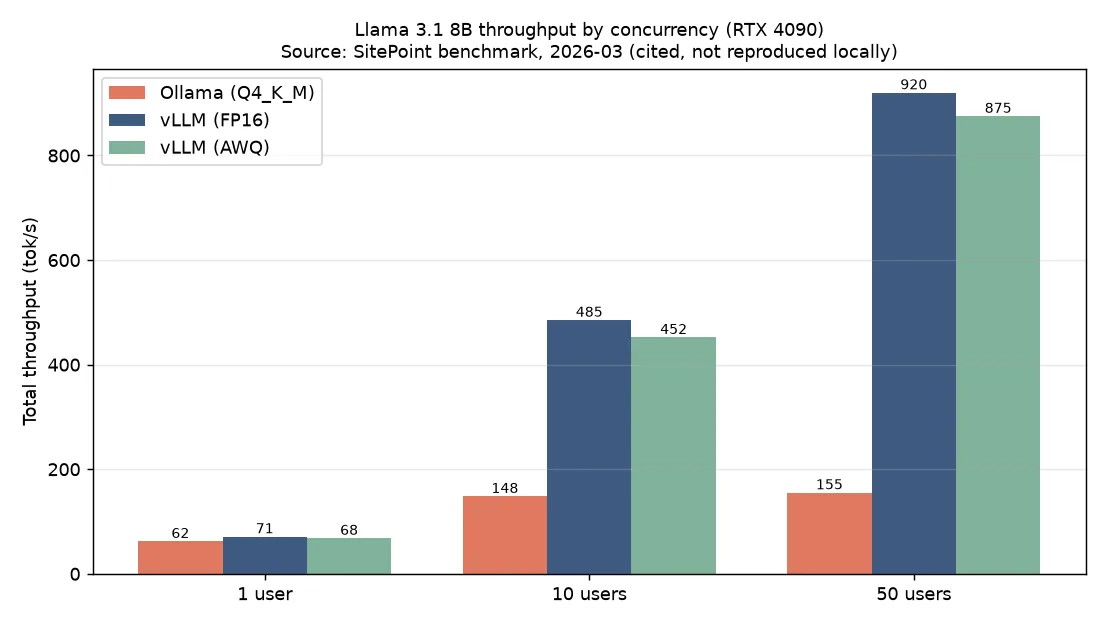
Ollama는 쉽고 vLLM은 빠르다는 통념을 2026년 RTX 4090 공개 벤치마크로 다시 검증합니다.
AI 에이전트 입문 가이드는 대부분 LLM 두뇌, 메모리, 도구, 에이전트 루프 네 조각을 설명하고 끝납니다.
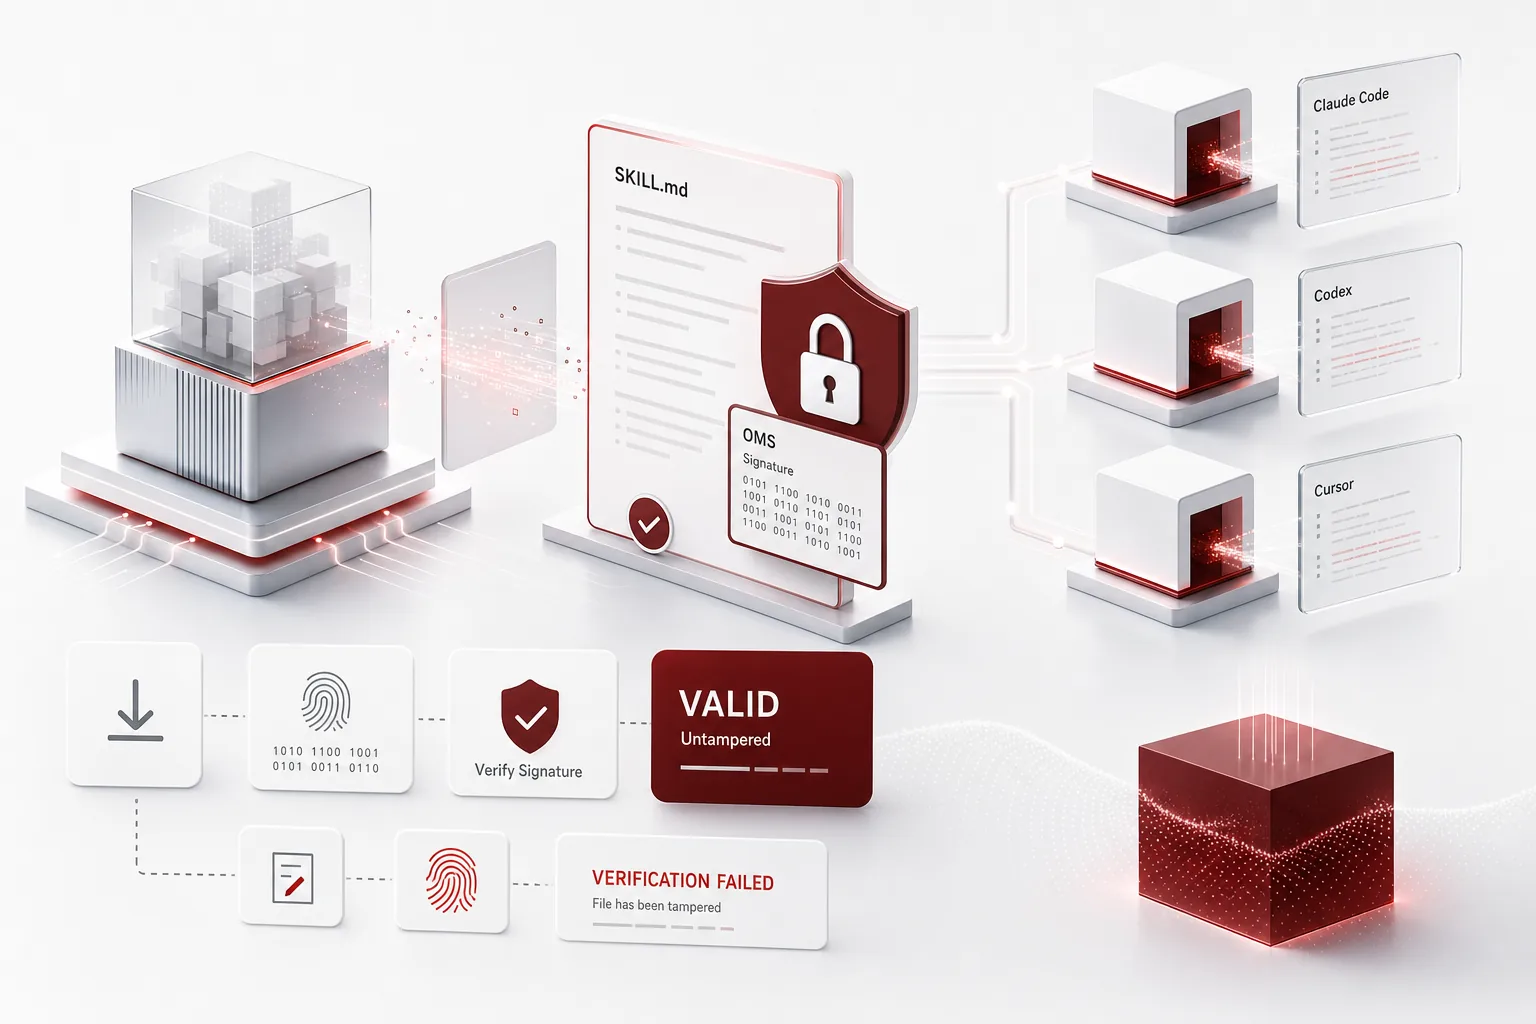
NVIDIA가 에이전트 스킬 200여 개를 OMS 암호 서명과 함께 오픈소스로 공개했습니다.
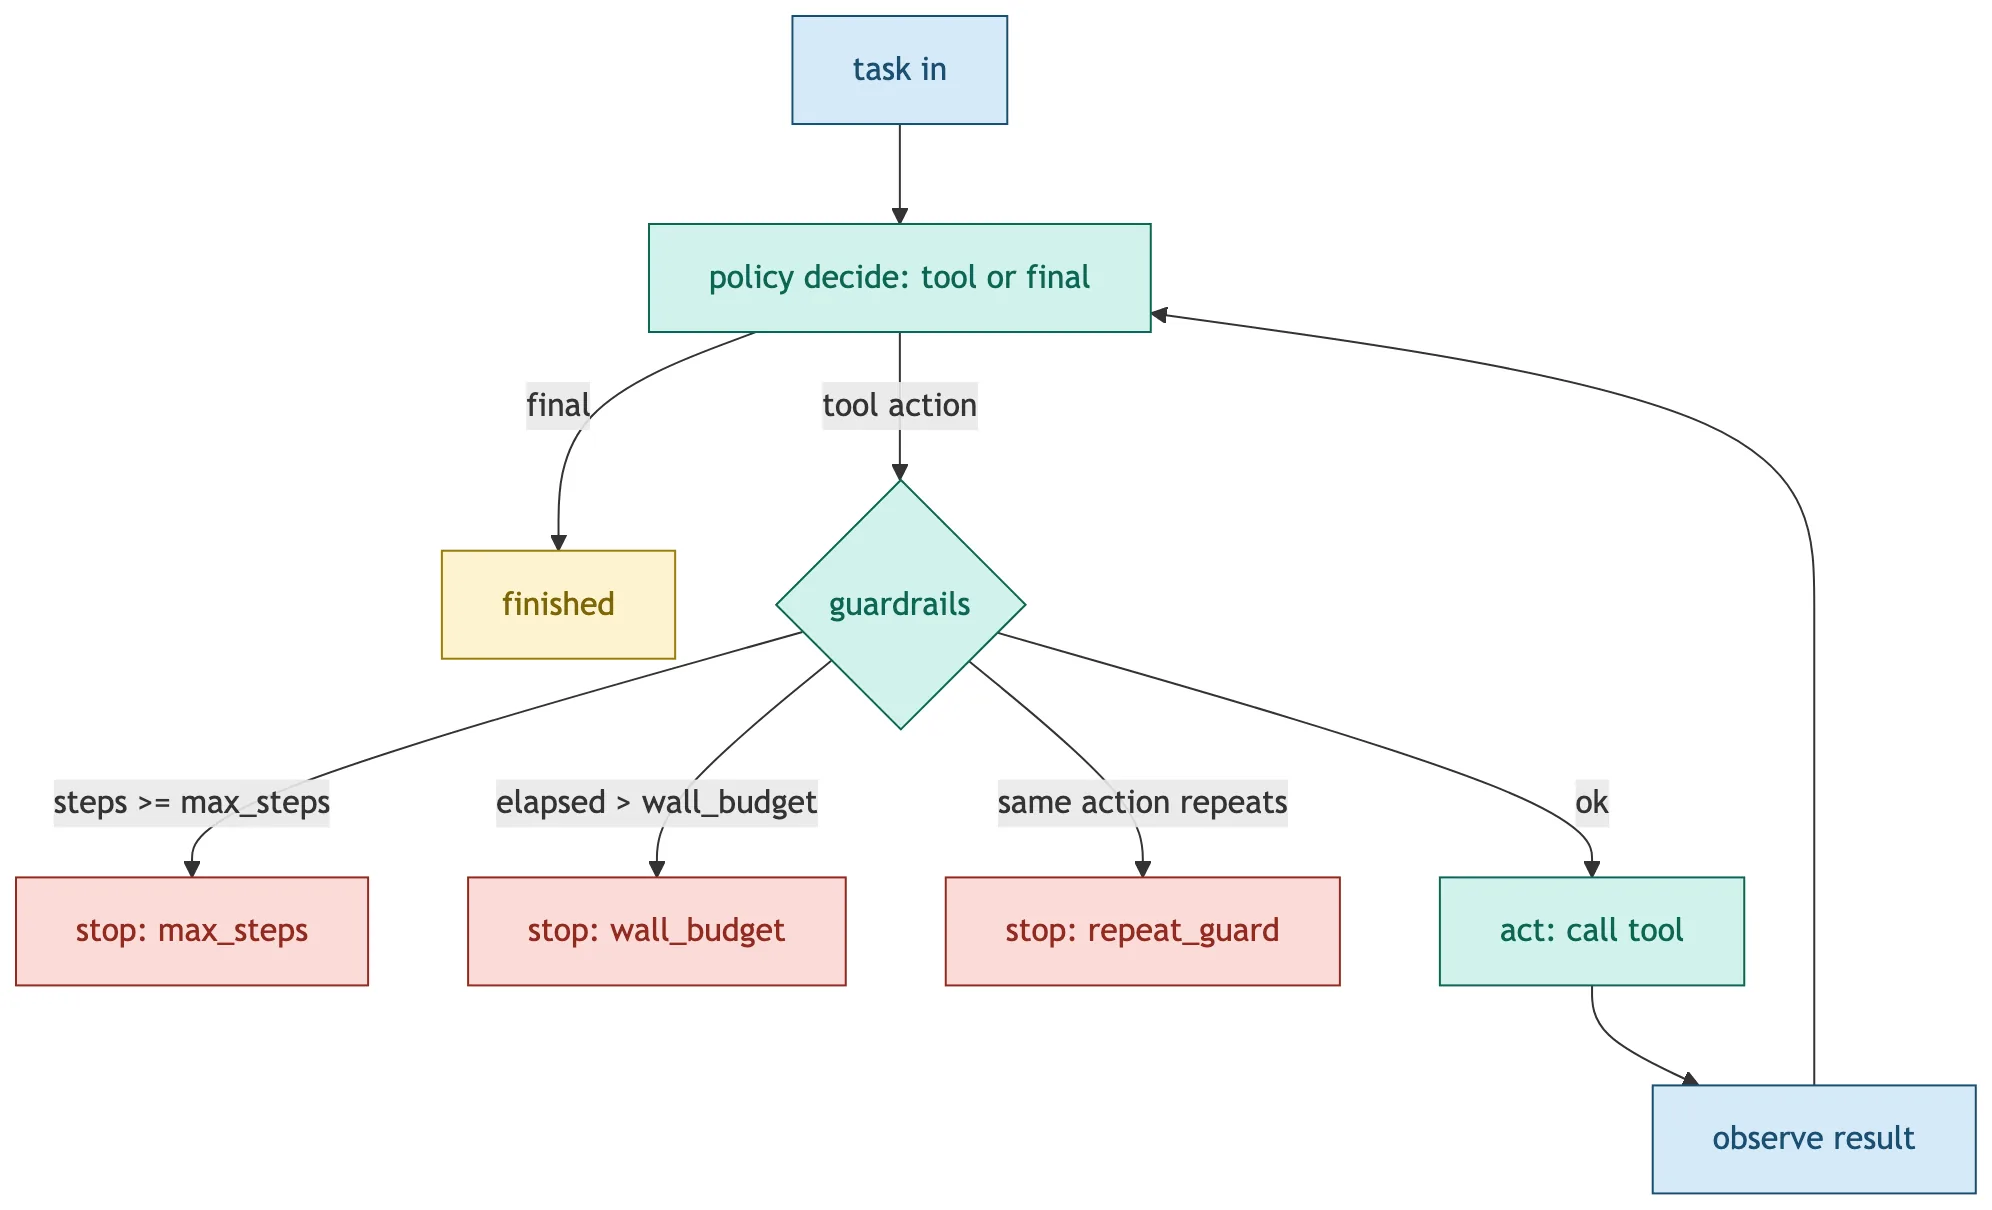
프롬프트를 잘 쓰는 시대에서 루프를 잘 설계하는 시대로 넘어가고 있습니다.
Anthropic이 슬랙 채널 안에서 @Claude를 호출해 일을 맡기는 Claude Tag을 공개했습니다.
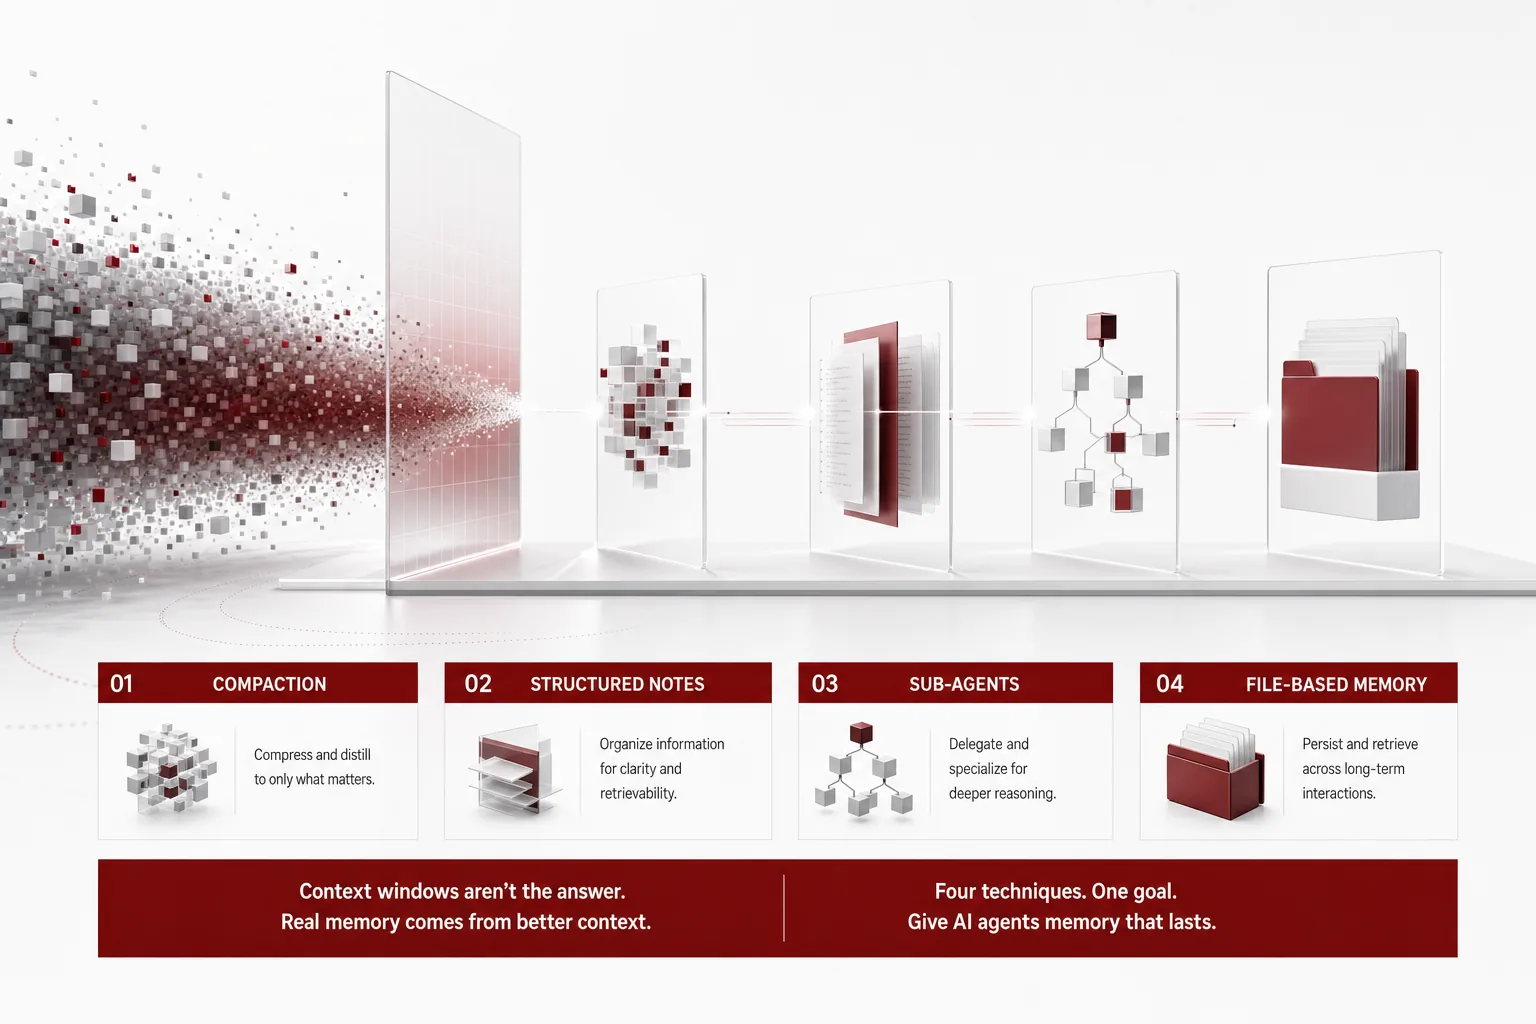
컨텍스트 창은 크다고 좋은 것이 아닙니다.
Google DeepMind가 2026년 4월 공개한 Gemma 4는 E2B부터 31B까지 5종으로 구성된 멀티모달 오픈웨이트 패밀리입니다.
NVIDIA가 공개한 Gemma-4-26B-A4B-NVFP4를 DGX Spark 한 대에서 16배 병렬로 돌리면 스트림당 약 18토큰/초, 합산 약 300토큰/초가 나옵니다.
Anthropic이 기존 Slack 앱을 대체하는 Claude Tag를 공개했습니다.
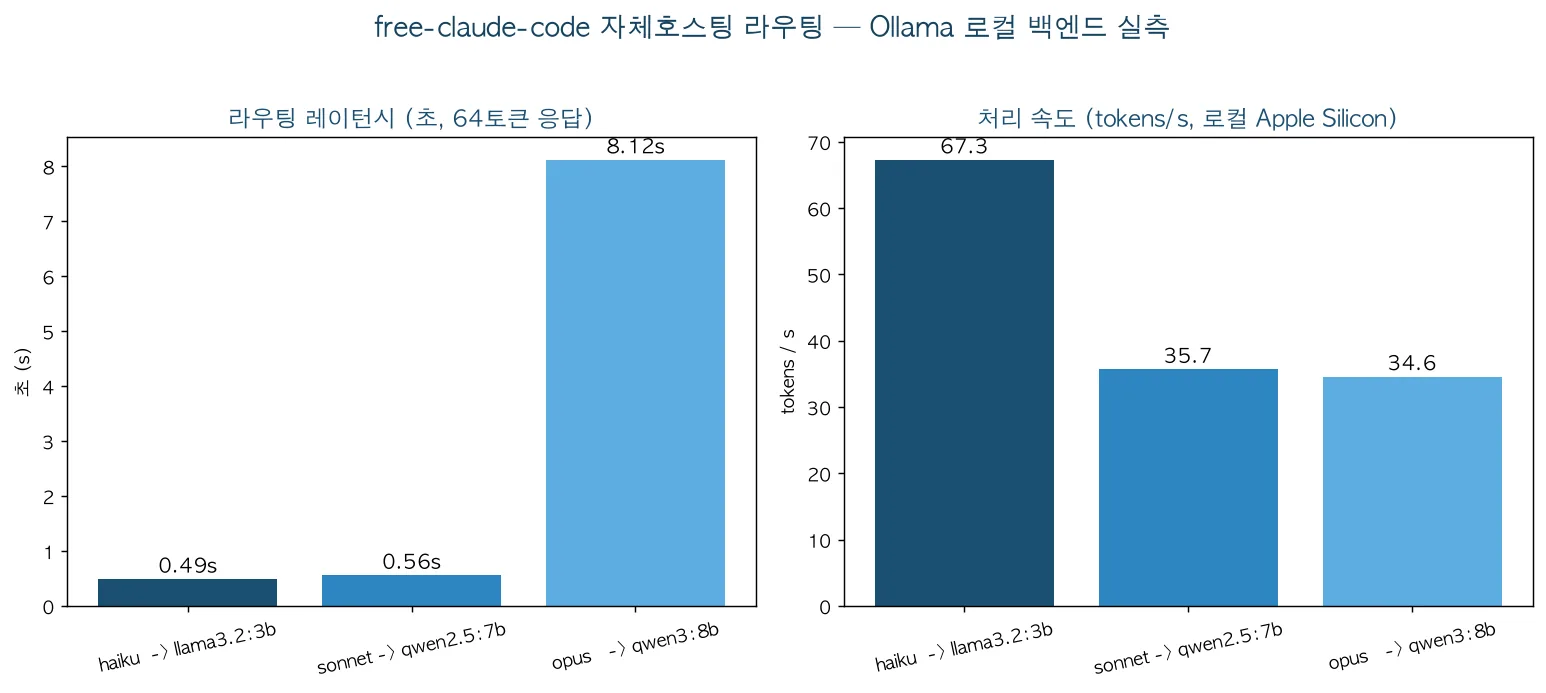
36.7k 스타의 free-claude-code는 Claude Code 트래픽을 Anthropic 호환 FastAPI 프록시로 받아 17개 프로바이더로 분기합니다.
DFlash는 토큰을 하나씩 그리던 EAGLE-3 드래프터를 블록 확산 드래프터로 바꿔, 미래 토큰 블록을 한 번의 전방 패스로 제안합니다.
claude-code-router로 Claude Code 트래픽을 glm-5.2·MiniMax-M2.7·Kimi K2로 분기합니다.
docker-android는 Android 에뮬레이터를 단일 컨테이너로 패키징해 헤드리스로 띄우는 오픈소스 프로젝트입니다.
Claude Code 안에서 슬래시 명령 한두 개로 1080p 영상을 렌더링하는 오픈소스 toolkit입니다.
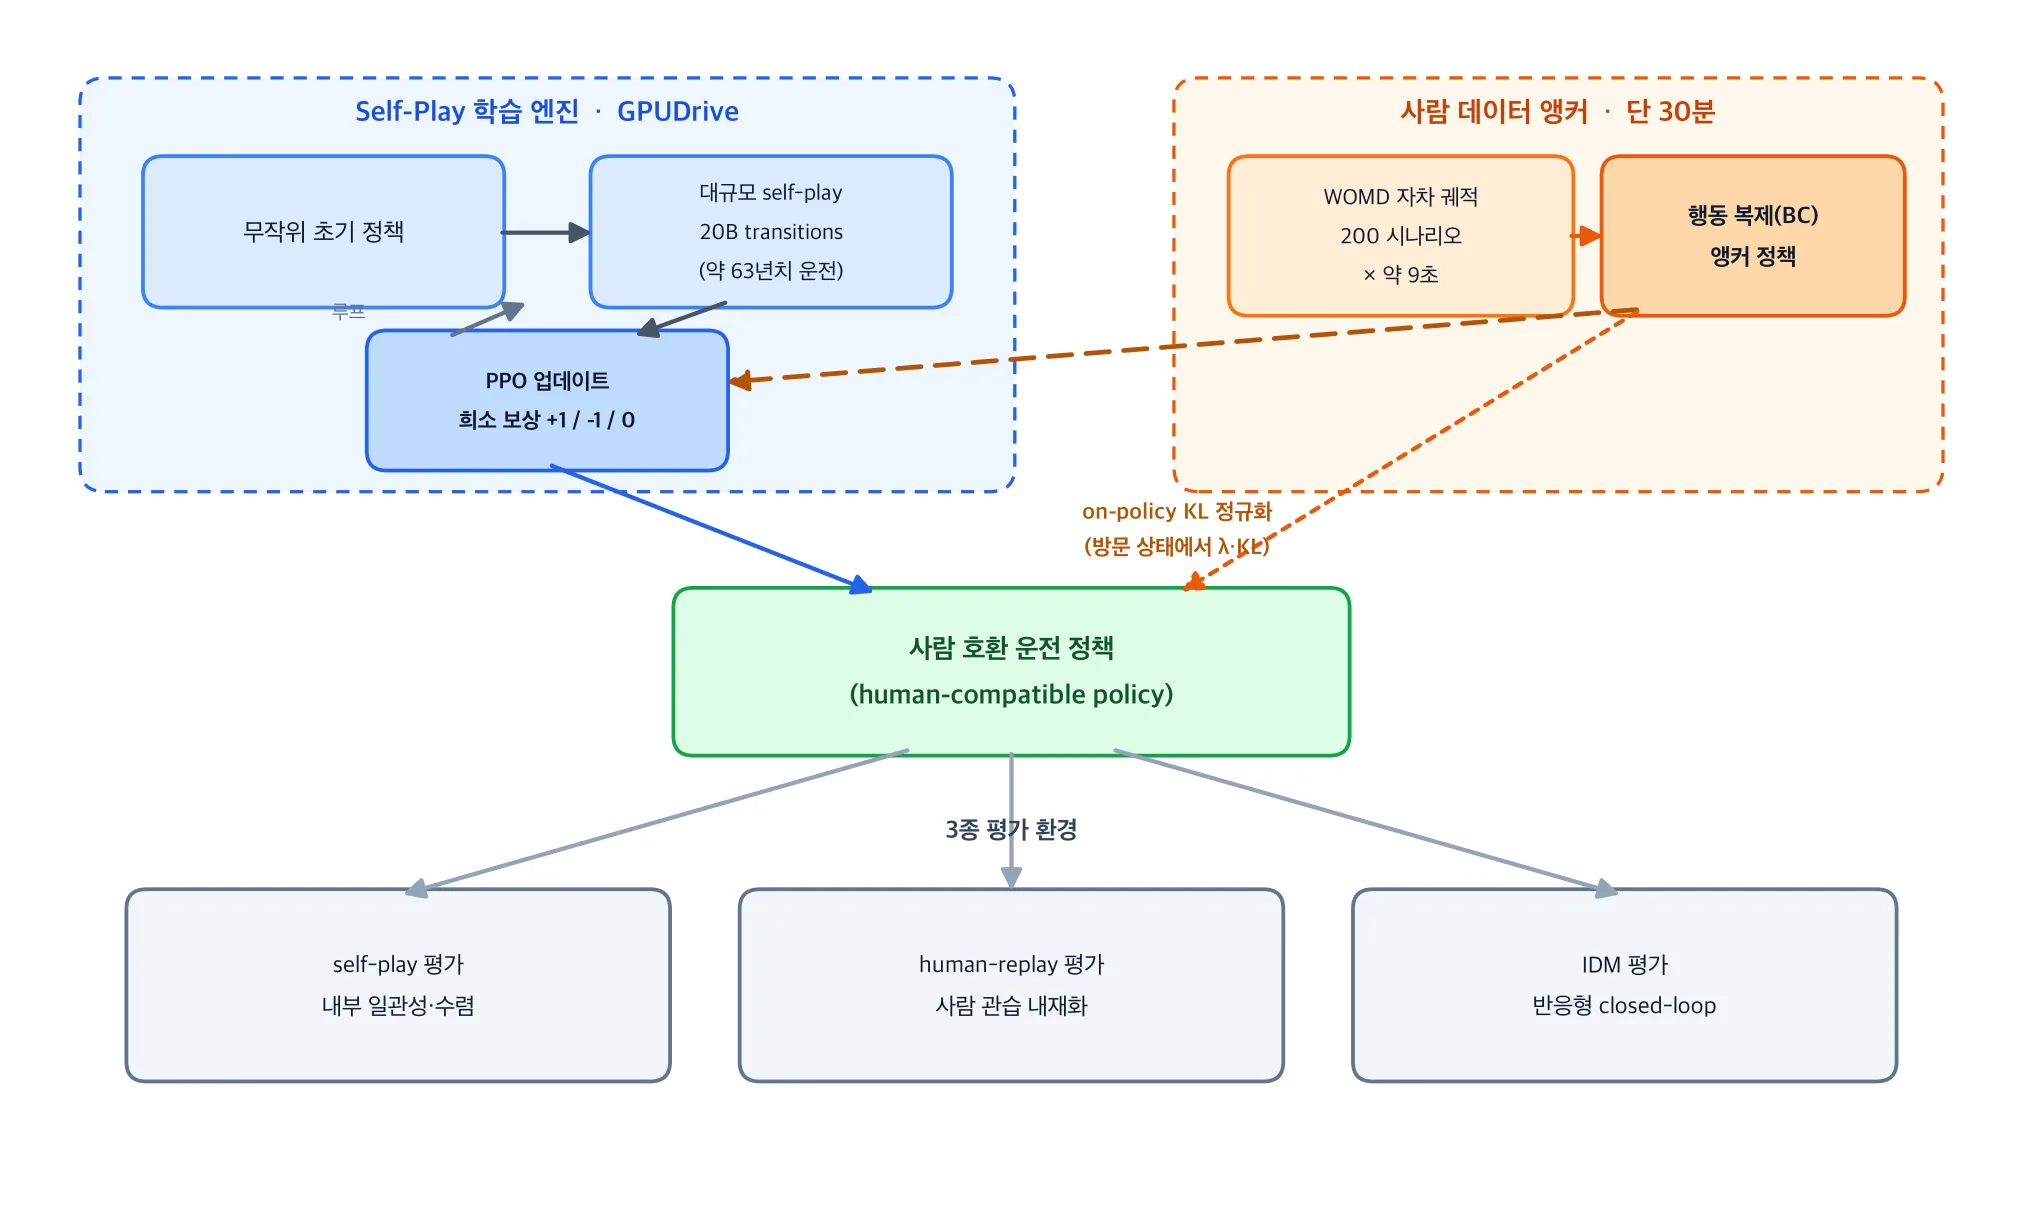
순수 self-play는 빠르지만 사람과 호환되지 않는 운전 관습으로 수렴합니다.
PaddlePaddle이 공개한 0.9B 초소형 비전-언어 모델 PaddleOCR-VL을 직접 설치해 한국어·영어·아랍어가 섞인 문서로 추론을 돌려봤습니다.
Micron이 Anthropic에 HBM·DRAM·SSD를 공급하고 AI 워크로드용 메모리 아키텍처를 공동 설계하며 시리즈 H에 투자했습니다.
vLLM이냐 SGLang이냐 TensorRT-LLM이냐를 먼저 고민하는 것은 순서가 틀렸습니다.
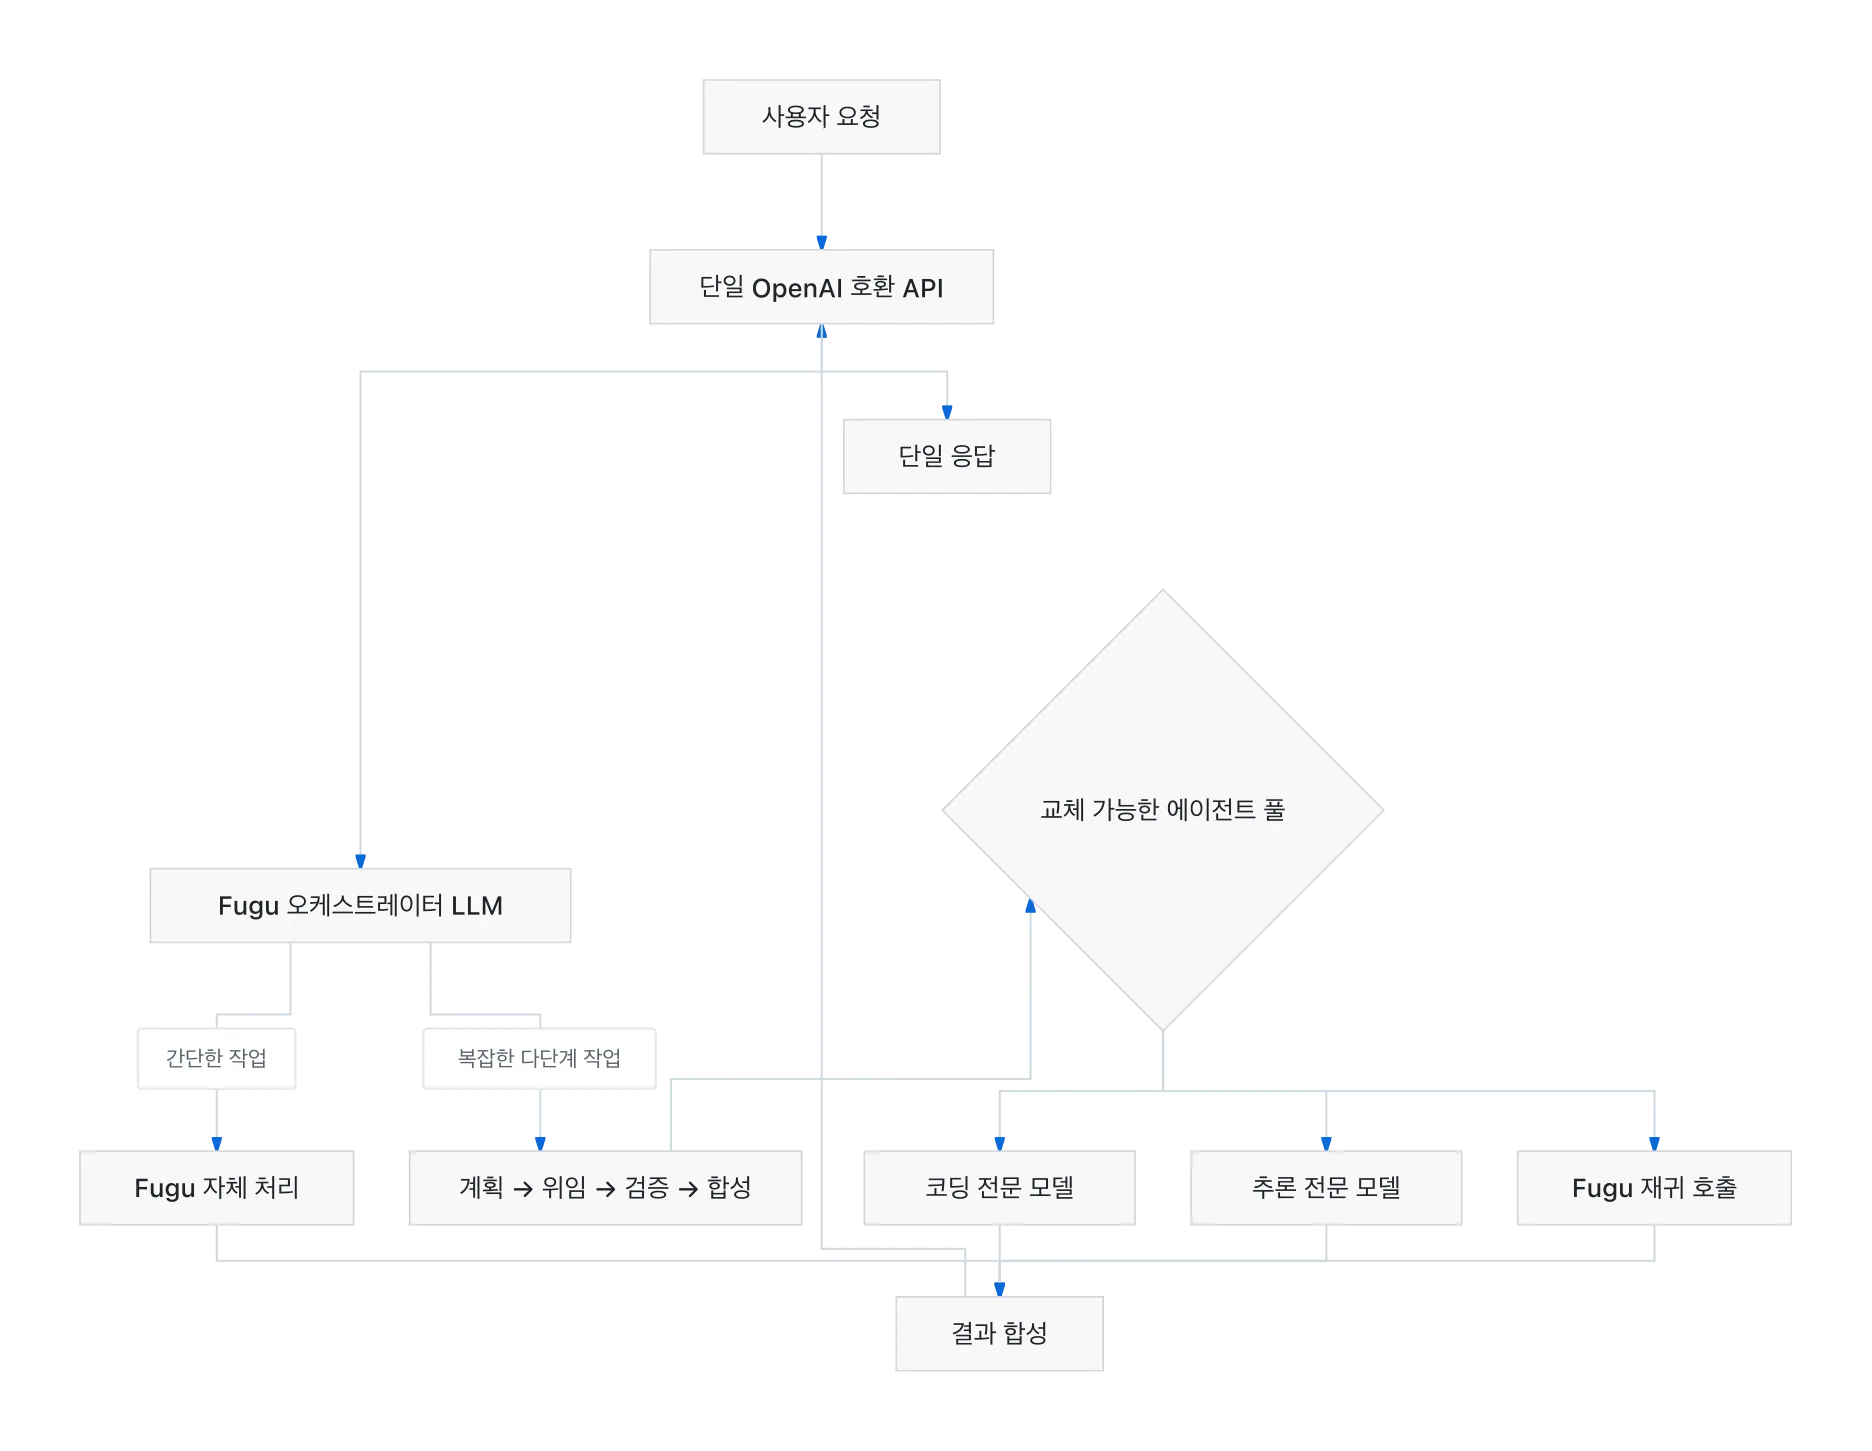
Sakana AI가 공개한 Fugu는 여러 LLM을 동적으로 조율하면서도 단일 모델처럼 동작하는 오케스트레이션 시스템입니다.
Nous Research의 Hermes Agent 공식 문서 169페이지와 커뮤니티가 만든 실전 워크플로 28개를 한곳에 색인해 ⌘K 한 번으로 검색하는 비공식 커뮤니티 사이트입니다.
Claude Code를 만든 사람이 ‘Fable 5가 내 코드의 100%를 쓰고 있고 Opus보다 최소 3배 강력하다’고 말했다는 인용이 돌았습니다.
문헌 조사부터 투고 가능한 원고까지, 10단계 파이프라인을 자동으로 잇는 Claude Code 스킬팩을 ThakiCloud 에이전트 환경에 실제로 통합해 봤습니다.
웹 디자이너 빅터 오디가 공개한 16분 튜토리얼은 Gemini 3.1로 사이트 구조를 짜고 Seedance 2.0으로 시네마틱 영상을 입혀, 과거 1만 달러를 받던 마케팅 사이트를 한 사람이 만드는 과정을 보여줍니다.
Anthropic이 Fable 5를 6월 22일까지만 구독 플랜에 무료로 포함하고, 23일부터는 종량제 크레딧으로 돌립니다.
사람이 자는 동안 시스템이 어제의 실패에서 배우고 스스로 개선됩니다.
r/LocalLLaMA GPU 모더레이터 Ahmad Osman이 무료 공개한 로컬 LLM 추론 종합 가이드를 정리합니다.
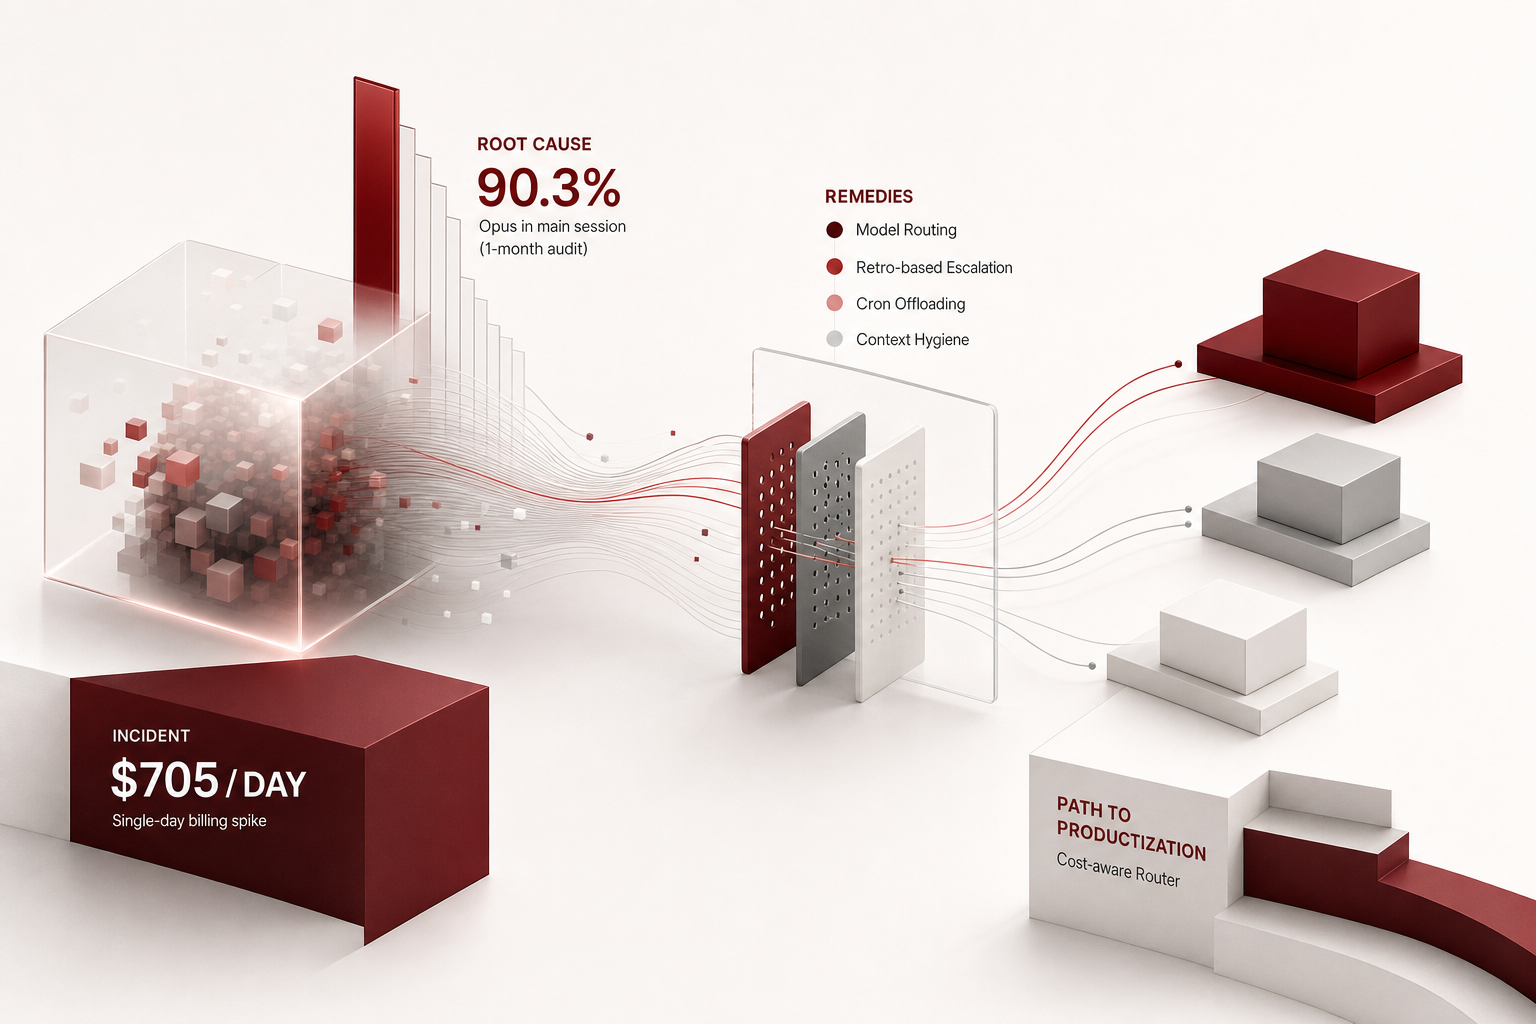
하루 $705 청구서 사고를 솔직하게 공개하고, 1개월 감사에서 발견한 원인(Opus 메인 세션 90.3%)과 처방(모델 라우팅, 회고 기반 에스컬레이션, cron화, 컨텍스트 위생)을 수치로 증명합니다.
의료 기관이 환자 데이터를 외부 클라우드로 반출하지 않고 사내 GPU 클러스터에서 도메인 특화 LLM을 파인튜닝하고 서빙하는 전체 워크플로를 설명합니다.
중국 Z.ai(Zhipu)가 MIT 라이선스로 공개한 744B MoE 코딩 모델 GLM-5.2를 정리합니다.
Z.ai는 GLM-5.2를 만들면서 RL 사후학습 인프라 전체를 오픈소스로 공개했습니다.
외부 클라우드를 쓸 수 없는 공공·정부 기관이 사내 GPU 인프라에서 LLM을 안전하게 서비스하는 방법을 설명합니다.
스킬 1,620개, 서브에이전트 55개, 야간 자가진화, 비용 가드레일까지.
스킬은 많을수록 좋은 게 아니라 세금입니다.
‘40가지 워크플로로 자는 동안 돈을 번다’는 바이럴 X 아티클이 타임라인을 흔들었습니다.
1,000 GPU 클러스터에서 연간 최대 수천만 달러를 낭비하는 세 가지 병목 지점을 K8s 네이티브 스케줄링으로 회수하는 방법을 설명합니다.
Z.ai가 MIT 라이선스로 공개한 744B MoE 코딩 모델 GLM-5.2가 SWE-bench Pro와 Terminal-Bench에서 GPT-5.5를 앞섰고, 비용은 약 1/6이라는 보도가 나왔습니다.
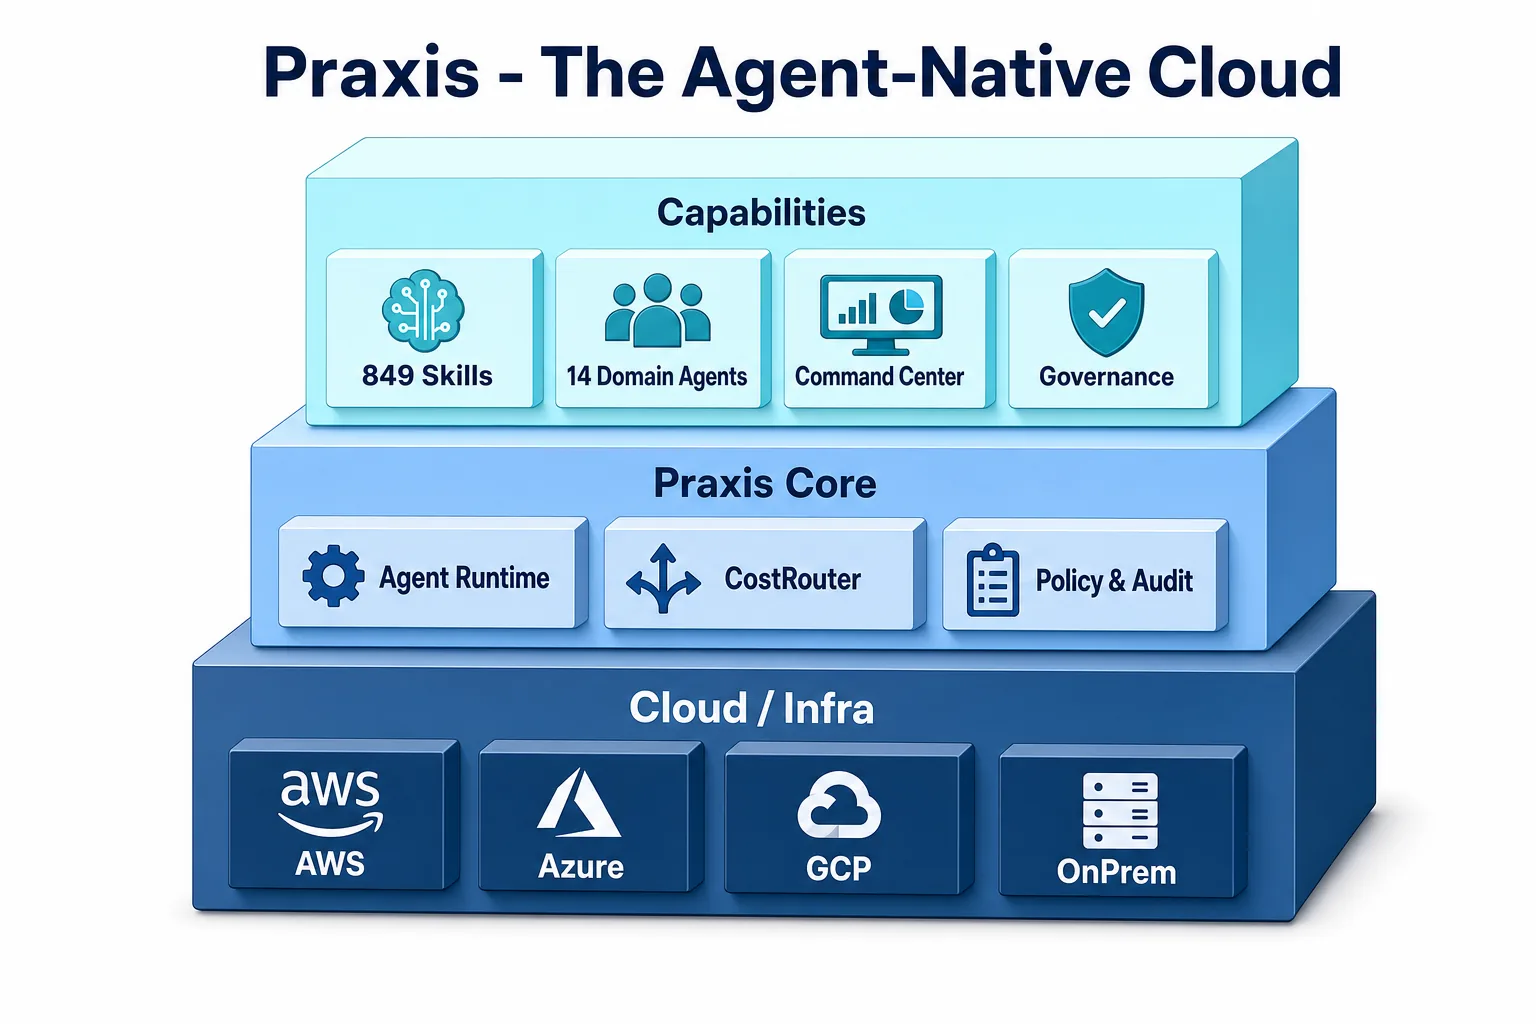
VM 중심 클라우드가 자율 AI 에이전트 운영에 부적합한 이유, 그리고 Skills·Tools·Policies·Audit Logs를 일급 리소스로 다루는 에이전트 네이티브 인프라 설계 원칙을 살펴봅니다.
AGI·인프라·노동이라는 세 렌즈로 AI의 미래를 달리 보는 허사비스, 황, 아모데이의 세계관을 비교하고, 불확실성이 겹치는 지금 빌더 조직이 각자에게서 무엇을 취해야 하는지 종합한다.
NVIDIA CEO 젠슨 황의 ‘엔지니어 1인당 수백 개 에이전트’ 비전이 현실화될 때 조직 구조와 일하는 방식은 어떻게 바뀌어야 하는가.
DeepMind CEO 허사비스의 ‘AGI와 거리가 멀다’ 발언을 출발점으로, AI 조직이 과대광고 대신 정직한 기대치 설정을 문화로 삼아야 하는 이유를 살핀다.
젠슨 황의 ‘시장이 붙인 별명’을 출발점으로, Moneyball 계승 심화, 데이터가 직관을 이기는 의사결정 문화를 어떻게 조직에 뿌리내릴 것인가
코드의 한계비용이 0에 수렴할 때, 엔지니어링 팀의 가치는 ‘무엇을 만드는가’에서 ‘무엇을 만들어야 하는가를 아는가’로 옮겨간다.
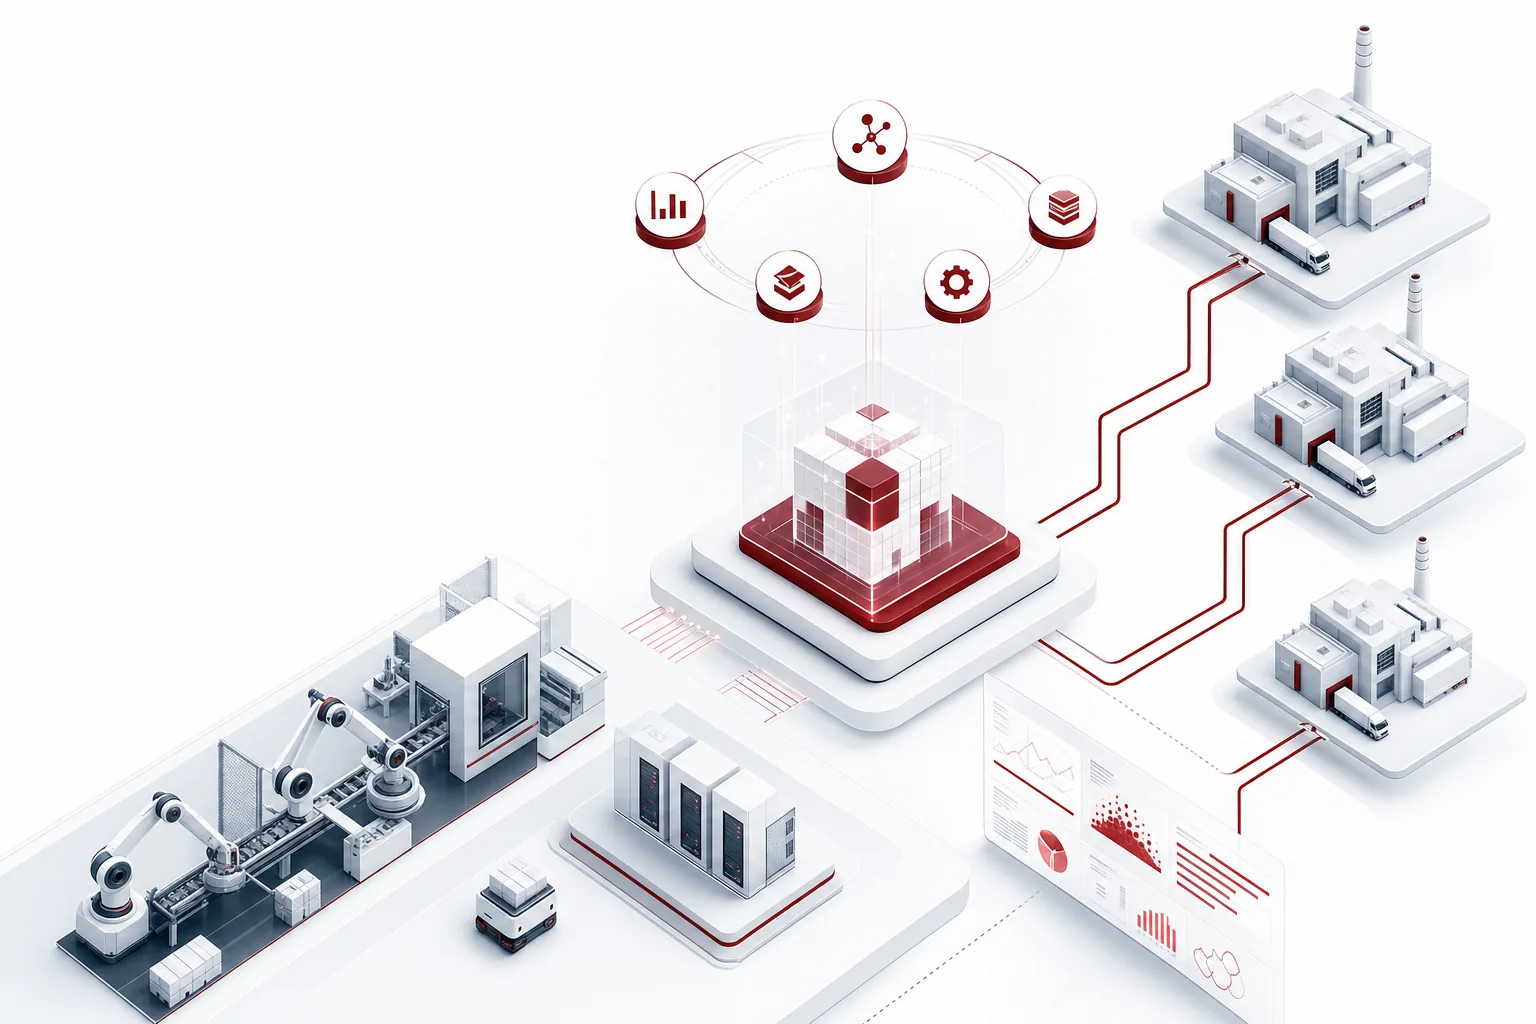
MLOps 인력 부족과 멀티공장 클러스터 관리 문제를 멀티페르소나 자율 에이전트팀으로 해소하는 실전 접근법을 소개합니다.
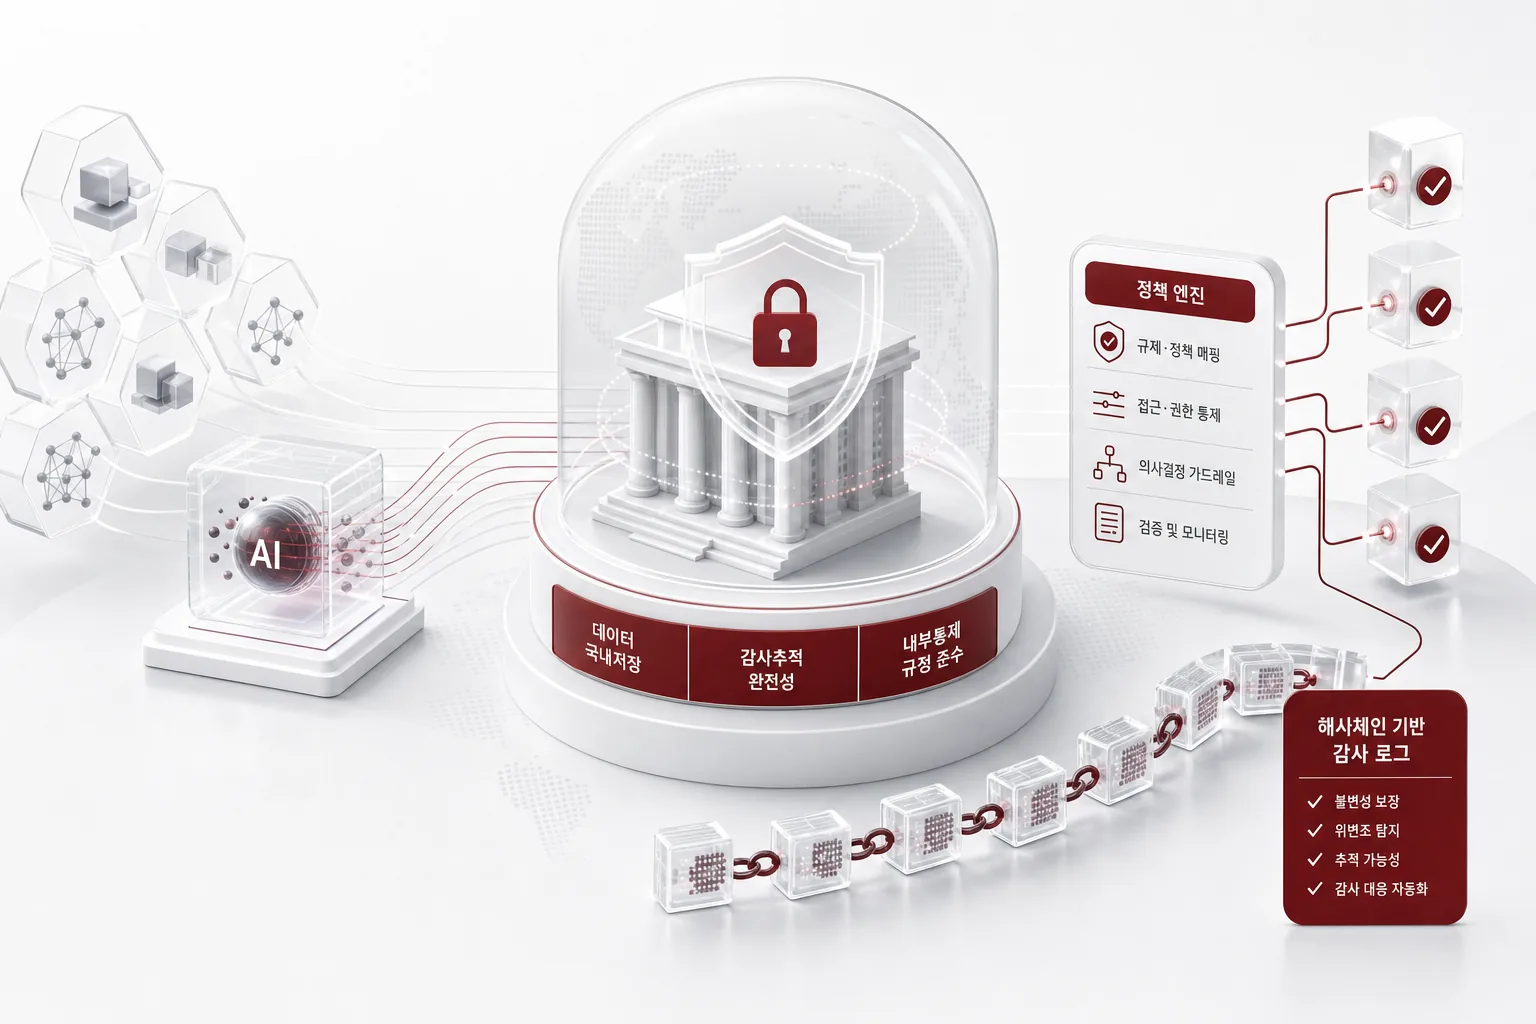
은행·증권·보험사가 AI 에이전트를 도입할 때 부딪히는 데이터 국내저장, 감사추적, 내부통제 요구사항을 정책엔진과 해시체인 감사 로그로 충족하는 방법을 가상 케이스로 살펴봅니다.
한 보안 연구자가 라우팅 설정 한 장으로 범용 코딩 에이전트를 20여 개의 전문 워크플로로 재배치하는 스킬팩을 공개하면서, 본인 스스로 위험한 이중용도 프로젝트라고 못 박았습니다.
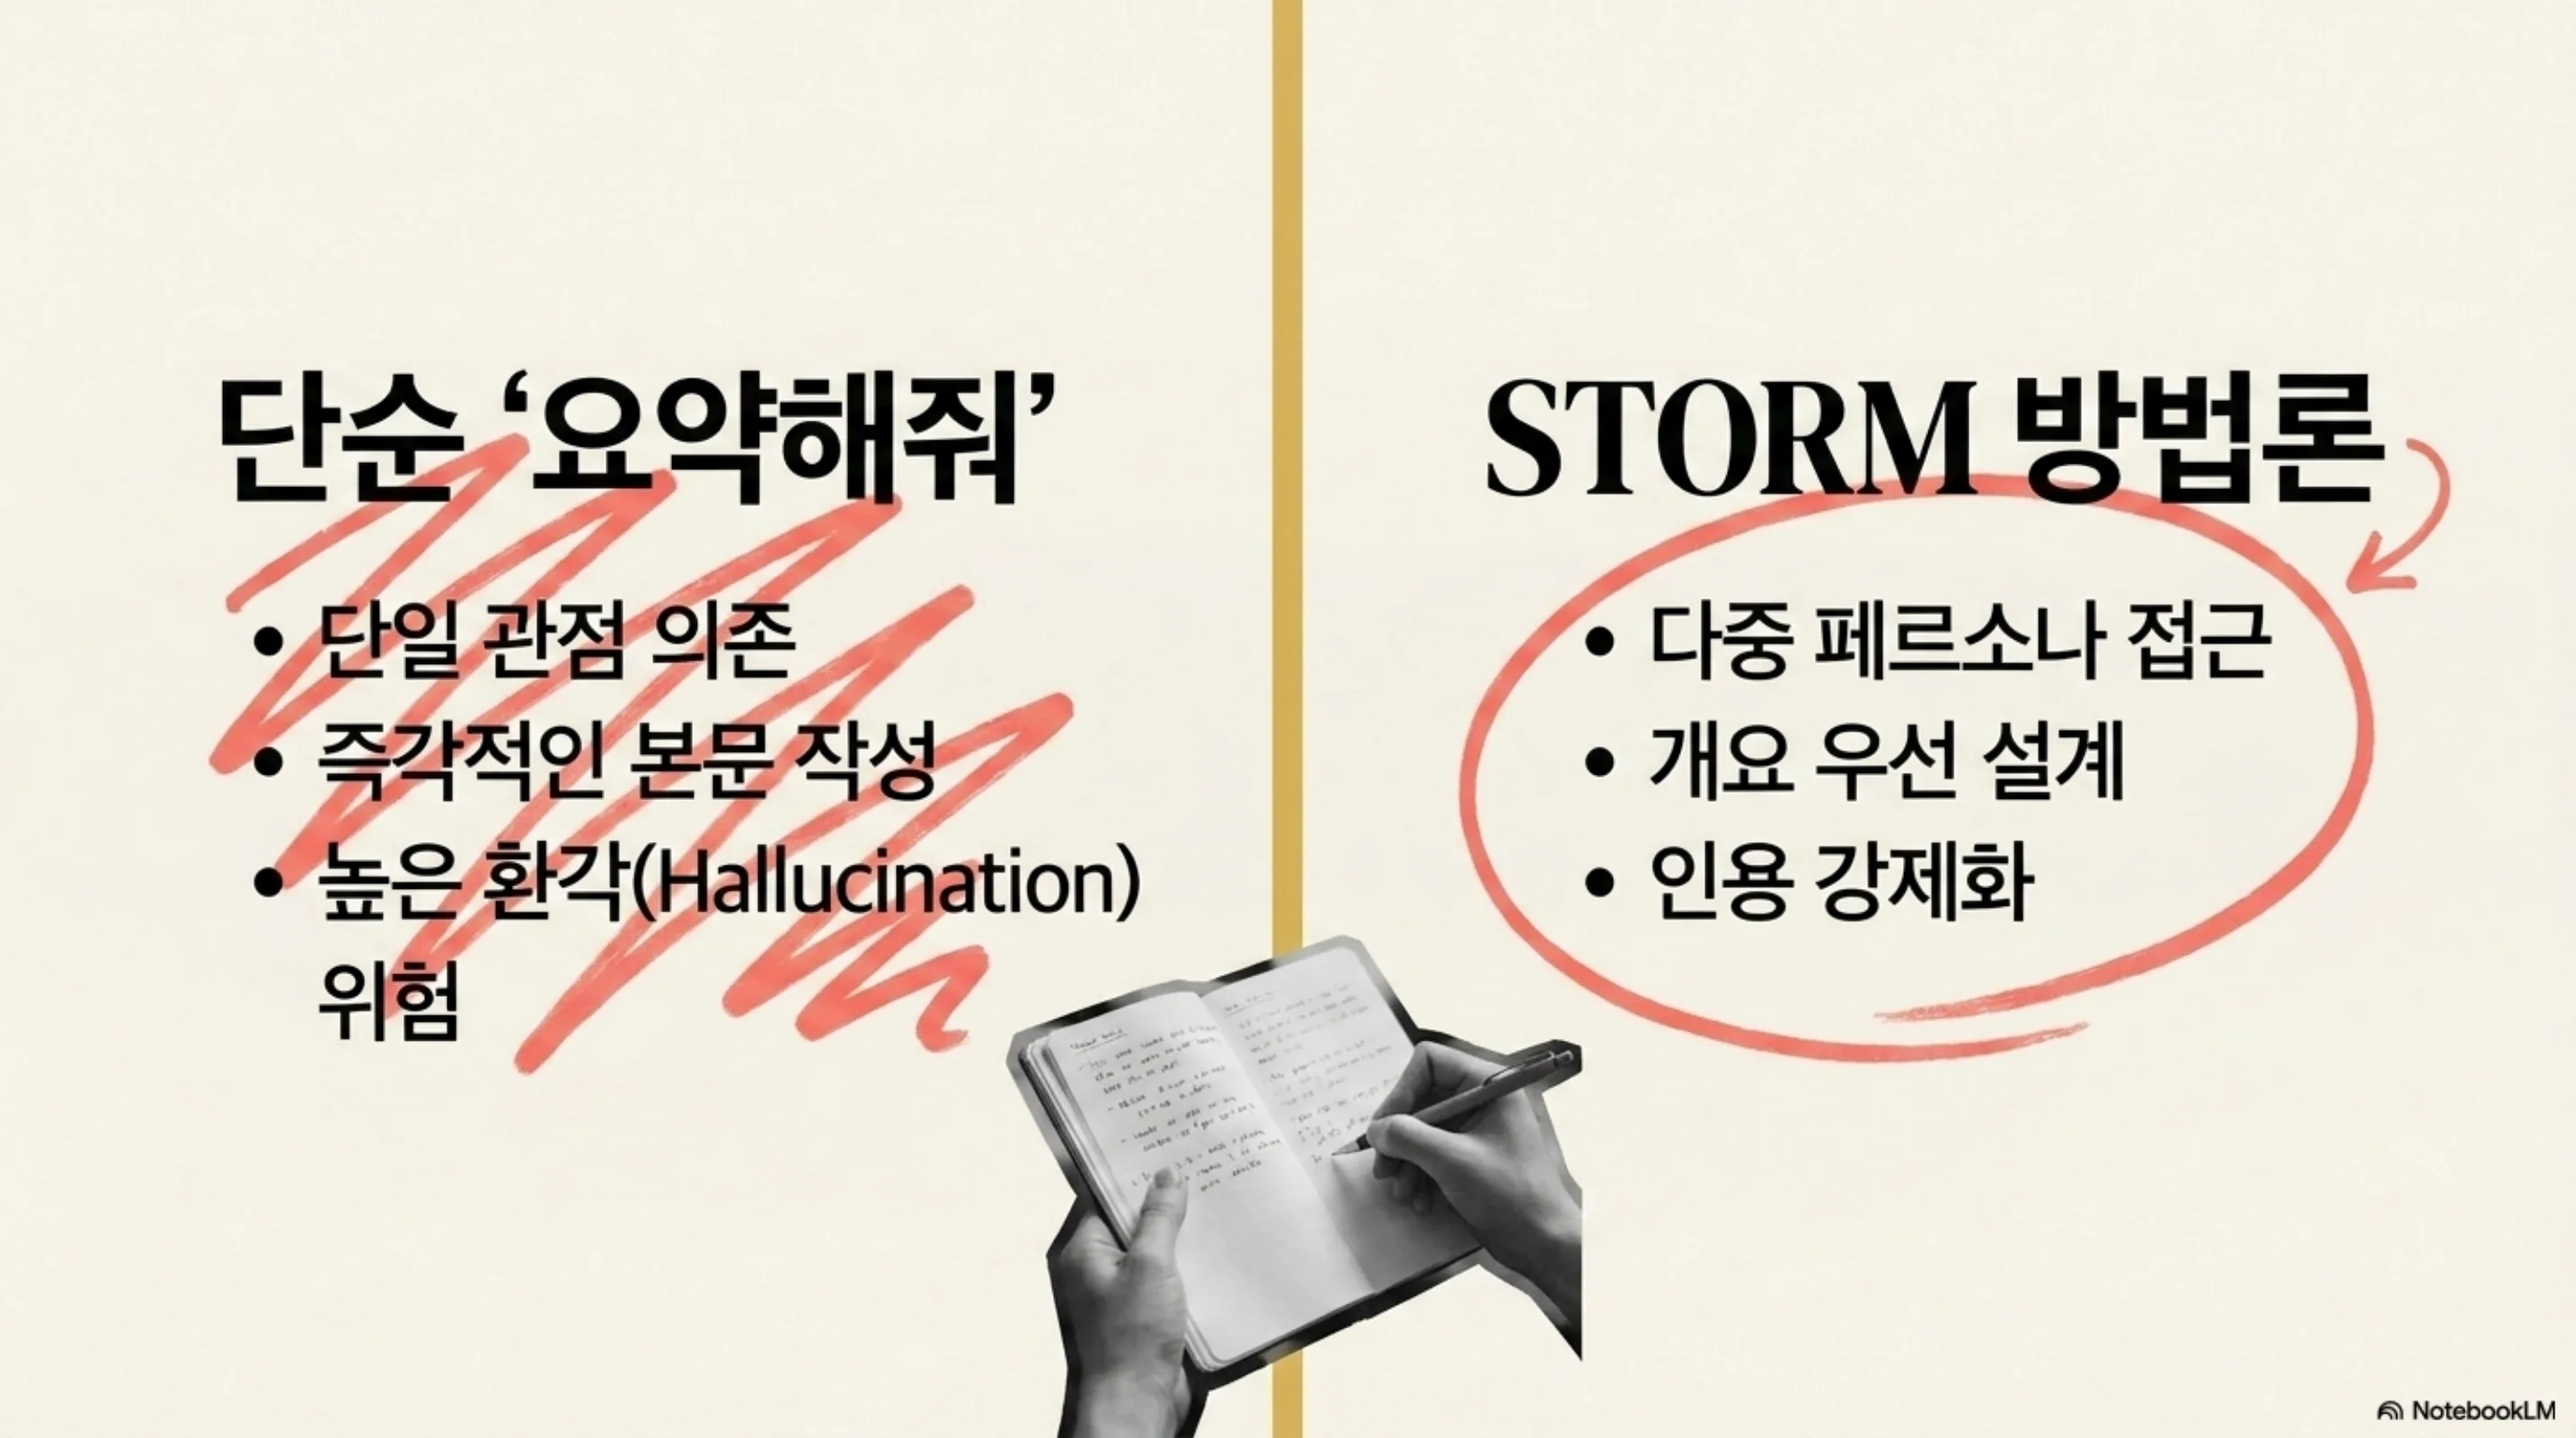
스탠퍼드 OVAL 연구실의 STORM은 질문을 던지고, 다관점으로 조사하고, 개요를 잡고, 인용이 달린 보고서를 생성하는 LLM 지식 큐레이션 시스템입니다.
스탠퍼드 REAP 기반 CoPaper.AI가 공개한 23,000개 이상의 실증 연구 에이전트 스킬 라이브러리를 분석합니다.
복합 사용자 요청은 스킬 하나를 고르는 문제가 아니라 여러 개를 조합하는 문제입니다.
구글이 TPU v2부터 Ironwood까지 5세대 트레이닝 슈퍼컴퓨터의 아키텍처 안정성, 규모, 회복탄력성, 전력 효율, 지속가능성을 정리한 논문(arXiv:2606.15870)을 분석합니다.
arXiv URL의 ‘arxiv’를 ‘autoarxiv’로 바꾸면 에이전트가 코드베이스 환경 설정, 최소 재현 실행, GPU 복제 비용 추정을 자동 수행합니다.
Z.ai가 오픈소스화한 slime은 RL 스케일링을 위한 LLM 사후학습 프레임워크입니다.
753B 규모 SOTA 오픈웨이트 모델 GLM-5.2를 RTX 4090 소비자 GPU에서 구동한 사례를 분석합니다.
Gemma 4 12B를 QAT와 TurboQuant로 RTX 4060 8GB에서 구동한 커뮤니티 벤치마크를 분석합니다.
Anthropic 공식 Skill-creator보다 강력하다고 입소문이 난 오픈소스 메타스킬 yao-meta-skill을 ThakiCloud 환경에 직접 클론하고 로컬 검증 게이트를 돌렸습니다.
여행 사진을 스튜디오 지브리 스타일 애니메이션으로 변환하는 구조화 프롬프트 기법을 분석합니다.
Nature 저널 기준의 과학 그림 생성과 학술 교열을 묶은 오픈소스 Claude 스킬 패키지 nature-skills를 직접 클론하고, nature-figure로 ThakiCloud 서빙 데이터를 제출 등급 2패널 그림으로 렌더링했습니다.
LlamaIndex가 발표한 LiteParse는 LLM 없이 PDF를 마크다운으로 변환하는 Apache 2.0 오픈소스 파서입니다.
AI 코딩 에이전트의 가장 큰 숨은 비용은 컨텍스트입니다.
Gemma 4 26B를 로컬에서 띄워 10개 병렬 서브에이전트로 SVG 아트 갤러리를 코딩하는 데모를 분석합니다.
LLM 에이전트가 수천 개의 재사용 스킬을 운용할 때 정확한 스킬 검색이 병목이 됩니다.
에이전트 스킬 문서를 외부 최적화 대상으로 삼아 스코어링된 롤아웃을 제어된 편집(추가/삭제/교체)으로 변환하는 SkillOpt를 분석한다.
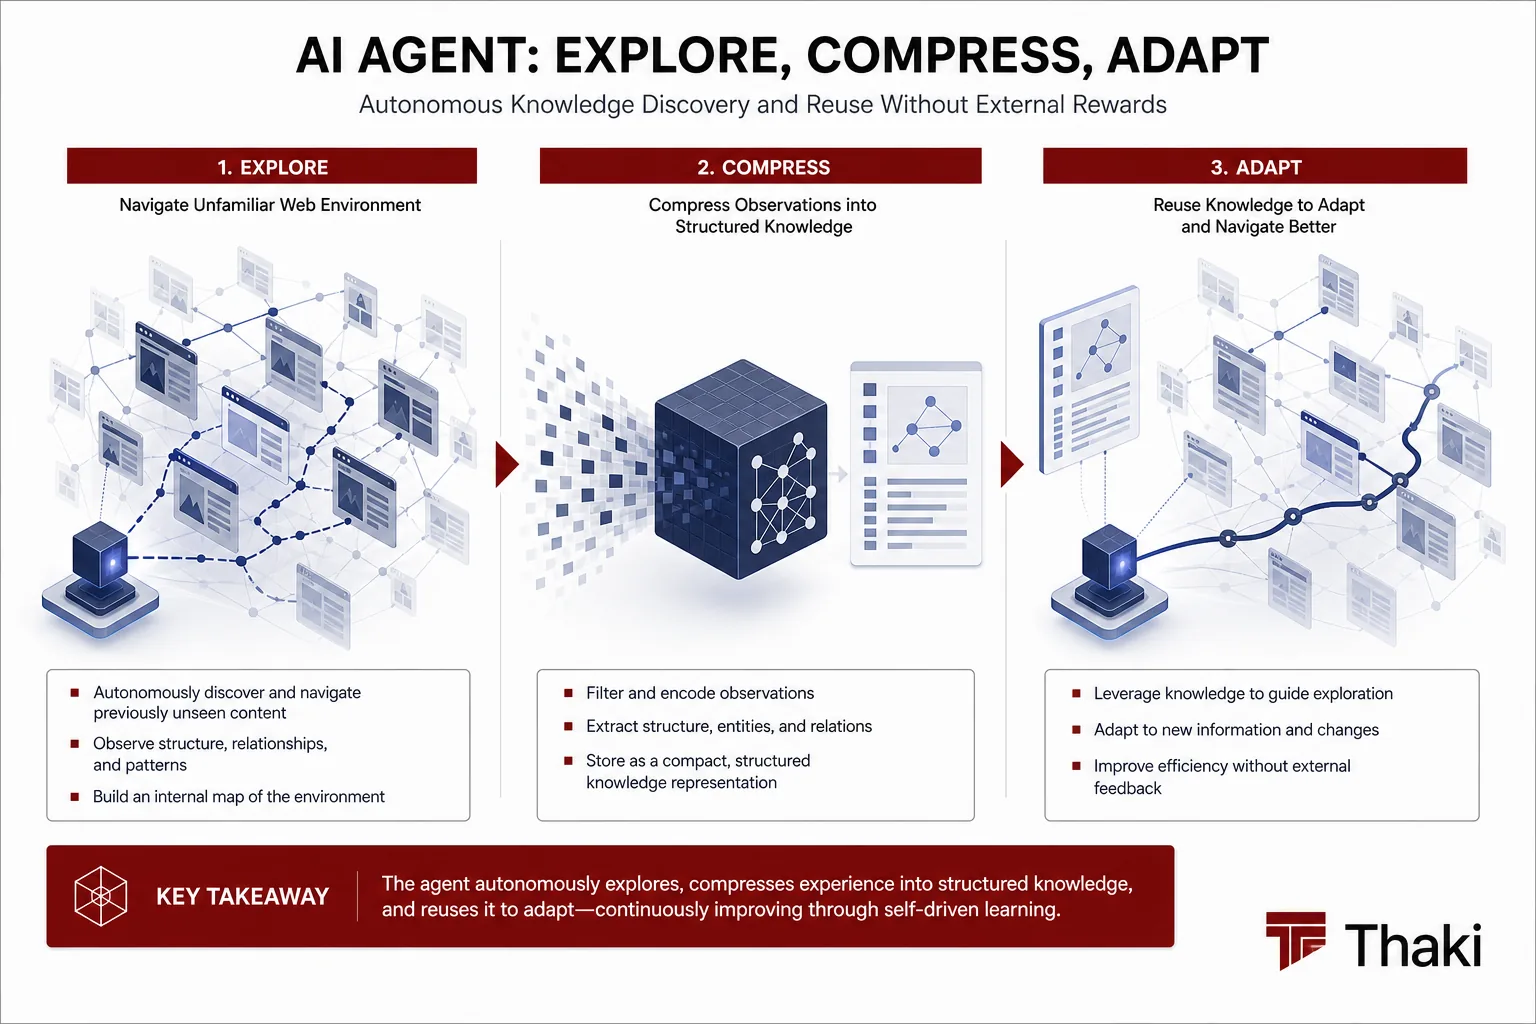
외부 보상 신호 없이 에이전트가 자체적으로 세계 지식을 생성하고 그 지식으로 다운스트림 성능을 높이는 훈련 방법론을 분석한다.
코드가 AI 에이전트 시스템의 기반 인프라로 기능하는 방식을 하네스 인터페이스, 하네스 메커니즘, 멀티에이전트 조율 세 계층으로 체계화한 서베이를 분석한다.
프롬프트, 툴, 메모리를 버전 관리 가능한 ‘프로토콜 리소스’로 추상화해 에이전트가 스스로 개선 루프를 닫는 Autogenesis Protocol(AGP)의 설계와 실험 결과를 분석한다.
NVIDIA가 OpenMDW-1.1 라이선스로 공개한 Nemotron-3-Ultra-550B-A55B는 Mamba-2와 MoE, Attention을 결합한 LatentMoE 하이브리드 아키텍처다.
MiniMaxAI가 공개한 M3은 428B 총 파라미터, 23B 활성 파라미터 MoE 멀티모달 VLM이다.
MiniMax가 공개한 M2.7은 229B 파라미터, FP8 지원, 113종 양자화 변형으로 온프렘 경로가 다양하다.
Moonshot AI의 Kimi K2.6은 1T 총 파라미터 중 32B만 활성화하는 MoE 구조로 dense 32B급 추론 비용을 유지하면서 256K 컨텍스트와 멀티모달을 지원한다.
Z.ai의 GLM-5.2는 DSA(Dynamic Sparse Attention)로 1M 컨텍스트를 2.9x FLOPs 절감하며 처리한다.
Microsoft가 공개한 FastContext-1.0-4B-SFT는 Qwen3-4B를 파인튜닝한 코딩 에이전트 서브에이전트 모델이다.
Google DeepMind가 공개한 DiffusionGemma-26B-A4B-it는 MoE 기반 VLM이되, 텍스트 생성을 autoregressive가 아니라 이산 확산(discrete diffusion)으로 수행한다.
환경설정부터 놓치기 쉬운 기능까지.
리서치부터 표지, 세일즈 퍼널, 배포 스크립트까지 한 파이프라인으로 묶은 이북 제작 스킬을 실제로 돌려본 기록.
EAGLE 3.1이 vLLM 메인에 머지된 2026년 5월 이후, 투기적 디코딩을 K8s LLM 서빙 스택에 어떻게 통합하고 실측 성능을 검증할지 다룬다.
NVIDIA Blackwell의 네이티브 4비트 부동소수점 포맷 NVFP4가 H100 FP8 대비 어떤 이점을 주는지, 그리고 vLLM/TensorRT-LLM 스택에서 실제로 적용하는 방법을 설명한다.
Blackwell 전용 NVFP4 말고, Hopper·Ampere에서 오늘 당장 vLLM으로 서빙 가능한 양자화 기법을 정리합니다.
GPU 활용률과 KV 캐시 압박, 토큰 처리량까지 모니터링하는 LLM 서빙 관측 스택을 Kubernetes 멀티테넌트 환경에 실제로 구성하는 방법을 다룹니다.
llm-d는 GPU를 늘리는 대신 같은 GPU에서 더 많은 요청을 처리하는 추론 스케줄러입니다.
GPU 감가상각 공식, Kueue 갱 스케줄링, vLLM scale-to-zero, 모델 티어 라우팅까지.
vLLM의 Automatic Prefix Caching을 프로덕션에서 어떻게 설정하고 측정하는지, 실제 히트율과 비용 절감 수치를 중심으로 정리했습니다.
Ollama를 단순 로컬 실험 도구가 아닌 K8s 클러스터의 LLM 서빙 레이어로 올리는 실전 패턴을 정리했습니다.
Kueue의 선점(Preemption) 메커니즘과 ClusterQueue 설계 원칙을 실제 AI/ML 플랫폼 운용 관점에서 정리했습니다.
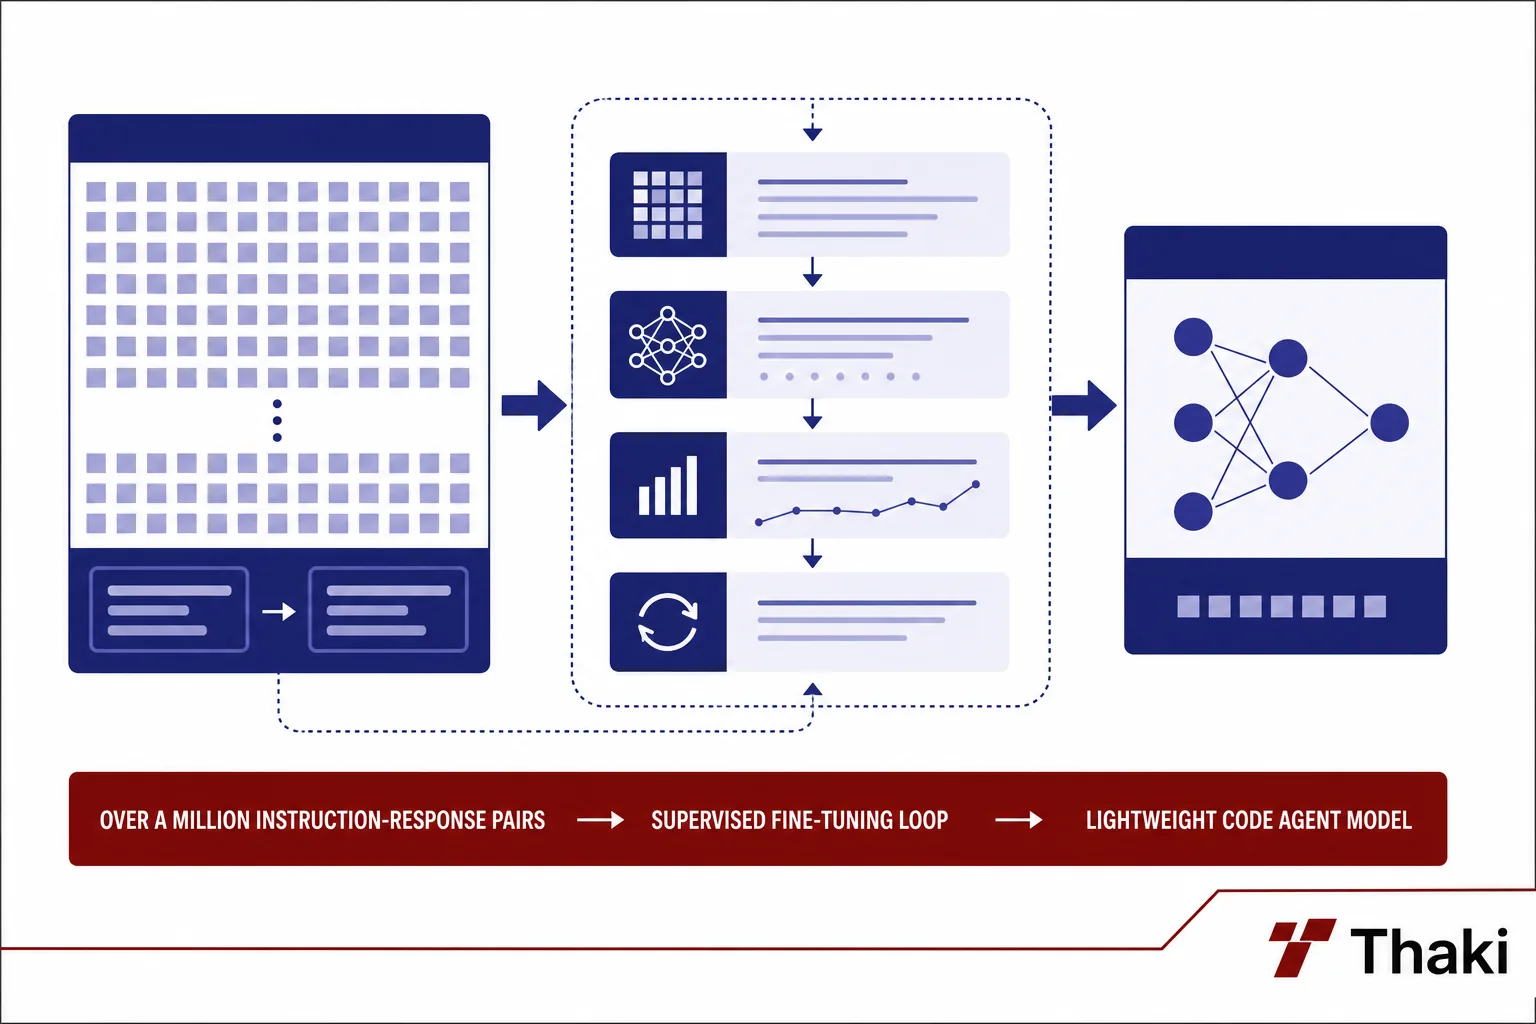
lazarus19가 공개한 Vibe-Coding-Instruct는 Apache-2.0, 110만 개 코딩 instruction-response 쌍 데이터셋이다.
Glint-Research가 공개한 Fable 5(Claude Code) 에이전트 trace 4,665개.
agents-last-exam은 153개 장기 과제로 컴퓨터 사용 에이전트를 평가하는 벤치마크 데이터셋이다.
기존 클라우드가 서버를 다루듯, Paxis는 에이전트의 능력·도구·정책·감사를 일급 자원으로 다룹니다.
2026년 프로덕션 환경에서 검증된 멀티에이전트 오케스트레이션 패턴 6가지를 정리합니다.
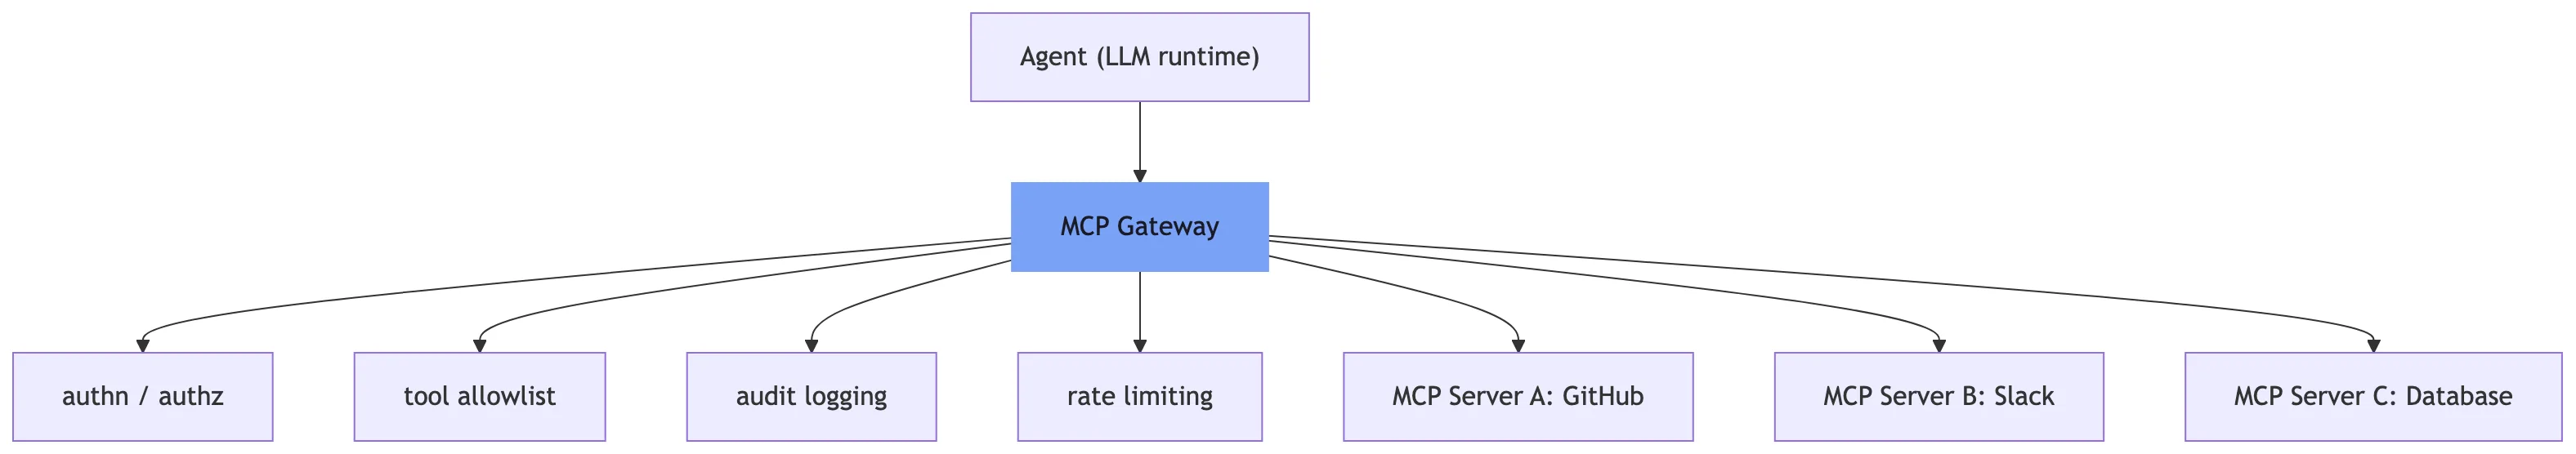
2026년 MCP가 에이전트 연결 표준으로 자리잡으면서 생긴 보안 문제와 운영 패턴을 정리합니다.
스케줄 잡, 이벤트 훅, 자가개선 루프, 메모리 파이프라인까지.
800개가 넘는 과거 대화에서 반복 워크플로를 결정론 엔진으로 캐내 스킬로 만들고, 실패를 근거로 스킬 본문을 leak-free로 진화시키는 두 개의 자율 루프를 코드와 함께 공개합니다.
하루 705달러를 태운 사고에서 출발해, LLM 모델 라우팅과 스킬 라우터, 토큰 위생 룰로 Claude Code 에이전트 운영비를 구조적으로 줄인 방법을 실제 규칙과 수치로 공개합니다.
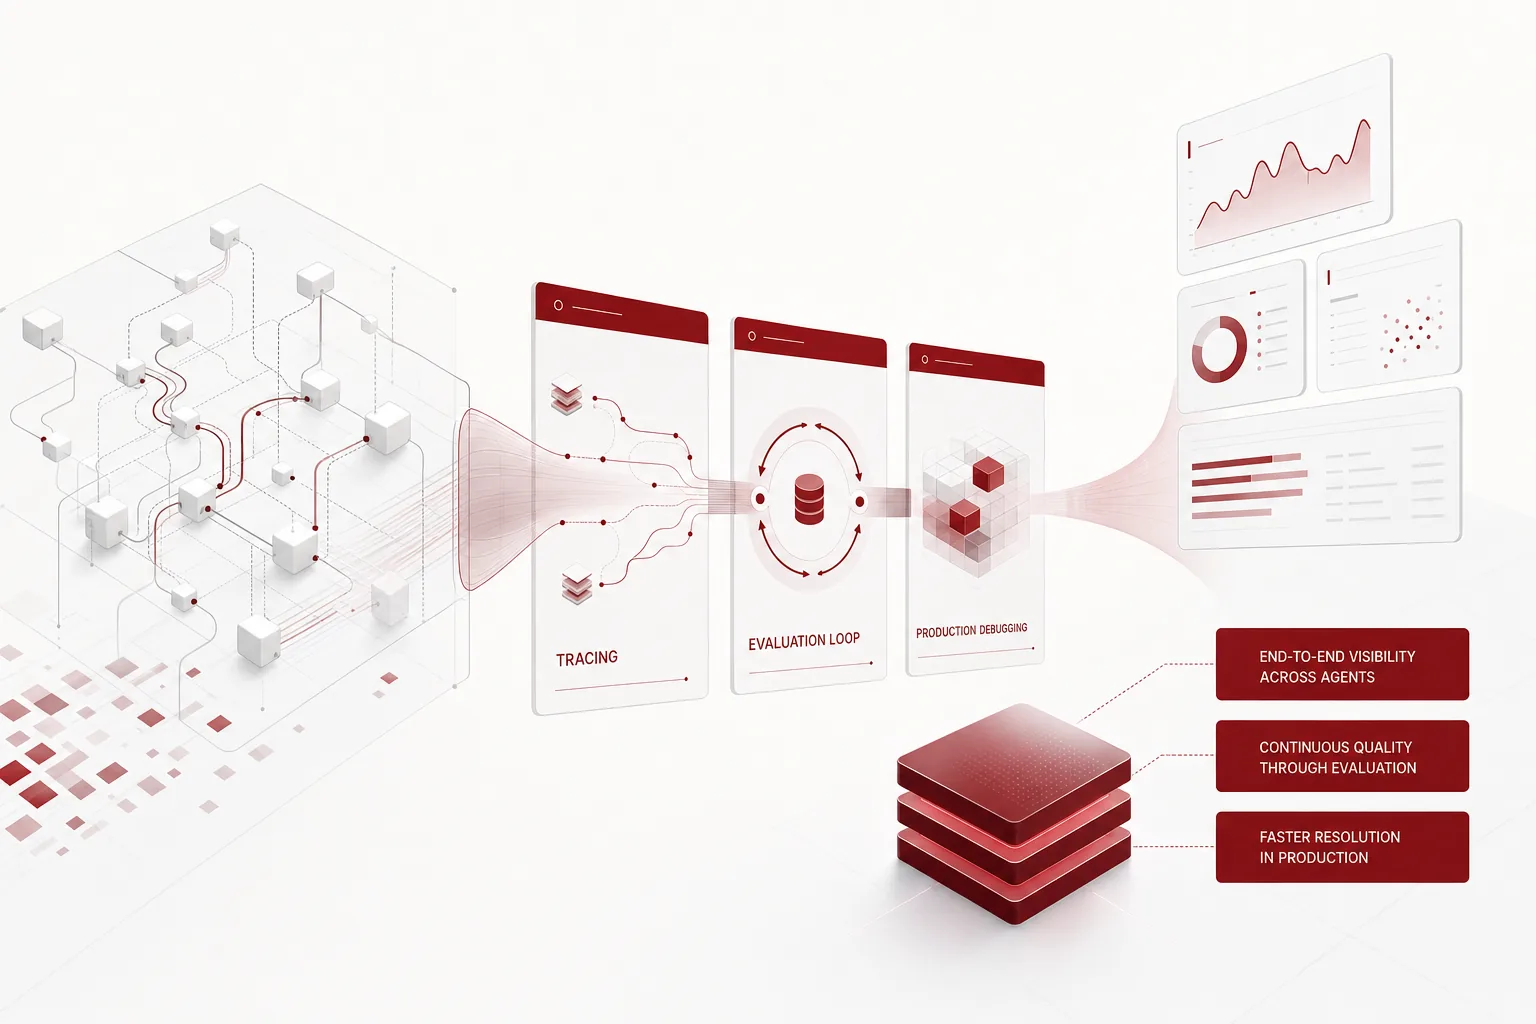
멀티에이전트 시스템에서 전통적인 로깅이 왜 통하지 않는지, 그리고 스팬 트레이싱·평가 파이프라인·프로덕션 디버깅을 어떻게 구축하는지 실전 관점에서 정리합니다.
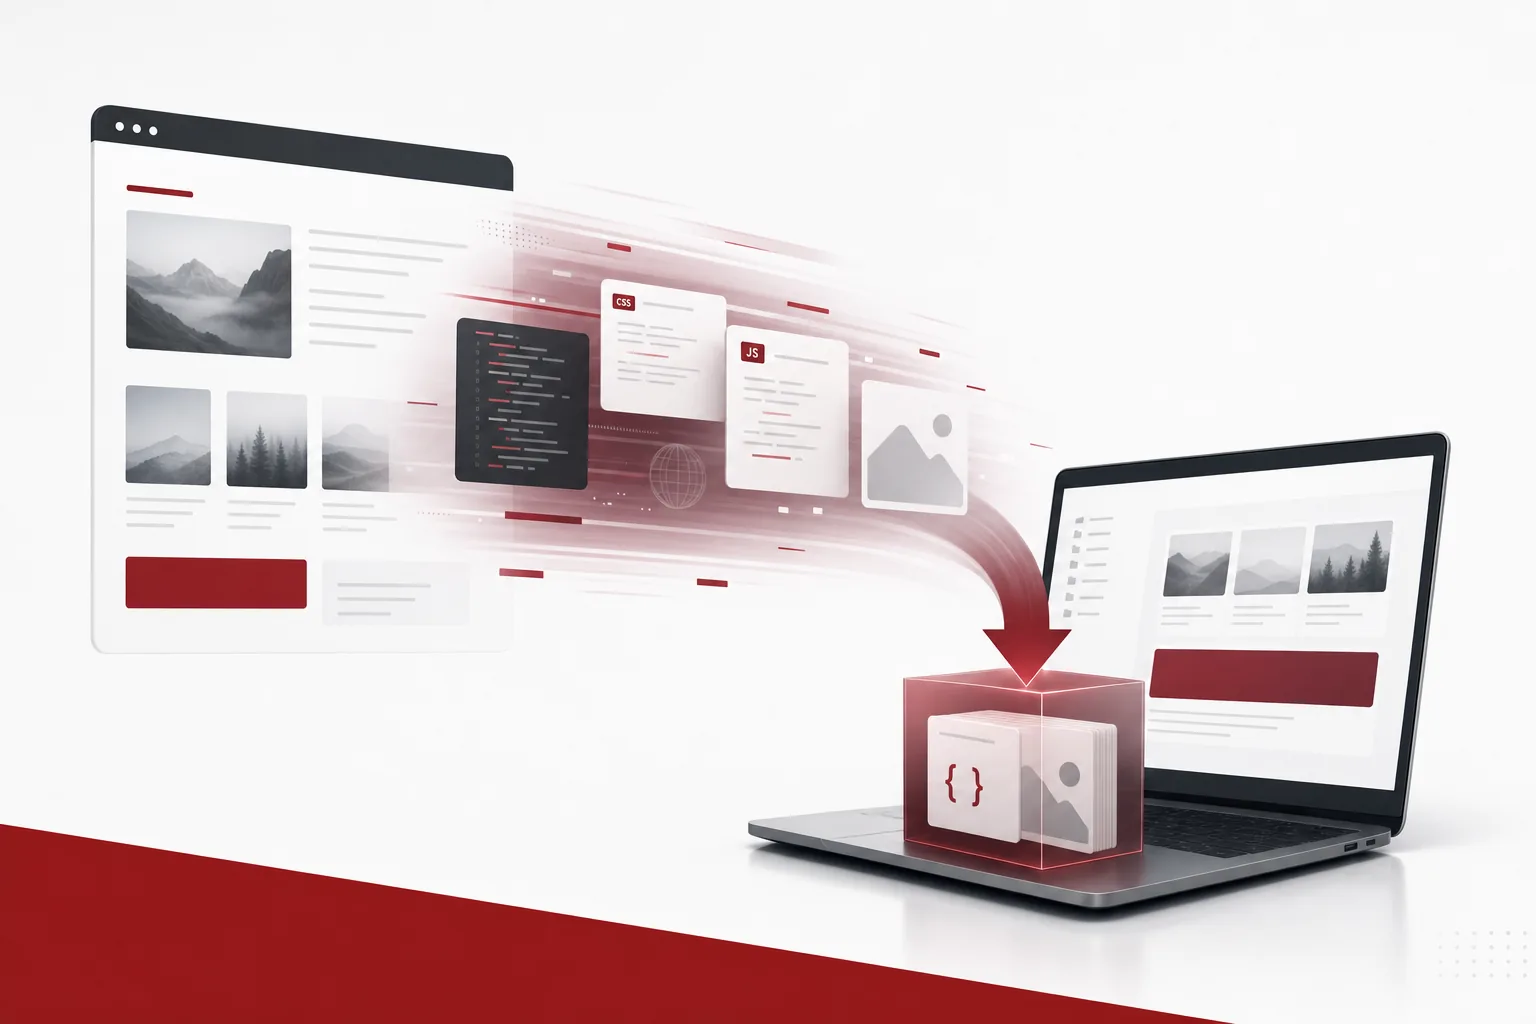
HTML, CSS, JavaScript, 이미지를 포함한 전체 웹사이트를 로컬 머신에 다운로드할 수 있는 강력한 Go 기반 웹사이트 클로너 Goclone 사용법을 배워보세요.
RAGLight 프레임워크를 마스터하세요.
LangGPT의 구조화된 프레임워크를 사용하여 고품질의 재사용 가능한 프롬프트를 만드는 방법을 배워보세요.
udocker를 사용하여 루트 권한 없이 Docker 컨테이너를 실행하는 방법을 배워보세요.
엔터프라이즈급 보안, 비용 제어, 벤더 유연성을 제공하는 오픈소스 AI 에이전트 오케스트레이터 Shannon의 설치부터 고급 멀티 에이전트 워크플로우까지 완전한 가이드를 제공합니다.
Helm Dashboard에 대한 종합 튜토리얼 - 시각적 인터페이스로 Kubernetes 차트 관리를 단순화하고 리비전 히스토리와 손쉬운 롤백 기능을 제공하는 Helm의 필수 UI 도구.
기술적 우수성은 모든 커리어의 기초이지만, 진정한 성장을 위해서는 기술적 능력, 제품 사고, 프로젝트 실행, 그리고 인간관계 기술이라는 네 가지 핵심 역량을 균형 있게 발전시켜야 합니다.
LLM 후훈련을 위한 필수 데이터셋과 도구들을 탐구합니다.
농업부터 e스포츠까지 다양한 분야의 엄선된 공개 데이터셋 컬렉션을 통해 전 세계 오픈 데이터 커뮤니티의 노하우를 만나보세요.
NVIDIA가 6백만 개의 다국어 추론 데이터셋을 공개하며 프랑스어, 스페인어, 독일어, 이탈리아어, 일본어 5개 언어로 확장된 고품질 훈련 데이터를 제공합니다.
64만 시간의 오디오 데이터로 구성된 NVIDIA의 최신 다언어 음성 인식 및 번역 데이터셋, Granary의 특징과 활용 방안을 알아봅니다.
PDF, 이미지, 오디오 파일을 자동으로 구조화하는 오픈소스 AI 플랫폼 Rowfill의 핵심 기능과 활용법을 알아보세요.
Node.js/TypeScript로 구축된 AnyCrawl로 웹사이트를 LLM 친화적 데이터로 변환하고, Google/Bing SERP 결과를 효율적으로 수집하는 방법을 마스터해보세요.
ByteDance에서 공개한 Dolphin 프로젝트의 Fox 데이터셋과 벤치마크를 상세히 분석합니다.
RedNote가 공개한 dots.ocr로 다국어 문서 레이아웃 분석과 OCR을 단일 비전-언어 모델에서 구현하는 방법을 알아봅니다.
프로덕션 환경에서 ML 애플리케이션을 구축하기 위해 필요한 핵심 기술 스택과 역량을 정리한 실무 중심 가이드
Vibe Coding과 Agentic Coding이 가져온 새로운 개발 문화를 어떻게 받아들이고 발전시킬 것인가? 과거의 관습에서 벗어나 AI와 함께하는 협업 문화 구축 가이드
15분 설문과 행동 데이터로 팀 궁합을 정량화해 채용부터 온보딩까지 전 과정을 최적화하는 Saberr 알고리즘 활용법
데이터로 숨은 가치를 발굴해 자원 대비 최대 성과를 이끄는 머니볼 전략을 개발·제품·채용에 적용하는 방법
AI 시대의 개발자는 모든 것을 알 필요 없다.
AI 엔지니어링을 시작하려는 분들을 위한 학습 로드맵입니다.
백엔드·인프라 엔지니어 채용을 위한 10대 필독서와 실무 적용 사례를 통해 우리가 찾는 인재상과 채용 기준을 소개합니다.
ThakiCloud의 Three Vs(속도, 검증, 버전관리) 기반 MLOps 문화와 실전 사례, 그리고 함께할 동료를 찾는 채용 안내를 담았습니다.
KCD Seoul 2025에서 발표한 자료를 공유합니다.
Thaki Cloud의 기업 문화, 복지, 개발자들의 이야기, 채용 정보 등을 공유합니다.
Thaki Cloud의 미션, 원칙, 그리고 가치를 공유합니다.
No posts match these filters.