결과로 배우는 스킬 선택: 2,000개 스킬 무인 하네스의 비용-질 frontier
스킬 레지스트리를 둔 무인 에이전트 하네스를 운영하거나, retrieval-augmented 구조로 매 스텝마다 스킬 설명을 모델 컨텍스트에 주입하는 시스템을 맡고 있는 국내 클라우드·AI 엔지니어라면 이 글을 읽기 바랍니다. ThakiCloud Research의 이번 논문, “The Outcome Router: A Cost-Quality and Generalization Frontier for Skill Selection Learned from Graded Task Outcomes in a 2,000-Skill Unattended Agent Harness”는 라우팅 경로에서 마지막까지 동결 상태로 남아 있던 레버 하나를 학습 대상으로 끌어올린 분석 논문입니다. 스토커의 점수는 압축했고 퓨전 가중치는 online 보정했고 스킬 텍스트는 holdout에 맞대고 모델 티어에는 가격을 매겼습니다. 하지만 “retrieved 풀에서 어떤 스킬을, 혹은 아무것도 없이 native를” 선택할지를 정하는 정책은 한 번도 배우지 못했습니다. 이 논문은 그 선택을 단계된 과제 결과, 성공 점수에서 λ×주입 비용만큼 차감한 값,으로 bandit 학습하는 구조를 세웁니다. 그리고 학습 라우터가 고정 품질에서 동결 라우터보다 얼마나 비싸지 않으며 그 apparent gain 중 holdout으로 실제로 넘어가는 비율이 얼마인지를 frontier bound로 답합니다.
문제의식: 라우팅 경로 위에서, 선택만은 배우지 못했다
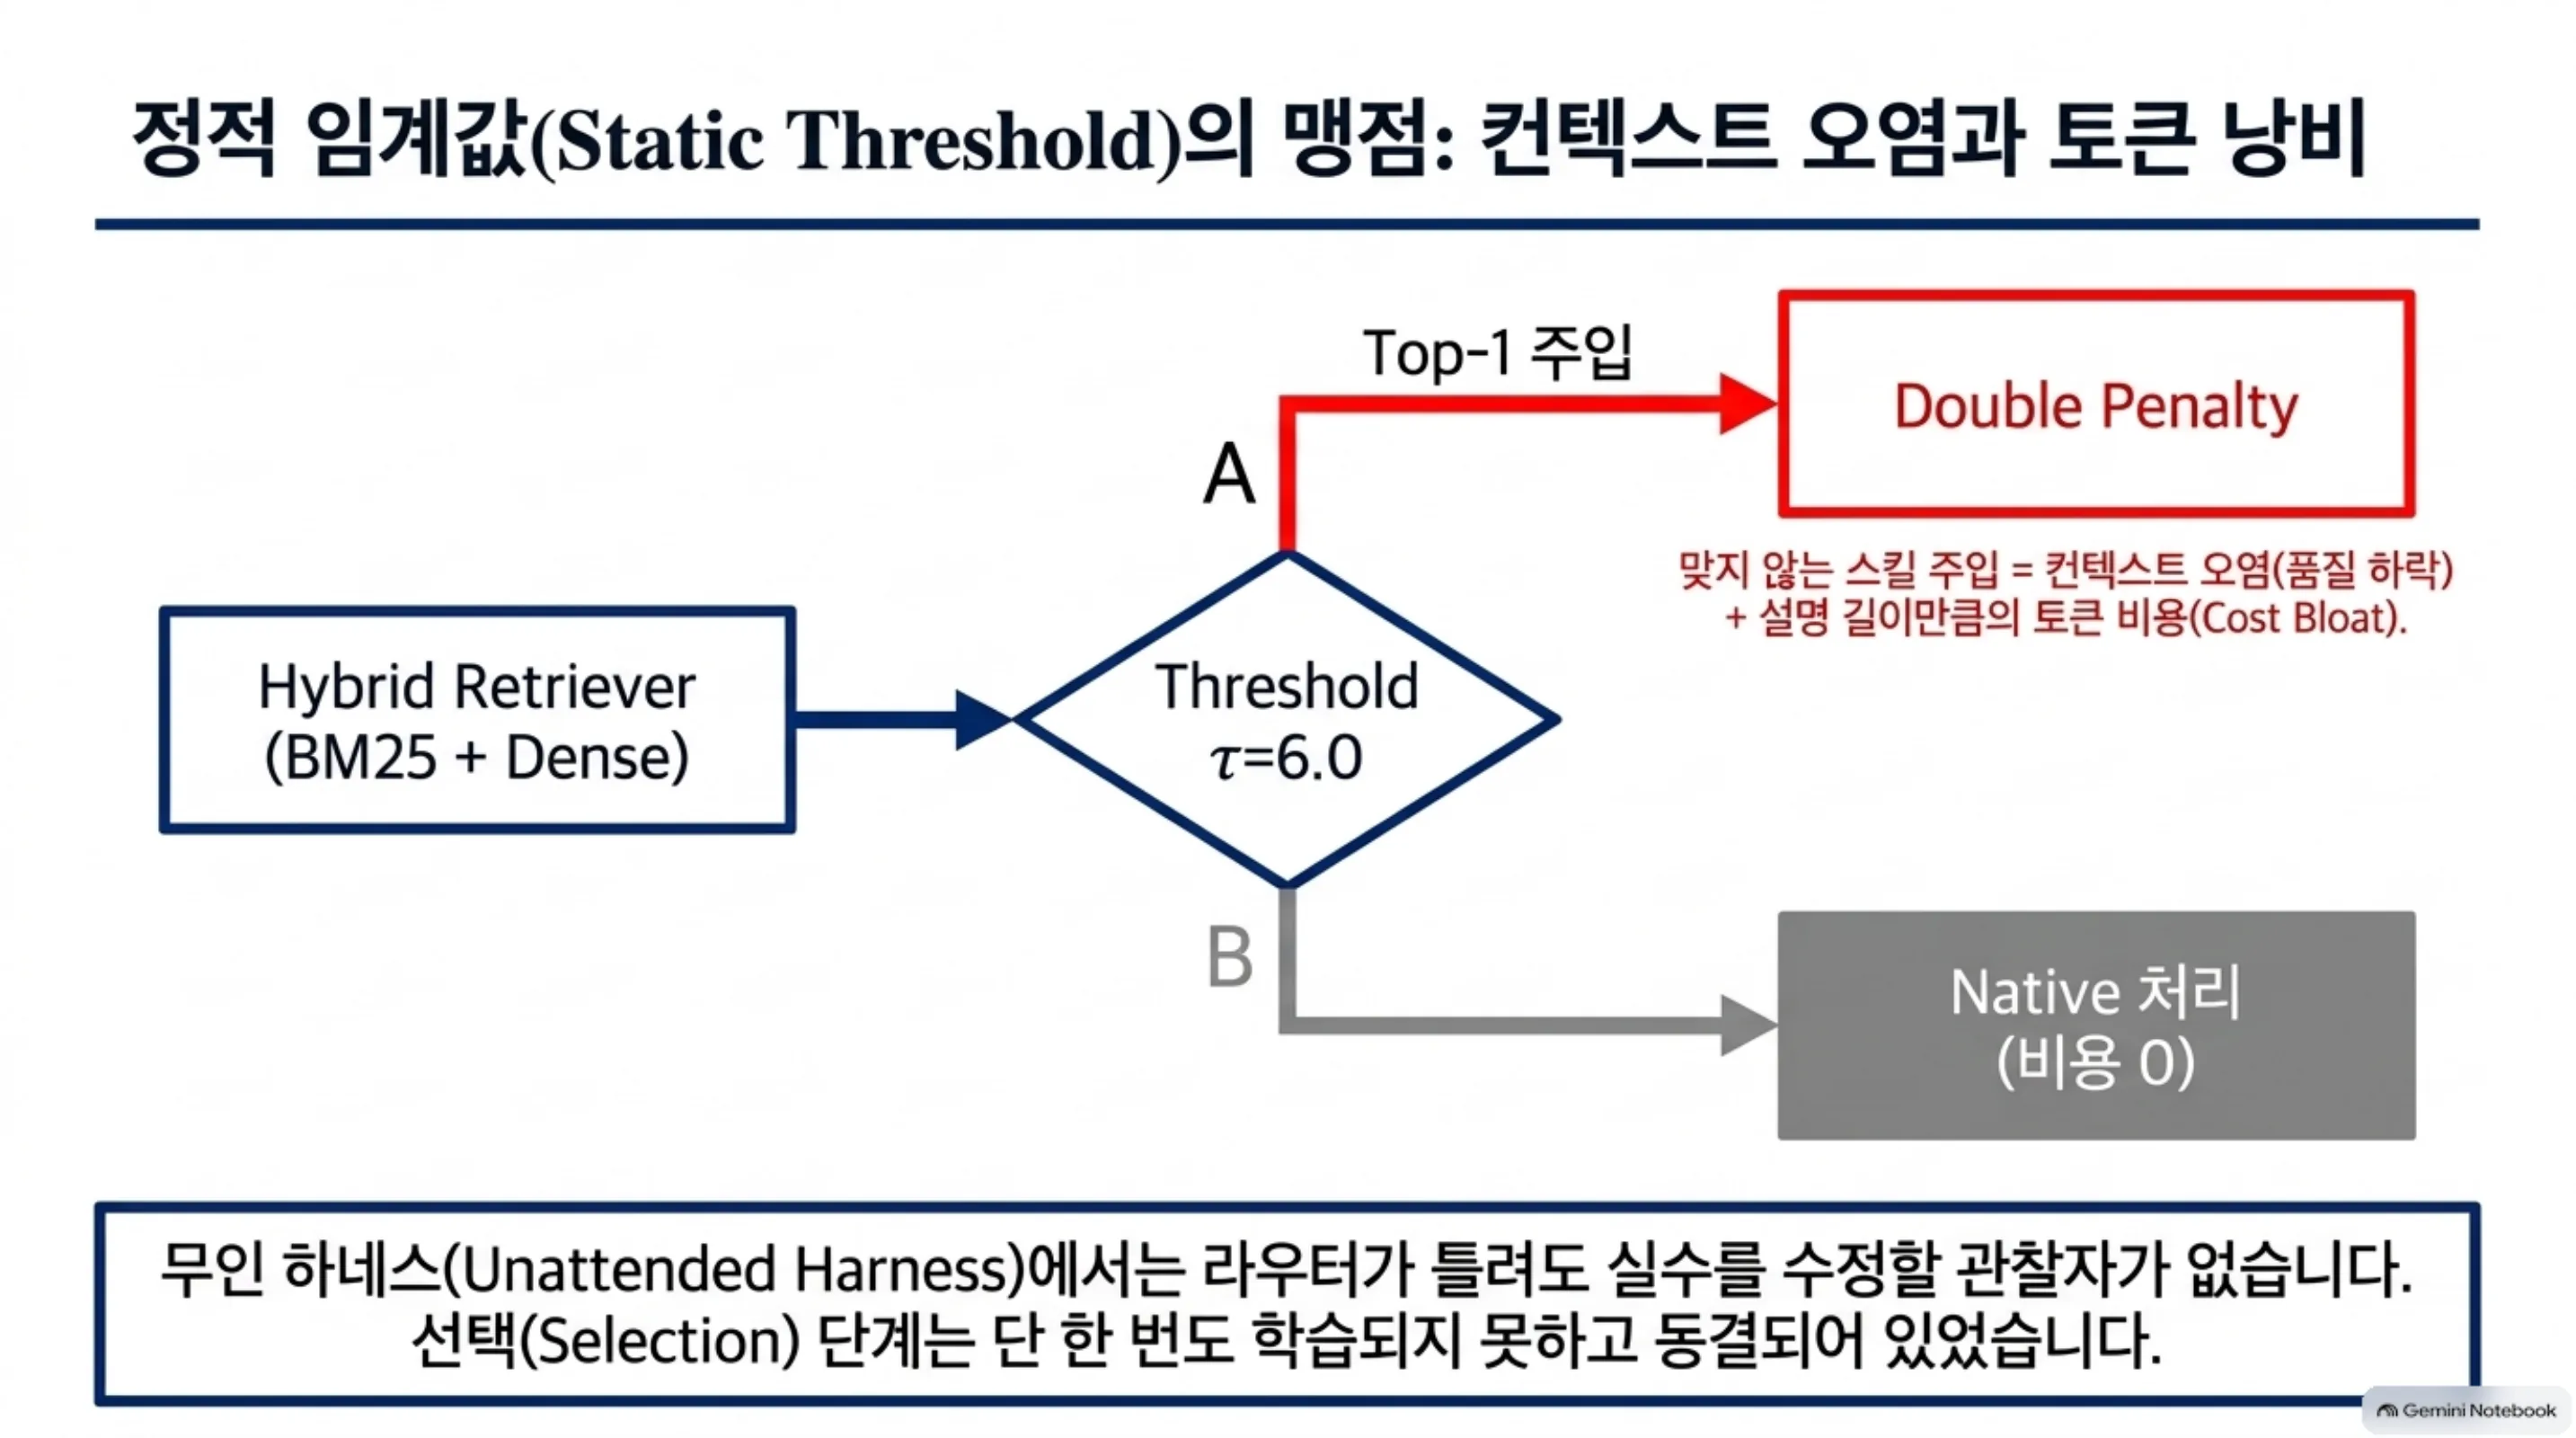
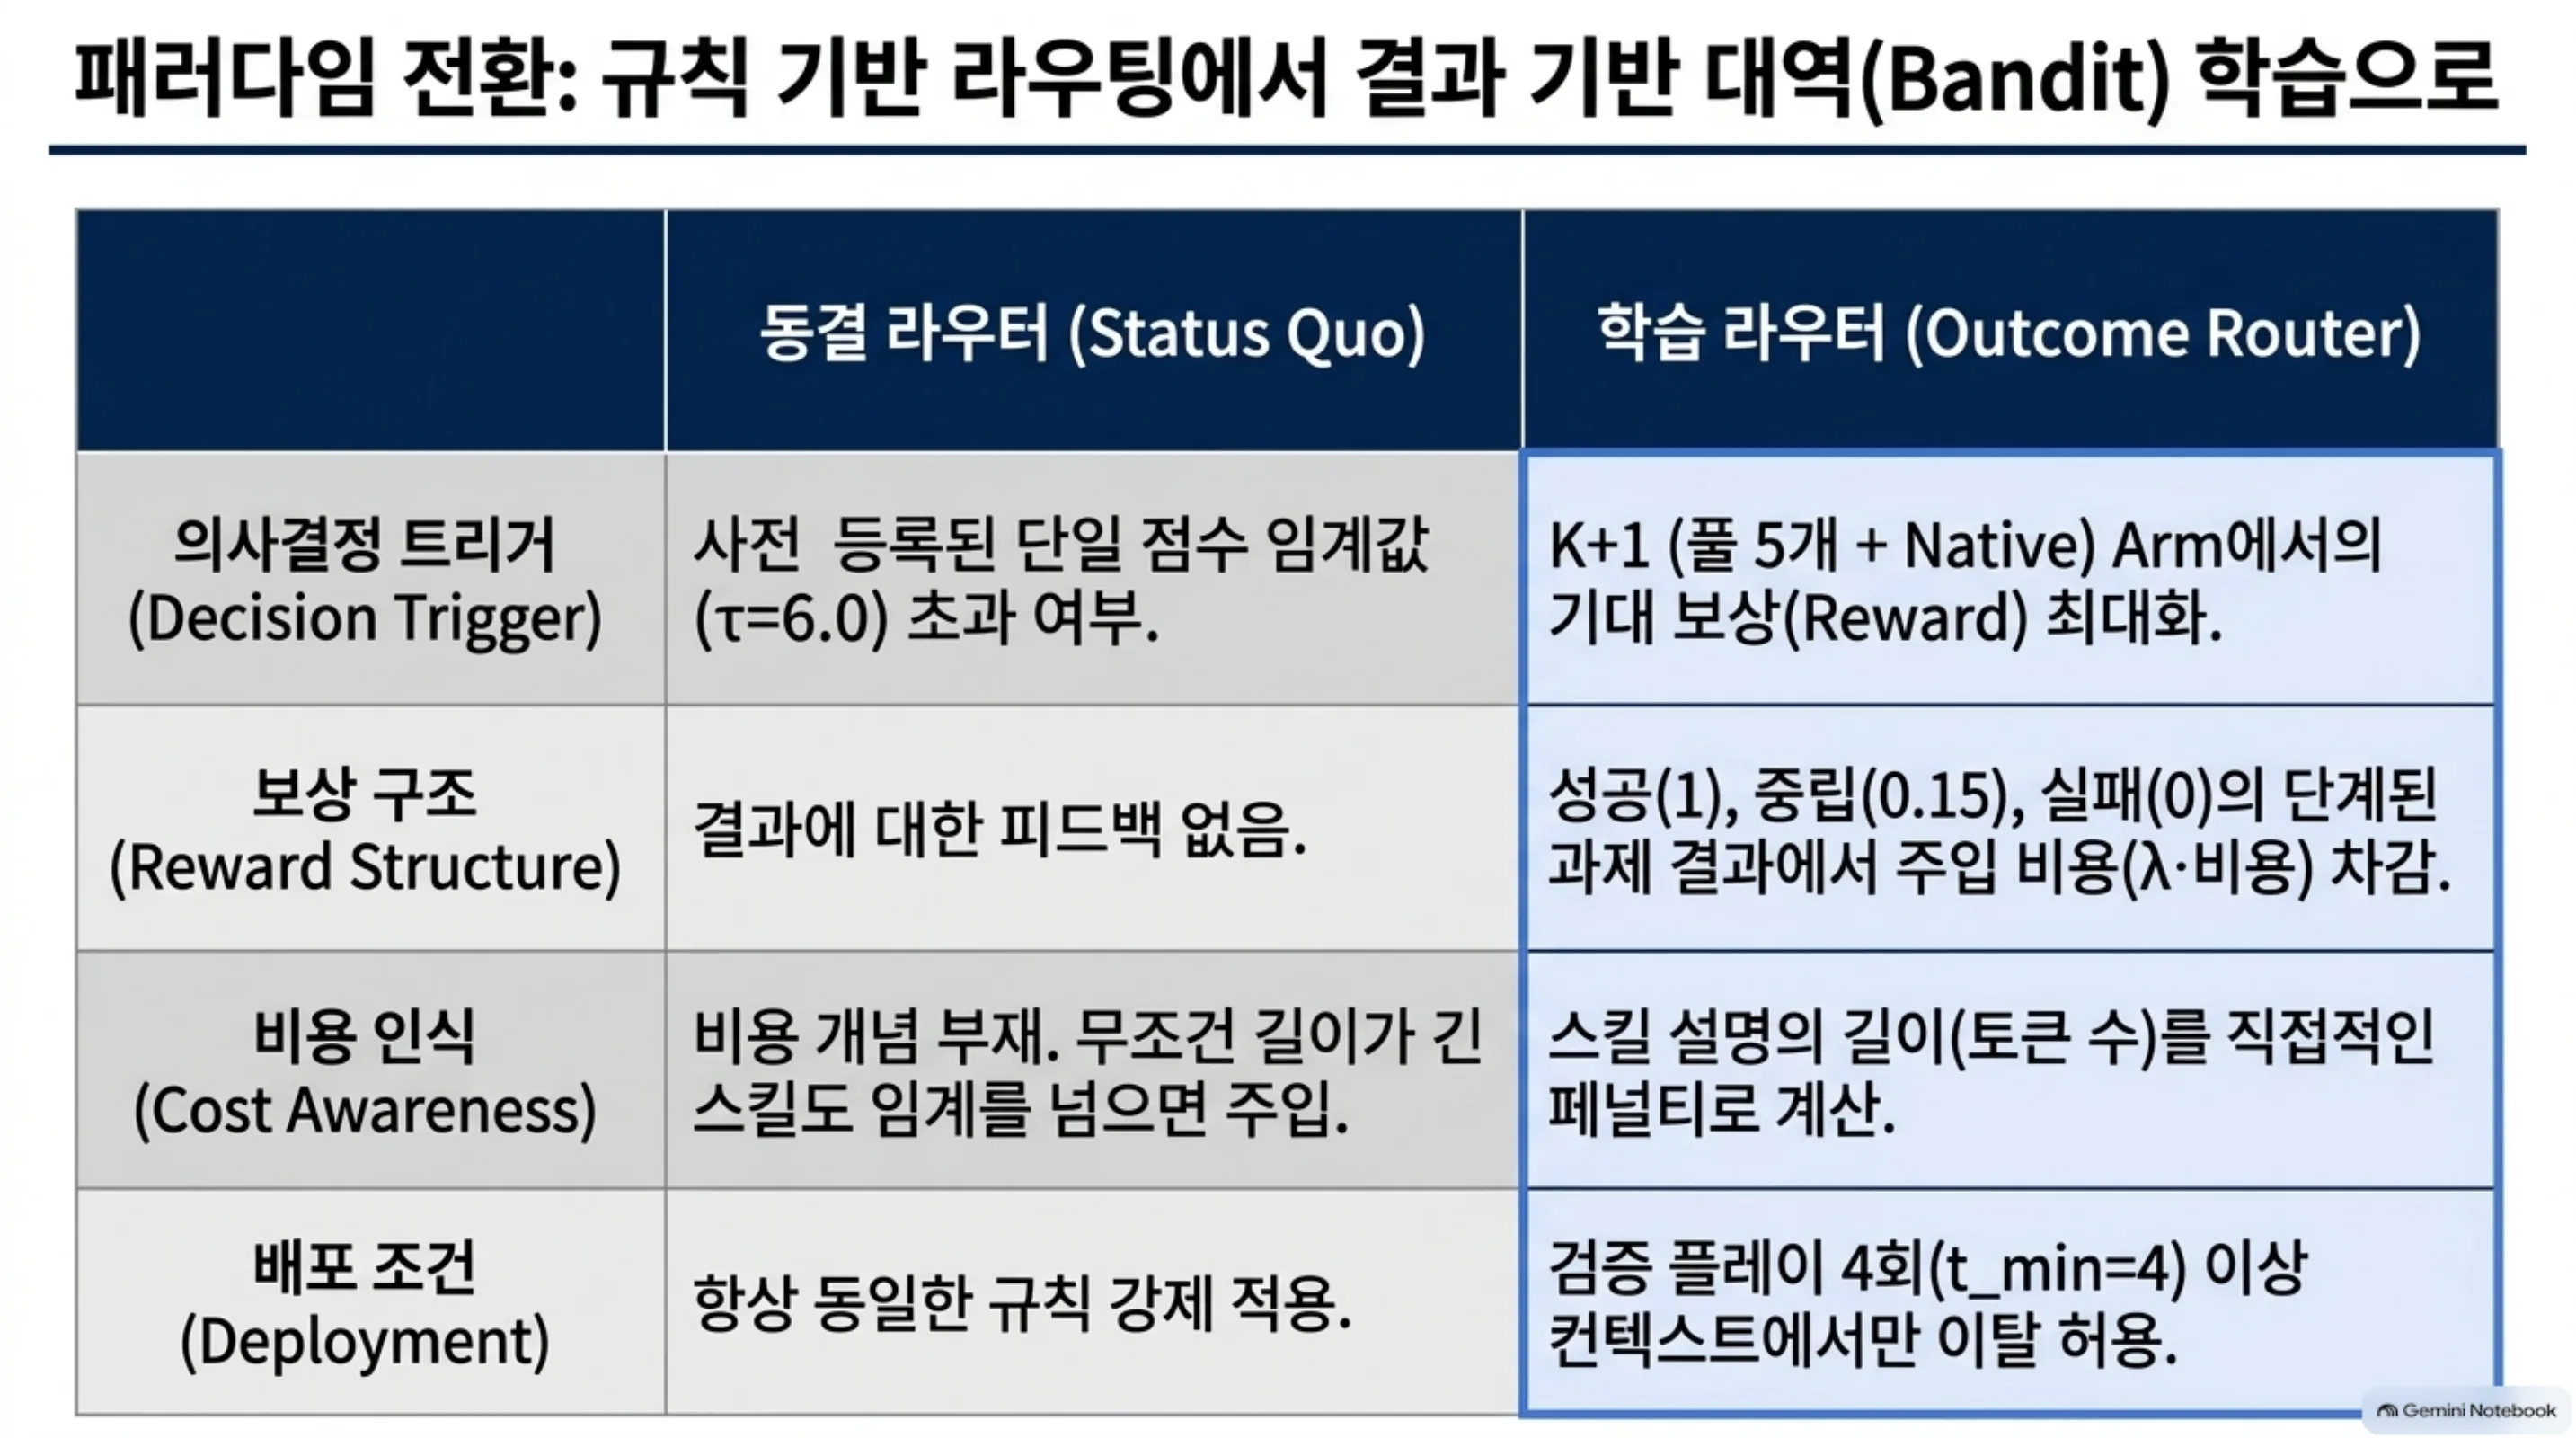
sra_bench 하네스에서 라우팅 경로의 동작은 이렇습니다. hybrid 리트리버, BM25 어휘 레인과 dense 임베딩 레인을 fusion한 것,이 레지스트리의 약 2,200개 스킬을 매 스텝 컨텍스트로 랭킹하고 상위 K=5개를 풀(pool)로 남깁니다. top-1 스킬의 fused score가 사전 등록된 임계 τ=6.0을 넘으면 그 스킬의 설명을 주입하고 넘지 못하면 native, 즉 주입 없이 모델 혼자서,로 갑니다. 이 “점수가 임계를 넘으면 top-1 주입”이라는 정해진 규칙이 지금까지의 라우터 전체였습니다.
이 라우터가 틀리면 두 가지 비용을 동시에 치릅니다. 맞지 않는 스킬의 설명이 컨텍스트를 오염시켜 품질이 떨어지고 주입된 설명의 길이가 그대로 토큰 비용으로 이어집니다. 하네스는 무인이기 때문에 그 trace를 읽는 사람도 없습니다. 실수가 쌓이는 동안 아무도 그것을 보지 않습니다.
앞선 연구들은 이 경로 위에서 레버를 하나씩 만졌습니다. gatekeeper study가 스토커의 임베딩 모델을 양자화했고 bandit-calibration study가 퓨전 가중치와 임계의 3×3 grid를 arm으로 bandit에 올렸고 goodhart-shift study가 밤마다 편집되는 스킬 텍스트의 train과 holdout 사이 drift를 잴 것입니다. zero-token study는 스킬과 모델 티어 사이 라우팅에 고정 품질 비용을 매겼고, thinking-router study는 선택과 실행 사이 reasoning 토큰 예산을 나눴습니다. 하지만 이 모든 연구에서 스토커 출력을 소비하는 방식은 정해진 규칙, 혹은 조잡한 grid 그대로였습니다. arm, 즉 풀의 어느 스킬을 주입할지를 결과에서 배우는 정책은 없었습니다.
bandit-calibration study의 경험은 여기서 중요합니다. arm을 (τ, w) grid에 두고 binary success reward를 쓰자, 선호 arm의 top-1 rate가 0.581로 기본값 0.558에 불과했고 native-query hallucination은 0.0에서 0.4로 뛰었습니다. grid가 좁고 reward가 이산적이면, 배움은 null을 남깁니다. 이번 논문이 arm을 (τ, w) grid에서 K+1개의 스킬 선택으로 옮기고 reward를 단계된 결과로 바꾼 이유가 바로 이것입니다.
이 gap은 이 계열 밖에서도 마찬가지입니다. contextual bandit와 budget-constrained router 계열은 모델 티어 사이에서 고르지만 retrieved 스킬 사이에서 고르는 일은 하지 않습니다. 이번 논문은 gatekeeper study를 명시적으로 upgrade합니다. 스토커는 그대로 동결 시키고, 그 위에 선택 정책을 학습하는 것입니다. 레버가 점수 단계에서 선택 단계로 이동한 만큼, 같은 하네스·같은 레지스트리·같은 동결 스토커 위에서 비교가 성립합니다.
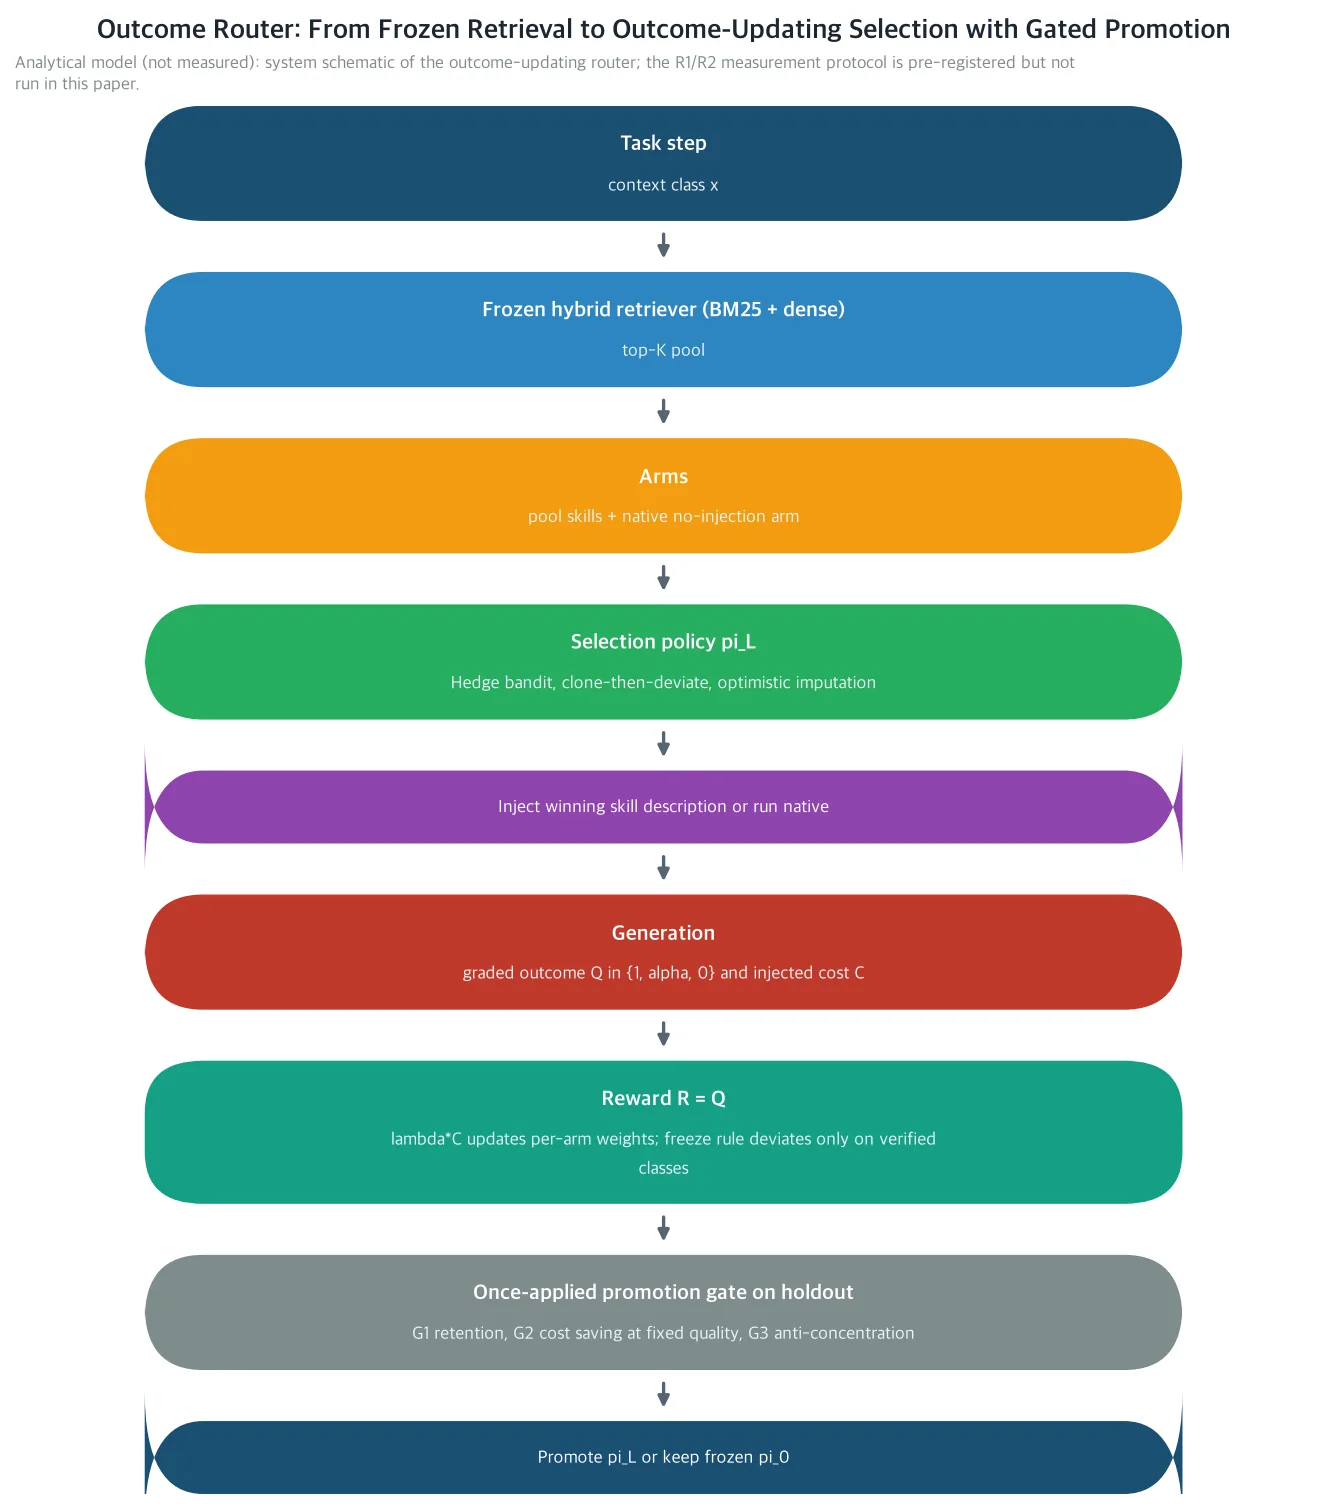 동결 hybrid 리트리버가 arm 풀을 공급하고 선택 정책은 단계된 과제 결과에서 학습되며 한 번만 적용하는 holdout 게이트를 통과한 경우에만 배포되는 구조입니다. (분석 모델이며 실측이 아닙니다.)
핵심 기여 1: clone-then-deviate bandit과 “동결 품질에서는 비싸지 않다”는 frontier
선택 정책을 bandit으로 쓰면, 매 스텝에서 allowable arm은 Ω_t = {1, …, K} ∪ {⊥}입니다. retrieved 풀 5개에 native 비주입 arm을 더한 K+1개입니다. reward는 R_t = Q_t − λ·c(A_t)입니다. Q_t는 단계된 결과로 {1, α, 0}, 성공·중립·실패를 취합니다(α는 0.15로 사전 등록). c(A_t)는 주입된 스킬 설명의 길이, 즉 토큰 수이고 native arm의 비용은 0입니다. λ는 실행 안에서 고정되고 sweep는 {0, 0.005, 0.01, 0.02, 0.05, 0.1} 여섯 값이 각각 별개의 실험입니다.
learning rule은 multiplicative weights(Hedge)에 optimistic imputation을 더한 것입니다. 친 arm의 reward는 관측값 R_t를 쓰고 안 친 arm은 자신의 과거 running max로 imputation합니다. 초기화는 clone-then-deviate입니다. 모든 arm의 가중치를 1로 두면 argmax가 동결 순서 tie-break로 동결 정책 π_0과 정확히 일치하고, 학습기는 출발부터 동결 라우터의 정밀한 클론인 셈.
배포 정책을 정하는 것은 freeze rule입니다. 검증 플레이가 t_min=4회 미만인 context class에서는 언제든 동결 클론 그대로이고 4회 이상 확인된 class에서만 argmax arm으로 바뀔 수 있습니다. 모든 이탈이 검증된 결과에 attributable하며 unverified mass에서는 학습기가 아무리 움직여도 배포에는 영향을 주지 못합니다. exploration ε_t = K/(t+K)는 weight 추정만 채웁니다. registry churn이 일어나면 해당 스킬의 가중치는 ρ_w=0.97로 decay하고 학습기는 레지스트리가 바뀌는 것과 같은 스케줄로 잊습니다.
| 이 구조가 in-sample에서 보장하는 것은 Proposition regret와 Corollary frontier입니다. 학습 라우터의 기대 reward는 hindsight 최적 reward에서 O(Δ_r·√( | S | ·K·ln K/T)) regret만 뺀 값 이상이고, Δ_r = 1 + λ·C_max, | S | 는 seen class 수, global 변종은 O(Δ_r·√(K·ln N/T))입니다. 동결 정책 π_0이 정책 공간의 고정 member이므로, 같은 regret만 뺀 값 이상으로는 동결 reward도 넘습니다. 이 reward 우위를 고정 품질로 번역하면 frontier containment가 됩니다. |
c_L(q_0) ≤ c_0 + ρ_λ/μ_λ + o(1)
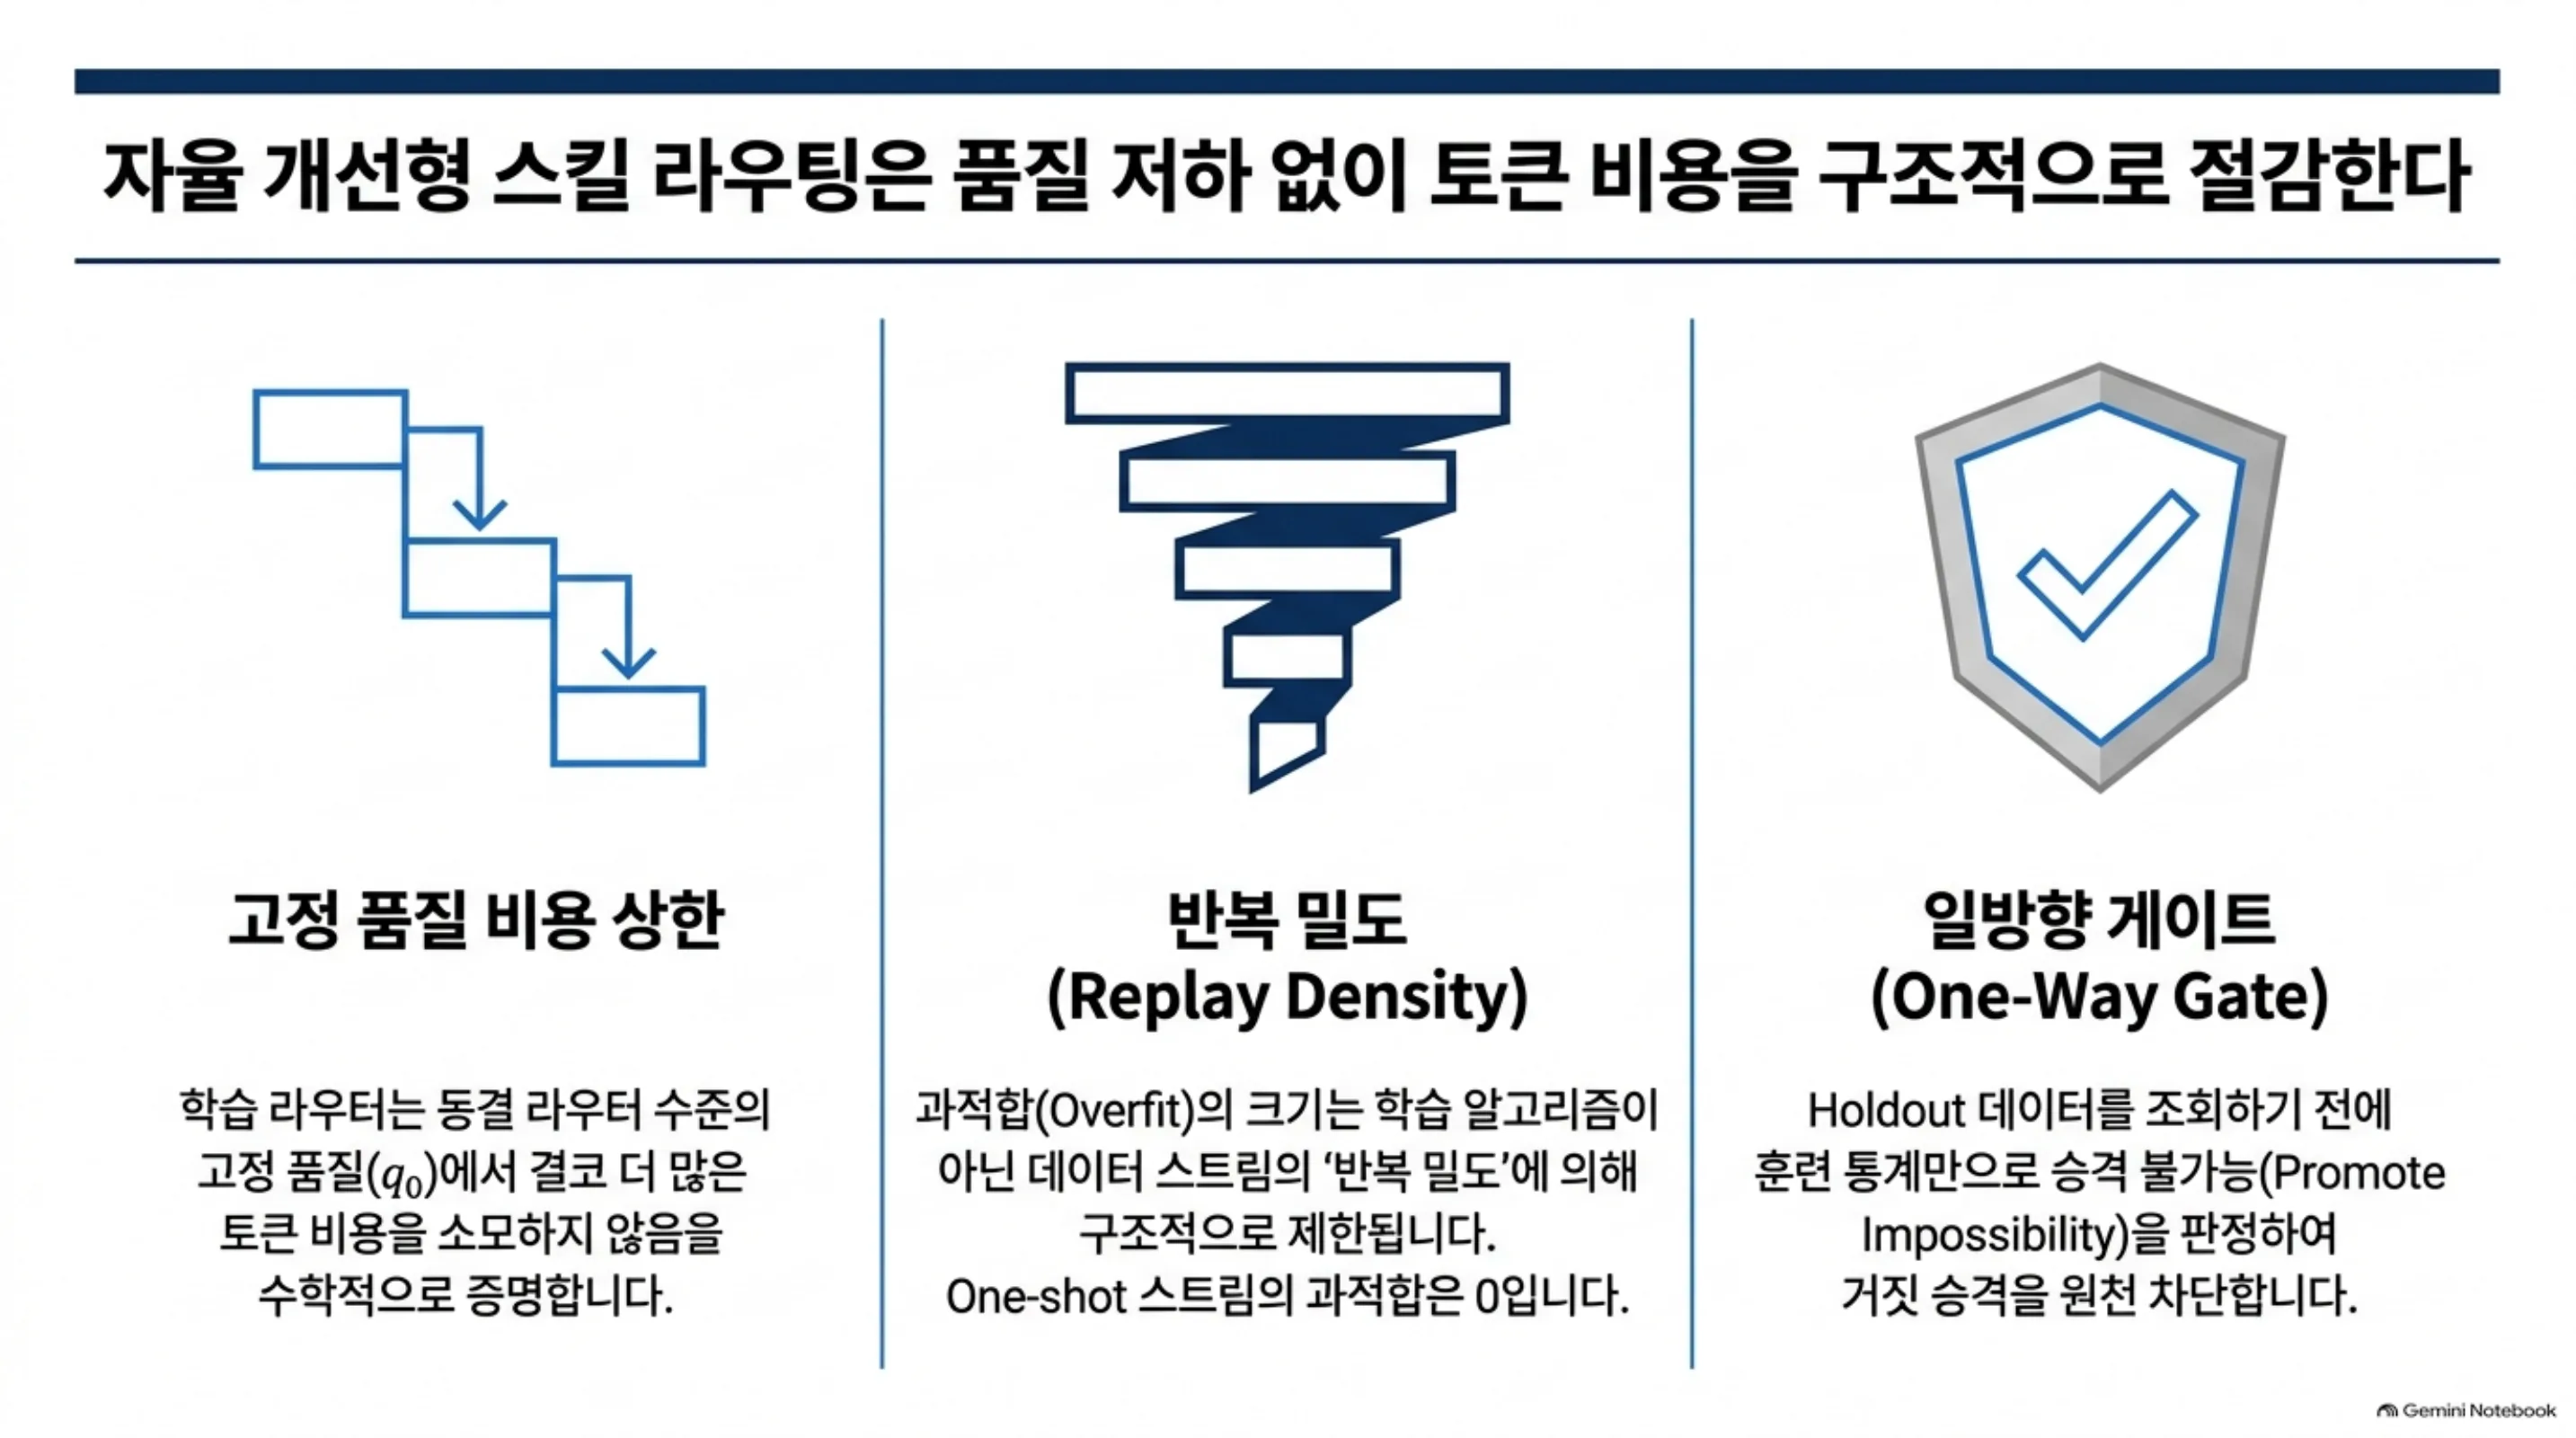
μ_λ = (q_0 − q_lo)/c_0는 동결 family의 slope margin입니다. 이 부등식의 1차 항이 이 논문의 첫 번째 주장이기 때문. 동결 품질 q_0에서 학습 라우터는 동결 라우터보다 비싸지 않습니다. 절감은 2차 항이고 그 2차 항은 Corollary cost가 세 항으로 분해합니다. (a) de-injection, misroute된 스킬의 주입 자체를 없애는 것(W_0·c̄inj). (b) gold 내부 substitution, gold 플레이에서 풀 안의 더 짧은 gold 스킬로 갈아타는 것(ρ_eq·Δc̄+). (c) quality surplus, 학습 정책이 남긴 품질 여유로 gold 주입을 더 없애는 것((q_L − q_0)·c̄_gold). near-duplicate 스킬 family가 없고 surplus가 작다면 (a)가 지배할 것입니다. 고정 품질의 경제학은 결국 “잘못된 스킬을 주입하지 않는 것”으로 환원되는 셈입니다. W_0, 즉 frozen misroute 질량,은 레지스트리가 크면 클수록 커지는 frozen 리트리버의 recall·top-1 miss 구조에 의해 결정됩니다.
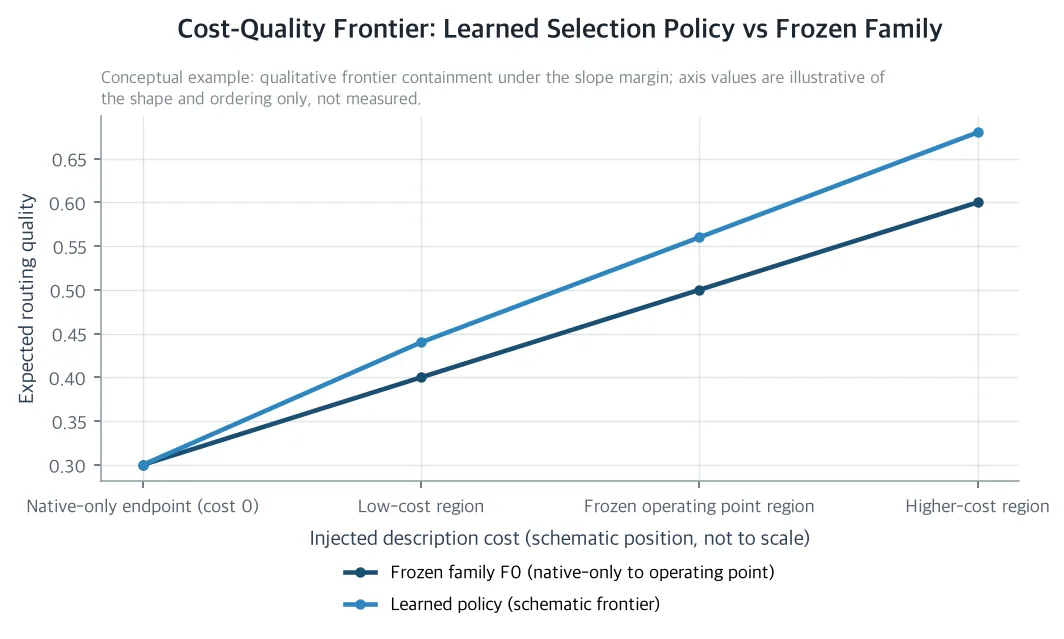 운영점 부근에서 학습 정책의 도달 가능 영역이 동결 family보다 약하게 위에 놓여 있어, 동결 운영 품질에서는 학습 라우터의 비용이 동결 라우터보다 커지지 않는다는 개략도입니다. (분석 모델이며 실측이 아닙니다.)
핵심 기여 2: holdout으로 가는 비율은 스트림의 replay 밀도가 정한다
in-sample bound는 “배우면 손해가 없다”까지만 말해 줍니다. 무인 환경에서 진짜 중요한 질문은, 그 apparent gain 중 holdout, 즉 안 본 context에 실제로 넘어가는 비율이 얼마인지입니다. 논문의 답은 두 단계를 이어 붙인 bound로 옵니다.
Φ = G_ho / G(λ; D_ho) ≤ P(S)·G_S/G*_ho + o(1) ≤ P(S) + o(1)
Φ는 holdout hindsight-oracle gain, 모든 arm을 사후에 가장 잘 골랐을 때의 gain,에서 final policy가 실현한 비율입니다. P(S)는 holdout law가 “학습에서 t_min회 이상 본 context class”에 차지하는 질량이고, G_S/G_ho는 per-unit gap ratio입니다. 등록된 기본값은 unseen class의 per-unit gap이 seen class를 넘지 못한다는 가정(G_U ≤ G_S)이기 때문, 비율은 1로 단순해진다. 그리고 P(S) 자체가 학습 스트림의 통계로 bound됩니다.
P(S) ≤ (1+κ)·T_rec / t_min + o(1)
T_rec은 2회 이상 반복된 class의 학습 플레이 질량이고 κ는 regime 상수입니다(A3’: seen set 안에서 p_ho(x) ≤ (1+κ)·p_tr(x)). 이 bound의 핵심은, holdout을 한 번도 돌리기 전에 학습 스트림의 class별 플레이 카운트만으로 계산된다는 것입니다.
두 bound가 만나는 극단 case가 one-shot 스트림입니다. 모든 class가 한 번만 플레이되면 T_rec = 0이고 S = ∅이며 freeze rule 덕분에 배포 정책은 두 스트림 모두에서 동결 클론과 동일합니다. apparent gain도 overfit gain도 promote할 것도 없고 게이트는 이 case를 구조적으로 거부합니다. overfit할 것이 애초에 없는 것입니다.
| train과 holdout의 분산도 같은 논리로 닫힙니다. | G_ho − G_tr | ≤ κ·P_tr(S)·G*_S + O(ρ_t)·(P_tr(S) + P(S)). 이 부등식이 말하는 것은, 과적합의 크기가 학습기의 성질이 아니라 regime 상수 κ와 seen-mass oracle gain의 성질이라는 것입니다. goodhart-shift study가 스킬 텍스트 편집의 train vs holdout drift를 법칙으로 만들었다면, 이번 논문은 그 split을 라우팅 정책 레벨로 확장한 것입니다. “배운 것이 과적합이다”라는 판정을 스트림의 replay 구조로 환원한 것입니다. |
여기에 transfer regime이 하나 더 붙습니다. local(컨텍스트별 가중치)과 global(스킬별 가중치) 두 변종은 상보적인 셈입니다. 스킬 분리성 가정(A4) 아래, 지속되는 스킬 core와 밤마다 흐르는 periphery가 교차하는 churn regime에서는 global 가중치가 class 특화 질량을 transferable 스킬 지식으로 바꿉니다. disjoint regime, 레지스트리 content가 반씩 분리된 경우,에서는 스킬 overlap 질량 P_ov ≈ 0이라 global의 우위가 slack으로 줄어든다는 뜻입니다. 둘 중 하나가 uniformly 우월하지 않으므로, D5 설계 규칙은 둘 다 학습하고 둘 다 게이트에 넘기도록 합니다.
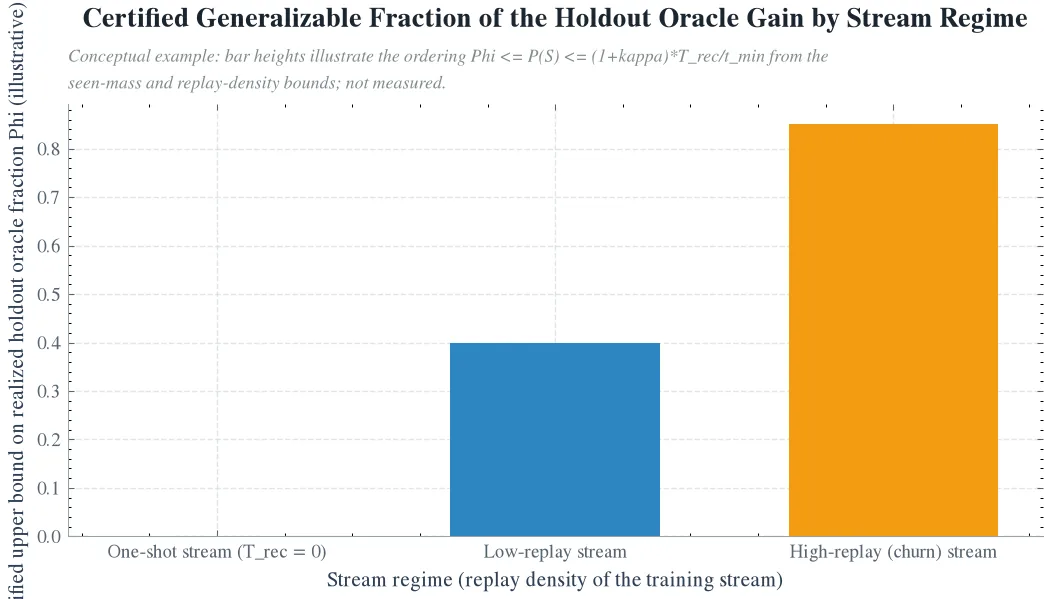 학습 라우터가 holdout hindsight-oracle gain의 어느 정도를 실현할 수 있는지, 인증된 비율이 학습 스트림의 replay 밀도 (1+κ)·T_rec/t_min에 따라 올라가고 one-shot 스트림에서는 0이 되어 라우터가 동결 클론 그대로 머무는 개략도입니다. (분석 모델이며 실측이 아닙니다.)
한 번만 닫는 게이트: holdout을 열기 전에 reject를 판정할 수 있다
learned policy가 동결 policy를 대체하는 순간은 정확히 한 번입니다. 게이트는 세 조건을 동시에 요구합니다. G1 retention: holdout에서 실현한 gain이 추정 holdout oracle gain의 γ = 0.4배 이상일 것. G2 fixed-quality savings: holdout에서 고정 품질 q_0의 비용이 동결 비용의 (1 − δ), δ = 10% 이하일 것. G3 anti-concentration: 어느 하나 context class도 전체 holdout gain의 ρ = 30% 넘게 기여하지 말 것.
이 게이트의 특징은 calibration입니다. A1-A3’와 추정 concentration 아래, G1이 high probability로 통과하려면 P(S) ≥ γ − o(1)이 필요하고 replay density bound를 결합하면 (1+κ)·T_rec/t_min < γ일 때 게이트는 G1을 확률 1 − o(1)으로 실패시킵니다. R1, 학습 스트림,만 끝난 뒤 R2, holdout,에 손대기 전에 “promote 가능성이 구조적으로 없다”를 판정할 수 있습니다. gate 자체가 Goodharting되지 않도록 λ·η·ε schedule·t_min·ρ_w·γ·δ·ρ까지 hyperparameter 전부를 사전 등록하고, 게이트 적용 이후의 재학습·재조정·holdout 2번째 look은 금지입니다(D6).
threat model도 함께 명시됩니다. 거짓 promote에는 (i) 충분한 seen holdout 질량, P(S) ≥ γ, 과 (ii) seen class 내부의 adversarial shift, grade 조작이나 grader hacking, 이 동시에 필요합니다. (i)는 one-shot 또는 low-replay 스트림에서 앞의 bound가 막아 주므로, 남은 위험은 (ii)이며 G3의 concentration cap이 그 잔여 위험을 제한합니다. “성공 경험에 중독된 스킬 몇 개의 high-grade 플레이가 learned 가중치를 장악한다”는 poisoning 공격에 대한, 선택 단계 방어입니다.
frontier가 뽑아내는 설계 규칙 D1-D7도 함께 등록됩니다. 강 baseline의 clone-then-deviate와 certified deviation(D1), arm이 곧 learning unit(D2), 단계된 reward(D3), 정책 레벨 split의 사전 등록(D4), local·global 병행 평가(D5), 게이트 one-shot 후 freeze(D6), churn에서의 decay(D7).
ThakiCloud, 작은 팀, 그리고 과학에 남는 것
ThakiCloud AI 플랫폼에 이 논문이 주는 것은 비용 최적화의 구체적인 경로입니다. 2,000개 이상 스킬 레지스트리에서 라우팅 정책이 과제 결과, 성공과 비용, 피드백으로 자율 진화하면, 동결 라우터 대비 토큰 비용을 줄일 수 있습니다. 고정 품질에서의 “비싸지지 않는다”는 보장과 절감의 3항 분해가 그 구조이고 sra_bench 하네스와 frozen-holdout 게이트가 있는 repository 인프라 위에서 이를 즉시 실측하고 promote 판단을 할 수 있습니다. R1은 레지스트리 앞반에서 250 synthetic keyword-rich task + 50 real labeled task, R2는 뒤반에서 harder keyword mix의 고의 distribution shift + 50 holdout task입니다. M1-M6 메트릭, 고정 품질 비용·train-holdout 분산·seen mass와 replay density·실현 Φ·학습 동역학·게이트 판정,까지 protocol은 사전 등록되어 있습니다.
일반화 검증 기준을 내장한 self-improving 라우터 설계는 작은 팀에게도 열립니다. 무인 자동화의 토큰 비용과 그 뒤의 에너지 비용은 scale이 클수록 플랫폼의 비용이 되며 “결과 피드백으로 학습하는 라우터가 과적합되는지 추적 가능한 평가 방법론”이 공유되는 것은 신뢰할 수 있는 자율 에이전트 확산의 infra가 됩니다.
과학적으로는, 동결 라우터의 비용-질 frontier 측정, Zero-Token Routing 계열,에서 학습 축과 train-holdout 분화 축을 동시에 bound한 첫 사례입니다. streaming task 환경에서 routing policy 학습의 일반화 한계와 overfit 크기를 정량화하는 새 지식을 주며, 그 핵심 문장은 “apparent gain 중 인증 가능한 상한이 스트림의 replay 밀도다”입니다.
한계: 부등식 위의 model 추정, 그리고 실행 전의 유효성 위협
이 논문의 모든 frontier 값은 명시된 가정, A1 per-context reward independence, A2 fixed λ, A3’ seen-set domination, A4 skill separability, 아래 model 추정입니다. 본 논문은 새 실측을 보고하지 않습니다. A3’는 seen set에서만 성립한다고 쓰고 unseen mass에서는 검사되지 않았으며 모든 unverified mass에서 동결 클론을 배포하는 freeze rule이 그 안전장치입니다. gate threshold γ·δ·ρ도 a priori로 설정된 값이고 R1/R2 protocol은 등록은 되었지만 이 논문 안에서 실행되지 않았습니다.
실행 단계의 유효성 위협도 함께 등록되어 있습니다. quality grade는 LLM judge에서 나오므로 grader noise가 게이트 판정(M6)에 상속됩니다. P(S)는 context class discretization에 민감해서 protocol은 두 가지 discretization을 등록하고 bound를 둘 다 읽어(M3)야 합니다. cost model은 context composition effect를 무시하고 single-gold annotation은 tool retriever의 능력을 과소평가한다는 지적이 있어 M2의 분산은 그것을 전제로 읽습니다.
그래도 방향은 명확합니다. 부등식이 정한 경계, 학습은 손해가 없고 overfit은 regime의 성질이며 게이트는 holdout을 열기 전에 reject를 판정할 수 있다, 위에서 프로토콜을 실행해서 그 상한이 실제 스트림에서 어디를 찍는지 확인하는 일입니다. 이번 논문은 그 실행의 설계도와 사전 등록서입니다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있습니다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-08-outcome-feedback-skill-router