침묵하는 리라우트: 스킬 설명 한 줄이 바뀌면, 건드리지 않은 과제의 행선지도 바뀐다
ThakiCloud의 프로덕션 에이전트 하네스는 밤마다 자기 스킬 설명을 다시 씁니다. 그 설명은 자연어 턴 하나하나를 약 2,200개 스킬 중 하나로 라우팅하는 hybrid 라우터의 유일한 라우팅 신호. 자기 스스로를 고치는 에이전트 레지스트리, MCP 도구 레지스트리든, 플러그인 스토어든, 프롬프트 라이브러리든, 그 무인 실행의 비용을 책임지는 클라우드·AI 엔지니어라면 이 글을 읽어야 합니다. 편집한 스킬이 여전히 잘 라우트되는지가 아니라, 편집이 건드리지 않은 과제들에 무엇을 했는지가 이 글의 질문이기 때문. 그 변화는 현행 회귀 게이트에서 보이지 않는다. 이 논문은 그 침묵하는 리라우트(silent reroute)를 법칙으로 재고 병합 전에 잡는 게이트를 준다.
문제의식: 게이트는 편집된 스킬만 보고 나머지는 침묵한다
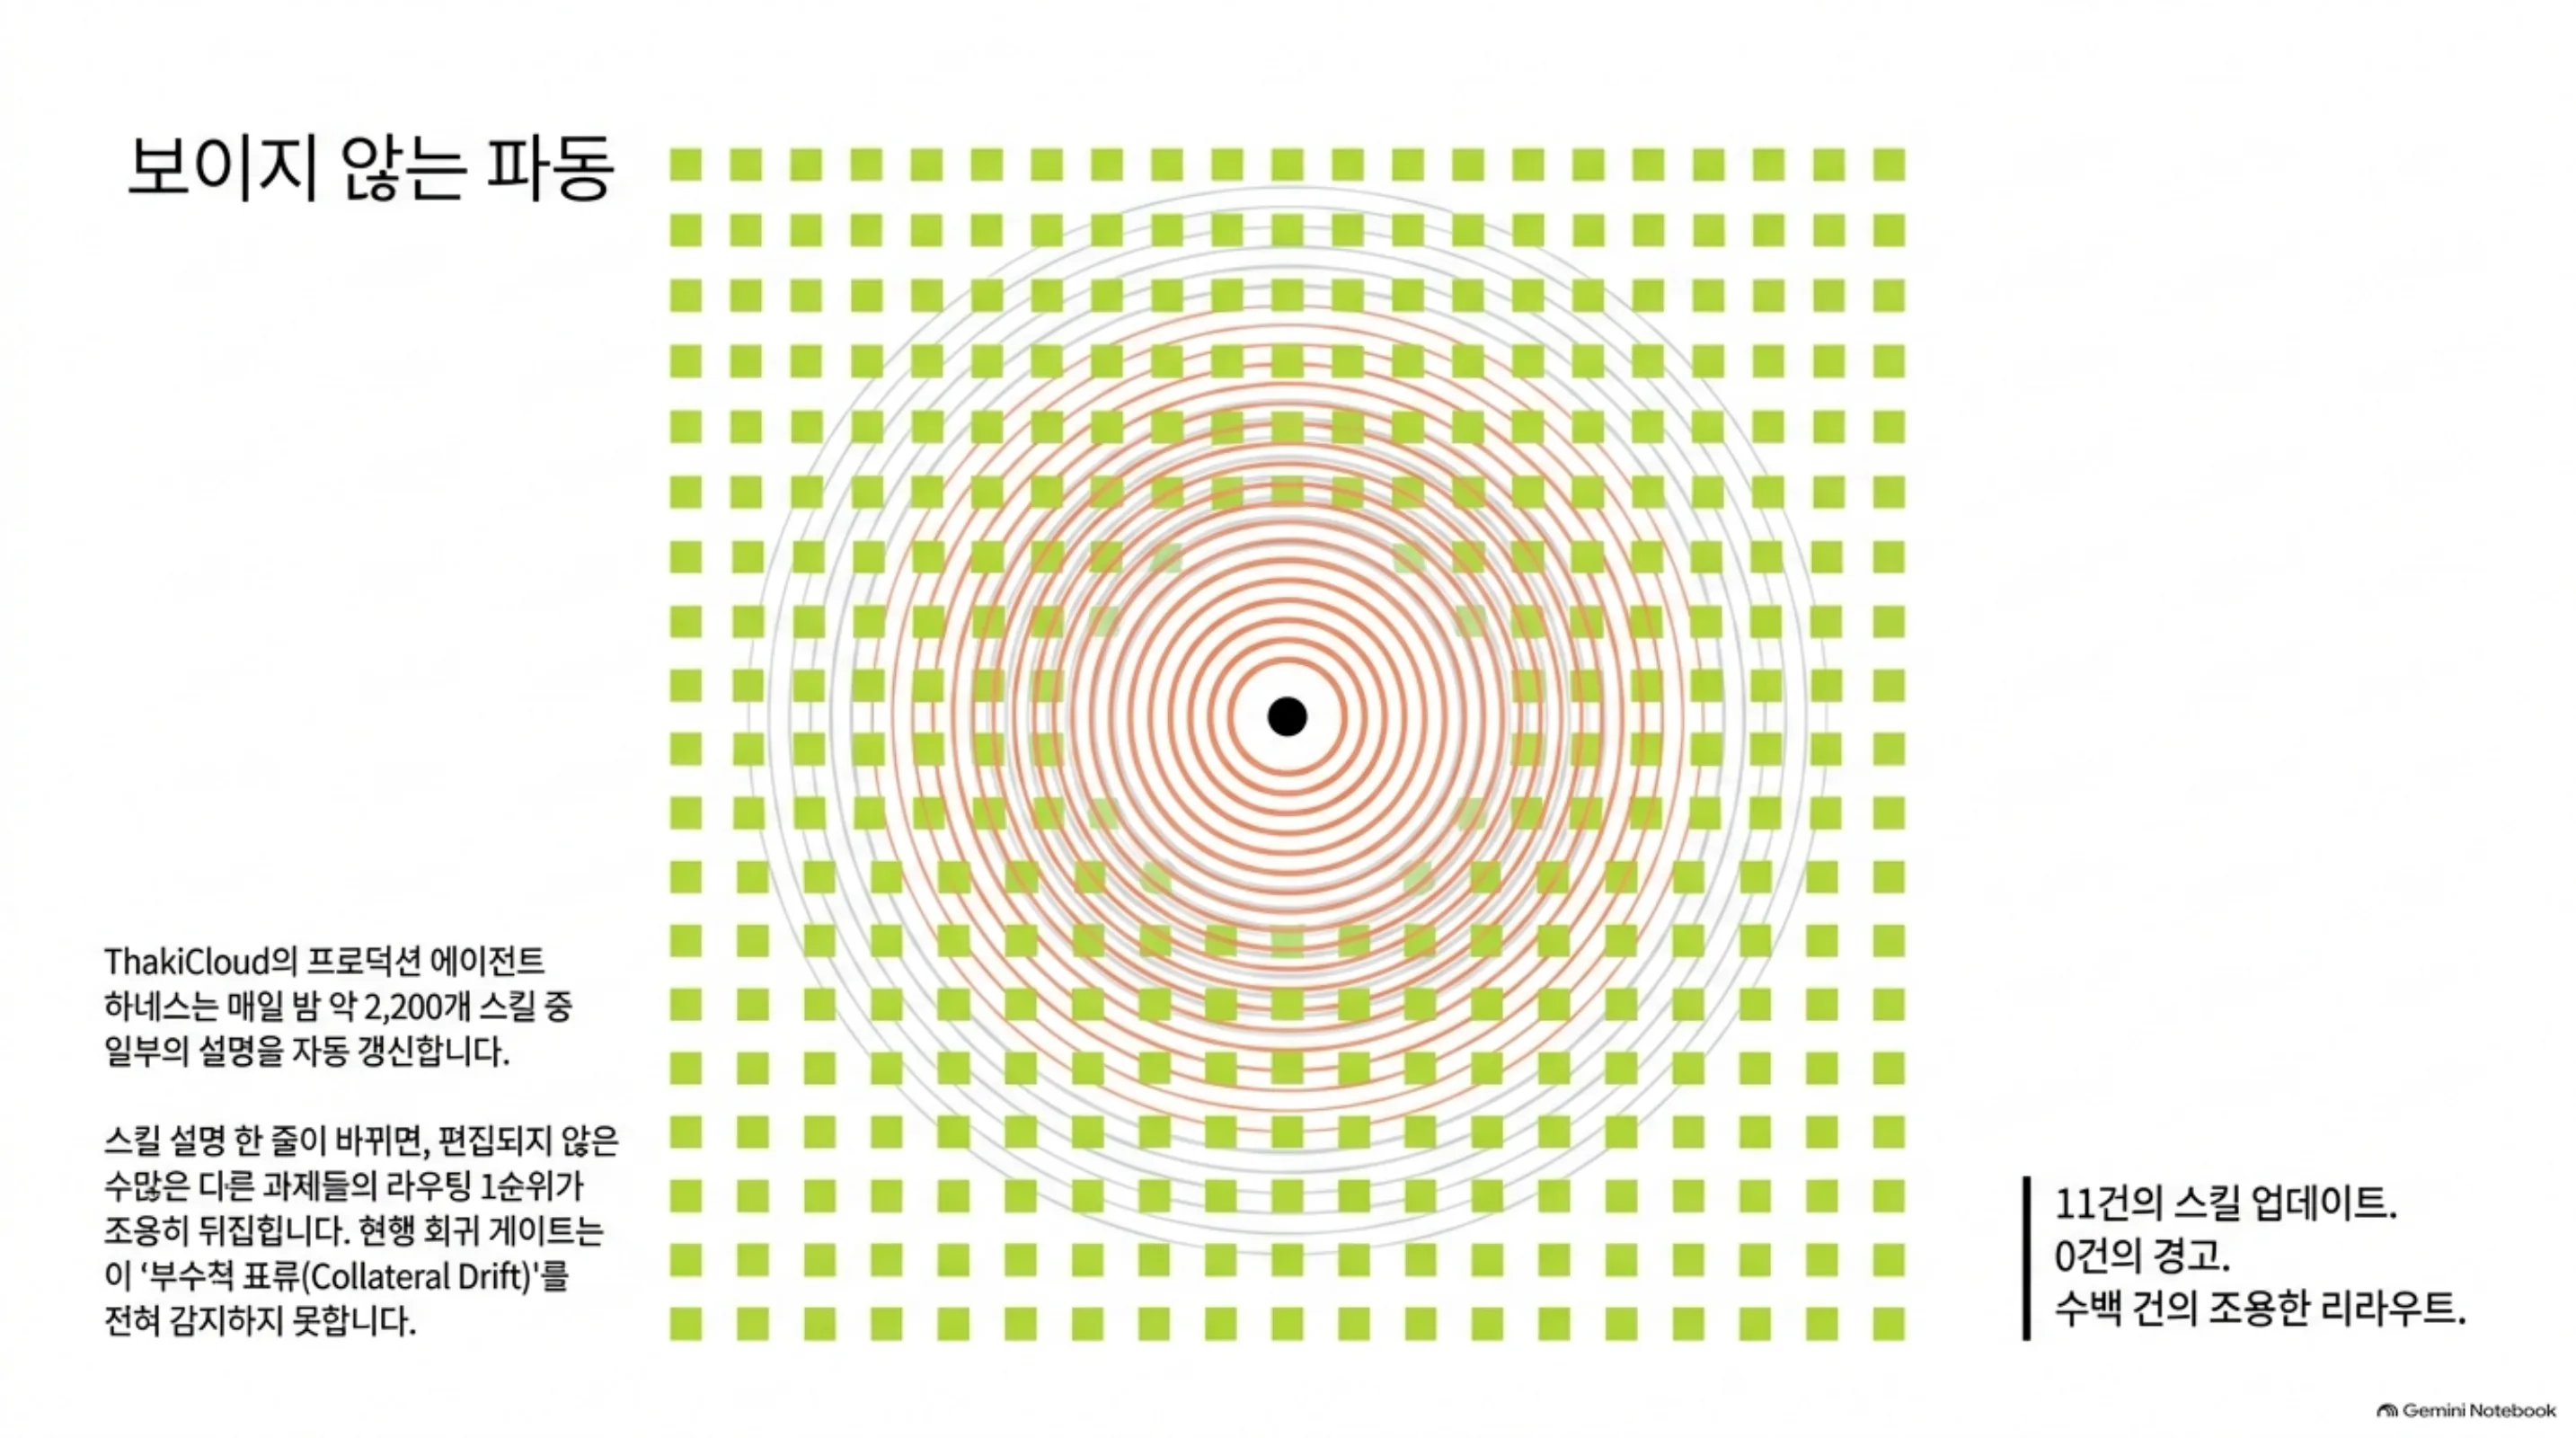
레지스트리는 7월 약 1,600개에서 10월 약 2,200개로 자랐고 그 사이 밤마다 돌던 커레이터 스윕은 이미 11개의 SKILL.md 설명을 새로 썼다. 무인으로 돌았고 게이트에는 보이지 않았다.
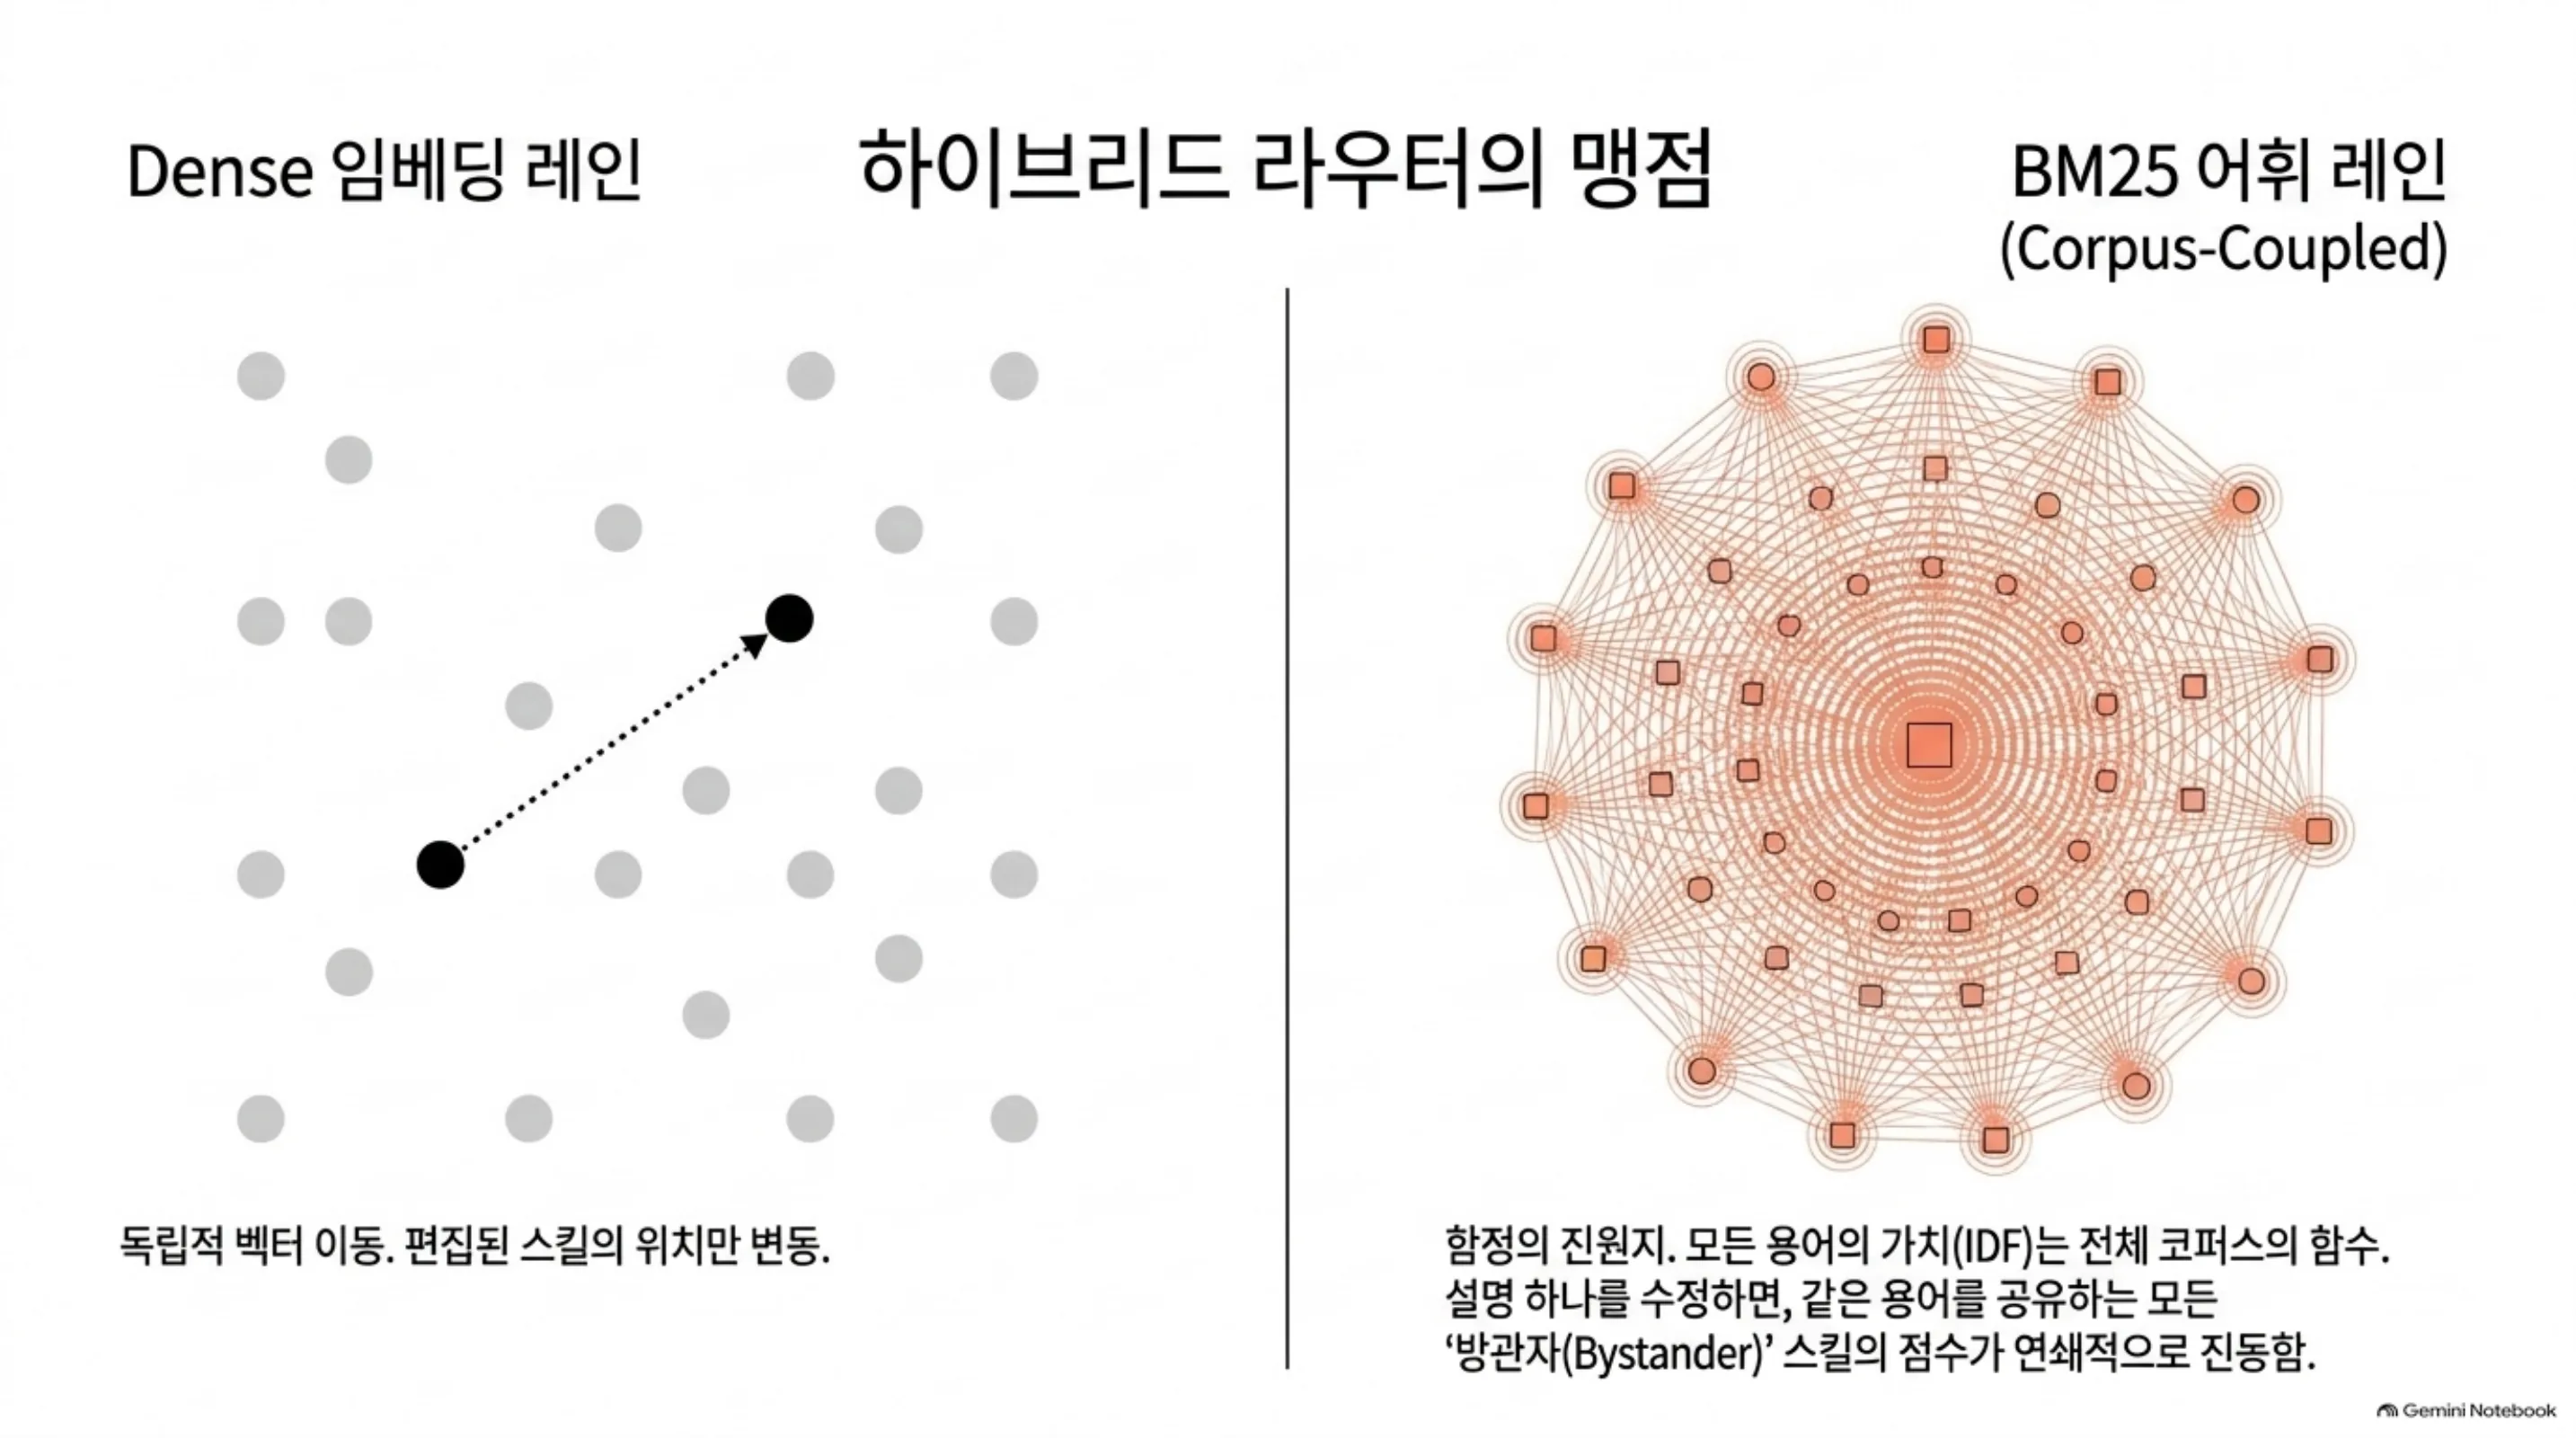
플릿이 믿는 라우터는 hybrid인 셈이다. BM25 어휘 레인과 임베딩(dense) 레인을 rank level에서 reciprocal rank fusion(RRF)으로 합친다. 두 레인 모두 설명을 읽는데, 레지스트리 쪽만의 메커니즘이 바로 여기에 있다. 어휘 레인은 코퍼스 결합(corpus-coupled)인 것이다. 모든 용어의 idf는 전체 스킬의 용어 빈도의 함수이기 때문에, 설명 하나를 다시 쓰면 같은 용어를 가진 모든 bystander 스킬의 어휘 점수가 모든 쿼리 위에서 함께 움직인다. dense 레인은 편집된 스킬의 임베딩만 움직인다. 어느 쪽 움직임이든 gold 스킬을 한 번도 건드리지 않은 과제의 top-1 결정을 뒤집을 수 있다. 논문은 이것을 collateral drift라 부른다.
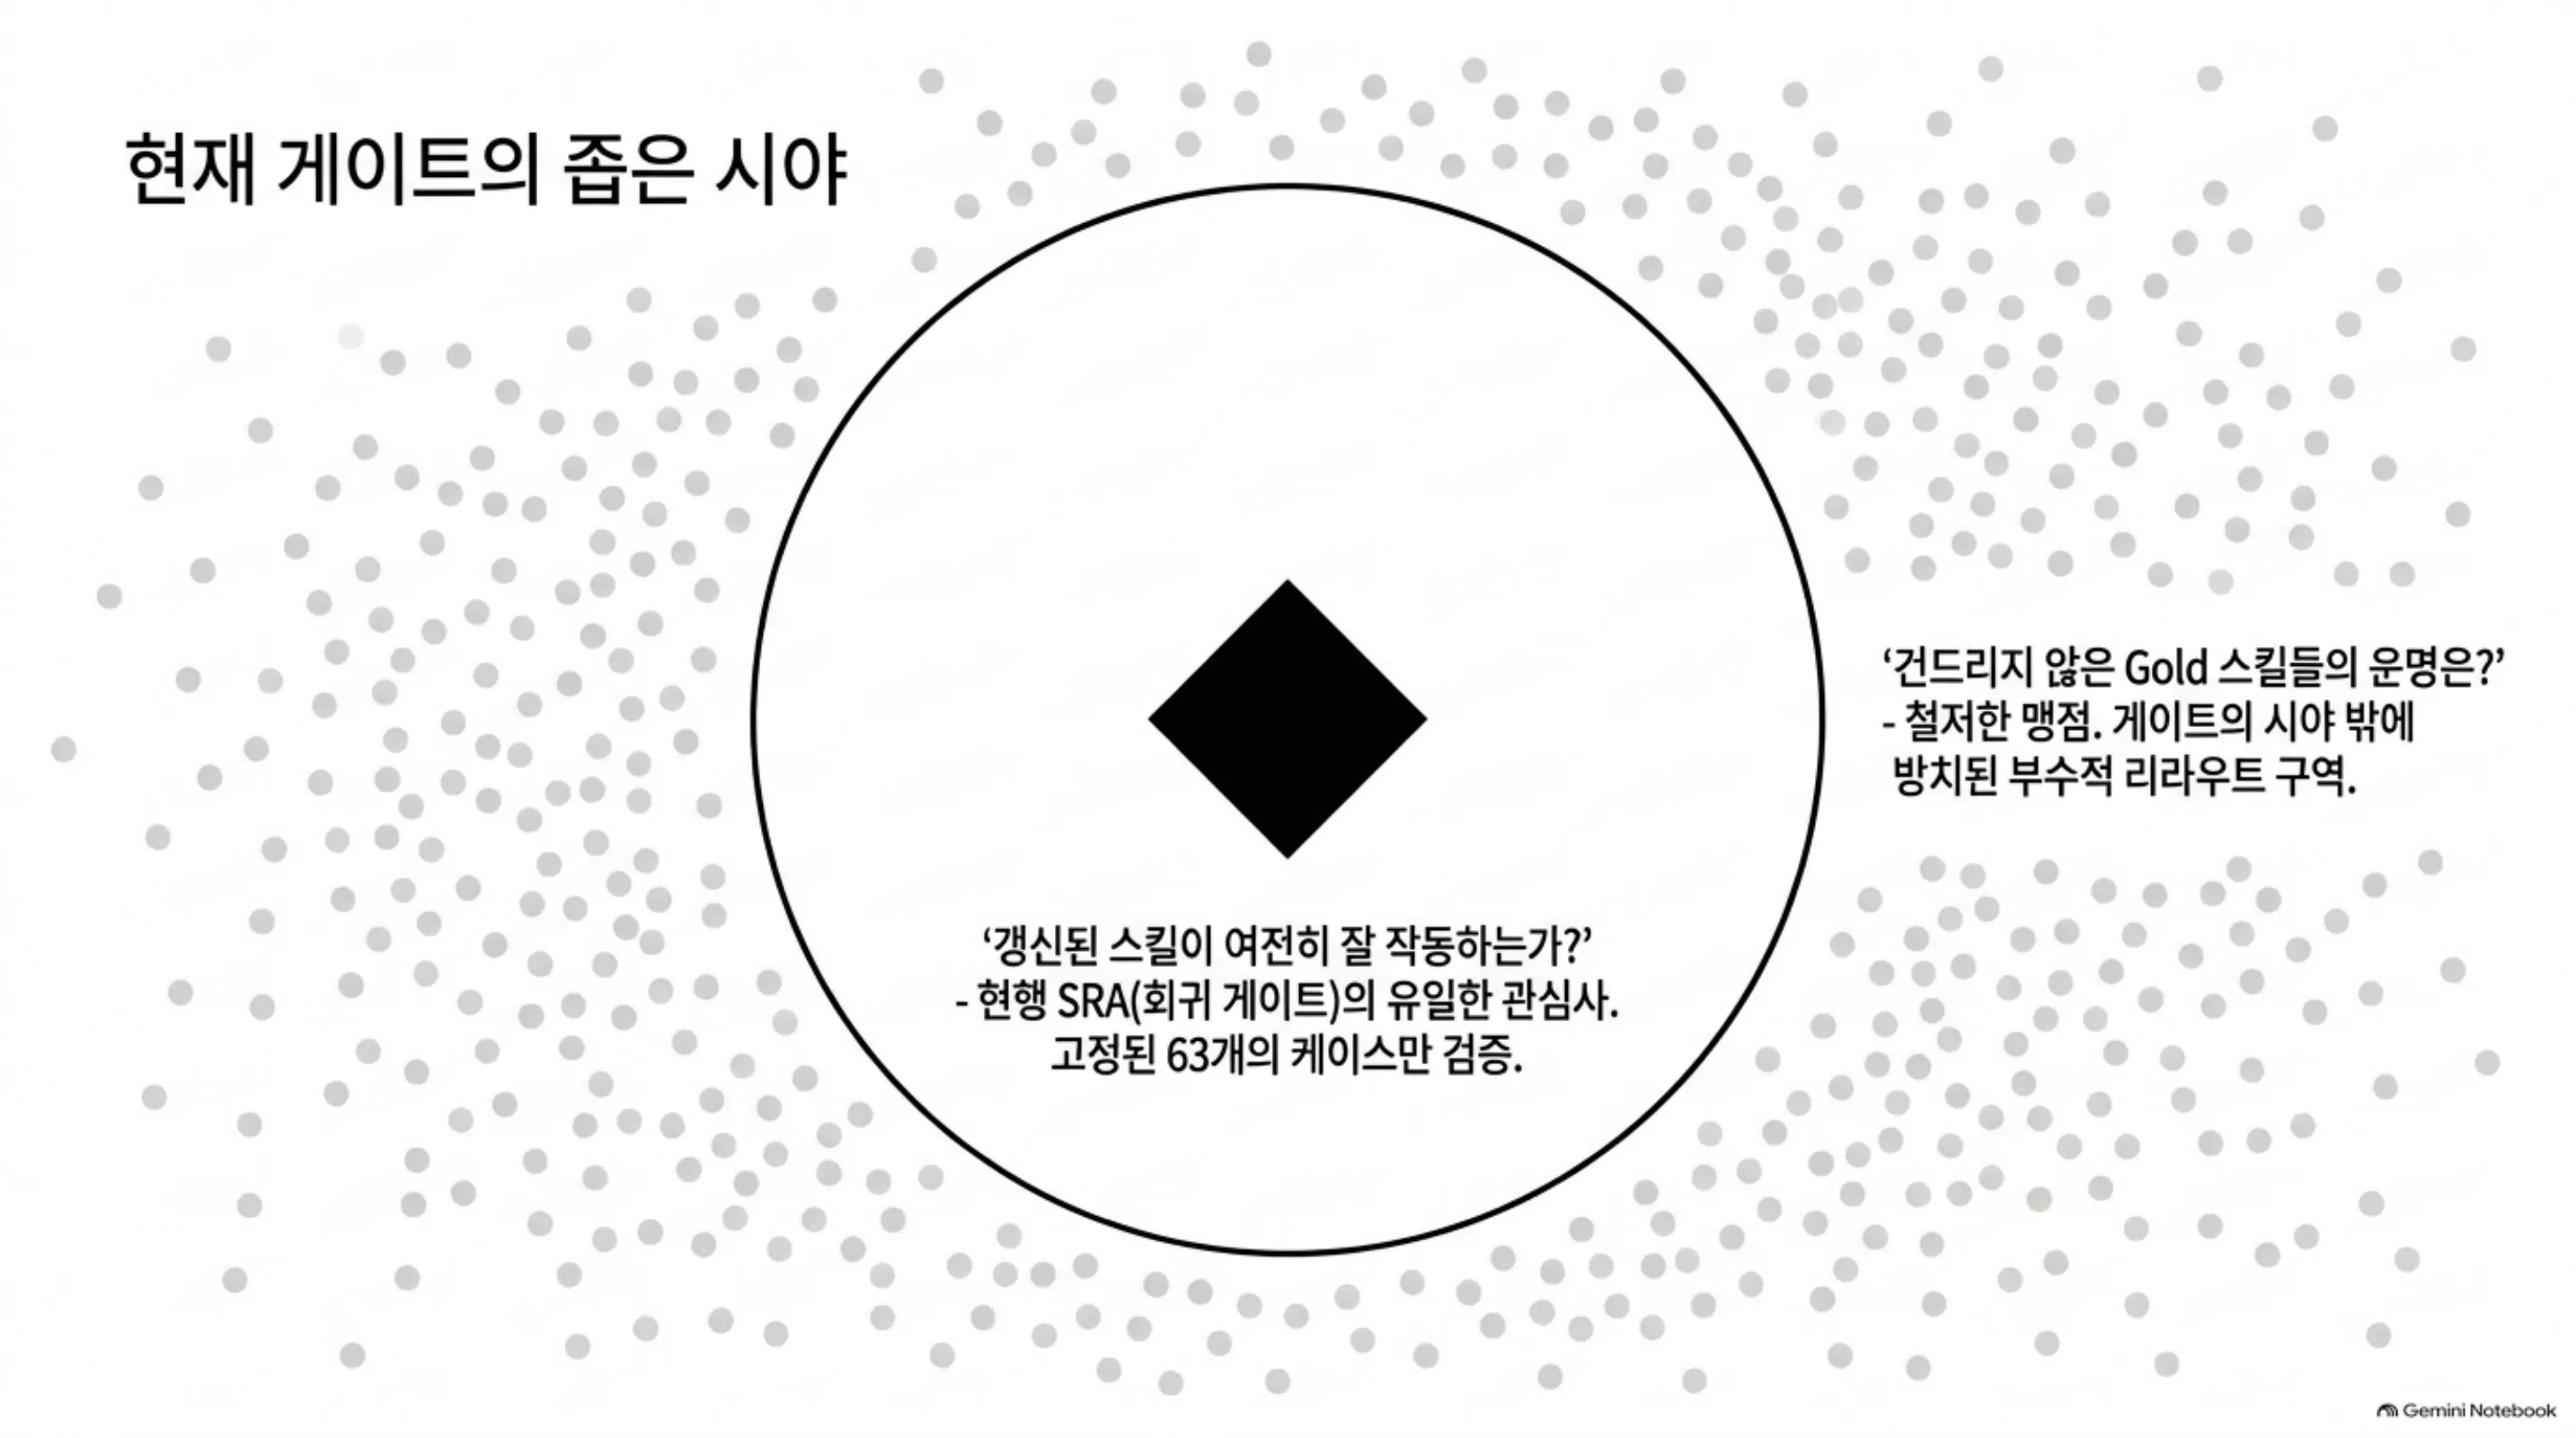
현행 회귀 게이트(SRA)는 갱신된 레지스트리를 고정된 63케이스 골든 suite로 다시 점수 매기지만 갱신된 스킬이 여전히 라우트되는지만 보기도 한다. 건드리지 않은 gold 스킬의 부수적 리라우트는 게이트의 시야 밖에 있다. 스윕이 병합되고 리라우트가 출하되고 플릿의 행동이 조용히 바뀐다. 이 논문은 앞서 ‘Quantizing the Gatekeeper’의 명시적 한 단계 업그레이드인 것이다. 그 논문은 dense 성분의 교란에서만 단일 쿼리의 top-1 rank safety를 상한으로 가둘 수 있다는 것을 보였다. 이번에는 교란 축을 모델 쪽에서 레지스트리 쪽으로 옮기고, 피해자를 편집된 쿼리 하나에서 모든 나머지 과제로 바꾼다. 두 연구는 같은 위험 화폐를 쓴다. dense 레인의 변위를 2위와의 마진에 놓고 재는 것이 그것이다.
핵심 기여: 편집 거리와 유형, 레지스트리 크기의 함수인 drift 법칙
논문의 중심은 1차 collateral drift 법칙이다. 기대 부수 top-1 플립률을 편집의 의미 거리, 편집 유형(paraphrase, semantic shift, truncation), 레지스트리 크기 N의 함수로 쓴다. 법칙은 기록된 생산점에 보정된다. N=2,029, top-1 0.489, Recall@5 0.867, 생존 곡선 P_top1(N)=0.867·e^(−2.83×10⁻⁴·(N−1)). 논문 전체의 수치는 이 기록 앵커이거나, 그 위의 1차 산술이거나, 모델 예측으로 표기된 값입니다.
hazard-margin 모델에서 스케일 법칙이 나옵니다. diffuse dense channel drift는 N·e^(−p(N−1))에 비례하고 이 함수는 N*≈3,535에서 최대입니다. 기록된 스케일로 환산하면 g(2,200)/g(1,600)≈1.16. 같은 스윕 하나가 7월보다 지금 약 16% 더 많은 diffuse 부수 drift를 일으킨다는 뜻이고 레지스트리는 drift 곡선의 상승 단에 있습니다. 모델 예측임을 붙여 두는 것입니다.
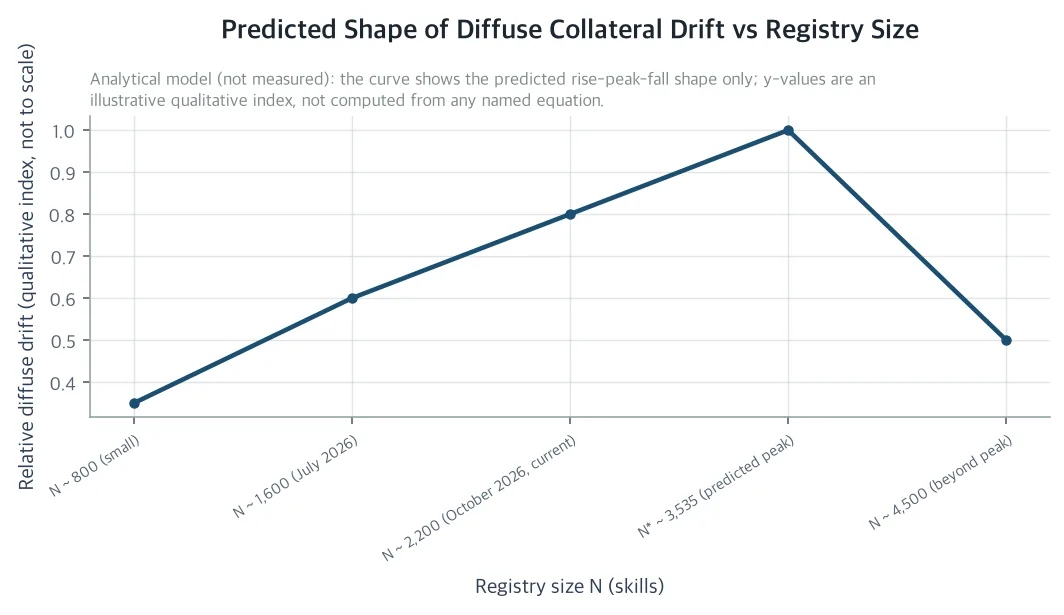 Drift 법칙 예측: diffuse collateral top-1 drift는 레지스트리 크기 N과 함께 올라가 N≈3,535 부근에서 정점에 이르고 그 이상에서는 내려갑니다. 현재 약 2,200 스킬 레지스트리는 상승 단에 위치합니다. (해석 모델이며 실측이 아닙니다)*
유형 법칙은 중증도 순서를 줍니다. 같은 dense 변위에서 semantic shift ≥ truncation ≥ paraphrase. Paraphrase는 1차 근사까지 idf-중립이라 무해한 noise floor에 앉습니다. Truncation, 곧 대체 없는 삭제는 드묾 용어의 idf를 ≈1/(n_τ−0.5)만큼 끌어올립니다. n_τ가 5에서 2 사이면 0.22~0.67. 같은 용어를 쓰는 bystander n_τ−1개와 그 용어가 들어가는 쿼리 위에 집중되므로, 어휘 레버로는 가장 날카롭습니다. Semantic shift는 큰 dense 변위에 더해, 기존 코퍼스에 없던 추가 용어 하나당 ≈7.29의 targeted idf 항을 얹습니다(N=2,200에서). 주입된 용어가 suite 쿼리와 맞물리면 플립률이 최대가 되고 이는 앞서 registry hijack 논문의 공격 시나리오와 같은 드묾 용어 레버가 커레이터에게는 조용한 리스크가 된다는 뜻입니다.
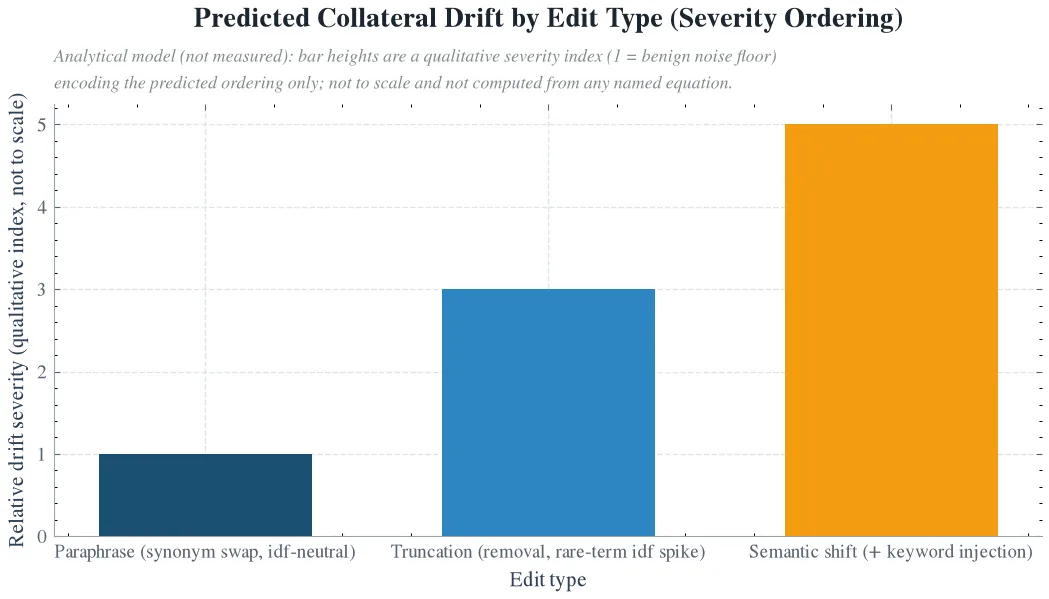 같은 dense 변위에서 기대 collateral top-1 플립은 semantic shift가 truncation, truncation이 paraphrase보다 크며 paraphrase는 무해한 noise floor에 위치합니다. (해석 모델이며 실측이 아닙니다)
세 번째 readout은 침묵 자체입니다. 같은 hazard 논증을 top-5 경계에 쓰면 ΔR@5 ≈ 0.25·F가 나옵니다. 부수 top-1 정확도를 3포인트 뒤집는 스윕이면 Recall@5는 0.75포인트쯤만 움직입니다. recall 중심 모니터링은 레지스트리 편집 drift를 약 4배 과소 판독합니다. 리라우트는 리콜 레벨에서 침묵합니다.
SRA-CI: 병합 전에 라우팅 회귀를 잡는 게이트
drift 법칙이 공학으로 번역되는 지점이 SRA-CI, 병합 전 shadow-routing 회귀 게이트입니다. 그 뒤 산술은 순수 이항(binomial) 산술입니다. 단일 케이스 트리거에서 유효 크기 n의 suite에 대한 게이트 power는 π(n, p_f)=1−(1−p_f)ⁿ. 기록된 suite 크기(63 nominal, 9월 시점 유효 42)에서 power는 p_f=1%일 때 0.469/0.344, 2%일 때 0.720/0.572, 5%일 때 0.960/0.884. 현행 게이트는 부수 과제의 5% 이상을 해치는 스윕은 잘 잡지만 침묵 밴드, 케이스당 1~2% 플립, Recall@5를 1포인트 미만으로 움직이는 스윕은 28~66%의 확률로 놓칩니다. p_f=1%에서 power 95%를 만들려면 n≈299케이스가 필요하고 rate 트리거의 오차 제약 산술도 같은 약 292케이스 설계 점에 닿습니다. 게이트의 suite는 약 300케이스입니다.
| 설계는 실행 가능한 수준까지 구체적입니다. 편집 집합 E를 가진 각 스윕마다, 후보 인덱스를 만듭니다. 편집된 | E | 개 설명만 다시 임베딩하고 어휘 통계는 증분으로 갱신하며 전체 재인덱싱은 하지 않습니다. SRA suite와 collateral suite(gold가 E 밖에 있는 과제)를 baseline·candidate 양쪽 인덱스 아래에서 다시 점수 매기고 drift readout으로 F_top1, ΔR5, 비용 단위의 중증도 가중 플립 질량을 계산합니다. F_top1≥τ_block이거나 단일 플립이 중증도 상한 c_max를 넘으면 차단합니다. 비용이 큰 steal 하나, 오래 실행되는 스킬이나 권한이 높은 스킬 위로의 플립, 는 rate와 무관하게 차단합니다. 아니면 changelog에 routing-impact statement를 붙여 병합합니다. 매일 밤 suite 유효성 감사로 각 gold의 존재와 최적성을 재확인하고 무효 케이스를 퇴역·재빌드하며 유효 suite 크기 n_eff를 telemetric으로 관리합니다. 유효성은 통계의 일부입니다. n_eff=42에서 63케이스 게이트는 p_f=1%에서 power를 13포인트 더 잃습니다. 고정 인덱스 위의 hybrid 라우터는 결정적이므로, 게이트가 보는 것은 표본이 아니라 스윕의 진짜 drift입니다. 비용은 가볍습니다. | E | =11 스윕에 300케이스 suite는 전체 재임베딩 dense 작업의 약 14%이고, churn 주기 약 52일에 분담하면 밤마다 쓰는 재임베딩 예산의 0.3% 미만입니다. |
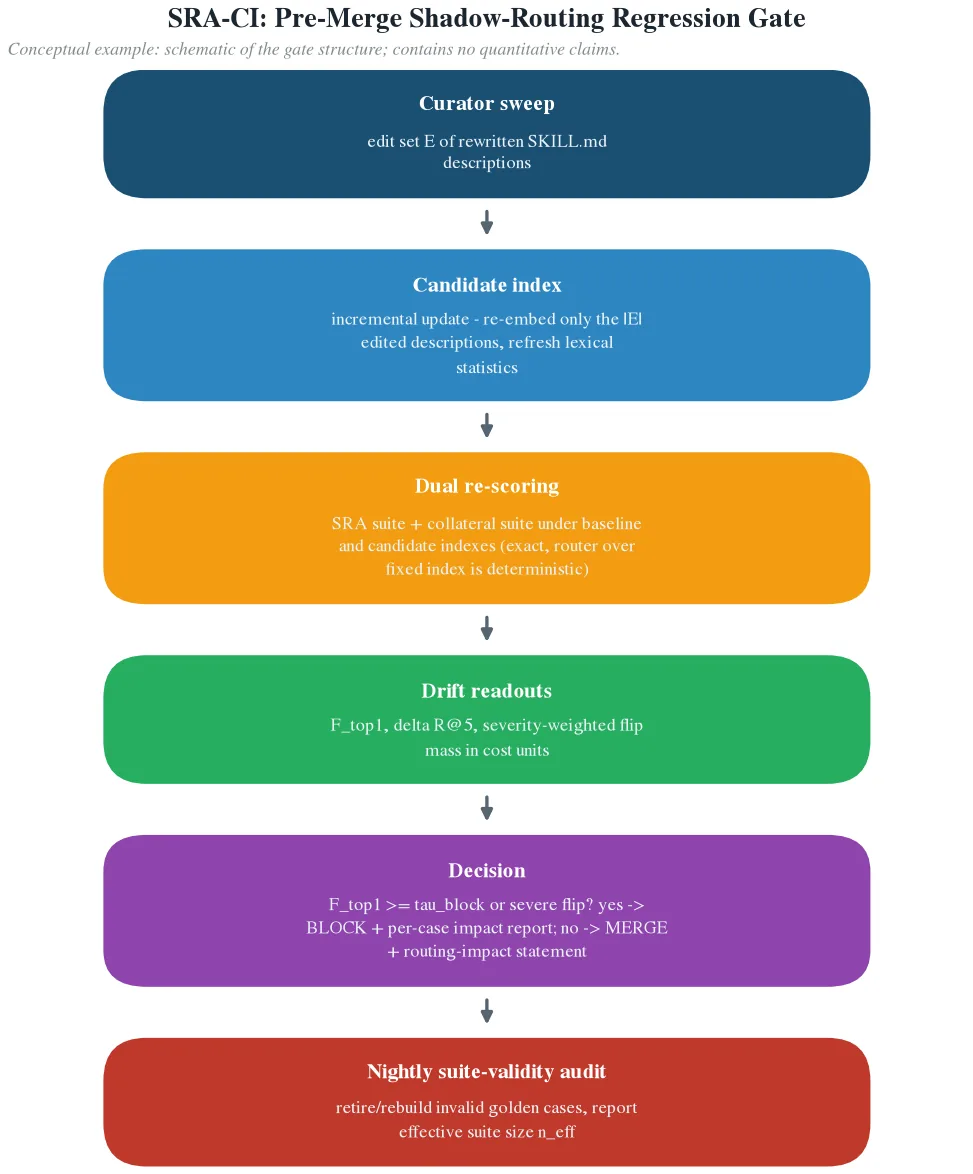 SRA-CI: 각 밤의 커레이터 스윕은 병합 전에 candidate 인덱스 위에서 SRA suite와 collateral suite로 다시 점수 매겨지고, 해로운 설명 편집은 조용히 출하되지 않고 impact report와 함께 차단됩니다. (개념 예시: 게이트 구조 다이어그램이며 정량 주장을 포함하지 않습니다)
회사·사회·과학에 남는 것
회사에는 자기 진화 루프의 병합 전 검사점이 생기는 것이다. 커레이터 스윕마다 candidate 레지스트리로 다시 점수 매기고 부수 top-1 플립률이나 Recall@5 저하가 보정된 임계값을 넘는 편집은 차단됩니다. 지금 블라인드인 설명 churn이 2,200 스킬 하네스에서 CI 점검이 되는 스킬 라우팅이 됩니다. 사회에는 자기 레지스트리를 스스로 고치는 무인 에이전트 플릿이 조용한 행동 변화에 대한 감사 가능한 상한을 필요로 하는 셈입니다. drift 측정 방법론과 최소 회귀 suite는 검색 기반 스킬·도구 생태계, MCP 도구 레지스트리, 플러그인 스토어, 프롬프트 라이브러리, 로 이전됩니다. 이전 논거는 세 가지 구조적 사실 위에 있습니다. 자연어 설명이 라우팅 신호의 본체라는 점, 어휘 레인이 모든 문서의 점수를 모든 용어 빈도와 결합시켜 무해한 편집에도 bystander 효과가 생긴다는 점, 그리고 생태계를 시험하는 고정 골든 suite의 유효성 자체가 줄어든다는 점. 과학에는 레지스트리 쪽 라우팅 불안정성의 첫 통제 측정입니다. 같은 라인의 query 쪽 패러프레이즈 불안정성과 인덱스 staleness 결과와 보완하며 drift 법칙(top-1 플립률 대 편집 거리·유형·크기)과 필요한 suite 크기가 ‘routing regression’, 바뀐 코퍼스 산물이 안 바뀐 입력에서의 라우터 결정 변화를 이르는 것, 을 이름 붙인 신뢰성 차원으로 만듭니다. 그리고 앞선 양자화 연구와 compose합니다. 편집 변위와 양자화 반경은 같은 마진 예산을 가산적으로 씁니다.
한계: 해석 논문이고 1차이고 아직 실측은 아니다
drift 법칙 정리는 dense 변위에 대해 1차입니다. 배치 스윕에는 2차 충돌 항이 있고 무해한 편집에선 과대, clustered injection(히잭 레짐)에선 과소 평가됩니다. neighborhood-mass 스케일링, 각 스킬이 작업 공간의 일정한 몫을 차지한다는 가정, 은 기록된 점이 고정하지 못하는 유일한 가정이고 상수 α는 telemetric으로 보정합니다. hazard-margin 모델은 계보의 constant-hazard fit을 물려받아, 스킬 집단의 구조적 변화가 p를 움직일 수 있습니다. 쿼리 집단은 고정되어 있고, input 쪽 패러프레이즈 플립은 같은 마진에 곱적으로 compose됩니다. 게이트 비용 산술은 모두 측정값이 아니라 계산입니다. 논문은 H1~H5의 반증 기준을 미리 적어 둡니다. 유형 순서, N≈2,200에서 N≈1,600 대비 10~25% 더 많은 diffuse 플립(모델값 ×1.16)과 3,500을 넘은 뒤의 안정화, median ΔR@5가 median F_top1의 0.4배 이하, suite power의 각 플립률별 수치, n_τ≤3 용어 삭제가 median 근소 차이 간극을 넘는 어휘 스파이크를 만드는 것. 게이트가 live가 되면 밤의 스윕 telemetric이 이 해석을 측정으로 바꿔 줍니다.
논문 원문과 데이터: https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-03-silent-reroute-skill-router-drift