The Autonomy Ladder: Kubernetes 인시던트를 복구 복잡도 L1에서 L3으로 층분할하면, 무인 복구가 안전하고 싼 경계는 nominal 시나리오에서 L2까지이며, 그 경계와 인시던트당 비용은 허락 전에 계산할 수 있습니다
집 안 고장을 혼자 고치는 에이전트는 일정 깊이까지만 맡겨도 됩니다. 그 깊이는 비용을 정하는 조건과 안전을 정하는 조건과 함께, 허락을 내리기 전에 계산할 수 있습니다. 이 글은 클러스터 온콜을 맡고 있는 국내 클라우드/AI 엔지니어, 그리고 복구 실행 권한을 어디까지 넘길지를 숫자로 정해야 하는 팀이 대상입니다.
ThakiCloud의 분석 논문, 자율 사다리를 소개합니다. 이 논문은 에이전트가 고장을 사람 개입 없이까지 얼마나 멀리 끌고 가고, 그 대가는 인시던트당 얼마이며, 어디서부터 사람이 루프에 남아야 하는지를 하나의 모델로 묶습니다. 먼저 성격을 짚겠습니다. 이 논문은 새 측정을 포함하지 않습니다. 본문에 나오는 모든 수는 명시된 nominal 가정에 대한 닫힌 형태의 평가이거나, 인용된 참고 문헌의 값에 해당합니다.
논문이 고정하는 것은 모델, 경계 조건, 사전 등록된 측정 프로토콜입니다. 자기 호스팅 클러스터에서의 현장 실측은 후속 연구에서 보고될 예정입니다.
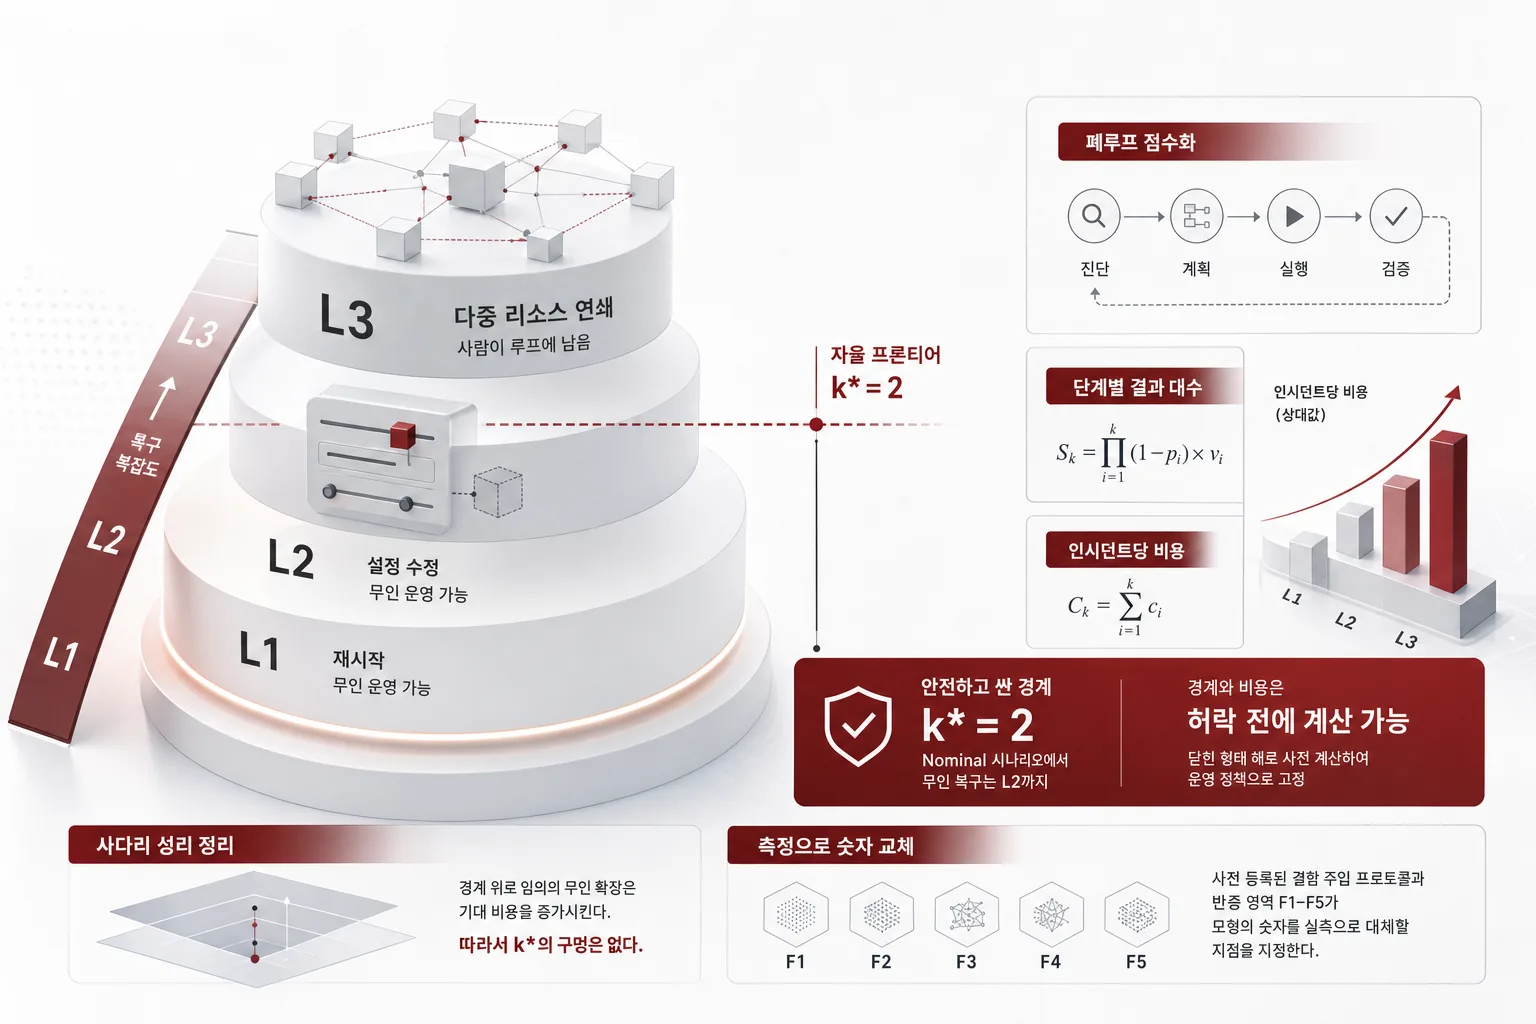 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
집에서 작은 고장을 고치는 법을 배운 아이로 비유하겠습니다. 부모는 온콜을 맡은 사람이고 아이는 에이전트입니다. 고장의 깊이는 세 단계입니다. 가전 하나가 멈춘 단계, 설정이 잘못돼 몇 개가 함께 멈춘 단계, 여러 곳으로 번져 고치는 순서가 중요한 단계입니다.
첫 단계는 단일 리소스 재시작이고, 두 번째는 설정을 고쳐 의존자를 순서대로 재시작하는 것이며, 세 번째는 롤백 계획까지 갖추며 여러 리소스를 순서대로 고치는 것입니다. 깊이가 오를수록 건드리는 곳이 늘어나고 실수의 피해가 커집니다.
대응 방식은 두 가지입니다. 무인(unattended)은 아이가 진단, 계획, 실행, 검증까지 혼자 하는 방식입니다. 인반(attended)은 아이가 진단과 보고만 하고 부모가 승인하고 실행하는 방식입니다. 인반이어도 아이가 정확히 보고하면 부모의 탐색 일은 줄어듭니다. 그 절약을 진단 배당(diagnostic dividend)이라고 부릅니다.
부모의 선은 두 개입니다. 첫째, 비용: 아이가 혼자 처리하게 되면 부모가 아끼는 시간이, 계속 감시하는 비용보다 작아서는 안 됩니다. 둘째, 안전: 아이가 실수해 피해를 남길 확률은 허용도 안에 있어야 합니다. 이 두 조건을 모두 통과하는 가장 깊은 단계가 자율 프론티어 k*입니다.
논문의 명시된 nominal 시나리오에서는 그 선이 두 번째 단계까지입니다. 가전 하나를 재시작하고 설정을 고치는 일은 아이가 혼자 해도 안전하고 싸다는 뜻입니다. 고장이 여러 곳으로 번진 단계에서는 부모가 남아야 합니다.
허락의 순서는 단계를 건너뛰지 않습니다. 아래 단계가 아직 실패하는 동안 위 단계가 통과하는 일은, 이 성질이 허용하지 않습니다. 아이 비유로 하면, 가까운 심부름이 아직 잘 안 되는 동안 먼 심부름을 맡기지 않는 것입니다. 이 성질을 사다리 성리(ladder property)라고 부르고, 그 덕분에 경계에 구멍이 생기지 않습니다.
고장이 드물면 부모의 감시 비용이 커지므로, 선이 한 단계 더 오를 수 있습니다. 그러나 안전의 선은 고장이 얼마나 자주 일어나든 이완되지 않습니다. 안전 선을 움직이는 것은 사고 비율뿐입니다.
즉, 사람 말로는, 집 안 고장 사다리의 둘째 마디까지는 아이에게 혼자 맡겨도 되고 여러 곳으로 번진 고장은 부모가 남아야 하며, 그 경계는 직감이 아니라 허락 전에 계산할 수 있는 값입니다.
무엇을 해봤나
기존 연구가 멈춘 질문
에이전트가 클러스터 API에 접속해 온콜 대응을 한다는 제안은 이미 곳곳에서 작동하고 있습니다. 다중 에이전트 리빌리티 스택 STRATUS는 라이브 워크로드에서 진단과 행동을 수행하며, 최근 에이전틱 AIOps·NetOps 아키텍처 조사들은 자율성 수준을 허용된 도구 표면과 필요한 증거에 묶어 놓습니다.
그래서 남은 질문은 하나입니다. 에이전트가 진단을 할 수 있느냐가 아니라, 고장을 사람 개입 없이 얼마나 멀리까지 끌고 가느냐입니다. 어느 복구 깊이까지, 인시던트당 비용은 얼마에, 그보다 멀리로는 어디서 사람 경계가 시작되는가? 온콜 경제학은 이것이 능력 문제인 동시에 예산 문제라고 말합니다.
기존 평가는 이 질문 앞에서 멈춥니다. 진단 벤치마크는 근본 원인(root cause) 식별을 점수화합니다. Cloud-OpsBench는 754개 런타임 검증 사례로, AIOpsBench는 과정별 Localization, Identification, Reason 점수로, ARGUS는 라이브 클러스터의 MCP 도구 인터페이스를 거쳐 진단을 평가합니다.
STAR는 RCA 추적의 단계로 복구 실패를 귀인하고, CloudIR-Bench는 인시던트 보고서로부터 완화 조치 예측까지 RCA를 확장했습니다. ReliabilityBench는 프로덕션급 스트레스에서 에이전트 신뢰성을 조사합니다. 이 평가들은 전부 시스템 내 실행 앞에서 끝납니다. 에이전트가 무엇을 말했는지를 점수하고, 시스템이 그 뒤에 실제로 무엇을 했는지는 묻지 않습니다.
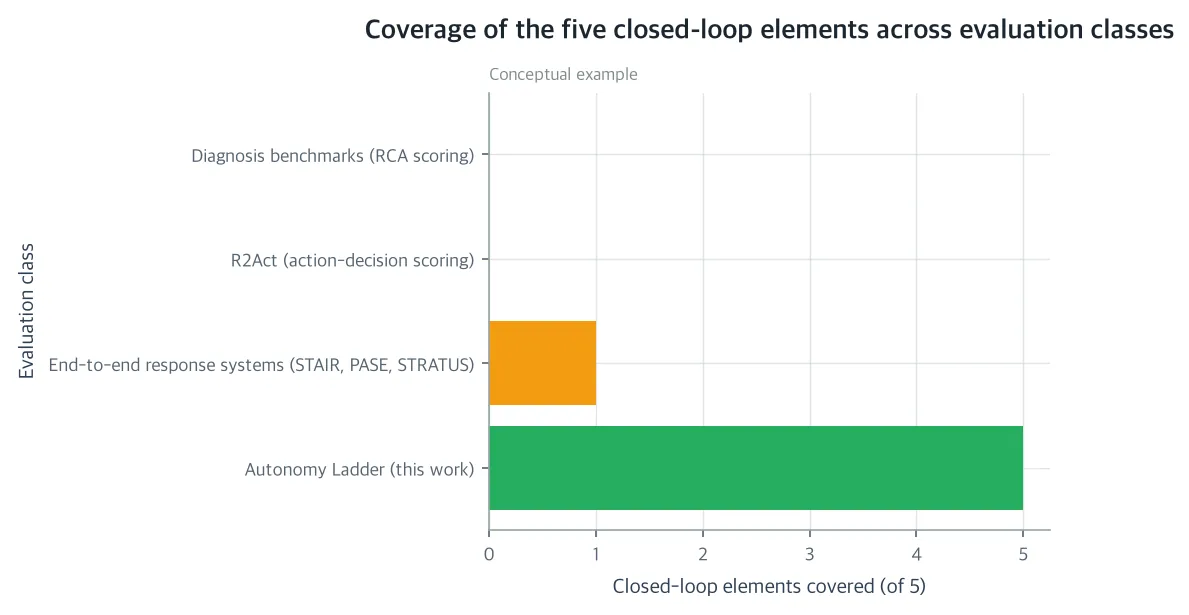 이전 연구군별로 5가지 폐루프 요소(시스템 내 실행, 하네스 검증 결과, 복잡도 층분할, 인시던트당 비용, HITL 경계의 정책 객체화)를 몇 가지 제공하는지 구조적으로 비교한 개념 예시입니다. R2Act의 유일한 요소는 유효성 게이트가 붙은 라이브 리플레이로, 예측 복구 행동을 실행하고 복구 후 서비스 건강을 확인하지만, 폐루프를 점수화하지도 가격 매기지지도 층분할하지도 경계를 두지도 않습니다.
가장 가까운 기존 연구는 R2Act입니다. R2Act는 진단에서 행동으로 넘어가는 결정을 점수화합니다. 보조 유효성 게이트 라이브 리플레이에서는 예측된 복구 행동을 라이브 클러스터에 실행하고 복구 후 서비스 건강을 확인합니다. 보고된 값은 302개 예측 중 146개가 라이브 실행에서 복구된 것, 48.3%의 유효성 게이트 리플레이 비율입니다.
다만 그 리플레이는 행동 유효성에 게이트가 걸린 확인일 뿐입니다. 단계별 결과의 폐루프로 점수되지도, 인시던트당 가격도, 복잡도 층분할도 없습니다. R2Act의 행동 유효성 게이트는 이 사다리의 검증 단계 전제조건으로 들어갑니다. 진단과 복구 행동 결정에서 멈추는 기존 평가를, 단계별 결과의 폐루프 점수와 인시던트당 가격과 복잡도 층분할과 닫힌 형태의 인반 경계가 더해지는 설계로 끌어올린 것이 이 논문의 명시적 업그레이드입니다.
STAIR, PASE, STRATUS 같은 엔드투엔드 대응 시스템과 Kubernetes 미설정 현장 연구는 실제로 행동하는 시스템입니다. 그러나 능력은 보고하고 경계는 보고하지 않습니다.
사다리의 세 층과 두 정책
The Autonomy Ladder(자율 사다리)가 이 빈 칸을 채우는 모델입니다. 이 사다리의 축은 깊이, 즉 수정이 어디까지 도달해야 하는가입니다. ThakiCloud의 이전 온콜 자동화 연구가 고장 클래스, 즉 무엇이 잘못되었는가로 층을 나누어 왔다면, 이 두 축은 직교하며 합성됩니다. 이 논문이 채우는 지점은 네 개입니다. 인시던트를 복구 복잡도로 층분할하고, 실행과 검증을 단계별 결과의 폐루프로 점수화하며, 각 인시던트에 가격을 매기고, 인간-인-더-루프(human-in-the-loop, HITL) 경계를 닫힌 형태의 정책 객체로 도출합니다.
사다리의 각 단계(rung)는 고장 클래스를 고정하고 수정의 깊이에만 따라 나뉩니다. L1은 단일 리소스 재시작입니다. pod나 컨테이너 하나가 비정상 상태에 있는데, 복구는 재시작이나 리스케일입니다. L2는 설정과 상태 수정입니다. ConfigMap이나 Secret의 값이 손상되어 의존 워크로드가 부서졌고, 객체를 고친 뒤 의존자를 순서대로 재시작합니다.
L3은 다중 리소스 연쇄입니다. 근본 원인인 미설정이 제2의 열화, 예컨대 스케일이 0으로 줄어든 의존성과 결합되어 있고, 복구는 롤백 계획을 동반한 순서 있는 다중 리소스 수정입니다. 피해 범위가 서비스 전체를 가로지릅니다. 한 단계 위는 한 단계 아래보다 많은 리소스를 건드리고 그 추론을 포함합니다. 이것이 단조-복잡도(monotone-complexity) 가정입니다.
각 단계는 단계 k에 대해 단조인 매개변수로 기술됩니다. 진단 정확도 d_k, 올바른 진단 조건부 안전 복구 확률 r_k, 부수 피해(collateral damage)를 남길 확률 u_k입니다. 아이 비유로 하면, 단계가 깊을수록 정확도가 낮아지고 피해가 커집니다.
단계별로 두 정책이 대비됩니다. 무인 정책은 에이전트가 진단, 계획, 실행, 검증을 모두 수행합니다. 인반 정책은 에이전트가 진단하고 검토만 하며, 사람이 승인하고 실행합니다. 결과의 명세는 네 가지입니다. SR은 안전 해결, IE는 정보에 기반한 에스컬레이션, U는 부수 피해를 동반한 불안전 행동, NE는 실효 없는 결과입니다.
올바른 진단 후 스스로 행동을 거두는 IE는 판단의 성공입니다. 틀린 진단으로 행동해 피해를 남기는 U는 실패입니다. 이 비대칭이 사다리의 결과 대수를 지탱합니다.
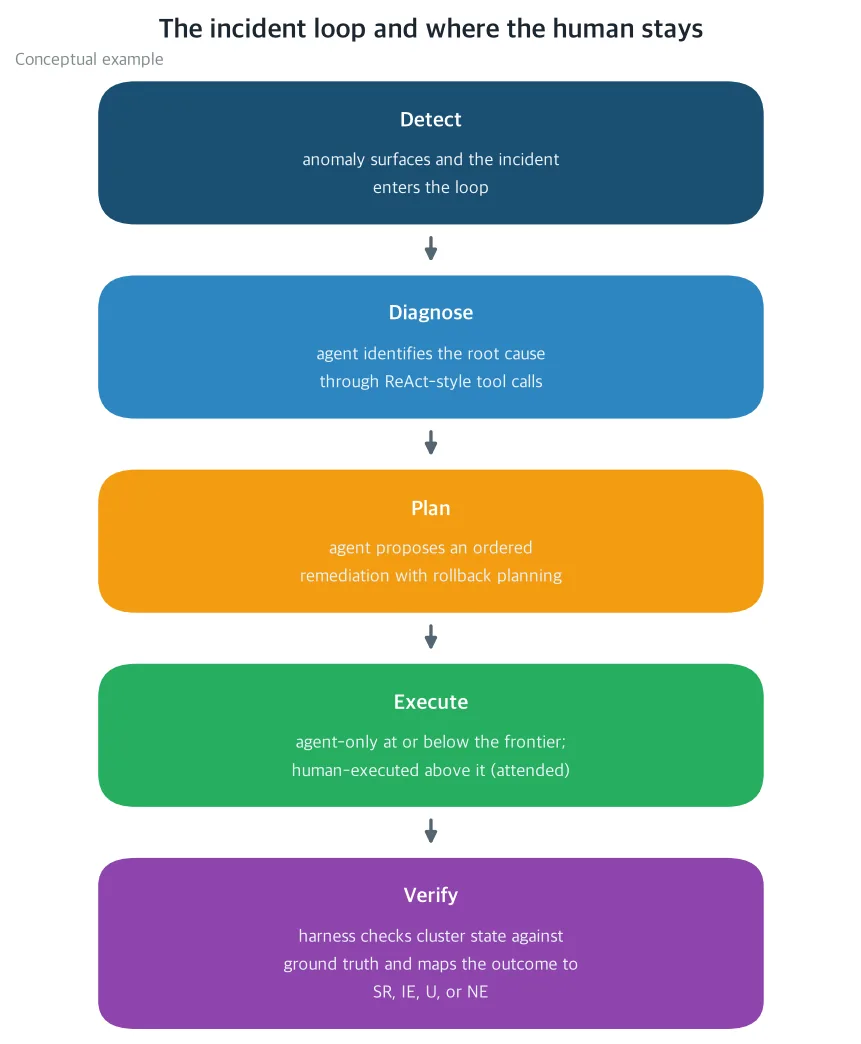 논문의 분석 대상인 폐루프 인시던트 과정입니다. 에이전트가 모든 단계에서 검출부터 계획까지 수행합니다. 실행은 자율 프론티어 이하에서만 에이전트 단독으로, 그 위에서는 사람이 담당합니다. 하네스가 에이전트 종료 후 클러스터 상태를 검증해 결과를 SR/IE/U/NE로 매핑하고 각 인시던트에 가격을 매깁니다. 개념 예시이며 실측이 아닙니다.
비용 모델과 두 조건
비용 모델은 전부 인시던트당입니다. 에이전트 추론 비용 c_a,k는 b0 + b1·k이며, 층의 깊이에 따라 컨텍스트가 커집니다. 사람 비용 c_h,k는 t0 + t1·k입니다. 부수 피해 손실 L_k는 k에 대해 비감소합니다.
진단 배당 ψ_k는 에이전트의 올바른 진단이 지워내는 downstream 사람 분별 작업의 비율입니다. 인반 잡음률 ω_k는 에이전트 검토와 사람 실행이 에이전트의 위험 행동 모드 중 얼마를 함께 잡아내는지입니다. 항상 켜져 있는 감시의 고정 비용 F, 인시던트 빈도 λ, 피해 허용도 ρ가 더 들어옵니다.
무인 정책의 인시던트당 비용 C^u_k는 c_a,k에 (IE_k + NE_k)·c_h,k와 U_k·L_k를 더한 것입니다. 에이전트는 모든 경우에 비용을 받습니다. IE와 NE에서는 사람이 전체 분별 비용으로 불려 오고, U에서는 손실이 현실이 됩니다. 인반 정책의 비용 C^a_k는 c_a,k에 (1-ψ_k)·c_h,k와 U_k·(1-ω_k)·L_k를 더한 것입니다.
사람이 검토된 계획을 실행하므로, 에이전트의 복구 실패 모드는 실행에 적용되지 않습니다. 분별 비용은 (1-ψ_k)만큼만 지불하고, 남은 피해는 공동 검토를 빠져나온 위험 행동 모드에서 옵니다.
두 정책의 차이 Δ_k = C^a_k - C^u_k에서 c_a,k는 소거됩니다. 토큰 비용만으로는 경계가 정해지지 않는다는 뜻입니다. 무인 운영이 단계 k에서 정당하려면 두 조건이 필요합니다. C1(비용)은 Δ_k가 -F/λ보다 작아서는 안 된다는 것이며, C2(안전)은 U_k가 ρ를 넘어서는 안 된다는 것입니다.
자율 프론티어 k는 이 두 조건을 모두 통과하는 가장 높은 단계입니다. 어떤 단계도 통과하지 못하면 k=0이며, 전부 인반입니다. 아이 비유로 하면, 부모가 두 선, 비용과 안전으로 계산해 허락하는 가장 깊은 심부름입니다.
함께 사전 등록된 결함 주입 프로토콜
논문은 결함 주입(fault injection) 프로토콜과 반증 영역 F1에서 F5를 사전 등록합니다. 이 프로토콜은 LLM 에이전트의 진단과 복구를 라이브 클러스터에서 엔드투엔드로, 성공률과 비용까지 재는 복잡도 층분할 인시던트 벤치마크 설계입니다. 대상은 자기 호스팅 Kubernetes 클러스터입니다. 단계마다 고장 클래스 하나씩을 주입하고, 주입기가 고장 상태를 알기 때문에 정답 상태는 구조적으로 보장됩니다.
L1은 일시적 OOM에 의한 pod CrashLoopBackOff, L2는 ConfigMap 값 손상, L3은 근본 원인 미설정과 스케일 0 의존성의 결합입니다. 훈련은 가시 split에서 이뤄지고, 평가는 봉인된 같은 클래스 holdout과 봉인된 미확인 클래스 holdout에서 이뤄집니다.
에이전트는 ReAct 스타일 도구 루프, 12턴 한도, 턴당 토큰 한도, 실시간 한도 안에서 작동합니다. 에이전트는 스스로 점수를 매기지 못하고, 하네스가 에이전트 종료 후 클러스터 상태를 검증해 SR/IE/U/NE로 매핑합니다.
반증 영역 F1은 단조 능력, d_1 ≥ d_2 ≥ d_3과 r_1 ≥ r_2 ≥ r_3, F2는 선형 에이전트 비용, F3는 경계 존재(최소 한 단계가 C1 또는 C2 실패, nominal에서는 L3), F4는 양의 진단 배당(ψ_k > 0, A/B 분별 시간 측정), F5는 바인딩 regime의 순서입니다.
모든 매개변수가 측정 가능한 양으로 매핑되어 있고, 후속 현장 연구가 선언된 숫자를 측정으로 대체합니다.
나온 결과
구멍 없는 프론티어
사다리 성리 정리가 경계의 모양을 보장합니다. P1에서 P7, 즉 매개변수별 단조-복잡도 가정과 인반 순이익의 깊이 우위라는 약한 강화 하에서, U_k는 k에 대해 비감소이고 Δ_k는 k에 대해 비증가입니다.
그러면 두 조건을 동시에 통과하는 단계의 집합은 {1, …, k*}라는 초기 구간이 됩니다. 아래 단계가 실패하는 동안 위 단계가 통과하는 구멍은 프론티어에 생기지 않습니다. 아이 비유로 하면, 부모가 가까운 심부름이 아직 실패하는 동안 먼 심부름을 허락하지 않는 것과 같습니다.
네 개의 부연 정리
네 개의 부연 정리(corollary)가 프론티어가 움직이는 방식을 기술합니다. 첫째, 임계 손실(critical loss)입니다. L*_k = S_k/(U_k·(1-ω_k))은 인반 정책의 남은 피해가 인반 순이익 S_k로 완전히 흡수되는 최대 부수 손실입니다.
k에 대해 단조 감소하고, 인반 운영이 사람의 시간을 더 이상 절약하지 못하는 지점에서 정확히 0을 건드리는 값입니다. 그 위 단계에서는 손실 L_k가 아무리 작아도 C1이 실패하며, 이것이 비용으로 제한되는 구간입니다. 그 아래 단계에서는 현실적인 손실 수준에서 안전 상한 C2만 바인딩합니다. 경계는 맨 위에서 비용이 정하고, 중간에서는 안전 상한이 정합니다.
둘째, 빈도 하한(frequency floor)입니다. 빈도 λ에서 비용 조건은 L_k ≤ L*_k(λ) = (S_k + F/λ)/(ω_k·U_k)일 때 성립합니다. 이 상한은 λ에 대해 엄격히 감소합니다. 인시던트가 드물면 감시 비용 F/λ가 커지고 비용 상한이 올라갑니다.
그러면 원래 비용 때문에 막혔던 단계 중, 그 조건을 만족하는 단계가 추가 면책됩니다. nominal 시나리오의 저빈도 구간에서는 정확히 L3 하나가 면책됩니다. 단, 안전 상한이 이미 통과한 단계에서만 그렇습니다. C2는 λ와 무관하며, 인시던트 빈도의 어떤 변화도 안전 상한을 올리지 못합니다.
셋째, 진단 배당입니다. 에이전트가 복구를 전혀 못 하고(r_k → 0) 위험 행동도 절대 하지 않는데(u_k → 0), ψ_k·c_h,k > c_a,k이면, ‘에이전트와 함께하는 인반’이 ‘에이전트 없는 인반’보다 비용이 더 낮습니다. 아이 비유로 하면, 고치지 못해도 정확히 보고만 하는 아이는, 보고가 없는 경우보다 언제나 부모의 시간을 아껴 줍니다. 에이전트는 순 진단가로서도 전 단계에서 비용 양수입니다.
넷째, 결정화(crystallization)입니다. 봉인 holdout에서 결정론적 플레이북의 안전 해결률 μ_k가 측정된 단계는, 에이전트 실행에서 결정론적 실행으로 승격될 수 있습니다. 승격된 단계가 프론티어에 남는 조건은 두 개입니다. u_det,k ≤ ρ이고, c_det,k < c_a,k - (u_k - u_det,k)·L_k입니다. 승격된 단계는 회귀 시점에 반증 영역과 대조해 재감사받습니다.
nominal 시나리오: k* = 2, L3은 사람이 남는 자리
이 섹션의 모든 수는 명시된 nominal 매개변수화에 대한 닫힌 형태의 평가입니다. 실측이 아닙니다. 가정은 아래 표와 같습니다. 정확도와 안전 복구 확률은 단계가 오를수록 내려가고, 위험 행동률과 손실은 오릅니다. 단조-복잡도 가정이 예측하는 모양 그대로입니다.
| 매개변수 | L1 | L2 | L3 |
|---|---|---|---|
| d_k 진단 정확도 | 0.95 | 0.88 | 0.75 |
| r_k 안전 복구 확률 | 0.80 | 0.55 | 0.30 |
| u_k 위험 행동률 | 0.02 | 0.08 | 0.10 |
| h_k 정보 기반 손바꿈 | 0.03 | 0.10 | 0.25 |
| η_k 잘못된 진단의 자기 불확실성 감지 | 0.40 | 0.35 | 0.30 |
| ζ_k 잘못된 진단에도 행동 | 0.10 | 0.20 | 0.40 |
| c_a,k 에이전트 비용 | 1.0 | 1.5 | 2.0 |
| c_h,k 사람 비용 | 3 | 4 | 5 |
| L_k 부수 피해 손실 | 1 | 2 | 3 |
| ψ_k 진단 배당 | 0.5 | 0.5 | 0.5 |
| ω_k 인반 잡음률 | 0.8 | 0.8 | 0.8 |
명시된 nominal 매개변수화(논문 Table 1). 비용은 정규화된 사람 분별 시간 단위이며 화폐를 주장하지 않습니다. c_a,k는 0.5 + 0.5k, c_h,k는 2 + k입니다. 스칼라 매개변수는 ρ = 0.10, F = 0.5, λ = 1입니다.
이 가정에 결과 대수와 비용 모델을 대입하면 아래 표가 나옵니다.
| 단계 | SR | IE | U | NE | C^u | C^a | Δ | L* | C1 / C2 |
|---|---|---|---|---|---|---|---|---|---|
| L1 | 0.760 | 0.049 | 0.022 | 0.169 | 1.676 | 2.504 | +0.828 | 192.3 | 통과 / 통과 |
| L2 | 0.484 | 0.130 | 0.086 | 0.300 | 3.392 | 3.534 | +0.142 | 16.3 | 통과 / 통과 |
| L3 | 0.225 | 0.263 | 0.145 | 0.367 | 5.585 | 4.587 | -0.998 | -22.4 | 미통과 / 미통과 |
단계별 결과 대수와 인시던트당 비용. nominal 가정에 대한 닫힌 형태의 평가이며 실측이 아닙니다. C2 통과는 U_k ≤ ρ = 0.10, C1 통과는 Δ_k ≥ -F/λ = -0.5를 의미합니다. 프론티어는 k = 2입니다.*
L1에서는 두 조건이 넉넉한 여지로 통과합니다. L2에서는 모두 통과하지만, 비용 여지가 크게 얇아집니다. L3에서는 두 조건이 동시에 실패합니다. 안전 상한 U_3이 허용도 ρ를 넘고, Δ_3은 -0.5 아래입니다.
즉, 사람 말로는, 가전 하나를 재시작하고 설정을 고치는 일은 아이가 혼자 해도 안전하고 싸고, 여러 곳으로 번진 고장은 부모가 승인하고 실행해야 한다는 뜻입니다. nominal 시나리오의 경계는 k* = 2입니다.
경계는 L3의 위험 행동률 u_3과 손실 L_3을 흔들어도 움직이지 않습니다. u_3을 0.02와 0.04로 낮추면 안전 상한은 통과하지만, 비용 조건은 여전히 실패합니다. u_3이 0.10 이상이면 두 조건이 동시에 실패하고, 안전 상한이 먼저 바인딩합니다.
u_3과 L_3의 격자 전체에서 프론티어는 k* = 2로 달라지지 않습니다. L3의 경계는 λ = 1에서 비용 조건이 정하고, 안전 상한이 추가적으로 바인딩하는 것은 u_3 > 0.04일 때입니다.
빈도와 잡음률도 같은 그림을 줍니다. u_3 = 0.02, L_3 = 1.0이면 안전 상한이 이미 L3을 통과합니다. λ = 0.1에서는 감시 비용 F/λ = 5가 비용 상한을 올려, L3 하나만 추가로 면책되고 k* = 3이 됩니다.
λ가 1 이상이면 프론티어는 다시 k* = 2로 돌아옵니다. 인시던트가 드물면 감시가 인시던트당 비싸므로, 비용은 더 많은 단계를 허용합니다. 안전은 하나도 추가 허용하지 않습니다. 인반 잡음률 ω를 0.50에서 0.95로 올리면 비용 적자는 깊어지지만, k*는 변하지 않습니다. 비용과 안전이 같은 방향을 가리킵니다.
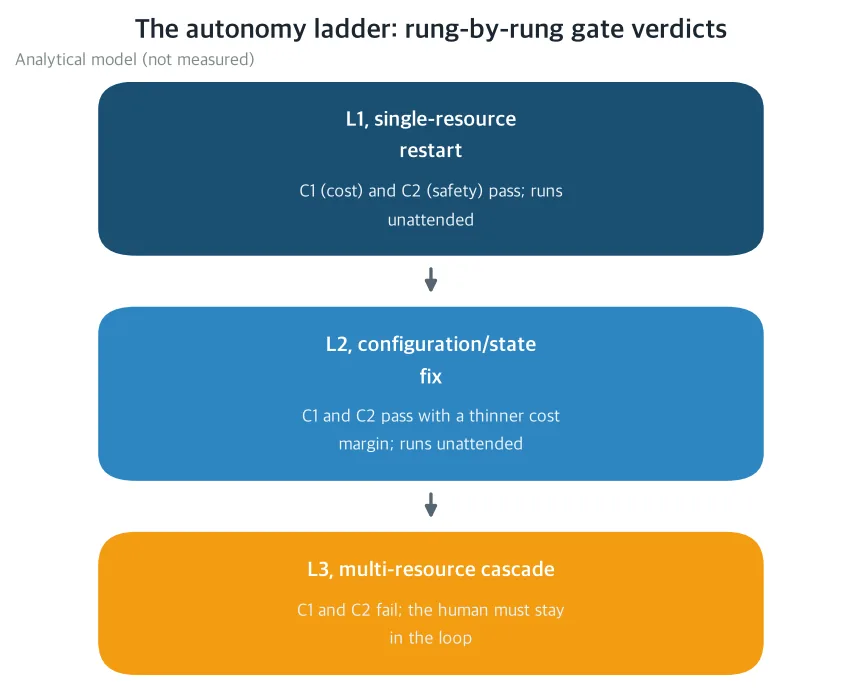 명시된 nominal 시나리오에서 L1과 L2가 C1(비용)·C2(안전) 양 조건을 통과해 무인 운영이 가능하고, L3은 양쪽을 실패해 사람이 루프에 남아야 합니다. 사다리 성리 정리로 프론티어에는 구멍이 없습니다. 해석적 모델의 산출물이며 실측이 아닙니다.
그래서 무엇을 바꾸면 되나
이 결과의 운영 번역은 단계별 자율 규칙입니다. L1(재시작)은 사후 감사와 함께 무인입니다. L2(설정과 상태 수정)는 측정된 u_2 ≤ ρ이고 L_2 ≤ L*_2일 때만 무인으로 운영합니다. 그렇지 않으면 에이전트가 진단하고 제안하고, 사람이 실행합니다.
L3(연쇄)는 λ ≥ 1에서는 nominal 시나리오 전부에서 인반입니다. 인시던트 빈도가 낮아지거나, d_3과 r_3 개선이 U_3과 Δ_3를 이동시키면 다시 평가합니다.
경계는 정상이 아니라 이동하는 객체입니다. 아이가 자라고 고장의 빈도가 바뀌면 선이 움직이고, 재추정은 그 선을 다시 확인하는 상시 비용입니다. ThakiCloud의 Kubernetes 플랫폼에 이 논문이 주는 것은, 온콜 자동화에 얼마를 투자할지와 실행 권한을 어느 깊이까지 넘길지를 정하는 예산 기준입니다. nominal 시나리오에서는 그 답이 L2까지이며 L3은 인반입니다.
그 답은 프로토콜의 실측으로 갱신될 값이며, 갱신되는 값이기에 예산에 쓸 수 있습니다. HITL 경계를 정량화하면 온콜 부담을 줄이면서도 자율 실패의 피해 범위를 제한합니다. 특히 안전 상한은 빈도와 무관합니다. 인시던트 발생량이 아무리 늘어도 ρ를 넘는 단계는 면책되지 않고, 측정된 u_k의 변화만이 상한을 움직입니다. 24/7 인프라 자동화의 확장 속도가 안전 기준을 무력화하지 못하는 구조입니다.
못 믿을 부분
첫째, 이 논문은 분석 논문이자 입장(stance) 논문입니다. 새 측정이 하나도 없고, 모든 수는 명시된 nominal 가정에 대한 닫힌 형태의 평가이거나 인용된 값입니다. nominal 매개변수화는 추정치가 아니라 시나리오이며, 이 글의 모든 결론은 그 가정에 조건부입니다.
둘째, 진단, 계획, 실행, 검증 단계 간 독립 가정은 가장 강한 이상화입니다. 아이 비유로 하면, 아이의 한 실수가 판단과 자기 점검을 동시에 망가뜨리지 않는다고 전제하는 것입니다. 현실은 그렇지 않을 수 있습니다. 틀린 가설 하나가 잘못된 행동과 자기 탐지 실패를 동시에 낳으면, U_k를 올리면서 SR_k를 내립니다.
구멍 없는 초기 구간이라는 경계의 구조는 단조한 변동 하에서 방향적으로 견고하지만, 상관성이 있을 때의 k* 수준은 측정에서 나와야 합니다.
셋째, 층은 대표적이지만 포괄적이지 않습니다. 대수는 K > 3 단계로 그대로 일반화되지만, 세 층이 현실 인시던트 분포를 포괄한다는 주장은 하지 않습니다. 넷째, 범위는 단일 플랫폼, Kubernetes입니다. 다른 오케스트레이터는 리소스 결합 깊이로 같은 층에 매핑된다는 주장뿐이고, 그 매핑은 여기서 검증되지 않았습니다.
다섯째, 비용 정규화, 사람 분별 시간은, 화폐와 캐싱 효과를 가립니다. 인반 정책은 검토된 계획의 사람 실행이 신뢰할 만하다는 전제를 두며, 그 실패 모드는 U_k·(1-ω_k)의 잔여로만 들어옵니다.
이 한계들이 곧 후속 연구의 질문입니다. 사전 등록된 프로토콜과 반증 영역 F1에서 F5가 선언을 측정으로 바꾸는 판정자 역할을 합니다. 그 첫 결과가 k*의 수준과 바인딩 조건입니다.
논문 원문과 수반 자료는 여기에서 볼 수 있습니다: The Autonomy Ladder 데이터셋
본문에 나오는 모든 수는 명시된 nominal 가정에 대한 닫힌 형태의 평가이며 실측이 아닙니다. 그림 세 장도 같은 모델의 산출물이며 개념 예시입니다.

