The Description Budget: 스킬 설명에 얼마나 텍스트가 필요한지, 그리고 정확도-토큰 프런티어가 레지스트리 규모에 따라 어떻게 이동하는지
스킬 레지스트리를 둔 retrieval 기반 agent 하네스를 운영하거나, 스킬 description을 per-request 프롬프트에 주입하는 시스템을 맡고 있는 국내 클라우드·AI 엔지니어라면 이 글을 읽어야 한다. 이런 아키텍처에서 description은 retrieval 정밀도와 per-request 토큰 비용이 동시에 거래되는 지점이다. 이 논문은 그 거래에 대한 닫힌 형태의 답을 주는 셈이다. ThakiCloud의 이번 논문, “The Description Budget: Measuring the Retrieval-Precision versus Prompt-Inflation Frontier of Skill-Description Verbosity Across Registry Sizes in a 2,200-Skill Agent Harness”는 스킬 description의 dual role, 인덱스 신호와 프롬프트 payload를, description-budget 문제로 정식화하는 것이다. 스킬 하나당 description 텍스트가 얼마나 필요한지, 그리고 레지스트리가 약 500개에서 2,200개로 커질 때 정확도-per-프롬프트-토큰 frontier가 어떻게 이동하는지 두 질문에 답한다. 본 논문은 해석 논문인가. frontier를 닫힌 형태로 유도하고 그것을 시험할 측정 프로토콜을 사전 등록한다.
문제의식: 같은 description이 인덱스 신호이자 프롬프트 payload
논문의 중심인 무인 agent 하네스에서 모든 user turn은 hybrid retrieval step을 통과하는 것이다. 각 스킬 description에 대한 lexical BM25 점수와 dense embedding similarity를 fusion한다. 이 fusion은 모든 request의 hot path 위에서 계산된다. 레지스트리는 한국-영어 혼합 쿼리를 응대하던 1,600개 스킬에서 2,200개 스킬로 자랐다. 인덱싱과 주입은 모두 스킬 description이라는 free-text 블록 하나로 처리된다.
스킬을 retrievable하게 만드는 같은 텍스트가 그것을 expensive하게 만든다. 주입되는 description의 모든 토큰은 들어가는 request마다 prefix-cache 할인만큼 뺀 뒤 다시 지불해 버린다. 장황하고 boilerplate가 많을수록 neighboring query에 대한 distractor가 강해진다. 인덱스에 들어가는 단어 하나하나가 off-target query의 collision 기회를 늘리기 때문이다. verbosity는 retrieval 정밀도와 per-request 비용을 같은 순간에 반대 방향으로 거래한다.
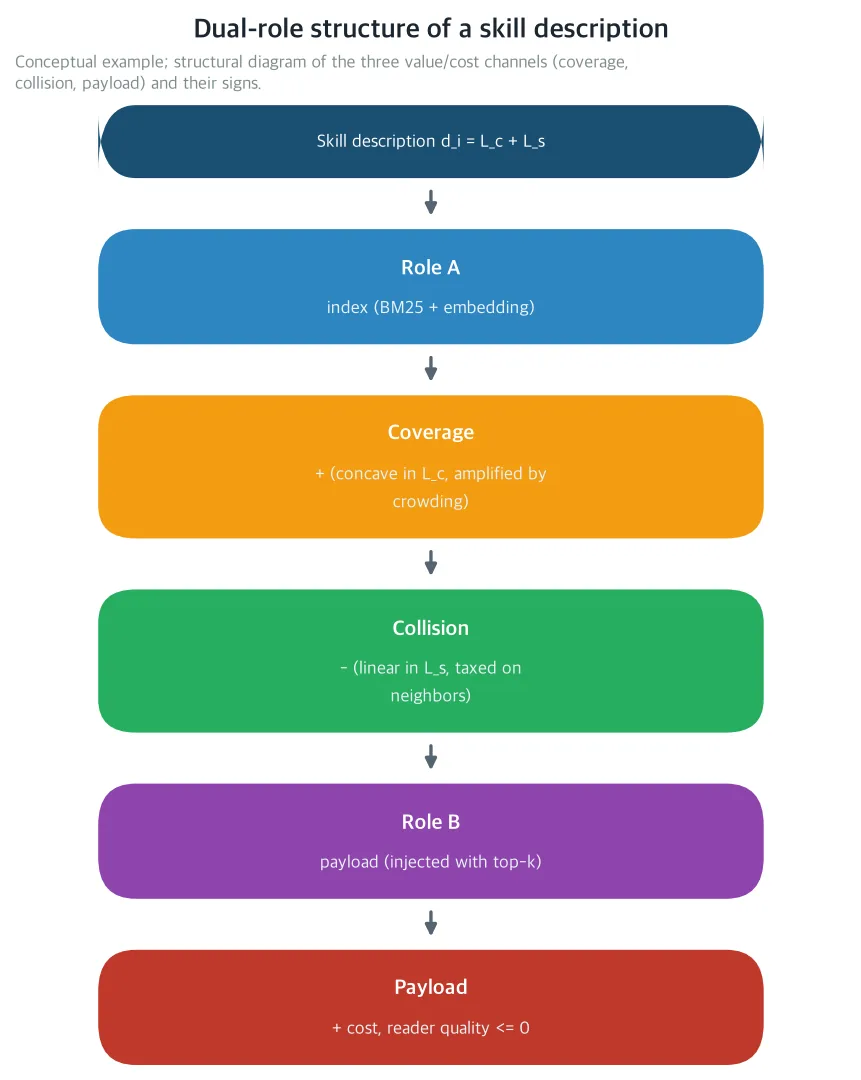 같은 텍스트 d_i가 retrieval 인덱스 신호(coverage gain과 collision loss)이자 주입되는 프롬프트 payload(비용과 reader degradation)로, description-budget 목적함수의 세 채널을 이룬다. (개념 예시. coverage·collision·payload 세 가지 가치/비용 채널과 그 부호의 구조 다이어그램.)
이 질문의 계보는 Gorilla에서 시작한다. 2023년의 Gorilla는 fine-tuned LLaMA 모델을 document retriever로 거대한 API corpus에 연결했다. retrieval이 hallucinated API 사용을 상당히 완화하고 test-time 문서 변화에 적응한다는 것도 보여 주었다. 하지만 corpus 텍스트를 주어진 것으로 취급했다. API 엔트리 하나당 텍스트가 얼마나 필요한지 묻지 않았고 retrieved 텍스트가 프롬프트에 주입될 때마다 치르는 per-request 비용도 model의 대상이 아니었다. 2026년의 스킬-ecosystem 연구 물결은 selection side, rewriting side, compression side, compute side, security side에서 같은 문제를 공격한다. registry size를 가로지르는 dual-role budget frontier를 model하는 일은 없다. 이 논문은 정확히 그 대상을 정의한다. 의도적으로 Gorilla의 아키텍처를 upgrade한다.
버짓 규칙: 최적 길이가 ‘차별 가치 / cache 조정 payload 가격’의 로그
논문은 스킬 description L_i 토큰을 capability content L_c와 surface mass L_s로 나눈다. capability content는 스킬이 무엇을, 언제, 어떤 대상에 대해 실행하는지를 담고 surface mass는 boilerplate와 반복 서술을 지닌다. name, 한 줄 capability, boundary sentence로 된 고정 structural template 아래 capability 비율이 길이 레벨에 걸쳐 일정하므로, 사다리 이동은 순수한 길이 이동이다.
request 당 기대 가치 V_i는 네 항으로 쓰인다. 첫째는 traffic 가중 coverage이다. capability 토큰은 Poisson rate로 스킬의 executable region을 덮는다. 붐비는 cluster에서 coverage는 (1+ζ m_i)로 증폭된다. 붐비는 cluster일수록 capability 토큰 하나하나가 더 많은 일을 한다. 둘째는 collision이다. surface 토큰 하나하나가 confusing neighbor m_i(N)개에 rate β로 혼선을 부과한다. BM25 half에서는 인덱스된 단어가 많을수록 off-target query의 겹칠 기회가 늘고 dense half에서는 boilerplate가 embedding을 generic cluster 방향으로 당긴다. 셋째는 cache 조정 payload 가격 c_eff L_i이다. 넷째는 음의이거나 0인 reader degradation 항 Q_reader이다. dual role의 긴장은 이 한 식 안에 있다. crowding이 capability의 가치와 surface의 가격을 동시에 올리기 때문이다.
가정 A1(coverage concavity)부터 A4(sublinear cluster saturation) 아래, KKT 분석이 세 결과를 준다. 첫 번째는 Theorem 1이다. V_i는 (L_c, L_s)에 대해 jointly concave이고 unique global maximizer가 존재하며 최적점에서 surface mass가 소거된다. L_s* = 0. boilerplate는 짧아지는 것이 아니라 통째로 사라진다. robustness 가정 A5가 이를 날카롭게 하는 것이다. 혼선 압력 m_i가 임계 c_eff/β 이상이면 최적 description은 순수 capability content이다. 두 번째는 Proposition 2, 닫힌 형태 버짓 규칙.
L_i*(N) = (1/θ_i) ln(α_i θ_i (1 + ζ m_i(N)) / c_eff)
스킬별 최적 길이는 traffic 가중 discrimination value와 cache 조정 payload price의 비의 로그이다. comparative statics는 바로 읽힌다. traffic weight α_i가 높으면 길고 neighborhood m_i가 붐비면 길고 토큰 가격 c_eff가 비싸면 짧다. 세 번째는 corollary이다. uniform budget는 dominated된다. 같은 총 budget에서 모든 스킬에 같은 길이를 주면 손실은 (1/2) Σ c_eff θ_i (L_i* - B/N)²로 bound된다. traffic weight의 분산이 ‘누구나 같은 길이’ authoring 관행의 배정 비효율을 가르는 measurable 상한이 된다.
500에서 2,200으로의 frontier 이동: 부호가 regime의 진위를 가른다
레지스트리가 500에서 2,200 스킬로 커질 때 frontier가 어떻게 이동하는지에 대한 단일한 답은 논문이 주지 않는다. shift의 부호는 a priori로 불확정이다.
A4(sublinear cluster saturation) 아래 혼선 질량은 m_i(N) = m_0 + Δm ln(N/N_0)로 로그 성장하고 frontier는 log-N 법칙으로 단조 상승한다. 레지스트리가 붐빌수록 capability content의 가치가 오르므로 최적 길이가 커진다. 대안 regime A4’(dense cluster) 아래 혼선 질량은 m_i ∝ N으로 가격에 선형으로 들어가고 discrimination value는 포화하는데 collision+payload price만 계속 커진다. 그러면 frontier는 non-monotone이 되고 내부 N†에서 peak를 준다. 논문의 schematic에서 peak는 약 750 스킬 부근이고 A4 frontier와의 crossing은 약 1,560 부근이다. 파라미터는 예시 값이다.
두 regime 중 어느 쪽이 맞는지를 논문은 주장하지 않는다. 둘 다 미지 함수 m_i(N)의 functional form이다. 논문의 내용은 두 형태가 모양이 다른 frontier shift를 주며, measurable한 대상인 confusion-pressure index m̄(N)이 그 사이를 판별한다는 것이다. 이것이 사전 등록된 falsification 조건 P1이다. L(2,200) - L(500)가 500 스킬 길이의 10%를 넘고 m̄(N)이 N에 sublinear이면 데이터가 A4를 고르고 log 법칙이 확인된다. measurable한 peak를 지닌 non-monotone frontier는 A4’를 가른다. confidence interval 안에서 평탄한 frontier는 dual role 긴장 자체를 falsify한다.
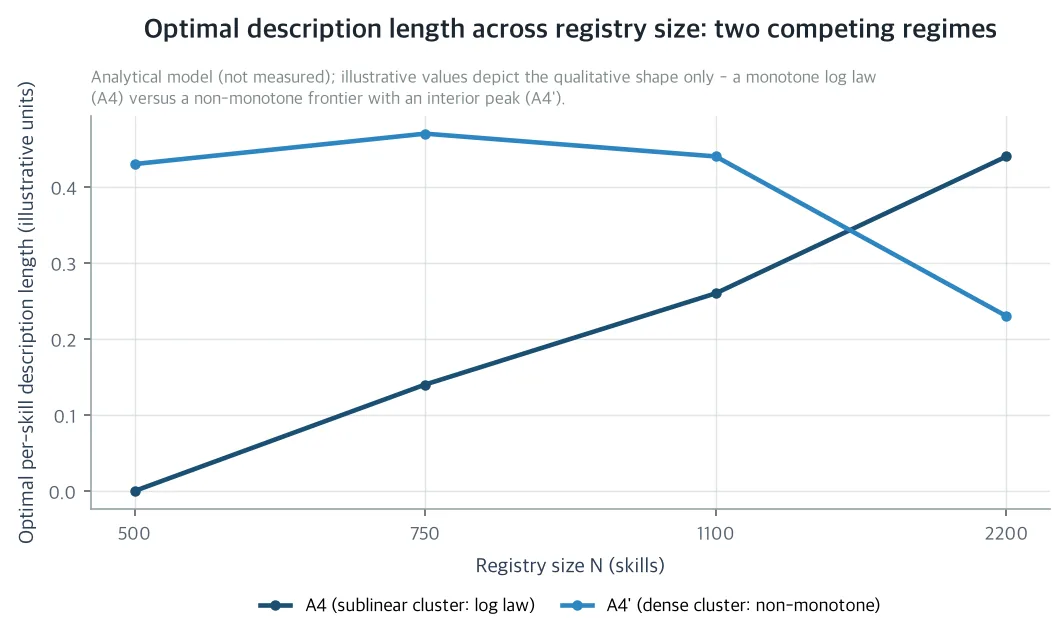 A4 sublinear-cluster frontier는 단조한 log-N 법칙으로 오르고 A4’ dense-cluster frontier는 내부 peak를 지닌 non-monotone 형태이며, 500에서 2,200으로 커지는 사이 frontier shift의 부호가 regime을 판별한다. (해석 모델이며 실측이 아니다.)
rewrite payback cliff: cache 임계는 건너거나, 가까이 가거나
Proposition 4는 registry 전체 rewrite를 가격 매긴다. 일회성 비용은 rewrite와 인덱스 재구축의 합 R×N이 되기 때문이다. request 당 절감 S는 rewrite가 prefix-cache 임계를 건너느냐에 따라 바뀌기도 한다. 논문이 인용하는 production cache 측정은 two-tier인 셈이다. 약 3,500 토큰의 날카로운 임계 아래에서 hit rate는 ρ ≈ 0.83로 plateau하고 그 위에서 할인은 다르다.
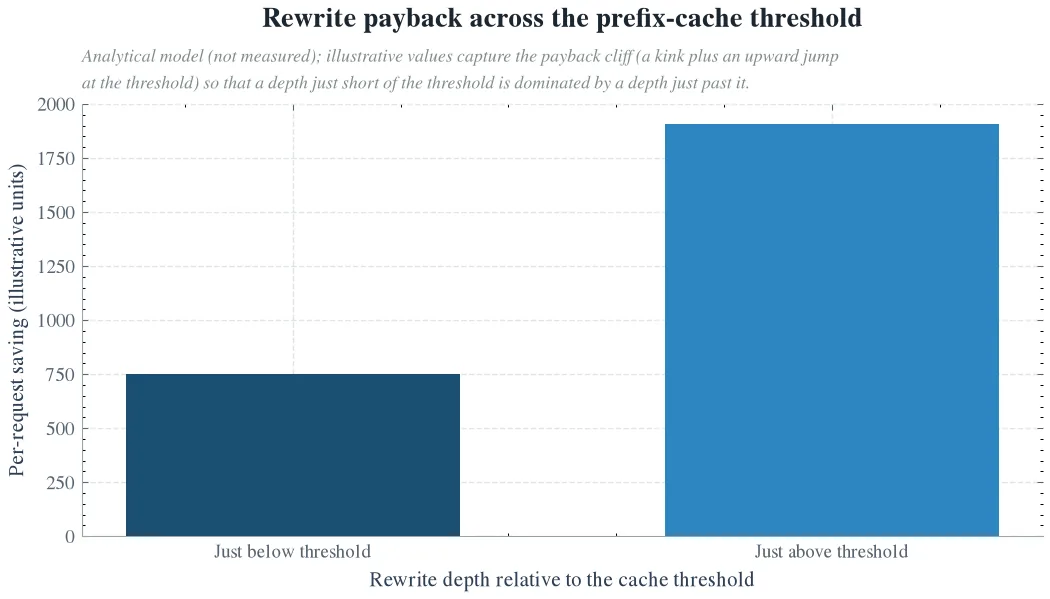 cache 임계 바로 아래에서 멈춘 registry 전체 rewrite는 임계를 건너는 rewrite보다 request 당 절감이 엄격히 작다. 임계를 건너는 순간 남아 있는 prefix 전체가 더 높은 plateau 할인으로 재가격매겨지기 때문이다. (해석 모델이며 실측이 아니다.)
rewrite depth ΔP가 임계 바로 아래에서 멈추면 제거되는 것은 tail 토큰뿐이고 그것들은 임계 위 할인으로 가격매겨진다. 임계를 건너면 남아 있는 prefix 전체가 새로운 할인으로 재가격매겨지고 절감에 p_in (ρ_b - ρ_a) P_t만큼의 도약이 붙기도 한다. 임계 바로 아래 depth는 임계 바로 위 depth에 엄격히 dominated된다. 최적 depth는 전체 budget 목표이거나 crossing depth이고 임계에 아주 가깝지만 못 미치는 지점은 없는 셈이다. 이것이 사전 등록 P3이다. jump 없는 단일 slope payback은 two-tier 재가격매김 메커니즘을 falsify하는 것이다.
그 위에 Proposition 5가 세 레버를 합성한다. corpus side의 budget b = L*, retriever side의 양자화 distortion ε과 fusion weight w, compute side의 router thinking 배정 t이다. local regime에서 end-to-end task quality는 Q = Q̄ (1+η_c)(1+η_s)(1+η_r)로 분해되고 1차까지 레버는 log-space에서 additive로 합성된다. frontier의 모양은 유지되고 위치만 이동한다는 뜻이다. 경제적으로 바른 적용 순서는 amortization이다. b가 먼저, 일회성 비용 RN이 모든 향후 request에 걸쳐 상환된다. 다음 ε, retriever rebuild마다 offline으로 적용되는 것이다. 그리고 t, task마다 비용이 드는 레버이다. description budget은 가장 많이 amortization되는 레버이며 앞선 report의 retriever side 결과와 compute side 결과에 corpus side 축을 더한다.
회사, 사회, 과학에 남는 것
회사에 가장 먼저 남는 것은 ThakiCloud이다. 무인 agent loop의 자율 repair loop가 스킬 description을 밤마다 재작성하는데, 길이 정책은 없었다. 2026-10-03에 무한정 재작성이 일으킨 collateral routing drift가 실측되었다. 버짓 규칙은 스킬별, registry size별로 measurable한 길이 상한을 repair loop에 부여하는 상시 constraint이다. SRA 라우팅을 안정화하고 무인 loop의 구조적 토큰 비용을 낮춘다는 것이다.
사회로 가면 범위는 넓어진다. 대규모 스킬/MCP 생태계를 운영하는 self-hosted agent 플랫폼 팀은 request마다 description 토큰을 지불한다. Model Context Protocol의 ecosystem-level 조사는 17개 marketplace에 368,754개 server listing을 세고 98.5%의 tool은 적어도 하나 이상의 functional alternative를 지닌다. 혼선 질량 m_i(N)이 큰 곳이 바로 그곳이다. description 길이는 registry-level external 효과인 셈이다. collision 항 β m_i L_s가 neighboring skill의 정밀도 손실을 스킬의 author에게 전가한다. 스킬별 길이 budget은 external effect의 일부를 internalize한다. budget 자체가 가격이다. 공개된 description-budget 레시피는 품질 손실 없이 이 낭비를 감사하고 제거하는 수단을 준다.
과학으로는 스킬 description 텍스트의 두 역할, 검색 인덱스 신호와 프롬프트 컨텍스트를 통제 실험으로 분리한 첫 연구인가. registry size에 의존하는 Pareto frontier, description-budget scaling 법칙은, registry size만 변인화한 기존 router scaling 결과와 겹치지 않는 축이다. Gorilla가 LLM을 retriever로 거대한 API corpus에 연결했다면, 이 논문은 corpus 자체에 가격을 매긴다는 뜻이다.
한계: 모든 숫자는 명시된 가정 위의 model 추정
논문의 모든 숫자는 명시된 가정 위에서 model 추정치로 도출된다. A1-A5는 측정 프로토콜이 고정하는 가설인 셈이다. A4 대 A4’ label은 열린 실증 문제로 남아 있다. 본 논문은 해석 논문으로 새 실측을 보고하지 않는다.
scorer는 단일 hybrid family이다. embedding model 하나와 고정 fusion weight w. adaptive fusion을 쓰면 가격 항이 바뀐다. injection은 static이고 packer가 없는데, packing을 쓰면 reader가 간직하는 것이 바뀐다. reader degradation 항 Q_reader는 placeholder이며 position-dependent 형태는 model되지 않았다. 인용된 3,500 토큰 임계를 넘는 cache 파라미터는 deployment-specific이고 C1-C2 조건으로 설정된다.
이 gap을 닫기 위해 논문은 측정 프로토콜을 사전 등록한다. 스킬별 약 5, 12, 20, 30, 40 토큰의 ladder rewrite, functional cluster 구성을 보존한 N ∈ {500, 1,100, 2,200}의 registry sweep, 셀마다 recall@5, top-1 정확도, retrieval level hallucination rate, per-request prompt 토큰 팽창, downstream task success, confusion-pressure index를 기록한다. 셀별 bootstrap confidence interval, cluster와 traffic quartile로 분할된 동결 audit set, 실행 전에 고정되는 코드와 registry snapshot이다. 분석 규칙은 측정 전에 고정해 버린다. 데이터에 맞춰 바꾸지 못한다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-10-description-budget-skill-verbosity