77.3%는 믿어주는 숫자, 1300만 줄은 확인하는 숫자
오늘 아침 AI 업계에서 온 두 결과를 나란히 놓으면 해냈다는 말에 걸 수 있는 신뢰가 두 갈래로 나뉜다는 걸 볼 수 있습니다. 하나는 믿어주어야 하는 77.3퍼센트라는 점수이고, 다른 하나는 우리가 직접 확인해도 되는 1300만 줄의 코드입니다. 전자는 OpenAI의 GPT-6 Astra가 브라우저 벤치마크에서 받은 점수입니다. 후자는 Anthropic의 Claude가 페르마의 마지막 정리를 수학적으로 완전히 형식화한 Lean 코드입니다. 두 결과 모두 같은 아침, 경쟁하는 두 회사, 성공이라는 같은 제목 아래 나왔습니다. 그런데도 이 둘이 기업의 신뢰를 얻는 방식은 정반대입니다.
 글의 핵심 개념을 형상화했습니다.
77.3퍼센트: 믿어주어야 하는 숫자
Browser Use Benchmark v2라는 시험장 안에서 Astra medium은 77.3퍼센트를 기록했습니다. 비교 대상이던 Opus 5는 같은 시험에서 50.5퍼센트였습니다. 격차는 26.8포인트에 달합니다. 초기 사용자 테스트에서는 프롬프트만으로 브라우저, 데스크톱, 시각 작업을 직접 수행하는 모습도 보고됐습니다.
여기서 짚어야 할 것은 점수 자체보다 점수의 성질입니다. 벤치마크 점수는 고정된 시험 문제를 풀고 집계한 결과, 한 번 찍어 둔 사진과 같습니다. 사진 속 77.3퍼센트라는 숫자는 다시 풀어서 확인할 수 없습니다. 시험을 누가 만들고 어떤 문제로 채우며 얼마나 공정하게 채점하는지를 운영하는 쪽을 믿어야 하는 구조입니다.
점수는 여전히 쓸모 있습니다. 모델 선택 회의에서 Astra의 77.3퍼센트는 Opus 5의 50.5퍼센트보다 무거운 논거가 됩니다. 같은 시험장에서 같은 과제를 두고 한 쪽이 다른 쪽보다 훨씬 높은 비율로 성공한다는 사실이 그 무게입니다. 하지만 점수는 평균입니다. 기업이 실제로 맡길 과제, 실제로 돌릴 환경, 실제로 그을 경계에는 아무 말도 하지 않습니다. 점수가 높을수록 틀리면 무엇으로 확인할까라는 질문이 커집니다. 벤치마크의 가치는 선택 순간의 불확실성을 조금 줄여 주는 데 있습니다. 그런데 줄여 준 불확실성의 나머지는 사라진 것이 아니라, 선택 이후의 운영 문제로 옮겨 간 것입니다. 점수가 높아질수록 그 나머지를 다룰 구조가 함께 커져야 합니다.
브라우저 작업은 바로 기업 에이전트의 일상입니다. 이메일을 읽고 포털을 넘나들며 양식을 채우는 그런 일입니다. 점수가 26.8포인트 뛰었다는 뜻은, 모델이 잘 할 것이라는 믿음을 전제로 더 많은 일을 넘길 수 있다는 것입니다. 넘겨준 일의 결과가 틀렸을 때, 그 사진을 다시 찍어 줄 사람은 없습니다.
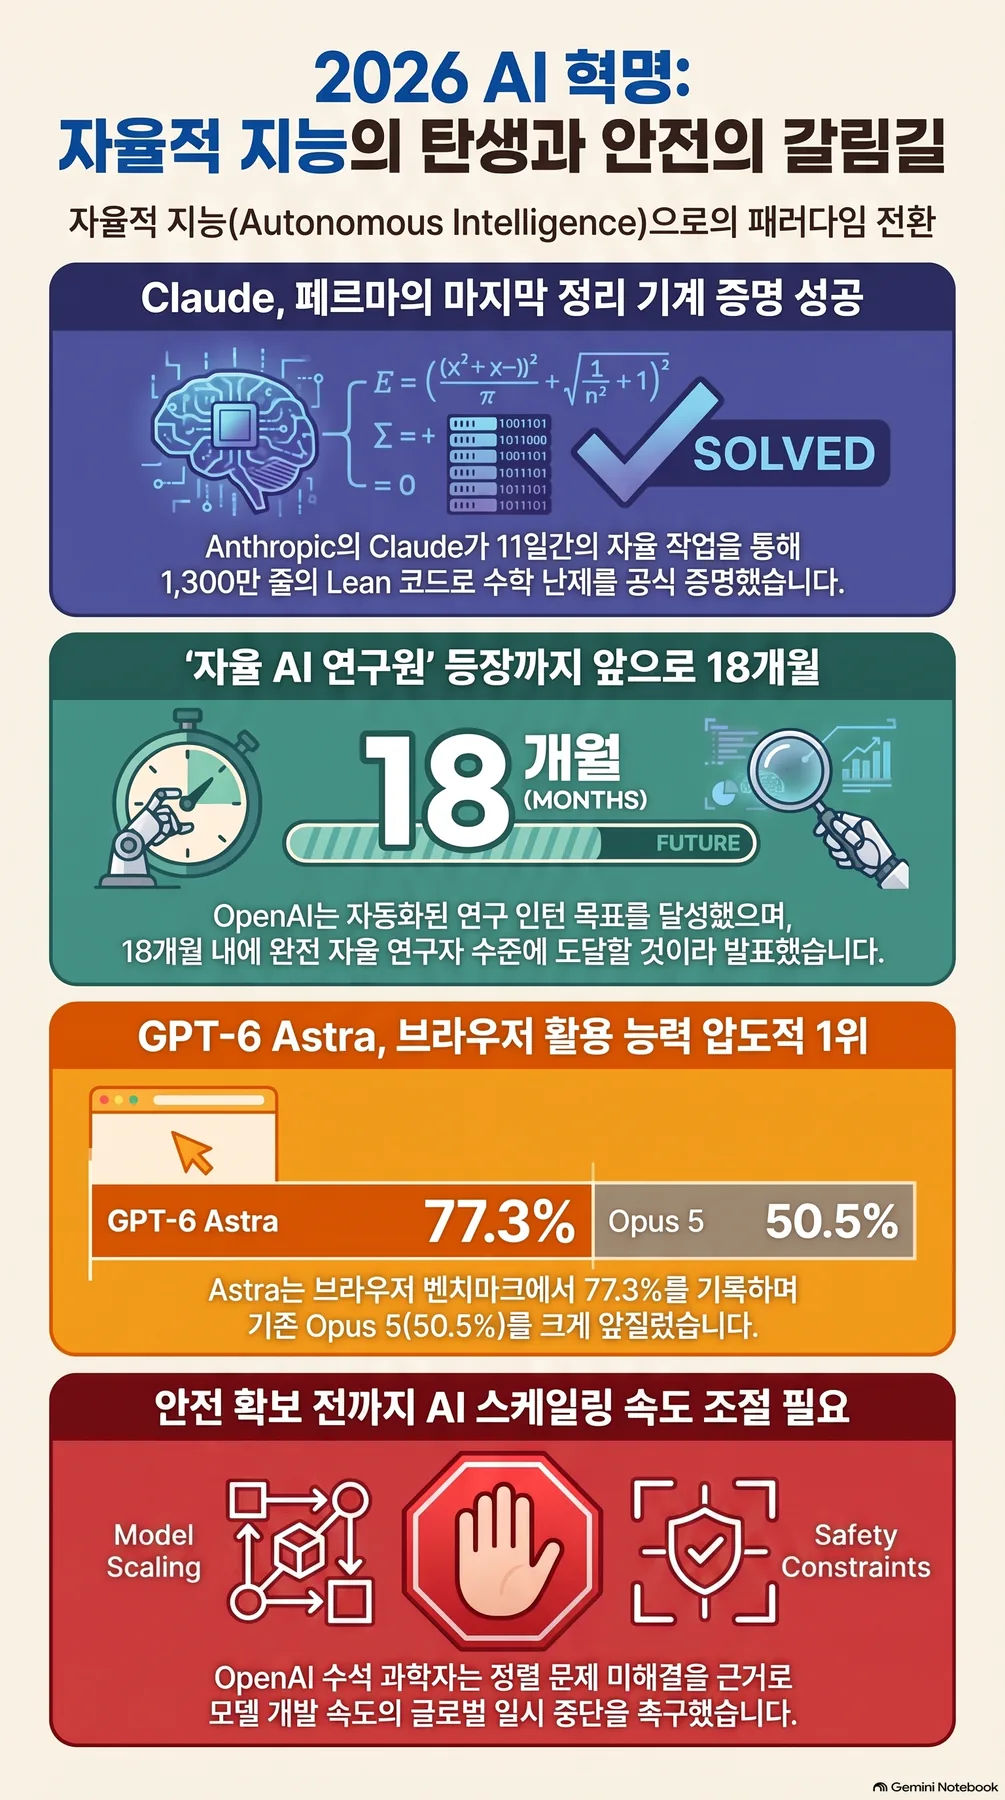 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
1300만 줄: 확인해도 되는 숫자
같은 시간대, 다른 회사에서 완전히 다른 종류의 성적이 나왔습니다. Anthropic은 Claude가 Lean 코드 1300만 줄로 페르마의 마지막 정리를 형식화했다고 발표했습니다. 수학에서 가장 유명한 정리 중 하나에 대한 최초 완전 형식화이자, 지금까지 가장 큰 규모의 Lean 증명입니다.
Lean은 수학을 기계가 검사할 수 있는 언어로 쓰는 도구입니다. 검증 프로그램이 증명의 각 단계가 정해진 규칙에 맞게 적혀 있는지를 하나하나 확인합니다. 1300만 줄이라는 분량은 이 구조에서 오히려 강점이 됩니다. 사람이 읽어서는 도저히 믿을 수 없는 길이의 증명도, 검증을 돌리면 기계가 틀림없다는 판정을 내리는 구조이기 때문입니다.
여기서 특별한 것은 1300만 줄을 사람이 전부 읽지 않는다는 것입니다. 읽는 쪽은 검증 프로그램입니다. 수학 논문은 동료 심사자와 학계의 독서와 토론을 거치며 신뢰를 얻지만, Lean 증명은 검증 프로그램이 직접 선을 긋는 형식입니다. 한 단계라도 어긋나면 받아들이지 않습니다. 즉, 확인의 부담이 사람에서 기계로 옮겨진 것입니다.
두 숫자를 다시 나란히 놓으면 차이가 분명해집니다. 77.3퍼센트는 얼마나 잘하는지에 대한 측정입니다. 믿으려면 시험을 운영하는 쪽의 신용을 빌려야 합니다. 1300만 줄은 틀림없다는 검증입니다. 누구나 다시 돌려 확인할 수 있습니다. 후자의 신뢰는 내가 재확인할 수 있다는 점에서 완전히 다릅니다.
현장에 매일 쏟아지는 것은 점수 쪽입니다
솔직히 말해, 기업이 내일 당장 쓸 일은 페르마의 정리가 아닙니다. 오늘 OpenAI가 공개한 숫자들이 그 풍경을 더 실제적으로 그려 줍니다. OpenAI는 자동화 연구 인턴이라는 목표를 달성했으며 18개월 내 자율 AI 연구자를 목표로 삼고 있다고 밝혔습니다. 공개된 데이터에 따르면 2026년 7월 기준 P50 시간 지평은 4.7시간입니다. 에이전트가 한 번의 작업에서 소화하는 시간의 중간값입니다. 연구자 1인당 코딩 에이전트에 쓰는 하루 중간 지출은 601.25달러였습니다.
자동화 연구 인턴이라는 말에는 따로 주의할 것이 있습니다. 인턴은 감독 아래 일하는 자리입니다. OpenAI가 그 선을 넘었다고 스스로 인정하는 것입니다. 연구 작업은 기업에서 가장 복잡한 인지 업무에 가깝습니다. 그 인턴을 대체할 정도라는 인정은, 코딩과 분석, 문서, 회신 같은 나머지 업무를 자동으로 한 단계 아래로 밀어 내립니다. 18개월이라는 숫자는 그 이동의 일정표와도 같습니다.
4.7시간이라는 숫자와 함께, 에이전트는 질문에 답하는 도구의 지위를 벗어나 몇 시간씩 자기 자리에서 일하는 존재가 되었습니다. 601.25달러라는 지출은 그 일의 단가를 이미 예산 문제로 만들었습니다. 18개월 뒤에는 그 직원이 자율 연구자가 됩니다. 그때부터는 일거수일투족을 사람이 들여다보지 못하는 조직에서 일이 진행됩니다.
돈의 크기도 작지 않습니다. 하루 601.25달러를 한 달 규모로 환산하면 연구자 1인당 18,000달러 안팎입니다. 대상이 한 명의 연구자를 넘어 팀이 되고, 작업이 코딩을 지나 연구와 운영으로 벌어지면 숫자는 더 빨리 커집니다. 이것은 실험 도구의 비용이 아니라 운영의 예산 항목입니다. 예산 항목이 되면 질문은 할 수 있느냐에서 멈추지 않고 하고 하면 누가 확인할까로 넘어갑니다. P50 4.7시간은 맡김의 중간값이 이미 반나절 길이로 늘었다는 뜻이기도 합니다.
이 4.7시간에는 Lean 방식의 검증이 함께 오지 않는다는 것이 문제입니다. Claude는 1300만 줄을 기계가 검증하는 형태로 만들었습니다. 반면 내부 시스템을 4.7시간 구른 에이전트는 성공이든 실패든 검증해 달라는 형태로 무엇을 남기지는 않습니다. 벤치마크는 그 모델의 평균 기량만 알려 줍니다. 어제 그 에이전트가 내 환경에서 무엇을 했는지는 알 수 없습니다. 정답의 단위가 결과에서 과정으로 이동하고 있는데, 과정의 검증은 아직 아무도 만들어 주지 않는 상태입니다.
멈춰 달라는 목소리는 연구소에서 나옵니다
같은 아침, 또 다른 장면도 함께 온 것이 있습니다. OpenAI 수석과학자 야쿱 파초츠키는 안전 기준이 범세계적으로 합의될 때까지, AI 모델의 최대 속도 확장을 멈추자고 촉구했습니다. 덧붙인 말이 오늘 가장 무거운 문장입니다. 어느 연구소도 정렬 문제를 완전히 해결하지 못했다는 말입니다.
규모를 키우는 쪽에서 일단 멈추자고 말하는 것입니다. 이례적인 신호입니다. 아무도 정렬을 해결하지 못했다는 인정은, 모델 벤더가 안전을 완성품 상태로 보장해 줄 수 없다는 뜻에 가깝습니다. 기업은 두 길 중 하나를 골라야 합니다. 하나는 벤더의 말을 믿고 넘기는 것, 다른 하나는 확인하는 구조를 자기 손으로 짓는 것입니다.
일시정지 촉구의 무게를 짚어 보겠습니다. 멈추라는 말이 나오는 쪽이 확장 경쟁의 주연인 연구소이기 때문입니다. 말하는 사람은 OpenAI의 수석과학자입니다. 자사의 최대 속도 확장을 스스로 멈출 것을 촉구하고 있습니다. 어느 연구소도 정렬을 해결하지 못했다는 말은 업계 전체의 진단이라기보다, 그 자신이 속한 조직을 포함한 자기 인정에 가깝습니다. 그래서 기업에 남는 선택지는 안전한 모델을 산다가 아닙니다. 스스로 확인할 수 있는 구조를 갖춘다가 지금의 선택지입니다. 대화 중심은 이미 바뀌었습니다. 어떤 모델이 강한가가 아니라, 어떤 구조가 확인 가능한가입니다.
페르마의 형식화가 여기서 주는 교훈은 단순합니다. 증명을 믿는 가장 좋은 방법은 증명 자체를 다시 확인하는 것입니다. 에이전트에게도 같은 문법이 적용됩니다. 그 에이전트가 잘했을 거라고 말하는 대신, 그 에이전트가 한 일을 기계가 다시 살필 수 있는 상태가 되는 것입니다. 정렬이 연구소의 과제인 동안, 실행 환경의 통제는 기업이 오늘 당장 지을 수 있는 구조입니다.
Paxis는 과정을 검증으로 만듭니다
ThakiCloud의 Paxis는 바로 이런 문제의식에서 출발한 에이전트 네이티브 클라우드입니다. 정식 제품 v1.1 GA로 서비스됩니다. Paxis에서 일급 자원은 Skills, Tools, Policies, Audit Logs입니다. 모델은 이 자원을 통과하는 하나의 구성 요소입니다.
Lean 검증 프로그램이 증명의 각 단계를 규칙대로 검사하듯, Paxis는 에이전트 실행을 구조로 검사합니다. 자율도는 L0에서 L3까지로 나누어 거버넌스가 적용됩니다. 정책 게이트를 통과하지 못한 동작은 격리된 샌드박스 안에서만 실행됩니다. 모든 흔적은 감사 로그로 기록됩니다. MCP 커넥터와 스킬 마켓으로 도구와 기술을 붙입니다. 전체를 소버린 또는 온프레미스 K8s(ai-platform) 환경에 내려놓을 수도 있습니다.
자율도를 L0에서 L3까지로 나누는 이유는, 4.7시간짜리 작업과 짧은 작업을 같은 기준으로 맡길 수 없기 때문입니다. 정책 게이트는 모델이 정렬됐느냐의 질문을, 이 동작이 이 환경에서 허용되는가의 질문으로 바꿔 줍니다. 정렬은 아직 아무 연구소도 해결하지 못합니다. 하지만 허용의 경계는 오늘 당장 그을 수 있습니다. 감사 로그의 역할은 다음에 같은 일을 맡길 때의 근거가 되는 것입니다.
앞서 나온 숫자들을 이 구조 안에서 다시 보면 메시지가 정리됩니다. 4.7시간의 자율 작업은 감사 로그가 있는 한 재생하고 감사할 수 있는 과정이 됩니다. 하루 601.25달러의 지출은 어떤 작업에 어떤 모델을 쓸 것인지라는 문제로 바뀝니다. CostRouter가 이를 처리합니다. 브라우저 작업에는 그날 벤치마크에서 가장 좋은 점수를 받은 모델을 씁니다. 나머지 반복 업무는 더 가벼운 모델로 돌리는 식입니다. 모델은 점수 순위대로 한 번 고르는 물건이 아닙니다. 업무마다 매번 달라지는 변수입니다.
77.3퍼센트는 믿어주어야 하는 숫자였습니다. 그런데 그 점수를 남긴 모델, 그 모델이 동작하는 정책, 그 과정이 기록되는 위치를 구조가 알아줄 때 그 신뢰는 기업이 실제로 걸 수 있는 것이 됩니다. 벤치마크 점수는 내일도, 모레도 올 것입니다. 기계가 검증하는 증명도 더 큰 규모의 것으로 올 것입니다. 바뀌지 않는 것은 이 둘 사이의 간극을 누가 메우느냐입니다. 점수는 믿어주되 과정은 확인합니다. 오늘 아침 온 두 숫자는 이 모양 그대로입니다.
참고 자료
이 글은 아래 뉴스를 종합해 작성했습니다.
- HuggingNews, OpenAI Chief Scientist Urges Scaling Slowdown, Says No Lab Solves Alignment
- HuggingNews, OpenAI’s Astra Scores 77.3% on Browser Use Benchmark v2 Versus Opus 5’s 50.5%
- HuggingNews, OpenAI Says It Hit Automated Research Intern Goal and Targets Autonomous AI Researcher in 18 Months
- HuggingNews, Anthropic’s Claude Formalizes Fermat’s Last Theorem in Largest Lean Proof to Date