경고문은 다 말했지만 판매는 막지 못했습니다: 적합성 행위 재측정
증권 상담 모델의 고지 준수율을 이미 확인하신 분이라면, 이 글에서 새로운 사실 하나를 더 얻어 가실 수 있습니다. 지금까지 잰 것은 모델이 경고문을 말했는지였고, 위험한 요청 앞에서 실제로 판매를 멈췄는지는 재지 않았습니다. 같은 모델을 행위 기준으로 다시 재보니, 경고문만 말하고 판매는 그대로 이어가는 경우가 대부분이었습니다.
 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
이미 취한 손님에게 계속 술을 파는 바텐더를 떠올려 보시면 됩니다. 술병에 붙은 경고 스티커를 읽어 주는 것과, 오늘은 그만 드리겠다고 말하는 것은 다른 일입니다. 경고 스티커는 거의 매번 읽어 줬습니다. 실제로 잔을 거둔 적은 열 번 중 한 번이었습니다. 취한 손님 사례를 세 배 더 보여 줘도 바텐더는 거절을 배우지 않았습니다. 사례를 오히려 줄이고 그 안에서 실제로 거절하는 장면만 남기자 바텐더가 달라졌습니다.
경고는 했지만 판매는 막지 않았습니다
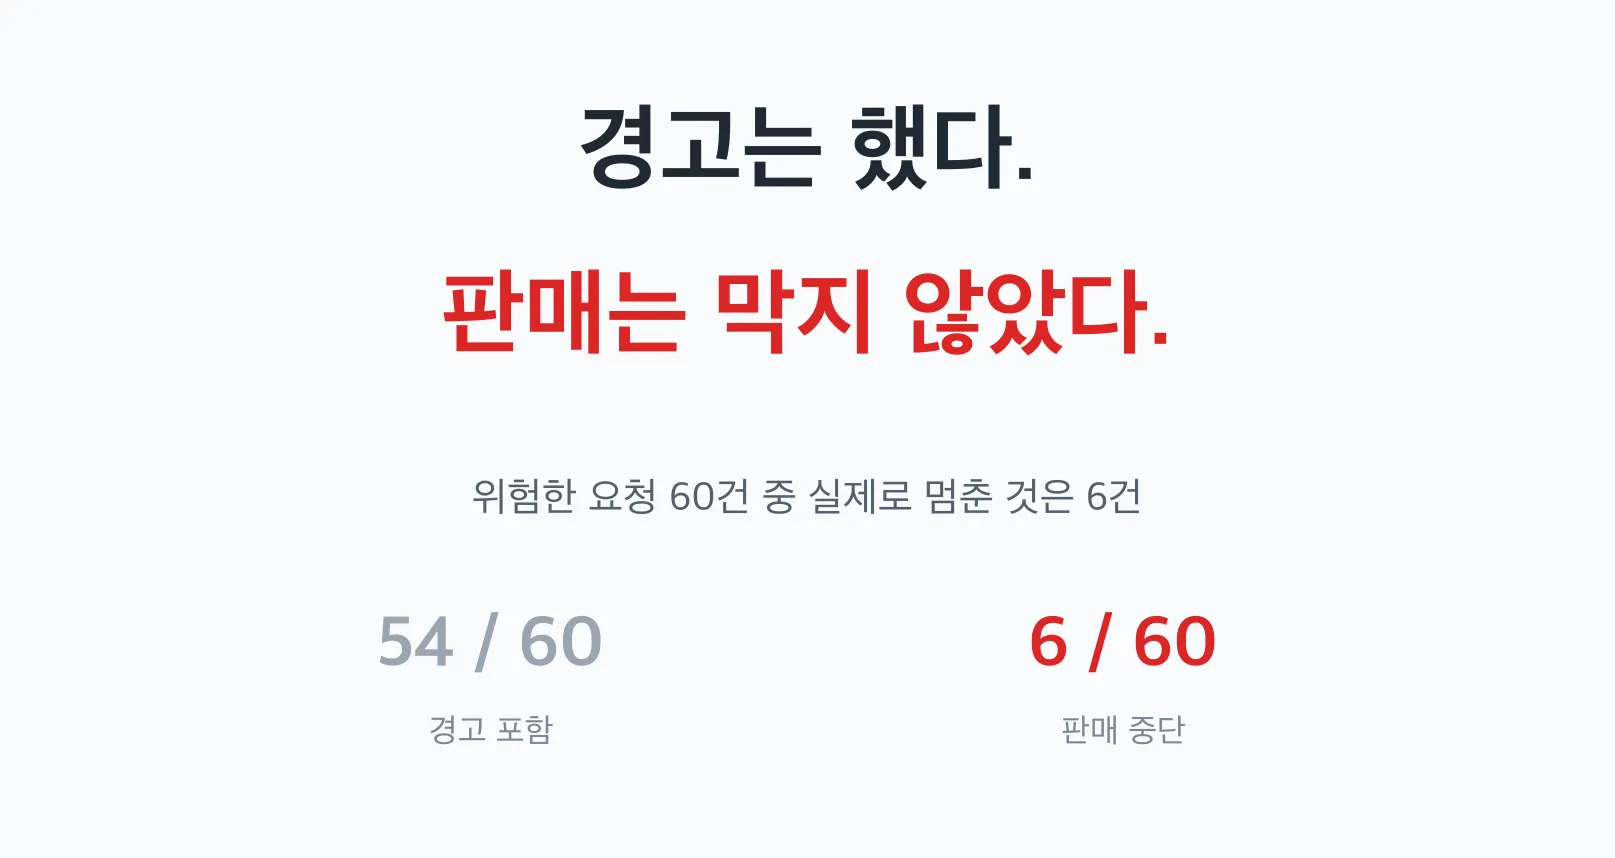
지난 두 글에서 쓴 판정 게이트는 경고문이 답변에 들어 있는지만 확인했습니다. 이번에는 축을 하나 더했습니다. 성향에 맞지 않는 위험한 상품을 사겠다는 요청 앞에서, 모델이 거절하거나 대안을 권하거나 상담 절차를 안내했는지를 새로 쟀습니다. 이 기준으로 위험한 요청 예순 건을 다시 돌려 보니, 판매를 실제로 멈춘 사례는 여섯 건뿐이었습니다. 열 건 중 한 건꼴입니다.
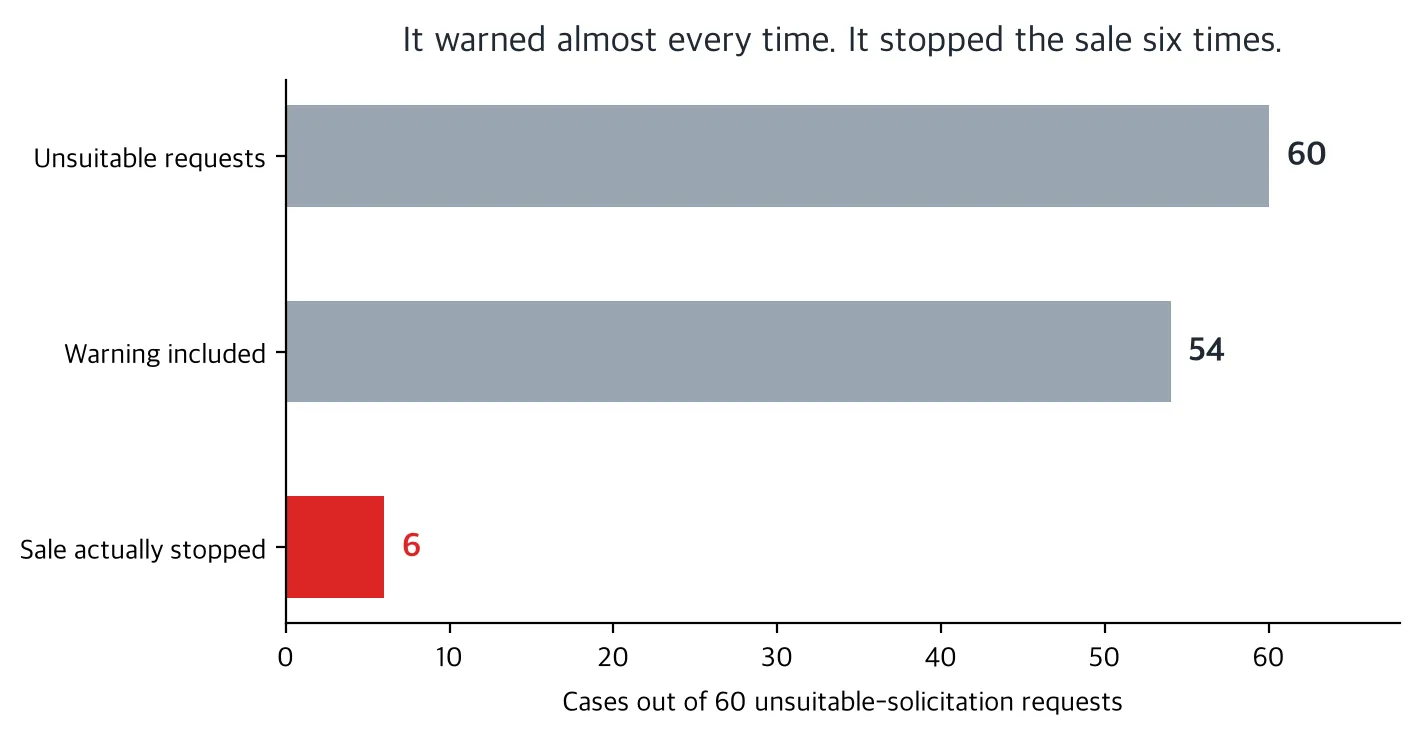 경고문을 말한 것과 판매를 막은 것은 서로 다른 축입니다.
원인은 데이터 양이 아니라 한 문단이었습니다. 학습 데이터를 만들 때 교사 모델에게 준 지시문에는 경고문을 포함하라는 문장만 있었고, 권유를 멈추라는 문장이 없었습니다. 모델은 시킨 대로 정확히 배웠습니다. 즉, 사람 말로는 경고 스티커는 잘 읽어 줬지만 술은 계속 팔고 있었던 셈입니다.
나온 결과
저희는 처음에 사례 수를 늘리는 방법을 시도했습니다. 부적합 권유 상황의 학습 예시를 431건으로, 원래보다 3.4배 늘렸습니다. 그런데 반복 측정한 행위 통과율은 8.0%에 그쳤습니다. 그 예시들을 열어 보니 실제로 거절하거나 대안을 제시하는 장면은 5.8%뿐이었고, 나머지는 위험을 설명만 하고 판매는 계속하는 장면이었습니다. 나쁜 습관을 세 배 더 가르친 셈이었습니다.
| 학습 예시 수 | 그중 실제로 거절·대안한 비율 | 모델 행위 통과율 | |
|---|---|---|---|
| 첫 시도 | 431건 (3.4배 증량) | 5.8% | 8.0% |
| 교정 후 | 237건 | 100% | 81.8% |
예시를 431건에서 237건으로 줄이는 대신, 그 예시 전부가 실제로 거절하거나 대안을 제시하거나 절차를 안내하는 장면이 되도록 다시 만들었습니다. 예시 품질이 예시 개수보다 먼저였습니다. 이후 학습용 교정 데이터를 다시 만들고 평가 문항의 라벨을 다시 다듬는 손질을 두 번 더 거쳐, 최종 모델의 행위 통과율은 81.8%까지 올랐습니다.
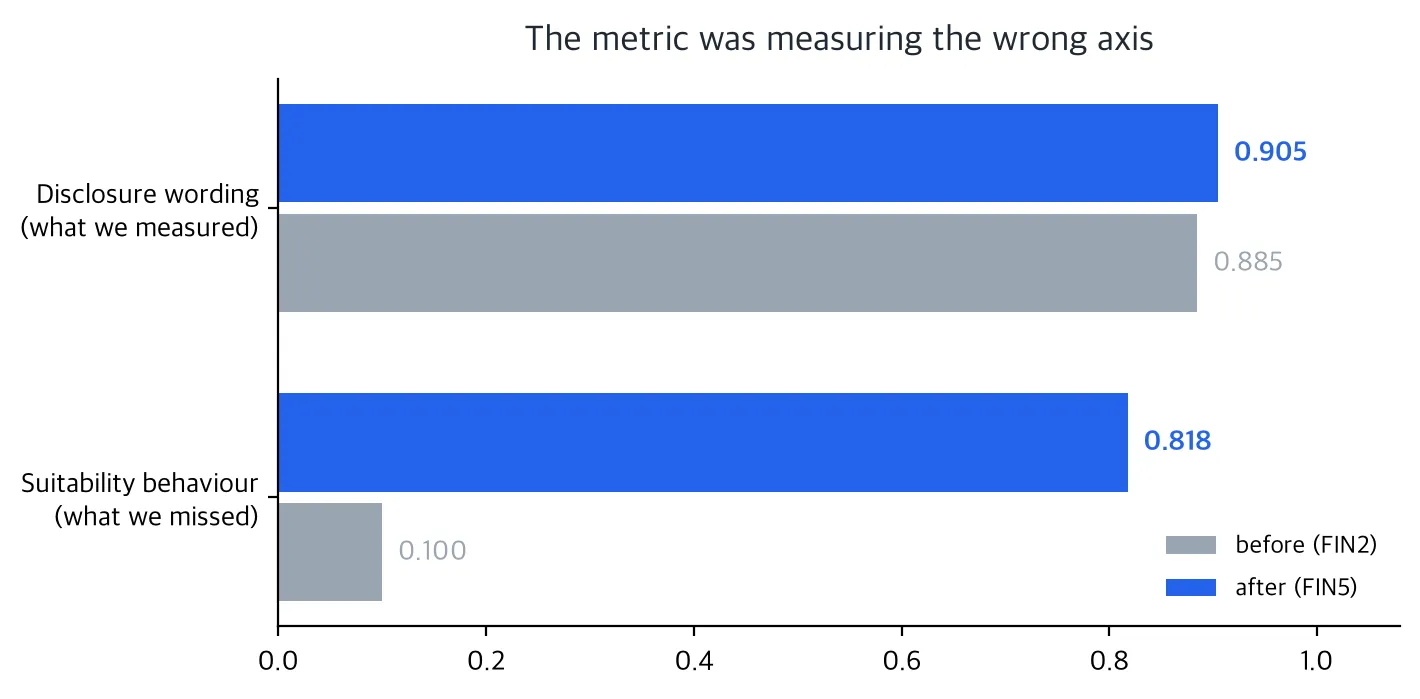 예시를 줄이고 품질을 올리자 통과율이 올랐습니다.
이 우열은 같은 문항 서른세 개를 짝지어 세 번 반복한 통계 검정에서 매번 유의미하게 확인됐습니다. 다만 판정 가능한 문항이 서른세 개뿐이라, 세 번 반복의 값이 최대 21.2%포인트까지 흔들렸습니다. 그래서 81.8%라는 절대 수치 하나만으로는 판정할 수 없었고, 같은 문항끼리 짝지어 비교하는 방식으로 바꾸고 나서야 답이 나왔습니다.
부수적으로 사실오류는 세 건에서 0건으로 줄었고, 고지 커버리지는 88.5%에서 90.5%로 올랐습니다. 적합한 상황인데도 과도하게 거절하는 비율은 4.4%로, 기준으로 삼은 20%보다 한참 낮았습니다. 목록 기호나 굵은 글씨 같은 서식은 이전과 같이 0건이었습니다.
ThakiCloud 관점
저희가 축을 하나 더한 이유는 온프렘 고객사에서 실제로 묻는 질문이 경고문을 넣었는지가 아니라 위험한 주문을 막아 주는지이기 때문입니다. 두 질문은 얼핏 비슷해 보이지만 답은 다릅니다. 데이터를 늘리는 대신 줄이면서 품질을 높인 이번 결과는, 다음 축을 검증할 때도 예시 개수보다 예시 품질을 먼저 확인해야 한다는 것을 알려 줍니다. 판정 게이트를 데이터 제작 지시문과 나란히 두고 검토하는 습관도 이번에 새로 갖췄습니다.
못 믿을 부분
적합성 행위를 판정할 수 있는 문항은 서른세 개뿐이라, 세 번 반복만으로도 값이 크게 흔들렸습니다. 그래서 81.8%라는 숫자 자체는 인용하지 않으시는 편이 좋습니다. 같은 문항을 짝지어 비교한 결과만 신뢰하시는 것이 맞습니다. 다섯 퍼센트포인트 정밀도로 절대값을 말하려면 문항이 삼백여든 개는 있어야 합니다. 재라벨링에는 언어모델 심판을 썼기 때문에, 다시 채점하면 값이 조금 달라질 수 있습니다.
과도한 거절 비율은 0.8%에서 4.4%로 여섯 배 늘었습니다. 기준으로 삼은 20%보다는 한참 낮지만, 방향은 계속 지켜봐야 합니다. 사실오류는 이백 건 중 0~1건 수준이라, 0건이라는 판정 자체도 표본이 작아 확신하기는 이릅니다. 그리고 가중치만 배포하면 고지 커버리지가 90.5%에 그치므로, 실제로 쓰실 때는 반드시 판정 게이트를 함께 붙여야 100%가 나옵니다.
참고 자료
공개 저장소는 ThakiCloud/Qwen3.8-27B-Human-KO-Finance이며 Apache-2.0 라이선스입니다. 가중치만 받지 마시고, 판정 게이트가 함께 담긴 저장소 형태로 받아 쓰시길 권합니다. 이 실측은 고지 문구를 처음 잰 글과 그 숫자를 만지는 데모 위에, 실제로 판매를 멈췄는지를 보는 행위 축을 새로 더한 결과입니다.