Hi3D 1.0, 200만 자산으로 실전 검증한 이미지-3D 모델이 오픈소스로
왜 읽어야 하나
3D 에셋 파이프라인을 돌리는 콘텐츠 팀, 이미지-3D 워크로드를 서빙할 플랫폼 엔지니어라면 이 글을 읽어야 합니다. 핵심 결론을 먼저 적습니다. Hi3D V1.0(구 Sparc3D)은 실전 워크플로에서 검증됐다는 점을 앞세운 오픈소스 이미지-3D 기하 정밀화 모델이고 학습 자산 200만 개와 기술 보고서의 3D 프린팅 슬라이싱 통과율 90퍼센트는 이 분야에서 오픈된 모델로는 손에 꼽는 수치입니다. 다만 기하 전용이고 NVIDIA GPU가 필수이며 벤치마크 분할과 훈련 코드는 담기지 않았습니다. 쓸지 말지는 아래 숫자를 보고 정하시면 됩니다.
개요
Hi3D는 10월 27일경 V1.0을 오픈소스로 공개했습니다. 개발 당시 이름은 Sparc3D였고 공개와 함께 제품명이 Hi3D로 정리됐습니다. 공개 목적은 연구, 개발, 생산 세 가지입니다. 모델 인퍼런스 코드, 가중치, 문서가 GitHub의 hi3d-official/Hi3Dv1.0에 올라 있고 가중치는 Hugging Face의 hi3d-official/Hi3Dv1.0에서 내려받을 수 있습니다. 온라인 데모는 Hugging Face Space(ilcve21/Sparc3D)에서 돌립니다.
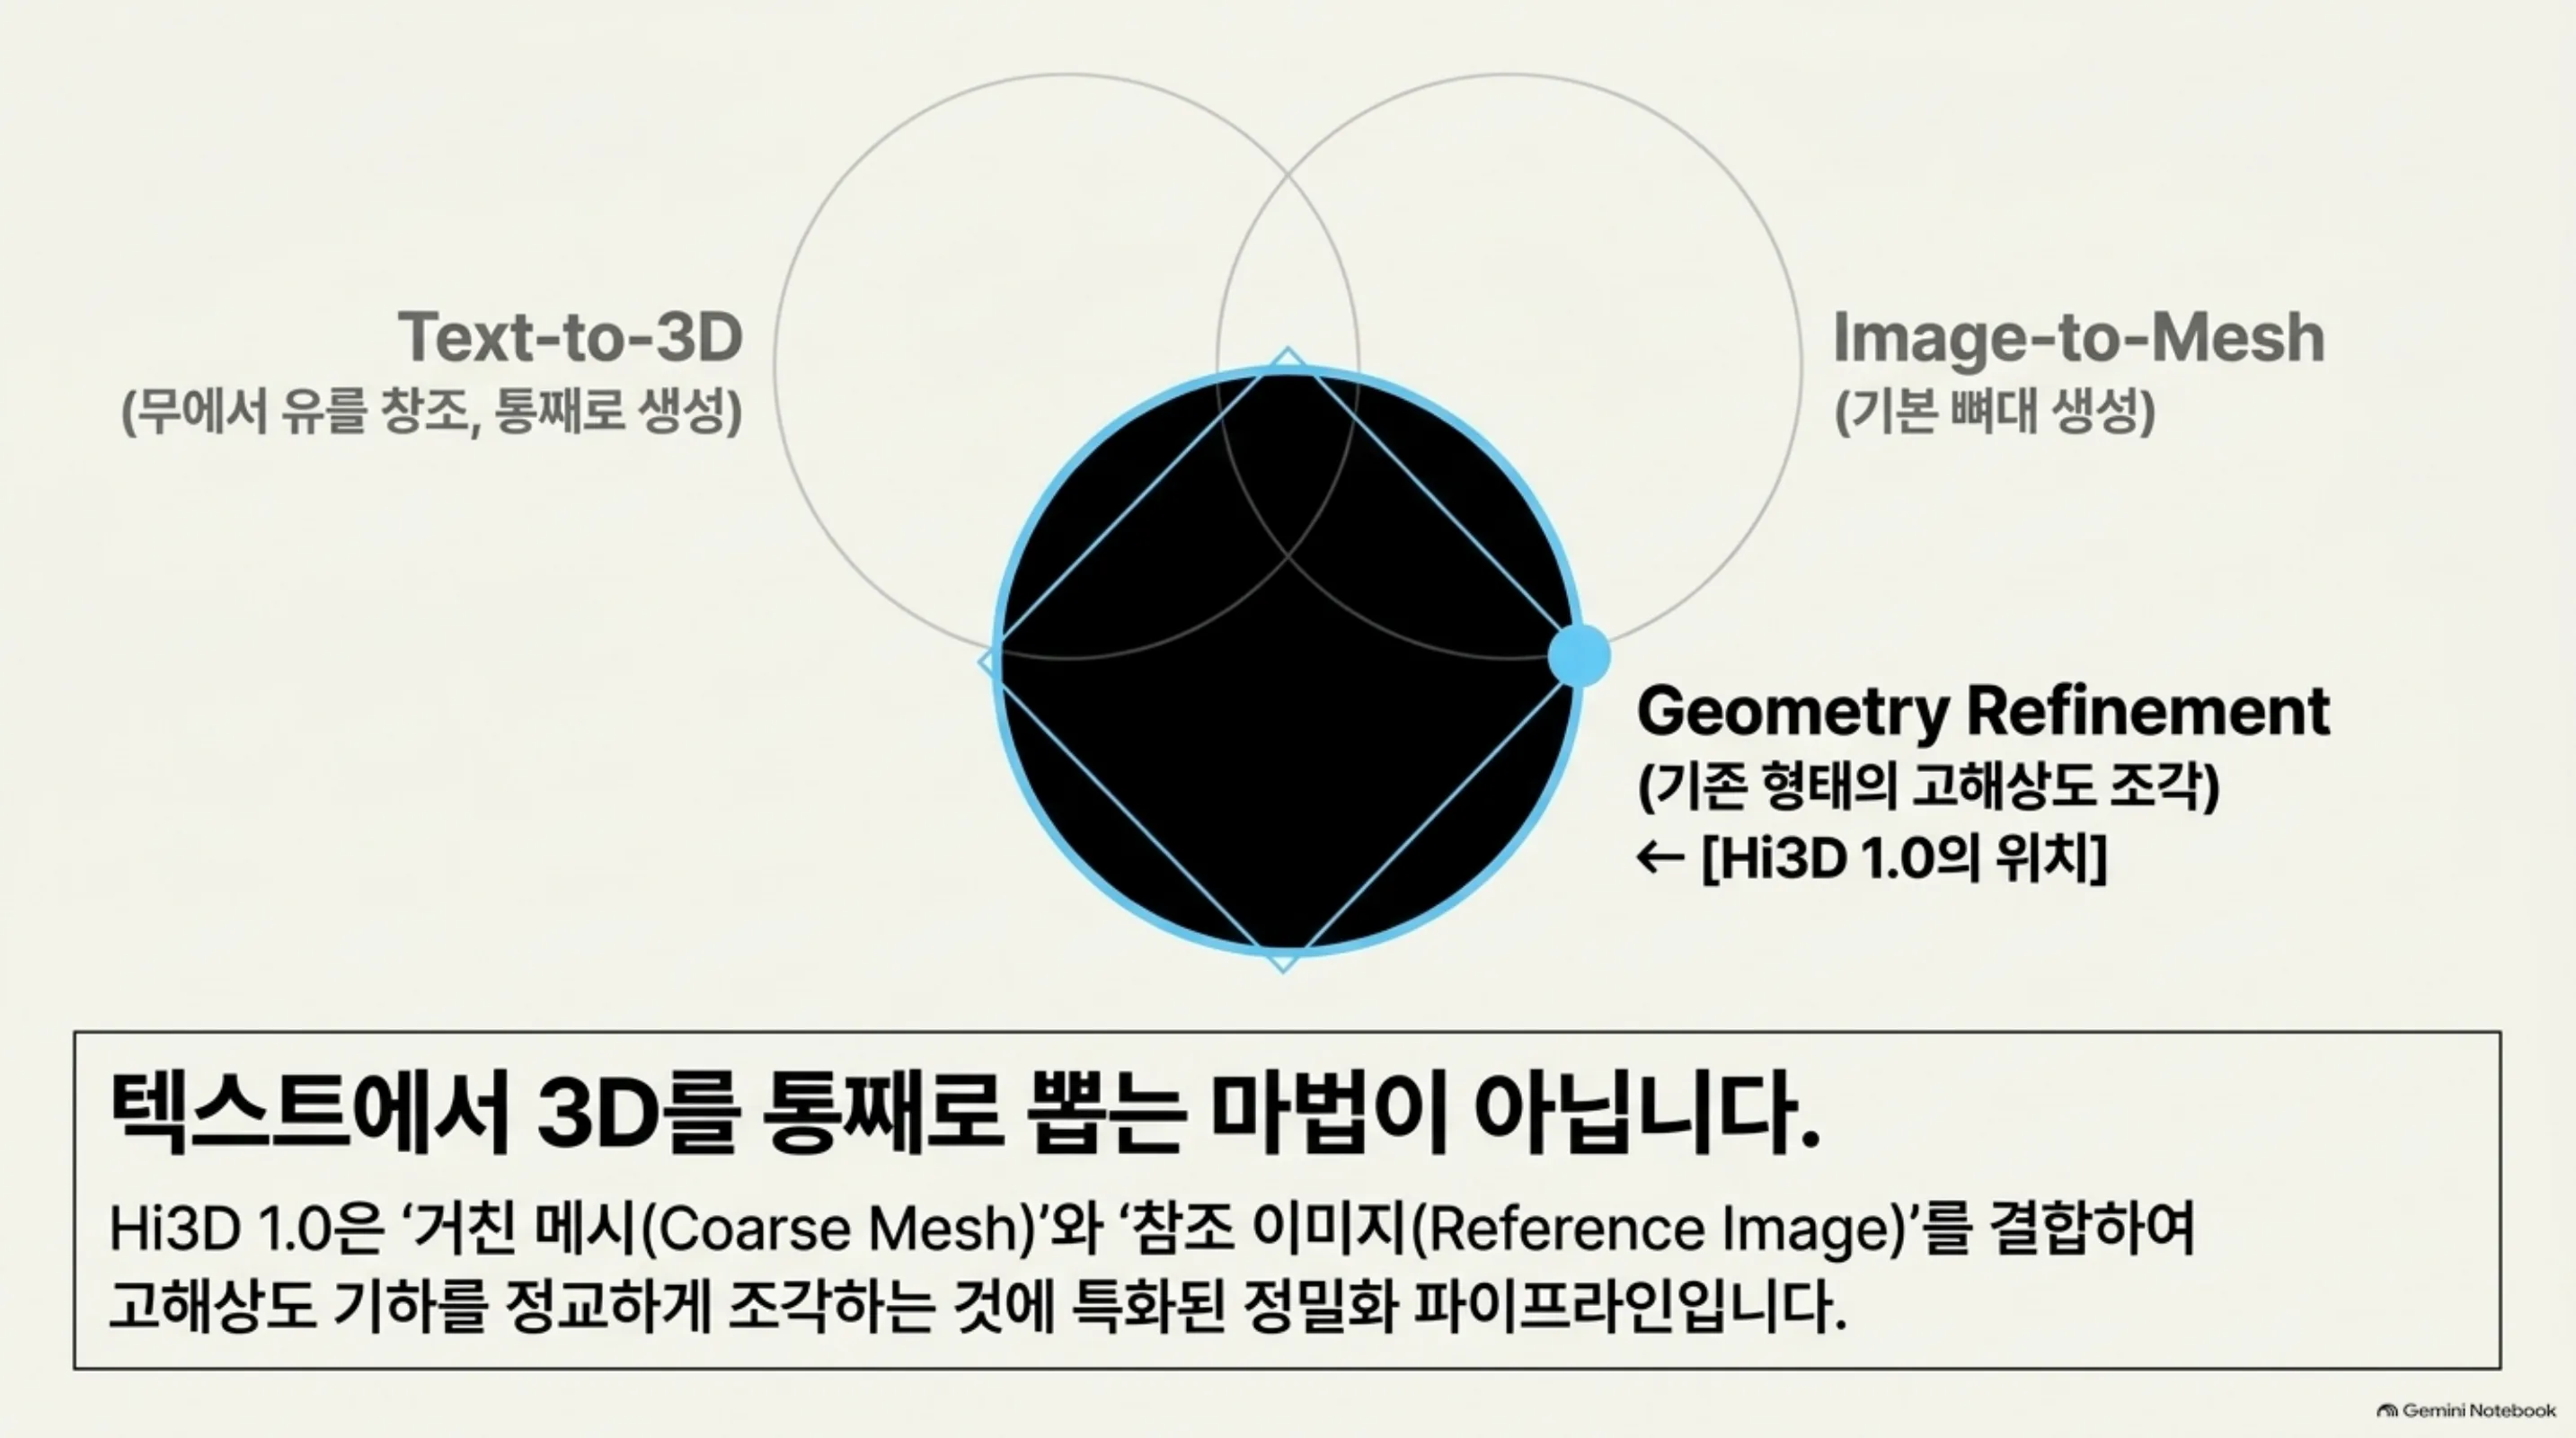
3D 생성 모델의 지도를 짚으면 Hi3D의 위치가 명확해집니다. 텍스트에서 3D를 통째로 뽑는 모델, 이미지에서 점군이나 메시를 만드는 모델, 그리고 이미 만들어진 거친 기하를 고해상도로 다듬는 모델은 서로 다른 작업입니다. Hi3D V1.0은 이 세 번째 작업, 기하 정밀화에 특화되어 있습니다. 거친 메시가 없는 워크플로에는 image_to_mesh 경로가 있지만 강점은 참조 이미지와 기존 기하가 함께 들어오는 정밀화 단계입니다.
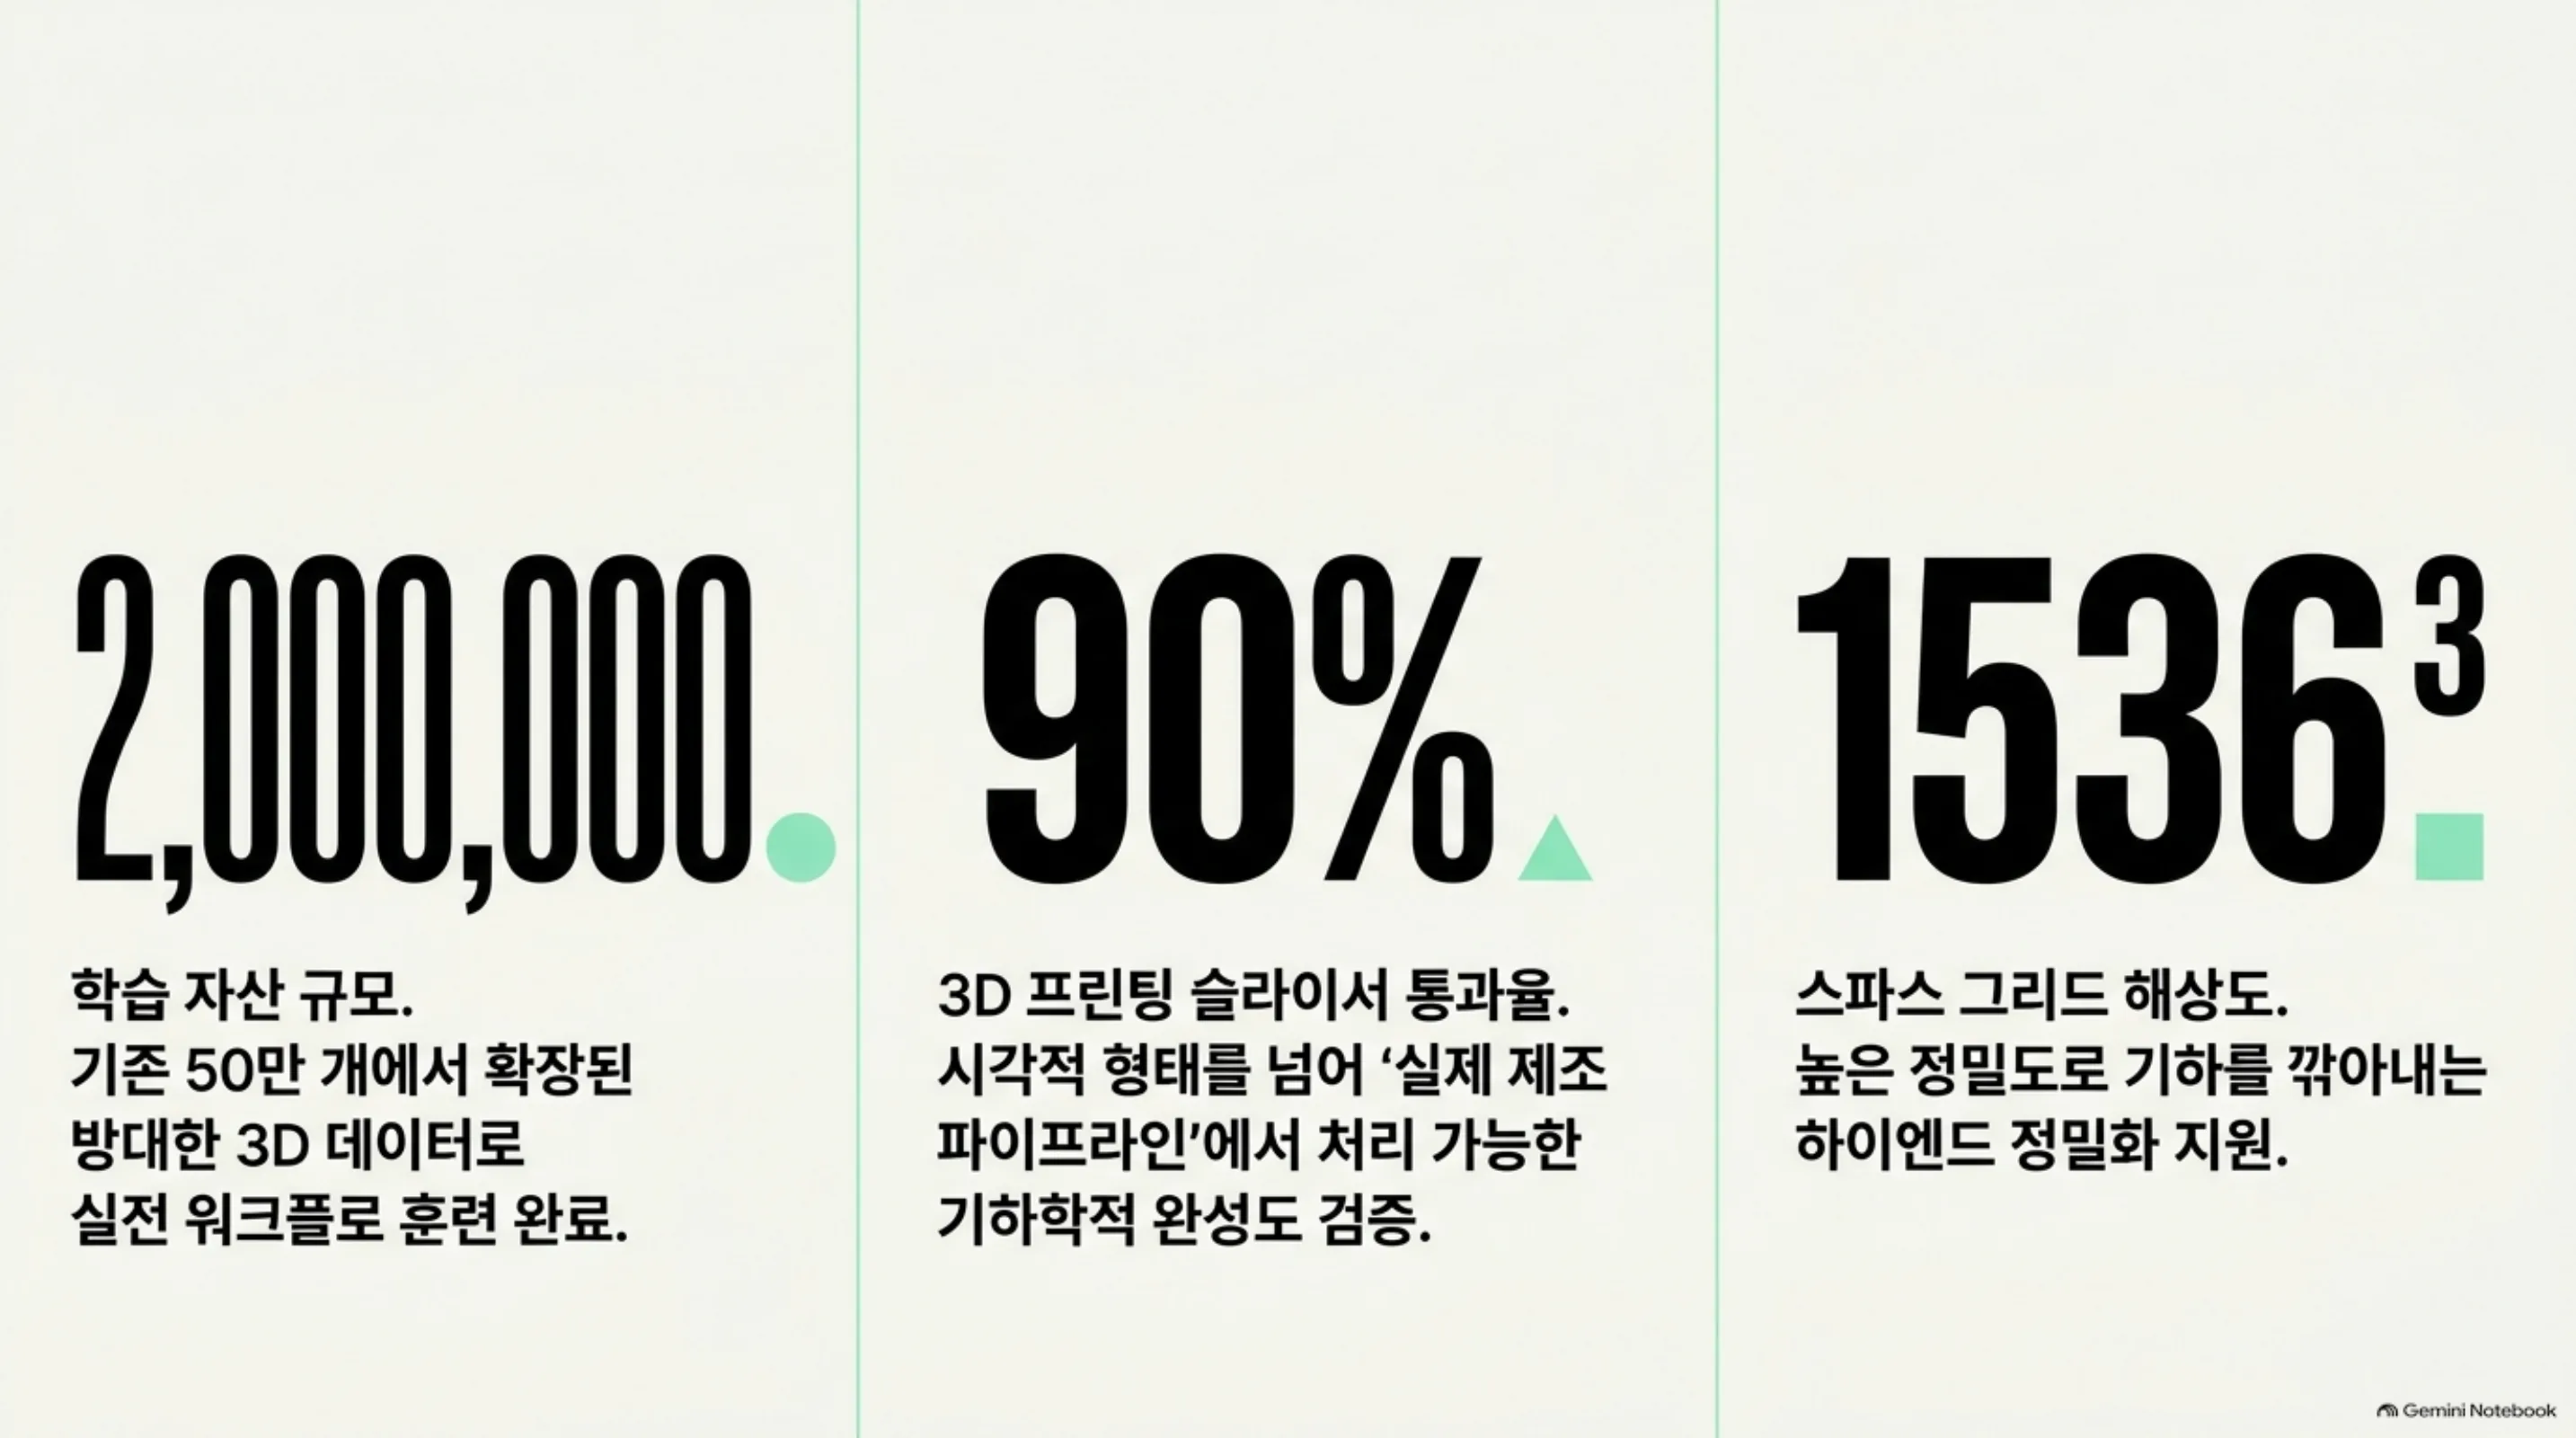
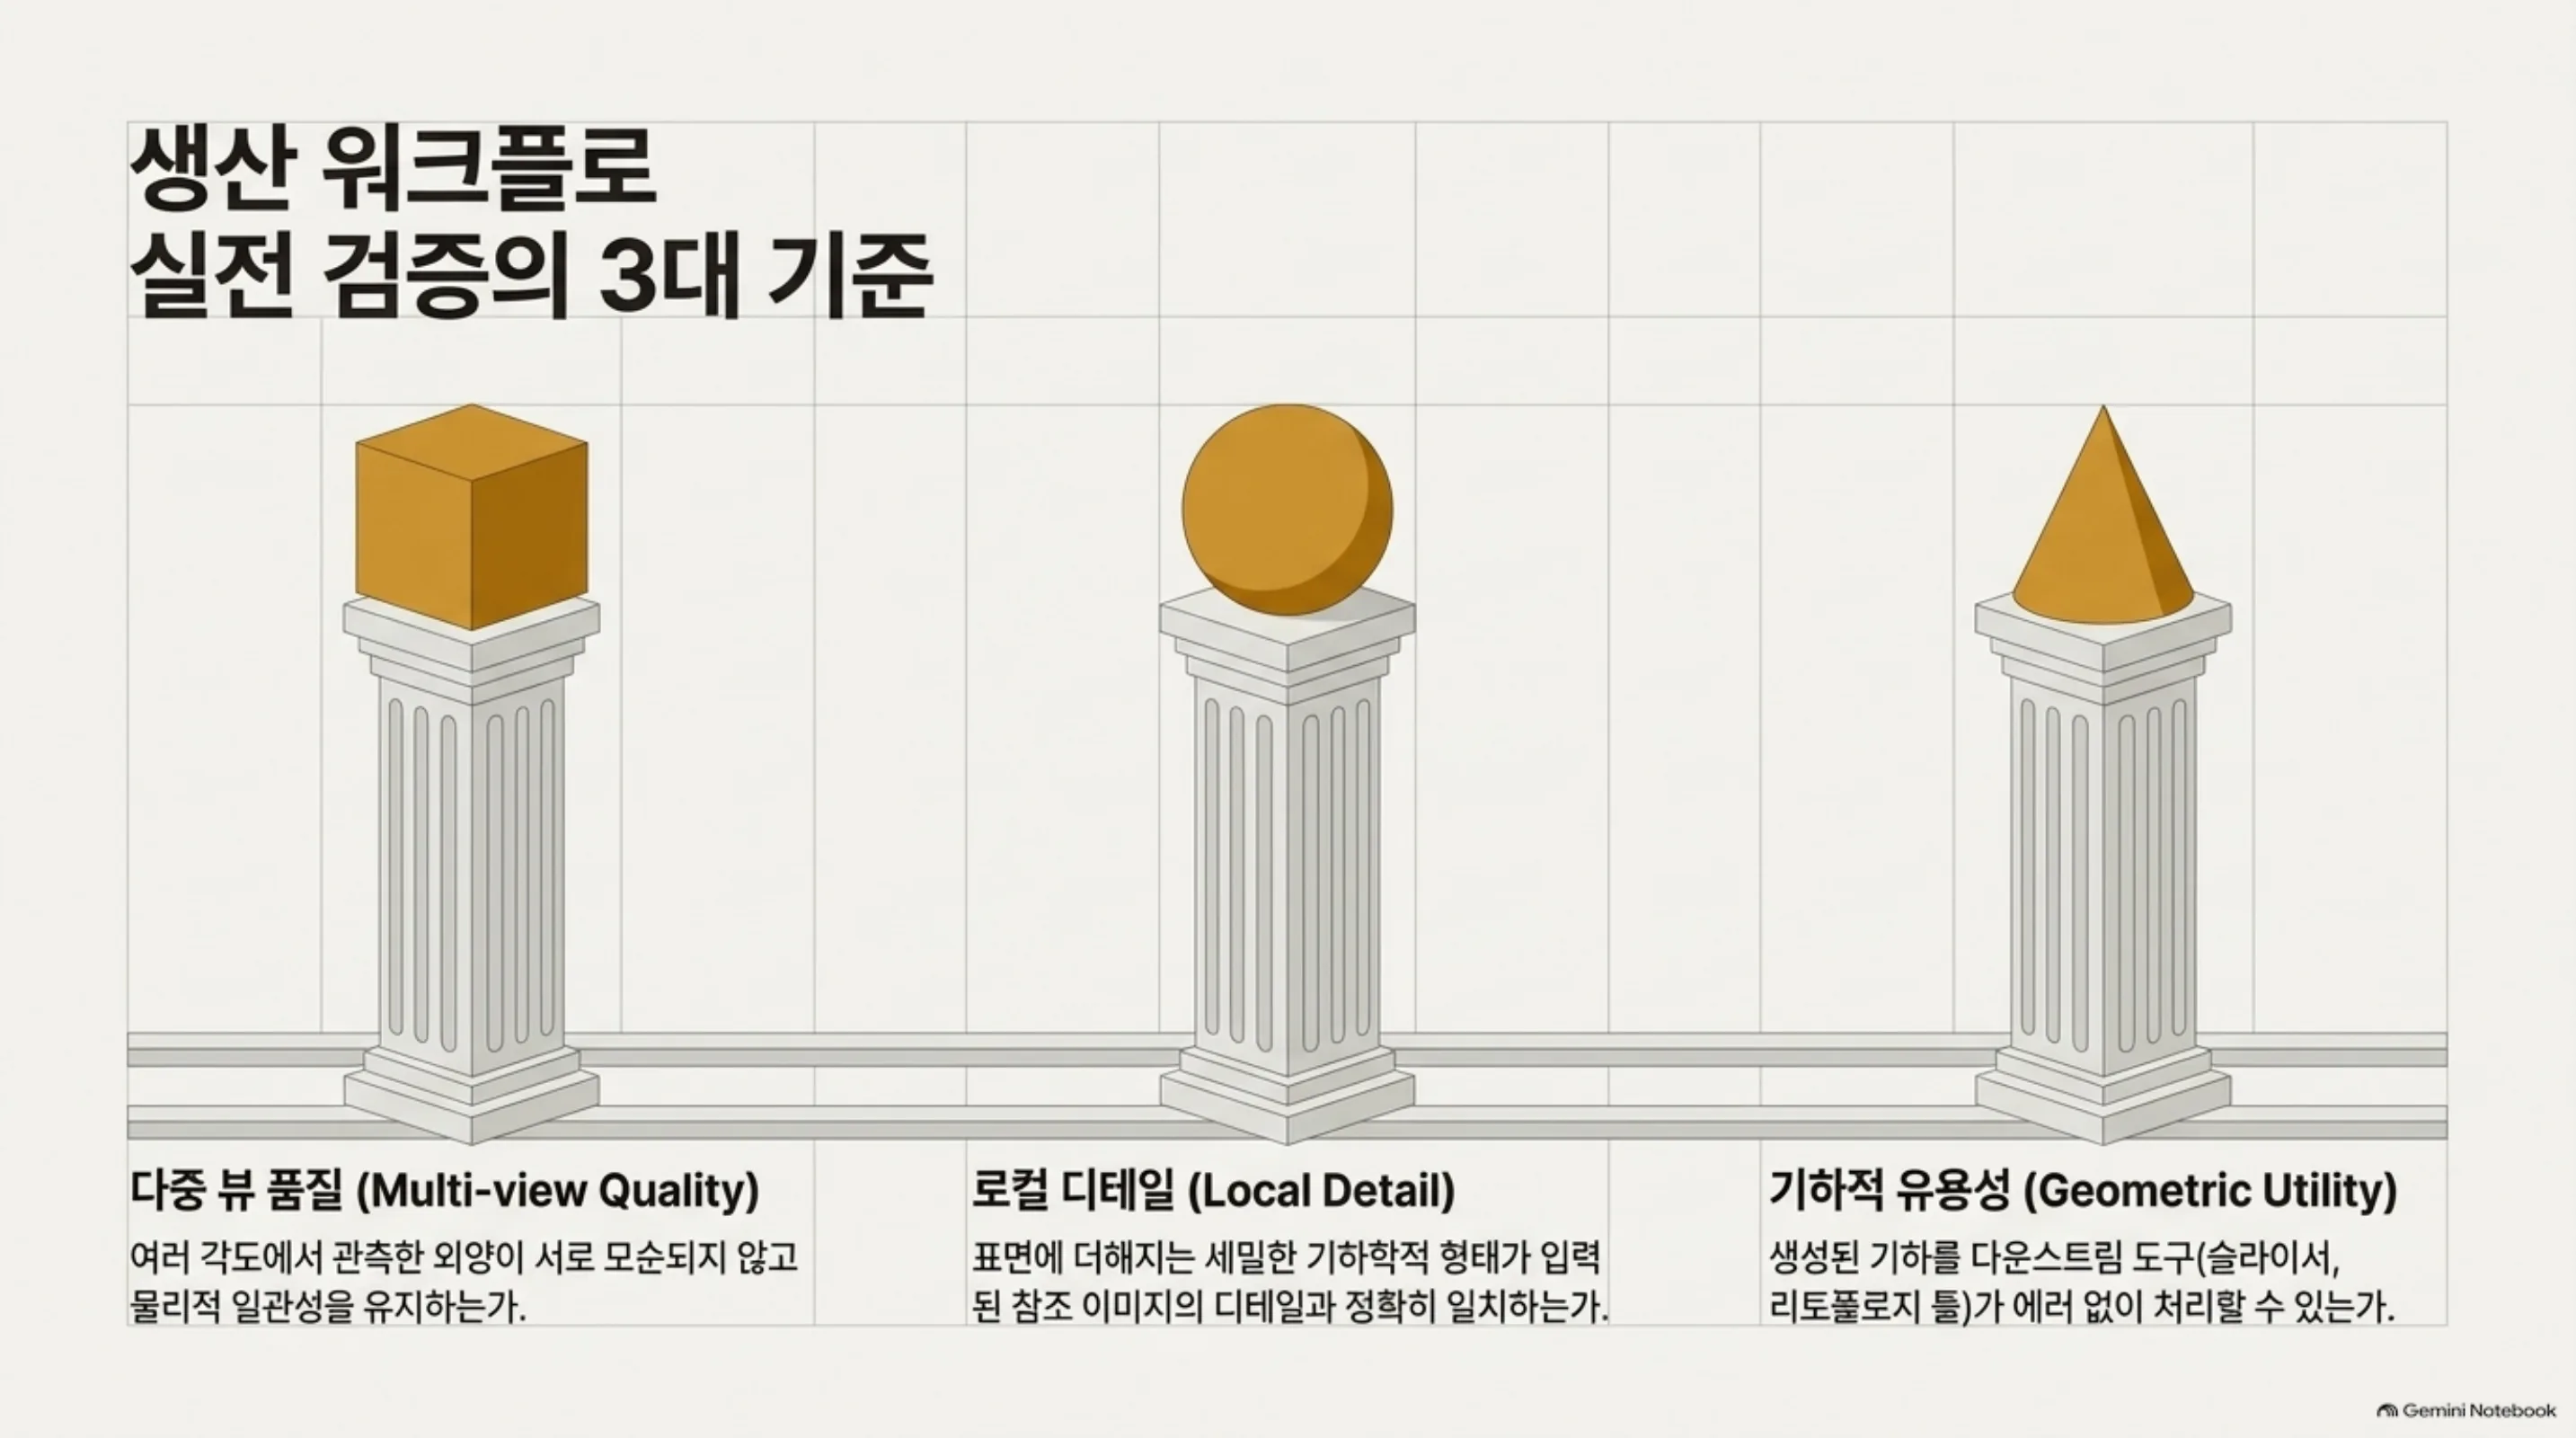
이 모델은 이미 상업 서비스에서 사용된 이력이 있습니다. Hi3D V3.0이 유료 서비스로 돌아가는 가운데, V1.0은 “실전 검증된” 버전으로 오픈소스에 내려온 구조입니다. 발표에 따르면 V1.0은 실제 생산 워크플로에서 다중 뷰 품질, 로컬 디테일, 기하적 유용성 세 기준으로 검증됐고 학습 데이터셋은 기존 Sparc3D 설정의 50만 개 자산에서 약 200만 개 3D 자산으로 늘었습니다. 추가로 1536³ 스파스 그리드 해상도 학습 데이터도 붙었습니다.
기술 보고서는 생성된 3D 모델의 90퍼센트가 3D 프린팅 슬라이싱을 통과한다고 적었습니다. 공개된 저장소에는 이 슬라이싱 검증의 분할이나 비교 메시가 담겨 있지 않습니다. 인퍼런스 검증용으로만 공개된다는 점은 아래 한계 섹션에서 다시 짚습니다.
Hi3D는 무엇인가
Hi3D V1.0이 하는 일은 기하 정밀화입니다. 거친 메시(coarse mesh)와 참조 이미지 한 장을 받아, 고해상도 기하를 뽑습니다. 사진에서 물체 하나를 통째로 만드는 “텍스트-3D”류가 아니라, 기존 기하를 참조 이미지와 함께 정교하게 다듬는 “이미지-3D 정밀화” 파이프라인의 한 단계입니다. 저장소에는 image_to_mesh.py(이미지에서 메시 생성)와 refine_mesh.py(메시 정밀화) 두 가지 데모가 함께 나옵니다.
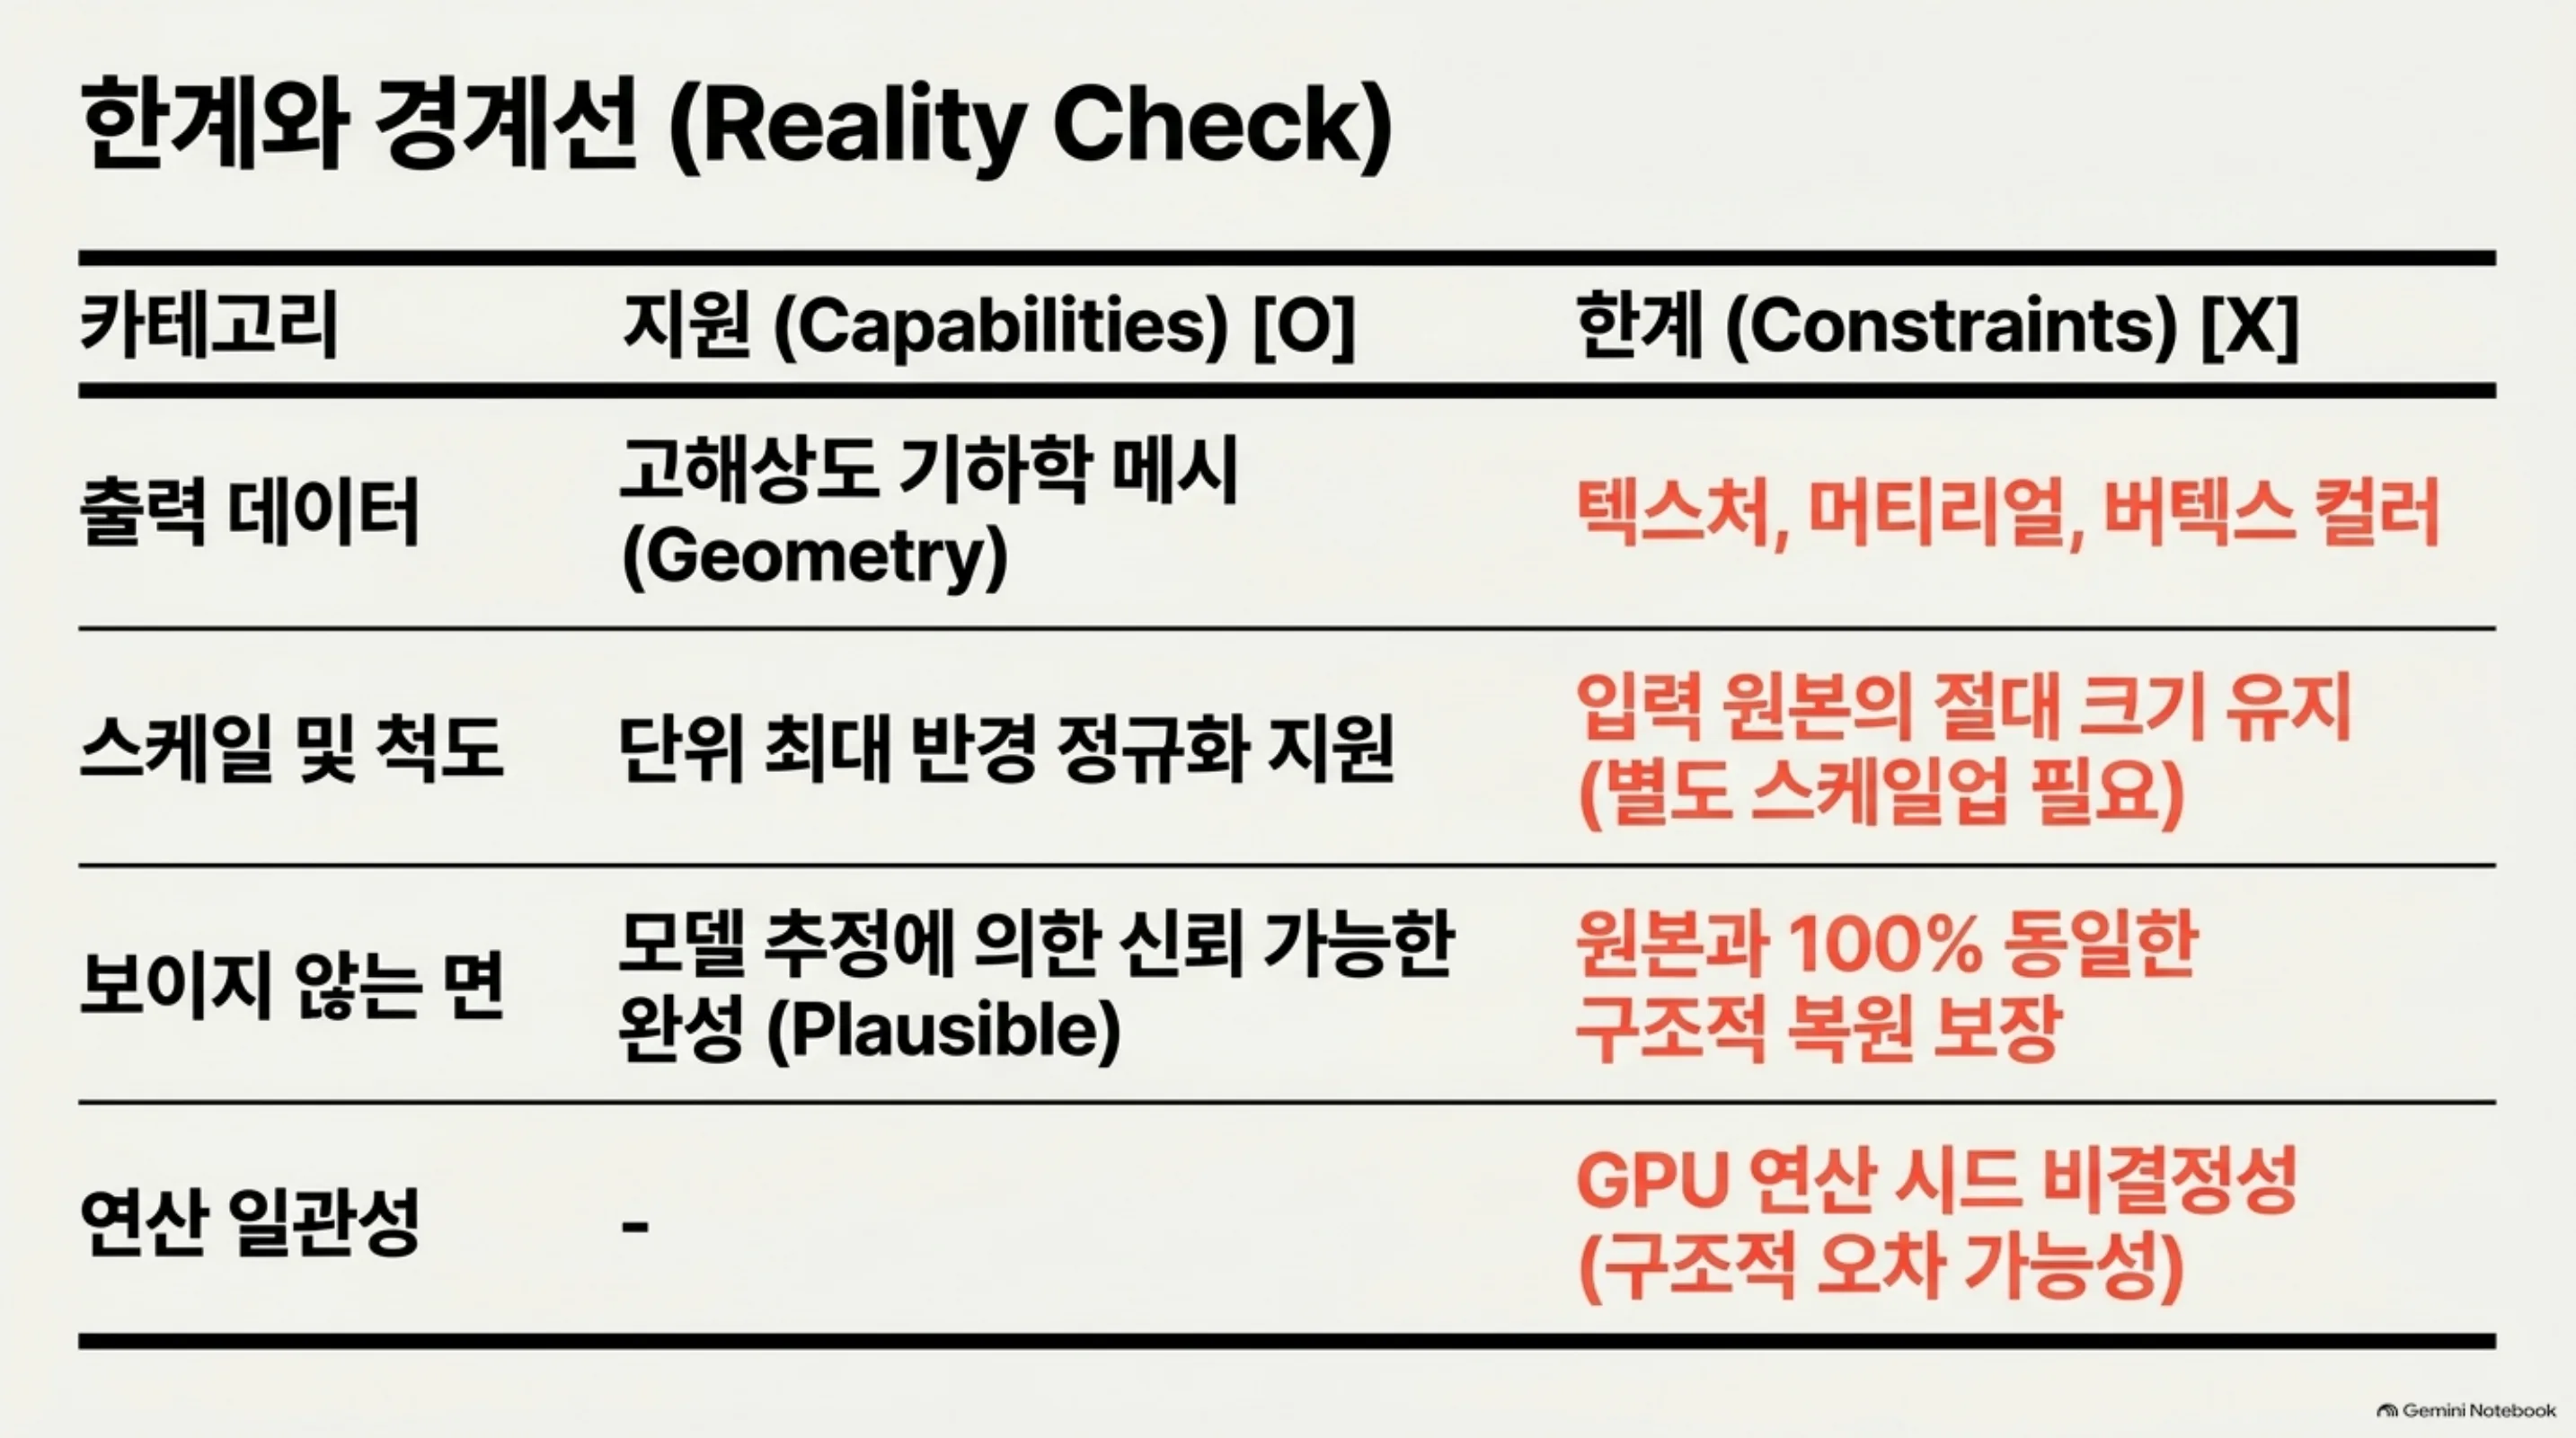
입력 계약이 구체적입니다. 거친 메시와 참조 이미지가 한 쌍으로 들어오고 참조 이미지는 그 메시가 어떤 표면과 디테일을 가질지를 결정하는 근거가 됩니다. 출력 메시는 단위 최대 반경으로 정규화되어 입력의 절대 크기를 유지하지 않으므로, 실물 스케일에 맞춘 에셋을 원하면 스케일 변환 단계를 파이프라인에 붙여야 합니다. batch size는 1이고 병렬 배치 인퍼런스는 구조상 지원하지 않습니다.
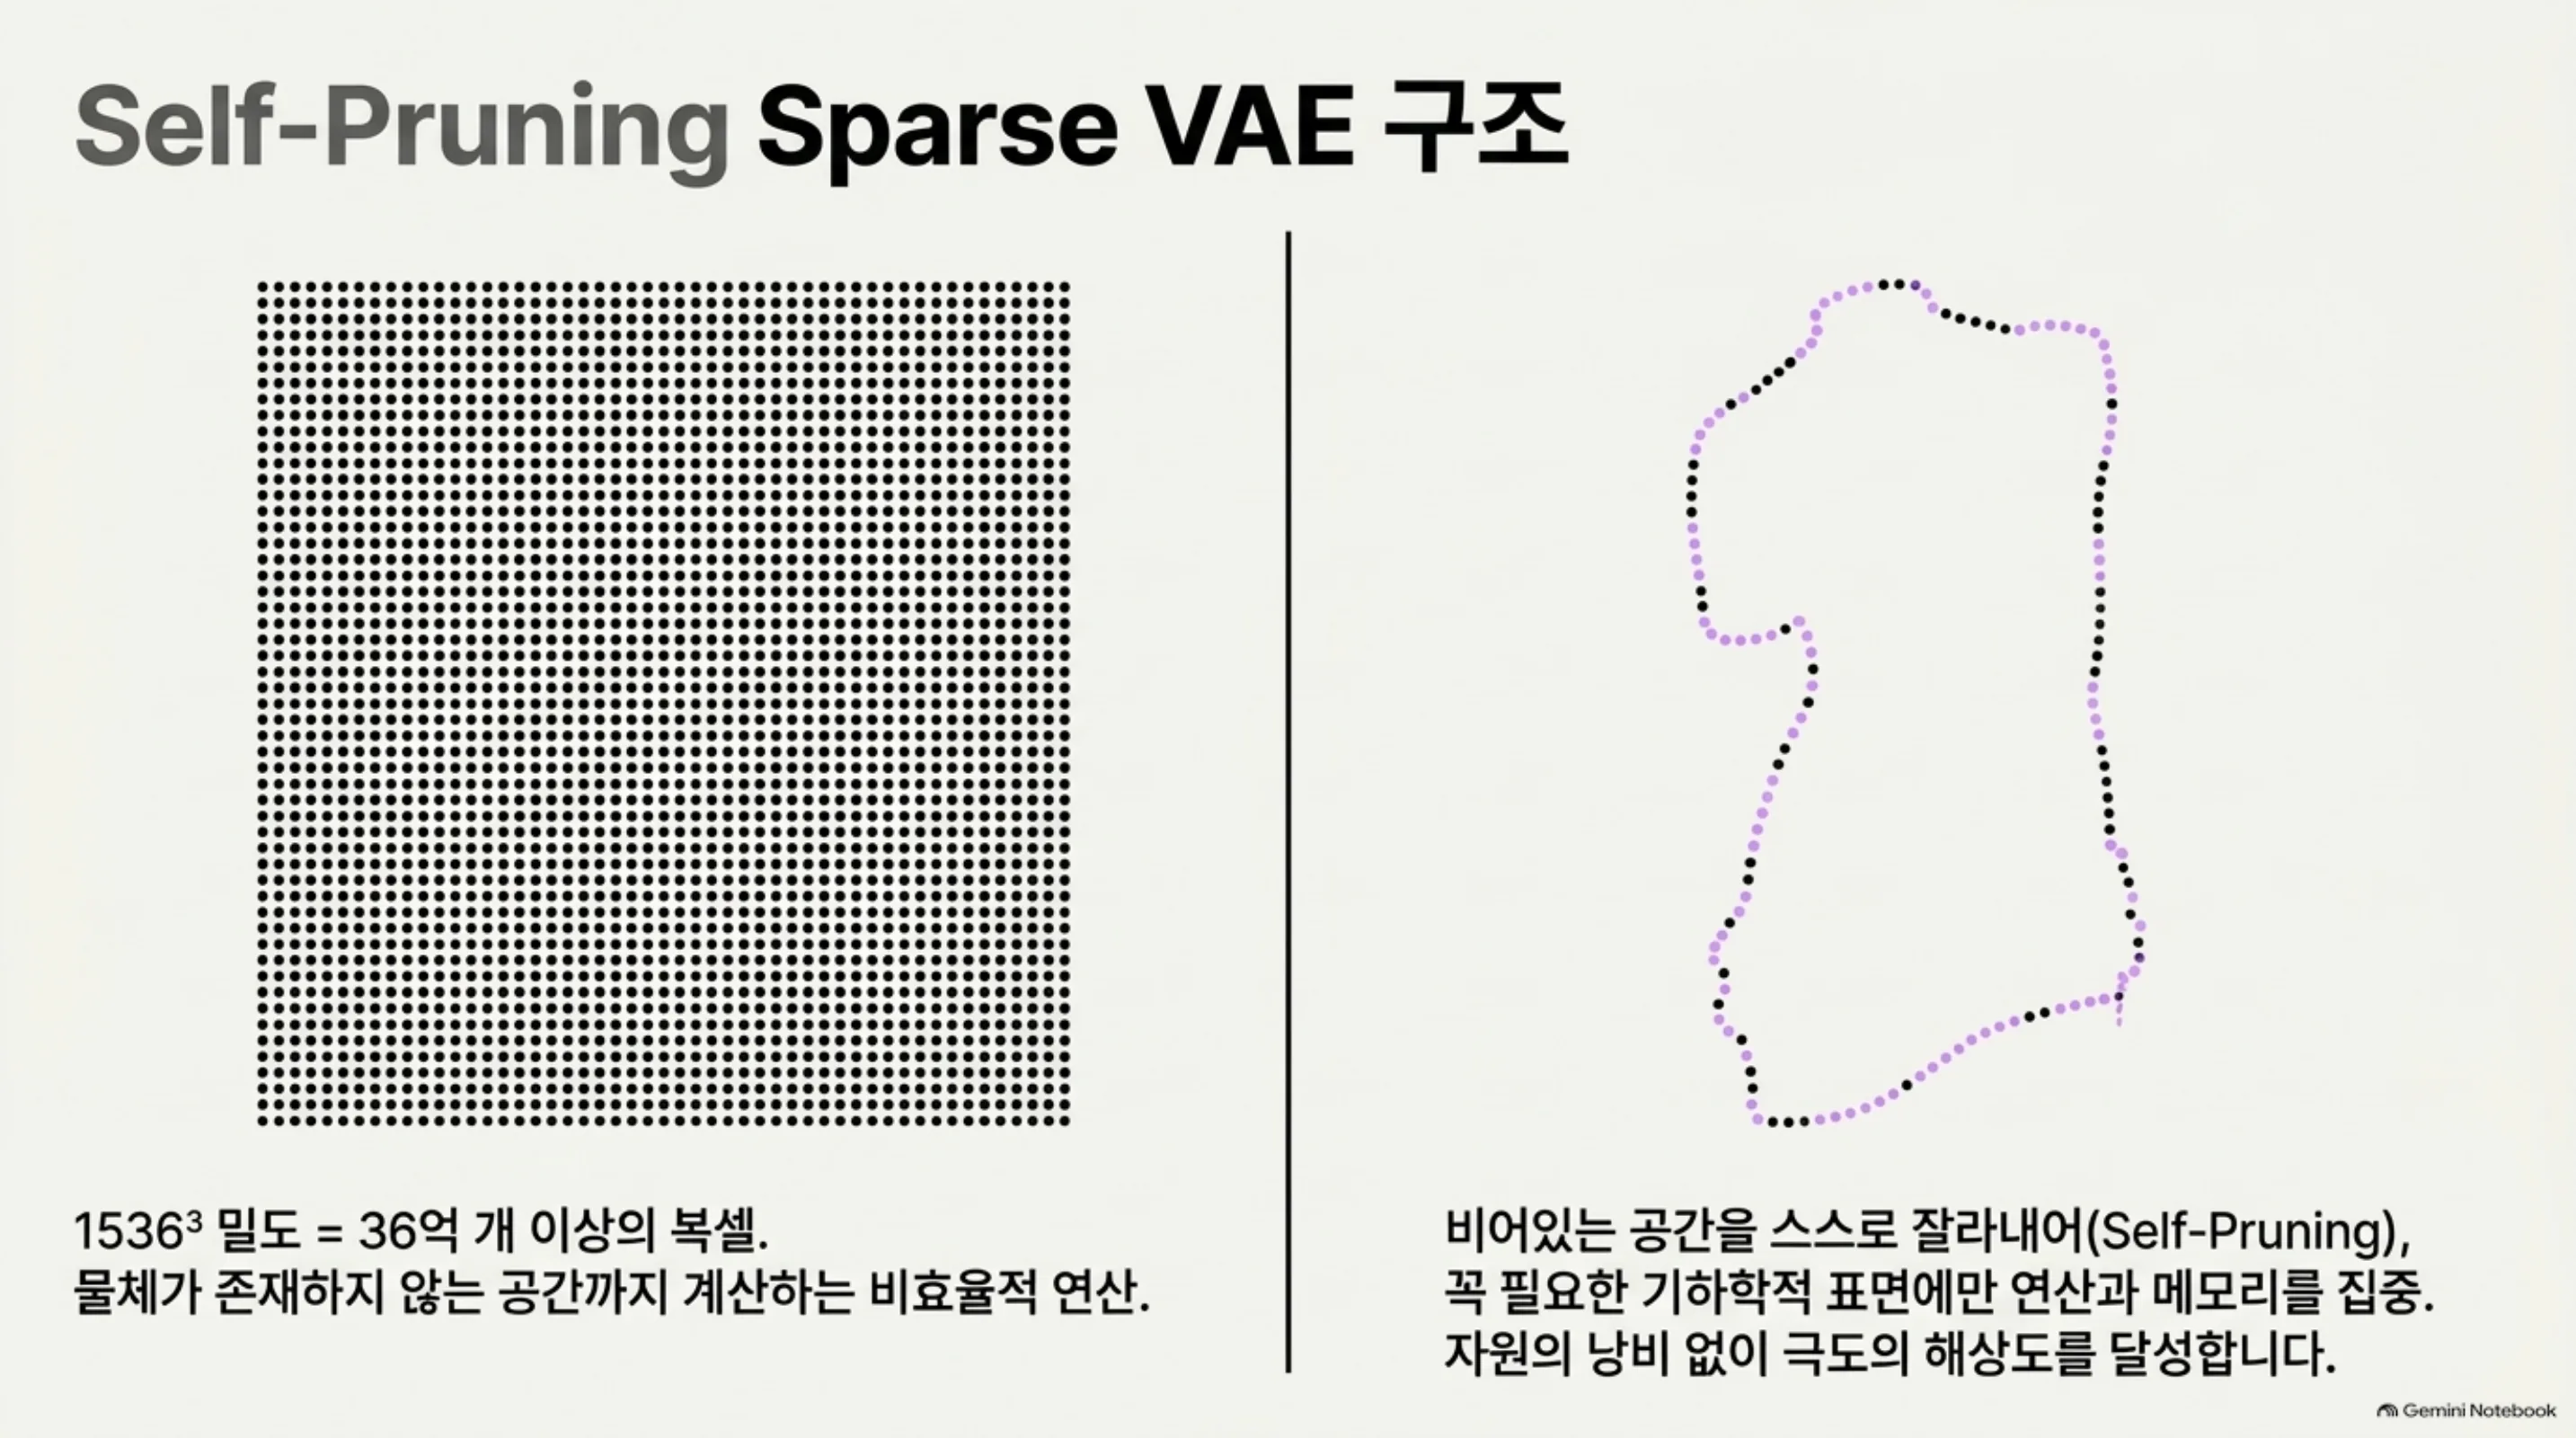
구조는 self-pruning sparse VAE에 기반합니다. 왜 스파스인지에 대한 답은 부피 계산이 줍니다. 1536³ 밀도 그리드는 36억 개 이상의 voxel을 다뤄야 하는데 물체가 실제로 차지하는 영역은 그 중 극소수입니다. 스파스 VAE는 비어 있는 voxel을 스스로 잘라내(self-pruning) 계산과 메모리를 실제로 쓰는 영역에만 씁니다. 정밀화는 단계적으로 올라갑니다.
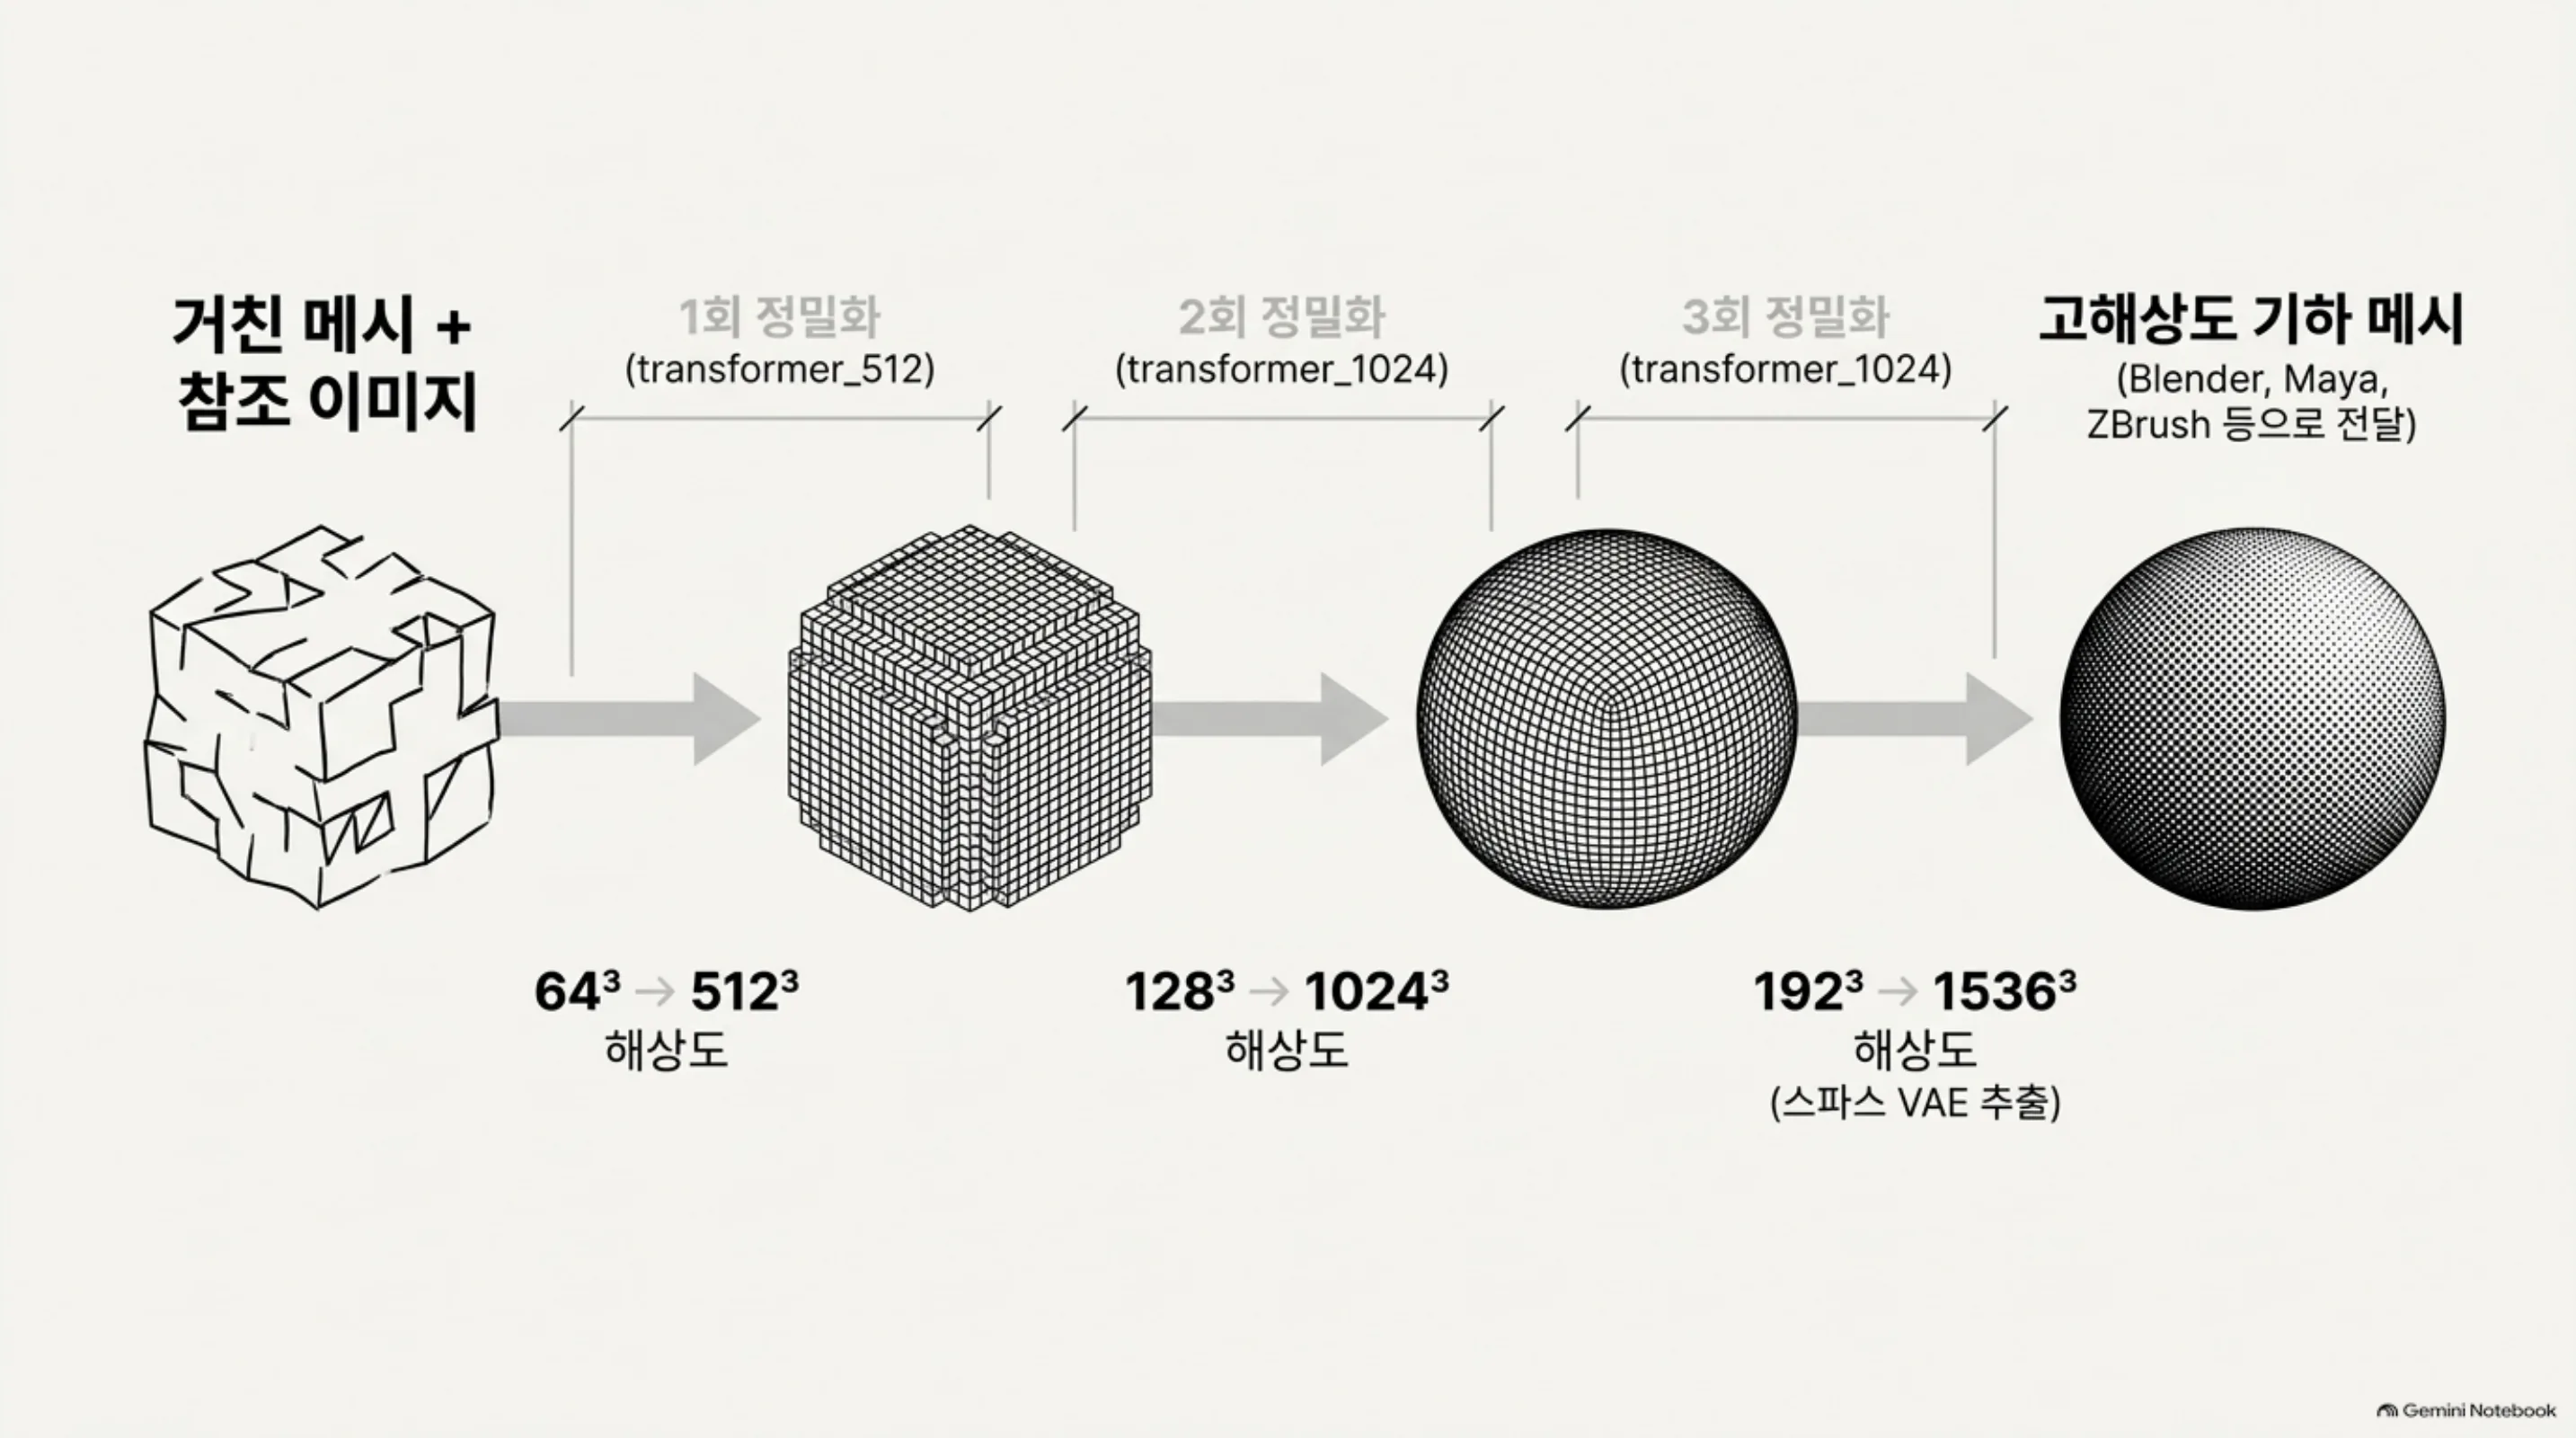
기본 지원 그리드는 세 단계로 나뉩니다. 64³에서 512³, 128³에서 1024³, 192³에서 1536³로 올라가며 각각 1회, 2회, 3회의 정밀화 패스가 적용됩니다. 1536³ 단계는 고밀도 텐서가 아니라 스파스 추출 그리드로 계산됩니다. 입력이 너무 굵으면 더 거친 지원 그리드로 적응할 수 있고 목표 해상도에 미달하면 에러를 반환합니다.
출력은 기하뿐입니다. 텍스처, 머티리얼, 버텍스 컬러는 담지 않습니다. 출력 메시는 단위 최대 반경으로 정규화되므로 입력의 절대 크기와 척도는 유지되지 않습니다. 이 두 가지는 파이프라인에 넣을 때 별도 단계를 준비해야 한다는 뜻입니다.
라이선스와 상업 조건
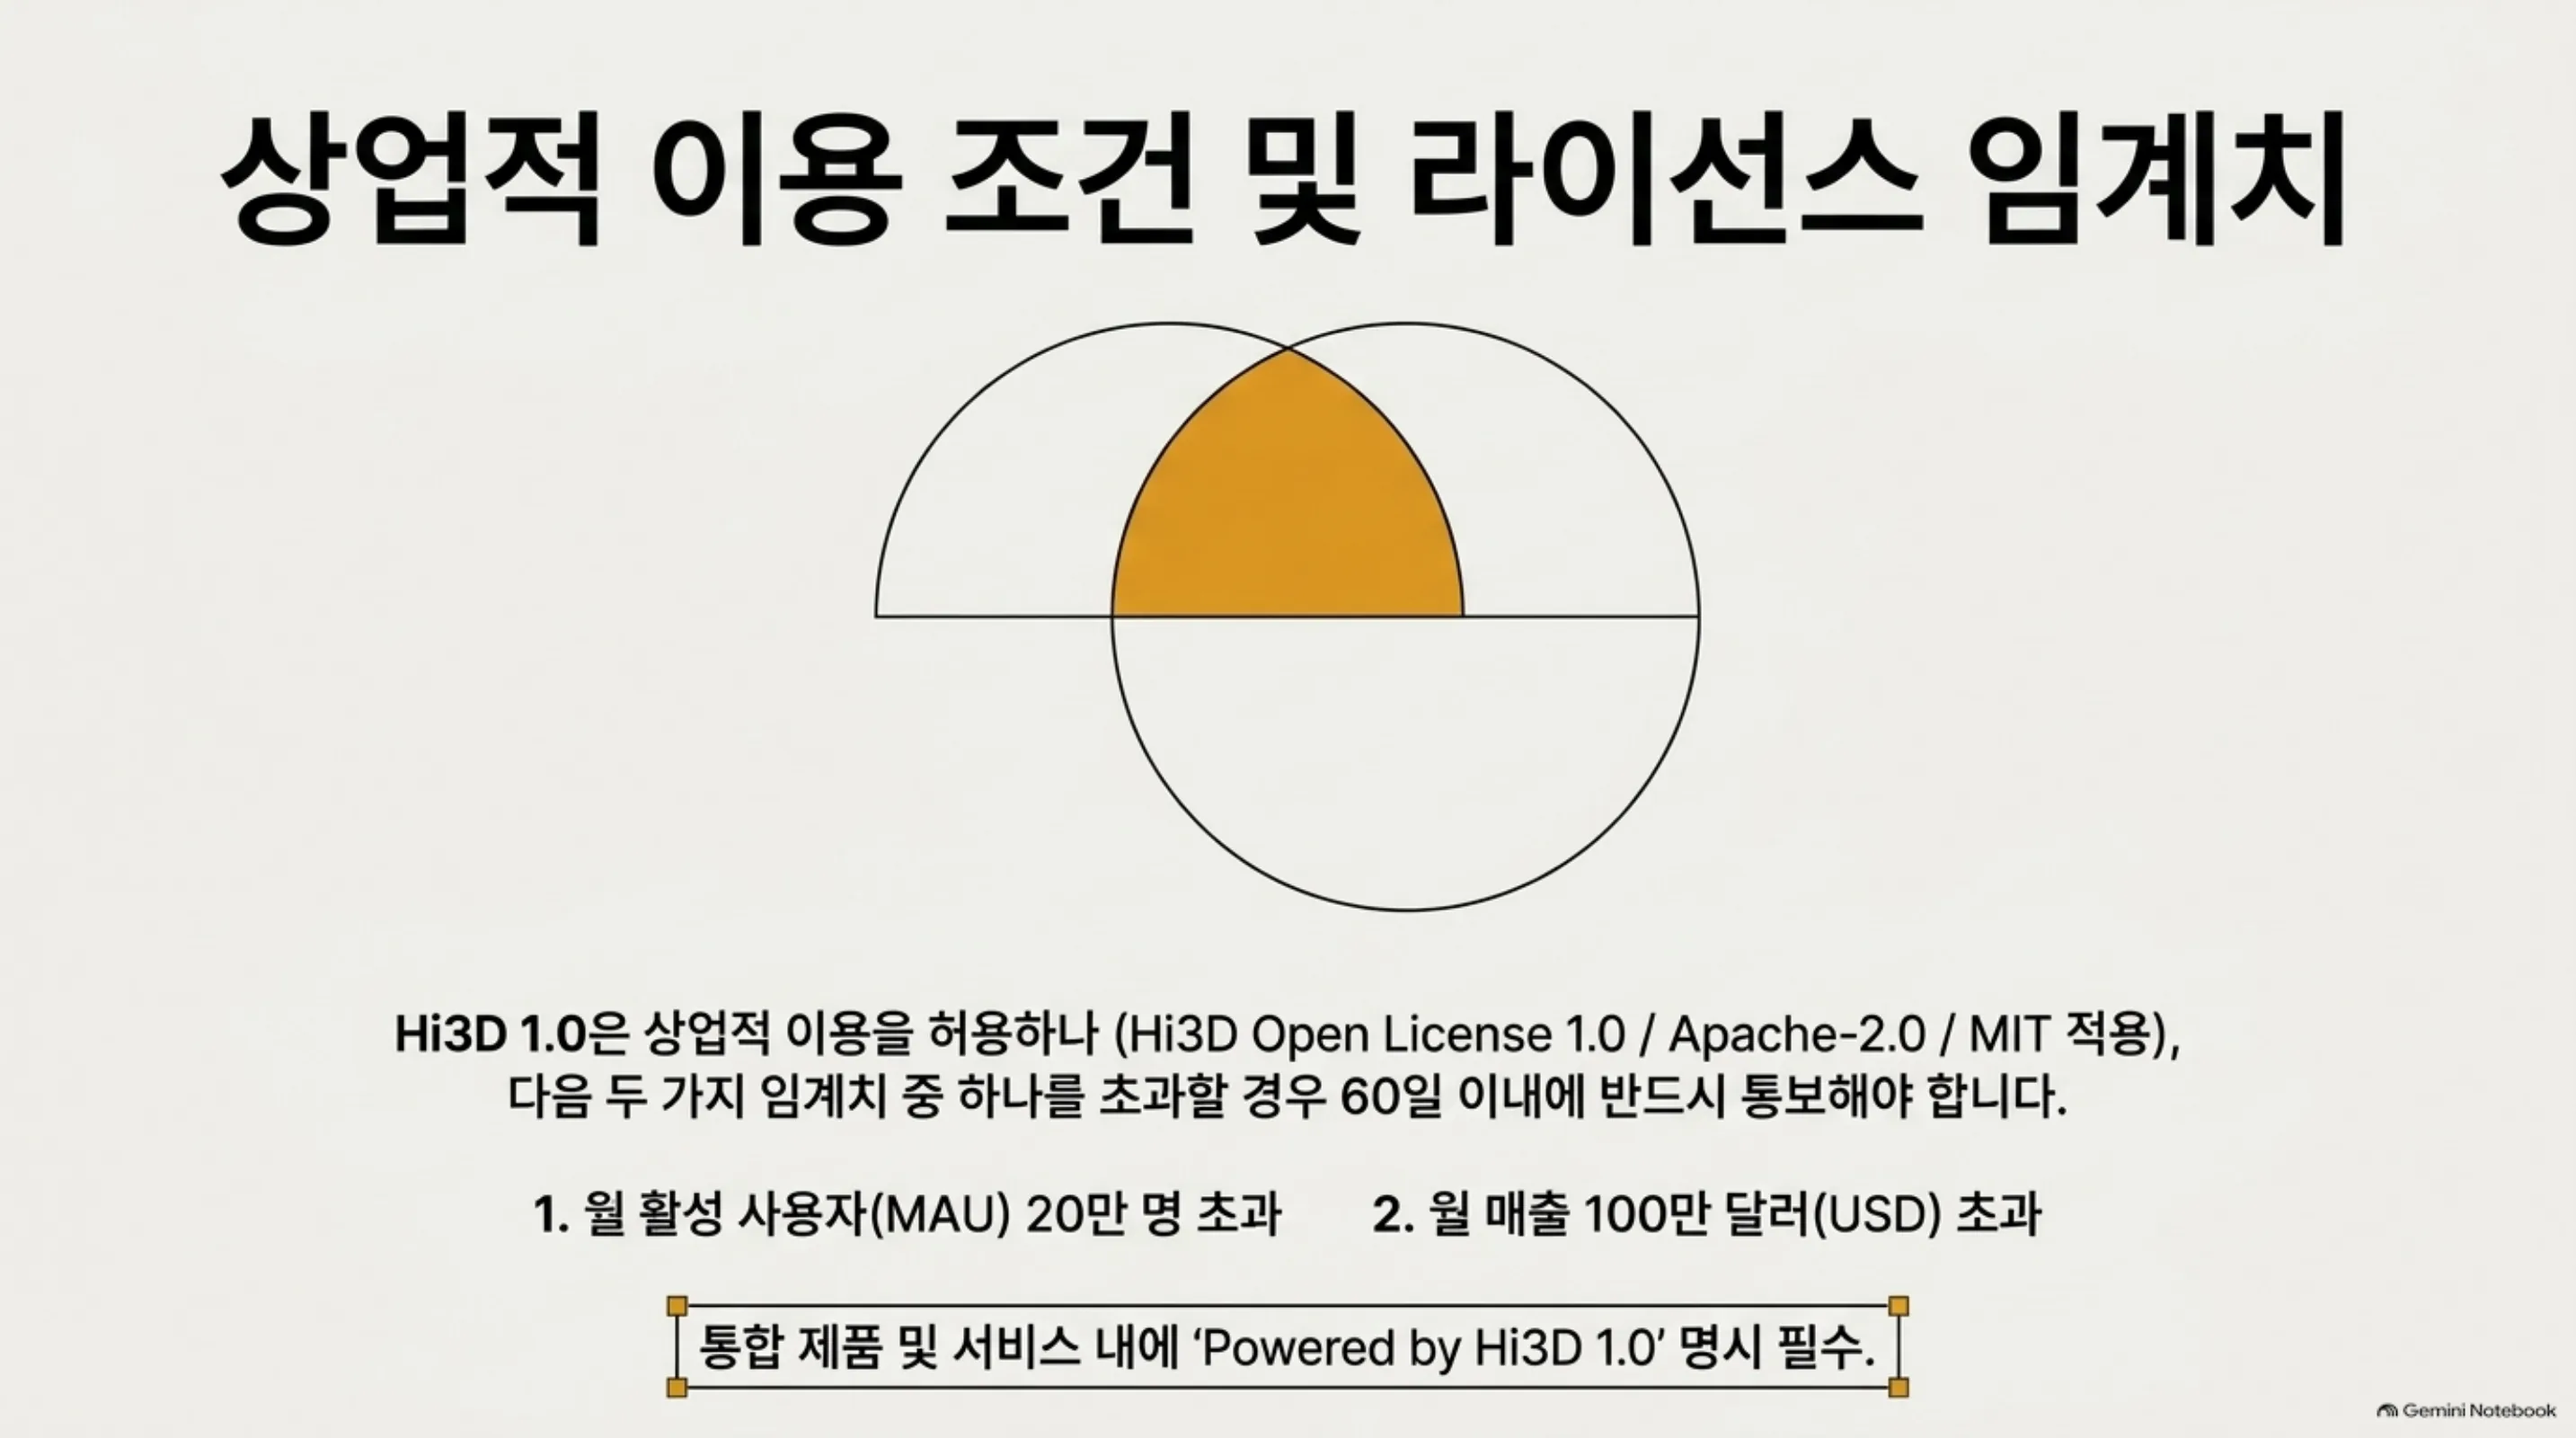
라이선스는 두 층으로 나뉩니다. Hi3D 자체 소유·승인된 부분은 “Hi3D Open License Agreement Version 1.0”이 관리하고 원본 및 제3자 부분은 기존 Apache-2.0과 MIT 조건이 유지됩니다.
상업 이용은 계약상 허용됩니다. 조건이 붙는 지점은 두 개입니다. 월 활성 사용자 20만 명을 넘거나 월 매출 100만 달러를 넘으면 60일 이내에 통보해야 합니다. 통합 제품에는 “Powered by Hi3D 1.0” 표기가 필요합니다. 오픈소스 모델로 드물게 구체적인 상업 계약 구조를 갖췄고 이 조건이 회사 정책에 부합하는지 확인한 뒤 도입해야 합니다.
로컬 배포와 사용
시스템 요구사항이 이 모델의 가장 실용적인 제약입니다.
| 항목 | 요구 사항 |
|---|---|
| OS | Linux |
| Python | 3.10 |
| GPU | NVIDIA, compute capability 8.0 이상 |
| CUDA | 12.0 ~ 12.5 |
| CPU 인퍼런스 | 경로 없음 |
측정된 스택은 Python 3.10.12, PyTorch 2.5.0+cu124, CUDA 툴킷 12.4.131, 96GB NVIDIA H20입니다. 1536³ 단계는 이 GPU에서만 검증되었고 작은 카드의 피크 메모리는 확정되지 않았습니다. H20 급이 안전 기준선이고 compute capability 8.0 이상이면 돌아가지만, 메모리 여력은 직접 재야 한다는 뜻입니다.
설치 명령은 저장소 문서에 그대로 적혀 있습니다.
git clone https://github.com/hi3d-official/Hi3Dv1.0.git
pip install torch==2.5.0+cu124
pip install packaging ninja psutil
pip install --no-build-isolation flash-attn==2.7.4.post1
pip install -c docker/constraints.txt
마지막 줄의 pip install -c docker/constraints.txt는 의존성 제약 파일을 저장소의 docker 경로에서 가져와 그대로 쓰라는 뜻이고 컨테이너 이미지를 만들어 배포하는 경로가 문서화되어 있다는 신호입니다. K8s나 Docker 기반 플랫폼에서 컨테이너로 올리는 경로에 맞춰져 있다는 뜻입니다.
데모 실행은 두 명령입니다.
python demo/refine_mesh.py
python demo/image_to_mesh.py
Python 인터페이스는 Sparc3DPipeline.from_pretrained로 파이프라인을 열고 enable_sequential_cpu_offload로 메모리 오프로딩을 켜고 progress_callback와 refine_voxels로 정밀화를 진행합니다. 순차 CPU 오프로딩은 레이어를 하나씩 GPU에 올리고 계산이 끝나면 CPU로 내려보내는 방식으로, GPU 메모리가 모델 전체를 담지 못하는 카드에서 메모리 여력 문제를 우회하는 표준 기법입니다. flash-attn이 필수이고 폴백 어텐션 경로가 없다는 점도 문서에 명시되어 있어 어텐션 커널 빌드가 안 되는 환경에서는 설치가 막힐 수 있습니다.
검증 현황과 벤치마크
공개된 검증은 두 층으로 나뉩니다.
첫째는 실전 검증입니다. V1.0은 이미 Hi3D의 실제 생산 워크플로에서 사용된 이력이 있고 다중 뷰 품질·로컬 디테일·기하적 유용성 세 기준으로 검증됐다고 발표가 적습니다. “오픈소스로 공개하는 것이 실전 쓰던 버전이다”라는 구조입니다. 세 기준을 풀면, 여러 각도에서 본 외양이 서로 모순되지 않는지(다중 뷰 품질), 표면에 붙는 세밀한 형태가 참조 이미지와 맞는지(로컬 디테일), 다운스트림 도구가 그 메시를 처리할 수 있는지(기하적 유용성)를 보면 됩니다. 3D 생성 모델 평가에서 화면 한 장의 화질 대신 이 세 가지를 잽니다. 출력이 도메인 워크플로에 들어간다는 전제에서 온 방식입니다.
둘째는 기술 보고서의 슬라이싱 통과율입니다. 생성 모델의 90퍼센트가 3D 프린팅 슬라이싱을 통과한다는 수치입니다. 슬라이싱이 통과한다는 것은 출력 메시가 인쇄 파이프라인에서 실제로 처리될 수 있는 기하를 뜻합니다. 수밀(watertight)에 가까운 면, 자기 교차하지 않는 볼륨, 프린터가 해석 가능한 해상도의 삼각망이 갖춰져야 슬라이서가 파일을 받아들이기 때문입니다. 시각적 품질 지표와 다른 “생산 가능성” 신호이고 3D 프린팅 슬라이싱을 검증 기준으로 삼는다는 것은 출력 기하가 화면 안의 형태가 아니라 실제 제조 파이프라인에서 처리됐다는 뜻입니다.
다만 공개 저장소의 범위는 인퍼런스 검증용으로 제한됩니다. 훈련 코드, 평가 하니스, 벤치마크 분할, 비교 메시는 담기지 않았습니다. 90퍼센트 수치를 독립적으로 재확인할 공개 데이터셋이 지금 없다는 뜻이고 도입 전에 자체 검증 세트를 돌리는 구간을 설계에 넣어야 합니다.
훈련 코드가 없다는 것은 또 다른 의미도 갖습니다. 이 모델을 자신의 도메인 데이터로 파인튜닝하는 경로는 공개되어 있지 않고 쓸 수 있는 것은 공개된 인퍼런스 파이프라인 그대로입니다. 도메인 특화 에셋(특정 제품군, 특정 스타일의 캐릭터)이 필요하면 공개 모델의 출력 품질로 요구를 채울 수 있는지 자체 데이터로 먼저 검증하는 순서가 먼저입니다.
ThakiCloud 제품 적용 시사점
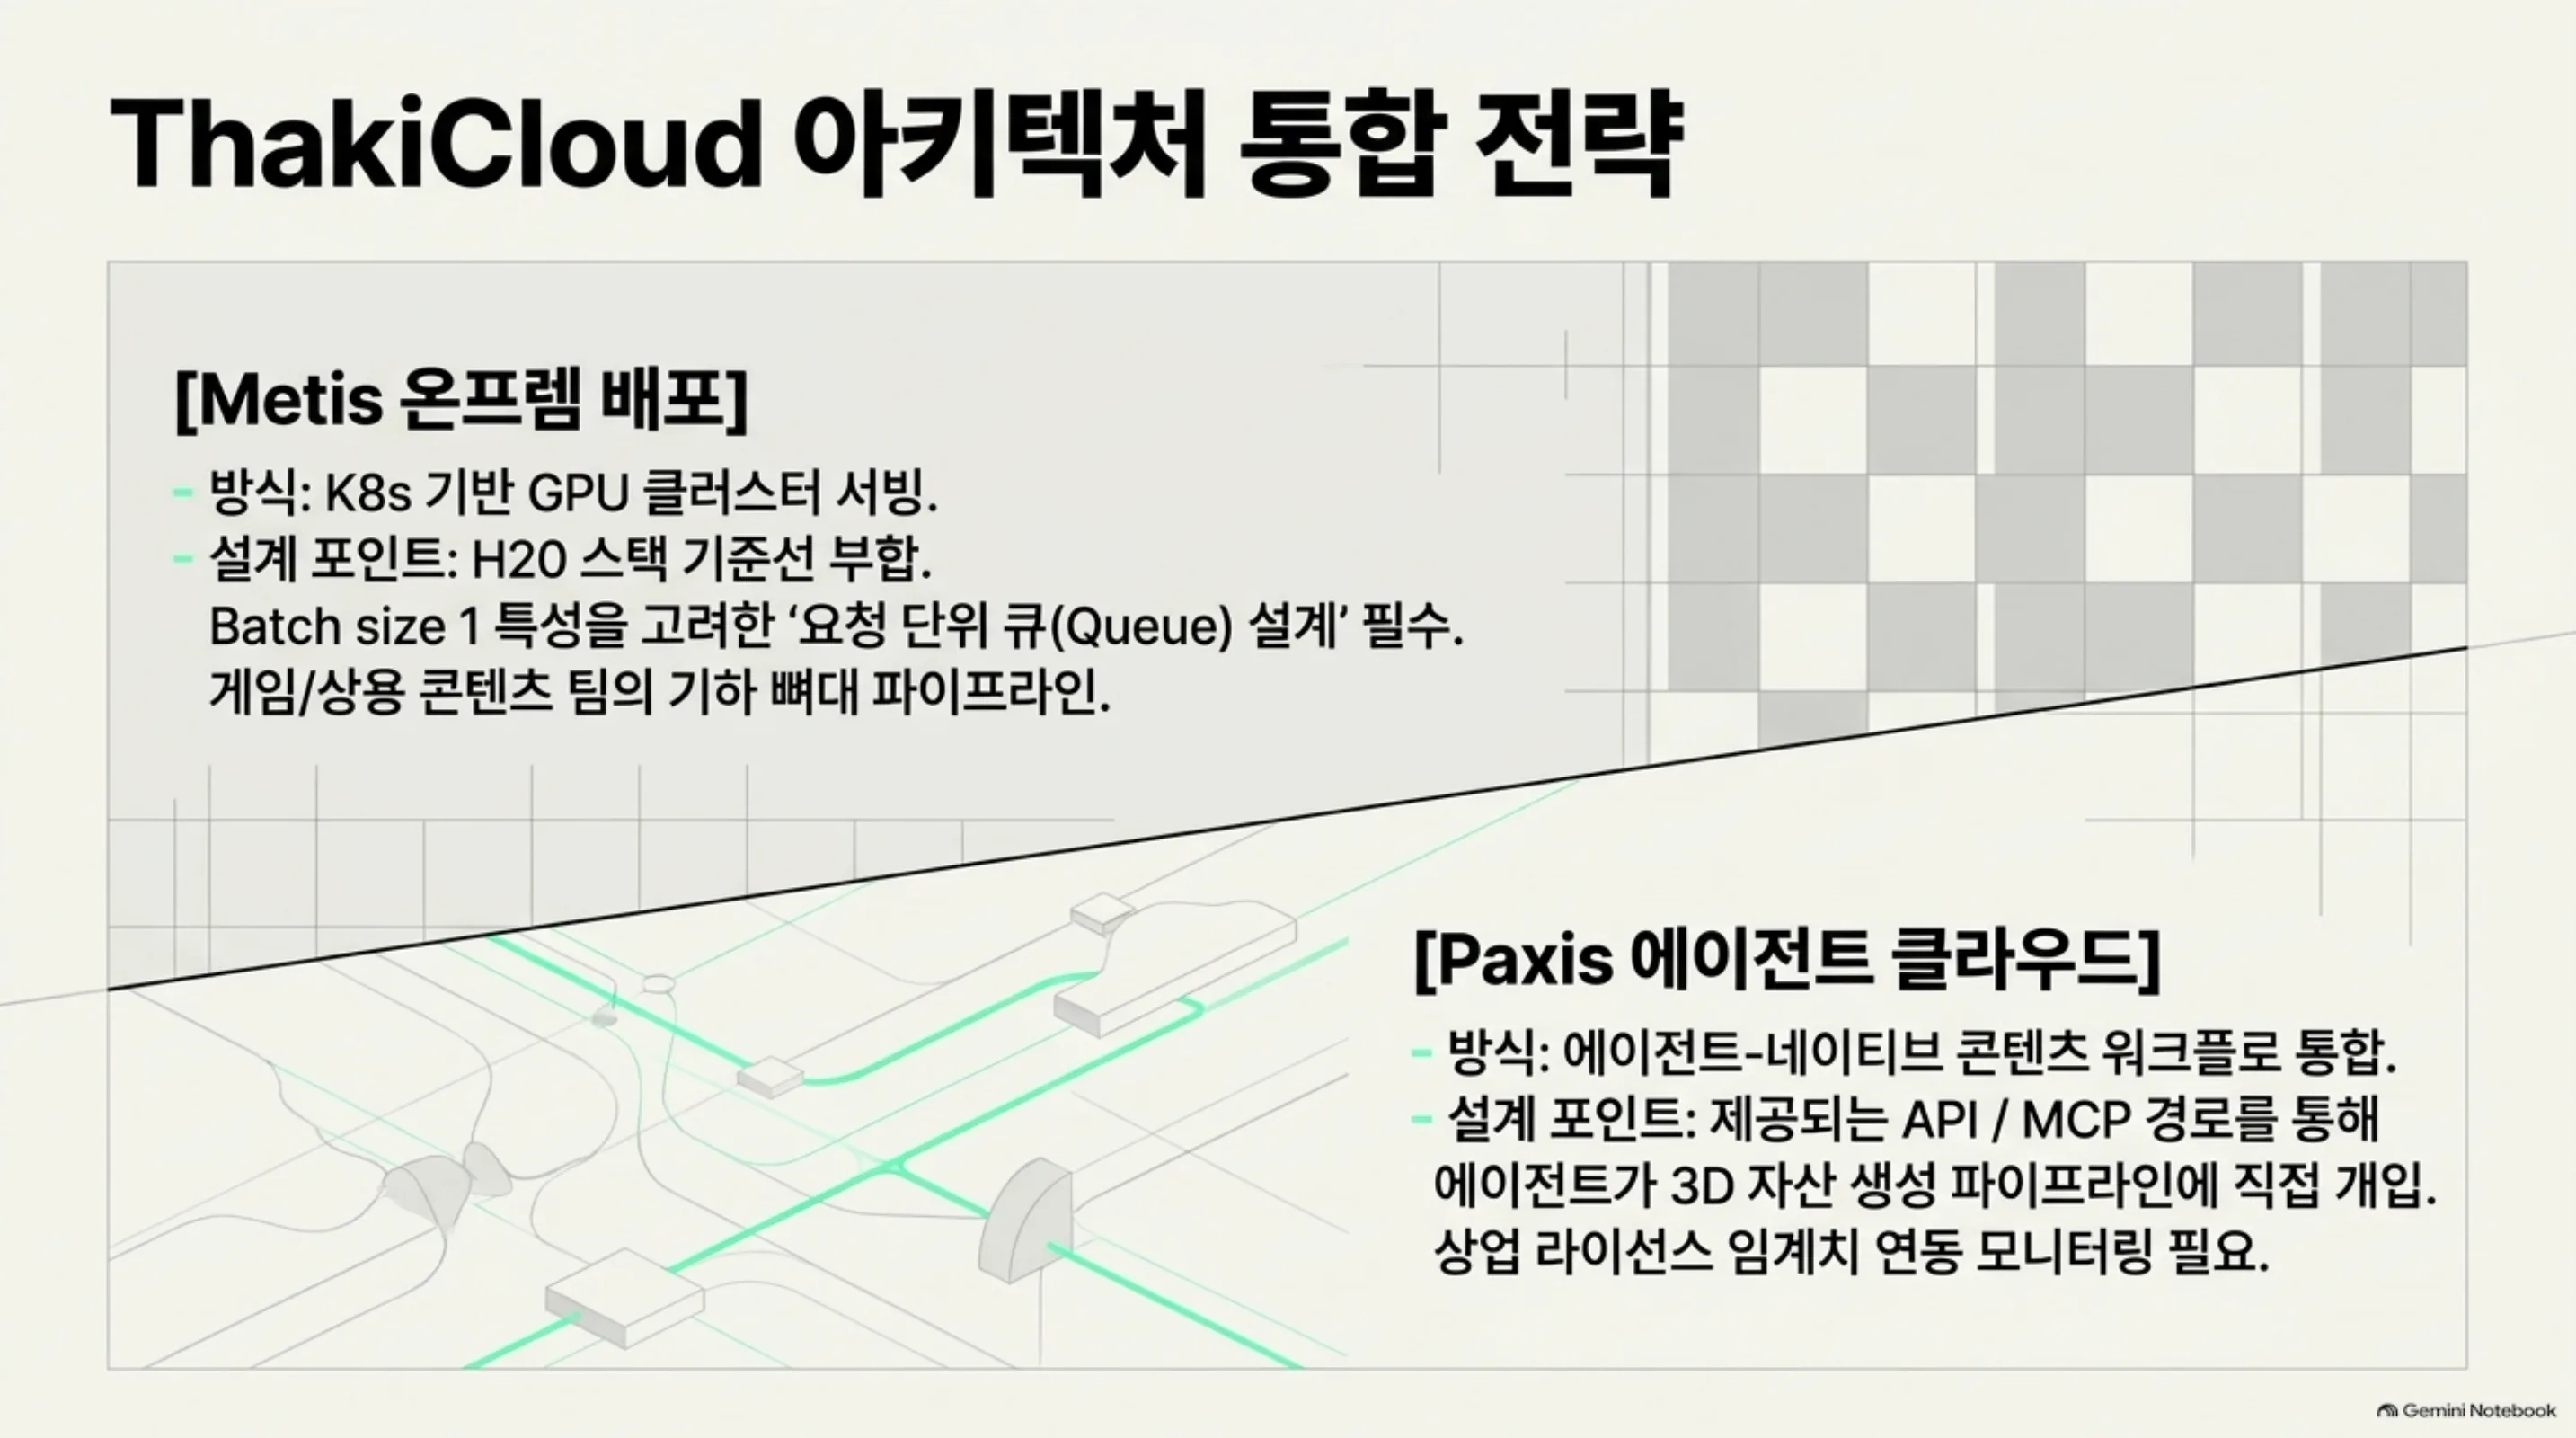
다키클라우드에서 이 모델이 만나는 지점은 두 곳입니다.
첫째, Metis(K8s 기반 모델 서빙)의 온프렘 배치입니다. 이 모델의 요구사항이 Linux, NVIDIA CC8.0+, CUDA 12.x로 딱 떨어지는 것은 Metis의 GPU 클러스터 서빙 구조와 같은 언어입니다. H20 검증 스택이 기준선인 만큼, Metis에서 인퍼런스 잡으로 올리는 것이 자연스러운 경로이고 batch size 1이라는 특성을 고려하면 요청 단위의 큐 설계가 필요합니다. 게임·상용 콘텐츠 팀의 온프렘 에셋 파이프라인에 텍스처가 아니라 기하를 먼저 넣는 단위로 쓰입니다. 현재까지 실전 검증 이력을 가진 후보 중 하나입니다.
둘째, Paxis(에이전트-네이티브 클라우드)의 콘텐츠 워크플로입니다. Paxis는 도구나 API를 일급 리소스로 다루는 구조이고 Hi3D가 제공하는 API·MCP 경로는 에이전트가 3D 에셋 생성 단계에 개입하는 통로가 될 수 있습니다. 기하 생성을 에이전트 워크플로의 한 단계로 넣는 시나리오에서 라이선스의 상업 조건(월 MAU·매출 기준 통보)이 에이전트 기반 콘텐츠 생산의 규모에 어떻게 맞물리는지는 도입 전 점검 대상입니다.
한계 및 반론
헤드라인의 “Blender에서 3D를 배우던 모든 사람에게 RIP”는 마케팅 문장입니다. 이 모델이 거두는 작업은 기하 정밀화이고 거친 메시와 참조 이미지가 먼저 필요합니다. 처음부터 물체를 통째로 만드는 것과는 다릅니다.
출력의 한계는 명확합니다. 기하 전용이라 텍스처·머티리얼·버텍스 컬러가 없습니다. 단위 최대 반경 정규화로 입력 척도가 사라지므로 실물 크기에 맞춘 에셋은 별도 스케일 단계를 요구합니다. 안 보이는 표면은 “신뢰 가능한 완성(plausible completion)”으로 채워지는데, 이는 모델이 추정해서 채운다는 뜻입니다. 구조적 오류가 남아 나올 수 있고 GPU 연산은 bit 단위로 결정적이지 않습니다. 시드는 메시 해시를 지닙니다.
배포 제약도 엄격합니다. CPU 인퍼런스 경로가 없고 flash-attn이 필수이며 1536³는 H20에서만 검증됐습니다. 96GB 카드가 기준선이라는 것은 온프렘 도입 전에 GPU 세대와 메모리를 먼저 계산해야 한다는 뜻입니다.
수치의 출처도 짚어야 합니다. 90퍼센트 슬라이싱 통과율은 기술 보고서 기준이고 공개 저장소에 재확인용 분할이 없습니다. 학습 데이터 200만 개의 구성과 품질 필터링 기준도 발표 수준으로만 알려졌습니다. 도입 결정 전 자체 검증 세트가 필요합니다.
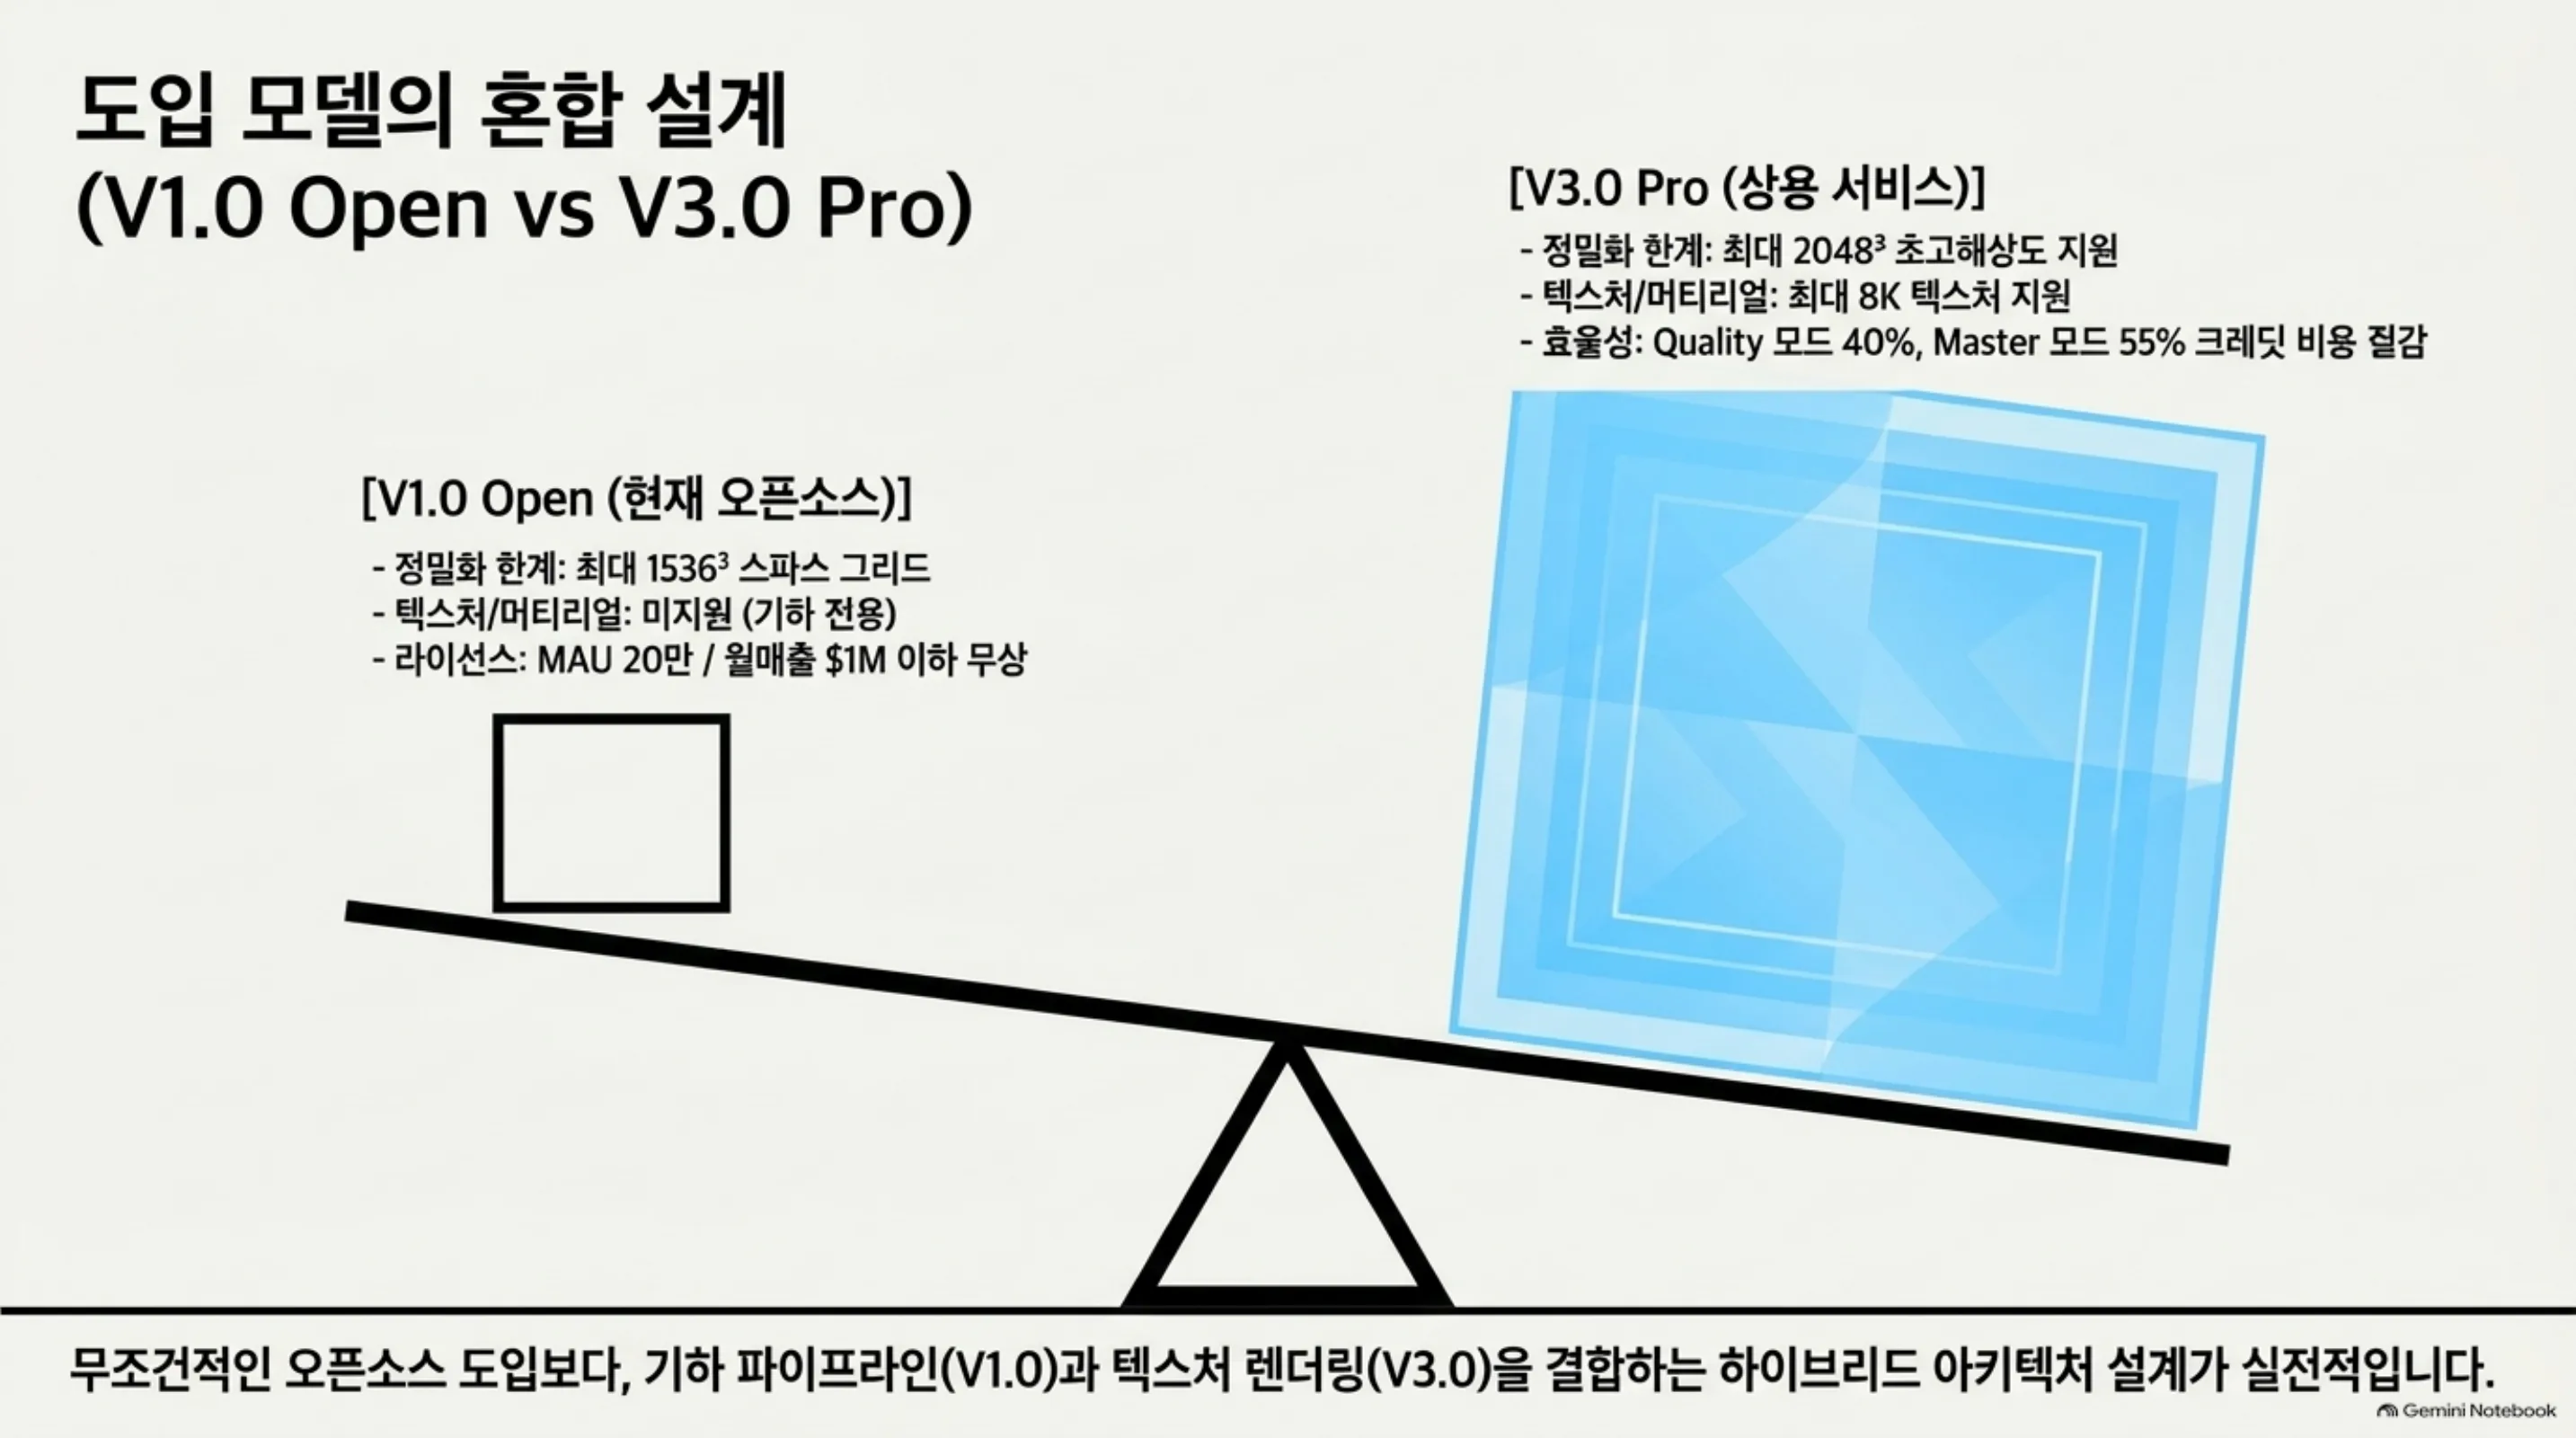
오픈 버전과 상업 버전의 간격도 감안해야 합니다. Hi3D V3.0은 기하 정밀화를 2048³까지 끌어올리고 텍스처를 최대 8K로 다루는 반면 V1.0은 1536³ 기하 전용입니다. 발표에 따르면 V3.0 전환은 크레딧 비용도 낮췄는데, Quality 모드는 40퍼센트, Master 모드는 55퍼센트 넘게 줄었습니다. 오픈소스 V1.0을 파이프라인에 넣는 것과 유료 V3.0을 함께 쓰는 혼합 설계는 현실적 옵션이고 두 버전의 품질 격차를 자체 데이터로 재는 구간이 필요합니다.
정리
이미지에서 3D 기하를 뽑는 오픈소스 모델이, “실전에서 쓰던 것을 공개한다”는 구조로 나왔습니다. 학습 자산 200만 개, 1536³ 스파스 정밀화, 기술 보고서 기준 3D 프린팅 슬라이싱 통과율 90퍼센트는 이 카테고리의 오픈 모델로는 현재까지 손에 꼽는 조합입니다. 다음 행동은 두 가집니다. 에셋 파이프라인 팀이라면 라이선스의 상업 조건과 기하 전용 출력을 먼저 확인하고, 자체 검증 세트를 세운 뒤 H20 급 카드로 슬라이싱 통과율을 재측정하는 것부터 시작해야 합니다. 플랫폼 엔지니어라면 Metis GPU 클러스터에서 batch size 1 인퍼런스 잡으로 올려 요청 단위 큐와 메모리 여력을 재는 것부터 시작하면 됩니다. “RIP Blender”라는 헤드라인보다, 거친 메시와 참조 이미지가 준비된 워크플로에 이 모델이 들어가는 위치를 먼저 그리시는 것이 이 모델을 다루는 정석입니다.
