무인 에이전트는 어디서 생각해야 하는가: 스킬 선택과 실행 사이 reasoning budget의 cost-quality frontier
무인 에이전트에서 생각 예산이 고정돼 있으면, 그 예산은 실행 단계에 몰아주는 것이 아니라 라우터와 실행 사이에 나누어 쓰는 것이 낫습니다. 무인 에이전트를 돌리거나 그 청구서를 책임지는 클라우드 엔지니어라면 읽을 값이 있습니다. 라우터의 생각 토큰 하나는 하류 실행 전체를 지키기도 하고 통째로 날리기도 하기 때문입니다.
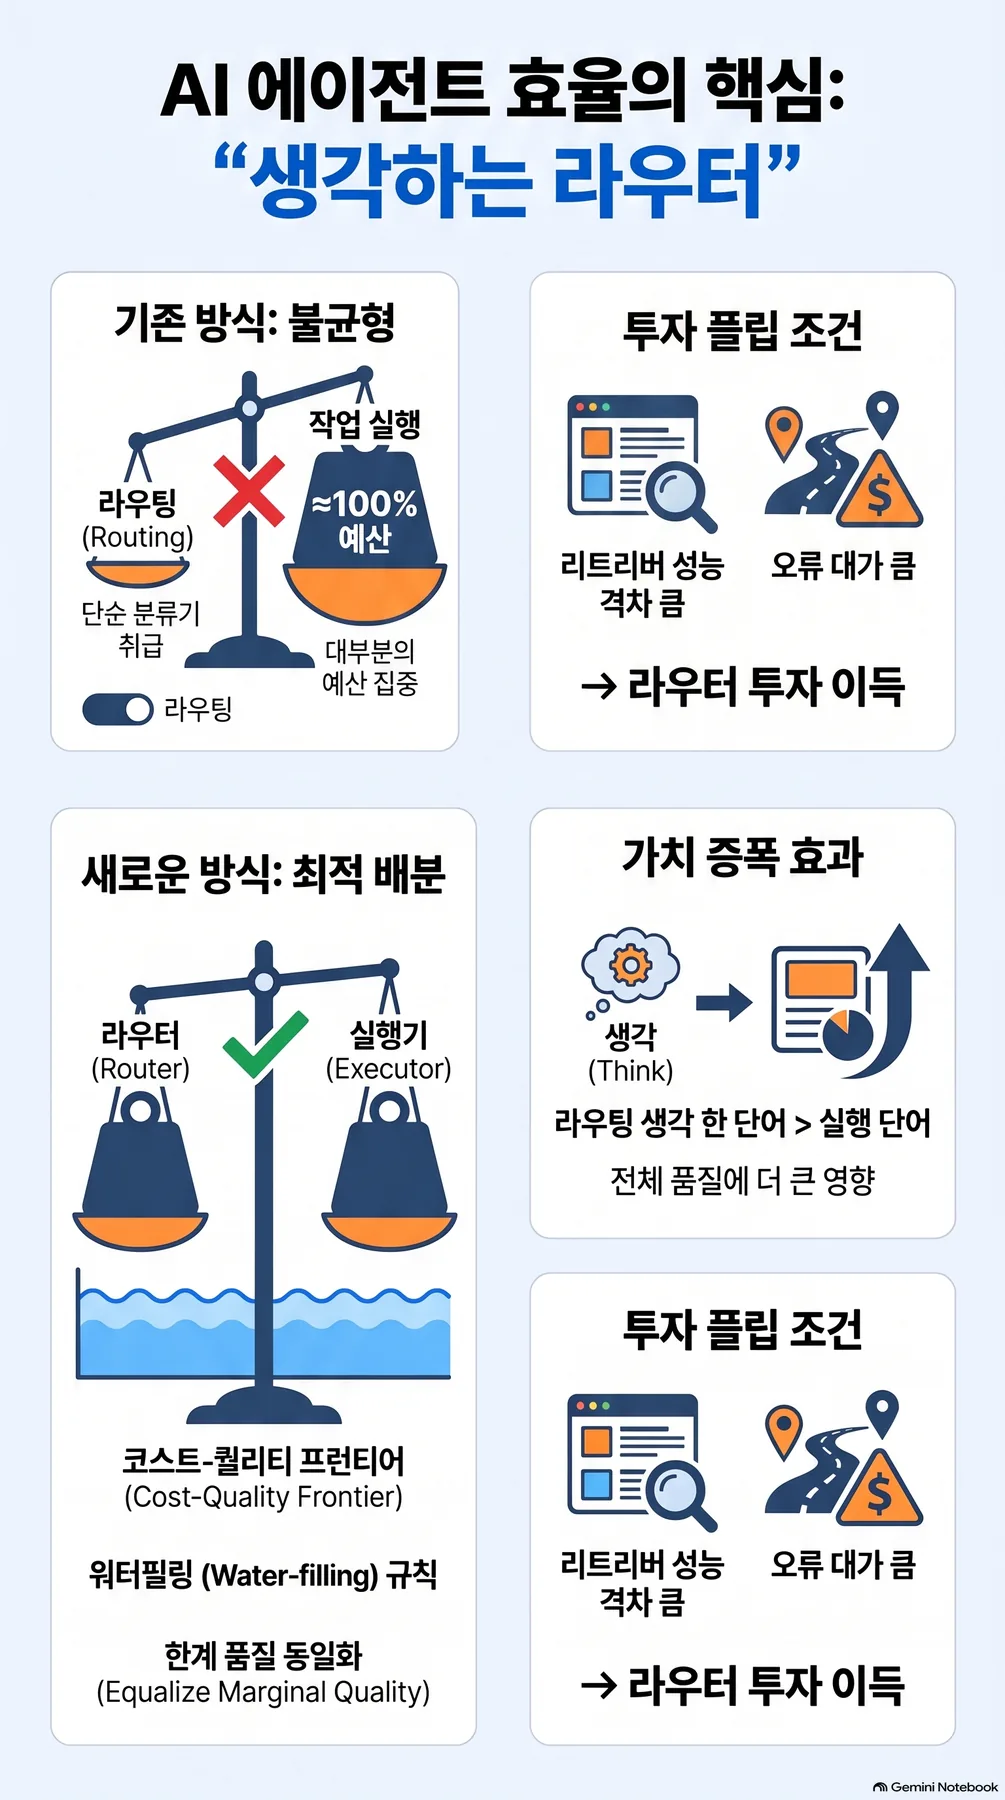
지금의 생산 환경에서는 들어오는 일을 먼저 라우터에 맡기고 나서야 실행 단계에서 생각을 쓰게 됩니다. 그런데 생각 예산의 대부분은 실행 단계에 몰려 있고, 라우터는 공짜 분류기로 다뤄집니다. 생각은 이제 가격을 매기고 길이를 조절할 수 있는 입력이 됐고, 재순위 매김과 저렴한 추론 모델이 라우터와 생각 토큰의 단가를 계속 낮추고 있습니다. 세 흐름이 겹치자, 시간과 날로 도는 무인 루프에서 질문은 “아예 생각할 것인가”에서 “어디에서 생각할 것인가”로 넘어갔습니다. 이 논문은 총 생각 예산이 고정돼 있을 때 그 토큰을 스킬 선택 단계와 작업 실행 단계 사이에 어떻게 나누면 달러당 하류 품질이 가장 큰지를 값으로 매깁니다.
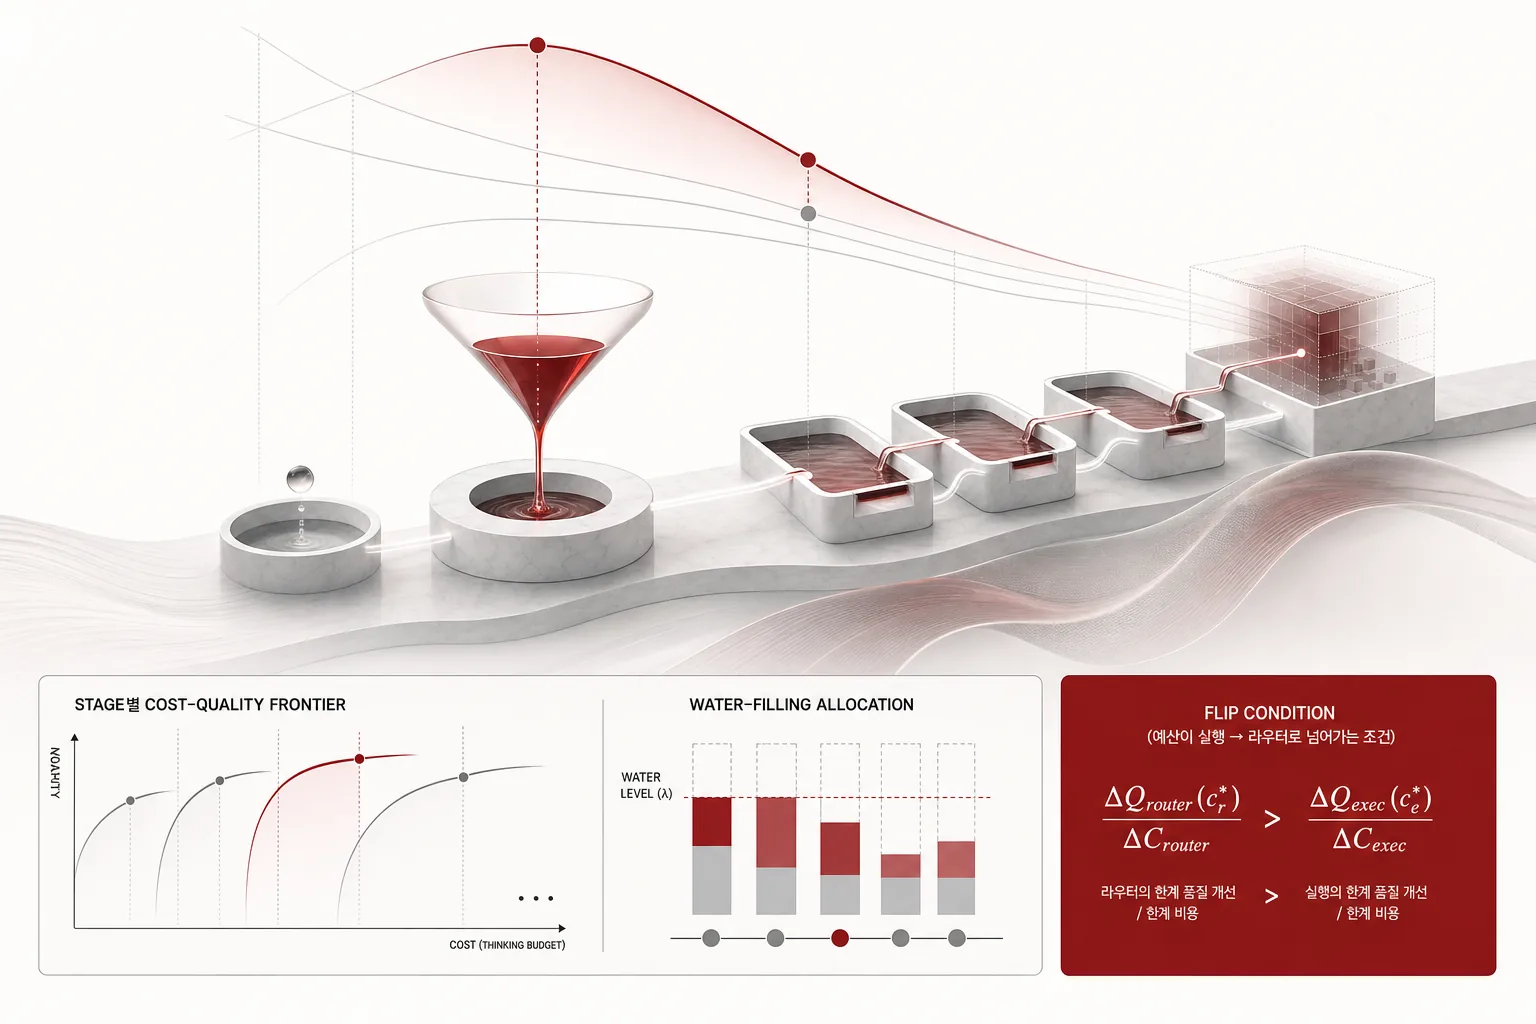 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
병원에 환자가 들어오면 트리아주 간호사가 먼저 어느 진료과로 보낼지 정합니다. 그 판정이 틀리면 환자는 잘못된 과로 가고, 뒤따르는 검사와 수술 비용은 통째로 허공을 가는데요. 트리아주는 수술보다 싸고 짧지만, 그 판정 하나에 이후의 모든 의료 자원이 따라붙습니다. 트리아주 판정을 더 정확히 할지, 아니면 수술 자체를 더 정밀하게 할지가 바로 그 배분 문제입니다. 그 규칙의 모양은 물이 낮은 데로 차는 water-filling입니다. 이 논문은 그 “어디에”를 비용 방정식으로 쓰고, 예산이 한 단계에서 다른 단계로 넘어가는 지점을 부등식으로 줍니다. 트리아주가 이미 거의 다 맞히는 병원에서는 수술에 쓰는 쪽이 낫고, 트리아주의 놓침이 큰 병원에서는 트리아주에 쓰는 쪽이 낫습니다.
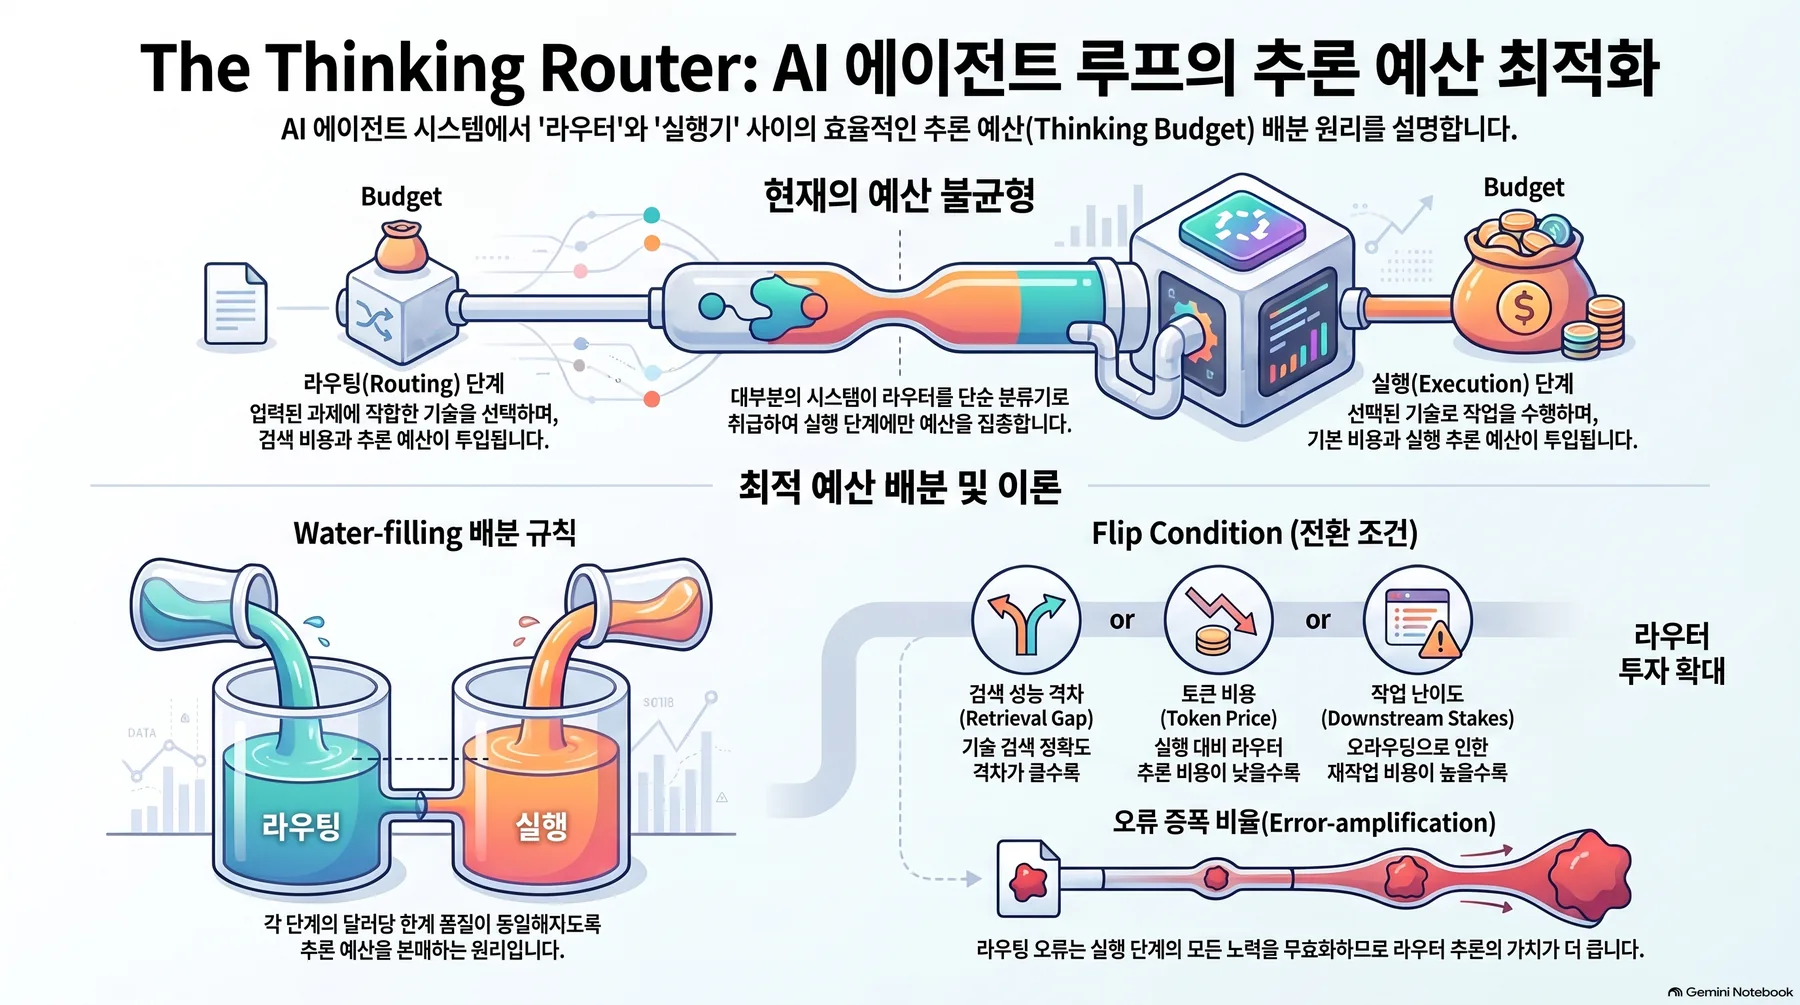 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
무료라 여겨진 라우터
두 단계의 구조는 단순합니다. Stage R(라우팅)에서는 하이브리드 리트리버(어휘 + dense)가 고정 비용 $b_R$로 후보 풀을 만들고 선택을 다듬기 위한 생각 단계가 토큰 단가 $p_R$에 $t_R$를 씁니다. 라우팅 정확도 $A(t_R)$은 top-k 풀에 gold 스킬이 들어 있는 확률이고 우리 프로덕션 route bench에서는 recall@k($k{=}5$)로 잡습니다. Stage E(실행)에서는 선택된 스킬이 기본 비용 $b_E$와 extended-thinking budget $t_E$, 토큰 단가 $p_E$로 돕니다. 실행 품질 $Q(t_E)$는 올바른 스킬이 주어졌을 때 작업이 올바르게 완료되는 확률입니다.
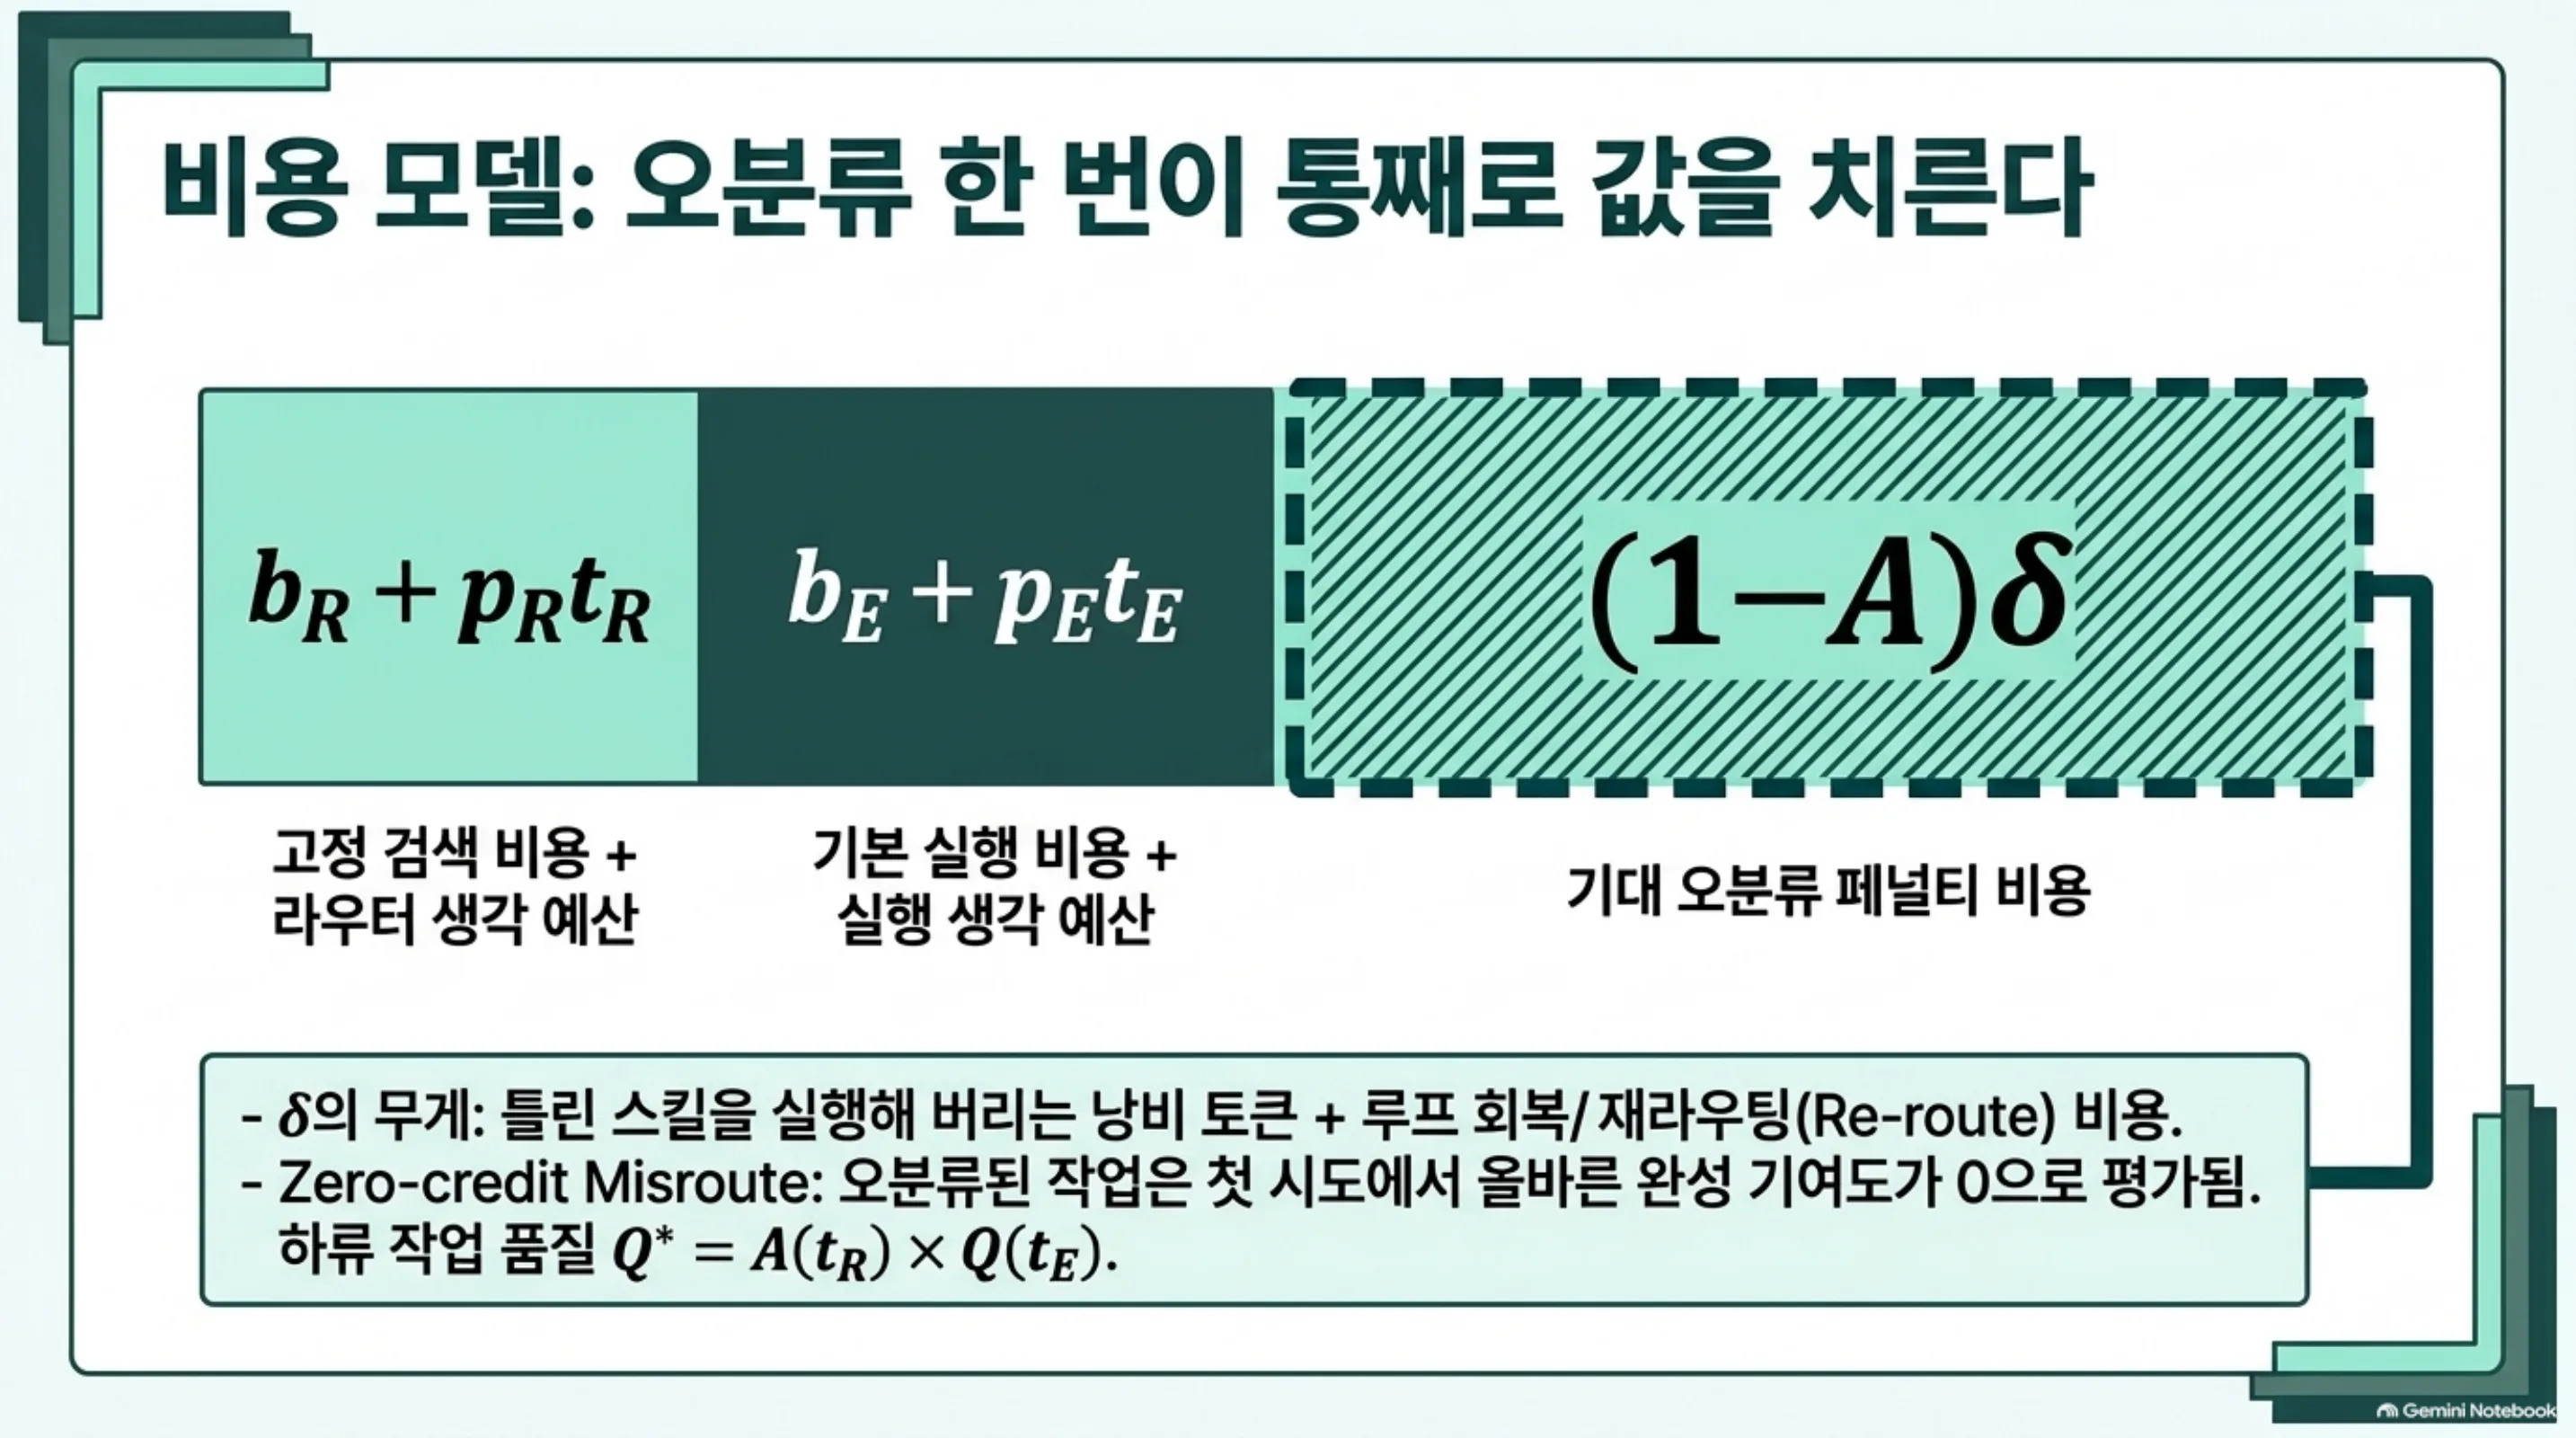
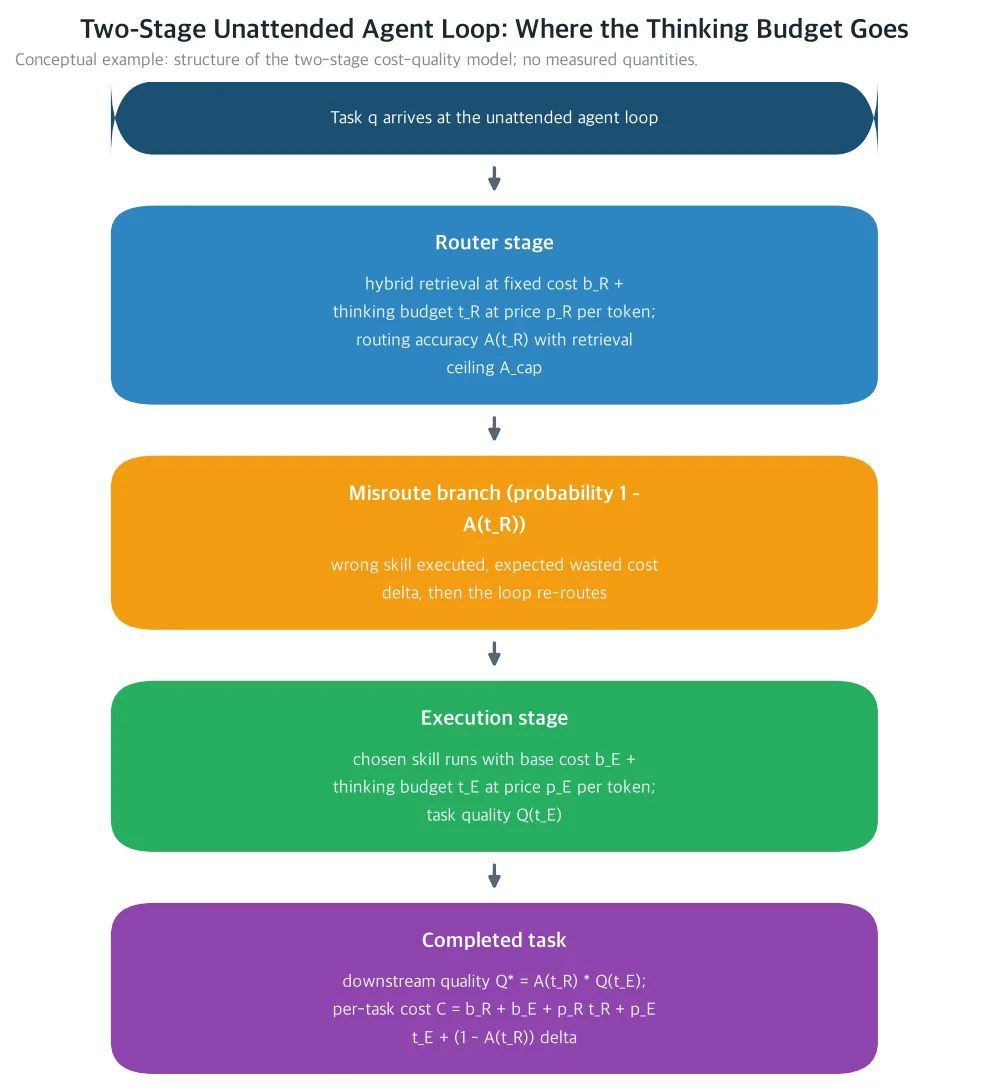 무인 에이전트 루프를 두 단계로 본 개념도입니다. 두 단계의 달러당 남은 품질 증가가 같아질 때까지 다음 달러를 낮은 쪽에 붓는 구조입니다. 지금 대부분의 harness는 라우터는 생각 없이 검색만 하고 실행에 생각을 전부 씁니다. water-filling의 언어로 보면 두 단계의 물수위가 어긋난 상태입니다. 라우터 단계는 고정 검색 비용 $b_R$(어휘 + dense retrieval)과 예산 가능한 생각 비용 $p_R t_R$을, 실행 단계는 기본 비용 $b_E$와 생각 비용 $p_E t_E$를 가집니다. 오분류(확률 $1-A(t_R)$)는 루프가 다시 라우팅할 때까지 기대 낭비 비용 $\delta$를 치릅니다. 개념 예시이며 두 단계 cost-quality 모델의 구조를 보여 주는 것입니다. (분석 모델, 실측 아님)
그 라우터가 매 턴의 hot path에 있습니다. 저희 실측에서는 하이브리드 스킬 라우터의 임베딩 절반이 오프라인에서 분배되는 것이 아니라, 모든 요청마다 조회됩니다. 실행 단계가 토큰의 대부분을 쓰지만, 라우터도 매 요청마다 비용 항목이 됩니다.
세 흐름이 그 그림을 바꿉니다. 첫째, 생각 토큰이 가격을 매기고 길이를 조절할 수 있는 입력이 된 것입니다. 생각 길이는 단일 생성의 cost-quality tradeoff를 조입니다. 둘째, 라우터가 더 이상 공짜가 아닌 것입니다. LLM 재순위 매김이 선택 단계를 매 요청의 비용 항목으로 만들었습니다. 셋째, 저렴한 잠재 추론 모델이 생각 토큰의 가격을 압축하고 있는 것입니다. 그래서 시간과 날로 도는 무인 루프에서는 어디에서 생각할 것인가가 binding한 비용 문제가 됐습니다.
이전 연구는 라우터의 검색 비용을 짚었습니다. 양자화 연구는 dense-embedding 절반이 1차 비용 항목이고, 그 압축 오차가 융합 가중치로 감쇠됨을 실측했습니다. multi-skill gap 연구는 2,275스킬 프로덕션 레지스트리에서 top-20 풀이 composite task의 gold 스킬을 24.3% 놓친다고 실측했습니다. binding constraint는 검색 쪽 coverage였고, local composer 능력은 아니었습니다. 14B 이하 local composer는 48개 중 0개의 parseable chain만 만들었습니다. repair loop 연구는 리트리버의 cross-lingual vocabulary bridge가 step coverage의 공동 binding constraint임을 보여 줬습니다. 수작업 oracle 분해도 step coverage 63.6%에 머물렀습니다. 세 연구 모두에서 라우터의 생각 예산은 암묵적으로 0이었습니다. 라우터는 생각하지 않았거나, 생각하더라도 그 비용이 회계에 들어가 있지 않았습니다. 이 논문은 그 빈칸을 채웁니다.
비용 모델: 오분류 한 번이 통째로 값을 치른다
작업당 기대 비용은 $C(t_R,t_E) = b_R + p_R\, t_R + b_E + p_E\, t_E + (1-A(t_R))\,\delta$입니다. $\delta$는 오분류의 기대 달러 비용입니다. 틀린 스킬을 실행해 버리는 토큰에, 루프가 회복하거나 abort할 때까지 뒤따르는 re-route 비용을 더한 값입니다. 가격은 API arm이면 list price, self-hosted serving(예: H200급 GPU)이면 감가 비용으로 잡습니다. 회계에서는 둘 다 같은 스칼라로 들어갑니다.
품질은 zero-credit misroute 가정에서 곱셈으로 factor화됩니다. 오분류된 작업은 첫 시도에서 올바른 완성에 기여하지 못한다는 가정입니다. 이 가정에서 하류 task quality는 $Q^*(t_R,t_E) = A(t_R)\,Q(t_E)$가 됩니다.
총 생각 예산 $B$(달러)에서 stage-level frontier는 $F(B) = \max_{t_R,t_E \ge 0}\; A(t_R)\,Q(t_E) \quad \text{s.t.} \quad p_R t_R + p_E t_E \le B$입니다. frontier는 총 생각 지출 하나하나에 대해 가장 좋은 하류 quality를, argmax는 그것을 만드는 budget 분할을 기록합니다. 가정은 네 개입니다. A1 separability: $A$는 $t_R$에만, $Q$는 $t_E$에만 의존합니다. A2 saturating response: 둘 다 미분 가능하고 단조 증가하며 엄밀한 오목함입니다. 천장은 $A^{\cap} < 1$과 $Q^{\infty} \le 1$입니다. 전자는 retrieval ceiling으로, 라우터 thinking이 아무리 많아도 corpus가 설명하지 못하는 스킬은 떠오르지 않습니다. 그리고 $A(0)=A_{\mathrm{ret}}>0$, $Q(0)=Q_0>0$입니다. A3 stationarity: 측정 윈도우에서 task mix와 skill registry와 description corpus가 고정입니다. A4 price constancy: 같은 윈도우에서 $p_R, p_E, b_R, b_E, \delta$가 상수입니다.
마진 값에서 비대칭이 드러납니다. 라우터 토큰의 마진 품질은 $\partial Q^/\partial t_R = A’(t_R)\,Q(t_E)$입니다. 실행 토큰의 마진 품질은 $\partial Q^/\partial t_E = A(t_R)\,Q’(t_E)$입니다. 라우터 토큰의 마진 비용은 $p_R - \delta\,A’(t_R)$이고, 실행 토큰의 마진 비용은 $p_E$입니다. 라우팅이 정확해질수록 기대 오분류 비용이 줄어, 라우터 토큰에는 마진 비용의 음의 항이 생기는 것입니다.
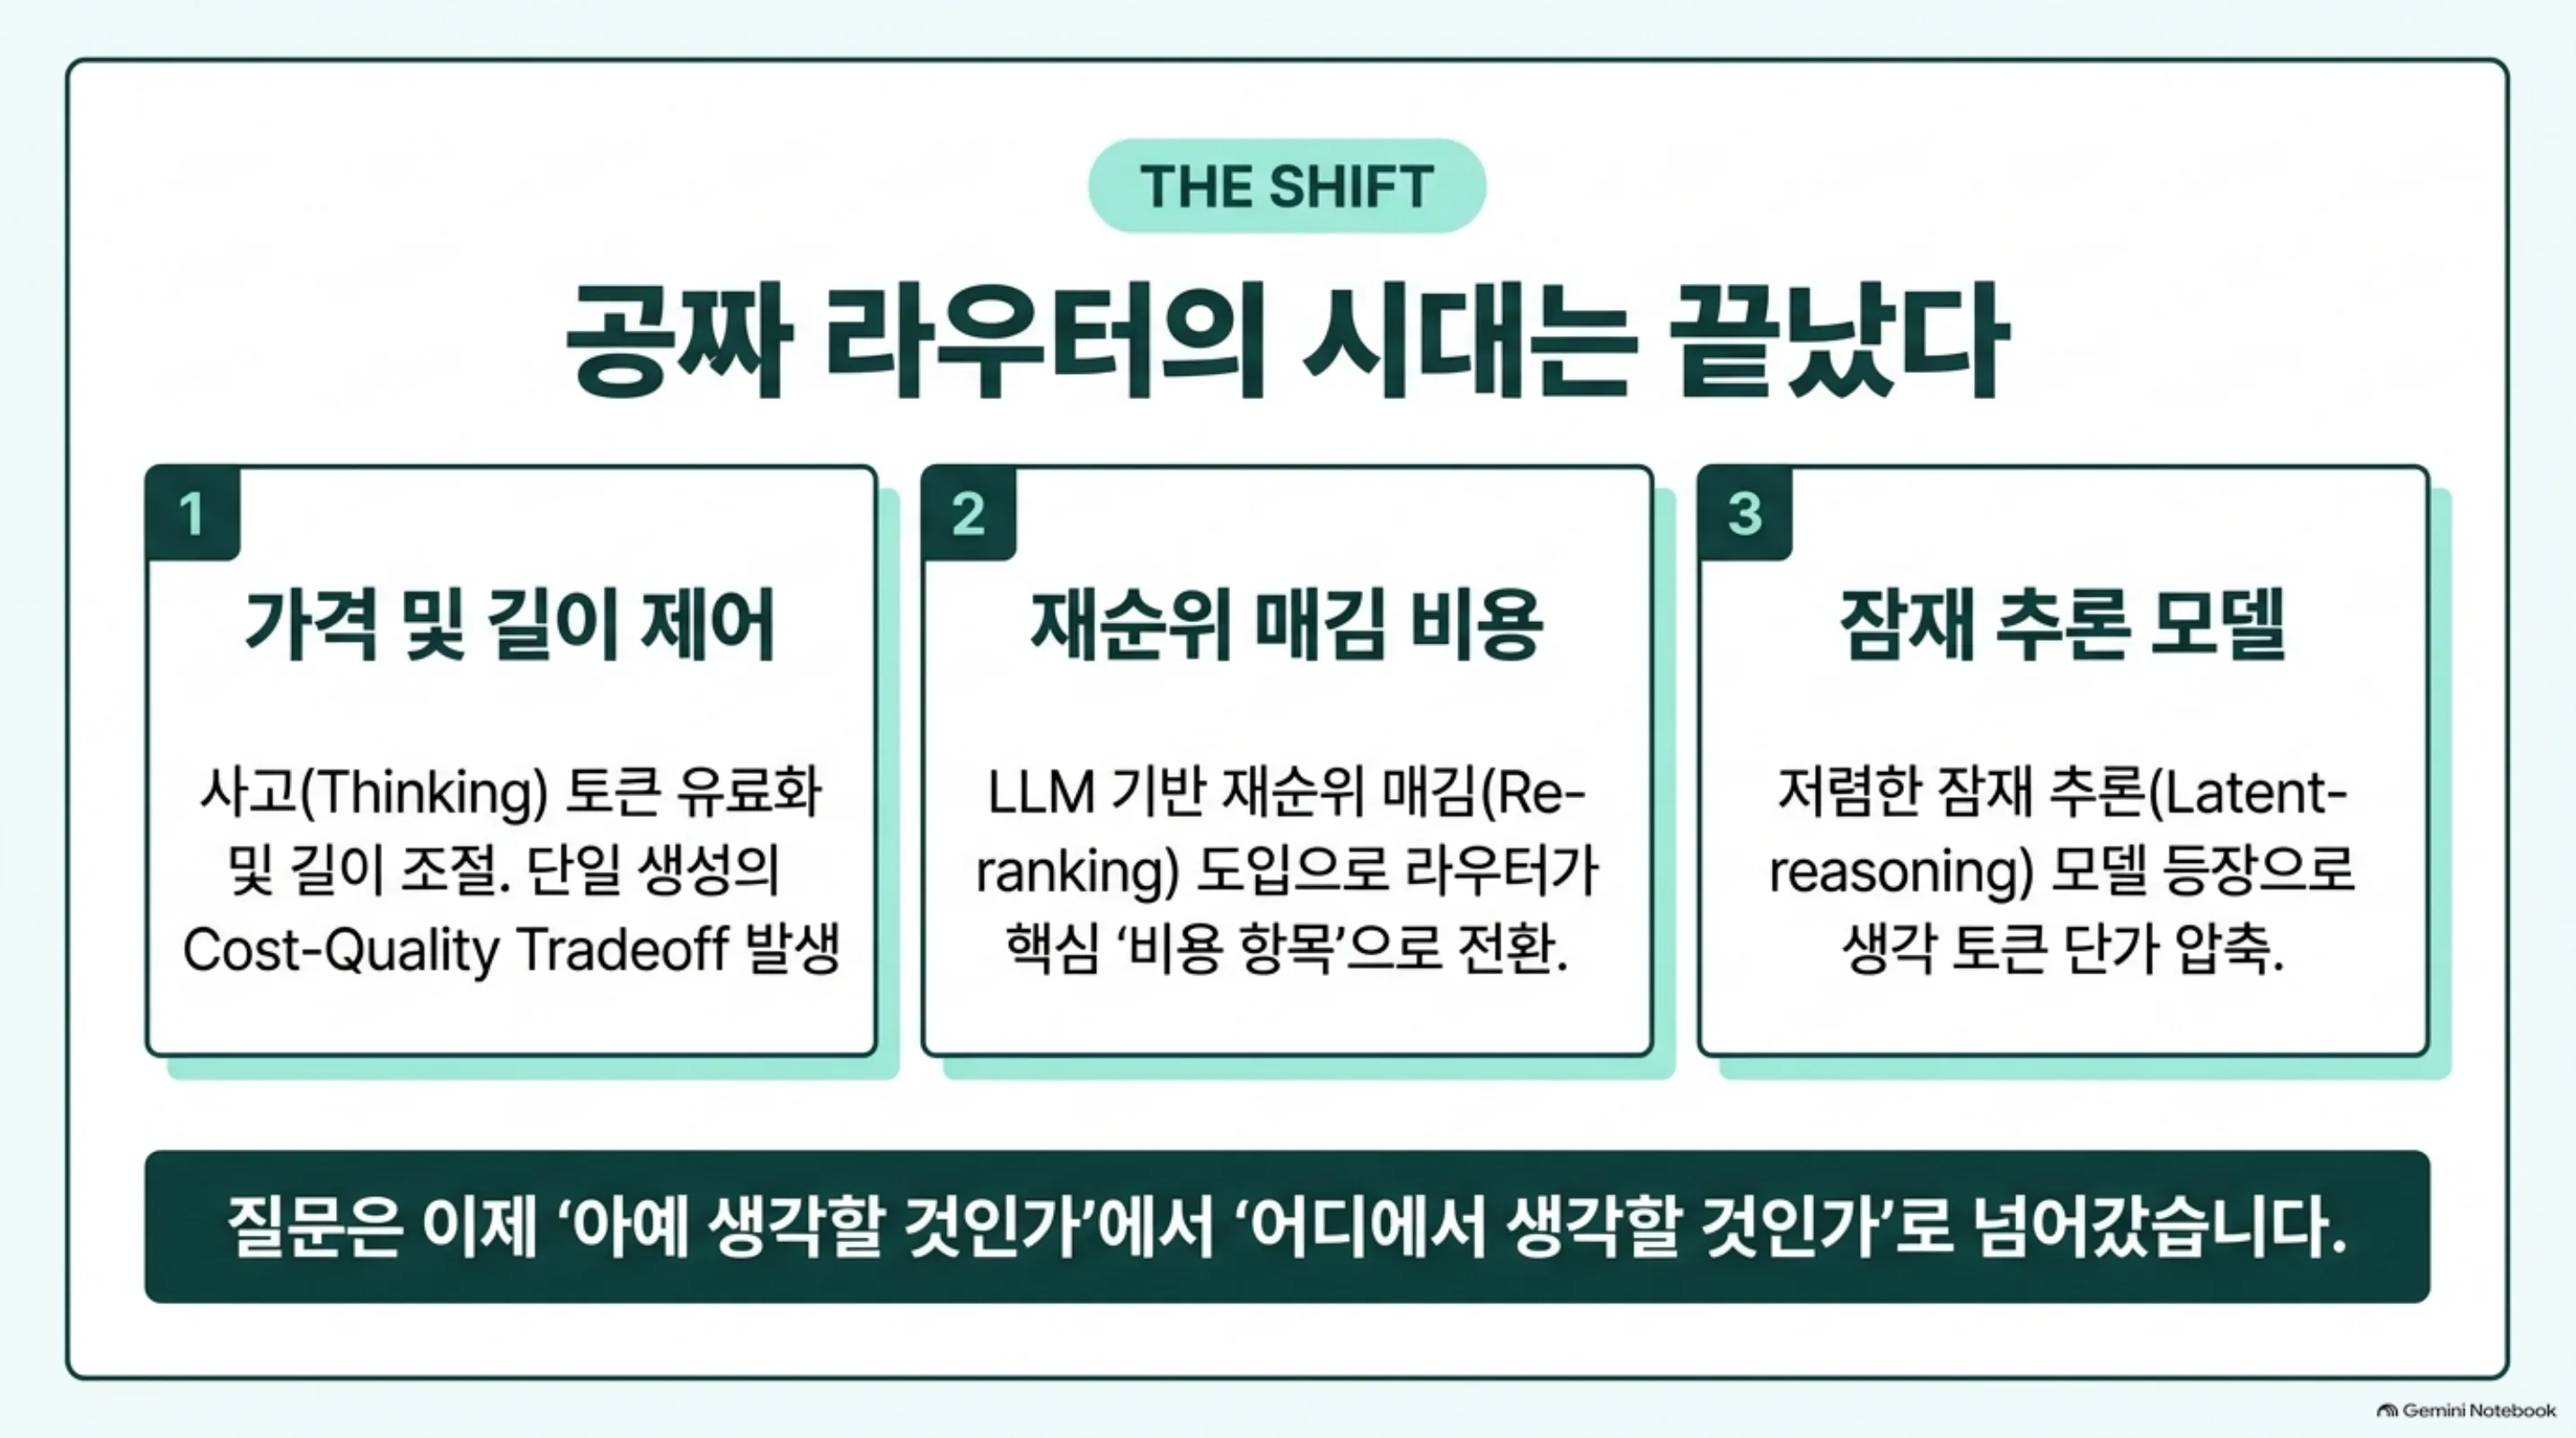
라우터 토큰이 실행 토큰보다 비싸지는 구조
이 비대칭이 이 논문의 제목이 가리키는 것입니다. 라우터 생각 토큰의 품질 수입 $A’(t_R)\,Q(t_E)$는 하류 실행 품질 전체에 곱해집니다. 라우팅 정확도 하나 단위는 뒤따르는 실행 지출 전체를 지키거나, 오분류라면 통째로 버립니다. 실행 토큰의 수입 $A(t_R)\,Q’(t_E)$는 라우팅 정확도에만 곱해집니다. 이미 고른 경로 위의 지역적 개선일 뿐입니다. 게다가 라우터 토큰은 $-\delta\,A’(t_R)$이라는 마진 비용의 음의 항을 가집니다. 라우팅 정확도의 증분 하나하나가 기대 오분류 비용을 지워내기 때문입니다.
증폭 비율 $\rho$는 이 대비를 하나의 숫자로 씁니다. $\rho = \dfrac{A’(t_R)\,Q(t_E)\,/\,(p_R-\delta A’(t_R))}{A(t_R)\,Q’(t_E)\,/\,p_E}$이며, $\rho > 1$이면 thinking의 다음 달러가 라우터에서 실행보다 더 많은 하류 quality를 사고, $\rho < 1$이면 반대로 됩니다.
구조적 귀결이 둘 있습니다. 품질을 고정하면 $\rho$는 $\delta$에 대해 증가합니다. 오분류가 비싼 환경은 라우터 thinking을 체계적으로 선호합니다. 여기에는 긴 하류 pipeline, order-sensitive composite task, 외부 side effect가 있는 환경이 포함됩니다. 그리고 어떤 크기의 router thinking으로부터도 얻는 품질 이득의 총량은 retrieval gap $g = A^{\cap}-A_{\mathrm{ret}}$로 상한 지워집니다. 모든 $t_R$에 대해 $A(t_R)Q(t_E) - A_{\mathrm{ret}}Q(t_E) \le g\,Q(t_E)$입니다. 반대로 $g > 0$이고 라우터의 응답이 비퇴화라면, 라우터에 어떤 positive 배분은 엄밀히 최적입니다.
이 gap은 이미 실측되어 있습니다. 2,275스킬 국영 양언 프로덕션 레지스트리에서 top-20 풀은 composite task의 gold 스킬을 24.3% 놓칩니다. retrieval gap, 그리고 라우터 thinking의 headroom은 composite work가 가장 중요한 레짐에서 가장 크다는 뜻입니다. 즉, 사람 말로는 가장 많이 헛갈리는 곳에서 라우터가 생각하는 값이 가장 크다는 뜻입니다.
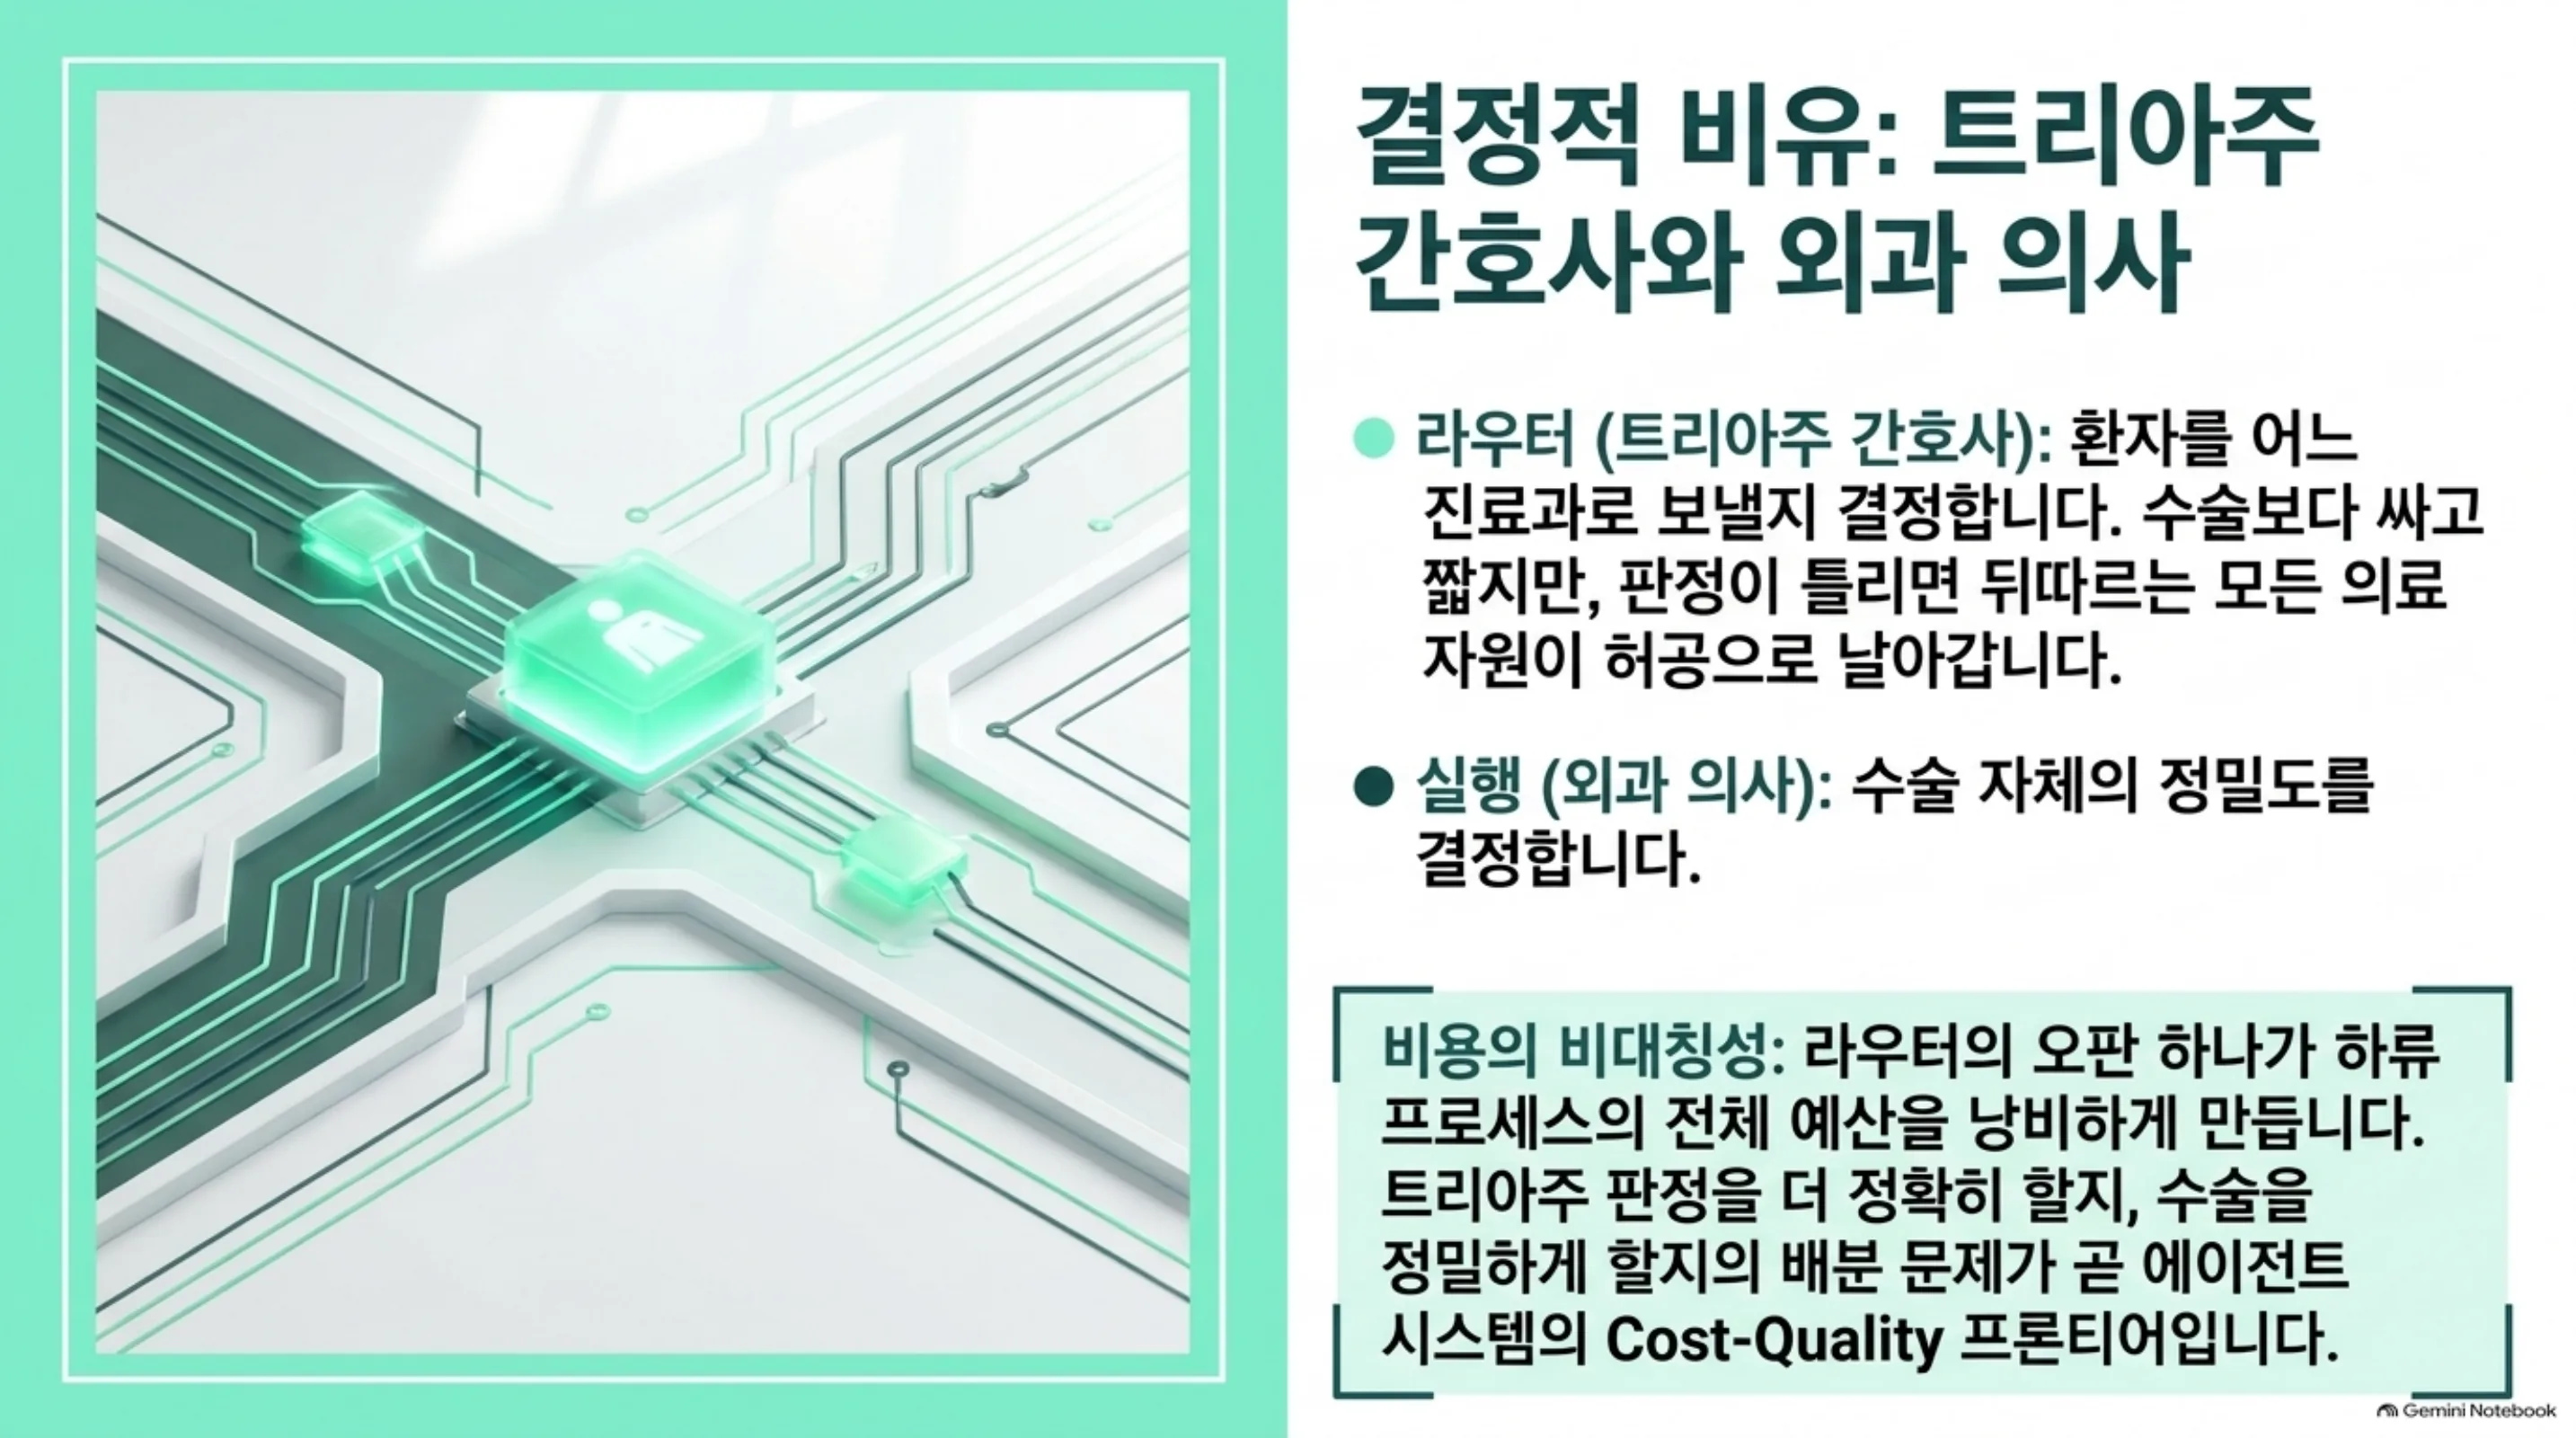
물이 낮은 데로 찬다: water-filling 배분 규칙
A1~A2에서 canonical saturating 형태를 씁니다. $A(t) = A_{\mathrm{ret}} + g\,(1-e^{-a t})$이고, $Q(t) = Q_0 + (1-Q_0)(1-e^{-b t})$입니다. $\delta = 0$이면 frontier는 유일한 쌍 $(t_R^, t_E^)$에서 달성됩니다. 두 단계의 마진 log-quality per 마진 달러가 같은 water level $\lambda^$와 같아지는 쌍입니다. $\lambda^$는 $p_R\, t_R(\lambda) + p_E\, t_E(\lambda) = B$라는 방정식의 유일한 해입니다. 이 방정식은 엄밀히 감소하는 스칼라 방정식이고, bisection으로 어떤 허용 오차든 유한 단계로 풀립니다.
운영으로 읽으면 단순합니다. 다음 생각 달러를 정규화 마진 품질 per 달러가 가장 높은 곳에 쓰고, 두 단계의 물수위가 같아지면 멈춥니다.
세 가지 행동을 짚습니다. $A(0)=A_{\mathrm{ret}}$가 이미 대부분의 작업을 커버하기 때문에, frontier에는 작은 $B$에서 kink가 생깁니다. 임계 budget 아래에서는 execution-only 배분이 최적이고($t_R^*=0$), 라우터는 flip condition이 성립할 때 처음 budget을 받습니다. $B$가 커지면 각 단계의 마진 품질이 포화하고, 분할은 천장에서 가장 먼 단계 쪽으로 다시 배분됩니다. 보통은 retrieval ceiling이 bind할 때까지 라우터 지출의 상대 비중이 늘어납니다. $\delta > 0$이면 라우터 thinking의 effective 마진 비용은 $p_R - \delta A’(t_R)$입니다. $\delta A’(t_R) \ge p_R$이면 라우터 thinking은 마진에서 비용 감소가 되어, 규칙은 latency나 API 천장까지 라우터 budget을 채웁니다.
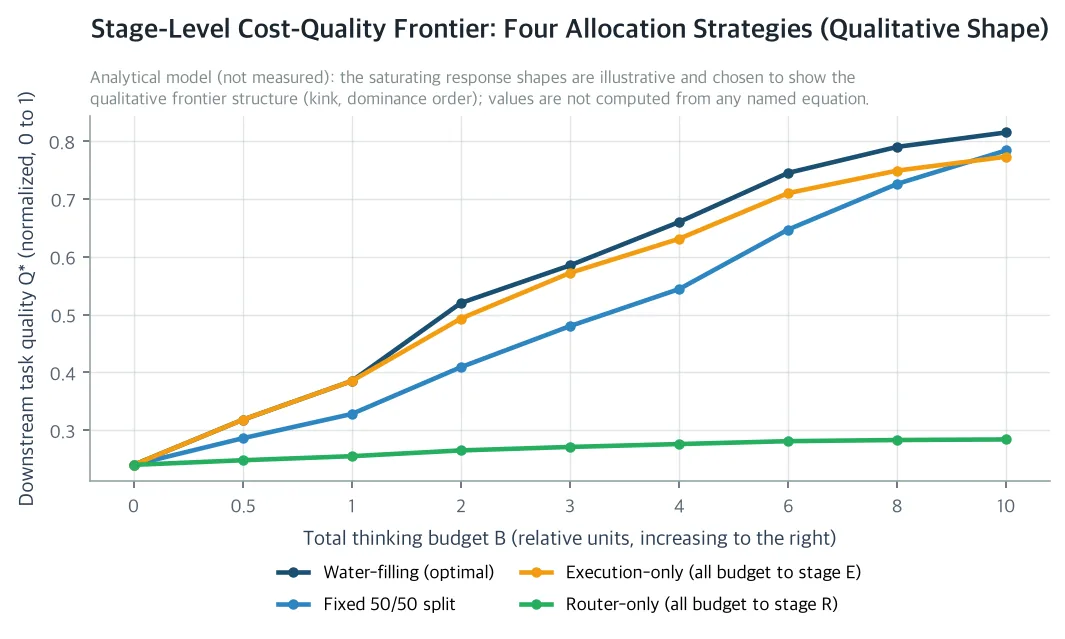 A1~A2 가정 하의 illustrative model computation이며 실측이 아닙니다. 파라미터는 $A_{\mathrm{ret}}{=}0.80$, $g{=}0.15$, $a{=}0.01$, $Q_0{=}0.30$, $b{=}0.005$, $p_R{=}p_E{=}1$(token-equivalent)입니다. 최적 water-filling 배분은 모든 budget 수준에서 두 고정 배분을 앞서며, 작은 budget kink 아래에서는 execution-only와 일치하고 그 위에서는 retrieval gap을 메우는 데서 실행 전용 대비 이득이 나옵니다. 50/50 분할은 라우터 응답이 포화하기 전에 라우터에 과잉 투자합니다. (분석 모델, 실측 아님)
예산의 방향을 뒤집는 flip condition
다음은 예산이 언제 라우터에서 통째로 빠지는지를 봅니다. budget $B$에서 execution-only 최적을 $t_E^0$로 놓으면, $\delta = 0$에서 라우터에 zero budget을 주는 배분이 최적인 필요충분 조건은 $\dfrac{A’(0)}{A(0)} \cdot \dfrac{Q(t_E^0)}{Q’(t_E^0)} \le \dfrac{p_R}{p_E}$입니다. canonical 형태로 쓰면 $A’(0)/A(0) = a\,g/A_{\mathrm{ret}}$, $Q(t)/Q’(t) = \dfrac{e^{bt}-(1-Q_0)}{b\,(1-Q_0)}$이므로, 조건은 $\dfrac{a\,g}{A_{\mathrm{ret}}} \cdot \dfrac{e^{b t_E^0}-(1-Q_0)}{b\,(1-Q_0)} \le \dfrac{p_R}{p_E}$가 됩니다. $\delta > 0$이면 flip은 늦춰지며, 조건은 $\dfrac{A’(0)\,Q(t_E^0)}{p_R-\delta A’(0)} \le \dfrac{A(0)\,Q’(t_E^0)}{p_E}$로 바뀝니다.
flip condition은 이 논문의 헤드라인 규칙인 셈입니다. 라우터 thinking이 가치 있는 것은 네 가지 중 하나가 성립할 때입니다. 첫째, retrieval coverage gap $g$가 클 때 가치 있습니다. 둘째, 라우터의 응답 속도 $a$가 높고 thinking이 recall로 잘 변환될 때 가치 있습니다. 셋째, 실행 단계가 포화 곡선의 깊은 지점에서 돌고 $Q/Q’$가 커서 실행 토큰이 곧 멈출 지점일 때 가치 있습니다. 넷째, 라우터 토큰이 실행 토큰보다 상대적으로 싸고, $p_R/p_E$가 작은 저렴한 latent-reasoning 모델이 만드는 레짐일 때 가치 있습니다. 즉, 사람 말로는 라우터의 놓침이 크고, 실행이 이미 포화됐고, 라우터가 싸면 라우터에 쓰는 쪽이 낫습니다.
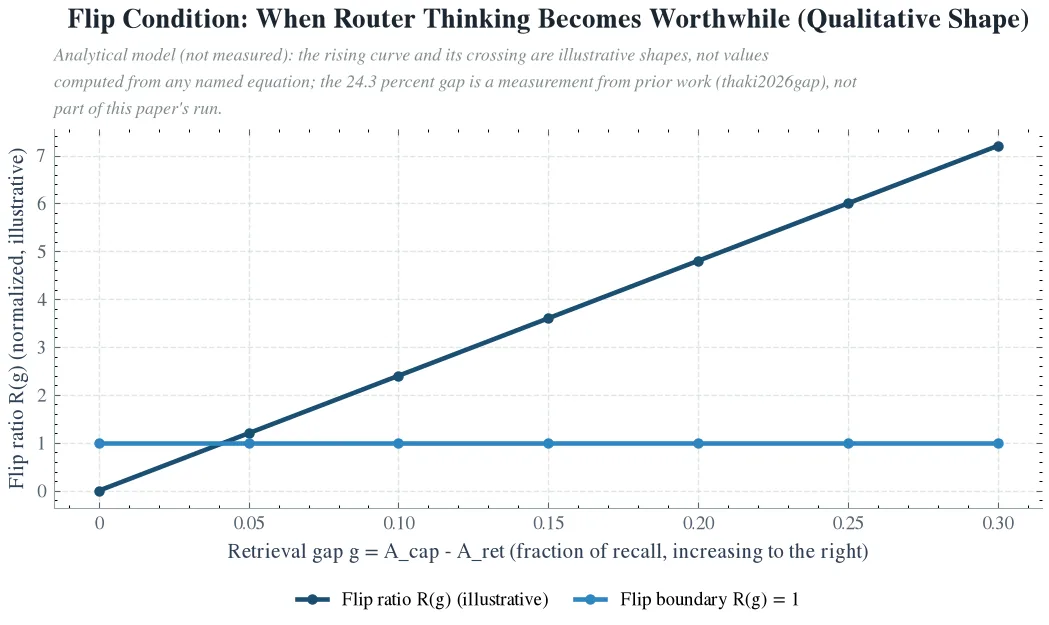 illustrative model computation이며 실측이 아닙니다. 파라미터 $a{=}0.01$, $A_{\mathrm{ret}}{=}0.80$, $b{=}0.005$, $t_E^0{=}400$, $p_R{=}p_E{=}1$이면 $R(g)=23.9\,g$이 되고, retrieval gap이 $g\approx0.042$를 넘으면 라우터가 positive thinking budget을 받아야 합니다. 2,275스킬 프로덕션 레지스트리의 top-20 coverage gap 24.3%는 이전 연구의 실측이며 이 논문의 run이 아닙니다. 이 값은 라우터에 thinking이 가치 있는 영역의 깊은 부분에 놓여 있습니다. (분석 모델, 실측 아님)
retriever 압축과 thinking budget는 서로를 대체하지 않는다
이전 양자화 결과는 $b_R$에 작용하고 $t_R$에는 작용하지 않았습니다. dense embedding의 INT8 양자화가 retrieval compute를 낮춥니다. 그 정확도 오차는 dense 항으로만 fused score에 도달하며, 융합 가중치에 의해 선형으로 감쇠합니다. 1차적으로 $w\,\epsilon$ 크기인 셈입니다. 이 논문의 레버는 $t_R$에 작용합니다. $t_R = 0$ 근처에서 thinking 이득 $A(t_R) - A(0)$은 $a\,t_R$ 크기입니다. 두 레버는 같은 frontier의 1차적으로 서로 다른 항에 작용합니다. $b_R$ 압축은 대략 품질 불변으로 비용 절편을 움직이고, $t_R$ budget은 대략 base cost 불변으로 품질을 올리는 것입니다. 상호작용은 $(\epsilon, t_R)$의 2차입니다.
실무적 귀결은 두 투자가 substitute가 아니라는 점입니다. retriever를 양자화한 뒤 아낀 달러를 실행 thinking에 쓰는 팀은 라우터 단계의 레버를 테이블 위에 남겨 둔 것입니다. frontier-optimal의 움직임은 레버를 한 번씩 당길 때마다 water-filling 방정식을 다시 푸는 것입니다.
프로덕션 벤치에서 frontier를 재는 5×3 프로토콜
router 팀이 프로덕션 인프라에서 stage-level frontier를 추정하는 절차입니다. 모든 양은 audit 가능하도록 정의됩니다. 모든 arm이 stage별 토큰 수와 task별 달러를 보고합니다.
router arm은 다섯 개입니다. R0 retrieval-only: 어휘 + dense hybrid score로 선택하며, LLM call은 없습니다. R1 zero-thinking re-rank: compact LLM이 extended thinking off 상태로 top-20 풀을 빠른 forward pass 한 번으로 재순위 매김합니다. R2: extended thinking을 작은 고정 budget $b_{\mathrm{low}}$로 씁니다. R3: $b_{\mathrm{med}} = 4\,b_{\mathrm{low}}$. R4: $b_{\mathrm{high}} = 16\,b_{\mathrm{low}}$. execution arm은 세 개입니다. E0: extended thinking을 쓰지 않습니다. E1: $e_{\mathrm{low}}$. E2: $e_{\mathrm{high}} = 8\,e_{\mathrm{low}}$. 전체 요인 5×3, 15 셀입니다. budget은 절대 토큰으로 정합니다. underlying model generation이 바뀌면 재정규화합니다. 기하 간격은 saturating response 모양(A2)을 탐침하되, 지출을 낭비하지 않습니다.
전체 요인은 프로덕션 route bench에서 뽑은 고정 task pool 위에서 돕니다. 스트래티파이는 둘입니다. single-skill 대 composite task, composite는 chain-benchmark 규약에 따라 order-sensitively 점수화됩니다. query language와 cross-lingual task가 retrieval gap이 가장 큰 곳에 놓이는지도 함께 봅니다. 각 셀은 같은 task를 같은 순서로 받습니다. 결정적 seed가 arm 간 차이를 task 변동이 아닌 budget에 귀속시킵니다.
측정 지표는 stage별로 갑니다. router stage는 recall@1, recall@5, top-1 exact match를 보고합니다. composite task의 chain-level hit(gold chain의 모든 gold 스킬이 순서대로 존재), thinking 토큰 지출, router stage 달러도 함께 보고합니다. execution stage는 task success(function-calling 정확도 + final-state check)를 보고합니다. thinking 토큰 지출, tool-call과 context 비용을 포함한 execution stage 달러도 함께 보고합니다. loop level은 task별 달러를 보고하며, list price와 self-hosted 감가는 따로 보고합니다. retry trajectory로 추정하는 기대 오분류 페널티 $\hat{\delta}$, 하류 quality $Q^*$, quality-per-dollar를 보고합니다. argmax 분할을 둔 frontier 점 $(B, F(B))$도 함께 보고합니다.
추정은 isotonic regression입니다. stage 응답 $\hat{A}(t_R)$, $\hat{Q}(t_E)$를 arm budget 위에서 fit하되, 단조성은 가정하고 모양은 가정하지 않습니다. frontier는 fit된 응답을 water-filling 방정식에서 읽고, frontier 점마다와 argmax 분할마다 95% bootstrap confidence interval을 겁니다. resampling은 스트레이타 내부 task를 대상으로 합니다. guardrail은 세 개입니다. 포화 check: $b_{\mathrm{high}}$가 $b_{\mathrm{med}}$보다 유의미한 recall 이득을 보이지 못하면, retrieval ceiling이 가깝습니다. 이때 gap bound가 유효합니다. flip check: description corpus나 registry가 바뀔 때마다 $g$가 움직이므로 flip condition을 재평가합니다. cost-drift check: flip condition이 가격에 민감하므로 model generation 사이의 $p_R/p_E$ 표류를 봅니다. 프로토콜은 고정 bench slice 위에서 주기적으로 다시 돕니다. frontier 점 하나라도 confidence interval 밖으로 이탈하면 silent default로 방치하지 않고 재배분 review를 트리거합니다.
latency와 sequence routing: frontier가 만나는 다음 지점
이론이 주는 답은 조건부입니다. 라우터 thinking이 값 있는 것은 retrieval gap이 크고, 오분류가 비싸고, 실행이 포화하고, 라우터 토큰이 싸울 때입니다. retrieval이 포화되어 실행에 아직 headroom이 있으면 라우터 thinking은 낭비인 셈입니다. 그래서 frontier는 harness별로 재야 합니다. 같은 model family도 포화한 single-skill 레지스트리에서는 flip condition의 한쪽에, 2,275스킬 양언 레지스트리에서는 다른 쪽에 앉습니다.
라우터는 매 턴에 돌기 때문에, 그 thinking budget은 latency budget이기도 합니다. 턴당 hard latency cap $L_{\max}$가 feasible set을 $t_R \le L_{\max}/r_R$($r_R$: 라우터 토큰/초)로 자릅니다. water-filling 규칙은 잘린 set에도 그대로 적용되고, $F(B)$만 낮아집니다. decision caching, 본 적 있는 task family에 라우팅 결정을 재사용하는 것,은 별도 arm으로 재어 볼 만한 free 1차 근사입니다.
flip 분석은 single-step 선택입니다. composite task는 산출물이 순서 붙은 스킬 chain이고, 라우터의 결정을 키웁니다. $\delta$는 chain 길이와 order-sensitivity와 함께 커지므로, 라우팅 응답 $A$를 움직이는 일도 비싸질 수 있습니다. 라우터는 개별 item 수준이 아닌 sequence를 생각해야 하기 때문입니다. framework는 $A$를 chain-level hit rate로 바꾸면 그대로 확장합니다. 오분류 스테이크가 라우터 값을 올리는 효과는 정확히 그 곳에서 가장 강할 것으로 논문은 기대합니다.
그래서 무엇을 바꾸면 되나
첫째, stage별 예산 튜닝 규칙을 세워야 합니다. 정규화 마진 품질 per 달러를 stage 사이에서 맞춰, route bench와 function-calling harness 위에서 재측정하는 규칙입니다. 스킬 선택 단계가 우리 agent stack의 cost-quality 레버인지 여부에 대한 답도 함께 남습니다.
둘째, retriever 압축과 라우터 thinking을 서로 다른 레버로 다뤄야 합니다. retriever를 양자화해 아낀 돈을 실행 thinking에 쓰는 것만으로는 라우터 단계의 레버를 놓치는 것입니다. frontier-optimal의 움직임은 레버를 한 번씩 당길 때마다 water-filling 방정식을 다시 풀어, 최적의 배분을 유지하는 것입니다.
셋째, frontier는 고정 bench slice 위에서 주기적으로 재측정해야 합니다. frontier 점 하나라도 confidence interval 밖으로 이탈하면 silent default로 방치하지 말고, 재배분 review를 트리거합니다. description corpus나 registry가 바뀔 때마다 flip condition을 다시 확인해야 합니다. 생각 예산을 stage별로 나누는 것이 무인 루프를 돌리는 팀의 청구서를 낮추는 accessibility 레버인 이유가 여기에 있습니다. 토큰 청구서와 task당 GPU 에너지가 동시에 줄면, frontier model의 청구서를 매 턴 감당하지 못하는 팀에도 자율 업무 자동화가 부담 가능해지기 때문입니다.
못 믿을 부분
이 논문은 analytical paper입니다. 배분 이론과 측정 설계를 세우며, 여기에 든 frontier 숫자는 A1~A2 하의 illustrative model computation이고 실측이 아닙니다. 이 글에 실측으로 들어오는 숫자는 전편의 2,275스킬 레지스트리 top-20 miss 24.3%뿐이고, 그마저도 이 논문의 run이 아니라 이전 composite-task 연구의 실측입니다.
A1(separability)은 라우터 thinking이 executor가 보는 task representation을 바꿀 때 깨집니다. 라우터가 스킬이 아니라 plan을 내놓는 경우이고, 그때 분석은 실행 품질을 execution thinking에 과귀속합니다. A3(stationarity)는 description corpus를 하룻밤 사이에 바꾸는 description repair에 의해 위반됩니다. 프로토콜의 flip check가 완화책입니다. zero-credit misroute 가정(오분류된 작업은 첫 시도에서 0점)은 robust retry가 있는 harness에게는 보수적입니다. positive-credit 변형은 $\delta$만 낮추고 flip을 늦출 뿐입니다. water-filling과 flip 정리에서 canonical 지수 형태는 tractability용입니다. 질적 진술, 즉 독수준 water level과 단조 flip condition은 A2 아래 어떤 saturating response에도 성립합니다. 프로토콜 자체가 그 check입니다. 고정 bench slice 위에서 주기적으로 재측정하고, frontier 점의 confidence interval 이탈을 재배분 review로 쓰는 것입니다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Thinking Router: Measuring the Cost-Quality Frontier of Reasoning-Budget Allocation Between Skill Selection and Task Execution in Unattended Agent Loops
이 글의 세 장은 전부 분석 모델 산출이며 실측이 아닙니다. 실측으로 들어가는 숫자는 전편의 2,275스킬 레지스트리 top-20 miss 24.3%뿐입니다.
 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.