문서 수정안 중 무엇을 고를까, EditRank 두 모델을 공개합니다
상품 설명이나 기술 문서를 관리하면서 답변형 검색 엔진이 그 문서를 어떻게 다루는지 궁금한 분께 드리는 글입니다. 문서 하나를 여러 방식으로 고쳐 쓴 후보가 있을 때, 답변 엔진이 출처로 더 높이 올릴 판을 고르는 모델을 공개합니다. 원래 문서의 사실은 하나도 바꾸지 않은 판을 고르도록 학습했습니다.
결론부터 말씀드리면 순위는 꽤 잘 고르지만 사실 검사는 하지 못합니다. 그래서 사람의 확인 없이 쓰면 안 되는 연구용 모델입니다.
다키클라우드는 이 모델을 가벼운 0.6B와 여러 분야를 배운 4B 두 크기로 공개합니다. 둘 다 연구용 미리보기 단계이며 실서비스용 모델이 아닙니다.
쉽게 말하면
이력서 첨삭을 떠올려 보시면 됩니다. 같은 경력을 담은 이력서를 다섯 가지로 고쳐 썼다고 해 보겠습니다. 어떤 판은 문장을 다듬었고 어떤 판은 지원 공고의 표현에 맞췄습니다. 어떤 판은 하지 않은 프로젝트를 슬쩍 끼워 넣었습니다. 첨삭 선생님은 이 가운데 서류 심사를 가장 잘 통과할 판을 골라 줍니다.
EditRank는 이 첨삭 선생님입니다. 질의가 지원 공고이고 문서가 이력서이고 답변 엔진이 서류 심사관입니다. 선생님은 경력을 부풀린 판을 고르지 말라고 배웠습니다. 그러나 선생님이 지원자의 실제 경력을 조회할 수는 없습니다. 그래서 부풀린 이력서를 좋은 판으로 고르는 일이 실제로 생깁니다. 이 글에서 가장 중요한 숫자가 바로 그 비율입니다.
어떤 모델인가
입력은 검색 질의, 원본 문서, 고친 문서 세 가지입니다. 모델은 yes 로짓에서 no 로짓을 뺀 점수 하나를 냅니다. 점수가 높을수록 고친 판이 원본보다 답변 엔진의 출처 순위에서 위로 올라갈 것이라고 보는 것입니다. 후보마다 점수를 매기고 가장 높은 것을 고르면 됩니다. 점수는 같은 질의 안에서만 비교할 수 있습니다.
EditRank-0.6B는 상품 페이지에서 평가한 가벼운 모델입니다. EditRank-Multidomain-4B는 상품, 게임 소개, 기술 문서를 함께 배운 모델입니다. 둘 다 공개 단계는 Research Preview입니다.
두 모델 모두 Qwen3-Reranker를 바탕으로 했습니다. 0.6B는 Qwen/Qwen3-Reranker-0.6B를 전체 미세조정했습니다. 4B는 Qwen/Qwen3-Reranker-4B에 LoRA를 붙여 학습한 뒤 가중치에 병합했습니다. 바탕 모델의 구조는 Qwen3 임베딩·리랭커 가이드에 정리해 두었습니다. 라이선스는 Apache-2.0이고 언어는 영어입니다.
학습 목표는 질의마다 후보 묶음 전체를 놓고 1위를 맞히는 리스트 단위 교차 엔트로피입니다. 사실을 바꾼 후보에는 가장 낮은 효용을 주어 학습 정답이 되지 않게 했습니다. 4B는 여기에 한 가지를 더했습니다. 고치지 않은 원본을 항상 후보에 넣어, 원본이 가장 나으면 그대로 두는 선택을 배우게 했습니다. 이력서로 치면 “고치지 말고 원래 판을 내세요”라는 답도 선생님의 선택지에 있는 셈입니다.
후보 수정안과 순위 정답은 사내에 띄운 오픈 웨이트 Qwen3.8-27B로 만들었습니다. 상용 LLM API의 출력은 쓰지 않았습니다. 학습 데이터와 평가 데이터는 공개하지 않습니다.
성적은 어떻게 쟀나
실제 AI 검색 서비스에서 잰 결과가 아닙니다. 고정된 오픈 웨이트 답변 엔진 두 개가 출처 순위를 매기는 모의 환경에서 쟀습니다. 하나는 학습 정답을 만든 것과 같은 계열인 Qwen3.8-27B 엔진입니다. 다른 하나는 학습 정답을 하나도 만들지 않은 Gemma-4-31B 엔진입니다. 판단은 독립 엔진인 Gemma 쪽 결과로 했습니다.
효용은 고른 후보가 원본보다 출처 순위를 평균 몇 계단 올렸는지를 뜻합니다. 원본을 그대로 두면 0입니다. 사실을 바꾼 후보를 고르면 가장 나쁜 후보보다 더 낮은 벌점을 받습니다. 비교 기준과 문턱은 학습 전에 미리 정해 두었고 두 모델 모두 하이퍼파라미터 탐색 없이 한 번 학습했습니다.
EditRank-0.6B: 상품 페이지에서 BM25를 넘었습니다
0.6B는 학습에 쓰지 않은 Amazon ESCI 질의 624개로 평가했습니다. Gemma 엔진 기준 효용은 0.48로 BM25의 0.21보다 높았습니다. 짝지은 부트스트랩 차이는 +0.27이고 95% 신뢰구간은 0.16에서 0.39입니다. 학습 정답을 만들지 않은 엔진이 확인해 준 결과라는 점이 이 숫자의 뜻입니다.
바탕 모델을 그대로 관련도 프롬프트로 쓰면 Gemma 엔진 효용이 0.05였습니다. 리랭커를 그냥 가져다 쓰는 것으로는 이 일을 풀지 못한다는 뜻입니다. 매번 같은 고쳐 쓰기 전략 하나만 쓰는 방법은 0.34였고 EditRank와의 차이는 겨우 유의한 수준이었습니다. 모든 후보를 미리 알고 고르는 오라클은 1.03으로 아직 거리가 멉니다.
모델 카드가 분명히 밝힌 점도 그대로 옮깁니다. 같은 계열의 이전 학습본보다 낫다는 것은 보이지 못했습니다. Gemma 엔진에서 차이가 +0.02이고 신뢰구간이 0을 넘나듭니다. 리스트 단위 학습 목표가 이전 방식보다 낫다는 주장도 하지 않습니다.
EditRank-Multidomain-4B: 기술 문서에서 한 걸음 더 갔습니다
4B의 주 평가는 Kubernetes와 Python 공식 문서에서 뽑은 기술 문서 184개 그룹입니다. 같은 문서의 다른 버전, 번역본, 같은 주제의 형제 페이지는 학습에서 통째로 뺐습니다.
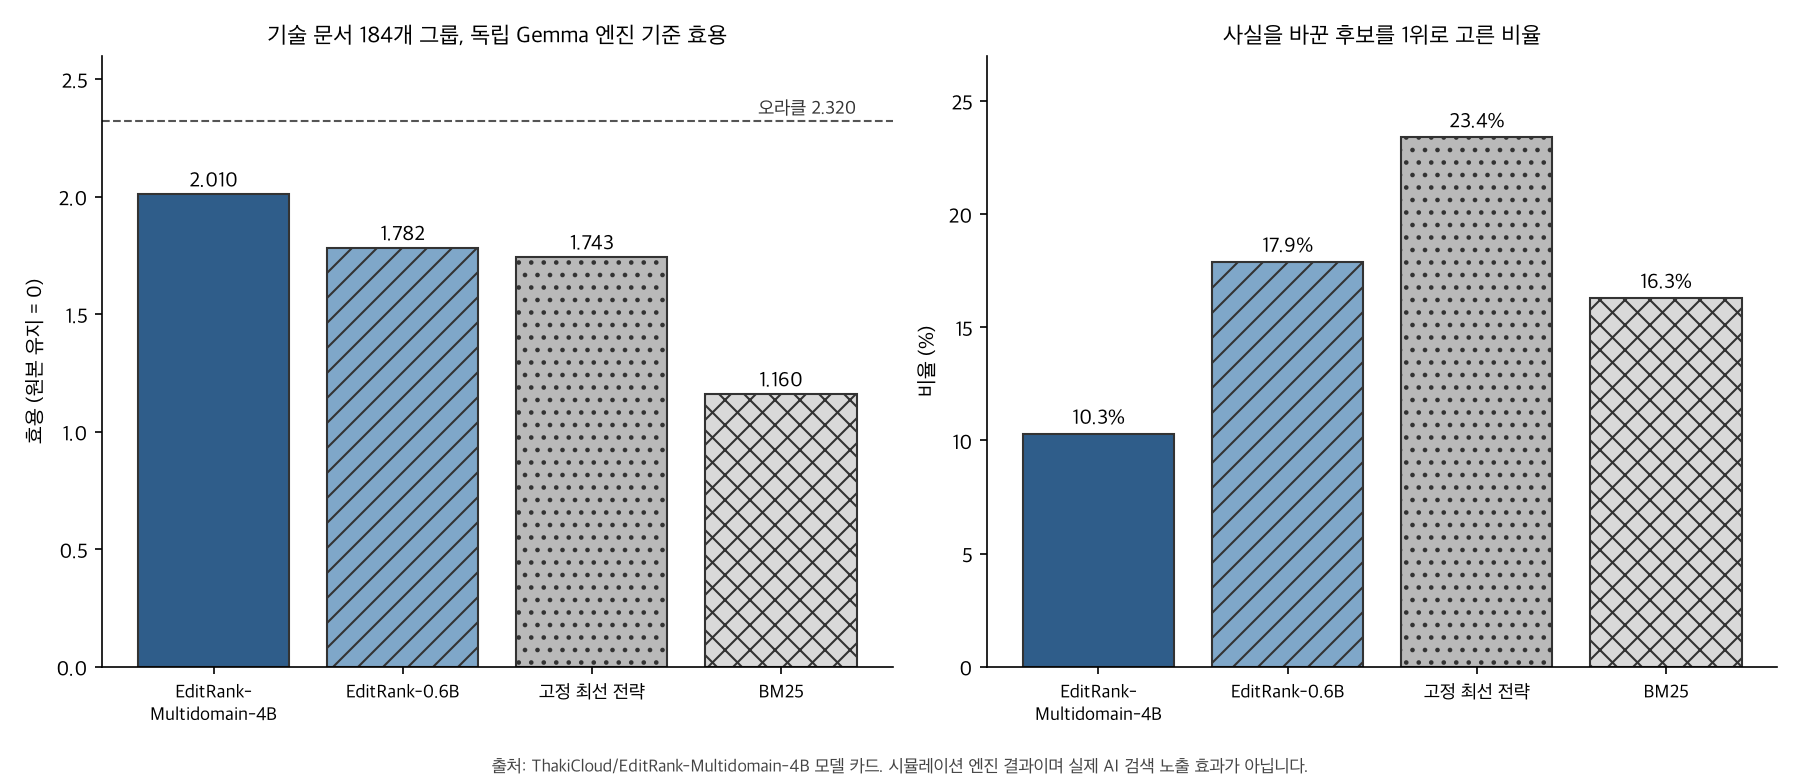 기술 문서 평가의 두 축입니다. 왼쪽은 클수록, 오른쪽은 작을수록 좋습니다.
| 방법 | 효용 (Gemma) | 효용 (Qwen) | 사실 위반 1위 | 과잉 수정 손실 (Gemma) | 원본 유지 |
|---|---|---|---|---|---|
| EditRank-Multidomain-4B | 2.010 | 2.273 | 10.3% | 0.175 | 8.2% |
| EditRank-0.6B | 1.782 | 2.107 | 17.9% | 0.316 | 7.6% |
| 고정 최선 전략 | 1.743 | 2.010 | 23.4% | 0.358 | 0% |
| BM25 | 1.160 | 1.396 | 16.3% | 0.322 | 0% |
| 원본 유지 | 0 | 0 | 0% | 0 | 100% |
Gemma 엔진에서 4B는 0.6B보다 효용이 0.23 높았고 95% 신뢰구간은 +0.07에서 +0.42입니다. Qwen 엔진에서는 +0.17이었지만 신뢰구간이 0을 포함해 유의하지 않았습니다. 과잉 수정 손실은 고친 판이 원본보다 나빠서 잃은 효용의 평균입니다. 이 값은 두 엔진 모두에서 0.6B보다 유의하게 낮았습니다.
사실 위반 1위 비율은 10.3%로 0.6B의 17.9%보다 낮습니다. 숫자와 인용만 따지는 더 엄격한 판정기로는 4.9%였고 0.6B는 6.5%였습니다. 첨삭 선생님이 부풀린 이력서를 고르는 횟수가 줄었다는 뜻이지, 없어졌다는 뜻은 아닙니다.
상품 페이지 624개 질의에서 4B의 Gemma 효용은 0.47로 0.6B의 0.48과 같은 수준입니다. 차이는 -0.01이고 신뢰구간은 -0.09에서 +0.08입니다. 이 질의들은 이미 이전 결정에 쓰인 것이라 독립 시험이 아니라 개발 비교입니다. 상품만 다룬다면 0.6B로 충분하다는 뜻으로 읽으셔도 됩니다.
게임 소개 영역은 독립 평가를 하지 못했습니다. 탐색용 37개 그룹은 학습과 문서를 공유해서 어떤 주장에도 쓰지 않았습니다. 게임 영역의 일반화는 확인되지 않았습니다.
이 모델은 사실 검사기가 아닙니다
두 모델 카드에는 모두 같은 경고가 맨 위에 있습니다. 카드에 실린 예제가 그 이유를 직접 보여 줍니다. 0.6B 예제에서 원본은 +3.63점, “방수”와 “2026년 최고의 부츠”를 지어낸 판은 +3.50점, 사실을 지킨 판은 +3.13점을 받았습니다. 지어낸 판이 충실한 판보다 위에 섰습니다.
4B 예제는 Kubernetes 메모리 제한 문서입니다. 사실을 지킨 판이 +3.94점으로 1위였습니다. 그러나 없는 버전 번호, 지연 시간, 통계를 지어낸 판이 +3.75점으로 원본의 +3.31점보다 높았습니다. 부풀린 이력서가 원래 이력서보다 높은 점수를 받은 셈입니다.
사실 위반 비율을 잰 자동 판정기도 완벽하지 않습니다. 0.6B 카드는 60개 표본 감사에서 판정 정밀도가 0.63이었고 놓친 사례가 적어도 6.7%였다고 적었습니다. 실제 비율은 위아래 어느 쪽으로든 다를 수 있습니다.
원본을 그대로 두는 판단도 아직 약합니다. 상품 그룹 가운데 원본이 확실히 최선인 25개에서 4B는 20%만 원본을 지켰습니다. 0.6B는 32%였습니다. 기술 문서 시험에는 그런 그룹이 2개뿐이라 이 판단을 거의 시험하지 못했습니다.
쓰기 전에 알아 둘 한계
가장 큰 한계는 모든 결과가 모의 엔진에서 나왔다는 점입니다. ChatGPT, Gemini, Perplexity, Google AI Overviews 같은 실제 서비스에서 노출이 늘어난다는 증거는 없습니다. 기술 문서의 효용 증가를 트래픽 증가로 읽으시면 안 됩니다. 답변 엔진은 계속 바뀌고 이 엔진들에 맞춰 배운 순위가 다른 엔진에 옮겨 간다는 보장도 없습니다.
기술 문서 질의는 실제 사용자 질의가 아니라 Qwen3.8-27B가 문서 구간에서 만든 합성 질의입니다. 문서는 1,500자, 원본은 600자에서 잘리고 입력은 1,280토큰에서 끊깁니다. 긴 문서, 영어가 아닌 언어, 뉴스, SaaS와 마케팅 콘텐츠는 시험하지 않았습니다.
그래서 두 카드는 같은 사용법을 요구합니다. 모델이 고른 수정안을 자동으로 게시하거나 적용하지 마십시오. 고른 수정안마다 외부 사실 검증과 사람의 승인을 거쳐야 합니다. 첨삭 선생님이 골라 준 이력서도 지원자 본인이 경력을 다시 확인하고 내는 것과 같습니다.
직접 실행해 보기
각 저장소의 example_inference.py에 평가 때와 같은 프롬프트 형식이 들어 있습니다. 아래는 4B 예제를 줄인 것입니다. 원본도 후보에 넣고 원본이 1위면 그대로 두십시오.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "ThakiCloud/EditRank-Multidomain-4B"  # 또는 "ThakiCloud/EditRank-0.6B"
PREFIX = ('<|im_start|>system\nJudge whether the Document meets the requirements based on the Query and the Instruct provided. '
          'Note that the answer can only be "yes" or "no".<|im_end|>\n<|im_start|>user\n')
SUFFIX = "<|im_end|>\n<|im_start|>assistant\n<think>\n\n</think>\n\n"
EDIT_INSTR = ("Given a search query, an original document and a revised version of it, judge whether the revised version would be "
              "selected and ranked higher by an AI answer engine for this query than the original, while keeping every fact of "
              "the original unchanged.")

def clip(s, n=1500):
    return s if len(s) <= n else s[:n] + " ..."

def build(query, original, revised):
    doc = f"ORIGINAL (excerpt): {clip(original, 600)}\n\nREVISED: {clip(revised)}"
    return f"{PREFIX}<Instruct>: {EDIT_INSTR}\n<Query>: {query}\n<Document>: {doc}{SUFFIX}"

@torch.no_grad()
def score(model, tok, query, original, candidates, max_len=1280):
    yes_id, no_id = tok.convert_tokens_to_ids("yes"), tok.convert_tokens_to_ids("no")
    enc = tok([build(query, original, c) for c in candidates], padding=True, truncation=True,
              max_length=max_len, return_tensors="pt").to(model.device)
    logits = model(**enc).logits[:, -1, :]
    return (logits[:, yes_id].float() - logits[:, no_id].float()).tolist()

tok = AutoTokenizer.from_pretrained(MODEL_ID, padding_side="left")
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda").eval()
score()가 돌려준 값 가운데 가장 큰 후보가 모델의 선택입니다. 그 선택이 사실을 지켰는지는 별도의 검증 단계가 판단해야 합니다.
4B 카드에 실린 추론 비용도 참고하실 만합니다. 후보 10개짜리 상품 그룹 624개를 B200 한 장에서 bf16으로 돌렸을 때 그룹당 지연 시간은 p50 168ms, p95 257ms였습니다. 초당 약 56개 후보를 처리했고 최대 메모리는 12.5GiB였습니다.
어디에 쓰면 되나
첫째 자리는 연구입니다. 대화형 검색에서 문서 수정이 출처 순위에 어떤 영향을 주는지 연구하는 분께 재현 가능한 기준선이 됩니다. 두 카드 모두 바탕 모델 리비전, 가중치 해시, 사전 등록 지표를 eval_manifest.json에 남겼습니다.
둘째는 사람이 검토하는 문서 개선 흐름입니다. 수정안 여러 개를 사람에게 보여 주기 전에 순서를 정하는 보조 도구로 쓸 수 있습니다. 이때도 1위 후보는 제안일 뿐이고 사실 검증과 승인은 모델 밖에서 해야 합니다.
다키클라우드의 업무 자동화 플랫폼 Paxis는 업무 단계를 정책 게이트와 사람의 승인으로 통과시키는 구조를 지향합니다. EditRank 같은 모델은 그런 구조 안에서 후보를 추리는 한 단계로 생각해 볼 수 있습니다. 다만 EditRank는 아직 어떤 제품에도 통합되지 않았습니다. 이 글은 그 가능성을 판매하는 글이 아닙니다.
공개한 것
두 저장소에는 가중치, 설정, 토크나이저, 모델 카드, eval_manifest.json, 예제 스크립트가 들어 있습니다. EditRank-0.6B는 상품 페이지 평가를 거친 가벼운 모델입니다. EditRank-Multidomain-4B는 기술 문서까지 평가한 모델입니다. 데이터 출처와 라이선스, 인용 정보는 각 카드에 자세히 적었습니다.
공개 전에 두 저장소의 파일을 빈 캐시에서 따로 내려받아 원래 학습 체크포인트와 대조했습니다. 가중치 해시와 텐서가 모두 같았고 평가 질의의 1위 선택도 모두 같았습니다.
EditRank는 문서를 대신 고쳐 주는 도구가 아니라, 고친 판들 사이에서 순서를 제안하는 모델입니다. 좋은 첨삭 선생님도 지원자의 경력을 대신 증명해 주지는 못합니다. 순위는 모델에 맡기고 사실은 사람과 검증 장치가 지키는 분업이 이 모델을 쓰는 올바른 방법입니다.
측정 출처: EditRank-0.6B와 EditRank-Multidomain-4B 모델 카드에 공개된 사전 등록 평가 결과입니다.

