4비트는 툴콜에 안전한가: 무인 에이전트 구조 출력의 정밀도 절벽을 돈으로 매기는 법
4비트로 서빙하면 비용은 확실히 내려갑니다. 그런데 무인 에이전트가 내는 구조적 호출은 같은 저정밀도에서 자유 산문보다 빨리 깨집니다. 셀프호스티드로 무인 에이전트를 돌리거나 그 서빙 청구서를 책임지는 클라우드 엔지니어라면, 이 글이 답하는 질문이 곧 오늘 일입니다. 이 논문은 4비트가 구조적 호출에 안전한지를 하나의 숫자로 정의하고 그 절벽의 위치를 서빙 비용과 맞춥니다.
배경을 짧게 둡니다. 같은 모델 체크포인트를 세 단계의 정밀도로 재코딩하고 H200 한 장으로 서빙합니다. 요청은 호출 구조를 계약으로 채점하는 툴콜과, 사실 관계로 채점하는 산문 두 종류입니다.
이 글의 질문은 하나입니다. 툴콜 조각이 산문보다 빨리 깨지는 정밀도 지점이 어디인지, 그리고 그 손실이 밴드폭 절약보다 비싼지 여부입니다. 답은 운영 규칙 세 개로 끝납니다.
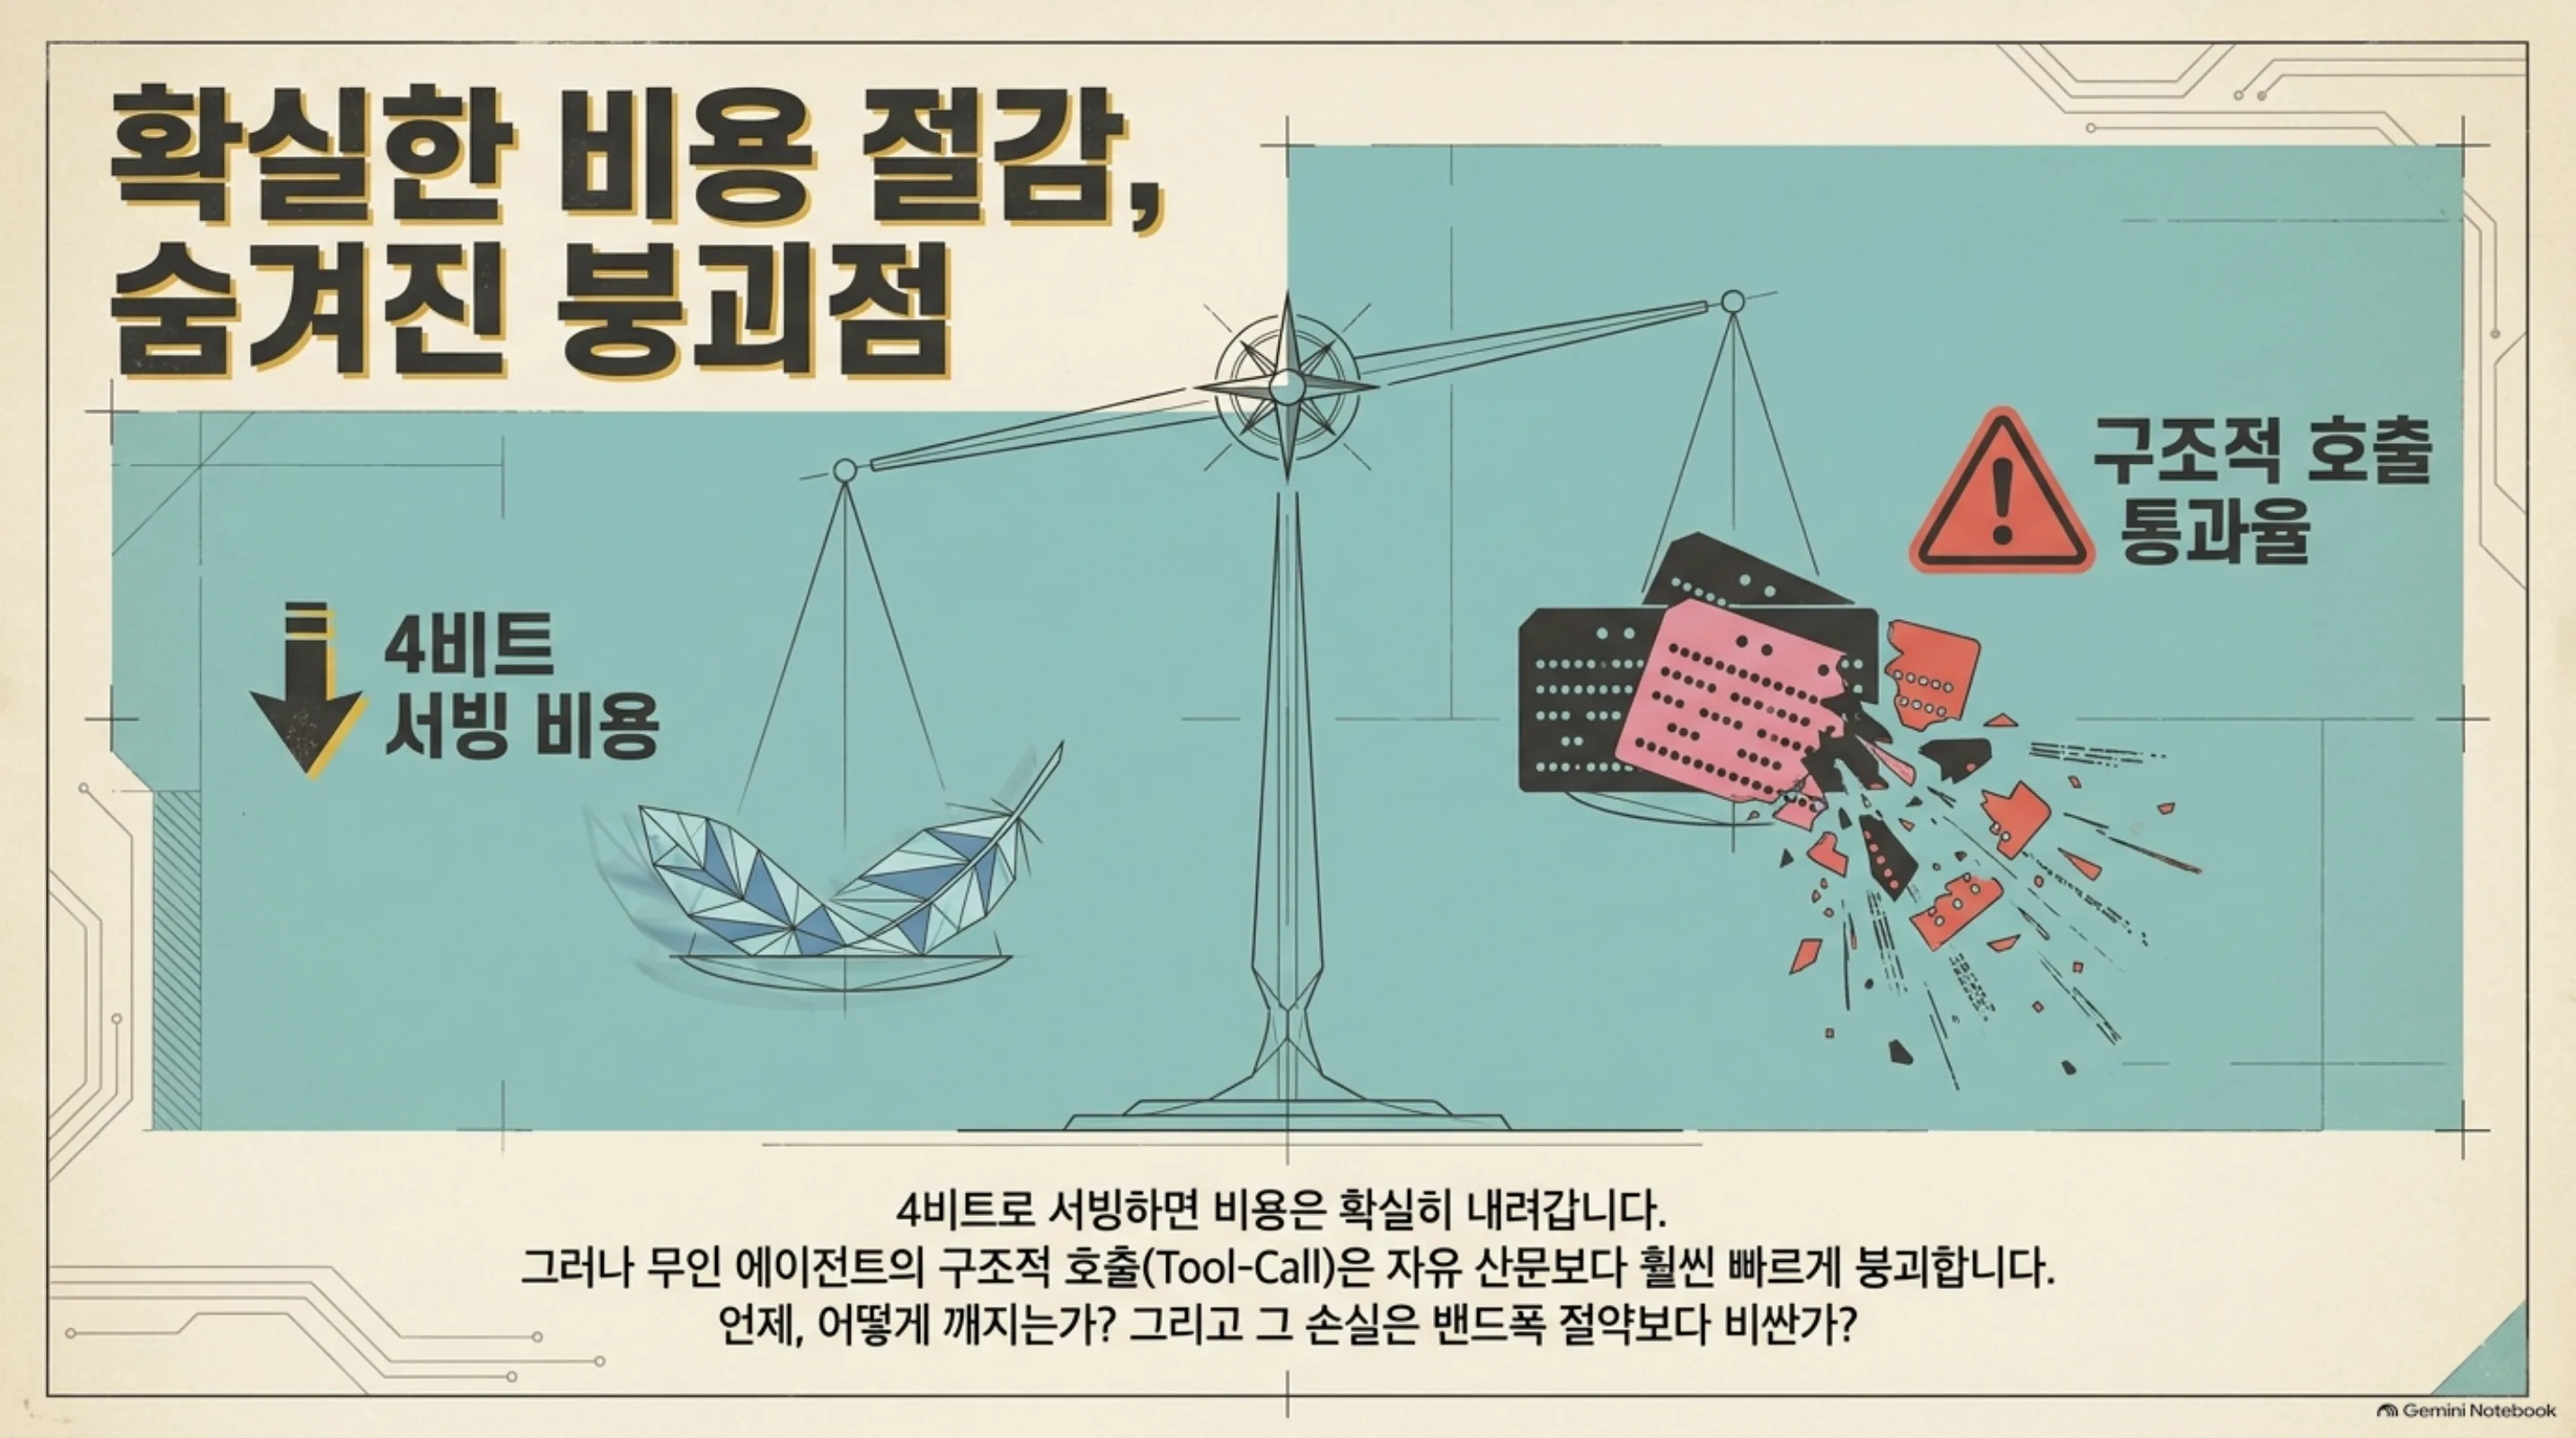
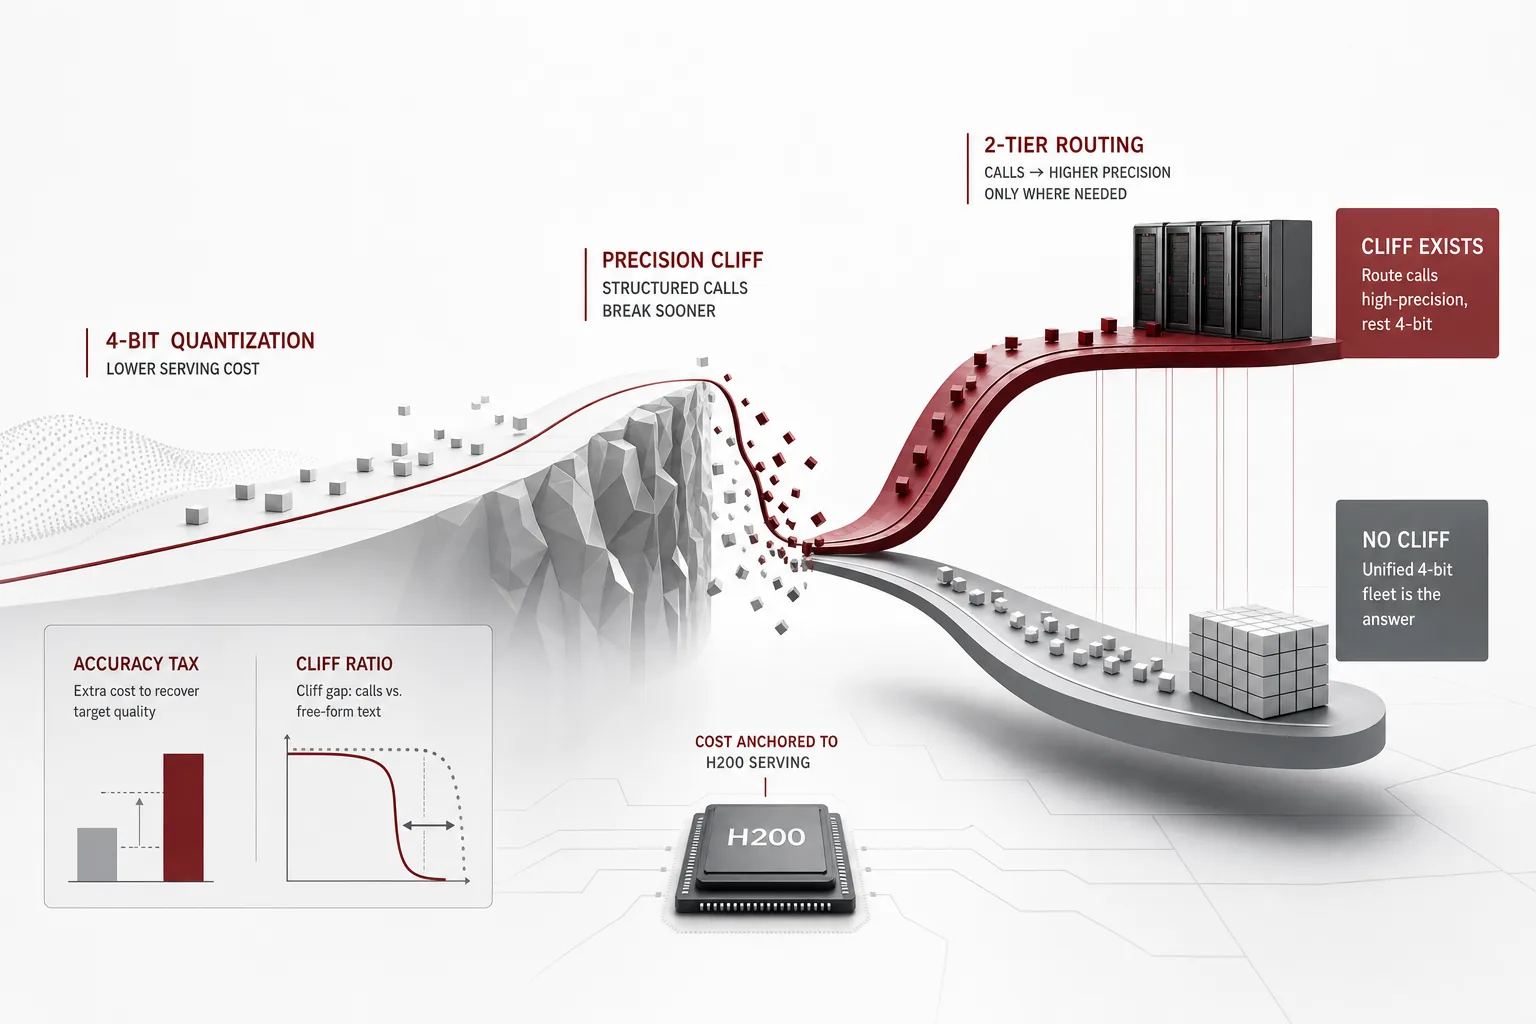 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
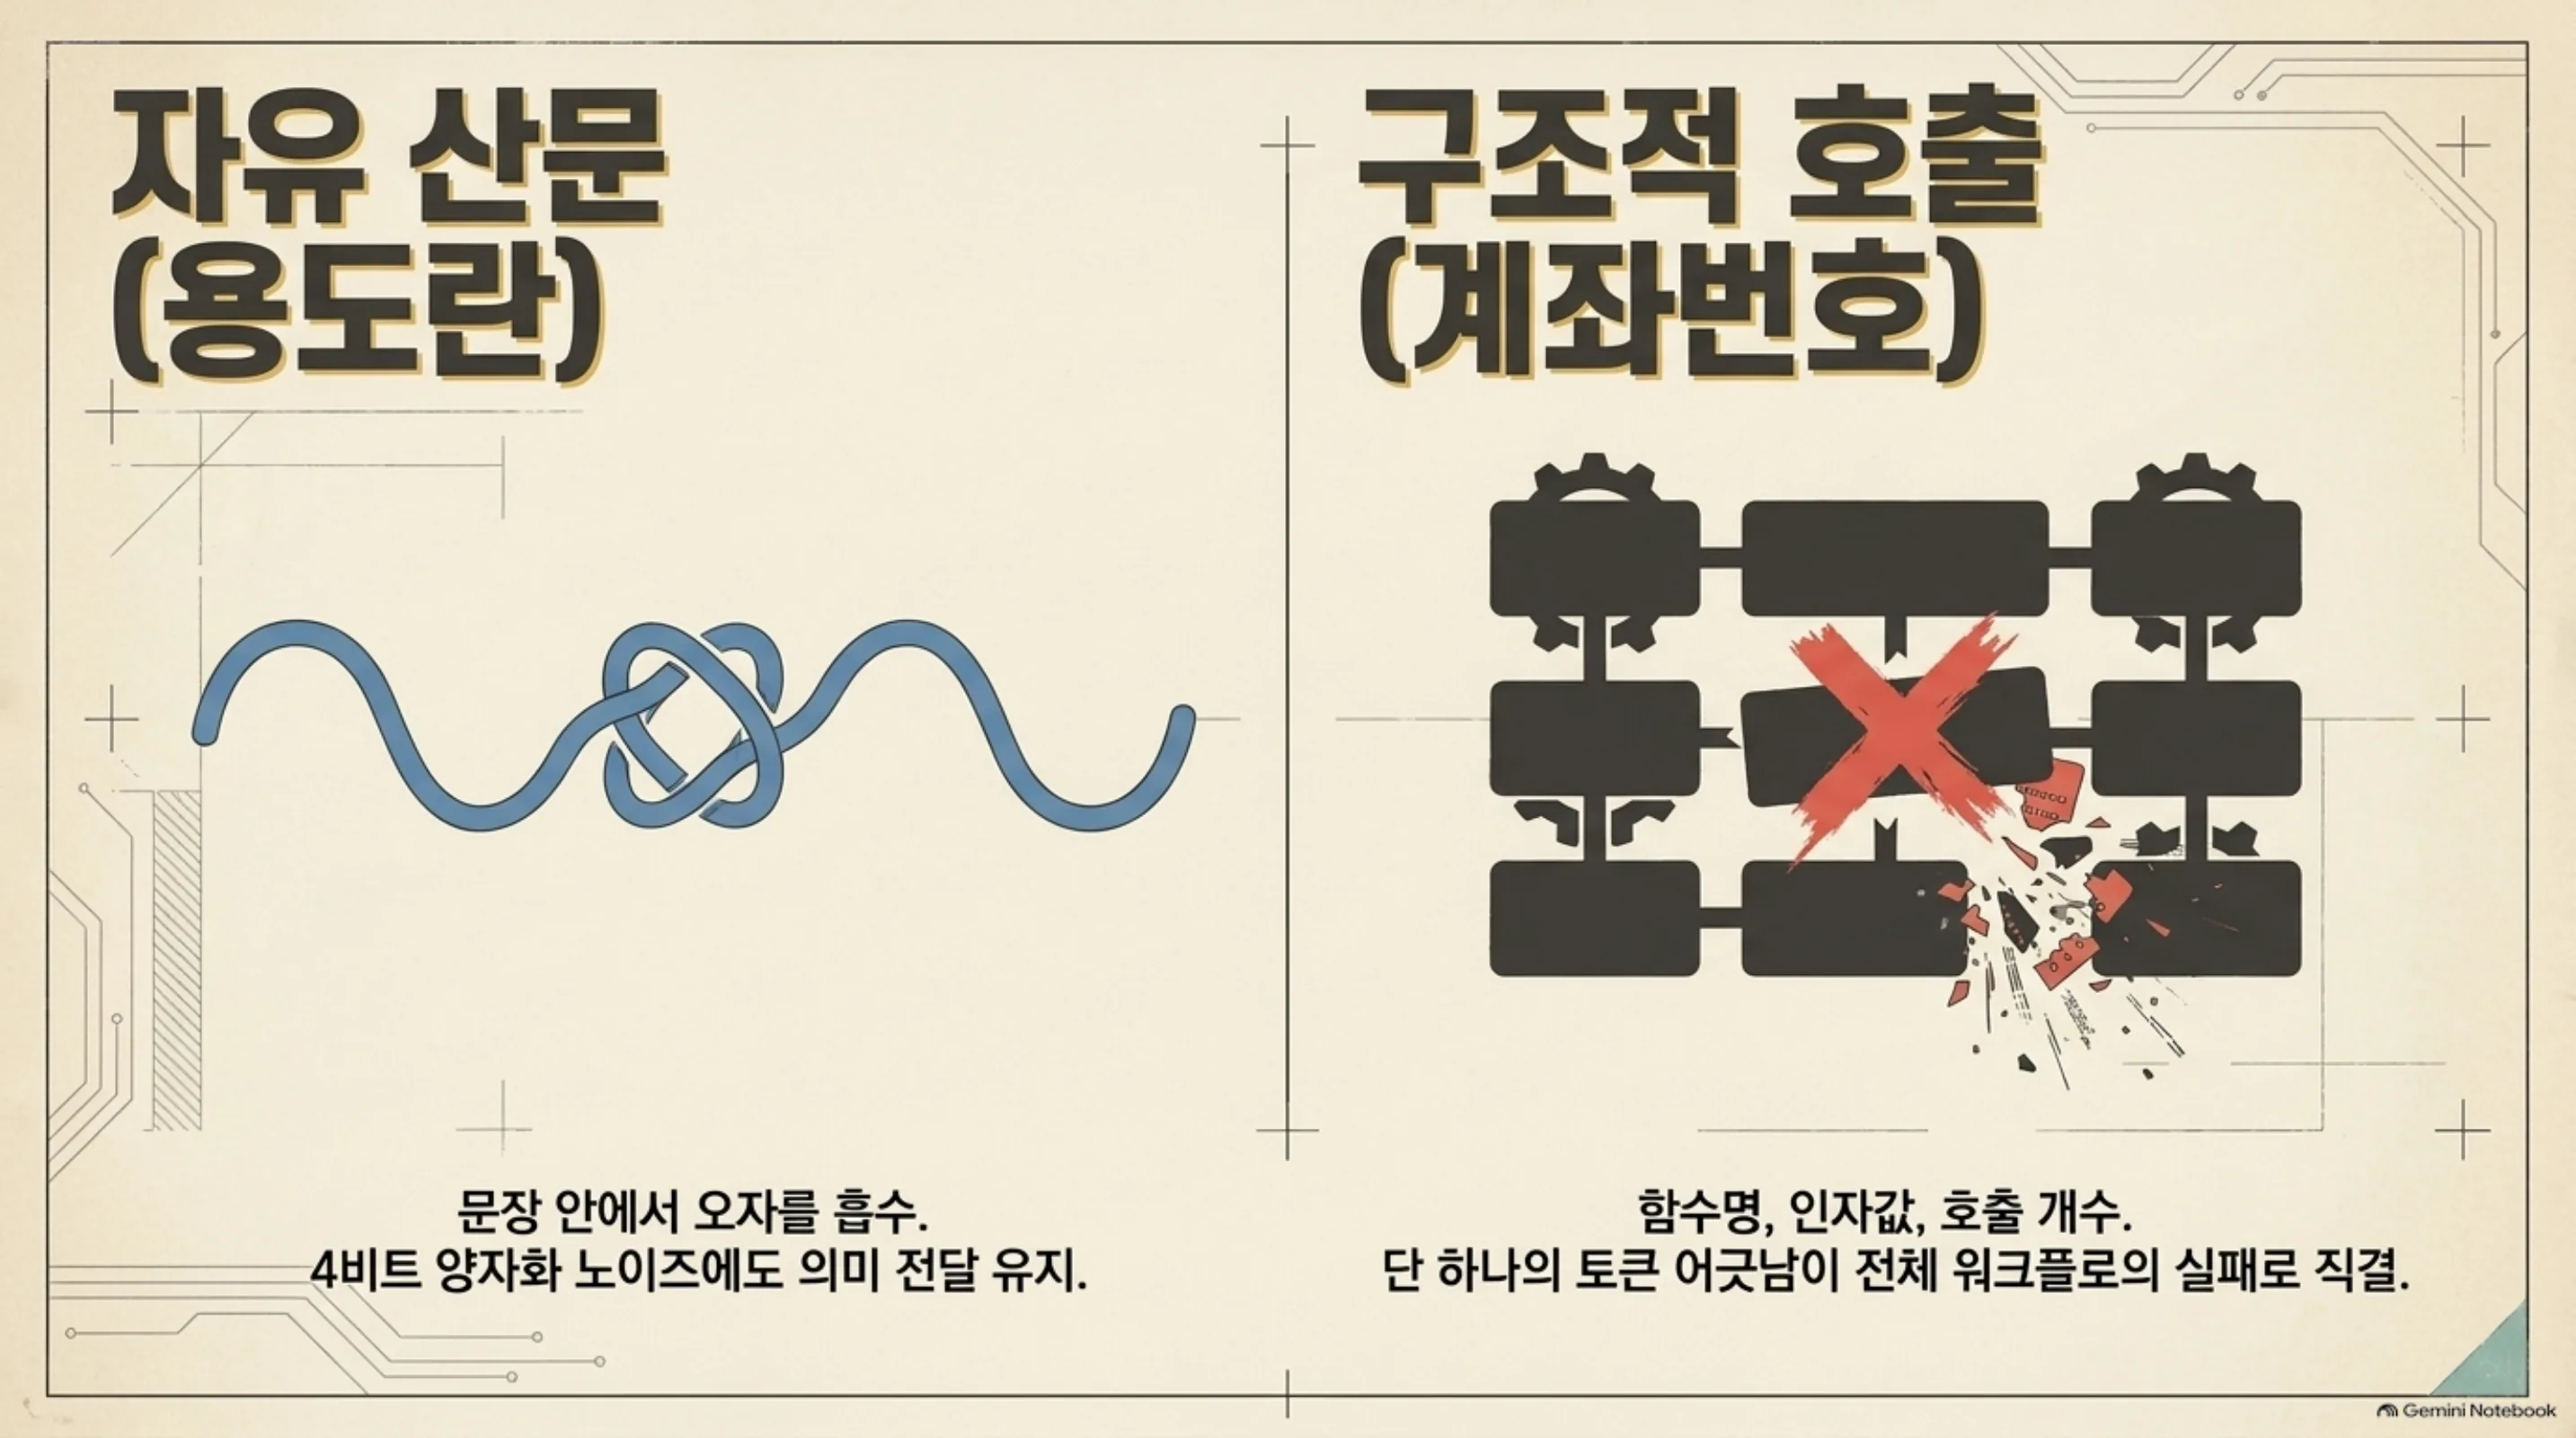
돈을 보내면 계좌번호와 용도란을 씁니다. 계좌번호는 짧은 문자열인데, 한 자리만 틀려도 송금은 통째로 무산됩니다. 용도란에 ‘사은’을 ‘사언’으로 잘못 적어도 돈은 그대로 잘 도착합니다. 무인 에이전트의 산출물도 이와 닮아 있습니다.
자유 산문은 용도란이고 구조적 호출은 계좌번호입니다. 함수 이름과 인자 값, 호출 개수를 뒤의 코드가 그대로 받아 쓰는 호출은 한 토큰만 어긋나면 워크플로 전체가 멈춥니다. 산문의 오자는 그 문장 안에서 흡수되지만, 호출의 오기는 재시도와 사용자에게 보이는 실패로 돌아옵니다. 같은 정밀도에서도 두 산출물의 깨짐 속도는 달라질 수 있습니다.
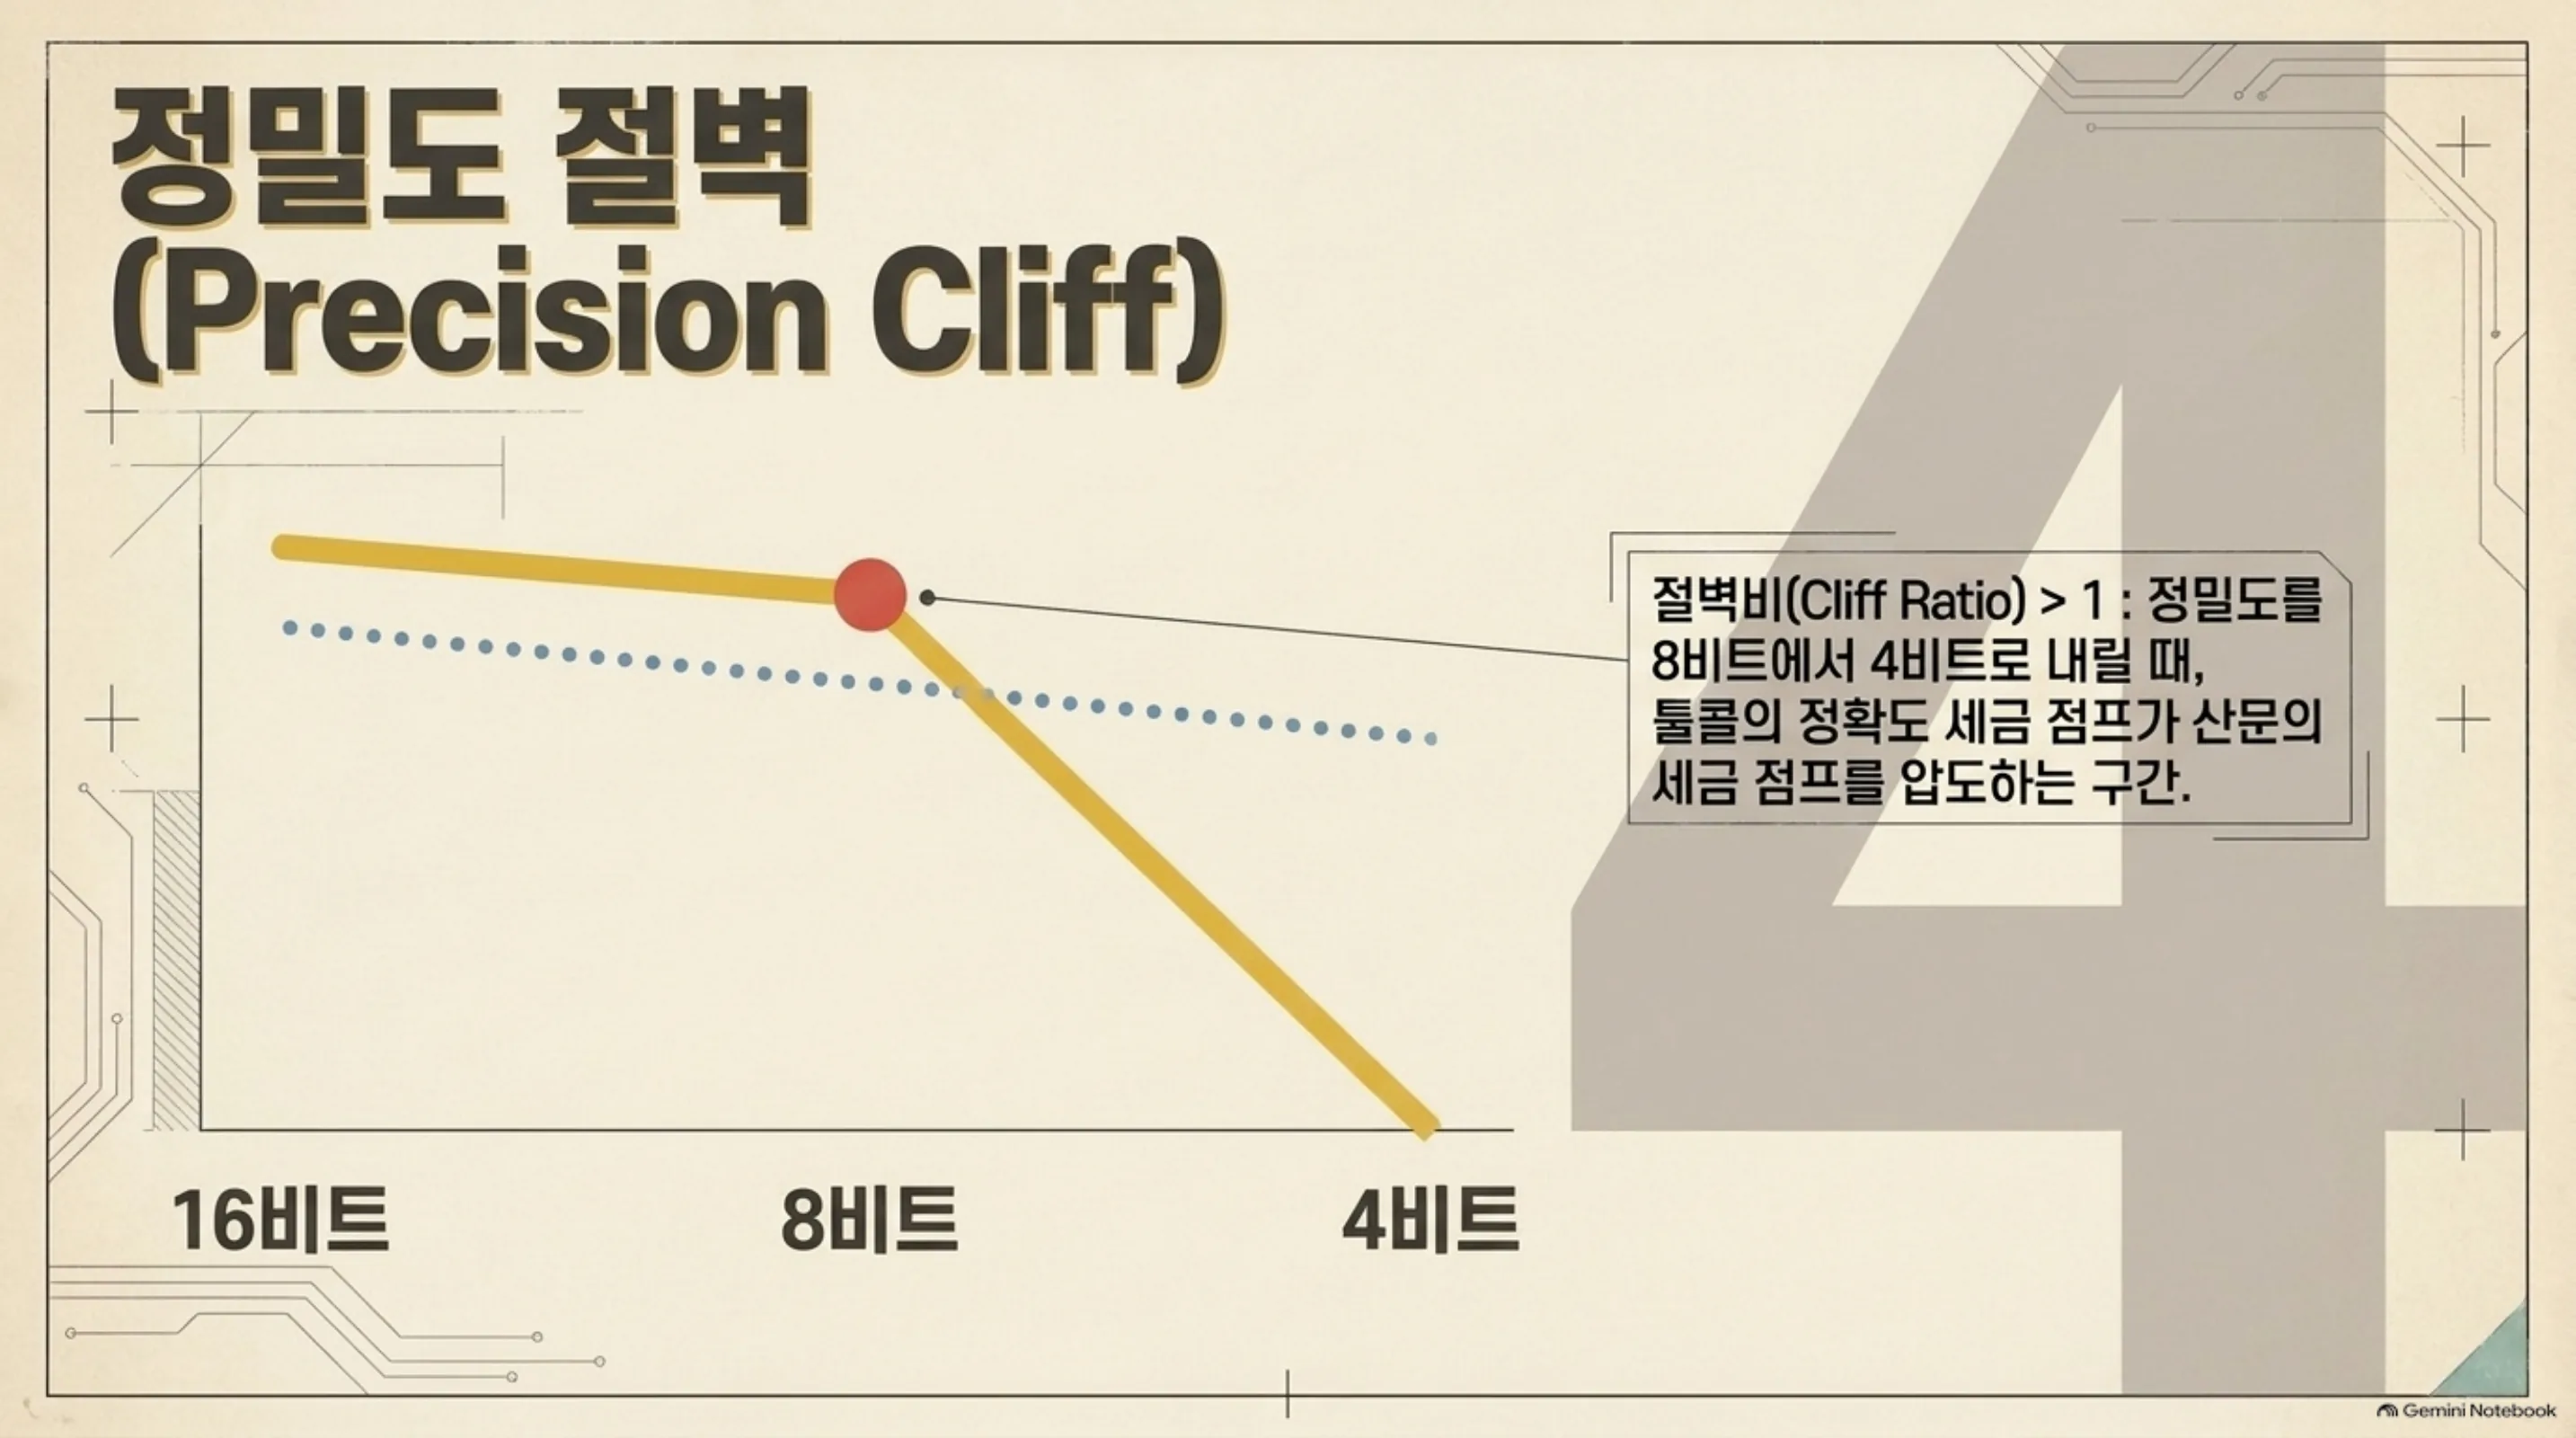
양자화 정밀도를 낮추면 토큰 단위의 판단이 흔들립니다. 그런데 흔들림은 균등하지 않습니다. 구조를 지탱하는 토큰, 즉 호출 경계와 함수 이름, 인자 값 위치는 원래 정답과 오답의 차이가 가장 얇은 곳에 몰려 있습니다. 그래서 정밀도를 8비트에서 4비트로 내리면 산문의 오자는 오자 수준으로 남고 계좌번호 한 자의 오기가 송금 실패로 바뀌는 지점이 생깁니다. 이 논문이 그 지점을 정밀도 절벽(precision cliff)이라고 부릅니다.
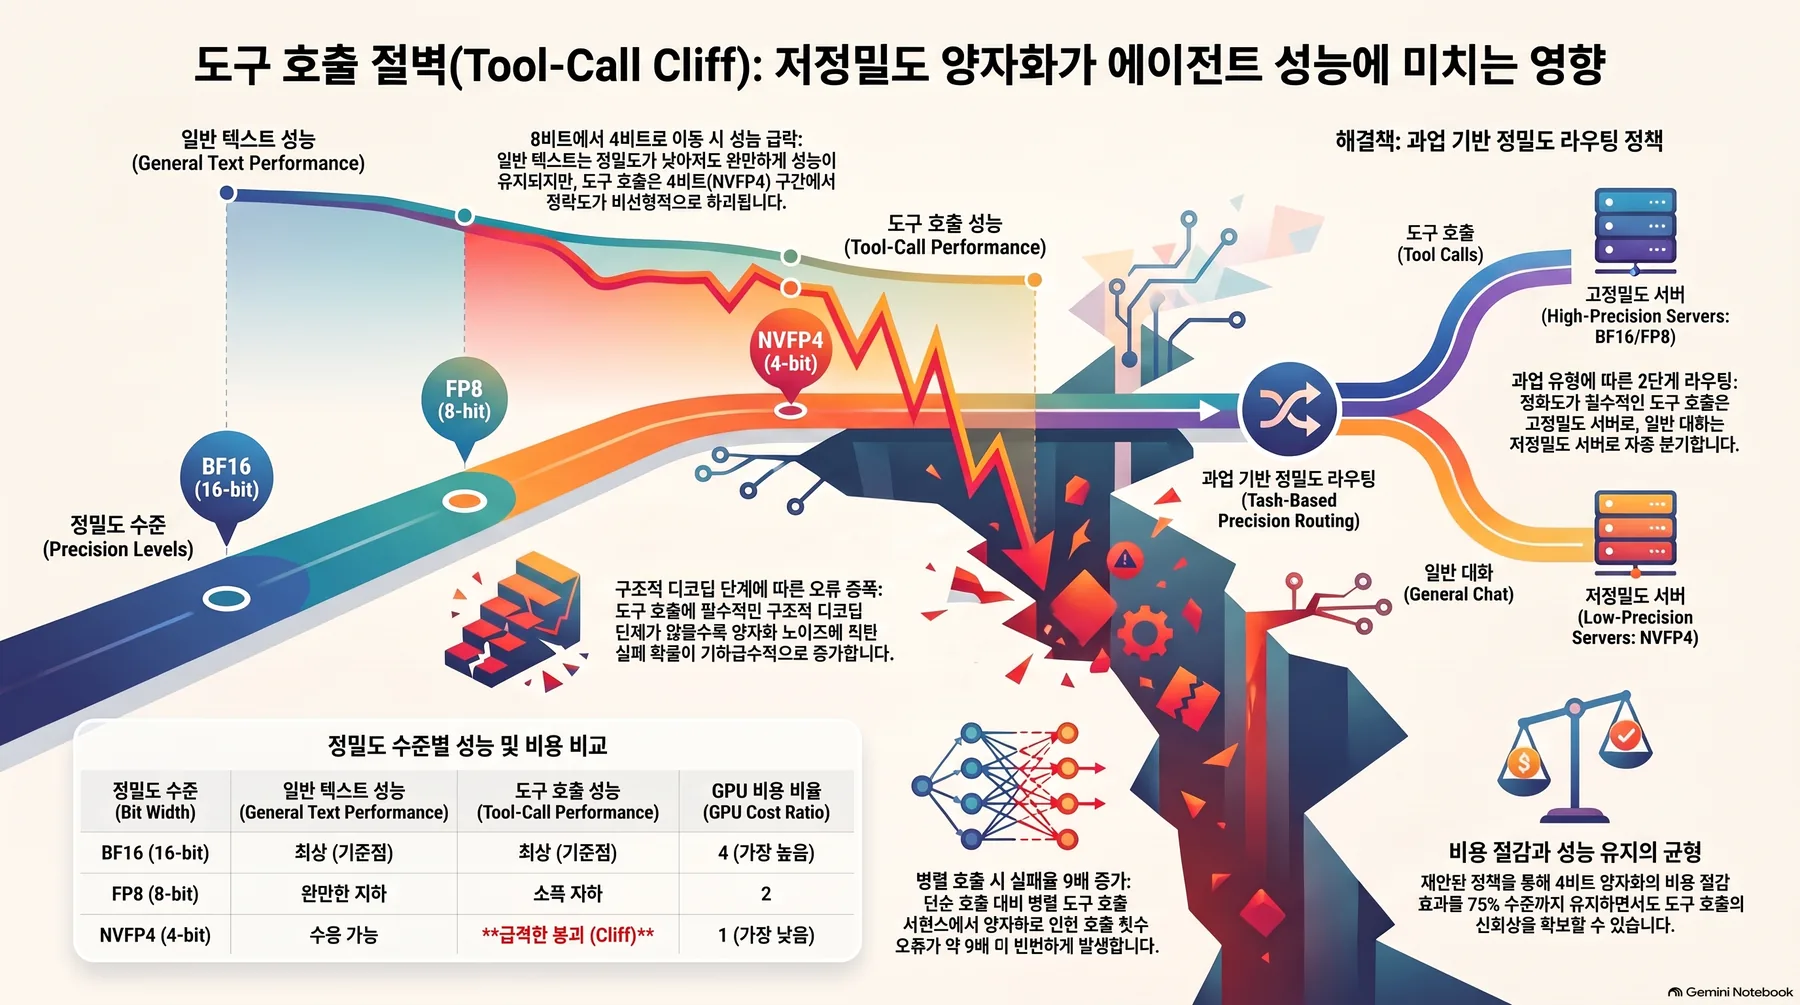 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
4비트가 안전한지 답할 근거가 없는 이유
서빙 비용을 줄이는 첫 손은 정밀도입니다. 무인 에이전트는 한 요청씩 들어오는 배치 1 레짐에서 돕니다. 이 레짐에서는 토큰 하나를 뿜을 때마다 가중치 전체를 한 번 읽기 때문에 케이스당 GPU 초는 가중치 바이트 수에 거의 비례합니다. GPU를 한 장 더 사기 전에 엔지니어가 먼저 당기는 고리가 정밀도입니다.
그런데 이 질문에 답할 근거는 아직 perplexity(모델의 문장 예측 오류)와 산문 정확도뿐입니다. 압축 벤치마크는 에이전트 능력을 범위 밖으로 두고, 가장 가까운 외부 실측도 16/8/4비트에서 표준 성공 점수가 평탄하다는 것까지만 보여 줍니다. 전체 점수가 안 움직이면 무손실처럼 보이지만 어떤 요청이 깨졌는지는 답이 없습니다. 툴콜 요청과 자유 산문은 따로 재어지지 않았고 저정밀도가 추론 토큰 부풀림이라는 숨은 비용을 정확도 열에 숨길 수 있다는 보고도 있습니다.
세 가지가 빠져 있습니다. 툴콜 조각이 정밀도를 낮출 때 어떻게 깨지는가, 어느 경계에서 깨지는가, 그 손실이 밴드폭 절약보다 비싼가? 이 세 질문에 답할 통제 실험은 아직 없습니다. 이 논문은 세 질문을 하나의 정의 아래로 모으는 것입니다.
절벽을 재는 정의 두 개와 증폭 메커니즘
논문의 첫 번째 기여는 절벽을 재는 정의 두 개입니다. 조건은 한 점에 고정됩니다. 같은 dense 체크포인트를 세 단계의 정밀도로 재코딩하고 H200 하나에 thinking 모드를 끈 채 temperature 0으로 서빙하는 것입니다. 모델 규모는 27B dense한 것입니다.
첫 번째 정의는 정확도 세금(accuracy tax)인 셈입니다. 16비트를 기준선으로 놓고 각 정밀도 단계가 카테고리당 통과율을 얼마나 깎는지로 씁니다. 두 번째 정의는 절벽비(cliff ratio)입니다. 툴콜의 세금을 자유 산문의 세금으로 나눈 값이기도 합니다. 절벽비가 1을 넘으면 같은 정밀도에서 툴콜 조각이 산문보다 빨리 깨진다는 뜻입니다. 정밀도 절벽이 존재한다는 주장을 숫자로 주는 지점이 바로 여기입니다.
세금이 구조적 호출 쪽에 집중되는 이유는 구조 디코드 단계에 있는 것입니다. 툴콜에는 반드시 지켜야 할 구조 단계가 있습니다. 호출 경계, 함수 이름, 호출 개수, 인자 값 위치입니다. 정리 전제의 핵심은, 바로 그 단계가 원래 정답과 오답의 마진이 가장 얇은 곳이라는 것입니다. 양자화 노이즈가 토큰 단위의 로짓을 흔들면 마진이 얇은 곳부터 판단이 뒤집히고 구조 단계 한 곳의 뒤집힘은 케이스 전체를 실패로 만드는 것입니다.
그래서 케이스 실패 확률은 구조 단계의 수에 비례해 증폭됩니다. 호출이 여러 개인 병렬 카테고리에서 벌어짐이 가장 큽니다. 형식화는 여기서 예측 두 개를 남깁니다.
첫 번째 예측은 카테고리별 실패 구성의 변화라는 뜻입니다. 단순 호출은 인자 값 오류가 압도적이고 병렬 호출은 호출 개수 오류가 눈에 띄게 늘어난다는 것입니다. 두 번째 예측은 절벽의 위치입니다. 노이즈 분산이 한 단계 내려갈 때마다 네 배씩 커지므로 절벽은 4비트 단계에 서고 8에서 4로 넘어가는 세금 점프는 그 위쪽 점프보다 훨씬 크다는 것입니다.
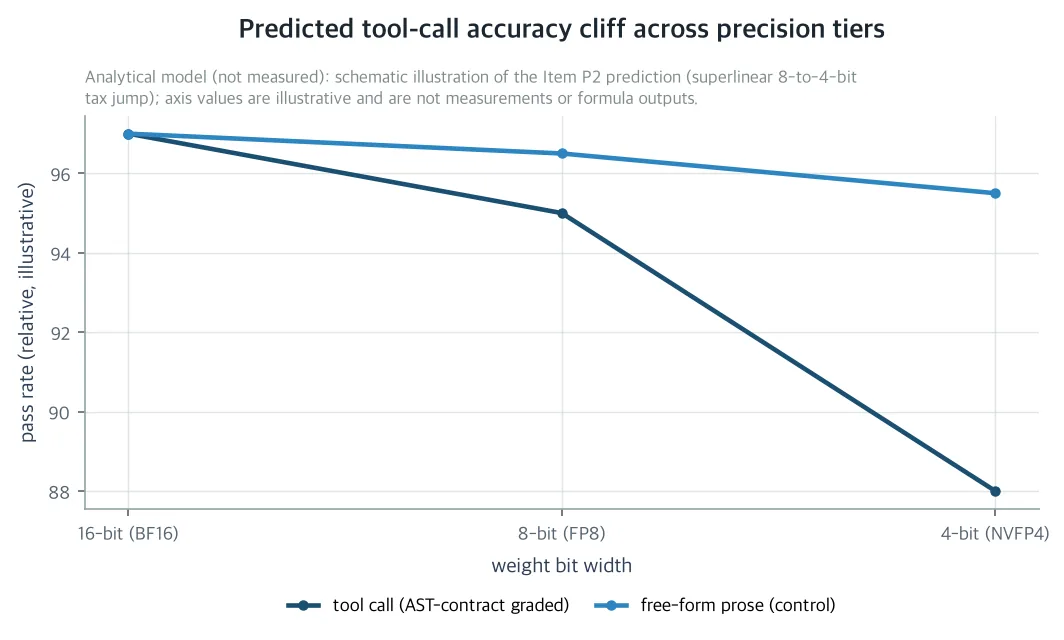 정밀도 절벽의 예측 모양 개념도. 툴콜 곡선은 8비트에서 4비트로 가며 가파르게 떨어지고 자유 산문 제원은 완만하게 줄어듭니다. 분석 모델의 예시이며 실측이 아닙니다.
형식화만으로 끝나지 않습니다. 이미 손에 있는 실측 한 점으로 예측을 맞춥니다. 이쪽 4비트(NVFP4) 체크포인트의 툴콜 평가 800건이 있고 전체 정확도는 89.6%입니다.
카테고리별 통과율과 실패 구성은 아래 표와 같습니다. 이 한 점에서 예측된 실패 구성이 실제로 보입니다.
| 카테고리 | 사례 수 | 통과율 | 주 실패 모드 |
|---|---|---|---|
| 단순 | 400 | 90.8% | 인자 값 불일치(실패 37건 중 35건) |
| 다중 | 200 | 89.0% | 혼합(인자 값 16, 호출 개수 4, 함수 이름 2) |
| 병렬 | 200 | 88.0% | 인자 값(14) + 호출 개수(9) |
| 전체 | 800 | 89.6% |
실패 구성도 예측대로인 셈입니다. 단순 카테고리 실패는 대부분 인자 값 불일치이고 병렬 카테고리 실패에는 호출 개수 오류가 크게 섞입니다. 단순에서 드물던 호출 개수 오류가 병렬에서 9배로 늘어나는 것, 예측이 말하던 구성 변화의 모습입니다.
남은 일은 이 한 점을 곡선으로 완성하는 것입니다. 16비트와 8비트, 그리고 자유 산문 제어를 같은 조건에서 재야 절벽비의 곡선이 완성됩니다. 다음 절에서는 이 곡선이 비용과 만나면 어떤 운영 규칙을 남기는지 보는 것입니다.
절벽의 가격: 손익분기와 운영 규칙
절벽이 있다는 말과 절벽의 가격이 있다는 말은 다릅니다. 이 논문은 절벽을 돈으로 환산하는 것입니다. 비용 축부터 갑니다.
배치 1 디코드는 가중치 읽기에 묶여 있습니다. 그래서 케이스당 GPU 초는 이상적으로 비트 수에 비례하기도 합니다. 16비트 대비 8비트는 절반, 4비트는 네분의 일입니다.
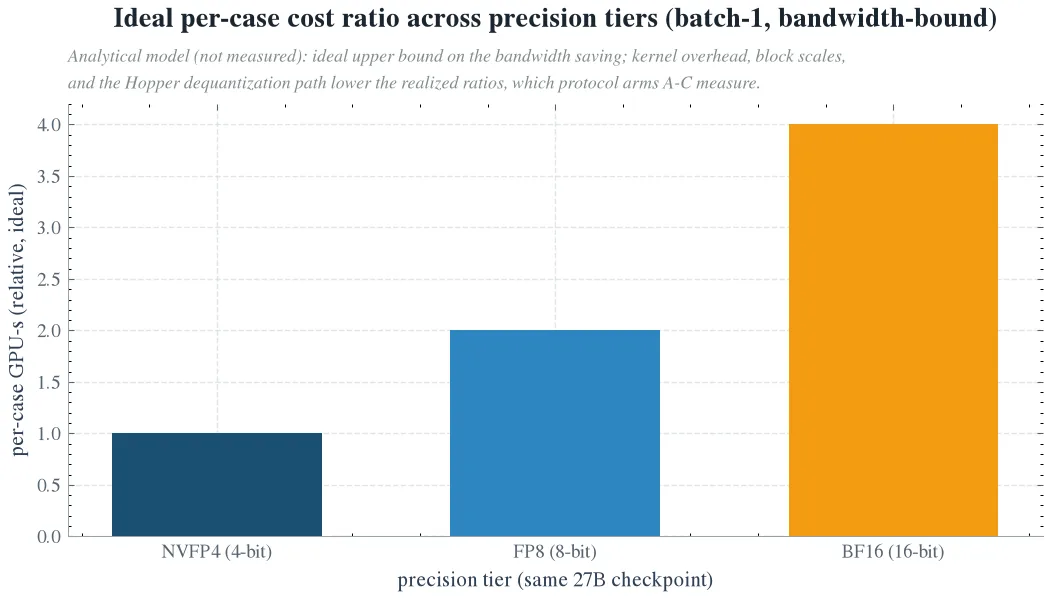 디코드에 묶인 배치 1 레짐에서 케이스당 GPU 초가 비트 수에 비례하는 개념도. NVFP4, FP8, BF16 재코딩의 이상적 비용은 1:2:4가 됩니다. 분석 모델의 예시이며 실측이 아닙니다.
이 비율은 이상적인 상한인 셈입니다. 커널 오버헤드와 디양자화 경로를 지나면 실제로는 좁아지고 결정에는 실측 값을 넣습니다. 가치는 비대칭이기 때문입니다. 틀린 호출은 워크플로를 멈추고 재시도와 사용자에게 보이는 실패를 남기지만 산문의 한 문장 오류는 그 문장 안에서 흡수됩니다.
그래서 손익분기 조건은 한 줄로 줄어듭니다. 저정밀도로 호출을 돌리는 밴드폭 절약이 정확도 세금에 가치를 붙인 것을 넘어야 플릿 전체를 저정밀도로 통일하는 것이 최적이고 넘지 못하면 호출만 한 단계 높은 정밀도로 올리는 2티어 정책이 이깁니다. 이 부등식 덕분에 상시 결정은 측정 값 두 개, 4비트 호출 세금과 실측 비용 비율,으로 줄어듭니다.
이쪽 트래픽은 10건 중 7건이 호출인가? 아래 표는 이 비용 비율로 세 정책을 비교한 것입니다. 절벽이 있어도 바닥선은 나쁘지 않고 절벽이 없으면 정밀도 논쟁이 청구서에서 사라집니다. 즉, 사람 말로는 어떤 경우에도 전부 16비트로 돌아갈 필요는 없다는 뜻입니다.
| 정책 | 호출 | 산문 | 16비트 대비 절감 |
|---|---|---|---|
| 통일 4비트 | 4비트 | 4비트 | 75% |
| 2티어 | 8비트 | 4비트 | 56% |
| 바닥선 | 16비트 | 4비트 | 19% |
2티어 정책은 말하자면 계좌번호만 정밀하게 쓰고 용도란은 대강 쓰는 것과 같습니다. 운영 규칙은 세 개입니다. 4비트 호출 세금을 산문 세금 대비 2pp 이내로 재면 플릿 전체를 4비트로 통일합니다. 분류기도 라우팅도 필요 없는 가장 단순한 답입니다.
절벽이 확인되면 태스크 유형으로 라우팅합니다. 요청에 이미 있는 needs_tools 플래그가 그 좌표이기 때문입니다. 어느 규칙이든 호출 조각에는 안전망을 씌웁니다. 호출을 계약으로 검증하고 실패하면 한 번만 상위 정밀도로 재시도합니다. 실패가 10건 중 1건 수준이라 이 재시도의 비용은 거의 들지 않습니다.
규칙을 판정할 실험도 함께 정의되어 있습니다. 16, 8, 4비트 호출과 자유 산문 제어를 같은 케이스 위에서 짝지어 재는 4분할 설계입니다. 각 분할이 어떤 가설을 반증하는지 기준 R1부터 R4까지 미리 정해둡니다. 절벽의 유무, 세금의 단조성, 실패 구성, 손익분기 판정, 네 가지입니다. 기준에 부딪히면 결론도 함께 무너지는 구조, 이것이 이 논문의 설계인 셈입니다.
이 글이 회사에 남기는 것은 토큰 팩토리의 상시 결정입니다. 무인 에이전트 워크로드를 4비트로 돌릴지, 호출 요청에 정확도 세금을 붙여 2티어로 라우팅할지를 측정 값 두 개로 답합니다. 사회적으로는 24시간 도는 자율 에이전트의 컴퓨트와 에너지 비용을 줄입니다.
저정밀도가 안전한 워크로드 유형을 특정하는 일은, 늘 도는 에이전트를 소규모 팀도 감당할 수 있게 하는 일입니다. 과학적으로는 같은 모델 규모에서 태스크 유형과 정밀도의 상호작용을 통제 실험으로 재는 첫 시도를 남깁니다. 난이도 기반 정밀도 라우팅이 놓치던 호출 절벽 곡선을 공개하고 thinking 토큰 축과 리트리버 축과 나란히 세 축의 가격을 같은 토큰 팩토리에서 완성하는 것입니다.
못 믿을 부분
이 논문은 분석 논문임을 자인합니다. 본문에 실측으로 들어오는 숫자는 4비트 기준선 한 줄뿐입니다. 절벽의 곡선과 초선형 점프는 아직 예측이고 4분할 설계가 그 여부를 판정합니다.
첫째, 모델은 27B dense 한 가족뿐입니다. 크기와 모델 가족을 건너 비교하는 곡선은 남아 있는 일입니다. 둘째, H200의 4비트는 저장과 밴드폭의 이야기입니다.
가중치를 읽는 쪽은 4비트이지만 계산은 16비트로 되돌려 돕니다. 그래서 실측 비용은 네이티브 4비트 하드웨어의 보수적인 상한이 됩니다. 정확도 기준은 계산 경로에 무관하지만 손익분기 마진은 Blackwell에서 재측정해야 합니다.
셋째, 채점기는 이쪽의 계약 검사이지 공식 벤치마크 체크어가 아닙니다. 티어 간 상대 비교는 유효하고 리더보드의 절대 점수 주장은 범위 밖입니다. 넷째, 결정적 디코딩만 다룹니다.
무작위 디코딩에서 절벽이 남는지는 열린 문제입니다. 다섯째, 툴콜 비중 70%도 이쪽 트래픽의 통계입니다. 비중이 다른 플릿은 손익분기를 다시 계산해야 합니다.
여섯째, 모든 티어가 사후 양자화(PTQ)입니다. 학습 중에 정밀도를 낮추는 QAT의 4비트는 절벽을 없애지 않고 움직입니다. 배치 1 레짐도 고정이고 배치 효과와 prefill 감사는 비용을 바꿉니다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Tool-Call Cliff: Measuring the Accuracy Decay of Agentic Structured Output Under Low-Bit Quantization in Self-Hosted H200 Serving
이 글의 두 장은 전부 분석 모델의 개념도이며 실측이 아닙니다. 실측으로 들어가는 숫자는 4비트 기준선(800건, 전체 89.6%)뿐입니다.
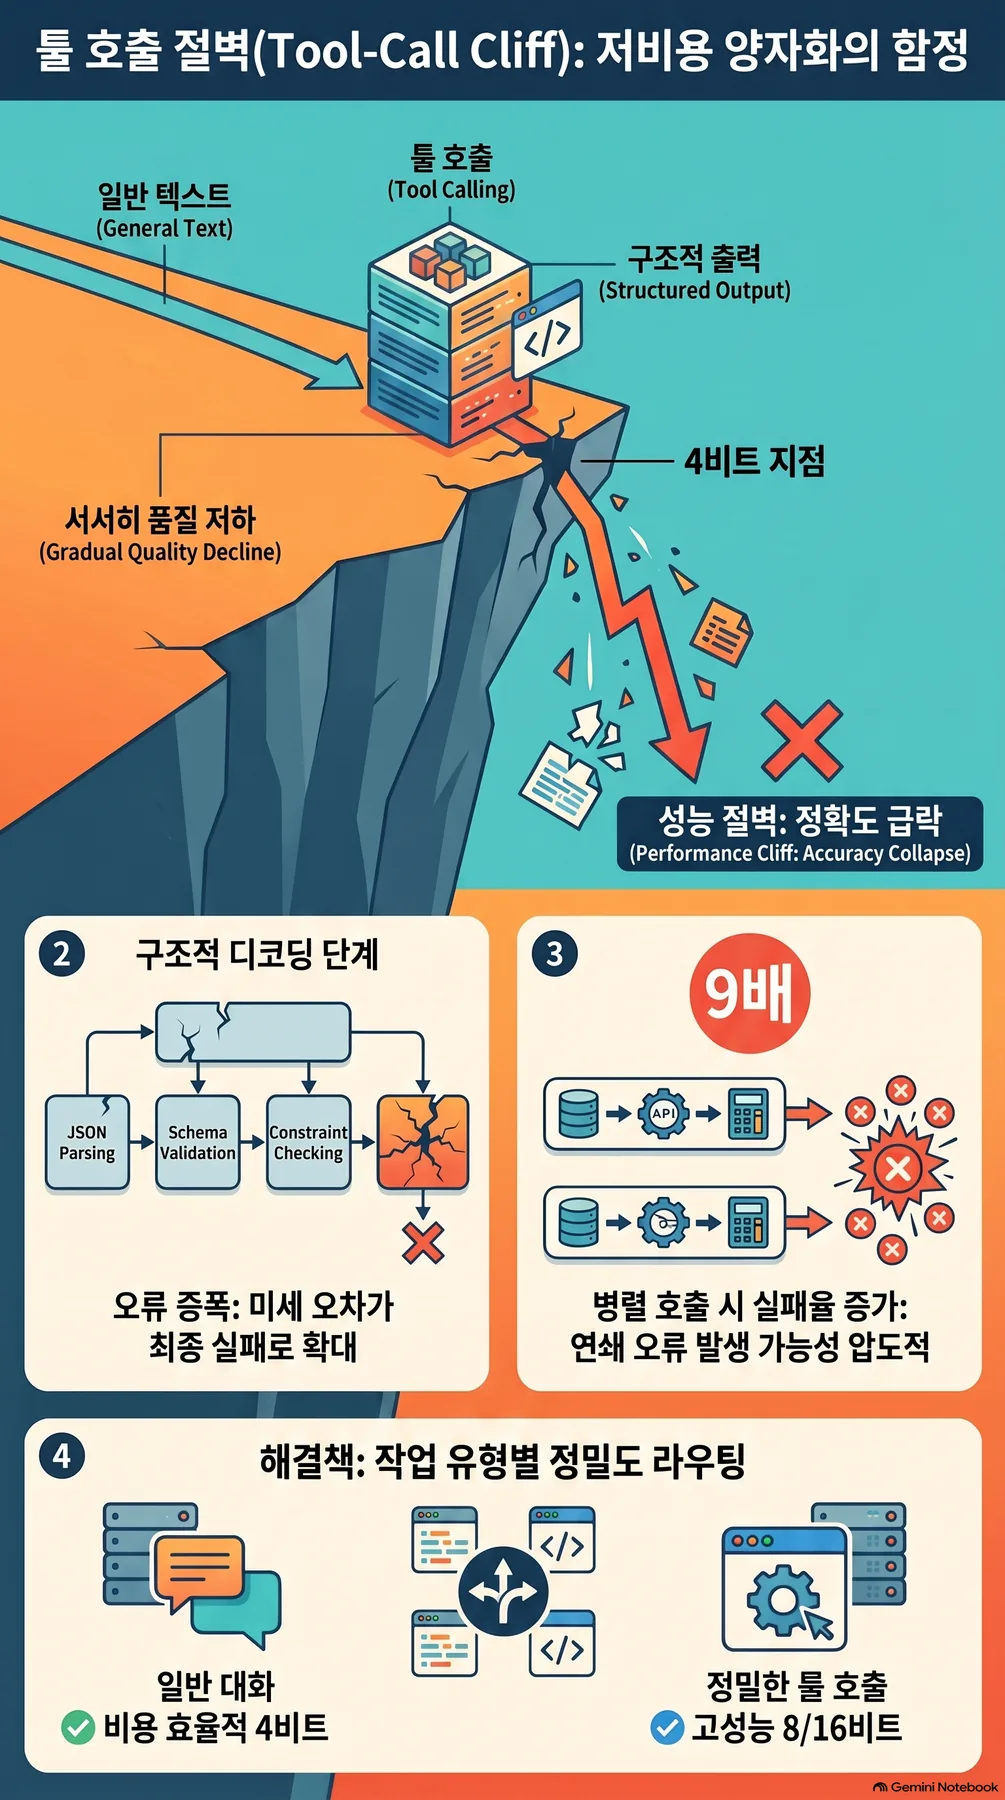 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.