KO-VoicePersona-E4B: 짧게 말하고 도구로 확인하는 한국어 음성 페르소나 모델
한국어 음성 비서나 마스코트를 만드는 팀을 위한 글입니다. 이 글은 짧게 말하는 한국어 음성 페르소나 모델을 소개합니다. 모델은 90자 이내의 말하기 좋은 한국어로 답하고, 모르는 사실은 지어내지 않고 도구를 부르며, 사람이 직접 쓴 독립 평가 58개 대화에서 도구 호출 정확도 0.78과 페르소나 유지 0.88을 냈습니다. 답변은 한두 문장, 숫자와 영어는 소리 나는 대로 풀어 쓰는 규칙도 지킵니다. 다만 답변의 36%는 같은 상투 문구를 반복하고, 실제 음성 인식과 합성 루프는 아직 평가하지 못했습니다. 한계도 함께 적습니다.
 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
라디오 쇼 진행자를 생각해 보겠습니다. 진행자는 질문마다 길게 이야기하지 않고 한두 마디로 답합니다. 방송 중 모르는 숫자나 사실은 지어내지 않고 스튜디오의 프로듀서에게 확인한 뒤 그 답만 말합니다. 그리고 쇼가 정해둔 말투를 처음부터 끝까지 유지합니다.
이 모델은 그런 진행자를 소프트웨어로 옮긴 것입니다. 90자 이내의 짧은 답이 쇼의 말투이고, lookup 같은 도구가 프로듀서이며, 독립 평가 수치는 진행 능력을 점수화한 것입니다. 즉, 사람 말로는 이 모델은 길게 떠들지 않고, 모르면 확인하고, 말투를 지켜 말하는 진행자입니다. 이름은 KO-VoicePersona-E4B이며, 뒤에서 소개할 Nemotron 3.5 Bolt E4B 본체 위에 얇은 어댑터를 학습한 모델입니다.
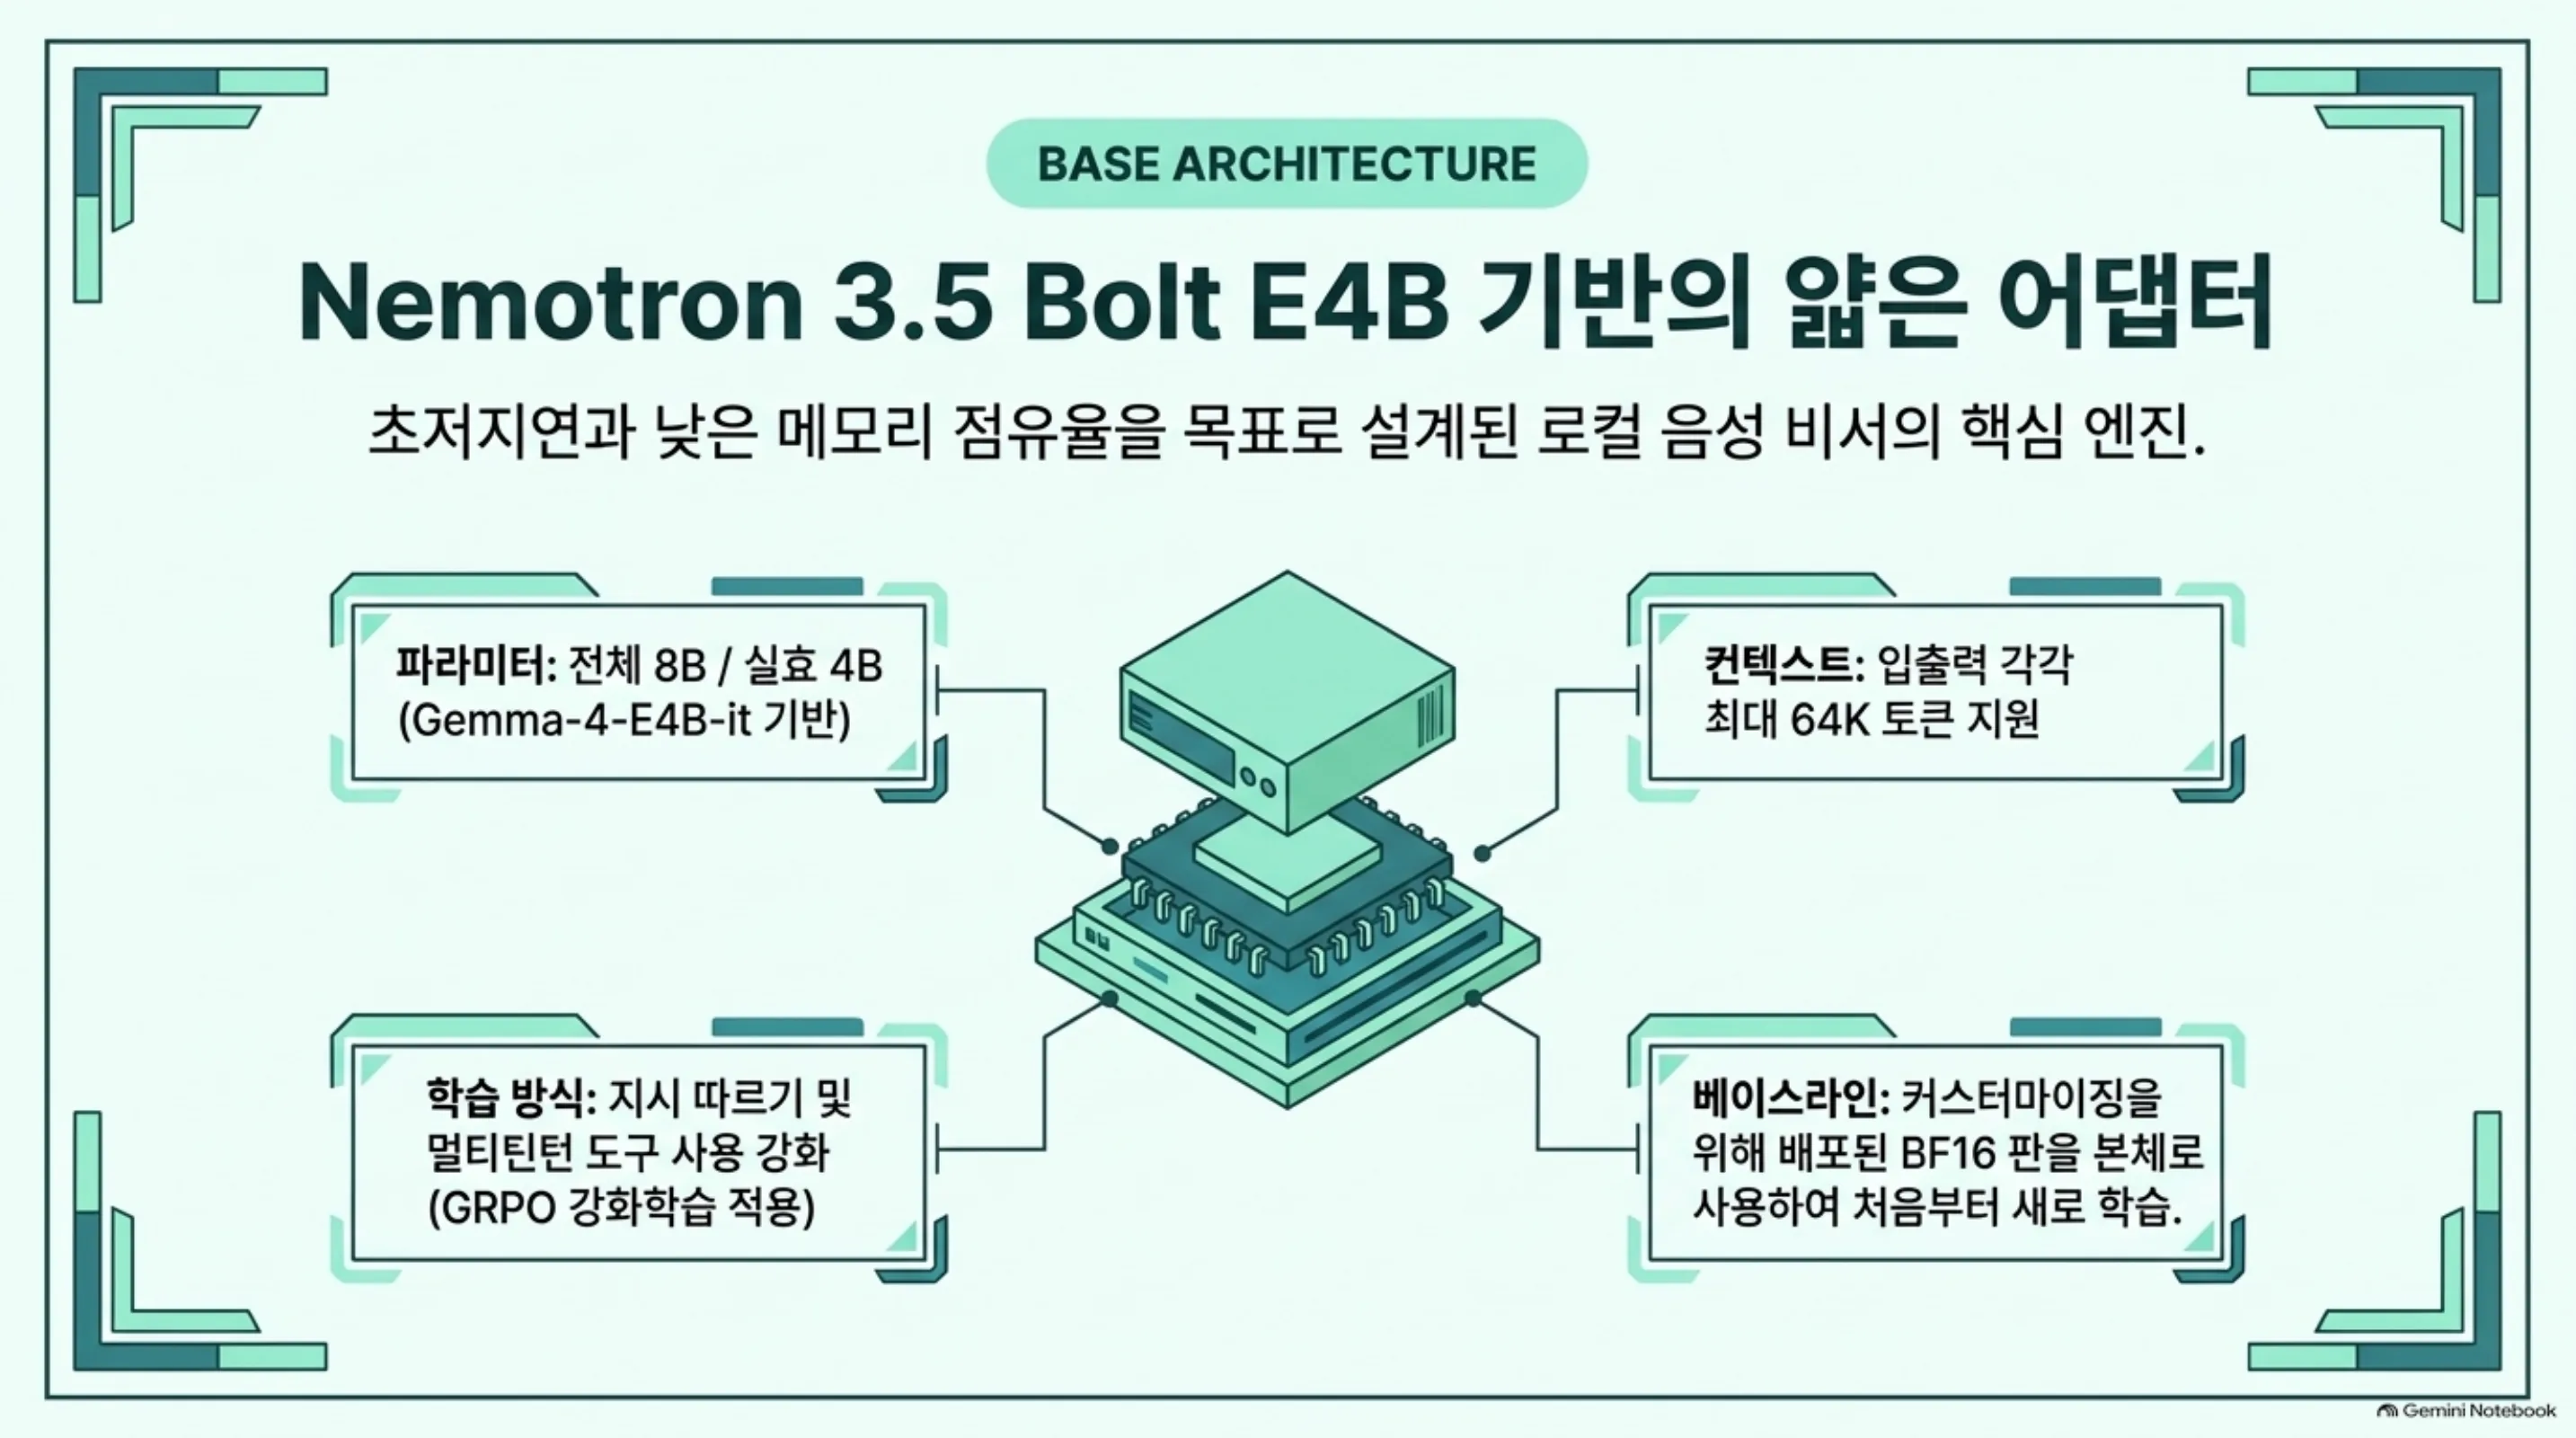
Nemotron 3.5 Bolt E4B는 어떤 모델인가
Bolt E4B는 NVIDIA가 Gemma-4-E4B-it을 기반으로 추가 post-training한 소형 언어 모델입니다. 전체 파라미터 8B, 실효 4B이고 입출력 각각 최대 64K 토큰을 지원합니다. 멀티턴 도구 사용, 지시 따르기, 입력 근거 유지를 강화했고, 강화학습은 GRPO로 진행했다고 밝힙니다. 낮은 메모리와 낮은 첫 토큰 지연이 목표라 로컬 비서나 엣지 장비에 맞습니다. 라이선스는 OpenMDW-1.1이며 Q4_K_M 4GB 판이 따로 공개되어 있습니다. BF16 판은 커스터마이징용 배포본이라 저희는 이 판을 본체로 썼습니다.
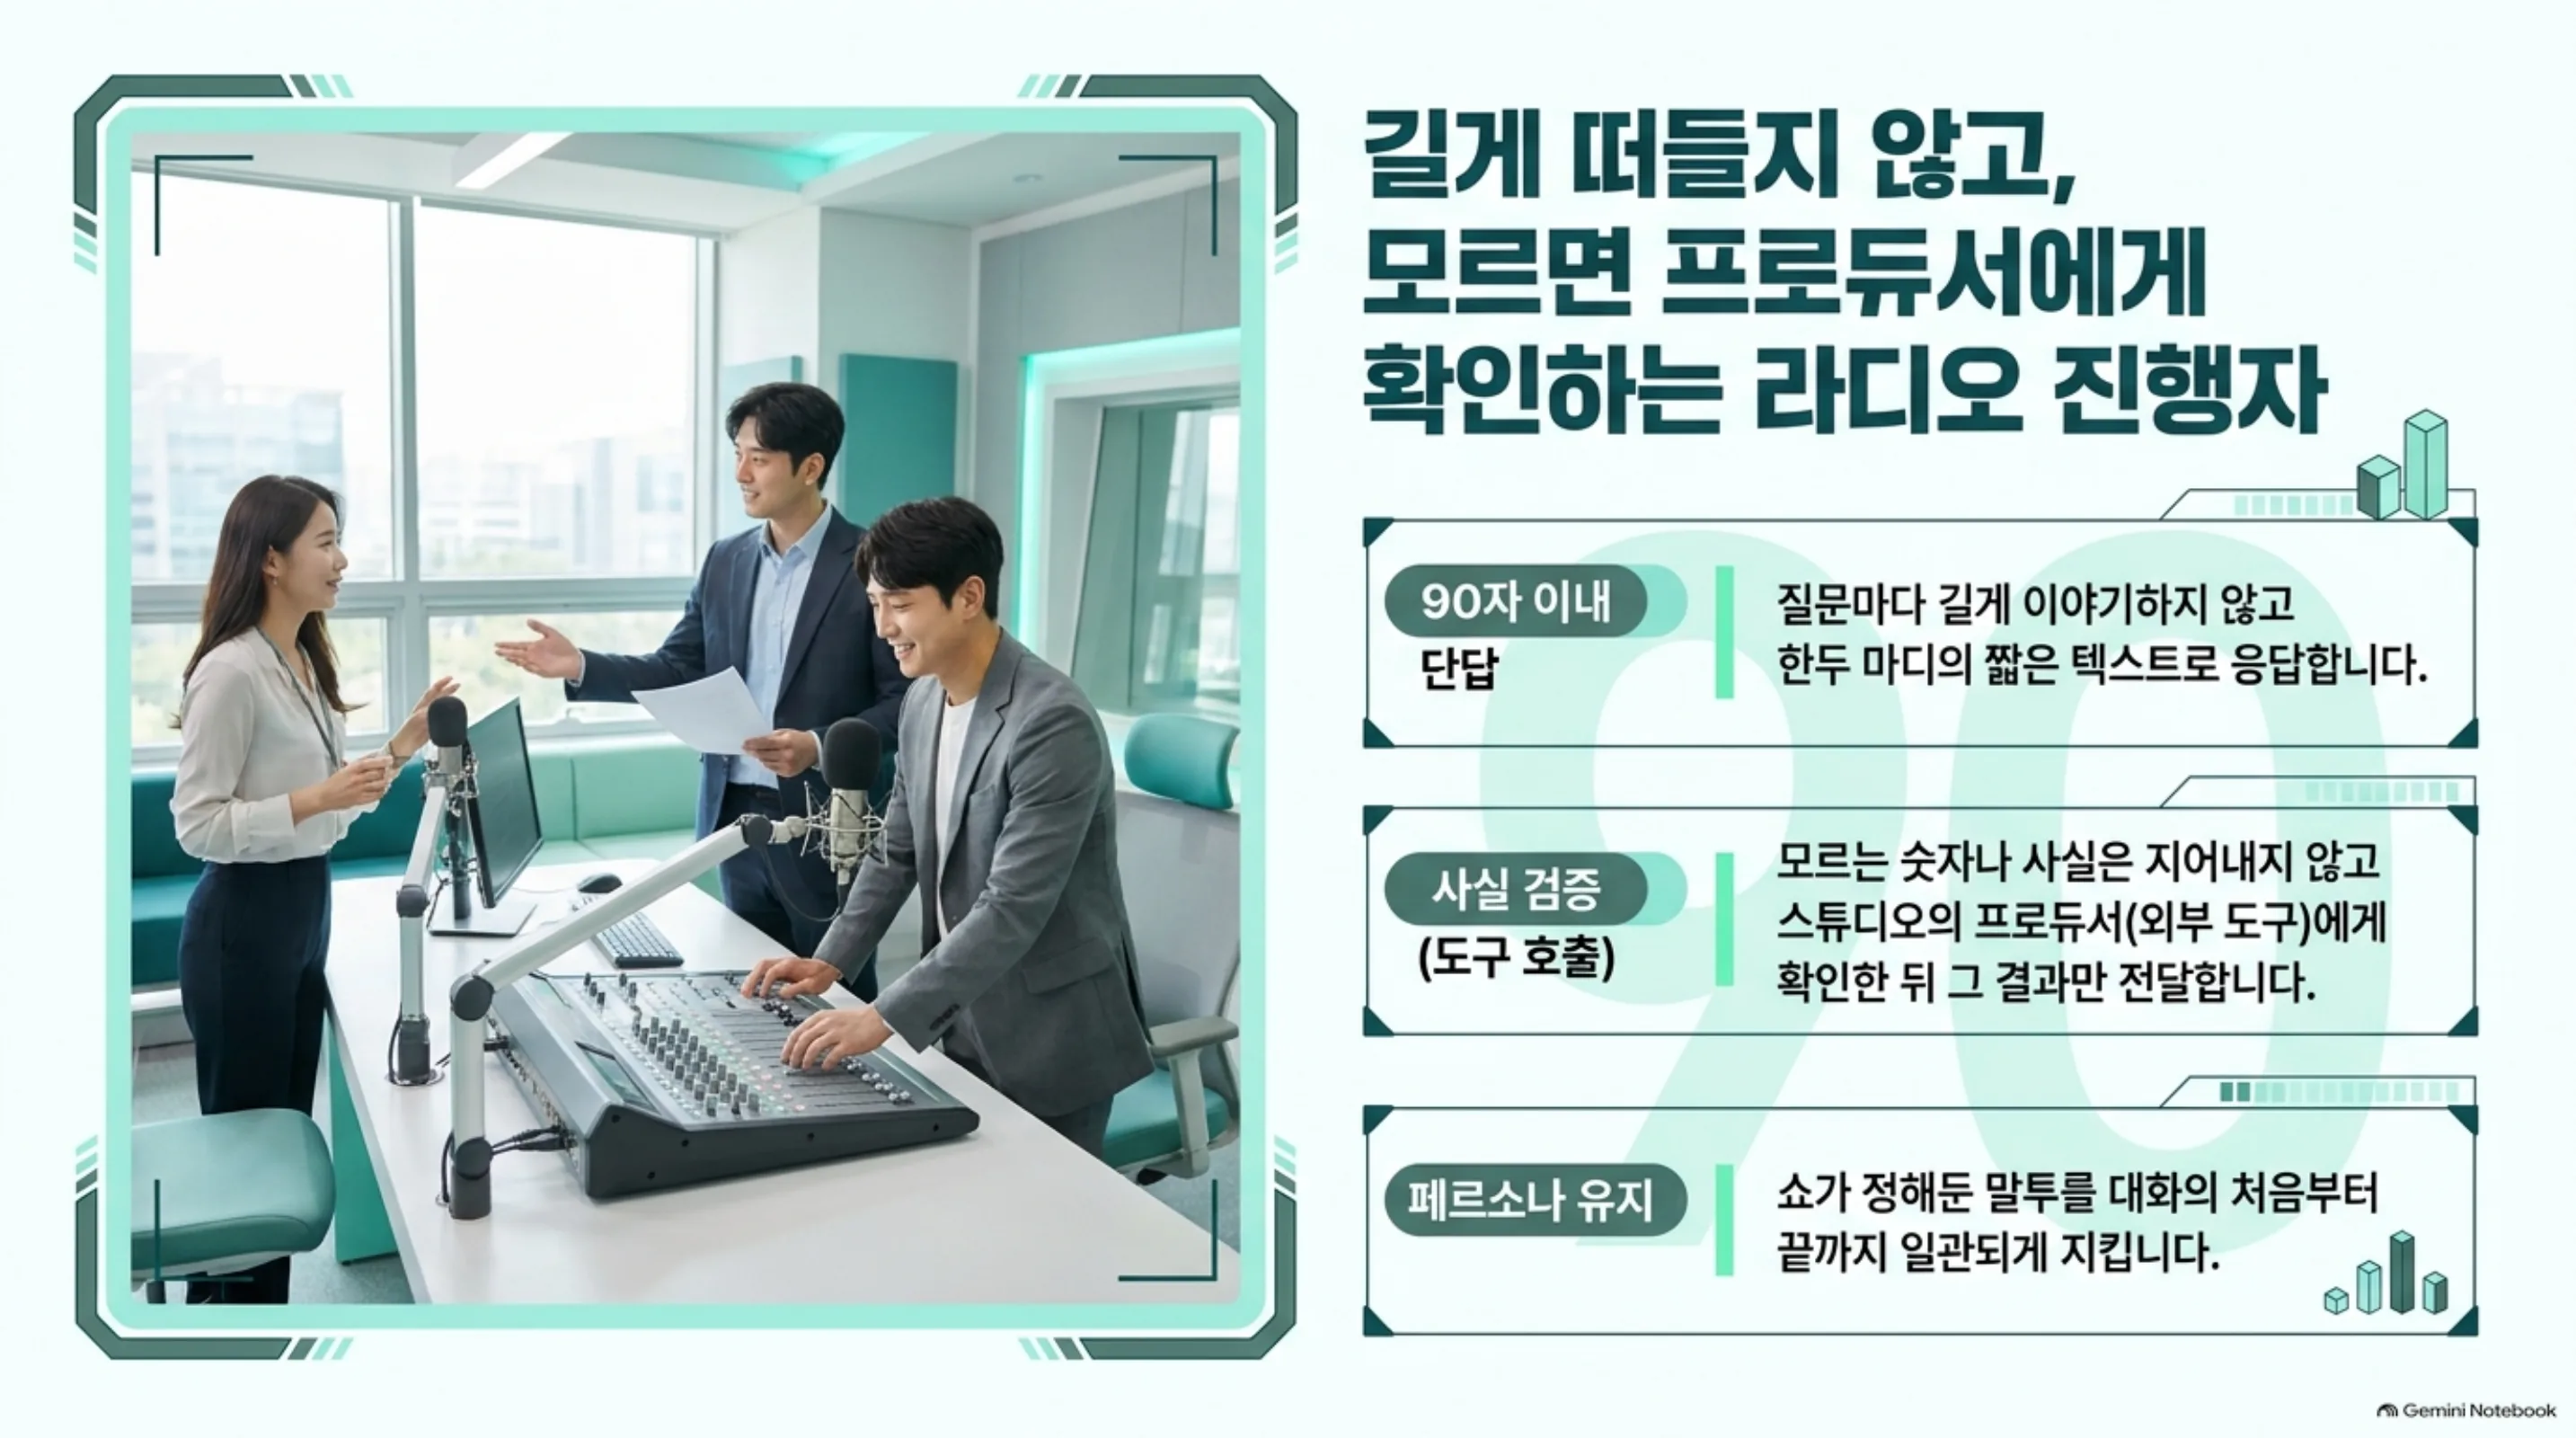
무엇을 하는 모델인가
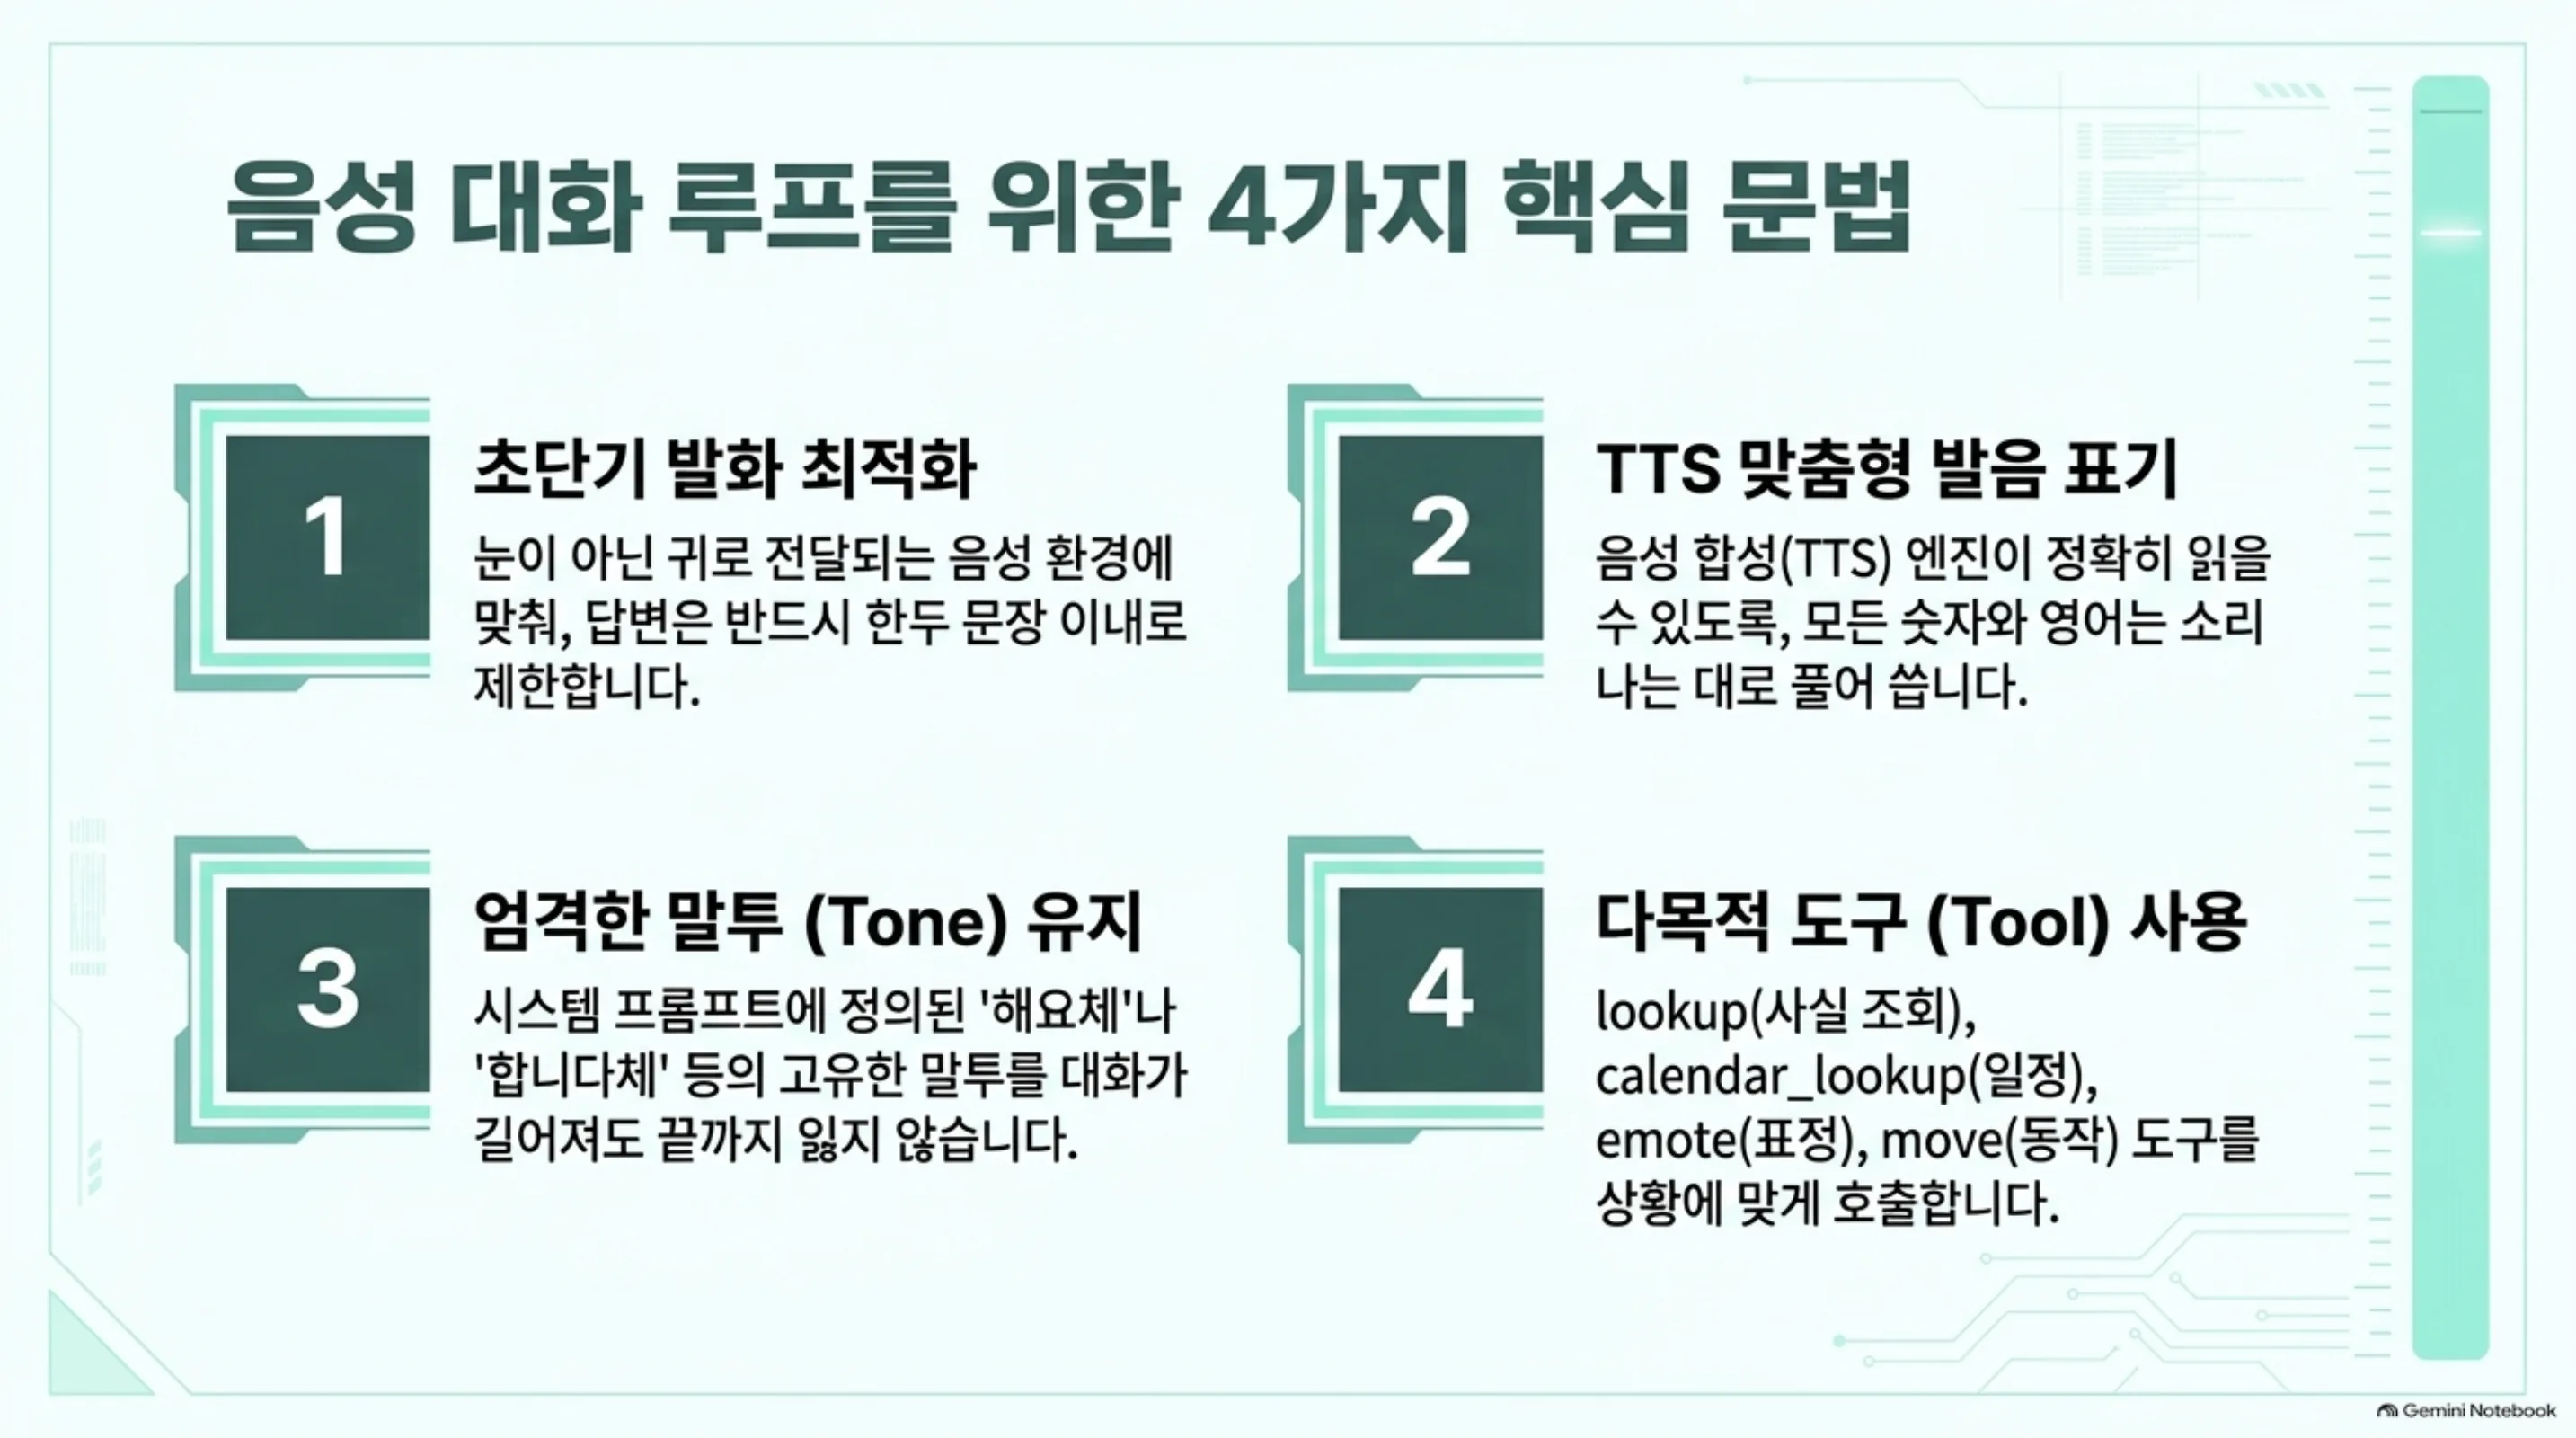
음성 대화에서 답변은 눈이 아니라 귀로 전달됩니다. 이 모델은 한두 문장, 90자 이내로 말하고, 숫자와 영어는 TTS가 읽을 수 있게 소리 나는 대로 풀어 씁니다. 시스템 프롬프트에 정한 말투(해요체나 합니다체)를 끝까지 지킵니다. 표정은 emote, 동작은 move, 사실 조회는 lookup, 일정은 calendar_lookup 도구로 처리하고, 도구 결과에 없는 시각이나 숫자는 찾지 못했다고 말합니다.
예를 들어 “오늘 날씨 어때?”라는 질문에 날씨를 아는 척하지 않고 lookup을 먼저 부릅니다. 결과가 돌아오면 그 내용만으로 짧게 말합니다.
어떻게 만들었나
 그림 1. 노란색 두 단계가 점수를 부풀리지 않게 막습니다. 라벨 생성과 누출 검사는 모델이 아니라 코드가 맡습니다.
학습 대화는 코드 규칙과 사내 교사 모델로 합성하고, 코드 검증기로 걸렀습니다. 결정론적 결함 검사에서 3인칭 자기 지칭과 어색한 회상 말투를 찾아냈습니다. 학습 데이터에서 이 결함이 123건 걸렸고, 이를 포함한 대화 141개를 버려서 0건으로 줄였습니다.
학습은 BF16 본체에서 처음부터 다시 시작했습니다. 앞선 v2는 이전 어댑터에서 이어 학습한 모델이라 상투 답변을 더 자주 반복했고, 그래서 v3.1은 이어 학습 없이 본체에서 새로 학습했습니다.
측정 결과
사람이 직접 쓴 독립 평가셋 58개 대화에서 본체, v2, v3.1을 같은 프롬프트로 비교했습니다. 큰 테스트셋의 도구 호출 정확도는 맨 아래 줄입니다.
| 평가 | Bolt 본체 | v2 | v3.1 |
|---|---|---|---|
| 도구 호출 정확도 (독립 58개) | 0.34 | 0.71 | 0.78 |
| 말투 유지 | 0.37 | 0.96 | 0.97 |
| 말하기 형식 | 0.42 | 0.96 | 0.97 |
| 페르소나 역할 유지 | 0.13 | 0.63 | 0.88 |
| 도구 호출 정확도 (큰 테스트셋) | 0.35 | 0.73 | 0.93 |
가장 크게 달라진 항목은 페르소나 역할 유지입니다. 본체는 0.13이라 대화가 길어지면 설정을 거의 잃었지만, v3.1은 0.88까지 올랐습니다. 배포용 Q4_K_M GGUF는 5.34GB이고 H100 한 장에서 단일 스트림 약 188 tok/s, GPU 메모리 3.8GB로 돌아갑니다. 정확도는 BF16과 같았습니다.
한계
- 답변의 36%가 반복되는 상투 문구입니다. 비교 기준(레퍼런스)은 28%였습니다.
- 독립 평가의 텍스트 103턴 중 1턴에서 근거 없는 사실을 지어냈습니다.
- 평가 대화는 사람이 쓴 글이지 실제 사용자의 음성이 아닙니다.
- 실제 ASR과 TTS를 붙인 루프는 평가하지 않았습니다. 인식 오류와 합성 품질이 만드는 문제는 이 수치에 들어 있지 않습니다.
도구 호출 정확도 0.78은 열 번 중 두세 번은 도구 이름이나 인자가 어긋난다는 뜻입니다. 라디오 비유로 치면 진행자가 프로듀서에게 확인해야 할 질문을 가끔 잘못 전달하는 습관이 남아 있다는 뜻이고, 그래서 도구를 실제로 실행하기 전에 바깥에서 검사하는 층이 필요합니다.
Paxis에서 쓰는 방식
Paxis는 기업 업무를 AI 에이전트로 자동화하는 ThakiCloud의 플랫폼입니다. 아래는 설계 방향이며 출시된 기능이 아닙니다. KO-VoicePersona-E4B는 ASR과 TTS 사이의 음성 페르소나 층으로 둡니다. 사용자의 말을 받아 짧은 답이나 도구 호출을 내놓습니다.
 그림 2. 모델은 제안하고 권한은 코드가 정합니다. 도구 호출은 Paxis 정책 검사를 통과해야 실행됩니다.
모델이 낸 도구 호출은 Paxis 정책이 먼저 확인하고, 통과한 것만 실행합니다. 사실과 시각은 도구 결과에서만 가져오고, 모델이 기억으로 채운 값은 말하지 않게 합니다. 상투 문구 반복이 거슬리는 서비스라면 최근 답변과 겹치는 문장을 코드로 걸러 다시 생성하는 방법도 쓸 수 있습니다.
모델 받기
- KO-VoicePersona-E4B: https://huggingface.co/ThakiCloud/KO-VoicePersona-E4B
- 컬렉션: https://huggingface.co/collections/ThakiCloud/thakicloud-bolt-e4b-specialists-6ade97db98b0258cb49447a0

