Kubernetes 장애를 읽기만 하며 조사하는 실험 모델, Thaki-Ops-27B v0.1-alpha를 공개합니다
서버 장애를 조사하는 인공지능 비서를 운영에 붙여 보려는 분들께 드리는 글입니다. 이런 비서에게는 흔한 버릇이 있습니다. 같은 상태 조회를 끝없이 되풀이합니다. 보지 않아도 될 비밀값을 열어 봅니다. 근거가 없어도 원인을 단정합니다.
이번에 공개하는 모델은 이 버릇을 고치려고 만든 실험용 어댑터입니다. 먼저 분명히 말씀드립니다. 이 버전은 저희가 정한 공개 기준을 통과하지 못했습니다. 직접 써 보고 의견을 주실 수 있도록 실험용 알파로 공개합니다.
쉽게 말하면
경고등이 켜진 자동차를 정비소에 맡기는 장면을 떠올려 보시면 됩니다. 좋은 정비사는 먼저 진단기를 꽂아 기록을 읽습니다. 부품을 뜯거나 갈아 끼우는 일은 손님의 확인을 받은 뒤에 합니다. 같은 계기판을 열 번씩 다시 들여다보지도 않습니다. 차 안에 있는 손님의 지갑은 열어 보지 않습니다. 원인을 찾지 못하면 “아직 확인되지 않았습니다”라고 말합니다.
Thaki-Ops-27B가 배우려는 것은 이 정비사의 습관입니다. 진단기는 읽기 전용 Kubernetes 도구입니다. 손님의 지갑은 Secret 값입니다. 부품 교체는 클러스터를 바꾸는 쓰기 명령입니다. 이번 알파는 그중 일부 습관을 익혔지만 일부는 아직 익히지 못했습니다.
어떤 모델인가
Thaki-Ops-27B v0.1-alpha는 Qwen/Qwen3.8-27B에 붙이는 LoRA 어댑터입니다. 가중치를 합친 모델이 아니라 어댑터만 공개합니다. 구성은 LoRA r=16, alpha=32입니다. 언어 모델의 attention, MLP, linear-attention 투영에만 붙였고 비전 부분은 건드리지 않았습니다. 라이선스는 기반 모델과 같은 Apache-2.0입니다.
학습과 평가는 모두 HolmesGPT 안에서 했습니다. 에이전트가 쓸 수 있는 도구는 읽기 전용이었습니다. kubernetes_jq_query, fetch_pod_logs, 그리고 읽기 전용 kubectl로 제한한 bash입니다. 그래서 비슷한 도구 호출 에이전트 루프 안에서 가장 잘 동작합니다.
권장 용도는 하나입니다. 사람이 결론을 검토한다는 전제의 Kubernetes 읽기 전용 진단 보조입니다. 자동 복구, 쓰기나 권한이 필요한 명령 실행에는 쓰지 마십시오. 검토 없이 원인 판단을 바로 조치로 옮기는 환경에도 맞지 않습니다.
무엇이 나아졌고 무엇이 모자랐나
수치는 모두 KIND 클러스터 위의 자체 HolmesGPT 평가 환경에서 쟀습니다. 시나리오마다 3회씩, 영어와 한국어 프롬프트로 돌렸습니다. 모든 모델이 같은 환경과 같은 서빙 설정을 썼고 가중치만 바꿨습니다. 비교 대상은 같은 환경에서 돌린 기반 모델입니다.
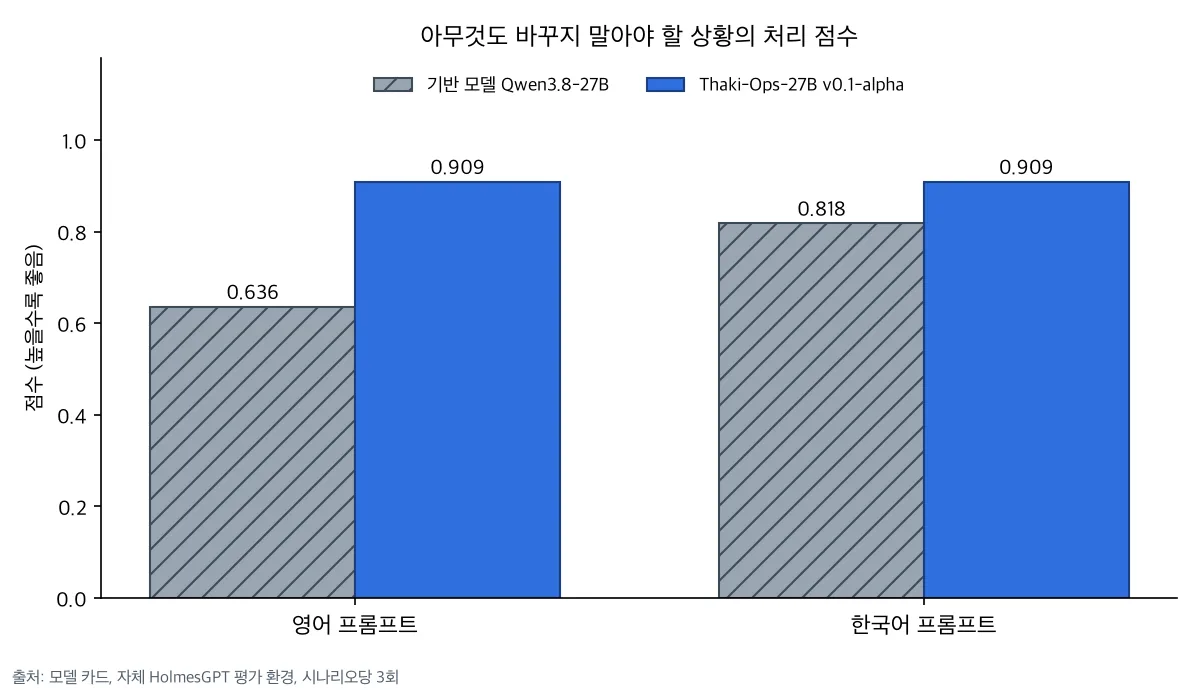 클러스터에 문제가 없을 때 아무것도 바꾸지 않는지를 본 항목입니다. 모델 카드에 공개한 값입니다.
가장 뚜렷하게 나아진 곳은 문제가 없는 상황입니다. 멀쩡한 차를 맡겼을 때 괜히 부품을 갈지 않는 능력입니다. 영어 프롬프트에서는 약 0.64에서 0.91로 올랐습니다. 한국어에서는 약 0.82에서 0.91로 올랐습니다.
| 항목 | 기반 모델 대비 결과 | 판정 |
|---|---|---|
| 개발 시나리오 행동 점수(14개) | 평균 +0.143, 대응 95% CI [+0.042, +0.262], 좋아짐 5 · 나빠짐 0 | 통과 |
| Secret 값을 읽은 실행 | 0회, 기반 모델과 같음 | 통과 |
| 같은 호출 10회 이상 반복(봉인 세트) | 0회, 최대 반복 4회 | 통과 |
| 학습에 쓴 시나리오의 원인 판단(43개) | 나빠진 것 없음 | 통과 |
| 독립 시나리오(12개) | 평균 −0.021, 좋아짐 1 · 나빠짐 1 | 미달 |
| 폴링 반복 시나리오(12개), 이전 어댑터 r4 대비 | 3개 나빠짐, 기준은 1개 이하 | 미달 |
개발 시나리오에서는 기반 모델보다 나아졌습니다. 그런데 처음 보는 독립 시나리오 12개에서는 사실상 차이가 없었습니다. 개발 시나리오에서 얻은 개선이 새 문제로 옮겨 간다고 아직 말할 수 없다는 뜻입니다. 이것이 알파로 남긴 가장 큰 이유입니다.
독립 세트를 읽을 때 주의할 점도 있습니다. 시나리오가 12개뿐이라 하나가 평균을 약 0.08 움직입니다. 여러 후보를 고르는 데 이미 쓴 세트라 완전히 깨끗한 검증 세트도 아닙니다. 그래서 평균이 0.02 낮다는 결과를 “나빠졌다”로도 “같다”로도 읽지 않는 편이 맞습니다.
아직 익히지 못한 습관
실패한 장면 몇 가지를 구체적으로 적습니다. 첫째는 파드가 스케줄될 때까지 계속 확인하는 시나리오입니다. 진짜 원인은 존재하지 않는 스케줄러를 가리키는 schedulerName 필드였습니다. 6회 중 4회는 이 원인을 찾았습니다. 나머지 2회는 좁은 상태 필드만 반복 조회했습니다. 계기판만 다시 보다가 정작 설정표를 펼치지 않은 셈입니다.
둘째는 이미 끝나서 정리된 Job 시나리오입니다. Job은 이미 실행됐고 리소스는 사라진 상태였습니다. 이벤트 기록을 보면 실행 이력을 확인할 수 있습니다. 그런데 6회 모두 이벤트를 확인하지 않았습니다. 사라진 리소스의 과거를 찾아보는 습관이 아직 없습니다.
셋째는 불확실성 표현입니다. 원인을 관측할 수 없을 때 “확정할 수 없다”고 답해야 합니다. 이 모델은 근거가 부족해도 그럴듯한 원인을 말하는 경우가 많았습니다. 정비사가 진단기 기록 없이 “배터리 문제네요”라고 말하는 것과 같습니다.
도구 없이 쓰면 이 경향이 더 드러납니다. 이벤트도 노드 배정도 없는 Pending 파드를 일반 채팅으로 물었습니다. 모델은 “리소스 부족”이라고 단정했습니다. FailedScheduling 이벤트가 없다면 가능성이 낮은 답입니다. 반드시 도구 호출 에이전트 안에서 먼저 확인하고 답하게 쓰십시오.
학습은 어떻게 했나
방법은 LoRA 어댑터 지도 미세조정입니다. 도구 호출이 포함된 다중 턴 궤적 283개로 1 epoch 학습했습니다. NVIDIA B200 1장에서 약 3.4시간이 걸렸습니다. 처음부터 학습하지 않고 이전 어댑터 r4에서 이어 학습했습니다.
데이터는 팀이 직접 작성한 합성 KIND 시나리오에서 기록한 궤적입니다. 결정론 검사로 걸렀습니다. 정답 근거가 빠진 궤적, Secret을 읽은 궤적, 쓰기 명령이나 반복 호출이 있는 궤적은 모두 뺐습니다. 260개는 기반 모델이나 이전 어댑터가 직접 만들었습니다. 23개는 DeepSeek-V4-Pro API로 만들었습니다. DeepSeek 약관은 출력을 다른 모델 학습에 쓰는 것을 허용합니다. 고객 데이터와 운영 로그는 쓰지 않았습니다. 학습 데이터는 공개하지 않습니다.
직접 써 보기
기반 모델의 멀티모달 클래스 경로로 학습했습니다. 그래서 Qwen3_5ForConditionalGeneration으로 불러온 뒤 PEFT로 어댑터를 붙여야 합니다. 아래는 모델 카드의 예시입니다.
import torch
from transformers import AutoTokenizer, Qwen3_5ForConditionalGeneration
from peft import PeftModel

base = "Qwen/Qwen3.8-27B"
adapter = "ThakiCloud/Thaki-Ops-27B-v0.1-alpha"

tok = AutoTokenizer.from_pretrained(adapter)
model = Qwen3_5ForConditionalGeneration.from_pretrained(base, dtype=torch.bfloat16, device_map="auto")
model = PeftModel.from_pretrained(model, adapter).eval()

msgs = [{"role": "user", "content": "demo 네임스페이스의 파드가 이벤트도 노드 배정도 없이 20분째 Pending 입니다. 무엇부터 확인해야 하나요?"}]
ids = tok.apply_chat_template(msgs, add_generation_prompt=True, return_tensors="pt", return_dict=True, enable_thinking=False)["input_ids"].to(model.device)
out = model.generate(input_ids=ids, max_new_tokens=400, do_sample=False)
print(tok.decode(out[0, ids.shape[1]:], skip_special_tokens=True))
Qwen3.5 계열 구조를 지원하는 transformers와 peft>=0.20이 필요합니다. bf16 기준으로 GPU 메모리가 약 60GB 듭니다. 학습에 쓴 기반 모델 revision은 1d4bf0f2ff6012fd82039f2fa52739d0dd7c60c0입니다.
위처럼 일반 채팅으로 묻는 것은 동작 확인용입니다. 실제로 써 보실 때는 HolmesGPT 같은 에이전트에 읽기 전용 도구를 주고 붙이십시오. 앞서 말씀드렸듯이 도구 없이 쓰면 이 모델은 추측합니다.
쓰기 전에 알아 두실 것
Kubernetes에서만 잰 결과입니다. VM이나 일반 Linux 장애는 재지 않았습니다. 영어와 한국어만 시험했습니다. 알려진 실패 유형은 세 가지입니다. 조회 범위를 너무 일찍 좁혀 결정적인 spec 필드를 놓칩니다. 사라진 리소스의 이벤트 이력을 보지 않습니다. 근거가 부족할 때 원인을 단정하기도 합니다.
권한은 모델이 지키지 않습니다. 에이전트에 주는 도구 자체를 읽기 전용으로 묶으셔야 합니다. Secret 접근도 RBAC로 막아 두시길 권합니다. 모델이 내놓은 원인은 사람이 검토한 뒤에만 조치로 옮기십시오. 정비사의 진단서는 참고 자료일 뿐입니다. 수리 결정은 차 주인이 합니다. 에이전트에게 조치를 어디까지 맡길지는 자율 조치와 사람 호출의 경계를 다룬 글에서 더 읽어 보실 수 있습니다.
왜 공개하는가
다키클라우드는 업무 단계를 정책 게이트와 감사 기록으로 통과시키는 업무 자동화 플랫폼 Paxis를 만듭니다. 운영 로그를 외부 LLM에 보내기 어려운 환경에서는 사내에서 돌릴 수 있는 진단 모델이 필요합니다. Thaki-Ops-27B는 그 가능성을 확인하려는 실험입니다. 이 어댑터는 아직 어떤 제품에도 통합되지 않았습니다.
기준을 통과하지 못한 버전을 공개하는 이유도 여기 있습니다. 저희 평가 환경은 KIND 위의 합성 시나리오입니다. 실제 클러스터에서 어떤 장면에서 막히는지는 직접 써 보시는 분들이 더 잘 보실 수 있습니다. 같은 조회를 반복하거나 근거 없이 단정하는 장면을 보시면 모델 저장소의 Community 탭으로 알려 주십시오.
작은 모델에 정형 도구 호출을 가르친 앞선 공개 사례는 KoToolAct-4B 공개 글에 정리했습니다. 그 모델이 정해진 업무를 정확히 처리하는 쪽이라면 이번 모델은 원인을 조사하는 쪽입니다.
공개한 것
| 저장소 | 형식 | 용도 |
|---|---|---|
| ThakiCloud/Thaki-Ops-27B-v0.1-alpha | PEFT LoRA 어댑터 | Qwen3.8-27B에 붙여 쓰는 실험용 알파, 영문·한국어 모델 카드 포함 |
이번 알파는 완성된 SRE 에이전트가 아닙니다. 문제가 없을 때 손대지 않는 습관은 익혔습니다. 처음 보는 장애에서 끝까지 근거를 찾는 습관은 아직 익히지 못했습니다. 진단기를 읽을 줄 아는 견습 정비사 정도로 여겨 주십시오. 수리는 계속 사람이 맡아야 합니다.
측정 출처: 모델 카드에 공개한 값입니다. KIND 클러스터 위의 자체 HolmesGPT 평가 환경에서 시나리오당 3회, 영어와 한국어 프롬프트로 쟀습니다.

