채용 플랫폼이 만든 33B 에이전트 모델, Nanbeige4.3-33B
 30B급 오픈 모델 중 가장 넓은 에이전틱 벤치마크 표를 내민 모델의 포스터입니다.
왜 읽어야 하나
자기 에이전트 워크플로에 올릴 30B급 오픈 모델을 고르는 ML 엔지니어, 그리고 서빙 카탈로그를 관리하는 플랫폼 팀이라면 이 글을 읽어야 합니다. 결론부터 말하겠습니다. BOSS Zhipin(중국의 채용 플랫폼)의 Nanbeige LLM Lab이 공개한 33B dense 모델 Nanbeige4.3-33B는 자체 보고 기준 20개 에이전틱 벤치마크 중 17개를 30B급 오픈 모델 중 선두로 기록하고, 이 표를 저희가 직접 받은 config.json으로 다시 계산해 구조 수치는 전부 일치하는 것을 확인했습니다. 다만 20개 중 3개 행은 경쟁사의 공식 모델카드와 모순되어, 숫자 자체보다 “교사 모델을 먼저 만들고 증류한다”는 전략이 더 중요한 신호입니다.
개요
10월 24일, Hugging Face의 Nanbeige 조직에 두 개의 레포지토리가 올라왔습니다. Instruct 버전인 Nanbeige4.3-33B와 커스텀 포스트트레이닝을 위한 Nanbeige4.3-33B-Base입니다. 라이선스는 Apache 2.0이고, 언어는 영어와 중국어, 입력은 텍스트 전용입니다. 컨텍스트 길이는 524,288토큰(512K)입니다.
만든 곳은 모델 이름에서 알 수 있듯이 Nanbeige(南北阁) LLM Lab이며, BOSS Zhipin이라는 채용 플랫폼 내부에 있는 연구팀입니다. 모델카드의 연락처가 nanbeige@kanzhun.com(Zhipin의 도메인)인 것이 그 증거입니다. 공개 시계는 빠릅니다. Instruct 모델카드가 Hugging Face에 오른 것은 10월 24일(UTC 02:49)이고, 이틀 만인 25일에는 400이 넘는 좋아요와 함께 커뮤니티 GGUF 양자화 버전이 하나 등록되어 있었습니다. 연구팀의 말에 따르면 Nanbeige4.3 시리즈의 전략은 “고용량의 교사 에이전트를 먼저 만들고, 그 다음에 더 작은 모델로 에이전트 능력을 증류하는 것”입니다. 33B가 이 시리즈의 플래그십 교사 모델이고, Nanbeige4.3-3B 같은 작은 모델 증류 파이프라인이 그 다음 단계로 예고되어 있습니다.
흥미로운 점은 채용 플랫폼이라는 조직의 정체성입니다. 채용 플랫폼은 직무 수행 데이터(무엇을 하고, 어떻게 평가받고, 어떤 도구를 쓰는가)를 가장 많은 축적으로 가진 업종 중 하나입니다. JobBench 같은 직업별 에이전틱 벤치마크를 만든 조직이 바로 이런 구조라는 것은, 데이터와 벤치마크가 같은 곳에서 나온다는 뜻입니다.
이 연구팀은 처음 오는 팀이 아닙니다. 같은 Nanbeige 조직의 이전 릴리스 Nanbeige4.2-3B는 9월 중순 Hugging Face 트렌딩 LLM 상위권에서 700이 넘는 좋아요를 받은 3B급 엔디비 모델이었습니다. 시리즈 번호가 4.2에서 4.3으로 올랐다는 것은, 3B급 모델로 에이전트 엔디비를 먼저 돌아본 팀이 이제 33B 교사로 올라갔다는 뜻입니다. “작은 모델로 검증하고, 교사를 만들고, 다시 작은 모델로 증류한다”는 순서가 이 조직의 실제 이동 궤적입니다.
이 모델은 무엇인가
config.json을 직접 받아 확인한 구조는 표준 LlamaForCausalLM입니다. MoE가 아니라 dense, 즉 모든 토큰마다 전체 33B 매개변수가 활동합니다. 주요 사양은 아래처럼 읽힙니다.
- 히든 7,168, 52층
- GQA: 쿼리 헤드 56, KV 헤드 8, 헤드 차원 128
- FFN intermediate 22,016, 실루 액티베이션, 어텐션·MLP 바이어스 없음
- 보카브 166,912, RoPE theta 120M
- lm_head가 임베딩과 공유(tie_word_embeddings=false)되지 않음
채팅 템플릿에는 세 가지 스위치가 있습니다. enable_thinking은 추론(사고 블록) 생성을 켜고 기본값은 켜져 있고, preserve_thinking은 이전 턴의 사고를 유지할지 결정합니다. 연구팀은 일반 대화에는 False, 멀티턴 도구 사용과 코드 에이전트 워크플로에는 True를 권장합니다. 도구 호출은 XML 포맷을 권장하며 JSON도 지원합니다. 주목할 점은 서빙 레시피입니다. vLLM과 SGLang 예제 모두 4웨이 텐서 병렬(tp-size 4)에 –reasoning-parser qwen3 –tool-call-parser qwen3_coder를 씁니다. Llama 구조의 모델인데 파서는 Qwen3 계열 컨벤션입니다.
추론 설정 권장값도 공개되어 있습니다. 에이전틱·도구 작업은 temperature 1.0, top_p 0.95, max new tokens 65,536이고, 추론·채팅은 temperature 0.6, top_p 0.95, max new tokens 262,144입니다. 에이전트 작업에서 temperature 1.0을 권장한다는 점은 주목할 만합니다. 도구 호출과 탐색적 에이전트 동작에서는 샘플링의 다변성이 평가 점수에 기여할 여지가 있다는 판단이 담겨 있고, 이는 에이전틱 코딩 모델을 일반 챗 모델과 다른 추론 프로필로 취급해야 한다는 신호입니다.
dense라는 선택 자체도 읽을 곳이 있습니다. 30B급에서 MoE 구조가 흔한 지금, 전체 매개변수를 매 토큰마다 돌리는 dense를 고른 것은 추론 비용의 예측 가능성이 목적일 가능성이 큽니다. MoE는 활성 매개변수가 적어 서빙당 비용이 낮지만, 가중치 전체를 메모리에 올려야 하고 로딩·네트워크·캐싱의 footprint가 큽니다. dense 33B는 가중치 66GB라는 하나의 숫자로 서빙 요건이 확정되고, 4웨이 텐서 병렬 권장값이 그대로 배포 계획이 됩니다. 에이전트 워크로드는 긴 컨텍스트와 반복 도구 호출이 기본이라, 토큰당 비용의 안정성이 배치 처리량만큼 중요한 영역입니다. “가장 비싸 보이는 구조”를 고른 것이 아니라, “비용이 가장 예측되는 구조”를 고른 것이라 보는 쪽이 합리적입니다.
독립 검증: config.json으로 다시 계산
모델카드의 수치를 그대로 믿지 않고, HF에서 받은 config.json으로 매개변수 수와 메모리 수치를 독립 재계산했습니다. 검증 스크립트와 출력은 이 글과 함께 레포지토리에 보관해 두었습니다(outputs/blog-impl/nanbeige43-33b-open-agentic-teacher/).
계산 결과는 다음과 같습니다.
- 레이어당 어텐션 117,440,512 + MLP 473,432,064 + 노름 14,336 = 레이어당 590,886,912
- 52층 합계 30,726,119,424
- 임베딩 1,196,425,216, 공유되지 않은 lm_head 1,196,425,216
- 총 33,118,969,856 매개변수, 약 33.12B
- BF16 가중치 66.2GB(61.7GiB)
- KV 캐시 212,992바이트/토큰(208KiB, BF16)
- 512K 전체 컨텍스트 KV 캐시 약 104GiB
“33B dense”라는 명칭은 실제 33.12B로 일치합니다. 이차 보도(marktechpost)가 추정한 66GB 가중치, 토큰당 208KiB KV 캐시, 전체 컨텍스트 112GB(GB 환산)도 우리 계산과 일치합니다. 즉 구조 관련 수치는 공개된 config만으로 재현 가능한 상태입니다.
이 계산에서 실용적으로 읽을 것은 KV 캐시입니다. 토큰당 208KiB이면, 512K 컨텍스트를 그대로 열면 KV 캐시만으로 100GiB를 넘습니다. 가중치 66GB에 이걸 얹는 것은 다중 GPU 클러스터에서나 가능한 일이고, 실무에서는 maxModelLen을 낮추거나 KV 양자화가 선행 조건이 됩니다.
실무 컨텍스트로 환산하면 이렇습니다. 요청당 32K 컨텍스트면 KV 캐시가 약 6.4GiB, 128K면 약 25.8GiB입니다. 4웨이 텐서 병렬로 BF16 가중치를 나누면 GPU당 가중치는 16.5GB 수준이므로, 80GB급 GPU 4대(예: H200/B200 네 장) 조합이면 가중치 66GB + 동시 요청 수십 개의 KV 캐시가 들어가는 계산이 성립합니다. “512K 컨텍스트”라는 명칭은 모델이 학습된 위치 정보의 상한이지, 서빙 시점에 전량 열리라는 뜻은 아닙니다. 에이전트 워크로드의 실제 컨텍스트 분포에 따라 maxModelLen을 정하는 것이 서빙 계획의 핵심 변수입니다.
실제 벤치마크 결과
모델카드의 비교 표는 Qwen3.8-27B, Muse-Glimmer-30B, Gemma4-31B 세 모델과 경쟁하는 것으로, 전부 최고 thinking effort에서 같은 추론 하이퍼파라미터와 하네스로 평가했다고 선언합니다. 아래 표는 그 중 에이전틱 코딩과 코워킹 일부 행입니다.
| 벤치마크 | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 80.9 | 73.0 | 61.8 | 47.2 |
| Terminal-Bench 4.0 | 23.8 | 6.3 | 1.6 | 0.0 |
| DeepSWE | 65.5 | 42.5 | 4.4 | 2.7 |
| SWE-Bench Pro | 60.3 | 61.7 | 36.9 | 51.2 |
| Automation Bench | 54.2 | 38.3 | 15.2 | 9.7 |
| JobBench | 44.8 | 34.5 | 16.6 | 9.0 |
| GPQA Diamond | 89.5 | 89.2 | 83.5 | 91.3 |
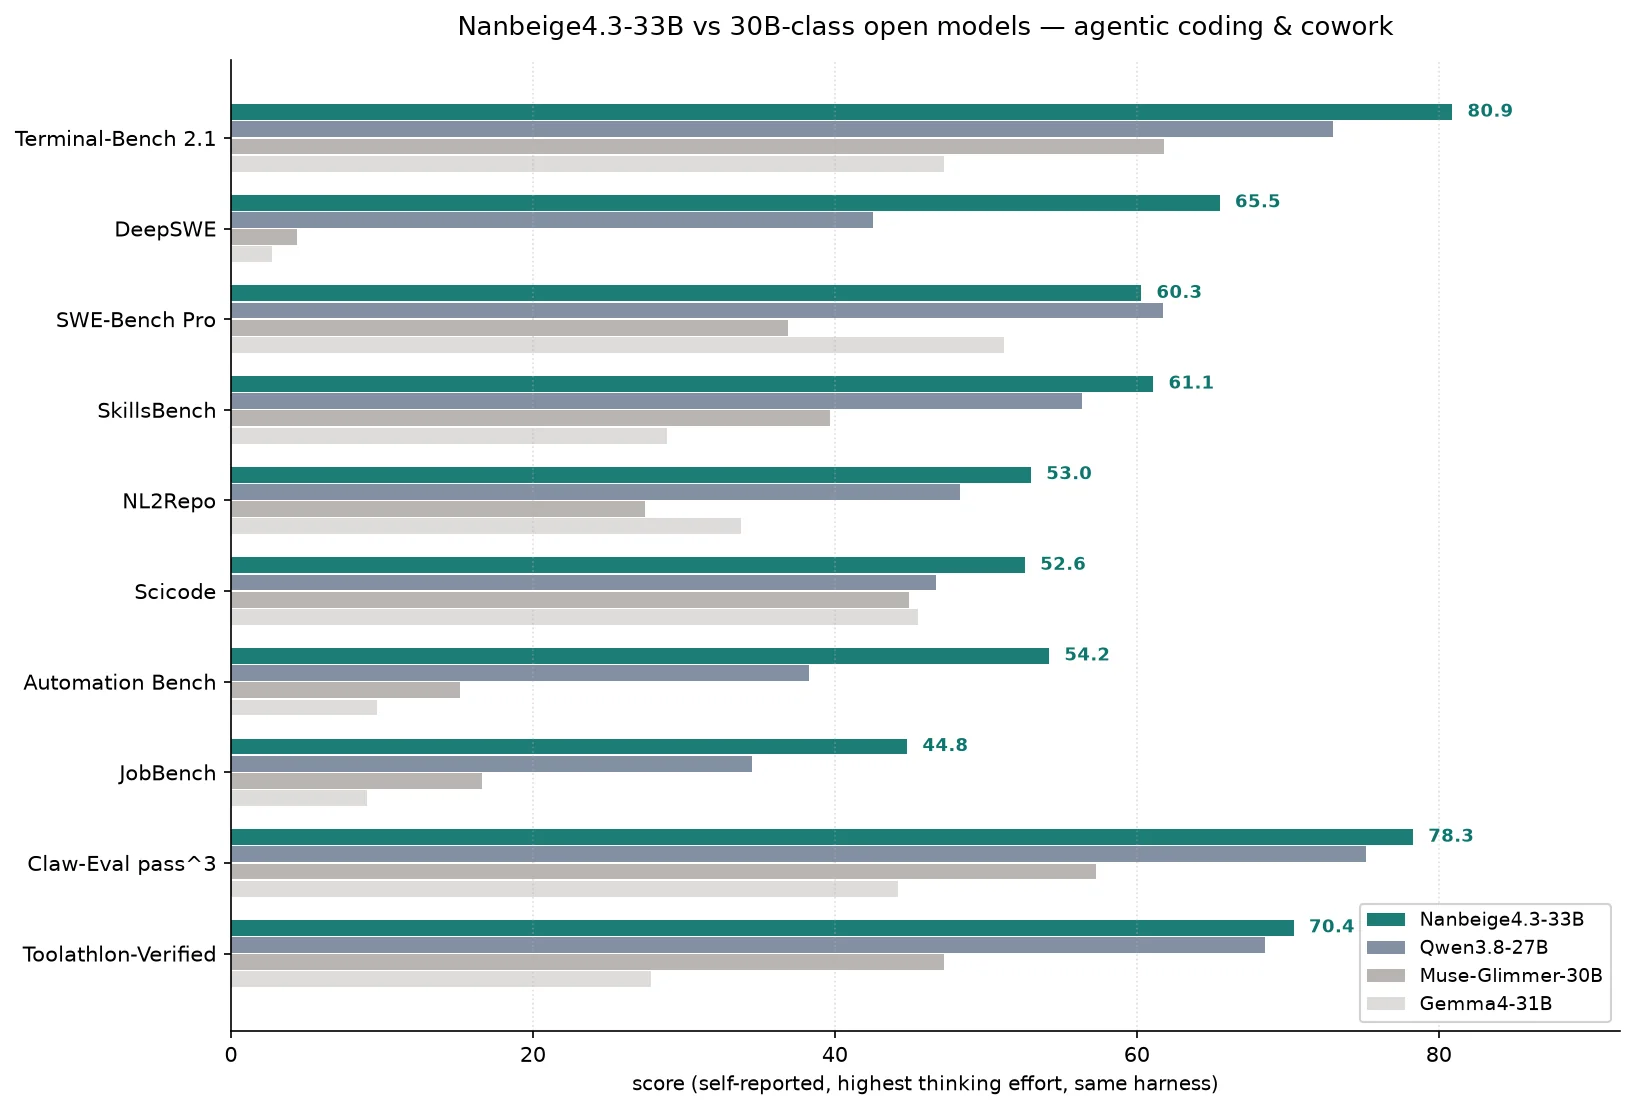 모델카드의 자체 보고 수치를 그린 비교 차트입니다. Nanbeige4.3-33B는 17개 행에서 선두지만 SWE-Bench Pro와 GDPval은 Qwen3.8-27B에, GPQA Diamond는 Gemma4-31B에 뒤집니다.
전체 20개 행 중 17개를 선두라고 모델카드는 말합니다. 뒤진 3개는 SWE-Bench Pro(60.3 대 61.7), GDPval(84.8 대 86.4), GPQA Diamond(89.5 대 91.3)입니다. 스스로 가장 낮은 점수로 표시한 행은 Terminal-Bench 4.0의 23.8로, 경쟁사 전원이 7점 이하라는 점에서 상대적 우위는 유지됩니다.
YC-bench에서는 시뮬레이션 수익 $1,025,437로 Qwen3.8-27B($641,290)를 크게 앞선다고 보고합니다. JobBench의 35개 직업 중 대부분에서 baseline을 이긴다고도 합니다.
모델카드 각주는 평가 하네스까지 공개해 두었습니다. Terminal-Bench 2.1은 Terminus 2로, Terminal-Bench 4.0과 DeepSWE는 mini-swe-agent v2.4.6으로, SWE-Atlas-QnA는 1,304개 태스크 전용 rubric에 GPT-6 Sol을 심사로 쓴 평가입니다. NL2Repo와 JobBench는 Claude Code 하네스(JobBench는 검색 도구 포함)로 돌렸고, Claw-Eval은 157개 단일턴 태스크로 이루어진 General subset의 pass^3, YC-bench는 모델 호출마다 최근 10턴만 과거 컨텍스트로 유지하는 설정입니다. 어떤 벤치마크를 어떤 도구의 하네스로 잰다는 것이 표 각주에 적혀 있다는 점은, 자체 보고라도 재현의 출발점이 명확하다는 뜻입니다.
Base 모델에 대한 비교도 하나 있습니다. 이차 보도에 따르면 Nanbeige4.3-33B-Base는 Gemma4-31B-Base 대비 보고된 8개 태스크 전부에서 앞서며, MMLU-Pro 66.9 대 59.3, GPQA 62.0 대 41.5입니다. 커스텀 포스트트레이닝을 전제로 한 조직에게는 이 Base가 실질적인 시작점입니다.
실용적 지점 하나 더. 공개 시점 기준 어떤 Hugging Face Inference Provider도 이 모델을 호스팅하지 않습니다.즉시 호출할 수 있는 API가 없는, 직접 서빙해야 하는 가중치라는 뜻입니다. 이는 “증류하고 포스트트레이닝할 가중치”라는 모델의 포지셔닝과 맞물려 있습니다. 모델카드는 “도메인 특화·산업 특화 에이전트를 위한 협력, 데이터와 학습을 포함한 공동 작업”을 명시적으로 초청해 두는데, 33B 오픈웨이트 공개에 이 정도로 개방형 표현을 붙인 것은 연구팀이 이 가중치를 완제품이 아니라 산업 공동 개발의 플랫폼으로 보고 있다는 뜻으로 읽힙니다.
다만 여기서 멈추지 않고 확인했습니다. 이차 보도(marktechpost)에 따르면 이 표의 경쟁사 수치가 각사의 공식 모델카드와 어긋나는 행이 있습니다. SWE-Bench Pro에서 Muse와 Gemma의 값이 서로 뒤집혀 있고(공식: Muse 51.2, Gemma 36.9 / Nanbeige 표: Muse 36.9, Gemma 51.2), Gemma4-31B의 GPQA Diamond는 구글 공식 84.3에 대해 91.3으로 올라가 있습니다. Terminal-Bench 2.1의 Muse 값도 공식 51.7에 대해 61.8입니다. 하네스 차이로 설명 가능한 부분도 있지만, SWE-Bench Pro 쌍이 뒤집혀 있는 것은 단순 오기일 가능성이 높습니다.
ThakiCloud 제품 적용 시사점
Metis(서빙) 관점에서 읽으면 이렇게 정리됩니다. BF16 66GB, 4웨이 텐서 병렬 권장이라는 것은 단일 80GB GPU에 올리는 게 아니라 4개 GPU를 묶거나, 양자화(FP8/INT4 계열)를 거친 뒤 1대 2대로 서빙해야 한다는 뜻입니다. ThakiCloud의 ai-platform이 멀티테넌트 서빙 카탈로그로 이 모델을 넣는다면, maxModelLen 512K 전량 서빙은 KV 캐시 100GiB 때문에 비현실적이고, 실무 컨텍스트(32K~128K)로 제한하거나 KV 양자화를 전제로 하는 것이 타당합니다. 파서 조합(qwen3 reasoning + qwen3_coder tool)은 우리가 Metis tuned-defaults에서 쓰는 Qwen3 계열 파서 컨벤션과 일치하는 쪽이라, 엔드포인트 등록 시 vllm_overrides에 그대로 적용할 수 있습니다.
Paxis(Agent-Native Cloud) 관점에서는 “교사 먼저 만들고, 작은 모델로 증류한다”는 순서가 더 중요합니다. Paxis의 워크플로 실행 단가는 모델 크기에 직접 비례합니다. 33B dense가 에이전트 워크로드를 수행할 수 있는 수준까지 올랐다면, 그 능력을 3B~7B급으로 증류해 Paxis의 저가 티어 워커에 넣는 계산이 성립합니다. “30B급 오픈 모델이 에이전트 코딩에서 실용 임계점을 넘었다”는 이번 공개는, 그 증류 파이프라인의 출발점이 실제로 존재한다는 신호입니다. Nanbeige4.3-3B가 나올 때 이번 33B 표와 비교하는 것이 그 신호의 검증 방법입니다.
한계 및 반론
첫째, 모든 벤치마크 수치는 자체 보고입니다. 독립 재현이 아직 없으며, 경쟁사 수치 3개 행은 공식 카드와 모순됩니다.
양자화 관점에서 우리가 검증한 매개변수 수(33.12B)를 그대로 대입하면 가중치만 계산할 때 FP8은 약 33.1GB, INT4는 약 16.6GB입니다. KV 캐시를 제외하고 가중치만 본 계산입니다. BF16이 아니라면 단일 80GB GPU에 올릴 수 있고, INT4라면 40~50GB급 하드웨어로 범위가 열립니다. 물론 양자화 시 성능 손실은 미검증입니다. 모델카드가 보고하는 것은 BF16 수치뿐이므로, “33B 에이전트 모델을 더 저렴한 서빙으로”라는 계산은 독립 벤치마크와 양자화 평가가 나올 때까지 추정([추정])에 머물러야 합니다. 둘째, dense 33B는 매 토큰마다 전체 매개변수를 돌리므로, 같은 성능이라면 MoE 모델 대비 서빙 비용이 구조적으로 높습니다. “성능 선두”와 “서빙 효율”은 별개이고, 이 모델은 전자의 주장만 하고 있습니다. 셋째, 텍스트 전용입니다. 멀티모달 입력이 없고(config의 챗 템플릿이 비멀티모달 입력을 거부한다는 문구를 포함하고 있습니다), 비전이 필요한 에이전트 워크플로에서는 제외 대상입니다. 넷째, “약 30B급” 비교군은 실제로는 27B~31B까지 흩어져 있고, 우리가 계산한 33.12B는 이 범위 중 가장 큰 쪽입니다. 비교의 편의가 모델의 유리함을 부풀리는지는 독립 실행 전에는 답할 수 없습니다.
정리
Nanbeige4.3-33B는 숫자표보다는 두 가지 사실로 평가해야 합니다. 하나는 채용 플랫폼 내부 연구팀이 Apache 2.0으로 33.12B dense(우리가 config.json으로 재확인했습니다)와 512K 컨텍스트, 에이전틱 벤치마크 17개 행 선두라는 주장을 동시에 공개했다는 점입니다. 다른 하나는 이것이 증류 파이프라인의 교사이며, 진짜 가치는 그 다음에 나올 작은 모델이라는 점입니다. 다음 행동은 단순합니다. 독립 재현(Terminal-Bench 2.1/4.0, SWE-Bench Pro)이 나올 때까지 구매·서빙 결정을 유보하고, 서빙을 검토한다면 양자화 + maxModelLen 제한을 전제로 Metis 카탈로그에 시험 엔드포인트를 잡아두는 것입니다. Nanbeige4.3-3B가 공개되면 33B 표와 함께 다시 확인합시다.
출처
- Nanbeige4.3-33B 모델카드 (Hugging Face)
- Nanbeige4.3-33B-Base (Hugging Face)
- Nanbeige4.2-3B (Hugging Face, 이전 릴리스)
- MarkTechPost: Nanbeige Releases Nanbeige4.3-33B, a 33B Open Agentic Coding Model
- (@nanbeige 공지 계정, X)
독립 검증 스크립트와 출력: outputs/blog-impl/nanbeige43-33b-open-agentic-teacher/verify_math.py (run-1.log)

