스킬 순서도 돈이 된다: 무인 에이전트 매니페스트 순서가 prefix cache 재사용과 손익분기를 정하는 방식
스킬 매니페스트의 순서도 돈이 됩니다. 무인 에이전트를 돌리거나 그 서빙 비용을 책임지는 엔지니어라면, 이 글이 다루는 순서가 청구서에 그대로 붙는 일입니다. 이 논문은 매 턴 다시 보내는 고정 머리말의 재전송 비용과, 순서로 아낄 수 있는 돈이 8할까지 커지는 이유와 손익분기 지점을 닫힌 형태로 계산합니다. 그 레버는 학습도, 엔진 변경도 필요 없습니다.
여기서 고정 머리말은 세 조각으로 이루어져 있습니다. 시스템 프롬프트, 툴 스키마, 스킬 매니페스트입니다. 이 세 조각은 루프가 도는 동안 거의 변하지 않고, 서빙 엔진은 매 턴 처음부터 다시 계산하는 대신 캐시에 남아 있으면 재사용합니다.
그 캐시는 접두 캐시(prefix cache)입니다. 재사용은 0번 토큰부터 똑같은 prefix에 대해서만 성립합니다. 그래서 순서가 돈이 됩니다.
이 글이 답하는 질문은 세 개입니다. 고정된 매니페스트 순서가 루프별 최근 사용 순서나 매 턴 섞인 순서에 비해 얼마나 아키는가? 그 손익분기 지점이 매니페스트 크기와 턴 간격, 캐시 경쟁 수준에서 어디에 오는가? 그리고 그 절감이 H200 기준 구성에서 얼마나 큰가?
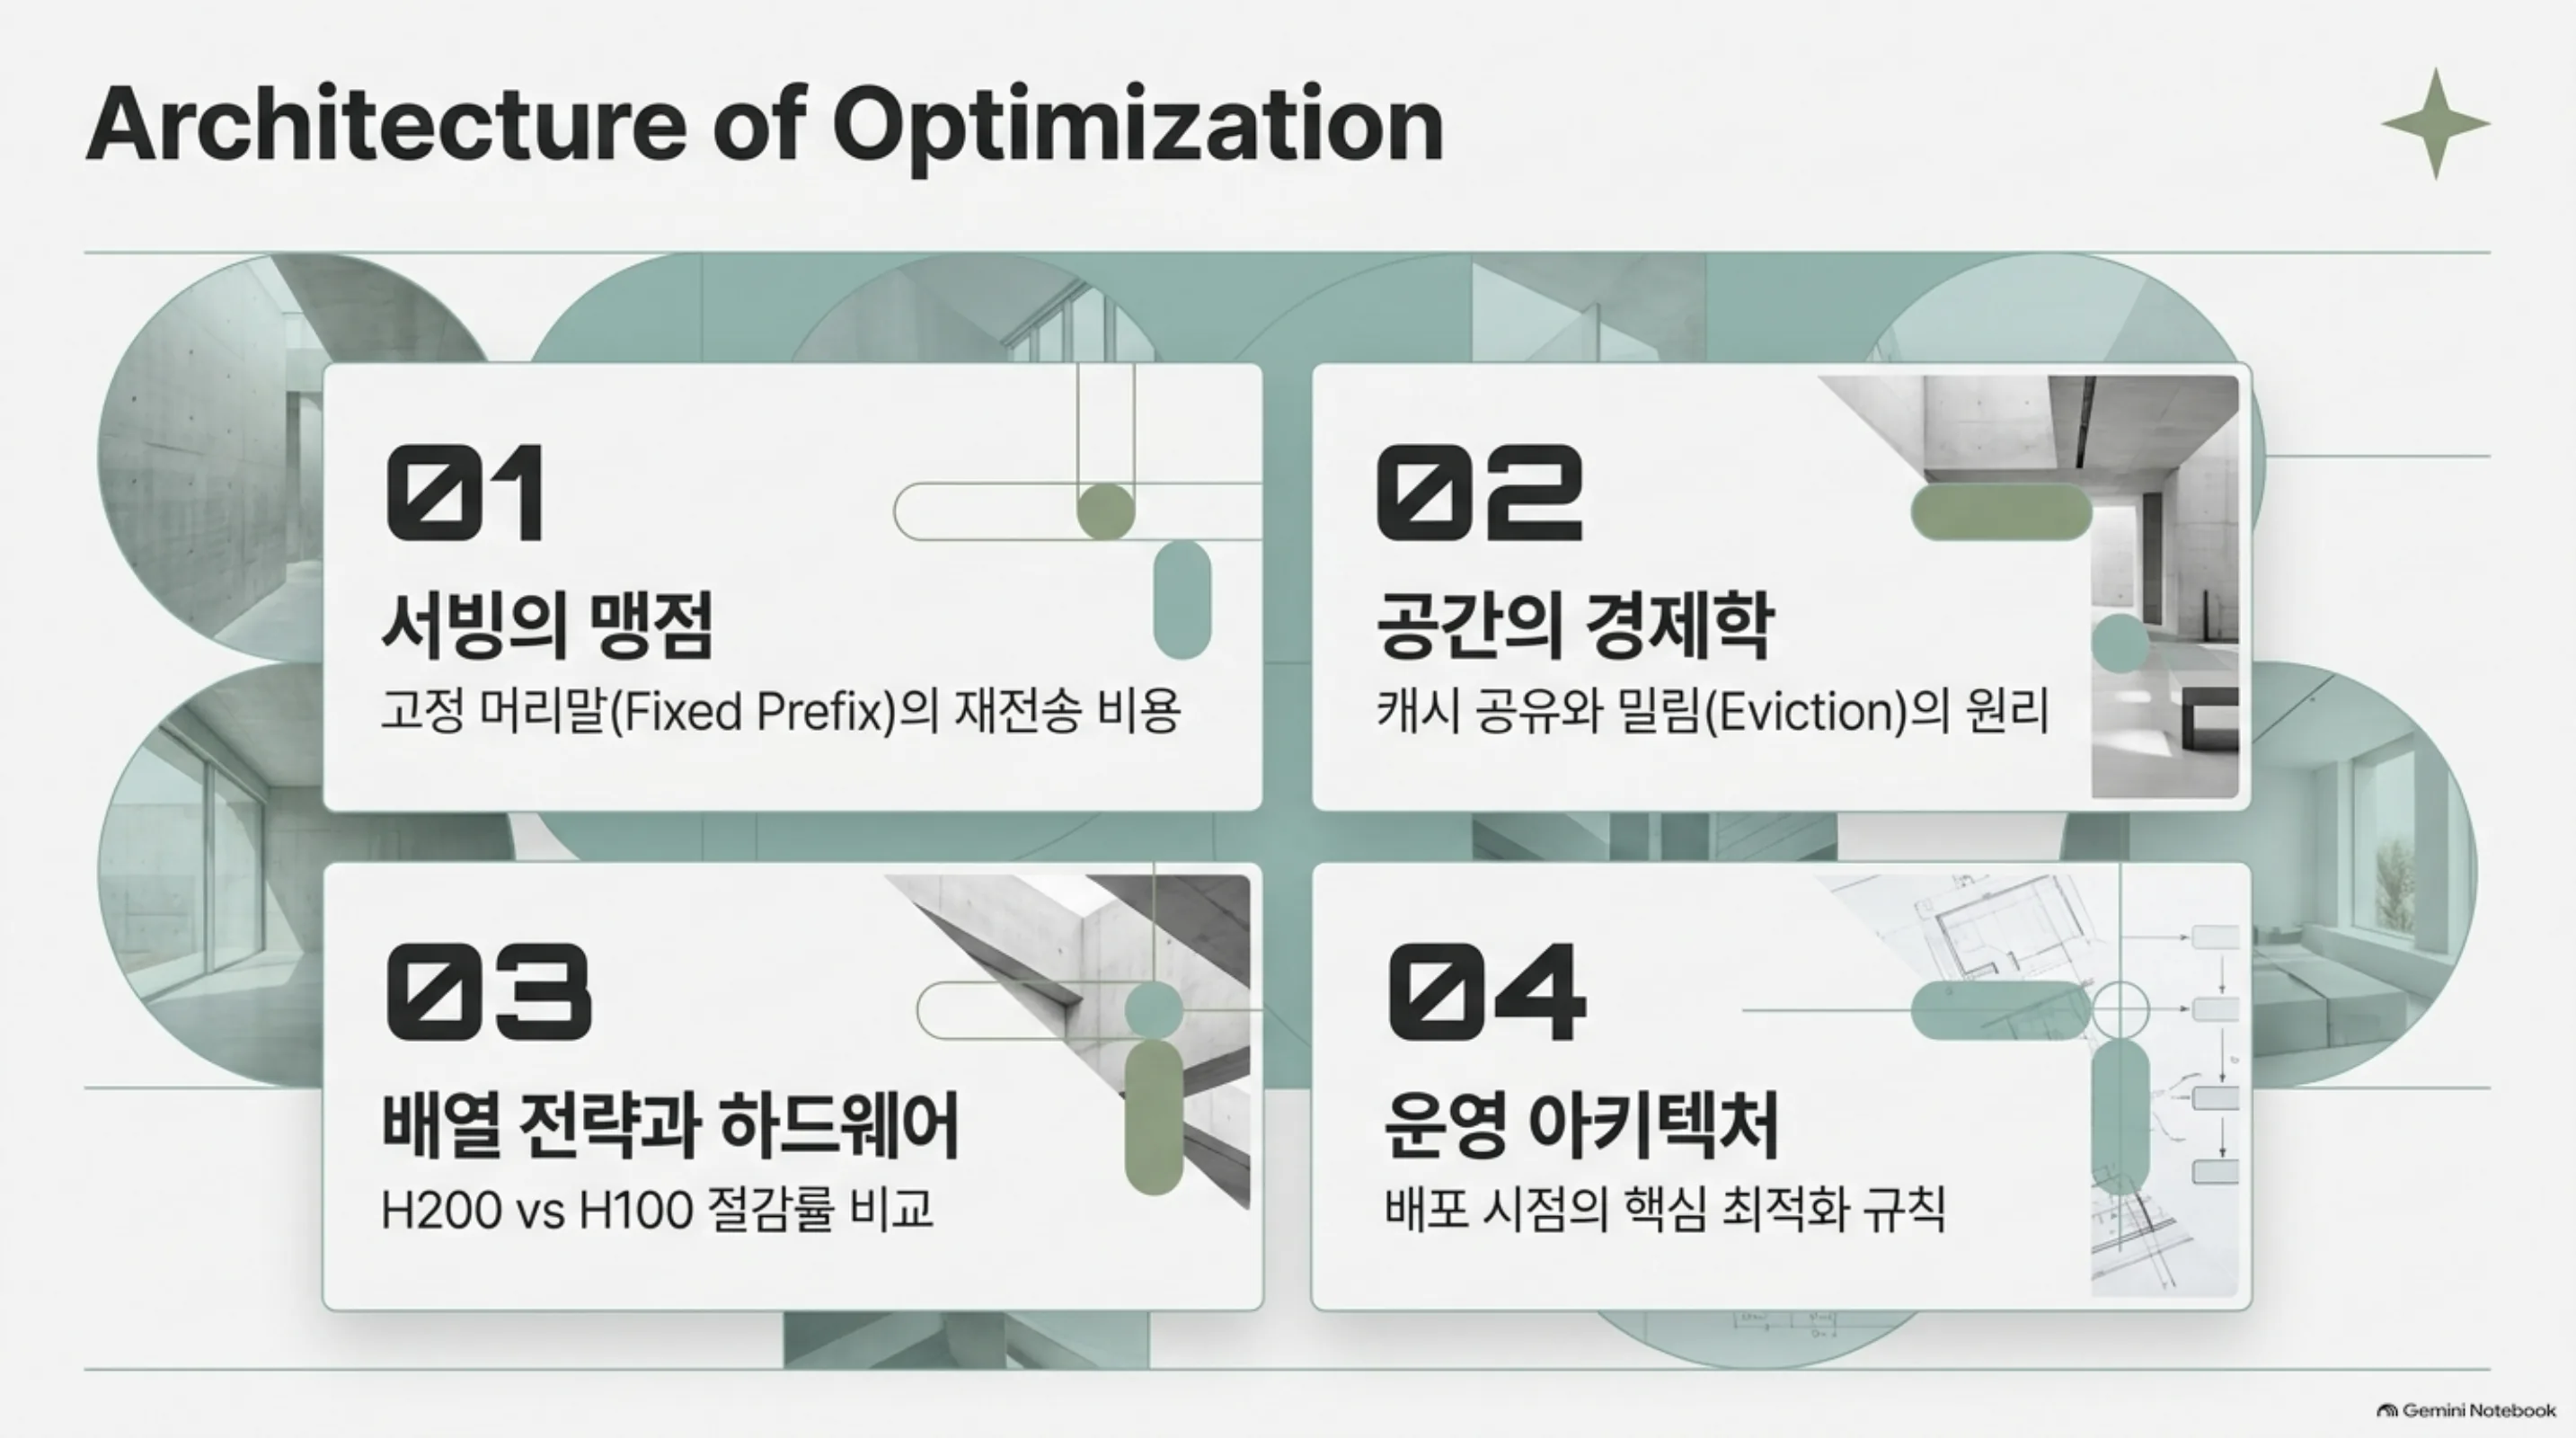
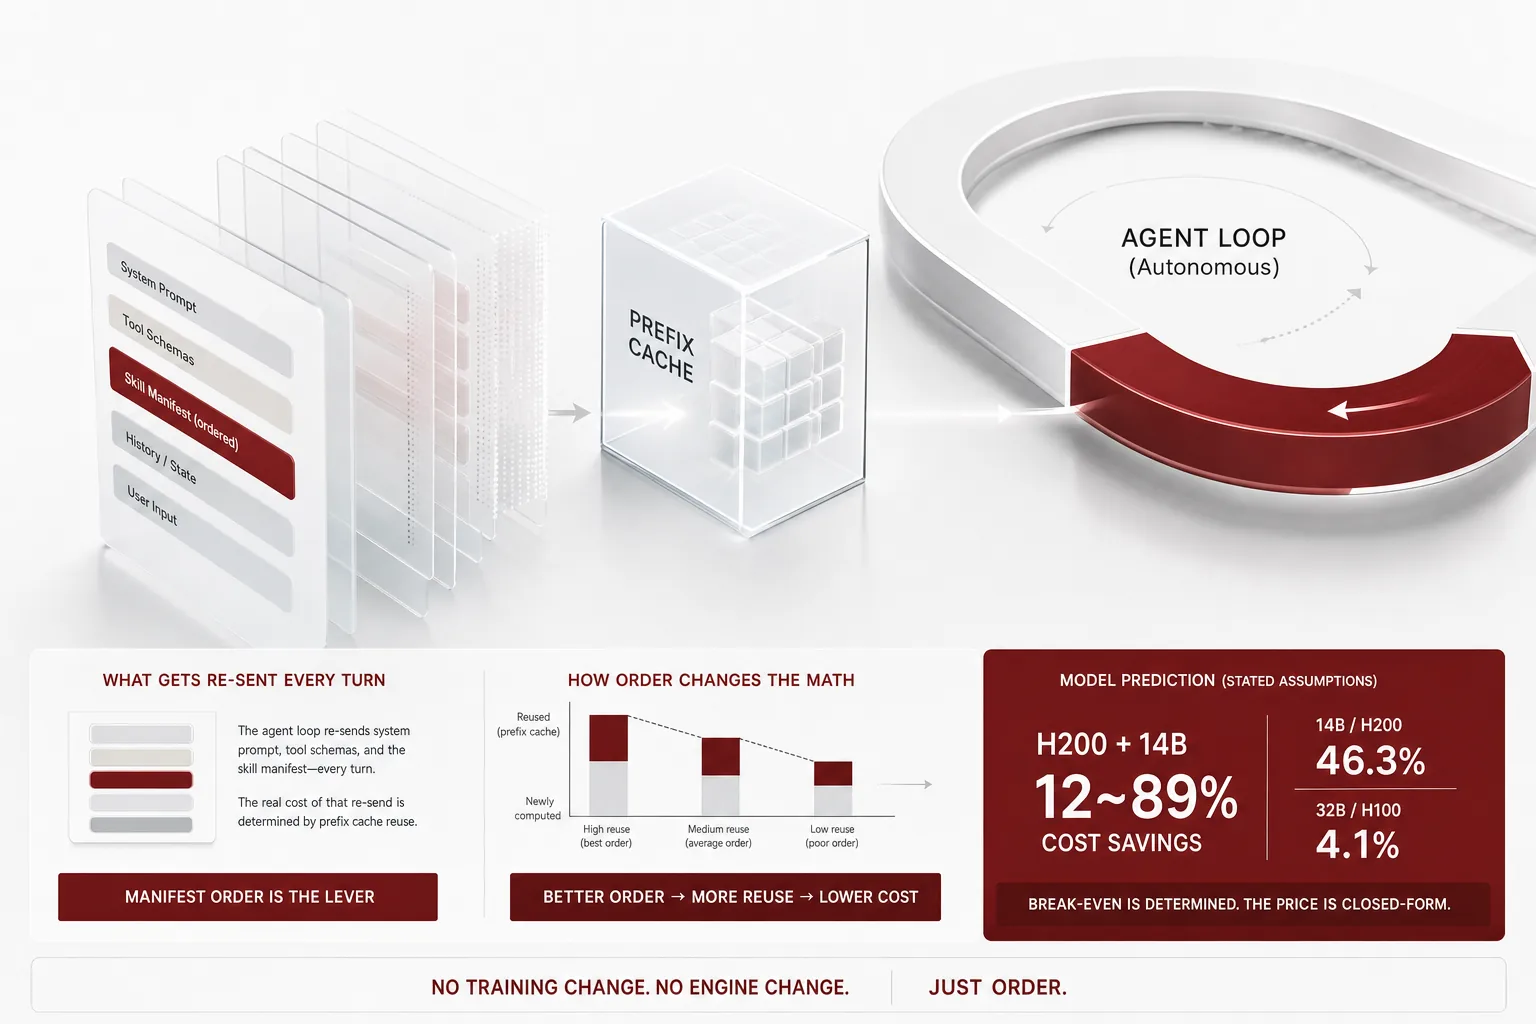 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
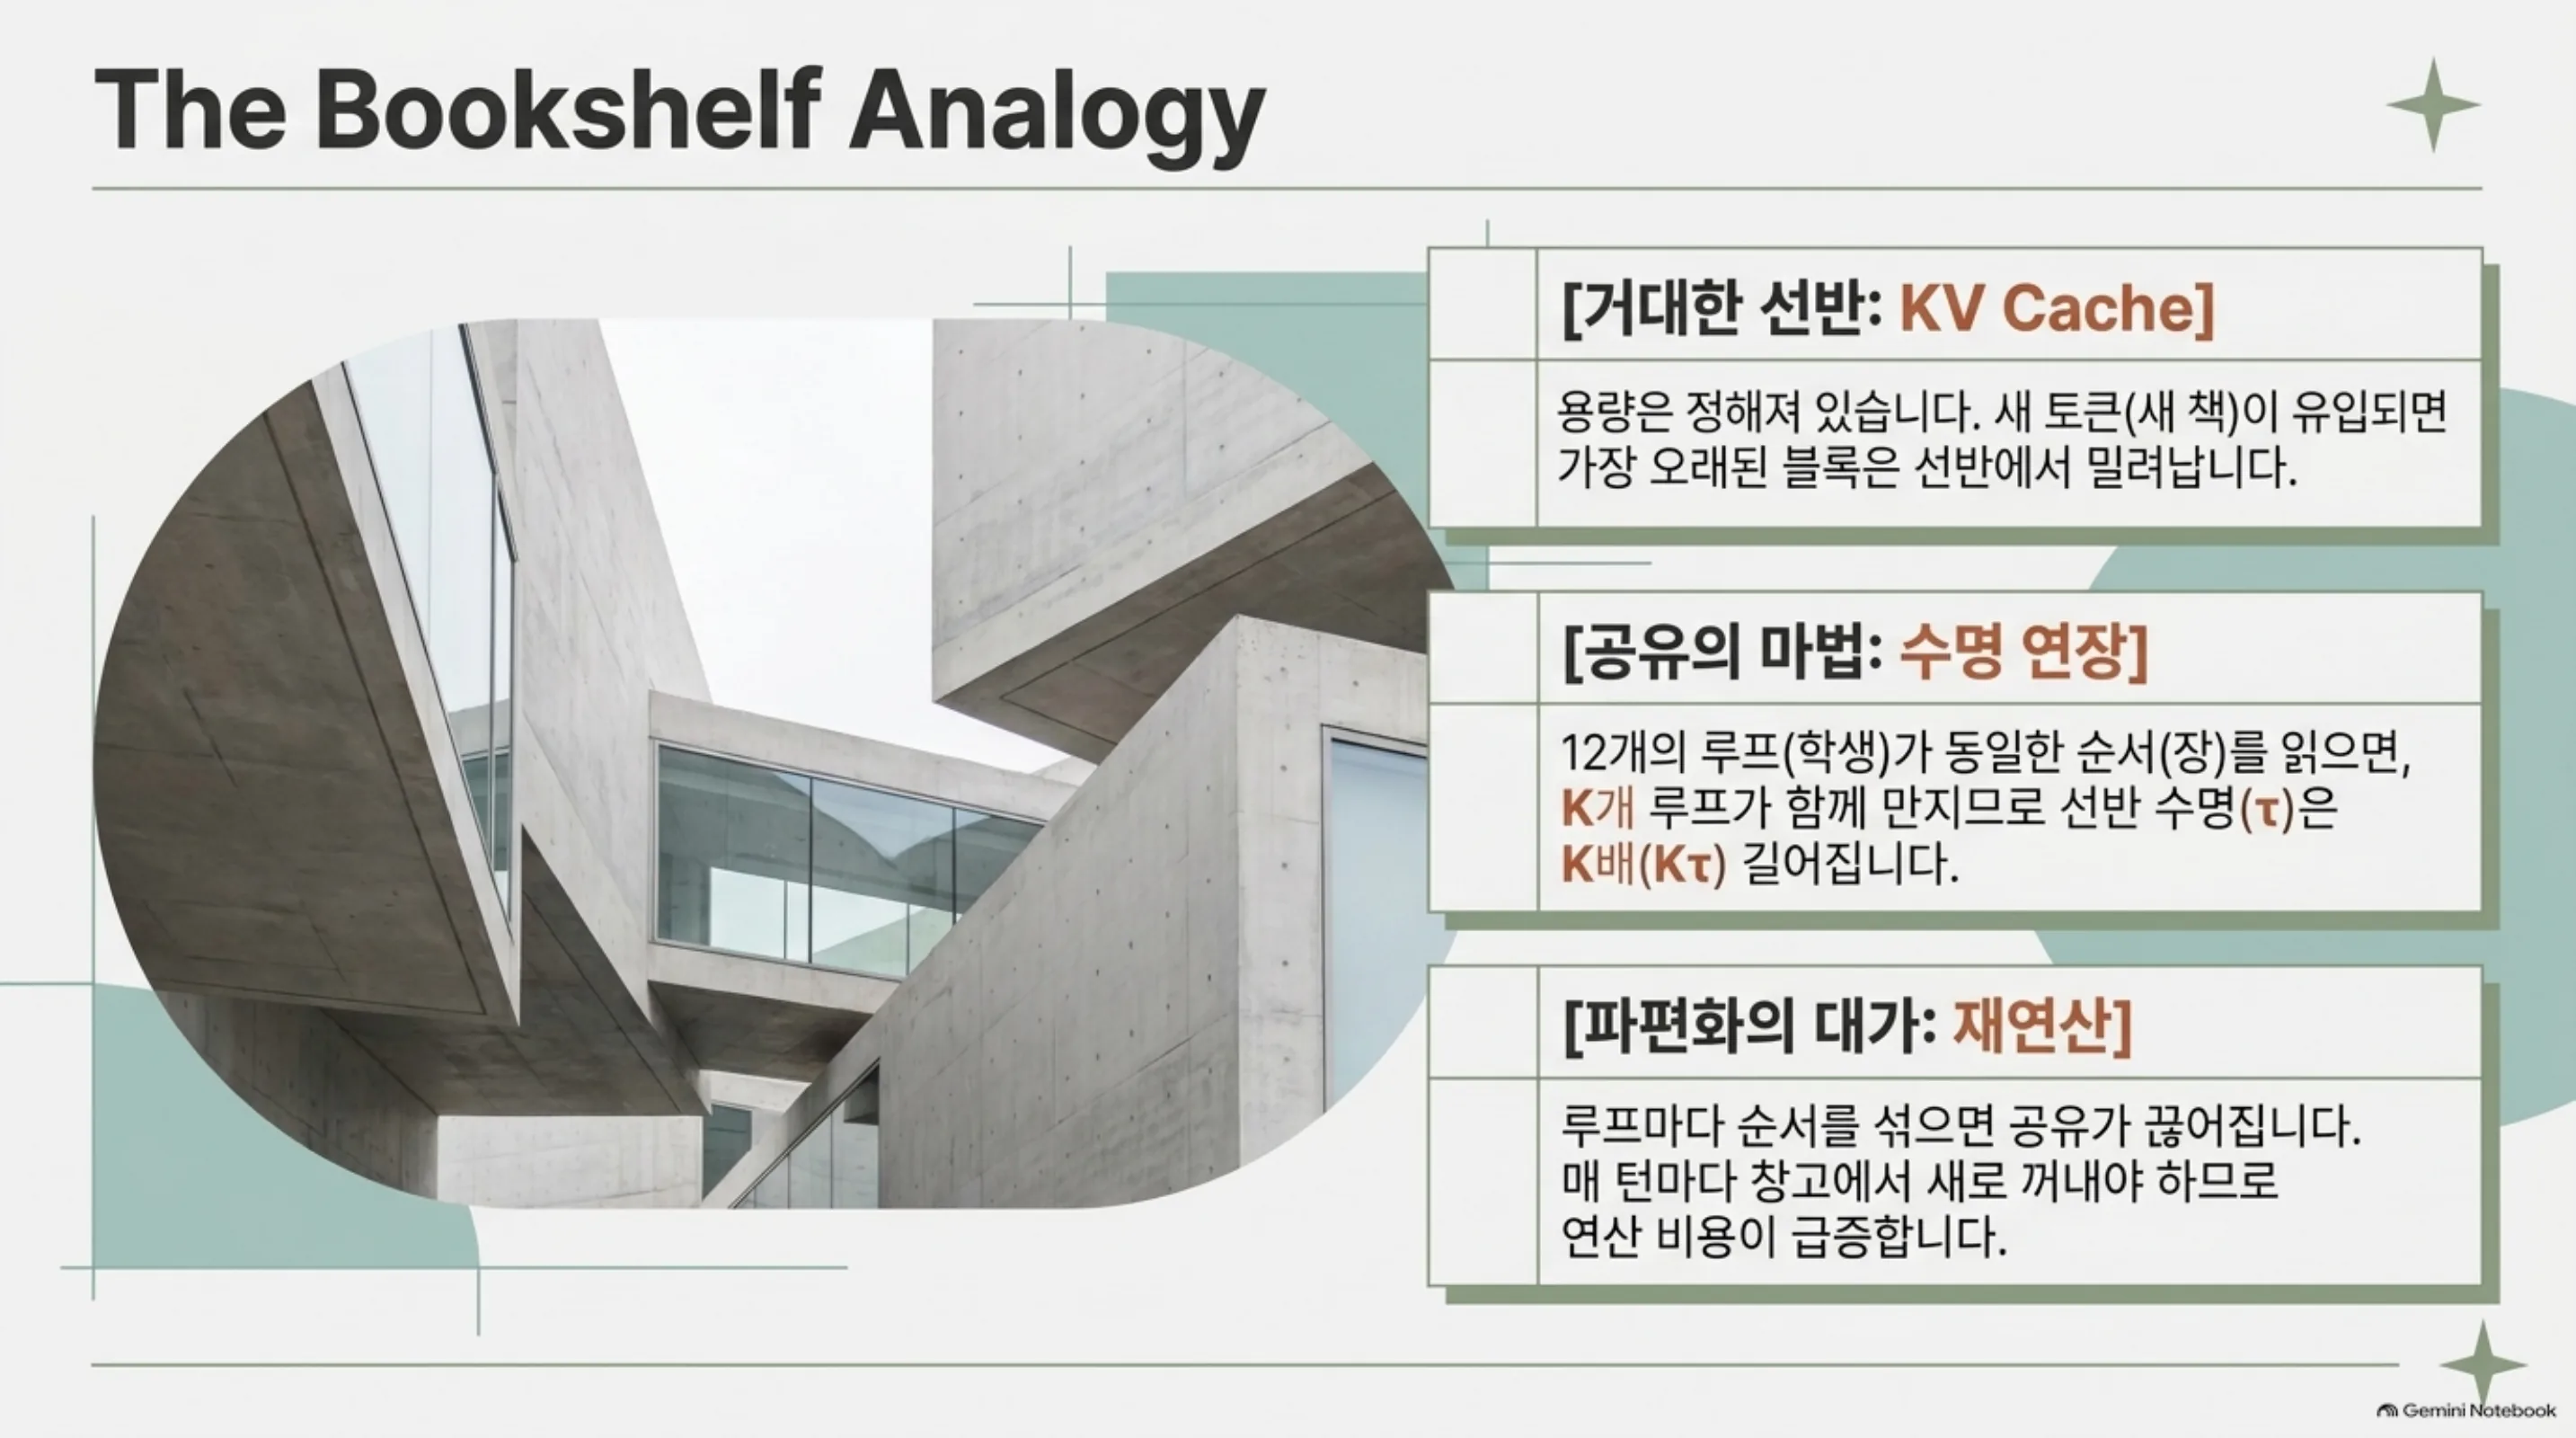
공용 자료실의 선반을 떠올려 보면, 이 논문의 구조가 그대로 들어맞습니다. 열두 명의 학생이 같은 교재로 같은 과제를 풀고 있습니다. 학생은 과제를 한 단계 끝내면 밖으로 나가고 돌아오는 시간이 턴 사이 간격입니다. 돌아왔을 때 교재가 선반에 남아 있으면 그 자리에서 이어서 읽기만 하면 됩니다. 선반에서 밀려났으면 창고에서 새로 꺼내야 합니다.
선반은 용량이 정해져 있고 새 책이 계속 들어오면 오래된 책이 밀려납니다. 동시에 열두 명이 같은 책을 쓰면 그 책은 혼자 쓰는 책보다 훨씬 늦게 선반을 지킵니다. 이 논문이 재는 것은, 바로 이 선반 위 공유가 얼마나 오래 가는가의 가격입니다.
매니페스트 순서는 교재의 장 순서에 해당합니다. 모든 학생이 같은 장 순서를 쓰면, 교재 앞부분이 누구와나 똑같아서 선반 공유가 오래 유지됩니다. 각자 최근 본 장부터 읽겠다고 순서를 바꾸면, 같은 책이라도 사람마다 접힌 쪽이 달라져 공유가 끊깁니다. 매 턴 장 순서를 다시 섞으면, 아예 처음 장부터 다시 펼쳐야 합니다.
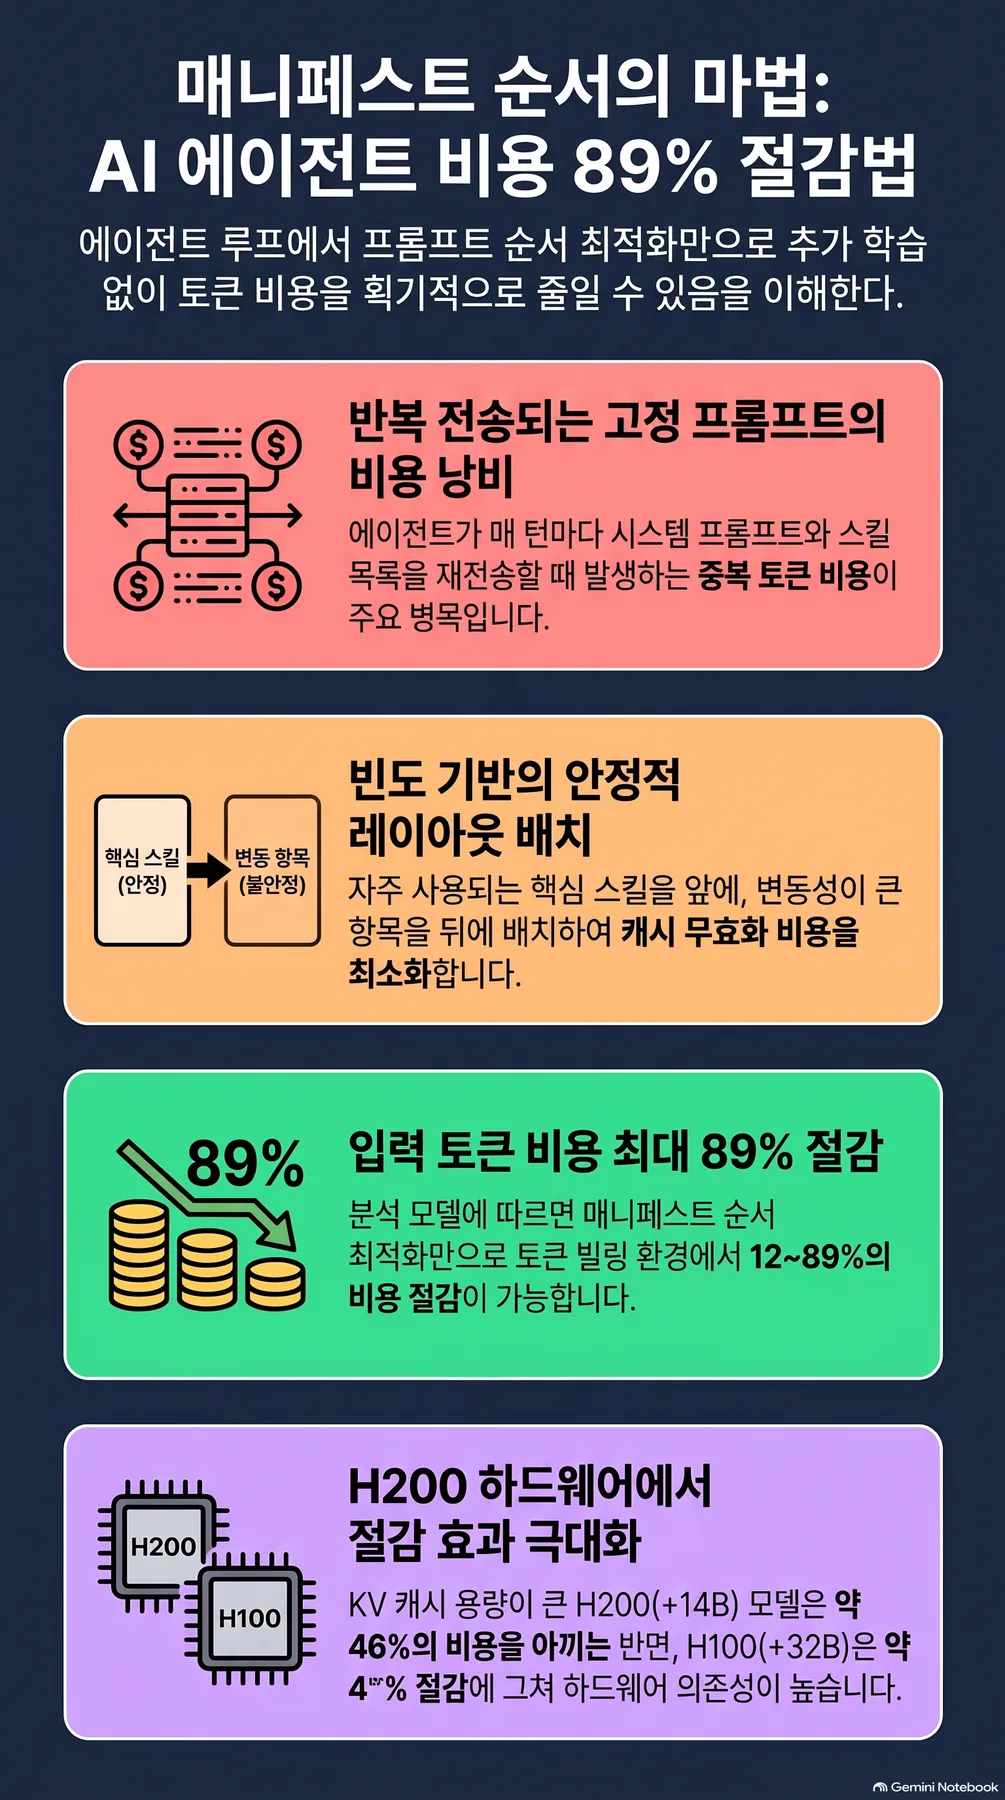
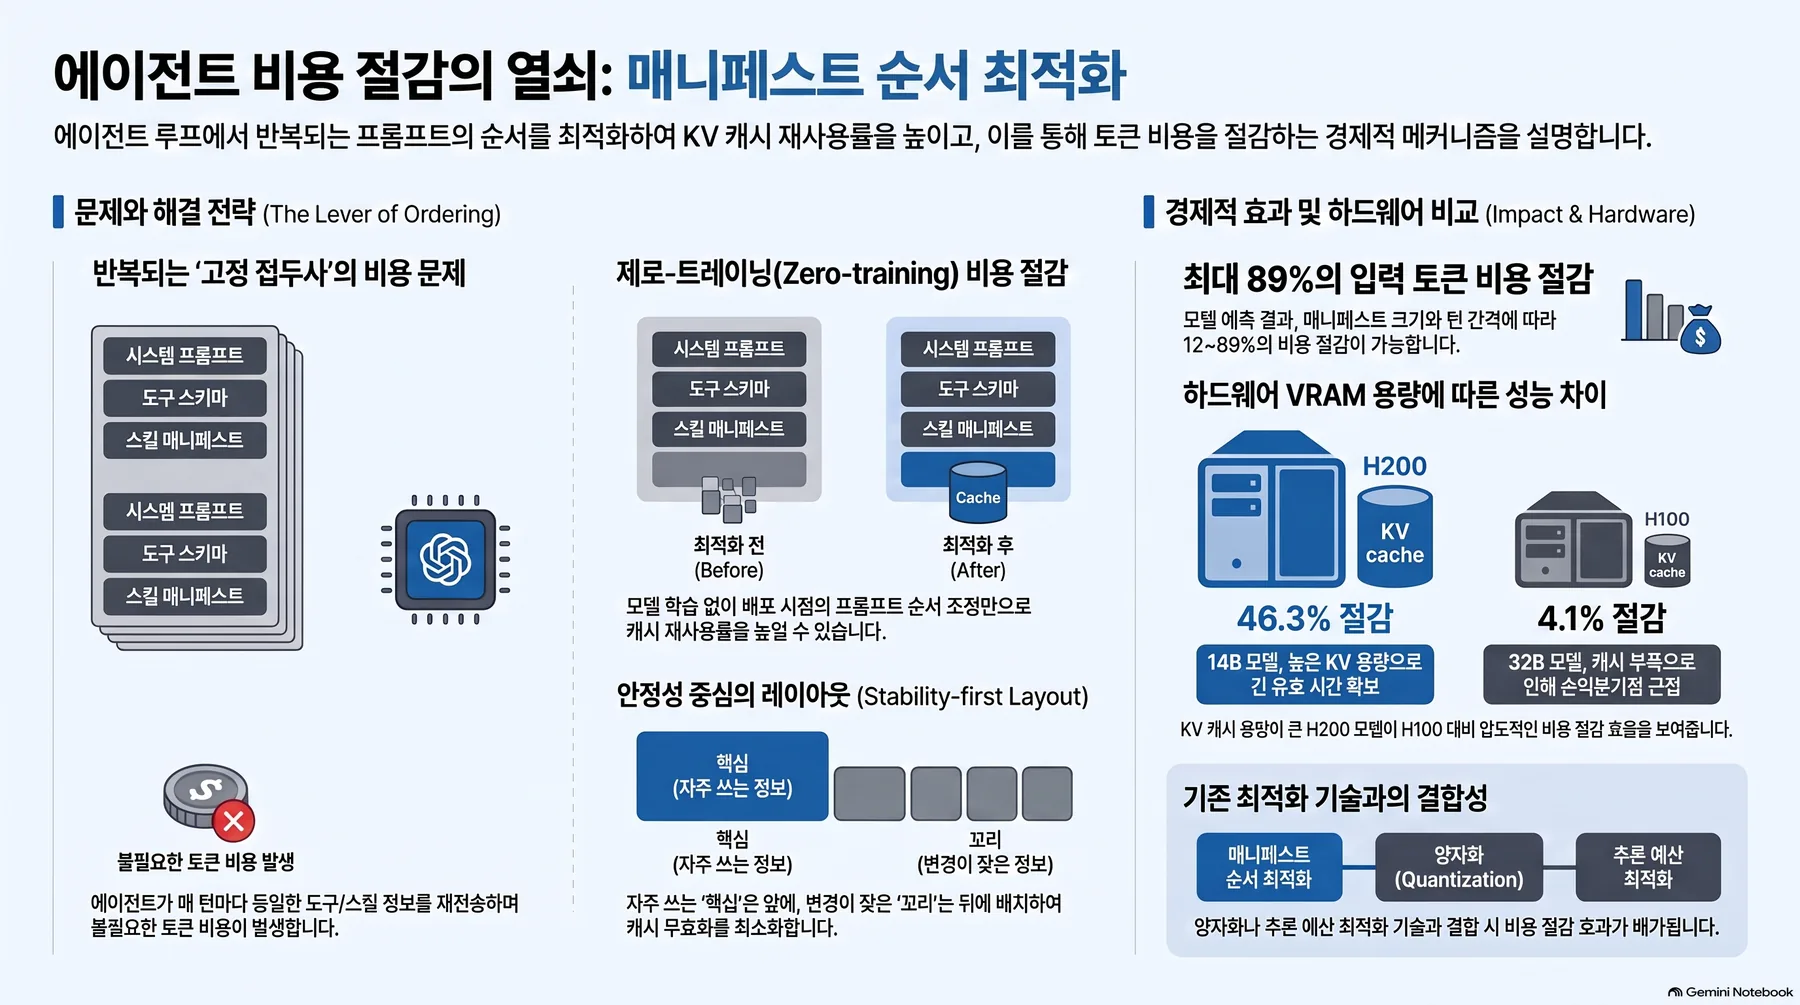 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
매 턴 다시 보내는 prefix의 가격
무인 에이전트 루프는 사람이 개입하지 않은 채 여러 턴에 걸쳐 일을 이어가는 구조입니다. 이 구조의 비용 특징은 단순합니다. 매 턴 전체 입력을 다시 보내고 그 앞은 항상 같은 고정 prefix입니다. 뒤의 작업 맥락은 툴 결과와 임시 상태가 쌓이며 턴이 갈수록 자랍니다.
접두 캐시를 쓰는 서빙 엔진은 이 앞부분을 다시 계산하지 않고 캐시에서 서빙할 수 있습니다. 다만 두 조건이 동시에 성립해야 합니다. 첫째, 순서가 공유 prefix를 온전하게 유지해야 합니다. 재사용은 0번 토큰부터 똑같은 prefix에 대해서만 성립하므로, 매니페스트 순서가 두 루프가 실제로 공유하는 토큰 길이를 정합니다. 둘째, 캐시가 턴 사이에 공유 블록을 살려 두어야 합니다.
무인 루프에서 턴 사이는 툴 실행과 외부 처리 시간이 대부분입니다. 경쟁이 있으면 다음 턴이 도착하기도 전에 공유 블록이 밀려납니다. 이 두 조건은 모두 엔진 바깥, 배포 시점에서 정해집니다.
매니페스트의 내용은 스킬 라우터가 정합니다. 범위 내 스킬을 나열하는 순서만은 운영자가 정합니다. 순서를 바꾸는 것은 모델도, 엔진도 건드리지 않습니다. 학습 없이, 배포 시점에서 당길 수 있는 레버인 셈입니다.
그런데 이 순서는 아직 경제 문제로 다뤄지지 않았습니다. 고정된 순서가 루프별 최근 사용 순서나 매 턴 섞인 순서에 비해 얼마나 아끼는가는 모릅니다. 매니페스트 크기와 턴 간격, 캐시 경쟁에 따라 손익분기 지점이 어디에 오는지도 모릅니다. H200급 인스턴스로 플릿을 세울 때 이 질문에 답해야 하는 쪽은 운영자입니다. KV 캐시는 턴 사이 공유를 가능하게 할 만큼 크지만 보장하지는 못합니다.
이전의 연구는 같은 플릿의 다른 비용 층을 계산했습니다. 라우터와 실행 사이 생각 토큰 배분, 검색용 임베딩 모델 양자화, 2,275개 스킬 레지스트리 위의 다중 스킬 라우팅입니다. 그 어디에도 매 턴 모든 루프가 다시 보내는 고정 prefix의 가격은 없었습니다. 라우터와 실행이 아무리 최적이어도, 이 토큰은 매 턴 다시 보내집니다. 이 논문은 그 층의 가격을 계산합니다.
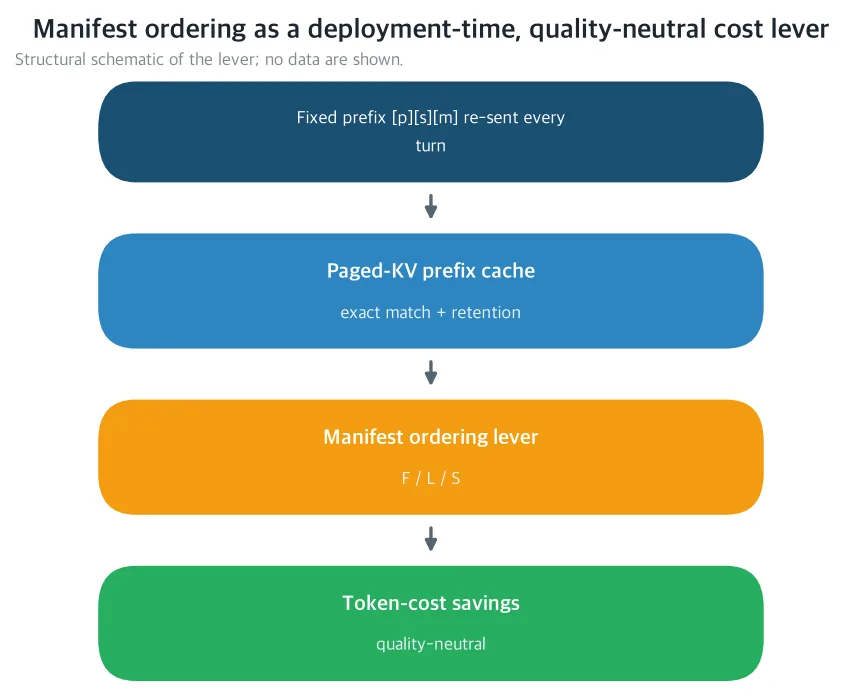 고정 prefix, 즉 시스템 프롬프트와 툴 스키마, 스킬 매니페스트는 매 턴 다시 보내집니다. 이 순서가 prefix cache 재사용, 곧 재전송 비용을 정합니다. 구조 개념도로 데이터는 표시하지 않았습니다.
닫힌 형태로 유도한 가격
이 논문은 이 순서의 가격을 닫힌 형태로 유도합니다. 서빙 인스턴스 하나에 K개 루프가 동시에 도는 구조이고 매 턴 입력은 고정 prefix에 턴이 갈수록 자라는 작업 맥락이 붙습니다. 재사용은 0번 토큰부터 똑같은 prefix에 대해서만 성립합니다. 캐시 밀림은 지수 형태로 모델링합니다. 블록이 마지막으로 쓰인 지 오래될수록 살아남을 확률이 지수로 줄고 그 시간 척도는 KV 캐시 용량을 새로 들어오는 토큰 속도로 나눈 τ입니다.
여기에 공유 접근 전제가 더 붙습니다. 한 블록을 q개 루프가 함께 쓰면, 그 블록은 q분의 1 간격마다 만져져 밀림 확률이 그만큼 느려집니다. K개 루프가 쓰는 prefix는 그만큼 오래 선반에 남는다는 뜻입니다.
순서는 세 가지로 비교합니다. F는 전역 빈도 우선 순서입니다. 모든 루프가 같은 순서를 쓰고 스킬 레지스트리 편집이 있는 때를 제외하면 시간에 따라 안정적입니다. L은 루프별 최근 사용 순서입니다. 루프 안에서는 안정적이지만 루프끼리는 갈라지고 보통 맨 위에 하나만 일치합니다. S는 매 턴 무작위 섞기 대조군입니다.
정상 상태 히트율, 즉 입력 토큰 중 캐시에서 서빙된 비율은 세 배열에서 뚜렷이 갈립니다. F에서는 고정 prefix 전체가 공유 prefix가 됩니다. K개 루프가 함께 만지므로 밀림 속도가 개인용의 K분의 1로 느려집니다. L에서는 매니페스트가 루프마다 달라, 공유는 시스템 프롬프트와 툴 스키마로 끝납니다. S는 정적인 머리 부분에만 붙습니다. 섞인 매니페스트가 작업 맥락 앞에 서기 때문에, 자기 바로 앞 턴의 맥락조차 다시 닿지 못합니다.
이 구조에서 유도되는 결과는 여섯 가지입니다. 첫 번째, 공유 격차입니다. F와 L의 히트율 차이는 매니페스트 길이에 정비례하고 K가 크고 턴 간격이 길수록 벌어집니다. 이 차이가 0이 되는 경우는 매니페스트가 비거나, 루프가 하나뿐이거나, 턴 간격이 거의 없을 때뿐입니다.
두 번째, 공유 수명입니다. F에서 고정 prefix의 유효 수명은 개인용 캐시의 K배, 즉 Kτ로 늘어납니다. 공유 히트율이 정상의 δ배로 떨어지는 턴 간격도 이 Kτ에 정비례합니다. 세 번째, 손익분기 3중입니다. F가 L보다 이득이 시작되는 간격, 정점에 이르는 간격, 다시 잦아드는 간격이 각각 유도됩니다. 셋 다 τ에 정비례합니다. KV 캐시가 클수록, 즉 H200급인수록, 모든 손익분기 간격이 용량 비율만큼 뒤로 밀려납니다.
넷째, 재전송 계수입니다. F 아래에서 캐시된 매니페스트를 한 번 더 보내는 비용은, 처음부터 새로 계산하는 비용에 계수 q를 곱한 것입니다. q는 공유 블록이 턴 간격을 버티고 있으면 캐시 단가, 밀려났으면 미캐시 단가에 이르기까지, 간격에 따라 그 사이를 오갑니다. 기준 구성에서는 한 시간 이내 간격에서 재전송 한 번이 새 프리필(prefill)의 10분의 1에서 5분의 3 사이입니다.
다섯째, 안정성 우선 배치입니다. 매니페스트의 j번째 스킬 설명을 수정하면, 그 뒤의 토큰 전체가 무효화되고 모든 루프가 다음 턴에 다시 계산해야 합니다. 자주 수정되는 스킬을 매니페스트 끝으로 몰아두면, 수정 한 바퀴의 기대 무효화량은 무작위 배치의 약 N분의 1로 줄어듭니다. N은 스킬 수입니다. 논문이 주는 합성 규칙은 이렇습니다. 안정적인 핵심은 접근 빈도순으로, 자주 바뀌는 꼬리는 변동성순으로 배치하는 것입니다.
여섯째, 이 레버는 다른 레버와 곱셈으로 합성됩니다. 모델 티어와 KV 양자화는 모든 비용 층의 단가를, 생각 토큰 배분은 생각 층을, 매니페스트 순서는 고정 prefix 층만 만집니다. 층이 겹치지 않으므로 세 레버는 곱셈으로 합성되고 위치 민감성이 유한하다는 전제 아래에서 순서는 품질 중립입니다. 비용 스택의 가장 안전한 첫 달러이자, 학습과 엔진 변경이 전혀 없는 유일한 레버입니다.
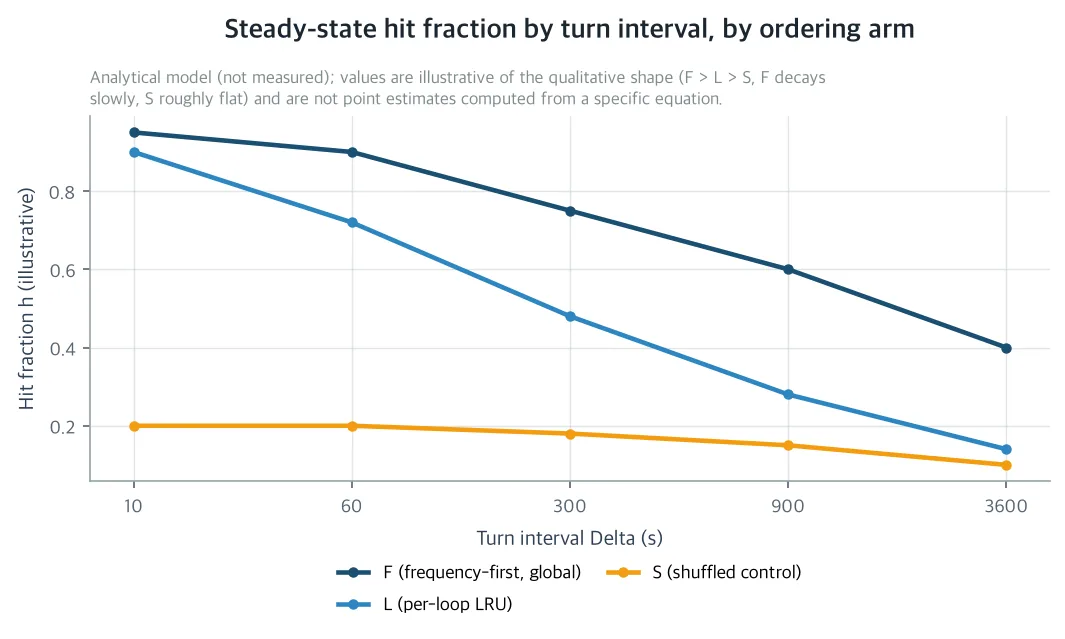 턴 간격별 정상 상태 히트율을 세 배열별로 그린 곡선입니다. F가 공유 prefix를 가장 오래 지키고 L은 빠르게 줄며 S는 정적인 머리 부분에서 멈춥니다. 해석 모델의 곡선이며 실측이 아닙니다.
H200 기준 구성에서 나온 예측
모든 수치는 명시된 전제 하의 모델 예측입니다. 기준 구성은 14B와 32B 모델을 H200(141GB)과 H100(80GB)에 올린 네 조합입니다. HBM에서 가중치와 런타임 오버헤드를 빼면, 14B에서는 H200이 H100보다 KV 캐시를 2.3배 더 가집니다.
32B에서는 가중치가 64GB라 H100의 작은 HBM에서 차지하는 비중이 커지고, 용량 격차는 6.1배로 벌어집니다. 밀림 시간 τ도 이 격차를 그대로 반영합니다. 같은 경쟁 조건에서 14B/H200은 277초, 32B/H100은 23초입니다. 즉, 사람 말로는 H200의 큰 메모리가 선반을 넓히는 것과 같습니다. 14B 교재에서는 2.3배, 32B 교재에서는 6.1배 넓은 선반이 됩니다.
Δ=900초, K=16, 매니페스트 6,000토큰 기준에서 14B/H200의 히트율은 F가 6할, L이 2할, S는 2할도 못 됩니다. F의 우위는 공유 수명에서 옵니다. 14B/H200의 K=16에서 공유 수명은 4,432초, 즉 74분입니다. 한 시간 툴 지연은 이 수명 안에 여유 있게 들어갑니다. L은 각 루프의 매니페스트가 개인용으로 밀리므로 이 수명의 혜택을 받지 못합니다. S는 정적인 머리 부분에서만 버티고 그 상한은 입력의 약 5분의 1입니다.
비용으로 보면, 토큰 과금 레짐 A에서 F는 S의 입력 비용보다 12~89%를 아낍니다. 절감은 큰 매니페스트와 중간 턴 간격에서 가장 넓습니다. 매니페스트 16,000토큰 이상에서는 Δ=300~900초 구간에 60~80%를 유지하고, Δ=3,600초에서도 3할 이상으로 남습니다. L과의 비교는 더 선명합니다. L의 매니페스트는 개인용으로 밀리지만 F의 매니페스트는 공유로 버티기 때문에, Δ=900초에서 절감이 44.5~67.2%까지 벌어집니다.
네 구성의 대비를 모으면 아래 표가 됩니다. 같은 Δ=900초, K=16, 매니페스트 6,000토큰 조건입니다.
| 구성 | 밀림 시간 τ(초) | F 히트율 | L 히트율 | S 히트율 | 절감(F 대 S) |
|---|---|---|---|---|---|
| 14B/H200 | 277 | 0.610 | 0.197 | 0.166 | 46.3% |
| 14B/H100 | 122 | 0.463 | 0.129 | 0.128 | 33.6% |
| 32B/H200 | 139 | 0.491 | 0.137 | 0.136 | 35.9% |
| 32B/H100 | 23 | 0.063 | 0.017 | 0.017 | 4.1% |
Δ=900초, K=16, 매니페스트 6,000토큰, 12턴 태스크 조건에서 나온 모델 예측이며 실측이 아닙니다.
같은 레버가 H200+14B에서는 46.3%의 절감을 붙이고 H100+32B에서는 4.1%에 머무릅니다. 11배 차이는 순서가 아니라, KV 캐시 용량 비율에서 옵니다. 32B/H200은 35.9%로 중간입니다. 14B/H100의 33.6%와 가까운 이유는, 두 구성의 밀림 시간이 모두 100초대 중반이기 때문입니다.
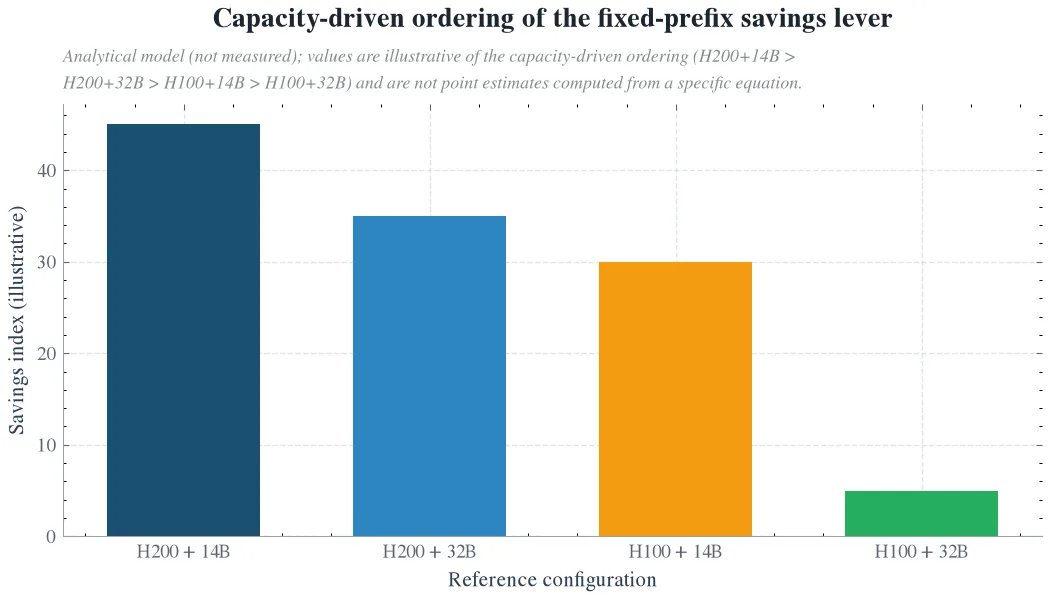 KV 캐시 용량이 밀림 시간을 정하므로, 같은 순서 레버가 H200+14B에서는 H100+32B보다 값이 큽니다. 용량 비율만으로 벌어지는 차이입니다. 해석 모델의 그래프로 실측이 아닙니다.
셀프호스티드 레짐 B에서는 절감의 모양이 달라집니다. 여기에서 절감은 벽 시간 중 프리필이 차지하는 비율로 상한이 잡힙니다. Δ=10초에서 매니페스트 48,000토큰이 45.8%를 아끼는 반면, Δ=3,600초에서는 0.1%까지 줄어듭니다. 즉, 사람 말로는 셀프호스티드에서 이 레버의 값은 청구서 줄이 아니라, 첫 토큰 지연 헤드룸으로 돌아옵니다. 같은 SLO에서 같은 인스턴스에 더 많은 루프를 올릴 수 있게 됩니다.
손익분기 3중도 같은 조건에서 나옵니다. 14B/H200, K=16에서 F가 L을 이기기 시작하는 간격은 15초, 정점은 820초, 잦아드는 지점은 10,212초입니다. K=64에서는 잦아드는 지점이 40,850초로, 한 시간 툴 지연이 공유 수명 안에 여유 있게 들어갑니다. 32B/H100은 다릅니다. 밀림 시간이 23초라 시작은 1초, 정점은 68초입니다. F의 우위는 툴 지연의 첫 1분 안에만 존재합니다.
이 레버가 회사에 남기는 것은 상시 비용 항목입니다. 무인 스킬 플릿 루프의 입력 토큰 지출을 학습과 엔진 변경 없이 줄이고 우리 에이전트 트레이스로 H200에서 끝까지 재볼 수 있습니다. 사회적으로는 자율 태스크 하나당 들어가는 추론 비용과 에너지를 줄입니다. 프리필을 건너뛰면 GPU 초가 줄고, 에너지는 GPU 초에 거의 붙어 있기 때문입니다. 24시간 도는 무인 자동화는 소규모 조직도 감당할 수 있게 됩니다. 과학적으로는 구조화된 에이전트 워크로드의 prefix cache economics를 처음 계산한 것입니다. 모델 티어와 양자화라는 축 너머로, 에이전트 설계라는 축을 LLM 비용 최적화 문헌에 더합니다.
운영 규칙으로 읽으면
첫째로, 매니페스트 순서는 전역 접근 빈도순으로 고정돼야 합니다. 공유 prefix가 K개 루프의 합집합으로 버티려면, 모든 루프가 같은 순서를 써야 합니다. 매니페스트의 내용은 라우터가 정하지만 순서만은 운영자가 당길 수 있는 레버입니다.
둘째로, 자주 바뀌는 스킬은 매니페스트 끝으로 몰아두어야 합니다. 수정이 오면 그 뒤의 토큰만 무효화되고 꼬리에 몰아두면 무효화량은 전체의 약 N분의 1로 줄어듭니다. 안정된 핵심은 빈도순, 꼬리는 변동성순이라는 합성 규칙입니다.
셋째로, 우리 인스턴스의 τ를 먼저 재야 합니다. τ는 KV 캐시 용량을 새로 들어오는 토큰 속도로 나눈 값입니다. 선반이 좁으면 교재가 먼저 밀려나는 것과 같습니다. 머신과 트래픽마다 레버의 유효 범위가 다릅니다. KV 캐시 여유가 작은 머신, 또는 턴 간격이 긴 루프에서는 레버가 이미 소진됐을 수 있습니다.
넷째로, 셀프호스티드에서는 절감의 값을 첫 토큰 지연 헤드룸으로 읽어야 합니다. F의 높은 히트율은 태스크당 GPU 업무를 빼 주고 같은 SLO에서 같은 인스턴스에 더 많은 루프를 올립니다.
다섯째로, 절감을 세기 전에 위치 민감성을 재야 합니다. 순서 변경이 태스크 결과를 바꾸는 비율만큼, 절감에서 차감해야 합니다. 이 논문의 검증 프로토콜은 이 차감을 미리 설계해 둡니다. 전용 H200에서 F, L, S 세 배열과 캐시 끄기, 매니페스트 없애기 두 대조를 돌리고 같은 태스크를 배열끼리 짝지어 성공이 맞는지 확인하는 품질 게이트를 둡니다.
못 믿을 부분
이 논문은 분석 논문임을 명시합니다. 본문에 실린 모든 숫자는 전제 A1부터 A8까지의 모델 예측이며, 실측은 하나도 없습니다. 대신 전제 하나하나에 해당하는 검사를 둔 트레이스 재실행 프로토콜을 지정해, 예측이 실측으로 바뀌는 문을 열어 둡니다.
첫째, 품질 중립은 전제이지 증명이지 않습니다. 장문 컨텍스트 모델은 긴 입력의 중간에 놓인 정보에서 성능이 떨어집니다. 이 논문도 그 한계를 인용해, 순서 변경이 태스크 결과를 바꿀 가능성을 전제로 합니다. 매니페스트가 48,000토큰이면 입력의 절반을 넘습니다. 절감이 가장 큰 곳에서, 품질 전제가 가장 강하게 물리는 구조입니다. 그래서 절감은 실측 위치 민감성만큼 차감한 뒤에만 쓰여야 합니다.
둘째, 모든 결과는 단일 인스턴스 범위입니다. K개 루프를 공유하는 서빙 인스턴스 하나에 대한 것이고 플릿은 인스턴스별로 다른 τ를 가진 인스턴스로 쪼개집니다. 라우팅과 배치 레버는 이 모델 아래에서 도는 것입니다.
셋째, 밀림 모델은 근사입니다. τ를 용량 대 유입 비율로 잡는 지수 밀림은 최근 사용 밀림의 평균 장 근사이며, 인스턴스별로 보정해야 하는 값입니다.
넷째, 재사용은 0번 토큰부터 똑같은 prefix에 대해서만 성립합니다. 위치 독립 재사용은 KV 캐시 하이재킹이 시연된 확장입니다. 이 모델은 그 히트를 세지 않습니다. 반대로 순서 레버는 턴 안의 토큰을 어디에도 옮기지 않으므로, 이 긴 prefix 의미론 안에서 안전한 것입니다.
끝으로, 셀프호스티드 달러 값은 벽 시간의 프리필 점유율로 상한이 잡힙니다. 툴 지연이 길수록 청구서 절감은 얇아지고 가치는 헤드룸으로 옮겨갑니다.
이 글의 수치는 모두 명시된 전제 하의 해석 모델 예측이며 실측이 아닙니다. 세 장의 그림도 개념도와 해석 곡선이며 데이터가 담겨 있지 않습니다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Manifest Order: Measuring KV-Cache Prefix Reuse and Token Cost Savings from Skill-Manifest and Tool-Schema Ordering in Unattended Agentic Loops on H200
 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
