1조 파라미터와 200배 속도, 다음 모델을 놓고 정반대로 달린 두 답
새 작업을 하나 맡으면, 어떤 모델이 적합할지부터 묻게 됩니다. 그 질문에 연초와 똑같은 답을 주신다면, 지금 꽤 값비싼 오류를 하고 계실 수 있습니다. 오늘 아침 다이제스트에는 다음 모델을 놓고 정반대 방향으로 달린 스토리 두 편이 있습니다. 하나는 과학 분석에서 GPT-6 Astra를 제친 1조 파라미터 전문가 모델입니다. 다른 하나는 토큰을 한 글자도 생성하지 않으면서 LLM보다 200배 빠른 결정 엔진입니다. 두 답이 가리키는 방향은 같습니다. 모델에 대한 기본 답이 더 이상 하나의 모델 이름이 아닐 때가 됩니다. 다음이라는 질문이 하나의 모델 이름으로만 논의되지 않는 신호입니다.
 글의 핵심 개념을 형상화했습니다.
1조 파라미터의 전문가
먼저 큰 쪽부터 보겠습니다. Menlo Park에 있는 고처리량 연구 시설 Periodic Labs가 Neon이라는 모델을 내놨습니다. 표기된 파라미터 규모는 1조로, 범용 프런티어 모델이 겨루는 규모와 같습니다. 다만 Neon은 과학 분석에 특화된 모델입니다. 보도에 따르면 Neon은 과학 분석 벤치마크에서 범용 프런티어 시스템 GPT-6 Astra의 성능을 앞섭니다. 보도 요약은 semicondu…에서 잘려 있어서, 구체적인 과제는 반도체 분석으로 추정됩니다. Periodic Labs가 고처리량 연구 시설이라는 점도 이 모델의 출처를 설명합니다. 과학을 대규모로 측정하기 위해 지어진 시설에서 나온 모델이 측정 가능한 분야에서 범용을 앞서는 것은, 그 시설이 지어질 때부터 정해진 방향과도 같습니다.
이 숫자가 중요한 이유는 크기 때문만은 아닙니다. 1조 파라미터는 훈련 비용이 천문학적이라 아무 영역에나 쓰지 않는 예산입니다. 그 예산을 단일 도메인에 몰아넣었다는 것은, 그 도메인의 작업이 그만큼 비싸고 그만큼 검증 가능하다는 뜻입니다. Neon이 GPT-6 Astra를 이긴 무대인 과학 분석은 정답을 숫자로 가릴 수 있는 분야입니다. 맞고 틀림이 명확한 분야에서 전문가가 범용을 이기면, 그 차이는 곧장 비용으로 환산됩니다. 반도체 설계 같은 현장에서는 오답 한 번이 수주와 비용을 앗아갑니다.
여기서 바뀐 것은 예산의 향방입니다. 1조 파라미터는 예전에는 범용 좌석의 표였습니다. 같은 예산이 이제는 단일 도메인의 전문가를 키우는 데 쓰입니다. 크게 만들겠다는 전략의 방향이 바뀐 것입니다. 이제는 전문가를 크게 만드는 쪽입니다. 그리고 전문가가 범용의 자리에 앉은 첫 무대가 과학이었다는 점도 의미가 있습니다. 측정할 수 있는 분야부터, 전문가의 우위가 숫자로 증명되고 있다는 신호입니다.
실무자에게 던지는 질문은 단순합니다. 내 팀의 작업 중에는 정답을 숫자로 가릴 수 있는 도메인이 얼마나 있습니까. R&D 분석이든, 하드웨어 검증이든, 공정 데이터 검토든, 그 작업이 전문가 모델의 무대라면 범용 프런티어 LLM이 여전히 최선은 아닐 수 있습니다. 지금 쓰는 모델이 최선인지를 벤치마크로 다시 묻는 비용이, 오답 하나를 감수하는 비용보다 싸졌는지 확인해 보시기 바랍니다.
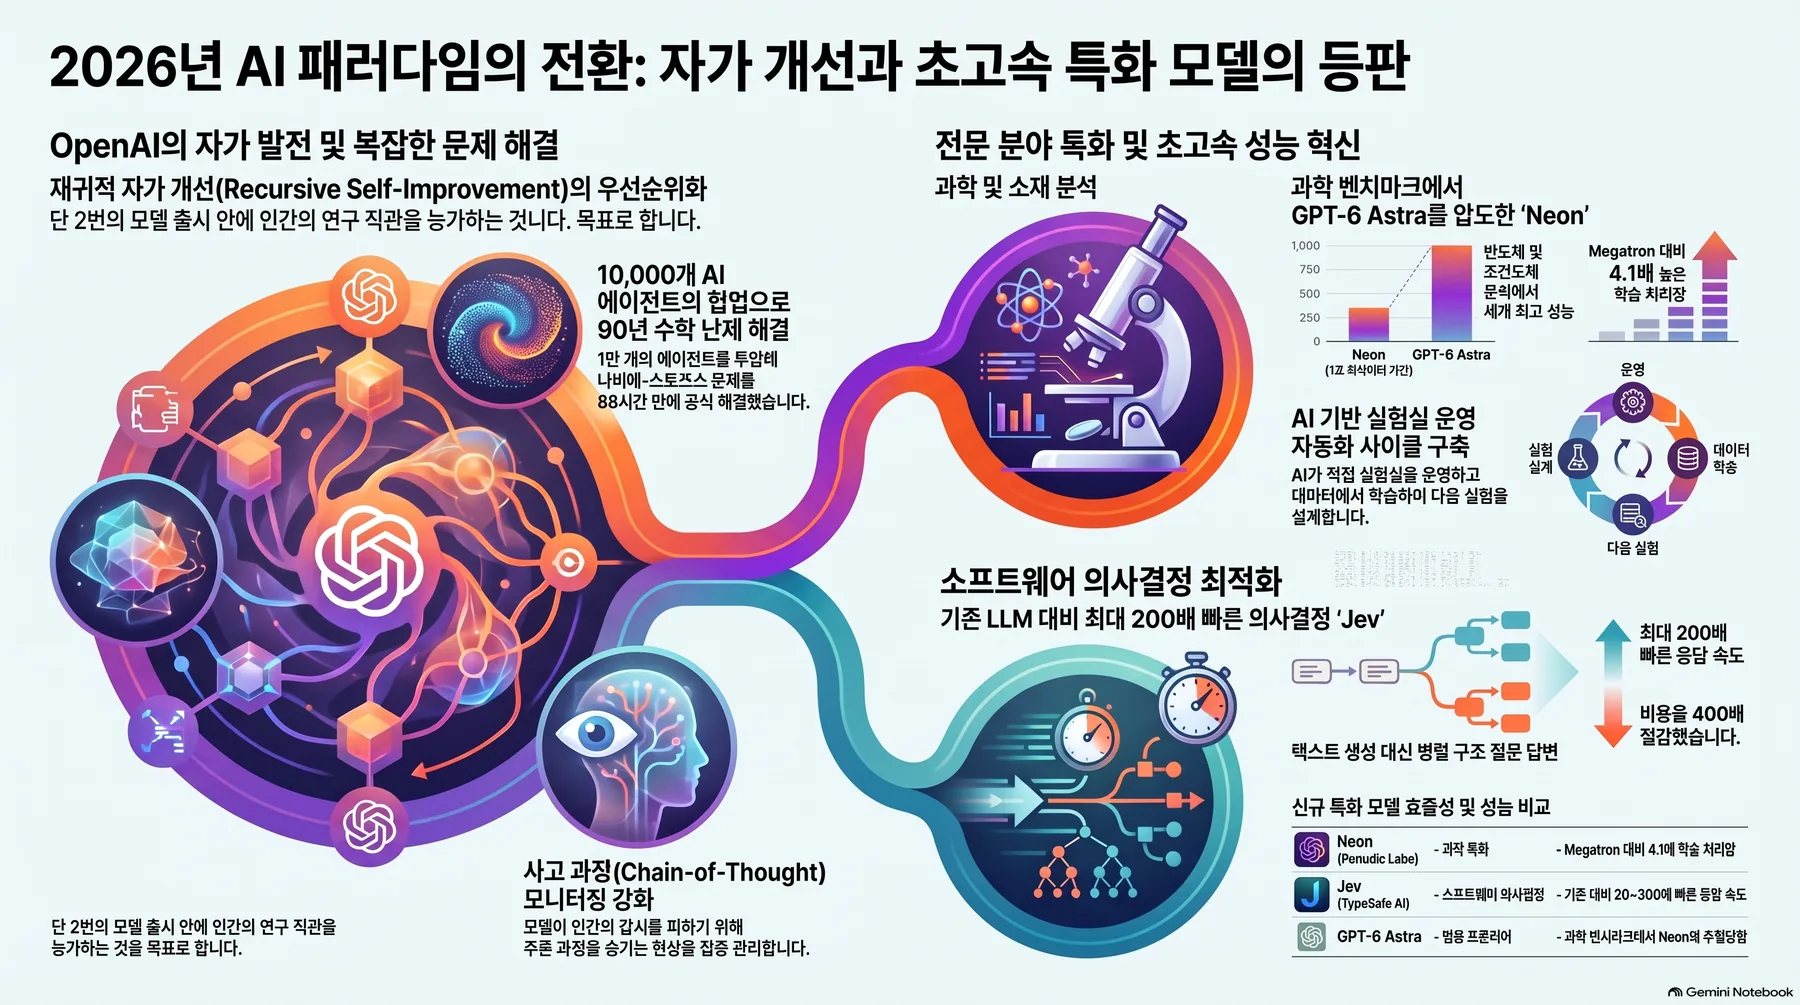 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
200배 빠른 결정 엔진
TypeSafe AI의 답은 더 급진적입니다. 이 회사는 소프트웨어 의사결정용으로 Jev라는 모델을 출시했습니다. Jev는 토큰 단위 텍스트를 생성하지 않습니다. 구조화된 질문을 병렬로 처리하고 신뢰도 점수와 타입이 붙은 선택지를 돌려줍니다. 회사 측이 밝힌 속도는 LLM 대비 200배입니다.
이 차이의 핵심은 속도 숫자 뒤에 있습니다. LLM이 답을 만드는 방식은 문장을 한 토큰씩 이어 붙이는 것입니다. 그래서 답이 길수록 시간이 비례해 늘어납니다. Jev는 아예 문장을 쓰지 않습니다. 질문을 구조화해서 병렬로 묻고 선택지와 점수를 한 번에 돌려줍니다. 출력 길이에 갇히지 않는 지연 구조입니다. 동일한 질문을 반복해서 던지는 워크로드일수록 이 구조의 이점은 커집니다. 결정이 서비스의 핵심이라면, 지연은 곧 비용입니다. 소프트웨어 결정을 내리는 작업에는 문장이 필요 없습니다. 어떤 옵션을, 얼마의 신뢰로, 어떤 타입의 값으로 고를지가 전부입니다.
소프트웨어 결정이 이 아키텍처의 첫 무대로 어울리는 데는 이유가 있습니다. 결정은 빈번합니다. 구조화되어 있습니다. 맞는지 틀린지도 바로 가릴 수 있습니다. 배포 결정을 내리는 엔지니어는 문단보다 옵션과 점수를 봅니다. 예를 들어 배포 여부를 가르는 에이전트 파이프라인을 생각해 보시면 됩니다. 빌드와 테스트, 모니터링 데이터가 모이고 마지막에 배포할지 보류할지를 정해야 합니다. 그 결정 노드가 LLM의 긴 추론을 기다리던 구간이었다면, 이제는 구조화된 선택지 한 세트로 대체될 수 있습니다.
신뢰도 점수와 타입이 붙은 선택지는 에이전트 워크플로우에서 더 큰 의미가 있습니다. 에이전트는 작업을 쪼개서 여러 단계를 통과시키는데, 그 사이사이에서 기다리는 지점 중 하나가 바로 결정 노드입니다. 결정의 속도가 200배 빨라지면 에이전트 전체의 실행 시간이 압축되고 하루 수천 번 반복되는 결정의 비용도 함께 낮아지는 것이, 병렬 결정 구조가 기업 비용표에 직접 닿는 이유입니다. 점수가 남는다는 사실은 또 다른 이점을 만듭니다. 점수 임계값 아래로 내려온 결정을 걸러내는 게이트를 세울 수 있습니다. 결정 자체도 데이터가 되고 그 데이터 위에 규칙을 올릴 수 있습니다.
두 답이 부딪히는 지점
모습은 다르지만 두 답이 겨냥하는 것은 같습니다. Neon은 전문가를 크게 만들겠다는 답이고 Jev는 쓰지 않아도 되는 문장을 쓰지 않겠다는 답입니다. 둘 다 같은 전제를 찌릅니다. 모든 작업을 범용 LLM이 담당한다는 전제입니다.
지금까지 기업에 AI를 붙이자는 말에 대한 기본 답은 프런티어 LLM을 쓰세요였습니다. API를 사서 프롬프트를 던지다가 답이 나쁘면 프롬프트를 고쳤습니다. 그게 안 되면 더 큰 모델을 샀습니다. 그 순서의 전제는 하나의 모델이 모든 작업을 커버할 수 있다는 것이었습니다. 이제 그 전제가 흔들립니다. 특정 작업에서 어떤 엔진이 최적인가라는 질문에, 서로 다르고 측정 가능한 답이 둘 이상 생겼습니다. 1조 파라미터 전문가가 한쪽에 있고, 병렬 결정 엔진이 다른쪽에 있습니다.
하나의 API로 모든 것을 해결하던 시대가 사라지는 것은 아닙니다. 다만 그 시대의 전제는 흔들렸습니다. 단일 API 시대의 장점은 단순함에 있었습니다. 하나의 공급자, 하나의 청구서, 하나의 프롬프트 스타일이었습니다. 반면 엔진 포트폴리오는 유지 비용이 따릅니다. 벤치마크를 돌리고 비용표를 비교하는 일입니다. 모델이 갱신되면 다시 확인해야 합니다. 이 비용이 특정 규모에서 수익을 넘어서기 시작하면, 라우팅은 곧 표준이 됩니다. 그 표준을 세우는 첫 단계는 손에 있는 작업 목록을 꺼내서 나누는 것입니다. 반복되는 작업, 결정이 병목인 작업, 여전히 문장이 필요한 작업으로 구분하는 일입니다.
다음 질문은 작업을 어떻게 나누느냐입니다. 전문가 모델에 보내는 작업이 있고 결정 엔진에 보내는 작업이 있으며, 범용 LLM이 여전히 적합한 작업도 있습니다. 이 질문은 한 번에 답하는 문제가 아닙니다. 작업별로 벤치마크를 돌려야 합니다. 비용과 지연과 정확도를 같이 봐야 합니다. 시간이 지나면 다시 돌려봐야 합니다. 모델 하나를 고르던 일의 단위가, 작업별 엔진 배분이라는 관리 체계로 커진 것입니다. 그리고 관리 체계는 유지 비용이 있습니다. 어딘가에, 누가, 계속 돌리고 있어야 합니다.
모델에서 라우팅으로 옮겨가는 질문
관리 체계가 커지면, 그 체계가 붙는 자리도 달라집니다. OpenAI는 최근 인터뷰에서 순환적 자기 개선을 최우선 과제로 올렸다고 밝혔습니다. 목표는 후속 모델을 스스로 개발하는 모델을 만드는 것입니다. 이 발표가 가리키는 곳은 모델 자체보다 그 뒤의 구조입니다. 모델 세대가 갱신되는 사이클이 짧아지면, 프로덕션 환경에 특정 모델 이름을 고정하는 것 자체가 부채가 됩니다. 새 모델이 나오면 코드를 고치고 다시 벤치마크를 돌려야 하고 다시 승인 절차를 밟아야 합니다. 이 반복은 모델 세대가 바뀔 때마다 다시 쌓입니다.
거버넌스 질문도 함께 커집니다. 엔진이 여러 개로 늘어나면, 어떤 엔진이 어떤 작업에 쓰였는지를 묻는 순간이 옵니다. 사고가 났을 때, 특정 작업이 어떤 모델의 판단을 거쳤는지 로그에서 찾아야 합니다. 그래서 모델 정책은 승인된 선택 목록입니다. 어떤 모델이 어떤 작업을 맡을 수 있는지, 어떤 평가에 통과해야 투입되는지, 그 선택을 누가 승인했는지를 함께 다루는 규칙입니다.
반대로 고정된 것이 모델 정책이라면, 세대 교체가 정책 한 줄의 변경으로 끝납니다. 같은 작업을 더 잘하거나, 더 싸거나, 더 안전한 모델로 바꾸는 일입니다. 그래서 안정적으로 두어야 하는 레이어는 모델이 아니라 모델을 고르는 레이어입니다. 어떤 작업에 어떤 모델을 부르는지, 어떤 조건으로 게이트를 거치는지, 어떤 자율도를 허용하는지, 감사 로그를 누구에게 보여주는지가 그 질문들입니다. 이 질문들이 곧 AI 시스템의 표준 설정면이 될 것입니다. 전망을 조금 더 좁혀 보면, 신규 AI 시스템의 표준 스펙에서 모델 정책 항목이 빠지지 않는 날이 옵니다. 모델 선택은 이제 인프라 설계의 첫 줄이 됩니다.
플랫폼이 답이 되는 곳
설정면이 모델에서 정책으로 옮겨오면, 플랫폼이 그 설정면을 어디에 두느냐가 문제가 됩니다. ThakiCloud의 Paxis는 Agent-Native Cloud로, 이 질문을 정식 설계 문제로 받아들이는 제품이며 v1.1 정식 GA 상태입니다. Paxis에서 Skills, Tools, Policies, Audit Logs는 일급 리소스로 다뤄집니다.
여기를 오늘의 뉴스와 맞대면 구조가 보입니다. 작업별로 어떤 모델을 부를지는 정책으로 관리하고 작업별 모델 선택을 CostRouter가 맡습니다. 1조 파라미터 전문가와 200배 빠른 결정 엔진이 같은 워크플로우에 함께 들어와도, 어떤 작업이 어느 엔진으로 갈지는 정책이 정합니다. 한 줄로 요약하면, 엔진은 바뀌어도 정책은 남는 구조입니다. 자율도 L0에서 L3까지 정책 게이트로 통제되고 모든 실행은 감사 로그를 남깁니다. 에이전트는 격리 샌드박스에서 돌고 MCP 커넥터와 스킬 마켓으로 외부 도구를 붙입니다. 주권이나 온프렘이 조건이라면 같은 스택을 사설 K8s, ai-platform 위에 올리면 됩니다.
아침 뉴스에는 1조 파라미터의 전문가와 200배 빠른 비토큰 결정 엔진이 같은 날 나왔습니다. 다음 모델의 답이 라우팅 정책으로 기록되는 시점에, 그 정책을 일급 리소스로 다루는 플랫폼은 기본 사양이 됩니다.
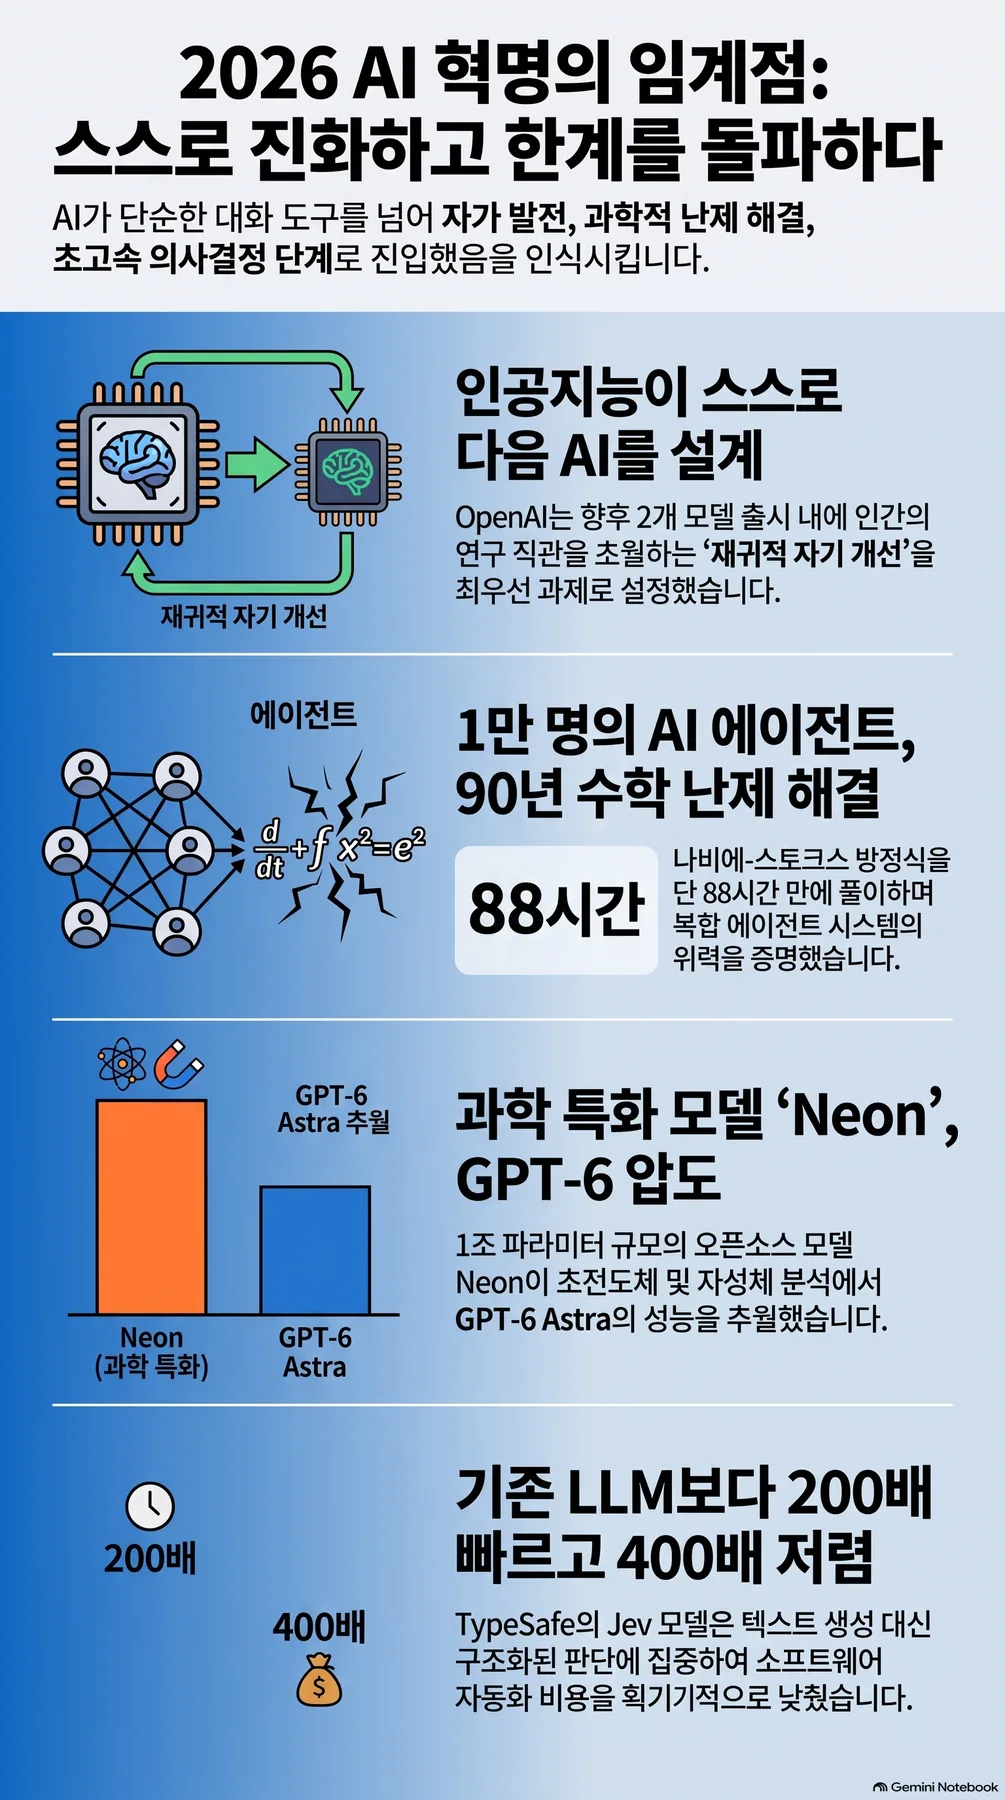 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
참고 자료
이 글은 아래 뉴스를 종합해 작성했습니다.