The Language Wall: 한국어 query가 영어 레지스트리에 닿는 날, 어떤 fusion weight도 치울 수 없는 total wall과 세 가지 고치기의 cost-quality frontier
대규모 skill 카탈로그를 자연어 호출 가능한 스킬로 제공하는 LLM agent harness를 돌리거나, 그 아래 검색·라우팅 레이어를 운영하는 국내 클라우드/AI 엔지니어라면 이 글을 먼저 읽어야 합니다. 이 논문이 답하는 질문은 단순합니다. 한국어 query가 영어 registry에 닿을 때 hybrid skill routing의 정확도가 얼마나 떨어지고 translation detour / multilingual embedder swap / bilingual descriptions 세 가지 표준 고치 중 어떤 것이 route당 토큰 비용을 가장 적게 쓰며 정확도를 회복하는가. ThakiCloud의 논문 “The Language Wall: A First-Order Margin Model of Cross-Lingual Skill Routing and the Cost-Quality Frontier of Translation Detours versus Multilingual Embedders in an Agent Harness with ~2,200 Skills”는 그 저하를 closed form의 first-order margin model로 형식화하고 anchor가 없는 query에 대해서는 어떤 fusion weight도 치울 수 없는 total wall을 도출합니다. 이전 논문과 마찬가지로 분석 논문이라는 뜻입니다. 모델과 frontier가 closed form이고 그 예측을 측정으로 채우는 pre-registered hypotheses 다섯 개를 지닌 deterministic paired-variant 프로토콜이 함께 등록되어 있습니다.
문제의식: hybrid router가 외면해 온 언어 장벽
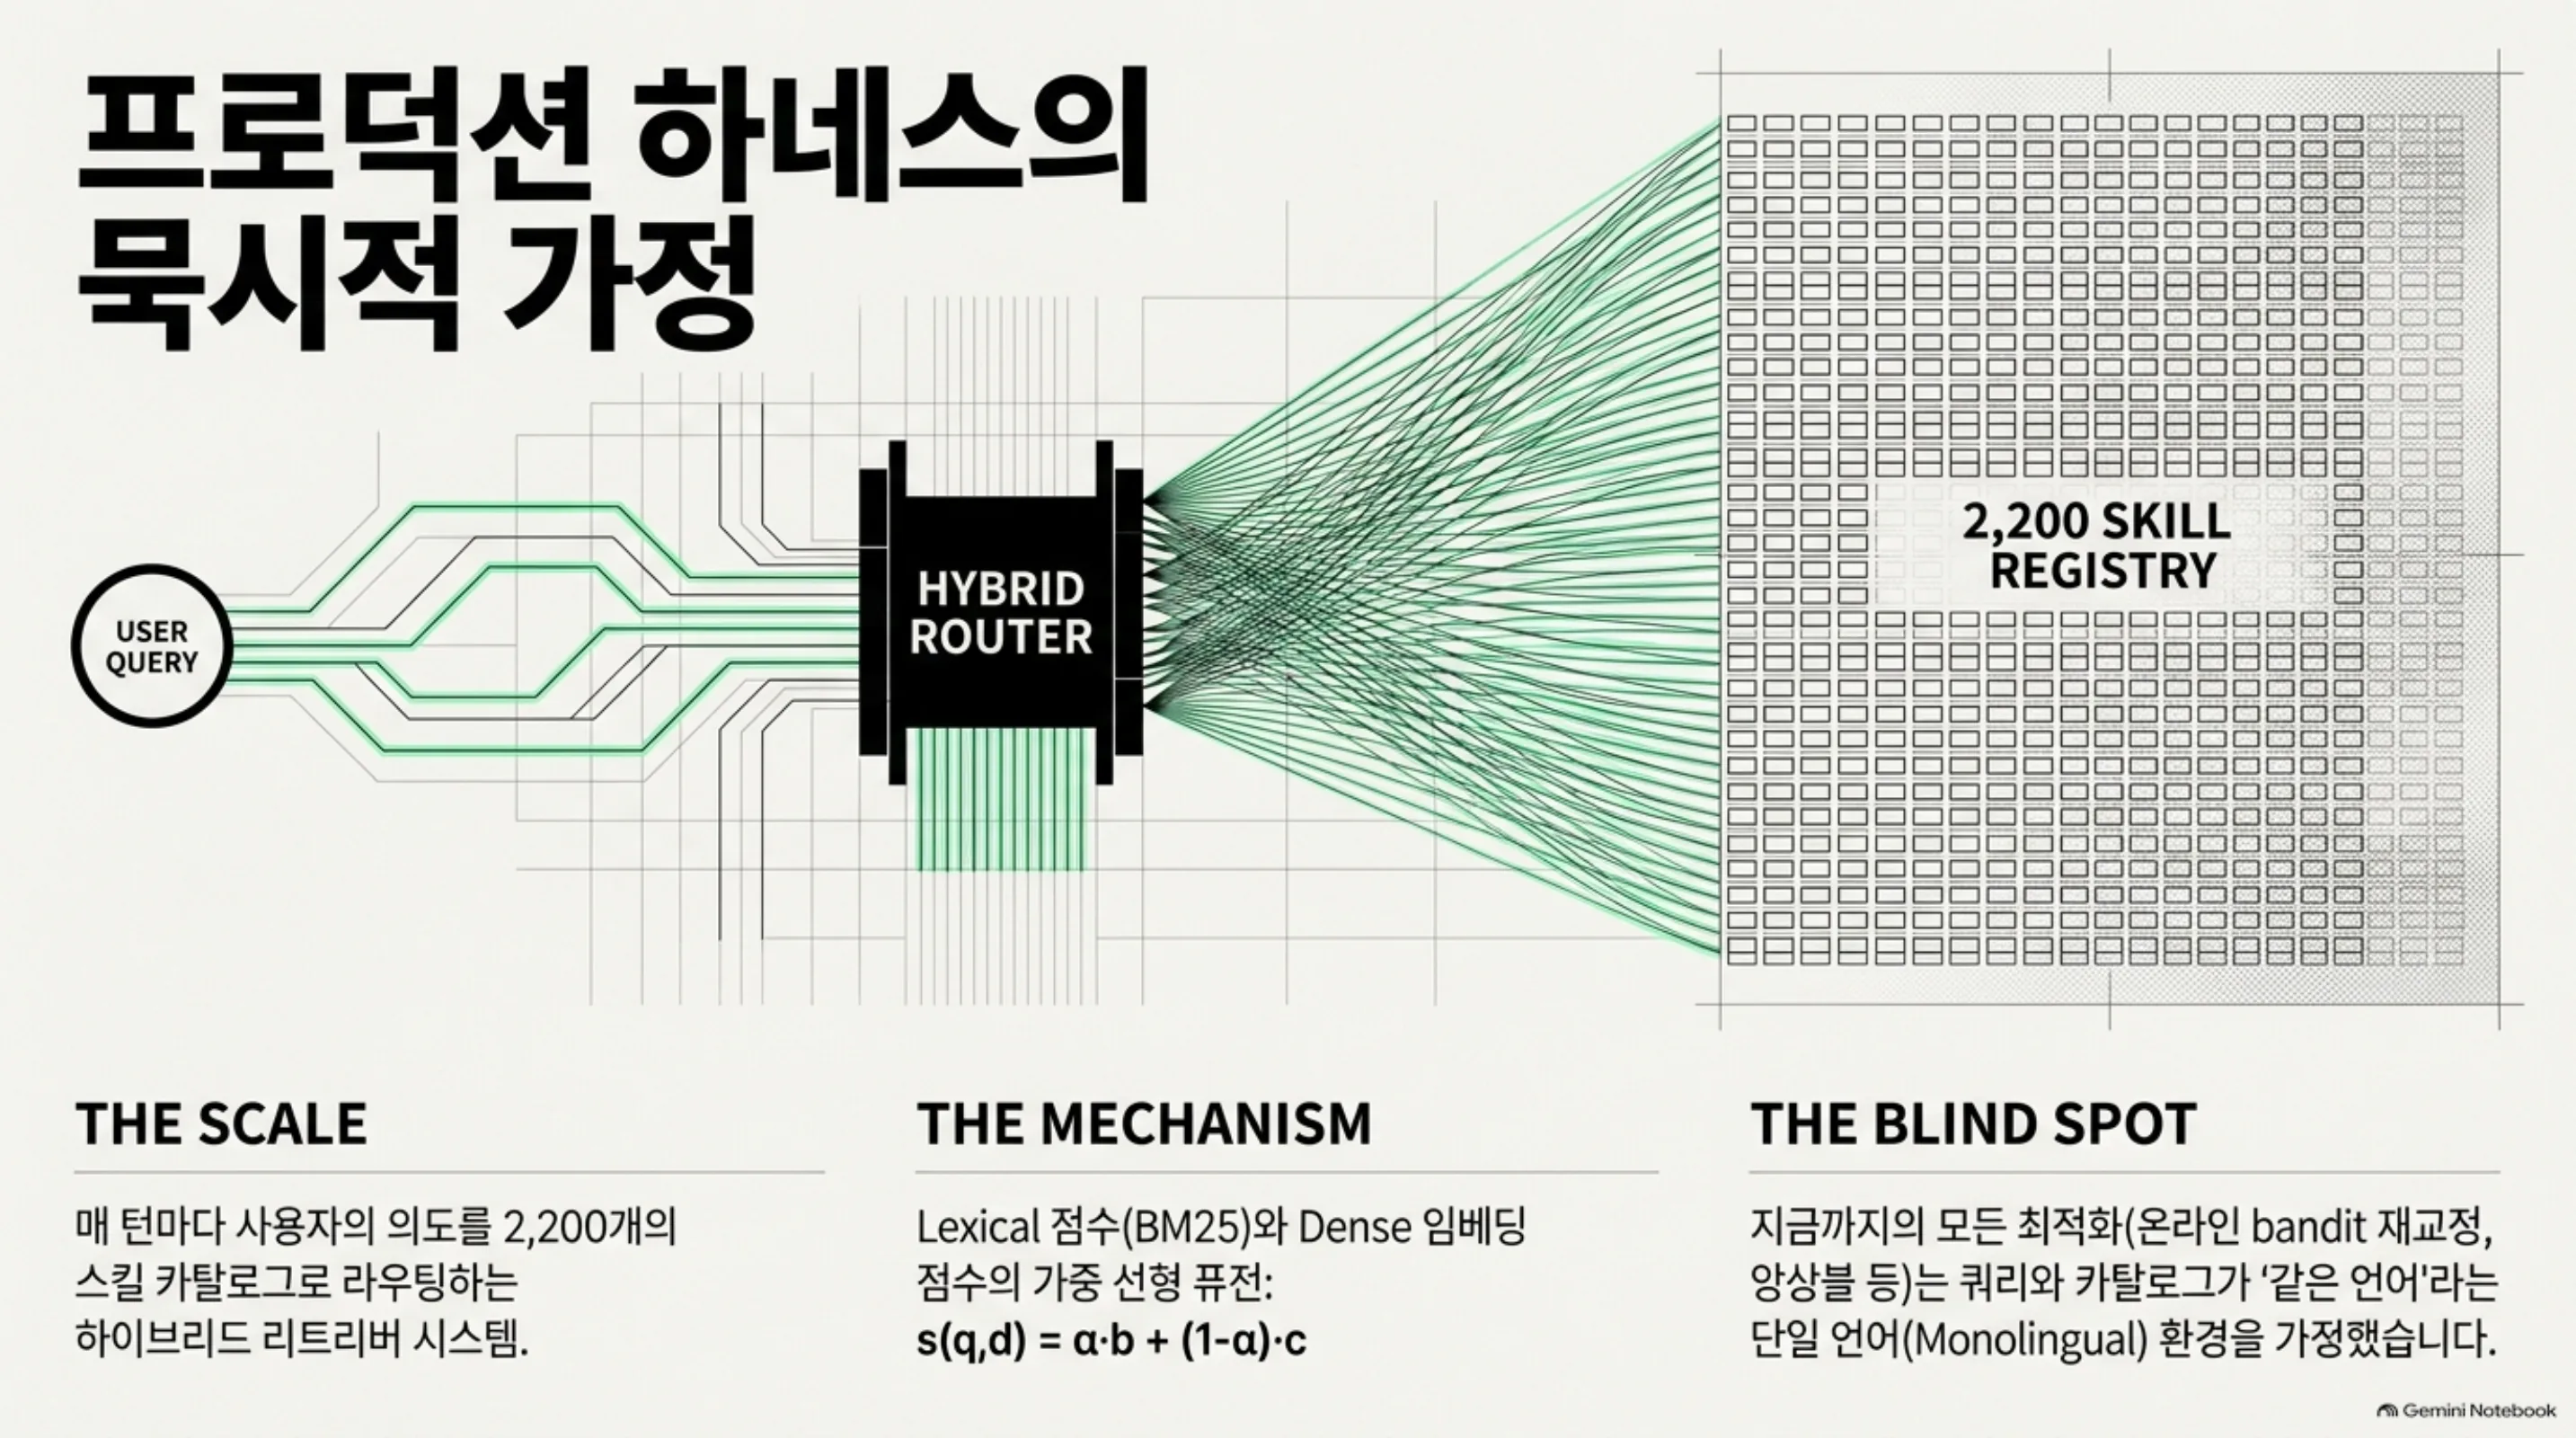
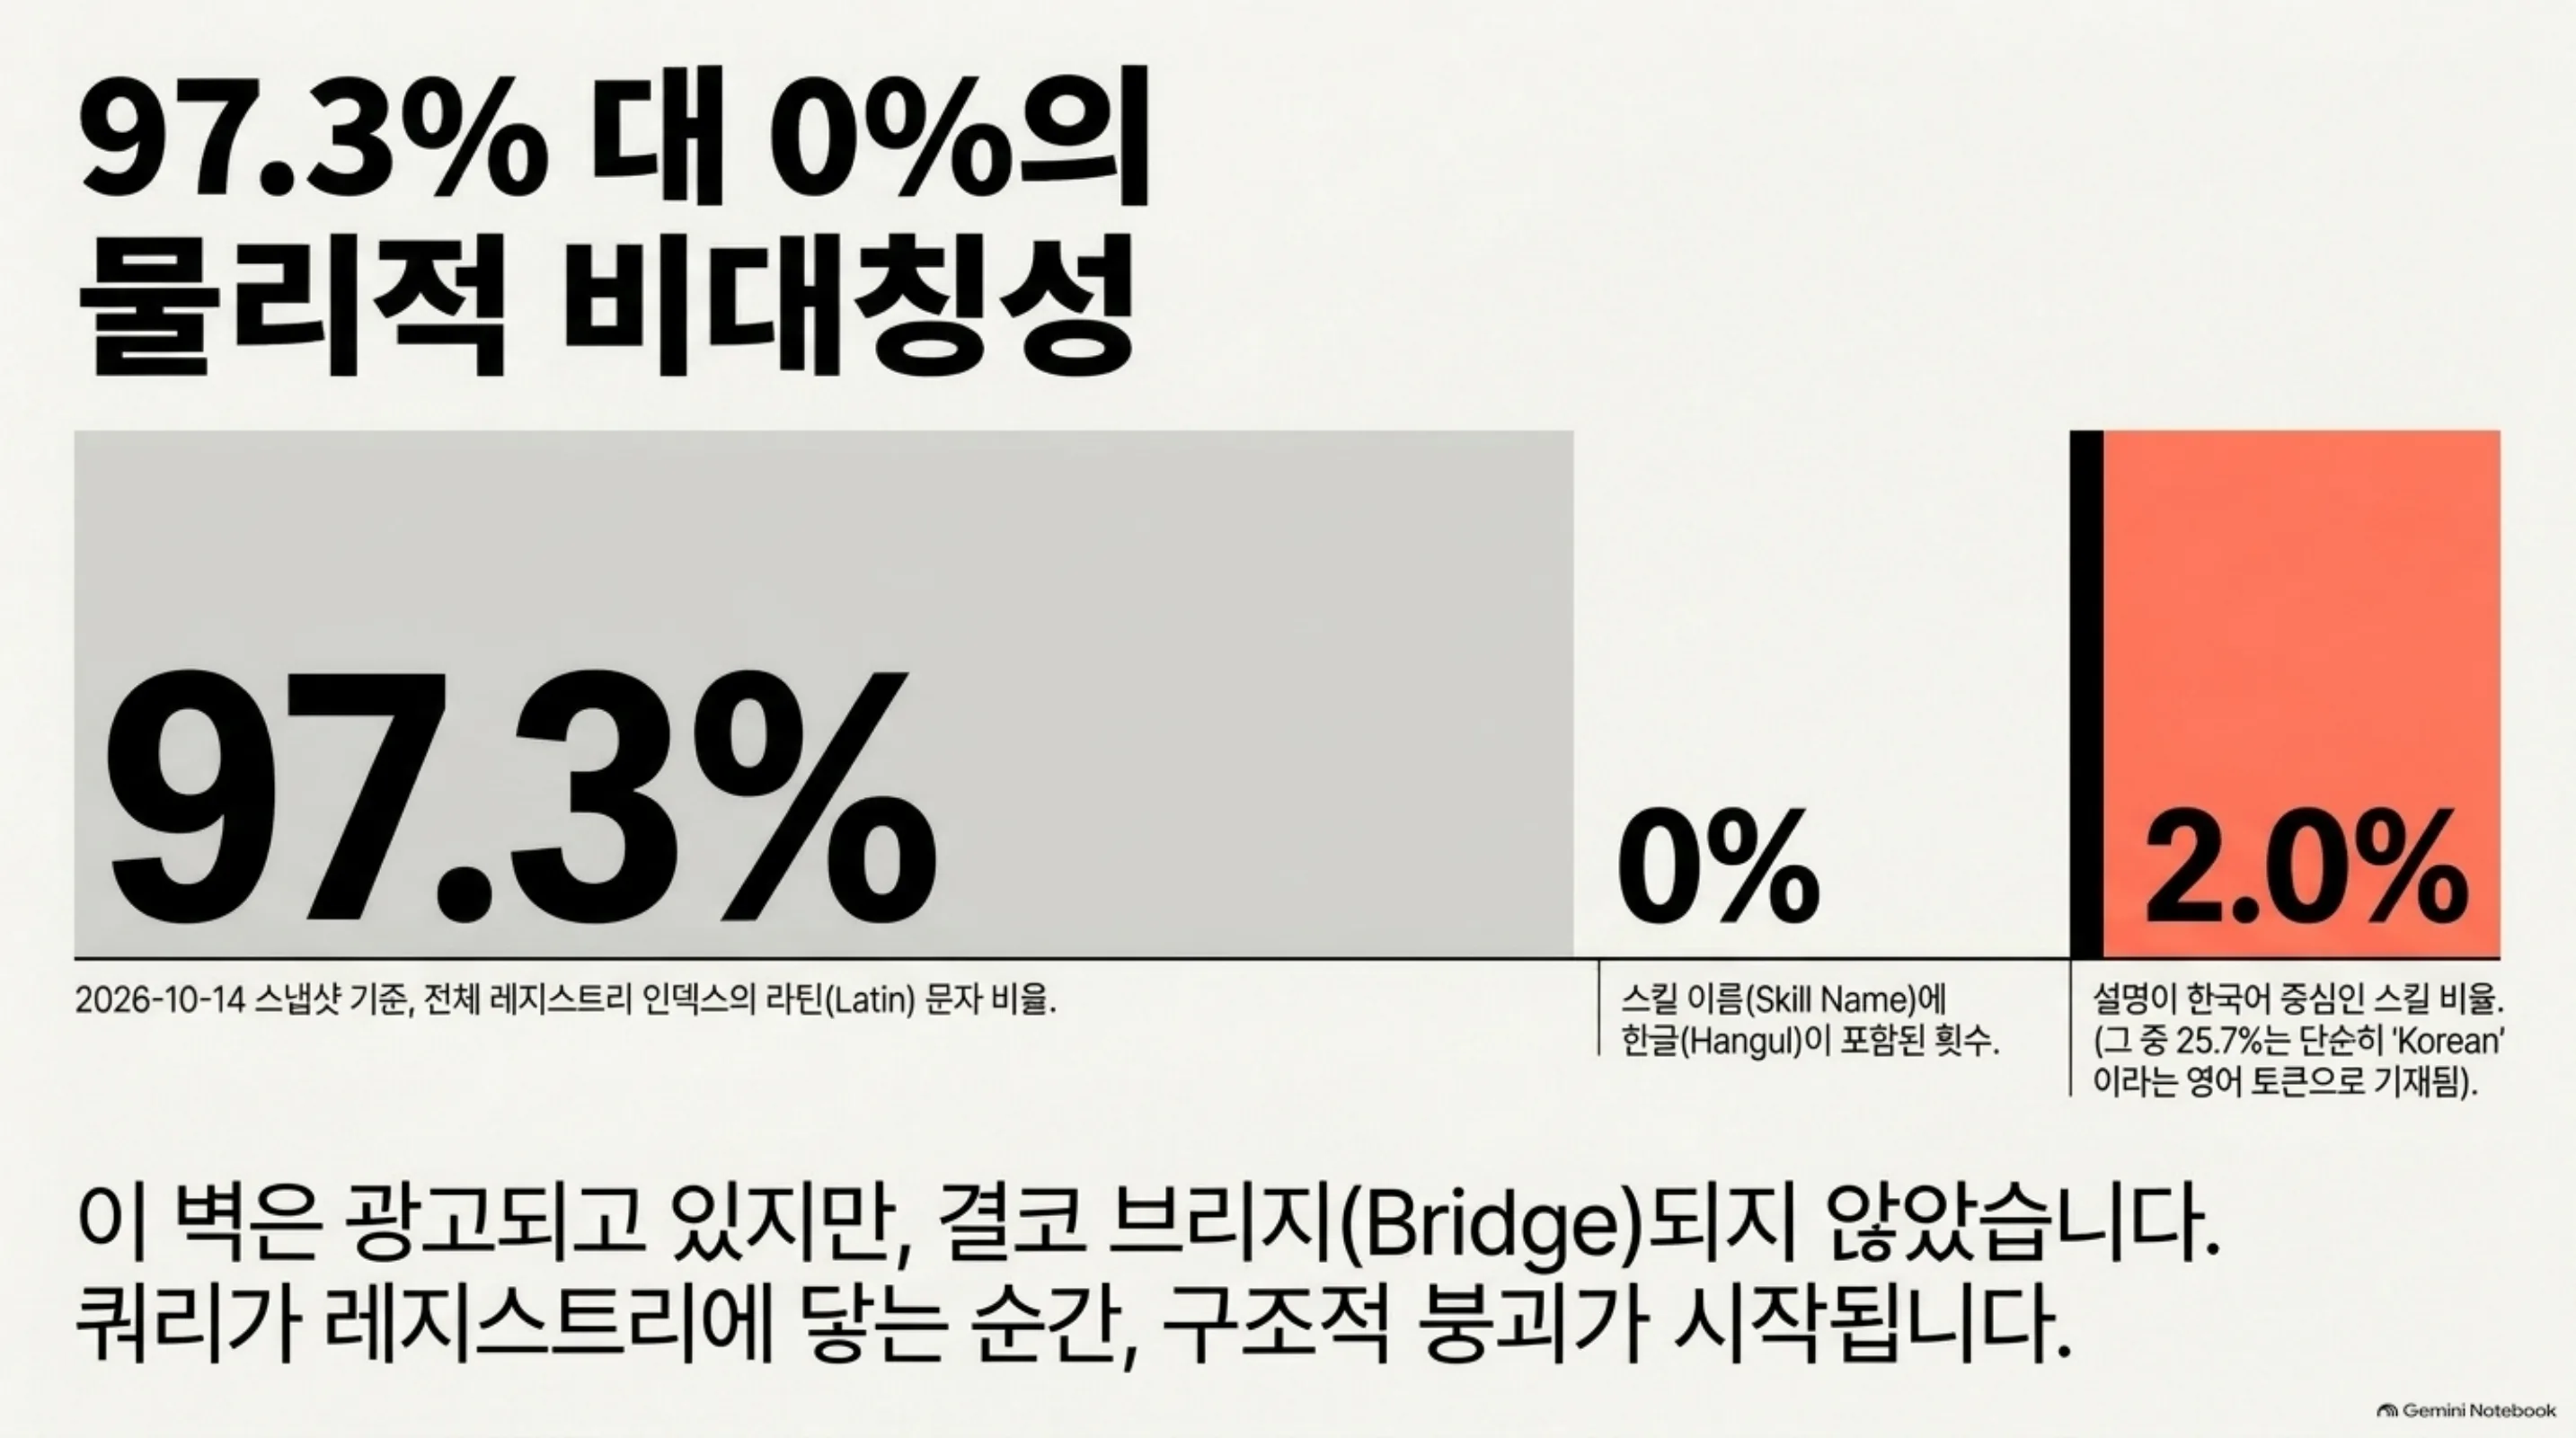
이 작업을 motivate하는 production harness는 bilingual 사용자 기반을 order 2,200개 skill 카탈로그로 라우팅합니다. 매 user turn마다 hybrid retriever가 어느 skill로 보낼지 고르는 것입니다. 후보 d 하나하나를 정규화된 BM25 lexical score b와 dense embedding cosine c의 가중 선형 fusion s(q,d) = α·b(q,d) + (1−α)·c(q,d)으로 점수 매기며 α는 시리즈의 이전 논문이 온라인 bandit으로 재교정하려 했던 그 hyperparameter이고 top-5 shortlist가 downstream executor로 넘겨진다. 카탈로그는 1차적 관점에서 영어 corpus라고 할 수 있습니다. 모델이 가정한 2026-10-14 design snapshot에서 인덱스된 전체 문자의 97.3%가 Latin script이고 skill name에 Hangul이 들어간 것은 0개이며 설명이 한국어-dominant인 것은 2.0%에 불과합니다. 그런데 설명의 25.7%는 “Korean”을 영어 토큰으로 적고 있는 셈입니다. 벽은 광고되고 있지만 브리지되지 않은 것입니다.
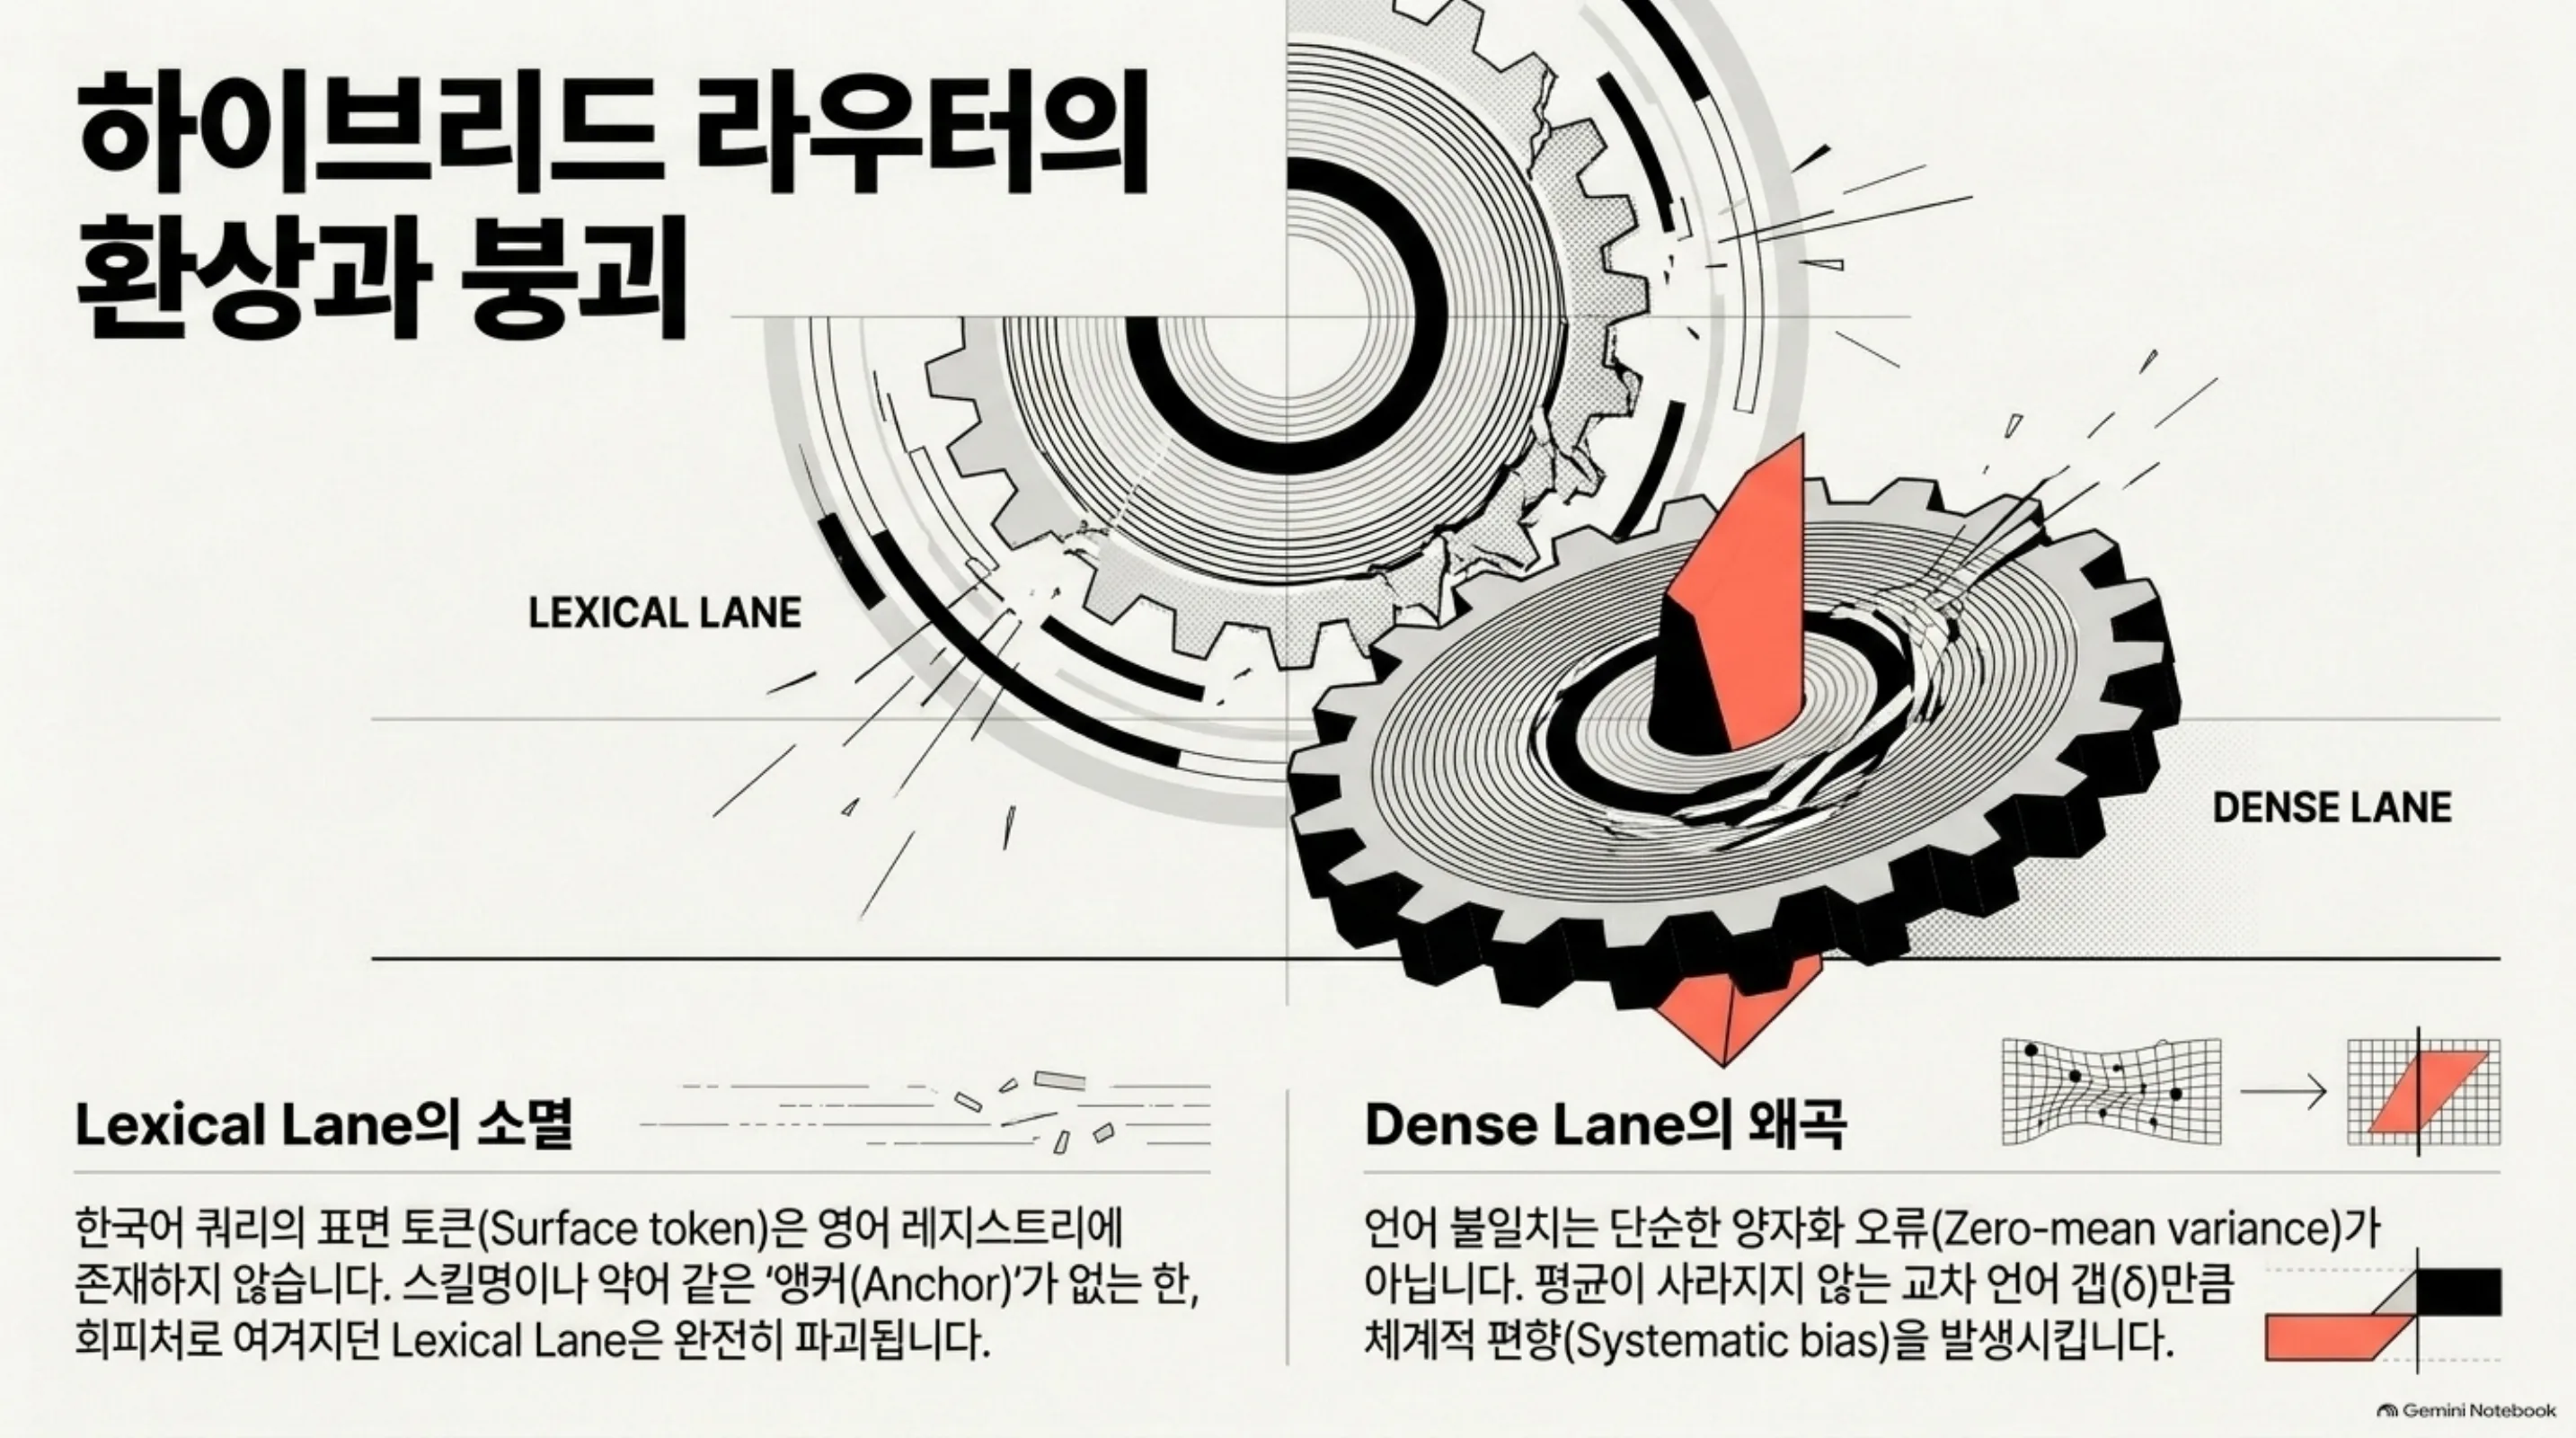
Cross-lingual information retrieval 문헌은 길지만 skill routing은 query와 카탈로그가 같은 언어라는 묵시적 가정 아래 연구되어 왔다. 이 시리즈가 이 router에 대해 이미 낸 네 논문(retriever ceiling, 온라인 fusion 재교정, ensemble voting, dense encoder 양자화)도 전부 같은 언어 편에서 질문했습니다. router의 양쪽이 다른 언어를 쓸 때 무슨 일이 일어나는지는 아무도 묻지 않았기 때문입니다. 이 논문이 다루는 perturbation의 형태는 직전 연구와 다르다. Quantization error는 fused score로는 dense lane으로만 들어오는 zero-mean variance이고 fusion weight α가 이를 linearly dampen합니다. 언어 불일치는 systematic bias인 셈입니다. Dense lane은 평균이 사라지지 않는 cross-lingual gap δ만큼 치워지고 회피처로 여겨지던 lexical lane조차 손상됩니다. 한국어 query의 surface token은 skill name, product name, 약어 같은 anchor가 query에 실려 있는 경우를 제외하면 영어 registry에 나오지 않습니다.
구별은 우발적이지 않고 구조적입니다. 양자화 아래에서는 보호 정리 자체가 α를 올리면 flip margin이 monotonically 커지고 α = 1에서 lexical lane이 intact한 회피처라고 말합니다. 언어 장벽 아래에서는 회피처 margin이 f·Δ_L로 줄어든다. Δ_L은 single-language lexical margin gap이고 f는 anchor fraction, 곧 query의 salient token 중 레지스트리 텍스트에 surface(Latin) 형태로 존재하는 비율입니다. f가 줄수록 회피처가 감쇠하고 f → 0에서는 어떤 α도 positive margin을 회복하지 못합니다. router의 자기 hyperparameter가 anchor 없는 query를 구하지 못한다는 뜻이며 남은 레버는 모델의 파라미터를 바꾸는 것뿐입니다. f를 올리는 것(사용자가 한국어를 썼으므로 불가능하다), δ를 줄이는 것, registry의 surface form을 바꾸는 것뿐입니다. 고치 메뉴는 세 개다.
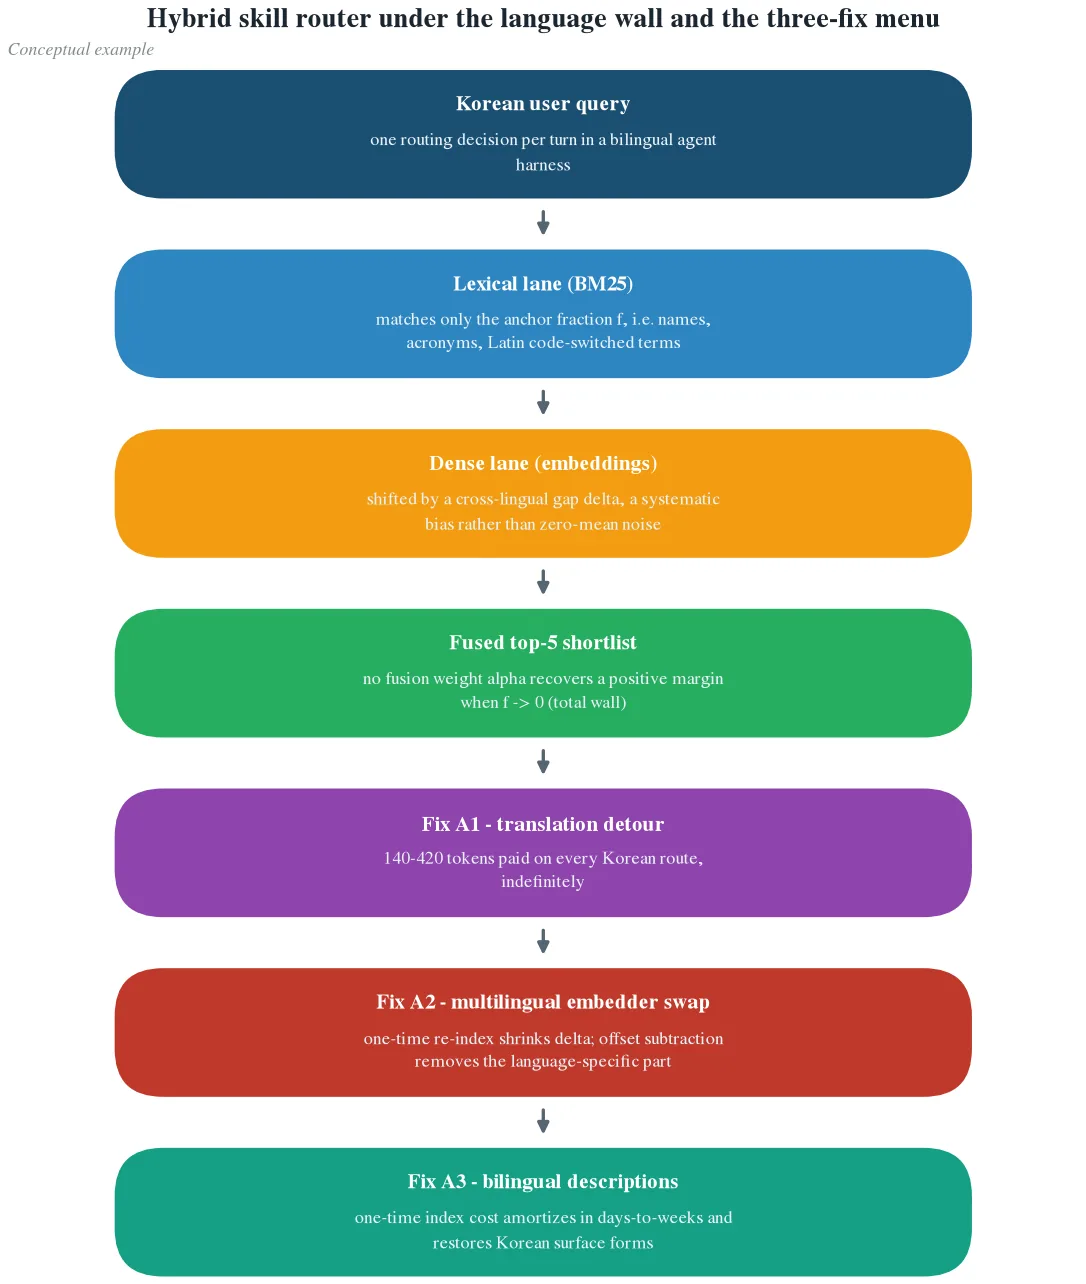 deployment와 three-fix menu의 구조. 한국어 query가 두 router 레인 모두에서 97% Latin registry에 부딪히고 fusion weight는 anchor 없는 query의 벽을 치울 수 없으며 모델의 파라미터를 바꾸는 것은 세 가지 index-side 또는 query-side 고치뿐입니다. (개념 예시, 실측이 아닙니다)
핵심 기여: closed form flip threshold와 total wall
first-order margin model은 두 가정으로 닫힙니다. query의 gold skill d와 nearest competitor d_j를 고정하고 같은 intent의 영어/한국어 렌더링을 q^en과 q^ko로 씁니다. single-language margin gap Δ_L(lexical)과 Δ_D(dense)는 전부 router가 q^en에 대해 이미 계산하는 float score에서 관찰 가능한 값이기 때문. 첫 번째 가정, anchor fraction f: anchor가 아닌 한국어 token은 어떤 bag-of-ngrams나 morphological tokenization이든 영어 registry와 (근사한) surface match가 없고, anchor는 single-language 강도로 match하므로 cross-lingual lexical margin은 f·Δ_L입니다. 두 번째, dense-lane gap δ: c(q^ko, d) − c(q^ko, d_j) = Δ_D − δ, δ ≥ 0. fused score의 cross-lingual margin은
m′(α) = α f Δ_L + (1 − α)(Δ_D − δ)
입니다. flip threshold가 closed form으로 나옵니다. dense-lane gap이 single-language dense margin 자체를 넘는 wall regime, γ = δ − Δ_D > 0에서, m′(α) < 0일 필요충분조건은 α < α_crit(f, δ) = γ / (f Δ_L + γ)인 셈. α_crit은 f에 대해 strictly decreasing이고 f = 0에서 최대 1, f → 1에서 γ/(Δ_L + γ)로 내려간다. anchor 없는 한국어 query는 α ∈ [0,1)의 모든 operating point에서 뒤집어진다. 두 번째 proposition이 이 논문의 이름, total wall입니다. f = 0에서 margin은 α ∈ [0,1] 전역에서 non-positive이고 fully-lexical 한계 α = 1에서만 0이 되지만 그 한계에서는 가정에 의해 query의 구분적 내용이 surface form에 없는 셈입니다. router는 anchor 없는 query에서 d*와 d_j 사이에 모든 α 운영점에서 score-blind이기 때문.
세 번째 결과는 직전 연구의 보호 정리가 뒤집힌다는 것입니다. 양자화 아래 α = 1의 margin은 어떤 ε에서도 Δ_L > 0이고 flip 확률은 α에 대해 monotonically decreasing합니다. 언어 장벽 아래 회피처 margin은 f Δ_L이고 f → 0에서 사라지는 셈입니다. α에 의한 monotone 보호가 정확히 벽이 가장 높은 곳에서 실패합니다. 실무적 함의는 α가 튜닝 대상 상수가 아니라 query의 관찰 가능한 anchor fraction의 함수라는 것입니다. anchor가 있는 query에서는 fully lexical로, 없는 query에서는 dense-lane 수리로 갑니다. 이전 논문의 온라인 bandit null result는 query mix가 언어를 바꿀 때 stationary-α policy가 기대해야 하는 결과 그대로입니다.
Dense-lane gap 자체도 둘로 쪼개집니다. δ = δ_lang + δ_sem. δ_lang은 모든 registry 문서에 공통인 언어-specific offset이고 index time에서 추정해 빼는 것만으로, training-free로 처리 가능합니다. 최근 multilingual dense model의 강한 same-language 선호를 per-language 상대 벡터 차감으로 교정해 four multilingual IR benchmark에서 효과를 확인한 것이 이 쪽입니다. δ_sem은 content-specific residual입니다. 가장 강한 zero-shot multilingual retriever도 Amharic에서 가장 강한 monolingual에 상대 MRR@10 23% 뒤처지고, fine-tuning으로도 닫히지 않는 이유입니다. 둘 다 더 큰 model이 아니라 index-side와 query-side engineering으로 고치는 데이터·학습 현상입니다.
Threshold에서 진단량이 따라오기 때문인 셈입니다. language-wall index LWI(α; δ) = E_f[1[α < α_crit(f, δ)]]는 언어 장벽 아래 top-1 결정이 뒤집히는 query의 기대 비율이며 float32 score와 관찰 가능한 anchor fraction f, encoder·direction마다 probe set 한 번으로 추정하는 δ만으로 계산됩니다. 양자화 논문의 rank-safety 진단 p_risk의 direct analogue로, error term이 bias로 바뀌고 safety channel이 손상된 형태입니다.
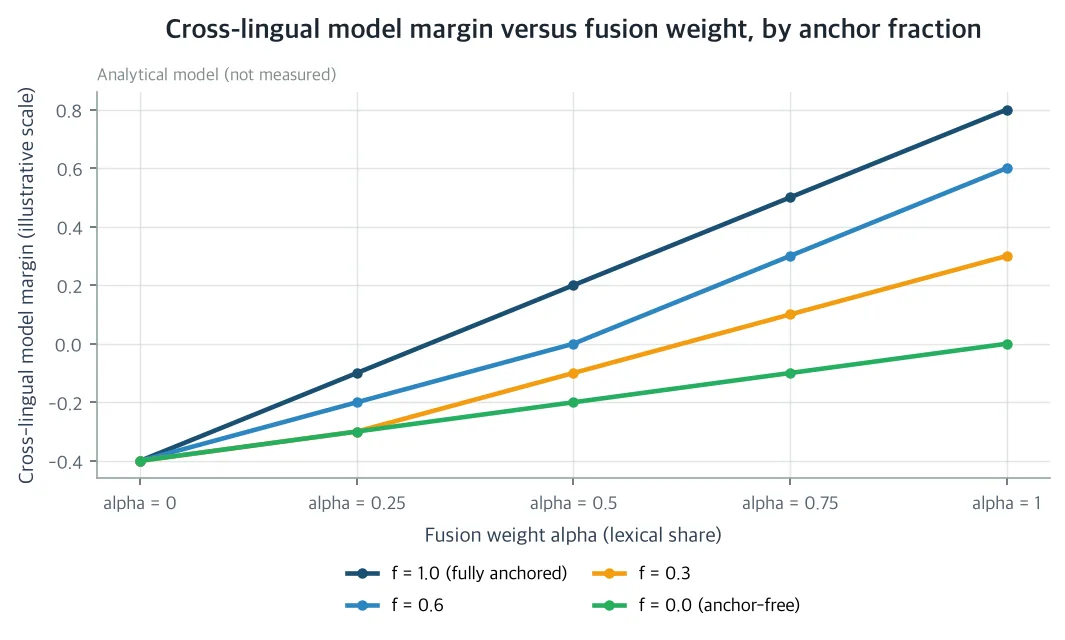 anchor fraction f별 fusion weight α에 대한 cross-lingual model margin m′(α). f가 작아질수록 zero-margin 교차가 fully-lexical 한계 쪽으로 이동하고 f = 0에서는 어떤 fusion weight에서도 margin이 non-positive가 됩니다. α의 어떤 선택도 치울 수 없는 total wall입니다. (분석 모델, 실측이 아닙니다)
Cost-quality frontier: route당 토큰으로 세면 가장 싼 고치
| 고치 메뉴의 세 명칭은 duty cycle이 매 turn 한 query, 영원한 router에 각기 다른 cost shape를 가집니다. A1 translation detour는 pinned LLM이 라우팅 전에 한국어를 영어로 번역하는 것입니다. route당 비용은 c_1 = P_t + (a+1) | q | ≈ 140-420 토큰(중앙값 ~250)에 serial latency call 한 번이 붙고 품질은 registry 어휘에 대한 번역 충실도로 한정됩니다. 단일 언어 안에서도 LLM-assisted query expansion이 non-expanded retrieval을 이기지 못하고 topic drift를 일으킨 것이 detour식 rewrite에 대한 주의 결과입니다. A2 multilingual embedder swap은 dense encoder를 언어를 잇는 것으로 바꿔 one-time re-index를 치는 것입니다. per-route marginal cost는 기존 router 수준이거나 그 이하입니다. compact 8M active-parameter retriever가 MMTEB Multilingual v2 Retrieval nDCG@10에서 56.2로, 활성 파라미터 대략 40배인 BGE-M3를 넘고 re-index는 CPU-minutes 순입니다. A3 bilingual descriptions은 skill 설명(중앙값 69단어, bilingual화하면 skill당 ~200 토큰)을 index time에 번역하는 것입니다. one-time O_3 ≈ 4.3×10^5 토큰과 유지보수가 들어가지만, surface form이 registry에 실리게 되어 lexical lane이 회복됩니다. index-side 변형 A2’(swap + training-free offset subtraction)와 A3q(INT8 encoder 통과)는 직전 연구와 합성합니다. |
Duty cycle 논리가 나머지를 처리합니다. Detour의 c_1은 모든 Korean route에서, 영원히 반복해서 나가는 비용이고 O_3은 한 번에 나가는 비용입니다. A3의 A1 대비 amortization horizon은 H* = O_3/(σ R c_1) ≈ 1,720/(σ R) 일입니다. R은 하루 route 수, σ는 Korean-route 비중. 하루 1,000건의 Korean route면 약 1.7일, 100건이면 약 17일, σ R ≳ 250이면 한 주 안에 들어옵니다. 논문은 A1-A3 경계만 고정합니다. A3 유지보수율 u가 미지정 파라미터라 A0-A3 경계는 미정이고 A2 re-index 비용이 토큰이 아니라 CPU-minutes로 표기되어 A2-A3 경계는 같은 단위로 쓸 수 없습니다. 일일 Korean-route 물량에 대한 step-function policy는 주장하지 않습니다.
Pareto 구조가 뒤따릅니다. H* 이후 A3가 비용에서 A1을 weakly dominate하고 품질에서는 모든 horizon에서 dominate합니다. A3는 surface form 자체를 복원하고 A1는 그 paraphrase만 복원하기 때문입니다. index-side 고치가 불가능한 corner regime(frozen 외부 encoder, read-only index)에서는 A1가 유일한 per-route 품질 레버입니다. Embedder swap이 detour를 dominate하는지는 모델로 결정되지 않습니다. 예시적 model level에서 두 swap 점(0.30, 0.20)은 더 낮은 marginal cost(25 vs 250 토큰/route)에 더 높은 residual flip rate로, detour(0.14)와 어느 쪽도 Pareto-dominant하지 않고 detour의 swap 대비 품질 순위는 실측 테스트에 맡겨집니다. Index-side 고치는 encoder-only marginal cost에 모여 residual flip rate를 점진적으로 낮추고, detour는 route당 토큰 프리미엄을 얹고 오른쪽 멀리 있습니다. 그려진 순서에서는 detour보다 낮은 flip rate를 도달하는 것은 A3뿐입니다.
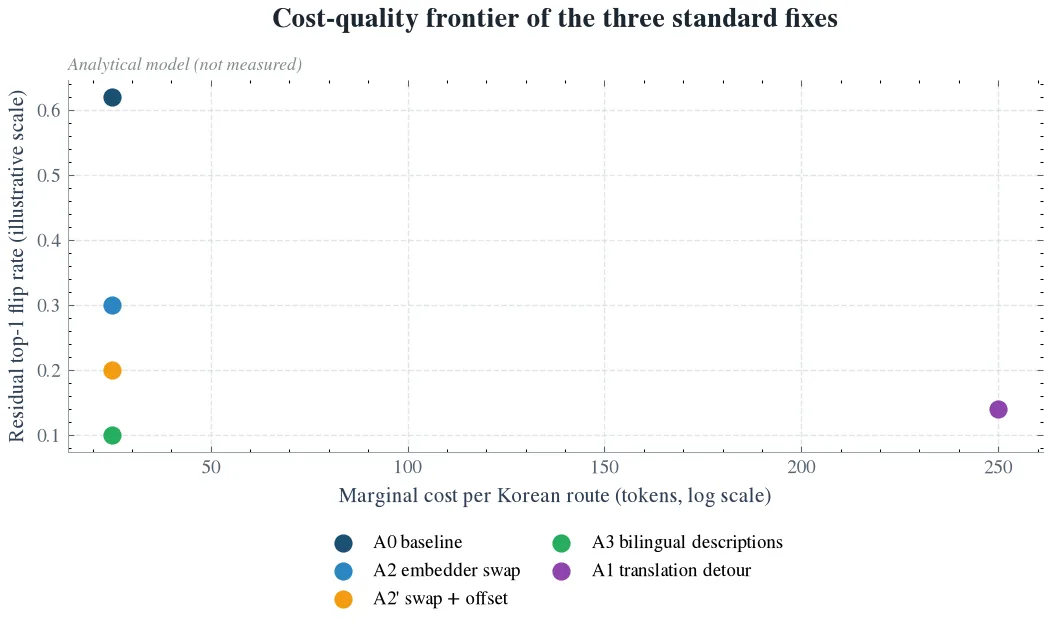 route당 토큰 marginal cost 대 residual flip rate의 cost-quality frontier. Index-side 고치(embedder swap, offset subtraction, bilingual descriptions)가 encoder-only marginal cost에 모여 residual flip rate를 점진적으로 낮추고 translation detour가 route당 토큰 프리미엄을 얹고 오른쪽 멀리 있습니다. 예시적 model level에서 detour의 flip rate 0.14는 두 swap 점(0.30, 0.20)과 bilingual descriptions 점(0.10) 사이에 있고 어떤 index-side 고치도 detour를 dominate한다고 주장하지 않으며, swap의 frontier 위치는 실측 테스트에 맡깁니다. (분석 모델, 실측이 아닙니다)
의미: 회사, 사회, 과학에 남는 것
회사로는, 언어 장벽은 97.3% Latin registry의 구조 속성입니다. 우발적인 것이 아닙니다. 97.3% Latin 비중이 registry의 center of gravity이고 고치 메뉴가 query 쪽(A1)이나 index 쪽(A3)에 동작하는 이유가 바로 그 비대칭인 셈입니다. 한국어 사용자가 영어 사용자와 같은 unattended-automation 신뢰도를 갖는 것은 벽이 명시적으로 가격 매겨질 때입니다. 한 번(A3, A2’)이든, route마다(A1)든. 예측된 최선 운영점은 offset-corrected, quantized multilingual encoder를 쓴 bilingual descriptions입니다. one-time index 비용은 며칠에서 몇 주에 amortize되고 detour는 매 Korean route당 ~140-420 토큰의 silent tax이며 시리즈의 cost discipline은 그 세금을 명시적으로 남기기 위해 존재합니다. 프로토콜은 flip rate와 같은 gold set 위에서 negative-case abstention도 채점합니다. anchor 없는 한국어 query를 조용히 잘못 라우팅하는 router는 “적용되는 skill이 없다”고 성실하게 말할 수 없습니다.
사회로는 agent skill ecosystem의 언어 장벽을 낮춥니다. 비영어 화자가 영어 화자와 같은 routing 품질과 unattended task-automation 신뢰도를 갖고 번역 비용은 조용히 지불되는 것이 아니라 route마다 측정되고 bounded됩니다. 비대칭은 이 플랫폼 밖에도 문서화되어 있습니다. human-verified Sinhala-Tamil e-government benchmark에서 영어 index의 monolingual retrieval은 Recall@15 10% 미만으로 거의 완전히 실패하고 multilingual embedder가 최고 translation 시스템의 92.4%/93.0%에 대해 96.2%/95.6%를 냈으며, 영어 index는 순수 영어 query로 served될 때 가장 좋다는 결과가 바로 이 registry의 비대칭과 같습니다.
과학으로는 cross-lingual hybrid skill routing의 첫 first-order margin model입니다. closed form flip threshold α_crit(f, δ)와 f → 0에서의 total wall, 양자화 보호 정리의 inversion을 주며 dense-lane gap을 index-side 제거 가능한 language offset과 content-specific residual로 분해합니다. 2,000+ skill agent harness의 deterministic graded bench 위에서 세 가지 표준 고치를 tokens per route로 비교한 첫 cost-quality frontier도 여기에 있고, 그 전부의 첫 실증 시험으로는 pre-registered hypotheses 다섯 개(H1-H5)의 deterministic paired-variant 프로토콜이 지정되어 있습니다.
한계: 아직 측정되지 않은 모델과 그 첫 시험
모델은 first-order입니다. Anchor fraction은 code-switching을 하나의 스칼라 f로 압축하고 character n-gram overlap은 anchor 존재에 대해 정확히 선형이 아닙니다. δ는 direction마다 스칼라인데, 실제로는 skill family마다 바뀝니다. Frontier의 cost 파라미터는 order-of-magnitude이고 이 router의 어떤 routing metric도 측정되거나 주장되지 않습니다. 이 논문에는 routing 실험이 없습니다. 모델과 frontier가 analytical이고 registry snapshot은 측정이 아니라 가정한 design input(실제 live router index는 2,275 entries, 2,274 unique names)이며 인용한 published value는 원문 그대로이고 모든 그림은 분석 또는 parameterized model curve입니다. 방향은 Korean-English만 다룹니다. 모델은 direction-symmetric이지만 근거는 그렇게 대칭적이지 않습니다. 다른 방향은 인용 문헌대로 query 언어 쪽에 불리하고 scope 밖입니다.
측정으로 frontier를 채우는 역할이 pre-registered 프로토콜의 것입니다. 시리즈의 deterministic graded benchmark의 언어 확장이며 어떤 arm도 돌리기 전에 고정됩니다. 기존 graded set의 각 gold case (q^en, d*)에 같은 intent의 human-authored, versioned 한국어 variant q^ko와, catalog skill이 하나도 적용되지 않는 matched negative case를 두 언어로 붙입니다. 케이스마다 f(계산값)와 A0 float score의 (Δ_L, Δ_D)를 저장합니다. A0 baseline, A1 detour(pinned translation model과 prompt, 번역은 log되고 재점수 가능), A2 swap(pinned checkpoint, fusion과 RRF 불변), A2’(probe set에서 한 번 추정된 offset), A3(한 번 번역해 pinned, description-budget gate 적용), A3q(INT8 encoder)까지, 모든 arm이 gold set, α grid(0.25, 0.5, 0.75), serving configuration을 공유하고 arm 내 온라인 적응을 금합니다. 지표는 언어별 recall@5, language swap 시의 top-1 flip(같은 α에서 q^en과 q^ko의 top-1이 다른 gold case 비율), α_crit 예측 대 observed LWI, arm별 route당 토큰, fixed margin threshold의 negative-case abstention, p95 route latency입니다. Pre-registered hypotheses는 다섯 개입니다. H1은 A0에서 anchor-free subset(f < 0.1)의 top-1 flip rate가 grid의 모든 α에서 ≥ 0.8이라고 H2는 A0에서 flip rate가 anchored subset(f ≥ 0.5)에서는 α에 대해 monotonically decreasing이고 anchor-free에서는 flat-or-rising이라고 예측합니다. H3는 A2가 Korean set에서 A0의 recall@5 gap의 ≥ 50%를 A1의 per-route marginal 토큰의 ≤ 10%로 닫는다고 H4는 A3가 anchored subset recall@5를 monolingual A0 level의 ≥ 90%로 회복하고 language-swap top-1 flip을 ≥ 3배 줄인다고, H5는 A2’가 추정 residual δ에서 A2를 strict하게 개선하고 same-language recall@5를 악화시키지 않는다고 예측합니다. 통계는 모든 rate에 exact binomial interval, observed flip 0은 rule-of-three bound로 보고, hypothesis는 interval이 threshold를 기준으로 supported, refuted, under-resolved 중 하나로 선언됩니다. Arm 간 사후 선택은 없습니다.
이 글의 세 장은 전부 분석 모델 또는 개념 예시이며 실측이 아닙니다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있습니다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-14-cross-lingual-skill-router-tax