정밀도 사다리: 셀프호스티드 서빙에서 모델 크기와 양자화 정밀도를 함께 고르는 비용-품질 프런티어
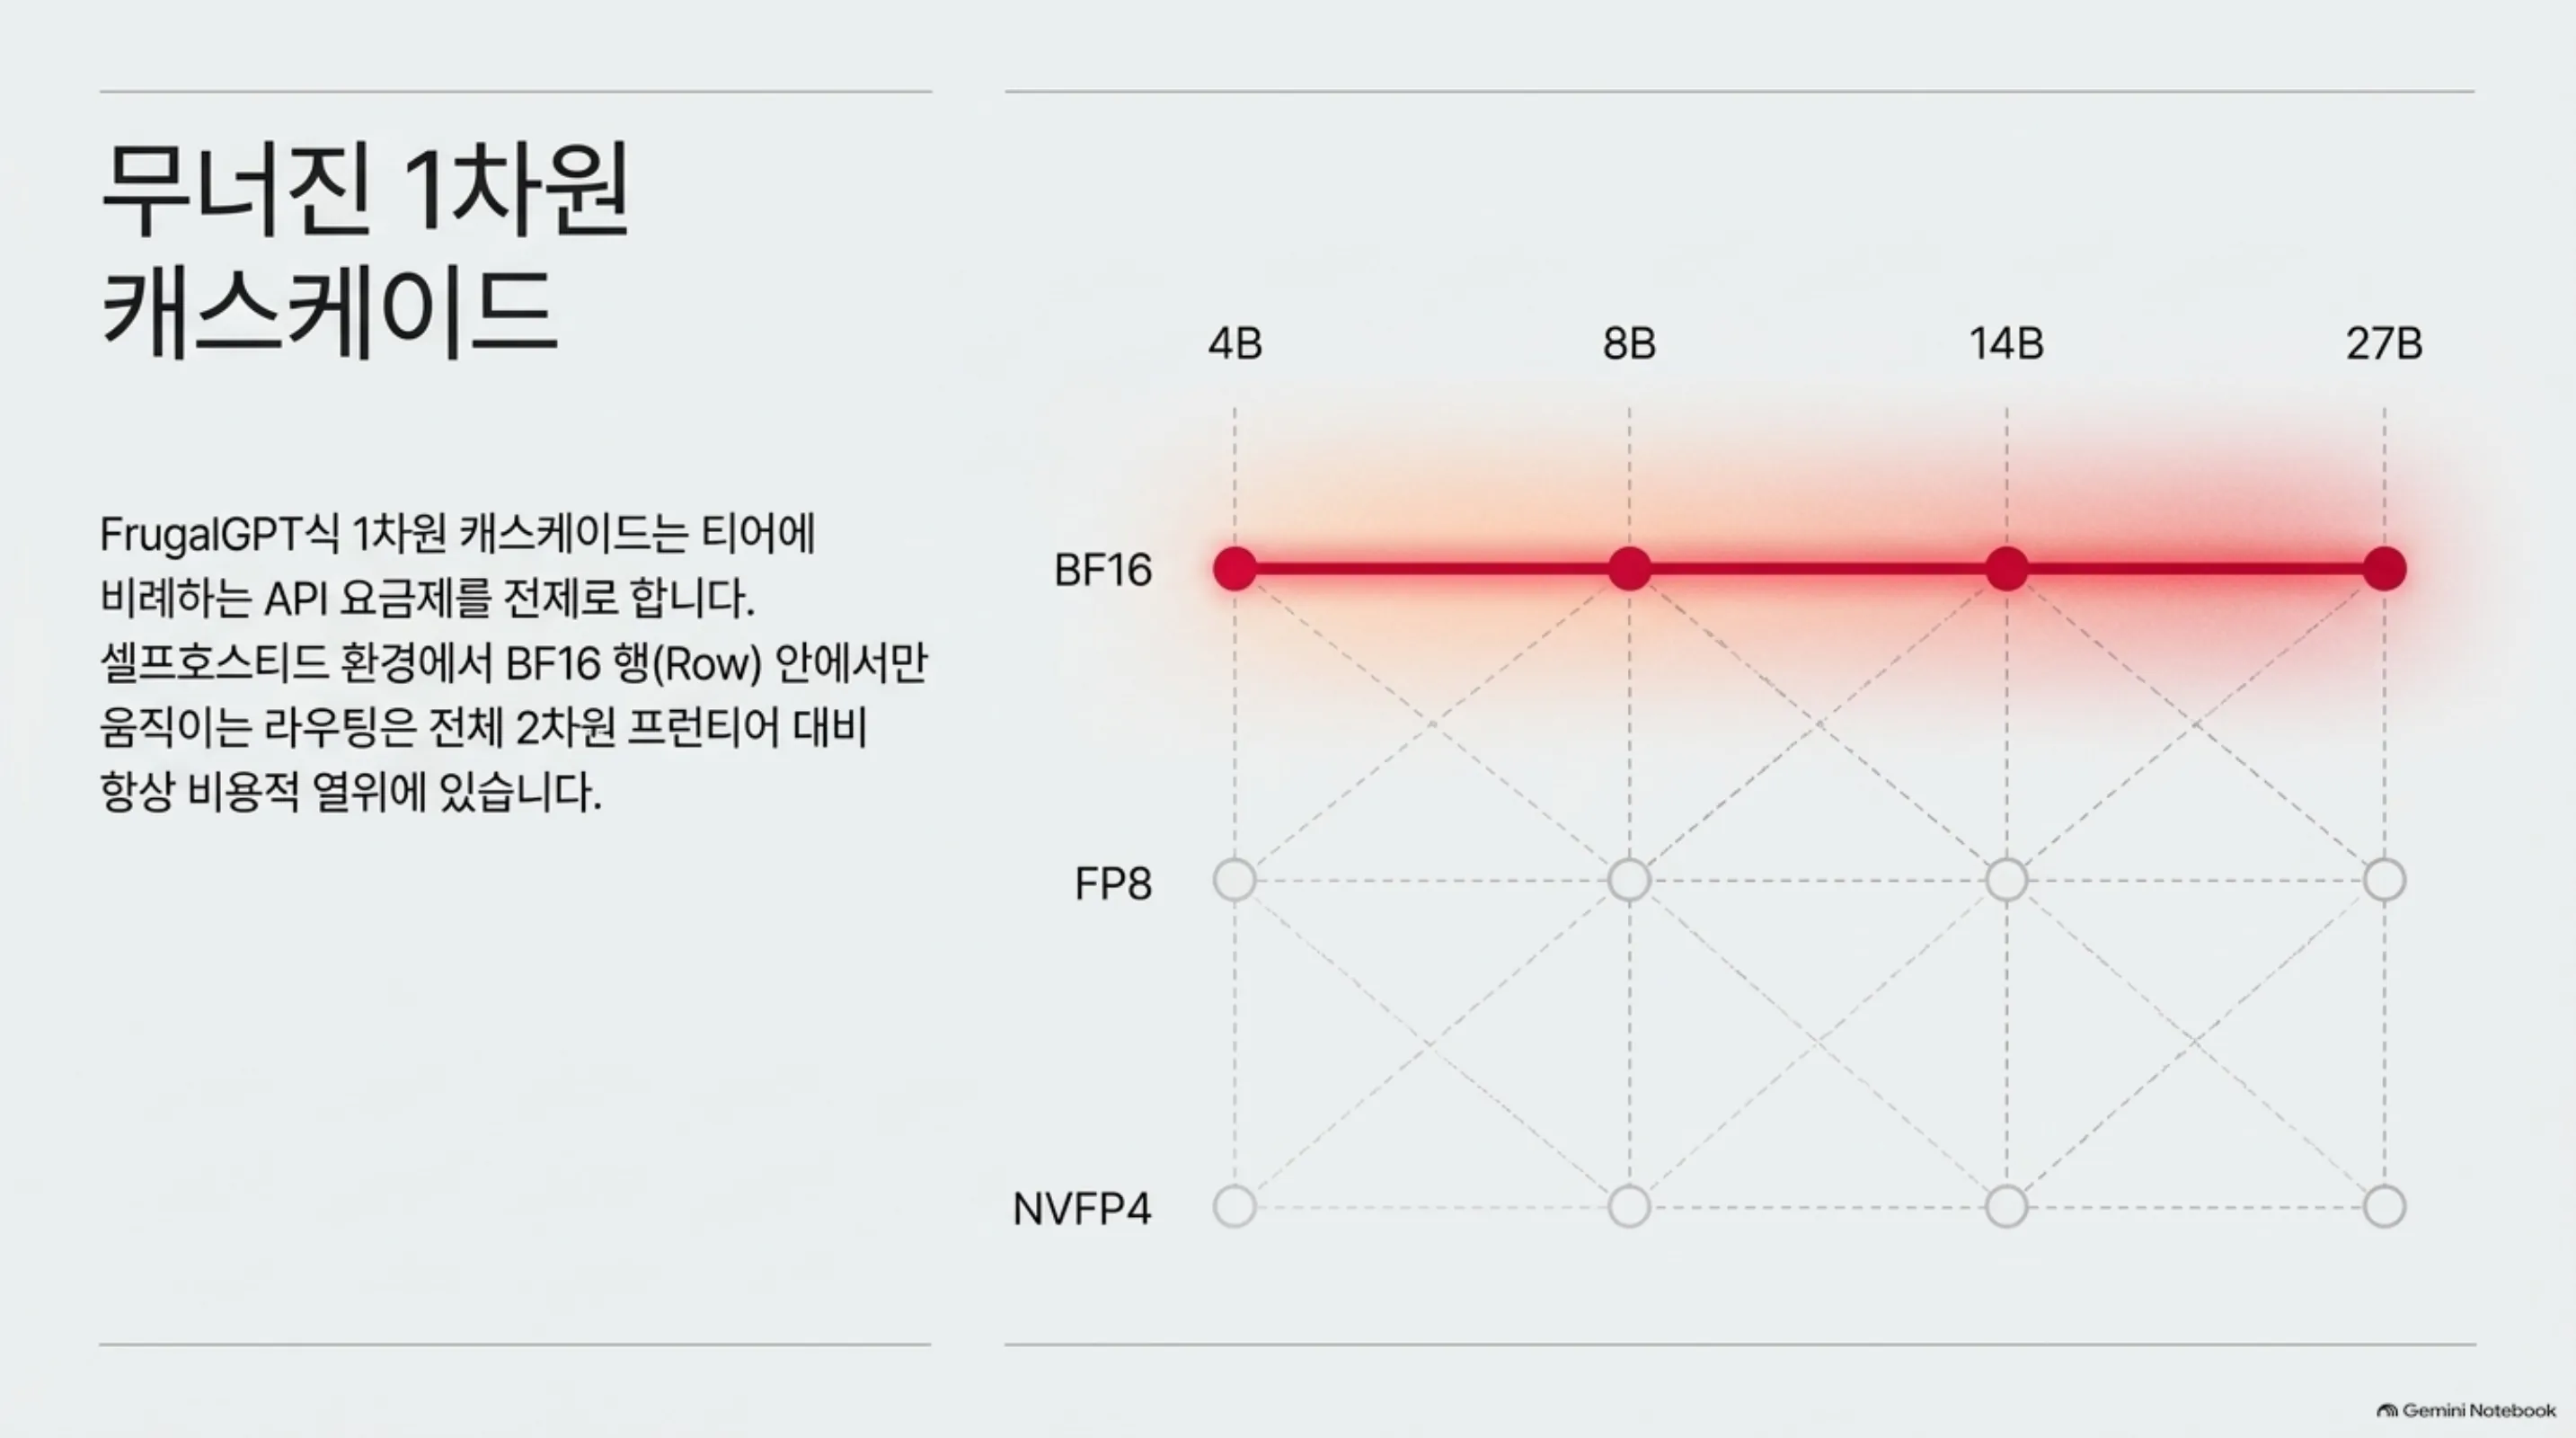
셀프호스티드 GPU로 무인 에이전트를 서빙하거나, 그 서빙 청구서를 책임지는 클라우드·AI 엔지니어가 이 글의 독자입니다. API로 모델을 부를 때는 고를 축이 하나였습니다. 모델 티어. 품질 게이트를 못 지키면 한 단계 위로 올리는 FrugalGPT식 1차원 캐스케이드가 표준 설계였습니다. 내 GPU 한 장을 직접 돌리면 축이 두 개가 됩니다. 모델 크기, 4B·8B·14B·27B. 그리고 가중치 정밀도, BF16·FP8·NVFP4. 어떤 조합이 올라와도 노드는 같은 GPU-시간 단위로 청구합니다. ThakiCloud의 이 논문 ‘정밀도 사다리’는 이 2차원 문제를 닫힌 형태로 풀어 줍니다. 카테고리당 가장 싼 (모델 × 정밀도) 조합을 고르는 규칙과, 쉬운 카테고리는 작은 풀프레션을, 어려운 카테고리는 큰 4비트를 고르는 범주별 역전 라우팅 표를 예상으로 줍니다.
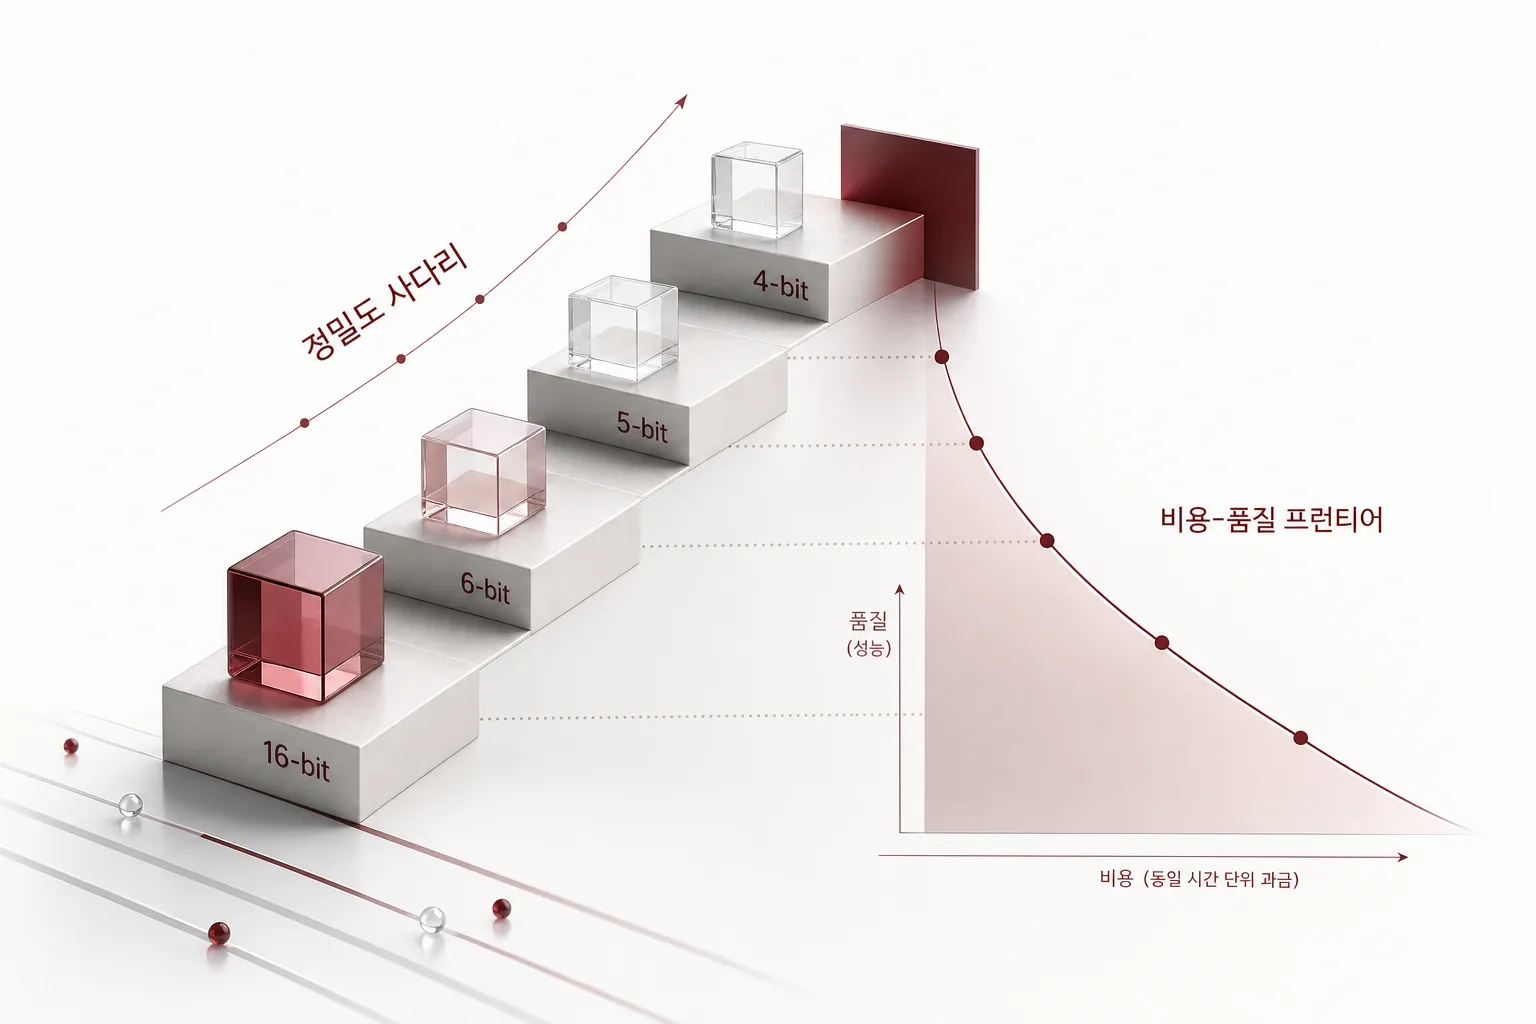 글의 핵심 개념을 형상화했습니다.
쉽게 말하면: 택시와 자가용
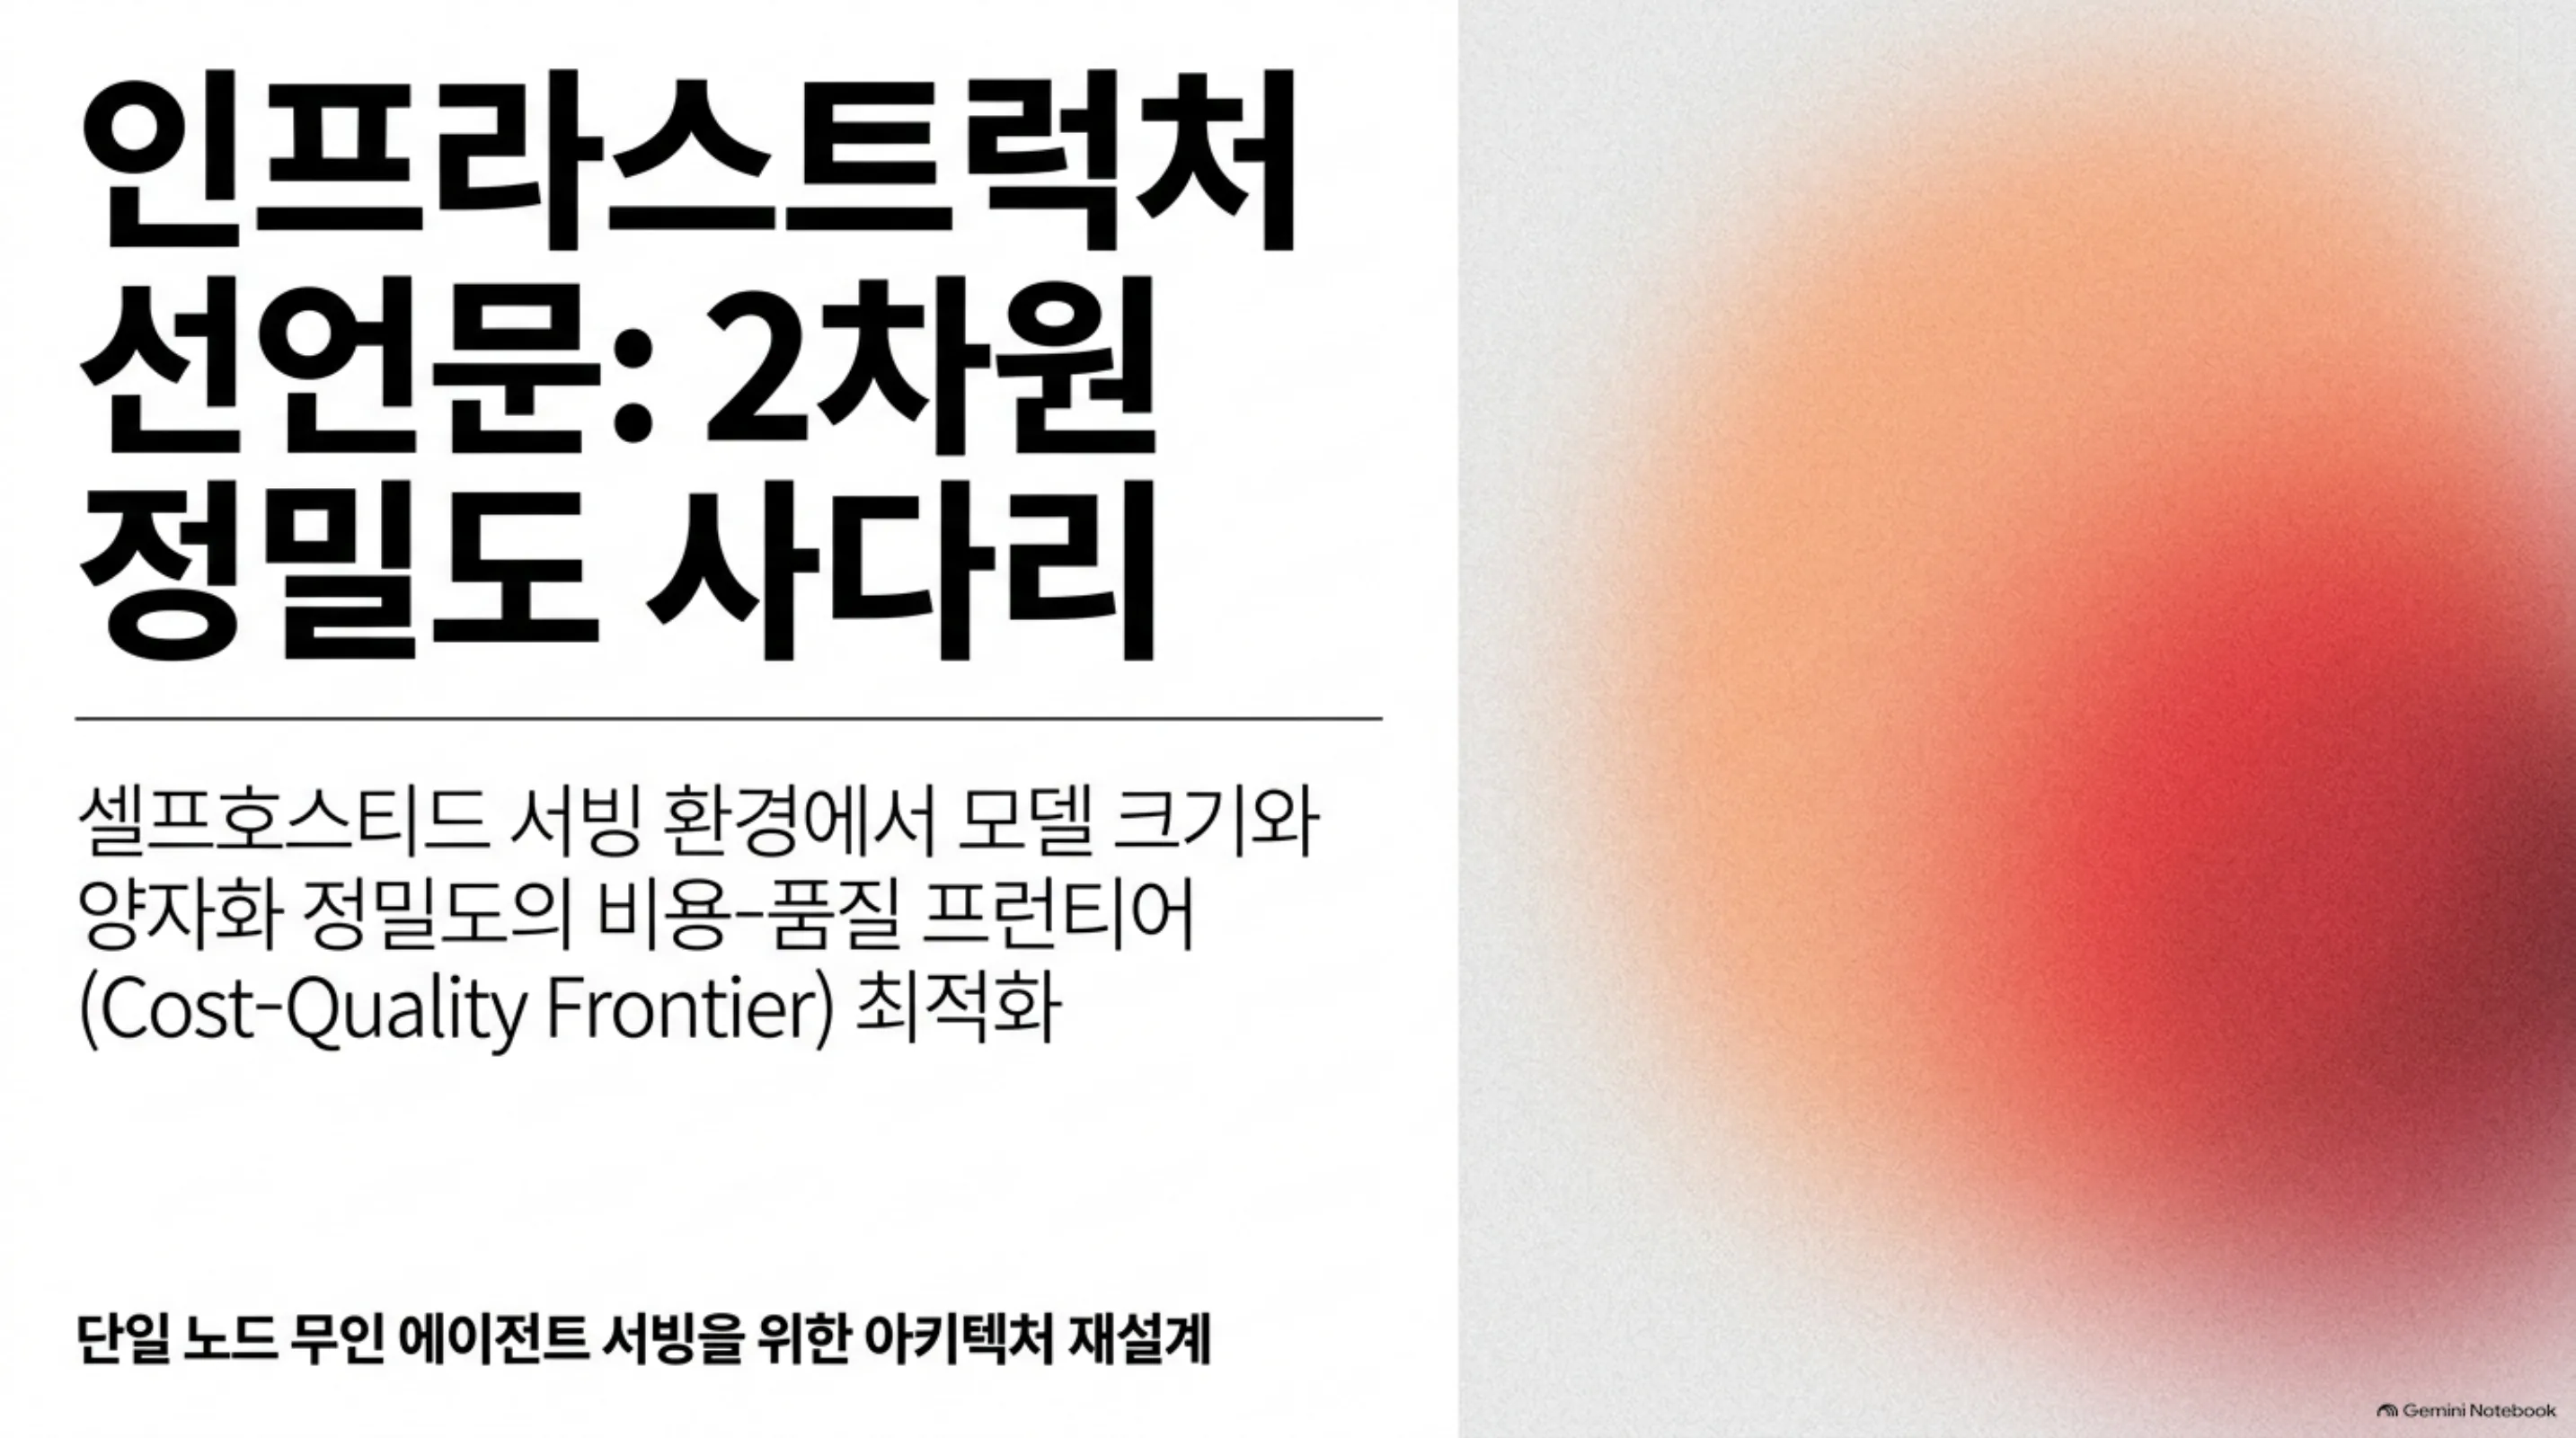
API는 택시비와 닮아 있습니다. 큰 모델을 부를수록 토큰 단가가 오르는 미터기 위의 가격입니다. 그래서 “먼저 작은 모델로 시도하고 안 되면 큰 모델로 올린다”는 단계가 비용 구조와 딱 맞았습니다. FrugalGPT 캐스케이드는 그 택시 요금표 위에 세워진 설계입니다.
자가용은 다릅니다. 유류비는 엔진이 무엇이든 시간당 일정하게 나갑니다. 같은 연료로 4비트로 줄인 큰 모델도, 풀프레션의 작은 모델도 똑같이 시간을 소모합니다. 이때 비용의 레버는 어떤 모델을 불렀는가가 아니라, 연료당 얼마나 많은 과제를 끝냈는가가 됩니다.
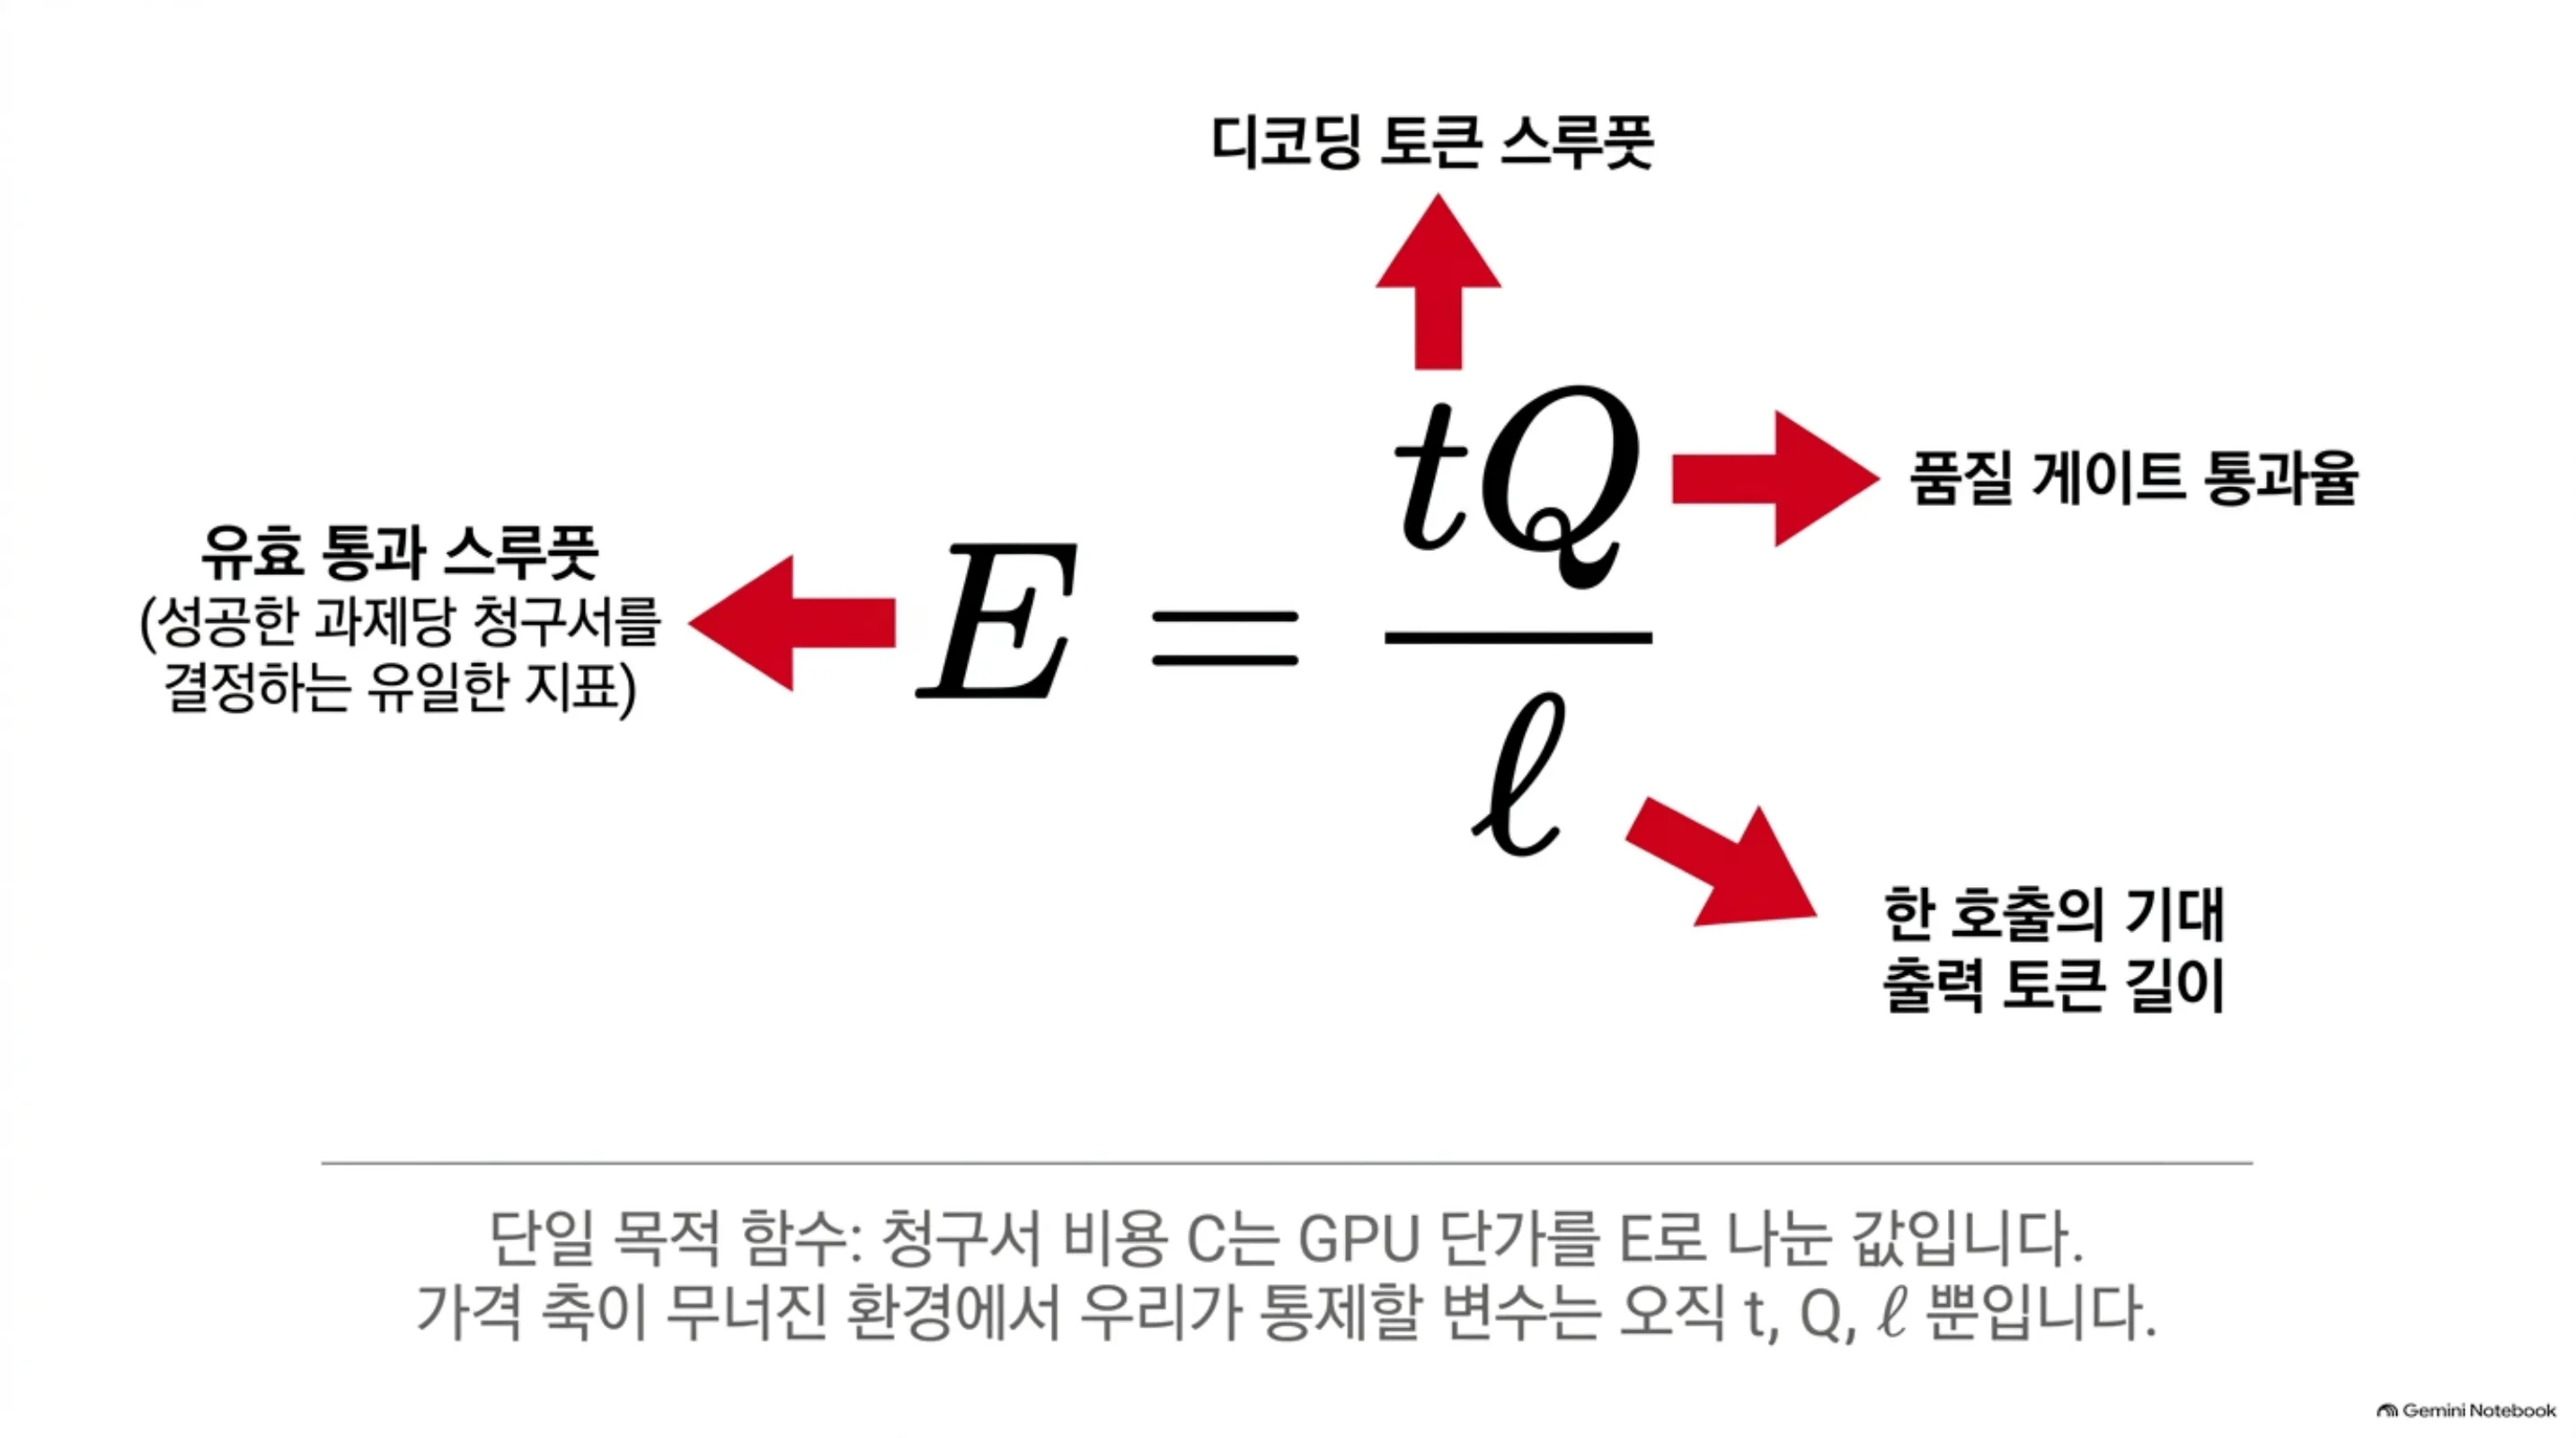
논문은 이 질문을 하나의 숫자로 압축합니다. 유효 통과 스루풋 E, 곧 tQ/ℓ입니다. 디코딩 토큰 스루풋 t에 코드 채점 통과율 Q를 곱하고 한 호출의 기대 출력 토큰 ℓ로 나눈 값으로, 단위 GPU-초당 품질 게이트를 통과해 전달되는 과제 수입니다. E가 클수록 성공한 과제당 청구서 C는 GPU-시간 단가 p_h를 E로 나눈 값으로 작아집니다. 이 공식에서 p_h는 어떤 모델이 어떤 정밀도로 올라와도 동일합니다. 가격 축이 무너지고 고를 수 있는 변수는 t, Q, ℓ뿐입니다.
문제의식: 1차원 캐스케이드는 셀프호스티드에서 한 축을 놓친다
FrugalGPT식 캐스케이드는 두 전제 위에 서 있습니다. 첫 번째는 품질 분류기가 요청을 티어 위로 올려 보내는 구조입니다. 두 번째는 호출 가격 자체가 티어에 비례한다는 API 가격 구조입니다. 셀프호스티드 단일 노드로 넘어오면 두 번째 전제가 사라집니다. BF16 4B를 돌리든 NVFP4 27B를 돌리든 청구서는 같은 GPU-시간 단가입니다.
캐스케이드는 그래서 4×3 그리드의 한 행, BF16 행만 따라 가는 것으로 줄어듭니다. 논문의 약지배 정리가 줍니다. BF16 행 안에서만 고르는 1차원 캐스케이드의 비용은 전체 그리드에서 고르는 2차원 프런티어보다 항상 같거나 비쌉니다. 동점이 되는 유일한 경우는 BF16 행 밖의 어떤 조합도 E에서 우월하지 않을 때입니다.
최근 나온 측정들은 전부 1차원이었습니다. 고정된 모델에서 비트 폭만 돌리는 양자화 절벽 측정, 고정된 모델에서 요청별 정밀도를 고르는 티어 라우팅, 고정된 정밀도에서 스킬 대 모델 라우팅, 고정된 모델에서 샘플링 정책. (모델 크기 × 양자화 정밀도)의 결합 비용-품질 프런티어만 열려 있었습니다.
이 논문이 답하는 배포 질문은 그래서 명확합니다. BFCL 스타일의 세 카테고리, simple·parallel·agentic 각각에서 품질 게이트 g=0.85를 지키며 가장 싼 (모델 크기 × 정밀도) 조합은 무엇인가. 그리고 27B NVFP4가 8B BF16보다 성공 과제당 싼 카테고리가 있는가.
핵심 기여: 교차 조건과 바이트 패리티
사다리의 핵심 정리, 교차 조건입니다. 큰 로우비트 챌린저 (m’, q’)가 작은 풀프레션 인컴벳 (m, BF16)보다 특정 카테고리에서 성공 과제당 값으로 싼 필요충분 조건은, ρ_c^t·ρ_c^Q > ρ_c^ℓ입니다. 스루풋 비율 ρ_c^t, 품질 비율 ρ_c^Q, 기대 길이 비율 ρ_c^ℓ의 곱 비교입니다. 챌린저가 토큰을 더 빨리 뿜고 품질이 더 좋고 출력이 더 짧으면 파라미터가 세 배여도 싸집니다. 진짜 성공 과제당 청구서로 확장하면 좌변에 성공률 비율 ρ_c^r이 한 번 더 곱해집니다.
기대 길이 비율이 1인 공유 레짐에서는 조건이 더 단순해집니다. 품질 차이를 BF16 기준의 티어 배당 D_c와 양자화 절벽 세금 ξ의 곱으로 쓰면, 교차에 필요한 조건은 D_c > ξ/(1-ξ)입니다. 풀프레션에서 큰 모델이 작은 모델보다 얼마나 좋은가, 그 배당이 4비트가 지우는 품질 세금보다 크면 큰 로우비트가 이깁니다.
그 조건이 카테고리마다 다른 쪽으로 기울 이유가 있습니다. 바이트 패리티입니다. 디코딩이 병목인 단일 노드 서빙에서 토큰당 스루풋은 가중치 바이트를 읽는 속도로 정해집니다. 8B BF16은 가중치당 2바이트를 곱해 16.0GB입니다. 27B NVFP4는 유효 4.5비트, 4비트 E2M1 요소에 16개 요소당 FP8 블록 스케일 하나를 더한 값으로 15.2GB입니다. 파라미터가 세 배인데, 포워드 패스당 읽는 바이트는 약 5% 적습니다. 그래서 스루풋 비율은 1 부근에 머무르고 논문은 0.9~1.05를 합리적 선분포로 둡니다. 스루풋이 사실상 동등해지면 교차 조건은 품질 균형, D_c와 ξ의 싸움으로 줄어듭니다.
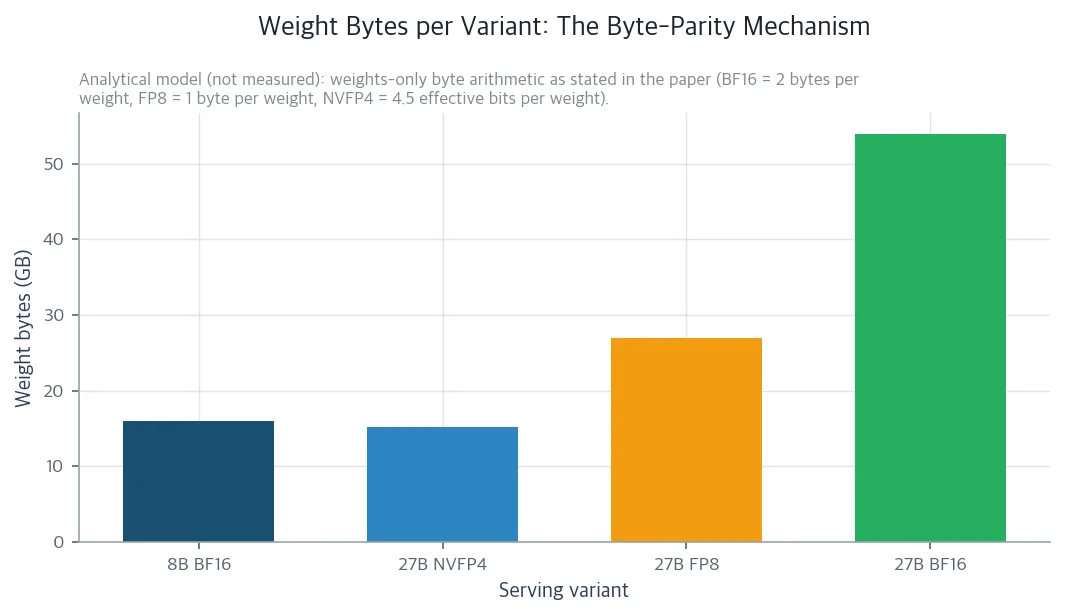 교차 지점의 가중치 바이트 산술입니다. 가중치당 유효 4.5비트의 27B는 15.2GB, 16비트의 8B는 16.0GB로, 파라미터 세 배의 27B가 포워드 패스당 약 5% 적은 바이트를 읽습니다. FP8과 BF16의 27B는 비례 참고용입니다. (해석 모델의 산술이며 실측이 아닙니다. BF16은 가중치당 2바이트, FP8은 1바이트, NVFP4는 유효 4.5비트로 계산)
레짐의 모양, 세 갈래입니다. dividend-dominated 레짐에서는 (1+D_c)(1-ξ)가 의무 구조 디코드 단계 s_c에 대해 증가하고 교차는 가장 어려운 카테고리에서만 성립합니다. 쉬운 카테고리에 작은 풀프레션, 어려운 카테고리에 큰 로우비트가 서는 정밀도 사다리의 본 모습을 그립니다. cliff-dominated 레짐에서는 모든 카테고리에서 임계치 이하이고 1차원 캐스케이드가 이미 2차원 최적입니다. low-bit-dominated 레짐에서는 모든 게이트 통과 카테고리에서 큰 로우비트가 최적입니다. 실제로 어떤 모양이 뜨는지는 사전 등록 프로토콜의 출력으로 결정됩니다.
하드웨어 이관 정리도 하나 줍니다. H100 NVL (93.6GB)에서 잰 값으로 H200 (141GB, 가격 비율 1.4)에 이관하면 라우팅 표 자체는 변하지 않습니다. 카테고리별 공통 인자 β_c가 가격 비율 1.4를 넘을 때만 절대 달러 비용이 개선되고 메모리 여지는 당연히 이관됩니다. 반증 기준 R4, β_c의 허용 오차를 닫습니다.
예시 계산: 시나리오 값으로 본 부호의 반전
아래 계산은 실측이 아닙니다. 논문이 명시한 시나리오 값으로, 각 가정은 문맥에서 그대로 옮깁니다. 공유 레짐 전제, ρ_c^ℓ=1, 진짜 성공 오버레이 ρ_c^r=1. 스루풋 비율 ρ_c^t는 바이트 패리티의 0.95. 27B NVFP4의 품질은 인용 앵커 0.896, 800건 BFCL 스타일 스위트 전체 값이고 카테고리 불변으로 가정합니다. 8B BF16의 카테고리별 품질은 simple 0.95, agentic 0.80으로 둡니다.
simple에서는 품질 비율이 0.896/0.95=0.943입니다. 곱은 0.95×0.943=0.896으로 1 미만. 교차하지 않습니다. 작은 풀프레션 모델이 쉬운 카테고리를 포화시키므로, 4비트가 절벽 세금을 안고서도 이길 재간이 없습니다. 그래서 simple의 승자는 8B BF16.
agentic에서는 부호가 반전됩니다. 품질 비율이 0.896/0.80=1.120, 곱은 0.95×1.120=1.064로 1 초과. 교차합니다. 27B NVFP4, 성공 과제당 약 6% 쌉니다. 구조적으로 어려운 카테고리에서 27B와 8B의 BF16 품질 격차, 즉 티어 배당이 5% 스루풋 격차를 갚아 줍니다.
카테고리마다 부호가 반전된다는 것은, 같은 27B NVFP4가 simple에서는 8B BF16보다 비싸고 agentic에서는 싸다는 뜻입니다. 논문의 중심 예상, 범주별 역전 라우팅 표가 바로 이 계산에서 나옵니다.
실측 가능성 레이어: 메모리는 제약이 아니었다
실측 레이어는 의도적으로 얇고 그 얇은 레이어가 연구를 지탱합니다. H100 NVL, 93.6GB 노드에서 BF16 4B/8B/14B의 피크 VRAM은 7.5/15.3/27.5GB로, 가장 큰 14B도 용량의 29.4%까지였습니다.
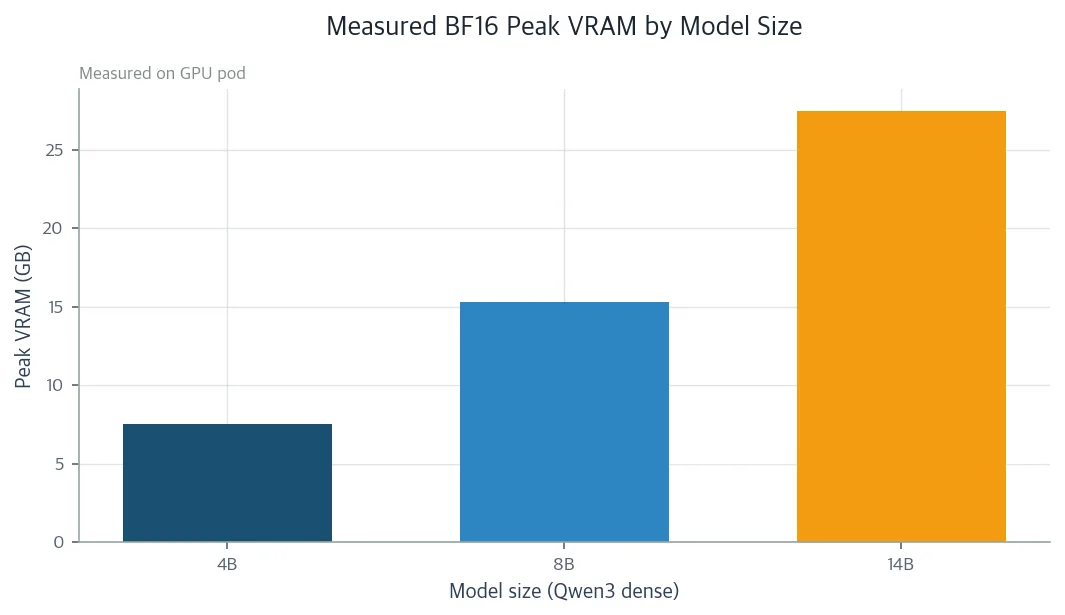 93.6GB 노드에서 Qwen3 4B/8B/14B 체크포인트의 실측 BF16 피크 VRAM입니다. 7.5/15.3/27.5GB로 70% 이상의 여력을 남겨, 가능 집합의 제약은 메모리가 아니라 스택이었습니다. (GPU 팟에서 실측)
66.1GB, 70% 이상의 여력이 남습니다. 바이트 패리티 산술로 27B 행까지 확장하면 BF16 54.0GB, FP8 27.0GB, NVFP4 15.2GB. 4×3 그리드 전체가 93.6GB에 올라옵니다. H200의 141GB에는 더 말할 것이 없습니다.
체크포인트 로딩 시간은 4B의 2.2초에서 14B의 5.0초까지 매끄럽게 늘어납니다. 세 체크포인트의 병렬 다운로드는 전부 171초 부근이고 가능성 패스의 총 벽 시간은 189.8초.
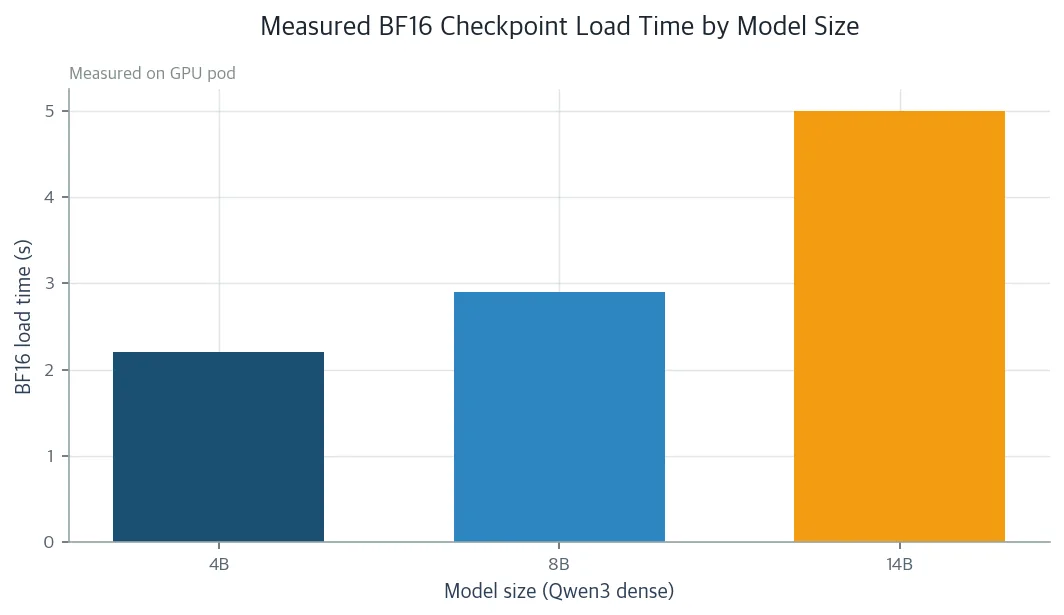 93.6GB 노드에서 실측한 BF16 체크포인트 로딩 시간. 4B의 2.2초에서 14B의 5.0초까지 매끄럽게 늘어납니다. 가능성 패스의 총 벽 시간은 189.8초였습니다. (GPU 팟에서 실측)
결정적인 제약은 메모리가 아니라 스택이었습니다. bitsandbytes의 8비트와 4비트 nf4 로딩 경로를 6번 시도, 세 크기 × 두 정밀도, 전부 실패했습니다. 이 스택에서 쓸 수 있는 로우비트 축은 프레임워크 네이티브 양자화 체크포인트, 곧 프로덕션 서빙 스택의 NVFP4뿐. 가능 집합 F는 메모리가 아니라 스택 지원으로 결정됩니다.
가격과 품질 앵커는 인용 입력입니다. GPU-시간당 H100 $2.50, H200 $3.50, B200 $5.00, RTX 5070 $0.60. H200/H100 비율은 1.4. 품질 앵커는 27B NVFP4 프로덕션 체크포인트의 800건 BFCL 스타일 스위트 전체 89.6% (2026-09-06)입니다.
검증 설계: 사전 등록 프로토콜과 반증 기준 R1-R4
그리드 셀의 품질-스루풋 값은 이 프로토콜의 출력으로 지정되어 있습니다. 워크로드는 simple 12건, parallel 8건, agentic 4건의 총 24건입니다. 토큰 예산은 simple 96, parallel 192, agentic 128. 단일 호출 카테고리는 EOS 비활성으로 고정 예산을 쓰고 agentic는 턴당 상한을 씁니다. 스루풋 프브는 동시성 C=8, N=64 시퀀스로 잡니다.
반증 가능한 예측, 세 개입니다. P1 사다리의 비퇴화, 세 카테고리 중 둘 이상이 다른 조합을 고릅니다. P2 캐스케이드 교차, 적어도 한 카테고리에서 BF16 행 밖의 로우비트 점이 최적입니다. P3 범주별 역전, 27B NVFP4가 agentic에서는 8B BF16을 이기고 simple에서는 이기지 못합니다.
반증 기준 R1-R4가 반대편을 닫습니다. R1은 8B BF16의 카테고리별 품질이 27B NVFP4 품질 × 스루풋 비율을 모든 카테고리에서 넘으면, 헤드라인 교차가 모든 카테고리에서 무효입니다. R2는 BF16 행이 모든 카테고리에서 지배하면 정밀도 축 자체가 게이트 아래에서 중복이라는 뜻입니다. R3은 8비트→4비트 세금 점프가 16비트→8비트 증가분을 넘지 못하면 초선형 절벽 예측이 반증되고 사다리 임계치는 선형 절벽으로 다시 유도됩니다. R4는 H200 실측이 H100 NVL 모델과 20%를 넘게 어긋나면 하드웨어 이관 정리가 반증됩니다.
회사가, 사회가, 과학이 얻는 것
회사에는 배포 가능한 라우팅 표가 남습니다. 카테고리당 하나씩, 게이트 g=0.85를 지키며 E를 최대화하는 (모델 × 정밀도) 조합. 현재 인용 앵커를 가진 로우비트 점은 27B NVFP4 하나뿐이라, 사다리의 첫 눈은 그 지점에 고정된다. 교차 테스트가 BF16 인컴벳 상대에서 성립하는 카테고리는 27B NVFP4로, 안 성립하는 카테고리는 FrugalGPT식 BF16 행을 유지한다.
이 표는 토크 팩터리의 4단 조합에서 한 단계를 차지한다. 제로 토크 스킬 라우터는 스킬을 카테고리별로 보낸다. 라우팅 표는 카테고리를 사다리의 눈으로 배정한다. 무료 결정적 밸리데이터의 검증 후 재시도는 엔드포인트 내부의 드로 수를 책임진다. 큐 인식 티어 폴백은 큐 압력 아래에서 다음 눈으로 내려가는 일이다. 청구서의 네 인자, 하드웨어 단가 p_h, 길이 정책 ℓ, 스루풋 t, 품질 Q를 네 단계가 각각 하나씩 소유한다. 어떤 레버가 하나만 바뀌어도 청구서는 그 자리에서 재스케일되고 나머지 구조는 건드리지 않는다.
재시도는 청구서에 영향을 주지 않는 것도 이때의 성립이다. 무료 결정적 밸리데이터 아래에서 통과한 과제당 기대 드로 수는 정확히 1/Q이며 재시도 예산은 포기자율만 움직인다. 폴백의 방향도 크기 순이 아니라 E 순이다. E에서 앞선 작은 로우비트 눈이, 큰 BF16 눈보다 먼저 갈 수 있는 합법적인 폴백 목적지다.
사회적으로는 무인 자동화의 달러와 전기가 줄어드는 지점이다. 큰 모델의 로우비트가 작은 풀프레션과 같은 품질에서 언제 싼지가 정량화되면, 셀프호스티드 서빙 운영자는 과제당 추론 지출을 줄이는 구체 레시피를 얻는다.
과학적으로는 FrugalGPT식 1차원 캐스케이드가 (모델 크기 × 양자화 정밀도)의 2차원 비용-품질 프런티어로 승격되는 지점이다. 에이전트 툴콜 워크로드에서, 범주별 로우비트 정확도 감소, 즉 툴콜 절벽과의 상호작용까지 포함해서이다. 교차 조건은 닫힌 형태이고 FrugalGPT 캐스케이드는 이 프런티어의 BF16 행 투영으로 흡수된다.
못 믿을 부분
이 논문은 해석 연구이다. 실측 레이어는 가능성 확인에 집중하고 그리드 셀의 품질과 스루풋 값은 새로운 측정이 아니다. 예시 계산의 시나리오 값, 8B BF16의 카테고리별 품질 0.95와 0.80은 가정이다.
첫 번째 경계는 Qwen3 dense 패밀리 하나이다. MoE 패밀리나 다른 패밀리로 이관은 열려 있다. MoE에서는 라우팅 일관 양자화가 특히 중요하다. 두 번째 경계는 하드웨어 이관이다. 실측은 H100 NVL이고 배포 목표는 H200이다. 이관 정리는 공통 인자 β_c가 가격 비율 1.4를 넘을 때만 절대 달러 비용이 개선된다는 조건부이다. R4가 그 오차를 감시한다.
게이트도 g=0.85 하나에서 고정이다. 다른 운영점은 같은 닫힌 형태로 다시 토크되지만 프로토콜 재실행이 필요하다. 공유 레짐 가정도 기억해 두십시오. ρ_c^ℓ=1은 길이 부풀림이 없다는 뜻이고 로우비트가 추론 토큰을 부풀리거나 압축된 모델에서 침묵 오류가 늘면 ρ_c^ℓ>1 또는 ρ_c^r<1이 되어 필요한 배당이 올라가고 교차 집합은 줄어듭니다. 보수적인 방향이지만 부등식을 읽을 때 그 빛 아래에서 읽어야 합니다. 가격도 퍼블릭 온디맨드 리스트 프라이스. 스팟이나 프리엠티블, 내부 전력 가격이 p_h의 레벨을 바꿔도, 레마 1에 의해 사다리의 순서 자체는 움직일 수 없습니다.
마지막으로, 실현되는 레짐이 아직 답이 없습니다. 사다리, 빈 교차, 로우비트 지배 세 갈래 중 어느 쪽이 뜨는지는 R1-R4 실행 이후. 다만 부호가 틀려야 할 지점은 이미 정해져 있습니다. 그 결과를 닫는 프로토콜을 함께 읽으면 됩니다.
논문 원문과 데이터: https://huggingface.co/datasets/thaki-AI/daily-paper-2026-09-27-precision-ladder-model-quant-routing