틀리면 작업 통째, 의심하면 호출 한 번: 2,000스킬 라우터의 veto frontier
매 턴마다 스킬 2,000개를 자동 라우팅으로 돌리는 에이전트를 운영하거나, 그 라우팅 비용을 재는 플랫폼 팀이라면 이 글이 대상입니다. 스킬을 하나 잘못 골라 실행을 보낸 대가는 작업 통째가 사라지는 것이며, 의심해서 AI 심판을 한 번 더 부르는 대가는 그 호출 하나입니다. 이 비대칭을 계산에 넣는 순간, 라우터의 ‘정확도’는 더 이상 답이 아닙니다. 이 논문이 답하는 질문은 둘입니다. 첫 번째는 1위와 2위의 점수 차이가 실제 틀림 확률을 얼마나 잘 나타내는지입니다. 두 번째는 어느 지점에서 자동 실행을 멈추고 심판 호출로 넘길 때 총 비용이 가장 작은지입니다. 결론은 하나입니다. 그 차이를 결정하는 것은 교정(calibration)인 셈. 그리고 교정의 손익분기는 p* = p_j + C_e/C_r이라는 하나의 상수로 정리됩니다.
 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
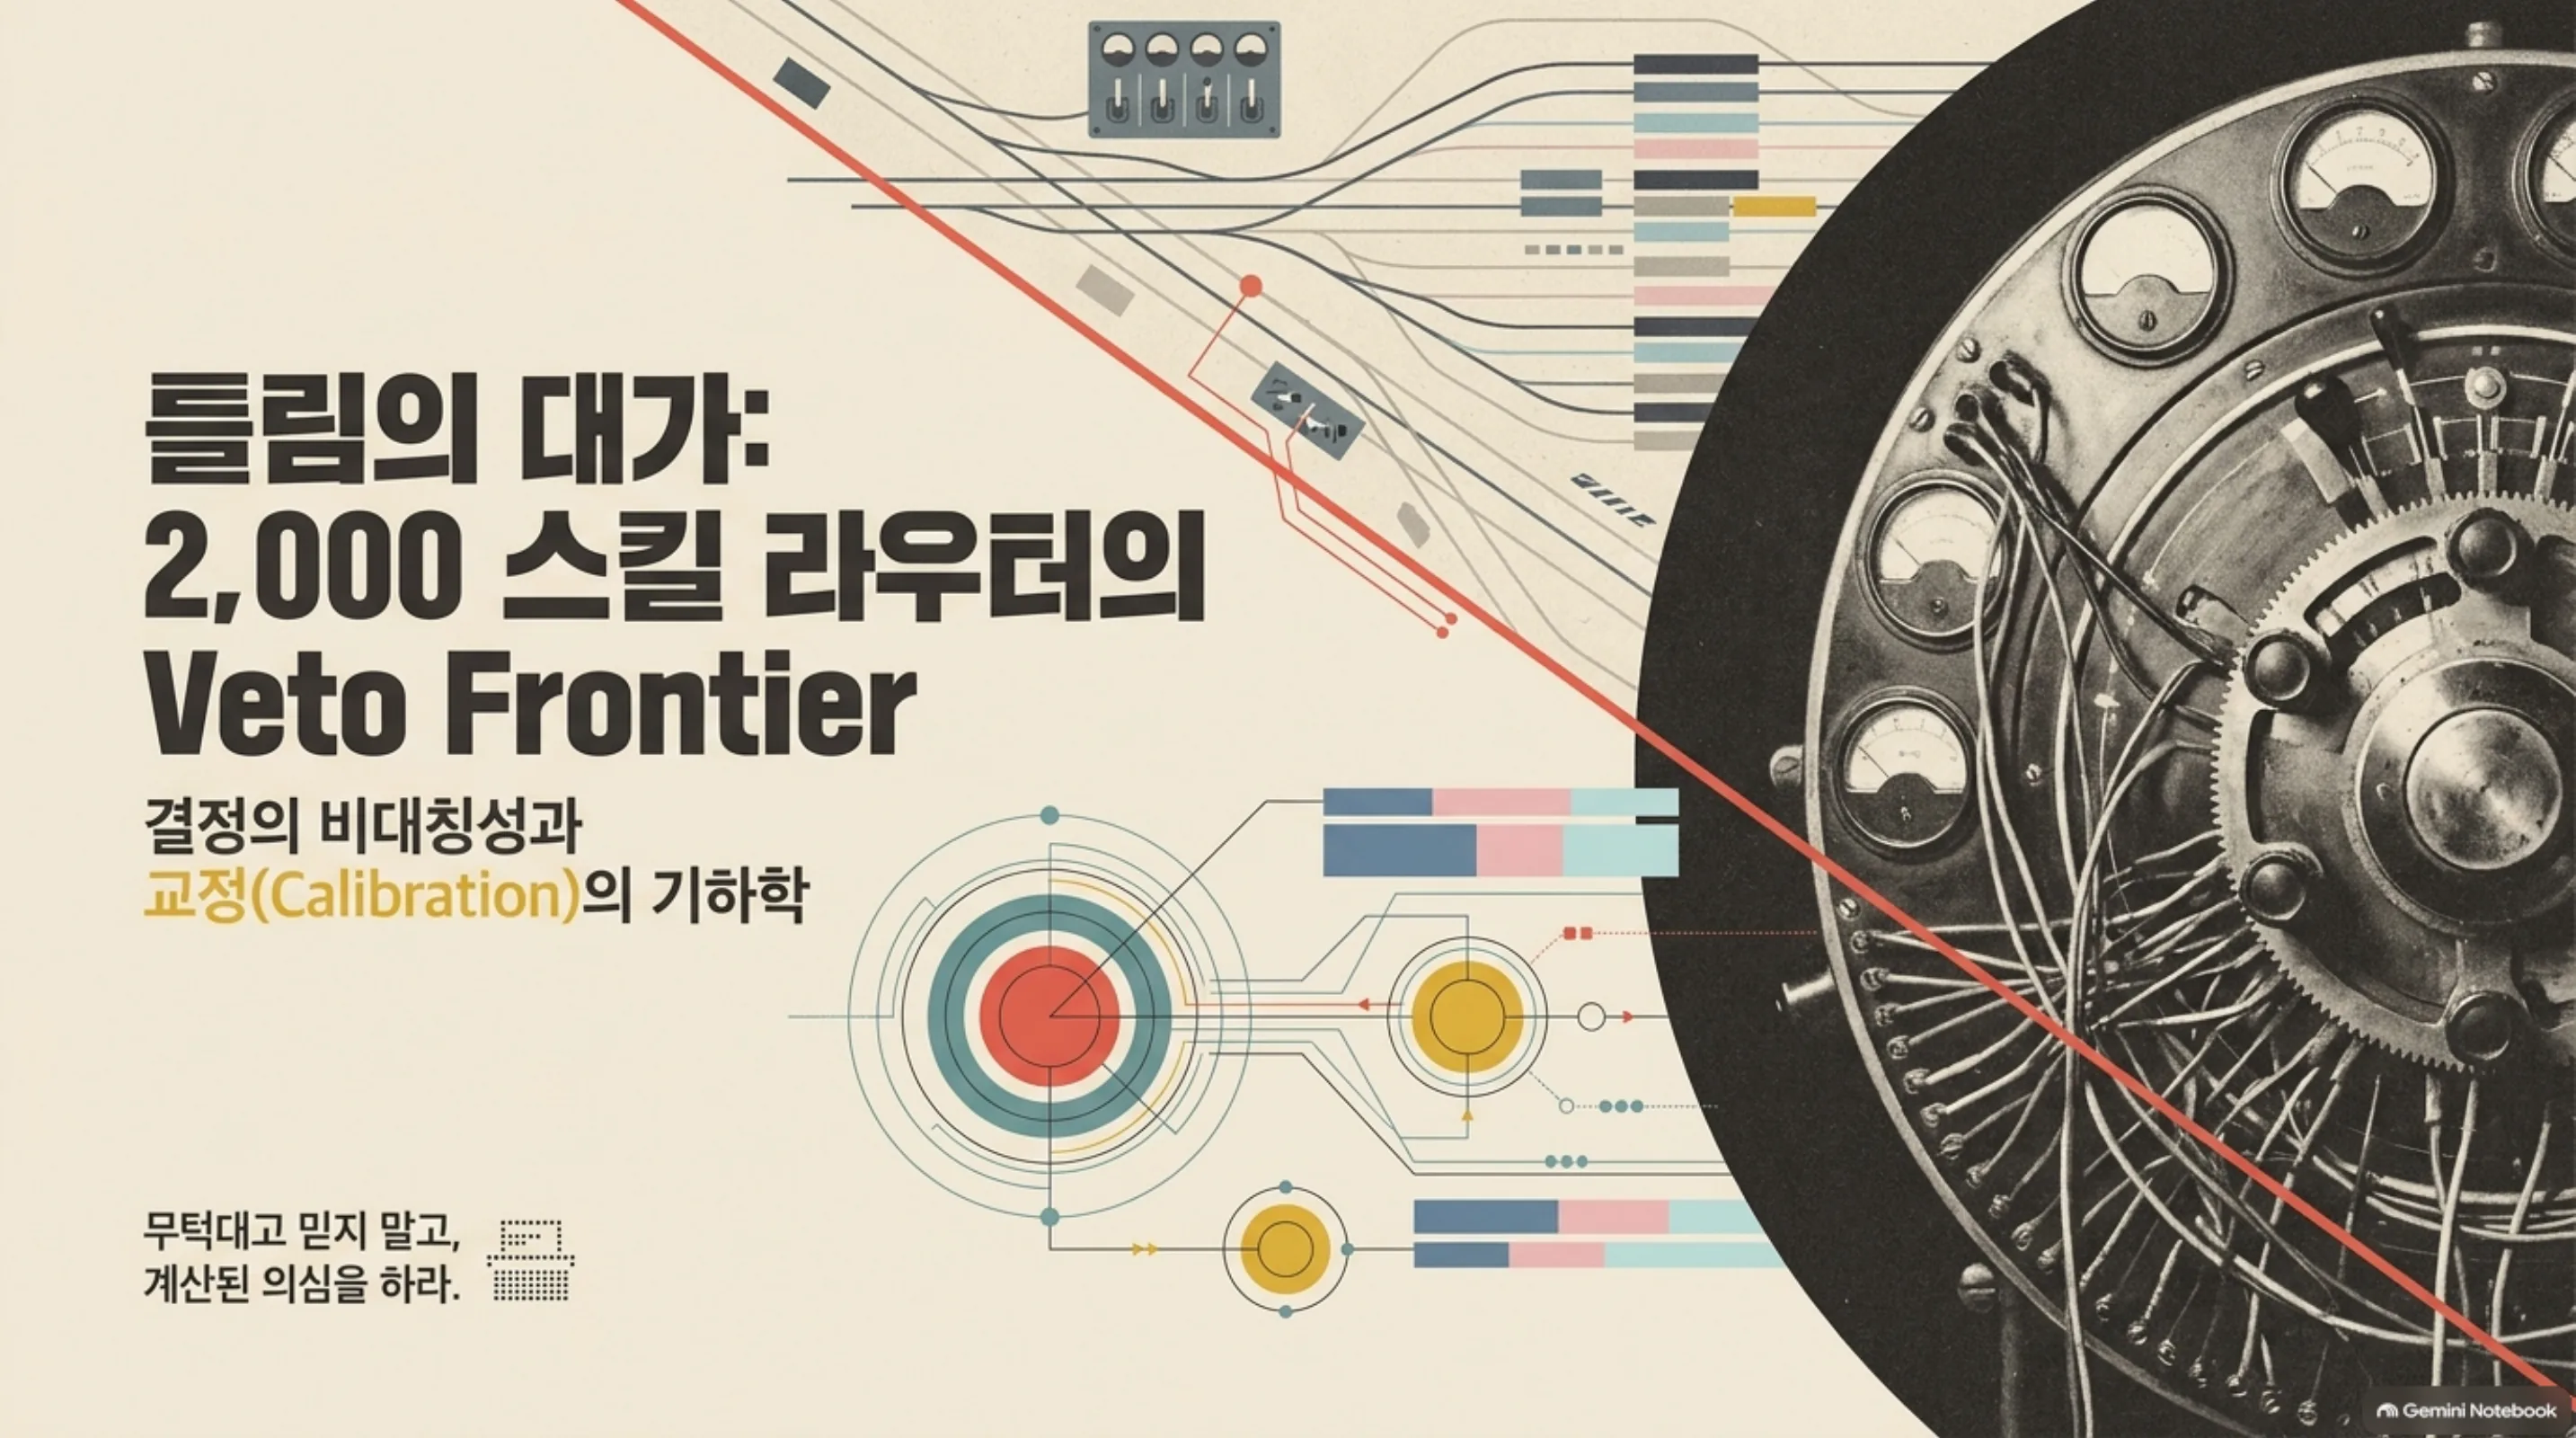
메뉴가 2,000개 달린 식당을 상상해 보십시오. 주문이 오면 웨이터가 메뉴에서 하나를 골라 바로 주방에 보냅니다. 웨이터가 잘못 읽으면 음식은 망가지고, 식사 통째가 망가집니다. 대신 웨이터가 ‘잘 모르겠다’며 매니저에게 한 번 확인하면, 대가는 그 확인 하나이고 식사는 제대로 나갑니다.
이 논문은 2,000개 메뉴 중 하나를 골라야 하는 웨이터의 세계에서, ‘매니저에게 확인을 맡길 가치’가 있는 지점을 계산하는 글입니다. 웨이터는 스킬을 고르는 라우터이고 잘못 읽기는 틀린 라우팅이며 매니저는 확신이 없을 때만 부르는 AI 심판, LLM 심판(judge)입니다. 웨이터의 ‘확신’은 1위 메뉴와 2위 메뉴 점수 차, 마진의 크기입니다. 핵심은 두 가지입니다. 그 차이가 잘못 읽을 확률을 얼마나 잘 말해 주는지를 알면, 어느 차이부터 매니저에게 가야 하는지 정해집니다.
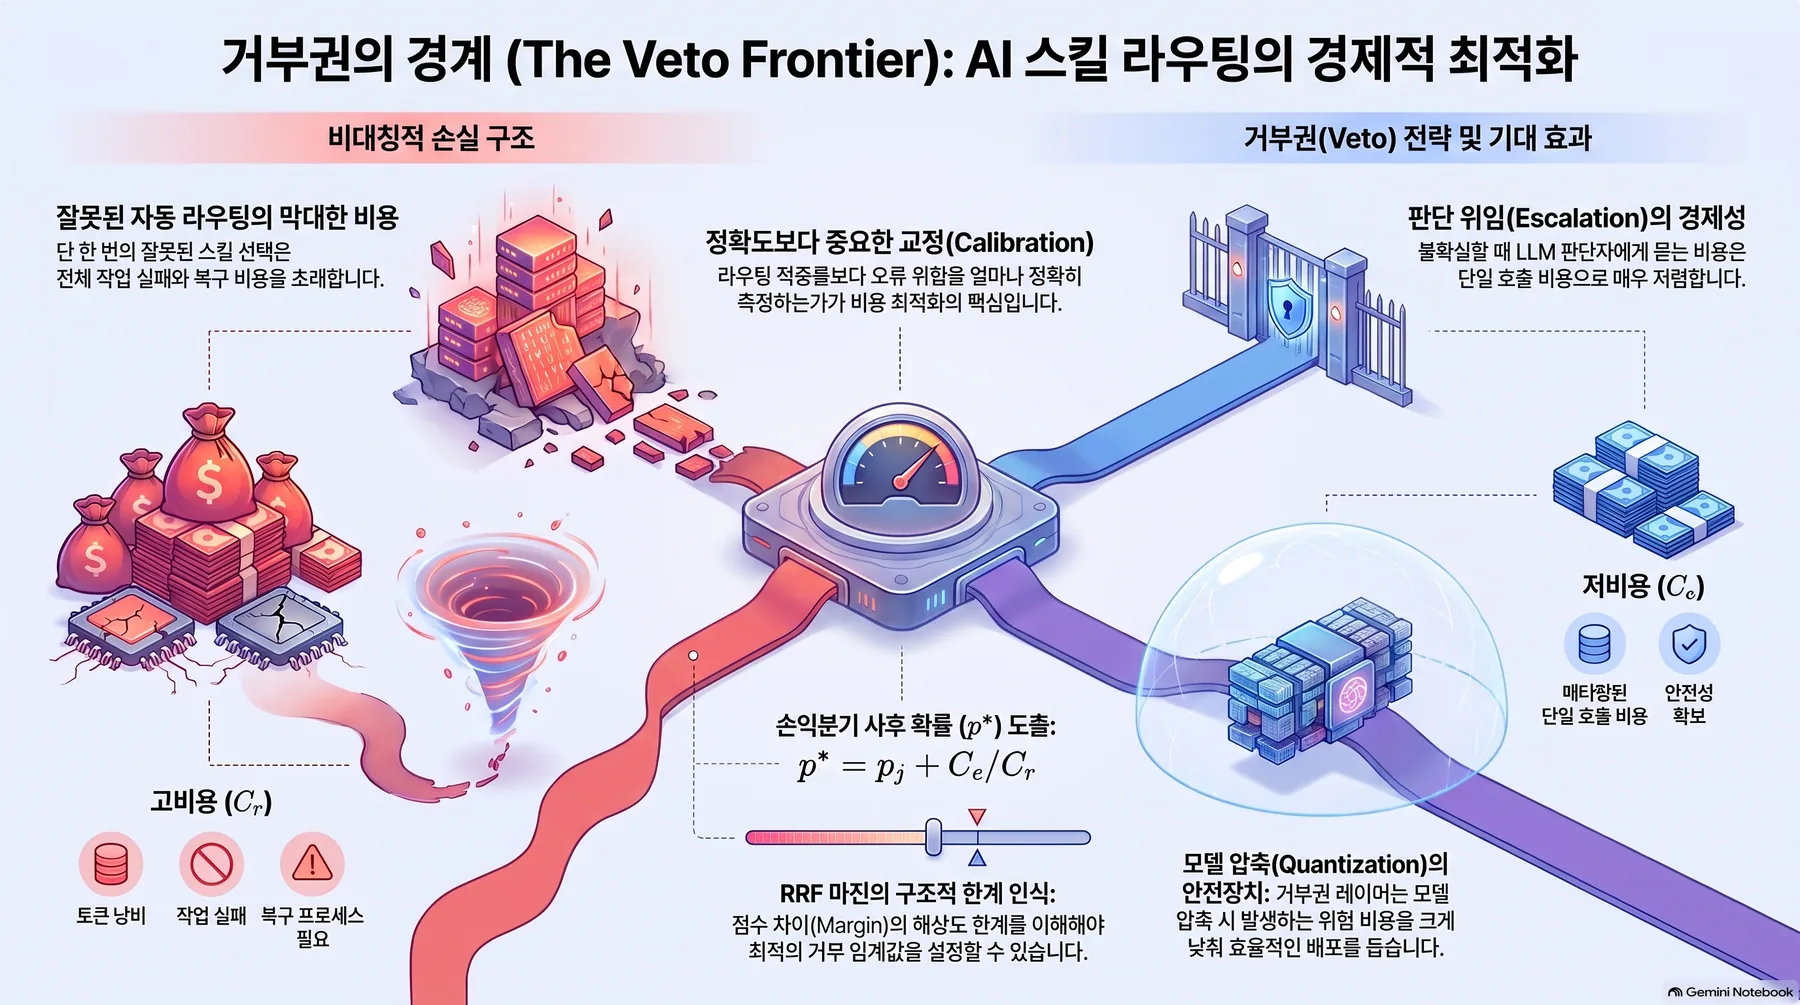 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
틀리면 작업이 통째, 의심하면 호출 한 번
이 작업의 동기인 배포 환경에서는 스킬 카탈로그가 2,000개 안팎입니다. 이전 압축 연구에서는 1,910개를, 시퀀스 라우팅 연구에서는 2,275개를 실측했습니다. 매 턴마다 라우터는 그중 하나, top-1을 골라 실행에 넘겨야 합니다. 라우터는 어휘 BM25와 dense embedding 두 개의 순서를 역순위 합산(reciprocal rank fusion, RRF)으로 융합합니다. RRF 점수에서 top-1과 2위의 차이, 점수 마진(margin)이 이 환경이 가진 유일한 쿼리별 확신입니다.
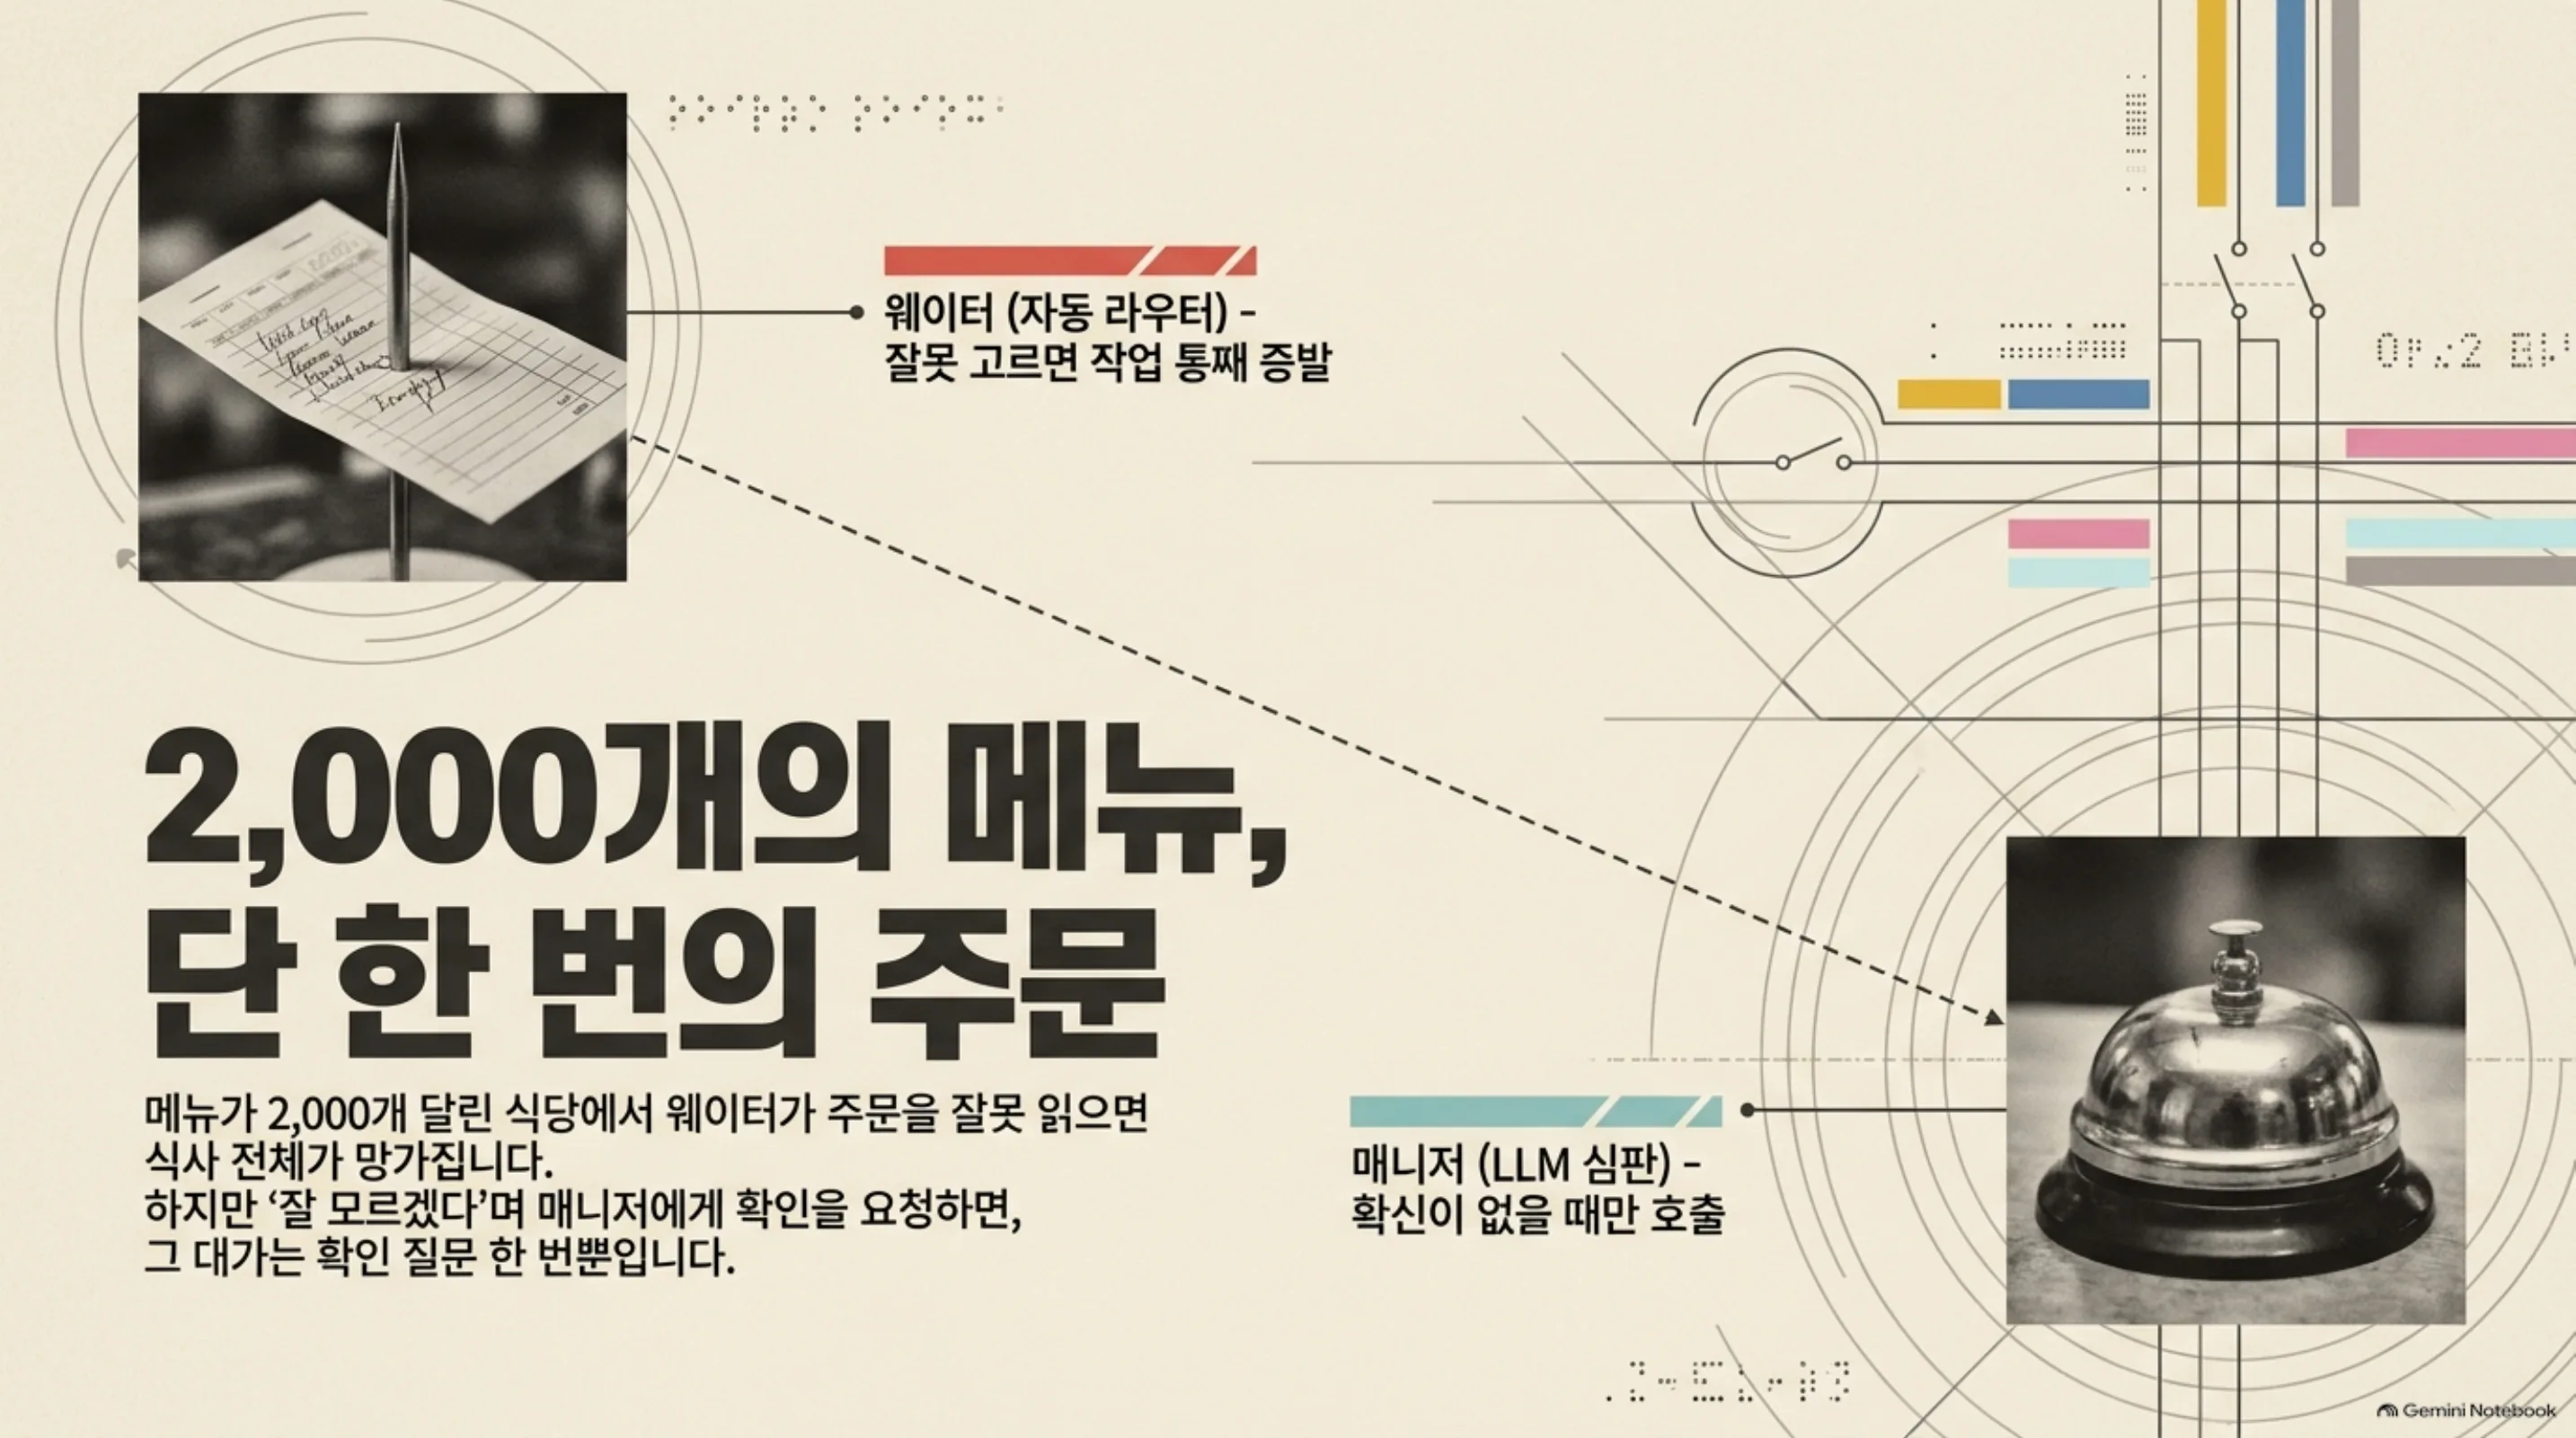
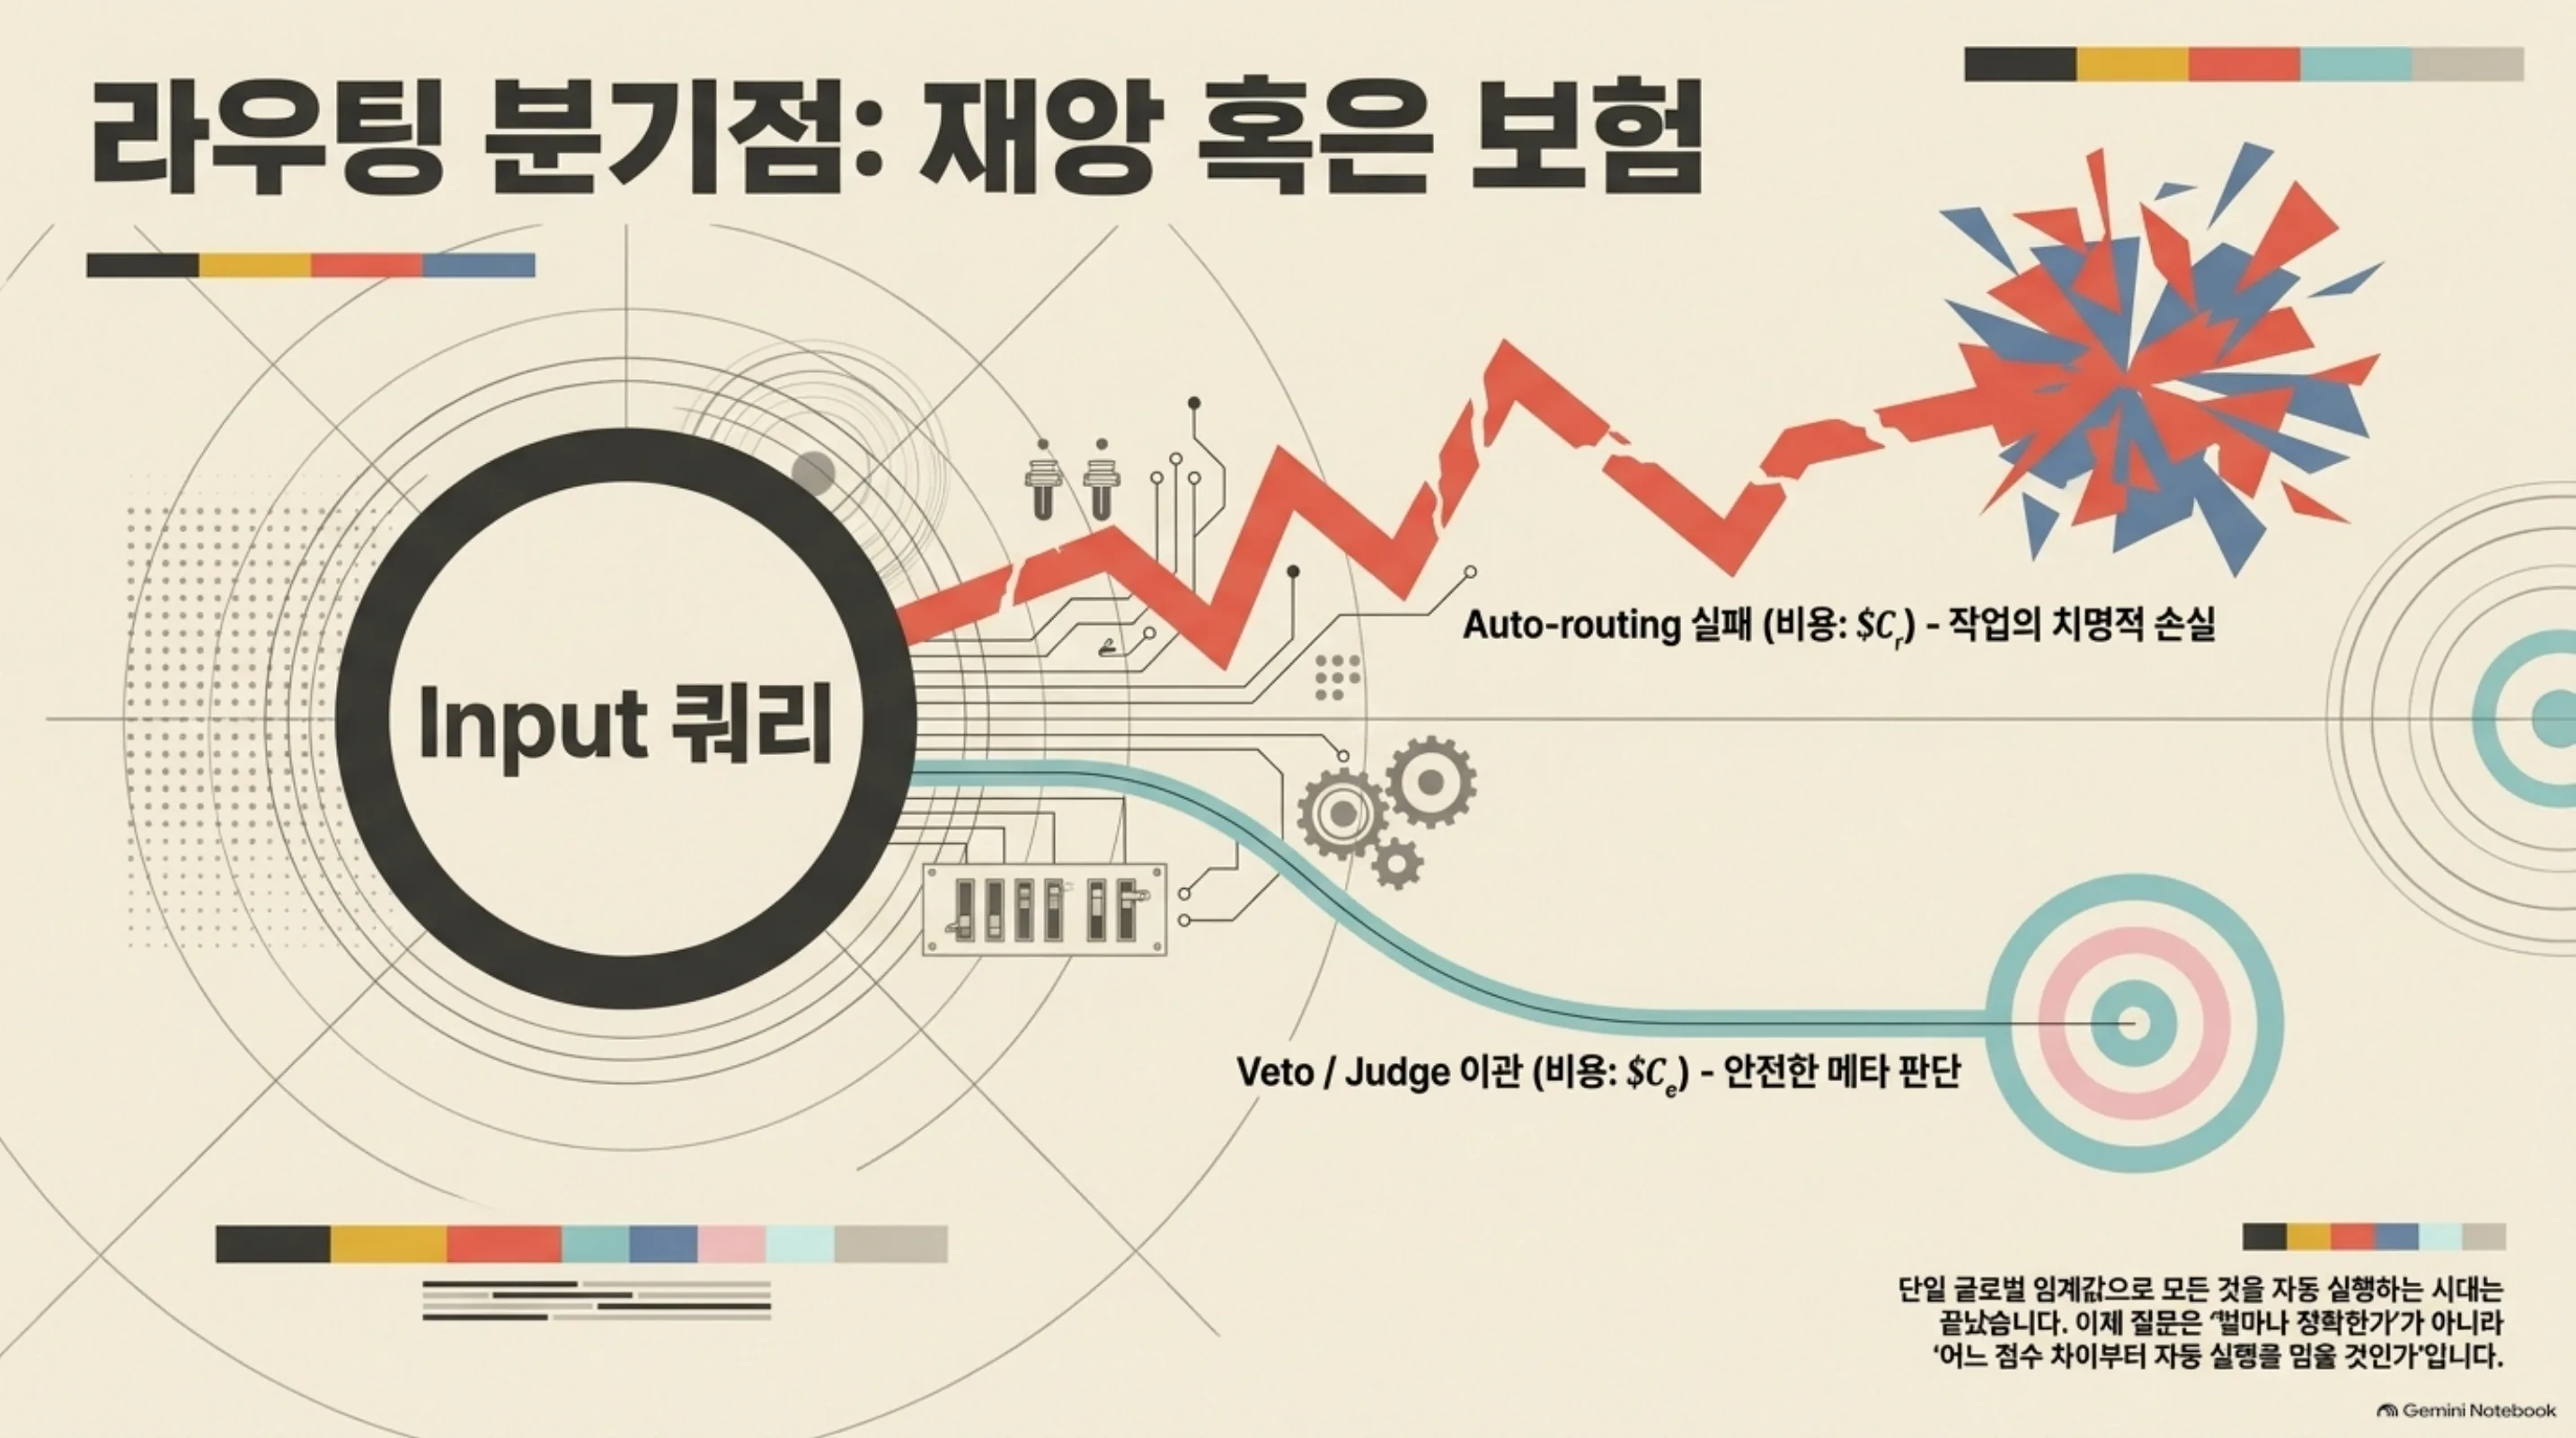
비용은 비대칭입니다. 자동 라우팅이 맞으면 대가는 스킬의 downstream execution 비용뿐입니다. 틀리면 실행 토큰, 실패하거나 오도하는 산출물, 그리고 그 뒤를 잇는 복구 경로까지 통째로 사라집니다. 반면 이관(escalation)은 상위 5개 shortlist에 대한 metered 호출 한 번이지요. 심판은 확률 p_j로 틀리지만 오차 페널티 C_r이 심판 호출 비용 C_e보다 훨씬 큰 세계에서는 의심이 실수보다 언제나 쌉니다. 그래서 질문은 라우터의 정확도가 아닙니다. 어느 마진부터 자동 실행의 기대 비용이 의심의 기대 비용보다 낮은가, 그것이 질문입니다.
그 질문이 성립하려면 마진이 교정되어 있어야 합니다. 마진 값을 읽으면 틀림 확률이 바로 읽혀야 한다는 뜻입니다. 그래야 임계값을 어디에 두느냐가 비용 계산이 되고 그렇지 않으면 임계값 위치를 어디로 옮기든 계산은 무의미합니다. 기존 스킬 라우팅 연구들은 전부 정확도 중심입니다. hit@k와 MRR을 최적화하고 라우터를 always-on으로 둡니다. 확신은 드물게 등장해 tie-breaker로 쓰일 뿐입니다. 라우터가 스스로 결정을 멈출 수 있는가, 멈추면 얼마를 쓰고 얼마를 아끼는가는 아무도 묻지 않은 질문입니다.
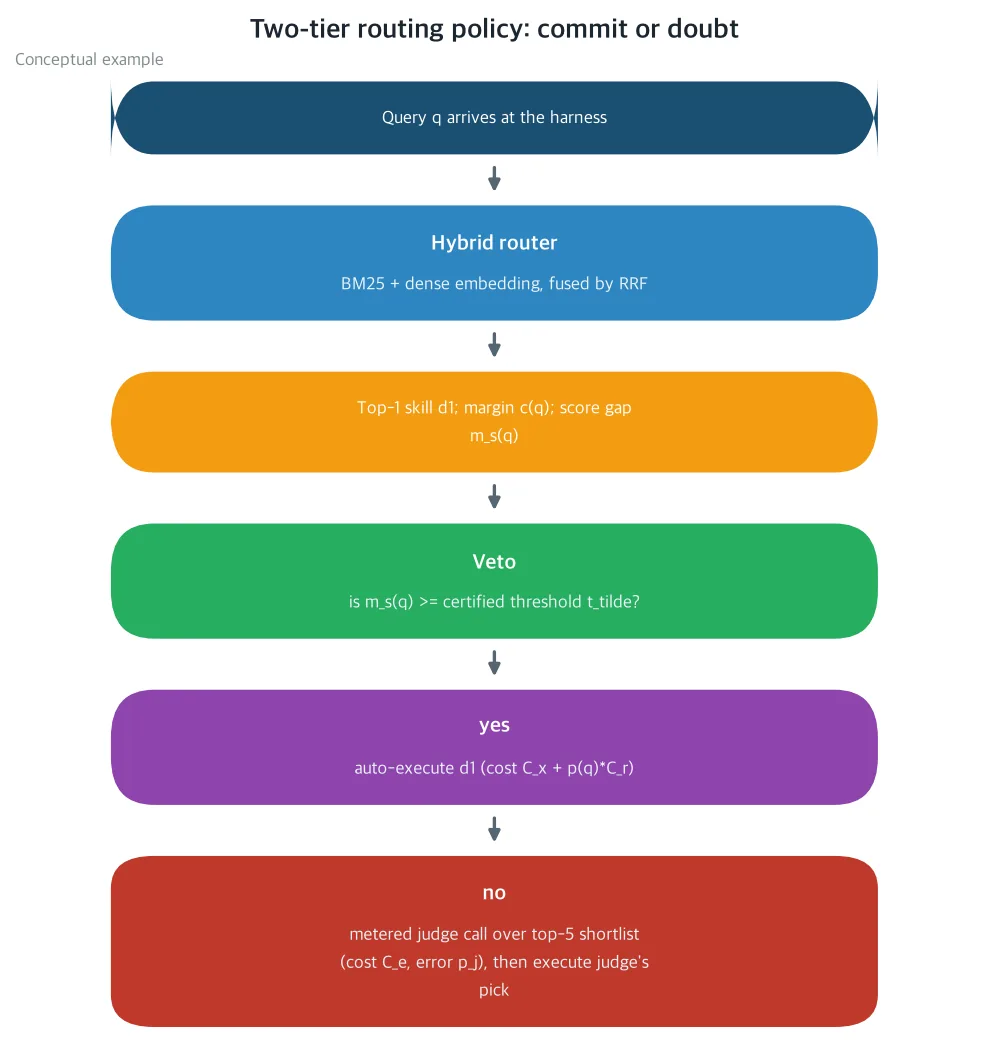 모든 쿼리가 하이브리드 RRF 라우터로 점수를 받고 거부(veto) 레이어가 점수 차이가 인증 임계값을 넘으면 top-1 스킬을 바로 실행하고 넘지 못하면 metered 심판 호출 한 번을 씁니다. C_r이 C_e보다 훨씬 크다는 비대칭이 ‘의심’을 싼 쪽으로 만듭니다. 개념 예시입니다.
p* = p_j + C_e/C_r: 의신이 보험이 되는 지점
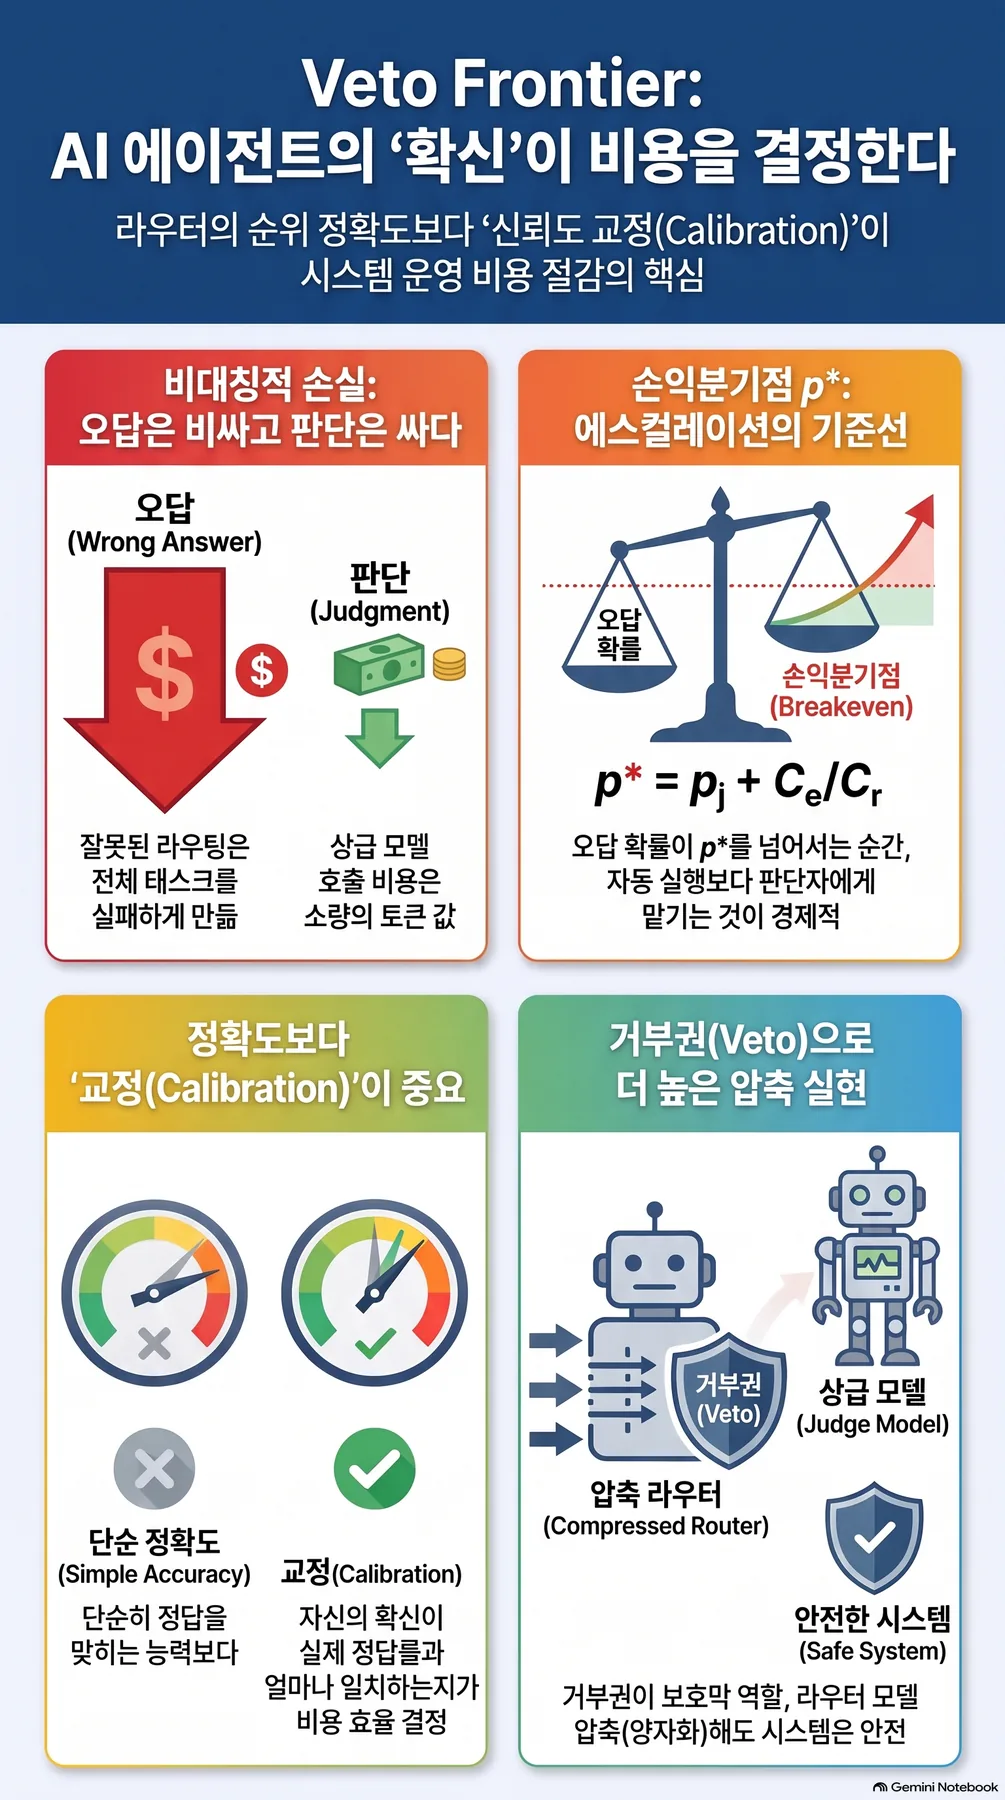
손익분기 posterior는 단순합니다. 쿼리 q의 틀림 확률 p(q)가 p* = p_j + C_e/C_r보다 크면, 그 쿼리에서 심판 이관이 자동 실행보다 항상 쌉니다. 작으면 반대로 자동 실행이 싸고 심판 호출은 헛돈입니다. ‘확신’과 ‘의심’을 나누는 상수가 이것이라, 이름을 붙일 가치가 있습니다. 즉, 사람 말로는 p*가 ‘심판 호출 한 번’을 ‘틀림 확률’로 환산하는 환율입니다. 식당 말로는, 매니저에게 한 번 확인하는 대가를 잘못 읽기 확률로 환산한 값입니다.
네 가지 귀결이 따릅니다. 첫째, abstention은 fallback의 수준이 아닙니다. 보험입니다. 심판의 오차율이 이관된 집합에서 자동 라우터에 육박하면 p는 1에 붙고 마진이 아무리 잘 교정돼도 의심은 거의 의미가 없습니다. 둘째, 심판이 무료가 되면 C_e는 0으로, p는 p_j로 떨어지고 완전한 무료 심판은 posterior 오차가 0인 쿼리만 자동 실행에 남깁니다. 셋째, p_j + C_e/C_r이 1 이상이면 이관은 언제나 순비용입니다. 정답은 심판 타이어를 바꾸는 것입니다. 거부 범위를 넓히는 것은 비용만 늘어납니다. 넷째, C_r은 스킬 클래스마다 다르므로 p*도 클래스마다 다르고 단일 global 임계값은 잘못된 대상입니다.
두 번째 결과는 regret 상한입니다. 마진에서 틀림 확률 추정치를 만들어, 추정치가 p* 이하면 자동 실행으로 가는 정책을 씁니다. 그 정책이 최적 정책(Bayes policy)보다 내는 초과 비용은 C_r에, 추정치와 실제 확률의 평균 절대 차이를 곱한 값 이하로 묶습니다. 교정이 ε만큼 어긋나면 쿼리당 C_r × ε를 넘는 초과 비용은 나오지 않습니다. 마진이 오차 위험을 완벽히 잘 서열화해도, 값이 확률로 환산될 때의 어긋남이 비용의 전부입니다. 비용에 바인딩되는 양은 정확도가 아니라 교정입니다.
세 번째 결과는 연구 질문을 하나의 부호 검사로 압축합니다. 마진 임계값 c에서 자동 실행하는 정책을 쓰면, ‘항상 자동 실행’을 이기려면 이관된 집합, 마진이 c 이하인 쿼리들의 조건 오차율 r(c)이 p를 넘어야 합니다. 마진이 어느 구간에서도 p를 넘지 못하면, 임계값을 어디에 두어도 거부 레이어는 순비용입니다. 곧 라우터가 확실히 틀리는(confidently wrong) 경우, 오차가 높은 마진에 몰려 있으면, 투자 방향은 임계값을 다듬는 쪽이 아닙니다. 스킬 설명의 품질, 심판 타이어, 검색 커버리지로 가야 합니다. 반대로 마진이 신뢰할 수 있는 위험 신호라면 r(c)는 어딘가에서 p*를 넘나들고 그 교차점이 운영점입니다.
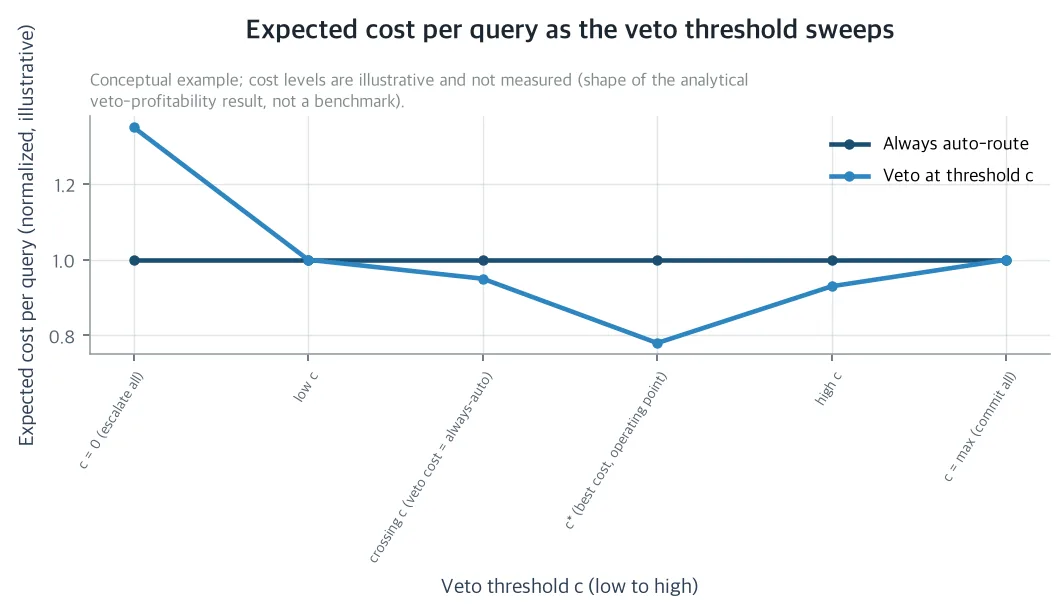 항상 자동 실행은 일정한 기대 비용을 냅니다. 임계값 거부는 모든 쿼리를 이관할 때 가장 비싸고 이관 집합의 오차율이 p를 넘나드는 지점에서 항상 자동 실행선을 교차하며 운영점에서 최저에 닿은 뒤 모든 것을 자동 실행할 때 원래 비용으로 돌아옵니다. 분석 모델 도식이며 실측 값이 아닙니다.*
RRF 마진은 확률값이 아니라 서수: 유한 격자
RRF 마진은 신경망의 confidence가 아닙니다. 순위 융합의 성질입니다. 그 기하학이 어떤 임계값 정책의 분해능도 묽습니다. 먼저, 마진은 top-1과 top-2의 어휘 순위와 dense 순서, 4개의 순위 정수만으로 결정됩니다. 이 네 순위가 유지되는 한 기저 점수가 아무리 흔들려도 거부 판단은 바뀌지 않습니다. 흔들림이 인접 순위 간 점수 차이 전체만큼 커도 마찬가지입니다. 같은 순위 프로필이지만 주제 모호성이 다른 두 쿼리는, 예를 들어 두 스킬이 짝지어진 쿼리에서 역할을 뒤바꾸는 경우, 똑같은 거부 판정을 받습니다.
둘째, 범위는 유한합니다. ranker 둘, 후보 N개라면 마진의 이론적 최대값은 2/(k+1) - 2/(k+N)입니다. k=60, N=2,000에서는 3.2퍼센트를 넘지 못합니다. 1위와 2위가 두 ranker에서 모두 인접한, 가장 치열한 top-2의 마진은 2,000분의 1도 안 되는 크기입니다. 마진이 순위 튜플의 함수이므로 값의 지지집합은 유한한 격자, 최대 N^4개이고 coverage-risk 곡선은 그 위에서 구간별로 상수입니다. 다시 말해, 마진은 눈금이 적은 자리이고 그 눈금은 거부 레이어가 자르는 지점 근처에서 가장 거칩니다.
결국 임계값 정책의 분해능이 가장 거친 곳이, 바로 거부 레이어가 일하는 곳입니다. 마진 분포의 상단 근처에서는 서로 다른 점수 구성이 같은 마진 값으로 몰립니다. 임계값이 실제로 놓일 수 있는 유효한 위치는 연속 스케일이 보여주는 것보다 훨씬 적습니다. 실용적 귀결은 하나입니다. 배포 환경은 RRF 마진(융합이 이미 만들어낸 결정 통계량)과 점수 공간 gap(순위 안의 분리 정보를 가진 두 번째 신호)을 둘 다 저장해야 합니다. 둘은 다음 섹션의 인증 임계값에서 각자 다른 역할을 합니다.
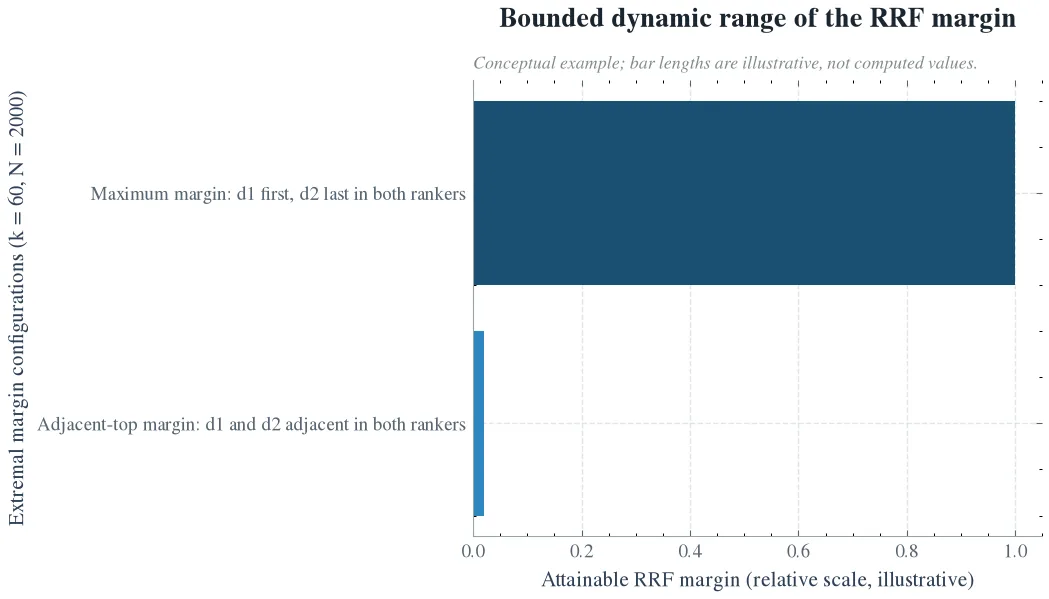 RRF 마진은 유한한 순위 격자 위의 값이라 도달 가능한 범위가 유한합니다. k=60, N=2,000에서 최대 마진은 0.0318, 두 ranker에서 모두 인접한 1·2위 마진은 0.00053, 곧 2/((k+1)(k+2))입니다. 임계값 분해능은 거부 레이어가 실제로 일하는 인접 top 구간에서 가장 거칩니다. 개념 예시이며 막대 길이는 계산된 값이 아닙니다. 설명용입니다.*
거부 레이어가 양자화 여지를 사는 합성
바로 이전 연구는 이 라우터의 확신 신호를 더 싸게 만들 수 있는지 물었습니다. embedding 쪽을 양자화했을 때 융합 점수가 얼마나 흔들리는지 상한을 묶고, 주어진 비트 폭 b에서 top-1이 불변임을 인증하는 rank-safety 밴드를 유도했습니다. 인증되지 않은 쿼리, at-risk 분율 ρ(b)는 전부 ‘틀린 라우팅 한 번’의 비용으로 가격 매겼습니다. 그런데 그 밴드도 라우터는 그냥 넘기지 않았습니다. 모든 것을 확신하고 실행에 돌렸습니다.
이 논문은 그 안전 밴드와 교정 손익분기를 합성합니다. 교정된 posterior가 p에 닿는 점수 gap t와 양자화 흔들림 상한을 하나로 묶으면, ‘gap이 max(t*, Δ_RRF(b)) 이상이면 자동 실행’이라는 단일 인증 임계값이 나옵니다. 이 정책을 쓰면 세 가지가 동시에 성립합니다. 자동 실행된 모든 쿼리는 양자화 인증을 받으므로 압축이 rank-flip 오차를 만들지 않습니다. 초과 이관은 at-risk 밴드 분율 이하, 쿼리당 ρ(b) × C_e 이하입니다. 오차율은 절대 오르지 않습니다.
핵심은 재가격입니다. 이전 연구의 채택 조건은 ‘절감 ≥ at-risk 분율 × 틀린 라우팅 비용’이었습니다. 이제 그 밴드는 심판 호출 비용 C_e로 다시 가격 매겨집니다. C_e는 C_r의 극소 부분이므로, 거부 레이어를 단 라우터는 같은 라우터가 전부 자동 실행할 때보다 훨씬 더 큰 압축을 견디는 셈입니다. 거부 레이어가 양자화 headroom을 산다는 뜻입니다. 이전 연구가 보수적으로 worst-case 밴드로 잡은 것이, 싼 이관 밴드로 바뀝니다. 식당 말로는, 매니저가 오해를 받아 가니까 메뉴책은 좀 더 얇고 싼 인쇄로 바꿔도 되는 겁니다.
실제 배포의 융합은 RRF이고 blend weight가 없으므로, 이전 상한은 rank 이동 단위로 다시 유도해야 합니다. embedding 쪽의 양자화가 top-2 후보의 dense rank를 δ_r(b)칸까지 움직인다면, worst-case 마진 침식은 2δ_r/(k+1)² 이하입니다. k=60에서 rank 이동 한 칸은 RRF 마진을 약 2,000분의 1, 인접 top-2 마진과 같은 수준으로 깎습니다. RRF 공간의 인증은 본질적으로 거칩니다. top-2가 dense 쪽에서 인접하지 않은 쿼리 위주로만 인증되므로, 교정의 분해능을 묶던 격자가 양자화 인증의 정밀도도 같은 수준에서 묶습니다. 두 진단이 RRF 아래에서 공통의 분해능 한계를 공유합니다. bound는 1차 worst-case입니다. δ_r이 헐거우면 오신고가 나는데, 그건 안전합니다. δ_r이 실제를 못 덮으면 인증이 조용히 무효가 됩니다.
회사에, 사회에, 과학에 남는 것
회사 쪽으로는 두 가지가 남습니다. 첫째, 거부 레이어가 ThakiCloud 자체의 2,000개 스킬 레지스트리에서 틀린 라우팅으로 통째로 날아가는 실행을 줄여냅니다. 심판 호출은 그 이관이 비용을 갚는 지점에서만 쓰입니다. Metis의 작업당 비용과 무인 자동화 신뢰성에 직접 닿는 레버입니다. 둘째, 인증 임계값이 embedding 쪽의 양자화 채택 조건을 크게 이완시킵니다. 라우터가 더 낮은 비트 폭에서 top-1을 지킬 수 있게 되면, 라우팅의 추론 비용도 함께 내려갑니다.
사회 쪽으로는 ‘자기 모른 것을 아는’ 에이전트가 남습니다. 무인 에이전트의 예산은 실행과 의심, 두 가지에 쓰입니다. 정확도 중심의 프로그램은 전자를 최적화하고 후자를 무료인 것처럼 다룹니다. 이 논문은 둘을 하나의 상수 p*에서 교환한다고 보여줍니다. 2,000개 스킬 레지스트리가 무기한으로 돌 때, 자주 맞는 라우터와 틀려도 되는 라우터의 차이는 그 상수의 교정에서 나옵니다. 고비용의, 또는 환각적인 스킬 실행이 줄어듭니다. 무인 업무 자동화의 토큰과 에너지 footprint도 함께 낮아집니다.
과학 쪽으로는 비대칭 손실 아래 LLM 에이전트 스킬 라우팅의 첫 calibration과 selective prediction 분석입니다. 기존 learning-to-defer와 cascade 라우팅 연구는 모델 tier 사이에서 답을 이관합니다. 싼 tier가 실패해도 답이 degraded 될 뿐입니다. 스킬 라우터가 실패하면 실행 자체가 통째로 날아갑니다. 손실의 비대칭은 크기에서 오지 않습니다. 종류에서 옵니다. 그래서 break-even과 regret은 commit/doubt, 즉 확신과 의심이라는 행위 쌍에 대해 유도됩니다. cascade 연구가 쓰는 route/escalate 쌍과는 행위 자체가 다릅니다. RRF 마진의 calibration 오차(ECE, expected calibration error), coverage-risk 곡선, break-even abstention 임계값은 정확도 중심 라우팅 연구가 한 번도 재지 않은 축이고 이 논문은 그 축을 정형화합니다.
아직 못 믿을 부분
이 논문은 분석 연구입니다. RRF의 정의에서 나오는 구조적 사실 외에는 empirical claim을 내지 않습니다. 열린 양은 전부 5단계 검증 프로토콜에 넘겨져 있습니다. 63개 골든 라우팅 세트(sra_bench, route_bench) 위에서 live 마진과 Metis metered 심판 호출로 각각 고정됩니다. n=63이라 bin별 추정치는 넓습니다. 4단계는 부호 검사이지, 크기의 추정치는 아닙니다. 마진이 확실히 틀리는 쪽이면 거부 레이어는 순비용이고 그 부호는 4단계에서 읽힙니다.
이상화도 몇 개 있습니다. 심판 오차율 p_j는 이관 집합 전체에 대한 상수로 두었지만, 이관 집합이 이질적이라면 이 가정은 깨집니다. 논문은 p_j를 전 범위 평균으로 두지 않고 실제로 심판이 쓰이는 이관 집합 위에서 재도록 일부 교정합니다. gold label 자체에도 노이즈가 있습니다. 그 노이즈는 동등한 능력을 가진 스킬 쌍, 곧 거부 레이어가 보호하려는 모호한 쿼리에 정확히 떨어집니다. C_e는 모델 tier와 shortlist 크기와 프롬프트 길이에 따라 바뀌는 endpoint 특정 값이므로, 심판 tier가 바뀌면 p*를 다시 유도해야 합니다.
거부가 사는 것과 안 사는 것도 구분해 둡니다. 거부 레이어는 단일 스텝 라우팅 위험을 심판 tier로 옮길 뿐입니다. gold 스킬이 shortlist에 없으면 심판도 같은 검색 맹점을 공유합니다. 이전 시퀀스 라우팅 연구는 복합 작업에서 top-20 검색 풀이 gold 스킬의 약 24퍼센트를 놓친다고 실측했습니다. pool 안에서 라우터가 틀리는 것에 대한 보험이지, pool 자체에 대한 보험이 아닙니다. 클래스별 임계값도 같은 이유로 필요합니다. read-only 스킬과 destructive 스킬의 C_r은 다르고 단일 global 임계값은 잘못된 대상입니다. 마진은 catalog drift, 곧 매일 들어오는 새 스킬과 설명 재작성과 중복 제거에 따라 stale해집니다. rolling window에 대한 재교정(conformal recalibration)이 자연스러운 동반자입니다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Veto Frontier: Measuring Skill-Router Calibration and the Asymmetric Cost of Abstaining vs. Auto-Routing in a 2,000-Skill Agent Harness
이 글의 세 장은 전부 개념 예시와 분석 모델 도식입니다. 어떤 곡선도 실측 값이 아닙니다. 수치는 프로토콜의 live 마진과 metered 심판 호출이 채웁니다.
 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.