The Culling Dividend: 자기 진화형 2,200-skill 레지스트리를 줄일 때, 어떤 스킬을 남기느냐가 얼마나 남기느냐보다 먼저 정밀도를 정하고 break-even은 운영 게이트가 결정합니다
스킬 2,000개 이상의 레지스트리를 키우는 자기 진화형 에이전트 하네스를 돌리고 아무도 쓰지 않는 스킬을 어떻게 골라낼지를 정해야 하는 국내 클라우드/AI 엔지니어라면 이 글이 대상입니다. 레지스트리는 밤새 스스로를 편집하고 스킬이 태어나고 죽습니다. 죽은 스킬은 인덱스에 계속 얹혀 있기 때문입니다. 인덱스에 걸린 스킬 하나하나가, 어떤 쿼리도 그쪽으로 라우트되지 않는 한이든 재임베딩과 라우팅과 직렬화 카탈로그 페이로울 세금을 냅니다. ThakiCloud의 분석 논문 The Culling Dividend는 퇴출(retirement)을 통제 개입으로 만듭니다. 고정 목표 크기 K에서 usage-ranked culling(적게 쓰인 것부터 제거)과 random down-sizing(같은 개수 무작위 제거)을 놓고 두 가지를 답합니다. 어떤 스킬이 남느냐가 아니라 얼마나 남기느냐가 하이브리드 라우터의 회수 정밀도를 좌우하는지. 재임베딩과 라우팅 오버헤드의 절감이 정밀도 손실과 맞바뀌는 break-even(손익분기)이 어느 레지스트리 크기에서 오는지. 읽으면 자기 레지스트리를 어느 깊이까지, 어떤 순서로 깎아도 정밀도 게이트를 지킬 수 있는 근거가 생깁니다.
먼저 성격을 짚어 보겠습니다. 이 논문은 분석 논문입니다. 새 측정을 보고하지 않습니다. 센서스 값과 결정당 1,440.3 토큰 bill은 각각 이전의 Skill Graveyard와 The Router’s Toll에서 인용한 실측입니다. 본문에 나오는 나머지 모든 수는 명시된 가정 A1-A5에 대한 모델 예측입니다. 그림 두 장도 같은 모델의 산출물입니다.
 글의 핵심 개념을 형상화했습니다.
문제의식: 진입과 크기와 생존자에게는 가격이 있었지만, 나가는 쪽에는 없었다
마켓플레이스형 스킬 집계는 이미 23만 개를 넘었습니다. 병목은 스킬을 만드는 것이 아니라 고르는 것입니다. 에이전트가 수천 개의 능력 규모로 커지면 방해 후보(distractor) 풀만으로도 수만 개에 이릅니다. 자기 진화형 레지스트리에서는 이 성장 문제가 dead weight(쓰이지 않고 인덱스에 얹혀 있는 질량) 항과 겹칩니다. 아무도 라우트하지 않는 스킬에도 재임베딩, 라우팅, 카탈로그 페이로울 비용이 부과됩니다.
ThakiCloud의 이전 연구가 스킬 라이프사이클 네 면 중 세 면에 가격을 매겼습니다. Skill Graveyard는 생존자 경제를 측정하고 인덱스에 얹힌 죽은 질량이 부과하는 graveyard tax의 상한을 붙였습니다. 다만 실제로 롱테일을 잘라내는 통제 개입은 하지 않았습니다. 센서스의 1,285-manifest 일괄 purge는 기계적 재인덱싱 이벤트입니다. usage 기반 culling의 가격은 주지 못합니다. Mint Frontier는 진입 쪽에 가격을 매겼습니다. 새 스킬을 민트하는 것, 기존 스킬로 라우트하는 것, 포기를 선언하는 것의 비용-품질 break-even입니다. Selection Break-Even은 크기 쪽에 가격을 매겼습니다. retrieval 기반 라우팅이 in-context selection을 이기는 crossover 지점입니다. 남은 면이 퇴출입니다. 어떤 스킬을 제거하고 어느 깊이까지 제거할지에 대한 가격은 없었습니다.
이 논문은 그 퇴출에 가격을 씁니다. 고정 목표 크기 K에서 세 arm(비교 그룹)을 대조합니다. usage-ranked culling은 적게 쓰인 것부터 제거해 usage count u 기준 top-K를 남깁니다. random down-sizing은 균등하게 뽑은 K-subset을 남깁니다. demand-ranked oracle(진짜 수요를 아는 이상 arm)은 진짜 수요 w 기준 top-K를 남깁니다. 그 프록시 프로토콜 안에서 밀봉되어 있습니다. culling과 random 두 arm은 최종 크기가 같습니다. 다른 것은 composition(남는 스킬의 구성)뿐입니다. 이것이 “어떤 스킬이 남느냐”와 “얼마나 남느냐”를 분리하는 깨끗한 통제 실험이 되는 이유입니다.
설계: 동결된 하이브리드 라우터, 다섯 가정, 같은 K
분석 대상은 활성 작업 집합 N = 2,200 스킬입니다. 하네스 센서스는 다음과 같습니다. registry entry 2,287개, live manifest 1,789개, 추가된 distinct manifest path 2,351개, removal 이벤트 1,322개, bulk purge 1,285 manifest(2026-05-13), 2026-06-10부터 2026-09-22까지의 logged routing 이벤트 14,749개, sealed gate suite 63 case, off-index shelf 49개입니다. usage telemetry는 logged injection 이벤트의 집합입니다. 라우터가 스킬을 프롬프트에 주입할 때마다 그 스킬의 routing 이벤트 하나가 됩니다.
라우팅 스택은 하이브리드 리트리브어입니다. 코퍼스에 대한 BM25와 TF-IDF cosine 항을 per-query max-normalization을 붙여 동등 가중으로 fusion해, survivor 위 top-5 shortlist를 냅니다. 문헌에서 스킬 규모에서도 경쟁력이 유지되는 표준 레시피로 확인된 구성입니다. 라우터를 고정함으로써 composition이 깨끗한 변수가 됩니다.
가정은 A1부터 A5입니다. A1은 near-Zipf 수요입니다. w_i ∝ r_i^(-α), headline α = 1.1, 밴드 α ∈ [0.7, 1.5]입니다. headline 값에서 수요 랭킹 상위 10% 스킬이 수요 질량의 79.9%를 차지합니다. 밴드 전체로는 45.6%부터 96.4%까지 움직입니다. A2는 rank fidelity입니다. culling 집합이 수요 집합과 일치할 확률을 κ로 놓고 나머지는 균등 K-subset입니다. 예측 밴드는 κ ∈ [0.5, 0.9]입니다. 낡은 usage 스파이크나 신규 진입 스킬의 부분 관찰 윈도우 같은 기계적 노이즈가 이 κ 하나로 요약됩니다. A3는 위에서 설명한 하이브리드 fusion이 고정되어 있음을 말합니다. A4는 distractor-demand monotonicity입니다. 스킬 i를 타깃으로 하는 쿼리에 대해, 수요가 엄격히 낮은 스킬 j의 기대 component별 점수는 i보다 낮아, 테일이 약한 distractor로 채워진다는 것입니다. A5는 유지보수 비용이 선형이라는 것, C(K) = c_0 + c_1·K입니다. 재인덱싱 빌드 시간, 직렬화 인덱스 바이트, 쿼리당 평균 scoring latency, 카탈로그 단어 수 네 차원으로 meter됩니다.
| 모델은 culling을 통제 개입으로 형식화합니다. survivor 집합 R_K에 | R_K | = K입니다. 정밀도는 r_5(R_K) = Σ_i w_i·p_5(i | R_K)입니다. p_5는 i를 타깃으로 하는 쿼리가 fusion top-5 안에 들어오는 indicator입니다. |
정밀도를 가르는 것은 구성: coverage x discrimination 분해와 culling dividend ΔK(β)
첫 결과는 분해 항등식(P1)입니다. r_5(R_K) = A(R_K)·B(R_K). coverage A는 남은 수요 질량의 비율을 나타냅니다. discrimination B는 남은 질량에 조건부인 평균 정밀도입니다. arm 간 격차가 이 두 항으로 쪼개집니다.
discrimination B를 frontier에서 1차로 밀어내는 결과가 두 개 있습니다. rank-safe(랭크 안전) lemma는 스킬 j가 모든 fusion component에서 타깃 i보다 낮게 점수받으면 j를 제거해도 i의 fusion 랭크가 내려가지 않음을 보여 줍니다. per-query max-normalization은 j가 component maximum이 아니라면 survivor 집합에서 불변입니다. j의 슬롯이 비는 것은 i의 랭크를 높이는 방향뿐입니다. 2차 corollary는 A4에서 이어집니다. culling이 제거하는 것은 생존하는 고수요 타깃의 약한 distractor가 대부분이므로, B는 fusion 재규격화 항 δ를 뺀 B_full 근처를 유지합니다. δ는 제거된 테일 비율 (N-K)/N이 0에 가까워지면 사라집니다. leading-order frontier 차이는 coverage에 모두 있습니다. 이것이 fusion-tax 채널을 닫는 부분입니다. fusion-tax 문헌에서 fusion은 강한 distractor가 재순위화할 때 해가 됩니다. 테일 culling은 그 채널을 다시 열지 않습니다.
coverage sandwich(P2)가 수치를 붙입니다. random down-sizing의 기대 coverage는 E[A_rand(K)] = K/N으로 정확합니다. 어떤 수요 분포에서도 그렇습니다. κ mixture 아래 culling의 coverage는 A_cull(K) = κ·H_K/H_N + (1-κ)·K/N입니다. H_K는 truncated Zipf 합, headline에서 H_N = 5.9527입니다. 기대 composition dividend는 ΔA(K) = κ·(H_K/H_N - K/N)으로, 음이 아니고 κ = 0일 때만 0입니다. usage는 수요의 잡음 있는 양의 신호(E[u_i]가 w_i에 대해 증가)입니다. culling은 기대에서 coverage 면으로 random보다 아래로 내려가지 않습니다.
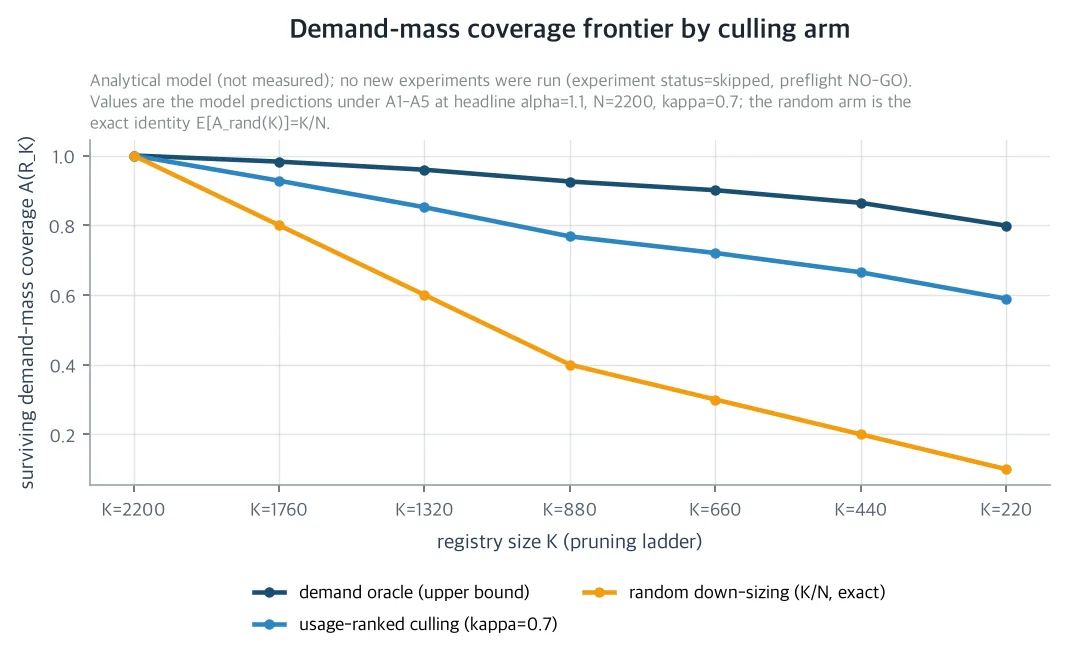 Pruning ladder K = 2,200부터 220에서 arm별 survivor 수요 질량 coverage A(R_K). 같은 레지스트리 크기에서 usage-ranked culling(κ=0.7)이 같은 크기의 random down-sizing(K/N, 정확)보다 많은 수요 질량을 보존합니다. demand oracle이 상한입니다. 가정 A1-A5에 대한 분석 모델의 예측이며 실측이 아닙니다.
frontier 지배(P3)가 이어서 옵니다. culling과 random의 기대 정밀도 차이는 B_full·κ·(H_K/H_N - K/N) + o(1)인 셈입니다. 모든 K에서 음이 아닙니다. κ > 0이고 K < N이면 strictly 양이기 때문입니다. 상대 정밀도 예산 β(coverage 1 - β 이상)를 고정할 때 K_arm(β)는 그 예산을 충족하는 최소 ladder 크기입니다. sandwich는 K_oracle ≤ K_cull ≤ K_rand입니다. culling dividend는 ΔK(β) = K_rand(β) - K_cull(β) ≥ 0입니다. 말 그대로 random down-sizing이 유지해야만 하는 레지스트리 크기를, usage-ranked culling은 버려도 되는 크기입니다.
수치로 보면, primary 예산 β = 0.10에서 random arm의 K*는 2,200, 즉 어떤 culling도 예산을 충족하지 못합니다. culling arm(κ = 0.7)은 K = 1,760에서, oracle은 K = 660에서 예산을 맞춥니다. dividend ΔK는 β = 0.10에서 440, β = 0.30부터 0.50에서는 1,100까지 커집니다(κ = 0.7). 가장 깊은 ladder K = 220에서는 coverage가 culling(κ = 0.7)은 0.5891, random은 0.100입니다. 같은 크기에서 남은 수요 질량이 약 5.9배 다른 것입니다. near-Zipf의 head-heavy 질량이 composition을 정밀도의 1차 변수로 만드는 지점입니다.
break-even depth K_be(ρ) ≲ 100: 사전 등록된 가격밴드 전체에서 게이트가 바인딩한다
K까지 culling한 순익은 NB(K) = π·c_1·(N-K) - μ·B_full·(1 - A_cull(K))입니다. π는 재임베딩과 라우팅 오버헤드로 이루어진 cost unit 하나당 가격, μ는 정밀도 손실 unit 하나당 가격, 즉 miss multiplier입니다. ρ = μ·B_full/(π·c_1)로 놓습니다. marginal 조건 ∂NB/∂K = 0을 풀면 break-even depth(P4)가 나옵니다. K_be(ρ) = [H_N/κ·(1/ρ - (1-κ)/N)]^(-1/α)입니다. ρ < N/(1-κ)일 때만 존재합니다. culling 하나당 marginal 정밀도 비용은 κ·K^(-α)/H_N + (1-κ)/N이며 break-even은 그것이 marginal 절감 π·c_1과 같아지는 지점입니다.
binding-gate corollary가 결론입니다. A1(α = 1.1, N = 2,200) 아래 K_be(ρ)는 ρ에 대해 증가합니다. 사전 등록된 가격비 밴드 ρ ∈ [0.5, 10^3] 전체에서 break-even depth는 K_be ≲ 100 스킬이며 최대 99.94(ρ = 10^3, κ = 0.9)입니다. 이것은 사전 등록된 모든 예산에서 운영 정밀도-유지 게이트 depth K* ≥ 220보다 아래입니다. ρ가 0+에 가까워지면 break-even은 0으로 수축합니다. 그 극한에서 경제는 절대 바인딩하지 않습니다. 발산은 ρ가 no-cull threshold N/(1-κ)에 가까워질 때만 옵니다. κ = 0.9, 0.7, 0.5에서 threshold는 각각 22,000, 7,333, 4,400입니다. 사전 등록된 밴드는 거기에 미치지 못합니다.
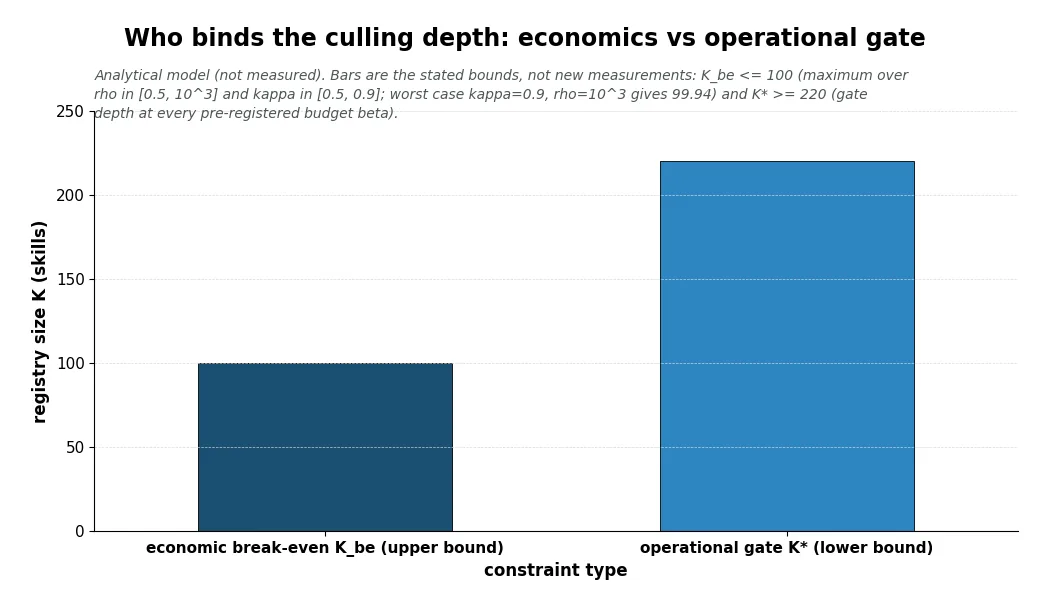 사전 등록된 가격밴드 전체에서 경제적 break-even depth K_be(상한 ≲ 100 스킬)가 운영 정밀도-유지 게이트 K(하한 ≥ 220 스킬)보다 아래에 머물러, culling 깊이를 바인딩하는 것이 게이트입니다. 가정 A1-A5에 대한 분석 모델의 예측이며 실측이 아닙니다.*
메커니즘은, 게이트 근처의 깊이에서도 culling 하나당 정밀도 손실이 작다는 것입니다. headline κ = 0.7에서 depth K = 1,760의 culling 하나당 marginal 손실은 1.7×10^(-4)·B_full, K = 880에서 2.0×10^(-4)·B_full, K = 220에서 4.5×10^(-4)·B_full입니다. K가 줄수록 marginal tail 수요 질량 κ·K^(-α)/H_N은 커집니다. random mixture 하한 (1-κ)/N은 일정해서, 게이트 범위 K ≥ 220 전반에서 손실이 O(10^(-4))를 유지합니다. culling 깊이를 바인딩하는 것은 정밀도 게이트입니다. dividend는 온전히 취해집니다. 깎는 깊이를 정하는 것은 가격비가 아니라, 잃을 정밀도를 얼마까지 허용하는가입니다.
그래서 무엇을 주나: 회사, 사회, 과학
회사에 이 논문은 밤새 자기 진화하는 스킬 생태계에 실측 가능한 culling 정책을 줍니다. 2,200 레지스트리에서 저사용 롱테일을 어떤 순서로, 얼마나 잘라야 sealed SRA audit(sra_bench)의 recall@5와 top-1을 잃지 않는지를 frontier로 그립니다. 그 frontier를 따라 재임베딩·라우팅 오버헤드·리트리브 노이즈 비용이 내려갑니다. 토큰 팩토리의 고정비가 직접 줄어듭니다. 라우터의 결정당 1,440.3 토큰 bill에 있는 K-dependent retrieval과 카탈로그 성분도 culling으로 줄어듭니다. 인덱스 비용은 스킬 수 x 차원 x 페이로울의 곱입니다. 그 중 distractor 질량을 제거하는 레버는 culling뿐입니다. quantization(스킬당 차원)과 description budget(스킬당 페이로울)은 개수를 그대로 두기 때문입니다. culling은 operating point를 구조 break-even N* 쪽으로, 그 아래로 옮깁니다. in-context selection이 경쟁력이 되는 지점에서는 순익을 구조 arm과 다시 비교해야 합니다. 비교 대상이 라우팅 bill만은 아니기 때문입니다.
사회에 이 논문은 상시 켜져 있는 자율 에이전트 인프라의 dead weight를 숫자로 만듭니다. 아무도 라우트하지 않는 스킬이 지탱하는 컴퓨트와 에너지 부담을 정량화하는 것입니다. binding-gate regime과 사전 등록된 반증 조건은, 무인 자동화의 능력축소를 안전하게 감행하기 위한 운영 안전게이트가 됩니다. 게이트가 바인딩 제약이므로, “게이트까지 깎고 그 안에서 얼마나 더 싼지는 경제가 정한다”가 실행 가능한 규칙이 됩니다.
과학에 이 논문은 레지스트리의 composition과 cardinality를 분리한 첫 통제 실험입니다. 같은 최종 크기에서 usage-ranked culling과 random down-sizing을 대조함으로써 에이전트 스킬 생태계의 long-tail law를 세웁니다. survivor economics와 registry-size break-even 두 계열을 개입 실험으로 한 단계 끌어올립니다. Skill Graveyard의 라이프사이클 경제를 생존자 회계에서 통제된 exit-side 개입으로 확장한 것이 바로 이 논문입니다. culling gate는 mint frontier의 진입 가격과 쌍을 이룹니다. corpus-growth identity의 steady state에서 진입률과 퇴출률이 맞물립니다. 통제 변수는 N(t)입니다.
논문은 동결 팩토리얼 측정 프로토콜과 반증 조건 F1-F6을 함께 둡니다. 이것은 측정 도구입니다. 프로토콜은 네 arm으로 이루어집니다. full registry 2,200, 90일 logged usage 윈도우의 usage-ranked culling, 크기당 seed 1회 draw의 random down-sizing, culling 윈도우가 끝난 뒤에야 끝나는 sealed 30일 holdout usage 기간으로 랭크되는 demand 프록시입니다. 후자가 self-leakage를 막습니다. ladder는 K ∈ {2,200, 1,760, 1,320, 880, 660, 440, 220}입니다. (arm, K)마다 인덱스를 한 번 재빌드해 A5의 네 비용 차원을 meter합니다. 정밀도는 두 suite로 재습니다. sealed 63-case SRA audit(recall@5, top-1, MRR, survivor-conditioned와 unconditioned)과 500-query demand-proportional suite입니다. 후자의 40%가 스킬의 unique token을 직접 명명하고 60%가 태스크 속성을 parafras합니다. κ 추정치 κ-hat는 ladder에 걸친 culling 집합과 sealed holdout 수요 집합의 top-K overlap 평균입니다. 0이면 정보 없음, 1이면 oracle입니다. 반증 조건 여섯 개는 다음과 같습니다. F1: 모든 K < N에서 culling의 r_5가 random 아래로 내려가지 않음. 어느 cell에서든 2점 이상 회귀하면 P3가 그 cell에서 반증됩니다. F2: primary 예산 β = 0.10에서 K_cull < K_rand, 즉 ΔK > 0. F3: 모든 K에서 coverage sandwich K/N ≤ A_cull ≤ A_oracle이 성립. κ-hat가 [0.5, 0.9]를 벗어나면 break-even 표를 재앵커합니다. F4: rank safety B_cull ≥ B_full - 0.01과 B_cull ≥ B_rand - 0.01. 깨지면 component-maximum cell을 감사합니다. F5: sealed split 어느 것에서도 full-registry arm 대비 culling arm의 회귀가 2점을 넘지 못함. F6: 각 비용 차원이 K에 대해 단조 비증가이고 C(K) = c_0 + c_1·K가 factor 2 안에 fitting이 됩니다. 밀봉된 측정이 처음 박아 넣을 숫자는 κ입니다.
한계: 이 논문이 주장하지 않는 것
첫째, 이 논문은 분석 논문입니다. 새 측정을 하나도 쓰지 않습니다. κ는 여기에서 측정되지 않은 예측 밴드입니다. F3가 κ를 박고 coverage sandwich가 그 범위를 줍니다. 둘째, near-Zipf α = 1.1은 fitting한 값이 아니라 취한 값입니다. 밴드 [0.7, 1.5]는 head 질량(상위 10%가 45.6%부터 96.4%)을 움직이지만 regime 결론은 움직이지 않습니다. binding-gate corollary는 H_N이 유한한 어떤 α > 1에서도 성립하기 때문입니다. 셋째, leading-order corollary는 A4 아래에서 discrimination B를 고정합니다. fusion-tax 채널은 상한이 붙어 있지만 여기에서 측정된 것은 아닙니다. F4가 그 위치를 지정합니다. 넷째, demand 프록시는 sealed holdout usage 기간입니다. 진짜 latent 수요는 아닙니다. 다섯째, 63-case sealed suite는 계열 전체에서 안정한 house standard지만 절대 규모로는 작습니다. 500-query suite는 정확히 그 추정을 안정시키기 위해 존재합니다. 여섯째, random arm은 크기당 seed 1회 draw입니다. sandwich는 기대에서 성립합니다. multi-draw 버전은 사전 지정된 수정안입니다.
Goodhart 노출은 설계 안에서 처리됩니다. usage count는 루프의 자기 관찰량이므로, 자기 보고된 usage로 랭크하는 culling 규칙은 게임 가능합니다. 스킬이 자기 수치를 부풀려 잘림을 피할 수 있기 때문입니다. 그래서 이 논문은 culling을 logged routing decisions으로 랭크합니다. 라우터의 결정이지, 스킬의 자기 보고서는 아닙니다. 예산 β와 sealed holdout은 writable surface 밖에 둡니다.
graveyard tax에는 상한이 붙었습니다. culling dividend에는 가격이 매겨졌습니다. 다음 측정 F1-F6은 밀봉된 것입니다. 그 첫 숫자는 κ입니다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있습니다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-24-usage-culling-precision-maintenance-frontier
본문에 나오는 모든 수는 가정 A1-A5에 대한 분석 모델의 예측이며 실측이 아닙니다. 그림 두 장도 같은 모델의 산출물입니다.

