EG2 Hybrid W4 런타임: 멀티모달 임베딩 GPU 메모리를 0.58배로 줄이는 방법
GPU 메모리가 빠듯한 환경에서 텍스트, 이미지, 오디오, 비디오를 한 공간으로 검색해야 하는 엔지니어라면 이 글이 도움이 됩니다. 4비트로 줄인 가중치를 GPU에서도 줄인 채로 쓰면, 로드 후 GPU 메모리가 원래 모델의 약 0.6배로 내려갑니다. 다만 빨라지지는 않고, 지금은 한 종류의 GPU에서만 검증했습니다. 메모리를 얻는 대신 무엇을 내주는지, 어디까지 확인했는지를 숫자와 함께 차례로 설명합니다. 읽고 나면 우리 환경에 맞는 선택인지 판단하실 수 있습니다. 수치는 모두 공개된 모델 카드와 저장소 설명서에 적힌 값입니다.
EmbeddingGemma 2는 어떤 모델인가
EmbeddingGemma 2는 Google이 Apache 2.0으로 공개한 멀티모달 임베딩 모델입니다. 텍스트(코드 포함), 이미지, 비디오, 오디오를 받아 모두 같은 768차원 공간의 벡터로 바꿉니다. 그래서 “회의 녹음과 비슷한 내용의 슬라이드 캡처 찾기”처럼 미디어 종류를 넘나드는 검색을 모델 하나로 할 수 있습니다. 예전처럼 이미지를 캡션으로, 음성을 자막으로 먼저 바꾼 뒤 텍스트 임베딩에 넣는 2단 구조가 필요 없습니다.
전체 크기는 740M 파라미터입니다. 텍스트 본체가 270M이고 비전 인코더가 170M, 오디오 인코더가 300M을 더합니다. 필요한 인코더만 켜서 텍스트 전용 270M이나 텍스트와 이미지 440M처럼 가볍게 쓸 수도 있습니다. 100개가 넘는 언어를 지원하고 입력 길이는 모달리티 공통으로 8,192 토큰입니다. 출력 벡터는 768차원에서 512, 256, 128차원으로 잘라 저장 비용을 줄일 수 있습니다(자른 뒤 다시 정규화합니다). 용도는 검색과 RAG, 분류, 군집화, 의미 유사도입니다. 모델 자체에 대한 자세한 소개는 앞선 글에 정리했습니다.
이 글이 다루는 것은 그중 무게가 큰 부분, 비전과 오디오 인코더입니다. 두 인코더가 740M 중 470M을 차지합니다.
먼저 알아둘 것
공개한 모델 ThakiCloud/eg2-hybrid-w4-media는 EmbeddingGemma 2의 텍스트 가중치는 BF16 그대로 두고, 비전과 오디오 가중치만 4비트로 줄인 체크포인트입니다. 디스크 크기는 원본 BF16 저장소의 57%입니다.
그런데 모델 카드에는 솔직한 단서가 하나 붙어 있습니다. 공식 로더가 4비트 가중치를 로드할 때 BF16으로 다시 풀어 버리기 때문에, 로드가 끝난 뒤 GPU 메모리는 원본 BF16과 같습니다. 즉 이 체크포인트만으로는 내려받는 용량이 줄 뿐, 실행할 때 메모리는 줄지 않습니다.
이번에 GitHub에 공개한 ThakiCloud/eg2-l2v1(v0.1.0)이 그 빈칸을 채웁니다. 코드만 담았고 가중치는 다시 배포하지 않습니다. 실행할 때 공개 체크포인트를 고정된 revision으로 받아 그대로 씁니다.
쉽게 말하면
여행 가방에 겨울 옷을 넣는 장면을 떠올리면 됩니다. 공식 로더는 압축팩에 담아 온 옷을 호텔 방에 도착하자마자 전부 꺼내 옷장에 펼쳐 놓습니다. 옷장(GPU 메모리)은 원래 크기의 옷 전체로 채워집니다.
eg2-l2v1은 옷을 압축팩 그대로 옷장에 둡니다. 입을 때가 되면 그 옷 한 벌만 꺼내 펴서 입고, 다시 접습니다. 옷장은 훨씬 덜 차지만, 꺼내서 펴는 수고가 매번 생겨 외출 준비가 조금 느려집니다. 이 글의 결과가 전부 이 비유 안에 있습니다.
무엇이 달라졌나
공식 로더는 모델을 불러올 때 4비트 비전과 오디오 Linear 층을 전부 BF16으로 풀어 둡니다. 이 런타임은 4비트 코드를 GPU에 그대로 두고, Linear 층이 호출될 때마다 그 가중치만 풀어서 BF16 행렬곱에 넣습니다.
중요한 점은 네이티브 INT4 행렬곱이 아니라는 것입니다. 행렬곱은 똑같은 BF16 GEMM이고, 바뀐 것은 가중치를 저장하는 방식뿐입니다. 처리량을 조금 내주고 메모리를 얻는 거래입니다.
나온 결과
NVIDIA B200 한 장에서 측정했습니다. 로드가 끝난 뒤 GPU에 상주하는 메모리는 약 0.9GB로, BF16 모델의 약 1.5GB와 비교해 0.58배입니다. 정확도는 공식 로더와 거의 같습니다. 합성 입력에서는 임베딩이 사실상 같은 값이고(코사인 유사도 최솟값은 아래 그림 설명에 적었습니다), 실제 오디오에서는 결과가 비트 단위로 같았습니다.
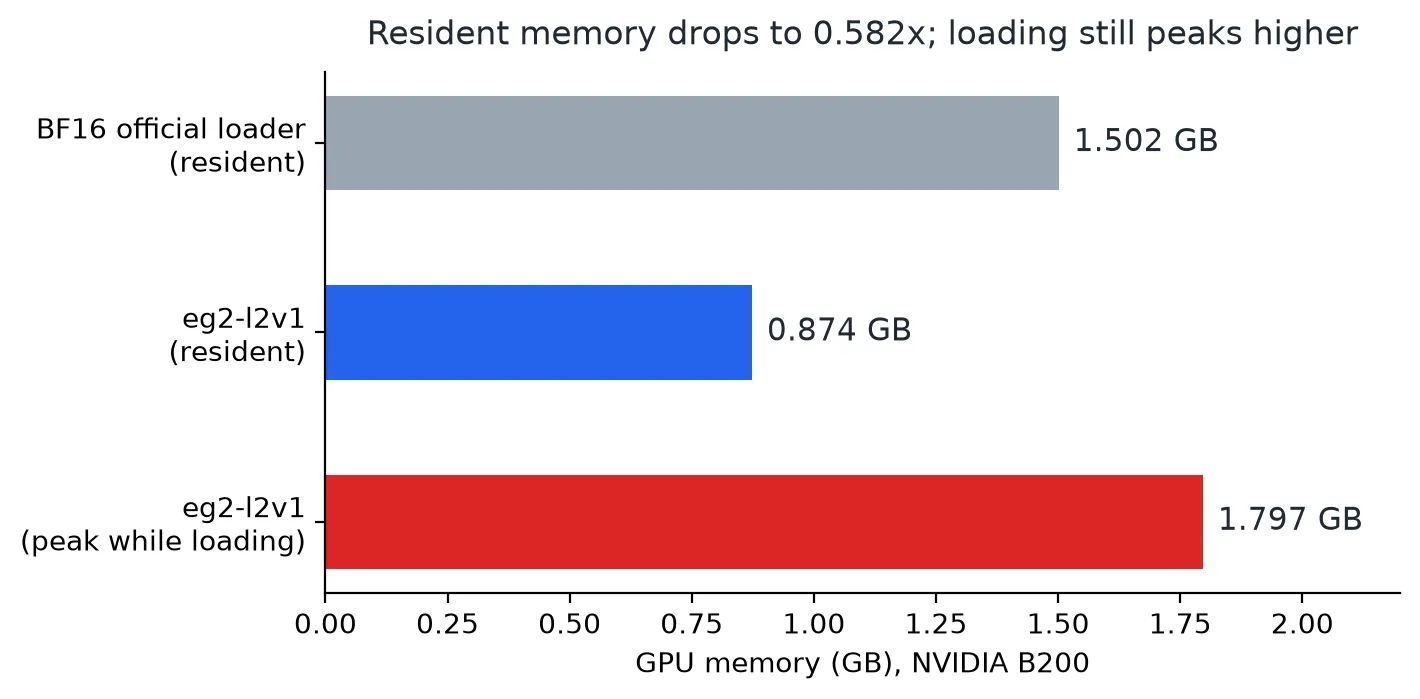 그림 1. GPU 메모리(B200). 공식 로더 대비 합성 입력 임베딩 코사인 유사도 최솟값은 0.9999998 이상입니다. 상주 메모리는 줄지만 로딩 중 최대치는 BF16 상주량보다 높습니다.
한 가지 주의할 점이 있습니다. 로딩하는 순간에는 최대 약 1.8GB까지 올라갑니다. 상주량만 보고 메모리를 빠듯하게 잡으면 로드 단계에서 실패할 수 있으므로, 배포할 때는 이 최대치만큼 여유를 두어야 합니다.
즉, 사람 말로는 “자리는 적게 차지하지만, 짐을 풀 때는 잠깐 더 넓은 바닥이 필요합니다.”
처리량은 줄어듭니다
같은 프로세스에서 BF16과 번갈아 3회 잰 중앙값으로 비교했습니다. 아래 표는 3초 길이의 합성 입력에서 BF16 대비 처리량입니다.
| 모달리티 | batch 16 | batch 64 |
|---|---|---|
| text | 1.014 | 1.002 |
| image | 0.956 | 0.988 |
| audio | 0.825 | 0.875 |
| video | 0.989 | 0.998 |
텍스트와 비디오는 거의 차이가 없고, 오디오가 가장 크게 느려집니다. 실제 녹음(FSD50K dev, 구간당 64개)으로 재면 오디오 처리량은 BF16의 0.83~0.94배입니다.
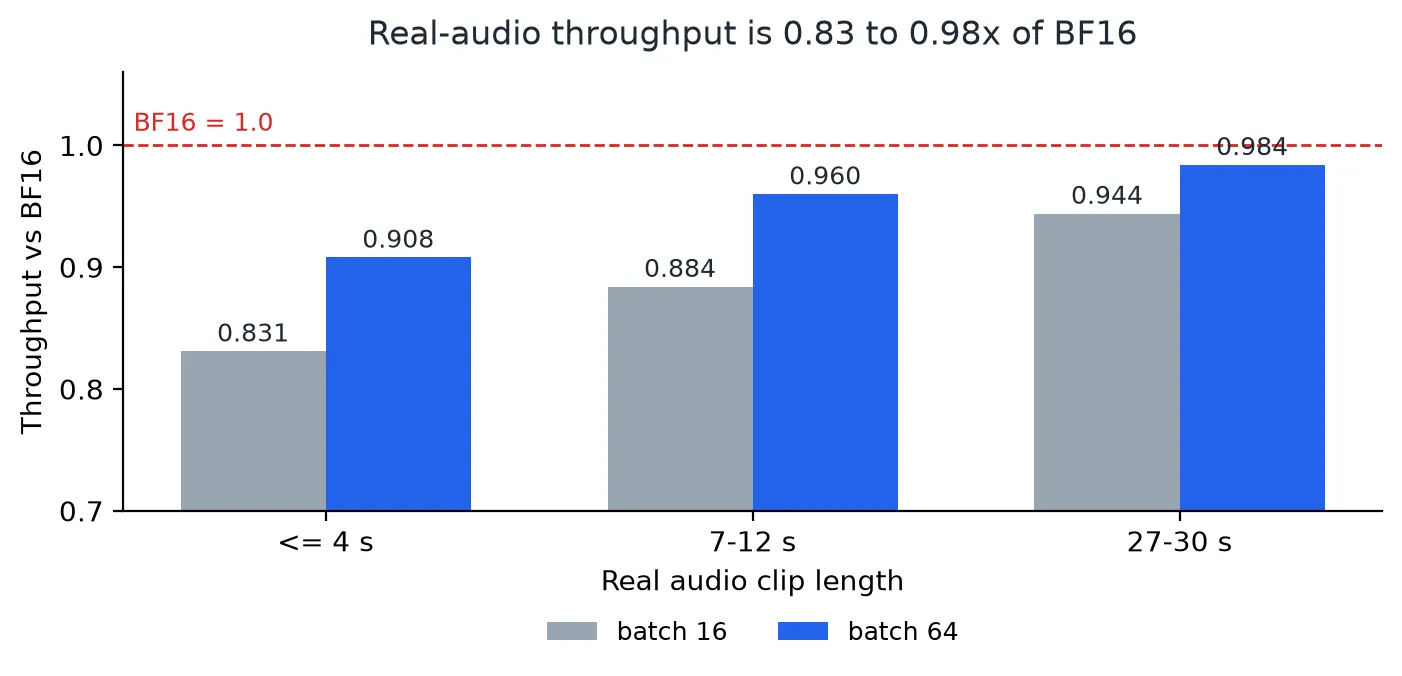 그림 2. 실제 오디오 길이별 처리량(BF16 = 1.0). 짧은 클립과 작은 배치일수록 불리합니다.
짧은 오디오가 가장 불리하고, 클립이 길고 배치가 클수록 격차가 줄어듭니다. forward 중 활성값 메모리는 BF16과 같아서, 30초짜리 클립 64개를 넣으면 6.2GB가 추가로 필요합니다. 줄어드는 것은 가중치 쪽 메모리뿐입니다.
검색 품질은 어떤가
L2V1은 공개 참조 로더와 동일한 입력에서 4개 모달리티의 임베딩이 bit-identical임을 확인했습니다(공개 이미지 환경의 selftest 기준). 별도의 검색 벤치마크는 L2V1 런타임으로 재실행하지 않았습니다. 아래 검색 평가는 모델 카드가 공식 로더로 잰 결과입니다. 카드는 이미지, 오디오, 비디오 검색에서 BF16 대비 열세가 아니라는 기준을 사전에 정해 두고 통과했다고 적고 있습니다. 다만 평가 데이터와 도구가 내부용이라 외부에서 그대로 재현할 수는 없습니다. 정확한 이웃 순서가 중요한 중복 제거나 유사도 검사에는 직접 가진 데이터로 한 번 더 확인하시기 바랍니다.
메모리를 줄이면 무엇이 좋아지나
임베딩 모델은 혼자 GPU를 쓰는 경우가 드뭅니다. 검색 결과를 받아 답을 쓰는 언어 모델, 재정렬 모델, 다른 서비스가 같은 GPU를 나눠 씁니다. 그 안에서 임베딩 모델이 상주로 차지하는 몫이 1.5GB에서 0.87GB로 줄면, 남는 자리가 세 가지로 쓰입니다.
첫째, 한 GPU에 더 많은 것을 함께 올릴 수 있습니다. 언어 모델의 KV 캐시처럼 여유 메모리가 곧 동시 처리량이 되는 쪽에 그만큼을 돌릴 수 있습니다. 둘째, 임베딩 쪽 배치를 키울 여지가 생깁니다. 상주 메모리는 줄었지만 forward 중 쓰는 활성값 메모리는 BF16과 같으므로(예: 30초 클립 64개에 6.2GB), 줄어든 상주분이 그대로 배치 여유가 됩니다. 셋째, GPU 한 장을 여러 서비스가 나눠 쓰는 구성에서 임베딩 모델을 더 작은 칸에 넣을 수 있습니다.
다만 배포할 때 잡아야 할 여유는 상주량이 아니라 로딩 중 최대치인 약 1.8GB입니다. 이 값을 넘는 칸에서만 안전하게 뜹니다.
교체 비용이 낮다는 점도 실무에서는 중요합니다. 같은 입력에서 임베딩이 공식 참조 로더와 같기 때문에, 공식 로더로 만들어 둔 벡터 인덱스를 다시 임베딩하지 않고 그대로 쓸 수 있습니다. 질의 쪽만 이 런타임으로 바꿔도 같은 공간에서 비교됩니다.
어떻게 활용하나
몇 가지 쓰임새를 들면 다음과 같습니다.
- 사내 멀티모달 검색. 문서, 슬라이드 캡처, 회의 녹음, 짧은 영상을 한 인덱스에 넣고 텍스트 질의로 찾습니다. 텍스트 처리는 BF16 그대로라 문서 검색 품질은 원본과 같은 경로를 탑니다.
- 에이전트의 기억 검색. 업무를 대신 처리하는 에이전트가 과거 문서와 화면, 음성 기록에서 근거를 찾을 때 이 임베딩이 바닥에 깔립니다. 에이전트 플랫폼(Paxis)에서 언어 모델과 임베딩을 같은 GPU에 두는 구성이라면 줄어든 메모리가 곧 언어 모델 쪽 여유가 됩니다.
- 추론 서빙에 함께 올리기. 언어 모델 서빙 노드(Metis)에 임베딩 엔드포인트를 곁들일 때 상주 부담이 작아집니다. 다만 이 체크포인트를 실제 서빙 엔드포인트로 띄워 검증하지는 않았습니다. 지금 확인된 범위는 아래 사용 예처럼 Python에서 직접 불러 쓰는 경로입니다.
반대로 이런 경우에는 맞지 않습니다. GPU 메모리가 제약이 아니면 이미지와 오디오는 공식 로더가 더 빠르므로 그쪽이 낫습니다. 짧은 오디오를 대량으로 처리하는 일은 처리량 손해가 가장 큽니다. 지원 GPU가 B200뿐이라는 점도 먼저 확인하셔야 합니다.
써 보려면
git clone https://github.com/ThakiCloud/eg2-l2v1.git && cd eg2-l2v1
bash install.sh
python selftest.py --out result.json     # exit 0 이면 통과
설치 스크립트가 잠금 파일로 버전을 고정하고, selftest가 공식 로더와의 임베딩 일치와 메모리를 확인합니다. 불러 쓰는 방법은 공식 sentence-transformers 사용법과 같습니다.
import numpy as np
from huggingface_hub import snapshot_download
import eg2_l2v1

path = snapshot_download("ThakiCloud/eg2-hybrid-w4-media",
                         revision="bc3574a285a2779ac0686cc149342f30fbbf8f5b")
model, info = eg2_l2v1.load(path)      # CUDA 전용

wav = np.zeros(16000 * 3, dtype=np.float32)          # 16kHz 모노 오디오로 바꿔 넣습니다
audio_emb = model.encode([{"audio": wav}], normalize_embeddings=True)
text_emb = model.encode(["a dog barking in the distance"], prompt_name="SearchQuery", normalize_embeddings=True)
print(float(audio_emb @ text_emb.T))
오디오는 16kHz 모노 float32로 넣고, 30초보다 긴 클립은 모델 처리기가 30초로 자릅니다.
못 믿을 부분
- 검증한 GPU는 B200(SM 10.0) 하나뿐입니다. H200은 중앙값으로는 같은 기준을 넘었지만 3회 중 1회가 오디오 batch 16에서 0.796이어서 지원 목록에 넣지 않았습니다.
- 4비트 체크포인트 전용입니다. CPU 경로가 없으니 CPU에서는 공식 로더를 쓰십시오.
- 속도를 올리는 도구가 아닙니다.
- 이 체크포인트로 추론 엔드포인트를 띄워 검증한 적은 없습니다. 이 글의 수치는 모두 로더와 임베딩 단계의 측정입니다.
이 수치는 시뮬레이션이 아니라 B200 한 장에서 잰 값이고, 코드와 모델은 모두 Apache-2.0으로 공개되어 있습니다.