근거 점수가 0.99인데 왜 못 믿을까: 추론 사슬을 보는 RAG 근거 판정 모델 ChainCheck-Judge 공개
RAG 파이프라인에 “이 문단들로 답해도 되는가”를 판정하는 모델을 붙여 쓰는 팀이라면 이 글이 쓸모 있을 겁니다. 판정 점수가 0.9 를 넘어도, 그 판정기가 추론이 끊긴 문맥을 정말 보고 있는지는 그 점수만으로 알 수 없습니다.
저희는 그 차이를 따로 재는 대조군을 만들고 그 대조군으로 판정 모델 세 개(4B·9B·27B)를 학습해 공개했습니다. 사슬이 끊긴 문맥을 가려내는 능력은 크게 올랐습니다. 반면 처음 보는 가상의 이름이 들어간 문맥에서는 대부분 학습 전보다 약해졌습니다. 이 글은 두 결과를 함께 적습니다.
쉽게 말하면
징검다리를 떠올리시면 됩니다. 질문에서 답까지 가려면 돌 두 개를 밟아야 합니다. “이 영화 감독의 출생지는?”이라는 질문이라면, 첫 돌은 “영화의 감독은 누구인가”, 둘째 돌은 “그 감독은 어디서 태어났나”입니다.
판정기가 해야 할 일은 돌이 다 놓여 있는지 보는 것입니다. 그런데 판정기를 속이는 방식이 두 가지 있습니다. 하나는 둘째 돌만 다른 사람 이야기로 바꿔 다리를 끊는 것입니다. 다른 하나는 돌에 붙은 이름표만 일관되게 바꾸는 것입니다. 이름표가 바뀌어도 다리는 그대로 이어져 있으니 건널 수 있습니다.
좋은 판정기는 끊긴 다리를 잡고 이름표만 바뀐 다리는 통과시켜야 합니다. 기존 벤치마크는 “멀쩡한 다리 대 끊긴 다리”만 시험합니다. 그래서 이름표가 바뀐 흔적만 보고 무조건 의심하는 판정기도 거의 만점을 받습니다.
NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
점수가 천장에 붙으면 아무것도 가르지 못합니다
근거 충분성을 묻는 보통의 평가는 손대지 않은 문맥과 끊긴 문맥을 나란히 놓고 판정기가 앞쪽에 더 높은 점수를 주는 비율을 봅니다. 이 글에서는 이 값을 명목 점수라고 부르겠습니다.
저희가 잰 판정기들의 명목 점수는 대부분 0.9 근처나 그 위였습니다. 이 구간에서는 시스템 사이의 순서가 거의 드러나지 않습니다. 더 큰 문제는 그 점수가 무엇에 반응해서 나왔는지 알 수 없다는 점입니다. 끊긴 다리를 알아봐서 나온 점수인지, 문맥에 손댄 흔적에 반응해서 나온 점수인지 명목 점수로는 갈리지 않습니다.
즉, 사람 말로는 “시험이 너무 쉬워서 누가 잘하는지 모르는 상태”입니다.
세 가지 문맥으로 두 반응을 떼어 냅니다
ChainCheck 는 같은 질문마다 문맥을 세 벌 만듭니다.
| 문맥 | 다리 | 손댄 흔적 |
|---|---|---|
| A | 이어짐 | 없음 |
| B | 이어짐 (이름표만 일관되게 교체) | 있음 |
| D | 끊김 (둘째 돌만 교체) | 있음 |
B 와 D 는 둘 다 손을 댄 문맥이라 흔적은 같고 다리가 이어졌는지만 다릅니다. 그래서 판정기가 B 를 D 보다 높게 보는 정도를 사슬 효과로 씁니다. A 와 B 는 다리가 둘 다 멀쩡하고 흔적 유무만 다릅니다. 판정기가 A 를 B 보다 높게 보는 정도는 편집 효과입니다.
마지막으로 사슬 효과에서 편집 효과의 크기를 뺀 값을 사슬 선택도라고 부릅니다. 이 값이 0보다 확실히 크면, 그 판정기는 흔적보다 다리를 보고 있다는 뜻입니다. 확실한지는 95% 신뢰구간의 아래쪽 끝이 0을 넘는지로 판정합니다.
무엇을 학습시켰나
출발점은 Qwen3.5-4B, Qwen3.5-9B, Qwen3.8-27B 세 모델입니다. 판정 방식은 같습니다. 질문과 문단을 주고 “충분한가, yes 또는 no”를 물은 뒤, 첫 토큰의 yes 와 no 로그 확률 차이를 점수로 씁니다.
학습 데이터는 MuSiQue 학습 분할에서 만든 세 벌짜리 묶음 7,481개입니다. A 와 B 는 충분(1), D 는 불충분(0)으로 둡니다. 여기에 “A 와 B 중 낮은 쪽도 D 보다는 확실히 높아야 한다”는 여유 조건을 손실에 더했습니다. 이름표만 바뀐 다리를 끊긴 다리처럼 다루지 말라는 신호를 직접 주는 셈입니다.
LoRA 로 한 번 학습하고 원래 가중치에 합쳐 전체 가중치 한 벌로 내보냈습니다. 학습 시간은 B200 한 장에서 4B 46분, 9B 55분, 27B 2시간 반 정도였습니다.
공개 기준은 결과를 보기 전에 정해 두었습니다. 학습에 한 번도 쓰지 않은 2Wiki 에서 실제 개체와 가상 개체 모두 사슬 선택도의 아래쪽 끝이 0을 넘어야 했습니다. MuSiQue 시험 분할에서도 같은 조건을 요구했습니다. 그리고 2Wiki 명목 점수가 같은 크기의 학습 전 모델보다 0.02 넘게 떨어지면 안 됐습니다. 세 크기가 모두 이 기준을 넘었습니다.
나온 결과
학습 전 모델과 학습 후 모델을 같은 프롬프트, 같은 채점 경로로 나란히 쟀습니다. 아래 표의 사슬 선택도는 학습에 쓰지 않은 2Wiki 의 실제 개체 기준입니다.
| 모델 | 명목 점수 (학습 전 → 후) | 사슬 선택도 (학습 전 → 후) |
|---|---|---|
| 4B | 0.932 → 0.983 | +0.136 → +0.376 |
| 9B | 0.898 → 0.993 | +0.078 → +0.386 |
| 27B | 0.905 → 0.997 | +0.129 → +0.461 |
2Wiki 실제 개체 295쌍. 사슬 선택도의 95% 구간(2,000회 재표집): 27B 학습 후 [+0.397, +0.485], 학습 전 [+0.054, +0.200]. 크기별 전체 표는 각 모델 카드에 있습니다.
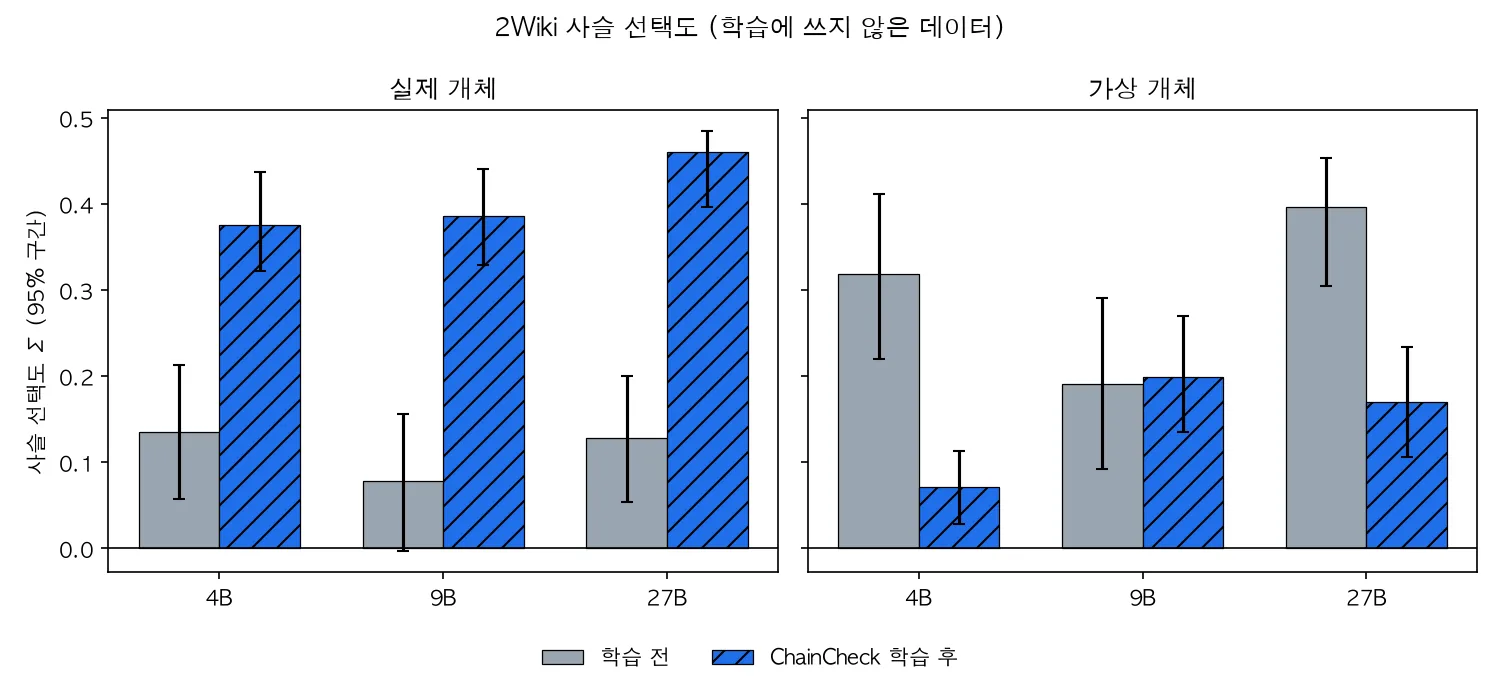 막대는 사슬 선택도, 선은 95% 구간입니다. 왼쪽이 실제 개체, 오른쪽이 가상 개체입니다.
세 크기 모두 사슬 선택도가 두 배 넘게 올랐습니다. 9B 는 학습 전 값의 구간이 0을 걸치고 있었으니, 학습 전에는 다리를 본다고 말할 근거가 없던 모델입니다.
즉, 사람 말로는 학습 전 판정기는 흔적에 반응하는 몫이 컸고 학습 후 판정기는 끊긴 다리를 훨씬 분명하게 잡습니다.
무엇이 바뀌었는지는 두 효과를 나눠 보면 보입니다. 실제 개체 기준으로 학습 전 모델은 편집 효과가 +0.1 에서 +0.2 남짓이었습니다. 이름표만 바뀐 멀쩡한 문맥에 벌점을 주고 있었다는 뜻입니다. 학습 후에는 사슬 효과가 거의 최댓값인 0.5 근처까지 올랐습니다. B 와 D 를 거의 완벽하게 가른다는 말입니다.
좋아지지 않은 곳
여기부터가 이 모델을 쓰기 전에 꼭 아셔야 할 부분입니다.
첫째, 학습 후 모델은 반대 방향으로 기울었습니다. 이번에는 이름표를 바꾼 문맥 B 를 손대지 않은 문맥 A 보다 더 높게 봅니다. 편집 효과가 대부분의 칸에서 음수로 뒤집혔고 큰 곳은 −0.5 까지 갑니다. 사슬 선택도는 편집 효과의 크기를 빼기 때문에 이 문제는 이미 위 숫자에 감점으로 들어가 있습니다. 그래도 이 점수를 “편집에 무관한 점수”로 읽으시면 안 됩니다.
둘째, 이름표를 처음 보는 가상의 이름으로 바꾼 문맥에서는 사슬 선택도가 대부분의 칸에서 학습 전보다 낮아졌습니다. 예외는 9B 의 2Wiki 하나입니다. 27B 기준으로 2Wiki 에서 +0.40 이 +0.17 로, MuSiQue 확인용 분할에서 +0.42 가 +0.05 로 내려갔습니다. 공개 기준인 “0보다 확실히 크다”는 넘었지만, 학습 효과는 실제 개체 쪽에서만 났습니다.
셋째, 27B 는 MuSiQue 확인용 분할의 실제 개체에서도 학습 전보다 값이 낮습니다(+0.18 → +0.11). 두 구간이 겹쳐 있어 나빠졌다고 잴 수는 없습니다. 다만 좋아졌다고도 말할 수 없습니다.
즉, 사람 말로는 실제 위키백과 개체가 나오는 문맥에서는 확실히 나아졌고 낯선 이름이 섞인 문맥에서는 기대하지 않으시는 편이 맞습니다.
공개하면서 걸린 두 가지
하나는 병합 과정에서 빠진 가중치였습니다. 처음 합친 4B 모델을 원본과 텐서 이름 단위로 맞대 보니 15개가 없었습니다. Qwen3.5 계열에 붙은 다중 토큰 예측(MTP) 가중치인데, 학습 코드가 읽어 들이지 않는 부분이라 저장할 때 조용히 빠졌습니다. 점수에는 영향이 없지만, 이것이 빠지면 vLLM 의 추측 디코딩을 쓸 수 없습니다. 원본 값을 그대로 옮겨 담도록 고쳤습니다. 원본에 있는 텐서가 하나라도 빠지면 공개 작업이 멈추도록 검사도 붙였습니다.
다른 하나는 기준 판정기의 재채점이었습니다. 논문 실험의 27B 기준 판정기를 이번 공개 경로로 다시 채점했더니, 문항 순위는 사실상 같은데 사슬 선택도가 신뢰구간 안에서 조금 움직였습니다. A 와 B 는 이름 하나만 다른 거의 같은 문맥이라 점수가 아주 가깝습니다. 그래서 연산 정밀도의 작은 차이만으로도 “A 가 B 보다 높다”는 판정이 일부 뒤집힙니다. 편집 효과를 비교하실 때는 같은 장비, 같은 정밀도로 잰 값끼리만 나란히 놓으시길 권합니다.
ThakiCloud 제품 적용 시사점
Paxis 위에서 돌아가는 업무 에이전트는 사내 문서를 검색해 답을 만듭니다. 이때 가장 비싼 실수는 근거가 끊겼는데 그럴듯하게 답하는 경우입니다. 판정기를 생성 앞에 두면 “답한다, 더 찾는다, 멈춘다”를 고를 수 있습니다. 그런데 판정기가 흔적만 보면 개정된 사내 규정처럼 이름만 바뀐 정상 문서를 막고 정작 끊긴 근거는 통과시킵니다. 이번 대조군은 바로 그 차이를 공개 전에 잡아내는 도구입니다.
Metis 에서는 크기 선택이 비용입니다. 판정기는 모든 질문 앞에서 한 번씩 돌아가니, 호출량이 생성 모델과 같습니다. 4B 도 2Wiki 에서 학습 전 27B 보다 사슬 선택도가 높게 나왔습니다. 지연 시간이 중요한 경로에는 작은 판정기를, 판정 하나가 비싼 경로에는 27B 를 두는 식으로 나눌 수 있습니다. 세 모델 모두 병합된 전체 가중치라 어댑터 관리 없이 그대로 올라갑니다.
Maxis 에서는 이 레시피를 고객사 문서로 다시 돌릴 수 있습니다. 필요한 것은 “다리가 이어진 문맥, 이름표만 바뀐 문맥, 다리가 끊긴 문맥” 세 벌을 만드는 규칙입니다. 사람 라벨은 필요 없습니다.
직접 돌려보기
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

repo = "ThakiCloud/ChainCheck-Judge-Qwen3.5-4B"
tok = AutoTokenizer.from_pretrained(repo)
model = AutoModelForCausalLM.from_pretrained(repo, torch_dtype=torch.bfloat16, device_map="auto")

SYSTEM = ("You are a strict evidence auditor for a retrieval-augmented QA system. "
          "Decide whether the given passages, taken together, contain enough information "
          "to fully answer the question. Related-but-insufficient passages do NOT count.")
USER = ("Question:\n{query}\n\nPassages:\n{passages}\n\n"
        "Do the passages together contain sufficient evidence to answer the question? "
        "Answer with a single word: yes or no.")

yes = [i for i in range(len(tok)) if tok.decode([i]).strip().lower() in {"yes", "y"}]
no = [i for i in range(len(tok)) if tok.decode([i]).strip().lower() in {"no", "n"}]

def sufficiency_score(query, passages):
    body = "\n\n".join(f"[{i + 1}] {p[:4000]}" for i, p in enumerate(passages))
    msgs = [{"role": "system", "content": SYSTEM},
            {"role": "user", "content": USER.format(query=query, passages=body)}]
    text = tok.apply_chat_template(msgs, tokenize=False, add_generation_prompt=True, enable_thinking=False)
    ids = tok(text, return_tensors="pt", add_special_tokens=False).to(model.device)
    with torch.no_grad():
        lp = torch.log_softmax(model(**ids).logits[0, -1].float(), -1)
    return (torch.logsumexp(lp[yes], -1) - torch.logsumexp(lp[no], -1)).item()  # 0보다 크면 "충분" 쪽
점수는 확률이 아니라 로그 오즈입니다. 문턱값은 갖고 계신 검증 데이터로 정하셔야 합니다. 대화형 모델이 아니니 자유 생성으로 쓰지 마시고 위처럼 yes/no 로짓을 읽어 쓰시면 됩니다.
갖고 계신 판정기를 같은 잣대로 재 보고 싶으시면 벤치마크 키트를 쓰시면 됩니다. 문항마다 점수를 매긴 파일 하나만 넘기면, numpy 만으로 도는 평가 스크립트가 명목 점수, 사슬 효과, 편집 효과, 사슬 선택도를 신뢰구간과 함께 냅니다.
python chaincheck_eval.py --data twowiki_replication.jsonl.gz --scores my_scores.jsonl --exclude-cb27b
NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
재현과 링크
- 모델: ChainCheck-Judge-Qwen3.5-4B, ChainCheck-Judge-Qwen3.5-9B, ChainCheck-Judge-Qwen3.8-27B
- 벤치마크 키트: ThakiCloud/ChainCheck (MuSiQue·2WikiMultiHopQA 기반 3,786문항, 평가 스크립트 포함)
- 컬렉션: ChainCheck 컬렉션
세 모델과 키트는 Apache-2.0 으로 공개돼 있습니다(키트 데이터는 원본 데이터셋 라이선스를 따릅니다). 모델 카드마다 학습 전 모델과 나란히 놓은 전체 표, 위에 적은 한계, 학습 설정이 그대로 있습니다. 측정 방법을 다룬 논문은 공개를 준비하고 있습니다.
판정 점수가 이미 0.9 를 넘는 상황이라면, 지금 필요한 것은 더 높은 점수가 아니라 다른 질문입니다. 그 판정기가 끊긴 다리를 보는지, 고친 흔적을 보는지부터 확인하셔야 합니다.
측정: B200 한 장, bf16, 2026-10-05. 수치는 같은 크기 학습 전 모델과 같은 채점 경로로 잰 값입니다.