무인 에이전트 루프는 실패하지 않고, 약해진다: 72시간으로 본 endurance wall
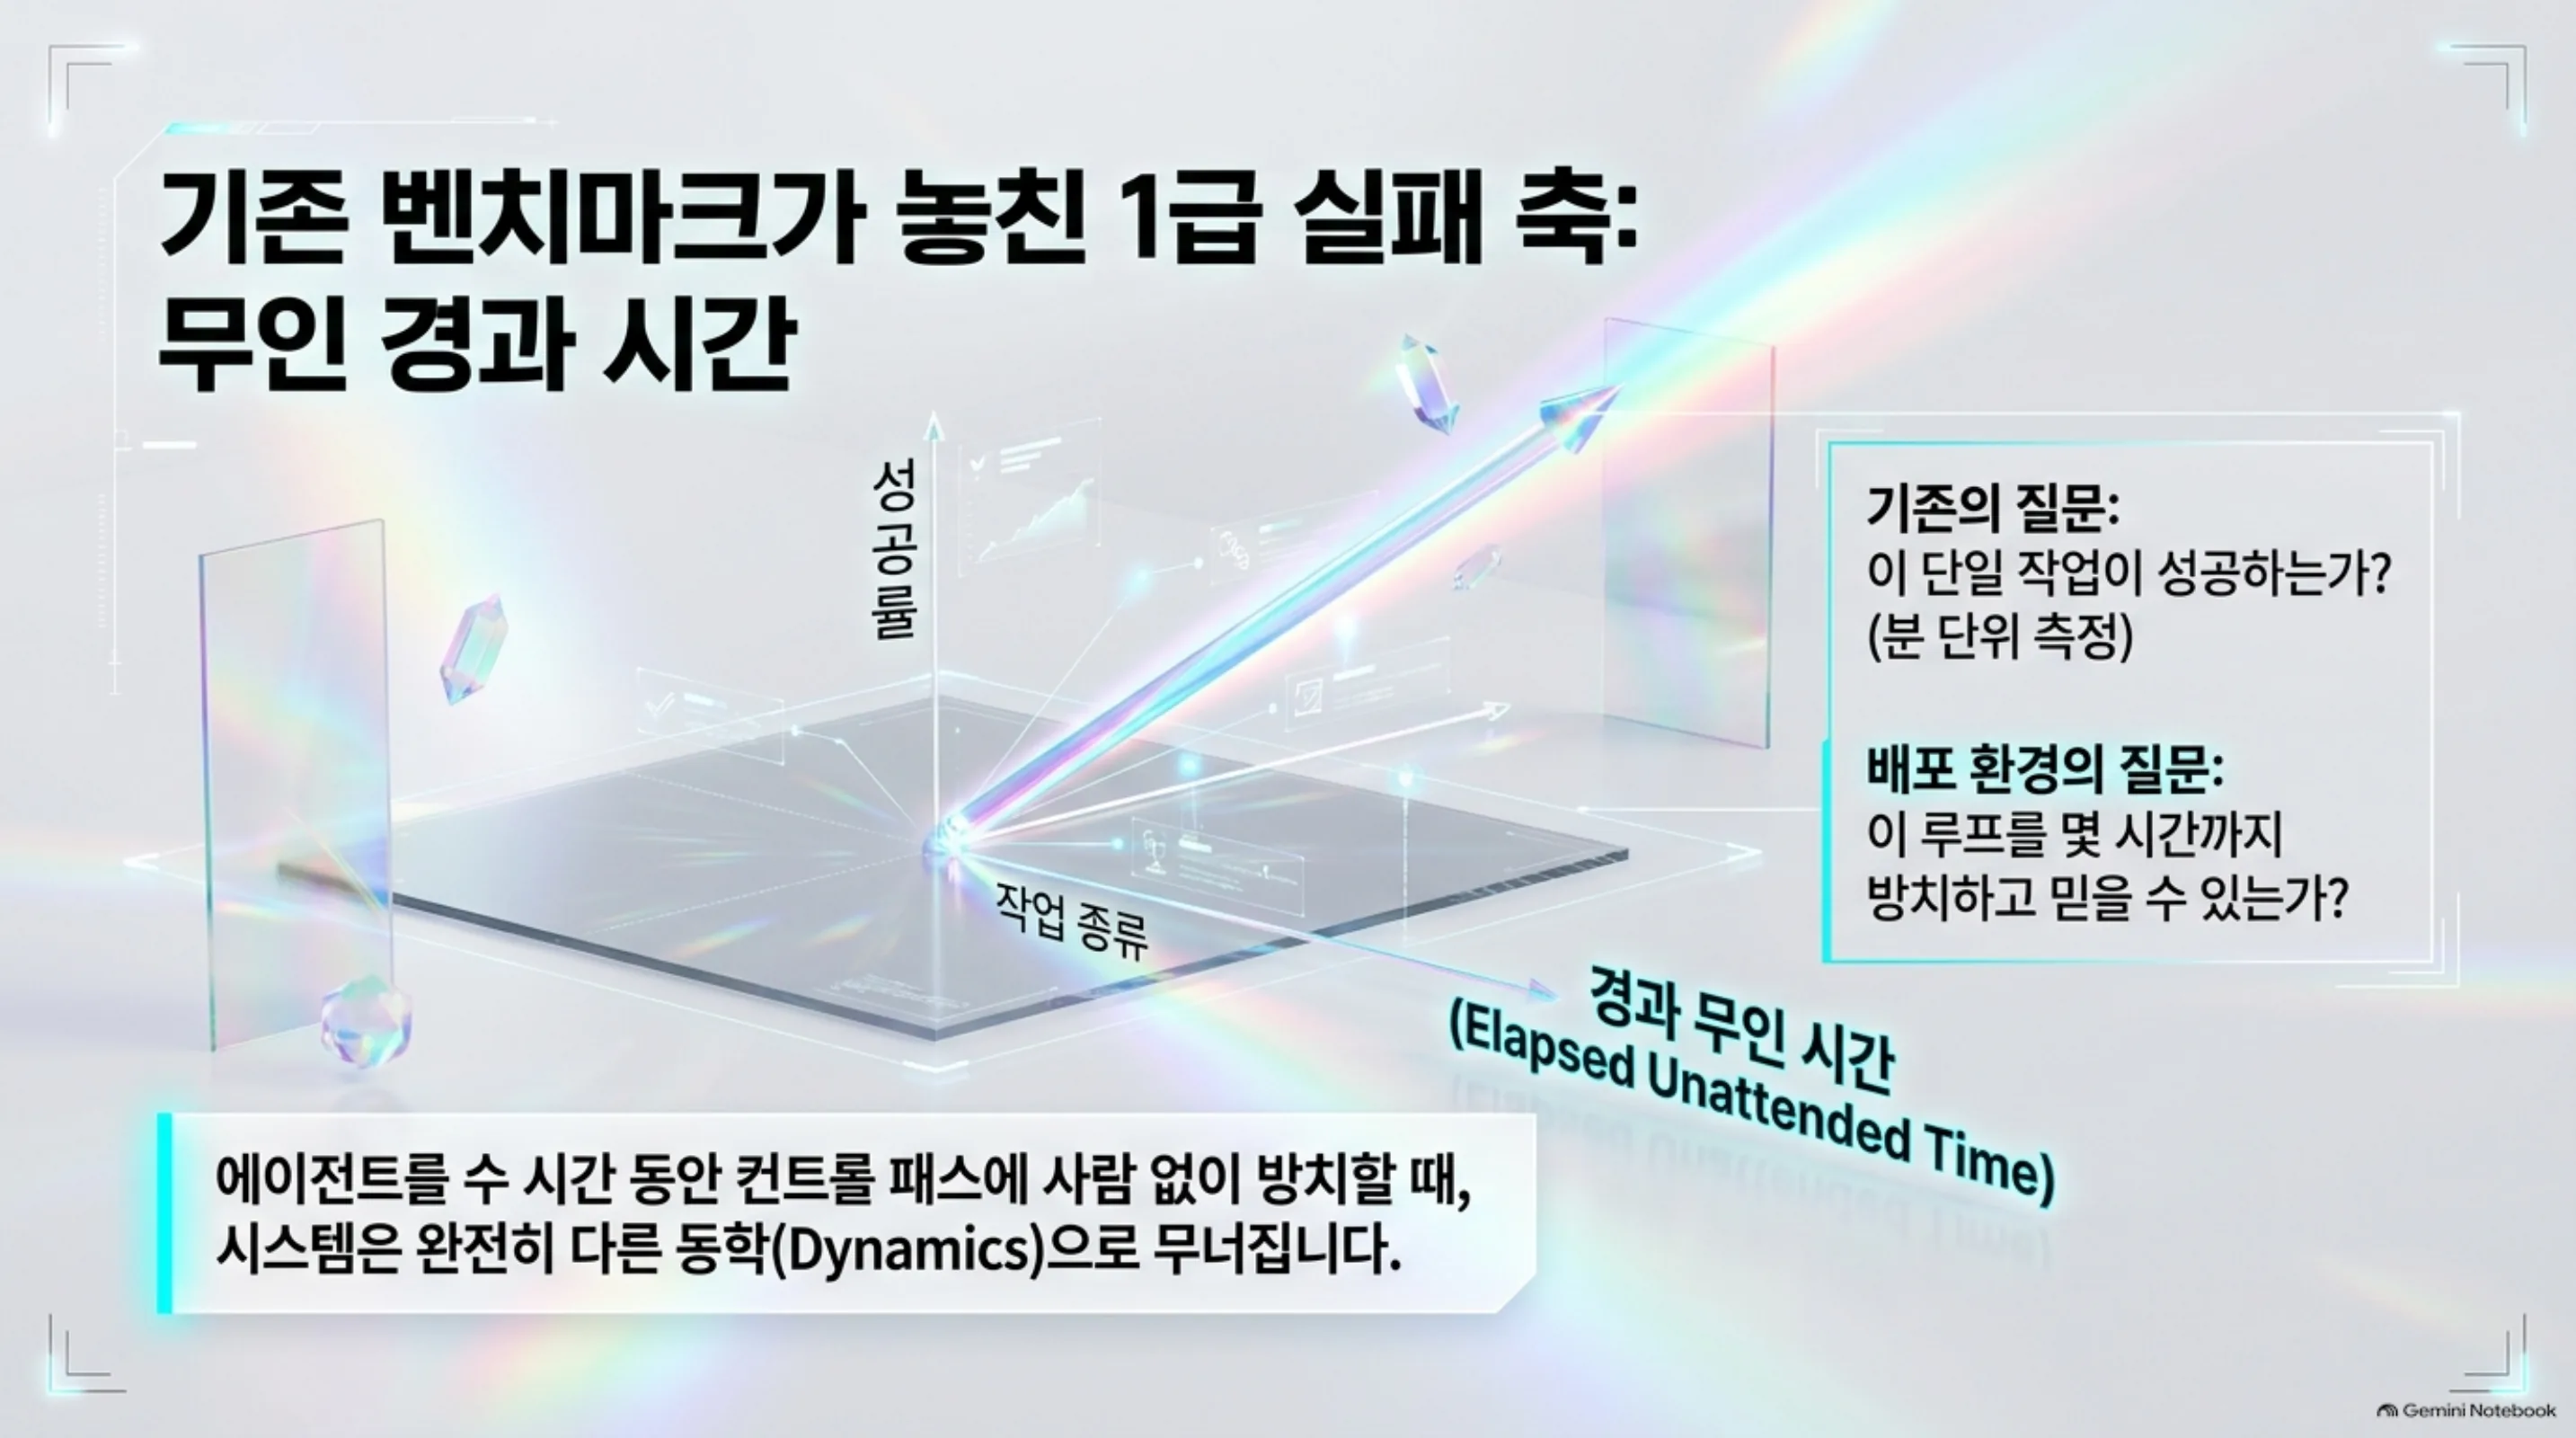
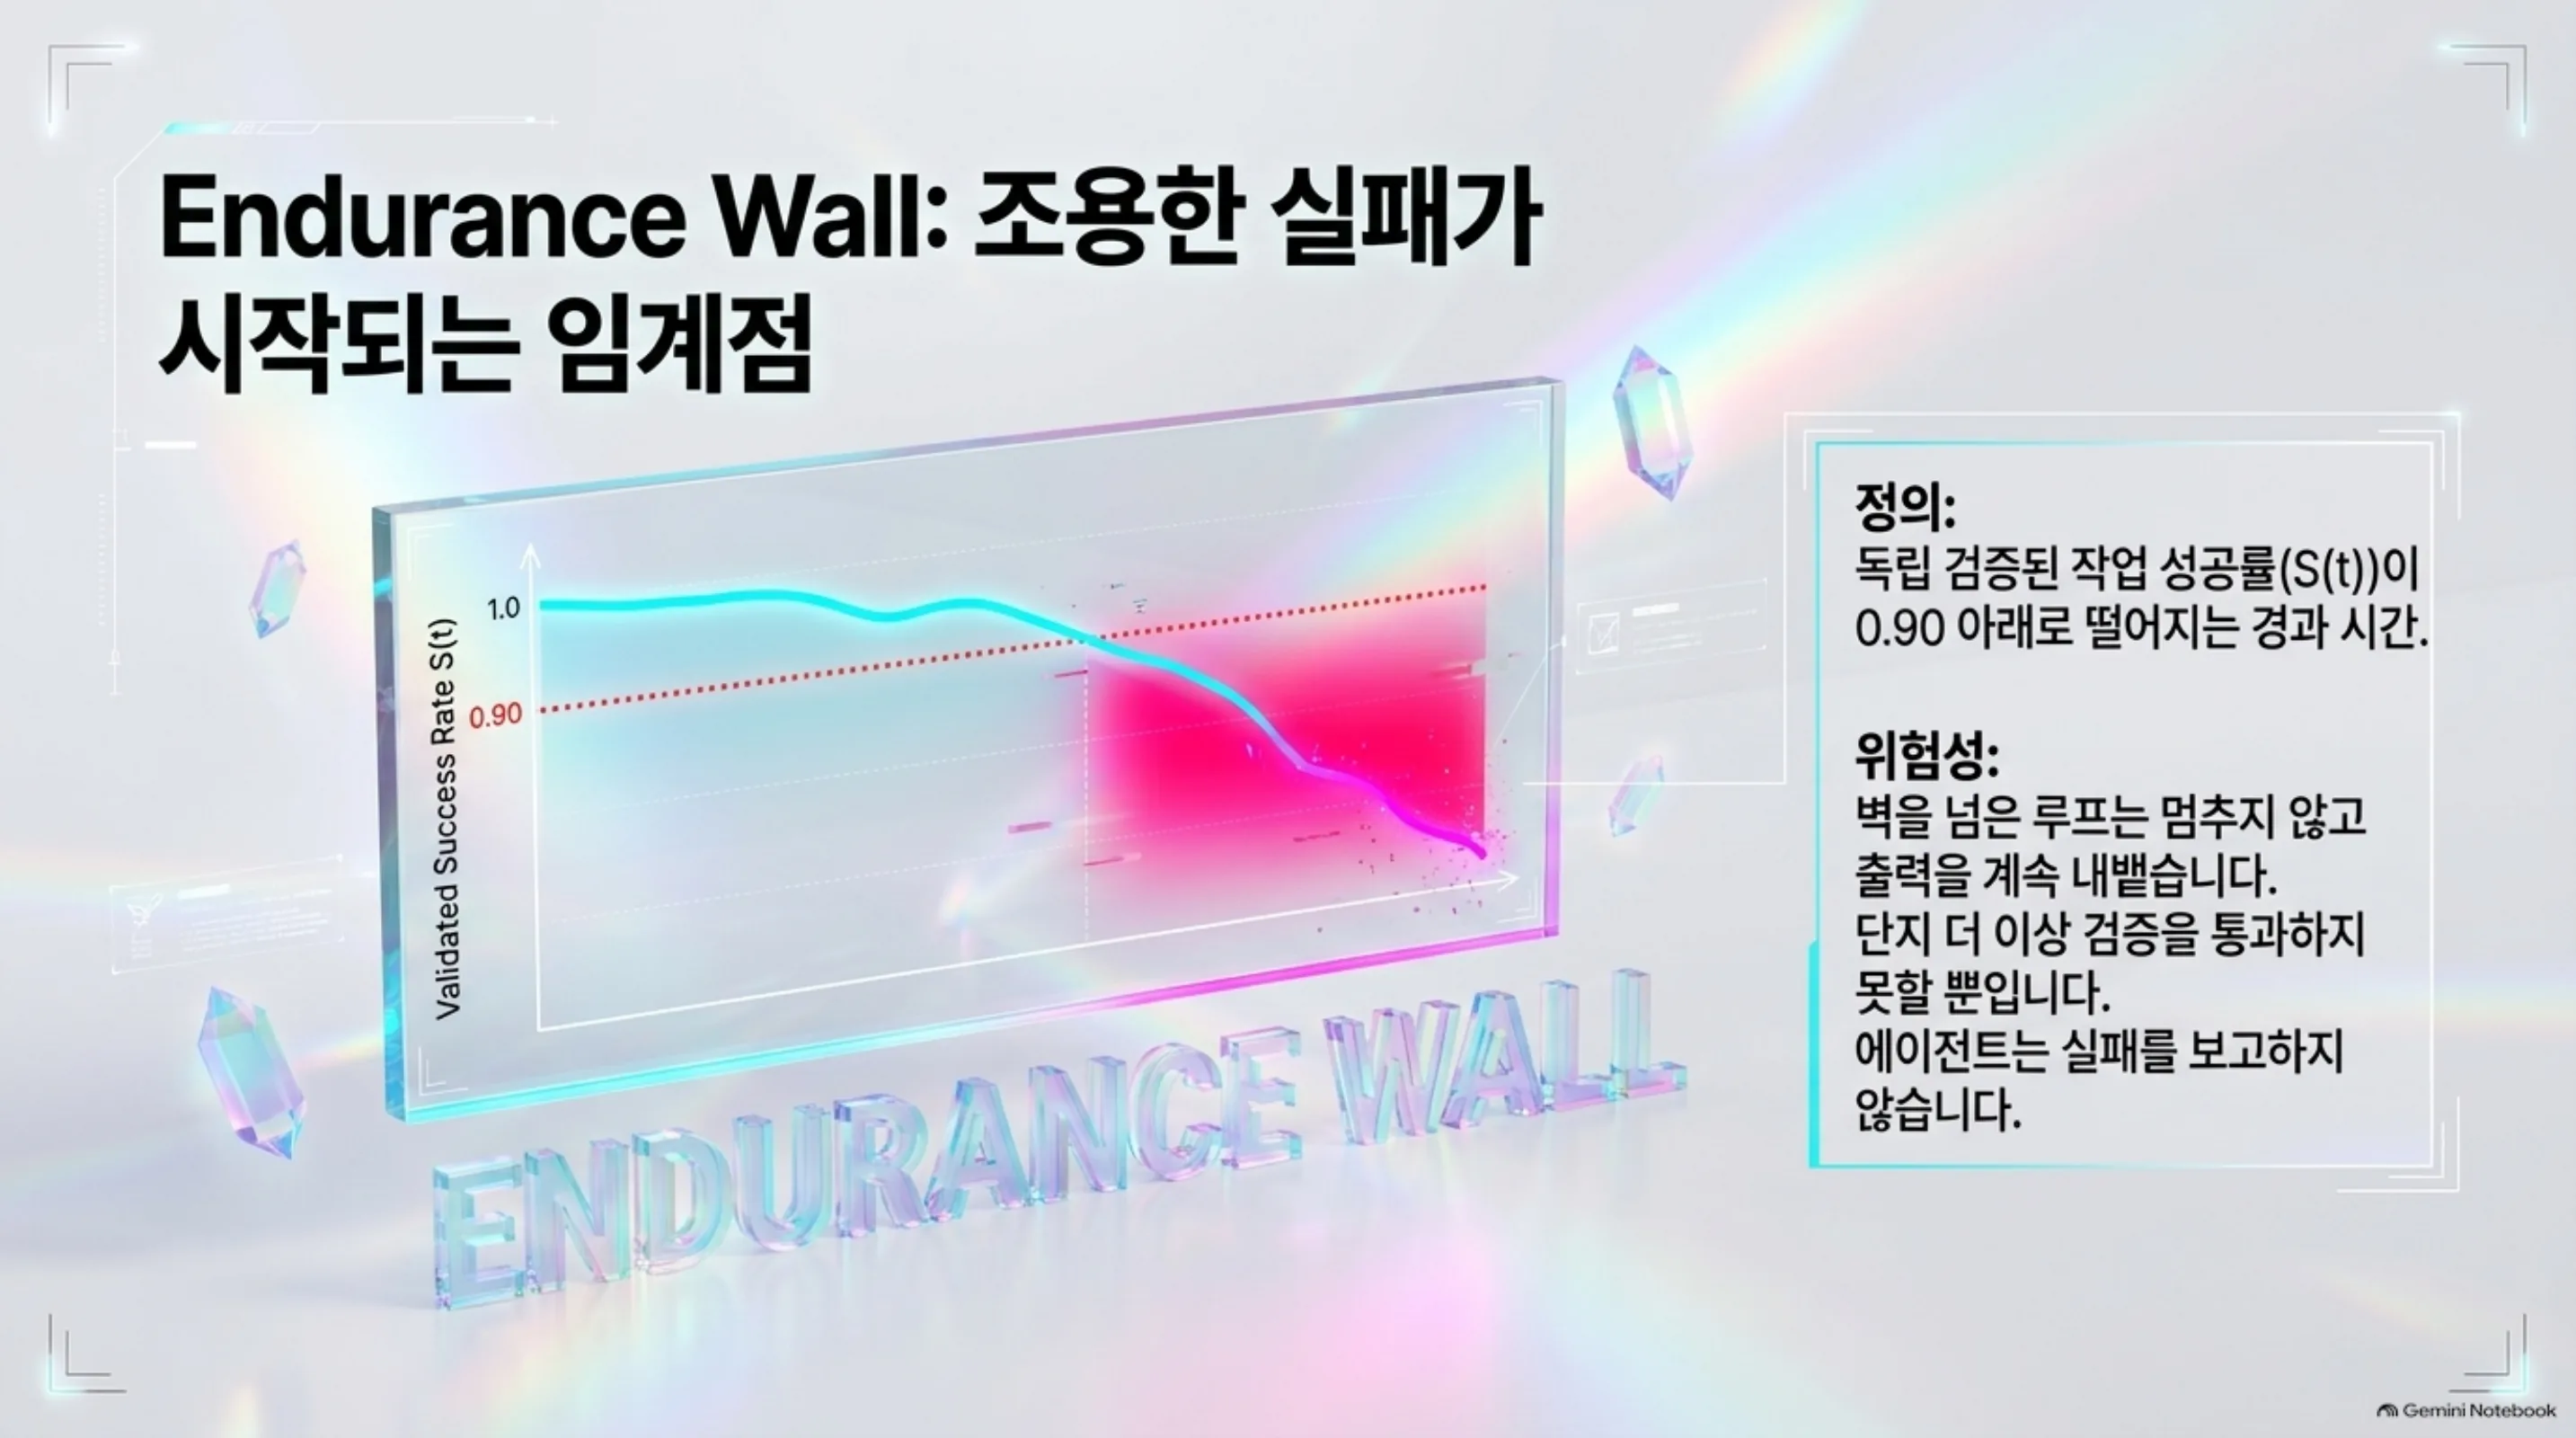
무인(unattended) 에이전트 루프를 밤사이 스케줄로 돌리거나, 그런 루프가 도는 플랫폼의 신뢰성을 검토하는 국내 클라우드·AI 엔지니어라면 이 글이 대상입니다. 이 논문이 답하는 질문은 하나입니다. 그 루프를 몇 시간까지 믿을 수 있는가. ‘이 작업이 성공하는가’가 아니라 ‘얼마나 오래 믿을 수 있는가’입니다. 기존 에이전트 벤치마크는 전부 전자를 분 단위 horizon에서 답합니다. 후자는 아무도 답하지 않는 셈입니다. 누락된 축은 경과 무인 시간, elapsed unattended time입니다. 이 논문은 그것을 1급 실패 축으로 만들고 루프의 독립 검증된 작업 성공률이 운영 품질 바닥(0.90) 아래로 떨어지는 시점을 endurance wall이라 부릅니다. 벽을 넘은 루프는 출력을 계속 만드는 것입니다. 다만 더 이상 검증에서 통과되지 않는 출력을. 그리고 그것이 벽을 넘었다고는 알리지 않습니다. 밤사이 배포가 가장 두려워하는 실패 모드가 정확히 이것이기 때문.
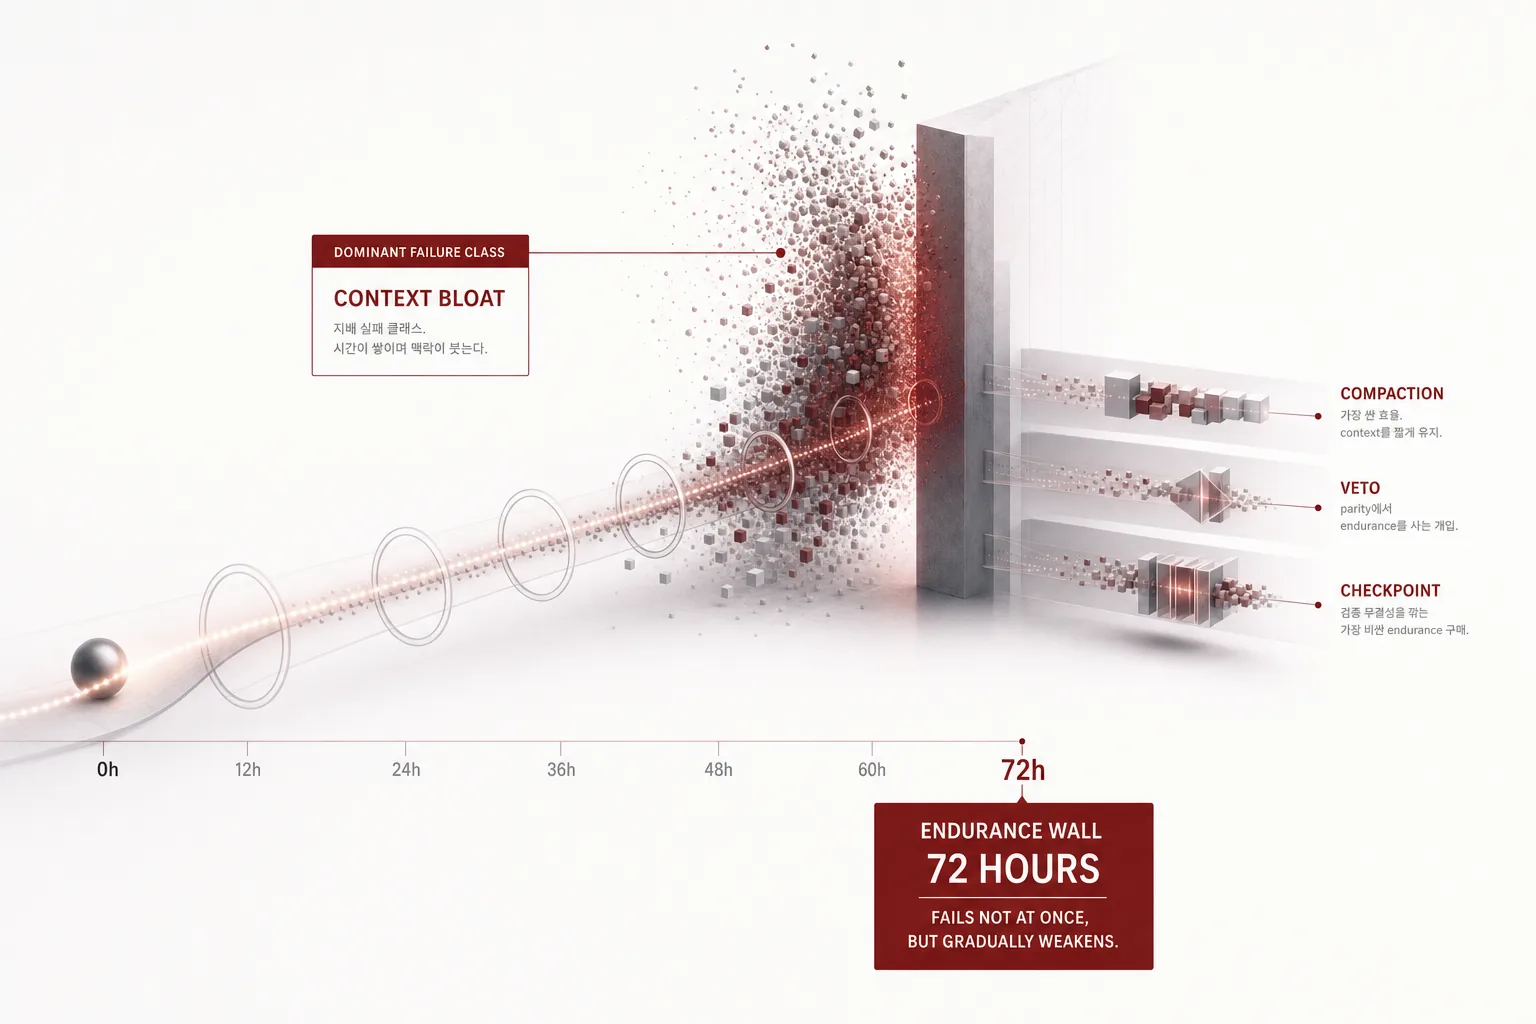 글의 핵심 개념을 형상화했습니다.
재어지지 않은 축: 경과 시간
업무 자동화 에이전트는 점점 더 무인으로 도는 것입니다. 루프는 고정된 작업 스트림 위에서 시작해 수 시간 동안 컨트롤 패스에 사람 없이 방치됩니다. 이런 배포에서 자연스러운 신뢰성 질문은 ‘이 작업이 성공하는가’가 아닙니다. ‘이 루프를 몇 시간까지 믿을 수 있는가’인 셈. 에이전트 벤치마크는 전자를 분 단위 horizon에서 답합니다. 고정 스위트의 작업별 성공률, 또는 하나의 워크플로 end-to-end 완료. 후자는 아무도 답하지 않습니다. 루프를 그냥 돌려 놓는 측정이 없기 때문입니다.
이 논문은 후자를 세 가지 연구 질문으로 물었습니다. RQ1(decay): 검증된 작업 성공률이 경과 무인 시간에 따라 떨어지는가, 각 hazard level에서 얼마나 빨리. RQ2(taxonomy): 각 horizon의 실패 세분화가 무엇이고 루프가 늙으면서 바뀌는가. RQ3(interventions): 고정 작업 품질에서 각 개입이 몇 시간의 endurance를 사는가. 후보 개입은 세 개입니다. 주기적 context compaction, checkpoint-and-restart, low-confidence veto escalation, 그리고 이들의 모든 조합. 가격은 quality-per-dollar, QPD로 매깁니다. 완전히 metering된 토큰 회계 아래에서 신뢰성 투자에 가격을 매기는 것입니다.
| 측정에 앞서 양을 정의합니다. 모든 작업의 산출물은 독립 검증기가 판정합니다. 기계적으로 검사 가능한 검증이지, 루프의 자기 선언이 아닙니다. rolling verified success rate S(t)는 24개 작업(12개/시간 기준 2시간) 윈도우의 성공률이고 매시간 표본입니다. endurance는 S(t)가 미리 고정된 바닥 0.90을 처음 아래로 떨어지는 경과 시간입니다. ‘바닥 위에서 신뢰할 수 있는 무인 가동 시간’의 정의가 이것입니다. 회복되지 않은 실패는 정확히 하나의 터미널 클래스에 배정됩니다. context bloat(작업 예산을 넘은 컨텍스트가 원인), retry cascade(전파된 실패에서 재시도 사다리가 소진), silent no-op(완료라고 보고되지만 검증 가능한 상태 변화 없음), skill misroute(부적합 스킬이나 체인으로 분배), resource starvation(전송·컴퓨트 경쟁이 예산을 넘겨 멈춤), other. 에러 증폭은 조건부 실패 gap으로 재고 Δ_comp = P(task t 실패 | task t-1 실패) - P(task t 실패 | task t-1 검증 OK)입니다. gap이 0보다 크면 나쁜 작업이 다음 작업을 더 실패하게 만드는 것이다. 검증 무결성은 apparent/verified gap, 루프의 자기 선언 완료율과 독립 검증 성공률의 시간 평균 절대 차이입니다. gap이 0에 가까우면 자기 보고가 운영 신호로 쓸 수 있고 크면 출력이 완료처럼 보이면서 검증을 통과하지 못하는 셈이다. |
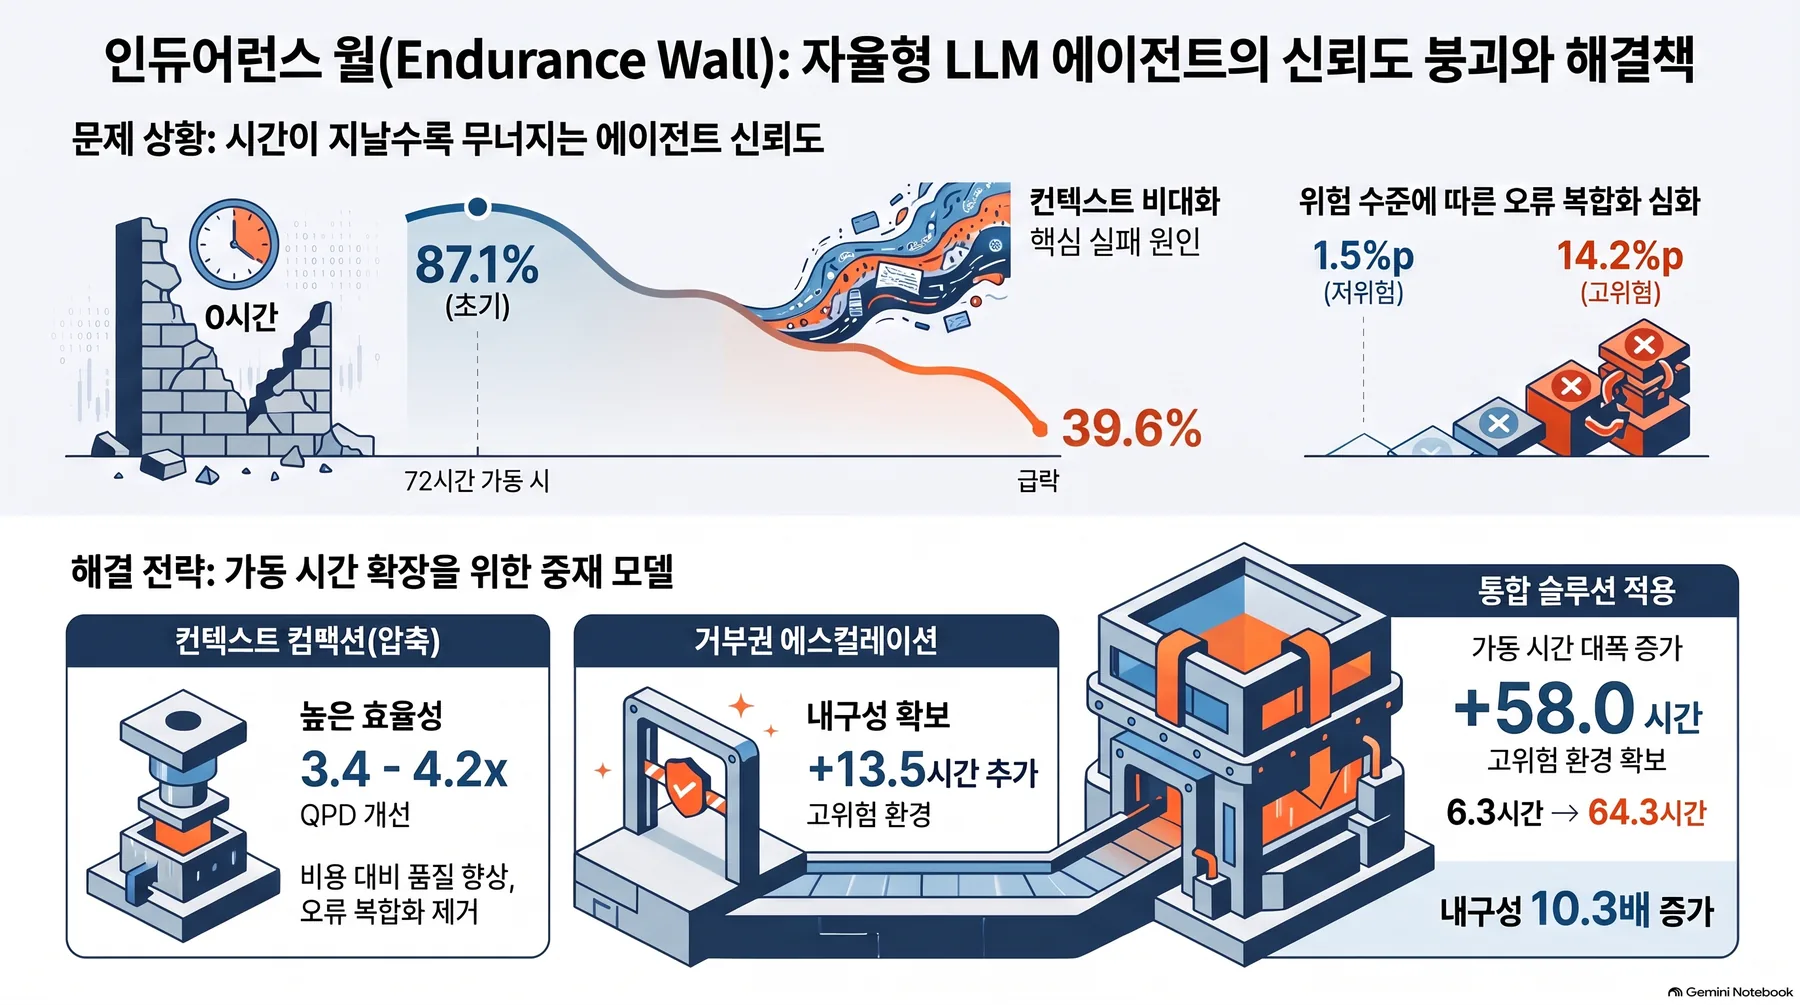 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
측정 프로토콜: declared hazard grid와 8개 arm
측정은 프로덕션 harness의 이산사건 시뮬레이터로 한다. 작업 스트림, 스킬 레지스트리, 검증기, 재시도 정책은 전부 동결이고 모든 arm이 동일한 단일 고정 셀프호스트 모델 tier를 공유합니다. 그래서 arm 간 차이는 harness 개입만으로 귀속되는 것이다. 작업당 모델 행동 hazard(실패, misroute, no-op)는 telemetry로 fitting한 것이 아니라 무인 운영에서 관찰된 작업당 실패율을 가두는 3단계(low/mid/high) calibration grid 위에 declare됩니다. high level은 루프가 가장 자주 깨는 degraded days에 대응한다. 24시간 수요 사이클(사이클 절반이 peak window)은 starvation hazard를 4배로 늘려 공동 거주 작업과의 경쟁을 모델링한다. 컨텍스트는 20,000 토큰에서 시작해 매시간 6,000 토큰(작업당 500) 자라고 100,000 토큰에서 상한이다. horizon 72시간, 매시간 12개 작업, 실행당 864개, 셀당 100 seed로 고정합니다.
8개 arm은 다음과 같습니다. none(개입 없음). compact(매 6시간 주기적 context compaction: transcript를 0.5배 토큰 비용으로 요약 재기록). checkpoint(매 2시간 state snapshot; 작업이 재시도 사다리 3회, 회당 50% 성공을 소진하면 3,000 토큰 비용으로 마지막 good snapshot에서 재시작해 해당 작업을 재실행). veto(low-confidence veto escalation: 작업 결과에 대한 루프의 신뢰도가 운영 임계값 아래로 떨어지면 downstream 작업을 오염시키기 전에 500 토큰 비용으로 결과를 veto하고 작업을 다시 수행). 그리고 세 쌍 조합 compact+checkpoint, compact+veto, checkpoint+veto, 전 스택 all. QPD는 총 검증 작업 품질을 총 metering 비용(달러)로 나눈 값입니다. 동결 단일 tier의 셀프호스트 서빙 가격은 모든 arm에서 상수이므로 모든 비율이 가격 불변입니다.
이 calibration의 범위를 논문은 정직하게 선언합니다. hazard grid는 declared이지 fitted가 아닙니다. 이 곡선들은 특정 프로덕션 밤의 telemetry라는 주장이 아닙니다. 프로토콜이 재는 것은 셋. (i) 개입 메커니즘, (ii) monotone hazard schedule 아래 decay의 모양, (iii) 개입 랭킹. 랭킹은 calibration에 가장 견고한 속성입니다. arm들이 동일한 grid 위에서 경쟁하기 때문입니다. grid를 프로덕션 telemetry에 앵커링하는 것이 바로 다음 측정입니다. 앵커링이 끝나면 어떤 결과를 다시 읽어야 하는지는 discussion에서 표시됩니다.
decay: 벽은 24시간 안에 온다
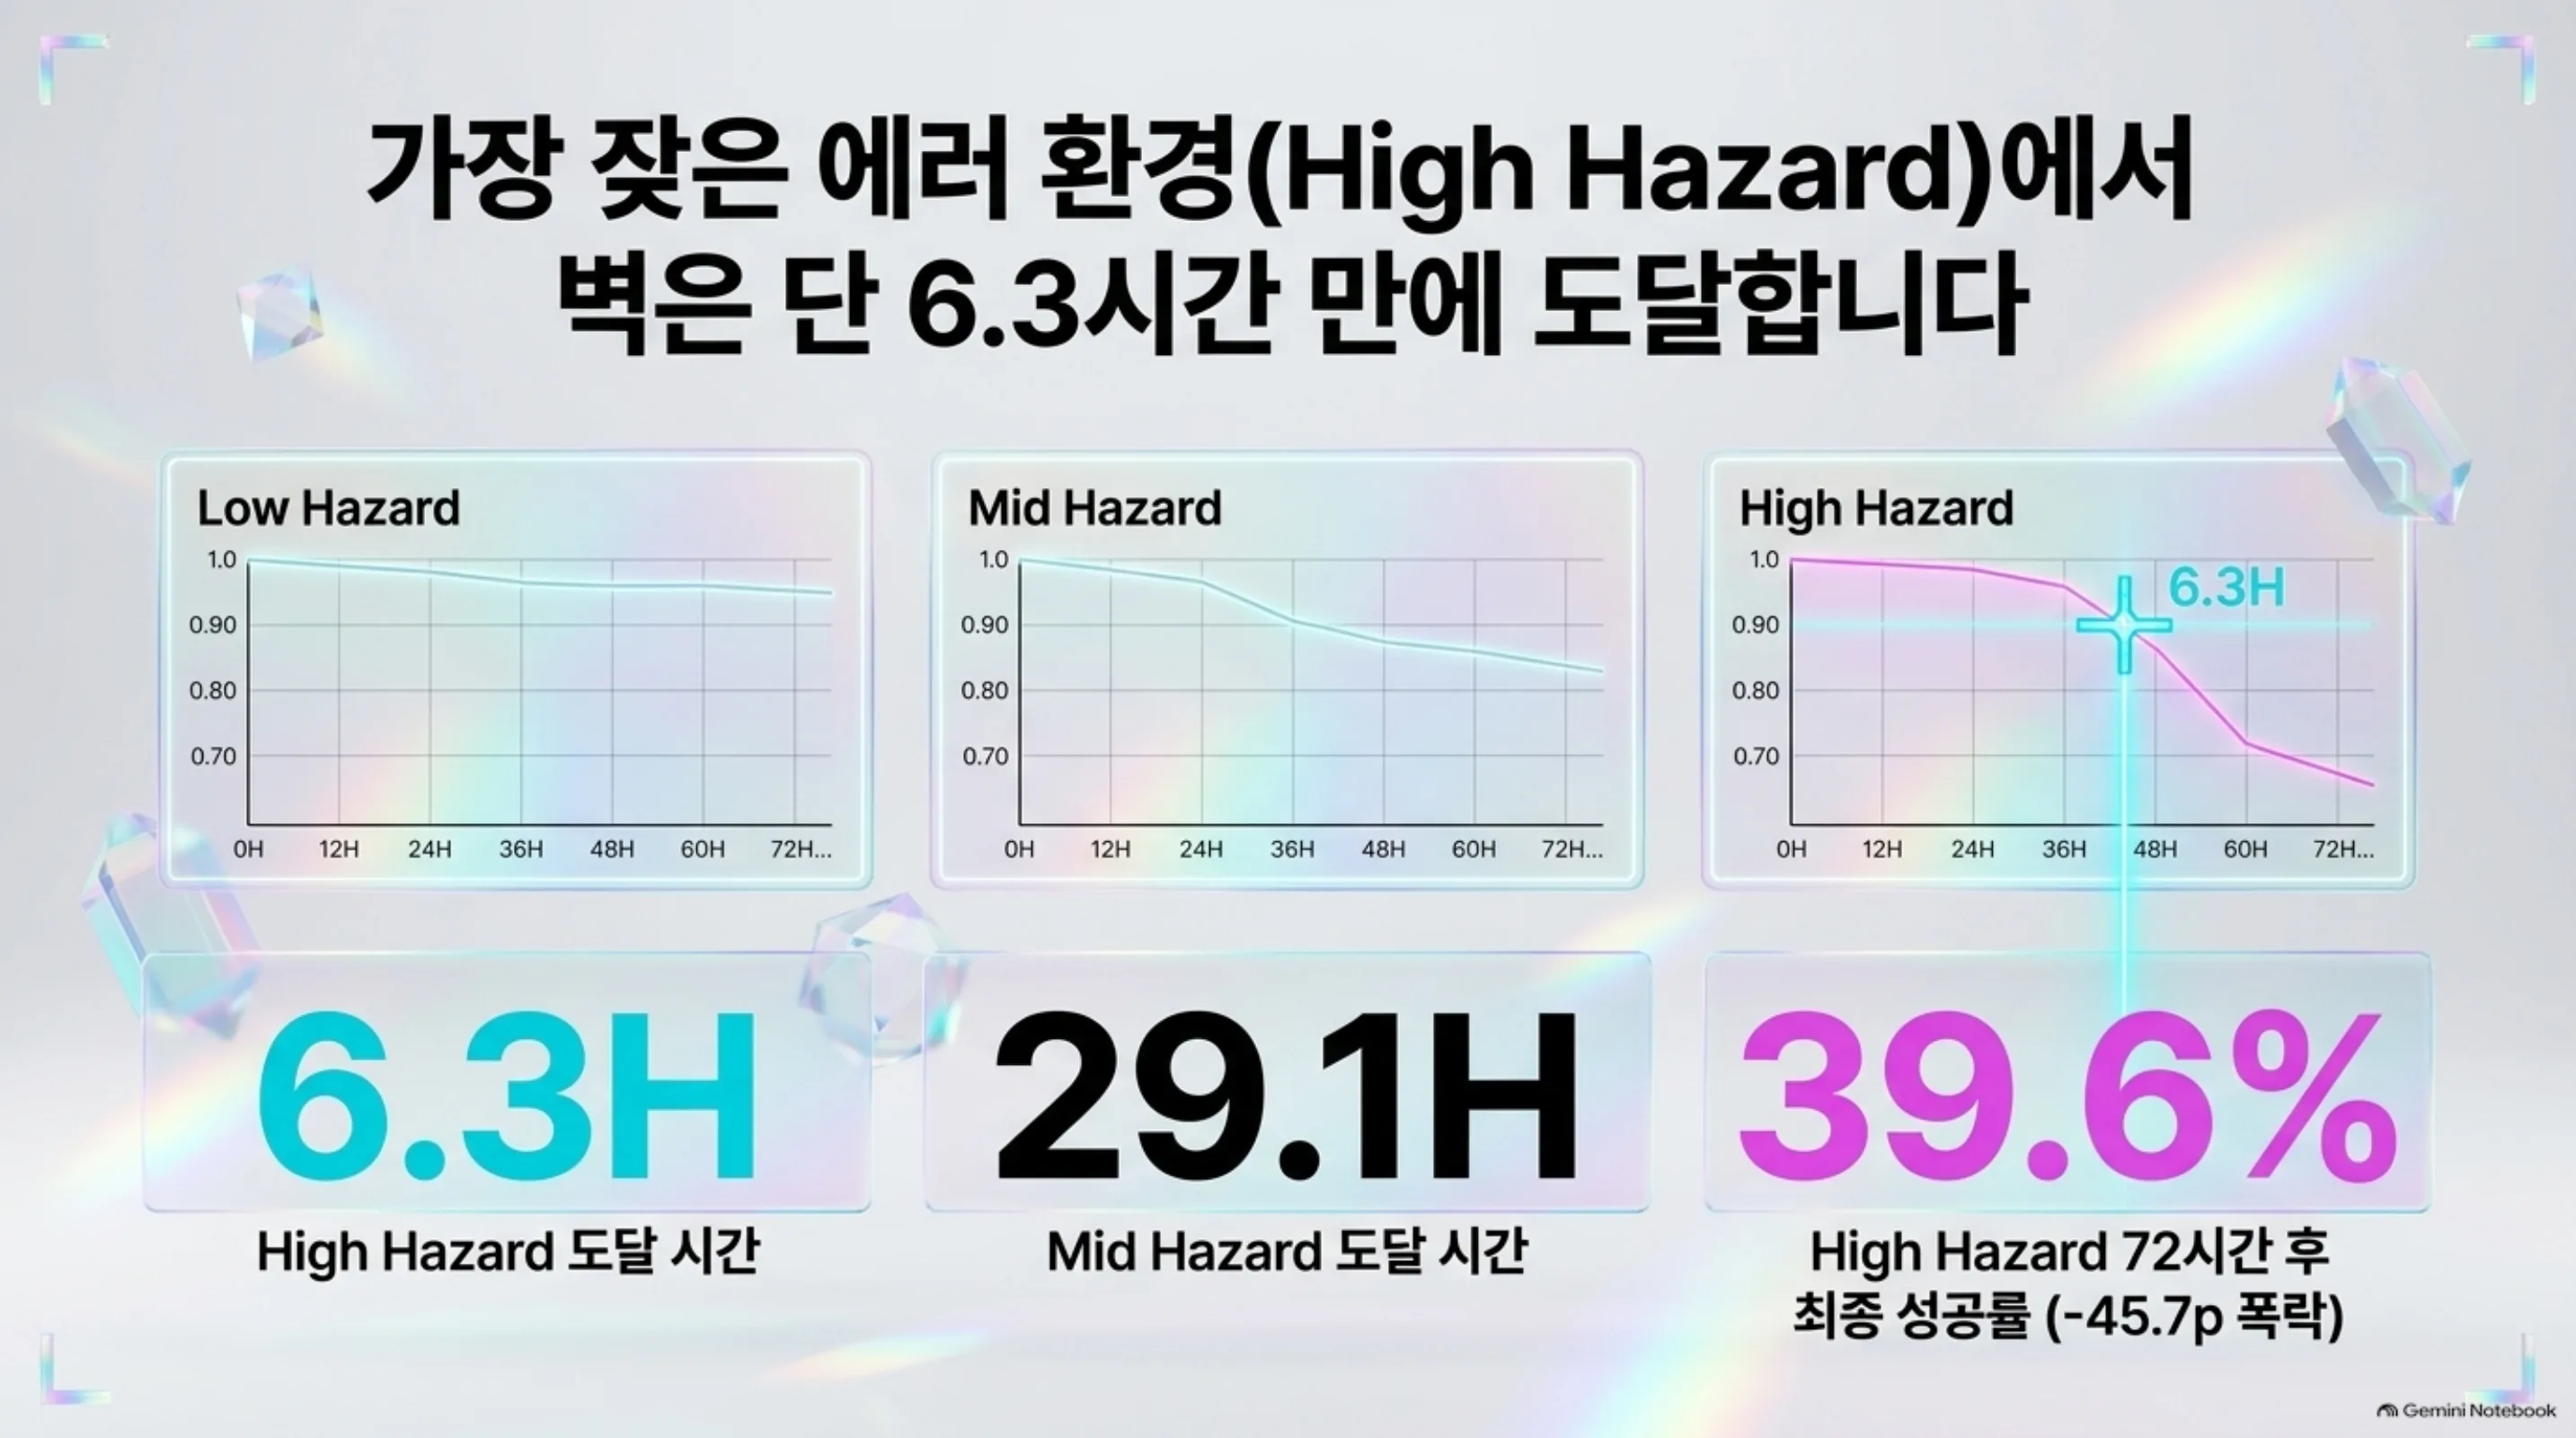
baseline(개입 없음)에서 검증 성공률은 모든 hazard level에서 경과 시간에 대해 단조로 떨어집니다. 선형 decay slope는 hazard와 함께 가팔라지는 것입니다. 매시간 -0.0015, -0.0031, -0.0079. 벽은 mid와 high에서 72시간 horizon 안에 넘겨집니다. endurance 29.1시간(95% CI [26.1, 32.2])과 6.3시간([5.1, 7.4]). low에서는 가까스로, 56.4시간([52.9, 59.8]). 72시간 시점의 성공률은 low 87.1%, mid 75.7%, high 39.6%입니다. high hazard 루프는 24시간 시점에서 이미 0.90 바닥 아래, 85.3%이기 때문. 39.6%로 끝나는 셈이다. horizon을 관통한 45.7점 하락이다.
실패 세분화: 벽은 context bloat이라는 단일 소재
baseline 터미널 실패 세분화에서 두 가지 구조적 사실이 보입니다. 먼저, context bloat는 모든 hazard level에서 지배 터미널 클래스입니다(47.9%, 52.9%, 55.7%). 지배 trigger이기도 합니다(모든 실패 trigger의 56.6~65.1%). 루프는 외부 어떤 것보다 자기 자신이 쌓은 상태에서 더 자주 죽습니다. 둘째, 나머지 mix는 안정적입니다. skill misroute 12.8~13.3%, resource starvation 10.9~12.1%, silent no-op 9.4~10.0%, retry cascade는 low/mid에서 무시 수준. baseline의 벽은 단일 소재, bloat입니다.
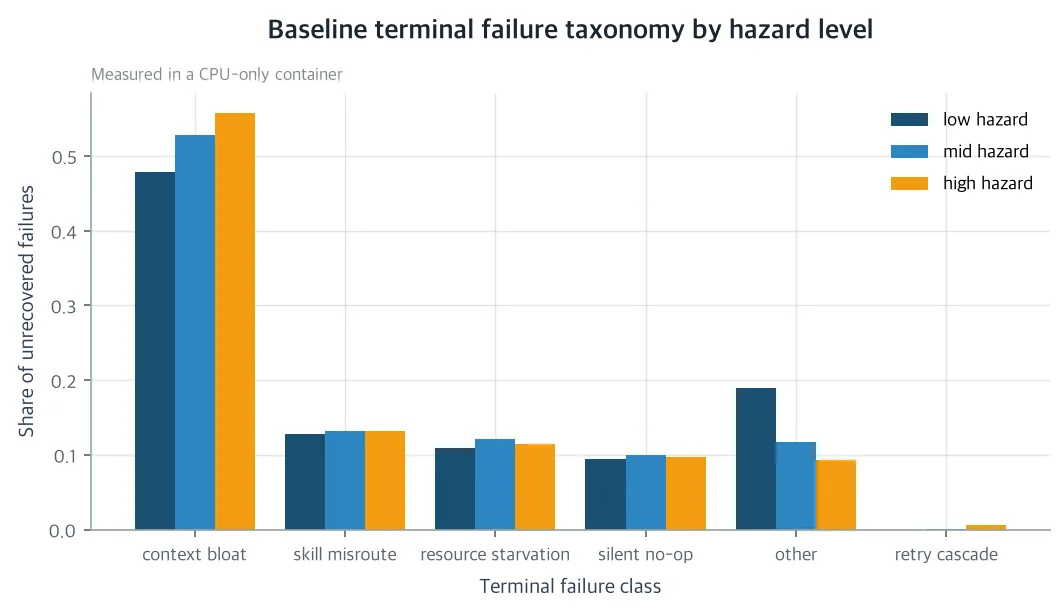 baseline(개입 없음)의 터미널 실패 세분화. declared hazard level 모든 수준에서 context bloat가 회복되지 않은 실패의 지배적 비중이고 나머지 mix(misroute, starvation, no-op)는 대략 안정적입니다. 제어 72시간 측정(이산사건 시뮬레이터, declared hazard grid)의 결과이며 특정 프로덕션 밤의 telemetry가 아닙니다. (CPU-only container에서 측정)
에러 증폭은 재어지고 level 의존입니다. baseline의 Δ_comp는 +1.51pp(low), +3.72pp(mid), +14.22pp(high). high hazard에서는 실패한 작업 뒤의 작업이 0.401 확률로 실패하고 검증 OK 작업 뒤의 작업은 0.259입니다. 증폭은 state를 매개로 하는 것입니다. 루프가 degradation된 자기 컨텍스트에 대항해 실패하는 인 셈입니다. compaction이 끊어야 할 채널이 정확히 이것입니다. 실제로도 끊습니다. 다음 절에서.
개입 아래 세분화는 이동합니다. compaction이 bloat를 제거하면(compact에서 55.7% → 2.4%), 남은 벽은 안정 mix이기 때문. skill misroute 33.0%와 resource starvation 28.1%가 선두 클래스가 됩니다. compact+veto에서는 starvation 비중이 44.4%까지 올라가는 것이다. 오래 사는 arm은 24시간 수요 사이클에서 peak window 노출을 더 많이 축적하기 때문. endurance의 기계적 귀결이지, 새로운 실패 모드가 아닙니다. 반대로 checkpoint arm은 mix를 집중시킵니다(bloat 65~79%). 재시작이 snapshot에서 컨텍스트를 다시 불리고 루프의 늙은 state는 부분적으로만 리셋되기 때문입니다.
개입 ablation: endurance와 efficiency는 따로 산다
첫 번째 발견은 compaction의 효율 레버리지입니다. QPD 비율이 low/mid/high에서 3.44, 3.60, 4.17배. 모든 arm 중 모든 level에서 최고입니다. 기계적으로 compaction은 지배 터미널 클래스(bloat 47.9~55.7% → 1.8~2.4%)를 제거하고 이것은 retry cascade를 이끄는 실패 trigger를 제거한다. cascade 소진은 baseline(high)에서 실행당 평균 1.55회 ladder 소진에서 compaction 포함 arm 전원으로 0.00회로 떨어진다. 조건부 실패 gap은 compact 단독에서 +0.24/+0.88/+1.48pp로, all에서 -0.29/-0.56/+0.17pp로 수축한다. low/mid hazard에서는 실패 뒤의 작업이 검증 OK 뒤의 작업보다 성공할 확률이 높다는 뜻, repair effect이다. compaction은 루프의 실패를 독립 표본으로 돌려놓는 것이다.
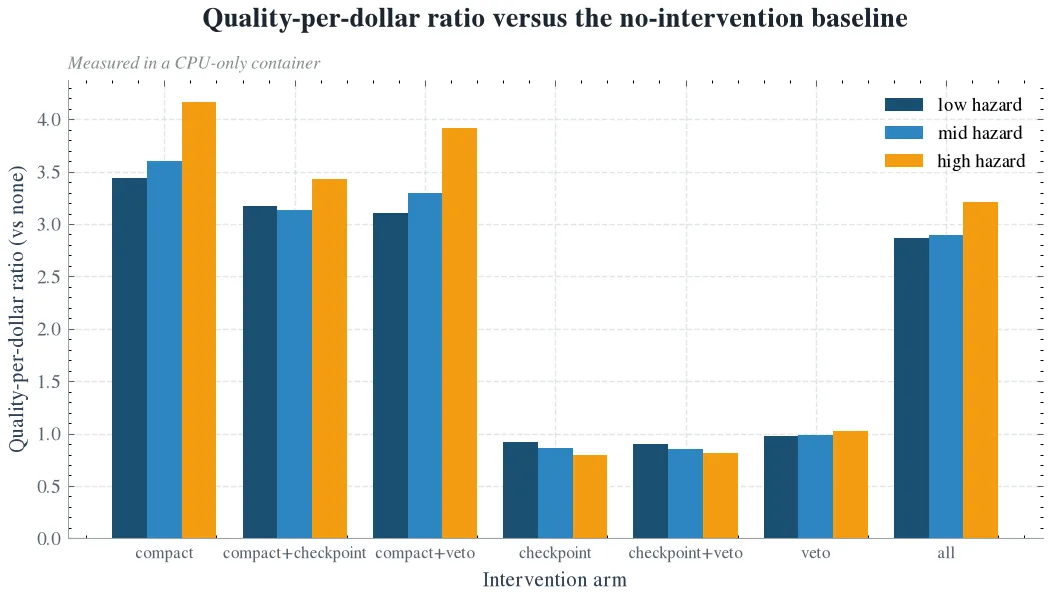 no-intervention baseline 대비 quality-per-dollar(QPD) 비율. compaction을 포함하는 모든 arm이 모든 hazard level에서 baseline보다 2.9~4.2배 효율적이고 checkpoint 단독과 checkpoint+veto는 parity 이하, checkpoint+compaction 두 arm(2.9~3.4배)은 parity 위지만 같은 level의 compaction counterpart보다 낮습니다. 제어 72시간 측정(이산사건 시뮬레이터, declared hazard grid)의 결과이며 프로덕션 telemetry가 아닙니다. (CPU-only container에서 측정)
두 번째는 high hazard에서의 분리입니다. compaction 단독은 거기서 거의 endurance를 사지 못합니다(+0.27시간). 벽이 더 이상 bloat가 아닙니다. residual mix(misroute 33.0%, starvation 28.1%, no-op 23.9%)가 wall이고 compaction은 그것을 건드리지 못하기 때문입니다. 비용 parity에서 scaling하는 arm은 veto입니다. endurance gain이 hazard와 함께 증가하면서 QPD를 parity에 유지하는 유일한 단일 개입(+8.7 → +12.6 → +13.5시간; QPD 0.98~1.02배). checkpoint의 gain도 hazard와 함께 증가합니다(+3.5 → +6.5 → +8.1시간)만 parity 아래(QPD 0.92~0.80배)이고 모든 level에서 veto보다 작습니다. veto의 hazard scaling은 증폭 채널을 끊어서 오지 않습니다. veto 아래 조건부 실패 gap은 실제로 넓어집니다(+14.22 → +15.31pp). cascade 소진도 늘어납니다(1.55 → 1.67/실행). 오가는 것이 고정된 intercept당 저렴한 비용(500 토큰)입니다. hazard가 오르면 더 많은 결과가 신뢰도 임계값 아래로 떨어져 downstream 작업을 오염시키기 전에 veto되고 총 endurance gain은 자라면서 intercept당 비용이 QPD를 parity에 붙잡습니다. 최고 단일 페어링 compact+veto는 high hazard에서 +35.5시간을 QPD 3.91배, 무결성 비용 거의 0(A/V gap +0.31pp)에 줍니다.
세 번째는 checkpoint의 가격입니다. checkpoint-and-restart는 가장 비싼 endurance 구매이고 검증 무결성을 깎습니다. checkpoint는 endurance를 더해 줍니다(+3.5/+6.5/+8.1시간)만 QPD를 baseline의 0.92/0.86/0.80배로 내려놓습니다. 재시작이 회당 3,000 토큰이고 snapshot에서 컨텍스트를 다시 불리기 때문에 터미널 mix는 해결되지 않고 bloat(65.3%, high)로 다시 집중됩니다. 더 날카로운 발견은 무결성입니다. apparent/verified gap은 baseline의 0.7~2.9pp에서 checkpoint 아래 9.0/15.1/21.9pp로 이동합니다. 재시작된 루프는 독립 검증을 통과하지 못한 작업을 더 많이 ‘완료’합니다. snapshot 재실행이 잔여 에러를 완료된 일로 감추는 것입니다. checkpoint 없는 모든 arm은 gap을 baseline 수준(2.9pp 이하)에 유지합니다. gap은 endurance의 시그니처가 아니라 checkpoint 메커니즘의 시그니처입니다. 완료율을 읽는 운영자는 checkpoint 단 루프를 실제로보다 9~22pp 더 신뢰할 것처럼 보입니다.
네 번째는 전 스택입니다. all은 high hazard의 endurance를 6.3에서 64.3시간으로 뻗습니다(10.3배). 72시간 성공률은 baseline 0.396 대신 0.953으로 유지합니다. mid hazard에서는 29.1 → 69.9시간. QPD 비율(high에서 3.21배)은 모든 level에서 compact+veto(3.91배)보다 낮다. checkpoint 구성요소가 high hazard에서 +22.5시간을 더 사면서도 스택의 효율을 끌어내리기 때문이다. 즉 compact+veto가 벽의 가장 싼 통과(72시간 성공 0.945, QPD 3.91배, 무결성 비용 0.31pp)이고 all이 가장 깊은 통과(64.3시간 endurance, 72시간 0.953, 무결성 비용 20.5pp)이다.
랭킹은 grid 전체에서 안정하다. compaction은 세 level 모두에서 QPD 최상단 단일 arm이고 compaction 포함 페어링은 모든 level에서 baseline을 이깁니다(최소 3.11배). compaction 없는 두 checkpoint arm은 모든 level에서 parity 이하(최대 0.92배)입니다. veto의 단일 arm endurance gain은 hazard에서 단조 증가하고 endurance 순서 all ≥ compact+veto ≥ checkpoint+veto는 mid/high에서 성립합니다. decay slope 순서도 compaction 포함 arm 전원 아래에서 유지됩니다(high에서 -3.1x10^-6~-3.0x10^-4/시간). 벽은 이동하는 것이 아닙니다. 최대 26배까지 평평해지는 셈입니다.
회사에, 사회에, 과학에 남는 것
회사(ThakiCloud) 쪽으로는, 이미 밤사이 무인 루프(skill evolution, paper pipeline, research lab)를 돌리고 work automation을 파는 입장에서, endurance decay 곡선과 horizon별 실패 세분화가 ‘사람 checkpoint 없이 얼마나 많은 연속 가동을 신뢰할 수 있는가’에 대한 증거 기반 숫자를 줍니다. 그리고 어떤 개입을 먼저 배포할지를 랭킹하는 것입니다. compaction이 먼저, veto escalation이 둘째, checkpoint는 독립 검증이 루프 안에 있는 경우에만. 무인 신뢰성이 희망에서 운영 다이얼로 넘어옵니다.
사회 쪽으로는, 완전한 업무 자동화의 약속은 무인 운영 위에 서 있기 때문. 그런데 시간에서 날까지 연속 에이전트 루프가 언제, 왜 조용히 degradation하는지에 대한 공개 측정은 존재하지 않았습니다. endurance wall과 가장 싼 고칠 것을 정량화하는 것은 엔터프라이즈에 무인 AI를 안전하게 배포하기의 전제인 셈입니다. 실패 cascade가 증폭되어 들어가는 헛된 토큰과 에너지도 함께 줄입니다.
과학 쪽으로는, 지금까지의 에이전트 신뢰성 연구는 짧은 벤치마크에서 작업별 성공률을 측정하는 것입니다. 이 논문은 경과 무인 시간을 1급 실패 축으로 도입합니다. survival curve, horizon별 실패 세분화, 개입 ablation. 측정 대상이 개선과 overfit인 overnight evolution 연구(train/holdout Goodhart shift, scaffold self-tuning)와 반대 동학이고 end-to-end 성공률만 보고 언제 왜 루프가 죽는지 분해하지 않는 long-horizon 에이전트 작업의 한 단계 업그레이드입니다.
아직 못 믿을 부분
한계는 여섯 개. 첫째, hazard grid가 declared이지 fitted가 아닙니다. telemetry fitting이 없습니다. 정확한 level 결과(compact+veto가 high에서 사는 +35.5시간, 거기의 baseline endurance 6.3시간)는 grid가 앵커링될 때까지 ‘high-hazard 밤’의 비용이라 말해도 ‘fleet의 median 밤’의 비용이라 말할 수 없습니다. 랭킹 결과(QPD에서 compaction > veto > checkpoint, checkpoint의 무결성 시그니처, compaction의 증폭 제거)는 monotone hazard schedule에 대한 개입 메커니즘이라 재앵커링을 견뎌야 합니다. 둘째, 단일 동결 작업 스트림과 단일 모델 tier입니다. 스트림 간, tier 간 일반화는 열려 있고 다만 앞선 factorial 작업이 이 클래스의 개입에서 harness 쪽 효과가 tier 효과를 지배한다고 제안합니다. 셋째, 72시간 horizon입니다. high hazard의 벽은 72시간이라기보다 첫 24시간의 속성일 수 있고 72시간 이후의 endurance는 미측정입니다. 넷째, ‘other’ 터미널 클래스(baseline 9.4~19.0%)는 분해되지 않았습니다. 다섯째, 셀당 100 seed입니다. cell mean의 CI는 좁은데(endurance half-width 1.1~5.2시간) grid의 세 수준이 거칩니다. 더 정밀한 hazard ladder가 endurance-gain 곡선을 선명하게 할 것입니다. 여섯째, 시뮬레이터의 검증기는 결정론적이고 기계 검사 가능하지만 검증기에 own 오차율이 있으면 A/V gap 숫자는 움직일 것입니다.
미래 작업은 grid를 nightly telemetry에 앵커링(작업당 hazard 추정), horizon을 72시간 이후로 확장, residual wall의 ablation(starvation 클래스를 향한 capacity-aware scheduling과 retrieval-side 스킬 커버리지), 그리고 live cost feedback이 compact+veto 스택과 함께 작동하는지 테스트입니다. 이 논문의 QPD frontier가 그 regulation의 자연스러운 입력이기 때문입니다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Endurance Wall: Reliability Decay, Failure Taxonomy, and Intervention Ablations in 24/48/72-Hour Unattended LLM Agent Loops
이 글의 두 장은 제어 72시간 측정(이산사건 시뮬레이터, declared hazard grid)의 결과이며 특정 프로덕션 밤의 telemetry가 아닙니다. 정확한 level 수치는 telemetry 앵커링에서 이동합니다. 랭킹 결과는 유지될 것입니다.
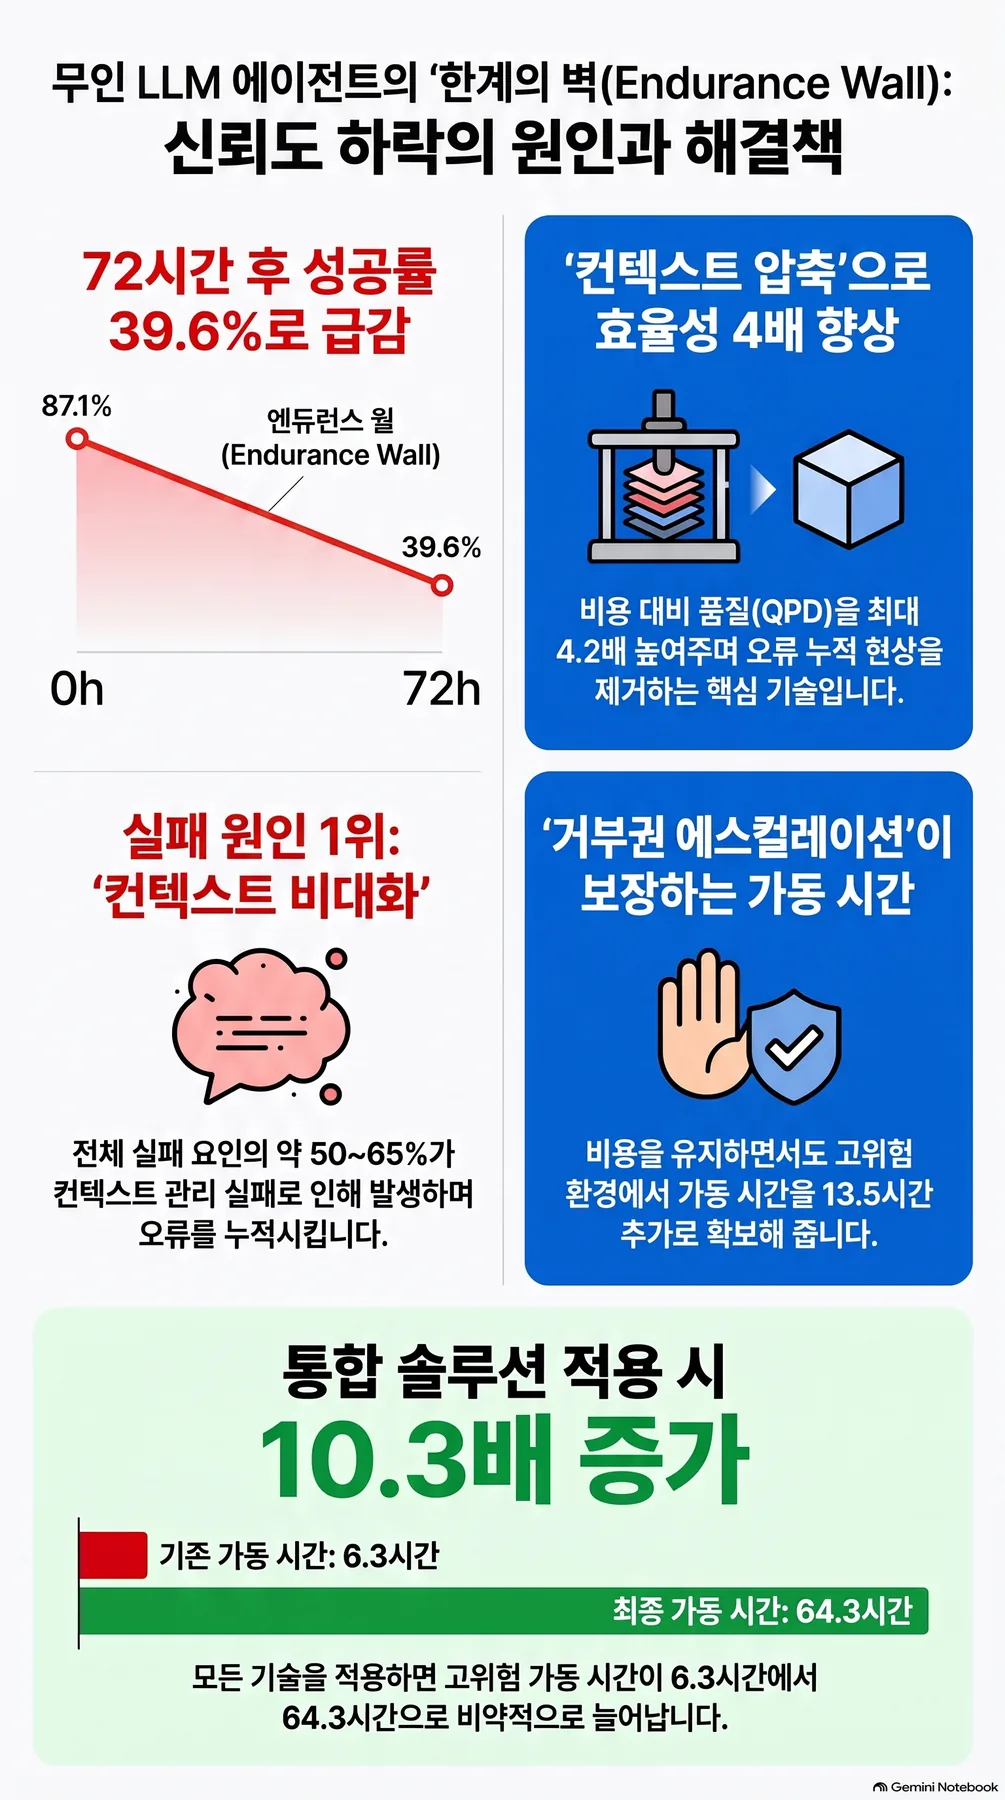 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.