The Draft Skill: 하이브리드 라우터의 LLM-rerank 구간이 스킬을 고르는 동안, lite-confidence 후보를 병행해서 미리 실행하고 수용 frontier를 재는 분석 논문
스킬 2,000개가 넘는 무감시 에이전트 하네스를 셀프호스트 H200에서 돌리거나 그 하네스의 루프에 skill-router를 붙여 둔 국내 클라우드/AI 엔지니어라면 이 글의 대상입니다. 무감시 루프에서는 들어오는 태스크마다 실행 전에 라우팅 결정 하나가 지나갑니다. 어떤 스킬을, 얼마나 빨리. ThakiCloud의 분석 논문 The Draft Skill는 그 결정이 나기까지 걸린 시간을 묻습니다. LLM-rerank 스테이지가 고심하는 동안 lite-confidence가 높은 후보 스킬을 미리 실행하면 고정된 라우팅 정확도에서 end-to-end wall time이 얼마나 줄고 거절된 draft의 wasted compute가 어느 수용률에서 break-even을 넘는지. 이 논문은 분석 논리로 씁니다. 새 측정을 보고하지 않으며 모든 수는 선언된 nominal 가정에 대한 closed-form 예측입니다. 그림 세 장도 같은 분석 모델이 뽑은 값입니다. 읽고 나면 자기 하네스의 여유 worker로 어떤 스킬을 draft하고 어떤 pool 크기는 하지 말아야 하는지에 근거가 생깁니다.
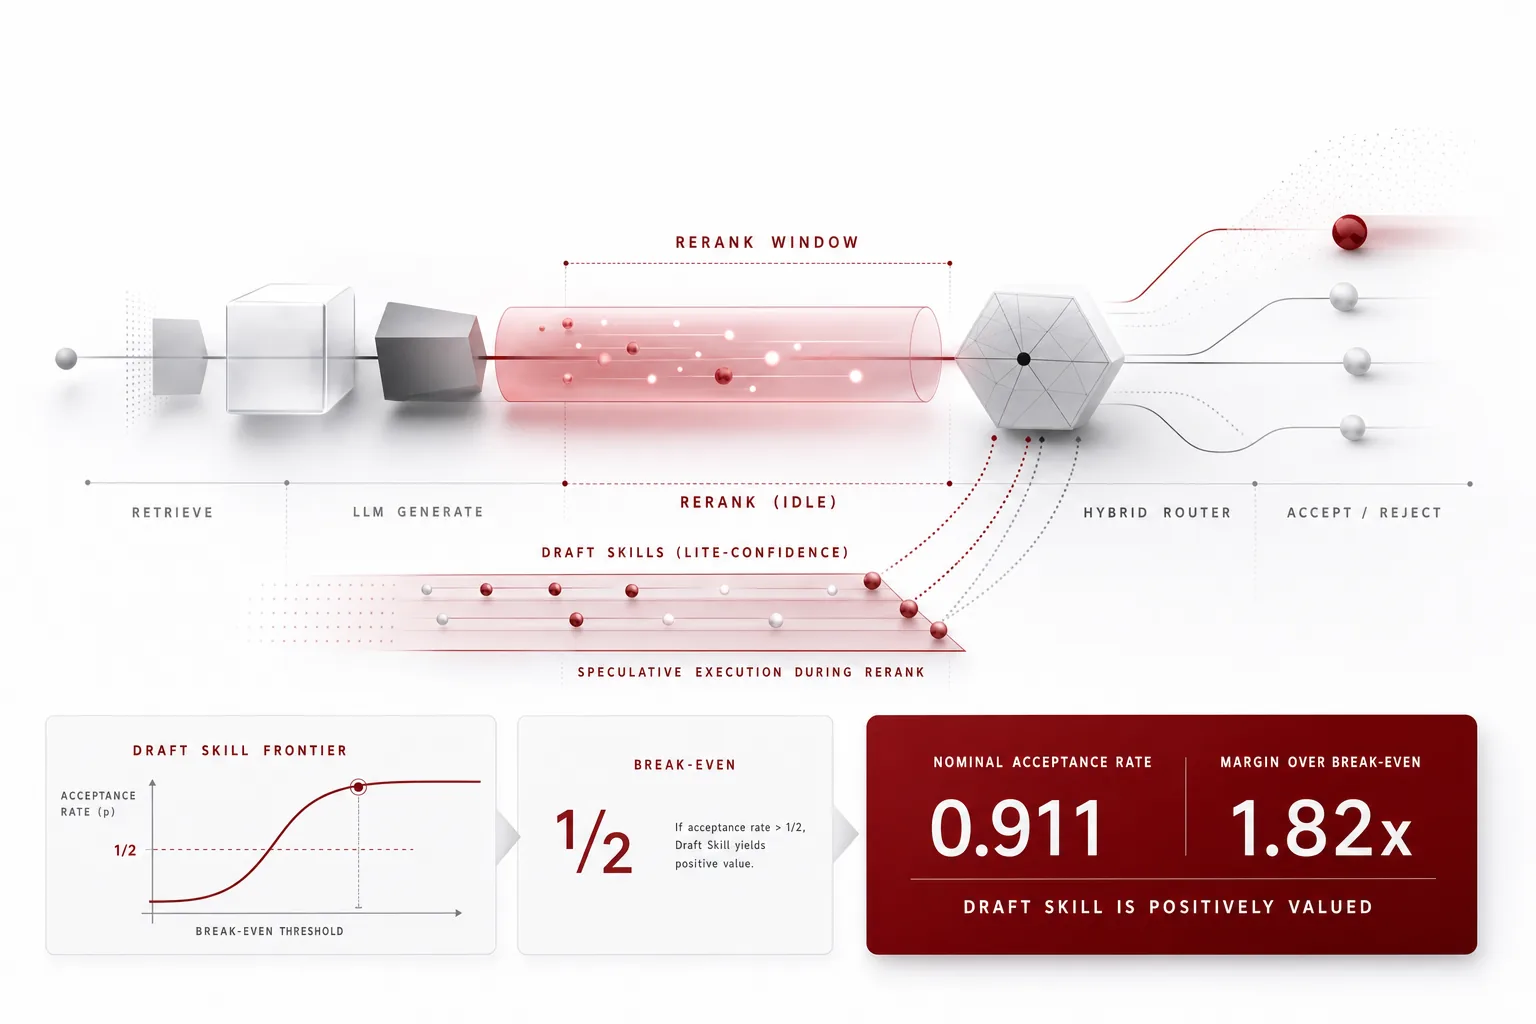 글의 핵심 개념을 형상화했습니다.
문제의식: rerank가 고심하는 동안, 아무 스킬도 실행되지 않습니다
측정 대상은 두 스테이지 하이브리드 스킬 라우터입니다. lite 스테이지는 BM25 인덱스로 후보를 회수하고 top k=8 스킬의 고정 manifest를 context에 주입합니다. 후보별 lite-confidence 점수를 붙인 랭킹 리스트를 시간 T_L에 반환합니다. LLM-rerank 스테이지는 그 주입된 후보를 점수 매겨 최종 스킬을 뽑아냅니다. 시간이 T_R입니다. 선택된 스킬은 그다음에야 worker에서 실행됩니다. 레지스트리는 동결된 2,293-entry이며 셀프호스트 H200 위의 2,200-skill 무감시 에이전트 하네스에 배포되어 있습니다. 라우터의 token bill(full가 결정당 1,440.3 대 lite 409.6)과 8.9pp의 hybrid-over-BM25 top-1 lift는 이전 논문 The Router’s Toll에서 실측된 값이고 이 논문은 선언된 상수로 다시 씁니다.
핵심 관찰은 단순합니다. LLM이 어떤 스킬을 실행할지 고심하는 동안, 아무 스킬도 실행되지 않습니다. rerank 스테이지는 실행 경로상의 유휴 윈도우입니다. 톨 논문은 이 윈도우를 token으로만 가격 매겼고 wall time으로는 매지지 않았습니다. 이 논문은 그 윈도우를 wall time으로 씁니다.
에이전트를 위한 speculative execution에는 이미 한 줄이 있습니다. copy-on-write 샌드박스에서 미래 trajectory 스텝을 out-of-order로 실행하는 계열, 약한 모델이 draft하고 강한 모델이 prefill 한 번으로 검증하는 계열이 그렇습니다. 그러나 그 draft 단위는 ‘미래 스텝’이고 검증자는 두 번째 유료 LLM review입니다. LLM routing 문헌은 어디로 보낼지를 고르지만 실행은 결정이 끝나기를 기다립니다. 결정 중에 미리 실행하는 것은 어느 쪽도 하지 않았습니다. Draft Skill는 직교합니다. 결정 중에 실행합니다. draft 단위는 현재 스킬 실행이고 예측 원천은 production 하이브리드 라우터의 lite 스테이지이며 검증자는 이미 계산 중인 라우터 자신의 최종 결정입니다. 검증이 추가하는 LLM 비용은 결정론 검사 외에는 0입니다.
설계: draft/verify 정책, 손실 없음, 두 개의 regime
정책은 다섯 단계입니다. 먼저 lite 스테이지를 돌려 랭킹 후보와 lite-confidence 점수를 얻습니다. T_L입니다. 다음 LLM-rerank 스테이지를 시작합니다. T_R입니다. 동시에 lite-confidence가 임계 τ를 넘는 각 후보를 여유 worker에서 내림순으로 draft, 즉 pre-execution합니다. T_D가 듭니다. 여유 worker가 다하거나 자격 집합이 소진되면 멈춥니다. rerank가 최종 스킬을 내뿜으면 그 스킬의 draft를 찾습니다. 최종 스킬이 draft한 스킬과 같고 결정론 검증기(schema 유효성, idempotency, read-side-only 효과)가 통과하는 경우에 한해 draft를 수용합니다. 수용되면 draft의 출력을 결과로 쓰고 재실행을 생략합니다. 거절되면 draft를 버리고 최종 스킬을 그대로 실행합니다.
검증기는 결정론적이고 read-side only이므로 거절된 draft는 관찰 가능한 효과를 갖지 않습니다. 최종 스킬은 draft가 없었다고 해도 똑같이 실행됩니다. 여기서 손실 없음(losslessness)이 나옵니다. 수용은 라우터 자신의 최종 결정으로 정의되고 거절은 항상 그 결정을 그대로 실행하는 fallback입니다. 최종 스킬에 대한 분포는 drafting이 있든 없든 동일합니다. 움직이는 양은 두 개뿐입니다. wall time(hidden draft는 T_E를 절감할 수 있음)과 wasted compute(거절 draft는 worker당 λT_D입니다). 스펙ulation은 결정의 비용을 바꿀 뿐, 결과를 바꾸지 않습니다.
안전 경계도 설계에 들어 있습니다. write-side(부수 효과 있는) 스킬은 drafting에서 제외됩니다. idempotent한 read-side 스킬만 draft할 수 있고 결정론 검증기는 수용을 세기 전의 모든 draft에 실행됩니다.
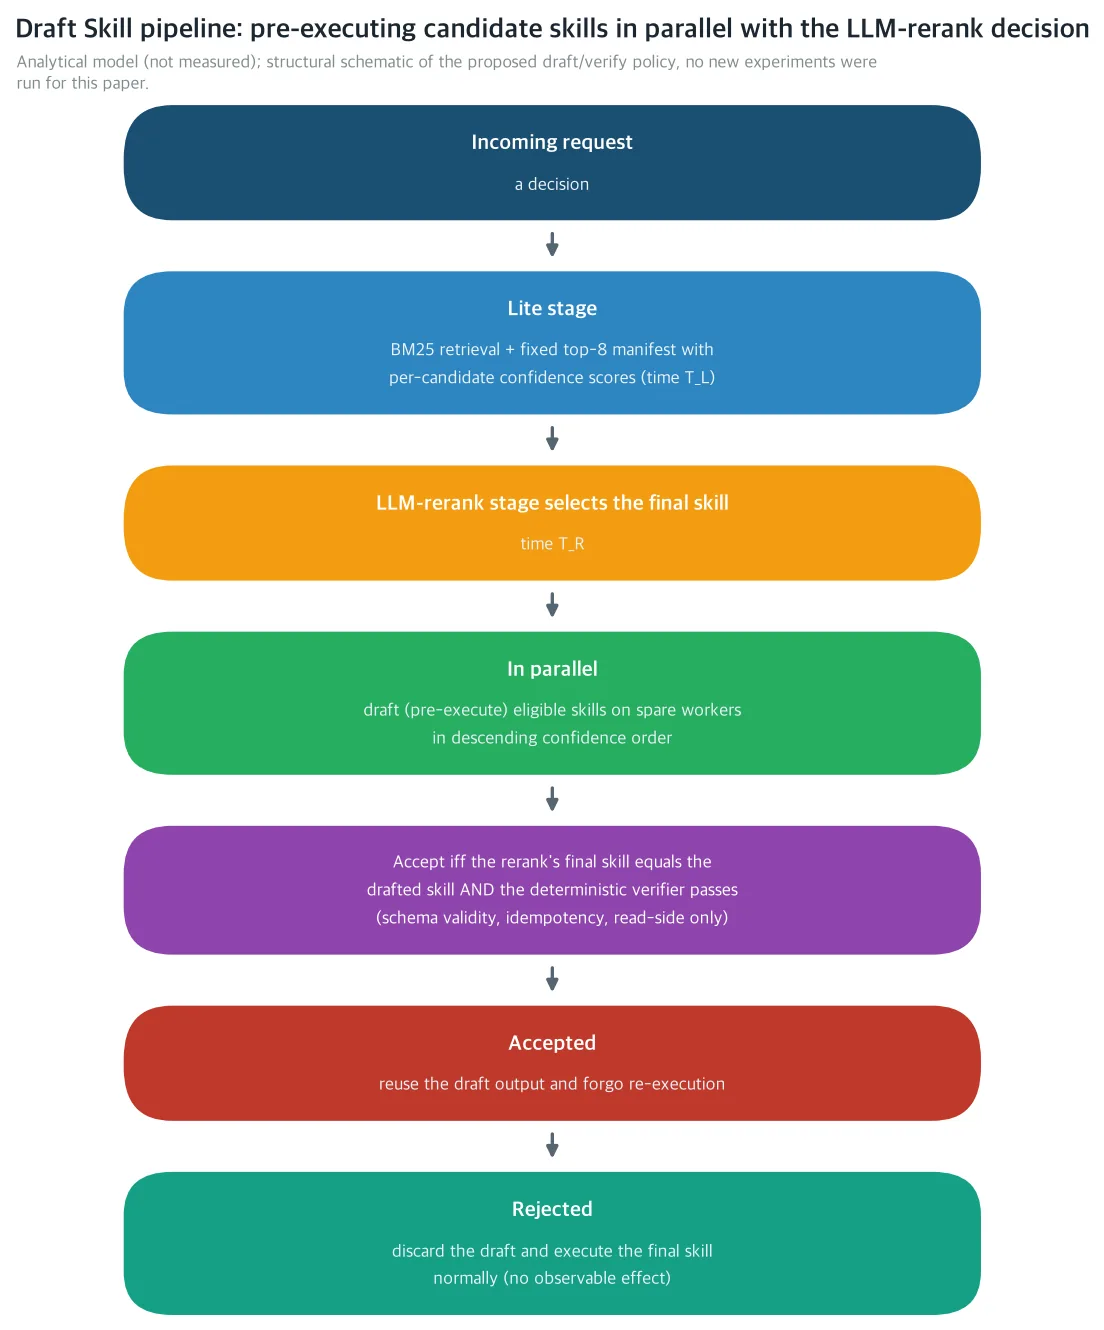 rerank 스테이지가 최종 스킬을 계산하는 동안, 여유 worker가 lite-confidence 후보를 draft하고 라우터 자신의 결정과 결정론 검증기가 각 draft를 수용하거나 폐기합니다. 이 그림은 분석 모델의 형상이며 실측이 아닙니다.
결정마다 두 regime이 있습니다. draft가 rerank 윈도우 안에 드는지입니다. draft hidden(T_D ≤ T_R)이면 draft는 lite 스테이지 끝에서 시작해 rerank 결정보다 늦지 않게 끝납니다. 수용 시 실행 전체가 윈도우에 흡수되어 절감이 T_E 전부이고 거절 시 절감은 0이며 draft는 순수 폐기 컴퓨트입니다. 어느 쪽이든 rerank wall time은 변하지 않습니다. draft exposed(T_D > T_R)면 rerank 결정이 draft 완료 전에 납니다. T_D = T_E에서는 실행의 꼬리가 더 이상 숨기지 못해 절감이 T_R으로 줄어듭니다.
핵심 기여: 네 결과와 행동 단위 Draft Law
네 결과는 클래스 내 drafting, 즉 cost class 안에서 draft가 그 스킬 실행 그 자체(T_D = T_E)인 경우에 대해 성립합니다.
T1, 단일-draft break-even입니다. hidden regime에서 결정당 순경제이득은 B = λ(pT_E − (1−p)T_D)이며 스펙ulation이 순양(+)인 것은 p ≥ p* := T_D/(T_D+T_E)일 때뿐입니다. T_D = T_E이면 p* = 1/2이고 cost class, rerank 지연, 임계 어느 것에 대해서도 무관합니다. 토큰 단위 스펙ulation은 토큰당 draft 비용비가 1보다 훨씬 작아 기준이 낮습니다. 행동 단위 draft는 실행 전체를 내므로 기준이 얇은 overhead가 아니라 반입니다.
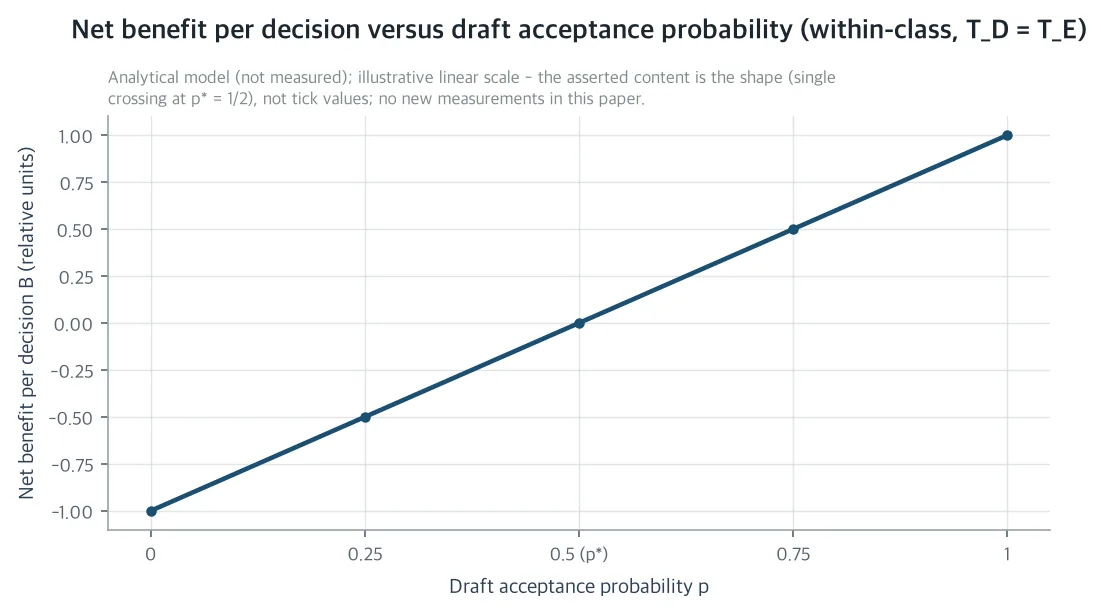 클래스 내 순이득은 수용률에 대해 선형이고 break-even p에서 유일한 제로 교차를 갖습니다. 그래서 confidence 임계는 이득의 크기를 조절할 뿐 부호를 뒤집지 못합니다. 분석 모델의 형상이며 실측이 아닙니다.*
T2, hidden-regime 불변성입니다. T_D ≤ T_R이면 (a) E[wall] = T_L + T_R + (1−p)T_E ≤ T_L + T_R + T_E로 스펙ulation은 wall time을 결코 나쁘게 하지 못하고 (b) 기대 절감 pT_E는 모든 T_R ≥ T_D에서 같고 p는 T_R에 의존하지 않으며 (c) 클래스 내 drafting에서 폐기-절감비는 (1−p)/p로 class, T_R, τ에 무관합니다. exposed regime에서는 절감이 p(T_E + T_R − T_D)이고, T_D = T_E이면 pT_R으로 떨어집니다.
T3, 임계 부호-독립성입니다. 선언된 형태(g(τ)는 τ에 대해 감소, p(τ)는 증가, frontier B(τ)는 τ에 대해 unimodal)에서 eligible τ에서 모두 p(τ) ≥ p*이면 B(τ)는 모든 τ에서 음이 아닙니다. 임계 게이트의 일은 이득의 크기, 즉 coverage를 조절하는 것이지 부호를 뒤집는 것이 아닙니다. 클래스 내에서는 B(τ) = λg(τ)T_E(2p(τ)−1)이고 p(τ) ≥ 1/2인 모든 τ에서 비음(+)입니다.
T4는 m-pool greedy 규칙입니다. m개 후보 pool(m개의 병렬 worker, 각 draft 비용 T_D)의 순이득은 B_m = p_mT_E − (m−p_m)T_D이며 순양(+)인 것은 p_m ≥ mT_D/(T_E+T_D)일 때뿐입니다. marginal한 m번째 draft가 돈을 벌려면 p_m − p_{m−1} ≥ T_D/(T_E+T_D)가 필요합니다. T_D = T_E이면 pool break-even은 m/2이고 커버리지가 완벽하지 않으면 m=1에서만 도달할 수 있습니다. 단일 top-1 draft가 더 큰 pool 전체를 엄격 지배한다는 뜻입니다. 2-draft pool이 돈을 벌려면 T_E/T_D ≥ (2−p_2)/p_2, 3-draft pool이면 T_E/T_D ≥ (3−p_3)/p_3이 필요합니다. 다중 draft 스펙ulation은 결국 class-skew 수단입니다. 싼 것을 draft하고 비싸게 결정하는 것.
행동 단위 Draft Law는 네 결과를 붙이는 법칙입니다. 수용은 p = 1 − (1−q)·r로 분해됩니다. q는 lite 스테이지 top-1 정확도, r은 lite 놓치미에 조건부인 검증기 repair 확률, 즉 rerank 스테이지가 그 놓침을 고치는 확률입니다. 토큰 단위 법칙과 형태가 정확히 대응합니다. 다만 draft 단위가 실행 전체이고 검증자가 라우터의 이미 계산된 결정이므로, 기준은 1/2이며 검증 비용은 0입니다. marginal 검증 비용이 0인 것이, 행동 단위 스펙ulation을 애초에 감당 가능하게 하는 지점입니다.
선언된 nominal의 frontier: 수용 margin 1.82x, speedup 1.09~1.82x
rate card는 다음과 같습니다. T_L = 0.05 s, T_R = 2.0 s(sweep {1, 2, 4, 8}), cost class cheap/medium/expensive의 T_D = T_E = 0.3/2.0/20.0 s, lite top-1 정확도 q_L = 0.80, hybrid top-1 0.889, 인용 8.9pp lift, 검증기 repair 확률 r = 0.445, top-1 수용 p̄ = 1 − (1−q_L)·r = 0.911, pool agreement coverage p_2 = 0.960, p_3 = 0.985, 폐기-절감 오즈 0.0977입니다. 전부 가정이지 측정이 아닙니다.
top-1 draft frontier를 cost class별로 보면 cheap(0.3 s, hidden)에서 절감 0.2733 s, 폐기 0.0267 s, 순이득 0.2466 λ-s, wall 2.35 s에서 2.0767 s로 speedup 1.132x입니다. medium(2.0 s, hidden 경계)은 절감 1.822 s, 폐기 0.178 s, 순이득 1.644 λ-s, wall 4.05 s에서 2.228 s로 speedup 1.818x를 냅니다. expensive(20.0 s, exposed)는 절감 1.822 s, 폐기 0.178 s, 순이득 1.644 λ-s, wall 22.05 s에서 20.228 s로 speedup 1.090x입니다. medium과 expensive의 순이득 동치는 nominal의 우연이지 정리가 아닙니다. exposed 절감이 pT_R이고 그것이 hidden 클래스 내 절감 pT_E = 0.911 × 2.0 s와 같은 것은 경계 클래스 시간이 선언된 T_R = 2.0 s와 겹치기 때문이며 다른 T_R에서는 두 행이 갈립니다.
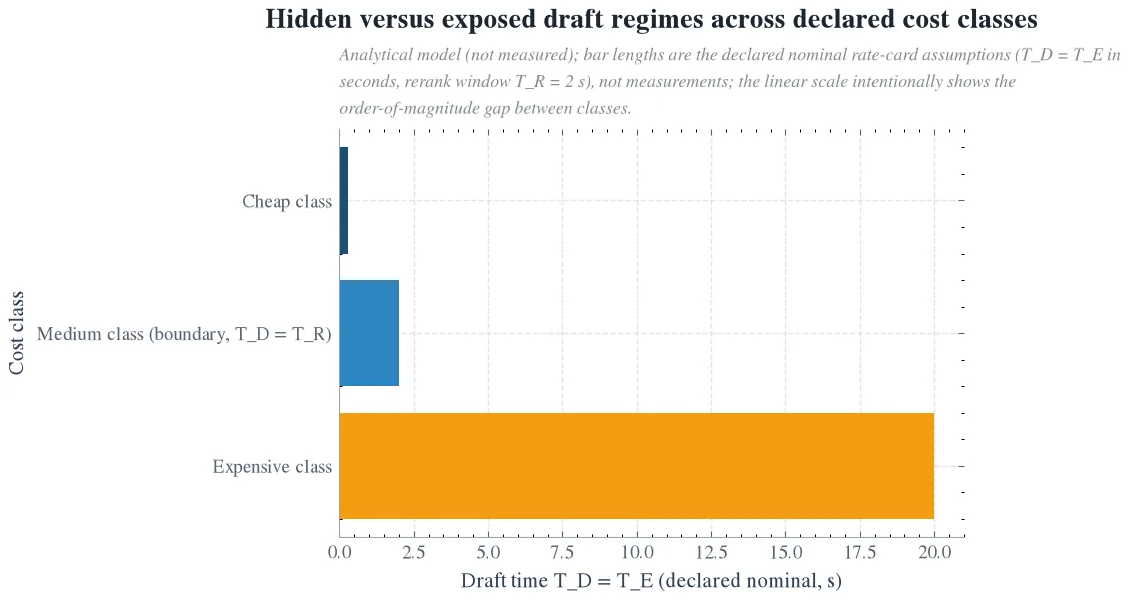 실행 시간이 rerank 윈도우 안에 드는 draft는 hidden으로 실행 전부를 절감하고 expensive class만 exposed로 절감이 윈도우에 상한을 받습니다. 선언된 nominal의 closed-form이며 실측이 아닙니다.
rerank 지연 축을 보면 hidden frontier는 T_R에 대해 평탄하다. 절감 pT_E, 폐기 (1−p)T_D, 순이득 B 어느 항에도 T_R이 없다. cheap 행은 sweep한 모든 T_R에서, medium 행은 모든 T_R ≥ 2.0 s에서 그대로 유지된다. speedup 비율은 base wall이 커질수록 희석되지만 절감되는 초는 움직이지 않는다. exposed인 expensive class의 절감은 pT_R이고 sweep 끝점 T_R = 1 s에서는 순이득 0.822 λ-s로 T_R = 2 s 값의 정확히 절반이다. 스펙ulation의 가치는 rerank 윈도우가 draft에 비해 긴 곳에 집중된다. 톨 게이트가 고르는 윈도우가 정확히 그것이다.
임계 축에서는 nominal 수용 0.911이 1/2 기준을 0.411 넘고 p(τ)가 τ에 대해 증가하므로 선언된 형태가 유지되는 한 B(τ)의 부호는 모든 τ에서 양(+)이다. 게이트의 일은 부호가 아니라 규모다. τ를 낮추면 기대 절감과 기대 폐기가 함께 올라가고 g(τ)p(τ)의 선언된 unimodal 형태가 규모의 최대 지점을 고정한다.
class-skew margin을 붙이면 선언된 coverage p_2 = 0.960에서 2-draft pool은 T_E/T_D ≥ 1.083, 즉 온건한 skew에서 돈을 벌고 p_3 = 0.985에서 3-draft pool은 T_E/T_D ≥ 2.046, 즉 강한 skew에서 벌린다. 클래스 내 drafting(비 1)은 둘 다 못 넘긴다. 그래서 pool 행은 m=1을 지나면 음(−)이고, T_D = T_E에서 순양(+)인 pool은 단일 top-1 draft뿐이다. medium class(T_D = T_E = 2.0 s)의 pool frontier는 다음과 같다. m=1이면 p_1 = 0.911, pool break-even 0.5, B_1 = +1.644 λ-s이다. m=2는 p_2 = 0.960이 pool break-even 1.0 아래, marginal Δp_2 = 0.049가 0.5를 못 넘겨 B_2 = −0.160 λ-s가 된다. m=3은 p_3 = 0.985가 1.5 아래, Δp_3 = 0.025가 0.5 아래, B_3 = −2.060 λ-s로 가장 크다.
사전 등록 실측 프로토콜: 216 strata, 반증 기준 R1-R4
논문은 실측 프로토콜을 선언하지만 이 논문 안에서 실행하거나 보고하지는 않는다. two-arm 비교다. off arm은 rerank 스테이지가 유일한 결정 경로이고 on arm은 설계 섹션의 draft/verify다. 두 arm은 동일한 동결 결정 집합, 동일한 2,293-entry 레지스트리, 단일 H200 노드를 공유한다. 그래서 stratum 간 차이가 draft 스테이지에 귀인된다. sweep 축은 네 개다. lite-confidence 스케일의 gate τ ∈ {0, 2, 4, 6, 8, 10}, cost class {cheap, medium, expensive}(T_D = T_E = 0.3, 2.0, 20.0 s), declared model/batch 제어의 rerank 지연 T_R ∈ {1, 2, 4, 8} s, pool 크기 m ∈ {1, 2, 3}이다. 설계가 주는 것은 6 × 3 × 4 × 3 = 216 strata, 432 arm-strata다.
stratum마다 네 메트릭을 보고한다. 관찰된 수용률, 결정당 wall p50/p95, 폐기 worker-초, stratum 추정에서 평가한 순이득 B(hidden regime에서는 p̂T_E − (1−p̂)T_D, 아니면 그 exposed 대수)다. 수용 메트릭은 agreement 기반이다. draft한 스킬이 최종 rerank 스킬과 같고 결정론 검증기가 통과하는 것. 그래서 R1이 nominal p̄ = 0.911을 1/2 기준에 직접 대면시키는 구조입니다. 안전은 앞에서 두었듯 write-side 스킬 제외와 idempotent read-side 한정, 모든 draft에 대한 검증기 선행 실행입니다.
반증 기준은 네 개이며 각자가 어떤 결과를 반증하는지 명합니다. R1: 어느 nominal stratum에서든 cheap class의 관찰 top-1 수용이 0.5 아래이면 선언된 rate card의 agreement 모델(p̄ = 0.911)이 break-even p* = 0.5를 넘는다는 nominal clearance 주장을 반증합니다. 정리는 기준을 세울 뿐 관찰이 검증하는 것은 nominal입니다. R2: hidden regime의 stratum에서 spec-arm wall이 off-arm wall을 넘으면 T2의 wall identity (a)가 그 stratum에 대한 예측으로서 반증됩니다. R3: 관찰 폐기-절감비가 stratum 수용의 95% 이항 CI를 넘어 예측 오즈 (1−p̂)/p̂에서 벗어지면 불변성 (c)가 깨집니다. R4: 고정 τ와 class에서 관찰 수용이 T_R에 의존하면 수용 불변성 (b)가 반증됩니다.
그래서 무엇을 주나: 회사, 사회, 과학
회사에 무감시 에이전트 하네스는 어떤 스킬을 실행하기 전에 LLM-rerank 라우터의 전체 결정 지연을 물어옵니다. 이 논문은 rerank 구간과 병행해 싼 결정론 스킬을 미리 실행하고 라우터 자신의 결정과 결정론 검증기로 수용·폐기하는 스펙ulative pre-execution의 wall-time·wasted-compute frontier를 셀프호스트 H200에서 계산해 2,200-skill 라우팅의 지연을 직접 줄이는 운영 레버를 줍니다. 이전 계열과의 합성은 깔끔합니다. 톨 게이트가 어떤 결정에 검증 윈도우가 주어지는지 고르고 스펙ulation이 그 윈도우를 수익화합니다. 스펙ulation은 정확도에 중립이므로 miss economics는 불변이고 토큰 단위 레버는 T_R 자체를 줄여 합성합니다. hidden 절감은 그 줄어듦에 불변이라 두 레버는 서로 다른 항을 가격 매깁니다.
사회에 토큰이 아니라 행동 단위의 스펙ulative 실행은 라우팅 결정 지연을 무료 병렬 작업으로 바꿉니다. 소형 조직도 항상 켜져 있는 자율 자동화를 더 낮은 컴퓨트·에너지 비용으로 운영할 수 있게 합니다. 수용 판정이 LLM judge가 아니라 결정론 검증기라는 점은 신뢰 가능한 무인 자동화의 비용 장벽을 낮춥니다. 결과가 주는 것은 speedup 숫자가 아니라 더 낮은 진입 비용입니다. 단일 H200으로 24/7 결정 루프를 돌리는 작은 운영자가 그 루프를 감당할 수 있게 되는 것. 스펙ulation 예산은 이미 지불한 윈도우이고 검증 예산은 0이니까요.
과학에 이 논문은 토큰 단위 speculative-decoding 수용 법칙(Draft Law 계열)을 스킬·행동 단위로 끌어올립니다. 검증자가 라우터의 최종 라우팅 결정이고 draft 비용이 스킬 실행 전체인 regime에서 첫 closed-form의 acceptance·wall-time·wasted-compute frontier와 break-even 조건을 세웁니다. 결정 캐싱, 실행 후 루틴 컴파일, 결정 후 병렬화 계열이 채우지 못한 ‘결정 전 실행’ 틈새를 메우는 부분입니다. 구조적 내용은 zero-cost-verifier 속성이고 skill routing 너머로 일반화됩니다. 어떤 서빙 시스템이든 (a) 이미 최종 결정을 계산하고 (b) 시간이 T_R > 0인 스테이지는 검증 윈도우를 갖습니다. draft 단위는 싼 것, 결정론적인 것, 결정 그 자체로 손실 없이 검증되는 것만이면 됩니다. 에이전트 루프의 planner 스테이지는 in-flight tool execution과 겹치고 cache-invalidation 윈도우와 index rebuild도 같은 형태를 가집니다. lookup 대신 T_R을 deliberation에 쓰는 reasoning router는 윈도우를 넓혀 이 속성을 더 귀하게 만듭니다.
한계: 이 논문이 주장하지 않는 것
caveat은 네 개입니다. 첫째, 선언된 nominal(q_L = 0.80, r = 0.445, p̄ = 0.911, coverage 0.911/0.960/0.985)은 배포 전에 보정되어야 합니다. 결과는 그것에 대해 closed form이지만 관찰 수용이 기준 아래로 떨어지는 stratum은 보장을 잃습니다. 둘째, 클래스 내 T_D = T_E는 draft 후보가 최종 스킬과 비용이 다르면 성립하지 않는 가정입니다. T4의 skew 조건이 일부 커버합니다(선언된 coverage에서 2-draft pool은 T_E/T_D ≥ 1.083, 3-draft pool은 2.046 필요). 비 1의 클래스 내 drafting은 m=1을 넘는 모든 pool에서 패합니다. 셋째, 모델은 결정 윈도우 하나를 가격 매깁니다. chained speculation, 즉 draft 중에 draft하는 것은 범위 밖이며 hiding 조건은 윈도우마다 다시 검증받아야 합니다. 넷째, scale입니다. 인용 8.9pp hybrid-over-BM25 lift와 endorsement 모델(rerank가 lite 놓침을 고치지 못하면 두 번째 후보로 회귀하지 않고 잘못된 lite top-1을 지지하는, 이 논문의 선언 가정)은 2,293-entry에서 선언된 상수로 쓰이고, 둘 다 레지스트리 성장과 함께 움직일 수 있습니다.
이 논문은 새 측정을 하나도 포함하지 않습니다. 모든 수는 선언된 nominal 가정에 대한 closed-form 예측이거나 인용된 참고문헌에 속한 결과입니다. R1-R4가 붙은 사전 등록 프로토콜은 선언되어 있고 그 후속 실행이 네 결과에 대한 사전 지정된 테스트가 됩니다. 그 때까지 수용 margin 1.82x와 결정당 speedup 1.09~1.82x는 모델 예측으로 남습니다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있습니다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-25-draft-skill-speculative-execution-frontier

