인덱스는 썩는다: 2,000스킬 라우터의 staleness frontier와 재임베딩 주기
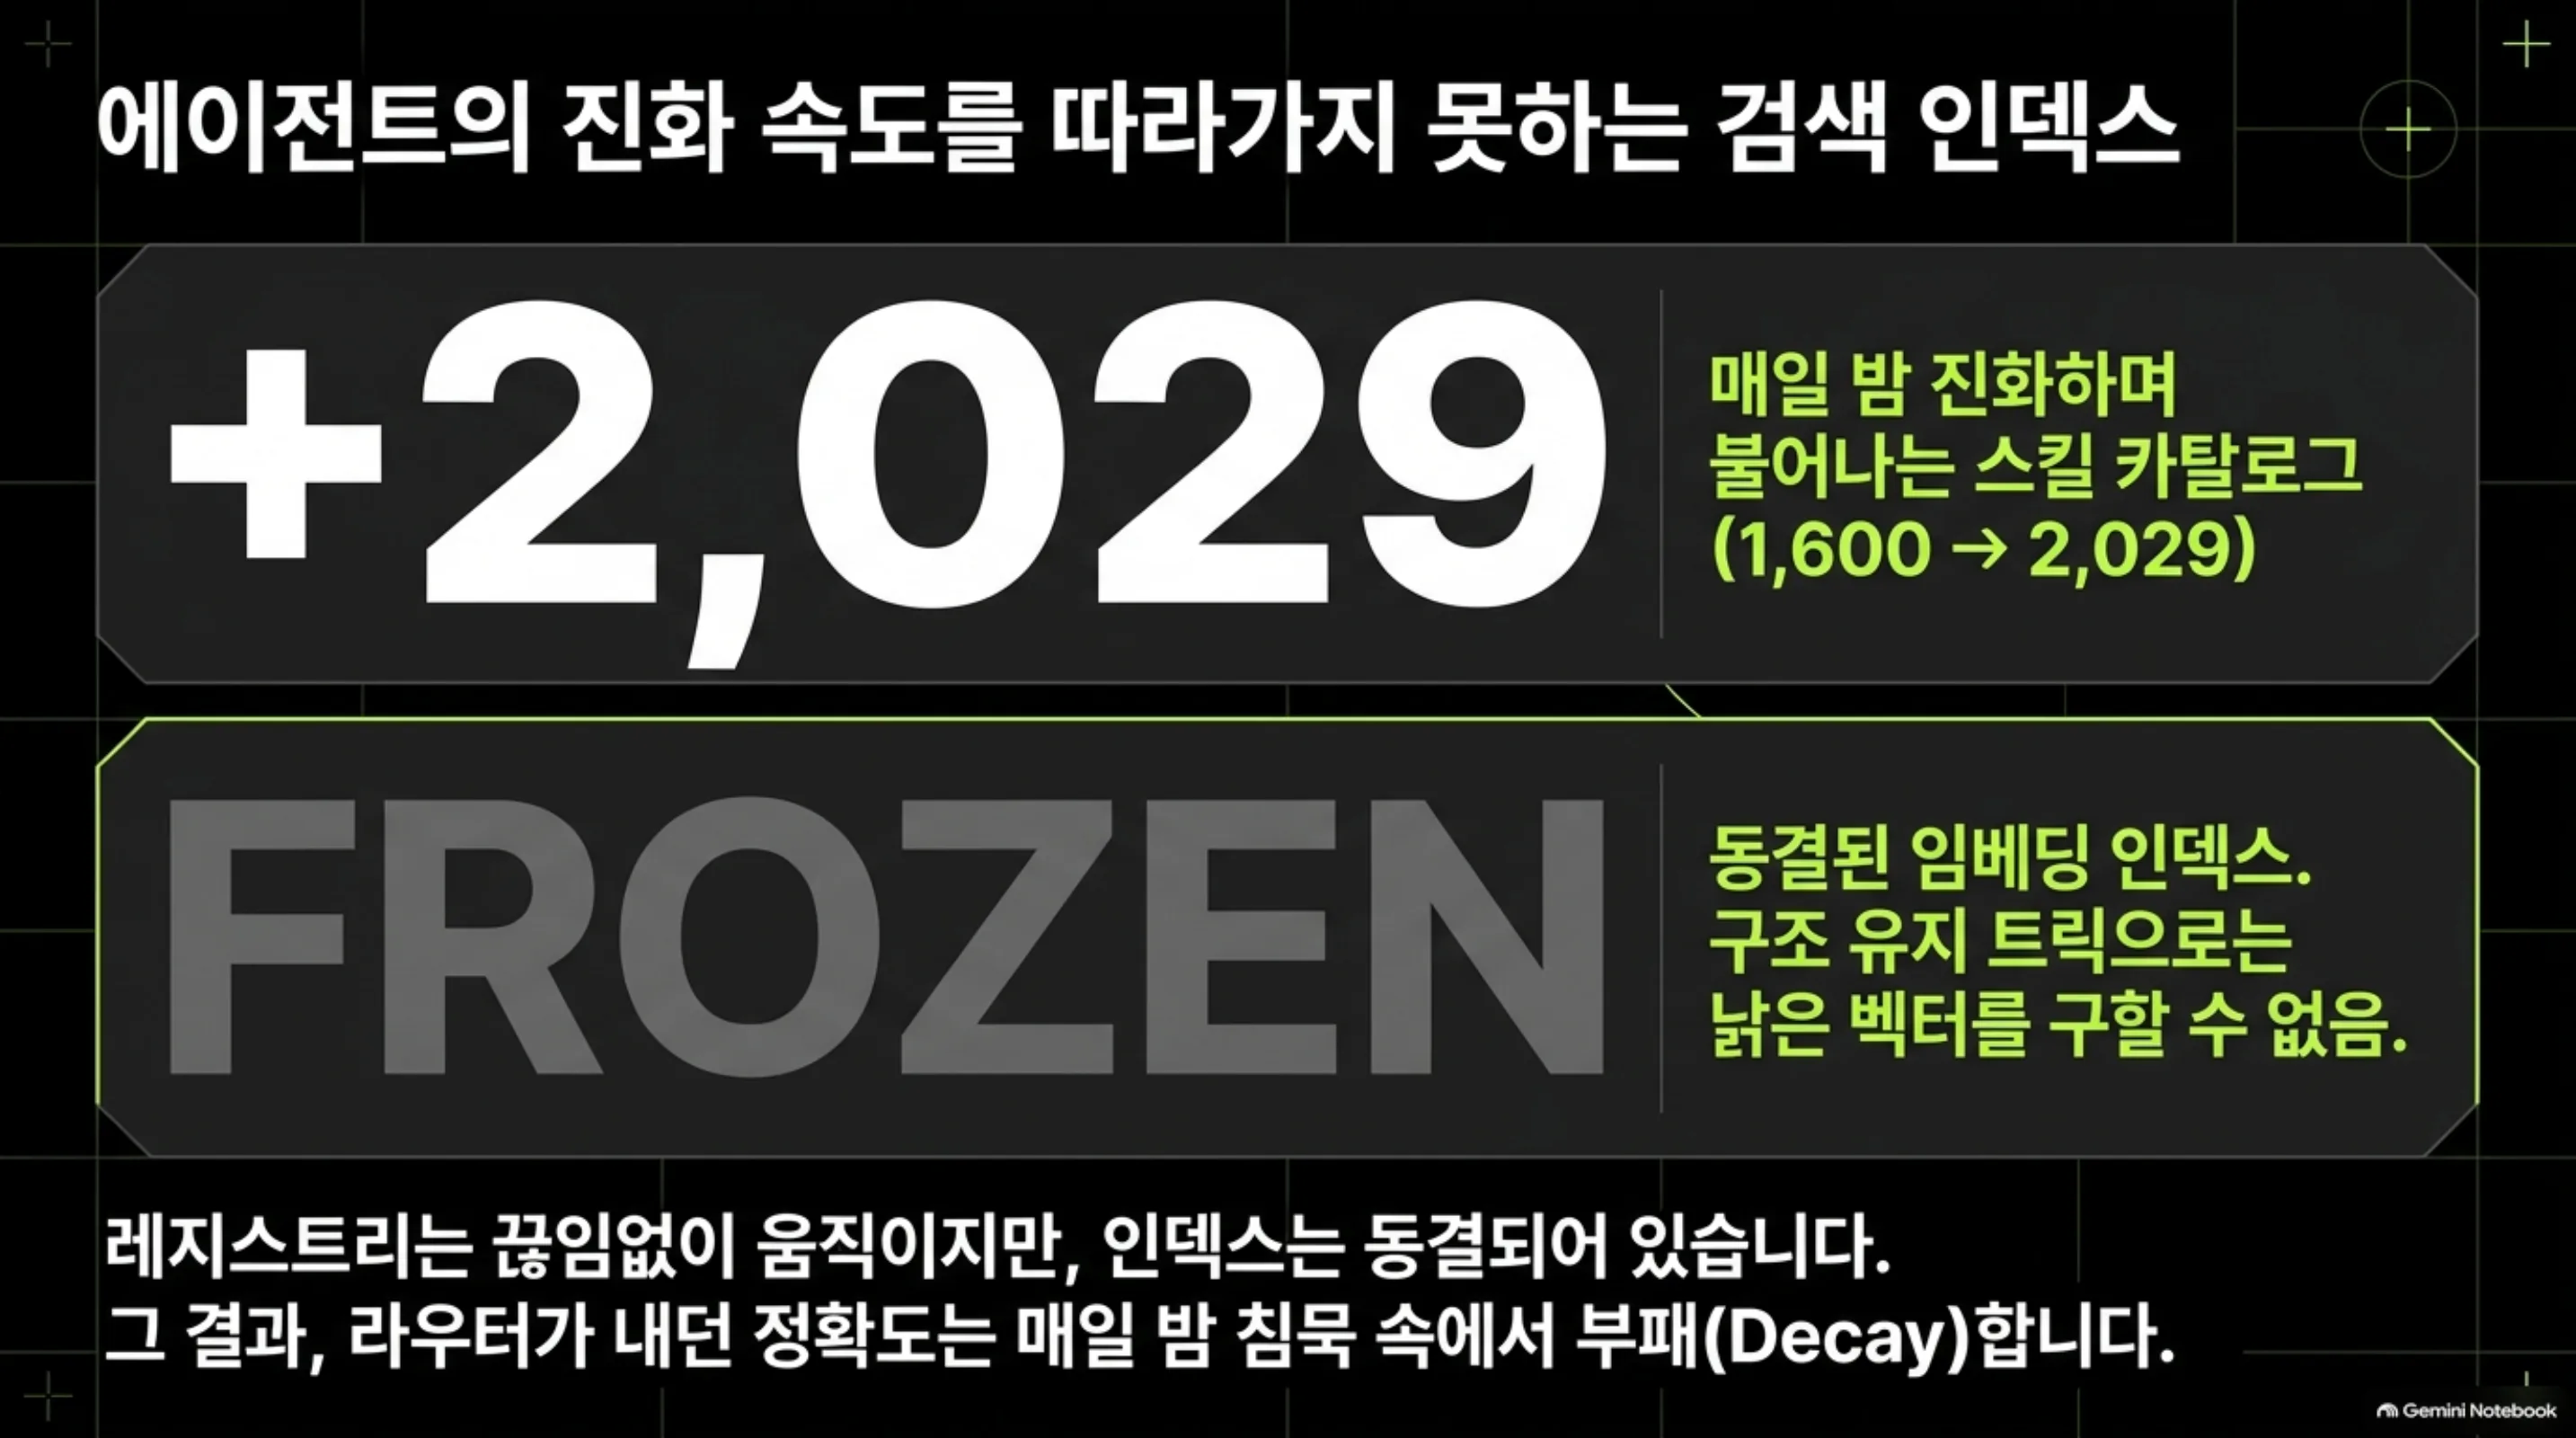
자기 진화하는 에이전트 스킬 플릿을 돌리는 국내 클라우드/AI 엔지니어, 또는 그 플릿의 검색 인덱스 비용을 책임지는 분이라면 이 글을 읽어야 하는 것이다. 스킬 카탈로그는 밤마다 바뀌지만 검색 인덱스는 따라오지 않습니다. 이 인덱스가 내던 라우팅 정확도는 조용히 썩어가는 셈입니다. 이 논문은 동결된 인덱스의 정확도가 얼마나 빨리 썩는지, 그리고 총비용을 최소화하는 재임베딩 주기가 무엇인지 답합니다. 답은 두 개의 공식입니다. 정확도가 어떻게 썩는지를 주는 법칙과 두 비용의 비율로 정해지는 재임베딩 주기.
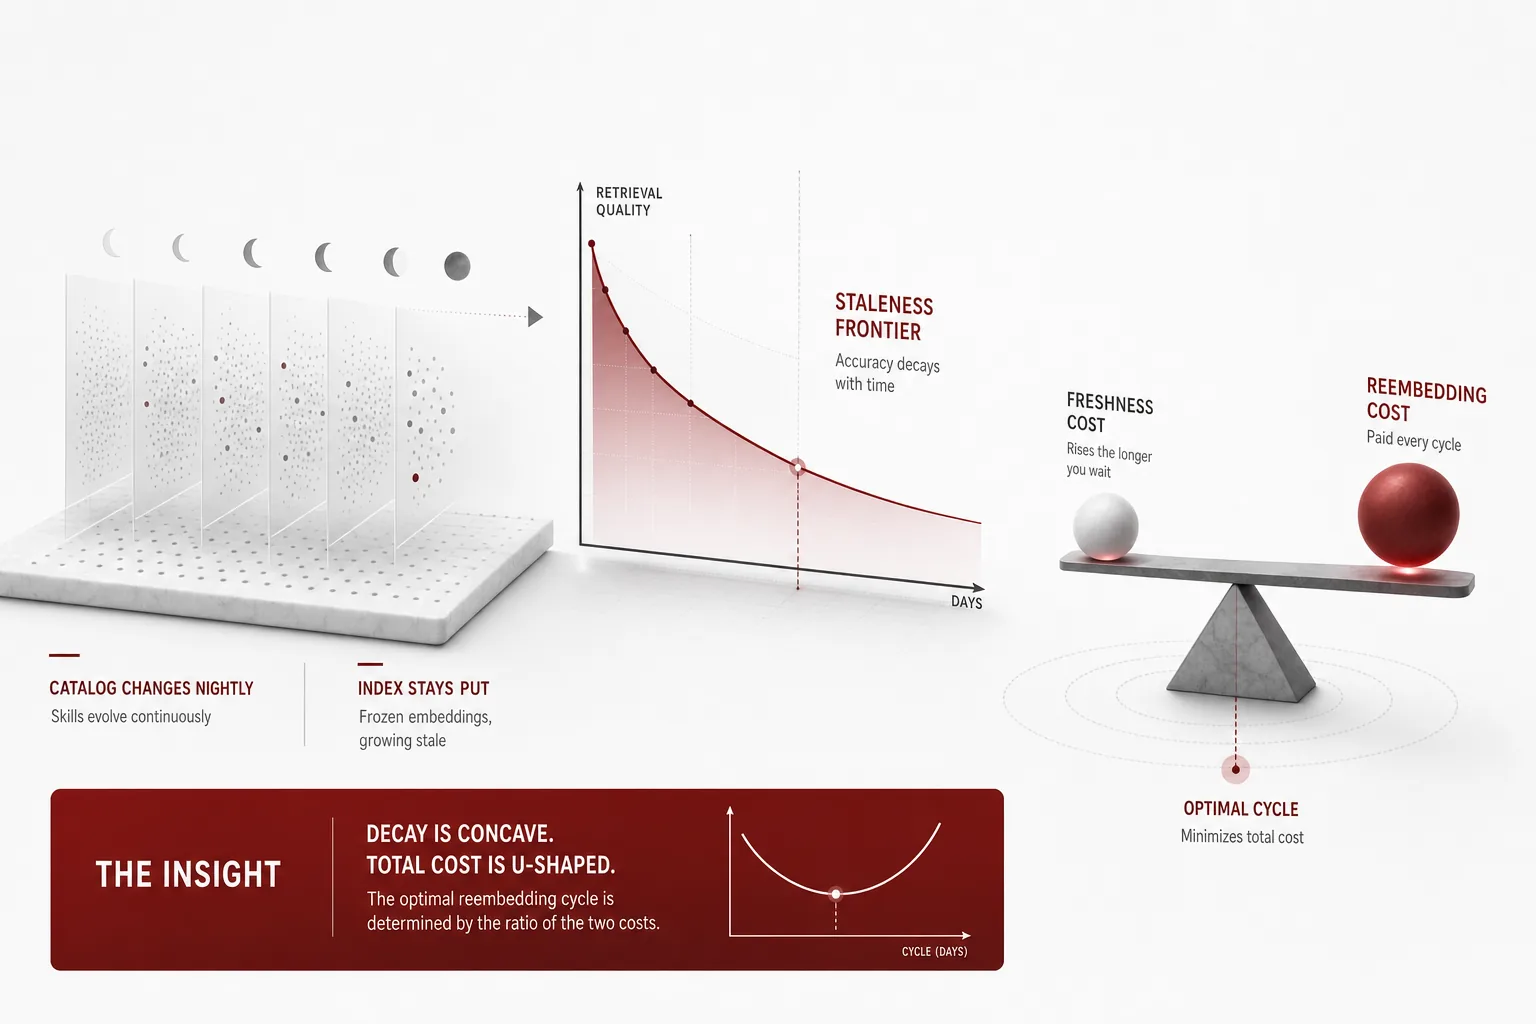 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
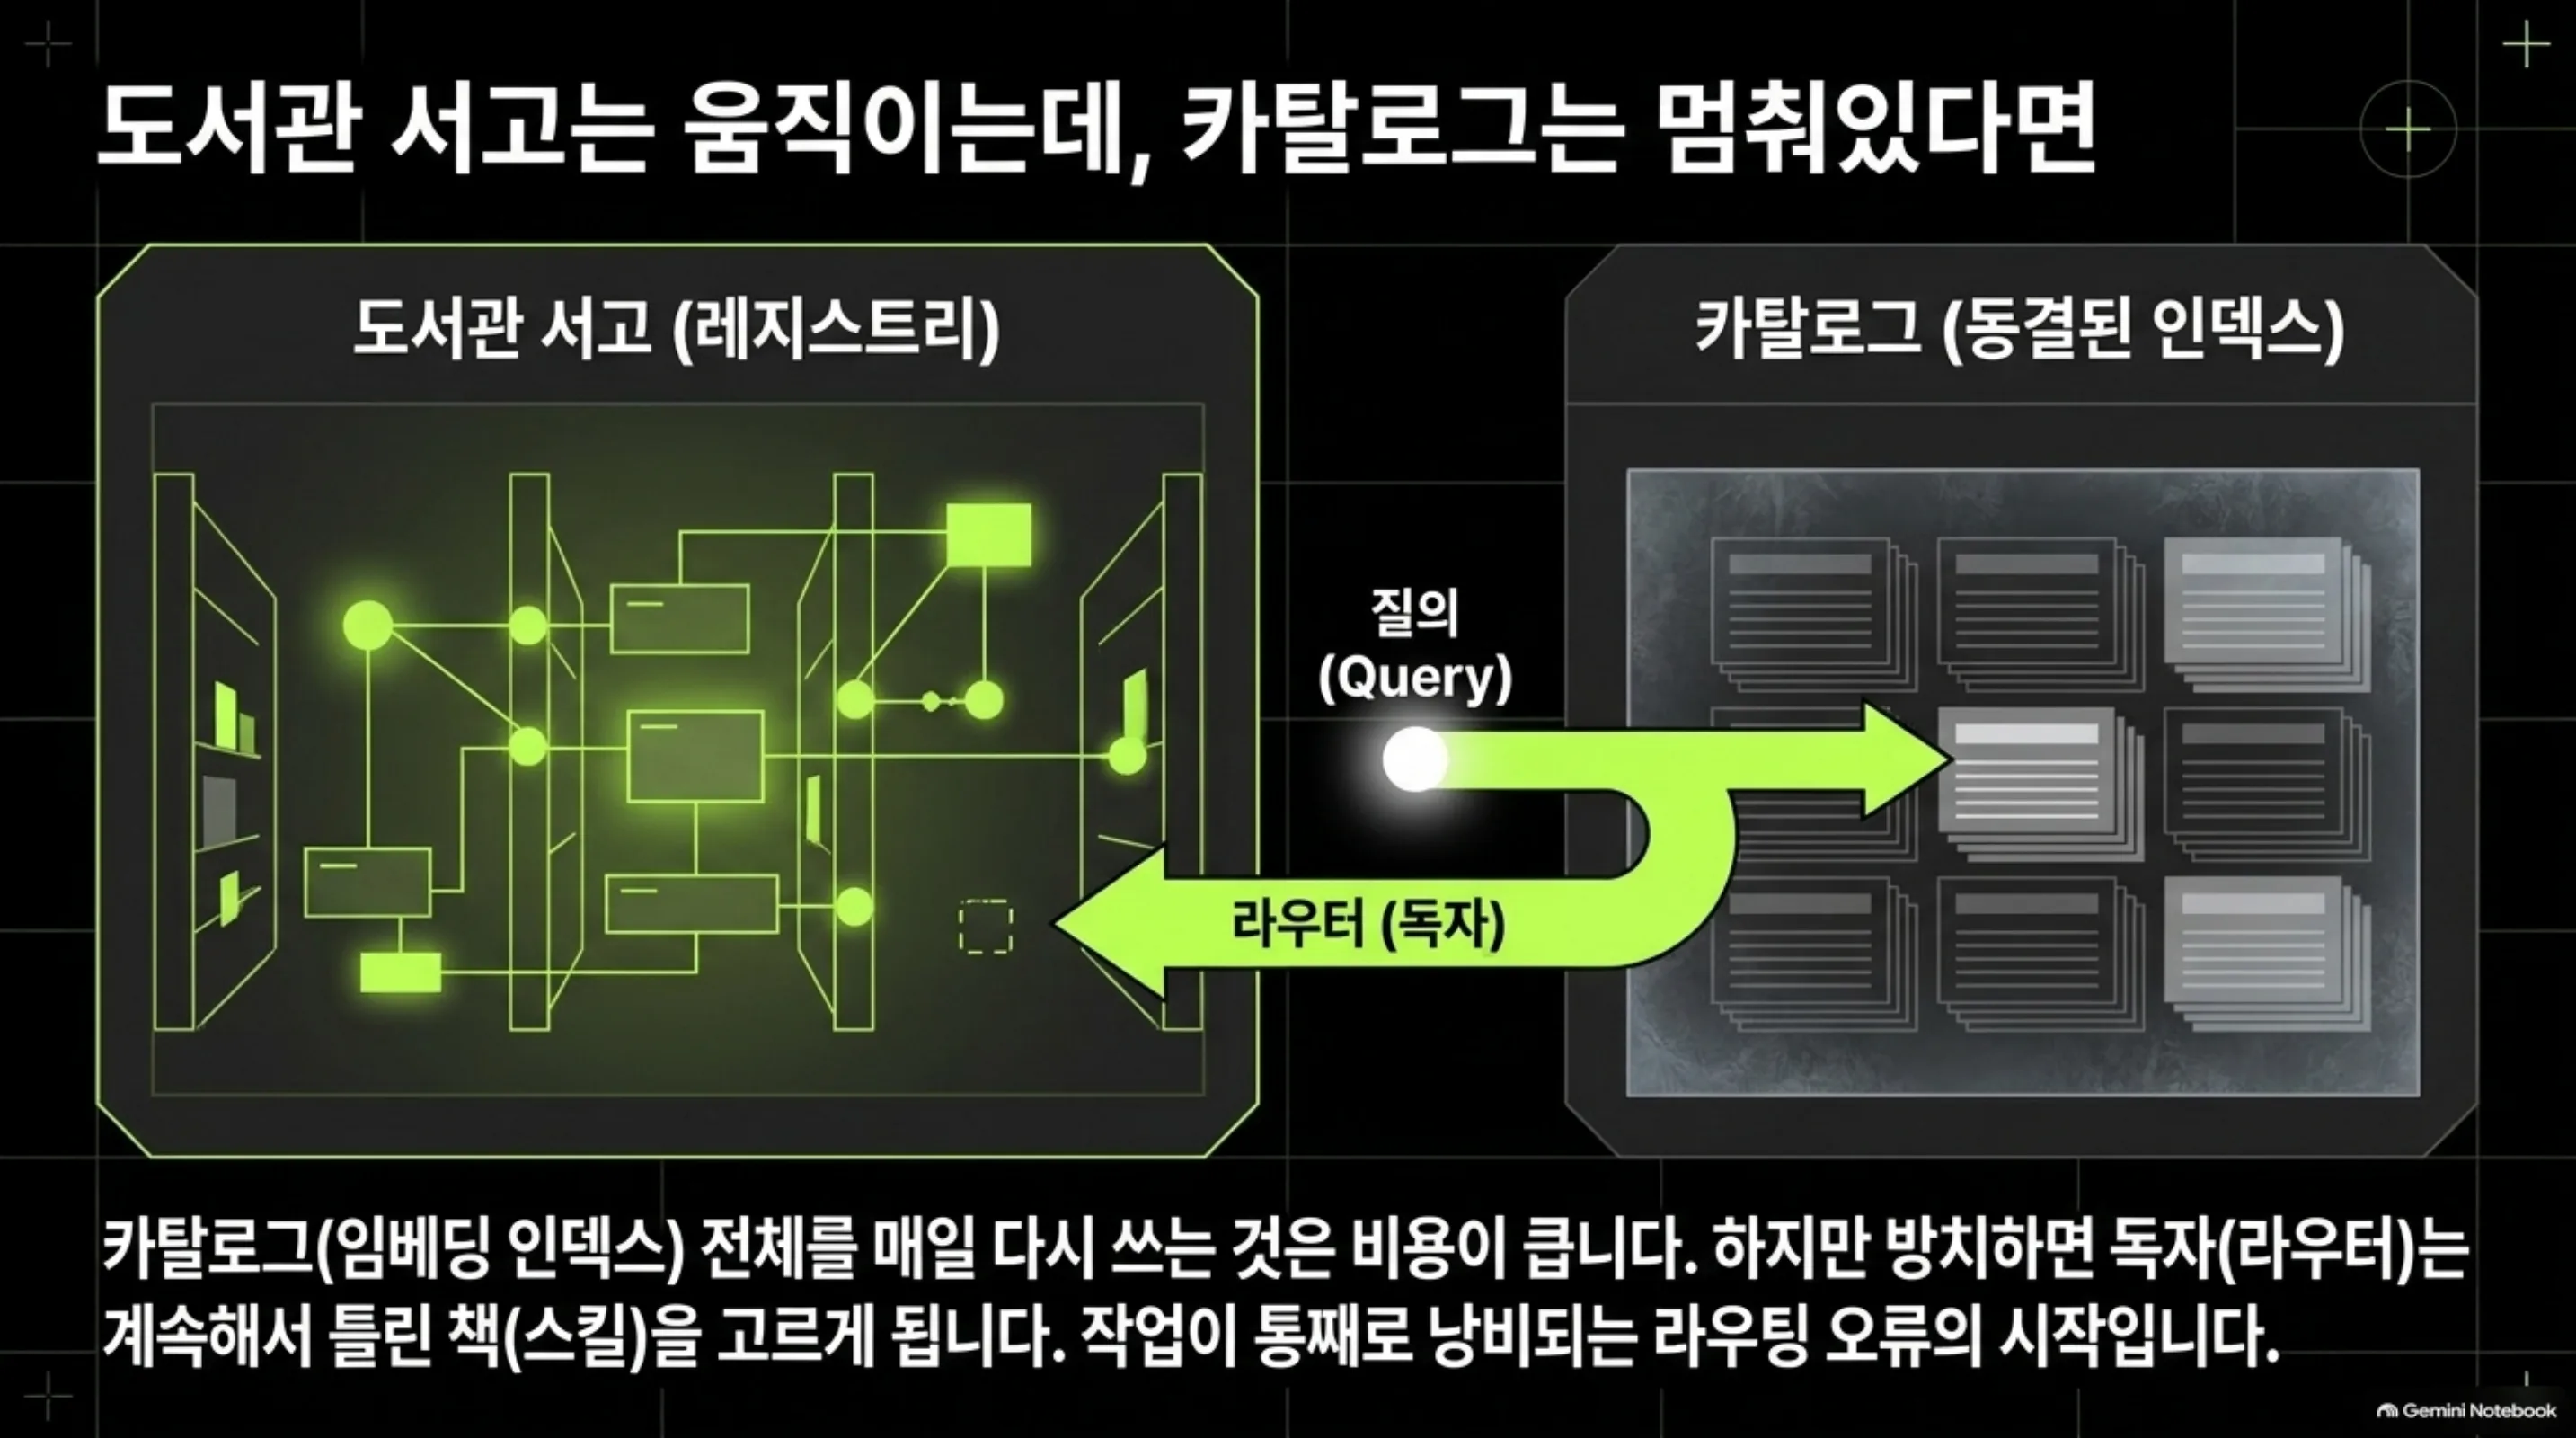
하루마다 새 책을 입고하고 서고를 다시 정리는 도서관을 상상해 보십시오. 사서는 책이 추가되거나 이동할 때마다 카드 카탈로그를 갱신합니다. 그런데 카탈로그 전체를 다시 쓰는 일은 비쌉니다. 책자마다 내용을 다시 읽고 카드에 위치를 다시 써야 하기 때문입니다. 그래서 도서관은 정해진 주기로 카탈로그를 다시 쓰고 그 사이 카탈로그와 서고는 조금씩 어긋납니다. 독자는 카드를 꺼내 카드에 적힌 위치로 갑니다. 책이 옮겼다면 독자는 틀린 책을 손에 듭니다. 질문은 카탈로그를 얼마나 자주 다시 쓰느냐입니다. 매일 쓰면 사서의 일이 쌓이고 쓰지 않으면 독자는 계속 틀린 책을 고릅니다. 이 논문은 그 균형의 가격을 매겨 최적 주기를 유도합니다.
도서관은 2,000개 스킬 레지스트리이고 카드는 검색 인덱스 항목이며 사선은 카드를 다시 쓰는 로컬 임베딩 서버입니다. 독자가 틀린 책을 고르는 것은, 라우터가 틀린 스킬로 요청을 보내 작업이 통째로 낭비되는 것과 같습니다.
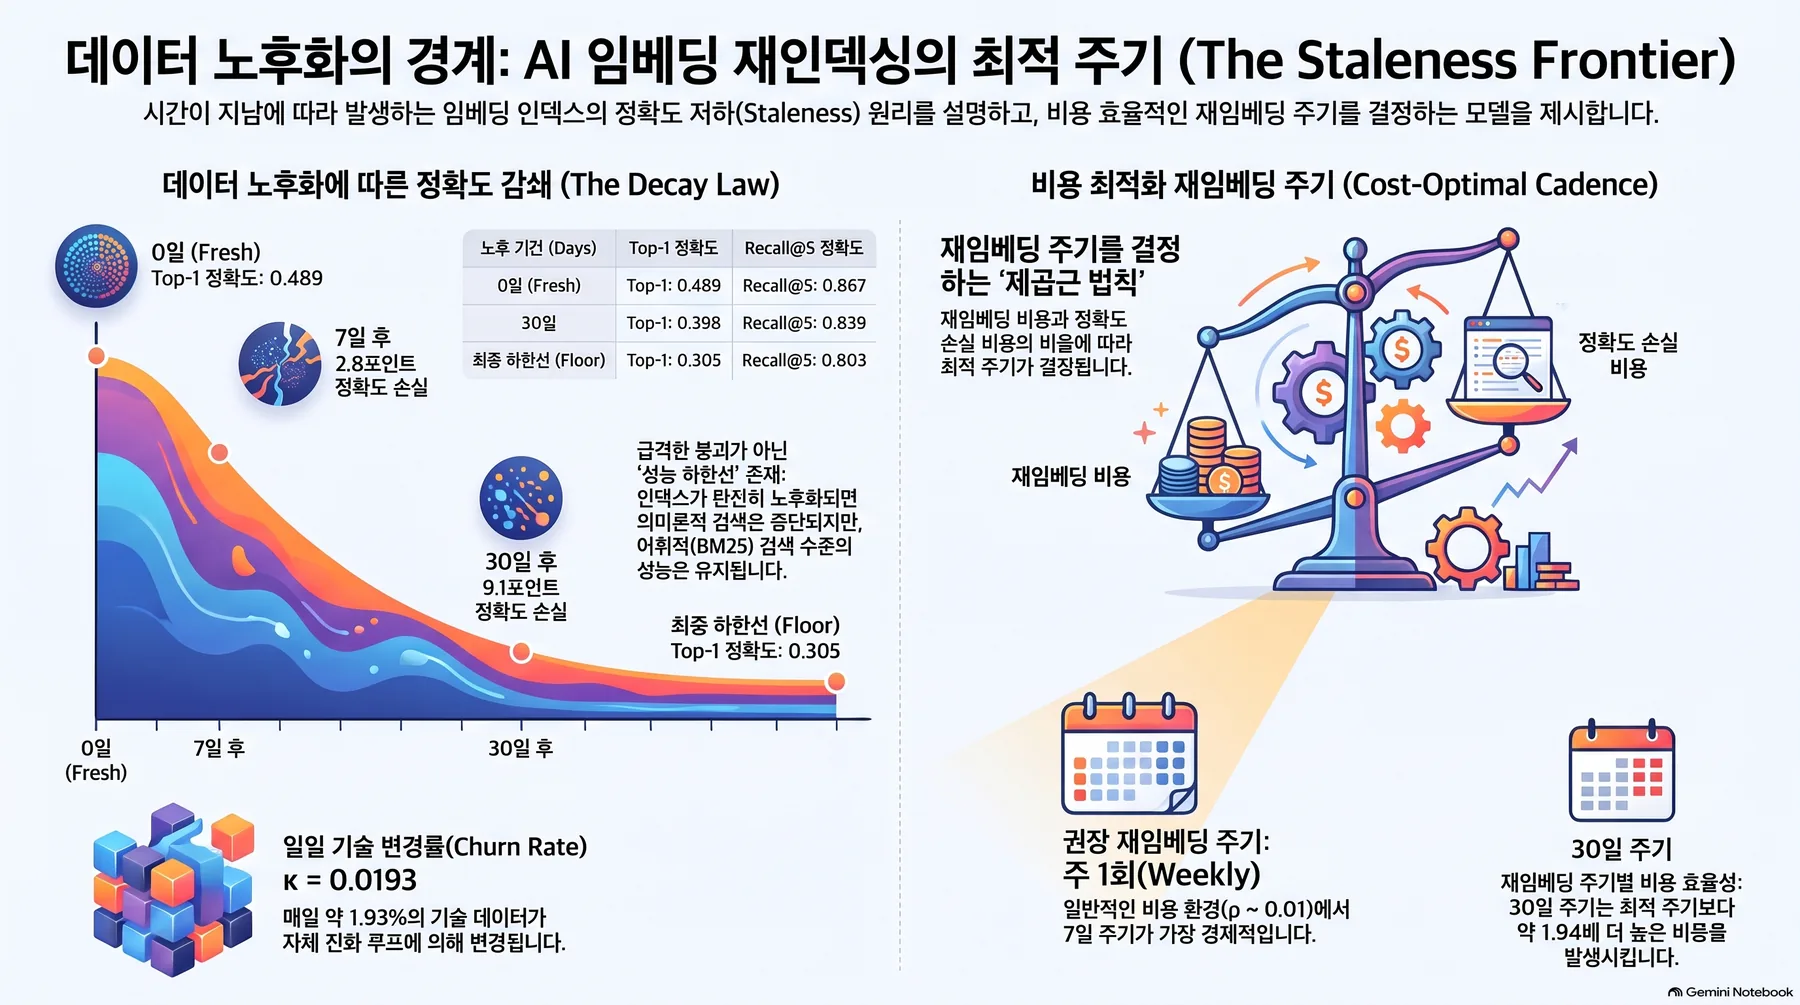 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
문제: 레지스트리는 움직이고, 인덱스는 동결된다
이 배포 환경의 스킬 레지스트리는 약 2,000개입니다. 밤샘 자기 진화 루프가 스킬을 고치고 설명을 다시 쓰는데 세 주 사이에 레지스트리는 1,600개에서 2,029개로 불렀습니다. 매 턴의 요청을 스킬 하나로 보내는 라우터는 어휘 BM25 레인과 임베딩 레인을 역순위 융합(RRF)으로 합칩니다.
이전 연구 Curse of Skills는 레지스트리 크기를 변수로 삼아 기록된 모니터 점을 크기 축 생존 모델의 서명이라고 보여 줬습니다. 그 모니터 점의 Recall@5는 86.7%이고 top-1은 48.9%였습니다. 하지만 그 연구에서는 인덱스가 암묵적으로 새것이었습니다. 그 모델의 감쇠는 크기 N에 있고 시간에는 있지 않았습니다.
임베딩 인덱스는 동결된 산출물입니다. 재임베딩 사이사이 레지스트리는 인덱스 아래에서 움직입니다. 새 스킬은 인덱스에 없고 바뀐 설명은 인덱스에 남아 있지 않습니다. 동적 벡터 인덱스 연구는 항목이 추가되거나 삭제될 때 인덱스 구조의 일관성을 선형보다 작은 비용으로 유지합니다. 다만 벡터가 불변이라고 가정합니다. 자기 진화 레지스트리에서는 벡터의 원문 자체가 진화 루프에 의해 다시 쓰입니다. 구조 유지 트릭으로는 낡은 벡터를 구할 수 없습니다. 개입은 재임베딩이고 질문은 언제인가입니다.
그래서 연구 질문은 두 부분입니다. 첫 번째는 인덱스 나이 t와 변동률 κ에 대한 함수로, top-1과 Recall@5가 얼마나 빨리 떨어지는가입니다. 두 번째는 전체 재임베딩 비용과 틀린 라우팅으로 버려지는 하류(downstream) 비용을 주었을 때 총비용을 최소화하는 주기가 얼마인가입니다. 도서관 말로는, 카탈로그를 다시 쓰는 사서의 일과 틀린 책을 고르는 독자의 낭비 중 무엇이 싼지를 묻는 것입니다.
감쇠 법칙: 절벽이 아니라, 바닥
모델은 네 가지 가정에 섭니다. 항목은 일정한 사고율로 변하고 낡은 항목은 임베딩 레인에게 무정보적인 점수를 주며 어휘 레인은 언제나 최신 텍스트를 지니고 경쟁 항목 충돌은 거의 독립적입니다. 이 가정에서 낡음 분율 s(t) = 1 - e^(-κt)가 모든 것을 움직입니다. 정답 항목이 낡으면 정답을 찾을 확률이 d_r만큼 낮아지고 쿼리당 기대 충돌 수는 Δλ만큼 오릅니다. top-1 정확도는 P(t) = r(t)·e^(-λ(t))이고 Recall@5는 같은 형태에 5개 이하의 경쟁 항목이 정답을 앞지른 포아송 확률을 곱합니다.
일관성 검사는 통과합니다. t = 0에서 이 법칙은 기록된 점을 정확히 재현합니다. 변동률이 0이면 기록된 수준에서 시간에 대한 상수가 되고 이것이 바로 크기 축 생존 모델의 영역입니다. 크기 축과 시간 축은 (N 기록, t = 0)에서 만나고 두 연구가 합쳐지면 두 축 정확도 지형 A(N, t; κ)가 완성됩니다.
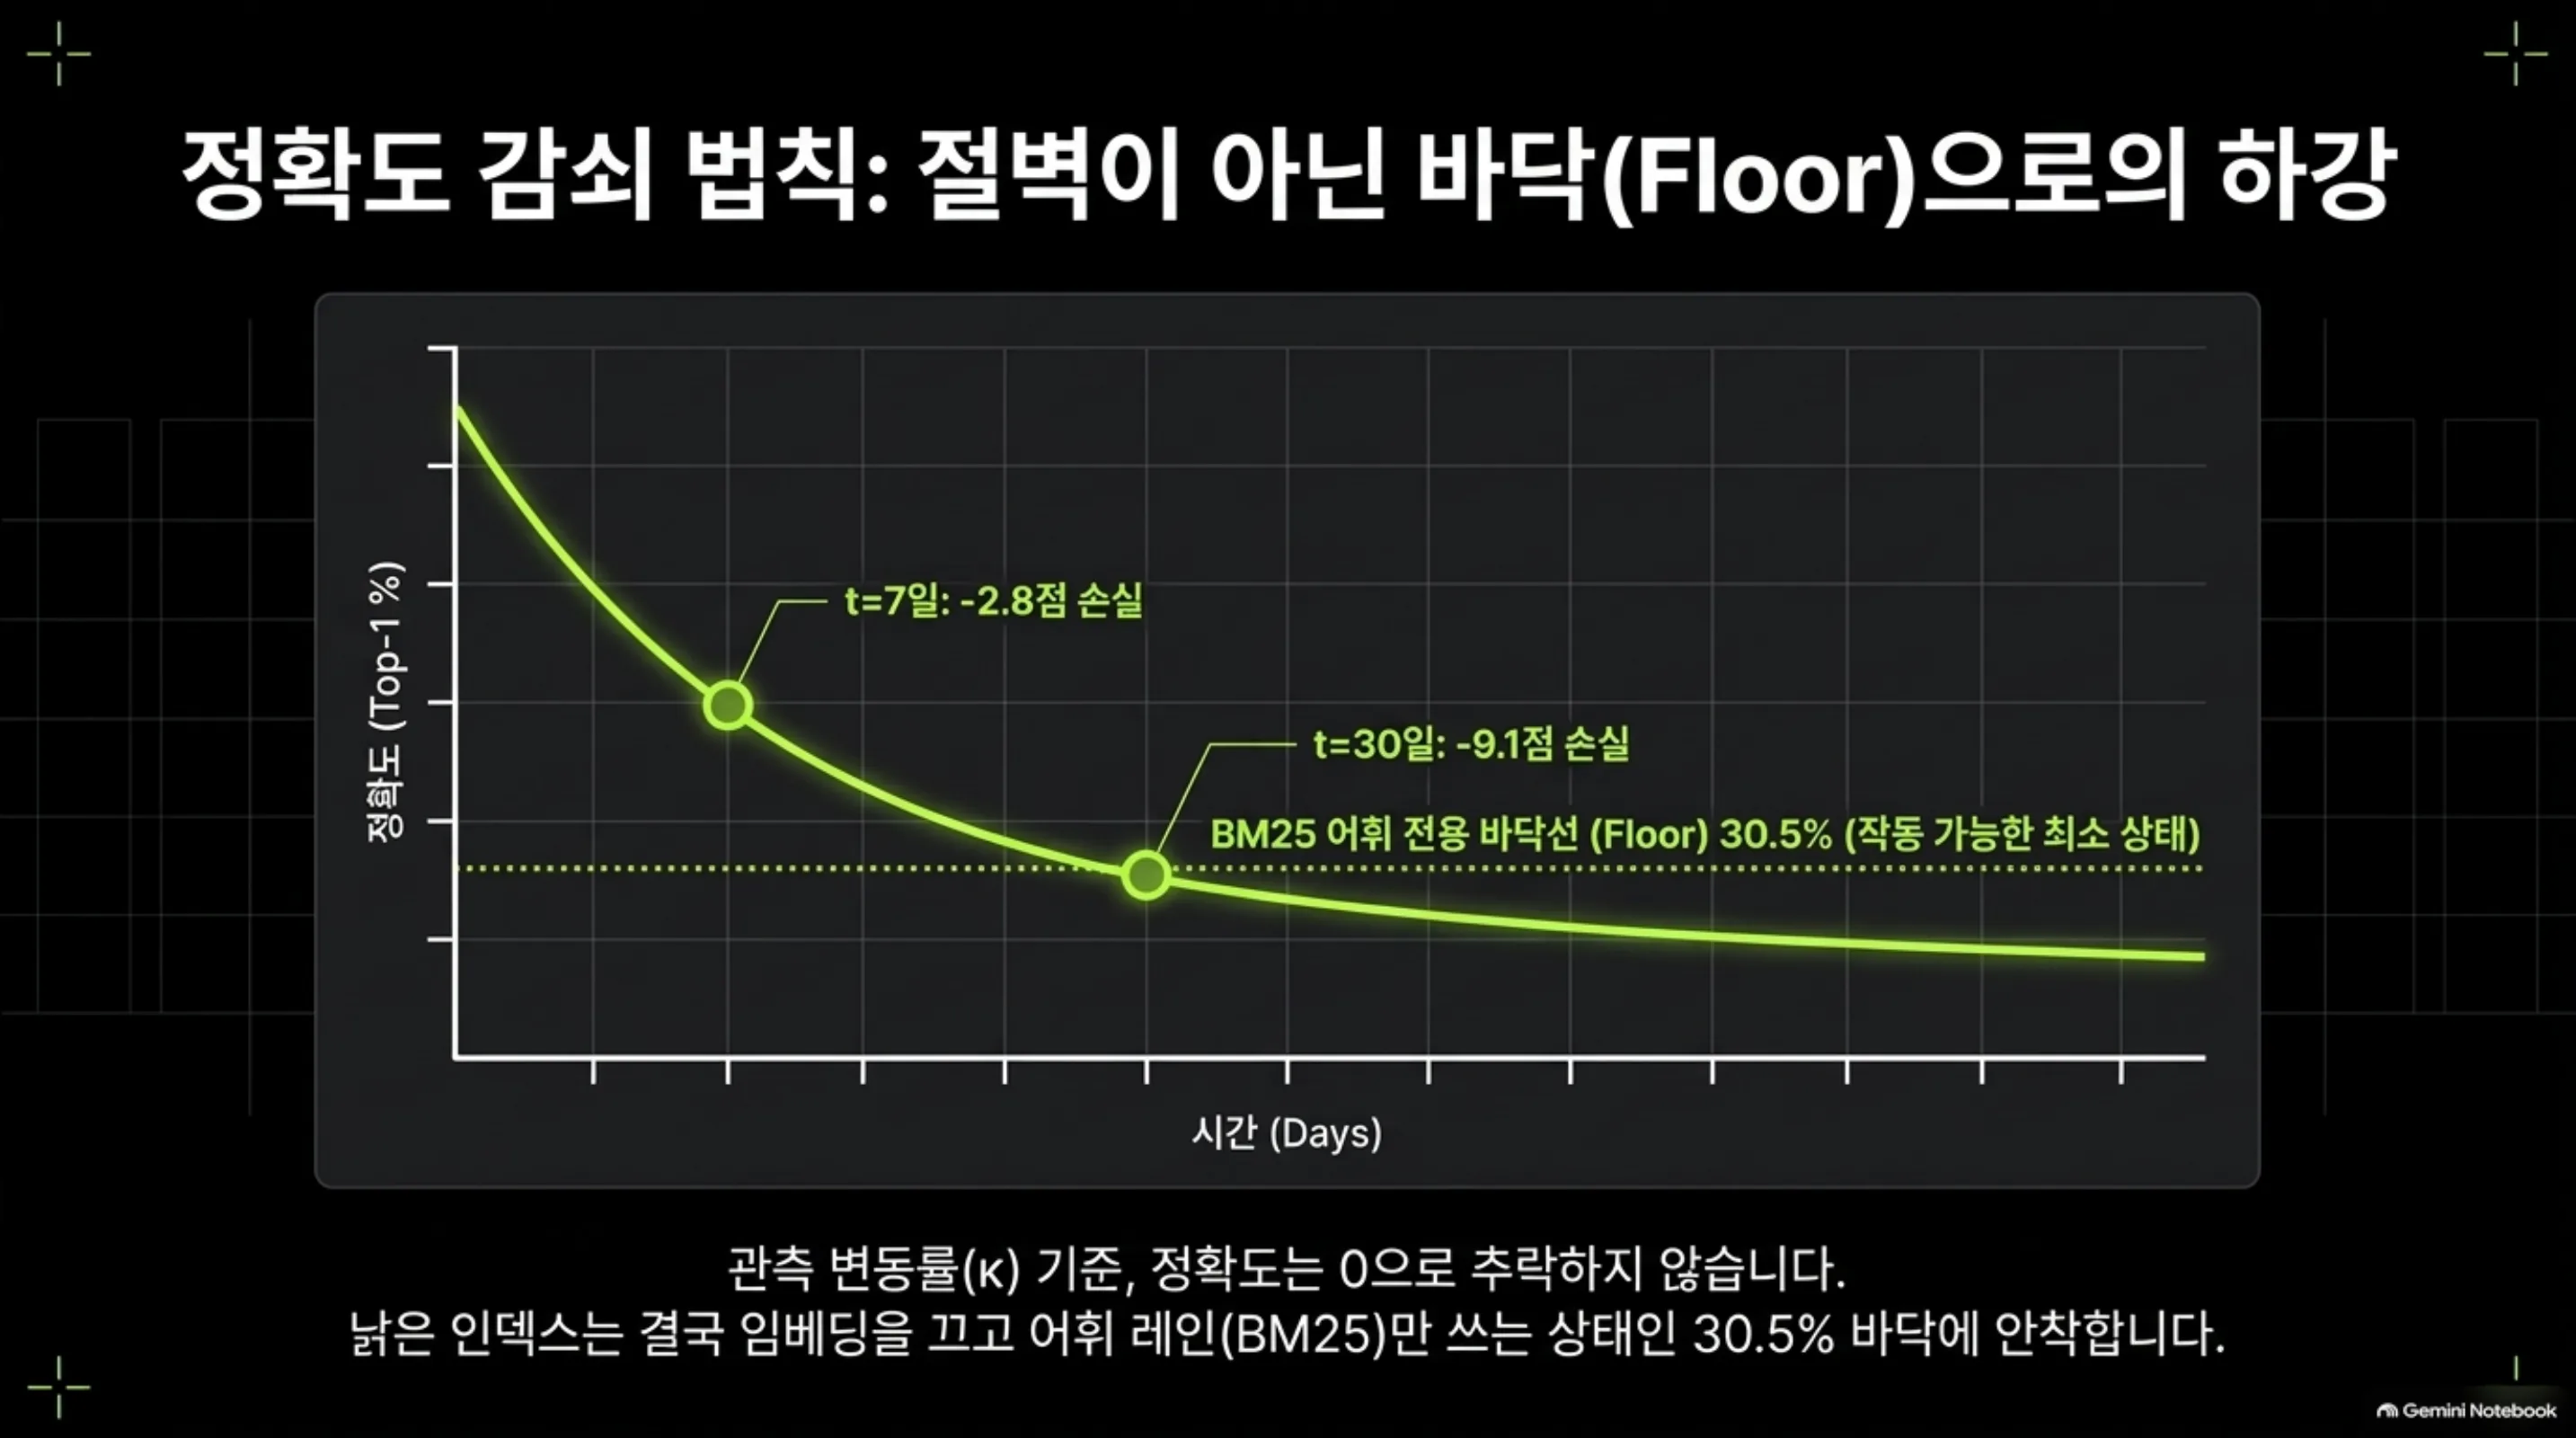
관측 변동률(스킬당 하루 약 0.02)에서 모델은 이렇게 말합니다. top-1은 7일에 2.8점을 잃고 30일에 9.1점을 잃습니다. 총 손실은 18.3점이고 바닥은 약 30.5%입니다.
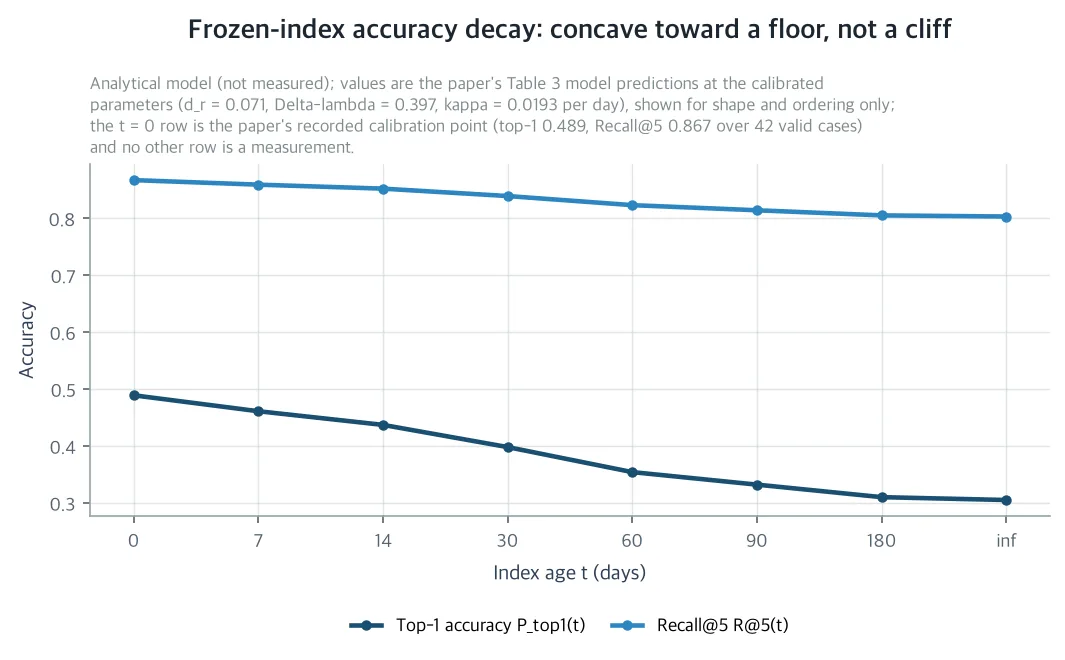 관측 churn율(κ = 0.0193/skill-day)과 reference 파라미터(d_r = 0.071, Δλ = 0.397)의 분석 모델 예측입니다. t = 0 앵커(top-1 0.489 / Recall@5 0.867)만 실측이며 나머지 곡선 값은 전부 실측이 아닌 모델 출력입니다. 7일 2.8점, 30일 9.1점, 총 18.3점(바닥 0.305)까지 top-1이 오목하게 떨어지고 Recall@5는 총 6.4점(바닥 0.803)까지 떨어집니다. 점선은 모델이 예측한 어휘 전용 바닥선입니다. reference 파라미터는 기록된 terminal 점(BM25-only arm, hit@1 0.5278 / hit@3 0.7778, 36 golden query, 1,910-entry catalog)과 불일치한다는 점을 논문이 공개합니다. (Analytical model, not measured)
즉, 사람 말로는, 한 달을 놔두면 레지스트리의 4할이 낡고 첫 추천 성공률은 9점 넘게 내려앉는다. Recall@5는 총 6.4점을 잃어 80.3%로 가섭니다. 손실의 절반은 약 37일 안에 생기는 것이다.
모양은 오목합니다. 처음 빠르다가 나중에 평탄해진다. 낡음 분율이 포화하기 때문에 레지스트리의 마지막 20%는 첫 추천의 마지막 4점만을 담당한다는 뜻이다. 바닥이 어디인지가 더 중요합니다. 완전히 낡은 인덱스는 곧 임베딩 레인을 끄고 어휘 레인만 쓰는 구성 그 자체입니다. 동반 양자화 연구는 그 구성을 자기 골든 세트 위에서 재어 hit@1 52.8%와 hit@3 77.8%를 기록합니다. 도서관은 낡았지만 독자는 여전히 책을 찾는다. 바닥은 죽은 상태가 아니라 작동하는 구성.
논문의 앞부분에 공개되는 중요한 전제입니다. 끝 상태(terminal) 파라미터 쌍(d_r, Δλ)은 이 스위트에서 어떤 기록된 측정에도 고정되지 않았습니다. 논문은 참조(reference) 값(d_r 약 7%, Δλ 약 0.4)을 싣고 그것이 기록된 끝 상태 점과 불일치한다는 것을 공개합니다. 참조 값에서 끝 상태 top-1은 약 30.5%입니다. 기록된 끝 상태 점 약 0.5보다 약 22점 아래입니다. 동결 실험군(frozen arm)이 이 쌍을 재고정할 때까지 모든 감쇠 크기는 기록된 증거가 지원하지 않는 참조 쌍의 모델 출력.
재임베딩 주기: 제곱근 법칙과 손익분기
두 비용 스칼라가 그 균형을 가격 매깁니다. C_re는 로컬 임베딩 서버에서 2,029개 레지스트리를 통째로 재임베딩하고 인덱스를 다시 쓰는 비용이고 c_q는 틀린 라우팅이 정확도 1점당 1일 단위로 하류에서 버리는 비용입니다. Δt일 주기의 총비용율은 C(Δt) = C_re/Δt + c_q·L̄(Δt)입니다. 첫 항은 재임베딩 비용의 주기별 분배이고 두 번째 항은 주기 내 평균 정확도 손실을 하류 비용으로 환산한 것입니다.
주기가 시간 상수(약 52일)보다 훨씬 짧은 저비용 영역(cheap regime)에서는 손실이 선형 램프처럼 시작하고 최적은 제곱근 형태를 칩니다. Δt* = √(2·C_re / (c_q·P’(0))). 재임베딩 비용이 절반이면 최적 주기가 30% 짧아지고 틀린 라우팅 비용이 두 배면 같은 30% 짧아진다. 고전적 재고 재충전 주기와 같은 형태이다. 도서관의 카탈로그 재작성이 재고 문제로 바뀐 것이다.
무차원 형태로 운영점은 하나의 숫자 ρ로 정해진다. ρ는 재임베딩 한 번의 비용을, 시간 상수 한 개(약 52일) 분량의 전체 정확도 손실로 나눈 값이다. ρ가 약 1/1000이면 최적은 약 2일로 짧아지고 5%이면 약 17일, 50%이면 약 3개월로 길어진다. 재임베딩을 전혀 하지 않는 것은 ρ가 약 1 이상, 즉 재임베딩 한 번이 시간 상수 한 개 분량의 전체 손실보다 비쌀 때만 최적이다.
비용 풍경은 최적점 근처에서 평탄하다. ρ = 1%에서 7일 주기가 가장 싼 셈이다. 5일은 5% 남짓 비싸고 30일은 두 배 남짓이다. 재임베딩을 전혀 하지 않는 경우는 최적점보다 훨씬 위에 있다. 그래서 운영자는 달력에 맞는 주기를 골라도 잃는 것은 몇 퍼센트 이내이다.
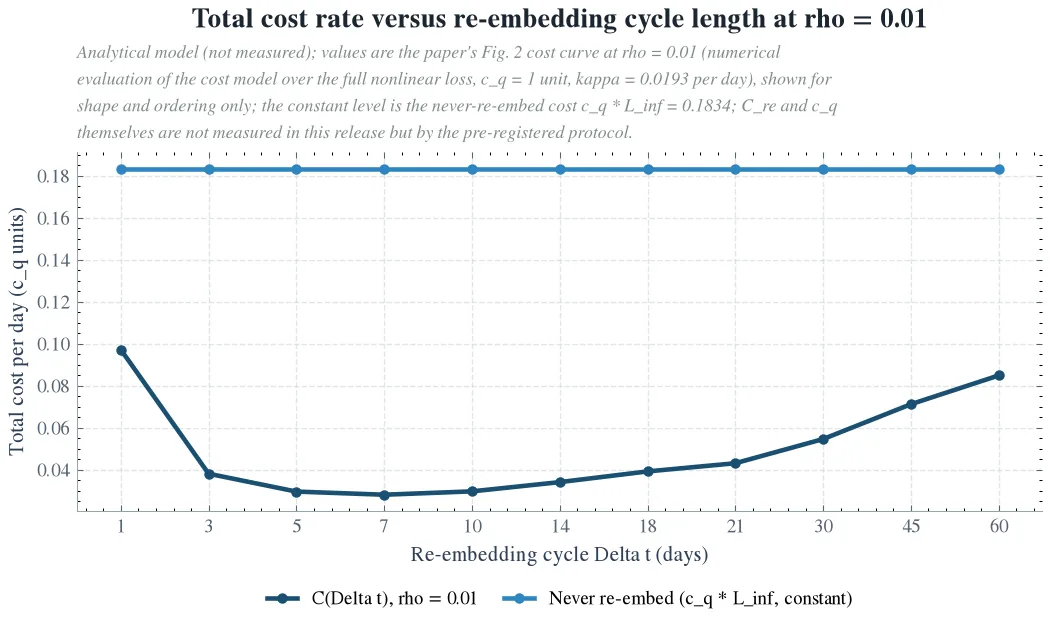 ρ = 0.01, reference 파라미터의 분석 모델 예측이다. 하루 총비용 C(Δt) = C_re/Δt + c_q·L̄(Δt)는 재임베딩 주기에 대해 U자형이다. 최저점은 7일 주기(0.0281, c_q 단위)에 있고 5일은 1.05배, 30일은 1.94배이다. 재임베딩을 전혀 하지 않는 경우는 c_q·L∞ = 0.1834로 최저점보다 훨씬 위에 붙어 있다. (Analytical model, not measured)
손익분기(break-even) 규칙은 판단을 하나의 부등식으로 만듭니다. 고정 주기가 안 함을 이기려면 재임베딩 한 번의 비용이 그 주기가 막아주는 하류 손실보다 작아야 합니다. C_re < Δt·c_q·(L∞ - L̄(Δt))가 그 조건입니다. 주 단위에서 보면 일주일 평균 손실은 0.01점이고 안 함은 0.18점에 붙어 있습니다.
논문은 직전 재임베딩 이후 누적 손실이 C_re/c_q에 도달하면 재임베딩한다는 임계 정책도 평가합니다. ρ가 매우 작으면 최적을 5% 이내로 추적하지만 ρ = 1%에서는 포화되는 곡선을 모르기 때문에 4.6배 넘게 늦깁니다. 논문은 고정 주기를 권고합니다.
운영 레시피는 짧습니다. C_re를 한 번 재고 c_q를 실트래픽 한 주로 재어 ρ를 계산하고 주기를 읽고 재임베딩을 스케줄합니다. ρ는 매달 다시 계산해야 합니다. κ는 진화 루프와 함께 흘러 설명이 많이 고쳐질수록 최적은 짧아지기 때문입니다. 도서관 말로는, 사서가 자주 서고를 다시 정리하면 카탈로그도 자주 다시 써야 한다는 뜻입니다.
회사에, 사회에, 과학에 남는 것
회사에는 구체적인 재임베딩 예산이 남습니다. 2,000개 스킬 레지스트리를 매 밤 무조건 재임베딩하거나 혹은 영원히 안 하는 대신 플릿은 측정된 정확도 감쇠 비용이 측정된 인덱스 재작성 비용을 넘을 때만 재임베딩합니다. 진화 루프 자신의 변동이 만드는 조용한 감쇠로부터 기록된 라우팅 지표를 지킵니다.
사회에는 자기 진화 에이전트가 빠져 있던 예산이 남습니다. 자기 개선 에이전트 시스템은 퍼져 나가지만 신선도 예산이 없으면 그 시스템이 의존하는 자율 스킬 진화가 작업을 배분하는 라우터를 조용히 썩게 합니다. 공개된 정확도 감쇠 법칙과 손익분기 주기 규칙은 에이전트 harness를 운영하는 어떤 팀이든 신뢰할 수 있는 자기 진화 자동화의 컴퓨트와 에너지 비용을 낮춥니다.
과학에는 정적 벤치마크가 볼 수 없는 시간 축이 남습니다. 이 논문은 제어된 레지스트리 변동률 아래 하이브리드 검색 인덱스의 인덱스 나이를 변수로 삼아 정확도 감쇠 법칙과 비용 최적 재임베딩 주기를 유도합니다. 정적 레지스트리 크기 scaling law를 시간 축으로 확장한 것입니다. 두 연구가 합쳐지면 크기와 시간을 아우르는 정확도 지형 A(N, t; κ)가 완성됩니다. 논문은 30일 동결 실험군에서 terminal 파라미터를 재고정하고 변동 주입 제어와 수치 기준 위에서 감쇠 법칙을 반증할 측정 프로토콜을 사전 등록했습니다.
아직 못 믿을 부분
첫째는 참조 값 그 자체입니다. 기록된 끝 상태 점은 참조 값이 예측하는 끝 상태 top-1보다 약 22점 위에 있습니다. 기록된 증거가 참조 값을 지원하지 않는다는 뜻입니다. 동결 실험군이 재고정할 때까지 손실 깊이와 바닥은 전부 모델 출력입니다. 모델의 손실 깊이는 top-1 18.3점, Recall@5 6.4점이고 바닥은 30.5%와 80.3%입니다.
진짜 바닥이 어디에 있는지 알려주는 가장 좋은 증거는 자기 세트 위의 기록된 끝 상태 구성이고 그것은 모델의 바닥보다 훨씬 위에 있습니다. 둘째는 일정 사고율 가정입니다. 변동은 밤마다 몰아치는 형태이고 κ는 시간 평균 속도입니다. 동결 실험군이 실제로 유효한 속도를 재습니다. 셋째는 낡은 항목이 무정보라는 가정입니다. 낡은 설명이 능동적으로 오도하면 끝 상태는 어휘 전용 구성보다 아래에 앉고 모델의 바닥은 낙관적 상한이 됩니다. 그 경우 실측 바닥은 모델 값보다 아래에 있고 프로토콜의 반증 기준이 그것을 잡도록 설계되어 있습니다.
넷째는 측정되지 않은 비용 스칼라입니다. C_re와 c_q는 프로토콜이 측정하는 입력이고 이 논문은 둘 다 측정하지 않습니다. 그때까지 운영 클레임은 저비용 영역의 제곱근 형태, 손익분기 부등식, 그리고 ρ 약 1 이상에서만 안 함이 최적이라는 규칙의 형태입니다. 캘린더 날짜는 아닙니다. 다섯째는 단일 harness입니다. 국영 양언 레지스트리 하나, RRF 융합 하나, 로컬 인코더 하나로 되어 있습니다. 영문 전용 레지스트리나 학습된 융합 이전은 미검증입니다. 이식 가능한 클레임은 구조, 즉 낡음 분율에 지수적으로 떨어지는 감쇠와 측정 가능한 바닥, 그리고 제곱근 주기입니다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Staleness Frontier: Accuracy Decay of Frozen Skill-Router Embedding Indexes Under Registry Churn and the Cost-Optimal Re-Embedding Cadence
이 글의 두 장은 전부 참조 파라미터 값의 분석 모델 출력입니다. 실측은 t = 0 앵커(top-1 48.9% / Recall@5 86.7%)와 기록된 끝 상태 구성(hit@1 52.8% / hit@3 77.8%, 36 golden query, 1,910-entry catalog)뿐입니다.
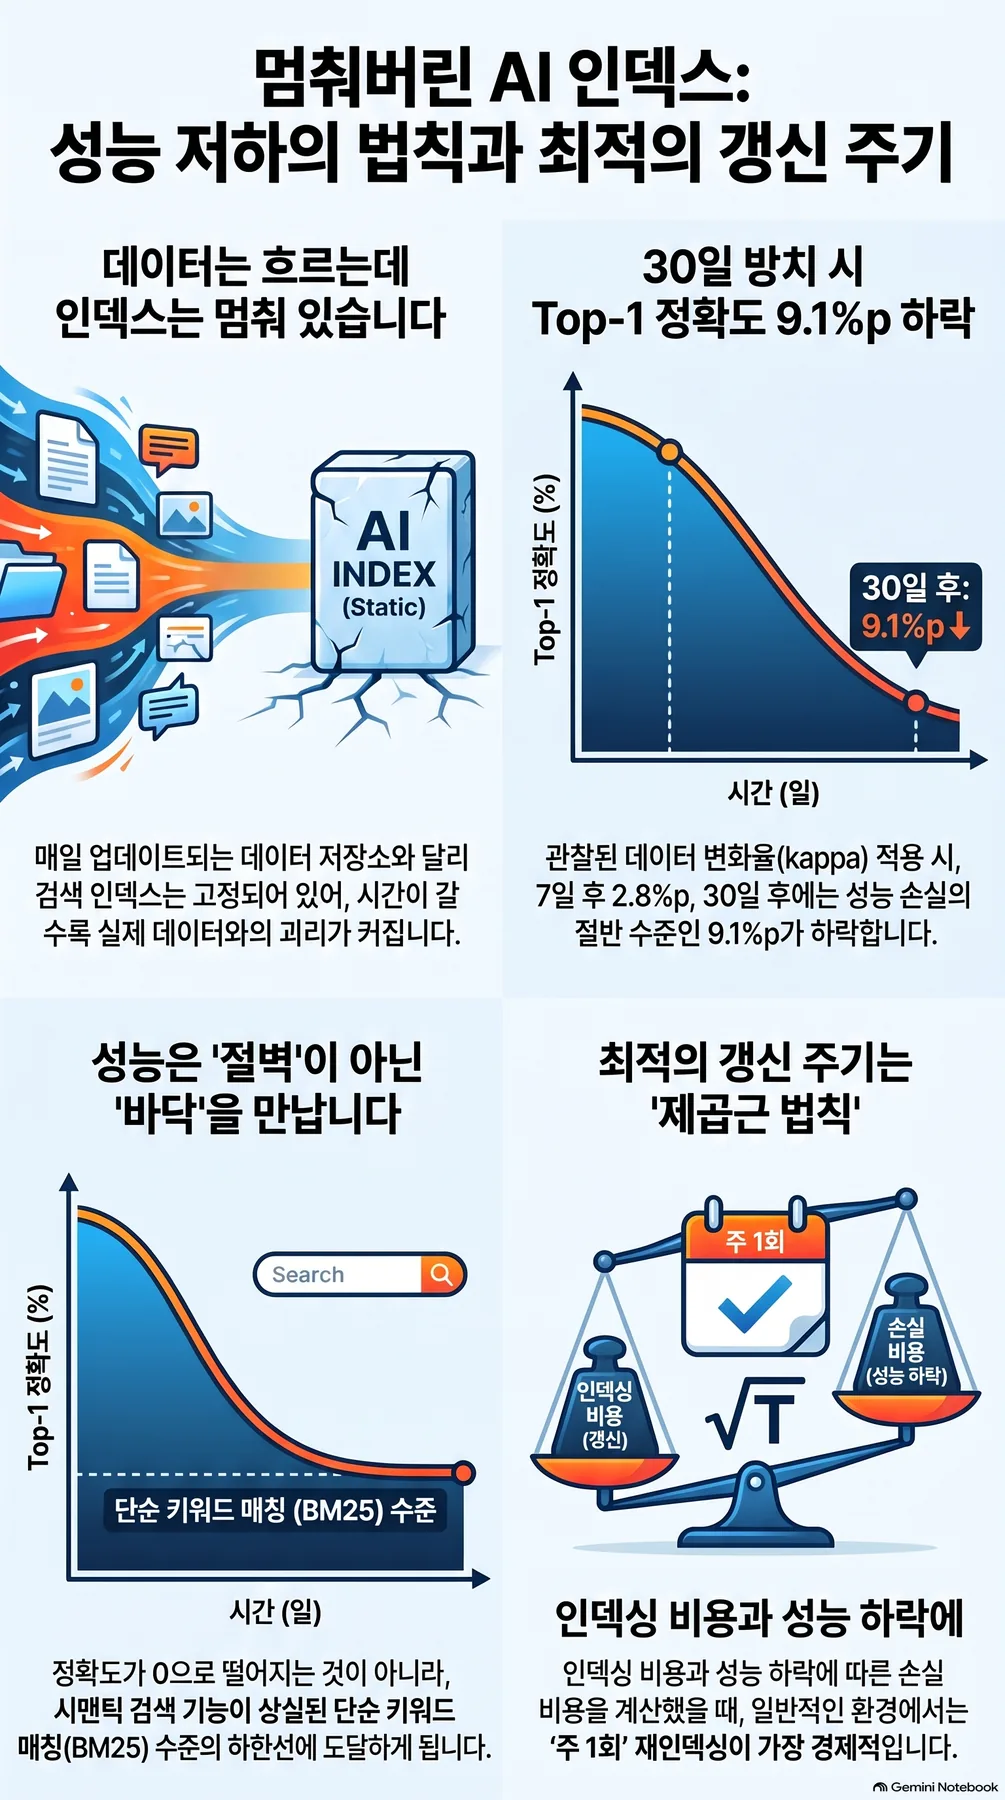 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.