The Transplant: 재사용 에이전트 스킬이 하네스를 옮길 때 능력의 몇 퍼센트가 남는지, 이동 전에 계산됩니다
스킬이 하네스를 옮길 때 남아 있는 능력은, 이식을 돌리기 전에 계산할 수 있습니다. H200 같은 셀프호스트 가속기에 에이전트 플릿을 돌리거나, 스킬을 여러 하네스에 나눠 쓰는 국내 클라우드·AI 엔지니어라면 이 글이 필요합니다. 어떤 스킬은 이식할 가치가 있고, 어떤 스킬은 하네스마다 다시 고쳐야 하며, 어떤 스킬은 새로 만들어야 하는지를 가르는 기준이 됩니다.
이 기준을 계수와 모델로 주는 것은 ThakiCloud의 분석 논문입니다. 먼저 성격을 짚겠습니다. 이 논문은 셀 값을 측정한 실측 논문이 아닙니다. 모든 주장은 분석적이며, 이 글에 나오는 수는 전부 분석 모델의 예측입니다.
논문의 이름은 The Transplant: Measuring Cross-Harness Portability and Capability Retention of Reusable Agent Skills Under System-Prompt, Tool-Schema, and Model-Tier Shift on Self-Hosted H200입니다. 이 글은 그 논문이 주는 계수와 모델, 그리고 이식 전에 재는 법을 순서대로 소개합니다.
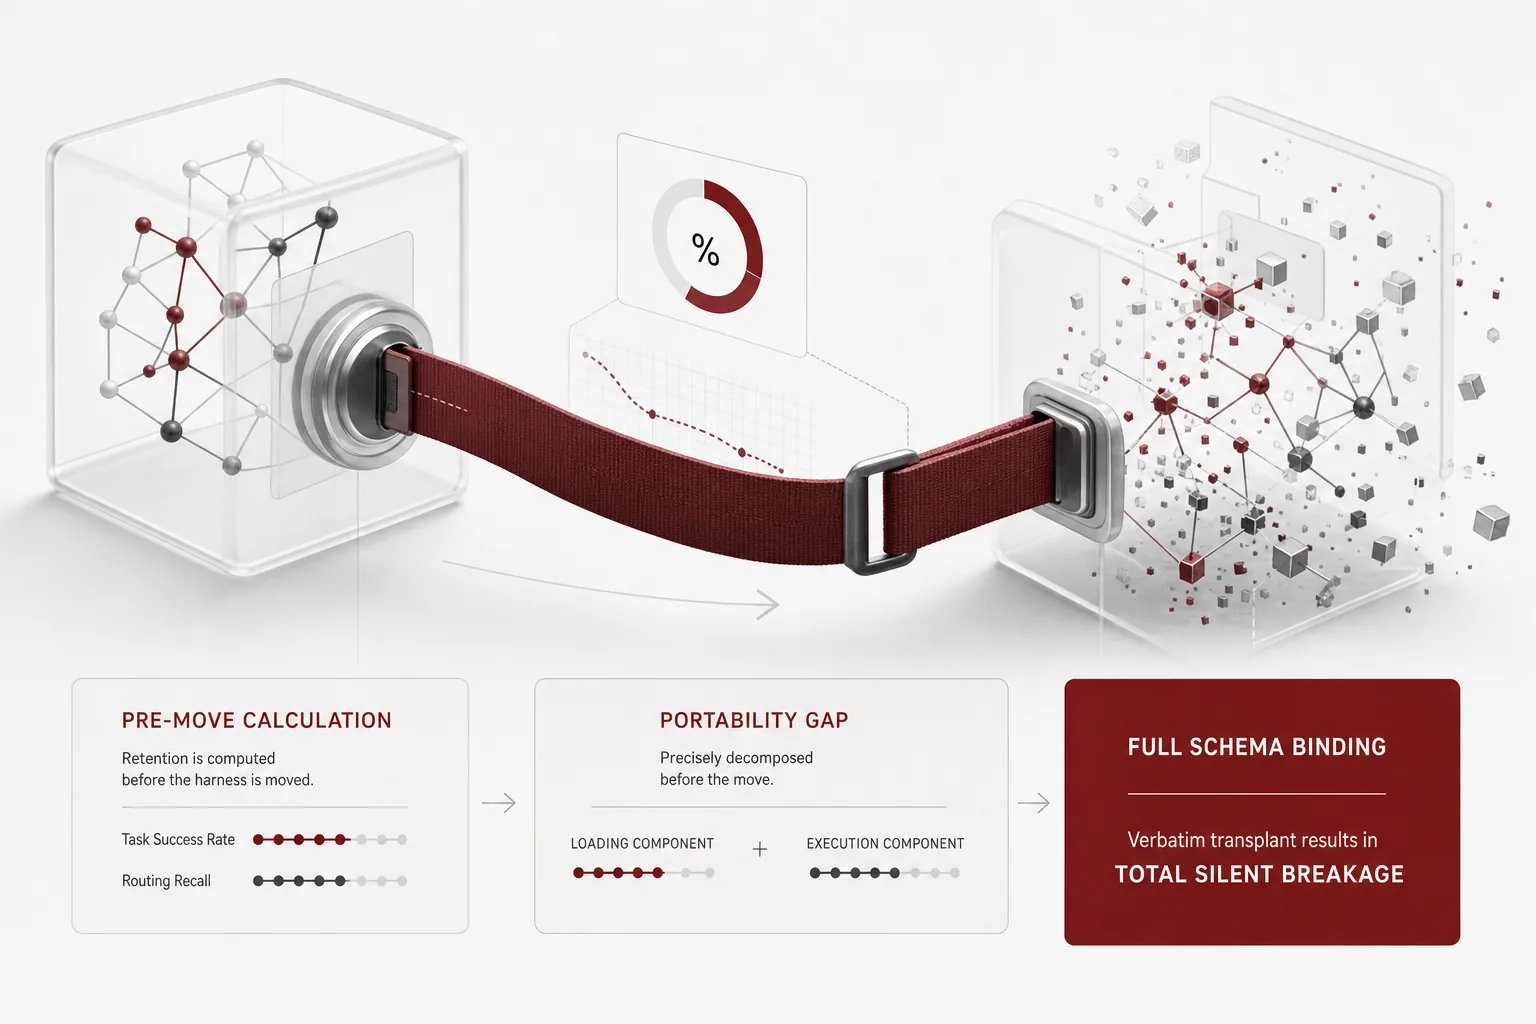 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
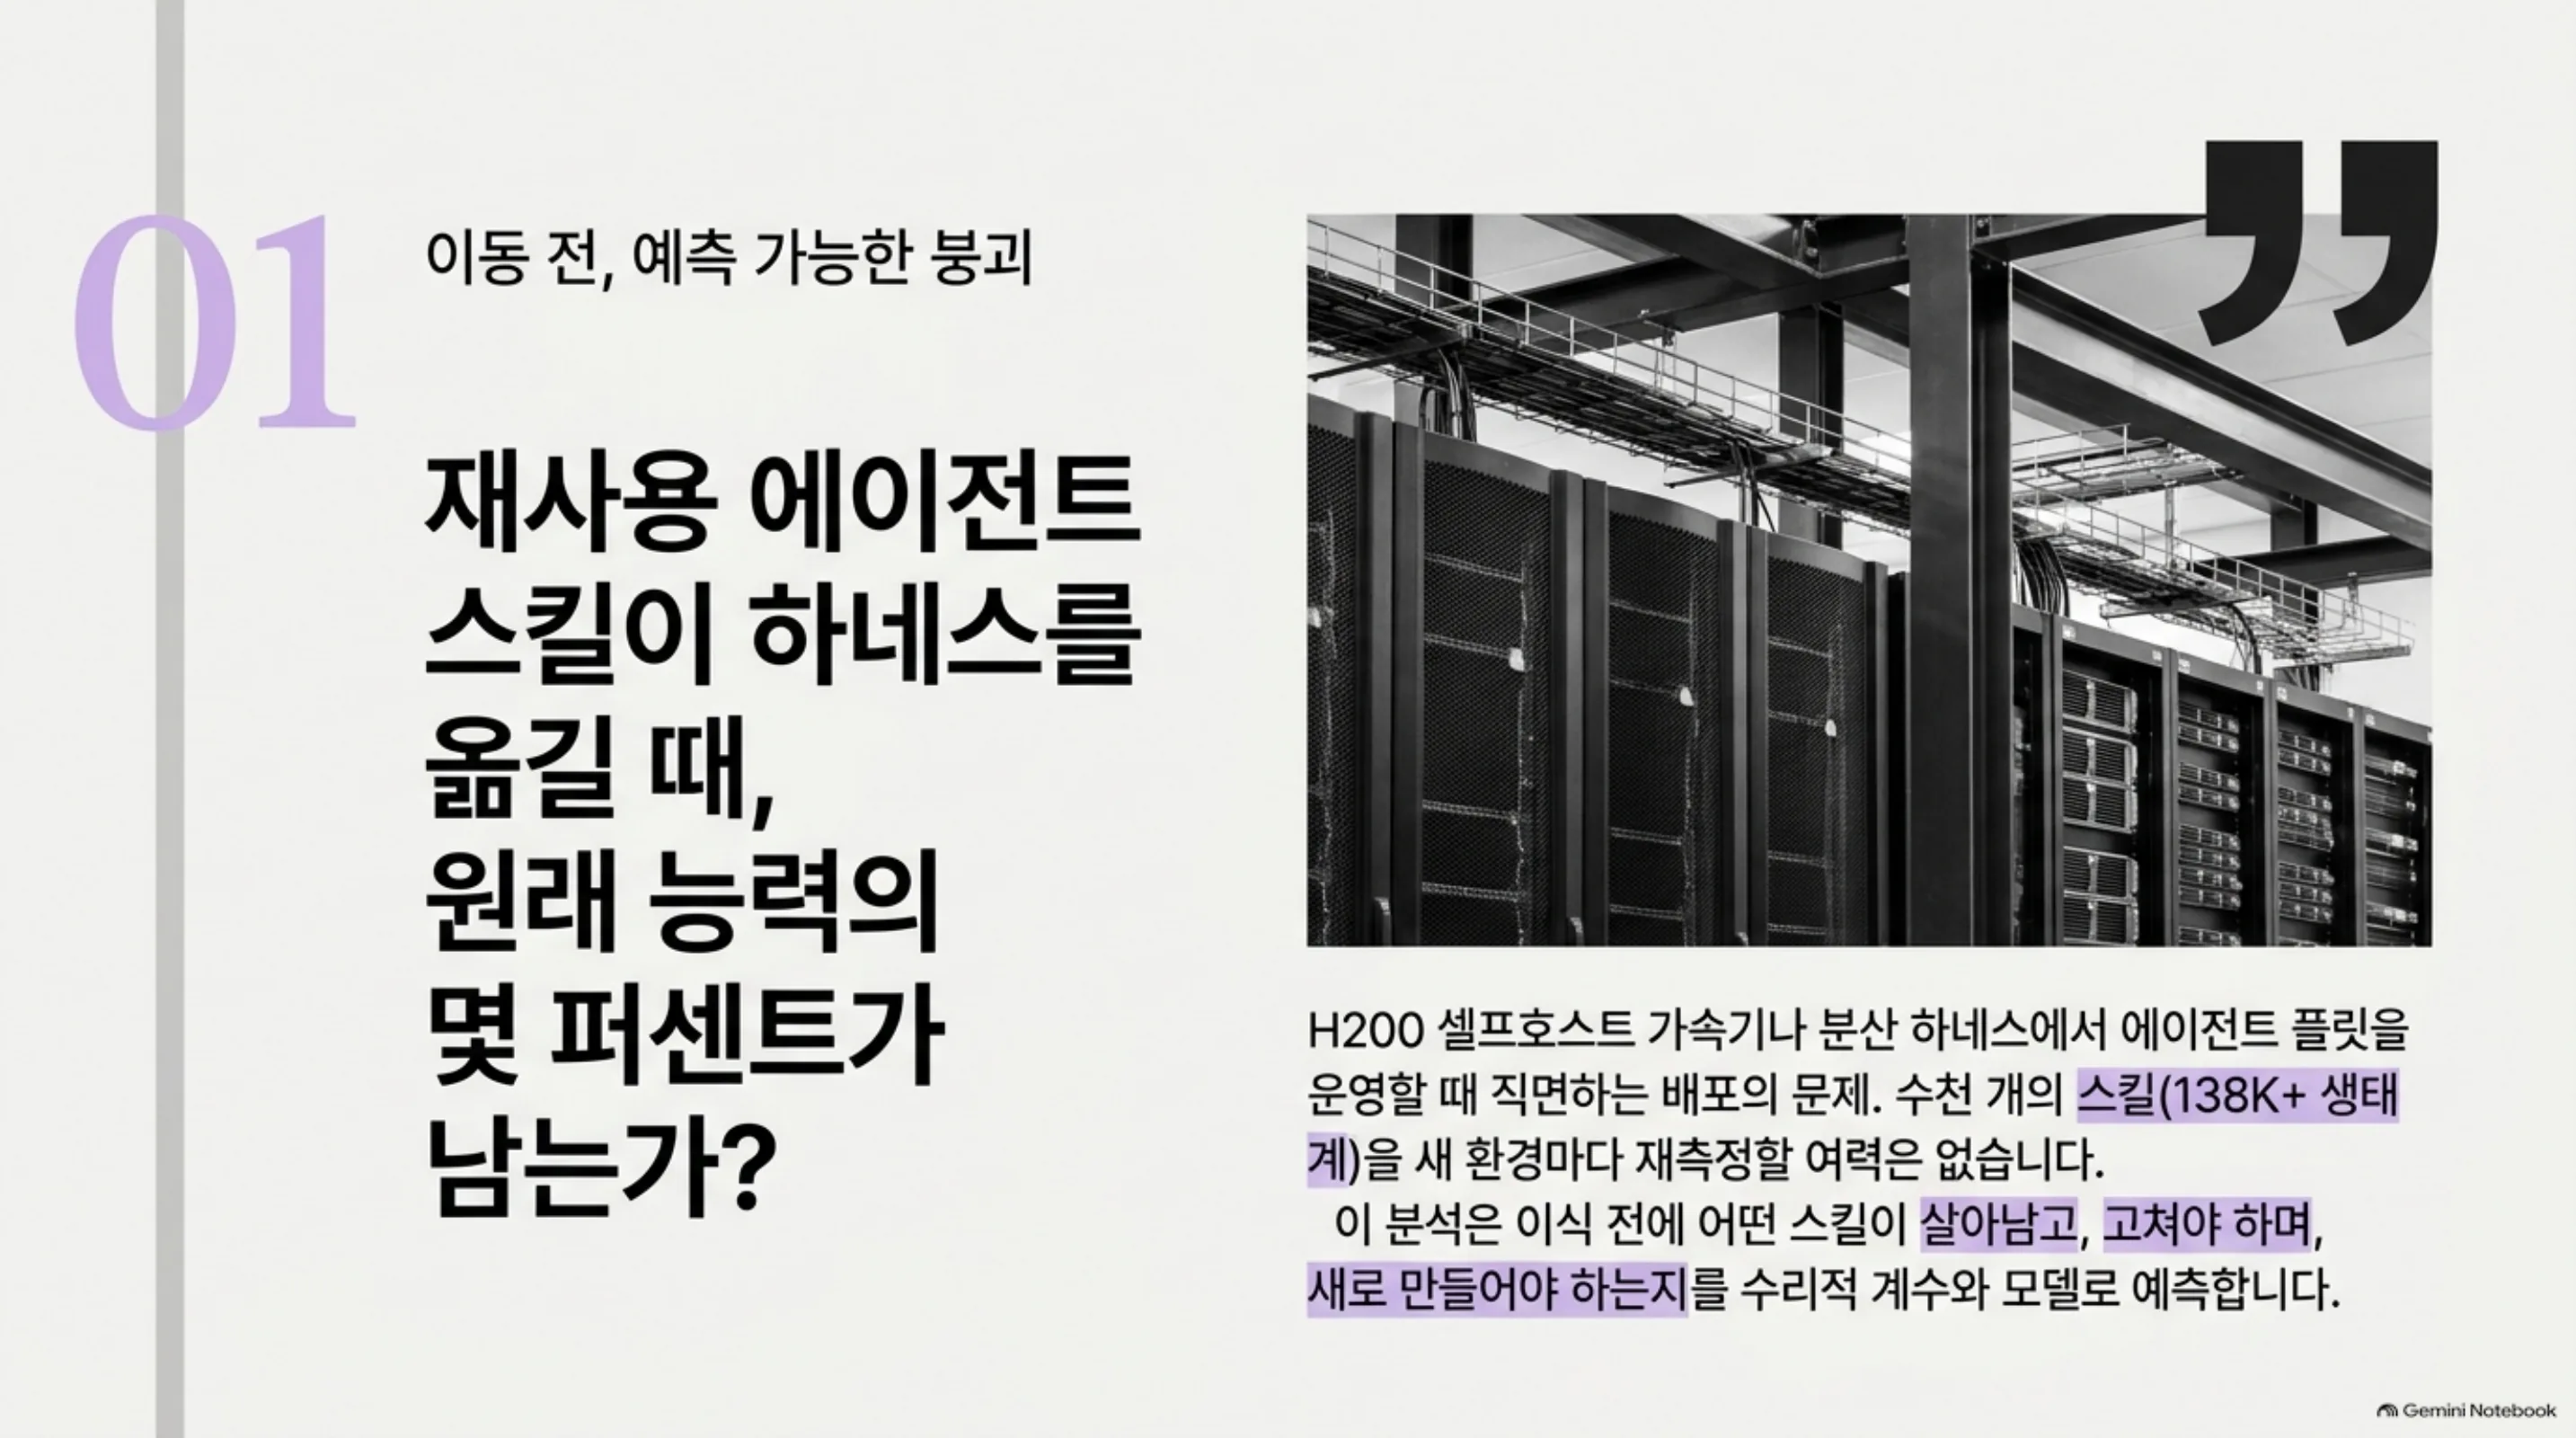
이사 비유로 시작하겠습니다. 스킬은 새 집으로 가져갈 세운 드럼 세탁기입니다. 지금 집(홈 하네스)에서는 잘 돌아갑니다. 다른 집(이식 대상 하네스)으로 가면 집만 바뀌지 않습니다. 콘센트의 모양(도구 스키마), 집안 규칙과 매뉴얼 언어(시스템 프롬프트), 세탁기를 돌리는 사람의 숙련도(모델 티어)까지 전부 새로워집니다.
질문은 하나입니다. 새 집에 가서 그 세탁기의 성능은 얼마가 남느냐?
이식 방법은 두 가지입니다. 낡은 플러그를 새 콘센트에 그대로 꽂는 그대로 이식(verbatim)과, 새 콘센트에 맞는 새 플러그를 달아 주는 재래핑(re-wrap)입니다. 새 플러그는 1대 1로 맞춥니다. 표면의 플러그만 바뀌고, 세탁기 안쪽은 건드리지 않습니다.
성능이 떨어지면 원인은 둘 중 하나입니다. 첫째, 새 집의 사서가 매뉴얼 카드 사이에서 그 세탁기를 찾아내지 못합니다(로딩 갭). 둘째, 찾긴 했는데 새 콘센트·새 규칙·새 숙련도 아래에서 제 성능으로 돌리지 못합니다(실행 갭). 논문은 총 손실을 이 둘로 정확히 나누어 줍니다. 근사가 아니라 항등식입니다.
특히 위험한 경우가 있습니다. 콘센트에 꽂혀 윙윙 돌아가는데, 정작 세탁은 되지 않는 경우입니다. 논문은 이 현상을 침묵 부수(total silent breakage)라고 부릅니다. 기록을 보면 멀쩡해 보이지만, 채점 앞에서는 모든 호출이 떨어지고 그 기계를 고칠 신호가 남지 않습니다.
이식 전에 가릴 수 있는 속성은 세 가지입니다. 기구가 낡은 콘센트 모양에 얼마나 단단히 묶여 있는지(스키마 결합도), 매뉴얼이 얼마나 낡은 집 규칙을 전제로 쓰였는지(프롬프트 앵커링), 연달아 몇 번의 동작이 성공해야 하는지(티어 깊이)입니다. 자산과 시험 문제만 있으면 세 값 다 계산되며, 실제로 옮길 필요가 없습니다.
즉, 사람 말로는 이사 트럭이 출발하기 전에, 플러그가 맞는지, 매뉴얼이 새 집 규칙으로 쓰였는지, 연속 동작이 몇 번인지만 보면 새 집 성능의 얼마가 남는지 예상할 수 있습니다.
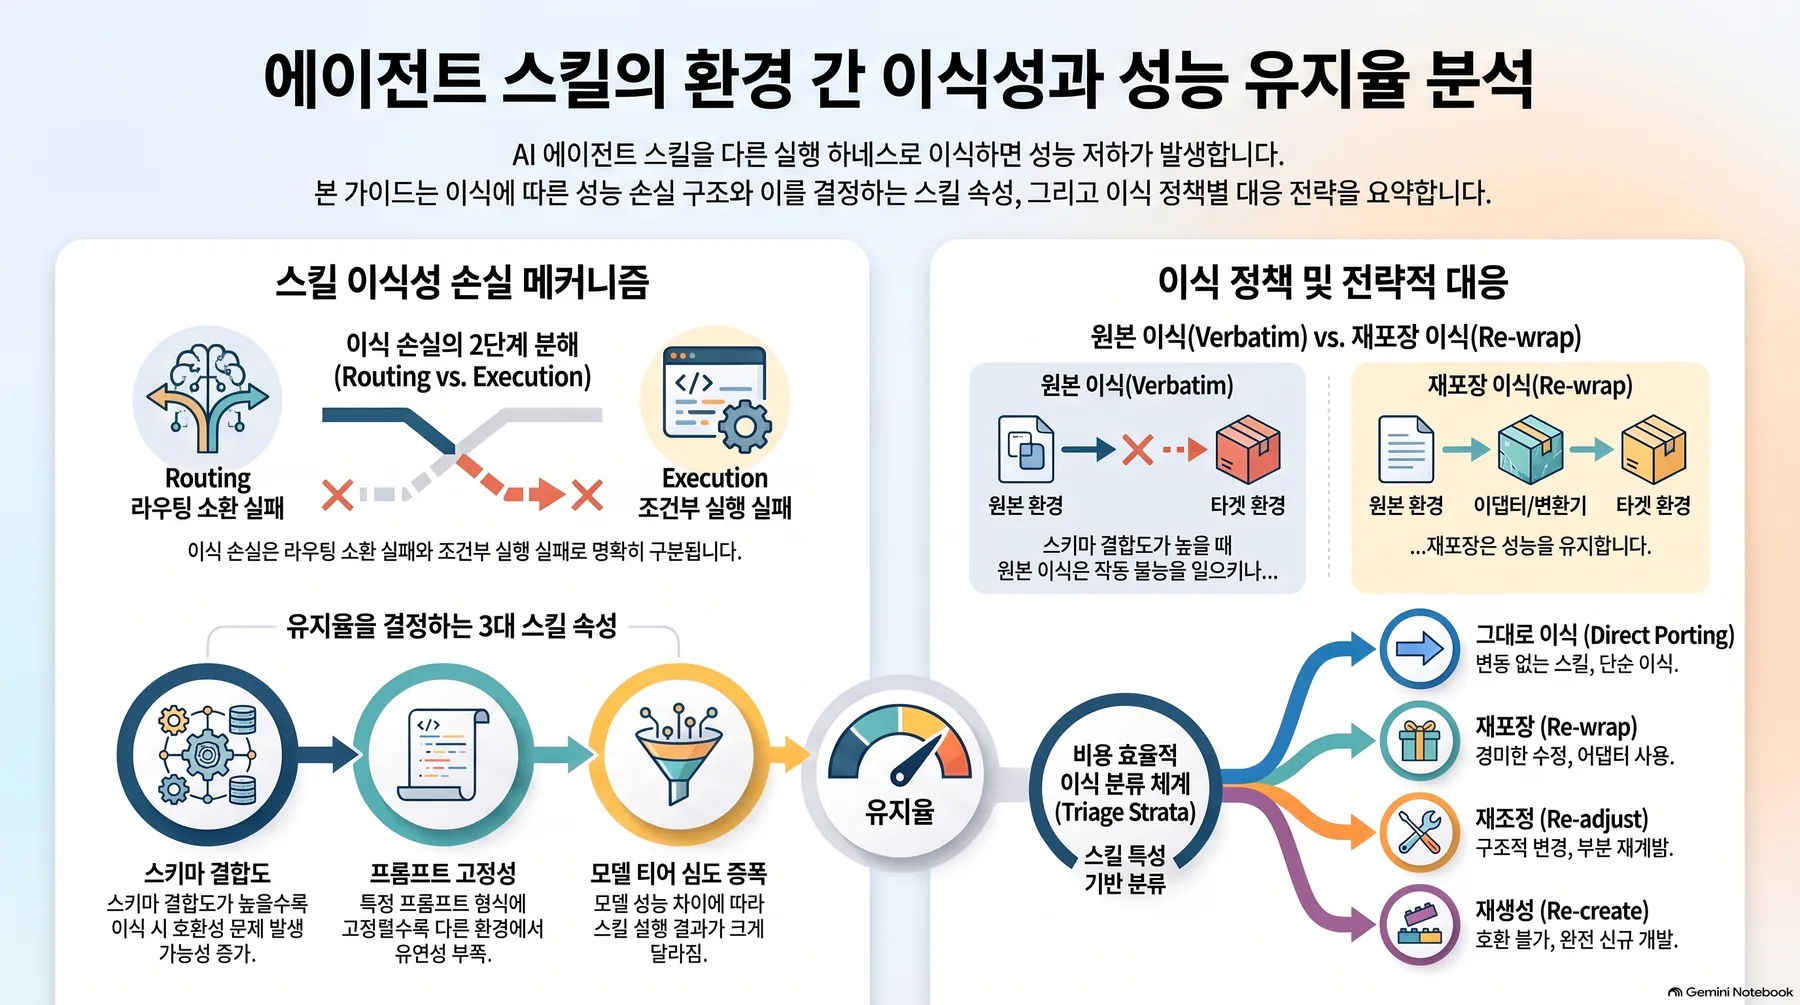 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
무엇을 해봤나
재사용 에이전트 스킬은 이미 작은 패키지가 됐습니다. 2026년 문헌은 스킬을 YAML 메타데이터와 자연어 지시문, 실행 가능 코드의 패키지로 취급합니다. 공개 생태계에는 스킬 파일 138K(약 138,000) 이상이 쌓였고, 형식은 정규형·대수 연구, 장기 유지보수 연구, 대규모 재사용 분석의 대상이 될 만큼 표준화됐습니다.
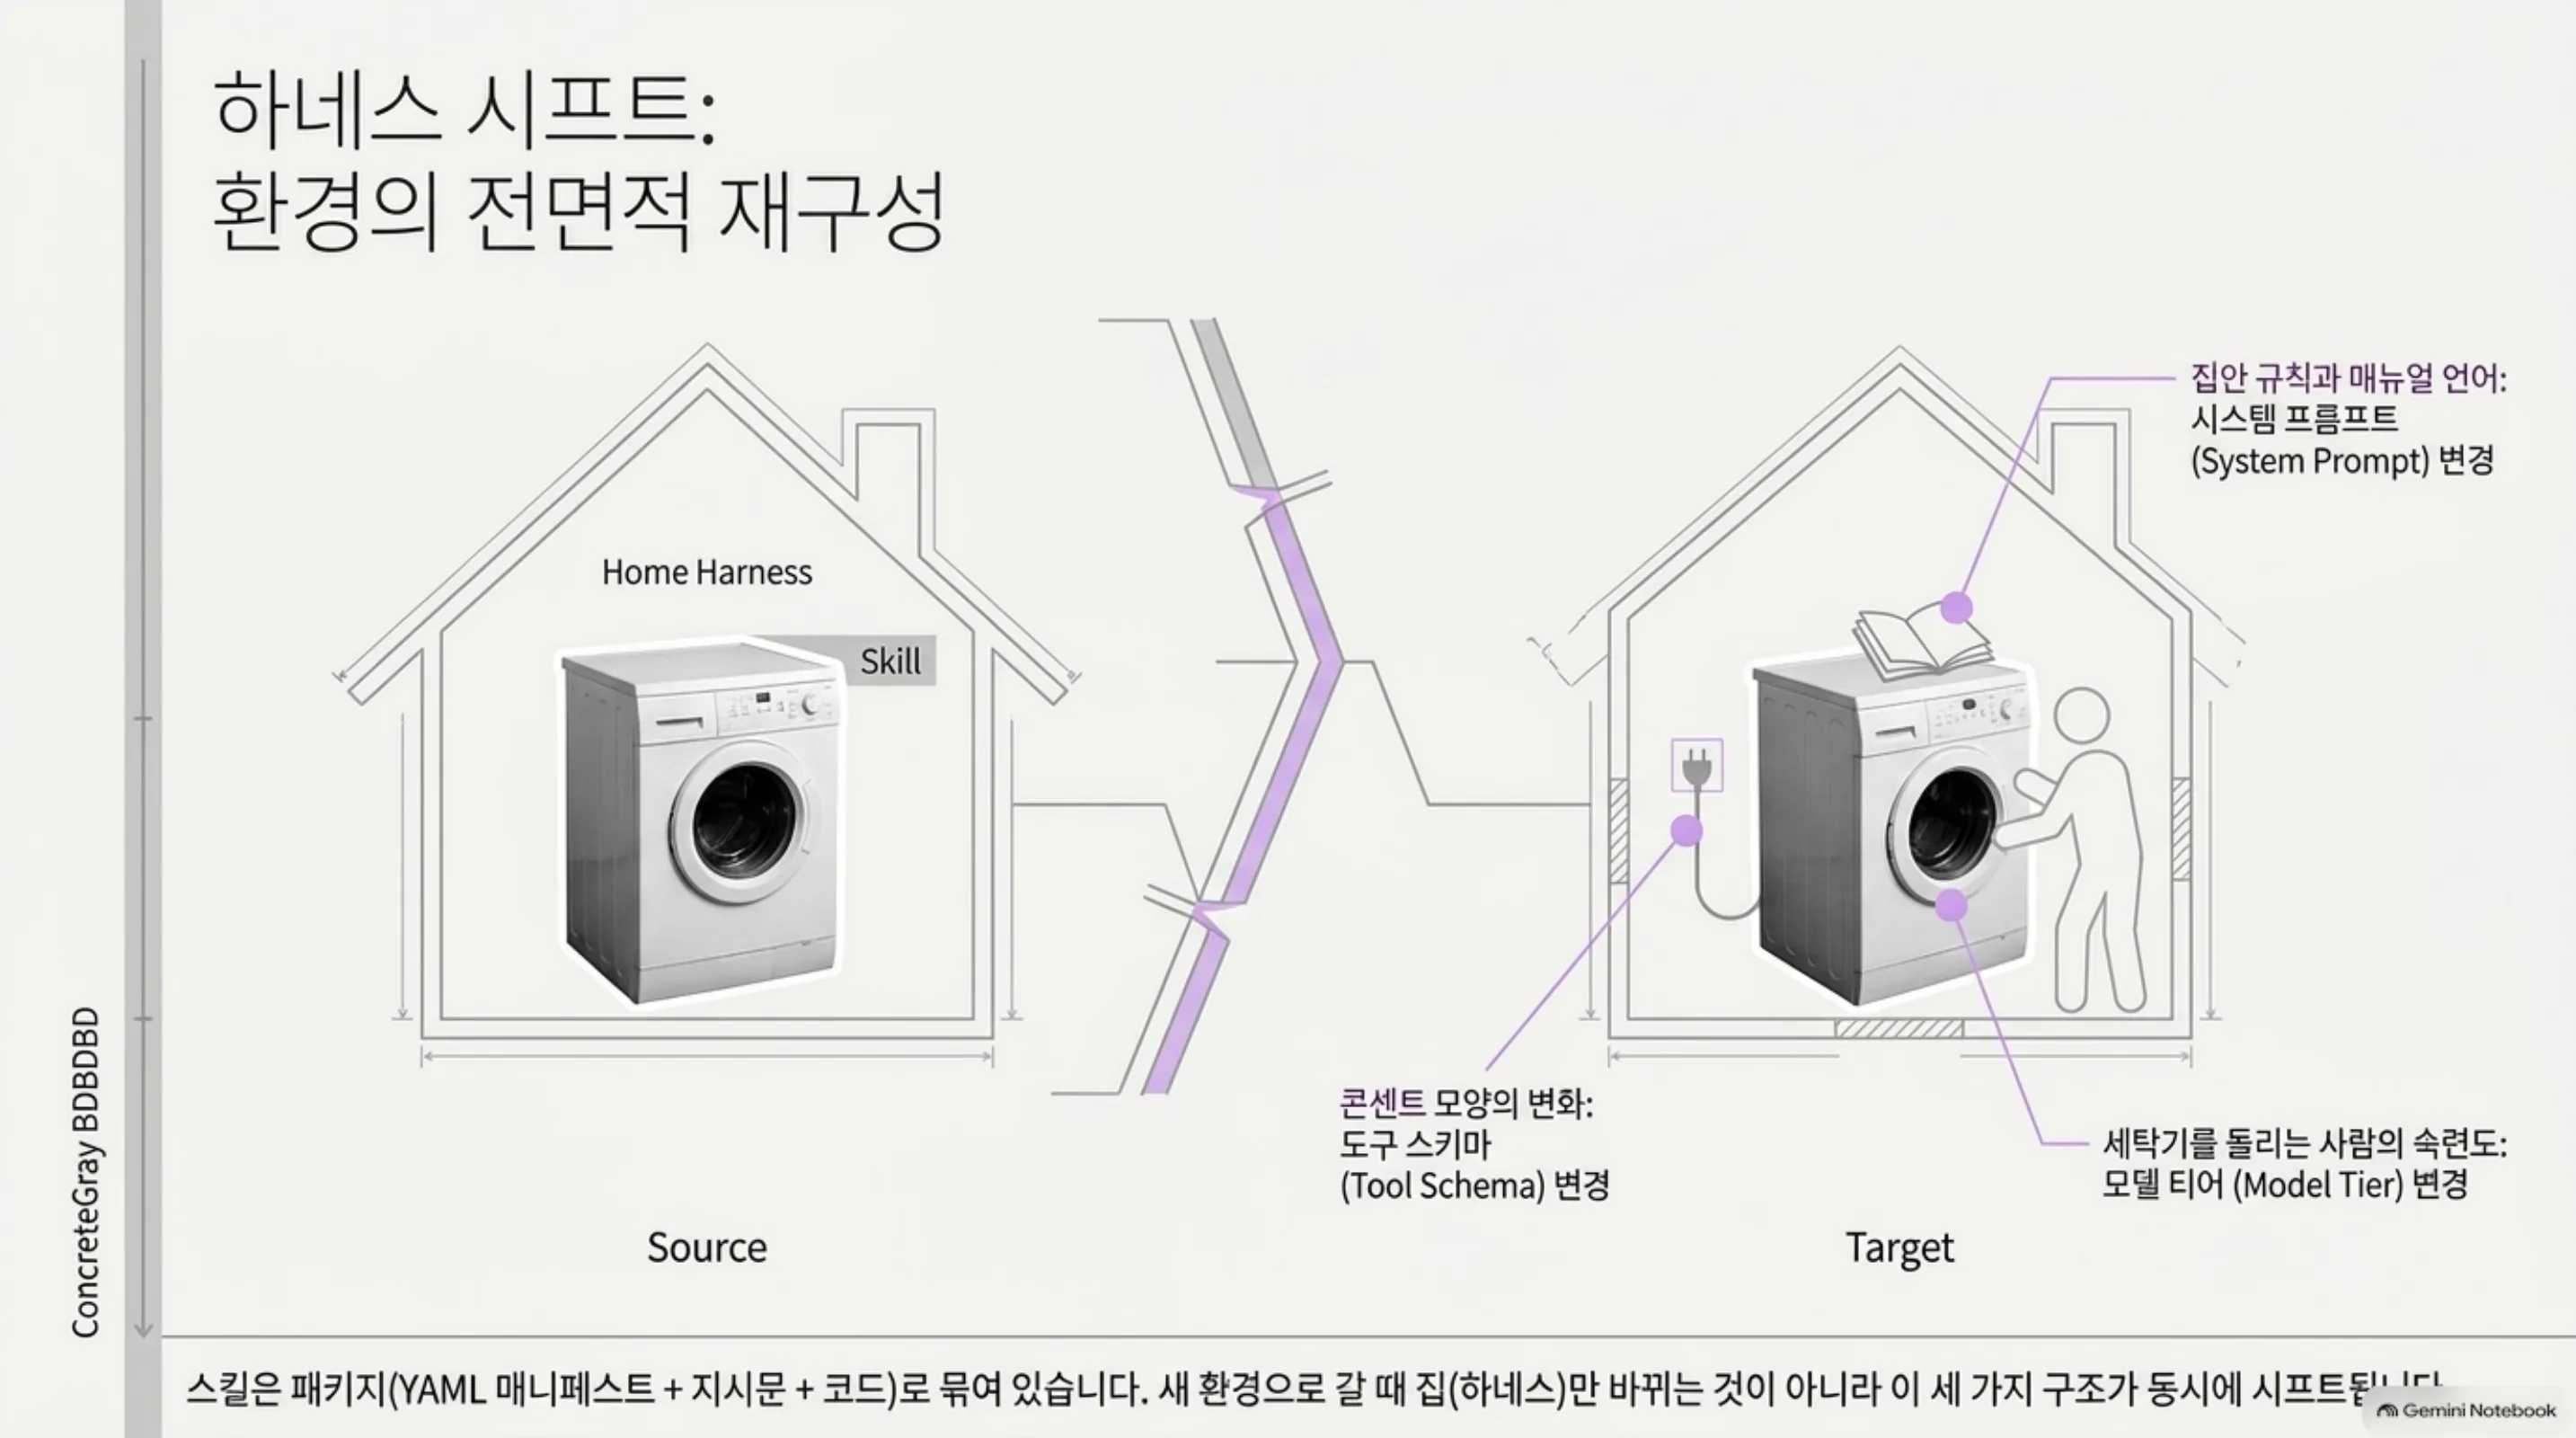
하네스는 모델보다 넓은 개념입니다. 시스템 프롬프트 환경(Π), 도구 스키마 관습(Σ), 모델 티어(μ)의 삼원조입니다. Π는 역할 규약, 게이트 훅 표현, 스킬 카드 문구, 언어를 담고, Σ는 이름·대소문자·인자 포장·오류 메시지 스타일을 정합니다. μ는 로컬에서 서빙되는 체크포인트의 정밀도와 크기 클래스입니다.
H200 같은 가속기에 추론을 셀프호스트하는 조직은 이런 삼원조를 병렬로 굴립니다. 프로덕션 게이트 훅 하네스 하나, 외부 사용자를 위한 최소 영문 하네스 하나, 용량 확보용 4비트 체크포인트, 지연 민감 마이크로태스크용 10억 파라미터 미만 체크포인트가 나란히 서빙됩니다. ThakiCloud의 플릿도 마찬가지입니다. 스킬 2,000개 이상이 여러 하네스와 모델 티어에 걸려 있습니다.
이것은 연구 문제이기 전에 배포 문제입니다. 수천 개의 스킬을 싣는 플릿은, 스킬이 착지하는 모든 하네스마다 다시 측정할 여력이 없습니다. 조직에 필요한 것은 둘입니다. 하나는 축별 보존률 측정으로, 이식할 스킬과 하네스마다 재조정할 스킬, 싸게 새 포장을 하면 되는 스킬을 가릅니다. 다른 하나는 이식 전에 보존률을 예측하는 스킬 속성입니다. 논문은 전자를 계수로, 후자를 모델로 줍니다.
지난 2년의 문헌은 하네스를 다른 방향에서 다뤘습니다. 적응 방법론은 스킬을 새 하네스에서 동작하도록 고치지만, 원래 능력의 몇 퍼센트가 남았는지는 답하지 않습니다. 학습 측 로버스트니스는 포스트 트레이닝에서 모델이 시프트를 견디게 하지만, 자산 자체는 측정되지 않고 동결 체크포인트에는 적용되지 않습니다. 런타임 포트러빌리티는 코드를 이동시키지만, 측정된 능력은 이동시키지 않습니다. 하네스를 변인으로 두는 연구는 고정 자산 아래 에이전트 행동을 재지만, 그 결과는 스킬 자산의 보존률로 읽히지 않습니다. 스킬 이전 연구는 자산을 태스크·팀·모델 패밀리 간으로 옮기며, 하네스는 고정합니다.
그 지도에서 비어 있던 칸이 하나 있었습니다. 그것은 고정된 스킬 집합을 하네스 간으로 옮기고 세 축을 격리해 보존률을 재는 칸입니다. 이 논문이 그 칸을 채웁니다. 소프트웨어 포트러빌리티 분석을 LLM 스킬 세계로 확장한, 자산 레벨 크로스 하네스 이식의 첫 통제된 팩토리얼 연구입니다.
자산은 매니페스트(SKILL.md)와 바디의 쌍입니다. 매니페스트는 프론트매터, 트리거 설명, 도구 계약 텍스트를 담고, 바디는 지시문과 스크립트를 담습니다. 이식 정책은 둘뿐입니다. 그대로 이식(verbatim)은 도구 이름, 인자 키 같은 표면 토큰까지 소스 관습에 머문 채 보냅니다. 재래핑(re-wrap)은 매니페스트와 바디의 관습 의존 토큰에만 1:1 재명명 맵을 적용하며, 표면이 아닌 “카드” 텍스트는 그대로 둡니다.
측정은 고정 태스크 스위트 위의 세 지표입니다. 각 태스크에는 정답 스킬과 정답 도구 호출 시퀀스가 매겨 있습니다. 결정론 라우터 r_h는 각 매니페스트를 해당 하네스 아래에서 렌더링해 랭킹 리스트를 반환합니다. 로딩 지표 ℓ_h(i)는 정답 스킬이 상위 k에 들었는지 표시하고, 채점기 g는 정확한 도구 이름, 필수 인자 존재, 타입, 정답 값 일치로 호출 시퀀스를 판정합니다. 리스트는 집합으로 비교합니다.
S_h가 태스크 성공률, L_h가 라우팅 리콜(로딩), J_h가 로드되고 실행된 태스크의 비율(합)입니다. 각 지표의 축별 보존률 R = M_h / M_h는 (0, 1]에 있고, 이식 갭 G = 1 - R입니다. 이식은 홈에서 동작하는 스킬(S_h > 0)에 대해서만 정의됩니다. 홈에서 실패하는 스킬은 보존률 회계에서 제외되며, 그 유병률은 별개의 실측 문제입니다.
검증은 동결된 2×2×2 팩토리얼 프로토콜로 설계됐습니다. 모든 축 레벨에서 결정론적이고, 모든 채점기와 스코어는 동결되어, 어떤 구현자든 같은 셀을 재현할 수 있습니다. 서브스트레이트는 페이지드 KV 엔진(vLLM 계열) 위의 셀프호스트 H200 단일 인스턴스이며, 8개 이식 셀은 모두 거기서 서빙됩니다. 매니페스트를 턴마다 재전송하는 고정 접두사 비용은 P·Σ 축에서 구조적으로 일정하게 유지되고, 서빙 체크포인트가 바뀌는 것은 T 축뿐입니다. 토큰당 단가는 비용 회계를 위해 미리 선언됩니다.
축 레벨은 둘씩입니다. P 축의 홈은 프로덕션 게이트 훅 스킬 카드 관습, 스코어링·권장 표현, 배포 언어 프롬프트이고, 이식은 최소 일반 영문 시스템 프롬프트입니다. Σ 축의 홈은 run_snake 같은 이름, parameters 포장, snake_case 키이고, 이식은 execute{Pascal} 같은 이름, params 포장, camelCase 키입니다.
T 축의 홈은 셀프호스트 H200 위 약 27B 저정밀도(NVFP4) 체크포인트이고, 이식은 10억 파라미터 미만 로컬 체크포인트로 대조합니다. 카드 텍스트는 Σ 레벨 간에 동일하게 유지되고, 라우팅 코퍼스는 언어 변동이 스키마 축과 섞이지 않도록 고정 언어로 스키마 우선 재렌더링됩니다.
스킬 집합은 프로덕션 인덱스에서 뽑은 정답 스킬 10개와, 실제 설명을 가진 동일 패밀리 디스트랙터 40개입니다. 디스트랙터 경쟁은 소음이 아니라 이식의 일부입니다. 정답 패밀리당 결정론 태스크 프롬프트 10개를 배포 언어로 고정합니다. 채점은 sra_bench와 BFCL 스타일 AST 채점으로 동결되며, 판정 항목은 정확한 도구 이름, 필수 인자 존재, 타입 검사, 정답 값 일치, 리스트의 집합 비교입니다.
채점기 무결성도 프로토콜의 일부입니다. 판정 파이프라인의 상태 무결성 불변식과, 어떤 셀에 점수가 매겨지기 전에 반드시 통과해야 하는 카나리 태스크의 정답 시퀀스가, 이식 갭이 깨진 오라클의 산출물이 되는 것을 막아 줍니다.
라우팅 스코어는 동의어 확장을 둔 동결 결정론 IDF 가중 스코어입니다. 라우터 소스에서 프로그램으로 추출해 원문 그대로 임베드하므로 전사 오차를 배제합니다. 셀마다 고정 쿼리 세트에서 recall@5, 고정 게이트 점수 recall@5-gated, top-1을 기록합니다. 통계는 셀별 독립 상태를 둡니다. 셀이 깨지면 그 셀만 열화되고, 보고서는 그것을 명시합니다.
보존률 비교는 스킬 내부 페어링이며, 무작위화 단위는 스킬입니다. 성공률과 리콜에는 정확 이항(Clopper-Pearson) 구간을 붙입니다. 스킬별 로그 보존률 추가성 잔차 Δ_resid(a)가 프로토콜의 내장 누출계이며, 축 쌍별 단계 분리 누출을 정량합니다.
모델은 셀 비교로 검증할 가설을 네 개 줍니다. H1은 스키마 축이 채점기에 보이며 결합도에 집중된다는 것입니다. H2는 라우팅을 공결합 제약으로 보며, 스키마 축에서 셀 대다수의 로딩 보존률이 실행 보존률보다 낮을 것으로 봅니다. 매니페스트 재렌더링과 디스트랙터 경쟁이 실행보다 먼저 로딩을 때리기 때문입니다. H3은 티어 손실이 깊이와 함께 증폭되고, 채점 게이트는 부분 보험에 그친다는 것입니다. H4는 세 속성이 포트러빌리티를 예측하며, 분리 규칙의 합성 예측이 이식 결정을 랭크한다는 것입니다. 파일럿 규모에서는 Spearman 계수로 보고하고 탐색적이라고 표기합니다.
나온 결과
갭은 정확히 둘로 쪼개진다
계수의 진단 핵심은 게이트-구성 항등식입니다. 결정론 라우터 아래에서 합 지표 J는 로딩 L과, 로드된 태스크 위의 조건부 성공률의 곱입니다. 보존률로 쓰면, 합 보존률은 로딩 보존률과 실행 보존률의 곱이 됩니다.
로그 스케일에서는 한 걸음 더 나아갑니다. 합 이식 갭은 로딩 갭과 실행 갭의 합으로 정확히 쪼개집니다. 항등식이지 근사가 아닙니다. 갭은 로딩 갭이거나 실행 갭이며, 둘은 섞이지 않습니다. 전자는 새 관습에서 라우터가 스킬을 더 찾지 못하는 것이고, 후자는 모델, 채점기, 표면의 불일치입니다.
바인딩 축은 가장 음인 항이며, 지표에서 바로 읽을 수 있습니다. 즉, 사람 말로는 세탁기가 새 집에서 제 성능을 못 내면, 사서가 찾지 못하는지, 찾았어도 돌지 않는지를 바로 가를 수 있습니다.
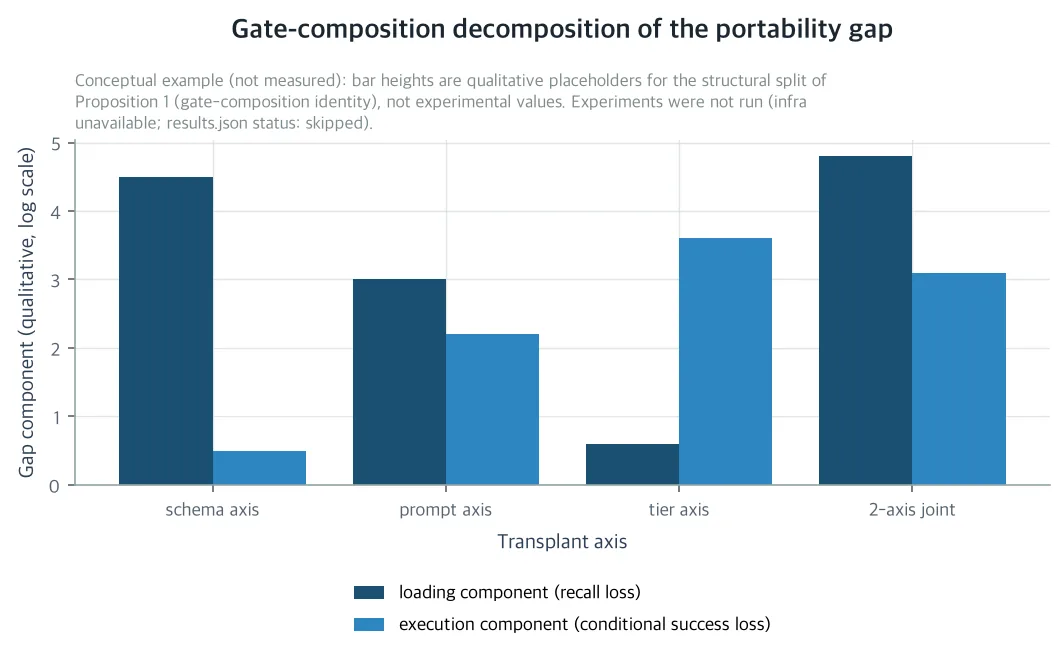 각 이식 축의 이식 갭을 로딩 성분(라우팅 리콜 손실)과 실행 성분(조건부 성공률 손실)으로 정확히 분해한 개념 다이어그램입니다. 바인딩 축은 지표에서 바로 읽을 수 있습니다. 분석 모델의 예시이며 실측이 아닙니다.
이식 전에 보존률을 계산해 주는 속성은 셋입니다. 스키마 결합도 κ_T는, 정답 태스크 중 적어도 하나의 필수 호출이 관습 의존인 태스크의 비율입니다. 도구 이름이나 필수 인자 키가 재명명 맵 아래에서 바뀌는 호출을 세는 것입니다.
프롬프트 앵커링 α는, 바디 구간 중 홈 프롬프트 관습(게이트 훅 표현, 스코어링·권장 문구, 배포 언어)을 전제하는 비중을 잰 것입니다. 티어 깊이 d̄는 정답 태스크당 순차 필수 도구 호출의 평균 수입니다. 셋 다 자산과 정답 스위트만으로 계산되며, 이식 실행이 필요 없습니다.
계보는 ThakiCloud의 앞선 연구에 이어집니다. 프로덕션 하네스의 스킬 1,600개를 측정한 그 연구는, 오라클 분해조차 스��� 커버리지 63.6%에 그쳤습니다. 라우터의 어휘 브리지는 공결합 제약으로 진단됐습니다. 이 논문은, 매니페스트를 새 스키마 관습과 프롬프트 환경으로 재렌더링한 뒤 그 잔여 라우팅 리콜이 얼마나 남는지 묻습니다.
스키마 축은 폐쇄형으로 닫힌다
모델은 단계 분리 조건에서 출발합니다. 라우팅은 (Π, Σ) 아래에서 렌더링된 매니페스트만 읽고, 실행은 바디·모델 티어·채점기만 읽습니다. 이 조건은 프로토콜의 구조로 성립합니다. 라우터는 바디를 보지 못하고, 채점기는 라우터 내부를 보지 못합니다. 축별 기속이 유효해지는 것이 바로 이 성질입니다.
스키마 축은 정리로 닫힙니다. 새 스키마 Σ’가 홈 관습과 1:1 표면 재명명 ρ_Σ만으로 다를 때, 그대로 이식의 실행 보존률은 R^S = 1 - κ_T입니다. 관습에 묶이지 않은 호출은 모델 불변성 덕분에 그대로 통과하고, 묶인 호출은 이름·인자 검사에서 전부 떨어집니다.
스키마에 완전히 결합된 스킬(κ_T = 1)은 침묵 부수를 보입니다. 트랜스크립트는 그럴듯해 보이지만, 관습 의존 호출이 AST 검사를 통과하지 못해 보상 기반 스킬 진화에 쓸 신호가 남지 않습니다.
재래핑 이식의 보존률은 1 - ε_ρ입니다. ε_ρ는 인터페이스 정렬 오류로, 재명명됐지만 의미가 같은 인터페이스를 모델이 잘못 재현할 확률입니다. 재명명 거리(대소문자, 키, 포장)와 κ_T가 커질수록 커집니다. 라우팅 쪽도 시프트합니다.
매니페스트 재렌더링은 설명에 심어진 관습 토큰을 통해 로딩 보존률을 1 - δ_ρ로 낮춥니다. 동결 IDF 스타일 스코어와 스키마 우선 재렌더링 아래에서는 δ_ρ가 셀마다 측정 가능한 상수가 됩니다.
채점기의 역할도 이 정리 안에 쓰여 있습니다. 관대한 의미론 채점기는 재명명을 구분하지 못해, 측정 가능한 스키마 갭을 지워 버립니다. AST 채점은 구조적으로 표면 감지이므로, 스키마 축의 기속에는 반드시 필요합니다.
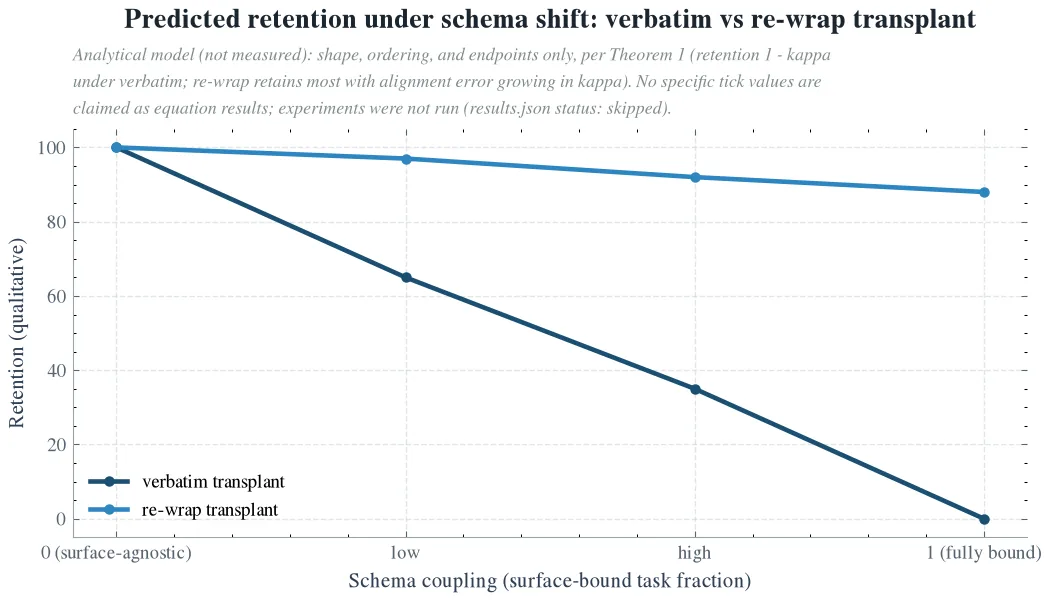 스킬의 표면 스키마 결합도가 커질 때, 그대로 이식과 재래핑 이식의 예측 보존률입니다. 그대로 이식은 결합도 1에서 0(total silent breakage)까지 단조로 떨어지고, 재래핑은 인터페이스 정렬 오류의 소폭 상승으로 높은 보존률을 유지합니다. y축은 정성적이며, 분석 모델의 예측이지 실측이 아닙니다.
티어 축은 깊이와 함께 증폭된다
티어 축은 깊이 증폭과 검증 경계가 닫습니다. 호출당 정확도가 홈 티어 p에서 이식 티어 p로 내려간다고 하면, 순차 필수 호출 d번이 필요한 태스크는 p^d로 성공합니다. 보존률은 태스크 분포 위에서 (p/p)^d의 기대값이며, Jensen 부등식으로 (p/p*)^d̄ 이상이 됩니다.
보존률이 평균 깊이 d̄와 함께 내려간다는 뜻입니다. 호출당 점수가 평평하게 보여도 다중 턴 손상이 작다는 뜻은 아닙니다. 그것을 가린다는 뜻입니다.
즉, 사람 말로는 한 동작의 점수가 평평해 보여도, 연속 동작이 늘수록 작은 실패 확률이 거듭제곱으로 커져 더 큰 손실이 됩니다.
무료 결정론 검증기를 끼우면 상승에 상한이 붙습니다. 호출당 성공은 배당 Δ = q·p_d/(1 - p_d)까지만 오르고, 그것도 δ(1 - p)로 캡됩니다. 침묵 오류 바닥 1 - p_s/(1 - p_d)은 어떤 재시도 예산으로도 넘을 수 없습니다.
약한 티어일수록 p_d가 작아, 보험은 갭이 가장 큰 곳에서 오히려 작아집니다.
게이트 대 티어 업그레이드의 교차점 p_d*(q) = 1 - 1/(q(3 - 2q))가, 셀마다 저티어 재시도가 싼지 티어 업그레이드가 싼지를 가릅니다. 이 식은 ThakiCloud의 앞선 연구(Validator’s Dividend)가 무료 결정론 검증기 아래에서 가격 매긴 것을, 이식 맥락으로 가져온 것입니다.
프롬프트 축은 앵커링이 닫습니다. 실행 보존률은 1 - α·η(μ) 이상입니다. η(μ)는 이종 환경에서 티어 μ의 앵커 구간당 성능 저화로, 강한 모델일수록 낯선 관습에 재적응이 잘 되므로, 프롬프트 손실은 높은 α 스킬에 집중되고 저티어에서 더 나빠집니다.
앵커 구간과 깊이 노출 호출이 함께 나타나는 곳에서는 P×T 합셀의 로그 보존률이 초가법(super-additive)이 됩니다. 합셀이 단일 축 셀 두 개의 합보다 나빠지는 것입니다. 세 축은 합계 지표에서 대칭적이지 않습니다.
순수 스키마 쇼크는 로딩 보존률과 그대로 이식 분기의 실행 보존률로 작용하고, 순수 티어 쇼크는 조건부 성공으로, 순수 프롬프트 쇼크는 둘 다로 작용합니다. 각 단일 축 셀은 (R^L, R^S̃) 평면에 특유의 시그니처를 남깁니다. 이것이 2×2×2 팩토리얼 설계를 스트레스 테스트가 아닌 측정 계기로 읽게 합니다.
이식, 재조정, 재생성을 가르는 예산
플릿 단위 결산은 예산 식으로 닫힙니다. V_f는 스킬 패밀리 f의 하네스당 가치, 즉 태스크 볼륨 × 태스크당 유틸리티입니다. C_t는 재래핑·재렌더링·재채점을 포함하는 일회성 이식 비용이고, C_r은 하네스당 재조정 비용, C_g는 목표 하네스에서 패밀리를 재생성하는 비용입니다.
두 번째 하네스로의 이식은, 보존된 가치가 이식 비용을 지울 때만 이식할 가치가 있습니다. R^J·V_f - C_t ≥ 0. 이식이 재생성을 이기는 조건은 R^J ≥ 1 - (C_g - C_t)/V_f입니다. 두 문턱 모두 이식을 돌리기 전에 계산할 수 있습니다.
즉, 사람 말로는 이사비(이식 비용)와 새 집 가치(보존된 가치)를 대조하면, 이사할지 고칠지 새로 살지를 이사 전에 알 수 있습니다.
스키마 정리, 티어 정리, 프롬프트 명제를 합치면 최적 이식 정책 φ*의 폐쇄형 분리가 나옵니다. κ_T ≈ 0의 표면 무관 패밀리는 그대로 이식입니다. κ_T ≫ 0이고 α가 낮으며 d̄가 티어 예산 안에 있으면, 1 - ε_ρ가 손익분기 문턱을 넘을 때 재래핑으로 갑니다. α·η(μ)나 깊이 증폭 티어 손실이 문턱을 막으면 하네스마다 재조정하고, 어떤 정책도 문턱을 넘지 못하면 재생성으로 결정합니다. 분리는 패밀리마다 네 층 중 하나를 가리키고, 계수는 그 층을 이식 전에 읽습니다.
플릿이 주기당 n_f개의 새 패밀리를 계속 만든다면, 그 노력은 이식 가능 층에서만 플릿 규모로 복리됩니다. 플릿 가치 식의 지표 1[R^J > θ*]가 그 스위치입니다. 스키마가 다른 목표 하네스를 향해 κ_T ≈ 1 패밀리를 만드는 노력은, 하네스마다 복제해야 하는 노력이며, 계수는 그 사실을 앞서 읽습니다.
비용 쪽에도 가격이 붙습니다. 재렌더링된 매니페스트는 고정 접두사를 바꾸고, 접두사 경제 모델(Manifest Order)로 가격 매긴 턴당 재전송 토큰은 C_t에 더해져야 합니다. 능력 계수만으로는 보이지 않는 항입니다.
그래서 무엇을 바꾸면 되나
첫째, 이식 전에 계수로 가릅니다. 스키마 결합도·프롬프트 앵커링·티어 깊이를 재면, 플릿 전체에 이식할 패밀리와 하네스마다 재조정할 패밀리와 재생성할 패밀리가 나뉩니다. 그 판단이 직감에서 예산 식으로 이동합니다. 로딩을 깨는 이식은, 실행이 무엇을 유지하든 스킬을 포기하게 만듭니다.
둘째, 매니페스트 재렌더링은 무료 변환이 아닙니다. 라우팅 자산의 비용이며, 고정 접두사를 바꿔 턴당 재전송 토큰을 늘립니다.
셋째, 티어 보험은 가격 매겨져 있습니다. 무료 결정론 검증기는 배당 Δ까지만 올려 주며, 침묵 오류 바닥은 재시도로 넘을 수 없습니다. 교차점 p_d*(q)로 셀마다 저티어 재시도와 티어 업그레이드 중 싼 쪽을 고릅니다. 낮은 티어는 지연의 선택입니다.
넷째, 계속되는 스킬 생성 노력을 이식 가능 층에 모읍니다. 다른 스키마의 하네스를 향해 완전 결합 패밀리를 만드는 노력은 하네스마다 복제될 뿐이며, 계수는 그것을 앞서 읽습니다.
이식 가능하고 상호운용 가능한 스킬 자산은, 조직과 모델 공급자를 가로질러 LLM 워크플로 자동화의 배포 비용을 낮춥니다. 분야는 패키지형 스킬 산출물로 수렴하고 있으며, “옮겼을 때 몇 퍼센트가 남는지”를 재는 공통 계수가 있으면, 그 기준은 누군가의 내부 도구에서 오픈 크로스 하네스 스킬 표준의 측정으로 이동합니다. 이 논문은 그 표준이 먼저 요구하는 계수를 놓는 구체적 한 걸음입니다.
못 믿을 부분
이 논문의 모든 주장은 분석적입니다. 프로토콜은 측정 계기이고, 셀 추정값은 프로토콜을 실행해야 나옵니다. 본문에서 인용하는 외부 숫자는 인용 연구의 것이며, 이 글의 두 그림도 분석 모델의 정성적 형상입니다.
단계 분리는 전제이고, 누출은 잔차로 측정합니다. 매니페스트 내용이 실행으로 새면 게이트-구성 항등식의 정확성이 깨집니다. 호출 시 모델이 읽는 계약 텍스트가 그런 경우입니다. 축 기속은 추가성 잔차 Δ_resid만큼만 깨끗합니다.
파일럿 규모는 정답 스킬 10개입니다. H4는 가설 생성에 그치며, 문턱 θ*를 프로덕션 분리에 넣기 전에 더 큰 홀드아웃 패밀리 풀이 필요합니다.
티어 축은 2레벨입니다. 한 엔진 계열 안에서, 약 27B 저정밀도(NVFP4) 체크포인트와 10억 파라미터 미만 체크포인트의 대조뿐입니다.
양자화 스윕 문헌(8비트~2비트)은 선행 정보로 가져오고 다시 스윕하지 않습니다. 클라우드 API 하네스와 다른 엔진 계열은 범위 밖입니다.
채점기 민감도는 양면입니다. AST 채점은 그대로 이식 체제를 보이게 하지만, 의미론 채점기가 용서할 옅은 차이까지 벌점합니다. 보존률은 (자산, 채점기) 쌍의 속성이며, 채점기 간 비교는 재기속을 요구합니다.
스킬은 유지보수, 자기 진화, 범위 확장으로 시간이 지나며 바뀝니다. 이식은 이사 당일의 스냅샷이며, 오늘의 자산에서 재는 보존률은 다음 달 리비전까지 보장되지 않습니다.
논문 원문과 수반 자료는 여기에서 볼 수 있습니다: The Transplant 데이터셋
본문의 모든 수는 분석 모델의 예측이며 실측이 아닙니다. 두 그림은 분석 모델의 정성적 형상입니다.
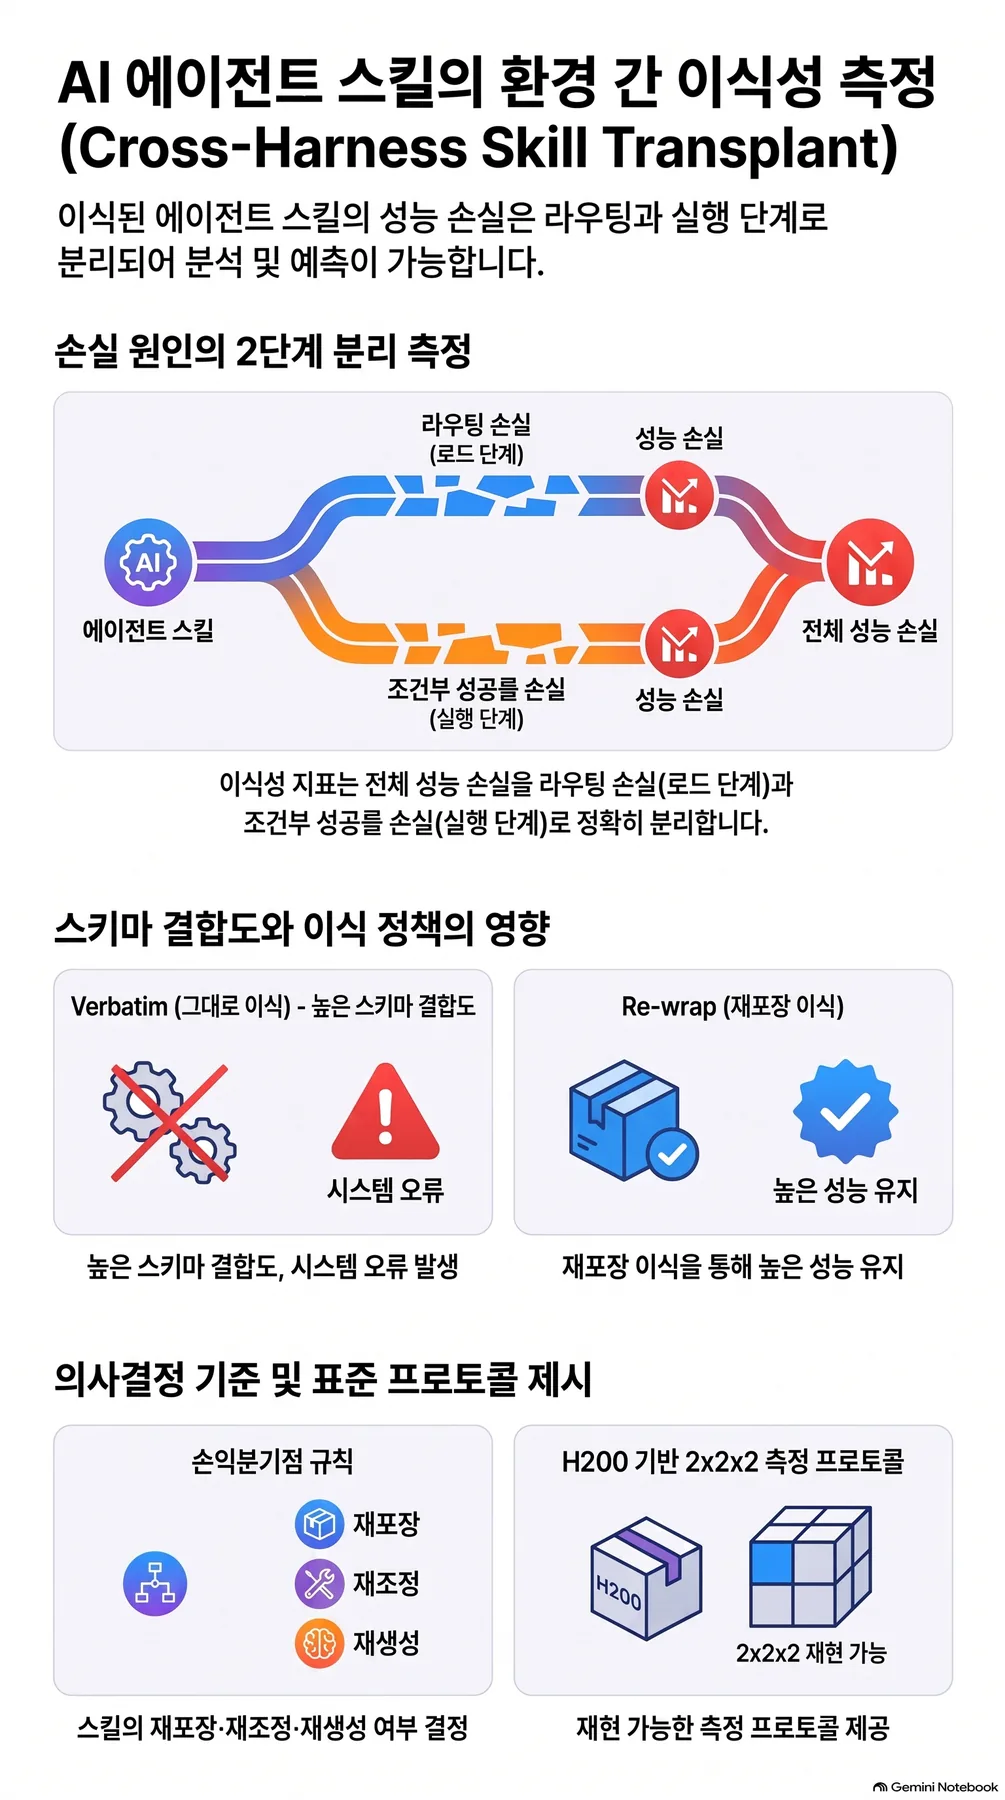 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
