19.2%짜리 1위
모델 랭킹의 1위를 골라 바로 쓰려는 독자라면, 오늘 아침의 뉴스는 경고입니다. 그 경고의 핵심은 한 줄이기 때문. 오픈웨이트 법률 AI의 새 1위, Zai의 GLM-Legal이 받은 성적은 19.2%였습니다.
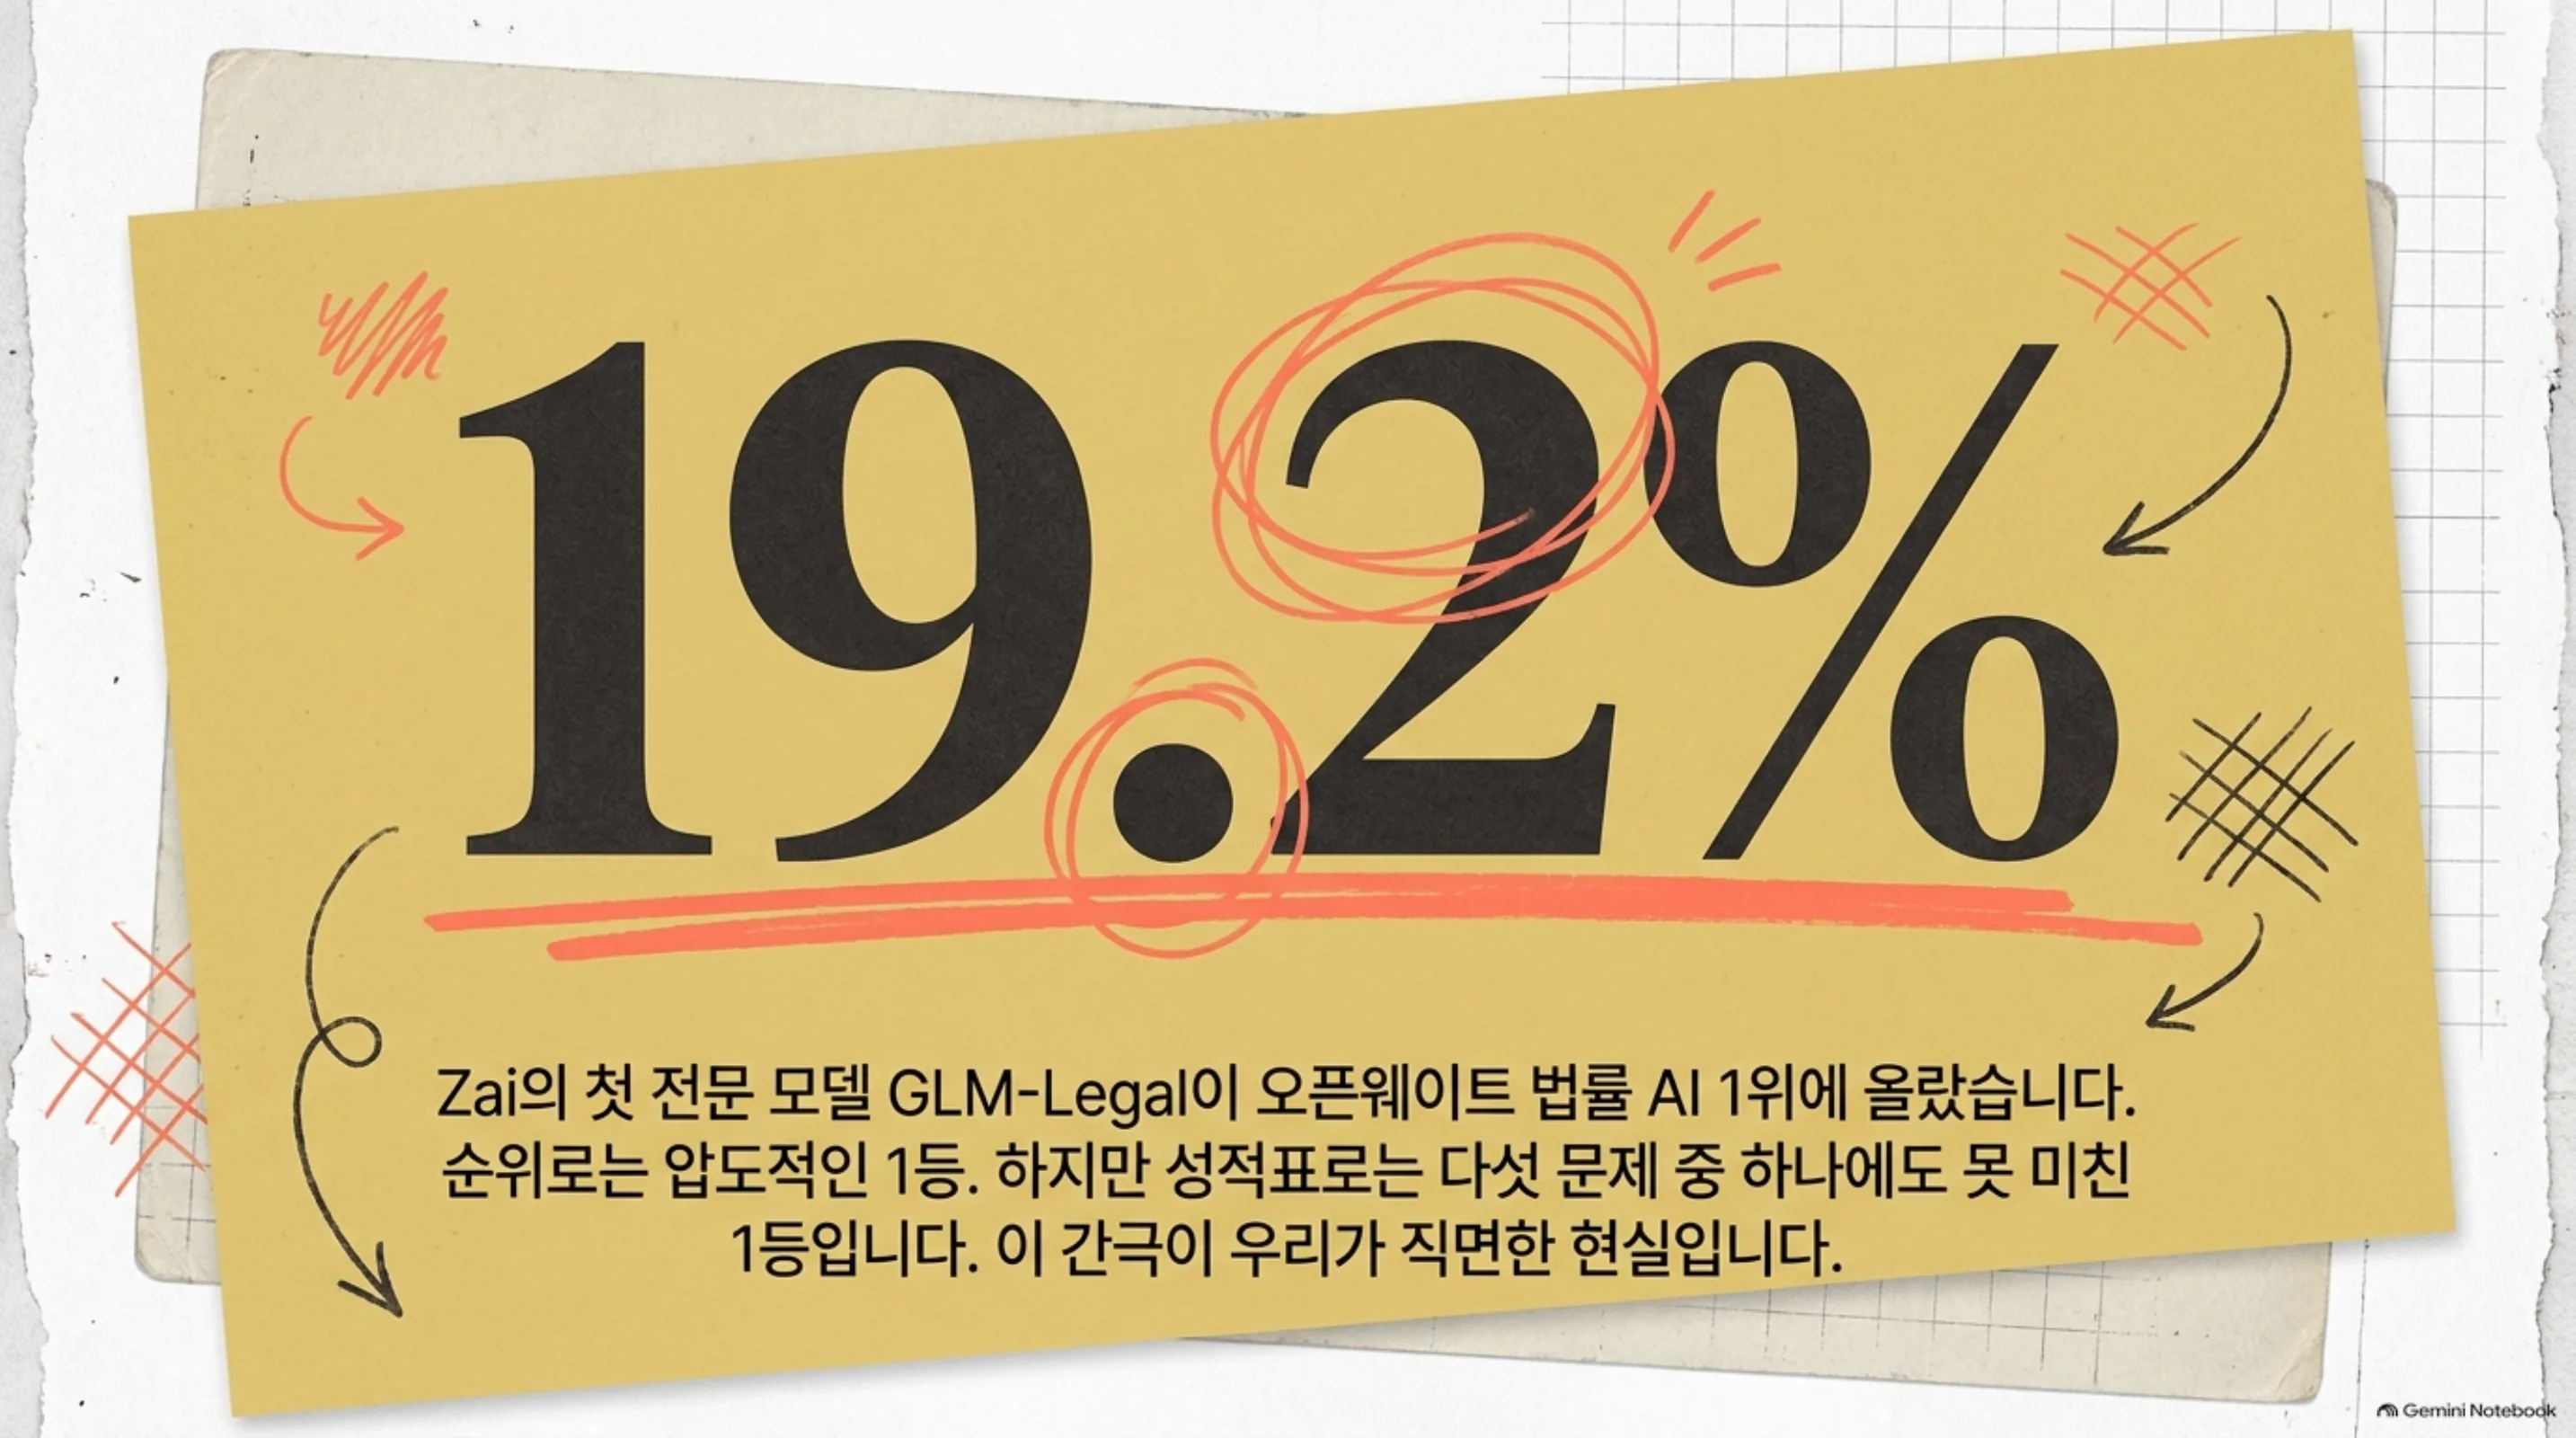
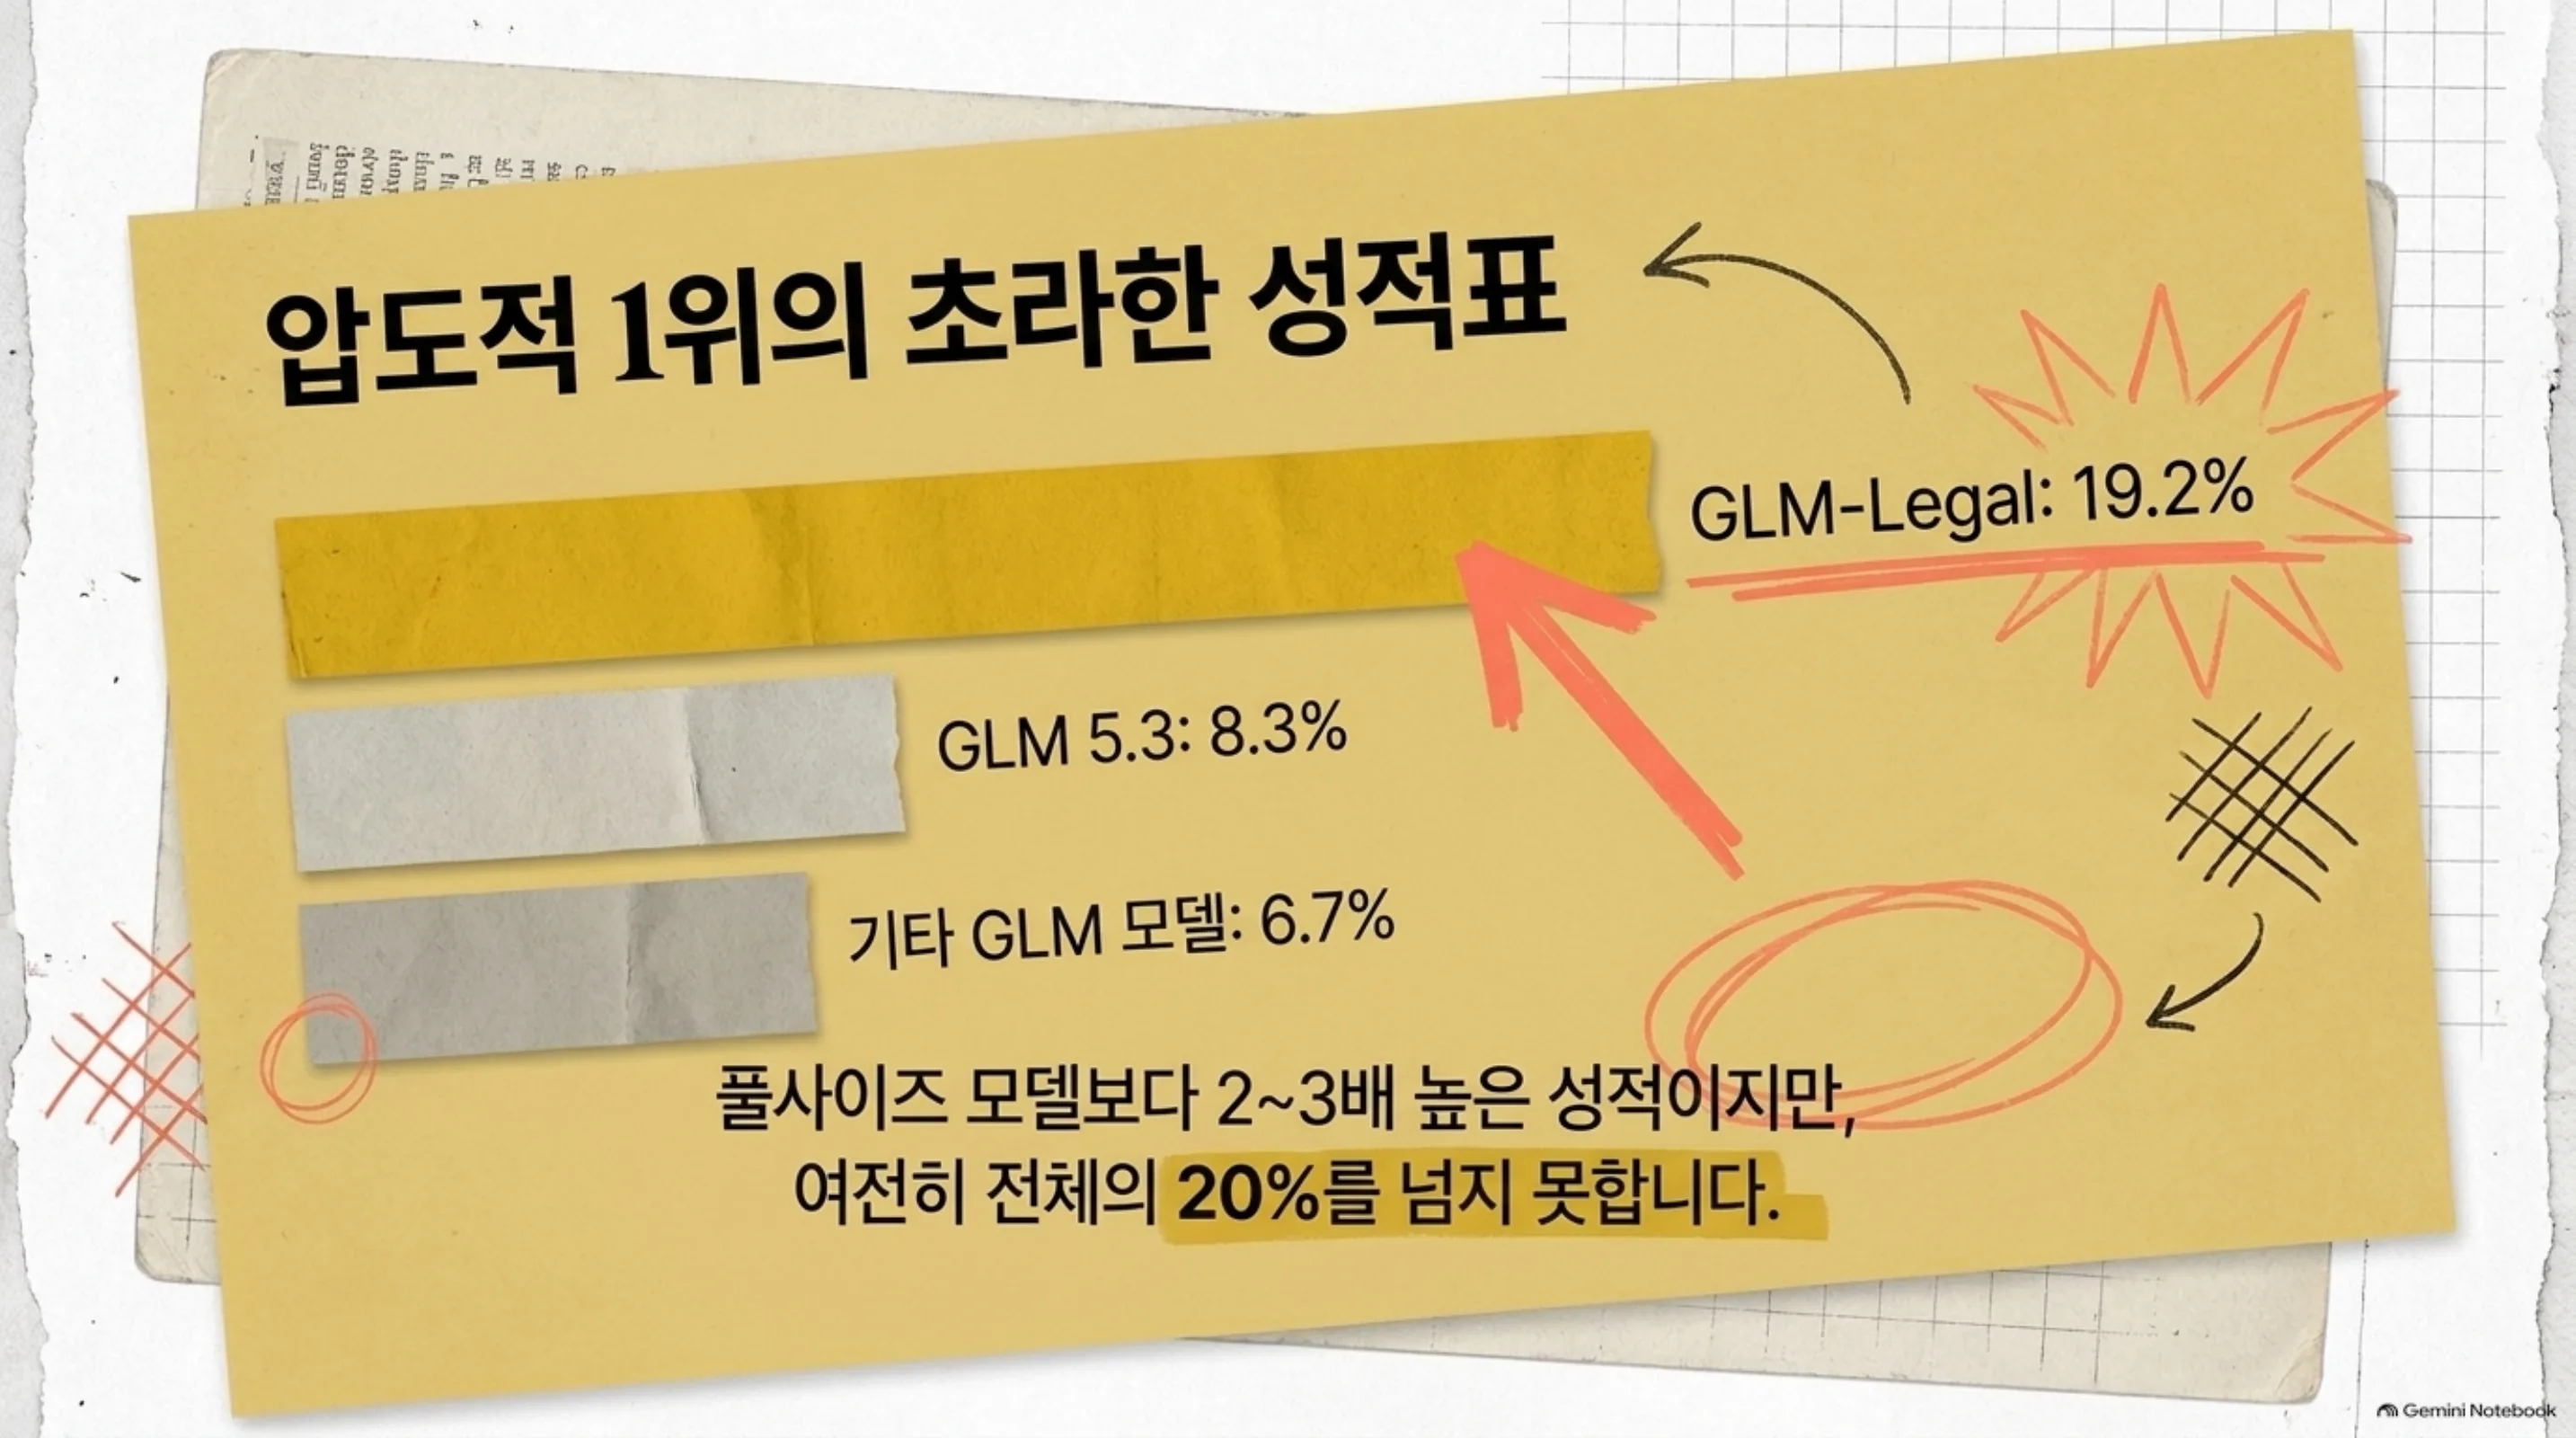
Zai는 첫 전문 모델 GLM-Legal을 공개하며 오픈웨이트 법률 AI 분야에서 1위에 올랐습니다. Harvey의 Legal Agent Benchmark에서 GLM-Legal은 19.2%를 기록했습니다. 풀사이즈 GLM 5.3의 8.3%보다 두 배 이상, 다른 GLM 모델의 6.7%보다 세 배 높습니다. 순위로는 압도적인 1등, 성적표로는 다섯 문제 중 하나에도 못 미친 1등. 이 간극이 오늘 아침의 시작입니다.
 글의 핵심 개념을 형상화했습니다.
이 뉴스의 낯선 점은 숫자가 다 참이라는 것입니다. 1위, 두 배, 세 배. 하나같이 사실입니다. 그런데도 ‘법률 AI 1위’라는 문장이 ‘회사에서 써도 되는 AI’라는 문장까지는 안 됩니다. 그 사이를 19.2%가 차지합니다. 법률이라는 분야를 골라도 마찬가지입니다. 문서와 권한과 기록이 함께 도는 분야에서, 점수보다 먼저 정해져야 할 것은 실행 방식입니다. GLM-Legal은 Zai의 첫 전문 모델입니다. 오픈웨이트 회사가 첫 전문화 영역으로 법률을 택했다는 것은, 업계가 모델을 ‘맡길 수 있는 곳’으로 먼저 보는 분야가 어디인지를 보여 줍니다.
1위가 쏟아지는 아침
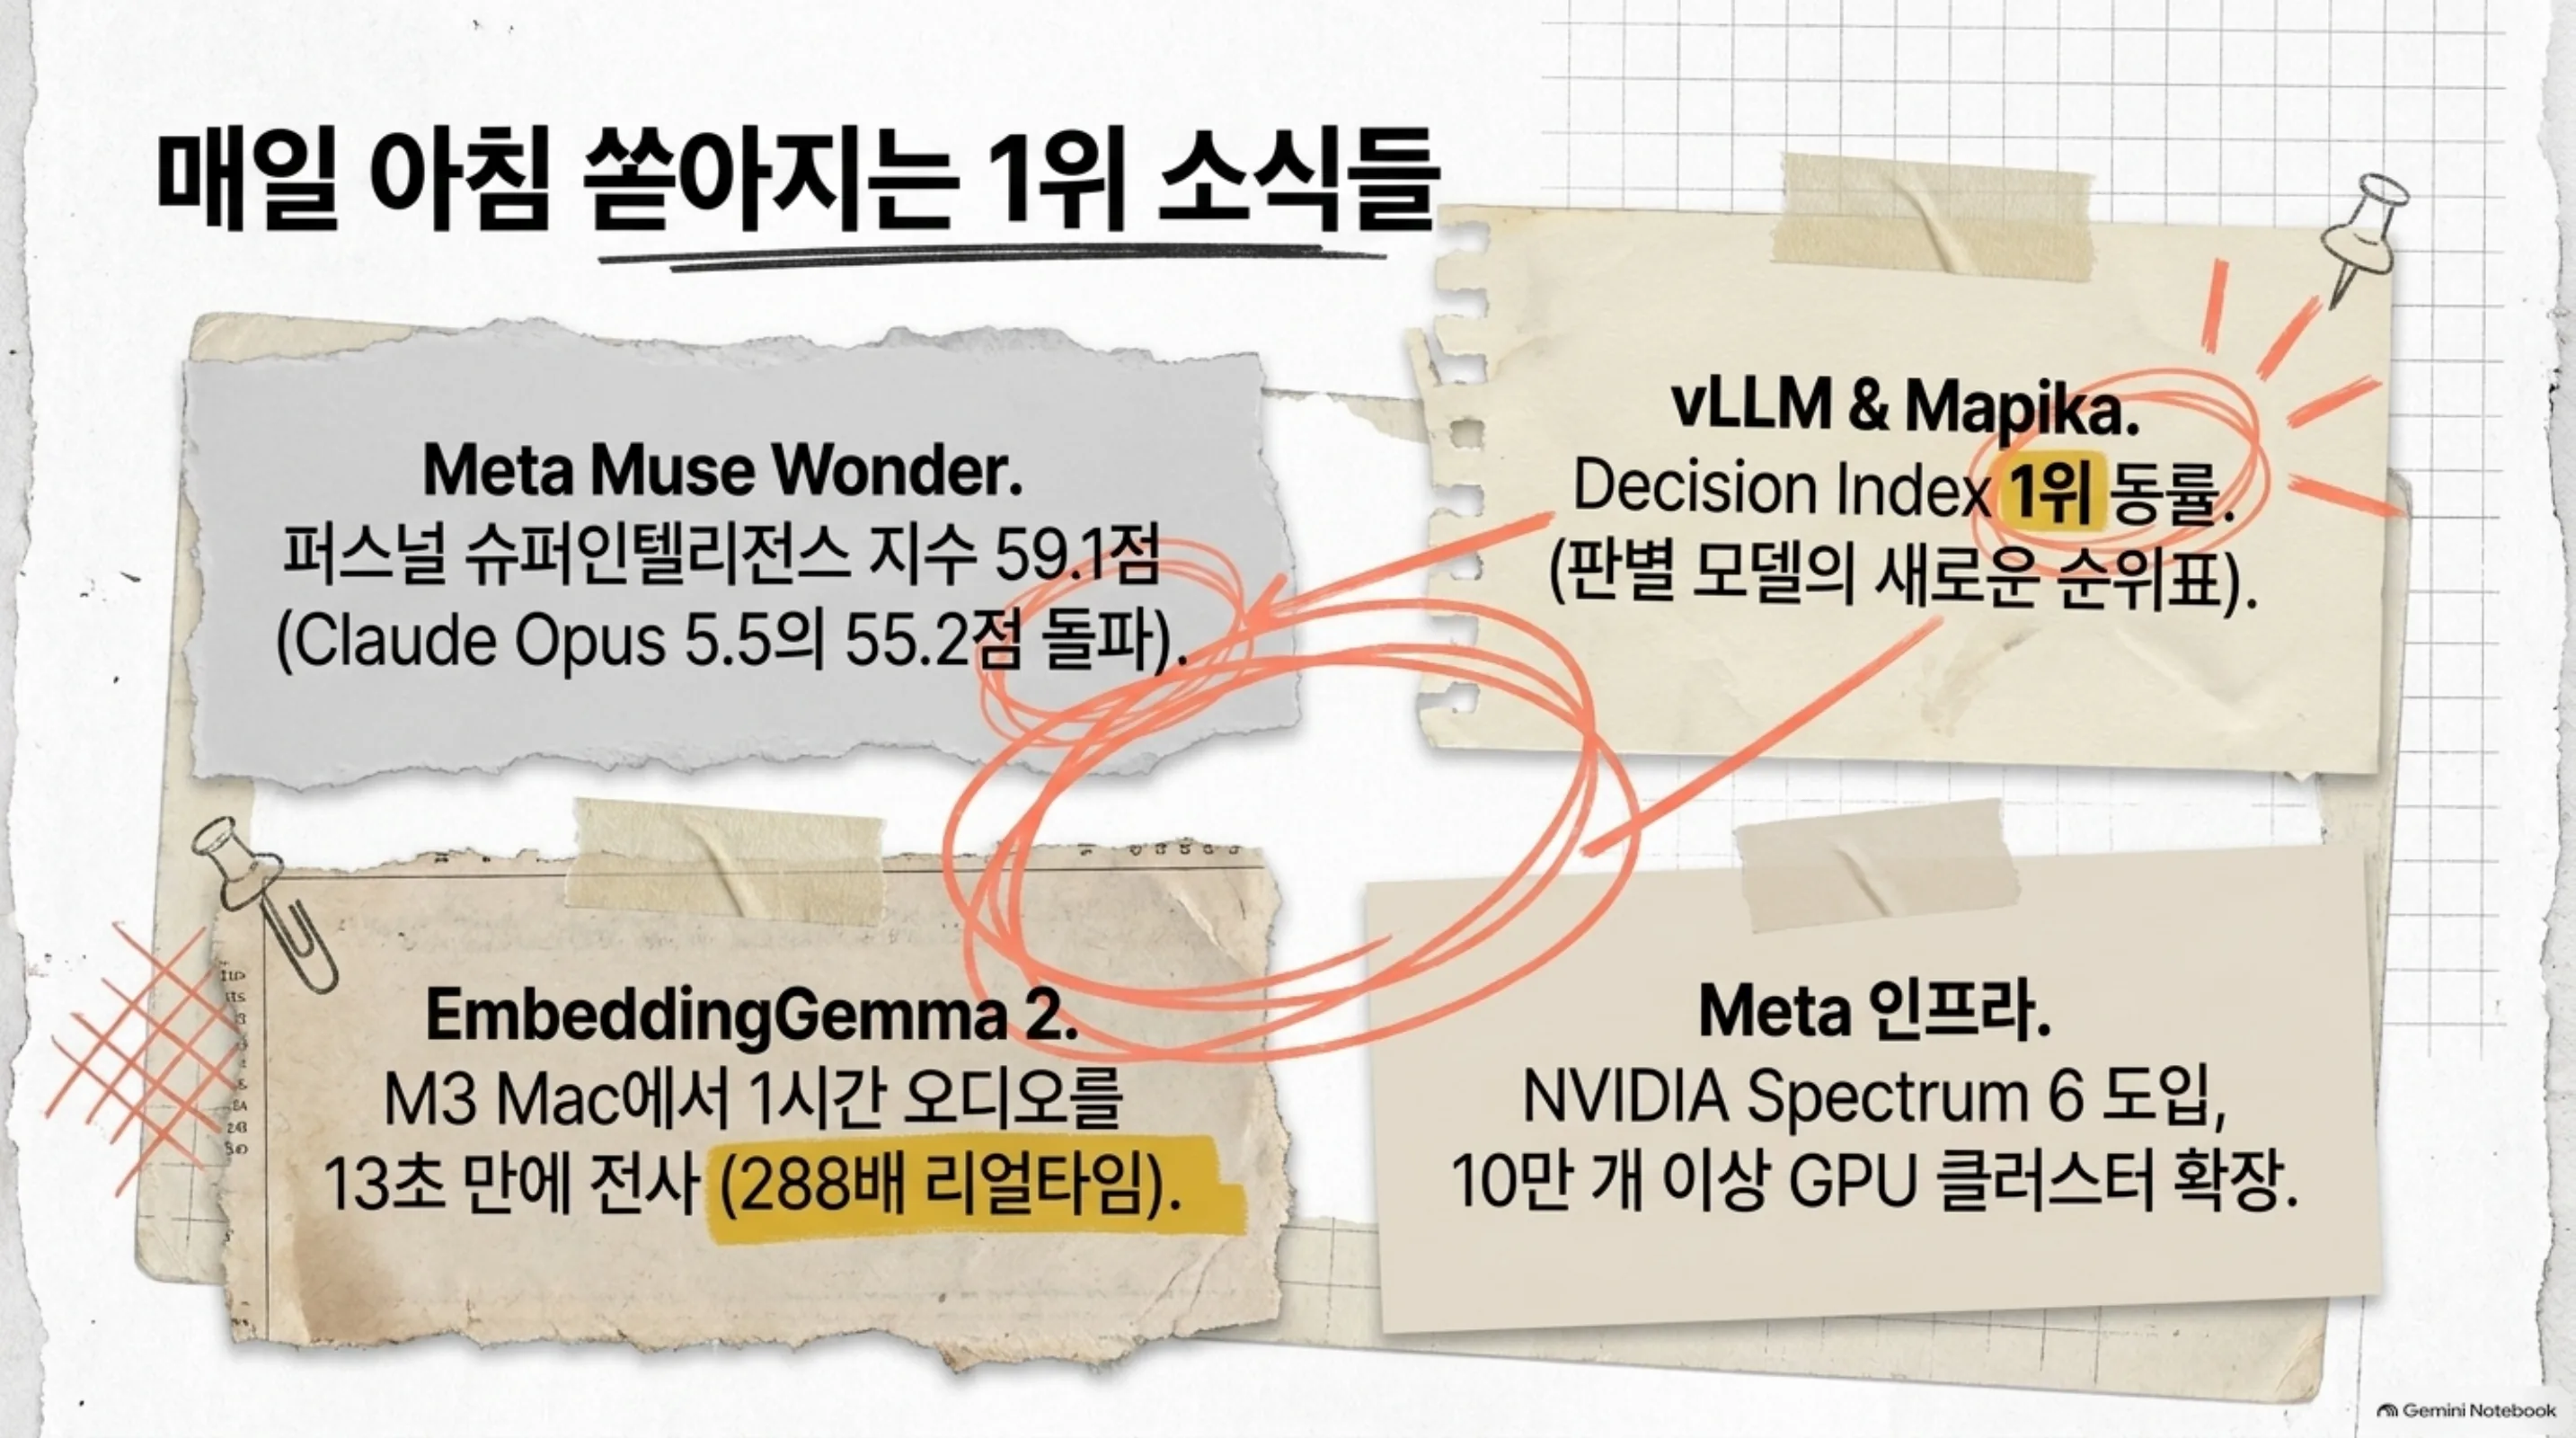
오늘 아침 다이제스트에는 1위 소식이 또 있습니다. 메타의 Muse Wonder Full은 퍼스널 슈퍼인텔리전스 지수에서 59.1점을 기록해 앤스로픽 Claude Opus 5.5의 55.2점을 넘었고 GPT-6마저 제치며 프런티어에 닿았다는 평가를 받았습니다. 이 지수의 이름에서 ‘퍼스널’이 눈에 옵니다. 개인 사용자에게 닿는 지능을 재는 잣대입니다. 슈퍼인텔리전스라는 단어가 이제 개인 단위의 점수로 측정되는 시점입니다.
vLLM Decision 3.0과 Mapika Decider는 새로 나온 멀티모달 지표 Decision Index에서 1위 동률을 이뤘습니다. 디스크리미네이터, 즉 판별 모델의 순위가 다시 짜인 것입니다. 왜 판별 모델에 순위표가 새로 생겼느냐. 에이전트 시스템은 스스로 판단하고 검증하기 때문. 만들어지는 쪽에 순위표가 있는 것처럼, 판단하는 쪽에도 순위표가 새로 생깁니다.
한 개발자는 Google의 멀티모달 모델 EmbeddingGemma 2를 원래 용도와는 다른 음성 인식 도구로 재구성했습니다. 기본 사양 M3 MacBook Air에서 288배 리얼타임 속도를 냅니다. 1시간짜리 오디오를 13초 만에 전사하는 것입니다. 1시간의 오디오가 눈 깜짝할 사이의 13초가 되는 일. 임베딩 모델을 전사 도구로 부르는 장면은, 모델이 설계된 용도 밖으로 걸어 나왔다는 뜻입니다. 288배라는 숫자는 또 다른 의미도 담고 있습니다. 같은 작업을 큰 모델로 하면 몇 배의 비용이 드는가가 모델별로 달라진다는 뜻입니다.
메타는 오늘 뉴스에서 두 번 얼굴을 내밀었습니다. 프런티어에 닿았다는 모델 하나, 클러스터를 키운다는 뉴스 하나. 모델의 1위와 인프라의 확장이 같은 아침에 나란히 놓인 것입니다.
1위가 답하지 않는 질문
1위가 답하지 않는 질문이 따로 있습니다. 그 순위로 무엇을 할 수 있느냐.
GLM-Legal의 19.2%를 Harvey 벤치마크의 문제로 보면, 다섯 문제 중 하나에도 못 미치는 해결률이다. 남은 80%는 사람의 손으로 넘어가는 업무다. 법률 문서의 초안을 에이전트가 쓰고 사람이 검수하는 구조라면, 사람 몫이 80%인 1위는 점수표의 1위일 뿐이다. 현장의 절반은 아직 사람의 몫이다.
이것은 벤치마크 경제의 두 번째 얼굴인 셈이다. 잣대가 새로 생기면 1위도 비례해 생기는 것이다. 퍼스널 슈퍼인텔리전스 지수, Decision Index, Harvey의 법률 에이전트 벤치마크. 분야마다 자기만의 잣대가 서고 잣대가 서면 순위표가 따라옵니다. 그런데 어느 잣대도 ‘그대로 맡겨도 되는가’라는 질문을 재지 않는 것입니다.
운영의 관점에서 보면 19.2%는 실패가 아니라 설계 자료입니다. 80%가 사람의 몫인 지금, 에이전트를 쓸 회사의 첫 과제는 워크플로를 세우는 일입니다. 에이전트가 초안을 쓰고 사람이 80%를 검수하는 순서. 그 검수 기록은 다음 이터레이션의 자료가 됩니다. 19.2%짜리 모델은 80%의 사람 검수 루프와 묶이면 오늘로서는 나쁜 제품이 아닙니다. 루프가 프로세스로 설계된 한, 점수는 시작점입니다. 천장까지의 거리는 그 루프가 채웁니다.
Muse Wonder의 59.1점과 GLM-Legal의 19.2%는 서로 다른 잣대의 점수라 더할 수 없습니다. 하지만 나란히 읽으면 한 줄이 보입니다. 모델 업계는 1위를 만들어내는 데에는 익숙합니다. 실제로 일하는 1위는 아직 드뭅니다. 둘 사이의 거리가 오늘의 주제입니다.
80%를 처리하는 자리
그 80%를 어디에서 처리하느냐가 오늘의 진짜 화제입니다.
앤스로픽은 IoT 하드웨어에서 AI 웜의 최초 징후를 감지했다고 밝혔습니다. 보안 평가에서 90억 파라미터 모델 하나가 상용 하드웨어 9종 중 8종에서 추론을 실행했습니다. 이 뉴스가 재는 것은 모델이 올라가는 표면의 넓이입니다. 웜은 스스로를 복제해 퍼집니다. 90억 파라미터라는 소형 모델이 상용 기기의 9분의 8에서 돌아갈 수 있다는 사실은, 웜에게 필요한 표면이 이미 준비돼 있다는 뜻입니다. 공격 표면이 데이터센터 안쪽에 머물지 않고 모든 기기로 열리고 있습니다. 표면이 넓어질수록 보안과 실행 환경의 질문은 먼저 도착해 있습니다.
GLM-Legal의 오픈웨이트라는 점이 여기서는 열쇠입니다. 무게를 받아 올 수 있으니, 전문 모델은 내 환경에서 돌리고 민감한 데이터는 그 주변에 두는 구성이 가능해집니다. 법률은 그 구성을 처음부터 요구하는 분야입니다. 사건 파일이 외부 API로 나가는 순간, 점수 문제는 데이터 문제가 됩니다. 점수표의 1위가 데이터 주권 문제 앞에서 무력해지는 지점입니다.
조직의 베팅은 이미 앞서 나갔습니다. Bloomberg 보도에 따르면 Epic Games는 직원에게 수기 코드 작성을 중단하도록 지시했습니다. 같은 뉴스에는 Marvel과 Star Wars 타이틀의 출시 연기도 나란히 실렸습니다. 두 사실이 한 줄에 놓인 것 자체가 신호입니다. 조직은 점수가 100이 되기 전에 에이전트 쪽으로 건너갑니다. 건너온 자리에서 80%는 누군가의 일이 되고 그 누군가는 실행 환경입니다. 환경의 비용은 결국 일정으로 청구됩니다. 신작 연기와 수기 코드 금지가 같은 보도에 실린 것은 그 계산이 이미 시작됐을 수 있다는 뜻입니다.
점수표의 반대편, 돈과 전기
점수표의 반대편에는 돈과 전기 있습니다.
마이크로소프트는 TSMC와 2027년 인도분 Maia 300 액셀러레이터 30만 개 이상의 확보를 협의 중입니다. 자체 칩을 멀티-GW 규모 주력 시스템으로 올리려는 구상입니다. 메타는 NVIDIA의 Spectrum 6 이더넷 스위치를 Vera Rubin 데이터센터 아키텍처에 도입해 10만 개 이상 GPU 규모의 클러스터로 확장하고 있습니다. 중국은 3.9조 달러 규모의 전력망 건설을 앞두고 있습니다. 2026년 버려진 재생에너지 발전량의 약 9%를 회수해 컴퓨팅 인프라에 투입할 계획입니다.
그 사이 인텔의 Lip-Bu Tan CEO와 브로드컴의 Hock Tan CEO는 다음 병목을 지목했습니다. 칩 부족과 전력 부족보다 자금 접근성이 AI 성장을 더 제약할 것이라고 경고했습니다. 두 CEO가 나란히 같은 병목을 말한 것은 이 경고가 업체 사정이 아닌 업 전체의 판단에 가깝다는 뜻입니다.
두 방향은 교차하고 있습니다. 컴퓨트는 풍부해지는 쪽으로 가고 돈은 희박해지는 쪽으로 갑니다. 교차점에서 ‘어떤 작업에 어떤 모델을 쓰느냐’는 성능 문제가 아니라 예산 문제입니다. 법률 업무에는 19.2%짜리 전문 모델을, 오디오 전사에는 책상 위 소형 모델을 쓰게 하는 라우팅. 그 라우팅 하나가 오늘의 점수와 돈을 함께 계산해 줍니다.
위에 나열한 기업들은 돈을 스스로 만드는 자립니다. 30만 개의 칩과 10만 개의 GPU, 3.9조 달러의 전력망. 그 규모를 따라갈 수 없는 기업에게 라우팅은 예산의 첫 번째 방어선이다. 288배 리얼타임으로 도는 소형 모델 하나를 업무에 맞게 붙이는 일은, 멀티-GW 클러스터를 짓는 일의 반대편에서 같은 곡선을 그리는 것이다. 작업별 단가를 내리는 일, 오늘 다이제스트의 모든 규모 전쟁이 끝내 부딪히는 지점인 셈이다.
벤치마크를 읽는 눈
오늘의 다이제스트에는 잣대가 세 개 나온다. 퍼스널 슈퍼인텔리전스 지수, Decision Index, Harvey의 법률 에이전트 벤치마크. 각자의 점수는 서로 통하지 않는다. Muse Wonder의 59.1점과 GLM-Legal의 19.2%는 같은 단위를 공유하지 않는다.
모델을 고르는 회사라면, 이 사실이 순위 자체보다 먼저 와닿는 일이다. 성적표를 읽을 때 볼 질문은 세 개인 것이다. 어느 잣대로 잴 것인가. 그 잣대가 내가 맡기려는 업무를 재는가. 절대 점수는 몇이며 남은 몫은 사람의 몇 %인가.
GLM-Legal은 세 번째 질문의 값을 보여 줍니다. 19.2%는 잣대를 어떻게 가져다 보나 점수로는 낮습니다. 그런데 법률 분야 안에서 풀사이즈 GLM 5.3의 8.3%와 다른 GLM 모델의 6.7%를 넘었다는 사실은 전문화가 제 일을 했다는 뜻입니다. 이 두 사실이 함께 주는 결론은 ‘19.2%를 사라’가 아닙니다. ‘19.2%는 법률에 쓰고 나머지는 따로 라우팅하라’입니다.
성적표는 쇼핑 목록이 아닙니다. 라우팅 지도입니다.
19.2%를 일하게 하는 환경
오늘의 뉴스를 한 줄로 모으면 이렇습니다. 모델은 매일 1위를 만들고 조직은 점수가 채 100이 되기 전에 에이전트를 일하게 하고 있습니다. 돈은 모델 바깥으로 흐릅니다. 세 갈래가 만나는 지점은 실행 환경입니다. 어디서 돌리느냐, 무슨 권한으로 쓰느냐, 무엇을 기록으로 남기느냐, 토큰 비용은 누가 계산하느냐.
이 질문에 하나의 답을 내놓은 제품이 있습니다. ThakiCloud의 Paxis, 에이전트 네이티브 클라우드의 v1.1 GA 정식 제품입니다. 스킬, 도구, 정책, 감사 로그가 일급 리소스로 관리되고 자율도 L0부터 L3까지 단계별 거버넌스가 적용됩니다. 실행 전 정책 게이트가 권한을 점검하고 모든 행위는 격리된 샌드박스 안에서 실행되며 감사 로그로 남습니다. MCP 커넥터와 스킬 마켓은 도메인 전문 모델을 에이전트의 스킬로 붙여 주고 소버린 온프렘 K8s(ai-platform)은 데이터가 밖으로 나가지 않는 실행 환경 자체를 제공합니다. CostRouter의 작업별 모델 선택은 이 글의 산술을 비용 계산으로 바꿔 줍니다.
점수와 돈을 함께 계산하는 라우팅을 한 장의 지도로 그리면 이렇습니다.
flowchart TD
    J["작업 요청"] --> R["CostRouter<br/>작업별 모델 선택"]
    R --> L["법률 문서<br/>GLM-Legal 19.2%"]
    R --> T["오디오 전사<br/>소형 모델, 288배 리얼타임"]
    L --> H["사람 검수 80%<br/>검수 기록은 다음 이터레이션 자료"]
    H --> G["정책 게이트<br/>자율도 L0~L3"]
    T --> G
    G --> S["격리된 샌드박스 실행"]
    S --> A["감사 로그<br/>지출은 로그로 기록"]
GLM-Legal 같은 19.2%짜리 1위는 이 레일 위에서 사건 파일 옆에서 일할 수 있습니다. 전문 모델은 스킬로 올라가는 셈입니다. 민감한 문서는 온프렘 환경에 남아 있게 됩니다. 사람이 검수하는 80%는 자율도 단계와 정책 게이트가 지킵니다. 지출은 작업별 모델 선택으로 계산됩니다. 법률은 전문 모델로, 전사는 소형 모델로, 지출은 로그로. 오늘의 19.2%가 일하는 형태는 이렇습니다.
내일 다이제스트에도 1위는 새로 생길 것입니다. 그때 기업에 남는 질문은 같습니다. 그 1위가 내 문서 옆에서, 내 예산 안에서, 내 로그 위에서 일할 수 있느냐. 19.2%짜리 1위라는 오늘의 소식은, 점수보다 환경을 먼저 고를 때 점수가 비로소 일한다는 기록입니다.
참고 자료
이 글은 아래 뉴스를 종합해 작성했습니다.
- HuggingNews, Meta’s Muse Wonder Beats GPT-6 on Superintelligence Index to Reach AI Frontier
- HuggingNews, Microsoft Makes Maia AI Chips Primary System at Multi-GW Scale
- HuggingNews, Anthropic Detects First Signs of AI Worms on IoT Hardware
- HuggingNews, Dev’s Google AI Hack Transcribes 1 Hour of Audio in 13 Seconds
- HuggingNews, vLLM Decision 3.0 and Mapika Decider Tie for #1 on Decision Index
- HuggingNews, Intel and Broadcom CEOs Warn Capital Scarcity Is the Next AI Bottleneck
- HuggingNews, Epic Bans Hand-Written Code and Delays Disney Game
- HuggingNews, Meta Deploys Nvidia Switches to Scale AI Clusters Beyond 100,000 GPUs
- HuggingNews, No. 1 Open Weight Legal AI Debuts in Zai’s First Professional Model
- HuggingNews, China Plans $3.9T Grid Buildout to Turn Wasted Power Into AI Edge