The Twin Registry: 셀프에볼빙 2,200 스킬 레지스트리의 twin(근접 중복 스킬) 축적 법칙, 4채널 라우팅 오류 귀속, merge vs rewrite 중복 제거 dividend를 분석으로 세운 논문
LLM 에이전트를 프로덕션으로 돌리면서 스킬이 수천 개 쌓인 레지스트리를 키우는 엔지니어, 혹은 그런 레지스트리를 곧 만들 국내 클라우드/AI 팀이라면 이 글을 읽어야 합니다.
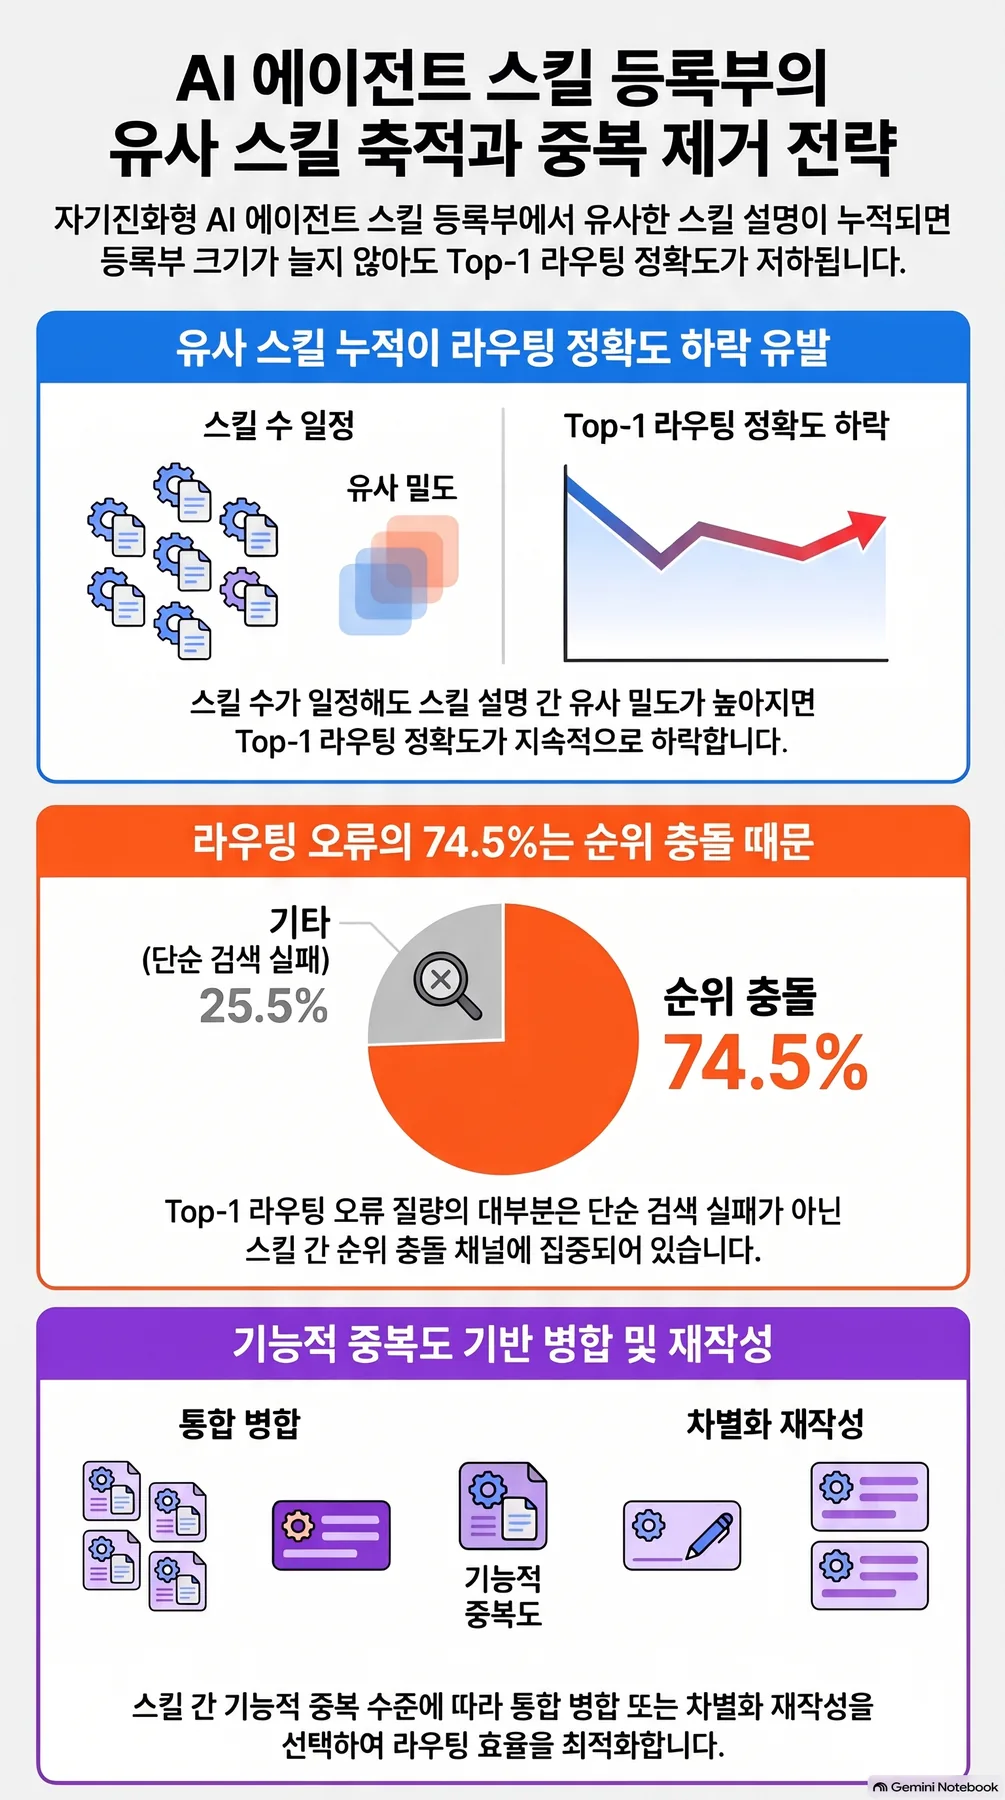
한 줄 결론입니다. 레지스트리가 커지지 않아도, 라우팅은 조용히 늙습니다. 커레이터 루프가 밤마다 설명을 다시 쓰고 빠지기에 새 스킬을 합성하며 만드는 근접 중복의 밀도가, 핫패스 위의 1위 추천을 조용히 내리기 때문입니다.
다만 읽기 전에 한 가지를 분명히 합니다. 이 논문은 분석 논문입니다. 본문의 모든 수치는 세 종류 중 하나입니다. 기록된 앵커, 그 앵커 위의 1차 산술, 라벨을 붙인 모델 예측이 그것입니다. 새 실측은 하나도 없습니다. 실측 숫자가 들어갈 곳은 논문이 사전 등록한 실측 프로그램입니다.
 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
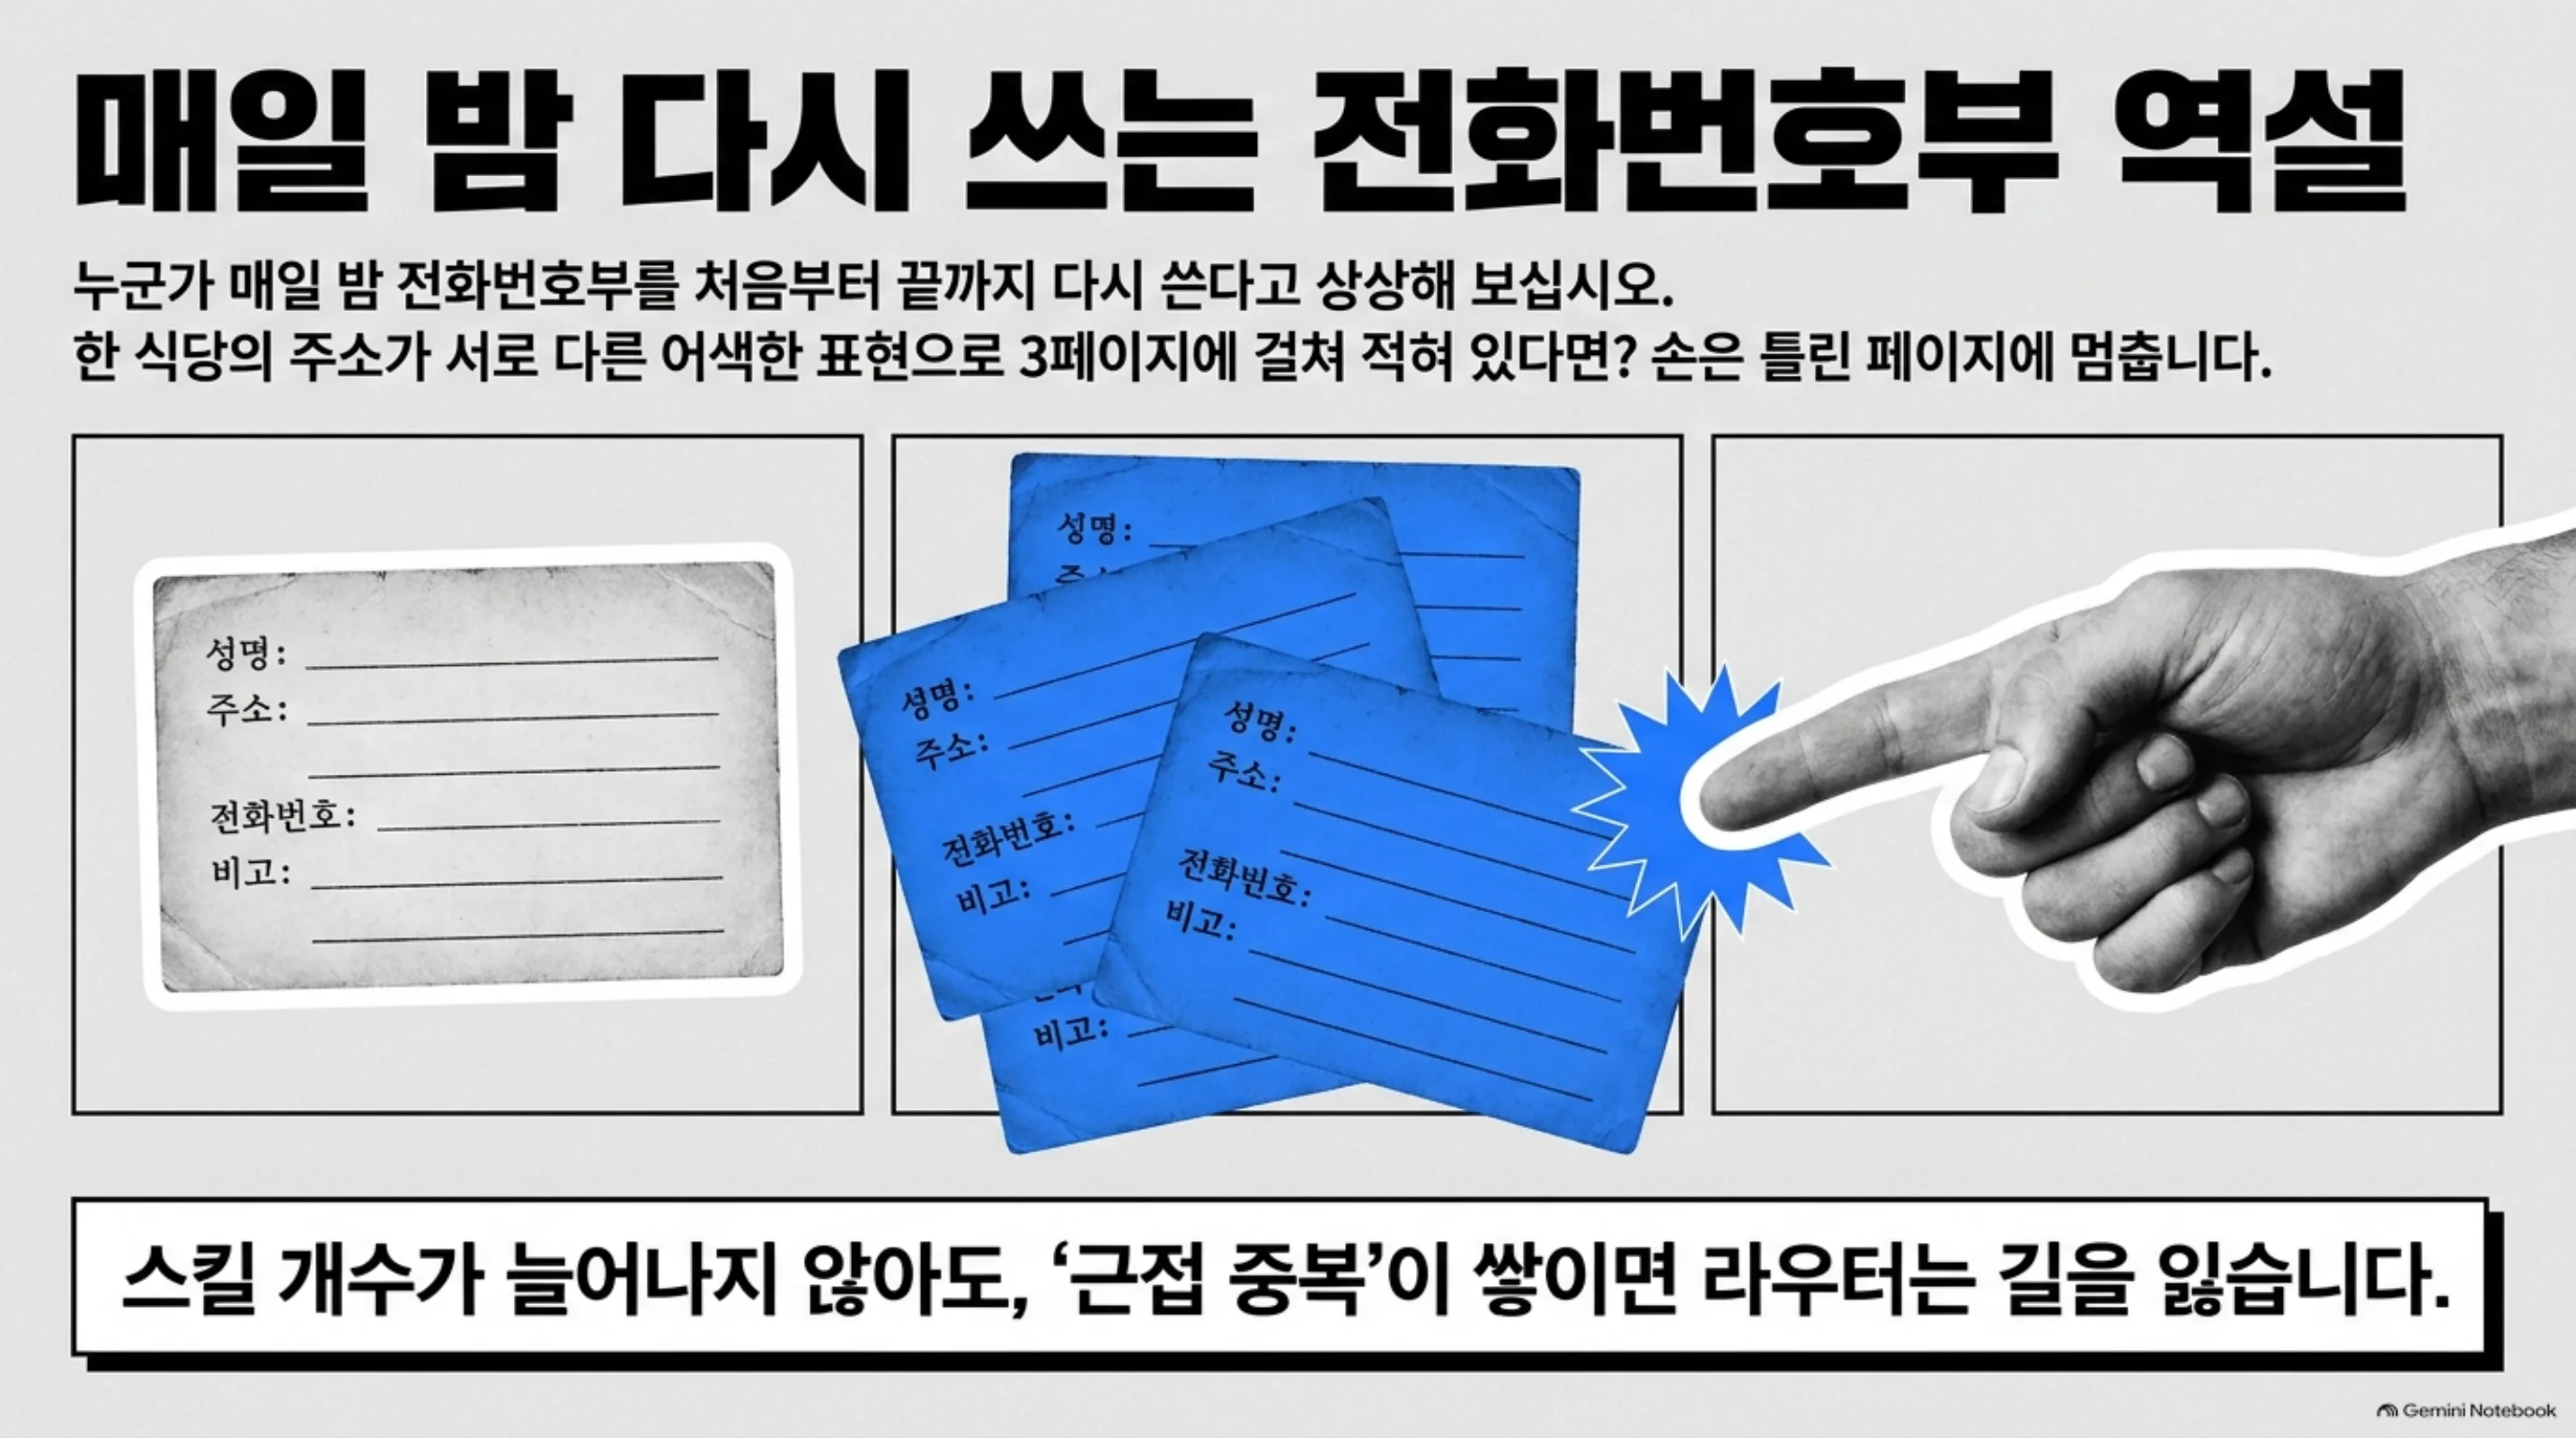
전화부 비유를 하나 씁니다. 누군가 밤마다 처음부터 끝까지 다시 쓰는 전화부를 생각해 보세요. 한 식당의 주소가 서로 다른 어색한 표현으로 3개의 거의 같은 페이지에 적혀 있습니다. 그 식당을 찾는 사람이 열면, 손이 틀린 페이지에 멈춥니다. 이런 근접 중복 페이지가 쌓일수록, 전화부 두께가 커지지 않아도 손이 틀린 페이지에 멈추는 횟수는 늘어납니다.
이 논문의 twin은 바로 그 근접 중복 페이지입니다. 에이전트 하네스의 스킬 레지스트리에는 2,200개 스킬이 있고, 밤마다 커레이터 루프가 설명을 다시 쓰고 새 항목을 합성합니다. 라우터는 사용자 쿼리에 가장 잘 맞는 한 페이지, 즉 top-1 스킬을 고릅니다. twin이 쌓이면 같은 쿼리에도 근접 중복 페이지들이 서로를 밀어내며, 손이 틀린 쪽에 멈춥니다.
청소법은 두 가지입니다. merge는 3개의 거의 같은 페이지를 하나로 합치고, 비어든 페이지에 다른 사업장을 채워 넣는 방식입니다. rewrite는 페이지를 모두 남기고 설명을 다시 써서 서로가 분명히 구분되도록 만드는 방식입니다. 이 논문은 중복을 정리할 때 비용 대비 효과가 나는 밀도를 폐쇄형 공식으로 줍니다. 스킬이 얼마나 비슷한지에 따라 어느 쪽 정리를 고를지 정하는 규칙도 줍니다.
즉, 사람 말로는, 전화부가 두꺼워지지 않아도 근접 중복 주소가 겹겹이 쌓이면 수화기를 든 손은 매일 조금씩 더 틀린 페이지에 멈춥니다. 이 논문(The Twin Registry)은 그 틀림의 속도와 청소법을 숫자로 세운 글입니다.
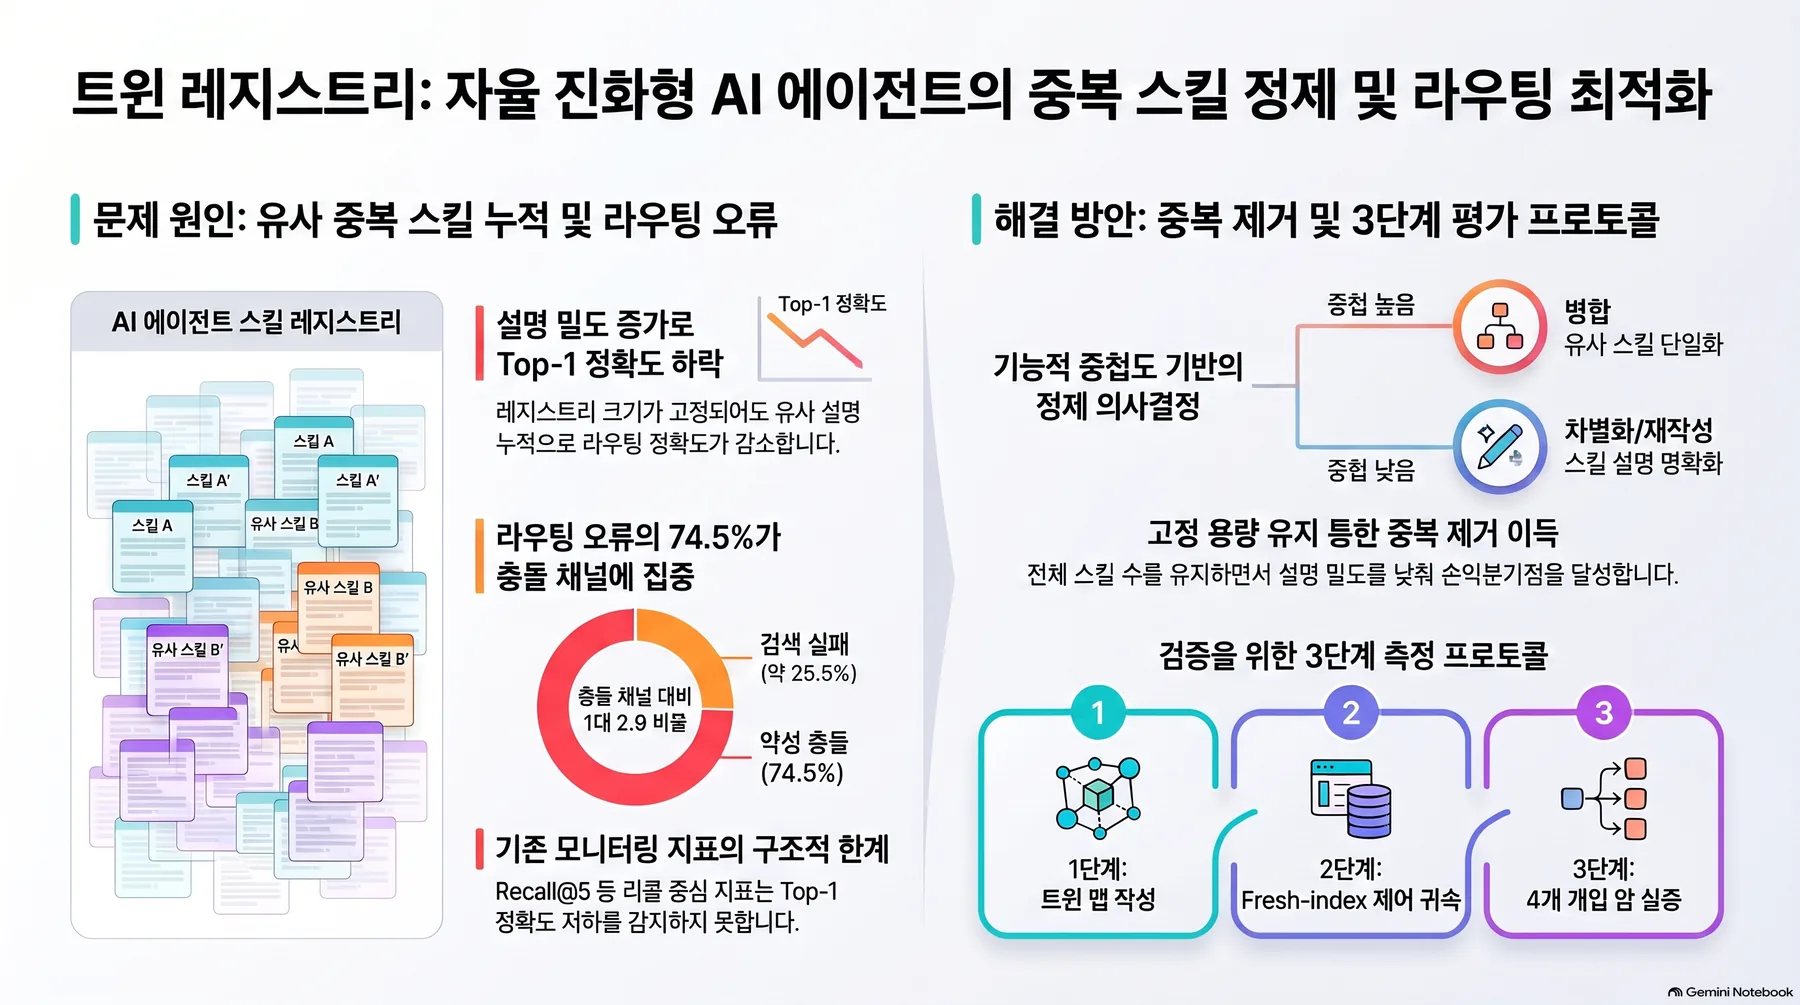 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
무엇을 해봤나
설정입니다. 이 논문이 보는 대상은 ThakiCloud의 셀프에볼빙 에이전트 하네스입니다. 각 스킬은 한 디렉터리이고, 라우팅 신호는 SKILL.md의 설명 하나뿐입니다. 하이브리드 BM25+embedding 라우터가 매 턴 top-1 스킬을 고르고, top-5 이웃은 모니터링용으로 남깁니다. 레지스트리는 정적이지 않습니다. 밤마다 LLM 커레이터가 설명을 다시 쓰고, 편집 유형별 collateral hazard는 semantic shift > truncation > paraphrase 순으로 큽니다. 라우터가 빠지면 새 스킬을 합성합니다.
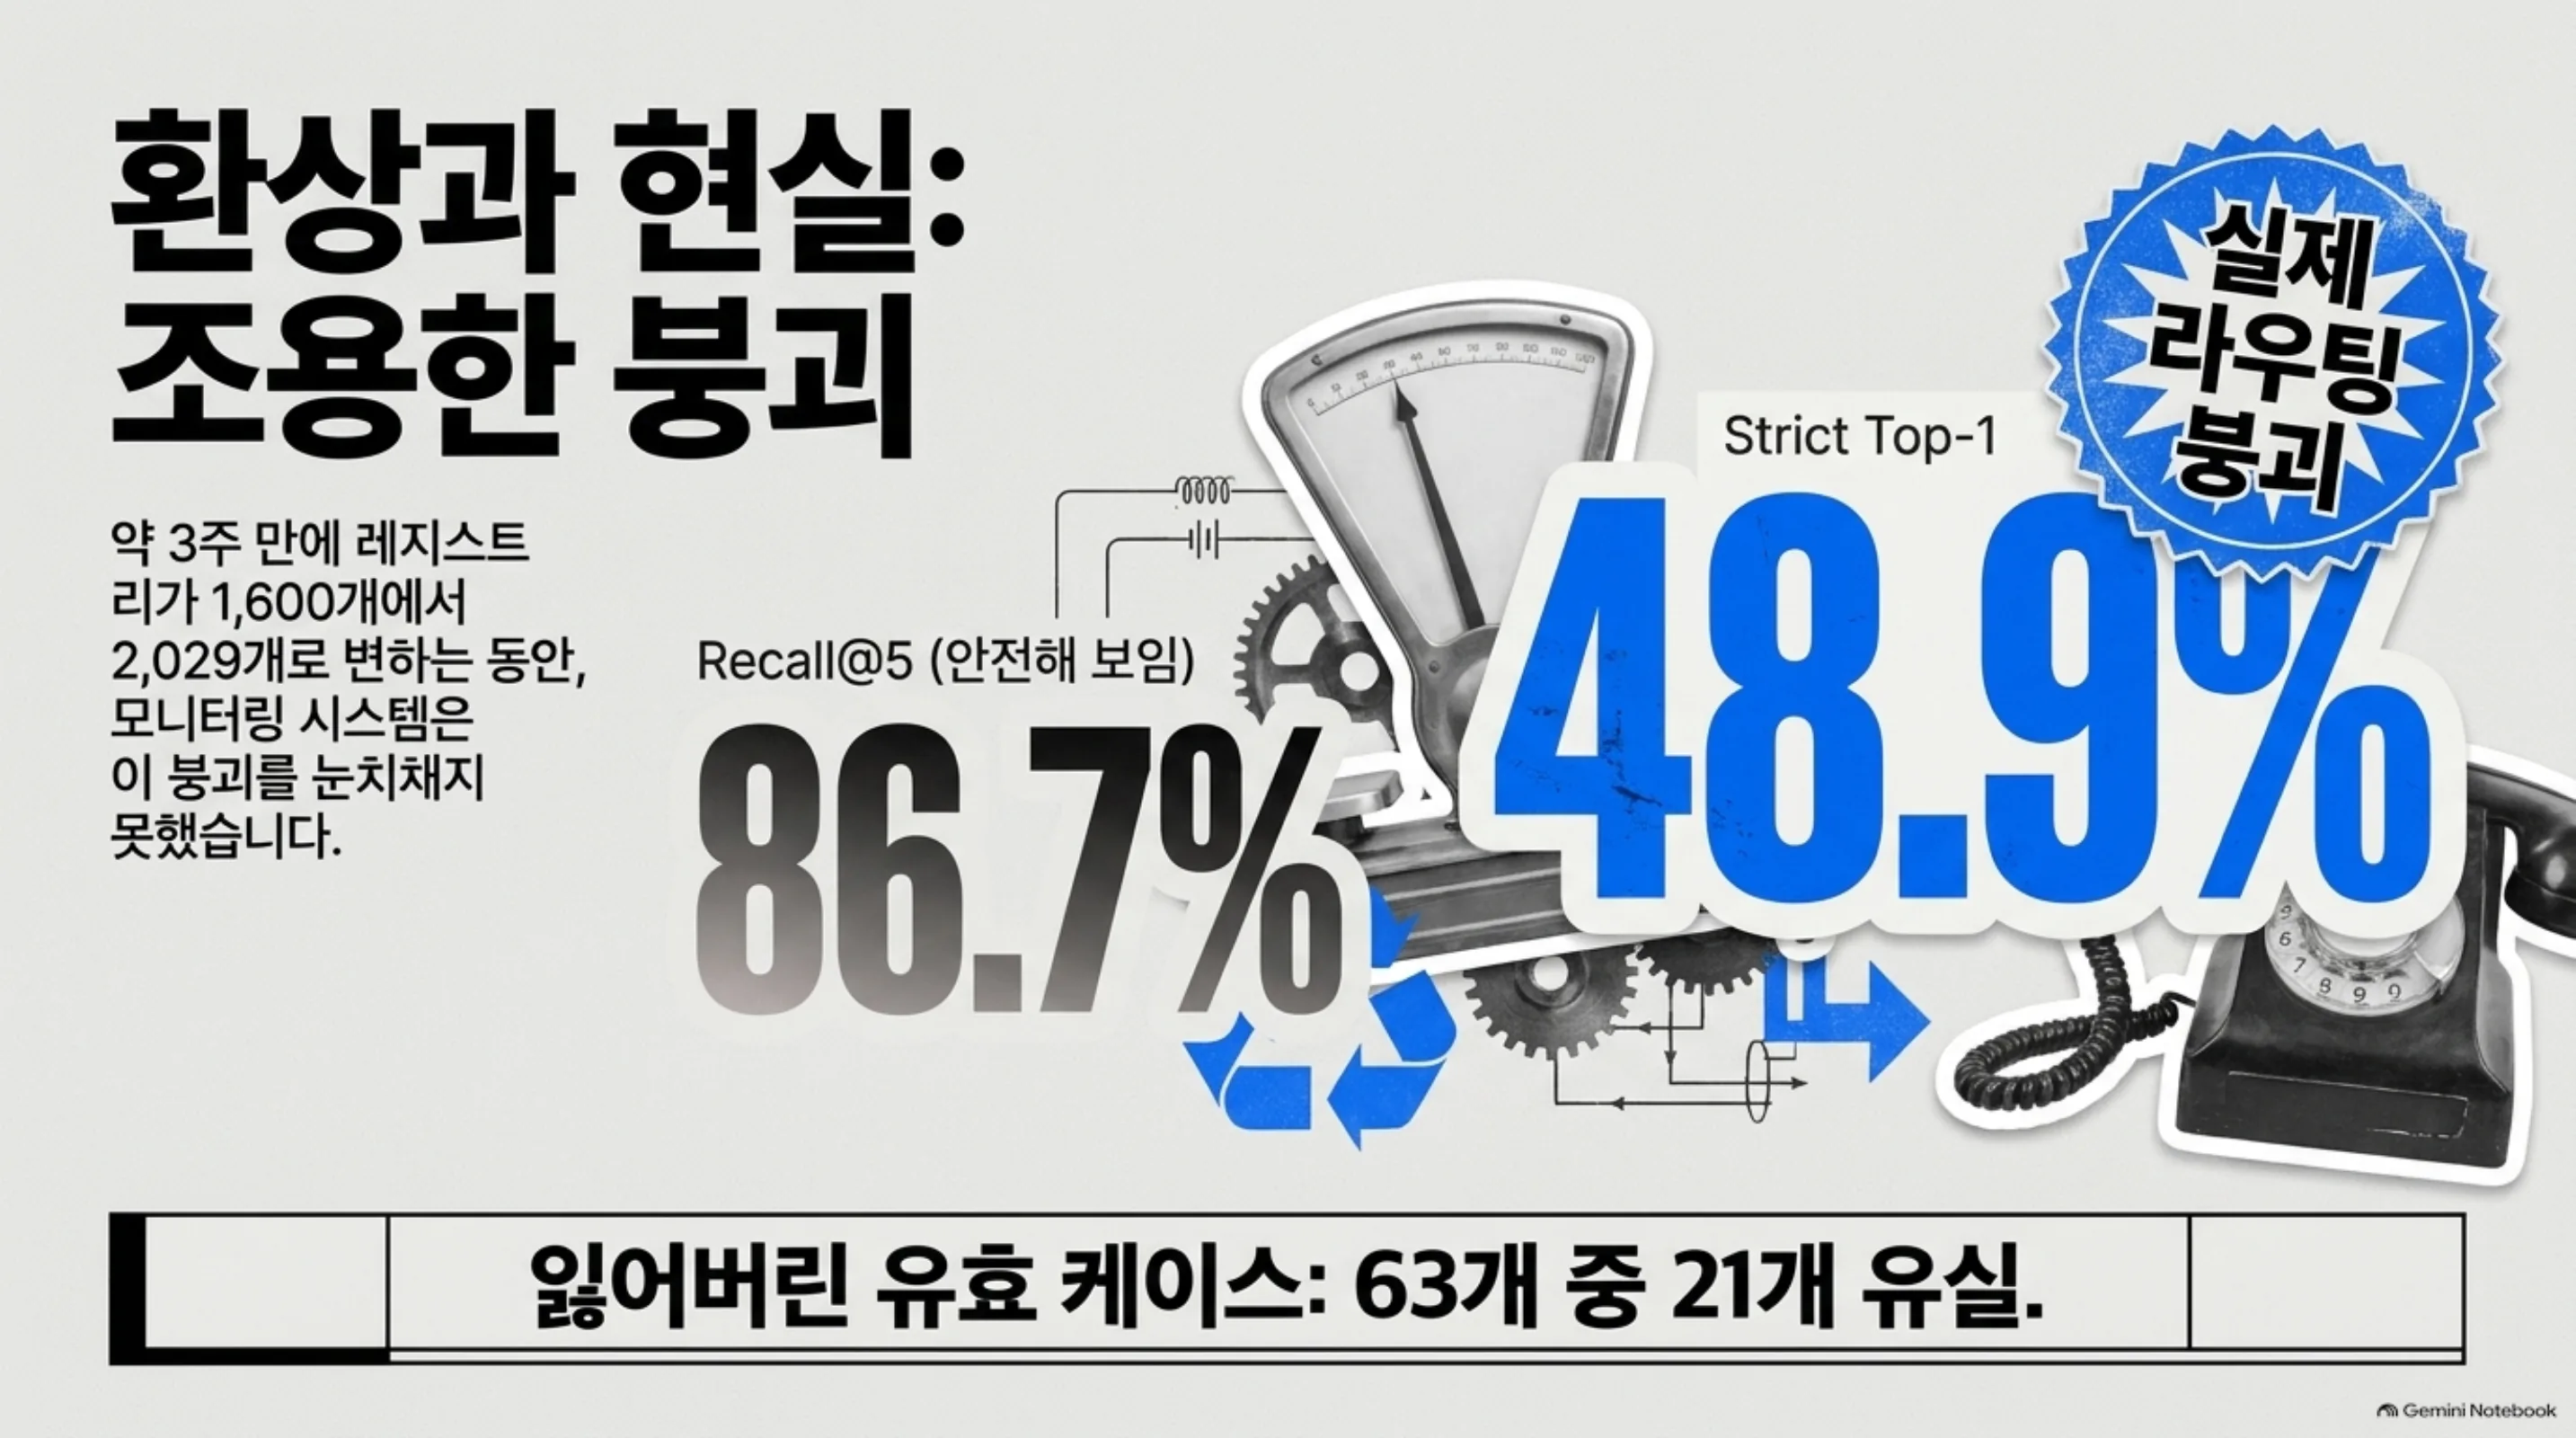
이 churn은 빠릅니다. 레지스트리가 약 1,600에서 2,029로 약 3주(2026년 7~9월) 만에 커졌습니다. 그 사이 고정 63케이스 골드 모니터인 SRA suite가 churn에 21케이스를 조용히 잃어, 42케이스만 유효해졌습니다. 유효 케이스로 점수를 다시 측정하자 Recall@5는 86.7%, 스트릭트 top-1은 48.9%였습니다. recall은 여전히 멀쩡해 보입니다. 여기서 함정이 시작됩니다.
시리즈 이전 논문들이 이미 매핑한 위생 축이 세 개 있습니다. 먼저 크기(cardinality) 축입니다. 생존 모델에서는 레지스트리가 커질수록 스트릭트 top-1이 떨어지고, 기록된 캘리브레이션에서 0.50 breakpoint는 약 1,950 스킬로 나와 이미 넘긴 상태입니다. N=512에서 2,029로 가며 스트릭트 top-1은 26.2포인트 빠지고 Recall@5는 0.0포인트 이동했습니다. 다음 어색성(verbosity) 축은 설명 길이 프론티어가 500에서 2,200으로 이동한 축인데, 부호가 불확정입니다. 마지막으로 고정 크기 구성 축은, 품질을 고정하면 중복 사본 m 개당 스트릭트 top-1이 1/(m+1)로 빠진다는 대칭성입니다. 이 세 축을 잰 뒤에, 시간 위에서 잴 축이 하나 남았습니다. 밀도(density) 축입니다. 라이브 커레이터 루프가 near-duplicate twin 설명을 얼마나 축적하는지를 잽니다. 2026년 9월 redundancy 연구에서 이미 미스가 세 쌍의 알려진 fine-grained pair에 집중된다는 flag가 있었고, 이 논문은 그 flag를 측정 가능한 축으로 올립니다. 분석이 키(key)로 잡는 N=2,234는 그 redundancy 연구에 기록된 구체적인 크기입니다. 현재 크기에 대한 주장이 아니라 선언된 baseline design choice이고, 인용 시리즈는 라이브 레지스트리를 약 2,200(2026년 10월)으로 보고합니다.
이 논문이 쓰는 기록 앵커는 아래 표에 모았습니다.
| 기록 앵커 | 값 |
|---|---|
| 생존 모델 P_top1(N)=r*exp[-p(N-1)] 캘리브레이션 | r=0.867, p=2.83x10^-4 |
| breakpoint(정확도 0.50) | 약 1,950 스킬(이미 초과) |
| 운영점(N=2,029) | Recall@5 86.7%, 스트릭트 top-1 48.9% |
| 키 baseline | N=2,234(2026년 9월 redundancy 연구) |
| SRA 모니터 | 63케이스 골드, 유효 42케이스 |
| collateral suite | 약 300케이스(SRA-CI shadow-routing 게이트) |
twin이 밀수록 breakpoint는 물러난다
첫 번째 기여입니다. 커레이터 루프는 복제 엔진입니다. 밤마다 이웃, 즉 코사인 유사도가 twin 임계 tau 이상인 곳에 착지하는 drifted rewrite와, 빠지기에 따른 스킬 합성이 twin 질량을 키웁니다. 반면 usage-ranked culling은 유사도로는 아무것도 잘라내지 않습니다. gate가 K*>=220이고 경제적 손익분기가 100 이하라서, 유사도 기준 트리밍이 일어나지 않습니다. 그래서 명시된 density gate가 없으면 twin 질량은 단조 비감소이고, 그 밤 단위 증가량 mu가 이 논문의 대상이 됩니다.
기록된 생존 모델과 기록된 구성 모델을 합성하면, 정확도가 임계 alpha를 하회하는 breakpoint N(rho)가 이렇게 나옵니다. N(rho) = 1 + ln(r/alpha) / [p(1+gamma*rho)]. rho는 duplicate density, 즉 twin 클러스터 안의 잉여 사본이 차지하는 비율 ((N-N_unique)/N)입니다. gamma는 중복 1개당 충돌 승수이고, 기록된 민감도 0.5와 1.0 둘 중 하나입니다.
| twin density rho | 안전 크기 N*(rho) |
|---|---|
| 0.0 | 약 1,946(기록된 약 1,950과 일치) |
| 0.2 | 약 1,622 |
| 0.4 | 약 1,390 |
표 값은 기록 앵커(r=0.867, p=2.83x10^-4, alpha=0.50, gamma=1.0 상단) 위의 1차 산술이며 실측이 아닙니다.
twin이 밀수록 안전했던 레지스트리 크기가 쪼그라듭니다. 같은 레지스트리라도 twin 밀도가 높은 쪽이 더 일찍 breakpoint를 만납니다.
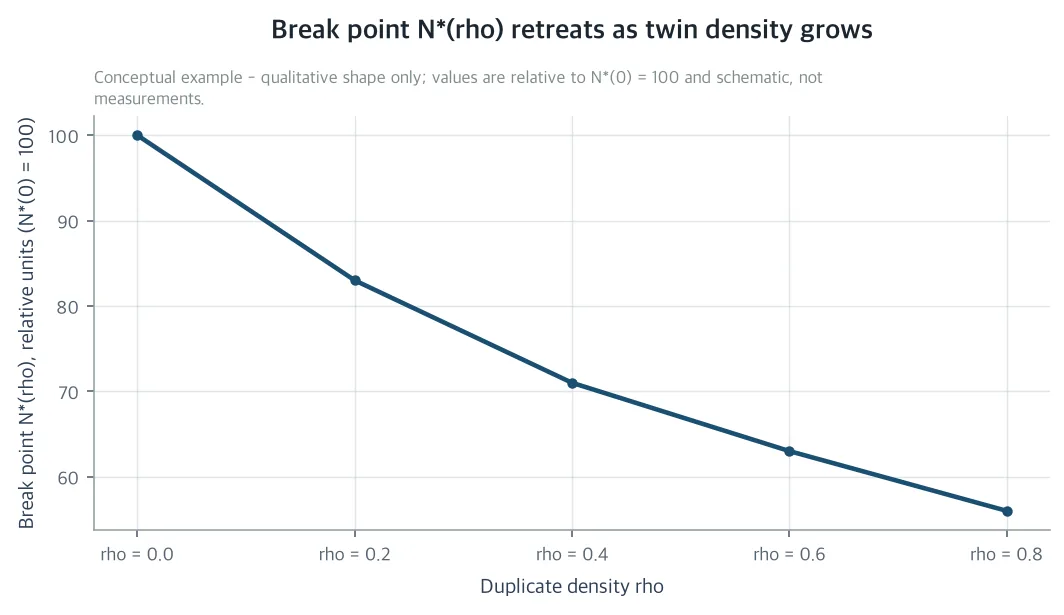 *모델이 예측하는 정확도 breakpoint(스트릭트 top-1이 0.50을 하회하는 레지스트리 크기)가 duplicate density rho에 대해 모노토닉하게 물러나는 형상. 기록된 캘리브레이션(r=0.867, p=2.83x10^-4)과 상단 gamma=1.0 민감도로 그린 분석 모델 예시이며 실측이 아닙니다.
키 baseline N=2,234에서 headroom H(rho)=N*(rho)-N은 rho=0에서 이미 -288입니다. twin이 하나도 없어도 breakpoint를 이미 넘었고, twin은 그 초과분을 더 깊게 만들뿐이라는 뜻입니다. twin density 1당 변화율 dH/drho는 rho=0.2, gamma=1.0에서 약 -1,351 slots입니다. twin density가 0.1 올라갈 때마다 초과분이 약 135 slots 더 깊어지는 속도입니다. rho=0에서 기울기는 gamma=1.0이면 약 -1,945, gamma=0.5이면 약 -972입니다. gamma가 기울기를 반으로 줄입니다.
여기서 붙는 corollary, aging in place가 가장 위험합니다. N을 2,234에 고정하면 dP/dt = -P(N,rho) * p(N-1) * gamma * mu입니다. rho=0.2, gamma=1.0에서 모델 합성은 정확도 P를 약 0.4로 줍니다(정확한 값은 아래 표). mu=0.01(밤 단위, 예시용 가정)을 대면 dP/dt는 스트릭트 top-1 기준 밤에 약 -0.26포인트입니다(가정 입력 하의 모델 예측). mu는 P1의 primary output입니다.
| aging in place(N=2,234 고정) | 값 |
|---|---|
| 모델 정확도 P(rho=0.2, gamma=1.0) | 0.406(모델 예측) |
| twin 생산률 mu | 0.01/밤(예시용 가정, P1 primary output) |
| 스트릭트 top-1의 밤 단위 drift dP/dt | 약 -0.26포인트(가정 입력 하의 모델 예측) |
레지스트리가 크지 않아도 top-1이 매일 조금씩 빠져나갑니다. 더 나쁜 점은 이 속도가 recall 중심 모니터가 구조적으로 못 본다는 것입니다. 42 유효 케이스 위의 1% per-case design point는 스윕당 약 0.4케이스 플립에 해당합니다. 기록된 power로 보면, 그런 스윕은 1% rate에서는 약 34~47% 확률, 2% rate에서는 약 57~72% 확률로 잡힙니다. 즉, 28~66% 확률로 놓칩니다(기록 앵커 위의 1차 산술). 대시보드는 조용한 채로, top-1은 스윕마다 케이스의 몇 분의 일씩 깎여나가는 구조입니다.
그래서 논문은 density gate의 의사결정 규칙을 줍니다. twin을 만들어내는 스윕이 유도하는 per-case 플립률이 300케이스 collateral suite의 1% design point를 넘는 순간, 게이트를 켜는 것입니다. 숫자는 안 쓰고 규칙만 두며, mu를 직접 읽는 twin map(P1)이 그 몫을 맡습니다.
오류는 네 갈래로 나뉜다
두 번째 기여입니다. 스트릭트 top-1 miss는 네 채널 중 하나에 해당합니다. 채널 A는 retrieval failure입니다. gold가 top-5에 안 들어온 경우로, 기록된 약 13포인트 채널입니다. 채널 B1은 benign sibling입니다. 돌아온 스킬이 gold의 twin이라 기능적으로는 정답인 경우입니다. 채널 B2는 malignant collision입니다. 비슷하지만 틀린, 클러스터 간 충돌로, 기록된 약 38포인트 충돌 질량에서 B1을 뺀 것입니다. 채널 G는 coverage gap입니다. 레지스트리에 그 쿼리에 맞는 스킬이 애초에 없는 경우입니다.
G를 추가한 이유는 기록된 ORACLE ceiling입니다. 1,600+ 스킬, 혼합 언어 regime에서 손으로 완벽히 만들어도 step coverage 63.6%까지밖에 못 도달했습니다. 36.4포인트 잔여(기록 앵커 위의 1차 산술)는 어떤 라우팅 개선으로도 거둘 수 없는 질량입니다.
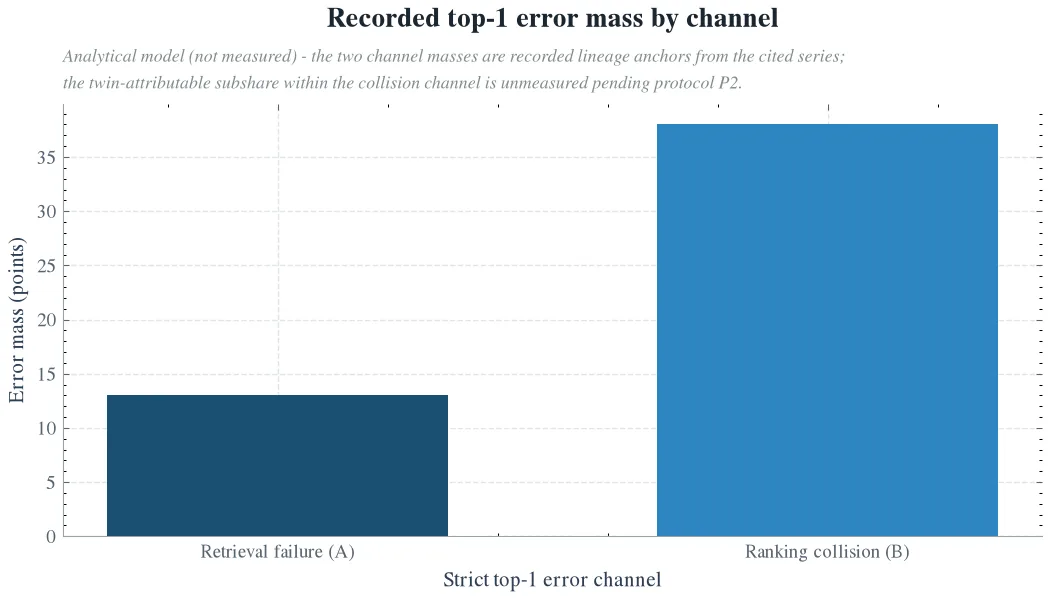 기록된 운영점 N=2,029에서 스트릭트 top-1 오류 질량이 retrieval failure(약 13포인트)와 ranking collision(약 38포인트)로 나뉘고 collision 채널에 2.9대 1로 집중되는 형상. 분석 모델 예시이며 실측이 아닙니다.
기록된 운영점(N=2,029)에서 top-1 오류 질량은 충돌 약 38포인트, 수집 실패 약 13포인트로, 2.9:1로 충돌 채널에 몰려 있습니다. twin 귀속 miss는 정확히 B1 채널이고, 항등식 share_B1 = share_B * c_twin이 정확히 성립합니다. share_B는 38/(38+13)으로 약 0.75입니다(기록 앵커 위의 1차 산술). c_twin은 충돌 miss에서 gold와 돌아온 스킬이 같은 tau-클러스터에 있는 비율입니다. c_twin은 P2 프로토콜이 잴 대상이지, 가정으로 넣을 값이 아닙니다. 예시 입력 c_twin=0.5를 대면 share_B1은 약 0.37입니다. 즉, 기록된 (A+B) top-1 오류 질량의 약 37%가 twin에 귀속됩니다(가정 입력 하의 모델 예측). 나머지는 수집 실패(A), 악성 충돌(B2), 미기록 커버리지 갭(G)입니다.
쌍을 이룬 cluster-mass 관계가 예측력을 담고 있습니다. 기록된 대칭성 결과 아래 B1 = C * E[m/(m+1)]입니다(모델 예측). C는 cluster-win 질량(P1 output)이고, per-query split m/(m+1)은 m=1이면 1/2, m=2이면 2/3, m=3이면 3/4입니다. 시리즈는 충돌 질량은 기록했지만, 그 질량이 confusable cluster에 얼마나 집중되는지는 기록하지 않았습니다. c_twin은 P2의 primary output입니다.
두 번째 구조 결과는 margin 집중입니다. flip이 일어나려면 score margin이 반경 rho_eff의 perturbation ball 안에 들어와야 합니다. dense 쪽 quantization error는 fusion weight에 선형으로 감쇠하며, fused score에 dense 항 하나로만 들어옵니다. background 후보는 N에 퍼져 있으므로, 후보당 flip hazard는 1/N처럼 스케일합니다. twin 클러스터는 gold 근처 O(rho_eff) 안에 m 개 후보를 몰아 넣습니다. 그래서 로컬 flip hazard는 global 1/N이 아니라 로컬 twin 질량 rho_local과 스케일합니다. twin 클러스터는 quantization과 paraphrase가 만든 flip 위험을 로컬 밀도로 증폭합니다.
쿼리 쪽에도 거울이 있습니다. 같은 intent의 두 paraphrase 사이 recommendation-set Jaccard similarity는 baseline을 크게 밑돕니다. cosmetic 재작성이든 constraint 추가 재작성이든요(아래 표, 약 6,000 runs). near-duplicate 입력도 구조 없는 ranking에서는 비슷한 불안정 순위를 만듭니다.
| 쿼리 쪽 paraphrase 취약성(기록) | 값 |
|---|---|
| cosmetic 재작성 recommendation-set Jaccard | 0.288 |
| constraint 추가 재작성 Jaccard | 0.135 |
| baseline | 0.50~0.6x |
| 규모 | 약 6,000 runs |
논문은 위 귀속을 세 가지 false-attribution 모드에서 지킵니다. F1은 scoring artifact입니다. index staleness가 밀도를 위장할 수 있고, stale entry가 기대 충돌 Delta_lambda를 추가합니다. 그래서 P2는 같은 레지스트리를 fresh index로 다시 점수 매기고, 차이만 staleness에 귀속합니다. F2는 malignant collision입니다. 태스크가 정반대인 twin pair는 negative transfer입니다. 그래서 P3의 rewrite arm이 클러스터 밖에서 새 confusable pair를 만드는지 지켜봅니다. F3는 cost channel입니다. 귀속된 miss가 다운스트림에서 싸게 복구되면 dividend가 사라집니다(기록된 miss pricing). 그래서 P3는 기록된 per-task ledger로 end-to-end 비용을 재합니다.
같은 크기에서: 합치냐, 다시 쓰느냐
세 번째 기여입니다. 키 baseline N=2,234에서 N을 고정하고 두 가지 정리를 비교합니다. MERGE(M)는 각 tau-클러스터를 canonical 스킬 하나로 통합하고, 비어든 슬롯을 개별 capability로 back-fill합니다. REWRITE(W)는 스킬을 전부 두고, 클러스터의 설명을 intra-cluster 코사인이 tau 아래로 갈 때까지 다시 씁니다(차별화). 두 arm 다 N을 고정하므로 per-query 라우터 추론 비용은 변하지 않습니다(flat inference cost). 변하는 건 일회성 intervention 비용과 정확도뿐입니다.
정확도 측면에서 두 arm은 1차로 자기 클러스터의 기록된 대칭성 손실 m/(m+1)을 0으로 되찾습니다. M은 추가로 duplicate 질량 자체를 없앱니다. N_eff가 N(1-rho)+N*rho/(m_bar+1)에서 N(1-rho_M) 쪽으로 내려갑니다. 충돌 채널이 줄고, dense index가 작아지며, 기록된 staleness 비용도 내려갑니다. W는 N_eff를 유지한 채, cluster 내 대칭성 회복과 averaging 아래 cluster 내 extreme score 제거(log cluster size 감산)만 얻습니다.
비용은 C_int = C_curator + C_reembed + C_gate입니다. M의 back-fill 합성은 기록된 24x 속도(중앙값 1.2일 대 29.0일, 개별 저작)로 시간 단위로 가격이 매겨집니다. W는 m_bar+1 개의 설명을 원자리에 고칩니다(canonical 멤버를 pin하면 m_bar). C_reembed는 기록된 index cadence에 touched entry를 다시 embed하는 비용입니다. C_gate는 300케이스 collateral suite에 SRA-CI shadow routing을 한 번 돌리는 비용입니다. 피하게 된 miss의 가치는 Delta P * V_miss * Q입니다. V_miss는 per-task miss price, Q는 밤 단위 테스크 물량입니다. 둘을 같다고 하면 손익분기 밀도 감축이 폐쇄형으로 나옵니다.
| 손익분기 밀도 감축 | 공식 |
|---|---|
| Delta rho_be | C_int / [P * p(N-1) * gamma * V_miss * Q] |
| P=0.406(모델 값), p(N-1)*gamma=0.632 대입 시 | 약 3.90 * C_int / (V_miss * Q) |
C_int의 모든 비용 파라미터는 P3의 pre-registered input이고, 이 논문은 숫자가 아니라 공식을 줍니다.
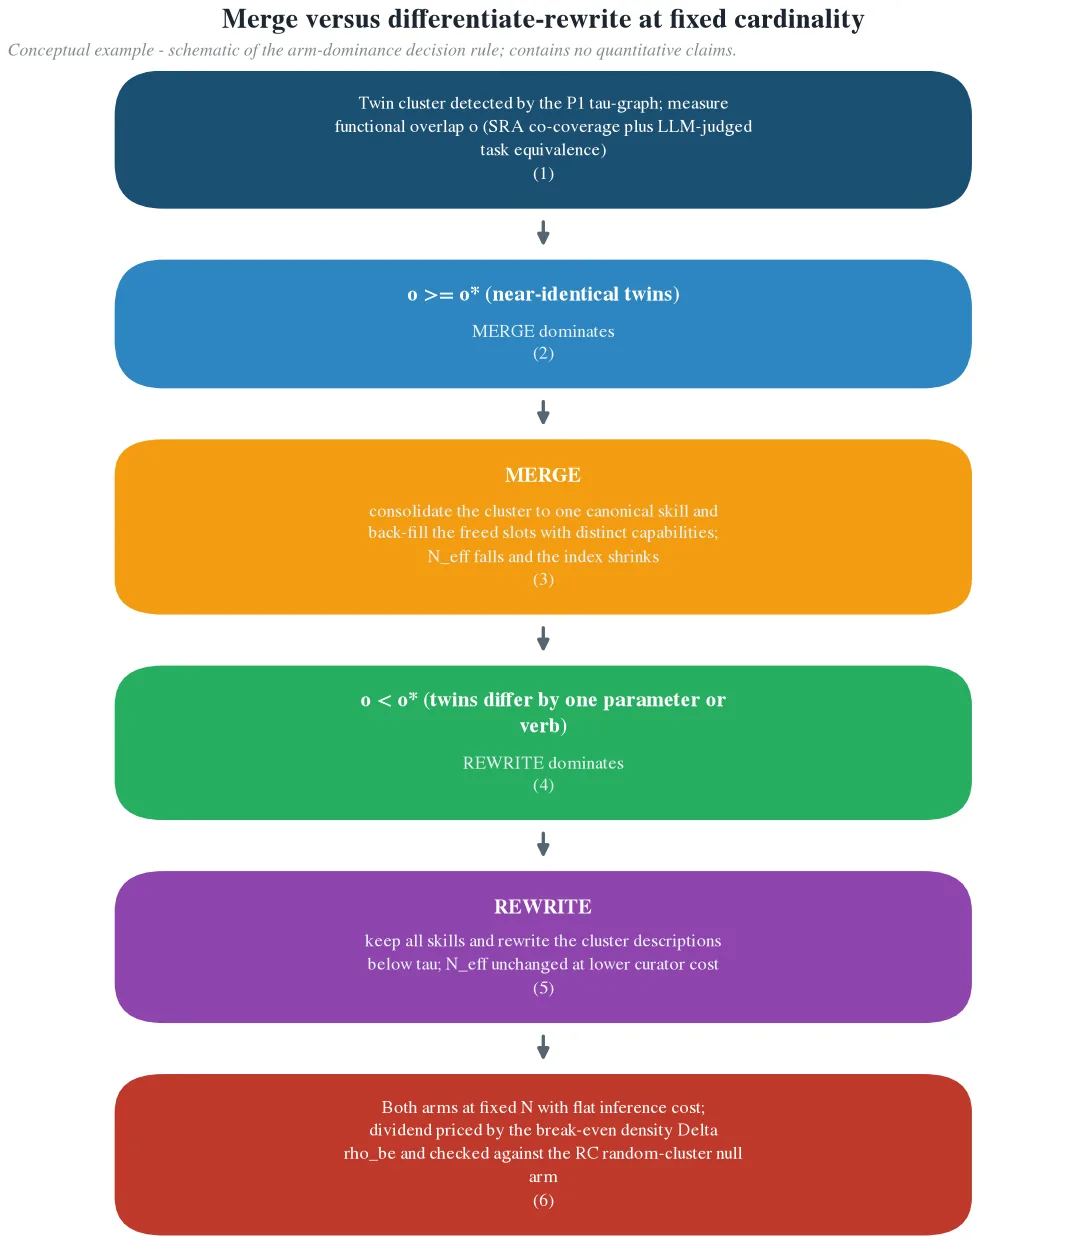 twin 클러스터의 기능적 중복 o가 사전 등록된 교차점과 비교되어 MERGE(통합 후 back-fill) 또는 REWRITE(원자리 차별화)를 고르는 결정 구조. 팔 지배성 의사결정 규칙의 개념 예시(스키마)이며 정량적 주장을 담지 않습니다.
어느 arm이 이기는지는 기능적 중복 o가 정합니다. o는 SRA case co-coverage + LLM-judged task equivalence로 잴 것이며, pre-registered입니다. o가 pre-registered 교차점 o* 이상, 즉 거의 같은 twin이라면 M이 지배합니다. 대칭성 회복은 같고, M은 N_eff 회복과 index 축소까지 얻는 반면, W는 기능적으로 같은 스킬을 다시 써도 구분이 안 됩니다. request-skill gap의 dilution 성질과, MCP scale에서 이름은 같고 설명도 비슷한 tool 팽창을 보면, 차별화가 신뢰롭지 않습니다.
o가 o* 미만, 한 파라미터나 한 동사 차이인 twin이라면 W가 지배합니다. 더 낮은 curator 비용으로 전체 대칭성 손실을 회복하고, coverage churn이 없습니다. semantic shift 편집이 collateral hazard가 가장 큰 클래스이고, K>=220 아래로 culling 하면 precision 유지가 사라지기 때문입니다. 경계 o는 arm curator 비용 차이를 cluster당 N_eff 통합 효과와 같다고 놓고, P3가 경험적으로 찾습니다. 정리(proposition)가 모델이라면, P3가 어느 arm이 이기는지 측정하는 몫입니다.
실측 프로그램: 프로그램 자체가 기여
네 번째 기여입니다. density 축의 측정을 반증 기준과 함께 사전 등록하고, 논문은 결과보다 이 프로그램 자체가 기여라고 명시합니다.
| 프로토콜 | 무엇을 잴 것인가 | 산출물과 의사결정 규칙 |
|---|---|---|
| P1 twin map | 스냅샷 레지스트리의 모든 설명을 embed하고, pre-registered tau grid(0.85, 0.90, 0.95)의 각 값에서 W회 연속 무산 후보 탐색 후 멈추는 threshold-aware 실행기로 tau-에지를 세고 연결 성분을 만듦 | rho_hat, cluster 크기 분포, consecutive nightly snapshot에서 나온 mu_hat(twin production rate); mu_hat를 SRA-CI의 1% per-case design point와 비교하고, 넘으면 density 축이 size 축보다 먼저 bind |
| P2 attribution | frozen SRA suite를 돌려 모든 top-1 miss를 P1의 tau-graph로 같은 클러스터 검사를 하며 A/B1/B2/G에 할당 | share_B1과 c_twin; F1은 fresh-index control로 통제 |
| P3 intervention | 네 arm: B0(무간섭 baseline), M(merge), W(rewrite), RC(random-cluster null) | 모든 arm은 같은 N에서 SRA + collateral suite, SRA-CI shadow gate로 평가; end-to-end 테스크 비용을 기록된 per-task ledger(token 지출 + 다운스트림 복구)로 재며 기록된 deadline 화폐로 환산 |
RC arm은 더 싼 arm의 편집 예산을 cluster 아닌 랜덤 스킬 세트에 써서, “어떤 curation이든 라우팅을 낫게 한다”는 null을 죽입니다. 반증 기준은 셋입니다. F1: arm의 이득이 fresh-index control에서 사라지면 staleness 귀속입니다. F2: rewrite가 클러스터 밖 새 confusable pair를 만들면 악성 충돌입니다. F3: 정확도 dividend가 full cost accounting을 못 버티면 cost 채널입니다.
그래서 무엇을 바꾸면 되나
ThakiCloud로는, 이 논문이 나이트 커레이터 루프가 스스로 만드는 실패 모드를 찾아냅니다. 2,000 스킬을 넘어서며 라우터 top-1을 갉아먹는 near-duplicate 축적입니다. 그리고 그 크기를 정량화합니다. 손익분기 밀도 감축을 폐쇄형 공식으로 준 merge-vs-rewrite dedup gate를 줘, 2,200+ 스킬 레지스트리를 flat inference cost로 routable하게 유지합니다.
비슷한 하네스를 돌리는 팀이라면, 적용할 규칙은 짧습니다. recall 중심 모니터를 대시보드로만 두지 마십시오. twin을 만들어내는 스윕의 per-case 플립률이 300케이스 collateral suite의 1% design point를 넘는 순간, density gate를 켭니다. merge냐 rewrite냐를 정하기 전에, twin map(P1)으로 twin production rate mu를 먼저 직접 읽습니다.
agent ecosystem이 공유되고 community-contributed 스킬 레지스트리 규모로 커집니다. 그러면 설명 공간 밀도는 더 이상 한 조직의 내정이 아니라, public-infrastructure 문제가 됩니다. 구조는 인접 시스템으로 옮겨붙습니다. 10만(100K) scale community hub와 11.1만(111K) pool public registry에서는 밀도가 첫 bind constraint입니다(모델 기대). 367,174개 MCP tool 팽창은 W-arm 답이 있는 density 문제입니다. 30%까지 potentially redundant인 knowledge-graph predicate도 같은 M-vs-W 두 arm 구조를 가집니다. agent memory 유지와 federated skill evolution은 각각 P1 twin map + P2 channel test, patch space M-arm으로 대응합니다. MoE 비유도 하나, 단 caveat과 함께 씁니다. twin 클러스터가 top-1 질량을 빼앗는 모양과, 겹치는 expert가 load를 빼앗는 모양이 구조적으로 같습니다. MoE의 답이 load control이라면, 여기의 답은 설명 공간 dedup입니다. 훈련 동역학에 대한 주장은 하지 않습니다.
못 믿을 부분
한계를 논문이 스스로 적어둔 그대로, 순서대로 정리합니다. 첫째, calibration 점이 하나입니다. r과 p가 production 점 하나로 추정한 것이므로, survival family 전체가 그 불확실성을 물려받습니다. 전화부의 한 페이지 예로만 전권을 교정하는 것과 같은 자리입니다. pre-registered tau grid(0.85, 0.90, 0.95)는 twin 정의의 민감도를 bound하지만 제거하지는 못합니다. 둘째, rho_hat, mu_hat, c_twin은 P1, P2 대기 중 추정치일 뿐 측정치가 아닙니다. 셋째, W-arm에는 separability 전제가 있습니다. 팔 지배성 정리는 기능적으로 구분되는 스킬이 tau 아래로 차별화 가능하다고 전제하고, 거의 같은 스킬이라면 M regime으로 붕괴합니다. 전화부로는, 3페이지가 정말로 같은 식당이라면 어찌 써도 구분이 안 되니 merge가 답이라는 뜻입니다. 넷째, fixed-N 가정입니다. 라이브 레지스트리는 계속 크고, mu>0에 N 성장까지 더하면 headroom 미분은 두 효과 각각보다 엄밀히 나빠집니다. 공동 궤적은 P1 output입니다. 다섯째, 하나의 embedding 모델, 하나의 하네스입니다. cross-model, cross-harness 주장은 없습니다. 여섯째, cross-lingual confusability에는 blind spot이 있습니다. 기록된 repair regime은 한국어와 영어 쿼리가 섞여 있는데, twin 정의는 이를 모델링하지 못합니다. 마지막으로, 이 논문은 분석입니다. 라벨을 붙인 모든 모델 예측은 pre-registered prior이지 결과가 아닙니다. 실측 숫자는 P1-P3가 채우고, 채우지 못하면 위의 반증 기준으로 주장이 죽습니다.
논문 상세 페이지와 수반 자료는 여기에서 볼 수 있습니다: The Twin Registry
이 논문은 분석 논문입니다. 본문의 수치는 실측이 아니라 기록된 앵커, 그 위의 1차 산술, 라벨 붙인 모델 예측이며 예시로 쓴 가정 입력(c_twin=0.5, mu=0.01 등)은 P1-P3 실측이 대체할 몫입니다.
 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.

