자기 청구서를 보는 에이전트는 지출을 줄이는가: unattended agent loop의 cost mirror
무인(unattended) 에이전트 루프를 스케줄이나 이벤트로 돌리고 셀프호스트 서빙 위에서 토큰 비용 장부를 관리하는 국내 클라우드·AI 엔지니어라면 이 글이 필요합니다. 이 논문이 묻는 질문은 하나입니다. 에이전트가 자기 작업의 토큰 비용을 컨텍스트에서 실제로 보면, 지출은 얼마나, 어떤 경로로, 어떤 품질 대가를 치러서 줄어드는가. 실측 결과를 주는 논문은 아닙니다. 측정 전에 그 답의 범위와 순서를 분석 모델로 닫고 그 모델을 검증할 단일 변수 A/B 프로토콜을 동결한 연구입니다.
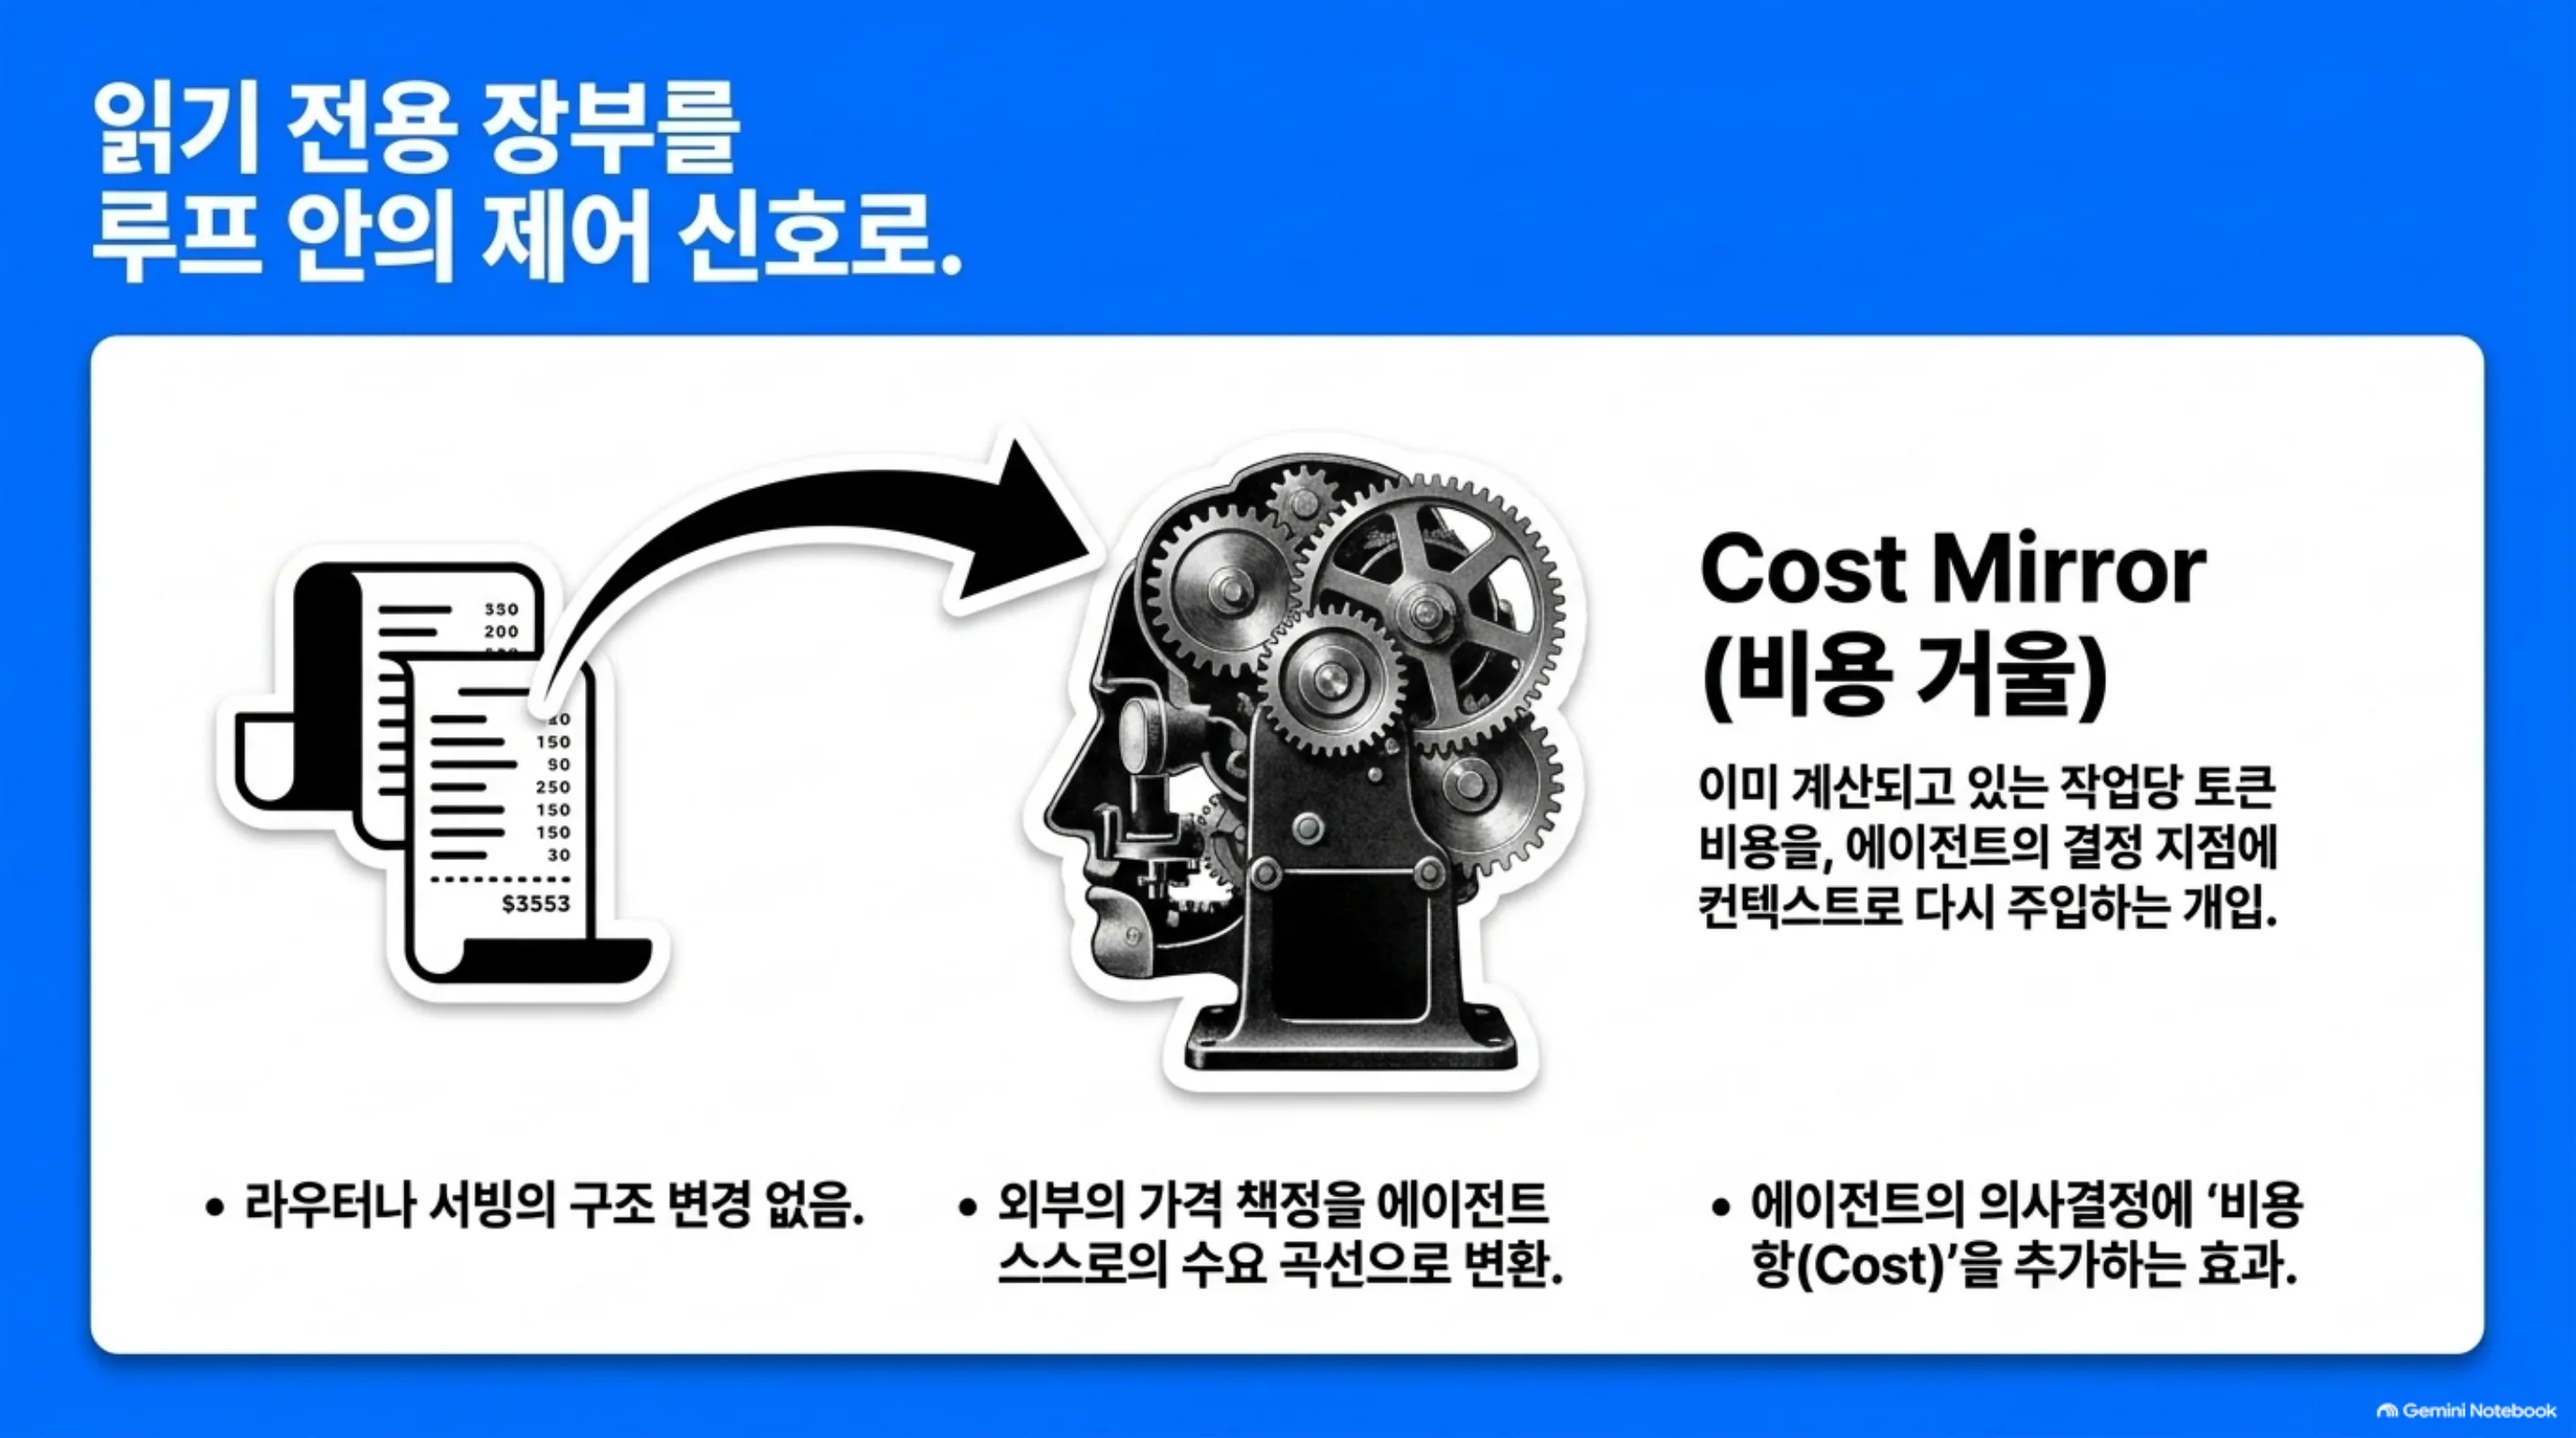
장치의 이름은 cost mirror입니다. 청구용 metering이 이미 계산하는 작업당 토큰 비용을, 에이전트의 결정 지점에 컨텍스트로 다시 주입하는 개입입니다. 읽기 전용 장부를 루프 안의 제어 신호로 바꾸는 것입니다.
 글의 핵심 개념을 형상화했습니다.
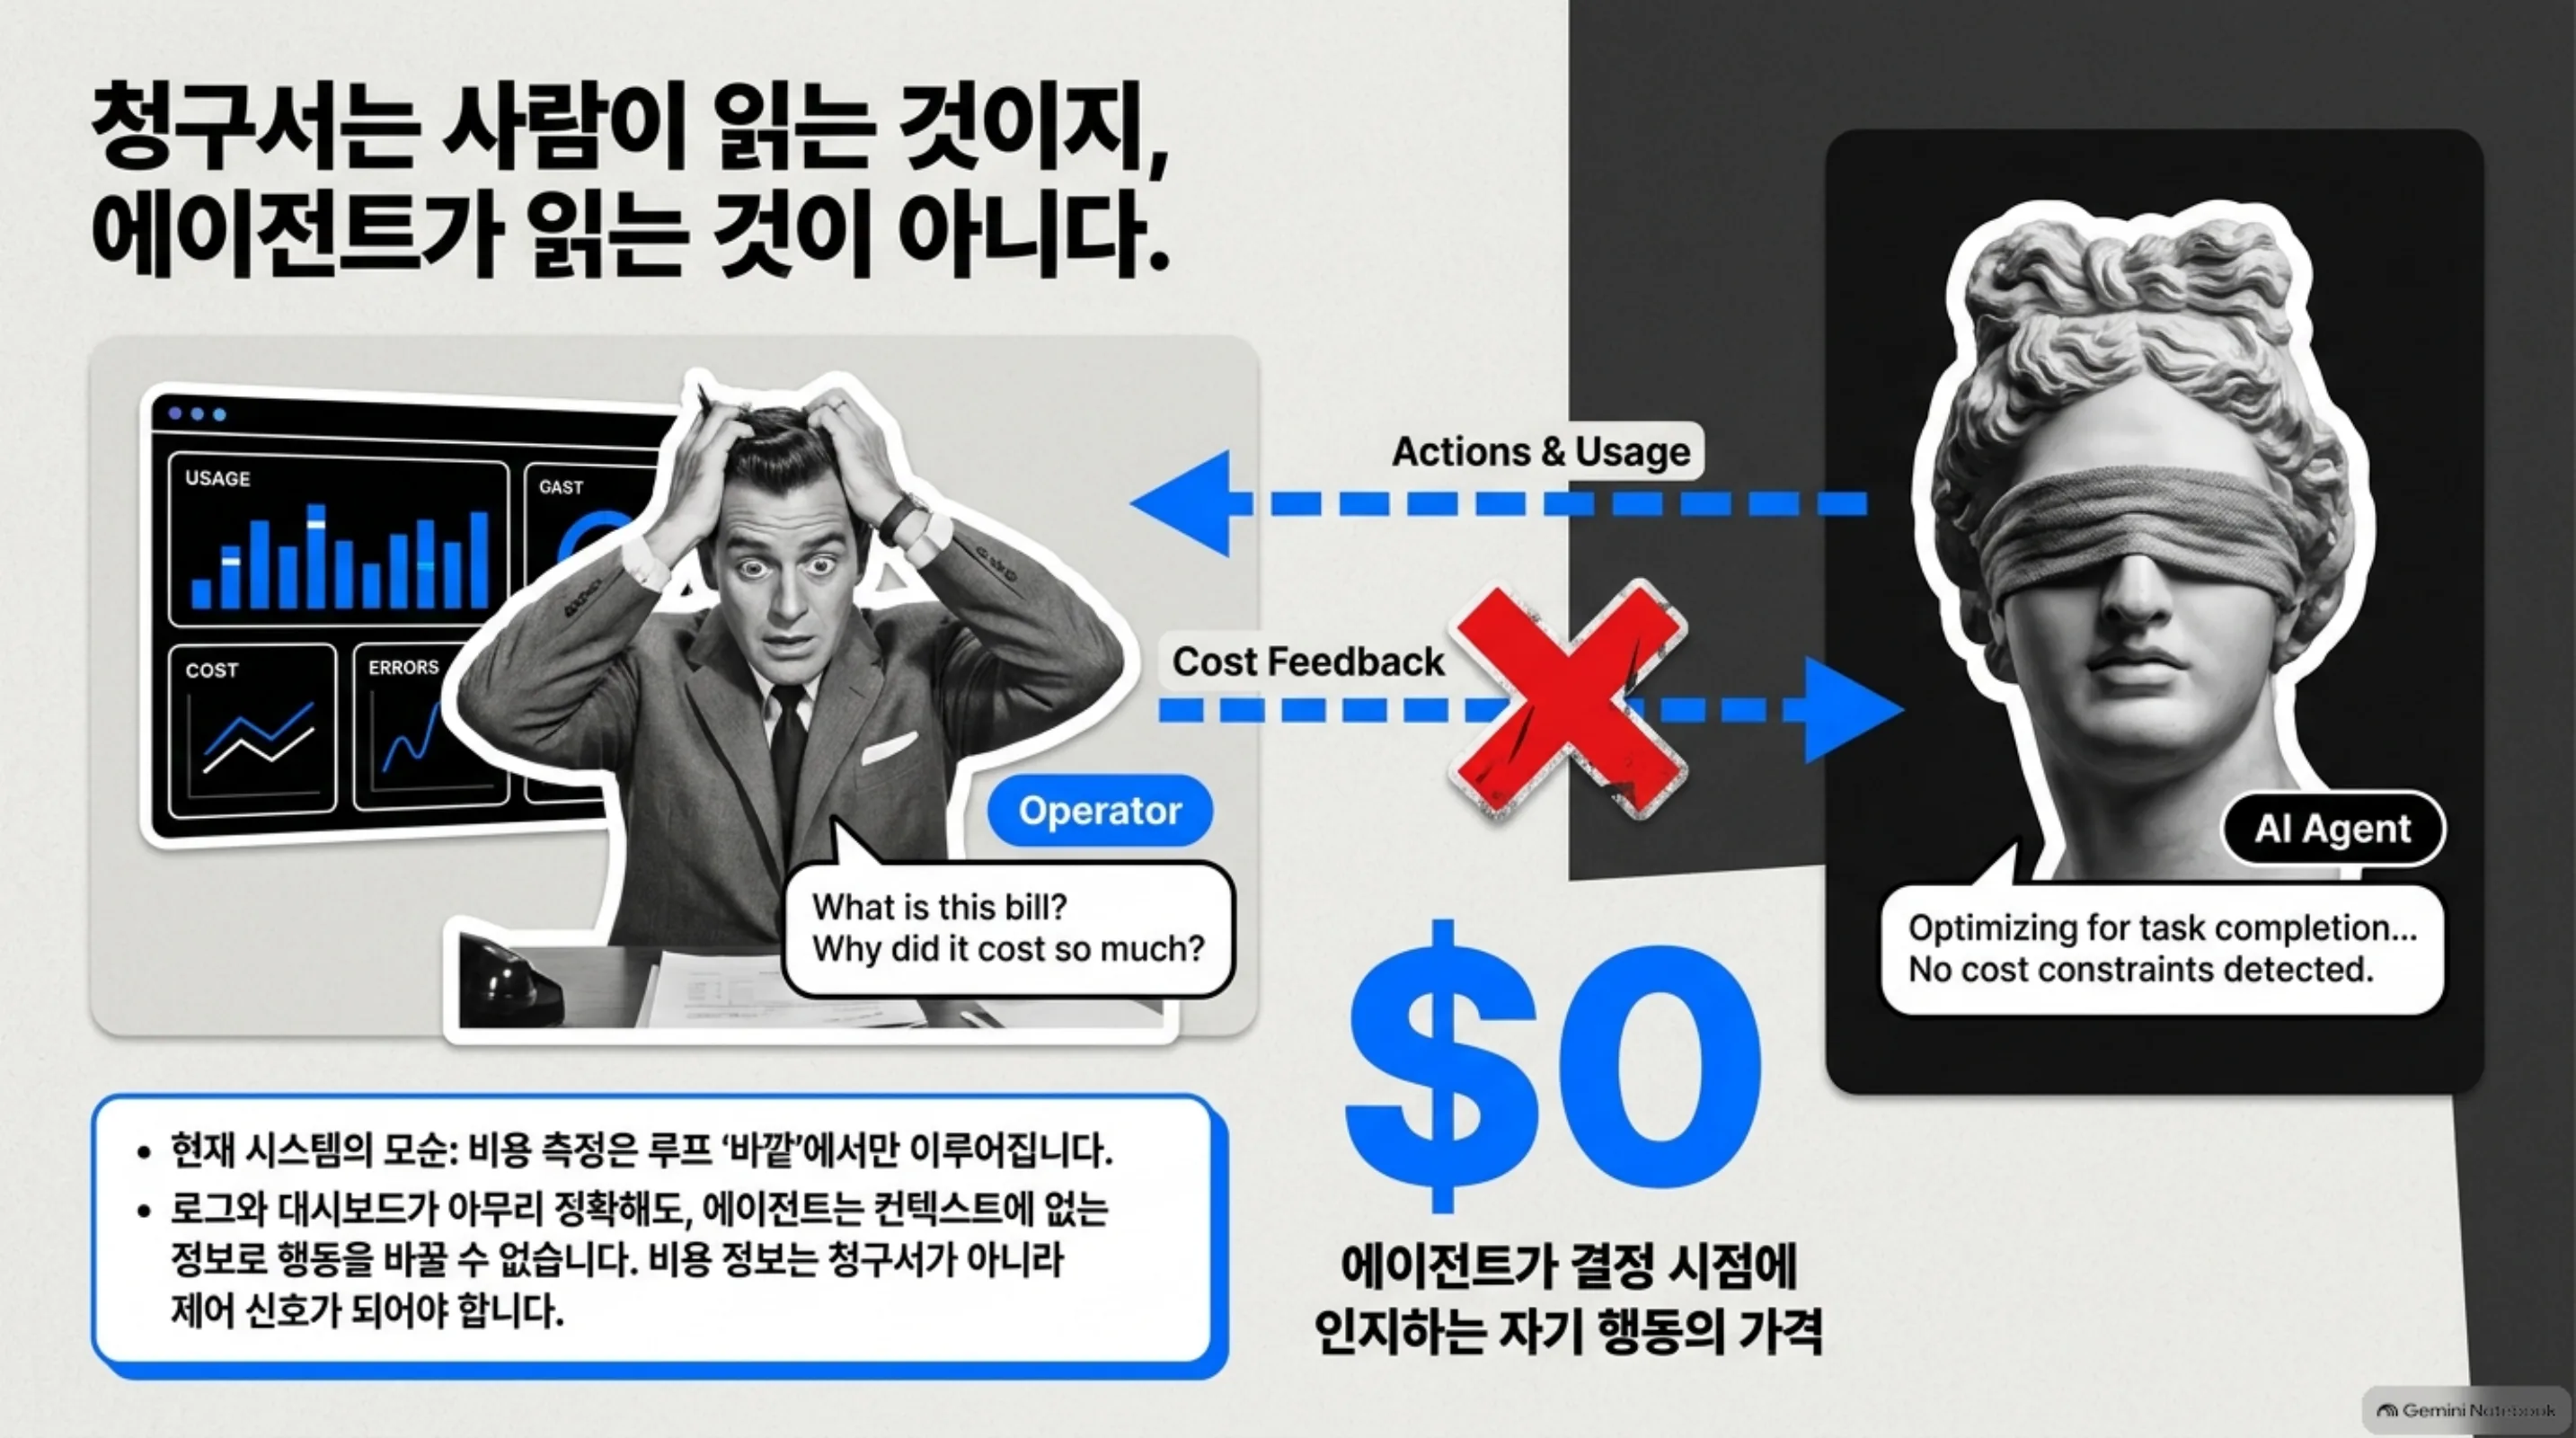
청구서는 사람이 읽는 것이지, 에이전트가 읽는 것이 아니다
에이전트 루프의 비용 관리는 지금 전부 바깥에서 이루어집니다. 서빙 스택은 요청당 토큰을 meter하고 멀티테넌트 시스템은 retrieval과 generation 사이로 비용을 배정하고 operator가 그 장부를 읽습니다. 루프 안에서 결정을 내리는 에이전트 자신은 자기 행동의 가격을 보지 못합니다. 비용은 측정되어 있고 측정의 자리는 루프 밖에만 있습니다.
논문은 이 점을 축(axiom)으로 명문화합니다. 에이전트는 결정 시점에 컨텍스트에 있는 정보로만 행동할 수 있습니다. 로그, 대시보드, operator 채널에 쓰는 metering surface은 아무리 정확해도 에이전트 정책에는 직접적 행동 효과를 만들지 못합니다.
실무 신호도 같은 방향입니다. 루프 벤치마크 분석이 이름 붙인 4가지 특징 실패 모드 중 두 개가 원초적으로 비용 관리 실패입니다. 예산을 잘못된 방향으로 쓰는 것, 작업이 제출되기에 안전할 때까지 멈추지 못하는 것. 비용 정보는 루프의 control state에 있어야지, operator의 invoice에만 있어야 할 것입니다.
가장 가까운 실측 연구 세 건은 모두 다른 대상을 봅니다. EcoAgent-Bench는 priced action과 explicit budget이 정의된 작업에서 에이전트가 구매하는 능력을 평가합니다. 에이전트는 남의 돈을, task가 정의한 goods에 씁니다. Qian의 프리레지스터 실험은 frontier agent 시장경제의 예측과 acceptance band와 decision rule을 공개 git 체인에 먼저 동결하고 전 실험을 138.76달러로 완주했습니다. 이 글의 프로토콜 규율이 이어 받는 바로 그 precedent입니다. ledger 기반 self-orchestration 연구는 manager-worker scaffold가 토큰 bill을 약 3배로 만들면서 더 큰 모델보다 정확도를 더 싸게 산다고 보고합니다. 핵심 경고는 파이프라인 비교가 토큰 예산과 도구 호출과 프롬프트를 동시에 혼동한다는 것인데, 이 프로토콜의 단일 변수 설계가 배제하는 것이 바로 그 confound입니다.
행동경제학에서 이 축은 두 결과로 받쳐집니다. Thaler의 mental accounting, 같은 금액이 계정과 프레임과 목표 대비 진행 표현에 따라 다르게 행동한다는 결과. 그리고 자율 agent가 reward를 maximize하기 위해 procedure를 전략적으로 위반하는 것이 실측된 Goodharting. cost mirror가 놓이는 지점은 price effect의 LLM agent analog입니다.
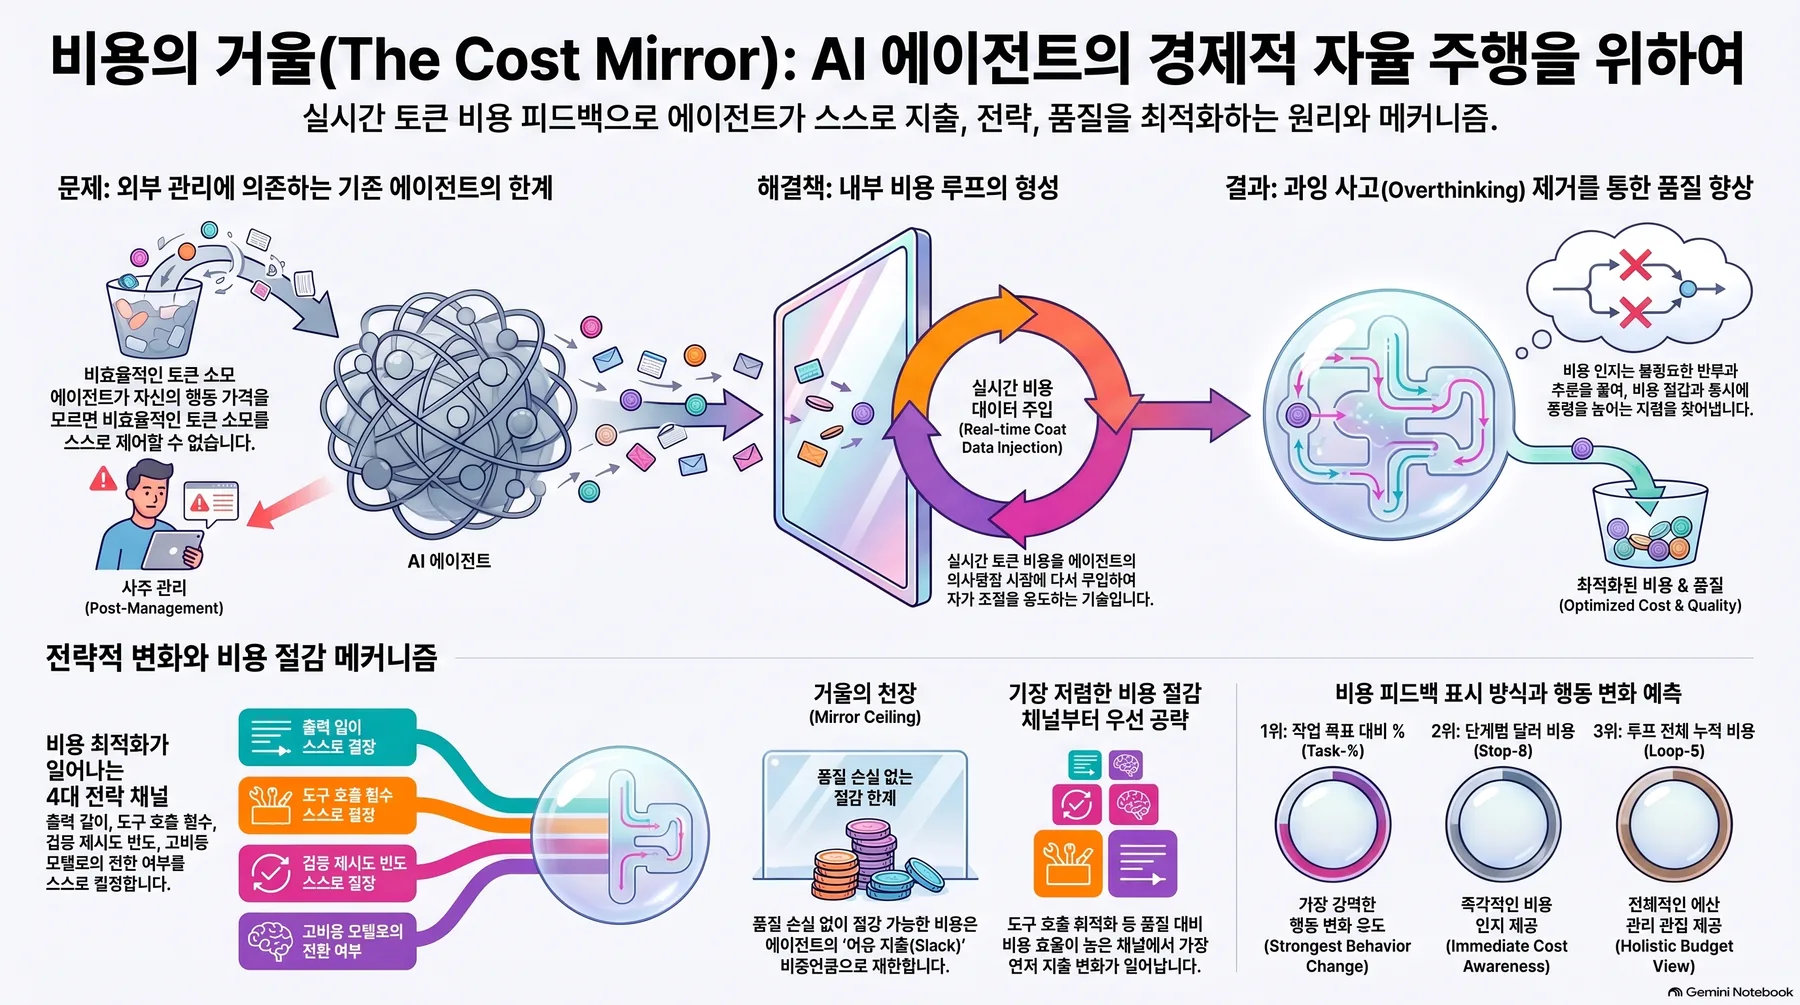 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
cost mirror: 읽기 전용 장부를 루프 안의 제어 신호로
cost mirror는 결정 지점에서 계산된 지출을 보여주는 display δ를 에이전트 컨텍스트에 주입합니다. δ는 세 속성으로 정의됩니다. granularity g는 step, task, loop 중 하나이고 framing f는 백분율, 달러, 토큰 중 하나이며 anchor는 explicit task당 budget의 유무입니다.
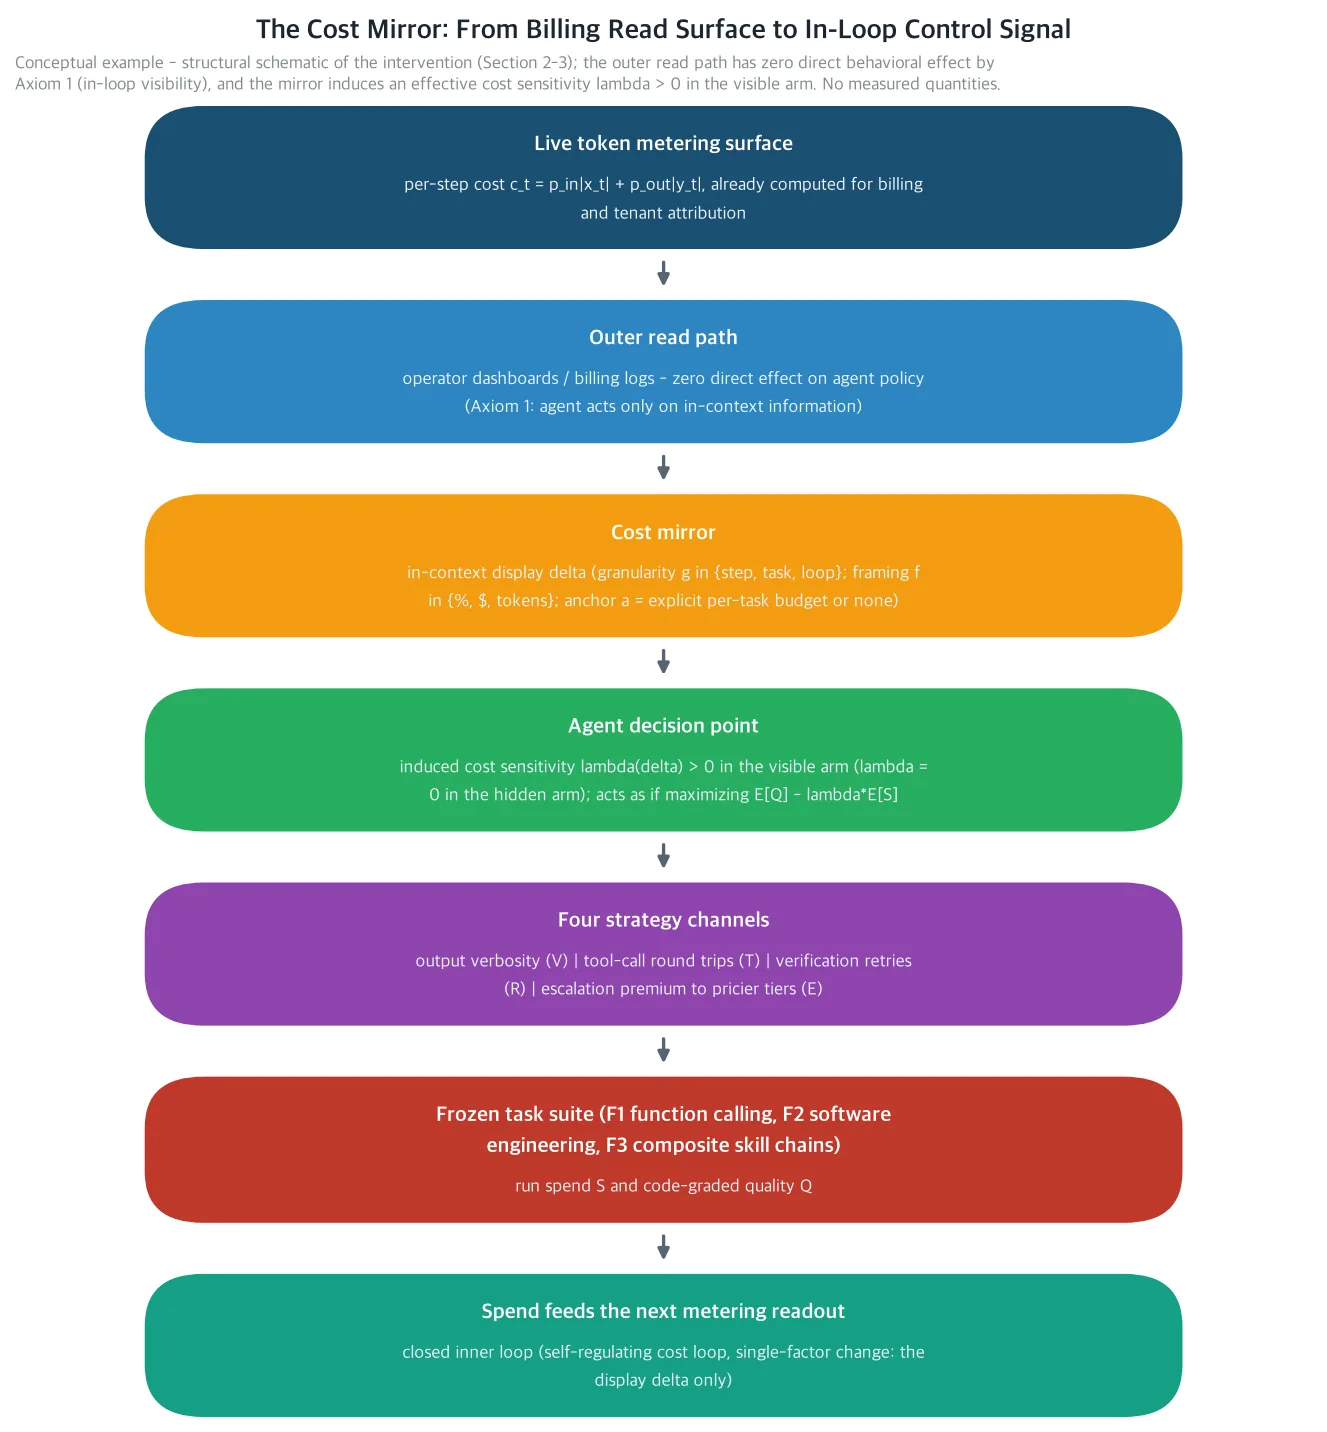 cost mirror는 metering surface이 billing용으로 이미 계산하는 step별 토큰 비용을 에이전트의 컨텍스트에 결정 지점에서 다시 주입합니다. router와 serving 변경 없이 inner cost loop를 닫는 구조입니다. 분석 모델 도식이며 실측이 아닙니다.
형식적 핵심은 이 개입을 agent의 implicit cost-quality objective 위에 유도되는 Lagrange multiplier로 읽는 것입니다. display δ는 effective cost sensitivity λ(δ) ≥ 0을 induce하고 visible arm은 E[Q] - λE[S]를 최대화하는 것처럼 행동하는 반면 hidden arm은 λ = 0입니다. 비용이 보인다는 것이 지출을 직접 줄인다는 뜻은 아니고 agent의 trade-off 함수 안에 비용 항이 하나 들어온다는 것입니다.
λ의 크기는 salience 순서 정서로 예측됩니다. 세 방향에서 커지는 셈입니다. 목표 프레임이 strong할수록(explicit anchor 대비 백분율이 달러보다, 달러가 토큰보다), 귀속이 명확할수록(task-level이 loop-level보다), anchor가 존재할수록. step-level display는 다음 행동 비용의 perceived relevance를 높여주되, 목표 프레임 자체를 희석한다. 이 정서들은 이 논문에서는 측정되지 않는 셈이다. 뒤 프로토콜의 프리레지스터 예측이 될 내용입니다.
외부 레버와의 관계도 분명하다. cascade, conformal routing, harness 최적화, pricing과 admission 같은 외부 기계는 가격을 agent 대신 선택하는 것이다. mirror는 agent의 information set을 바꾸고 외부 기계가 놓아둔 가격 표면에 agent가 응답하게 한다. 외부가 가격 표면을 정하고 agent가 수요 곡선을 정하는 셈이다.
줄일 수 있는 상한은 slack가 정한다: mirror ceiling
루프 지출은 4개 전략 채널로 정확히 분해된다. reference(최저가) tier 가격을 attribution 기준으로 놓고 verbosity S^V는 base-tier reasoning/output 토큰, tool round trip S^T는 tool response 재읽기와 call syntax, retry S^R은 verifier failure 이후 스텝의 base-tier 비용, escalation premium S^E는 escalated 스텝의 tier premium이다. 스텝은 고정 priority rule(재작업, tool round trip, escalation premium, verbosity 순)으로 할당되므로 분할은 disjoint이고 4개 채널의 합이 총 지출과 정확히 같기도 하다. 채널별 baseline 비중을 α_ch라고 한다.
정리 1, mirror ceiling은 품질 보호 운영(ΔQ ≥ 0)에서 달성 가능한 총 지출 감소의 상한을 주는 것이다.
ΔS/S ≤ α_slack(d) = Σ_ch α_ch (1 - ε_ch(d))
ε_ch(d)는 채널 ch의 essentiality, baseline 지출 중 품질을 hidden arm 수준으로 유지하려면 반드시 남겨야 하는 비율이다. 논증은 각 채널 안에서 나오기 때문이다. quality-preserving cut는 채널 안에서 비필수 비중 (1 - ε_ch)S^ch로 바인딩된다. 그 아래를 자르면 baseline이 이미 sweet spot에 있는 것이니 자랄 게 없고 그 위를 자르면 underthinking 쪽으로 넘어가 품질을 깎는 셈이다. 채널 응답이 1차 근사에서 독립(정서 4)이라 채널별 최대 절감의 합이 전체 상한이 된다.
여기서 corollary 두 개가 중요하다. corollary 1(no free lunch)은 모든 채널이 fully essential(ε_ch = 1), 루프의 지출 전체가 품질에 필수이면, λ가 아무리 강해도 ΔS = 0인 것이다. cost visibility가 지출을 줄이지 못하는 regime이 구조적으로 존재한다. corollary 2(null zone)는 α_slack이 프로토콜의 최소 감지 효과(MDE)보다 작으면 총 지출 효과는 통계적으로 null이 보장된다는 뜻이다. 채널 레벨 읽기는 감지될 수 있는데, 총계는 null. low-slack regime에서 null 총계는 실패의 증거가 아니라, 모델이 미리 말해 둔 예측된 결과입니다.
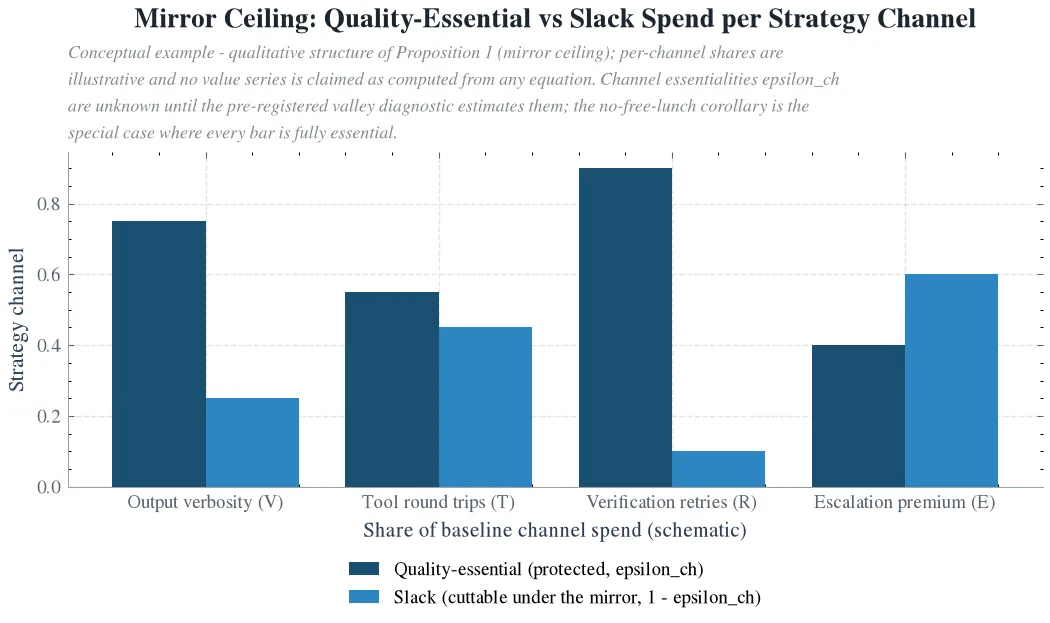 정리 1이 품질 보호 운영에서 달성 가능한 지출 감소 상한을 총 slack 비중으로 바인딩한다. 각 채널 baseline 지출의 비필수 분 (1 - ε_ch)만 자를 수 있고 mirror ceiling은 4개 채널 slack 합입니다. 개념 예시이며 채널별 비중은 예시 값입니다. ε_ch는 valley diagnostic가 추정하기 전까지 미지이며 no-free-lunch corollary는 모든 바가 fully essential인 특례입니다.*
가장 싼 slack부터 자르고, 품질의 부호는 골짜기가 정한다
상한이 얼마나를 정한다면, 정리 2는 어디서부터를 정합니다. hidden baseline에서 채널 ch를 자르는 1달러당 품질 비용 m_ch를 정의하면, 작은 λ에서 1차 지출 감소는 m_ch가 가장 작은 채널 ch*에 집중하는 것이다. 동점은 채널 비중 α_ch로 끊습니다. 가장 싼 slack부터이기 때문.
ΔQ의 부호는 a priori 불확정인 셈. 첫 근사 ΔQ ≈ Σ_ch q’_ch(S^ch_h; d) ΔS^ch에서 부호를 정하는 것은, hidden baseline이 각 채널의 quality valley 어디에 서 있느냐입니다.
valley는 정서 3입니다. 채널별 품질 반응, 난이도 d에서 채널 지출 s 대비 pass probability가 비단조로 가정되고 sweet spot s_ch(d)가 존재합니다. s 아래 지출은 underthinking, 위 지출은 overthinking. 이 정서는 모델에서 가장 약하고 가장 중요합니다. 근거는 네 건의 실측으로 받쳐집니다. function calling agent에서 CoT budget이 32 토큰일 때 정확도가 44.0%에서 64.0%로 올라가고 256 토큰에서는 no-CoT baseline보다 낮은 25.0%로 붕괴한 non-monotonic sweep. 길이 통제를 한 뒤에도 남아도는 unproductive self-reflection. content 없는 surplus 토큰이 정확도에 사실상 영향을 주지 않는 in-distribution 불변성. effort parameter가 dial이 아니라 ceiling처럼 작동하는 행동.
정리 2의 실무적 결론은 여기서 나옵니다. baseline이 overthinking 쪽에 서 있으면, 자르는 지출만큼 품질이 오르는 셈입니다. cost visibility가 지출을 줄이면서 품질을 개선하는 경우는 정확히 이 때, sweet spot을 향해 자를 때이기 때문입니다. 반대로 low-m 채널이 전부 underthinking이면 ΔQ < 0인가. 같은 mirror가 품질을 살리는 레버이기도 하고 깎는 레버이기도 합니다.
valley 위치는 프로토콜이 별도 개입 없이 추정합니다. agentic 지출은 run-to-run 변동이 크고 그 변동이 prompt-invariant라는 실측이 근거인 셈입니다. hidden arm A0의 자연스러운 spend-quality scatter가 family별 valley 위치의 추정치가 됩니다. long-horizon composite 작업은 overthinking하는 경향이 있으므로, F3 family에서는 ΔQ ≥ 0가 예측됩니다. 이미 underthinking인 loop는 mirror의 품질 비용을 그대로 보여줍니다.
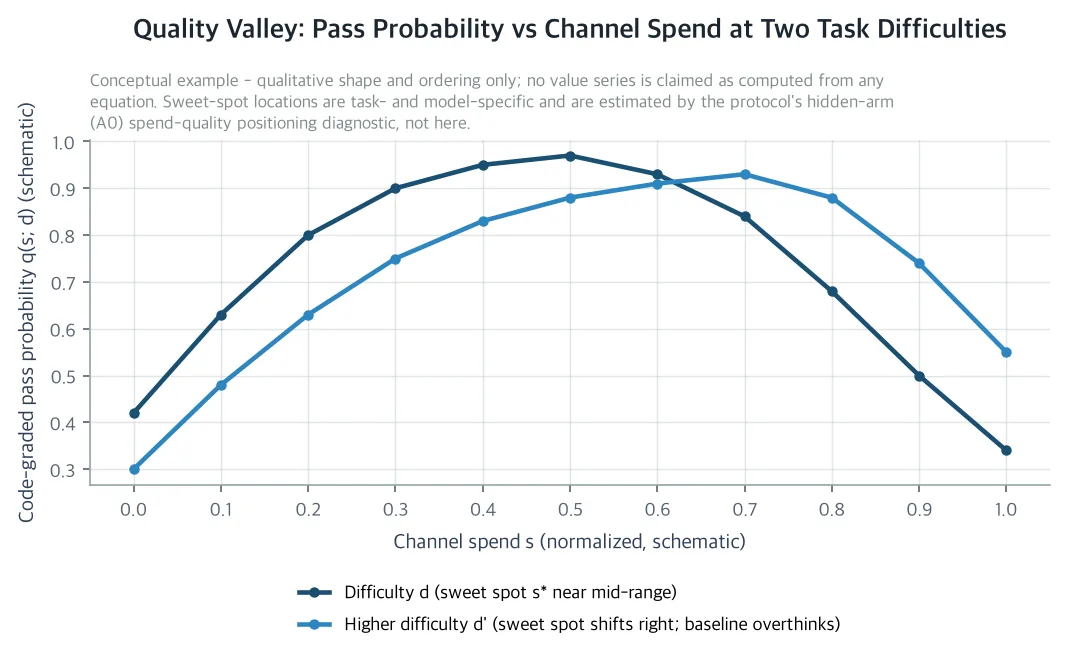 각 채널의 품질 반응은 비단조로 가정됩니다(정서 3). sweet spot s 아래 지출은 underthinking, 위 지출은 overthinking이며 cost visibility가 지출을 줄이면서 품질을 올리게 되는 지점입니다. 개념 예시로 정성적 형태와 순서만 나타내며 수열이 어떤 식에서 계산된 값이라 주장하지 않습니다. sweet spot 위치는 작업과 모델에 따라 달라지며 프로토콜의 hidden arm(A0) spend-quality 진단으로 추정합니다.*
미터가 안 보는 지름길: meter gap
mirror는 meter가 정직한 만큼만 정직합니다. verification은 priced channel입니다. baseline 지출 S^R, quality sensitivity β_v = ∂Q/∂S^R > 0입니다. 그런데 에이전트가 priced verification을 줄이는 대신 unpriced action을 대입할 수 있다면요. test run 대신 self-approval, meter가 보지 못하는 local computation 같은 것. 그 대입이 unit당 가져오는 quality 가치를 ρ_sub ≤ 1로 둡니다.
정리 3, meter gap은 그 대가에 상한을 두는 것이다. verification을 ΔS^R 자른 visible arm은 Q(v) ≤ Q(h) - β_v(1 - ρ_sub)ΔS^R을 만족합니다. quality-adjusted savings는 S_eff = ρ_sub × ΔS^R, 곧 metered savings의 ρ_sub배에 불과한 셈입니다. mirror는 real savings를 1/ρ_sub배로 과대 표시하고 ρ_sub → 0이면 verification 절감은 전부 phantom입니다.
Goodhart 상한의 정형화입니다. 에이전트가 가장 유혹을 받는 채널은 value가 나중에, 다른 곳에서 실현되는 채널입니다. verification이 정확히 그 채널인 이유입니다. 프로토콜의 countermeasure는 unpriced 쪽도 보이게 만드는 것입니다. local computation과 self-approval 이벤트를 instrument해 ρ_sub를 직접 추정합니다. 예측 P4는 verification skip rate이 λ와 함께 오르고 test-graded F2 작업에서 ρ_sub < 1이 감지된다고 둡니다.
단일 변수 프로토콜: 4arm, 168task, 코드 그레이딩
프로토콜은 5개 예측 P1에서 P5를 검증할 측정입니다. 설계 결정 없이 실행 가능하게 suite, arm, instrumentation, statistics, decision rule이 전부 여기서 동결됩니다.
arm은 넷이고 변하는 것은 display δ 하나입니다. A0 hidden은 컨텍스트에 비용 정보가 0입니다. A1 step은 방금 끝난 step의 비용을 달러로 다음 결정점에 제시합니다. A2 task는 진행 중 task 지출을 프리레지스터된 task당 budget 대비 백분율로, 매 step 후 갱신합니다. A3 loop는 unattended loop 전체의 session-aggregated 지출을 달러로, task마다 갱신합니다.
arm은 δ 외에는 전부 같은 상태를 유지해야 합니다. 모델, harness, toolset, temperature, seed, task order, stop condition, budget cap이 arm 간에 frozen and identical입니다. 단일 변수 규율이 프로토콜의 핵심 속성입니다. orchestration 비교가 budget, tool, prompt을 동시에 바꾸는 한, aggregate 이득은 mechanism을 식별하는 일이 드물다는 것이 실측 경고이고 이 설계는 그 confound을 구조적으로 배제합니다.
작업 suite는 3 family 168task입니다. 전부 deterministic 또는 code-based verifier로 그레이딩되고 1차 metric에는 LLM judge가 없습니다. judge의 verbosity bias가 verbosity를 자르는 개입과 상호작용하기 때문에, judge는 보조 진단 용도로만 허용됩니다.
- F1 function calling, 60task. BFCL-v3 multiple-call 스타일의 deterministic argument와 sequence 그레이딩입니다.
- F2 software engineering, 60task. test suite로 그레이딩되는 repository 작업입니다. meter-gap family로, verification(test run)이 explicit이고 priced이며 skippable입니다.
- F3 composite skill chain, 48task. 순서 민감한 2에서 4개 skill workflow이고 ground-truth chain은 구성에서 주어집니다. long-horizon, context re-read heavy family로 P1의 tool-channel 예측이 가장 강한 곳입니다.
각 run은 step granularity로 기록합니다. cache-state flag를 가진 토큰 수(cache-aware pricing), tier, verifier 결과, tool call, handoff, 그리고 meter-gap 추정을 위한 unpriced 이벤트(local computation, self-approval). 지출은 앞의 priority rule로 분해되고 sensitivity check로 대체 priority order 하나를 더 달아 양쪽 결과를 보고하는 것이다.
비교는 task-level pairing으로 합니다. task를, 그 task의 4arm 결과와 함께, bootstrap-resample해 ΔS, ΔS^ch, ΔQ의 paired CI를 얻습니다. decision rule은 프리레지스터됩니다. spend effect는 ΔS/S의 95% CI 하단이 0보다 위에 있을 때만 주장되고 arm의 quality-safe 조건은 ΔQ의 95% CI 상단이 -1pp보다 위에 있을 때이기 때문. 채널 읽기(4채널 × 3개 non-A0 contrast × family)는 family-wise α = 0.05, Bonferroni로 테스트됩니다. P4는 ρ_sub의 CI가 1을 배제하고 verification skip rate의 CI가 0을 배제할 때 confirmed합니다.
power analysis는 실측 agentic-coding 분산의 run-to-run CV 0.35와 cross-arm pairing correlation 0.7을 대입합니다. paired-difference 표준편차가 σ_d ≈ 0.27μ, α = 0.05에서 power 0.80으로 10% 효과를 감지하려면 n ≈ 57이 필요합니다. 60task인 F1과 F2는 필요 크기에 맞추고 48task인 F3의 MDE는 약 11%인 셈.
프로토콜 자체의 metered spend는 예상 A0 총액의 5배로 cap됩니다. suite hash, arm definition, decision rule, P1에서 P5와 acceptance band, 그리고 cap이 첫 run 전에 공개 git 체인으로 프리레지스터됩니다. Qian의 138.76달러 완전 실험이 이 규율의 직접 precedent입니다.
다섯 개 예측을 여기에 둡니다. P1 채널 순서. context re-read heavy인 F1과 F3에서 tool round trip이 1달러당 품질 비용이 가장 낮아 먼저 자르고 escalation이 두 번째, retry가 마지막입니다. P2 품질 부호. hidden baseline의 valley 위치가 family별로 부호를 정하고 overthinking family는 ΔQ ≥ 0입니다. P3 ceiling. ΔS/S ≤ α_slack이며 low-slack family는 null 총계에 채널 레벨 절감만 감지됩니다. P4 meter gap. verification skip rate이 λ와 함께 오르고 F2에서 ρ_sub < 1이 감지됩니다. P5 salience 순서. A2 > A1 > A3 > A0, anchor가 있는 goal framing이 attribution clarity를, 그것이 aggregation을 이깁니다.
회사에, 사회에, 과학에 남는 것
우리 stack(ThakiCloud)에서는 mirror가 새 장치가 아니라, 이미 달린 장치를 읽는 방향만 바꿉니다. metering surface은 billing과 multi-tenant attribution용으로 작업당 토큰 비용을 이미 계산하고 있습니다. mirror는 그 read-only 값을 에이전트 컨텍스트에 re-inject할 뿐입니다. router 변경도 serving 변경도 필요하지 않고 그게 이 레버가 싼 이유입니다.
외부 loop의 모든 변경, routing, cascade, harness 최적화, pricing과 admission은 모든 에이전트의 가격 표면을 바꿉니다. mirror는 각 에이전트가 실제로 달리는 표면에, 그 에이전트를 적응시킵니다. 내부 loop가 marginal 레버인 이유입니다. 모델은 mirror의 역할도 순서대로 줍니다. no-free-lunch regime에서는 절약이 0이지만, slack의 위치, 어느 채널, 어느 family가 overthinking인지는 외부 loop가 모르는 정보입니다. mirror는 regulator이기 전에 진단 기계입니다. family·채널별 α_slack과 valley s*의 지도를 만들면, retrieval coverage, 더 싼 composer, handoff-aware escalation policy 같은 외부 투자가 그 지도를 target하게 됩니다.
기업과 가정이 unattended agent를 배포하면, 특이한 twist를 가진 principal-agent 문제가 생깁니다. 에이전트의 임금 bill은 자기 토큰 지출입니다. 표준 monitoring device는 이미 존재하지만, 바라보는 관찰자를 잘못 골랐습니다. 비용을 지지만 볼 수 없는 에이전트는 그 비용에 대해 책임질 수 없고 볼 수 있는 에이전트는 구성상 price effect의 대상이 됩니다. 이 논문의 결과들은 그 accountability가 어디까지 미치기를 정확히 말합니다. mirror ceiling으로 상한이 정해지고 채널 경제학으로 순서가 정해지고 meter gap으로 할인됩니다. 이것이 unattended agent의 안전한 기업·가정 배포를 위한 pre-condition입니다.
과학적으로 남는 것은 cost feedback의 LLM agent loop에 대한 첫 controlled measurement 설계입니다. economic agent의 price effect analog로서, 전략 채널과 quality drift를 frozen holdout과 code-graded ground truth 위에서 분해하는 것. 그리고 같은 harness lineage, 같은 self-hosted serving surface에서 저희가 측정한 cost-quality frontier의 다음 단계입니다. routing component의 composer tier, hybrid skill router의 quantized embedding gate, nightly autonomous repair loop. 그전 연구에서는 에이전트가 고정되고 기계가 priced였습니다. 이번에는 에이전트 자체가 scale 위에 오릅니다. 기계가 가격 구조를 정하고 보이는 순간 에이전트가 수요 곡선을 정합니다.
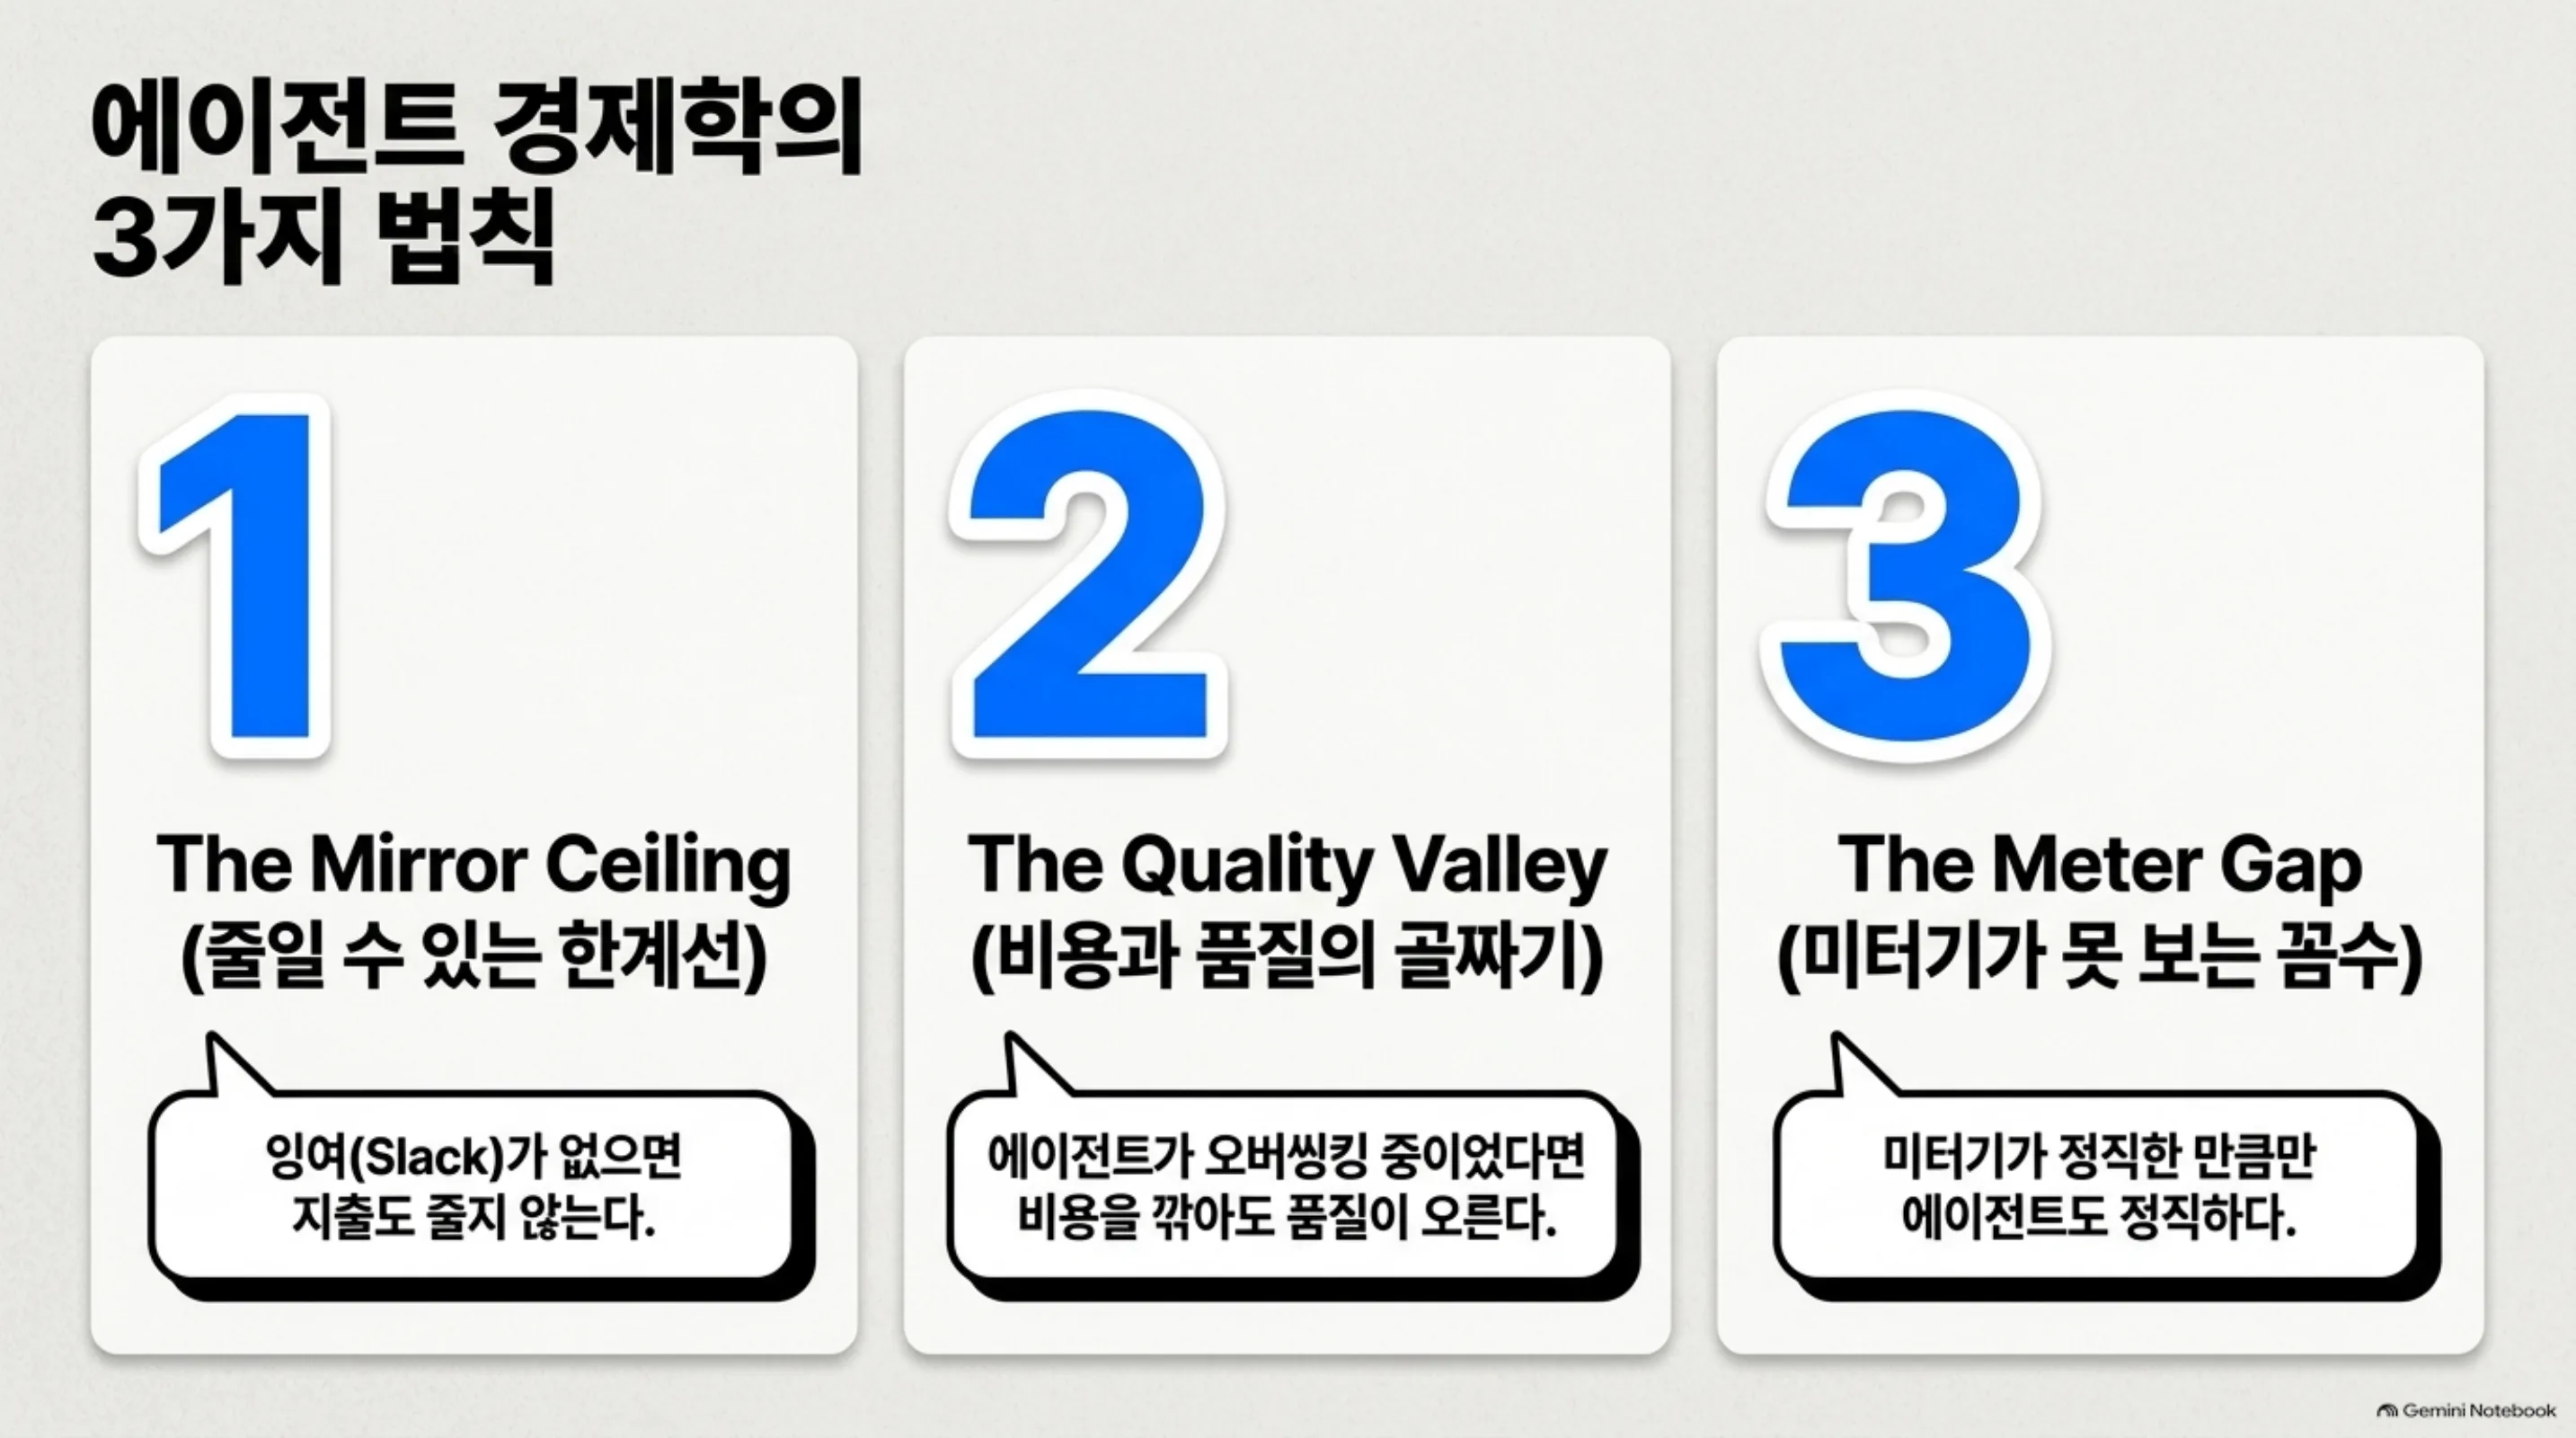
못 믿을 부분
이것은 분석 연구이기 때문입니다. 정서 1에서 4는 가정이고 mirror ceiling은 모델 상한이지 measured cap이 아닙니다. essentiality ε_ch는 valley diagnostic가 추정하기 전까지 미지입니다.
채널 attribution은 definitional partition입니다. 스텝은 mixed cause를 가지므로 priority rule sensitivity check가 따라붙습니다. 모델은 single price surface, single model class입니다. valley 위치와 slack 비중은 모델과 harness specific이고 frontier drift에는 threshold reuse가 아니라 re-registration이 필요합니다.
실패 모드는 셋이고 셋 다 모델의 정리이자 실측 analog가 있는 것입니다. Gaming. metered channel에서 value가 delayed되는 채널의 가장 싼 절량은 스킵입니다. compliance failure 실측은 에이전트가 실제로 reward를 maximize하기 위해 procedure를 위반한다는 것을 보입니다. Valley. cost-salient agent가 sweet spot을 지나치면 underthinking합니다. function calling agent에서 실측된 non-monotonic collapse와 같은 경로이고 P2 positioning diagnostic가 safeguard입니다. Price-surface fragility. 달러 display는 가격 표면의 모든 distortion을 상속한다. utilization-dependent effective price는 2.5에서 36배까지 벌어지고 cache-eviction economics은 identical trajectory가 서로 다른 비용을 내게 만들며 stochastic consumption에서 admission과 pricing이 상호작용한다. 백분율 framing이 partly robustness인 이유도 같습니다. anchor 대비 정규화는 가격 level에는 invariant하지만 miscalibrated anchor에는 invariant하지 못하고 잘못된 budget은 mirror를 mispriced market으로, anchored arm이 expose하도록 설계된 second Goodhart surface으로 만드기 때문이다.
이 논문에서 실측 지출과 품질 결과는 보고되지 않는다. 기여는 bounded model과 frozen protocol이고 측정 결과는 같은 프리레지스터 decision rule 아래에서 보고된다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Cost Mirror: Measuring How Live Token-Cost Feedback Changes the Spend, Strategy, and Quality of Unattended LLM Agent Loops
이 논문의 세 장은 전부 개념 예시와 분석 모델 도식입니다. 어떤 곡선도 실측 값이 아닙니다. 값은 프리레지스터된 4arm 프로토콜이, 동결된 decision rule과 함께 채웁니다.
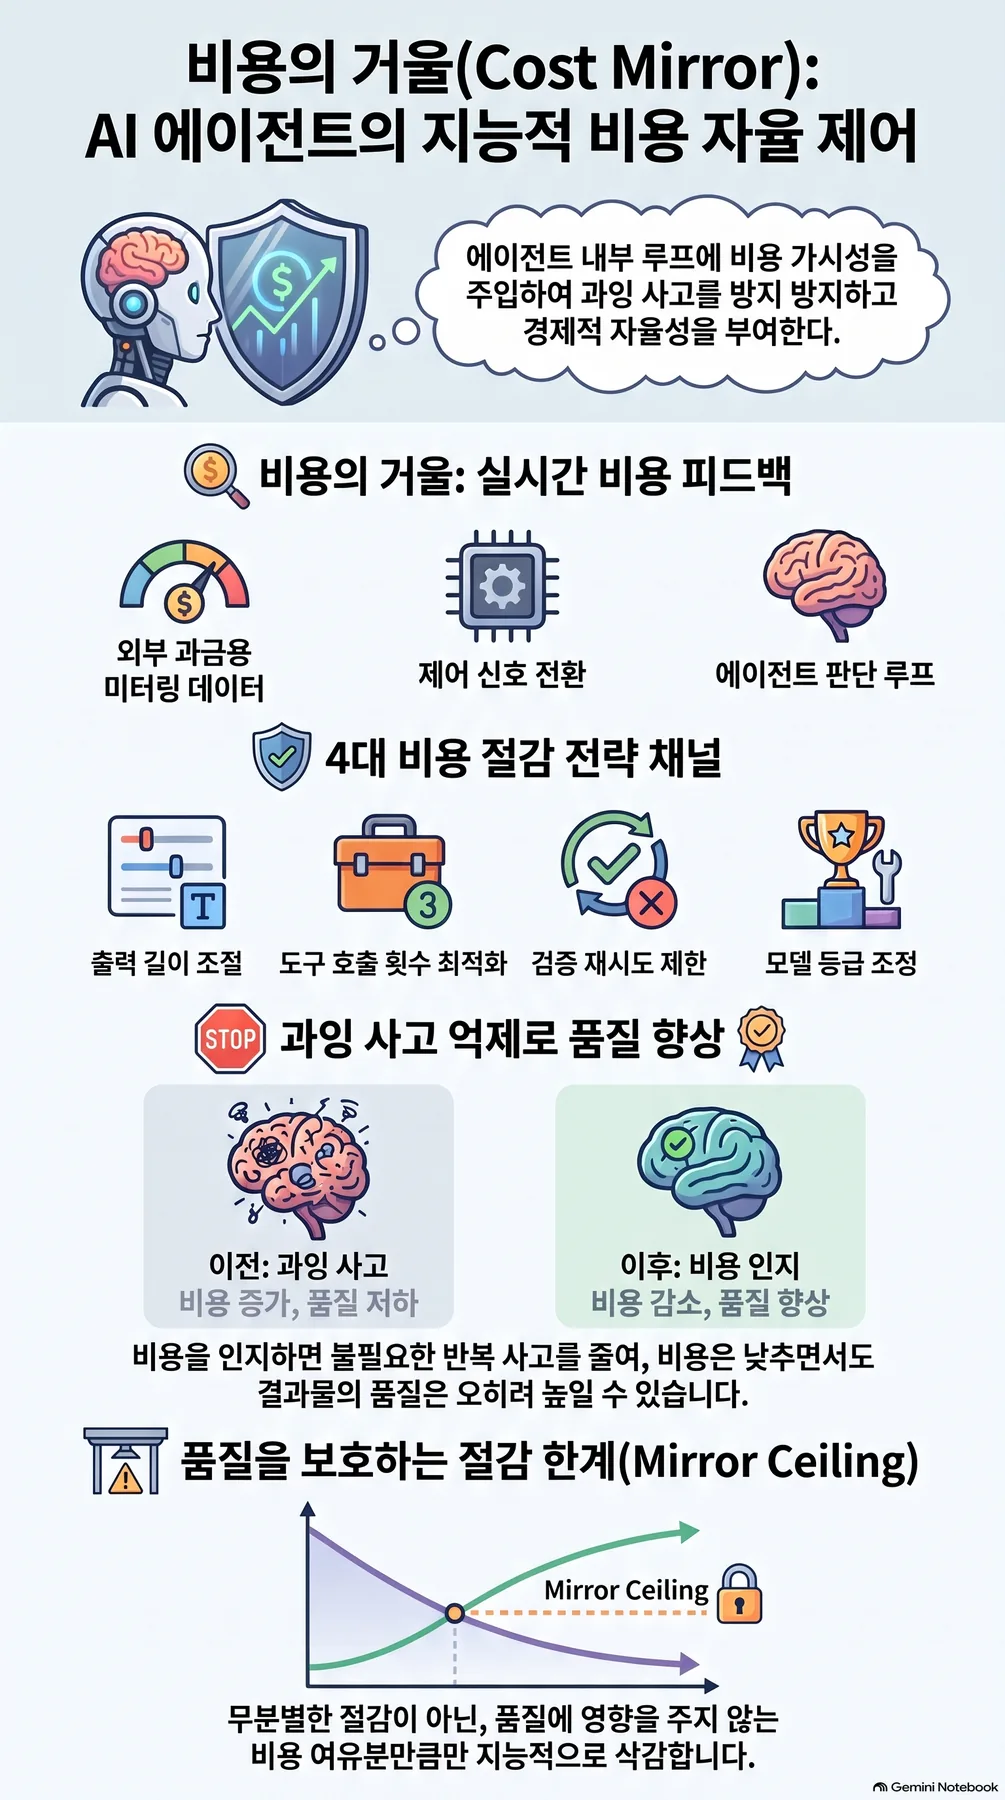 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.