검증기의 배당: 무료 검증기가 걸린 무인 에이전트에서 툴콜 정확도 1포인트를 사는 가장 싼 레버
양자화 셀프호스티드 체크포인트 위 무인 에이전트 루프를 돌리거나, 그 서빙 비용을 책임지는 엔지니어라면 이 글이 곧 오늘 일입니다. 이 논문은 툴콜 정확도 1포인트를 샘플링 비용으로 매깁니다. 검증-후-리샘플, k샘플 컨센서스, 모델 티어 업그레이드 중 어떤 레버가 가장 싼지, 그리고 리샘플링의 한계 배당이 티어 업그레이드 하나 값 아래로 내려오는 샘플 수까지 답합니다. 모든 숫자는 명시된 전제 하의 해석 모델 예측이며 논문은 실측으로 가는 길까지 사전 등록해 둡니다.
 글의 핵심 개념을 형상화했습니다.
루프 안의 유일한 정답 신호는 무료 검증기
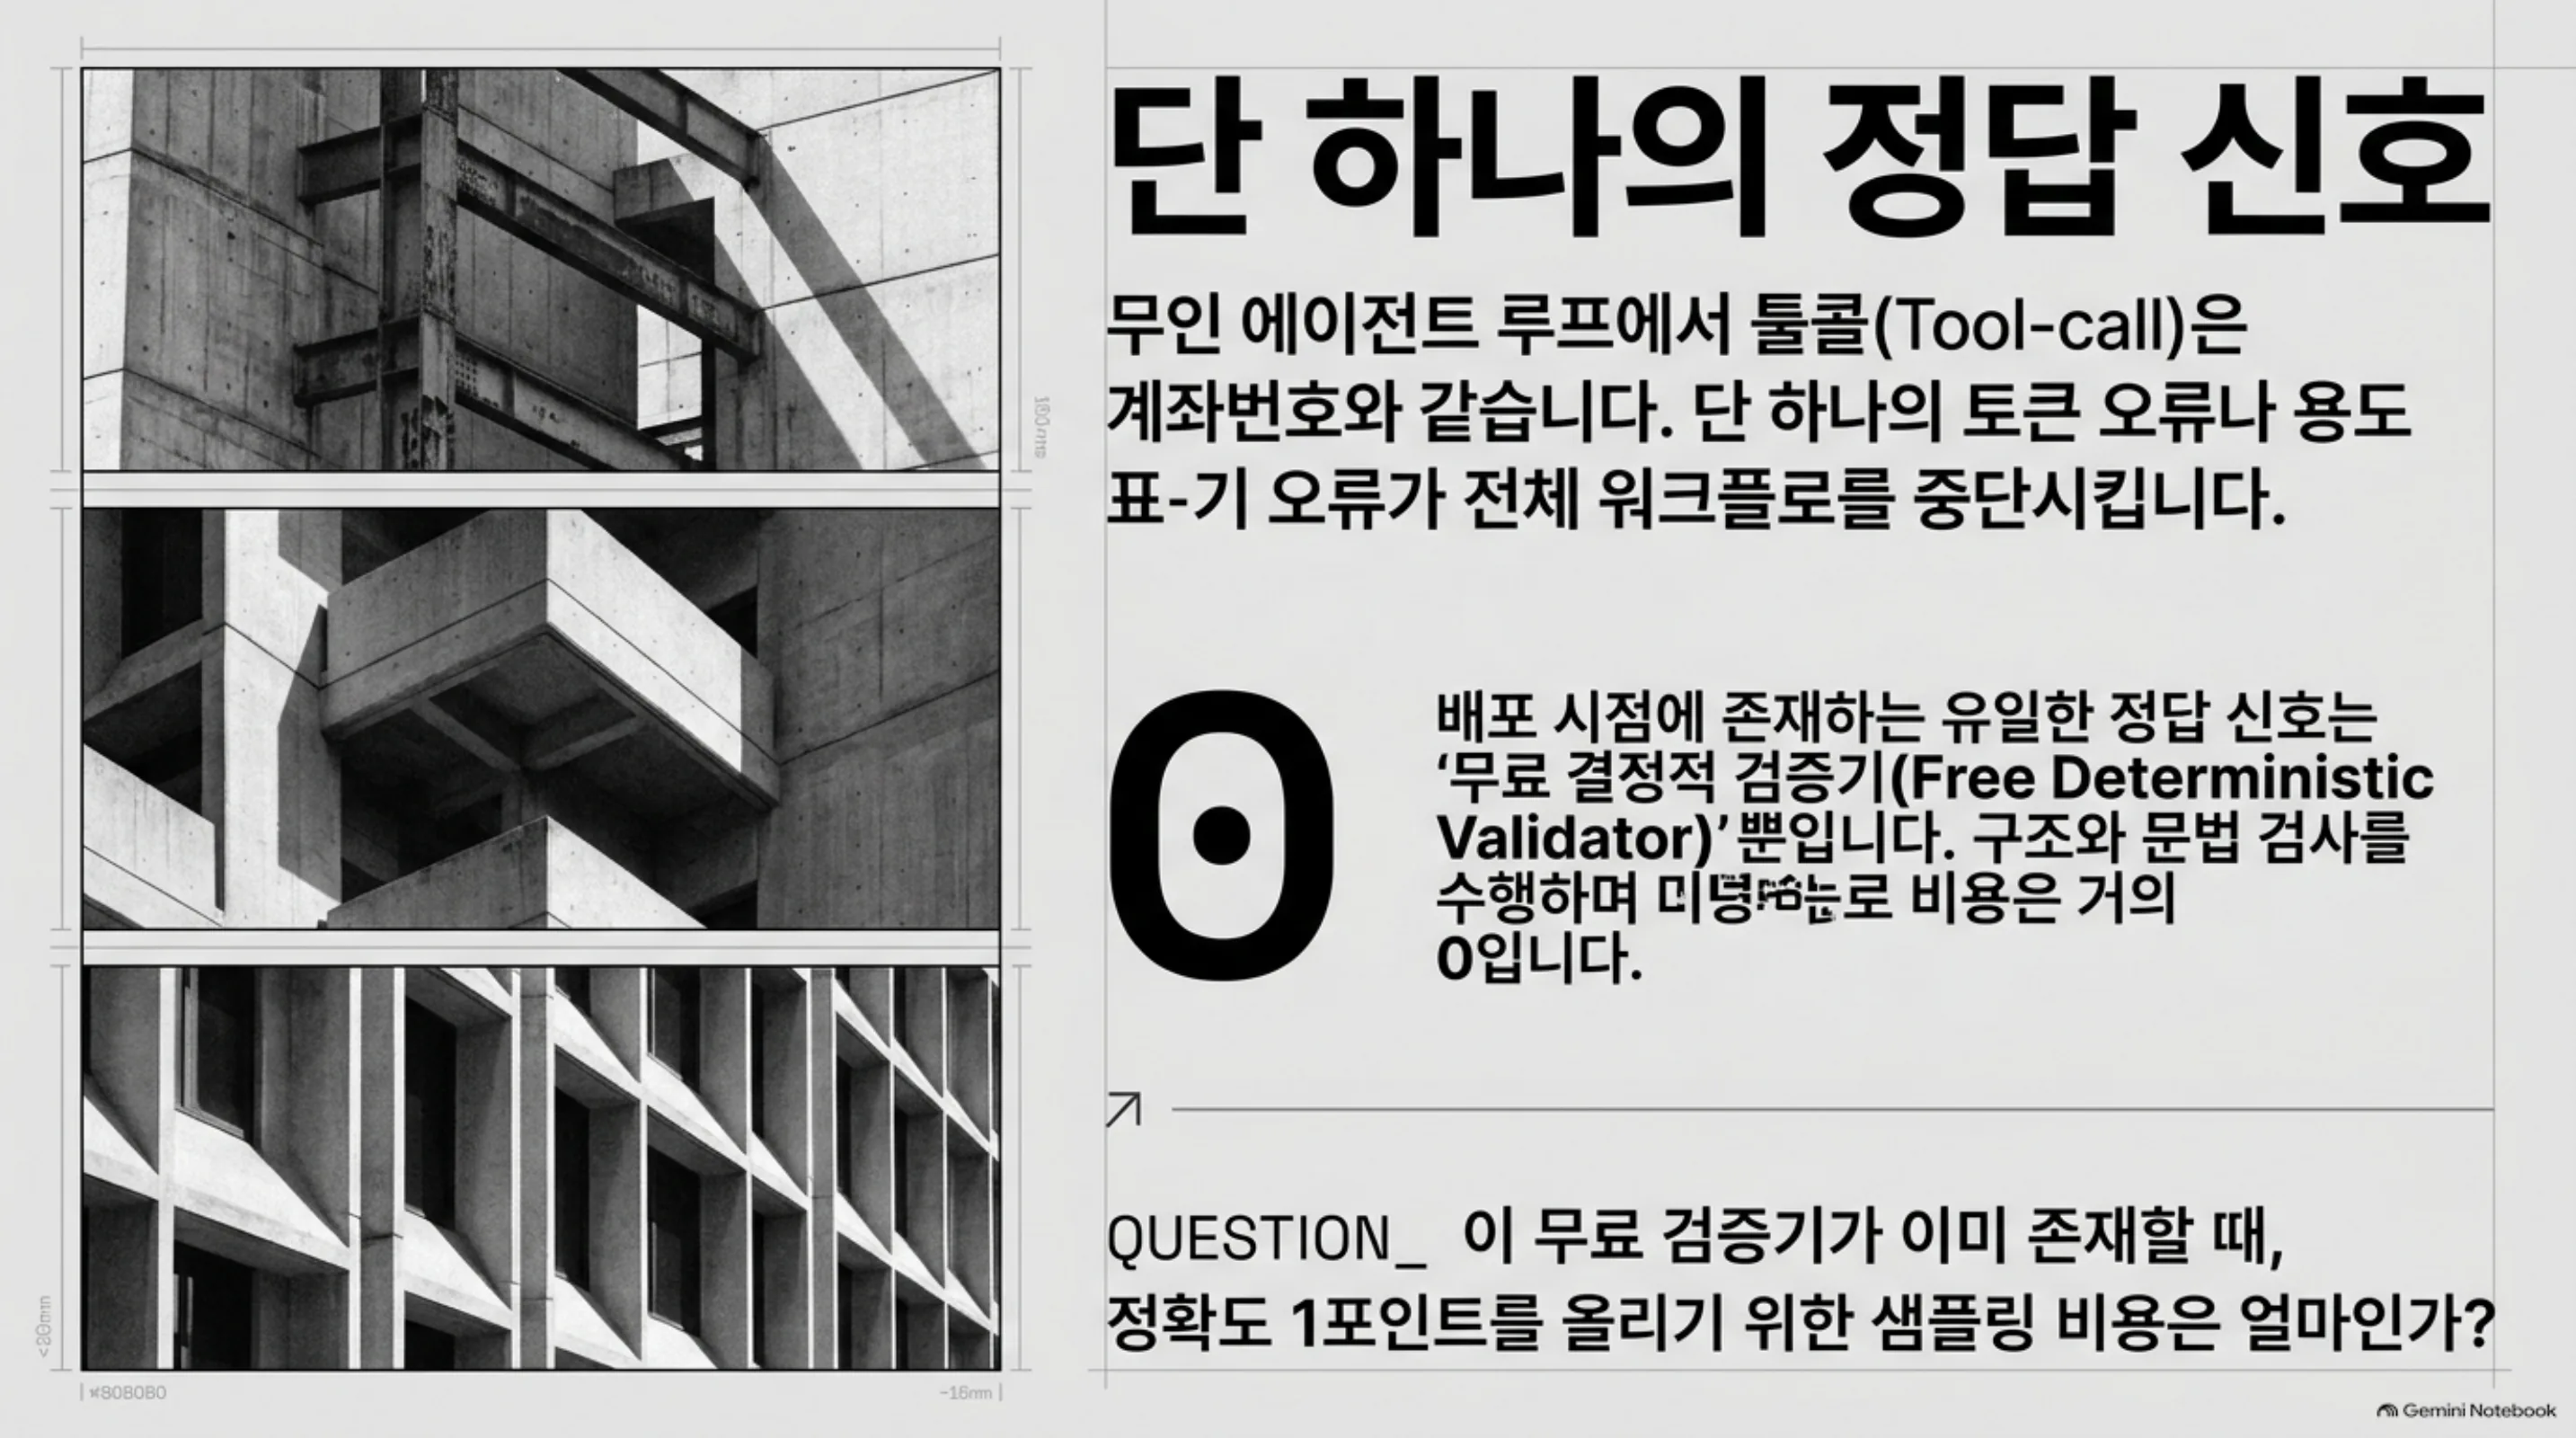
무인 에이전트 루프는 모든 툴콜을 신뢰해야 합니다. 각 계획 인스턴스는 툴콜 플랜, 즉 이름을 가진 인자를 둔 도구 호출의 순서 목록을 만들고 JSON이나 AST로 직렬화합니다. 뒤의 코드가 함수 이름과 인자 값, 호출 개수를 그대로 받아 쓰므로 한 토큰만 어긋나면 워크플로 전체가 멈춥니다. 툴콜은 계좌번호에 가깝습니다. 계좌번호 한 자의 오기는 송금 전체를 무산시키고 용도란 한 글자의 오기는 그 문장 안에서 흡수되는 것과 같습니다.
그런데 이런 루프에서 배포 시점의 정답 신호는 하나뿐입니다. 무료 결정적 검증기, 곧 스키마와 문법 검사에 AST 수준의 구조 검사를 더한 것입니다. Berkeley Function-Calling Leaderboard(BFCL) 하네스가 쓰는 검증과 같은 구조이며 비용은 거의 0입니다. 이 검증기를 쓰든 쓰지 않든 경로 위에 있고 논문의 질문은 이것입니다. 이미 경로에 무료 검증기가 있으면, 셀프호스티드 샘플링 비용으로 툴콜 정확도 1포인트가 얼마인지?
그 예산을 두고 샘플링 레버 네 개가 경쟁하고 외생 레버 하나를 더하는 것입니다. 첫 번째는 검증-후-리샘플(VTR)입니다. 검증기가 거부하면 다시 뽑고 예산까지 모두 실패하면 기각 처리하는 셈입니다. 두 번째는 전체 플랜 과반(MAJ-k)으로, k개 샘플에서 다수 표를 택합니다. 세 번째는 인자별 컨센서스(ARG-k)로, 스켈레톤과 인자를 따로 합쳐 씁니다. 네 번째는 저가 저지 선출(JUDGE-k)로, 값싼 지역 모델이 k개 중 하나를 고릅니다. 다섯 번째는 모델 티어 업그레이드로, 샘플당 r배(r>1)가 드는 외생 레버입니다. 셀프컨시스턴시 연구는 이 추가 샘플이 무엇을 사주는지를 자유 답변 문제로 재었는데, 무료 결정적 검증기 위 구조화 에이전트 액션의 샘플링 정책 경제학은 아직 빈칸이었습니다.
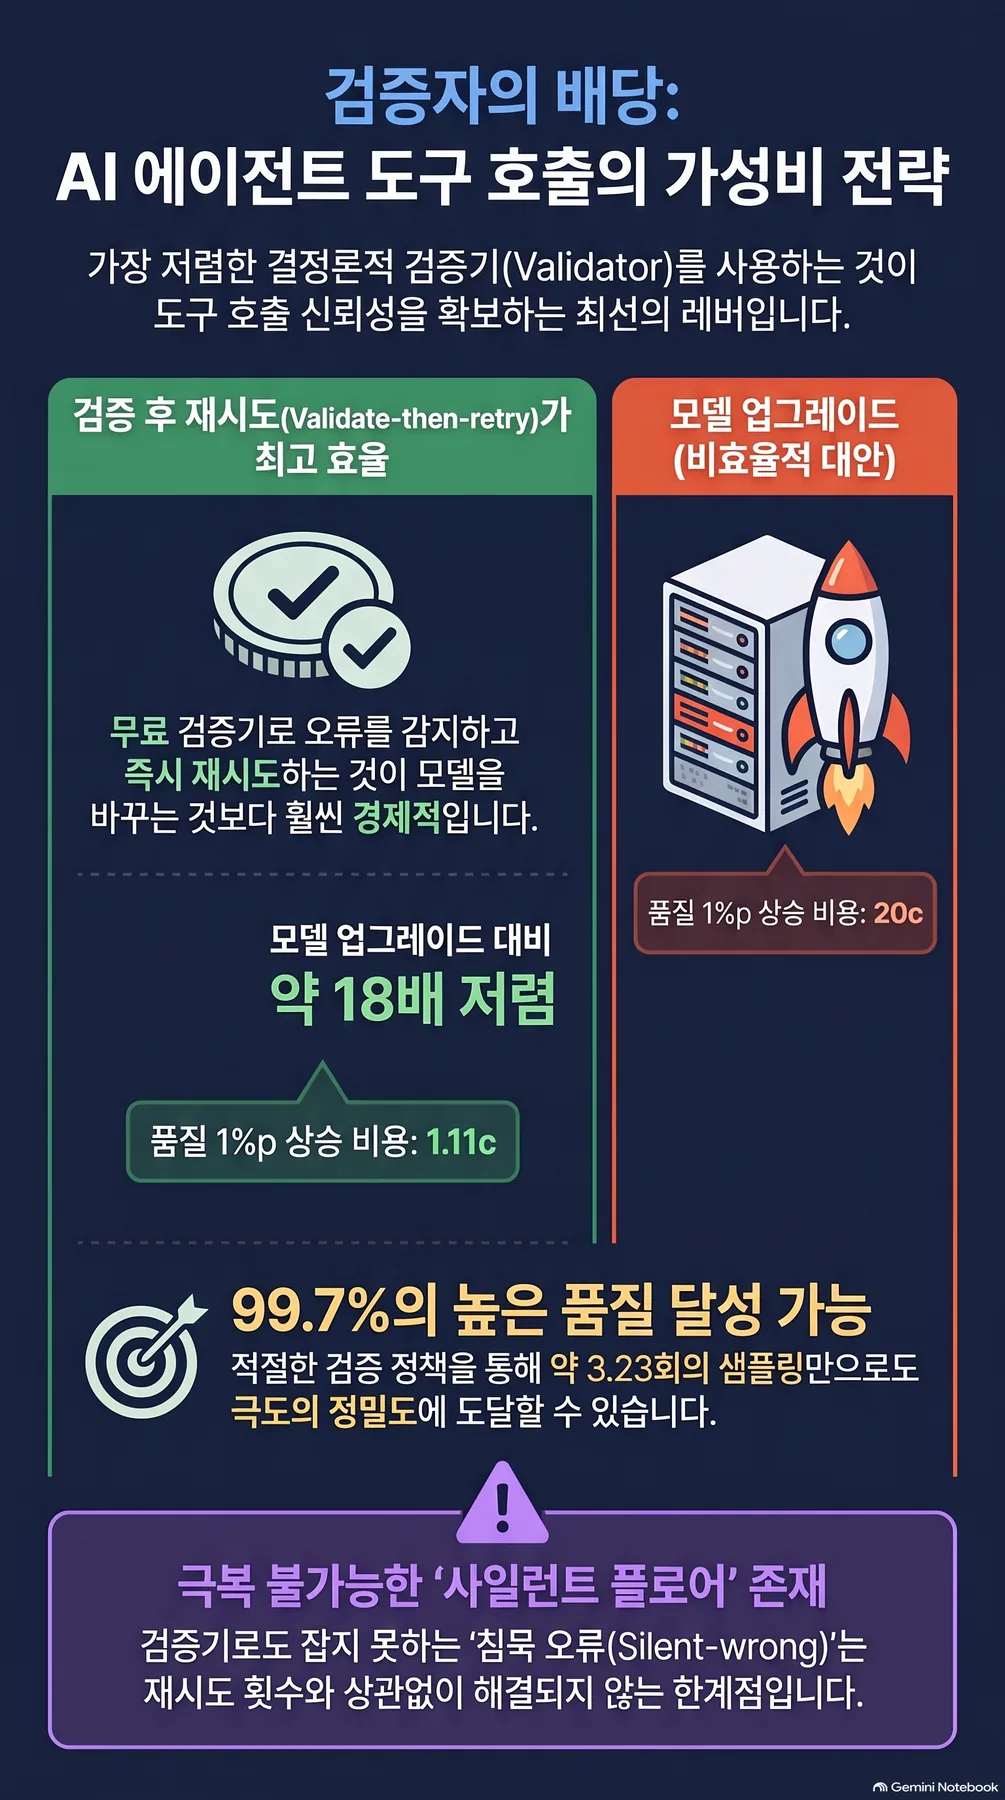
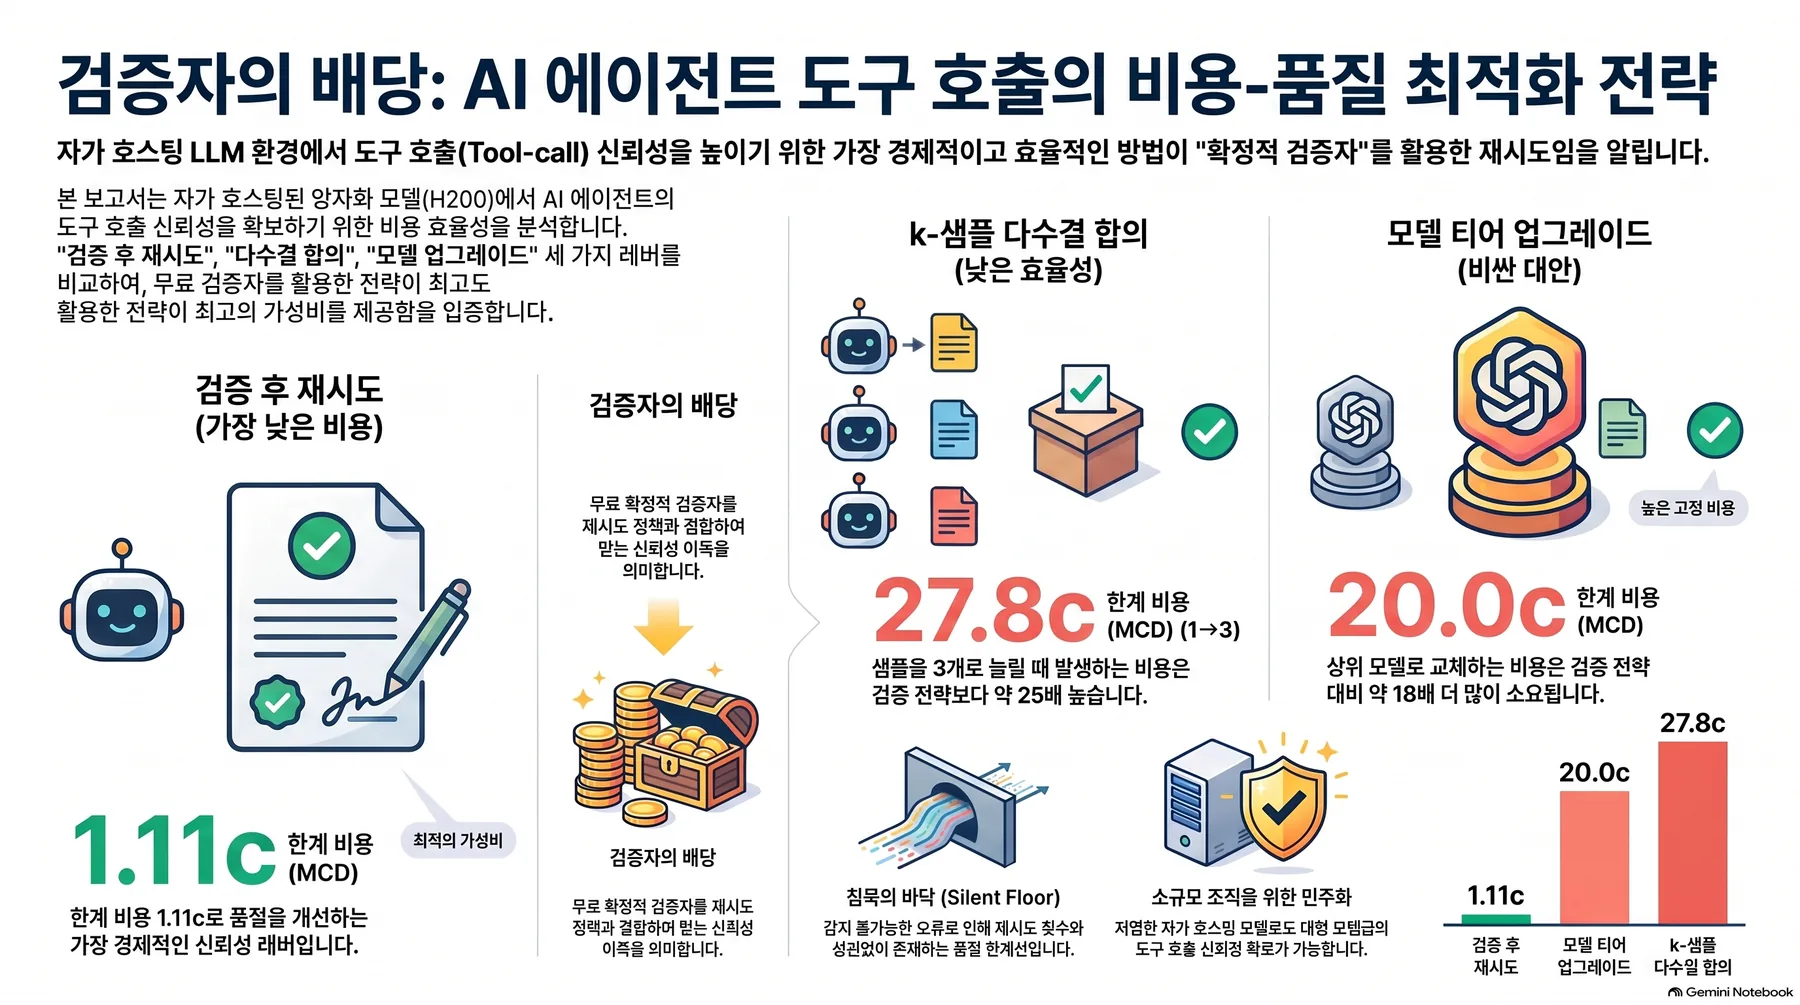 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
게이트의 배당: 무료 검증기가 사주는 것
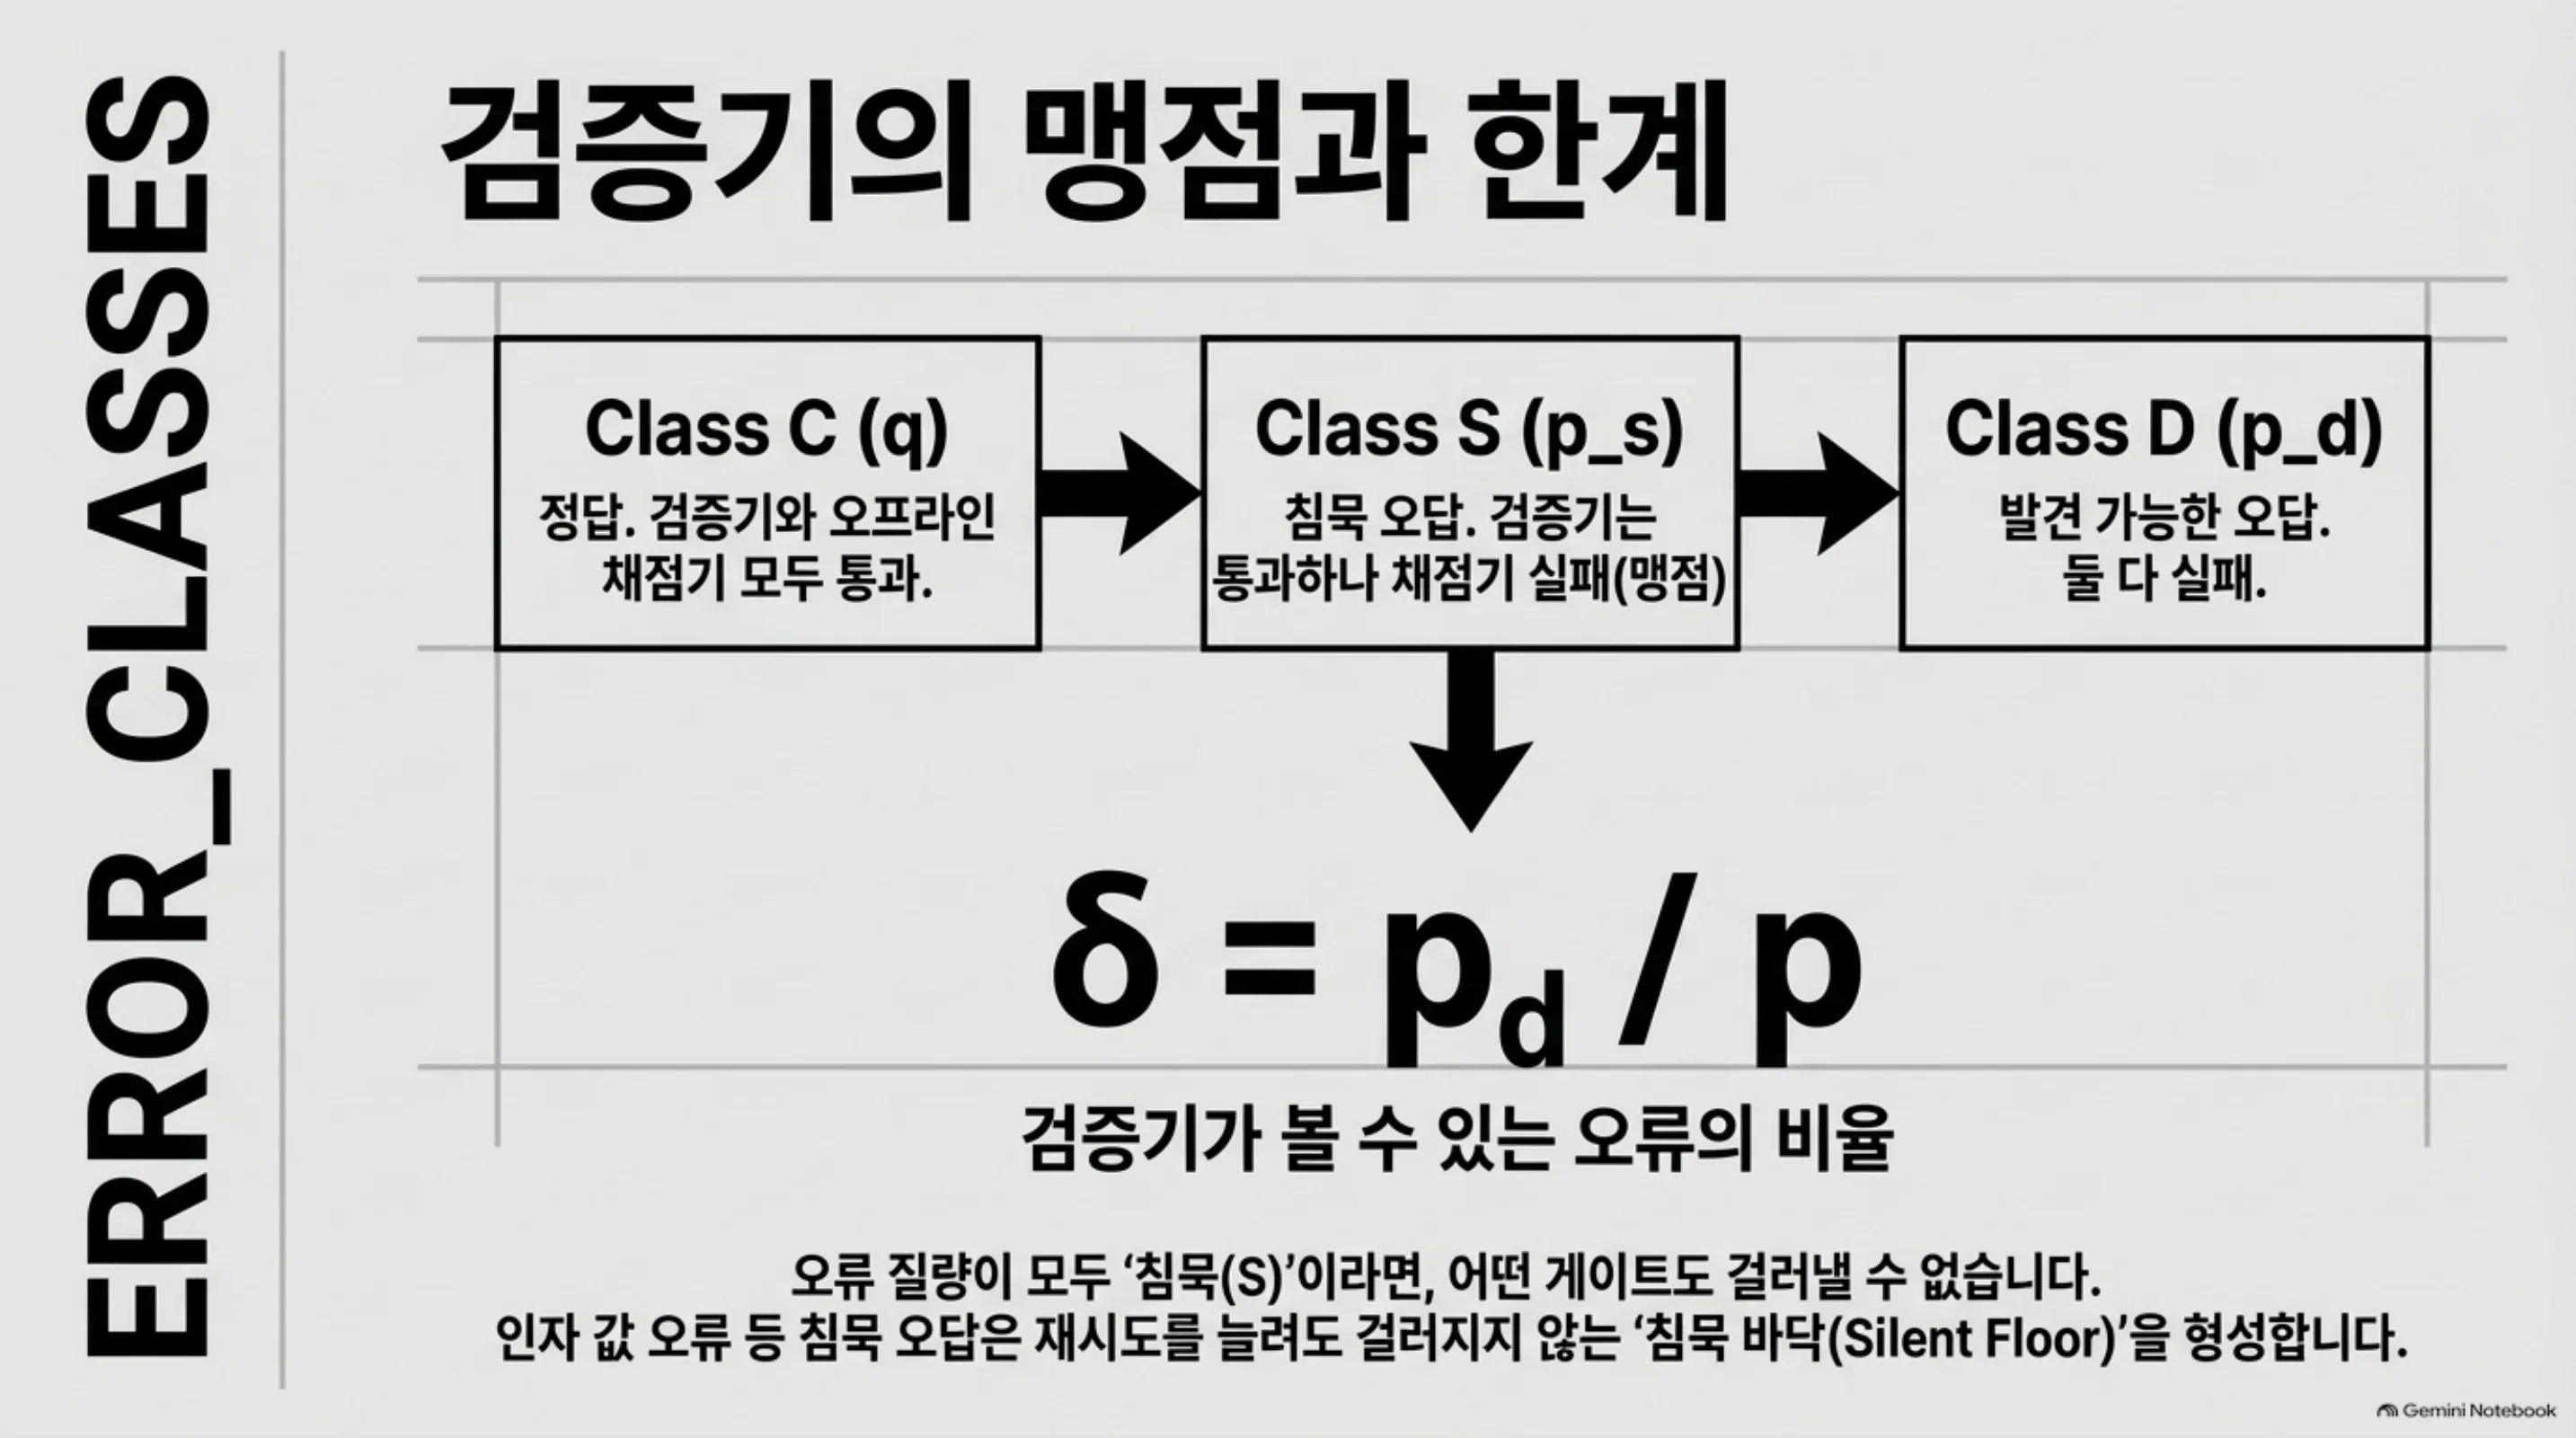
모델은 한 번의 뽑기를 세 클래스로 나눕니다. C는 정답으로, 검증기와 오프라인 결정적 채점기 G 둘 다 통과합니다. D는 발견 가능한 오답으로, 검증기와 채점기 둘 다 실패합니다. S는 침묵 오답으로, 검증기는 통과하지만 채점기는 실패합니다. 확률을 각각 q, p_d, p_s로 쓰고 셋의 합은 1입니다. 전체 오류 p=p_d+p_s 중 검증기가 볼 수 있는 비율은 δ=p_d/p이며 δ가 0에 가까워지는 경우를 검증기 맹점으로 부릅니다. 오류 질량이 전부 침묵이어서 어떤 게이트도 걸러낼 수 없는 상태입니다.
여기에 VTR 게이트를 걸면 배당 Δ=q·p_d/(1-p_d)가 생깁니다. 수용된 뽑기는 검증기 통과를 조건으로 하므로, 수용된 플랜의 조건부 질량은 q/(q+p_s)입니다. 게이트는 정확도를 q에서 q/(1-p_d)=q+Δ까지 올리고 배당은 전부 첫 수용 뽑기에서 실현합니다. 배당에는 천장이 있고 Δ는 δ·p를 넘지 않습니다. 발견 가능한 비율이 작으면 배당도 작고 맹점에서는 0입니다.
게이트의 정확도에 어떤 재시도 예산으로도 건널 수 없는 천장이 또 있습니다. 정확도의 상한은 1-p_s/(1-p_d)이며 논문은 이를 침묵 바닥이라고 부릅니다. 바닥 아래에 남는 오류는 검증기가 통과시키는 유일한 오답 클래스 S, 곧 인자 값 오류뿐입니다. 재시도를 얼마나 늘려도 이 클래스는 걸러지지 않습니다. 비용 쪽은 깨끗합니다. 기대 뽑기 수는 (1-(1-a)^n_max)/a(a=1-p_d)이고 n_max=2라면 정확히 1+p_d입니다. 발견 가능 오류율이 7퍼센트면 게이트 한 번의 기대 비용은 샘플 1.07개입니다.
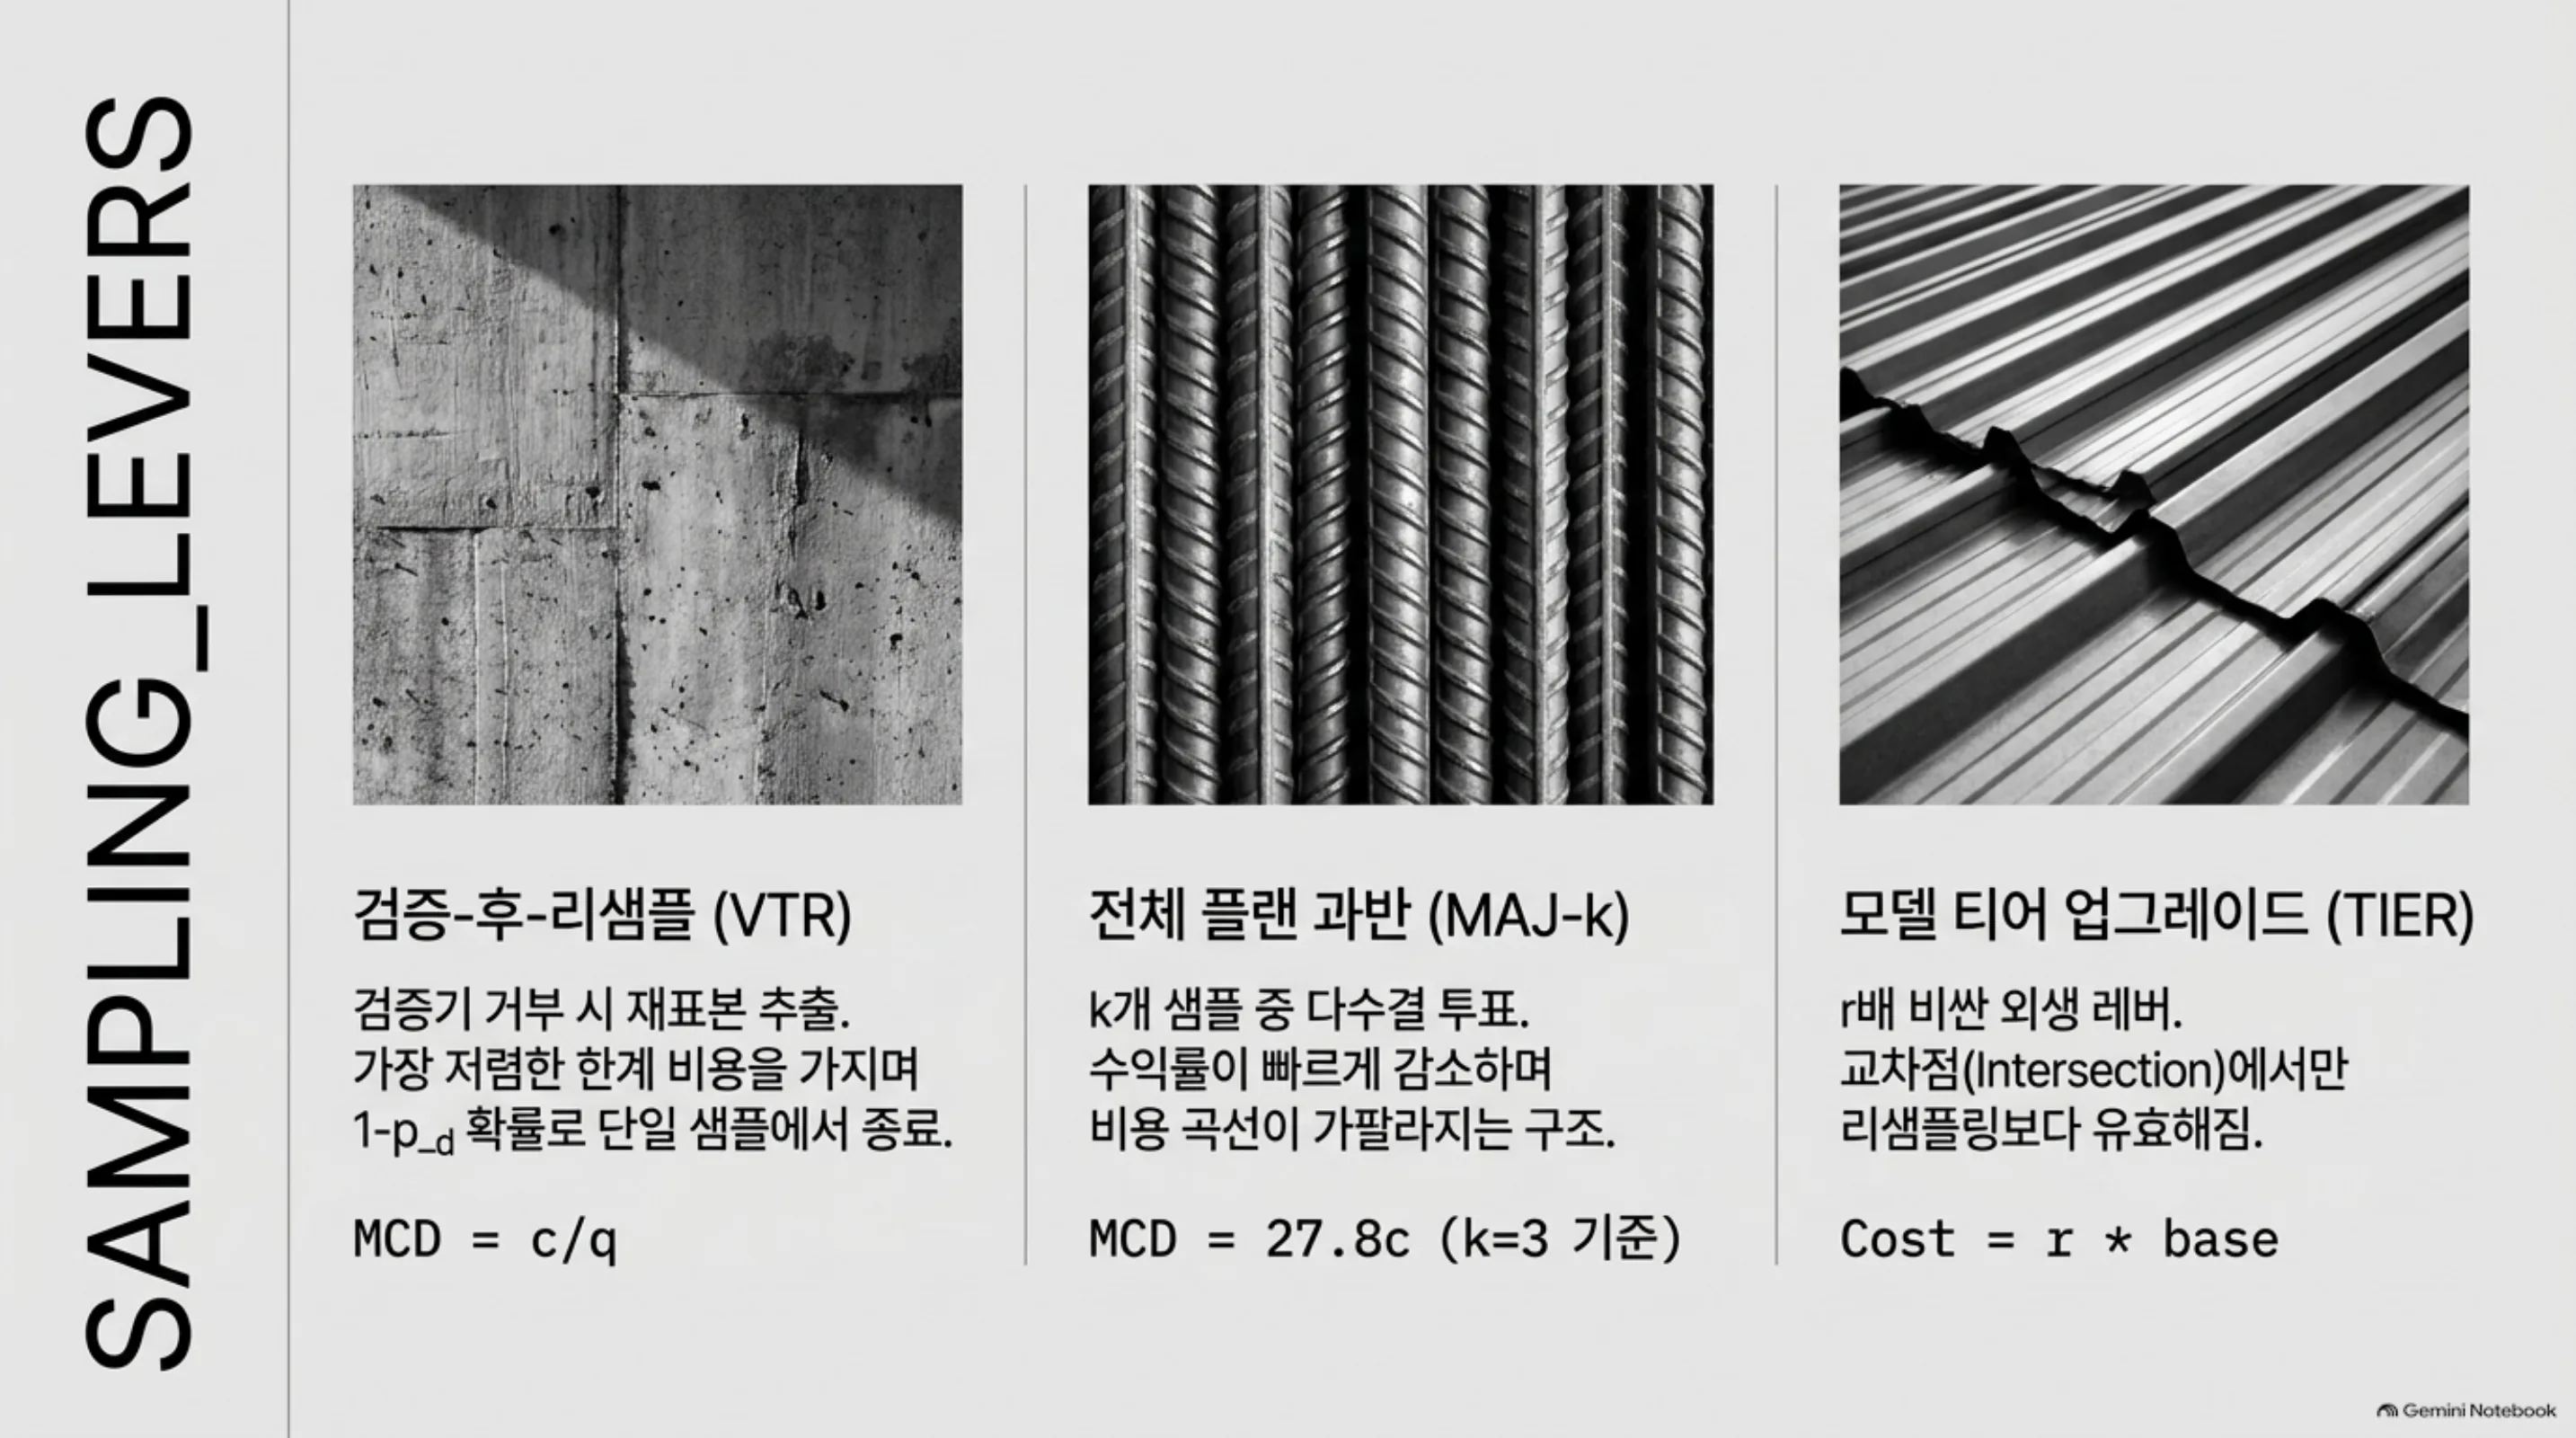
q=0.9, p_d=0.07, p_s=0.03인 해석 앵커에서 숫자는 이렇게 나옵니다. 배당 6.77포인트, 정확도 상한 96.8퍼센트, 기대 뽑기 1.07개, 마진 비용 MCD는 c/q. 품질 포인트 하나당 0.0111c입니다. 전부 닫힌 형태 식에서 유도한 값이며 실측이 아닙니다.
게이트의 가치는 정확도에만 있지 않은 셈입니다. 1-p_d 확률로 루프가 단일 샘플에서 끝나므로 기대 추가 비용은 p_d뿐입니다. 게이트는 발견 가능 오류 비율만큼의 추가 지연과 GPU 시간으로 정확도를 사는 레버라는 뜻입니다.
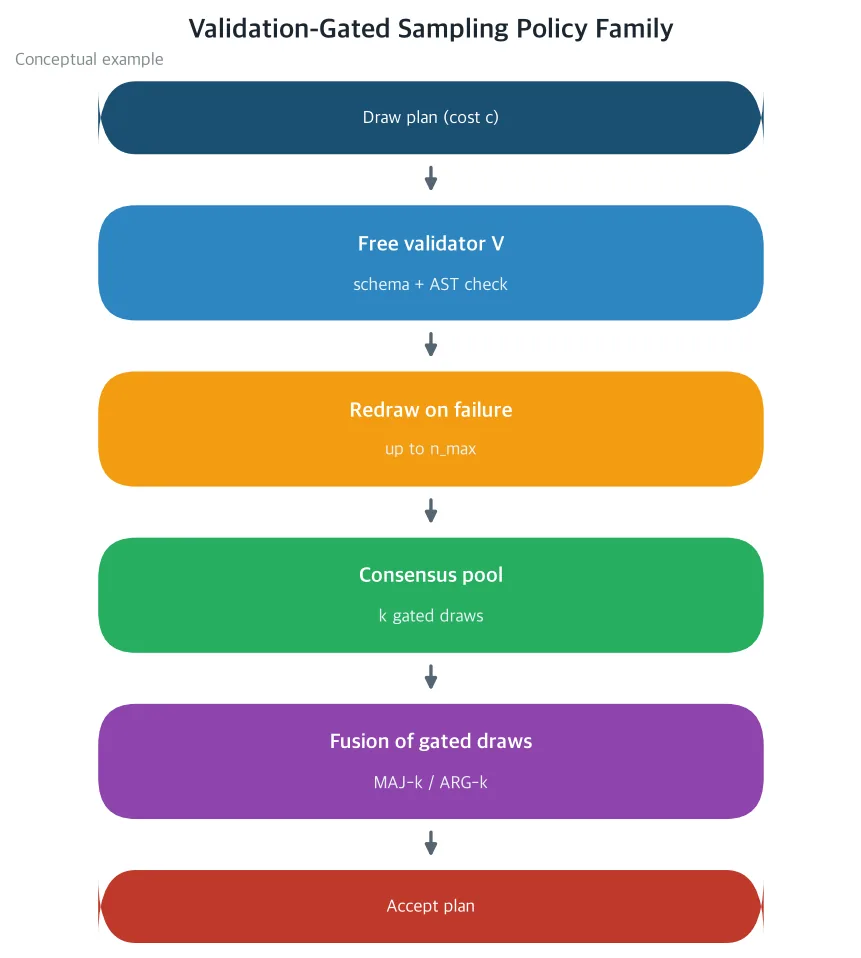 샘플링 정책 가족도. 셀프호스티드 양자화 체크포인트 위에서 무료 결정적 검증기를 축으로 실행 측 샘플링 레버(VTR, MAJ-k, ARG-k, JUDGE-k)와 모델 티어 레버가 합성되는 구조를 그린 개념도입니다. 실측을 담지 않은 개념 예시입니다.
컨센서스와 티어 업그레이드의 위치, 그리고 교차점
두 번째 레버는 추가 샘플을 컨센서스에 쓰는 일입니다. 전체 플랜 과반에서 k(홀수)개 다수 플랜이 정답일 확률은 이항 꼬리이고 k=3이면 q²(3-2q)입니다. k에서 k+2로 가며 생기는 한계 배당 d_k는 q가 1/2보다 클 때 k가 커질수록 줄어듭니다. q=0.9 앵커에서 첫 컨센서스 단계 1→3은 7.2포인트를 2샘플 비용에 사며 MCD는 27.8c입니다. 두 번째 단계 3→5는 같은 2c에 1.9포인트에 그치고 MCD는 103c입니다. 샘플을 더할수록 한계 가격이 가팔라지는데, 이는 셀프컨시스턴시 효율성 문헌이 이미 보인 감소 수익의 모양입니다. 뽑기당 정확도가 50퍼센트 이하면 과반 투표는 단일 뽑기를 넘지 못하고 논문은 이 영역을 투표 희석 레짐으로 부릅니다.
게이트와 과반이 교차하는 지점도 같은 계산으로 나옵니다. 게이트 상한 Q=q/(1-p_d)가 MAJ-3의 정확도를 넘는 것은 정확히 p_d가 p_d(q)=1-1/(q(3-2q))를 넘는 때입니다. q=0.9에서 이 임계값은 7.41포인트입니다. 임계값 바로 아래 p_d=7포인트에서 MAJ-3는 정확도로 0.4포인트 앞서지만 MCD는 VTR의 1.11c 대 27.8c로 20배 이상 격차가 납니다. 정확도와 마진 가격이 서로 다른 레버를 가리키는 지점이 바로 여기입니다.
게이트와 MAJ-3는 곱셈으로 합성됩니다. 게이트가 먼저 (q,c)를 (q/(1-p_d), c/(1-p_d))로 다시 정규화하고 컨센서스 이항식이 그 값에 그대로 적용됩니다. 앵커에서 게이트+MAJ-3는 기대 샘플 3.23개에 99.7퍼센트에 이릅니다.
모델 티어 업그레이드는 같은 가격 축 위에 위치합니다. 업그레이드 M’은 정확도 q’에 샘플당 r배입니다. 리샘플링 증분 k→k+2가 티어 업그레이드보다 싼 것은 정확히 (r-1)·d_k>2(q’-q)가 성립할 때입니다. q=0.9, r=2, 간극 5포인트에서 MCD_tier는 20c로, 첫 컨센서스 단계의 27.8c보다 쌉니다. d_k가 k에 대해 감소하므로, 이 티어보다 싼 리샘플링 예산은 어떤 홀수 k에도 없습니다. 컨센서스가 경쟁력이 있는 것은 다음 티어가 비쌀 때(r가 클 때)이거나, 정확도 간극이 작을 때(인접한 양자화 단계 사이)뿐입니다. 귀론은 더 선명합니다. q가 1/2보다 크고 r이 2 이상이면, 게이트 레버가 모든 홀수 k에서 세 레버 중 가장 싼 것입니다.
저지 레버는 지배됩니다. Q_J(k)=β(1-(1-q)^k)이고 β가 β=q/(1-p_d)/(1-(1-q)^k) 이하이면 품질-당-달러에서 VTR의 c/q에 항상 못 미칩니다. q=0.9, p_d=0.07, k=3에서 β는 96.9퍼센트로, 보정된 저가 저지가 넘을 수 없는 조건부 정확도입니다. 저지는 결정적 검증기가 없는 라우팅 결정 레짐에서만 의미가 있습니다.
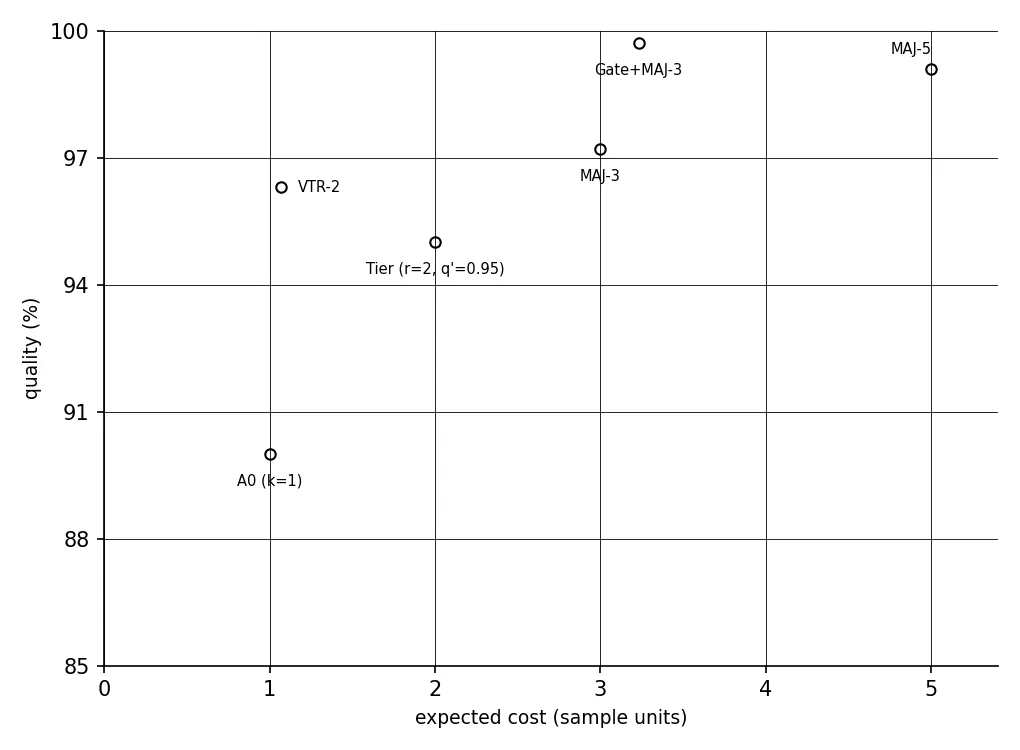 여섯 팔(A0 k=1, VTR-2, 티어 r=2 q’=0.95, MAJ-3, 게이트+MAJ-3, MAJ-5)의 품질과 기대 비용 위치. q=0.9, p_d=0.07, p_s=0.03 해석 모델의 닫힌 형태 식으로 계산한 값이며 실측이 아닙니다. 점선은 기준선 품질-당-달러 q/c입니다.
회사와 사회, 과학에 남는 것
이 분석은 무인 에이전트 루프의 샘플링 정책을 규칙 네 개로 압축합니다. 첫째, 항상 n_max=2로 게이트를 겁니다. 가장 싼 레버이고 마진 비용은 품질 단위당 c/q, 1-p_d 확률로 단일 샘플에 끝납니다. 둘째, 게이트 상한을 넘으면 컨센서스를 더합니다. 목표가 q/(1-p_d)를 넘으면 MAJ-3을, 단일 침묵 인자 레짐에서는 ARG-3을 더합니다. 셋째, 티어 업그레이드는 교차점에서만 하는 것입니다. (r-1)·d_k>2(q’-q)가 더 이상 성립하지 않을 때, 즉 잔여 침묵 질량이 목표를 넘거나 컨센서스 MCD가 티어 MCD를 넘을 때입니다. 넷째, 결정적 검증기가 있는 한 저지 레버를 쓰지 않습니다. 지배된 레버이고 검증기 없는 레짐을 위한 예약인 셈입니다.
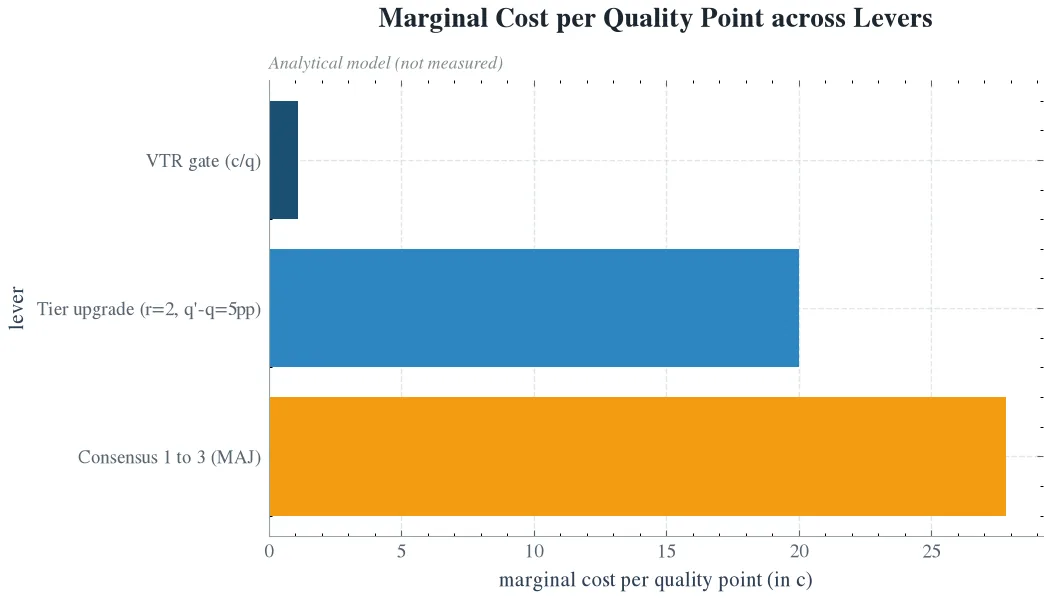 레버별 마진 비용(품질 포인트당). q=0.9 해석 모델에서 검증-후-리샘플 게이트가 가장 싼 레버이며 모델 티어 업그레이드와 첫 컨센서스 증분보다 훨씬 낮습니다. 실측이 아닌 해석 모델입니다.
ThakiCloud에게는 토큰 팩토리의 상시 결정 근거가 됩니다. 에이전트 워크로드가 양자화 셀프호스티드 모델에서 도는 한, 툴콜 정확도 1포인트를 살 때 먼저 당겨야 하는 레버와 그 배당이 어디까지인지가 정량적으로 정해집니다. 서빙과 에이전트 루프의 샘플링 정책 결정에 곧바로 쓰는 근거이며 사전 등록 BFCL 프로토콜로 곧바로 실측에 들어갈 수 있는 정책입니다. 사회적으로는 신뢰할 수 있는 자율 에이전트 운영의 비용과 에너지 장벽을 낮춥니다. 큰 모델 없이, 무료 결정적 검증기를 올바른 샘플링 정책과 짝지어 저렴한 양자화 셀프호스티드 추론 위에서 대형 모델급 도구호출 신뢰도를 얻는다면, 무감시 자동화를 안전하게 돌리는 비용이 줄어듭니다. 과학적으로는 셀프컨시스턴시를 자유문 답변에서 구조화 에이전트 액션으로 올리고 샘플 개수에 대한 품질-당-달러 프런티어와 리샘플링 대 티어 업그레이드 교차점을 확립합니다.
한 연결이 더 있습니다. 이전 연구에서 양자화 체크포인트가 툴콜에 내는 정확도 세금 τ_q를 실측했고 NVFP4는 800건에서 89.6퍼센트였습니다. 게이트 배당은 그 세금의 발견 가능 부분에 q/(1-p_d)≤1이 곱해진 값입니다. 즉, 게이트는 마진 가격 c/q로 양자화 세금을 되찾는 레버이고 되찾을 수 있는 상한은 침묵 바닥이 정합니다. 이는 이전 연구와 잇는 반증 가능 예측이고 사전 등록 프로토콜의 첫 예측 P1로 이어집니다.
믿지 말아야 할 부분
이 논문은 분석 연구이며 실측을 하나도 보고하지 않습니다. 모든 숫자는 명시된 파라미터에서 유도한 닫힌 형태 값입니다.
첫째, 독립뽑기 전제입니다. 고정 태스크의 플랜은 온도 T>0에서 i.i.d. 뽑기라고 근사하지만 다단계 툴콜은 동일한 호출에서도 측정된 비재현성을 보인다는 뜻입니다. 상관된 공실패가 있으면 실현 배당이 줄고 사전 등록 검사 R2가 정확히 이것을 보는 것입니다. 둘째, 완벽 검증기 전제인가? V는 모든 D를 거부하고 모든 C, S를 통과한다고 가정하지만 실제 검증기는 침묵 클래스에 대해 0이 아닌 거짓 통과율을 가집니다. 논문은 이를 ε 교란으로 처리하고 토큰 레벨 런타임 제어와 롤백이 거짓 통과율을 낮추는 배포 메커니즘으로 지목합니다. 셋째, 단일 정답 플랜 전제입니다. 여러 유효 플랜이 존재하면 전체 플랜 과반은 보수적 하한이고 정답 플랜을 여러 개 허용하면 과반 질량은 오를 뿐인 셈입니다.
평가 구조도 BFCL에 묶여 있습니다. 카테고리 구조와 채점 의미론은 BFCL 것이고 다른 스위트에서는 p_d와 p_s가 움직일 수 있습니다. 비용 비율 r, j, 처리량 승수도 근사이며 배포 전 서빙 스택에서 다시 유도해야 하는 것입니다. 저지의 β는 모델 파라미터이지 측정이 아닙니다.
실측으로 가는 길은 이미 정해져 있습니다. H200에 셀프호스티드 NVFP4 27B, BFCL simple·multiple·parallel 카테고리, k=1,2,3,5. 다섯 팔, A0(k=1), A1(VTR n_max=2), A2(MAJ-3), A3(ARG-3), A4(8B 지역 저지 JUDGE-5)가 사전 등록되어 있고 예측 P1~P4(배당 상한, 침묵 바닥, 교차점, 저지 지배)와 반증 기준 R1~R4(독립성 위반, 공실패, 양자화 세금, 저지 정보)가 붙어 있습니다. 기준에 부딪히면 결론이 함께 무너지도록 설계되어 있습니다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Validator’s Dividend: Measuring the Cost-Quality Frontier of Validation-Gated Resampling versus k-Sample Consensus for Agentic Tool-Call Output on Self-Hosted H200
이 글의 그림 세 장은 모두 개념도와 해석 모델 곡선이며 실측을 담지 않습니다. 본문에 인용된 k=1 기준선 89.6퍼센트(800건)가 이전 연구의 실측 값입니다.
 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
