초안 법칙: 에이전트 출력 구조가 스펙큘레이티브 디코딩 수용률과 순 토큰당 비용을 정한다
셀프호스티드 GPU에서 에이전트 워크로드를 서빙하거나, 그 서빙 비용을 책임지는 엔지니어라면 이 글이 곧 오늘 일입니다. 이 논문은 스펙큘레이티브 디코딩을 켤지 말지, 켰을 때 순 토큰당 비용이 얼마나 줄지는 워크로드 이름이 아니라 출력 구조로 정하는 법칙입니다. 스키마에 묶인 툴콜 비중이 클수록 수용률이 오르고 드래프트 모델 자체의 비용을 뺀 순 절감률과 브레이크이븐 지점까지 닫힌 형태로 나옵니다. 이 논문은 분석 논문이고 모든 수치는 명시된 전제에서 유도한 모델 예측입니다. 실측으로 가는 4팔 프로토콜과 반증 기준까지 함께 적어 둡니다.
 글의 핵심 개념을 형상화했습니다.
두 개의 열린 질문: 왜 에이전트 트래픽인가
에이전트 추론은 지금 LLM 서빙의 지배적인 레짐입니다. 툴콜은 알려진 도구 이름, 키, 열거형 값, 형식화된 인자 값 위로 짜인 JSON 문법에 그어지므로 자유 형식 산문과 다릅니다. 이 문법 프루닝이 스키마 위치에서 다음 토큰 분포를 집중시켜 평균 다음 토큰 엔트로피를 낮춥니다. 구조가 예측 가능하다는 직접 증거도 이미 있습니다. SPORK 연구는 생성 시작 시점에 포크한 탐지기가 5개 벤치마크에서 다음 도구 이름을 74.6에서 99.6퍼센트의 정확도로 예측했다고 보고합니다.
스펙큘레이티브 디코딩(speculative decoding)은 손실 없는 디코드 측 레버의 표준입니다. 작은 드래프트 모델이 후보 토큰을 미리 만들고 큰 타깃 모델이 이를 한 번의 병렬 패스로 검증하는 구조입니다. 수정된 기각 절차가 타깃 분포를 보존하므로 출력 품질은 그대로입니다. Medusa는 병렬 디코딩 헤드와 트리 어텐션으로 별도 드래프트 모델을 없애고 손실 없이 2.2배 이상, 공동 미세조정 시 2.3에서 3.6배의 총속도 향상을 보고했습니다. 다만 이 수치는 범용 워크로드에서 잰 값이고 드래프트 쪽 오버헤드를 빼지 않은 총속도입니다. 출력 구조별 수용률도 풀지 못했습니다.
정작 스펙큘레이션이 가장 이익이 되어야 할 에이전트 트래픽에서는 두 질문이 열려 있습니다. 첫째, 요청의 출력 구조가 스펙큘레이티브 디코딩 수용률을 측정 가능하게 정하는지입니다. 둘째, 드래프트 모델 자체의 서빙 비용을 포함하면 비교용 BF16 기준선과 같은 품질에서 순 토큰당 절감이 얼마나 큰지입니다. 이 논문은 두 질문에 닫힌 형태로 답합니다.
초안 법칙: 수용률을 정하는 변수는 출력 구조
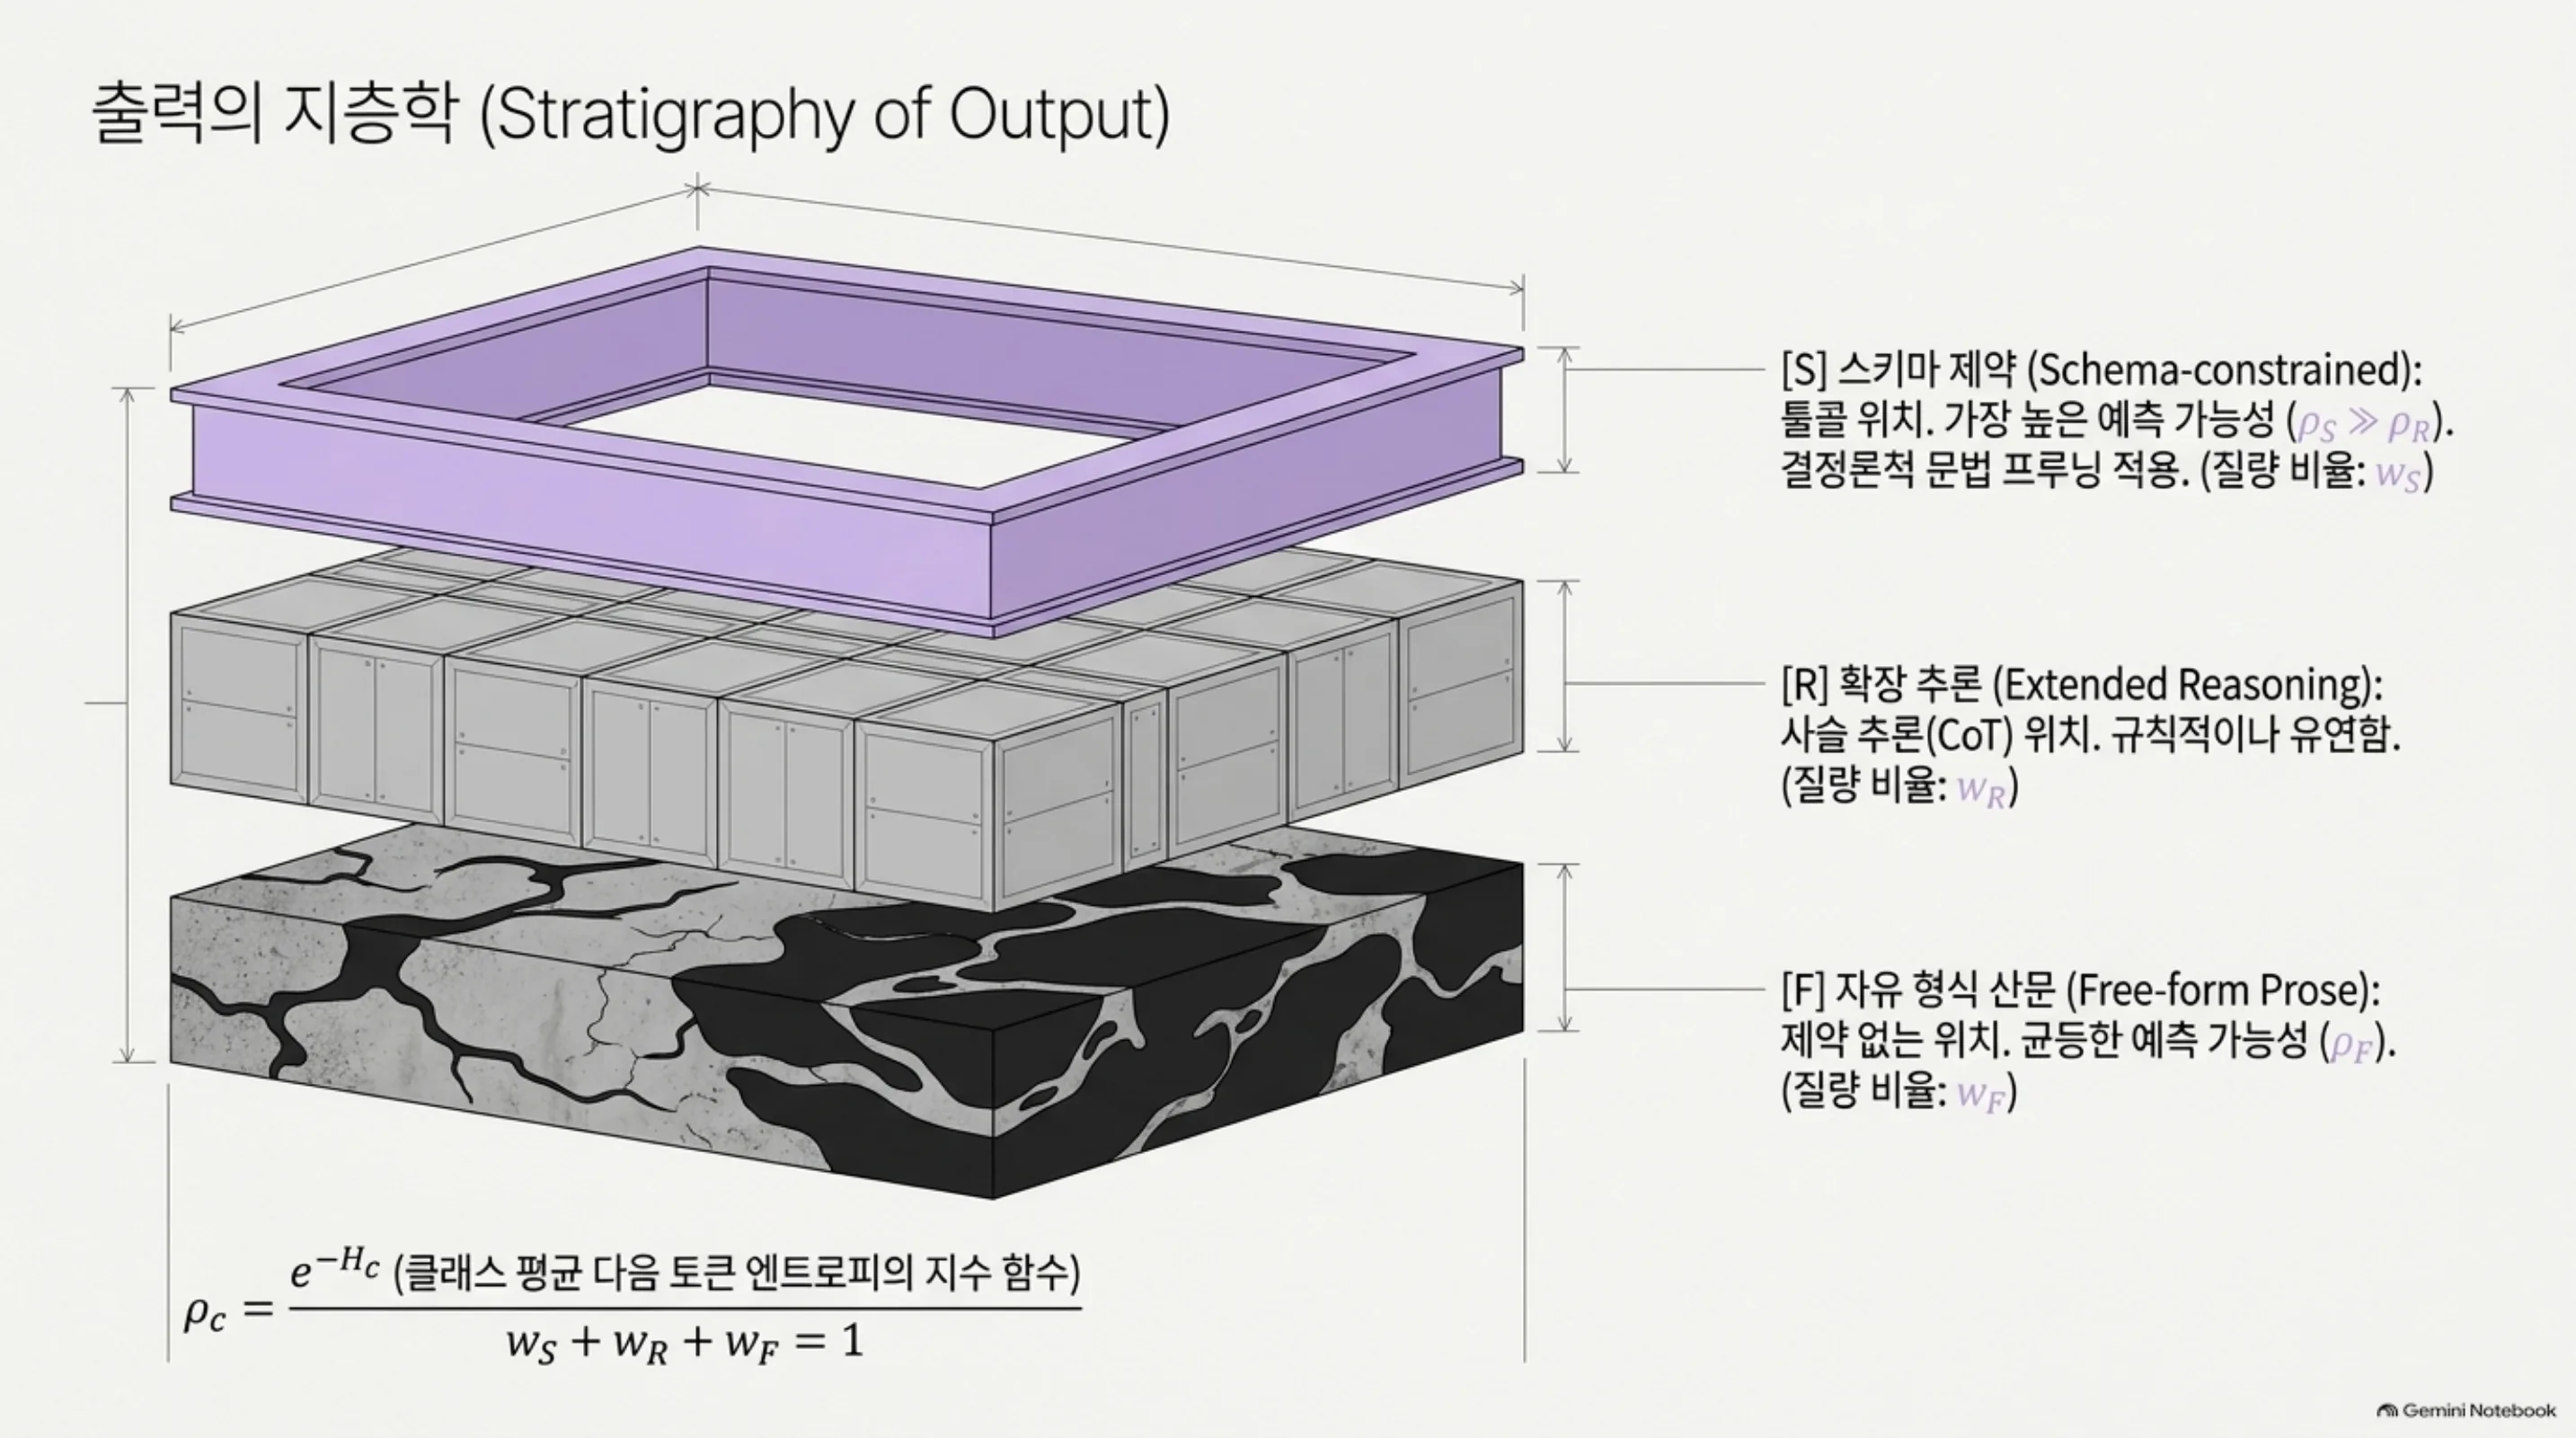
에이전트 턴의 출력을 세 위치 클래스로 분해합니다. S는 스키마 제약 툴콜 위치, R은 확장 추론 위치, F는 자유 형식 산문 위치입니다. 클래스 질량 비율 w_S, w_R, w_F의 합은 1입니다. 각 클래스에 정규화된 예측가능성 ρ_c를 부여합니다. 이는 클래스 평균 다음 토큰 엔트로피 H_c(나트)의 지수 함수 ρ_c=e^(-H_c)로, 결정론적인 위치는 1을, 균등한 위치는 1/V를 줍니다. 문법 프루닝이 허용 토큰 집합을 줄이므로 예측가능성은 ρ_S≫ρ_R≥ρ_F로 정렬됩니다.
드래프트 정렬 상수 κ를 두고 위치별 불일치 확률을 ε_i=κ(1-ρ_i)로 둡니다. 클래스를 혼합한 평균 불일치 ε̄=κ(1-ρ̄)에서 ρ̄=w_Sρ_S+w_Rρ_R+w_Fρ_F가 평균 구조적 예측가능성입니다. 초안 법칙은 이 둘을 잇습니다. 기대 수용 접두 길이 τ(γ)는 기하급수 Σ_{i=1}^{γ}(1-ε̄)^i의 합이고 ρ_S>ρ̄이면 τ와 순 절감률 s는 스키마 비중 w_S에 대해 엄격히 증가합니다.
두 극한이 법칙의 모양을 만듭니다. 스키마 천장에서는 w_S가 1로, ρ_S가 1로 가며 τ가 γ에 도달하고 순 속도 향상이 (γ+1)/(1+γ(δ+d))로 포화합니다. 엔트로피 바닥에서는 w_S=0에 드래프트가 완전히 어긋난 경우 τ가 0으로 내려가고 s가 -γ(δ+d)로 마이너스가 됩니다. 이 영역에서는 스펙큘레이션 자체가 순손실입니다. 중간에서는 스키마 위치의 한계 값이 나옵니다. 산문에서 질량 dw를 스키마로 옮기면 τ가 약 γ(γ+1)/2·κ(ρ_S-ρ_F)dw만큼 오르고 이것이 스키마 위치의 닫힌 형태 한계 수용 가치입니다.
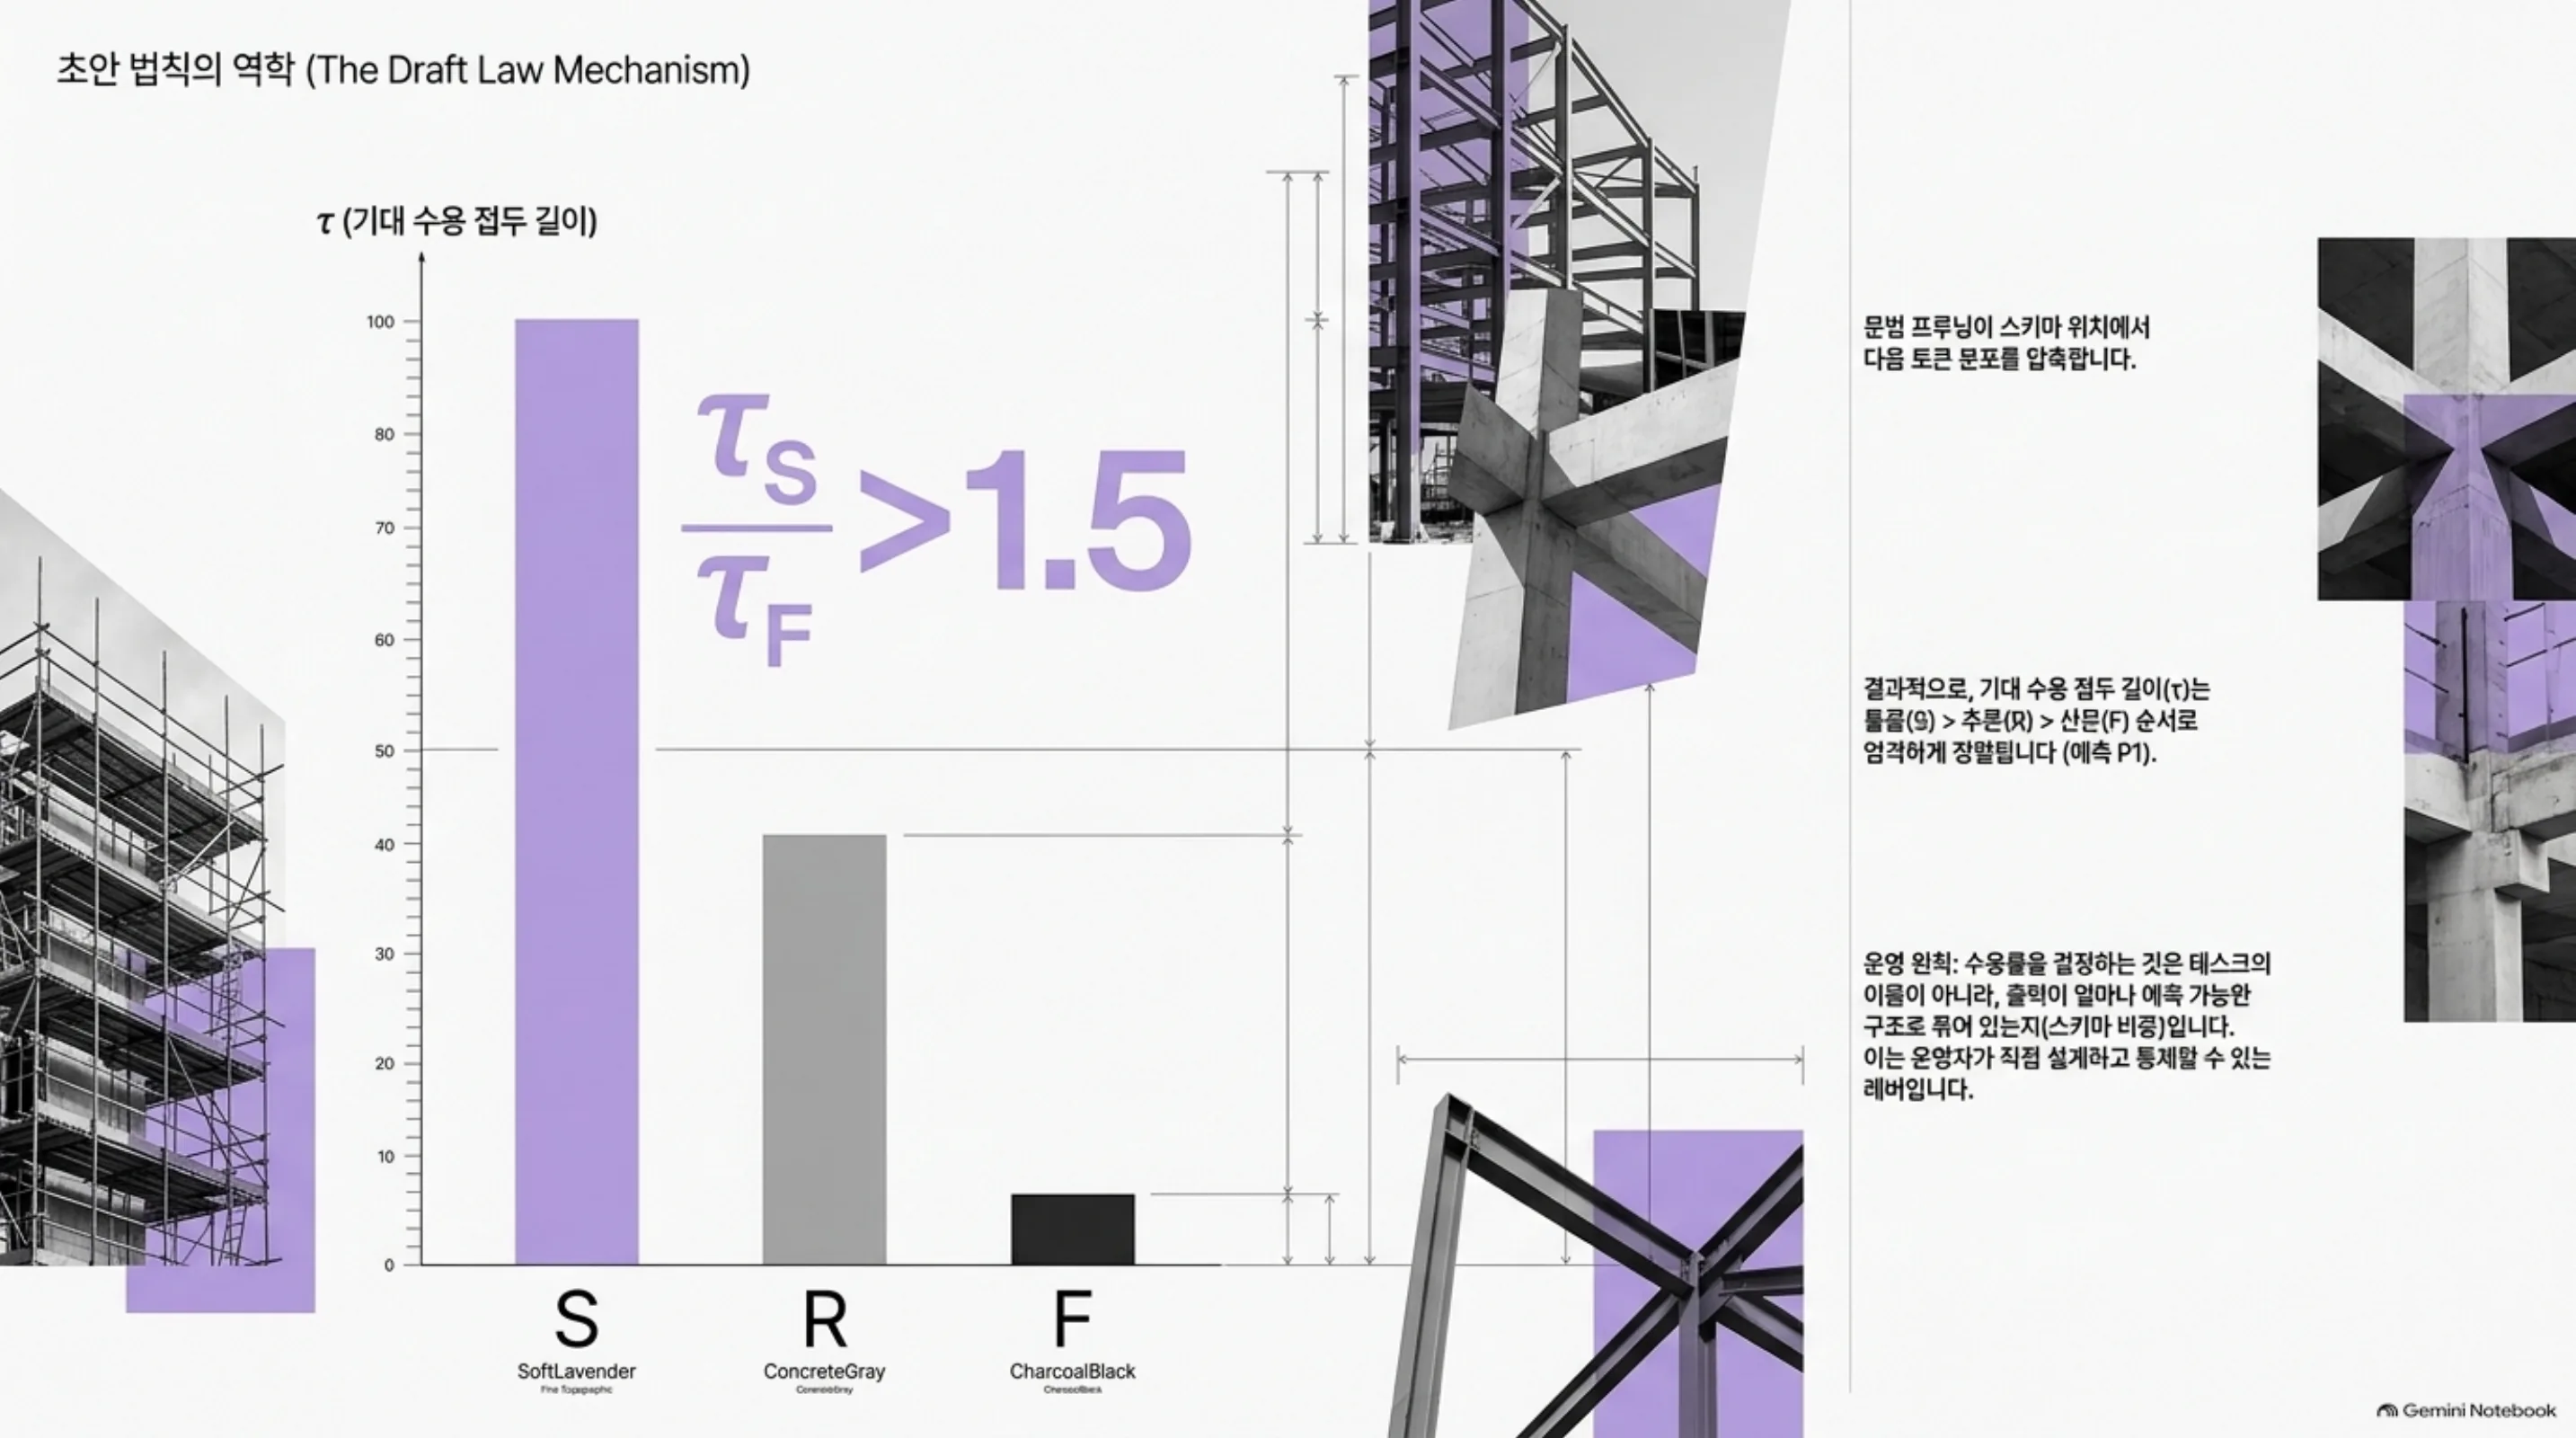
세 클래스의 순서에 대한 예측 P1도 나옵니다. 문법 프루닝이 스키마 위치에서 분포를 집중시키므로, 기대 수용 접두 길이는 툴콜, 추론, 산문 위치의 순서로 정렬되고 τ_S/τ_F는 1.5를 넘을 것으로 예측됩니다.
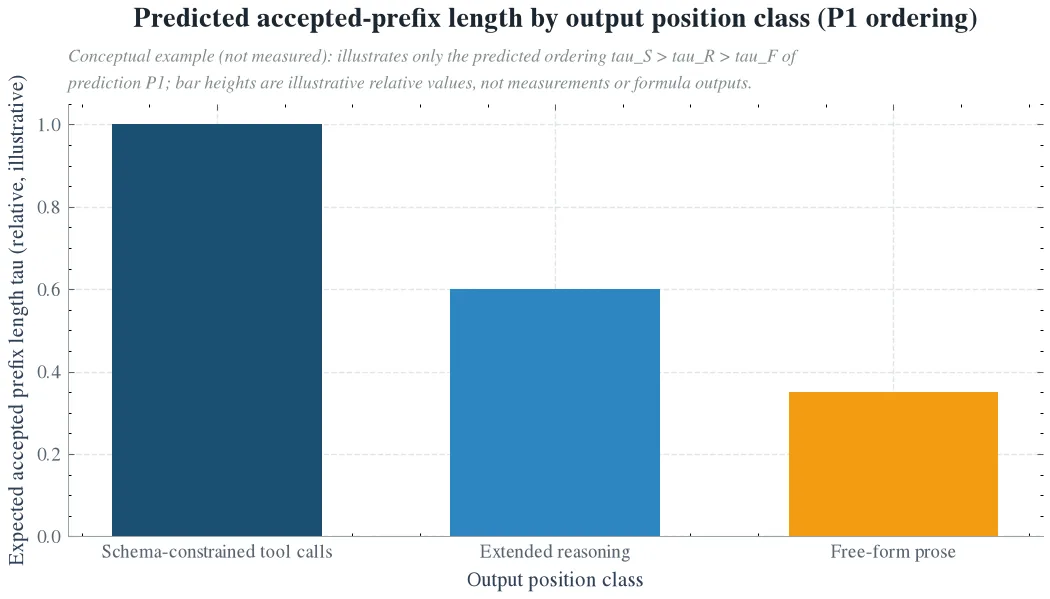 기대 수용 접두 길이의 클래스별 예측. 문법 프루닝이 스키마 위치에서 다음 토큰 분포를 집중시키므로 툴콜, 추론, 산문 위치의 순서로 정렬된다고 예측합니다(P1). 해석 모델 예측이며 실측이 아닙니다.
즉, 사람 말로는 수용률을 정하는 것은 출력이 얼마나 예측 가능한 구조로 묶여 있는지, 곧 스키마 비중입니다. 태스크의 이름은 변수가 아닙니다. 그리고 스키마 비중은 태스크 설계와 스키마 밀도, 도구 세기로 운영자가 직접 잡을 수 있는 레버입니다.
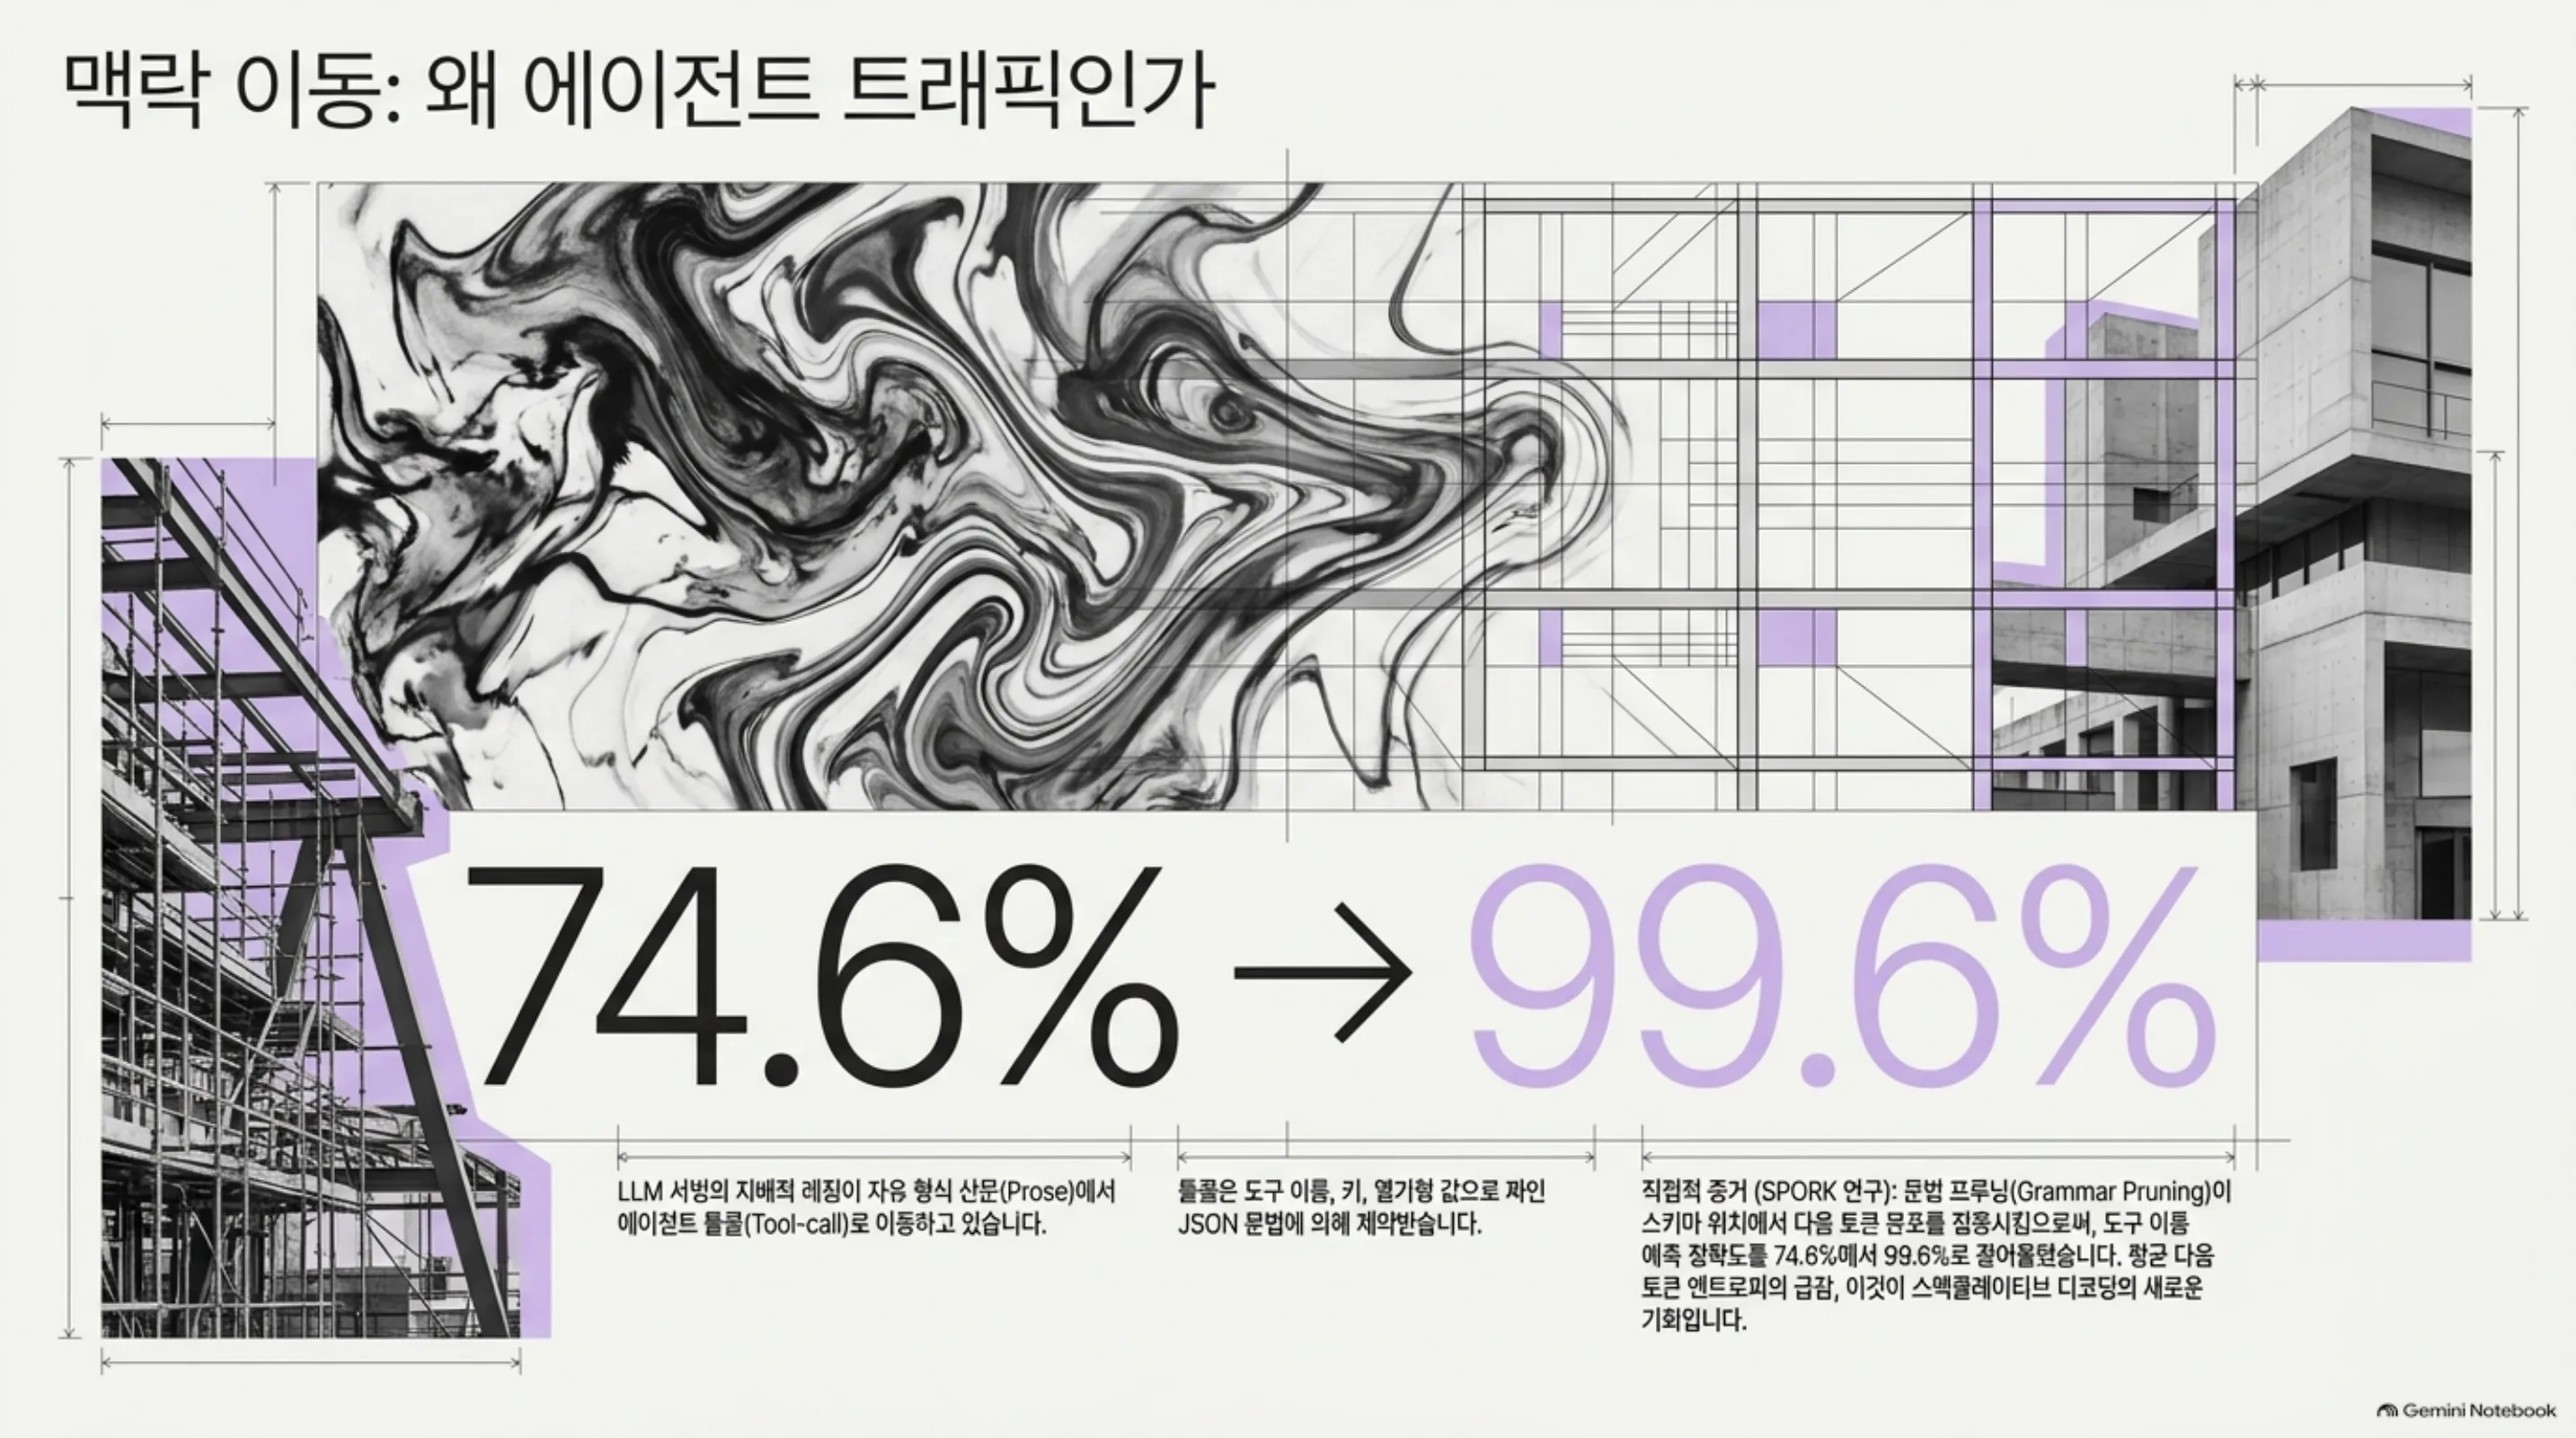
순 토큰당 비용과 브레이크이븐
순 비용에는 드래프트의 몫까지 넣어야 합니다. 타깃 디코드 패스 하나 c_T는 메모리 대역폭에 묶여 있고 γ+1개 후보 토큰을 한 패스로 검증하는 비용은 c_T(1+δγ)입니다. 여기서 δ는 추가 토큰당 검증 오버헤드(δ≪1)입니다. 드래프트 순전파 하나는 토큰당 d·c_T이고 d는 파라미터 비율 (1/8)에 드래프트 대역폭 활용률 η를 곱한 값입니다. 스펙큘레이션 라운드당 뱉어지는 토큰은 τ+1개입니다.
순 토큰당 비용은 c_net(γ,τ)=c_T(1+γ(δ+d))/(τ+1)이고 절감률 s는 1-(1+γ(δ+d))/(τ+1)입니다. 작은 ε̄ 영역에서는 s가 양수인 조건이 ε̄<ε=2(1-δ-d)/(γ+1)로 단순해집니다. 역산하면 유일한 브레이크이븐 스키마 비중 w_S=(ρ-ρ_n)/(ρ_S-ρ_n)이 나옵니다. 여기서 ρ=1-ε/κ이고 w_S가 w_S 미만이면 스펙큘레이션은 순손실입니다.
운영자 규칙으로 압축하면 두 줄입니다. 스키마 비중이 w_S*를 넘는 곳에서 스펙큘레이션을 켜고 자유 형식 산문이 지배하는 트래픽에서는 끕니다. 결정 근거는 총속도 숫자가 아니라 드래프트 비용을 뺀 순 이익과 품질 보존 보장이 함께 있는 값입니다.
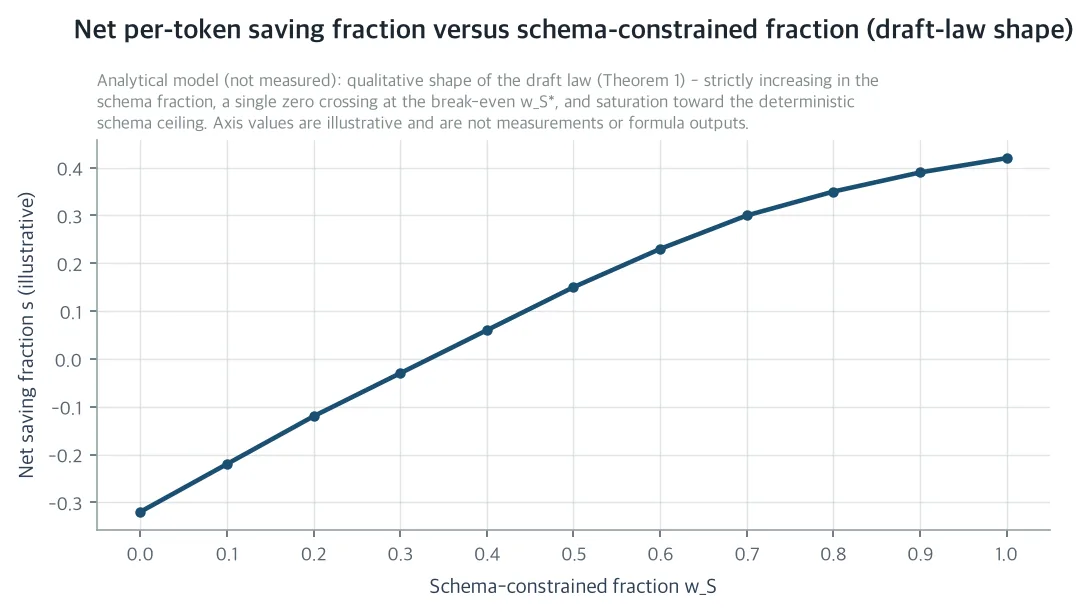 스키마 제약 비중에 따른 순 절감률. 브레이크이븐 스키마 비중 미만에서는 순손실이고 유일한 브레이크이븐 점에서 0을 지나 스키마 천장에 다가갈수록 포화합니다. 해석 모델 곡선이며 실측이 아닙니다.
이 레버는 서빙 스택의 다른 레버와 겹치지 않습니다. 에이전트 턴의 비용은 프리픽스 비용 C_pre와 디코드 비용 C_dec의 합으로 벌어지고 프리픽스 캐시 재사용은 C_pre에만, 스펙큘레이션은 C_dec에만 곱셈으로 작용합니다. 검증 게이트 리샘플링은 재시도 축으로 수용 턴에 기대 뽑기 수 ν를 겁니다. 셋은 서로 다른 비용 성분에 곱셈으로 합성되고 품질 회귀 예산은 덧셈입니다. 스펙큘레이션의 품질 기여는 0, 곧 정확한 타깃 검증입니다. C_total=ν[(1-h+h·c_hit)C_pre+(c_net/c_1)C_dec]가 그 합성입니다.
ThakiCloud, 사회, 과학에 남는 것
ThakiCloud에게는 토큰 팩토리의 새로운 비용 레버가 생기는 셈입니다. 수용률의 구조별 결정과 순 토큰당 비용은 품질 회귀 0으로, 프리픽스 재사용과 검증 게이트로 측정한 기존 축들과 곱셈으로 합성됩니다. 운영자는 총속도 숫자가 아니라 품질을 보존하는 비용 결정을 내리게 됩니다.
사회적으로는 품질이 고정된 상태에서 추론의 에너지와 화폐 비용을 낮춥니다. 작은 팀이 무인 에이전트 자동화를 돌리는 비용 장벽이 그대로 줄어듭니다.
과학적으로는 출력 구조를 스펙큘레이티브 디코딩 수용률에 잇는 새로운 경험 법칙입니다. 스키마 제약과 다음 토큰 엔트로피가 수용률을 정한다는 관계는 Medusa의 범용 총속도 측정에서 볼 수 없는 축입니다. 출력 구조가 수용률의 결정 변수이고 드래프트 비용을 뺀 순 비용에 브레이크이븐 조건이 붙는다는 두 축에서 Medusa의 명시적 업그레이드입니다.
실측으로 가는 길은 이미 정해져 있습니다. 단일 H200(141GB HBM3e)에서 vLLM으로 32B BF16 타깃과 4B BF16 동일 계열 드래프트를 돌리는 플랫폼을 측정 전에 선언합니다. 팔 A는 자유 형식 산문 제어 팔로 정렬 상수 κ와 오버헤드 δ, d, 기준선 c_1를 교정합니다. 팔 B는 BFCL 계열 스키마 제약 툴콜(온도 0), 팔 C는 긴 연쇄 추론, 팔 D는 무인 에이전트 루프 리플레이의 혼합 트래픽입니다. 깊이는 γ=4, 8, 16이고 배치 b=1(지연)과 b=8(처리량)을 씁니다.
반증 기준 R1에서 R4도 사전 등록되어 있습니다. τ_S≤τ_F이면 초안 법칙이, w_S≥0.6에서 s<0이면 브레이크이븐 모델이 기각됩니다. 합성 잔차가 15퍼센트를 넘으면 직교 합성 주장이, 온도 0에서 비트 불일치가 한 건만 나와도 무손실 주장이 기각됩니다. 기준에 부딪히면 결론이 함께 무너지도록 설계되어 있습니다.
믿지 말아야 할 부분
이 논문은 분석 연구이며 실측을 하나도 보고하지 않습니다. 모든 수치는 선언된 파라미터에서 유도한 닫힌 형태 값입니다.
첫째, 클래스 안의 독립뽑기 전제입니다. 클래스 내 위치별 수용을 i.i.d.로 보지만 긴 구조화된 스팬은 예측가능성 자기상관을 띠므로 기하급수 연쇄는 근사입니다. 오차 방향은 그런 스팬에서 실제 τ가 i.i.d. 값보다 작지 않으므로 모델은 구조화된 스팬에서 보수 쪽에 있습니다.
둘째, 정렬 상수 κ입니다. κ는 드래프트-타깃 쌍과 워크로드에 의존하는 것입니다. 좁게 훈련된 드래프터는 워크로드 이동에서 수용이 붕괴하고 수용 길이 인지 학습이 이를 직접 바꿉니다. 선언된 플랫폼에서 직접 측정이 가장 필요한 양입니다.
셋째, 정밀도 축은 범위 밖입니다. 정밀도는 BF16으로 고정했고 정밀도 축은 드래프트-타깃 정밀도 불일치를 다룬 이전 연구가 담당합니다. 두 직교 축의 합집합이 공동 프런티어입니다. 넷째, 디코드 비용 모델은 소규모 배치의 메모리 대역폭 제약을 전제로 합니다. 배치 축의 효과는 b=8 레짐에서만 프로토콜에 포함합니다. 혼합 전문가(MoE) 타깃이면 검증 토큰 수를 통한 전문가 이전이 d를 바꿉니다.
켜면 안 되는 경우도 명시되어 있습니다. w_S가 w_S* 미만인 자유 형식 중심 트래픽, 정밀도 불일치가 있는 양자화 MoE 타깃, 엣지-클라우드 분할입니다. 분할에서는 공존 스펙큘레이션만 이익이 되고 분산 분할은 거의 이익이 되지 않는다는 뜻입니다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Draft Law: Measuring How Agentic Output Structure Sets Speculative-Decoding Acceptance and Net Per-Token Cost on Self-Hosted H200
이 글의 그림 두 장은 모두 해석 모델 곡선이며 실측을 담지 않습니다.