The Apprentice Reranker: 라우터의 가장 비싼 LLM rerank 단계를 27B teacher에서 8B apprentice로 증류해, token bill은 7.1% 오르는 대신 wall time이 약 14.6배 줄어드는 cost-quality frontier를 실측했습니다
스킬 2,000개 넘는 무인 에이전트 하네스를 돌리는 회사의 라우터는, 태스크 하나를 어떤 스킬이 맡을지 고르는 마지막 판단을 가장 비싼 큰 모델에게 맡깁니다. 그 마지막 판단을 작은 모델로 옮기면 청구액은 오르는 대신, 판단 하나에 걸리는 시간만 크게 줄어듭니다. ThakiCloud가 자체 서버에서 실측한 결과가 바로 그런 그림입니다. 라우팅 비용을 책임지거나 무인 에이전트 하네스를 돌리는 분이라면, 이 실측이 판단의 근거가 됩니다. 이 글은 그 실측 논문 하나를 숫자와 한계까지 포함해 소개합니다. 읽고 나면 작은 모델이 큰 모델의 판단을 어느 정도까지 대신할 수 있는지, 그 대가는 무엇인지 알게 됩니다.
이 실측은 ThakiCloud의 새 논문 The Apprentice Reranker가 보여 주는 그림입니다. 라우터의 가장 비싼 구간인 LLM 재선별(rerank) 단계를 큰 모델에서 작은 모델로 옮기는 증류를 실측합니다. 후보 목록의 품질은 그대로 두고, 비용과 품질이 어떻게 바뀌는지를 확인했습니다. 결론부터 말하면 토큰 청구액은 7.1% 오릅니다. 약 14.6배 줄어드는 것은 판단당 걸리는 시간입니다.
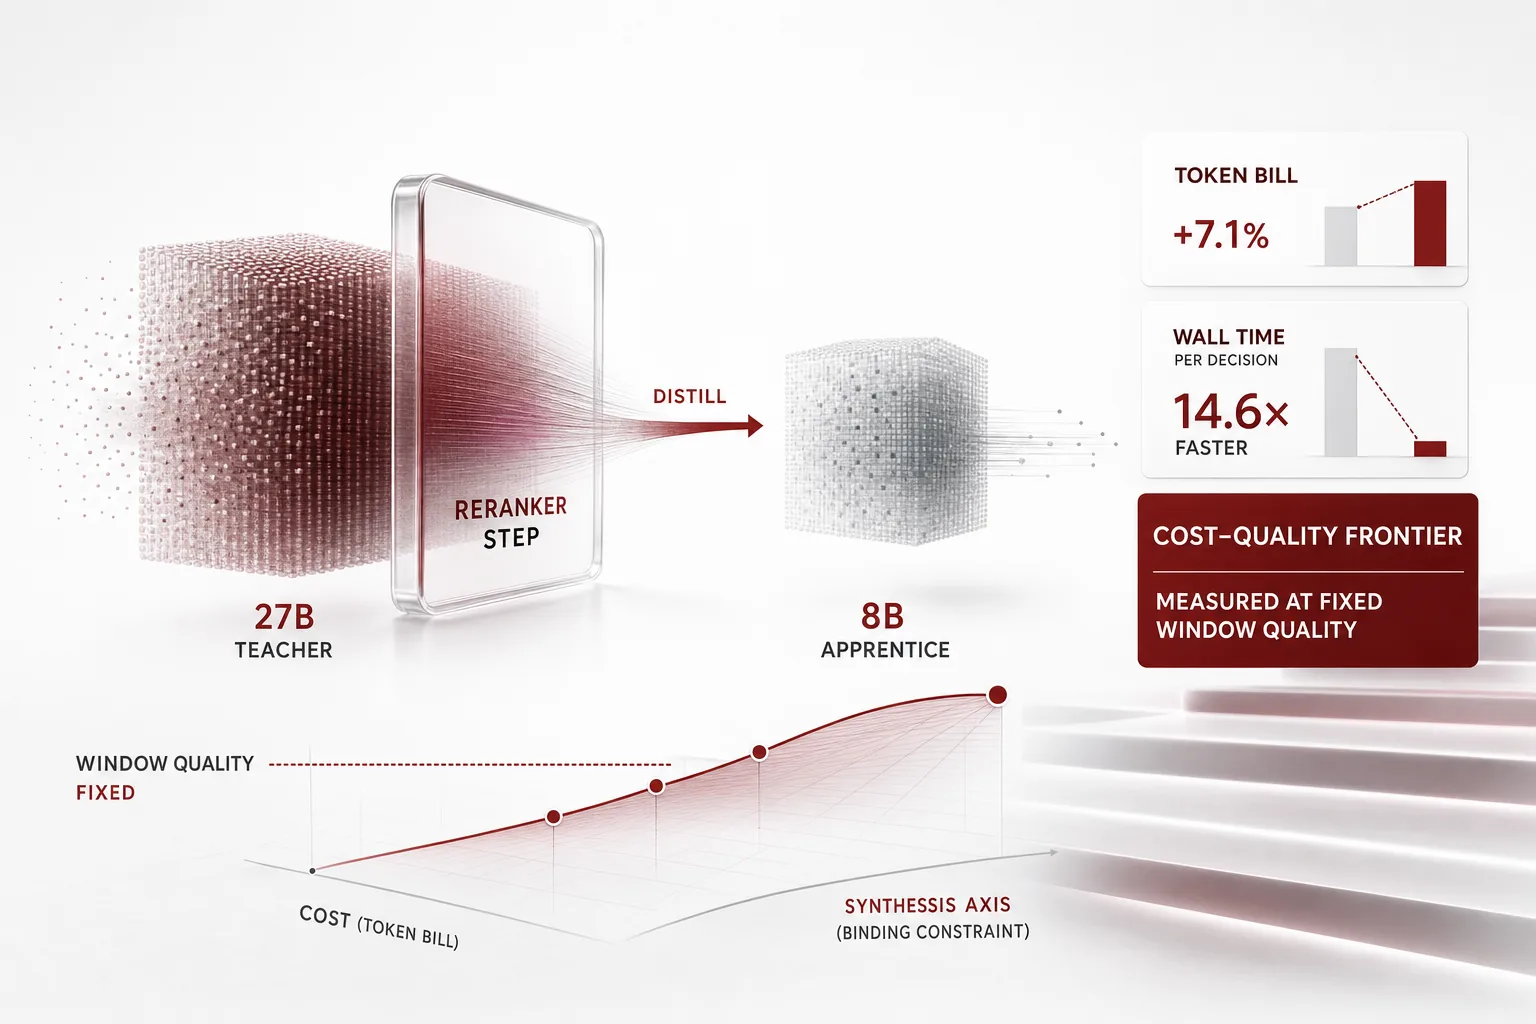 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
택시 배차 센터를 생각하면 됩니다. 전화가 오면 기사가 한 명 배정되어야 하고, 먼저 빠른 검색이 가까운 기사 여덟 명을 추립니다. 그 여덟 명에서 딱 한 명을 고르는 마지막 판단이 라우터의 재선별 단계입니다. 지금 그 판단을 27년 차 베테랑에게 맡깁니다. 정확하지만 한 건에 시간이 들고 비쌉니다.
10-23 시리즈 실측(The Router’s Toll)은 전체 라우팅 경로가 판단당 1,440.3토큰을 쓰고, 그 청구액의 71.6%가 이 마지막 판단, LLM 쪽에 앉는다고 봤습니다. 그런데 시리즈의 모든 실측은 이 판단을 27년 차 베테랑으로 고정해 왔습니다. 이전에 재본 두 지렛대, 임베딩 양자화와 전제 게이트는 어떤 계산을 돌릴지를 정했습니다. 증류는 어떤 모델이 그 계산을 돌릴지를 정합니다.
베테랑의 배정 기록을 8년 차 견습생에게 배워 주면, 그 판단을 견습생이 맡아도 되겠습니까? 이 논문의 실측은 그 질문에 대한 답입니다. 견습생은 베테랑의 배정에서 만든 선호 쌍으로 선호 쌍 학습(DPO)을 받아 훈련합니다.
결과는 세 가지로 압축됩니다. 첫째, 견습생의 배정 품질은 베테랑과 거의 같습니다. 둘째, 한 건에 걸리는 시간은 15분의 1쯤으로 줄어듭니다. 셋째, 청구 명세는 오히려 조금 더 비싸집니다. 두 사람의 명세용 종이에 눈금이 달라, 같은 일을 더 많은 칸에 채우기 때문입니다. 견습생이 못 따라 하는 곳은 딱 한 곳, 두 가지를 합쳐야 하는 가장 어려운 주문입니다. 그래서 나온 운영 방식은, 견습생이 먼저 배정하고 그런 주문에만 베테랑을 부르는 것입니다.
무엇을 해봤나
서빙 환경은 셀프호스트 H200입니다. 베테랑 역할의 teacher는 NVFP4 양자화로 서빙되는 Qwen3.8-27B family 모델이고, 견습생 역할의 student는 Qwen3-8B family 모델입니다. 학습 버전 v21은 사전 등록된 두 가지 비열등성 게이트를 모두 통과했습니다.
비교는 프로덕션 스킬 목록(registry) 2,295개 entry 위의 동결된 63개 라우팅 판단 시험 세트(holdout)에서 진행합니다. 45건은 스킬을 골라야 하는 경우, 10건은 적합한 스킬이 없는 경우, 8건은 겉으로 비슷한 스킬을 피해야 하는 경우입니다. 재선별 단계는 64토큰 상한(cap) 안에서 JSON 하나를 답합니다.
품질은 재선별보다 앞선 후보 목록 레벨에서 고정합니다. 5개 회수율은 77.8%, 목록 1위 정확도는 48.9%, 없는 스킬 지어내기는 0.0%, 비슷 스킬 회피율은 37.5%입니다. 이 지표들은 키워드 검색(BM25) 단계만의 일이므로 두 모델에서 동일합니다. “후보 품질을 고정했을 때”라는 조건이 여기서 생깁니다.
비용 축은 샘플링하지 않고 정확히 계산합니다. 재선별 청구액은 프롬프트 텍스트, 서빙 계열의 글자 조각기(tokenizer), 선언된 출력 상한의 결정론 함수입니다. 선언된 셀프호스트 요율은 100만 토큰당 입력 1.5달러, 출력 0.6달러로 티어 간 평탄합니다. 그래서 논문은 두 모델의 실제 글자 조각기로 63개 판단 전체의 청구액을 정확히 계산합니다.
품질 축은 H200 평가 클러스터에서 9월 4일과 5일에 서빙된 동결 케이스별 평가 산출물로 감사했습니다. 판단 유형 동결 세트 342행, 종합 판단(synthesis) 동결 세트 144행입니다. 문체 부수 효과 축은 외부 심사 없이 동작하는 결정론 게이트를 두 모델의 동결 산문 풀에 적용해 잰 것입니다.
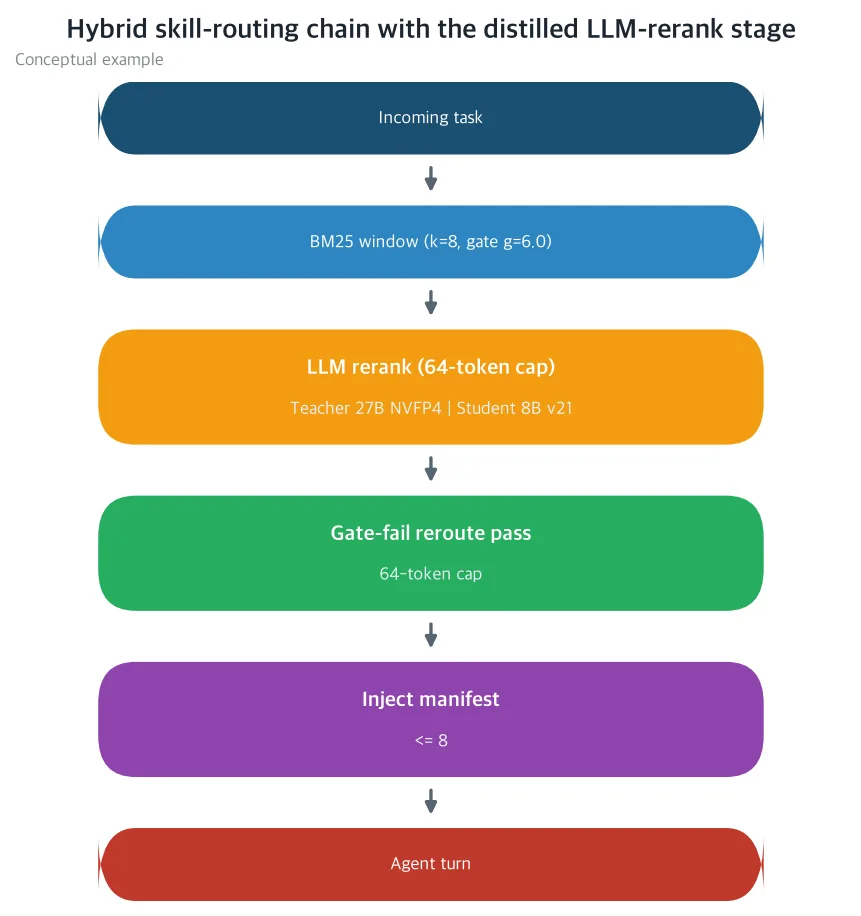 프로덕션 스킬 registry(2,295개 entry) 위의 하이브리드 skill routing chain입니다. LLM 쪽(rerank와 gate-fail reroute)이 라우터 전체 bill의 71.6%를 차지하며, 이 논문은 그 구간을 27B NVFP4 teacher에서 8B DPO student로 증류합니다. 아래 점선은 안전한 결정에서 LLM 쪽을 통째로 스킵할 수 있는 결정론 precondition gate입니다. 이 그림은 routing chain을 정리한 개념 다이어그램이며 실측 값이 아닙니다.
나온 결과
청구액은 줄지 않았습니다
선언된 티어 간 평탄 요율(flat rate)에서 견습생이 판단당 7.1% 더 냅니다. 판단당 1,445.3 대 1,350.1 토큰이고, 돈으로 환산하면 판단당 10분의 1센트쯤입니다.
원인은 모델 크기가 아닙니다. 같은 계열의 두 글자 조각기가 같은 텍스트를 서로 다르게 쪼개기 때문입니다. Qwen3 계열 8B 조각기는 동일한 재선별 프롬프트를 53.9토큰 더 적게 압축합니다.
논문은 이것을 명제로 형식화합니다. 평탄 요율에서는 청구액 차이가 글자 조각기 쌍만으로 결정되고, 같은 어휘를 쓰는 견습생이라면 청구액 차이는 정확히 0입니다.
즉, 사람 말로는 베테랑과 견습생은 같은 일을 하되, 견습생의 명세 종이가 눈금이 세어 같은 일을 더 많은 칸에 채우니 명세서가 조금 더 비싸게 나옵니다.
진짜 지렛대는 시간입니다
동결 H200 서빙 지연 기준으로 중앙값 판단당 합성 시간이 10.6초에서 0.7초로 줄어 14.6배 빠집니다. 키워드 검색 단계(26.5ms)는 두 모델 모두 무시할 수 있습니다.
세션당 라우팅 판단 6개로 환산하면, 라우터 실거동 시간이 세션당 약 59초 사라집니다. 밤샘 루프에서는 라우팅이 세션 안에 들어맞는지, 라우팅이 세션을 집어 삼키는지의 차이입니다.
즉, 사람 말로는 베테랑의 배정 하나가 수 분이라면, 견습생의 배정 하나는 몇 초입니다.
판단은 퍼졌습니다. 빠지는 것은 한 축뿐입니다
판단 유형 동결 세트 전체 통과율은 베테랑과 견습생 모두 91.5%입니다(n=342). 판단 생존율, 견습생 통과율을 베테랑 통과율로 나눈 값을 판단 유형(kind)별로 보면 차이가 보입니다.
안전에 직결되는 4가지 유형(정체성, 언어, 도구 자제, 개인정보 비노출)은 98% 이상으로 온전히 살아남습니다. 실행 유형(암송, 단계 순서, 행동 정책)은 9.7에서 12.9포인트 내려가고, 도구 행동 선택은 17.3포인트 올라갑니다.
종합 판단 축은 베테랑의 100%에서 66에서 69%로 떨어집니다. 안전 여분을 깨는 유일한 축이며, 배포의 결정적 제약(binding constraint)입니다. 짝지은 행(paired row)의 부호 검정은 11 대 1로, 견습생이 유의하게 잃지 않는 방향입니다.
전체 91.5% = 91.5%가 정확히 이 편차를 가립니다. 그래서 경계곡선(frontier)을 논문은 스칼라가 아니라 판단 유형 레벨로 씁니다.
즉, 사람 말로는 견습생은 일상 주문을 거의 완벽히 배정하되, 두 가지를 합쳐야 하는 주문에서만 미끄러집니다.
덤으로 문체까지 엄격해졌습니다
견습생의 동결 산문 풀은 텍스트당 게이트 위반이 30.2%로, 베테랑의 53.5%보다 낮습니다. 베테랑의 코퍼스 판정을 정하는 S1 심각도 패턴 두 개(반어 대조, 결론 전환 마커)는 견습생 풀에 나타나지 않습니다.
작은 기반 모델로의 DPO 증류가 베테랑 특유의 ‘AI 에세이’ 표면 마커를 벗겨 냅니다.
즉, 사람 말로는 견습생은 토큰이 아니라 시간의 지렛대이고, 마스터의 문체 습관까지 덤으로 벗겨 줍니다.
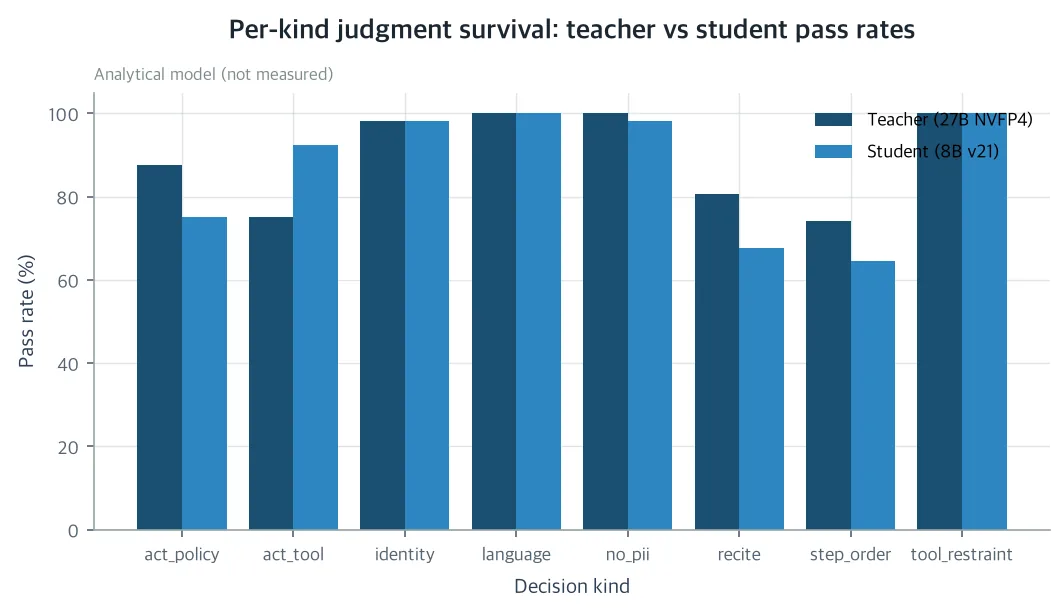 동결된 342-row kind holdout의 kind별 pass rate, teacher 대 student입니다. safety-critical kind는 보존되고, execution kind는 퍼지며, act_tool은 17.3points 올라갑니다. binding degradation은 synthesis axis에 있습니다. paired row의 부호 검정은 11 대 1(p=0.0063)이고, median 결정당 composite 시간은 10.63s에서 0.73s로 줄어듭니다. Qwen3-8B tokenizer는 동일한 rerank prompt를 53.9 token 더 적게 압축합니다. 이 그림은 분석 모델이 그린 것이며 실측 값이 아닙니다.
그래서 무엇을 바꾸면 되나
논문은 세 가지 정책 위에 배포 경계곡선을 형식화합니다. 항상 베테랑, 항상 견습생, 특정 결정 클래스에서만 베테랑으로 부르는 견습생 우선입니다. 각 정책은 두 갈래의 분포 혼합입니다.
클래스 C에서 베테랑으로 부르면 C의 비중만큼 청구액 차이가 들고, C에서 베테랑 판단 차이가 그만큼 돌아옵니다. 회피된 오판 1개당 50센트의 선언 카드에서, 종합 판단 클래스로 베테랑을 호출하는 것은 라우터 실거동 시간의 암시적 초당 가치가 약 1.6센트를 넘지 않는 한 손익분기(break-even) 초과입니다. 이 임계는 라우터 실거동 시간 1초의 어떤 합리적 비용보다 훨씬 위에 있습니다.
권고되는 배포는 종합 판단 조건부 베테랑 호출(escalation)을 붙인 견습생 우선 재선별입니다. 호출된 결정마다 9.9초의 추가 실거동과 10분의 1센트의 청구액 차가로, 결정적 제약 축에서 베테랑의 32포인트 판단 차이가 돌아옵니다. 경계곡선의 무릎은 모델이 아니라 정책입니다.
이 지렛대는 시리즈에서 이미 재본 다른 두 지렛대와 합성합니다. 전제 게이트는 LLM 쪽이 아예 돌릴지를 정합니다. 임베딩 양자화는 후보 목록을 얼마나 싸게 회수할지를 정합니다. 증류는 판단을 얼마나 빨리 만들지를 정합니다. 현재 결정적 제약은 어떤 LLM 갈래도 아니라 후보 목록 자체, 37.5%의 비슷 스킬 회피율입니다. 그래서 시리즈의 다음 압축 대상은 회수입니다. 견습생의 가치는 고정된 정확도에서의 시간과 문체입니다.
회사로는 LLM 재선별 단계를 27B 베테랑 티어에서 8B 증류 티어로, 후보 목록 품질을 고정하고 옮기는 것입니다. 셀프호스트 플랫폼의 모든 무인 태스크에서 판단당 약 9.9초의 라우터 실거동 시간이 사라지고, 밤샘 루프는 GPU 시간당 더 많은 판단을 처리합니다. 라우팅이 더 이상 세션을 잡아 먹지 않게 됩니다.
사회로는 작은 증류 모델로 싸고 셀프호스트이며 정확한 스킬 라우팅을 하는 재현 가능한 레시피를 남깁니다. 결정론 청구, 동결 산출물 품질 감사, 외부 심사 없는 문체 게이트가 그 구성입니다. 토큰당 프론티어 모델 클라우드 청구액이 에이전틱 스킬 생태계 운영의 장벽인 조직에는, 이 레시피가 그 장벽을 낮춥니다.
과학으로는 스킬 라우팅의 마지막 재선별 단계에서 베테랑에서 견습생으로 판단 신호가 얼마나 전달되는지를 처음 실측한 것입니다. FrugalGPT와 RouteLLM 계열의 LLM 연쇄 라우팅 문헌은 모델 사이를 라우팅할 뿐, 라우터 자신의 크기는 고정합니다. 이 논문은 큰 모델의 라우팅 판단이 DPO 아래 8B 견습생에 얼마나 남는지, 경계곡선 비용은 어떤지 실측합니다. 평탄 요율에서는 명시적 토큰 청구액이 거의 중립이고, 실거동 시간이 지배합니다. 시리즈의 밴딧과 양자화 라인과 함께 읽히게 되는 결과입니다.
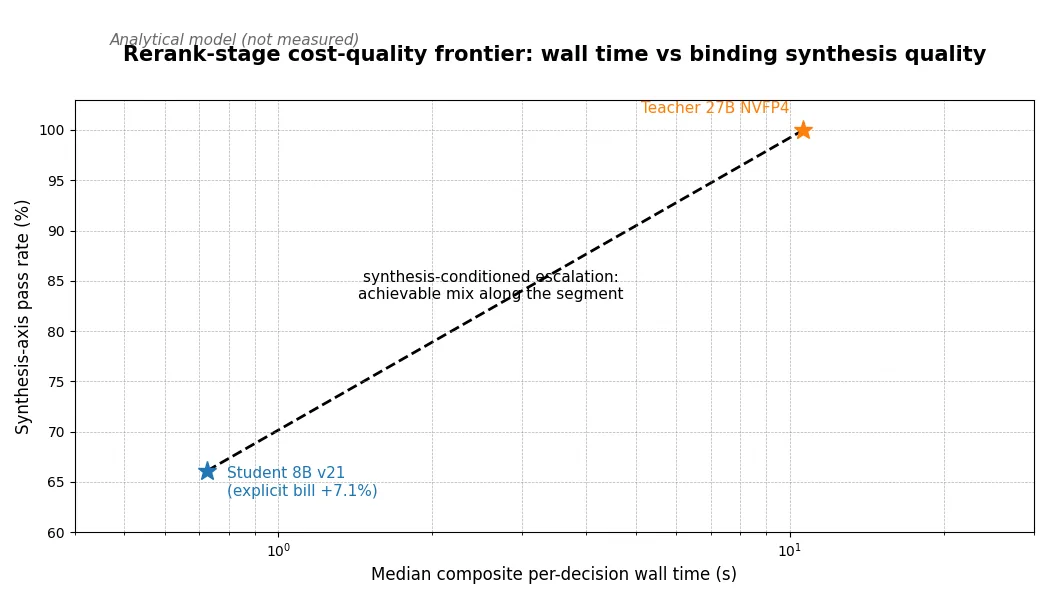 두 arm을 구별하는 두 축, median 결정당 composite wall time(log scale)과 synthesis axis pass rate 위의 rerank 단계 frontier입니다. student 점은 explicit token bill 7.1% 증가를 안고 있고, 결정당 bill 차이는 0.00014달러입니다. 회피된 miss 1개당 0.50달러의 선언 카드에서, synthesis class로 escalation하는 break-even 임계는 초당 약 0.016달러입니다. 두 점 사이의 세그먼트는 혼합 escalation 정책의 집합이며, student 끝의 무릎이 권고되는 배포입니다. 이 그림은 분석 모델이 그린 것이며 실측 값이 아닙니다.
못 믿을 부분
한계는 다섯 개입니다. 첫째, 베테랑의 동결 지연은 라벨된 11개 케이스 부분집단에 기대고 있습니다. 그래서 14.6배 합성 비율은 라이브 프로토콜이 동일한 서빙 조건에서 두 갈래를 재측정할 때까지 규모 추정치입니다.
둘째, 문체 풀의 크기와 케이스 구성이 다릅니다(해석 가능한 419 대 341). 그래서 53.5% 대 30.2% 비교는 방향적이지 짝지음이 아닙니다. 셋째, 종합 판단 동결 세트의 구성이 갈래별로 다릅니다(베테랑 n=54, 견습생 n=85). 해당 축의 통과율은 짝지음이 아닙니다.
넷째, 이 연구는 63개 SRA 결정에서 두 모델을 다시 서빙하지 않는다는 뜻입니다. 재선별 단계의 라이브 최종 top-1과 선택 없음은 같은 프로토콜로 사전 등록되어 있고, 동결 산출물은 그 하나의 축에서 간접 증거만 줍니다. 다섯째, 요율과 상한은 선언된 프로토콜 상수이지 토큰당 관측값이 아닙니다. 티어별 차등 가격 규약에서는 청구액 이야기가 바뀌며, 청구액 명제는 평탄 요율에서만 성립합니다.
라우터 시리즈는 이제 세 가지 지렛대, 통행료와 압축, 증류를 모두 가격 매긴 것입니다. 남은 결정적 제약은 상류, 후보 목록 자체입니다.
논문 상세 페이지와 수반 자료는 여기에서 볼 수 있습니다: The Apprentice Reranker
본문의 수치는 읽기 쉽게 반올림했고, 원 수치는 각 그림 캡션에 그대로 두었습니다. 청구액 명제는 평탄 요율에서만 성립합니다.

