정확도 95% 대신 이렇게 말하기: 답한 질문 안에서 오류율 상한을 보증하는 법
규칙 기반 판정에 LLM을 붙이려는 한국 금융·공공 기업의 엔지니어와 PM을 위한 글입니다. 결론부터 말하면, “정확도 95%”라는 문장은 감사 앞에서 쓸모가 없습니다. 대신 이렇게 말해야 합니다. “이 모델은 답한 질문 안에서 오류율이 목표 α를 넘지 않는다는 것을 90% 신뢰로 보증하고, 그 보증을 지키기 위해 질문의 X%는 스스로 판단을 유보해 사람이나 더 큰 모델에 넘깁니다.” ThakiCloud의 K-Decision에 이 방식을 실제로 붙여 본 결과를 숫자로 보여드립니다.
이 모델이 어떻게 학습됐고 Jev와 비교하면 어디서 이기고 지는지는 이전 두 글, 4B 모델에게 법령 속 숫자 판단을 가르친 방법과 Jev 한국판을 만든 이유에서 다뤘습니다. 이 글은 그 모델의 확률 출력을 감사 가능한 보증으로 바꾸는 계층 하나를 얹은 결과입니다.
정확도 하나로는 감사를 통과하지 못하는 이유
K-Decision은 타입드 디시전 모델이라, 문서 상태와 질문을 받으면 choice, noul(예/아니오), score 세 가지 유형 중 하나로 선택지마다 확률을 냅니다. 신뢰도는 그 확률 분포에서 가장 큰 값, 즉 max probability입니다. 문제는 “정확도 95%”라는 숫자 하나로는 눈앞의 이 질문이 그 95% 안에 드는지 5% 안에 드는지 알 수 없다는 점입니다. 감사 로그에 “정확도 95% 모델이 예라고 답했습니다”라고만 남으면, 사람이 검토할 때 이 판정이 실제로 얼마나 믿을 만한지 다시 원문을 읽고 재해석해야 합니다.
컨포멀 예측 계열의 방법, 그중에서도 Learn-then-Test(Angelopoulos 외)는 이 문제를 다른 각도에서 풉니다. 정확도를 올리는 대신, 모델이 낸 확신도에 임계값을 걸어 확신이 낮은 질문은 아예 답하지 않고 유보합니다. 남은 질문, 즉 임계값을 넘어 실제로 답한 질문들 안에서는 오류율이 미리 정한 목표 α를 넘지 않는다는 것을 통계적으로 보증합니다. 이 보증은 새 질문이 보정에 쓴 질문들과 비슷한 분포에서 나온다는 가정 위에 서 있고, 그 가정이 깨지는 지점도 이 글 뒤에서 그대로 보여드립니다.
임계값은 K-Decision의 세 질문 유형마다 따로 정합니다. 보정 데이터에서 정확 이항 p-value로 후보 임계값들을 하나씩 검정하고, 유형이 세 개이므로 목표 오류 확률 δ=0.10을 본페로니로 세 유형에 나눠 씁니다. 보정과 테스트는 법령 단위로 분할해서, 같은 법령의 조문이 보정 세트와 테스트 세트에 동시에 들어가지 않게 했습니다.
법령 조문에서 목표 α를 낮출수록 벌어지는 일
공개 법령 세트 KD-Lawset-KO는 한국 법령 원문(법제처 국가법령정보센터)에서 코드로 자동 생성한 질문들입니다. 과태료 상한을 초과했는지, 기한을 지켰는지(날짜 계산, 초일 불산입, 공휴일 처리 포함), 특정 항의 과태료 상한이 얼마인지, 징역형 상한이 얼마인지를 묻습니다. lawset-v2 기준으로 보정 532문항, 테스트 542문항, 그리고 평가에 쓰지 않은 부처를 모아 둔 시프트 세트 393문항으로 나뉩니다.
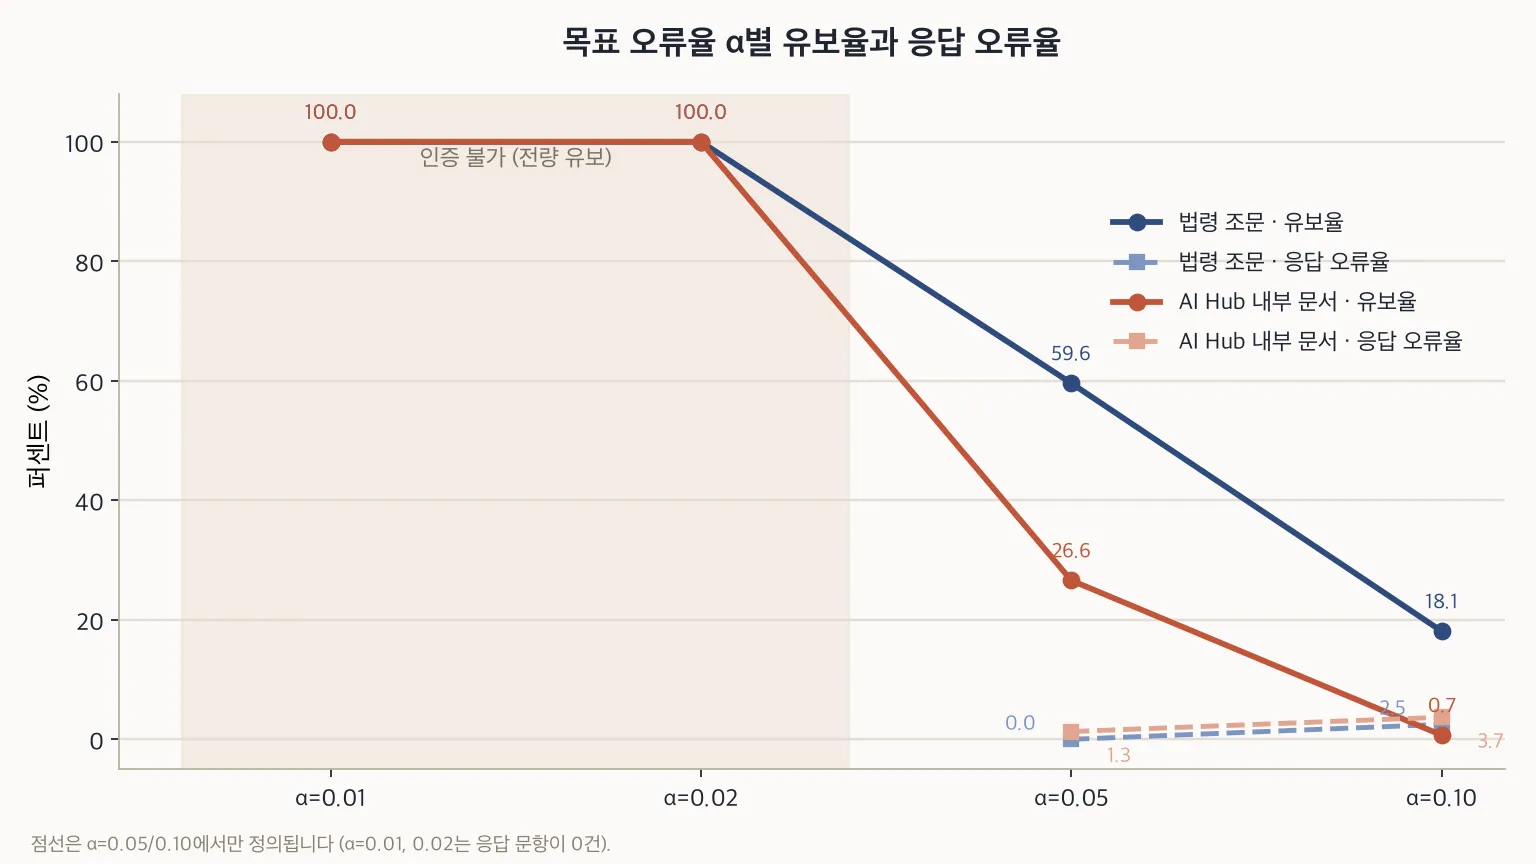 목표 α를 낮출수록 유보율이 오르고 응답 문항 안 오류율은 내려갑니다. α=0.01과 0.02에서는 두 도메인 모두 전량 유보해 아예 인증하지 못합니다.
α=0.05로 걸면 법령 조문의 59.6%를 유보하고, 남은 40.4%에서 오류율이 5% 이하라는 보증을 얻습니다. 이번 시험셋에서 실제로 관측된 오류는 0건이었습니다. α를 0.10으로 완화하면 유보율이 18.1%로 떨어지지만 응답 문항 안 오류율은 2.5%로 올라갑니다. 더 낮춰서 α=0.01이나 0.02로 걸면 이 세트에서는 아예 인증할 수 없습니다. 통과하는 임계값이 없어서 전량 유보로 떨어집니다. 이 그래프의 요점은 “유보율이 낮을수록 좋다”가 아니라, 유보율과 오류율이 한 손잡이로 함께 움직인다는 것입니다. 손잡이를 조이면 남는 질문이 줄고, 풀면 그 질문들의 오류율이 오릅니다.
이 세트에서 4B 모델은 choice와 score 유형은 이미 전부 맞히고 있습니다. 손잡이를 움직이는 것은 사실상 noul(예/아니오) 유형, 그중에서도 기한 계산 문항입니다. 전량 응답시켰을 때 기한 문항의 오류율은 약 31%로, 다른 유형과 확연히 다릅니다. 초일 불산입이나 공휴일 처리처럼 규칙이 촘촘한 계산에서 확신도가 흔들리는 것으로 보이고, 그래서 α를 낮추면 거의 이 유형에서 유보가 쏠립니다.
사내 문서에서는 손잡이가 반대로 돈다
내부용으로만 쓰는 AI 허브(한국지능정보사회진흥원) 문서 QA 세트는 사람이 만든 라벨을 가진 1,402문항입니다. 이 데이터 자체는 공개하지 않습니다. 이 세트의 기본 정확도는 choice 97.4%, noul 95.1%로 법령 세트보다 전반적으로 높은 출발점에서 시작합니다.
같은 α=0.05를 걸면 유보율이 26.6%로 법령 조문의 절반 이하이고, 응답 문항 안 오류율은 1.3%입니다. α를 0.10으로 풀면 유보율은 0.7%까지 떨어지지만 오류율은 3.7%로 올라 법령 조문의 같은 α보다 오히려 높습니다. 그래프에서 두 도메인의 선이 α=0.05와 0.10 사이에서 서로 자리를 바꾸는 것이 보이실 텐데, 이것이 그 지점입니다. 법령 조문은 유보를 많이 하는 대신 오류를 더 세게 눌러 잡고, AI 허브 문서는 애초에 기본 정확도가 높아 같은 α에서 유보를 덜 하면서도 비슷한 오류율 근방에 머뭅니다.
이 세트에는 분명한 한계가 하나 있습니다. 분할을 문서 단위가 아니라 질문 단위로 했다는 점입니다. 같은 문서에서 나온 질문 여러 개가 보정 세트와 테스트 세트에 흩어져 들어갔을 수 있고, 그러면 같은 문서 안 질문들 사이의 상관관계 때문에 보증이 실제보다 낙관적으로 보일 위험이 있습니다. 이 갭을 메우려면 문서 단위 분할로 다시 재는 것이 다음 순서입니다.
보증이 흔들리는 지점: 도메인이 바뀌면 다시 보정해야 한다
이 보증이 얼마나 단단한지 확인하려고 법령 단위로 500번 재분할해 반복했습니다. 보정에 쓴 것과 같은 분포 안에서는 응답 문항 오류율의 정확 95% 하한이 목표 α를 넘은 경우가 재분할 500번 중 최대 1.2%에 그쳤습니다. 즉 분포가 바뀌지 않는 한 보증은 거의 항상 지켜집니다.
문제는 도메인이 실제로 바뀔 때입니다. 평가에 한 번도 쓰지 않은 부처들을 모은 시프트 세트에 같은 임계값을 그대로 적용했더니, noul 유형의 오류율이 목표 α에 근접했습니다. 예를 들어 α=0.15로 걸었을 때 실측 오류율이 14.2%까지 올라, 목표와의 차이가 1퍼센트포인트 안쪽으로 좁혀졌습니다. 이 결과를 그대로 전해 드립니다. 보정을 한 도메인에서 다른 도메인으로 그대로 들고 가면 안전 여유가 거의 사라진다는 뜻이고, 그래서 새 도메인에 배포할 때는 그 도메인의 문서로 임계값을 다시 보정하는 것이 이 방법을 쓰는 전제 조건입니다.
유보한 질문은 어디로 가는가
유보된 질문은 외부 API를 호출하지 않고 사내에서 자체 운용하는 Qwen3.8-27B 모델로 넘어갑니다. 보정에 한 번도 쓰지 않은 별도 확인 세트, 시행령 조문에서 뽑은 591문항으로 이 경로를 확인했습니다. 4B가 이 중 406문항에서 유보했고, 그 406문항만 따로 떼어 두 방식을 비교했습니다.
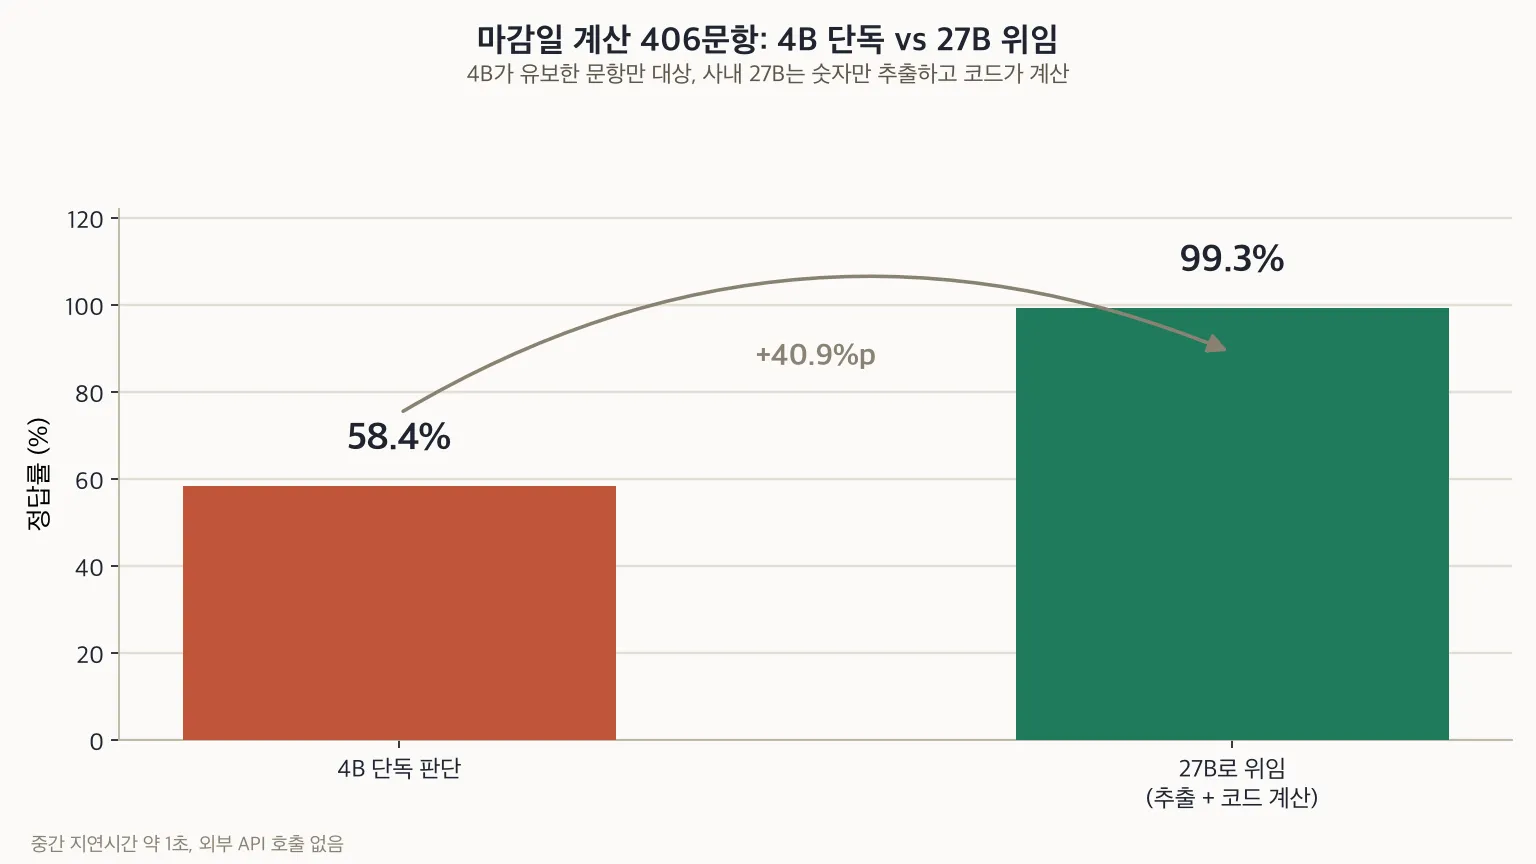 4B가 유보한 기한 계산 문항 406개를 4B에 억지로 답하게 한 경우와 27B에 넘긴 경우의 정답률 차이입니다. 27B는 답을 직접 판단하지 않고 날짜 두 개와 기한 일수만 추출하며, 실제 계산은 코드가 합니다.
4B에게 그 406문항을 억지로 답하게 하면 정답률은 58.4%에 그칩니다. 반면 27B는 정답을 직접 판단하지 않고 문서에서 기준일 두 개와 기한 일수만 뽑아내고, 초일 불산입과 공휴일 처리를 포함한 날짜 계산은 별도 코드가 수행합니다. 이 경로의 정답률은 99.3%로, 법령 단위로 재표집한 부트스트랩 95% 신뢰구간이 [36.0, 45.8]인 40.9퍼센트포인트 차이입니다. 이 가설은 실험 전에 미리 등록해 둔 것이었고, 결과가 그대로 확인됐습니다. 중간 지연시간은 약 1초였습니다. 유보가 그냥 판단을 포기하는 것이 아니라, 4B가 약한 지점을 정확히 짚어 코드가 계산할 수 있는 형태로 넘기는 경로라는 뜻입니다.
라벨 자체의 신뢰도
이 모든 보증은 결국 라벨이 맞다는 전제 위에 서 있습니다. KD-Lawset-KO의 라벨은 독립적으로 작성한 두 프로그램이 코드로 계산합니다. 이 라벨 품질을 재확인하기 위해, 전체 2,812문항 전부를 gpt-5.6-luna가 라벨을 보지 않은 채 처음부터 다시 풀게 했고, 두 결과가 갈린 25건은 gpt-5.6-sol이 판정했고, 판정자가 라벨에 끌렸을 가능성을 지우려고 같은 25건을 sol에게 라벨 없이 한 번 더 풀게 했습니다. 25건 모두 코드 라벨과 같은 답이 나왔습니다. 그 결과 잘못된 라벨은 0건, 애매한 문항은 1건이었고, 라벨 오류율의 95% 상한은 0.13%입니다. 이 검증은 사람이 눈으로 감수한 것이 아니라 모델 기반 재검증이라는 점은 분명히 해 둡니다. 모델 검수가 놓친 것도 있었습니다. 질문이 묻는 조문 줄에 “보상금의 3배”나 “중 높은 금액”처럼 문항에 없는 값에 따라 달라지는 상한이 들어 있는지 규칙으로 다시 훑었더니 이런 문항이 4건 나왔고, 모델 검수는 그중 1건만 애매하다고 표시했습니다. 네 건은 데이터셋에 애매 문항으로 따로 표시했고, 빼고 다시 재도 α=0.10 결과는 유보 19.0%, 오류 1.8%로 거의 같습니다. 생성기는 다음 버전부터 이런 형태를 만들지 않습니다.
ThakiCloud 제품 적용 시사점
이 작업은 Paxis의 사람 승인 워크플로와 곧바로 맞물립니다. 에이전트가 규정을 근거로 판단을 내리다가 확신이 낮은 사안을 자동으로 유보하고 사람의 승인 단계로 넘기는 구조는, 컨포멀 유보가 그 유보 시점을 통계적으로 정당화해 주는 관계입니다. 감사 로그에는 “예”라는 텍스트가 아니라 “답함, 오류율 α 이하를 90% 신뢰로 보증” 또는 “유보, 사람 검토로 이관”이라는 두 상태만 남습니다.
Aegis 렌즈에서는 유보 이후의 경로가 이미 사내에서 완결됩니다. 유보된 질문이 사외 API가 아니라 자체 운용하는 27B 모델로 가고, 그 모델조차 판단을 직접 내리지 않고 숫자만 추출해 코드가 계산하게 하는 구조는 문서를 사외로 보낼 수 없는 금융·보험·공공·국방 고객에게 그대로 맞습니다. Maxis 렌즈에서는 도메인이 바뀌면 임계값을 다시 보정해야 한다는 이번 결과가 그대로 제품 요구사항이 됩니다. 고객 네트워크 안에서 새 문서군에 맞춰 임계값을 재보정하는 절차 자체가 지속적인 파인튜닝·보정 파이프라인의 일부가 되어야 합니다.
한계와 다음 단계
이 글의 결론을 그대로 받아들이기 전에 몇 가지를 분명히 해야 합니다. 첫째, AI 허브 세트는 문서 단위가 아니라 질문 단위로 분할했고, 이는 보증을 실제보다 낙관적으로 보이게 할 수 있는 알려진 한계입니다. 둘째, 도메인 시프트 결과는 한 사례일 뿐이며 모든 새 도메인에서 안전 여유가 똑같이 줄어든다고 단정할 수 없습니다. 셋째, 라벨 검증은 사람 감수가 아니라 모델 기반 재검증입니다. 넷째, 27B 위임 경로의 40.9퍼센트포인트 개선은 기한 계산이라는 좁은 질문 유형에서 나온 결과이고, 다른 질문 유형에서 같은 폭의 개선이 나온다는 보장은 없습니다.
다음으로 할 일은 AI 허브 세트를 문서 단위로 다시 분할해 보증을 재검증하는 것, 그리고 도메인 시프트가 일어날 때마다 임계값을 얼마나 자주, 얼마나 적은 데이터로 재보정할 수 있는지를 재는 것입니다. 이 두 가지가 채워지기 전까지는 이 글의 수치를 최종 판정이 아니라 중간 보고로 읽는 것이 맞습니다.
참고 자료
본문에 언급된 공개 자료입니다.
- Angelopoulos 외 · Learn Then Test: Calibrating Predictive Algorithms to Achieve Risk Control (arXiv)
- ThakiCloud · ThakiCloud/kd-4b-ko-v0 (Hugging Face)
- ThakiCloud · ThakiCloud/kd-lawset-ko (Hugging Face Datasets)
- AI 허브(한국지능정보사회진흥원) · 법률·규정 텍스트 분석 데이터 (AI Hub)