생각은 한 번입니다. 청구는 매 턴입니다: 에이전트 루프의 추론 과잉세(verbosity tax) 공식
멀티턴 에이전트 LLM을 직접 서빙하거나 도구 호출 워크로드의 비용 예산을 잡는 국내 클라우드·AI 엔지니어라면 이 글이 필요합니다. thinking을 켤지, thinking budget을 얼마로 줄지, 컨텍스트에 추론을 남길지. 이 세 결정이 에이전트 루프에서 얼마의 대가를 치르는지 공식으로 짚은 논문을 소개합니다. 추론 토큰은 한 번 생성되면 끝이 아닙니다. 컨텍스트에 남으면 매 턴 다시 청구됩니다. 그 청구가 지평선과 함께 이차적으로 커지는 현상을, 이 논문은 추론 과잉세(verbosity tax)로 이름 붙여 가격화합니다.
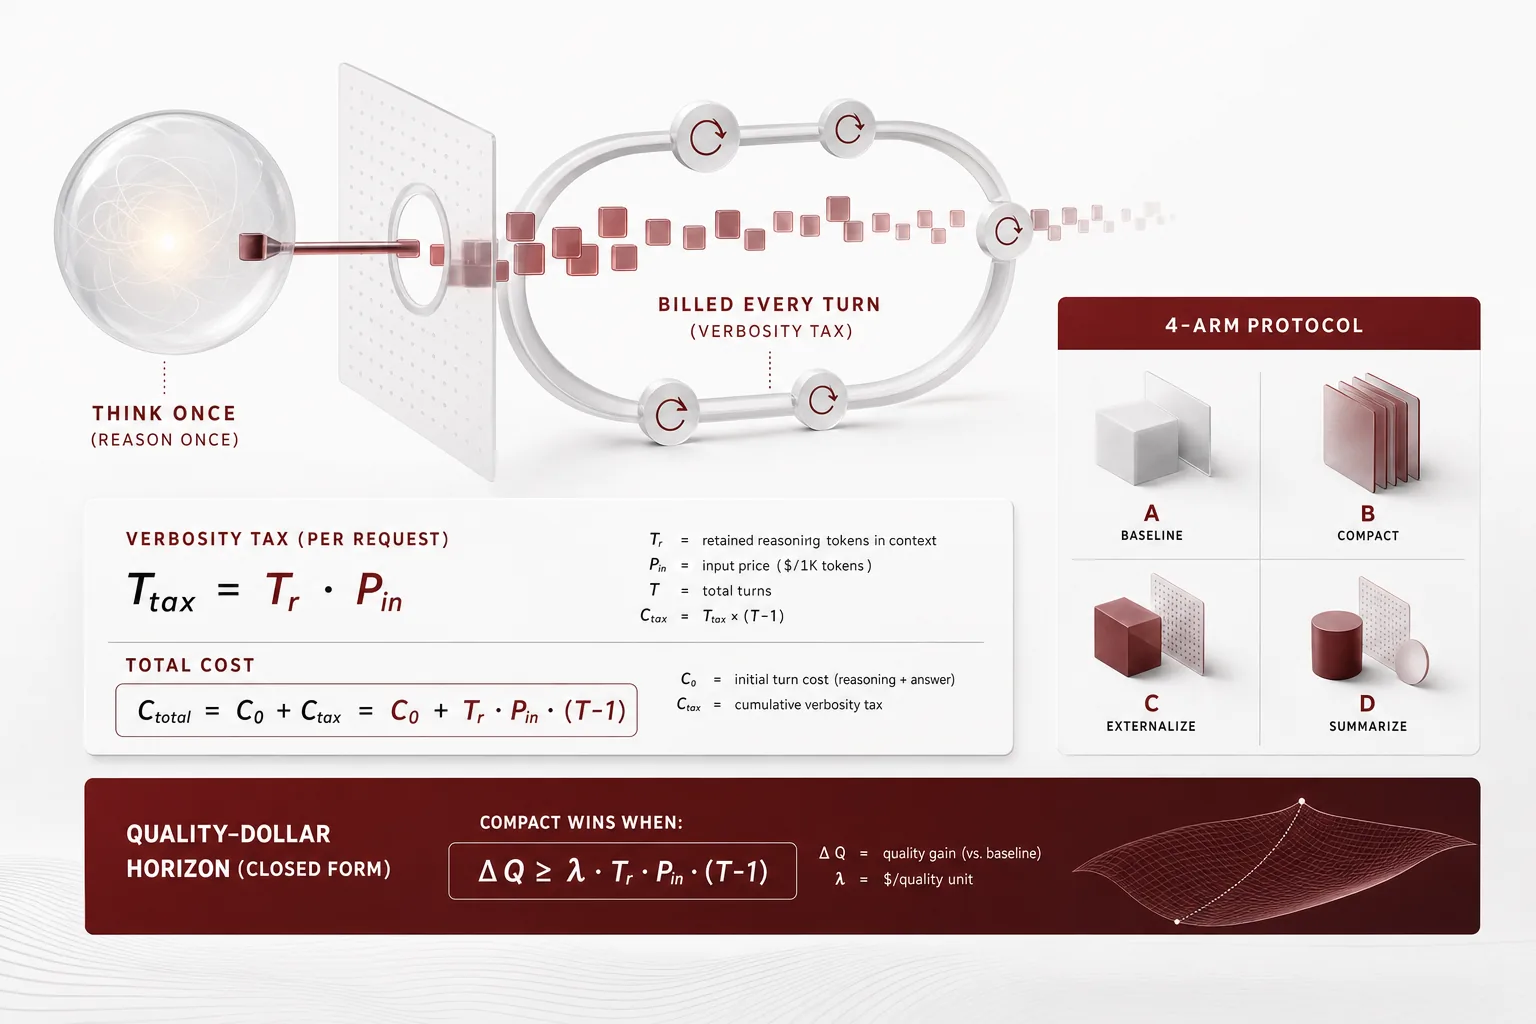 글의 핵심 개념을 형상화했습니다.
긴 말이 다시 청구되는 이유
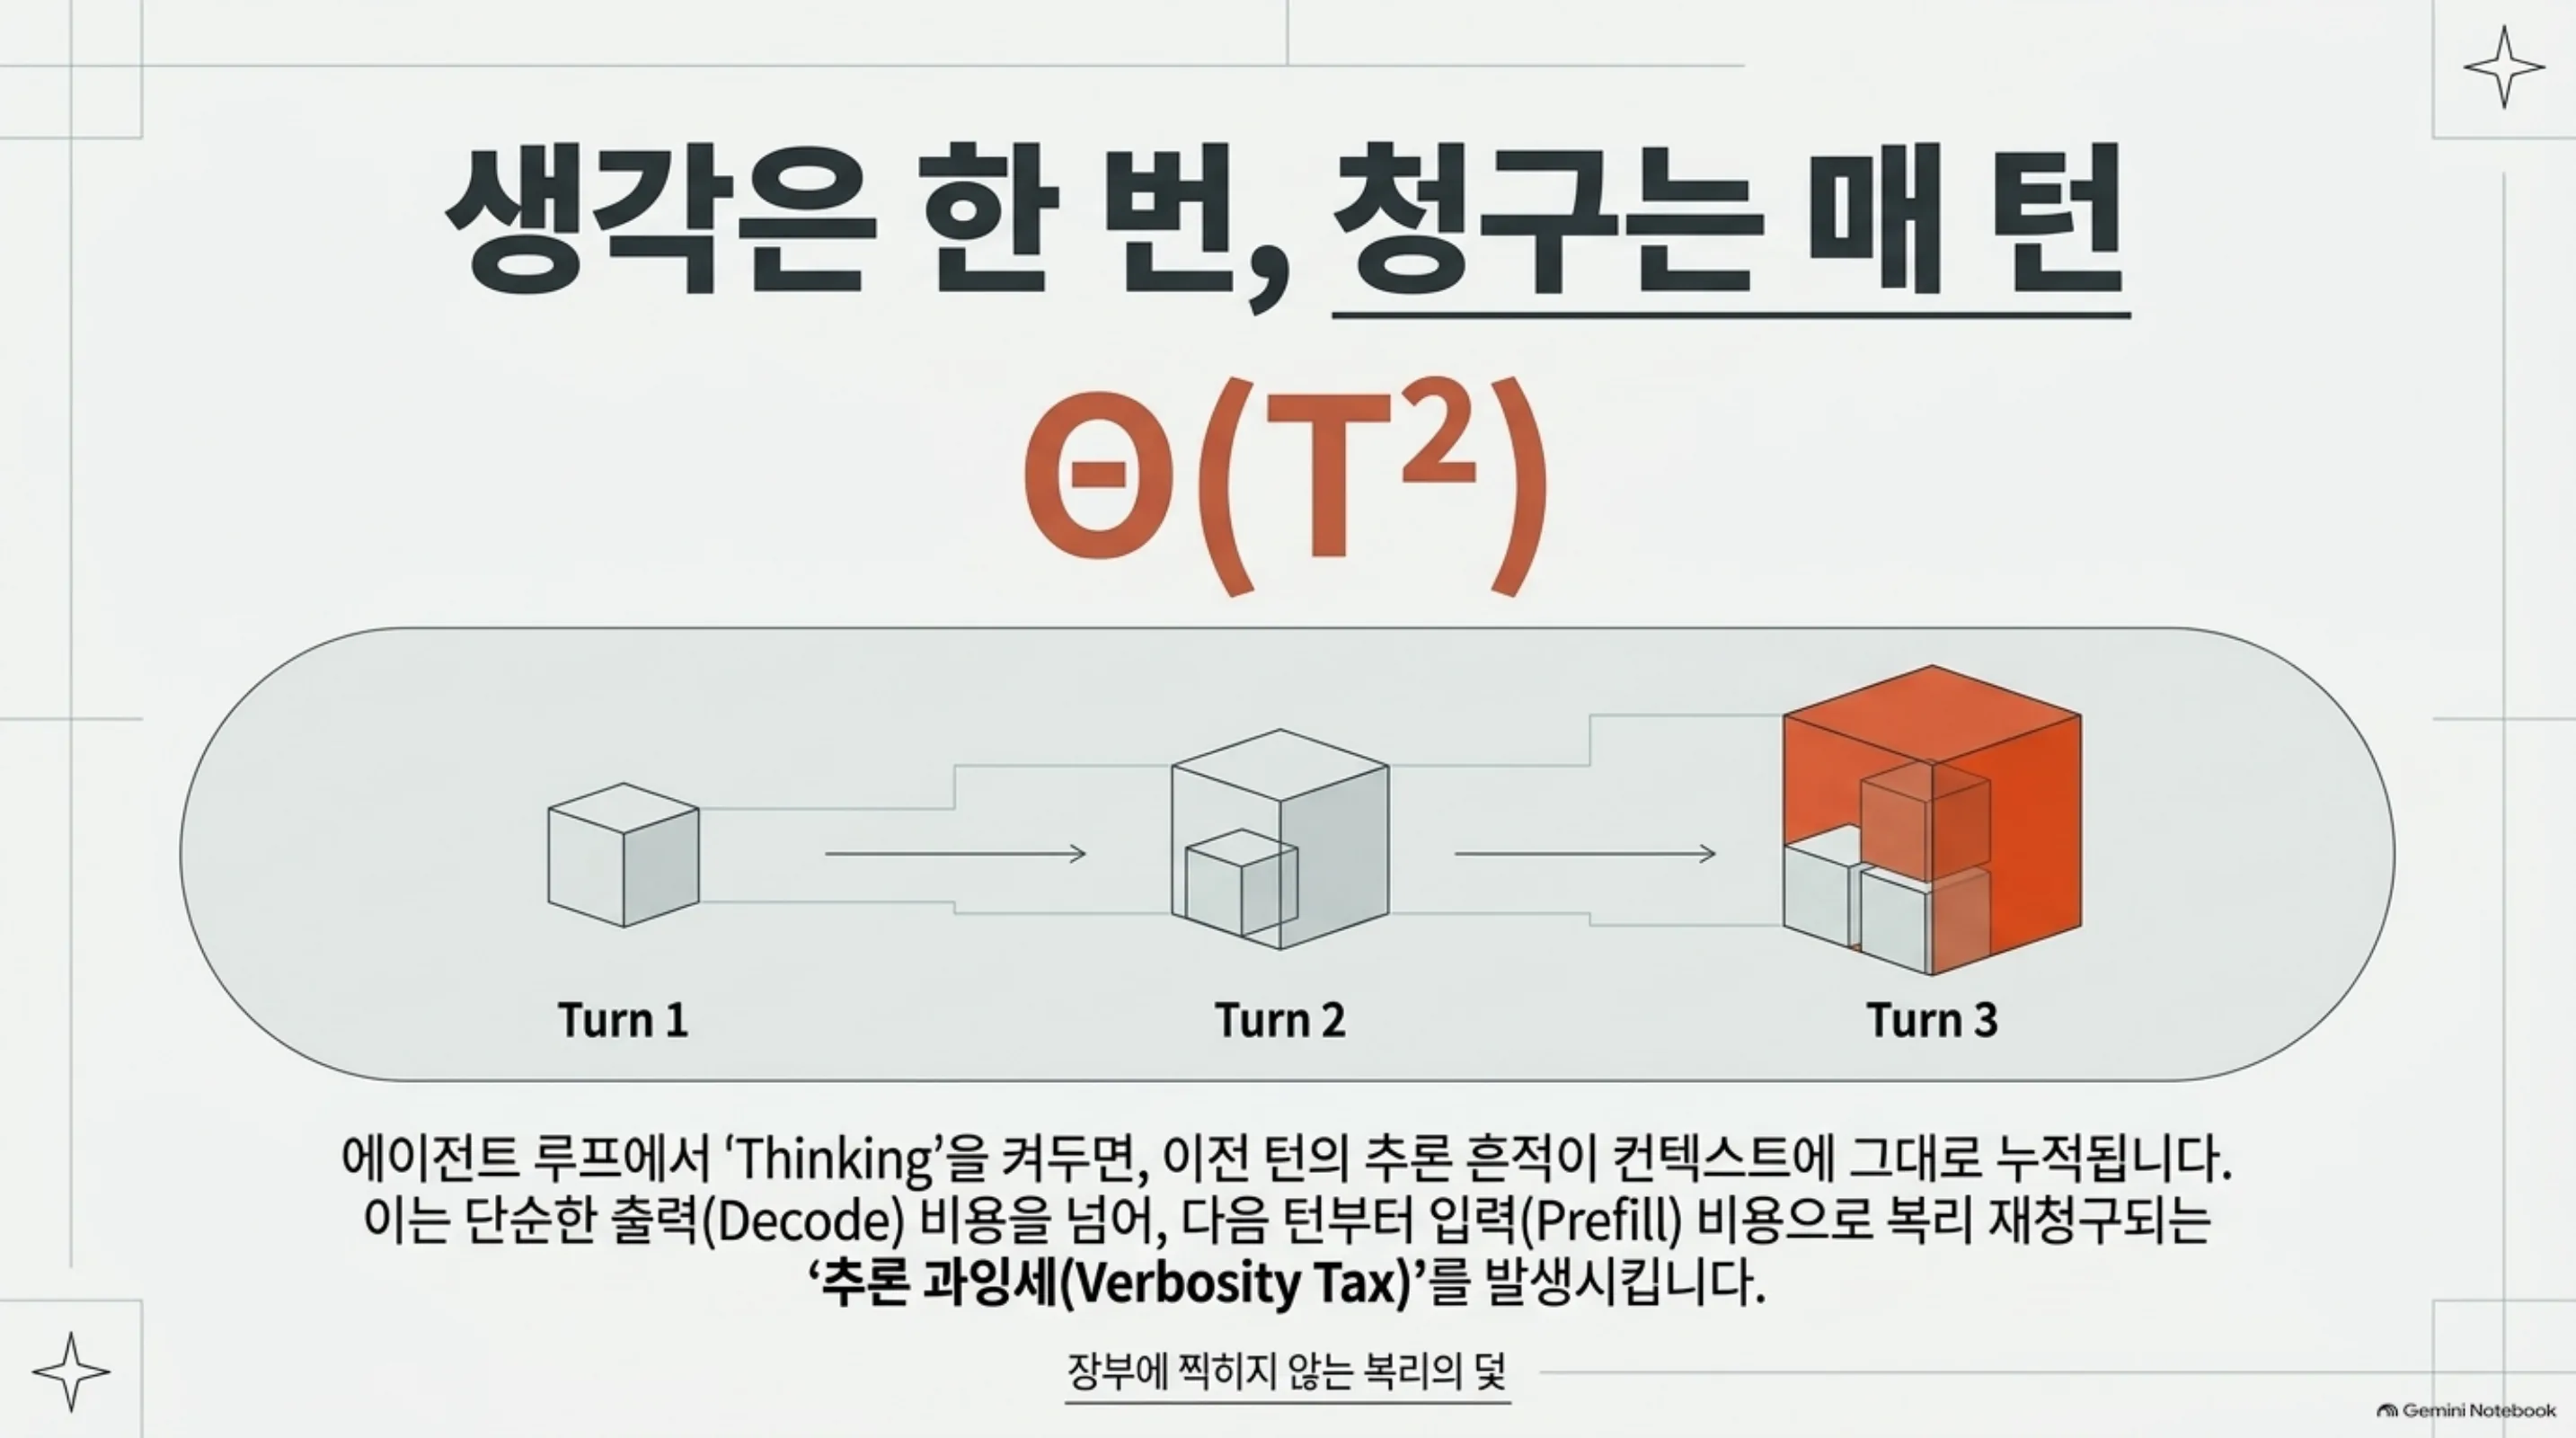
에이전트는 한 번의 질문을 답하는 시스템이 아니라 루프를 돌리는 시스템입니다. 멀티턴 도구 호출 에이전트에서 매 턴마다 모델이 다시 호출되고 그때 모델이 보는 컨텍스트에는 이전 턴의 추론 흔적, 행동, 도구 응답이 차례로 쌓여 있습니다. thinking을 켜둔 채로 돌리면 매 턴 추론 토큰이 컨텍스트에 남습니다. 남은 토큰은 다음 턴부터 입력 토큰 가격으로 다시 계산됩니다.
실무에서는 deployment 단위로 thinking on/off를 한 번 고정한 채로 돌리는 경우가 많습니다. 그 고정의 대가는 작업당 달러만 보고 있는 장부에 찍히지 않습니다. 총계만 보는 장부에서 추가 추론 토큰은 매 턴 조용히 복리로 쌓입니다. 이 논문은 그 고정과 그 청구서를 가시화하는 일에서 시작합니다.
이 축을 연 연구는 BDH-CQ입니다. 150M 파라미터 인컨텍스트 모델이 언어로 발화하지 않는 반복 잠언 추론(recurrent latent reasoning)을 돌렸고 ARC-AGI-1에서 작업당 계산 추론 비용 0.0007달러에 pass@2 29.5%를 기록했습니다. 작은 모델이 비용-정확도 파레토 프런티어를 깬 것입니다. 추론의 형식과 밀도, explicit 토큰 대 compact 계산, 자체가 모델 용량과 독립된 비용-품질 축이라는 뜻입니다. 이 논문은 그 축을 현실의 에이전트 서빙으로 옮깁니다. 모델은 고정하고 reasoning state만 바꿔 형식/밀도 축을 분리해 짚습니다. 에이전트 루프가 BDH-CQ의 단일 작업 설정에 추가하는 것은 재청구입니다. 컨텍스트에 남은 explicit 추론 토큰은 이후 모든 턴에서 다시 돈을 냅니다. 그 재청구가 턴을 건너 쌓이는 것이 추론 과잉세입니다.
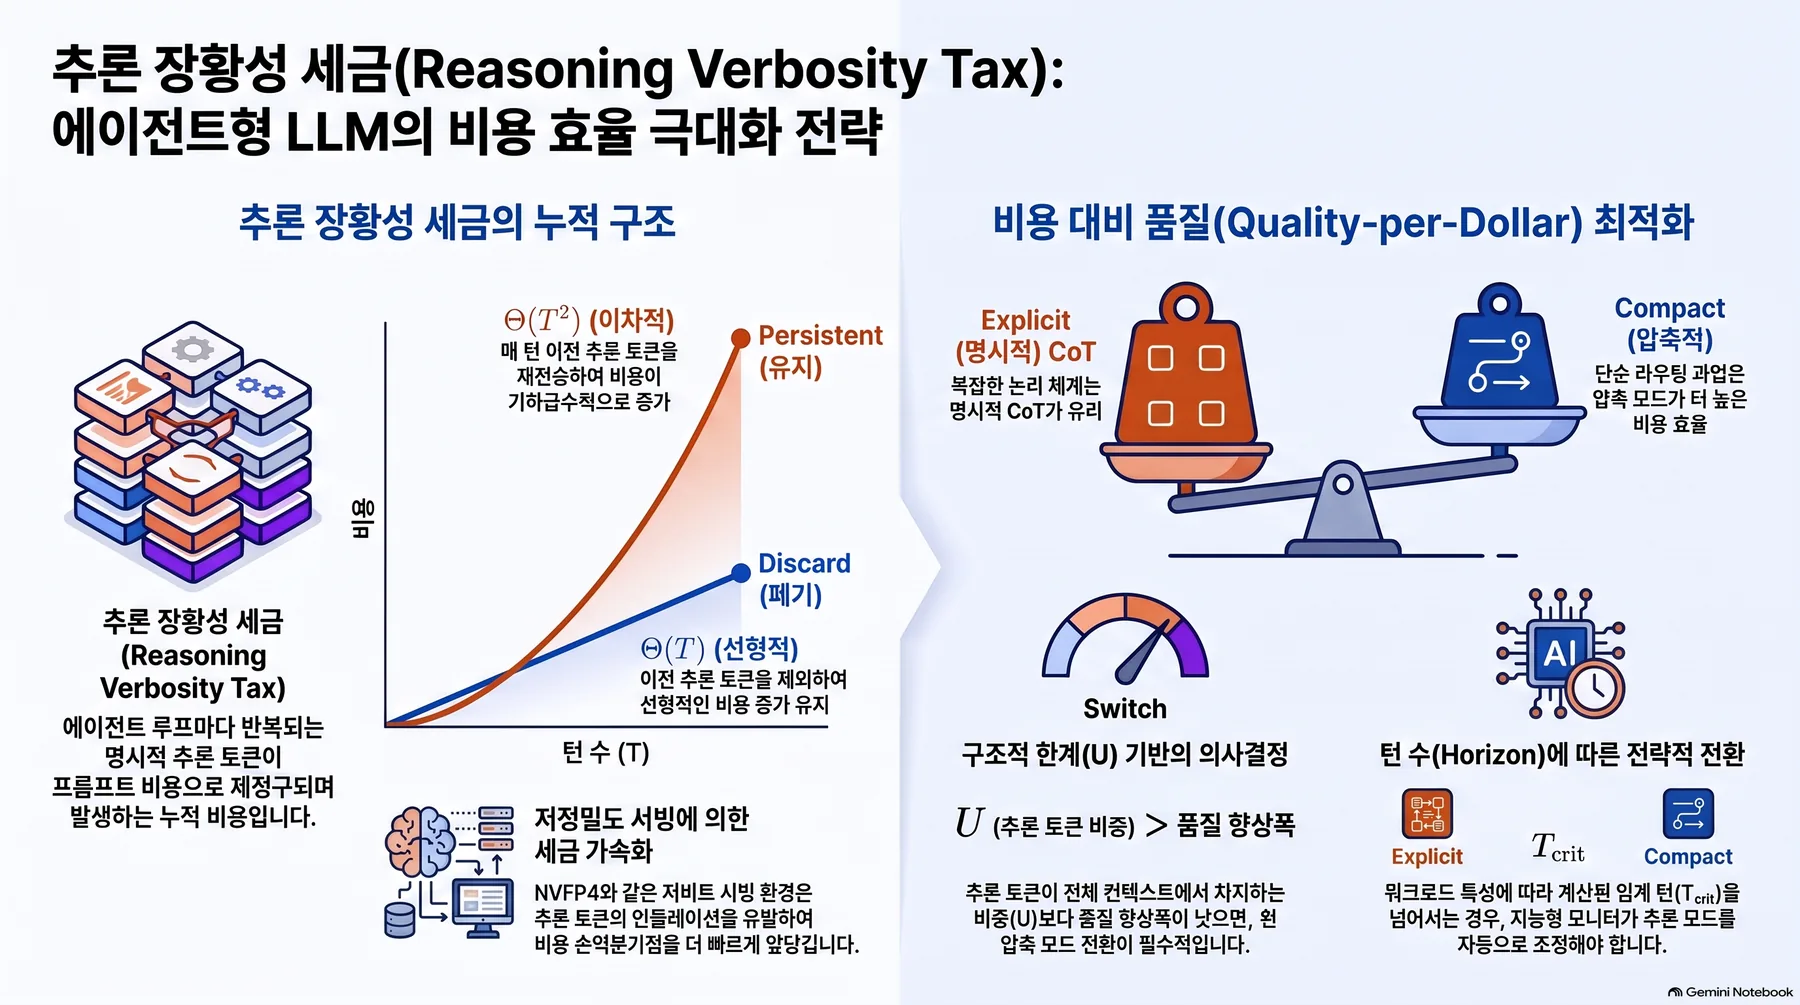 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
세(verbosity tax)를 공식으로 짜다
설정은 모델 가문과 작업 집합을 고정하고 state만 바꿉니다. H200에서 Qwen3-8B student는 bf16로, Qwen3.8-27B teacher는 NVFP4로 서빙됩니다. 작업 집합은 BFCL simple, multiple, parallel과 63개 case의 SRA routing bench입니다. reasoning state는 Qwen3 chat template의 thinking 토글로 바꿉니다. on/off 스위치와 thinking budget b가 서빙에 이미 달린 손잡이입니다.
컨텍스트 길이가 m인 턴에서 explicit state E(추론 v_E 토큰)의 턴당 세는 compact state C 대비 다음 비율인가.
τ₁ = (p_in·m + p_out·(v_E + o)) / (p_in·m + p_out·o) > 1 (v_E > 0)
p_in과 p_out은 H200 셀프호스트 기준 입력, 출력 토큰당 상감 가격이고 o는 턴당 출력/행동 토큰 수입니다. 세는 v_E에 대해 증가하고 m에 대해 감소하는 것이다. 고정 컨텍스트가 길면 세가 희석되고 thinking budget이 크면 세가 커집니다. 1차 근사는 τ₁ ≈ 1 + p_out·v_E/(p_in·m + p_out·o)입니다. 한 턴만 보면 작은 비율에 불과한 셈입니다. 물질적으로 변하는 것은 복리이기 때문.
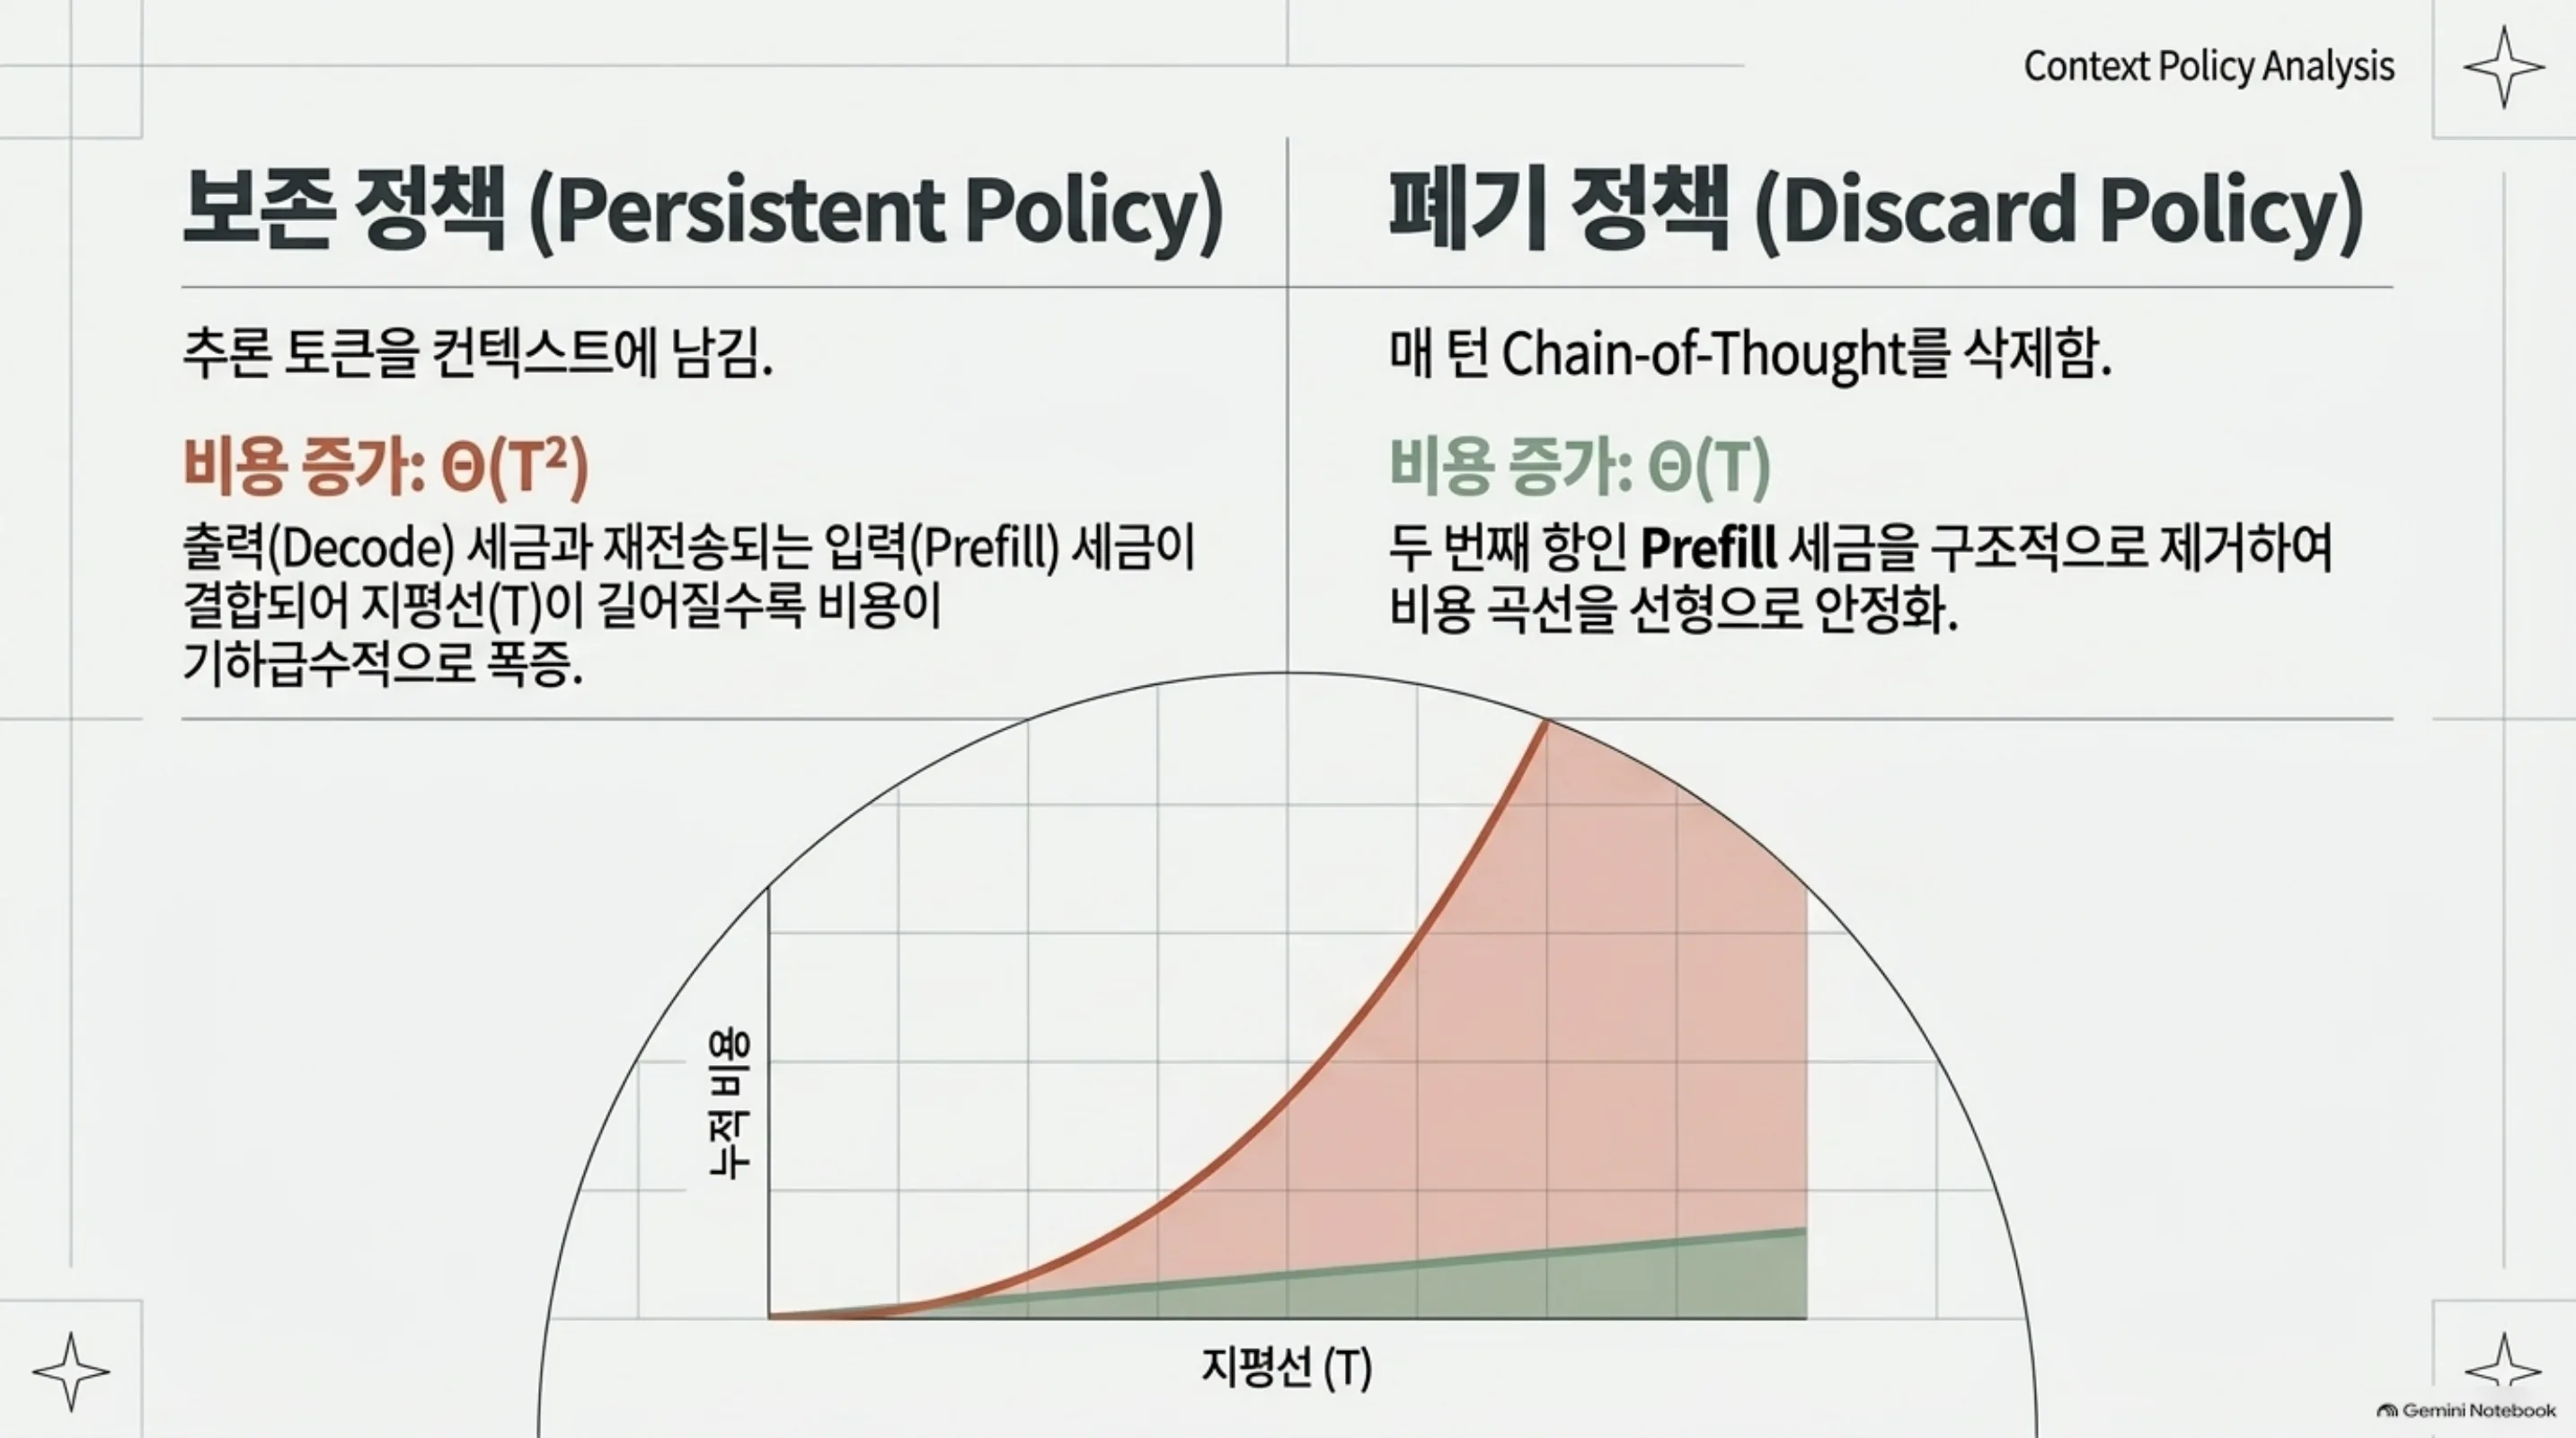
복리를 다룬 결과가 lemma입니다. persistent policy, 추론이 컨텍스트에 남는 정책에서 v_E, o, w(도구 응답 토큰)가 T 턴 동안 일정하면 explicit과 compact의 절대 비용 차는
v_E·(p_out·T + p_in·T(T-1)/2) → Θ(T²)
이고 매 턘 chain-of-thought를 지우는 discard policy에서는 p_out·v_E·T, 곧 Θ(T)입니다. 두 항의 읽기는 다릅니다. p_out·v_E·T는 decode 세입니다. 추론 토큰이 턴마다 한 번씩 출력 가격으로 생성되는 비용인 셈입니다. p_in·v_E·T(T-1)/2는 prefill 세입니다. 같은 토큰이 이후 모든 턴에서 다시 전송되어 입력 가격으로 다시 계산되기 때문입니다. discard는 이 두 번째 항을 구조적으로 없앱니다. 그래서 이차 대 1차 곡선이 컨텍스트 정책을 구분하는 측정 가능한 지표가 됩니다. 장부에 찍히는 곡선의 모양이, 추론을 남겼는지 지웠는지를 말해 줍니다.
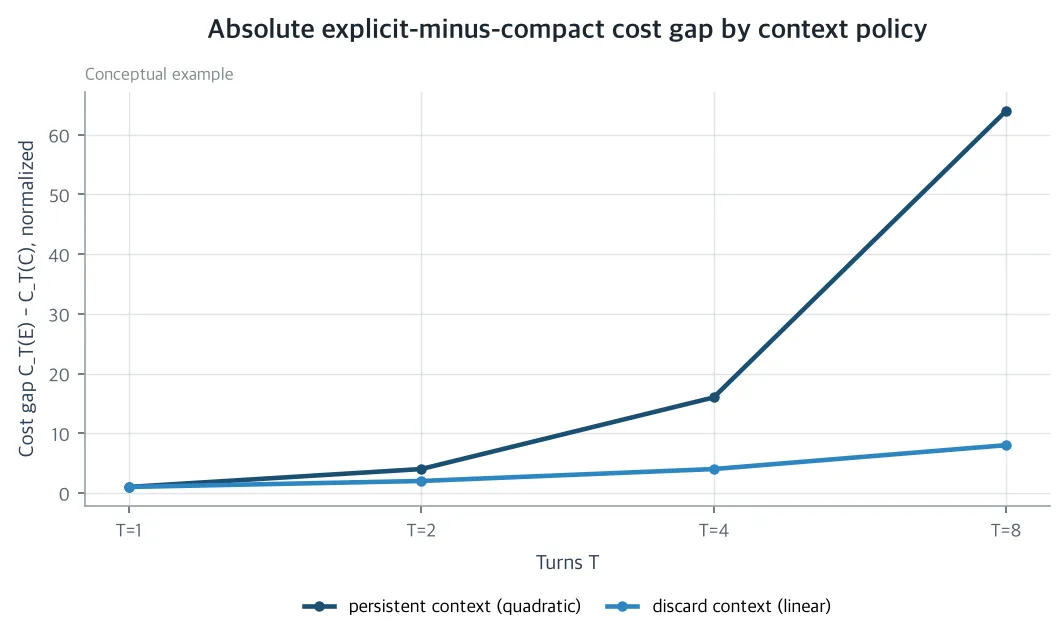 persistent 컨텍스트에서는 explicit 대비 compact의 절대 비용 차이가 지평선 T에 대해 이차적으로, discard policy에서는 1차적으로 커집니다. 그래프는 개념 예시이며 실측 값이 아닙니다.
상한도 있습니다. 표준 컨텍스트 조건 p_in·m > p_out·w, 고정 system/tool 컨텍스트 m이 큰 경우에서 persistent policy의 relative 세 τ_T는 τ₁에서 시작해 유한한 구조적 상한 U = 1 + v_E/(o+w)으로 단조 증가한다. 세는 지평선과 함께 벌어지지만 자라는 컨텍스트 안의 추론 비중이 정한 상한을 넘지 않는다는 뜻이다. discard policy에서는 τ_T가 τ₁에서 1로 감소한다.
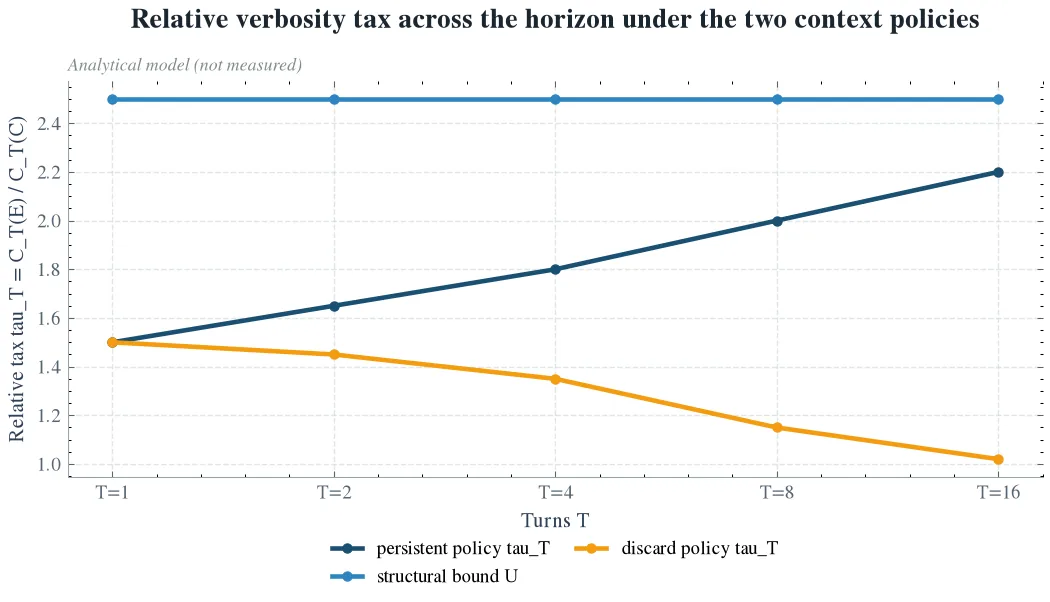 표준 컨텍스트 조건에서 persistent policy의 relative 세는 단일 턴 세 τ₁에서 구조적 상한 U로 단조하게 벌어지고 discard policy의 세는 1로 수렴한다. 분석 모델의 도식이며 실측 데이터가 아닙니다.
품질-달러 손익분기점
비용만으로는 state를 고를 수 없습니다. compact가 explicit보다 품질-달러, 즉 달러당 품질이 높은 조건을 닫힌 해로 줍니다. 조건은
τ_T > (q_E/q_C)^γ
입니다. q_E, q_C는 턴별 성공 확률이고 γ는 품질이 복리로 쌓이는 턴 수입니다. γ를 어디에 놓느냐에 따라 두 quality model이 나옵니다.
Model A는 deep dependency chain입니다. 작업 성공 Q = q^T이므로 γ = T가 됩니다. 품질 프리미엄 (q_E/q_C)^T는 T에 대해 지수이고 τ_T는 max{τ₁, U}로 상한이 있습니다. Δq > 0이면 어떤 정책에서도 crossover 지평선을 넘으면 explicit이 이깁니다. 긴 의존 사슬에서는 세를 치를 가치가 있다는 뜻입니다.
Model B는 k개의 critical turn이 품질을 떠메는 경우입니다. 단일 routing 결정이 대표적입니다. 품질은 T에 대해 복리하지 않고 γ = k, 프리미엄 R = (q_E/q_C)^k가 고정됩니다. persistent policy에서 R < τ₁이면 compact가 모든 지평선에서 이깁니다. τ₁ ≤ R < U이면 T > T_crit에서 compact가 이기며 T_crit은 닫힌 형태로 주어집니다. R ≥ U이면 explicit이 모든 지평선에서 이깁니다. discard policy에서는 τ_T가 τ₁에서 1로 감소하므로 R < τ₁이면 compact가 짧은 지평선에서, explicit이 긴 지평선에서 이깁니다.
두 model이 가리키는 실무 결론은 하나입니다. quality premium R이 상한 U보다 낮은 워크로드, routing이 대표인 경우, 장기 지평선의 승자는 컨텍스트 정책이 정합니다. persistent 재청구 환경에서는 compact가 유리하고 discard 환경에서는 decode 세가 1로 상감되어 explicit이 유리합니다. 이 반전과 이차-1차 곡선 차이가 프로토콜이 측정할 대상입니다.
과잉 공급 턴(over-provisioned turn)도 정의됩니다. 턴 t의 relative 비용 증가분 p_in(t-1)v_E + p_out·v_E가 relative 품질 증가분 (p_in·m + p_out·o)·Δq/q_C를 넘으면, 그 턴은 세를 내고 품질을 못 사 온 턴입니다. 두 testable condition이 따라옵니다. routing이 많고 의존이 짧은 Model B 워크로드(k ≪ T)에서는 과잉 턴 집합이 비어 있지 않다고 예측하고 deep chain인 Model A에서는 비어 있거나 드물다고 예측합니다.
thinking 예산의 최점은 지평선에 따라 움직인다
작업 클래스를 고정하고 thinking budget b를 0에서 b_max까지 sweep하면 두 구조적 사실이 성립합니다. 정확도 Q(b)는 b에 대해 비단조입니다. Q(0)에서 올라 피크를 찍은 뒤, budget이 추론을 불려 주는데 답이 그만큼 개선되지 못하는 구간에서는 내려올 수 있습니다. 이전 연구가 function calling 에이전트 작업 200개에서 budget 0에서 512까지 여섯 개를 sweep한 것이 이 비단조성의 근거입니다. 비용 C(b)는 b에 대해 증가합니다. persistent policy에서는 큰 b가 턴마다 decode를 더 쓰는 것뿐 아니라 이후 모든 턴의 재전송 prefill을 더 만들므로, 큰 b의 effective 비용은 지평선과 함께 자랍니다.
품질-달러 함수 F(b) = Q(b)/C(b)는 내부 최점 b를 가질 수 있습니다. 피크의 품질 이득이 비용 증가를 앞서는 b가 있으면 b는 0과 b_max 안에 있고 그렇지 않으면 b* = 0입니다. b가 0이면 compact point 자체가 그 작업 클래스의 품질-달러 최적입니다. 논문은 compact regime의 최대 품질-달러 손실을 price of optimality, PoO = F(b)/F(0) ≥ 1로 정의합니다. 운영자 품질 허용치가 ε이라면 PoO - 1 ≤ ε일 때 compact가 허용됩니다. persistent policy에서 b는 b(T)로 지평선에 의존하고 frontier는 단일 곡선이 아니라 지평선 인덱스를 가진 곡선 가족이 됩니다. 여러 지평선에 하나의 budget을 고정해 두는 운영은, 장부가 추적해야 할 frontier point를 암묵적으로 주고받는 것입니다.
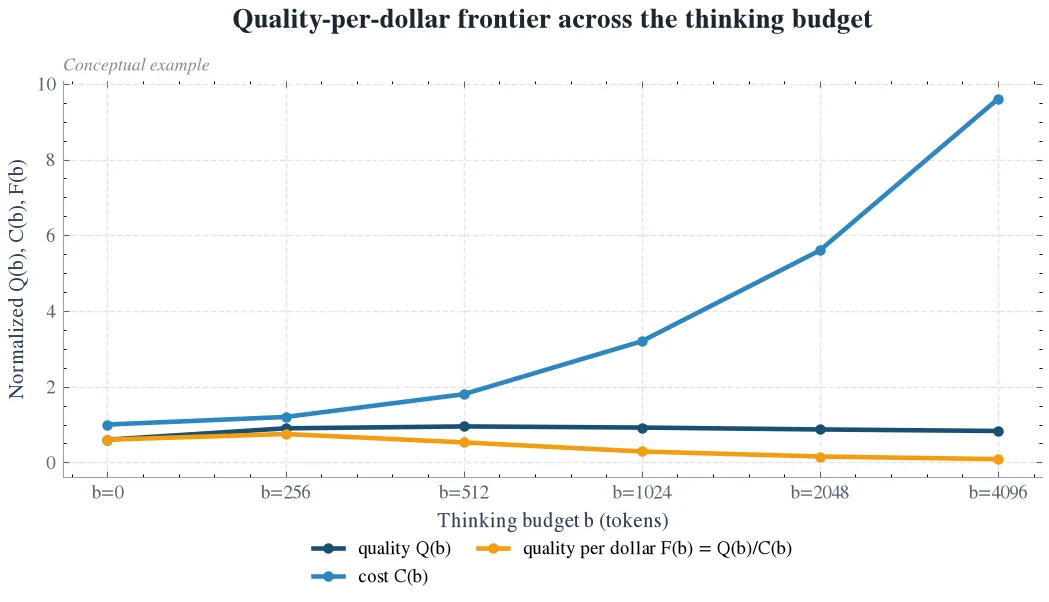 정확도는 thinking budget b에 대해 비단조이고 비용은 단조 증가하므로, 품질-달러 곡선은 내부 최점 b를 가질 수 있습니다. price of optimality가 운영자 허용치 안에 있으면 고정 compact(b = 0)가 허용됩니다. 개념 예시이며 실측이 아닙니다.*
low-bit serving과의 상호작용도 공식으로 잡힌다. quantization은 추론 길이를 α > 1배로 불린다. NVFP4에서는 같은 regime이 α·v_E 추론 토큰을 뿜는다. 세 excess τ₁ - 1은 α에 비례해 자라고 T_crit은 α에 대해 단조 감소해 α가 클수록 T = 1 쪽으로 수렴한다. 상한 U도 1 + α·v_E/(o+w)로 올라간다. bf16에서 break-even neutral이던 regime이 NVFP4에서는 명확하게 compact-favorable로 바뀐다. 토큰당 싼 가격과 턴당 많은 토큰은 경쟁이 아니라 곱셈이다. 서빙 정밀도는 break-even 계산의 입력이지, 사후 고려가 아니다.
워크로드 구조로도 state를 분류할 수 있다. schema 기반 single tool call과 routing 결정은 b = 0 근처다. 소형 reasoning model은 function calling에서 강한 instruction follower이고 SRA routing bench는 턴당 비용이 regime에 지배되는 routing 워크로드다. compositional인 multiple, parallel tool call은 내부 b가 있는 클래스다. 여기서는 budget이 call 조정을 삽니다. BFCL mapping으로 보면 simple split은 b ≈ 0, multiple과 parallel split은 내부 b가 plausible한 클래스다. SRA routing bench는 Model B의 natural home이다. routing 결정이 critical turn의 작은 집합, k ≪ T이기 때문이다.
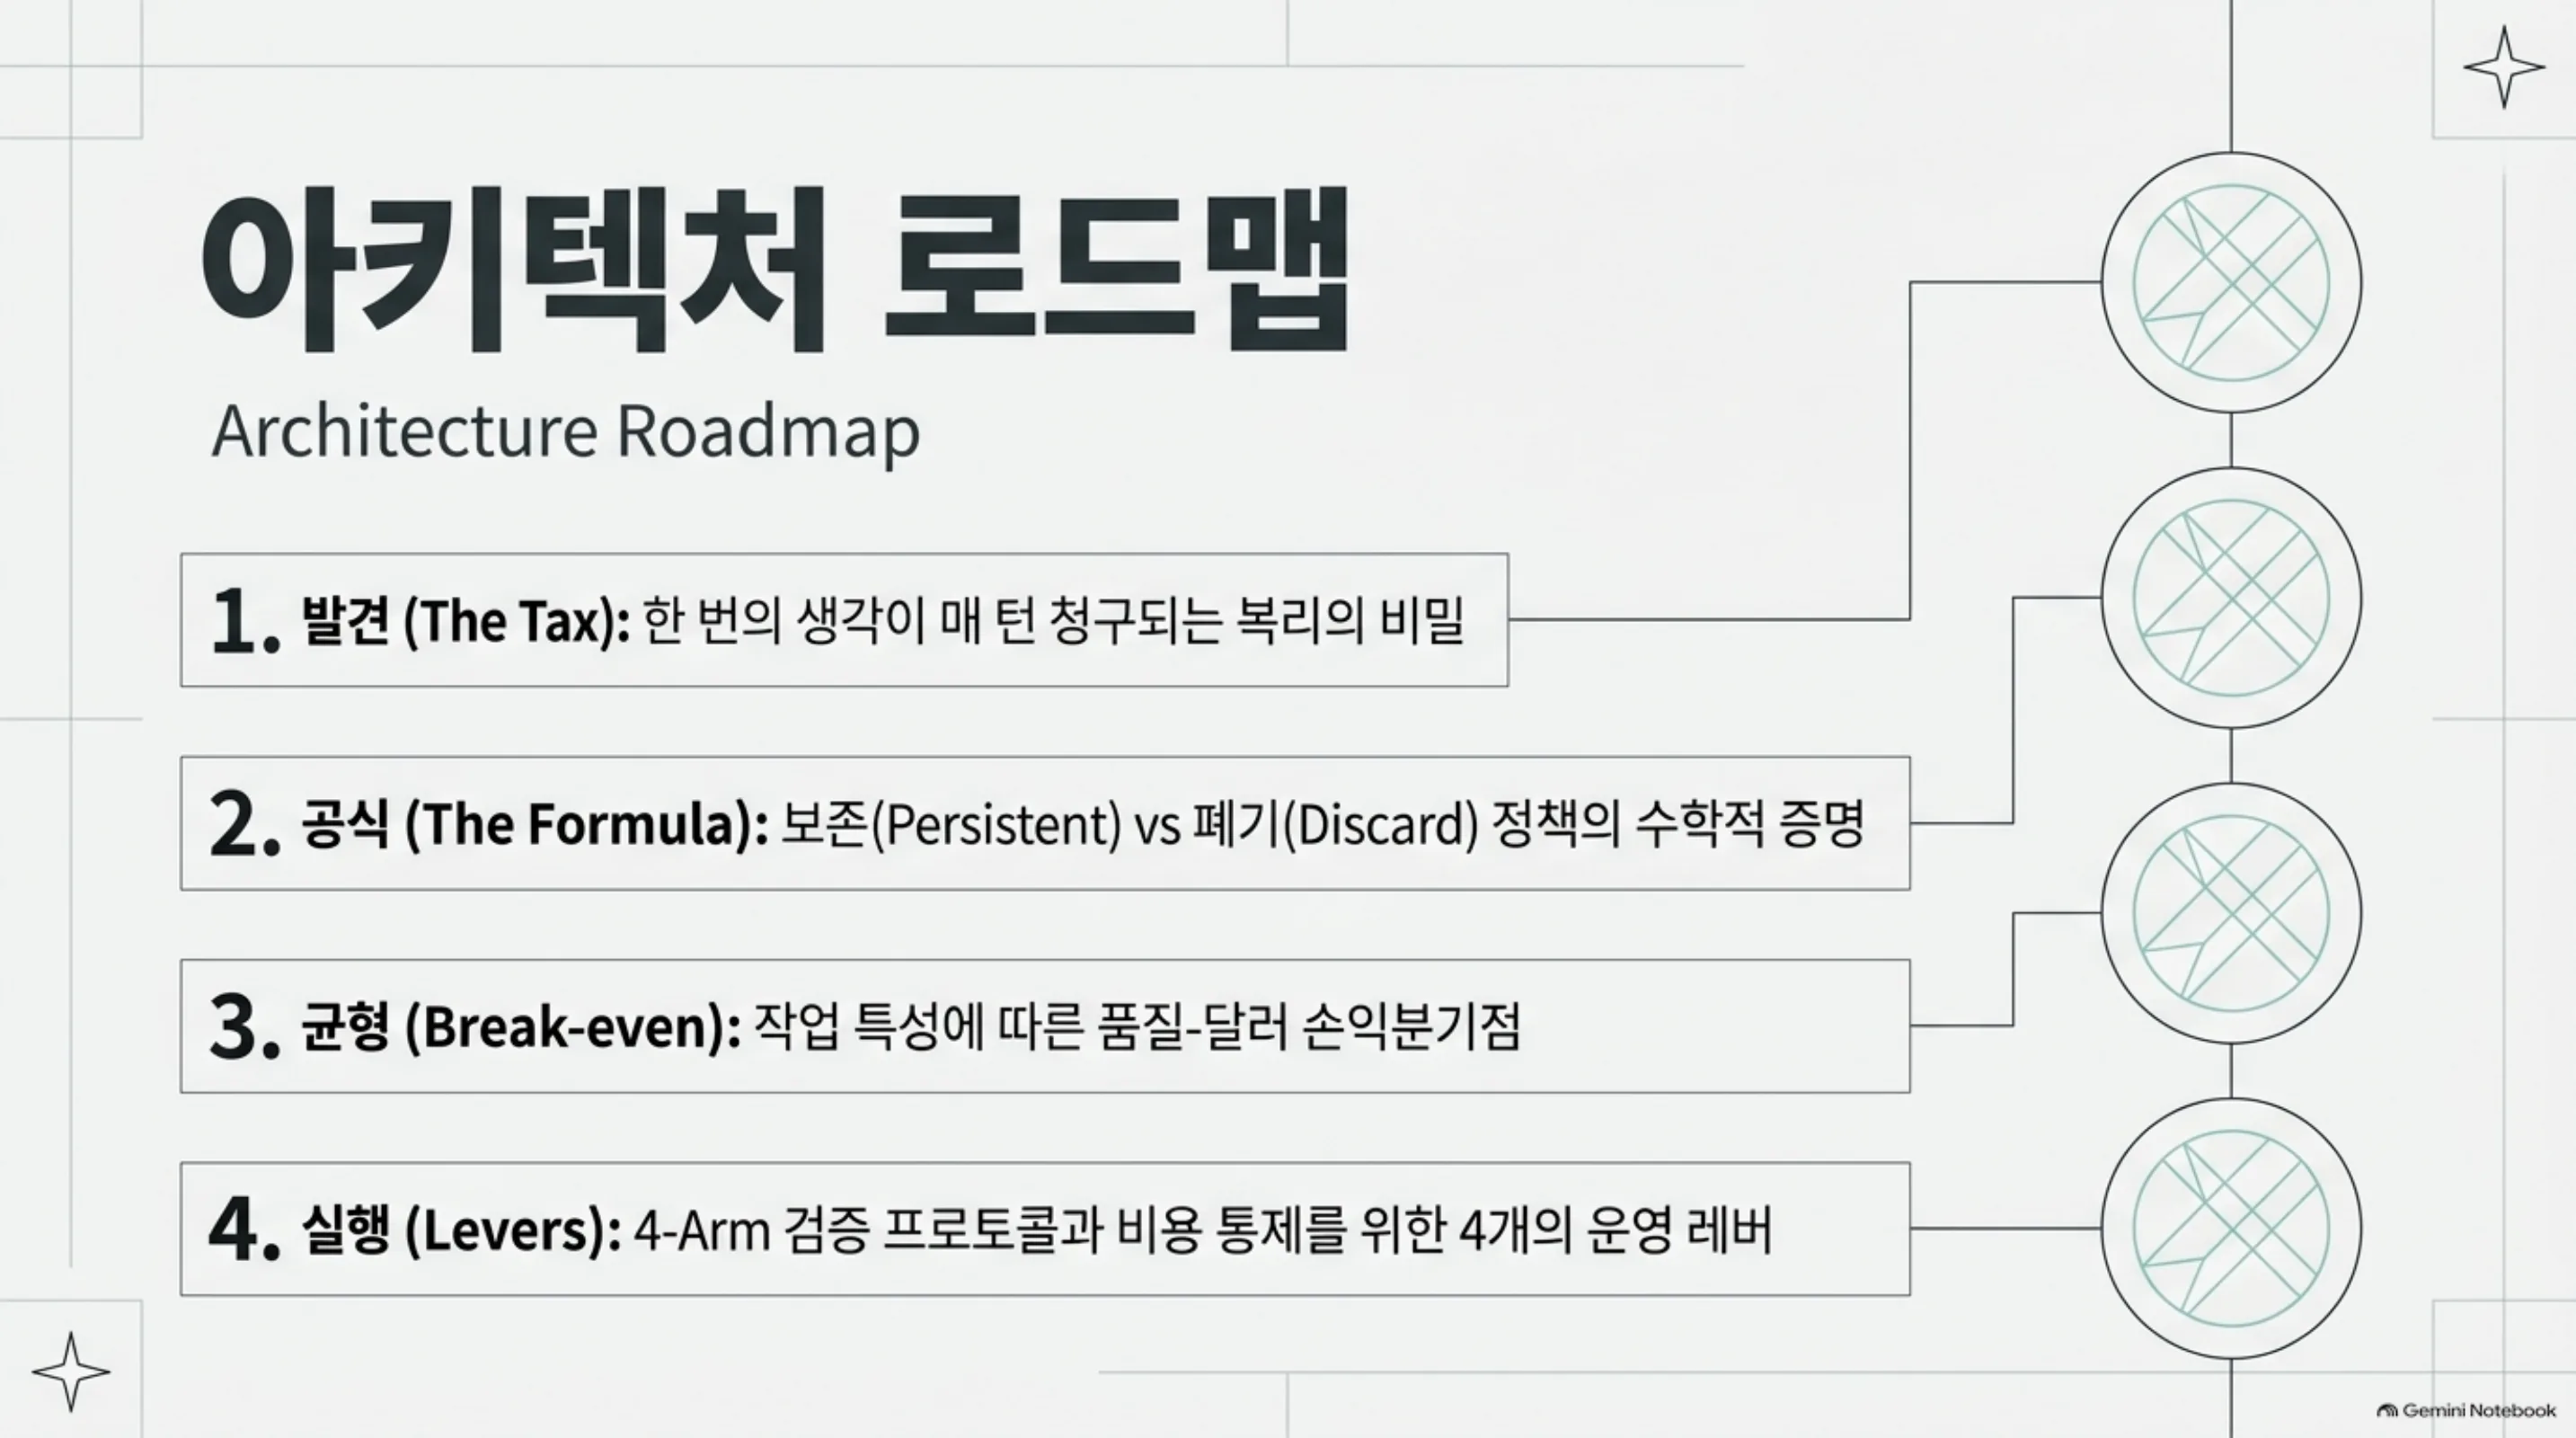
논문을 뒤집을 4arm 프로토콜
모든 결과는 구조적이며 값은 프로토콜이 채운다. 프로토콜은 전부 선포된, 검사 가능한, 규칙 기반 설계다.
플랫폼은 H200 continuous batching serving이다. model point는 두 개다. Qwen3-8B student bf16은 토큰 inflation이 없는 reference이고 Qwen3.8-27B teacher NVFP4는 토큰 inflation과 토큰당 싼 가격을 짝지어 α 상호작용을 재는 point다. Metis가 토큰을 meter하고 p_in과 p_out으로 나눈 상감 달러를 작업당 보고한다.
워크로드는 BFCL simple, multiple, parallel과 63개 case SRA routing bench, 그리고 각 워크로드의 멀티턴 변형이다. 지평선 T는 1, 4, 8, 16으로 lemma의 compounding 예측을 건드린다. 각 멀티턴 run은 컨텍스트 정책(persistent 또는 discard)을 선언하고 persistent run은 discard pair와 짝지어 이차-1차 구분 지표가 measurable하도록 한다.
arm은 넷이다. arm A는 default budget에서 thinking을 항상 켜는 explicit reference고 arm B는 thinking을 항상 꺼 v_t = 0인 compact baseline이다. arm C는 난이도 트리거로 턴마다 adaptive한 regime을 쓰는 allocation arm이다. arm D는 budget sweep b = 0, 256, 512, 1024, 2048, 4096으로 frontier를 채운다. decoding은 run마다 temperature와 seed를 선언해 고정한다. arm 간 차이를 sampling이 아니라 regime에 귀속시키고 arm 안의 작업 집합을 고정해 budget과 난이도 혼선을 통제한다. run-level control 전체는 metric 계산 전에 run config에 선언되고 per-turn decomposition은 보존된다. 세는 aggregate에서 되짚는 것이 아니라 cell by cell 검증된다.
metric은 BFCL split별 tool-call accuracy, SRA routing recall@1, per-turn reasoning 토큰, 총 입력/출력 토큰, wall-clock 지연, Metis 작업당 달러다. 전부 per-turn으로 분해된다.
arm을 읽는 방법은 고정되어 있다. A 대 B는 워크로드 클래스와 지평선별로 τ_T를 직접 재고 D는 실측 Q(b), C(b)로 b*와 PoO를 위치시켜 proposition의 부호를 확인한다. C는 over-provisioned corollary를 검사한다. difficulty trigger가 턴을 compact로 전환하고 그 턴의 실측 quality가 arm B와 맞으면 그 턴은 과잉 공급되어 있었다. 8B 대 27B 비교는 matched per-turn accuracy를 control로 size와 정밀도를 대조해 α 상호작용의 범위를 짚는다.
프로토콜은 논문을 뒤집을 수 있게 설계되어 있다. refutation criterion은 넷이다. R1: 선언된 컨텍스트 정책에서 실측 작업당 비용 delta가 T = 1, 4, 8, 16에서 Θ(T²)보다 Θ(T)에 더 잘 맞으면 persistent compounding mechanism은 반증된다. R2: 실측 품질-달러 ranking이 arm B 대 A, D에서 proposition이 예측한 부호와 반대가 되어 2개 이상 워크로드 클래스에서 일어나면 break-even 조건은 반증된다. R3: 과잉 턴 집합이 모든 워크로드 클래스에서 비어 있으면 regime allocation 예측은 반증을 받는다. R4: matched per-turn accuracy에서 NVFP4-27B의 실측 세가 bf16-8B 세 이하이면 α inflation 상호작용은 반증된다.
운영 규칙과 레버의 합성
결정 규칙은 state 고정을 장부로 대체하는 것이다. schema 기반 single tool 턴과 routing은 default compact다. compositional tool call은 내부 budget을 남기고 cost meter가 proposition의 조건으로 워크로드 클래스별 regime을 정한다. routing 클래스에서는 장부가 실측 τ_T를 (q_E/q_C)^k와 비교한다. 임계값 아래면 explicit이 켜진 채로 유지되고 위면 클래스가 compact로 플립된다. T_crit은 그 플립이 permanent가 되는 지평선이다.
effort, format, size, serving 네 레버는 axis가 서로 직교한다. effort는 고정된 state 안에서 subtask별 reasoning 양을 route하고 format은 state 자체의 턴당 가격을 재며 size는 model을 바꾸고 serving은 정밀도와 speculation을 바꾼다. axis가 독립이므로 axis별 break-even은 cost에서 곱셈으로 합성된다. 각 axis를 자기 break-even으로 옮기면 절감이 곱해진다.
compact의 대가는 감시성이다. 짧은 chain은 monitor하기 어렵고 misleading hint도 언급 횟수가 줄어도 답에는 영향을 준다. 운영 대응은 sampled audit path다. traffic의 작은 분율에 explicit CoT를 남기고 audit sample에서 쓴 regime과 budget을 기록한 뒤, audit된 quality를 meter된 세와 대조한다.
carbon으로 번역하면, compounding 세를 줄이는 것은 작업당 재전송 prefill compute를 줄이는 것이다. lemma의 p_in 항이다. 필요 없는 턴의 정확도에 손대지 않고 energy를 줄이는, 학습 없이 돌릴 수 있는 dial이다.
회사에, 사회에, 과학에 남는 것
회사에 남는 것은 장부가 보는 세다. 저희 token factory는 text 토큰에 가격을 매기지만 unattended 에이전트 루프는 매 턴 reasoning을 다시 뿜는다. 27B teacher의 BFCL baseline은 thinking state가 암묵적으로 놓인 채로 잰 것이었다. 이 논문은 repo에 이미 달린 enable_thinking/no_think 손잡이를 measured per-turn verbosity cost와 quality-per-dollar break-even으로 바꾼다. Metis는 이제 H200에서 워크로드 클래스별로 thinking on/off budget을 설정할 수 있고 보이지 않는 compounding 세를 계속 치는 대신 그 세를 보며 budget을 줄인다.
사회에 남는 것은 dial이다. reasoning 토큰은 inference 지출과 에너지의 크고 빠르게 자라는 비중이다. explicit 대 compact frontier를 open weights(Qwen3 가문)와 저희 harness로 재현 가능하게 만들면, 에이전트 AI가 싼 가격대에서 유지된다. tool-call과 routing reliability를 잃지 않으면서 cost와 carbon을 줄이는, 측정된 dial이 운영자에게 남는다.
과학에 남는 것은 첫 compounding 정형화다. BDH-CQ의 latent reasoning 효율 claim이 agentic serving의 per-turn cost-quality frontier로 변환된다. 형식/밀도 축은 effort 축(저희 07-29 Effort-Routing 연구)과 model size 축(distillation)과 직교한다. H200의 멀티턴 에이전트 루프에서 per-turn 과잉세가 어떻게 compounding하는지를 처음 보여 주는 것이 이 논문이다.
못 믿을 부분
실측은 없다. 이 논문은 분석적, 위치지움 논문이다. 모든 결과가 구조적이며 프로토콜이 그 값을 채우기 위해 설계되었고 refutation criterion이 주장의 값어치다.
state 토글은 template-level이다. Qwen3 hybrid thinking 토글은 explicit 대 no-CoT 두 끝단을 바꿀 뿐, trained latent recurrent reasoner, 곧 BDH-CQ 계열을 포함하지 않는다. 두 끝단 사이의 frontier, 그리고 그 사이를 채우는 것은 이 정형화가 여는 open question이다.
cost model은 steady-state를 가정한다. 상감 per-token 가격은 균일 부하를 전제하고 burst 워크로드는 p_in/p_out 구분을 깨뜨린다. 재전송 컨텍스트를 상감하는 prefix caching policy는 재전송 토큰의 effective 입력 가격을 바꾼다. τ₁과 U도 이 값과 함께 바뀐다. p_out > p_in은 셀프호스트 decode/prefill 가격 구조를 반영한다. 이 가격 관계가 반전되면 τ₁의 1차 항은 바뀌지만 lemma의 compounding 구조는 그대로다.
턴별 quality independence도 가정이다. 긴 사슬의 error propagation은 세를 넓힐 수 있을 뿐이다. 전파된 error는 corrective 재호출을 강제하고 재호출은 컨텍스트를 다시 price한다.
벤치마크는 tool calling과 routing을 덮는다. BFCL과 SRA routing bench는 그 두 도메인이다. code, retrieval 같은 다른 agentic 도메인은 critical turn 수 k와 γ가 다를 수 있고 break-even은 도메인별로 다시 도출해야 한다. T_crit을 해석하려면 그 전에 k를 추정해야 한다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Reasoning Verbosity Tax: Per-Turn Cost-Quality Frontiers of Explicit vs. Compact Chain-of-Thought in Self-Hosted Agentic LLMs on H200
이 논문의 모든 곡선은 분석적이며 실측이 아닙니다. 세 장의 그림은 개념 예시와 분석 모델 도식입니다. 실측 값은 4arm 프로토콜이 채우며 refutation criterion R1에서 R4가 실패 조건을 선언합니다.
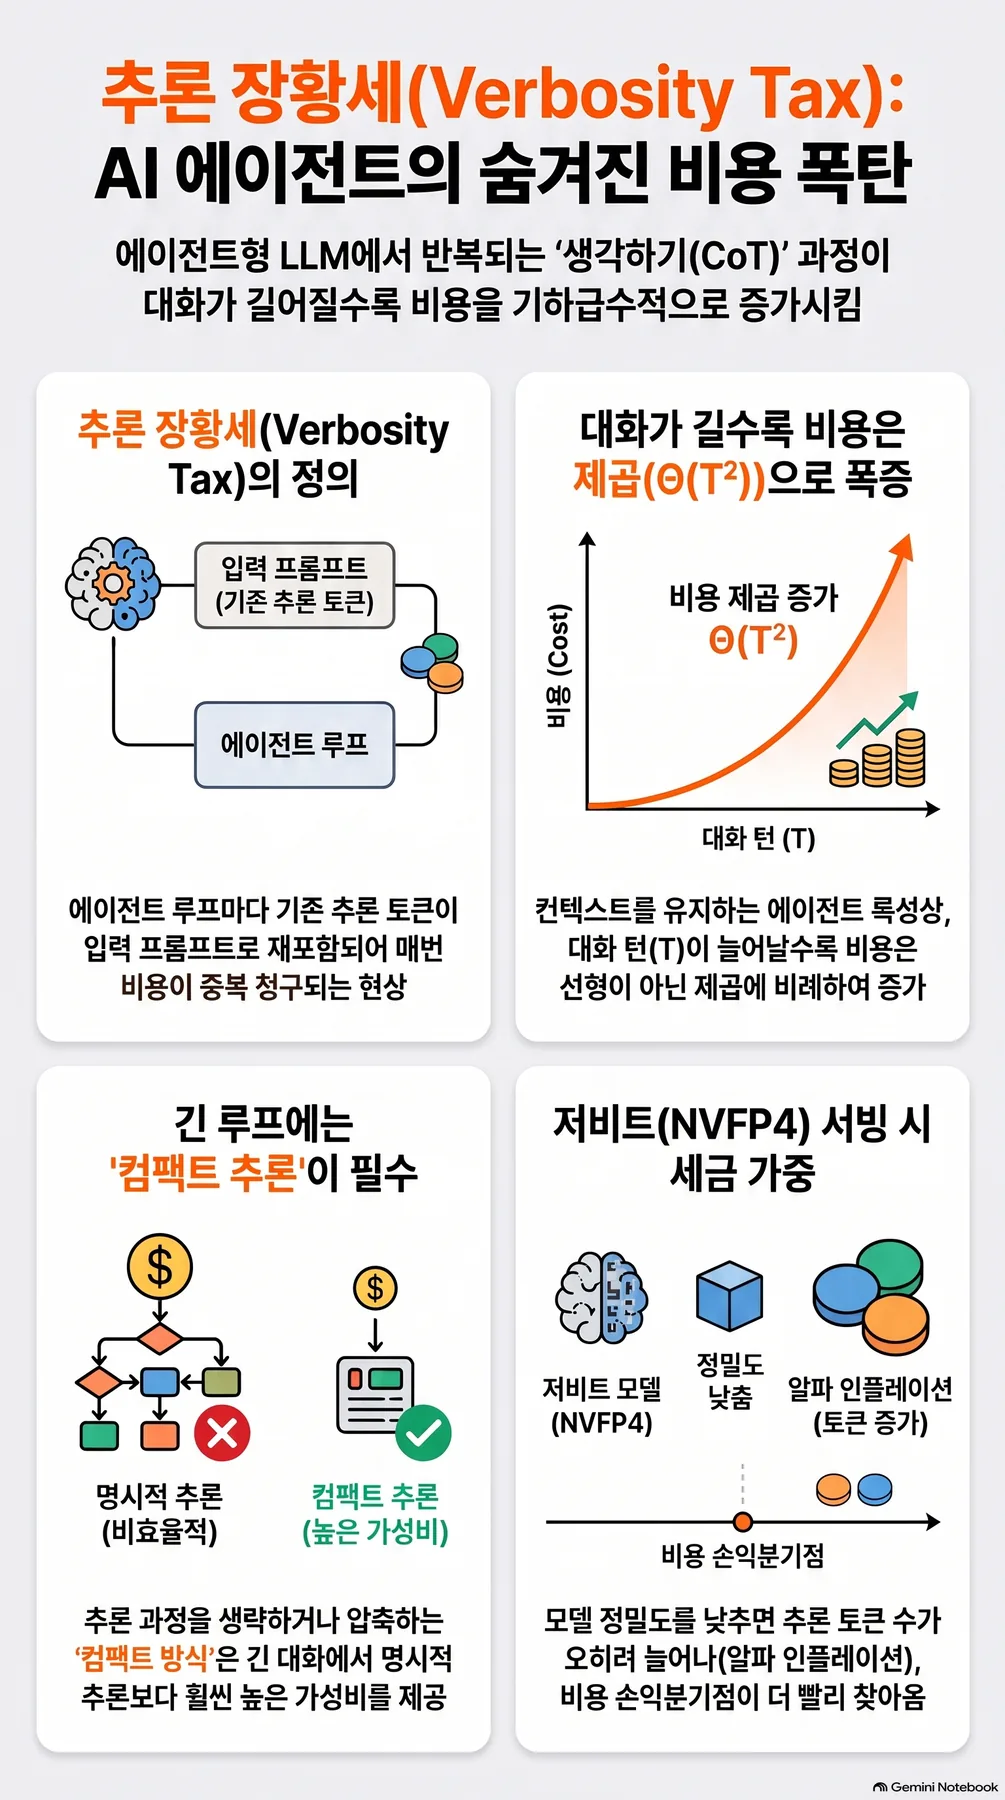 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.