The Router’s Toll: skill-router 파이프라인이 스스로 내는 토큰 통행료를 실측하고, 결정론 precondition gate로 그 bill의 71.6%를 스킵합니다
셀프호스트 H200 위에서 스킬 2,000개가 넘는 에이전트 하네스(에이전트 실행 환경)를 돌리거나, 그 하네스의 밤샘(overnight) 루프에 skill-router를 붙여 둔 국내 클라우드/AI 엔지니어라면 이 글의 대상입니다. 무감시 루프에서는 들어오는 태스크마다 라우터 파이프라인이 지나갑니다. 그런데 이 파이프라인 자체가 에이전트 루프 token의 몇 %를 쓰는지, 라우터가 아껴 주는 것보다 스스로 내는 것이 클 수 있는지에 대해, 라우팅 문헌은 답하지 못했습니다. ThakiCloud의 실측 논문 The Router’s Toll은 이 회계 공백을 메웁니다. 2,293-entry의 production skill registry와 동결된 63-decision holdout 위에서 라우터 파이프라인의 자체 token bill을 arm별로 미터링하고, 그 bill의 대부분을 스킵하면서도 실측 정확도 손실이 0인 결정론 precondition gate(파이프라인을 실행하기 전에 점수만 보고 생략 여부를 정하는 규칙)를 찾습니다. 읽고 나면 자기 하네스에서 라우터를 언제 켤지 근거를 갖고 정할 수 있습니다.
 글의 핵심 개념을 형상화했습니다.
문제의식: 라우터는 ‘무료 classifier’로 취급되어 왔습니다
운영 중인 에이전트 하네스에서는 모든 태스크가 실행에 앞서 하이브리드 skill-router 파이프라인을 지나갑니다. BM25 어휘 점수와 dense embedding 점수를 융합합니다. top-8 후보 윈도우는 LLM rerank prompt에 넘기고, 융합 top-1이 production threshold 6.0 아래로 떨어지면 gate-fail reroute prompt를 내보냅니다. 마지막으로 스킬 manifest k=8개를 execution context에 prefill로 주입합니다. 이 라우터는 관행적으로 무료 classifier로 취급되어 왔습니다. 하네스의 자체 cost audit는 execution turn의 가격을 매기고 라우팅 문헌은 라우팅이 아껴 주는 것, 즉 더 싼 모델과 줄어든 escalation과 더 나은 스킬 hit의 가격을 매겨 왔습니다. 파이프라인 자신의 token bill은 가정으로 처리되어 왔습니다.
그런데 모든 라우팅 결정은 라우터 자신을 위해 token을 냅니다. top-8 윈도우에 대한 rerank prompt는 결정마다 보내집니다. 6.0 gate가 top-1을 거절할 때마다 gate-fail reroute prompt가 보내집니다. 주입 manifest prefill은 스킬 이름과 설명을 최대 여덟 개까지 execution context에 다시 씁니다. 이 비용은 결정마다, 세션마다, 밤새, 그 라우팅 결정이 그 밤에 유용했든 하지 않았든 납부됩니다. 이 논문은 이 상시 bill을 라우터의 통행료(the router’s toll)라고 부르고, 그것을 재는 새 측정 축을 도입합니다. routing overhead share, t/(t+B)입니다. t는 라우터 파이프라인 token, B는 태스크 side baseline입니다.
논문은 세 가지를 묻습니다. 파이프라인이 end-to-end 루프 token의 몇 %를 스테이지별로, 결정당으로, 세션당으로 쓰는지(RQ1). 결정당 overhead가 어느 수준에서 라우팅이 순절약이 아니라 순비용이 되는지, 선언된 miss 가격 rate card 기준의 break-even 정확도 lift가 얼마인지(RQ2). 그리고 회수 자체의 점수 통계, 즉 BM25 top-1 임계와 top1-top2 margin으로 짠 값싼 결정론 precondition gate가 실측된 결정의 일부에서 비싼 파이프라인을 스킵하면서 동결 holdout 위에서 degradation 0을 지킬 수 있는지(RQ3)입니다. 세 번째 질문에 긍정 답이 나오면, 라우팅은 항상 켜 두는 비용에서 필요할 때만 켜고 사용량을 재는 duty-cycled, metered 비용으로 바뀝니다.
설계: 4개 arm과 동결 holdout, 결정론 token bill
측정 대상은 production skill index입니다. analyzer v5 기준 2,293-entry이며 그중 skill-kind가 2,193개입니다. 제목의 2,200-skill은 이 skill-kind를 가리킵니다. 나머지 entry는 skill-global 27, skill-agents 22, plugin-skill 187, rule 90, fin-agent 10으로 채워집니다. 제목의 셀프호스트 H200은 production 서빙 플릿을 가리킵니다. billing은 하드웨어와 무관한 결정론 token count이므로 실제 측정은 CPU development node에서 수행했습니다.
모든 bill은 Qwen3-0.6B tokenizer로 계산합니다. 이 tokenizer는 이 하네스가 선언한 serving family의 것입니다. 하네스가 각 스테이지에서 실제로 보내는 exact prompt 위에서 세 부분을 셉니다. LLM rerank prompt(top-8 후보 윈도우, instruction과 task text와 8개 후보의 이름과 설명), 6.0 gate가 top-1을 거절할 때만 보내는 gate-fail reroute prompt, 그리고 실제 주입된 entry의 이름과 설명 token인 k=8 injection manifest prefill입니다. LLM output cap은 rerank 답변 64 token, reroute 답변 64 token으로 선언되어 있습니다.
4개 arm(비교 구성)이 bill을 정의합니다. off는 routing token을 내지 않습니다. lite는 BM25 회수와 k=8 injection prefill만 내고 LLM 호출은 없습니다. full은 lite에 LLM rerank prompt와 gate failure 때의 reroute prompt를 더합니다. gated는 결정마다 결정론 precondition gate를 적용합니다. 후보 풀 scale R의 top-1 BM25 점수가 6.0 production gate 아래이거나 top-1이 τ 이상이고 top1-top2 margin이 margin param 이상이면 LLM 파이프라인을 스킵하고 lite bill만 냅니다. 그 외에는 full bill을 냅니다. gate 자체는 lite path가 이미 수행한 BM25 회수 외에 아무것도 소비하지 않습니다.
동결 holdout은 63개 라우팅 결정입니다. positive 45(스킬이 회수되어야 하는 경우), native 10(적합한 스킬이 없고 하네스가 스킬 없이 답해야 하는 경우), negative 8(스킬을 사용해서는 안 되는 경우)로 이루어집니다. holdout은 어떤 sweep도 실행하기 전에 동결했고 어떤 구성도 그것에 맞게 tune하지 않았습니다. 태스크 side baseline은 production day 하루(2026-10-22)의 main session 46개에서 measured했습니다. median turn 314,604 token, median session 1,811,354 token, 세션당 라우팅 결정 6개입니다.
가격은 declared 규약입니다. self-hosted serving은 input 1.50 달러, output 0.60 달러 per million token이고 miss 가격 rate card는 회피된 라우팅 miss 1개당 0.50 달러입니다. 하네스의 내부 벤치마크가 쓰는 것과 같은 카드입니다. 논문은 모든 수량에 measured, declared, cited 중 하나의 라벨을 붙입니다. measured는 모든 token bill과 overhead share와 skip share와 skip-set 정확도와 BM25 latency이다. declared는 서빙 rate와 miss 가격 card와 LLM output cap이다. cited는 2026-08-14 측정한 hybrid-versus-BM25 정확도 lift이다. protocol과 사전 등록 기준과 이 라벨은 sweep 실행 전에 고정했습니다.
톨의 실측: full 파이프라인이 결정당 1,440.3 token, LLM 쪽이 71.6%
production registry scale(R=2,293, n=63 동결 holdout)에서 비용을 내는 3개 arm의 결정당 bill은 다음과 같습니다. off는 구조상 아무것도 내지 않습니다. lite는 결정당 평균 409.6 token(median 451, max 810)을 내고 declared rate 기준 0.000614357 달러입니다. median turn의 0.13002%, 세션당 0.13548%에 해당합니다. full은 결정당 평균 1,440.3 token(median 1,443, max 2,314)을 내고 0.002090124 달러, median turn의 0.45574%, 세션당 0.47484%입니다. full 파이프라인은 lite path의 평균 bill의 3.52배를 냅니다. 결정당 1,030.7 token을 추가로 내며 그 중 952.6가 input, 78.2가 declared output이다.
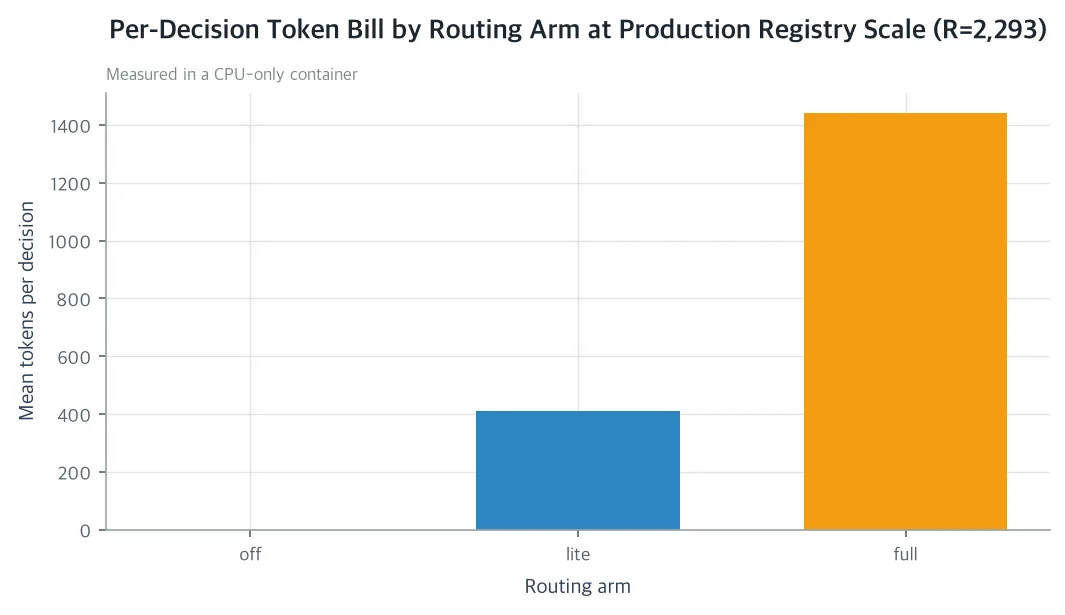 off, lite, full 세 arm의 결정당 평균 token bill(R=2,293, n=63 동결 holdout). full hybrid 파이프라인이 BM25-only lite path의 3.52배(1,440.3 대 409.6 token)를 냅니다. CPU-only container에서 measured한 값입니다.
full arm의 bill을 스테이지별로 분해하면, 라우터의 통행료가 어디에 쓰이는지 보입니다. rerank prompt(top-8 윈도우)가 가장 큰 단일 스테이지입니다. 평균 776.2 token(median 759, max 1,206)입니다. gate-fail reroute prompt는 63개 결정 중 14개(22.2%)에서만 발화하며 평균 176.3 token, median 0입니다. 나머지 49개 결정은 이 prompt를 보내지 않기 때문입니다. 발화하면 max 1,112까지 갑니다. k=8 injection manifest prefill은 구조상 lite arm과 동일합니다. 평균 409.6 token(median 451, max 810)입니다. declared LLM output은 rerank 답변 64 token, reroute 답변 64 token cap으로 billing되며 reroute cap은 14개 gate-fail 결정에서만 붙습니다. 그래서 output stage의 mean은 78.2 token(median 64, max 128)입니다. 파이프라인의 LLM 쪽, 즉 rerank와 reroute prompt 그리고 output은 full arm의 평균 1,440.3 token bill의 1,030.7 token, 71.6%를 차지합니다. 라우터의 통행료는 대부분 LLM 호출에 쓰입니다.
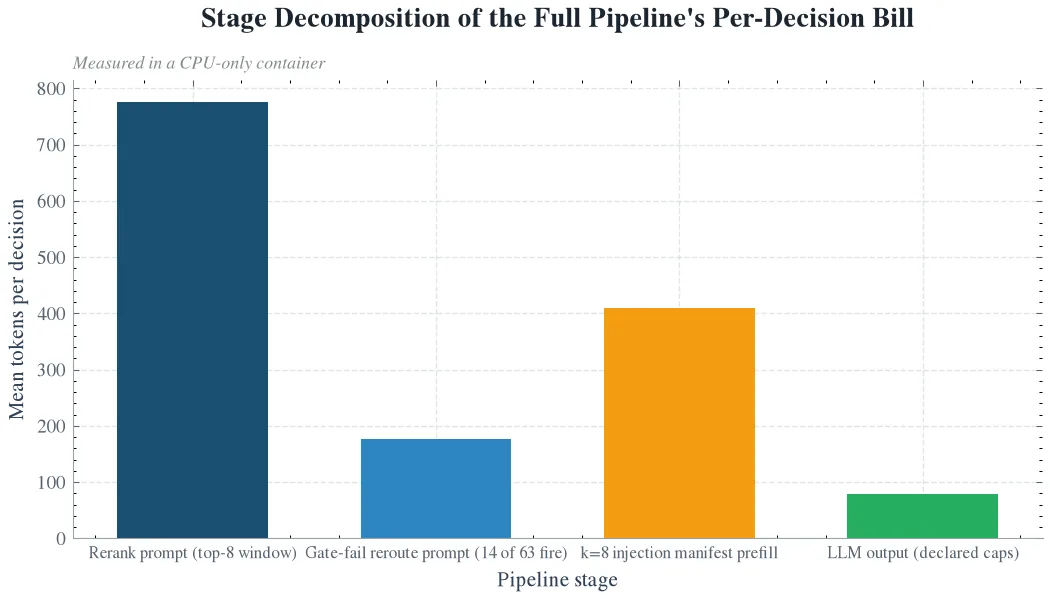 full arm의 스테이지별 평균 token 수. LLM 쪽(rerank prompt, gate-fail reroute prompt, declared output)이 1,440.3 token bill의 1,030.7 token, 71.6%를 차지합니다. CPU-only container에서 measured한 값입니다.
이 톨은 결정당 0.5% 미만입니다. full arm 0.45574%, lite 0.13002%입니다. 하지만 항상 부과되는 비용(always-on levy)입니다. 63개 결정 전부에, 세션당 약 6개씩, 밤샘 세션마다, 그 라우팅 결정이 그 밤에 유용했든 하지 않았든 납부됩니다. declared rate의 달러로 보면 arm 간 차이는 결정당 0.00209 달러 대 0.00061 달러입니다. 파이프라인의 결정론 부분은 wall-clock에서도 가볍습니다. 모든 arm(off 제외)이 의존하는 BM25 회수는 development node에서 평균 18.466 ms, max 98.696 ms입니다.
break-even: 톨이 정당해지는 최소 정확도 lift는 0.30%
RQ2는 순비용 임계점을 묻습니다. full-minus-lite의 추가 bill은 declared rate 기준 결정당 0.001475767 달러입니다. 선언된 miss 가격 rate card(회피된 miss 1개당 0.50 달러) 기준으로 full 파이프라인의 라우팅이 순이익이 되는 것은 정확도 lift가 결정의 최소 0.001475767/0.50, 즉 0.295%, 약 0.30%를 만들어 낼 때뿐입니다.
2026-08-14 측정한 인용 measured hybrid-over-BM25 lift는 Recall@5(40.0에서 48.9)와 top-1(17.8에서 26.7) 양쪽 모두 8.9 percentage points입니다. 6.0 gate가 적용되면 인용 gated Recall@5는 66.7에서 77.8로 움직입니다. 인용 lift는 break-even 임계의 약 30배입니다. measured bill과 declared card에서, 톨은 LLM 쪽이 인용 lift를 실제로 만들어 줄 때 정당화됩니다. 그렇지 않을 때를 위한 실측 zero-loss fallback이 바로 다음 섹션의 gate입니다.
민감도 분석도 함께 둡니다. full arm은 true lift가 결정당 0.30% 아래로 떨어지면 이 workload에서 순비용이 되고, declared rate가 두 배라고 가정하면 0.59% 아래에서 순비용이 됩니다. 인용 8.9pp lift는 두 임계 모두를 크게 상회합니다.
precondition gate: 30-config sweep에서 zero-loss 6개, production scale 71.6% 스킵
gate는 회수의 자체 점수 통계에 대한 결정론 precondition입니다. lite path가 이미 수행한 BM25 회수(development node에서 평균 18.466 ms) 외에 아무것도 소비하지 않고 자신의 token은 보내지 않습니다. gate의 유일한 결정은 어느 파이프라인이 비용을 내는지입니다. top-1 점수가 6.0 production gate 아래이거나 top-1이 τ 이상이고 top1-top2 margin이 margin param 이상이면 LLM 파이프라인을 스킵하고 lite bill만 냅니다. 그 외에는 full bill을 냅니다.
sweep(구성을 체계적으로 바꿔 가며 측정하는 실험)은 사전 등록된 30-config factorial입니다. registry scale R(128, 256, 512, 1,024, 2,293; production index를 고정 seed로 R-entry에 subsample)에 top-1 threshold τ(6.0, 8.0, 10.0)와 top1-top2 margin(0.0, 2.0)을 곱해 30개를 만듭니다. 구성이 zero-degradation-safe로 선언되려면, 동결 holdout 위에서 skip-set의 lite 정확도 지표(Recall@5, gated Recall@5, top-1)가 corpus-wide lite baseline을 양(+)으로 넘지 않아야 하고 skip set이 corpus rate를 넘는 새로운 native hallucination을 도입하지 않아야 합니다. 63개 case에서 나온 패턴은 보증이 아니므로 이 기준은 의도적으로 보수적으로 잡았습니다. safe 구성 중에서는 skip share가 가장 큰 구성을 고릅니다. 이 기준은 사전 등록되었습니다.
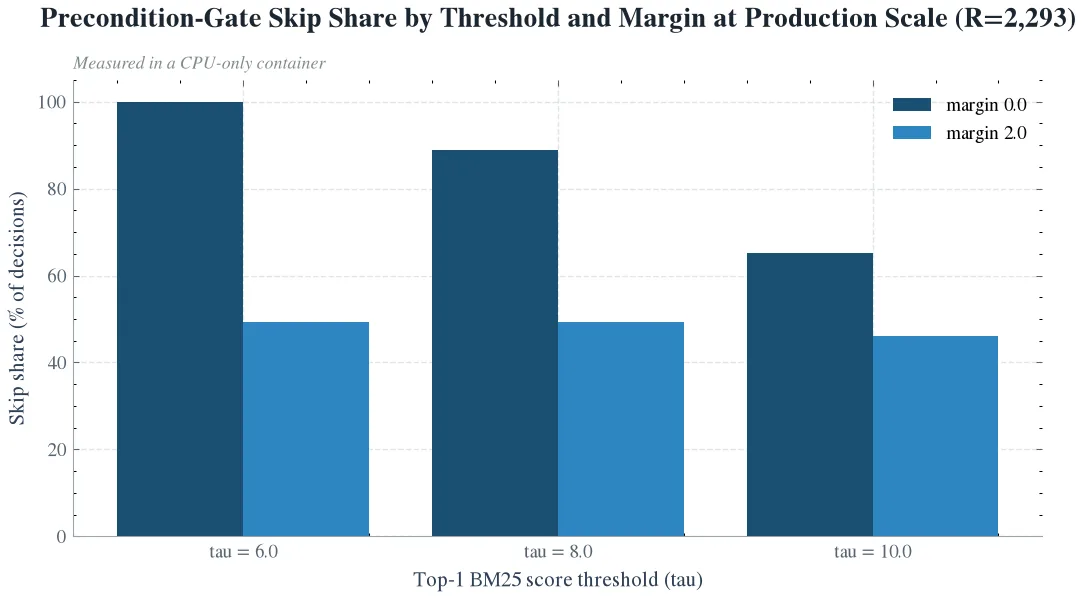 top-1 threshold(τ)와 top1-top2 margin별 skip share(R=2,293). τ=6.0/margin-0.0 구성이 holdout 100%를 스킵하며 bill reduction 71.6%, 실측 정확도 손실 0입니다. CPU-only container에서 measured한 값입니다.
production scale(R=2,293)의 6개 구성에서 두 가지 특징이 눈에 띕니다. 첫째, margin param은 모든 구성에서 skip share를 줄입니다. R=2,293에서 margin 2.0은 τ=6.0, 8.0, 10.0에서 skip share를 각각 50.8, 39.7, 19.1 percentage points 깎아냅니다. 100.0%에서 49.2%로, 88.9%에서 49.2%로, 65.1%에서 46.0%로 줄어든 셈입니다. 15개 (τ, R) 쌍 전체에서 margin-2.0 share는 margin-0.0 share보다 엄격히 아래에 있습니다(1.6에서 50.8 percentage points). safe인 τ=8.0/margin-0.0 구성조차 88.9%를 스킵합니다.
둘째, degradation triple을 봅니다. skip set의 lite 정확도에서 corpus-wide lite baseline(R=2,293에서 80.0, 73.3, 48.9)을 뺀 값입니다. τ=6.0/margin-0.0 row에서 정확히 0이고 τ=8.0/margin-0.0 row에서 0 이하(0.0, -0.8, -3.9)입니다. 반면 모든 margin-2.0 row와 τ=10.0/margin-0.0 row는 corpus보다 양(+)으로 위에 놓여 있습니다. top-1에서 최대 +17.8pp에 이릅니다.
사전 등록 기준으로 30개 구성 중 정확히 6개만 zero-degradation-safe입니다. 5개는 τ=6.0/margin-0.0 family, R(128, 256, 512, 1,024, 2,293)입니다. 각각 holdout의 100%를 스킵하고 bill savings는 95.7%, 91.2%, 85.9%, 80.6%, 71.6%입니다. 결정당 overhead share는 0.01801%에서 0.13002% 사이입니다. skip set은 corpus-wide lite baseline과 정확히 일치하며 3개 degradation 모두 0.0입니다. 여섯 번째는 R=2,293/τ=8.0/margin-0.0 row입니다. 88.9% 스킵, 64.5% saving, degradation(0.0, -0.8, -3.9)입니다. skip set이 모든 지표에서 corpus보다 같거나 아래에 놓여 있습니다. gate가 top-1이 6.0 production gate 아래인 empty-manifest 결정도 스킵하기 때문입니다.
사전 등록 규칙(가장 큰 skip share)에서 best safe 구성은 τ=6.0/margin-0.0 family입니다. 다섯 구성이 100% 스킵으로 동률이고 sweep의 ascending-R 평가 순서에서 보고되는 best는 R=128 arm입니다. 이것은 family ceiling이기도 합니다. 95.7% saving, 결정당 평균 56.7 token(median 0), overhead 0.01801%입니다. effective pool이 128-entry 이하인 scope-filtered deployment가 벌 수 있는 상한을 보여 줍니다. production scale R=2,293에서 같은 family는 동결 holdout의 100%를 스킵하고 bill reduction 71.6%에 실측 정확도 손실 0입니다.
margin-2.0과 높은 τ 구성은 high-confidence subset만 스킵하므로, skip set은 체계적으로 corpus lite baseline 위에 있습니다. R=2,293/τ=6.0/margin-2.0에서 skip-set top-1은 66.7, corpus는 48.9, +17.8pp입니다. 사전 등록의 보수적 규칙이 정확히 이것을 safe set에서 제외합니다. 63-case 동결 holdout에서, 쉬운 case만 스킵하는 gate는 corpus보다 잘 보일 수밖에 없고 그 패턴은 selection이지 guarantee가 아니기 때문입니다. production monitoring이 lift를 확인해 주면 이들도 타당한 operating point입니다. distribution-free 대안은 conformal deferral이고 결정당 cost/accuracy 로그는 자연스러운 monitoring substrate입니다.
gate의 주장에는 세 가지 경계가 있습니다. 첫째, gate는 quality gate가 아닙니다. 어느 스킬이 맞는지 결정하는 것이 아니라 어느 파이프라인이 비용을 내는지 결정합니다. 둘째, gate는 must-not-use 결정도 스킵합니다. τ=6.0/margin-0.0에서는 negative case 8개가 전부 skip set 안에 있고 거부는 injection의 6.0 production gate가 처리하며 skip gate가 아닙니다. 셋째, measured claim은 동결 holdout 위에서 lite baseline 대비 zero degradation으로 엄격히 한정됩니다. corpus-level이지 distribution-free가 아닙니다. 그리고 gate의 전 비용은 BM25 회수 한 번입니다.
이 결과가 남기는 것
회사 관점에서, 이 논문은 2,200개 이상 스킬 하네스와 밤샘 루프에서 라우터 파이프라인의 실제 token 부담을 처음 실측합니다. 조건부 라우팅, 즉 duty-cycle 정책을 근거 기반으로 결정 가능하게 합니다. token factory의 운영비용에 직접 반영됩니다. 라우팅은 더 이상 항상 켜져 있는 항목이 아니라 결정당 0.13002%(production scale, 실측 손실 0)로 metered 되는 항목이 됩니다. 세션당 6개 결정을 처리하는 무감시 overnight 운영에서, full arm은 세션당 약 0.0125 달러를 라우팅에 쓰지만 safe gate 아래에서는 약 0.0037 달러입니다. 작은 숫자지만 플릿 전체에서 밤마다 쌓입니다.
사회적으로는, 라우팅을 실측 가능한 비용 항목으로 바꿉니다. 제한된 셀프호스트 H200 예산에서도 자율 에이전트를 운영하기가 한결 쉬워질 수 있습니다. 라우터는 상시 세금이 아니라 필요할 때만 켜고 사용량을 재는 비용이 됩니다.
과학적으로는, routing overhead share라는 새 측정 축을 제시합니다. 라우터 파이프라인의 첫 비용 회계와, precondition-gate 스킵의 실증 안전 경계를 기록합니다. 지난 한 달의 라우터 논문은 전부 라우터가 얼마를 아끼는지를 측정했지만, 라우터 파이프라인 자체가 회수와 리랭크와 리라우팅 호출로 에이전트 루프 총 token의 몇 %를 쓰지는 측정한 적이 없었습니다. 이 논문은 그 회계 공백을 메웁니다. 이전 Thinking Router 연구가 라우터가 실행된다고 가정하고 얼마나 think하게 줄지를 답했다면, 이 논문은 라우터가 아예 실행될지를 답합니다. 두 결과는 합쳐집니다. gate가 실행 집합의 measure를 정하고, Thinking Router의 flip condition과 water level은 스킵되지 않는 집합 안에서 계속 적용됩니다.
한계: 이 논문이 주장하지 않는 것
한계는 여섯 개입니다. 첫째, hybrid lift는 2026-08-14 측정을 인용한 것이고 이 연구에서 재측정되지 않았습니다. break-even verdict은 그 staleness를 물려받습니다. 둘째, 서빙 rate와 miss 가격 card는 declared 규약입니다. 달러 결과는 그것들과 함께 움직입니다. 셋째, holdout은 단일 production corpus의 63개 결정입니다. gate의 안전 경계는 corpus-level이지 distribution-free가 아닙니다. 다른 corpus라면 safe set이 움직일 수 있습니다. 넷째, bill은 결정론 token count, 즉 hardware-independent이지만, latency 수치는 development node에서 잰 것이지 serving 플릿에서 잰 것이 아닙니다. 다섯째, 태스크 side baseline(median turn, session)은 단일 production day(2026-10-22)의 것입니다. overhead share는 day-selection variance를 물려받습니다. 여섯째, bill은 declared Qwen3-family tokenizer로 세었습니다. serving model의 실제 tokenizer count와 다를 수 있습니다.
열려 있는 후속 작업은 네 가지입니다. conformal prediction 정신의 distribution-free gate 보증, 결정당 로그에서 τ와 margin의 online calibration, 세션별 적응 duty cycle, gate된 duty cycle의 energy-cost twin 실측입니다.
본문의 token bill과 overhead share, skip share는 CPU-only container에서 measured한 값입니다. 서빙 rate와 miss 가격 card는 declared 규약이며 hybrid-versus-BM25 lift는 2026-08-14 측정을 인용한 것입니다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있습니다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-23-router-toll-overhead-share-gate

