The Composite Cost: 복합 작업은 5건 중 1건인데, top-1 점수는 25포인트를 부풀립니다. 2,283개 스킬 인덱스의 원샷 폭과 반복 재라우팅을 가격화했습니다
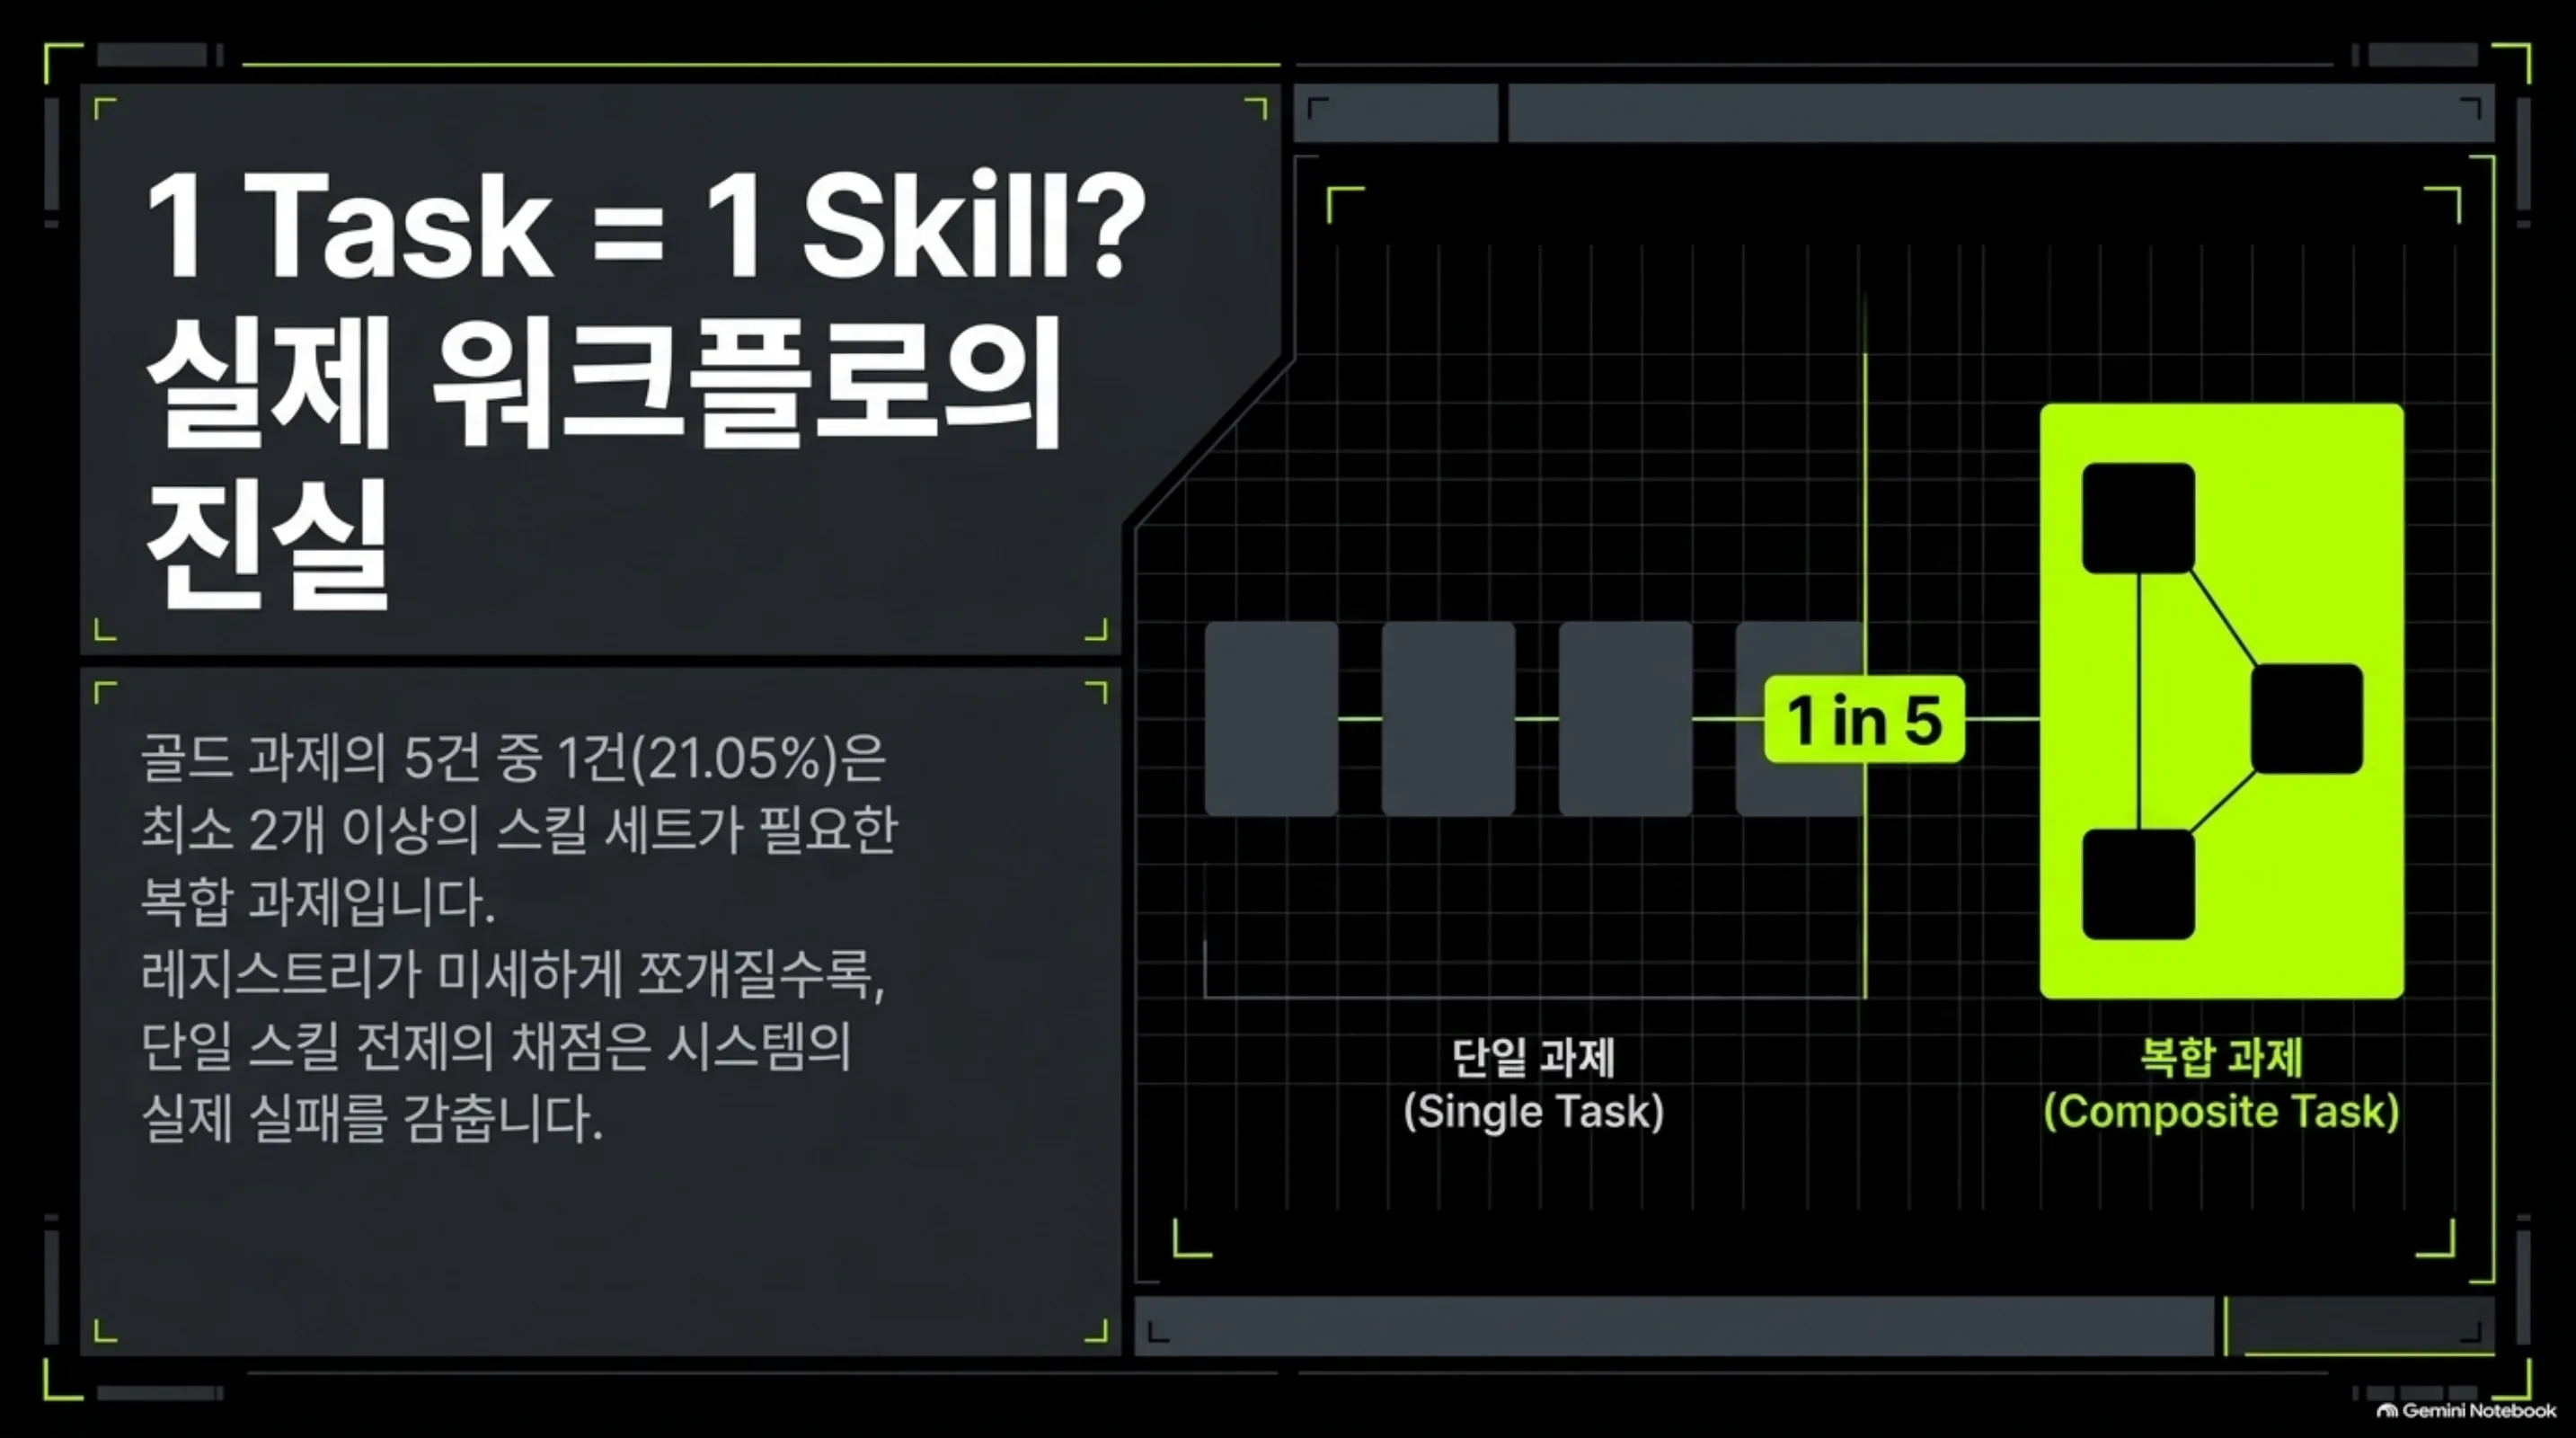
지금 쓰고 있는 스킬 라우터의 점수를, top-1이 맞는지 틀렸는지가 아니라 ‘그 작업에 필요한 스킬 세트를 다 가져왔는가’로 채점하면 어떨까. 이 글은 그 질문을 2,283개 스킬의 실전 인덱스에서 숫자로 쉰 ThakiCloud 연구팀의 논문 The Composite Cost(복합 비용)를 소개하는 것이다. 2,000개 안팎의 스킬 레지스트리를 둔 무감시 에이전트 루프를 돌리거나, 그 라우팅 단계의 정확도와 토큰 지출을 책임지는 클라우드/AI 엔지니어라면 라우터를 바꾸기 전에 읽어 두어야 합니다. 결론은 두 줄입니다. 한 줄째, 스킬 두 개 이상이 한 세트로 필요인 복합 과제는 골드 과제의 5건 중 1건꼴인데, 단일-gold top-1 채점은 그 과제에서 25% 적중을 보고하면서도 세트 완성은 0%입니다. 같은 k=1 예산에서 25포인트를 부풀리는 셈입니다. 두 줄째, ‘몇 번에 걸쳐’가 아니라 ‘얼마나 넓게’가 품질을 정합니다. 원샷 top-k는 k=8에서 무릎을 만드는데, 라우팅→실행→재라우팅 루프는 2.19배 호출을 물고 top-1 품질에 머밋습니다.
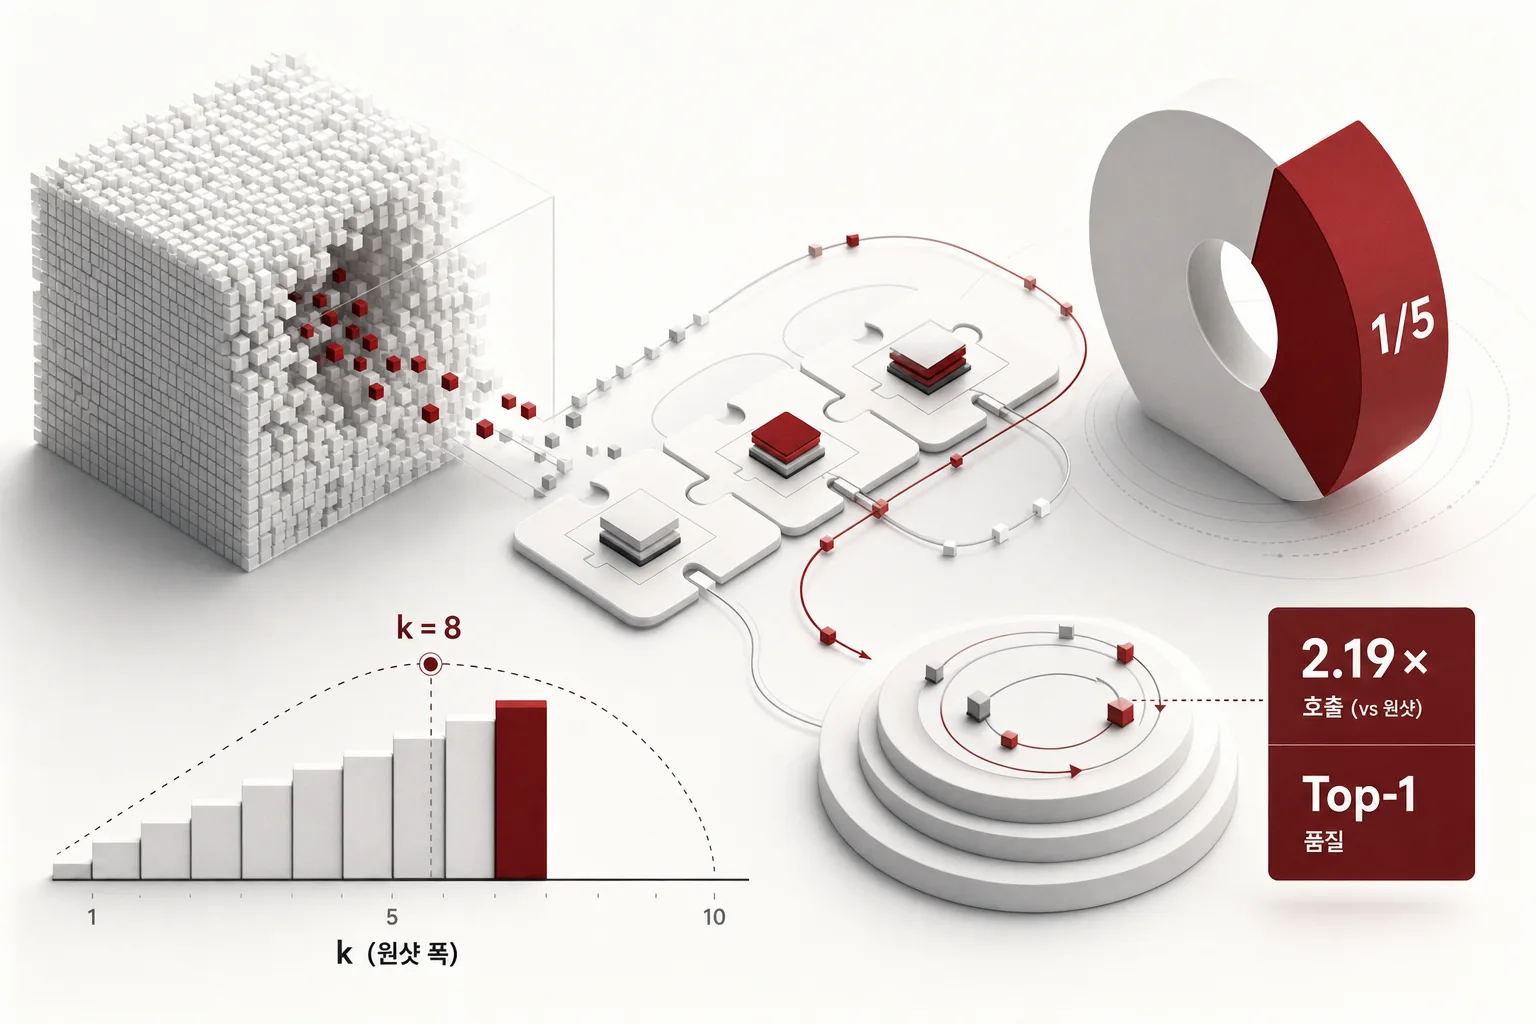 글의 핵심 개념을 형상화했습니다.
“스킬 한 장”이 전제였던 채점, 가늘어지는 레지스트리
무감시 에이전트 하레스에서 라우팅은 핫패스입니다. 요청이 들어오면 이름과 짧은 설명으로 된 스킬 인덱스 전체를 검색하고 점수 게이트를 넘은 스킬만 실행 컨텍스트에 주입하며 주입된 것이 곧 실행되는 것입니다. 스킬 코퍼스가 컨텍스트 윈도우보다 커서 매 요청마다 검색기가 이 길 위에 앉을 수밖에 없고 다시 물어볼 사람이 없는 무감시 루프에서는 이 라우팅 결정이 품질 게이트 전체입니다.
그 검색기를 어떻게 채점해 왔는지가 문제의식입니다. 지금까지, 저희를 포함해, 모든 라우팅 평가는 ‘과제 하나, 골드 스킬 하나, 정확도 숫자 하나’의 단일 스킬 측정입니다. 저희 이전 측정들이 이 하레스 계열에서 단일 스킬 top-1 검색을 33~53%에 놓고, 그 사이 라우터의 모델 쪽(양자화, 크로스 티어 투표, 제로 토큰 3-arm 경제학)을 차례로 가격화했습니다. 8월 말 The Multi-Skill Gap(멀티스킬 갭)은 같은 인덱스에서 2~4 스킬 체인을 재서, 순서까지 맞는 계획은 거의 나오지 않는다고 보고했습니다.
그런데 레지스트리는 그 사이 가늘어졌습니다. 자동 큐레이션 스윕이 거대 스킬을 인접한 특화 스킬로 쪼개는 동안, 한 작업에 진정 두 개 이상의 스킬이 필요한 비중이 올라가는 것입니다. 2,275개이던 인덱스가 2,283개로 늘어나는 사이 구성이 바뀌었는데, 채점 기준은 여전히 ‘첫 번째 골드 스킬이 1순위인가’로 남아 있었습니다. 미가격화였던 것은 두 개입니다. 첫째, 복합 작업의 유병률입니다. 실제로 라우팅되는 작업 중 몇 %가 스킬 두 개 이상을 요구하는가. 둘째, 라우팅 전략 자체입니다. 한 번에 넓게 검색하는 원샷 스킬셋 라우팅과, 라우팅→실행→재라우팅을 반복하는 루프 중 어느 쪽이 스킬 풀 세트를 더 싸게 가져오는가.
이 논문은 그 둘을 같은 하레스, 같은 레지스트리 계열, 같은 게이트 위에서 The Multi-Skill Gap의 한 단계 업그레이드로 셉니다. 결정 대상이 ‘어떤 모델이 체인을 조립할 것인가’에서 ‘풀 세트를 가져오는 데 라우터 호출을 몇 번, 얼마나 넓게 쓸 것인가’로 바뀌고 지표가 순서 민감한 체인 정확도에서 스킬 세트 리콜로 바뀝니다.
복합 작업은 5건 중 1건, 라우터의 게이트 신호는 10건 중 9건
시험판은 플릿의 실제 워크플로에서 만든 75개 작업, 4개 실험 군입니다. 단일 골드 45개(요청 1, 골드 스킬 1), 복합 골드 12개(요청 1, 순서 있는 골드 세트 2~5개, 평균 2.92, 총 35개 골드 자리), 스킬 불필요 10개(아무 주입도 위양성인 환각 군), 금지 스킬 8개(설명에 섞여 있는 세부 쌍 중 쓰면 안 되는 스킬이 명명된 회피 군)입니다. 복합 골드는 구성상 결정론적 정답입니다. 정답 여부는 인덱스 스냅샷 대조로만 판정되므로 채점에는 사람의 주관이 없습니다. 57개 골드 중 6개가 스냅샷 시점에 인덱스에 없는 이름을 참조해, 세트 지표는 51개 골드-사용 가능 과제(단일 42, 복합 9)로 나누어 계산합니다.
라우터는 프로덕션 그대로의 식용 단계입니다. 이름-설명 연결 필드 위의 순수 BM25(이름 가중 필드 스코어링, 클램프 IDF, 한글/CJK 바이그램 할인, 한글→영어 동의어 확장, 이름별 중복 제거)에 라이브 루프가 매 요청에서 쓰는 6.0 주입 게이트를 씌웠고 dense re-ranking은 의도적으로 꺼져 있습니다. 모델 축은 이전 논문에서 가격화되었으므로, 이번 비교는 LLM-자유이고 결정론적이며 환경에 의존하지 않습니다.
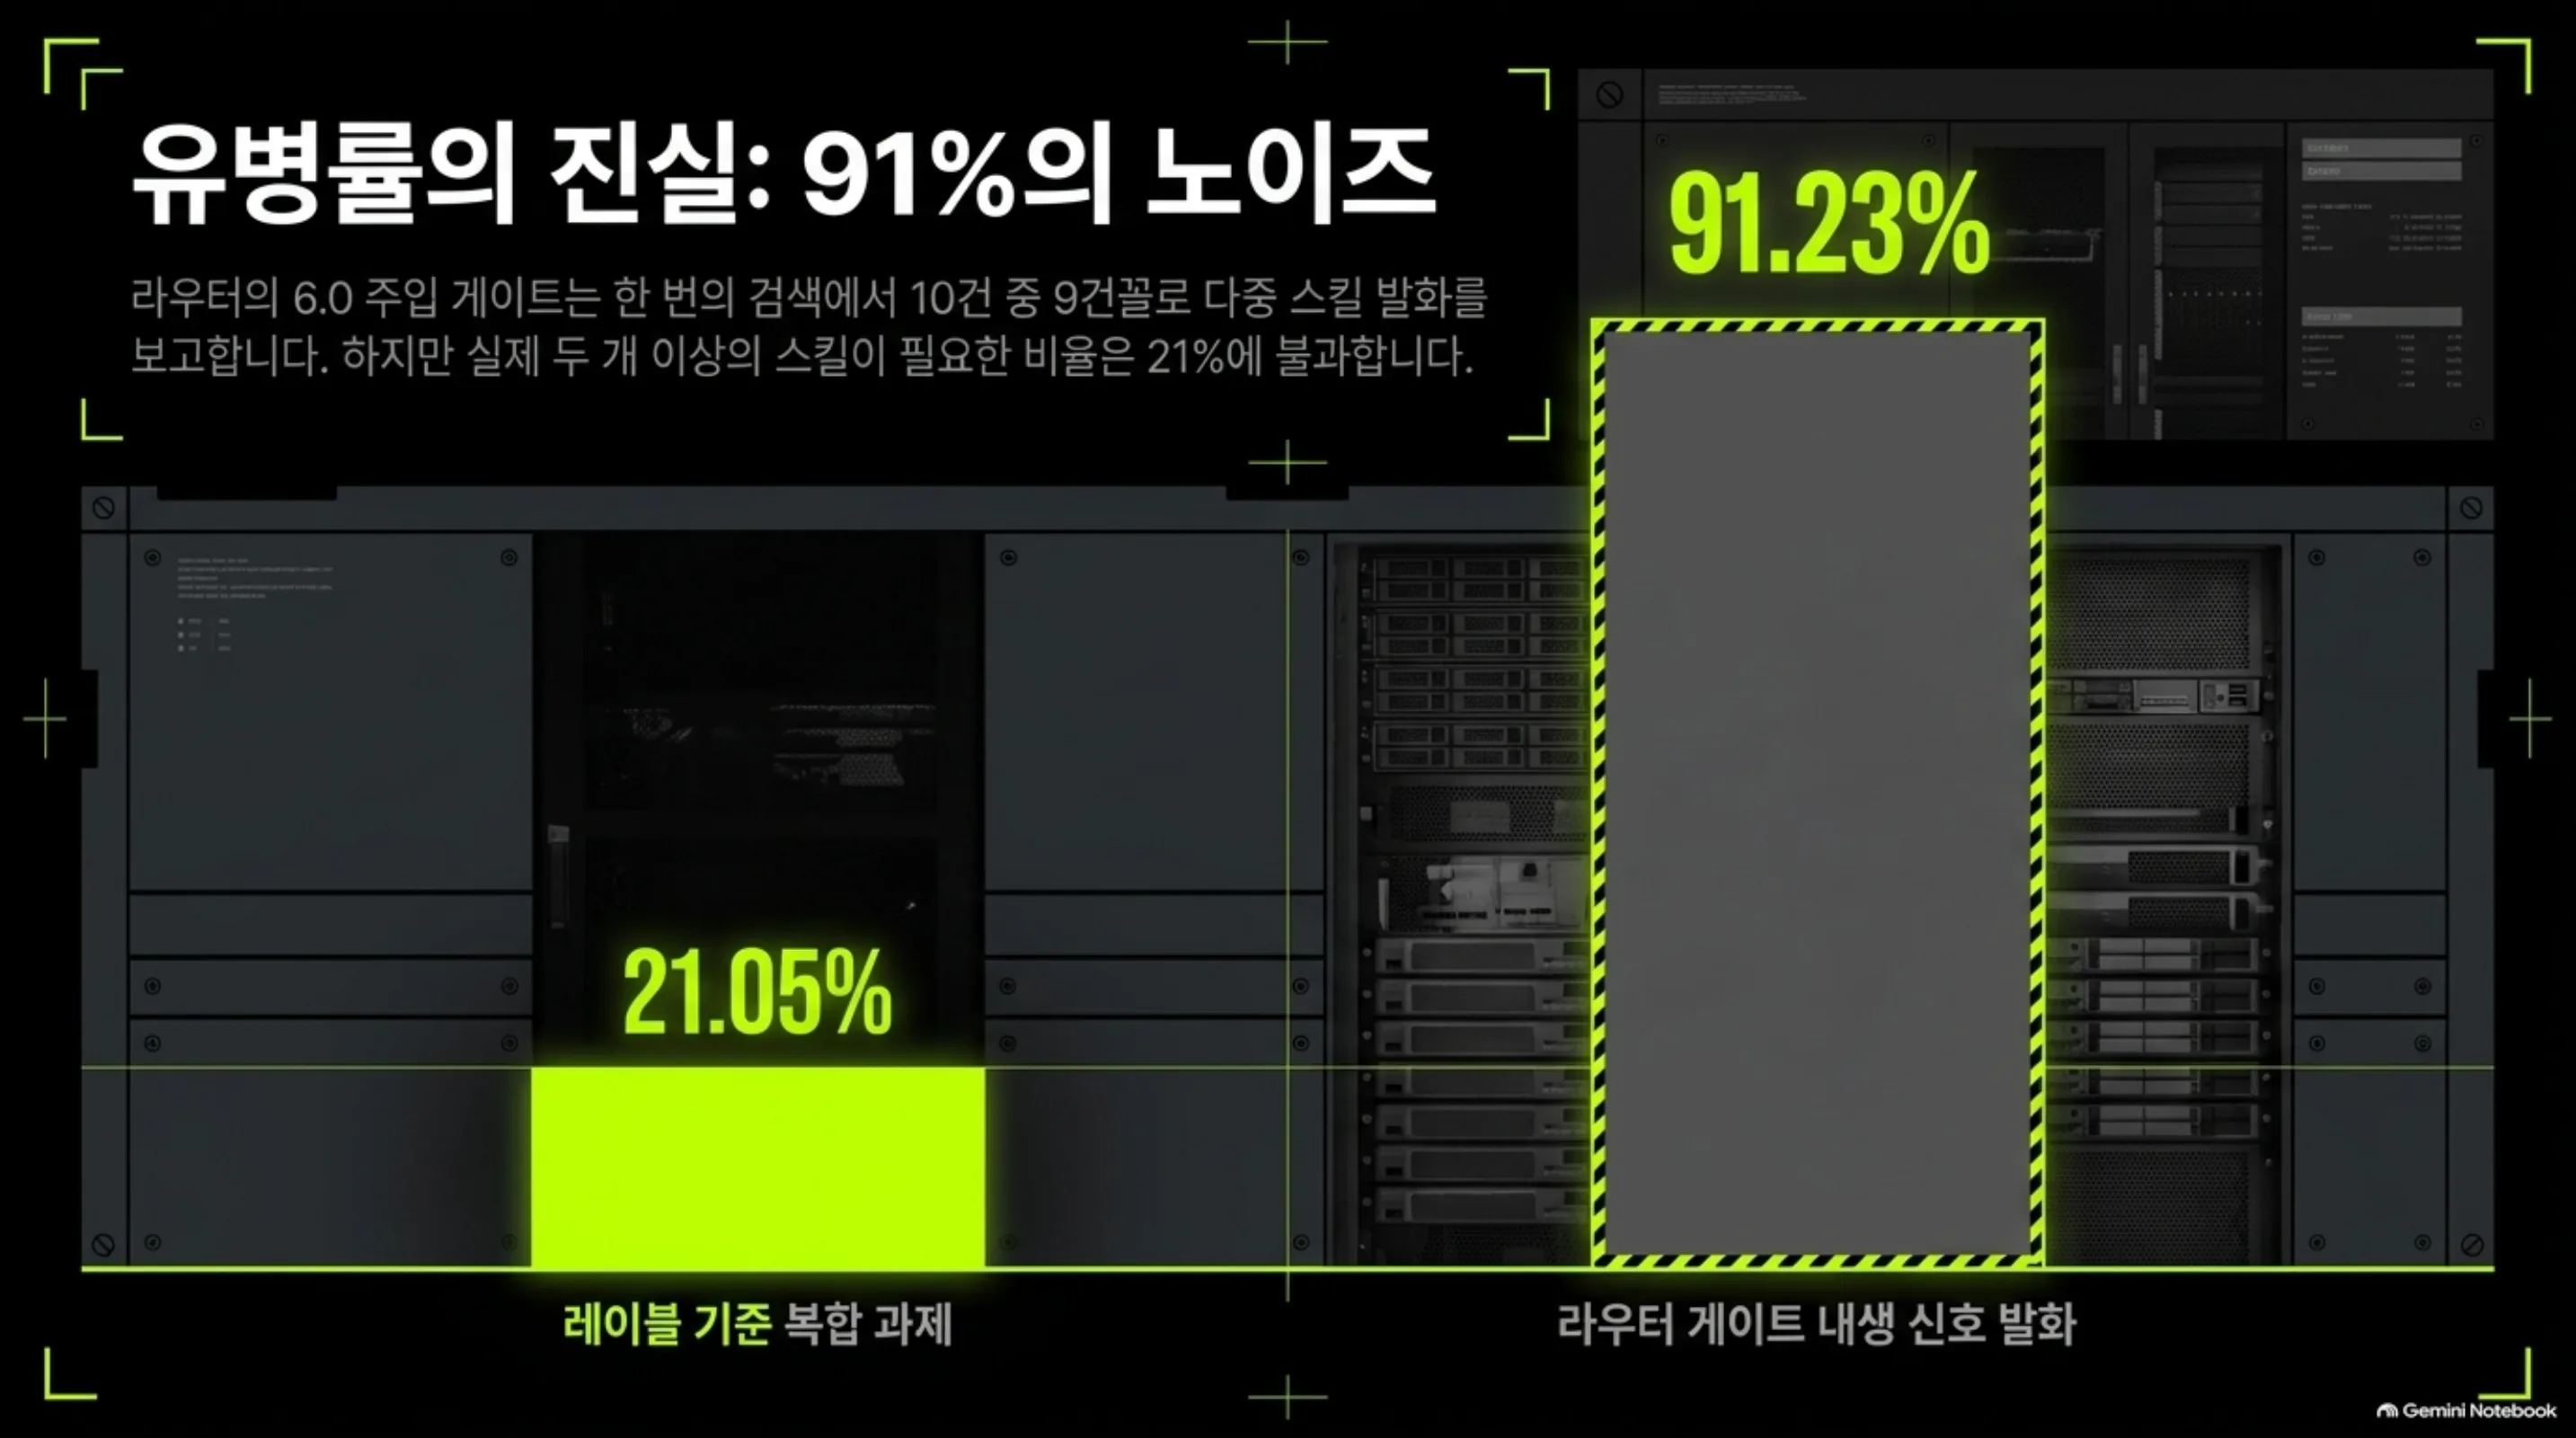
첫 번째 발견, 유병률입니다. 같은 코퍼스 위에 두 개의 ‘복합 비중’이 공존합니다. 레이블 기준(골드가 구성상 두 개 이상의 세트인 작업)은 57개 골드 과제의 21.05%, 12/57, 5건 중 1건입니다. 같은 순간 라우터 자신의 내생 신호(한 번의 검색에서 두 개 이상의 스킬이 6.0 게이트를 넘는 것)는 91.23%(52/57)에서 발화합니다. 풀면 단일 스킬 과제 45개 중 41개, 복합 12개 중 11개. 스킬 불필요 10개에서는 0입니다.
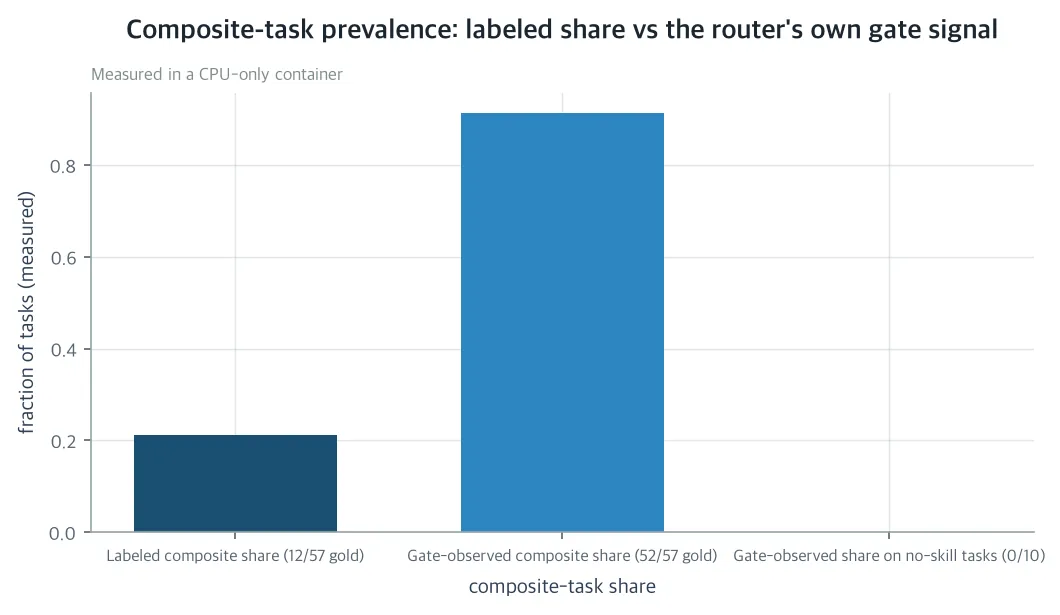 레이블 기준으로 57개 골드 과제의 21.05%만 복합(두 개 이상 스킬)입니다. 반면 한 번의 검색에서 두 개 이상 스킬이 6.0 주입 게이트를 넘는 게이트 관찰 신호는 골드 과제의 91.23%(단일 41/45, 복합 11/12)에서, 스킬 불필요 과제는 0/10에서 발화합니다. 게이트는 ‘스킬 없음/있음’은 완벽히 가려도 복합 여부로는 교정되지 않은 신호라는 실측인 셈. (2026-10-16 스킬 인덱스 스냅샷, 75개 작업 코퍼스, CPU-only 컨테이너에서 측정)
신호가 이렇게 부풀리는 이유는 인접 스킬의 공유 어휘이기 때문. 특허 패밀리 스킬과 그 초안 작성 형제가 설명에서 같은 단어를 쓰면, 작성 요청에 두 스킬이 함께 게이트를 넘는다는 뜻. 그래서 ‘게이트를 넘는 후보가 둘 이상이면 복합’으로 만든 검출기는 57개 중 52개를 플래그할 텐데, 그중 41개는 단일 스킬 과제입니다. 게이트가 잘하는 일은 환각 선을 지키는 것, 스킬 불필요 10개에서 0건 발화하고 0건 주입하는 것이므로 그 신호가 그대로 유병률이 되지는 않습니다. 유병률은 게이트 쪽이 아니라 작업군 쪽, 레이블로 재는 것입니다.
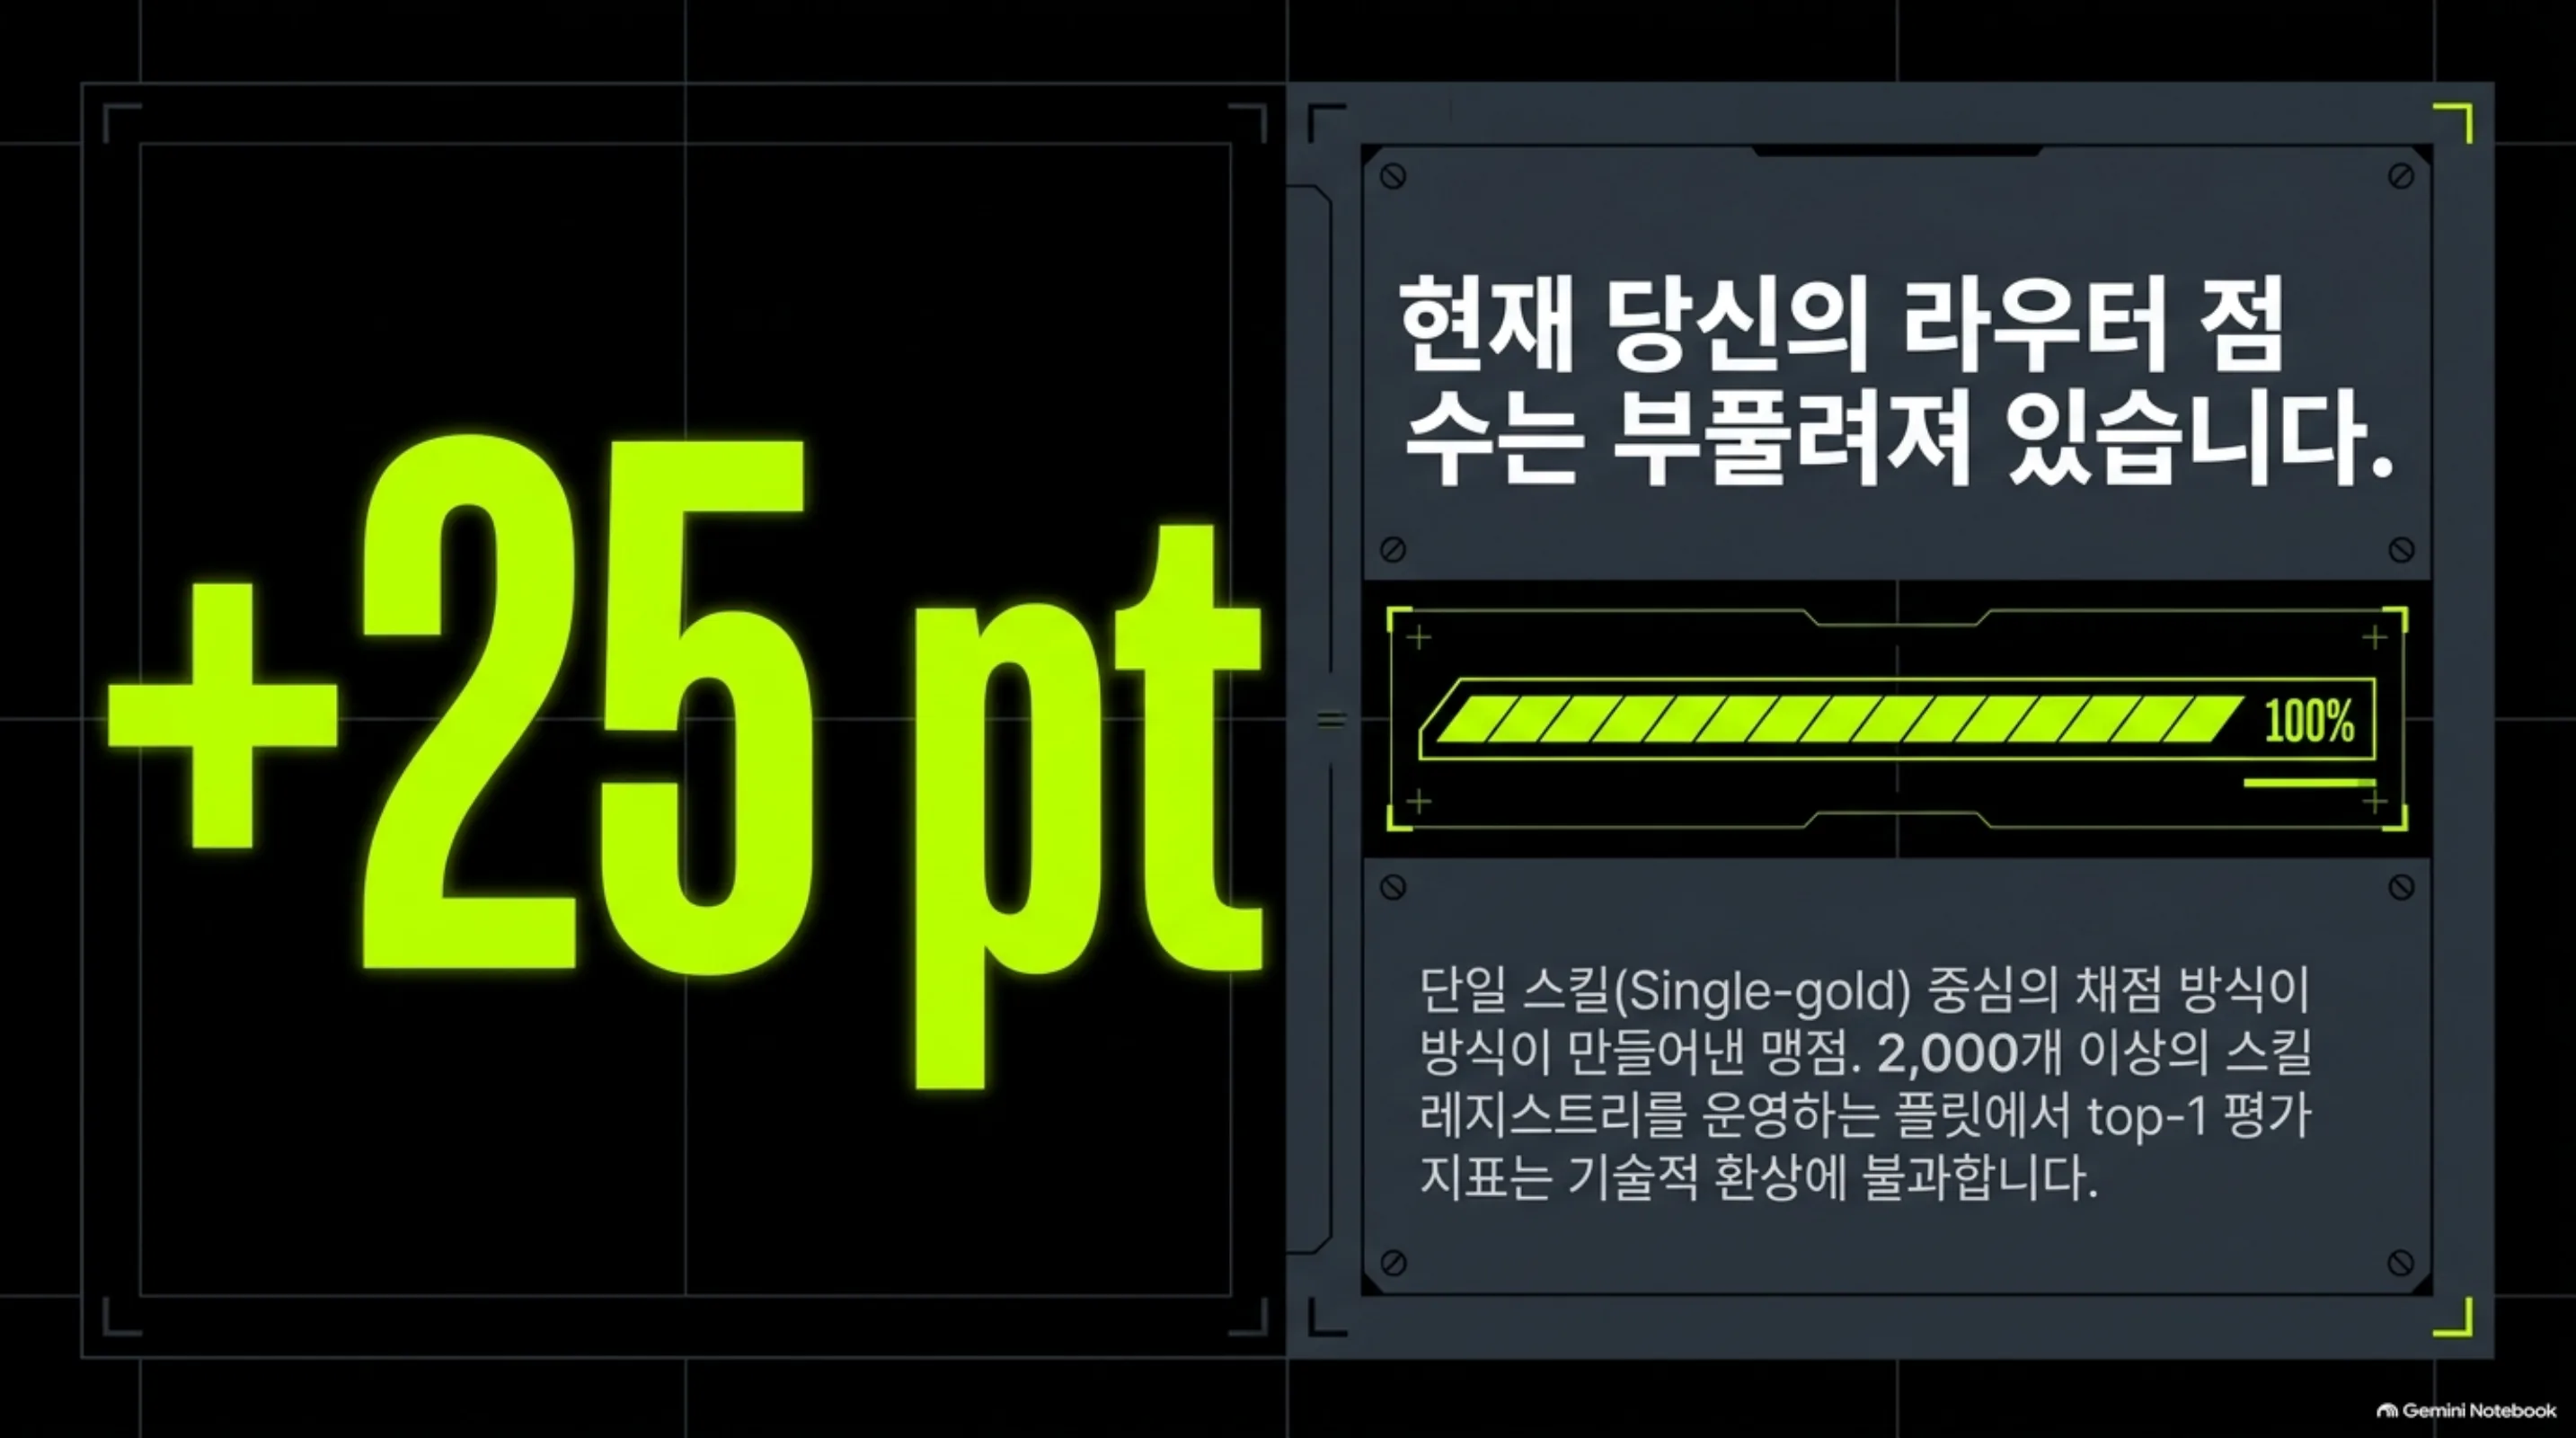
두 번째 발견은 그 채점 방식이 만든 부풀림 자체입니다. 12개 복합 과제를 옛날 식으로(골드의 첫 원소가 1순위가 되는가) 채점하면 라우터는 25%(3/12)를 보고합니다. 주식 분석→옵션 전략, 사고 초동→런북 실행, RFP 해석→제안서 작성, 그 세 쌍의 첫 걸음이 가장 강력한 어휘 유인물이어서인 셈. 같은 k=1 예산으로 세트 식(골드 세트 전체가 주입 안에 들어오는가)이면 0%, 0/9(골드-사용 가능 분모)입니다. 같은 예산에 25포인트 차이. 단일-gold 지표는 한 번도 복합 작업을 끝내지 않은 라우터를 25% 성공으로 인증하는 셈이고, 이는 이전 체인 벤치가 외부에서만 보였던 ‘멀티스킬 갭’이 표준 SRA-Bench 채점 내부에서 보이는 모습입니다.
폭을 넓히는 쪽이, 다시 검색하는 쪽보다 싸다: k=8에서 멈추는 무릎
전략 가격화의 한 짝은 원샷 top-k 스킬셋 라우팅입니다. 검색을 한 번 하고 랭킹 순 top-k를 그대로 주입하는, 프로덕션 훅의 k=1을 일반화한 것입니다. 자유 매개변수는 폭뿐이고 비용은 과제당 1회 호출 + k개 주입. k를 1, 2, 3, 4, 5, 8, 10으로 쓸어 올렸습니다.
세트로 채점한 스킬 세트 리콜(SR)은 48.92%(k=1)에서 83.53%(k=8)으로 오르고 거기서 멈춥니다. k=10은 네 가지 품질 축 모두에서 k=8과 정확히 동일하고 주입 컨텍스트만 25% 더 드는 품질 0의 폭인가. 복합 축은 실제로 움직입니다. 체인 완성(복합 과제의 골드 세트 전체가 주입된 비율)은 0%에서 44.44%(4/9)로 오르고 그중 마지막 단계 k=5→k=8이 22.2포인트를 만듭니다. 단일 스킬 정밀도는 더 일찍, k=5에서 85.71%로 포화합니다.
대가는 반대편에서 나옵니다. 금지 스킬 회피율은 87.50%(k=1, 7/8)에서 25.00%(k=8·10, 2/8)로 한 방향으로만 떨어집니다. 여덟 개 금지 스킬 중 여섯 개가 top-8 풀 안에 들고 그중 하나는 정답이 자신의 세부 형제인 요청에서 1순위로 랭킹됩니다. 폭이 커버를 사들이고 회피를 대가로 치르는 것입니다.
게이트는 폭 제어기로는 약합니다. top-10 윈도우 안의 6.0 이상만 주입하는 변형은 골드 코퍼스에서 과제당 평균 7.16개를 주입합니다. 570개 top-10 자리 중 408개가 게이트를 넘기 때문입니다. 단 환각 군에서는 완전히 다른 물건입니다. 스킬 불필요 10개에서 게이트를 넘는 후보가 0건이고 주입도 0건입니다. 게이트가 지금 플릿에서 하는 일, 환각 선 지키기는 그대로 유지한다.
측정 비용은 작고 결정론적이다. 전체 측정(모든 군 × 75개 과제)은 2,283개 문서 인덱스 전체를 215회 검색하는 데 9.88초(호출당 약 46ms, 엔드투엔드 9.97초)를 썼다. LLM을 부르지 않은 식용 측정의 비용 축(호출 수, 주입 스킬 수, 검색 벽시계)은 LLM 라우터 구성의 토큰 비용에 선형 대응한다. 매 호출이 LLM 라우팅 결정 1개, 매 주입 스킬이 실행 프롬프트의 컨텍스트 블록 1개인 셈이므로, 이 뼈대가 곧 그 가격의 골격이다.
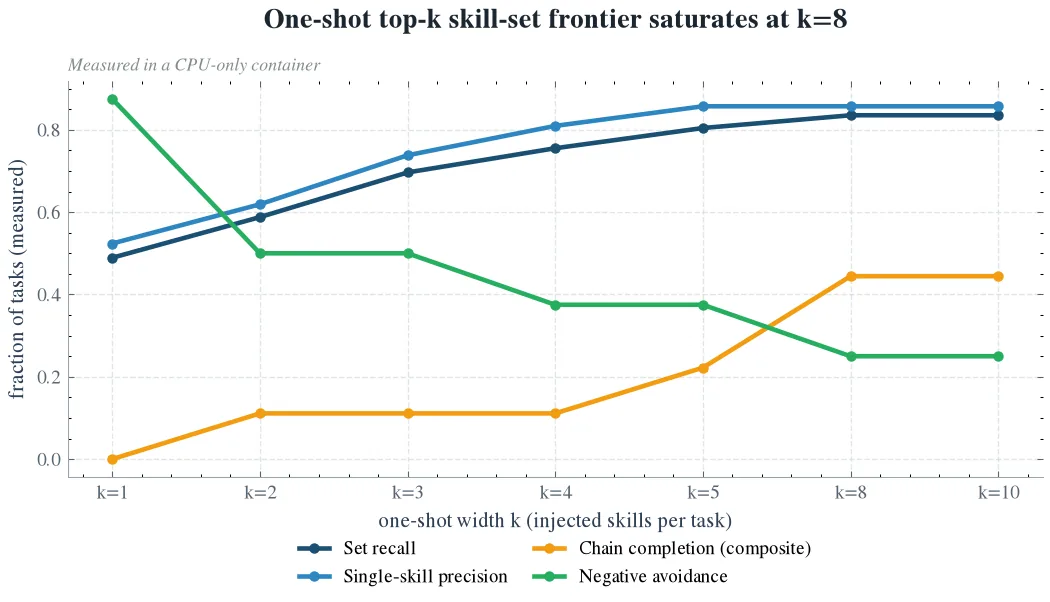 세트로 채점한 스킬 세트 리콜(SR), 단일 스킬 정밀도, 복합 과제의 체인 완성이 원샷 폭과 함께 오르다가 k=8에서 멈춘다. k=10은 모든 축에서 k=8과 동일하고 주입만 25% 더 든다. 반대편에서 금지 스킬 회피율은 87.50%에서 25.00%로 한 방향으로만 떨어져, 폭이 커버를 사들이고 회피를 대가로 치르는 실측이다. (2026-10-16 스킬 인덱스 스냅샷, 75개 작업 코퍼스, CPU-only 컨테이너에서 측정)
무릎을 운영점으로 놓으면: k=8에서 SR 83.53%, 체인 완성 44.44%, 정밀도 85.71%, 회피율 25.00%. 묶이는 자원이 커버리지 대신 실행 컨텍스트라면, 측정된 무릎 밑 지점은 k=5(SR 80.43%, 정밀도 85.71%, 회피 37.5%)입니다.
“한 번 더”를 사기 위한 루프는 2.19배 호출을 물고 top-1에 머뭅니다
전략의 다른 짝은 반복 재라우팅입니다. 라우팅→실행→재라우팅: 현재 요청에서 top-10을 검색해 게이트를 넘은 1순위를 주입하고 ‘실행’한 뒤, 잔여문으로 다시 검색하고 예산 5회까지 갑니다. 실행은 이전 복합 측정과 같은 LLM-자유 프록시입니다. 방금 라우팅된 스킬을 요청과 이어준 표면 어휘(이름 단어, 설명 토큰, 동의어 가교 형태)를 요청에서 걷어 내고 그 잔여문을 재라우팅합니다. 어떤 군도 세부 과제 라벨을 쓰지 않고 루프가 보는 것은 요청 텍스트와 인덱스뿐인 셈입니다.
측정된 결과는 이 전략의 가격입니다. 과제당 2.193회 호출, 1.2105개 주입. 품질은 top-1의 품질: SR 49.80%(k=1의 48.92%보다 +0.88포인트), 체인 완성 0%, 단일 정밀도 0.5238, 회피율 0.875, top-1과 축마다 같습니다. 57개 중 54개에서 스킬을 하나 이상은 모으지만 첫 검색 이후 53개 과제에 걸친 68번의 추가 호출이 건져 올린 새 스킬은 15개, 22.1%뿐입니다. 종료는 56/57에서 ‘게이트를 넘는 잔여 후보 없음’, 1/57에서 잔여문 부족. 5회 예산에 닿은 과제는 없습니다.
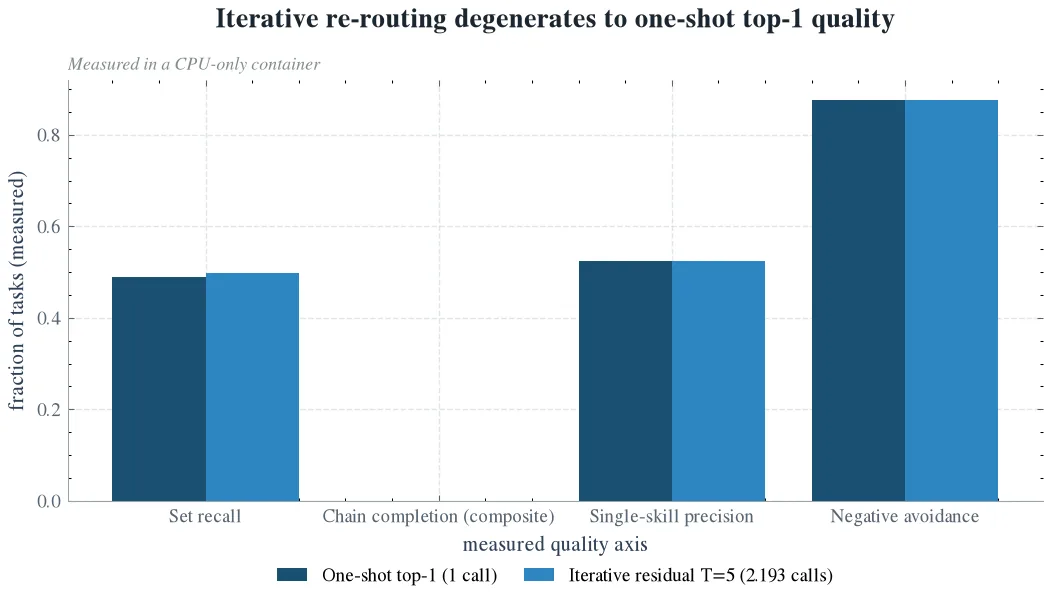 반복 route-execute-re-route 군(과제당 2.193회 라우터 호출, 1.2105개 스킬 주입)은 SR 49.80%, 복합 체인 완성 0%에 머밋습니다. 정밀도와 회피율은 one-shot top-1(1회 호출)과 축마다 같고 k=8(SR 83.53%, 체인 완성 44.44%)에는 2.19배 호출로 엄격하게 지배됩니다. (2026-10-16 스킬 인덱스 스냅샷, 75개 작업 코퍼스, CPU-only 컨테이너에서 측정)
죽는 방식이 이 군의 역학 안에 보입니다. 실행 프록시가 걷어 내는 것이 첫 검색을 발화시킨 표면 어휘 그 자체이고 그 잔여문은 구조적으로 앵커를 잃은 희박한 조각입니다. 조각은 6.0 게이트 위로 점수를 만들지 못합니다. 죽는 것은 검색 원시물이 아니라 재-앵커링 신호입니다. 외부 결과와도 맞물립니다. 검색 시점에 쿼리를 쪼개면 파편의 의미 희석으로 오히려 성능이 떨어지는 단계 인식 결과, 그리고 ‘획득 라운드의 한계 품질이 0에 가까우면 비용 인식 정지는 1라운드에서’라는 결정론적 모양, 이 둘의 실측 대응이 56/57입니다.
무감시 루프의 비용 모델이 자르려는 그 장부, 라우터 호출,으로 치러야 하는 세금입니다. +0.88포인트의 SR, 0의 복합 이득에 2.19배 호출. 재-앵커링 신호를 다시 짓기 전까지 반복 재라우팅은 배포 불가입니다.
무감시 플릿의 운영 규칙 다섯 개, 그리고 회사·산업·과학이 얻는 것
측정에서 직접 읽는 운영 규칙은 다섯 개입니다.
첫째, 야간 스킬-진화 루프의 채점을 단일-gold top-1에서 세트 지표로 바꿉니다. SR, 체인 완성, 금지 회피를 단일/복합/스킬 없음/금지 혼합 코퍼스 위에서. 25%를 인증하던 지표가 0%를 숨겼으므로, 루프가 보는 숫자부터 바뀌어야 합니다. 복합 작업 검출기도 작업군 쪽, 구성상 레이블 또는 골드 세트 위 학습으로 세웁니다. 게이트는 환각 선 지키기로 남습니다.
둘째, 원샷 폭을 측정된 무릎, k=8에서 돌리기 때문. k=10은 동일 품질에 25% 더 컨텍스트이고 컨텍스트가 묶인다면 k=5가 무릎 밑 지점입니다.
셋째, 반복 route-execute-re-route를 배포하지 않습니다. 잔여문이 실제 실행 출력을 실어, 재-앵커링 신호를 살린 채 오기 전까지는. 혹은 분해를 검색 단계에서 재랭킹 단계로 옮기는 쪽.
넷째, 폭을 설명 분리와 쌍으로 묶습니다. k=8에서 6/8의 금지 스킬이 풀 안에 들며 실패 가족은 전부 단일-gold 계열에서 이미 기록된 세부 쌍인 셈입니다. 그 쌍의 설명을 쌍대 분리로 다듬거나, 주입 세트 위에 verify-gated 필터를 쓰는 것이 측정된 보완이라는 뜻입니다.
다섯째, 전략을 가격화한 뒤 커버리지에 투자합니다. k=8 풀 바깥에 남은 16.5%의 골드 자리는 검색 쪽, 설명 어휘의 문제입니다. 이전 체인 벤치의 풀 천장(2,275개 인덱스에서 k=20, 24.3% 골드 미스)과 인덱스 성장(2,275→2,283)을 놓고 보면, 검색 쪽 커버리지 천장은 한 번의 산물이 아니라 제정의 속성으로 읽힙니다.
회사의 몫은, 무인 플릿의 야간 최적화에 새로운 축이 생기는 것입니다. 복합 작업 검출기 슎과 세트 레벨 SRA 지표가 야간 스킬-진화 루프로 들어가고 2,200개 스킬 레지스트리에서 다중 스킬 실패를 숨겨온 단일-gold top-1을 대체합니다.
산업의 몫은 가격입니다. 같은 비용 뼈대가 LLM 라우터 구성의 토큰 지출에 선형 대응하므로, 폭을 무릎에서 돌리고 루프를 끄는 것만으로도 무감시 에이전트 자동화의 토큰 지출과 벽시계가 줄어듭니다. 자체 H200 한 대라는 상품 하드웨어 위에서, 큰 플랫폼 벤더뿐 아니라 작은 팀에게도 무감시 루프가 감당 가능한 비용으로 내려옵니다.
과학의 몫은 평가 축입니다. 프로덕션 규모 스킬 생태계에서 복합 작업 유병률과 스킬 세트 리콜을 처음으로 측정하고 반복 재라우팅과 원샷 멀티 스킬 라우팅 사이의 실측 비용-품질 프론티어를 제시합니다. 단일 스킬 top-1 정확도 너머의 새 축이고 스킬 ‘세트’ 획득에서는 무릎이 실측된 모양입니다. 유병률(21.05%)과 게이트 신호(91.23%)의 분리도, 라우터의 내생 신호를 검출기로 쓰는 관행에 대한 실증 기록으로 남습니다.
못 믿을 부분
첫째, 유병률의 범위입니다. 21.05%는 레이블된 평가 코퍼스(실제 워크플로 템플릿의 골드 57개)의 속성입니다. 프로덕션 트래픽에 대한 추정치는 아닙니다. 프로덕션 작업 로그는 이 측정에 없었고 이 수치는 제정 특성화입니다. 인구 추정치는 아닙니다.
둘째, 실행 프록시입니다. 반복 군의 ‘실행’은 LLM-자유 표면-스트립 프록시입니다. 진짜 실행이라면 출력을 잔여문에 덧붙이고 루프를 재-앵커링할 수도 있습니다. 이 논문이 말하는 것은 ‘멀티 라운드 라우팅이 불가능하다’가 아니라, ‘측정된 프록시의 루프가 배포 불가하다’입니다.
셋째, 식용 전용 라우터입니다. dense re-ranking은 의도적으로 꺼져 있고(모델 축은 이전 논문에서 가격화), 하이브리드 라우터라면 k 값이 움직일 수 있습니다. 다만 두 군이 같은 검색 원시물을 쓰기 때문에 전략 지배 관계는 견고할 것으로 봅니다.
넷째, 규모와 외적 타당도입니다. 75개 과제, 2,283개 인덱스의 스냅샷 한 장, 게이트 임계값 6.0 하나(단일-gold 축에서 튜닝). 6개 골드 과제가 스냅샷에 없는 이름을 참조해, 세트 지표는 51개 골드-사용 가능 과제(단일 42, 복합 9) 위에서 계산됩니다. 다른 레지스트리, 다른 게이트, 다른 언어 혼합에서는 미검증입니다.
다섯째, 비용 매핑입니다. 측정된 비용은 LLM-자유 뼈대이고 LLM 라우터 구성의 달러 비용은 선언된 단가 위의 선형 매핑입니다. 측정값은 아닙니다. 둘 다 선형으로 재스케일되지만 지배 관계는 재스케일되지 않는다는 점이 이 매핑의 유효한 부분입니다.
마지막으로, 유리한 식용 제정입니다. 복합 과제 표면 표현은 구성상 골드 스킬 설명이 쓰는 것과 같은 산출물과 단계를 부릅니다. 더 어려운 표면 형태라면 SR은 낮아지겠고 오히려 검색 쪽 발견을 강화하는 방향입니다.
세 장의 그림은 모두 2026-10-16 스킬 인덱스 스냅샷과 75개 작업 코퍼스, CPU-only 컨테이너에서의 실측 데이터입니다. 각 캡션에도 그렇게 적어 두었습니다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있습니다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-17-composite-multi-skill-routing