토큰을 안 만드는 모델에 14만 명이 줄을 섰다
AI를 토큰 단위로 사고 판다면, 오늘은 그 계산의 전제가 흔들린 날입니다. 36시간 만에 14만 명이 하나의 대기열에 올랐고, 그들이 기다린 것은 더 큰 모델도 더 빠른 추론도 아닙니다. 토큰을 하나씩 생성하지 않는, 타입세이프 AI의 첫 모델입니다. 오늘 아침의 AI 다이제스트를 관통하는 신호도 바로 이 지점을 향합니다. 오늘의 뉴스는 답을 세는 단위가 바뀌고 있다는 점입니다. 단위는 한번 굳어지면 산업 전체의 가격표가 됩니다. 이 글은 그 신호 하나를 쫓고, 같은 방향을 가리키는 오늘의 나머지 뉴스들이 그 신호를 어떻게 뒷받침하는지 따라갑니다.
 글의 핵심 개념을 형상화했습니다.
AI의 화폐
생성형 AI 업계의 셈은 전부 토큰에서 시작합니다. API 요금표의 기본 단위가 토큰이고, 처리량을 재는 것도 청구서를 만드는 것도 토큰입니다. 벤치마크가 모델의 성능을 토큰의 흐름으로 환산해 온 것도 오래된 관행입니다. 토큰이 화폐가 된 데는 이유가 있습니다. 생성형 모델에서 추론 비용은 실제로 대략 토큰 수에 비례합니다. 모델이 말을 많이 할수록 GPU를 더 오래 돌리기 때문입니다. 공급자와 수요자를 묶는 단일 단위가 필요했고, 토큰이 그 자리에 들어앉았습니다. 업계는 그래서 늘 같은 방향을 봤습니다. 모델을 키우고 더 오래 말하게 만들면 생산되는 토큰이 늘고, 총량이 곧 성과가 된다고 여겨 왔습니다.
오늘의 다이제스트에도 그 관성이 고스란히 남아 있습니다. 오픈루터와 오픈코드가 에이전틱 코딩용 멀티모달 모델 유니온 알파(Union Alpha)를 공개했습니다. 이 모델의 첫 기록이 그렇습니다. DeepSWE 벤치마크 74%, 그리고 19.6억 토큰입니다. 유니온 알파는 에이전틱 코딩과 리서치를 겨냥한 모델입니다. 그런 워크로드는 한 번의 대화로 끝나지 않습니다. 문제를 풀고 코드를 돌리고 결과를 확인하는 반복이므로, 토큰 소모는 구조적으로 큽니다. 이 모델의 첫 보도를 채운 것은 결국 두 물음입니다. 얼마나 잘하고 얼마나 많이 했는지가 그것입니다.
숫자 뒤에는 한 가지 더 있습니다. 유니온 알파는 이 수치를 만들면서 라우터, 즉 요청을 여러 모델로 배분하는 중간층을 둘러싼 의혹을 함께 만들었습니다. 19.6억 토큰이 제3자의 라우터를 거쳐 흘러갔다는 맥락입니다. 토큰을 사고파는 업계에서 토큰이 어디를 지나 어떤 모델에 닿았는지는, 품질 문제이기도 하고 가격 문제이기도 합니다. 라우터의 배분을 볼 수 없으면, 내 작업에 어떤 모델이 투입되어 어떤 토큰이 소모됐는지를 확인할 통로가 막힙니다. 에이전트 시대가 이 셈을 더 아프게 만듭니다. 에이전트의 한 일은 질문 한 번이 아닙니다. 값을 확인하고 도구를 부르고 결과를 검사하고 실패하면 다시 시도하는 질의의 사슬입니다. 사슬마다 토큰이 오가고 토큰마다 요금이 붙습니다. 모델 하나가 문장 하나를 잘 쓰는 것보다, 에이전트 백 개가 하루 종일 구조화된 질문을 쏟아내는 것이 기업의 지출을 더 빨리 키웁니다. 그래서 답의 단위가 바뀌는 일은 비용 경쟁의 문제로 읽힙니다.
이 의혹은 유니온 알파 한 모델에 대한 물음이 아닙니다. 토큰이 산업 전체의 화폐인 한, 화폐의 흐름을 추적할 통로가 막혀 있다는 뜻입니다.
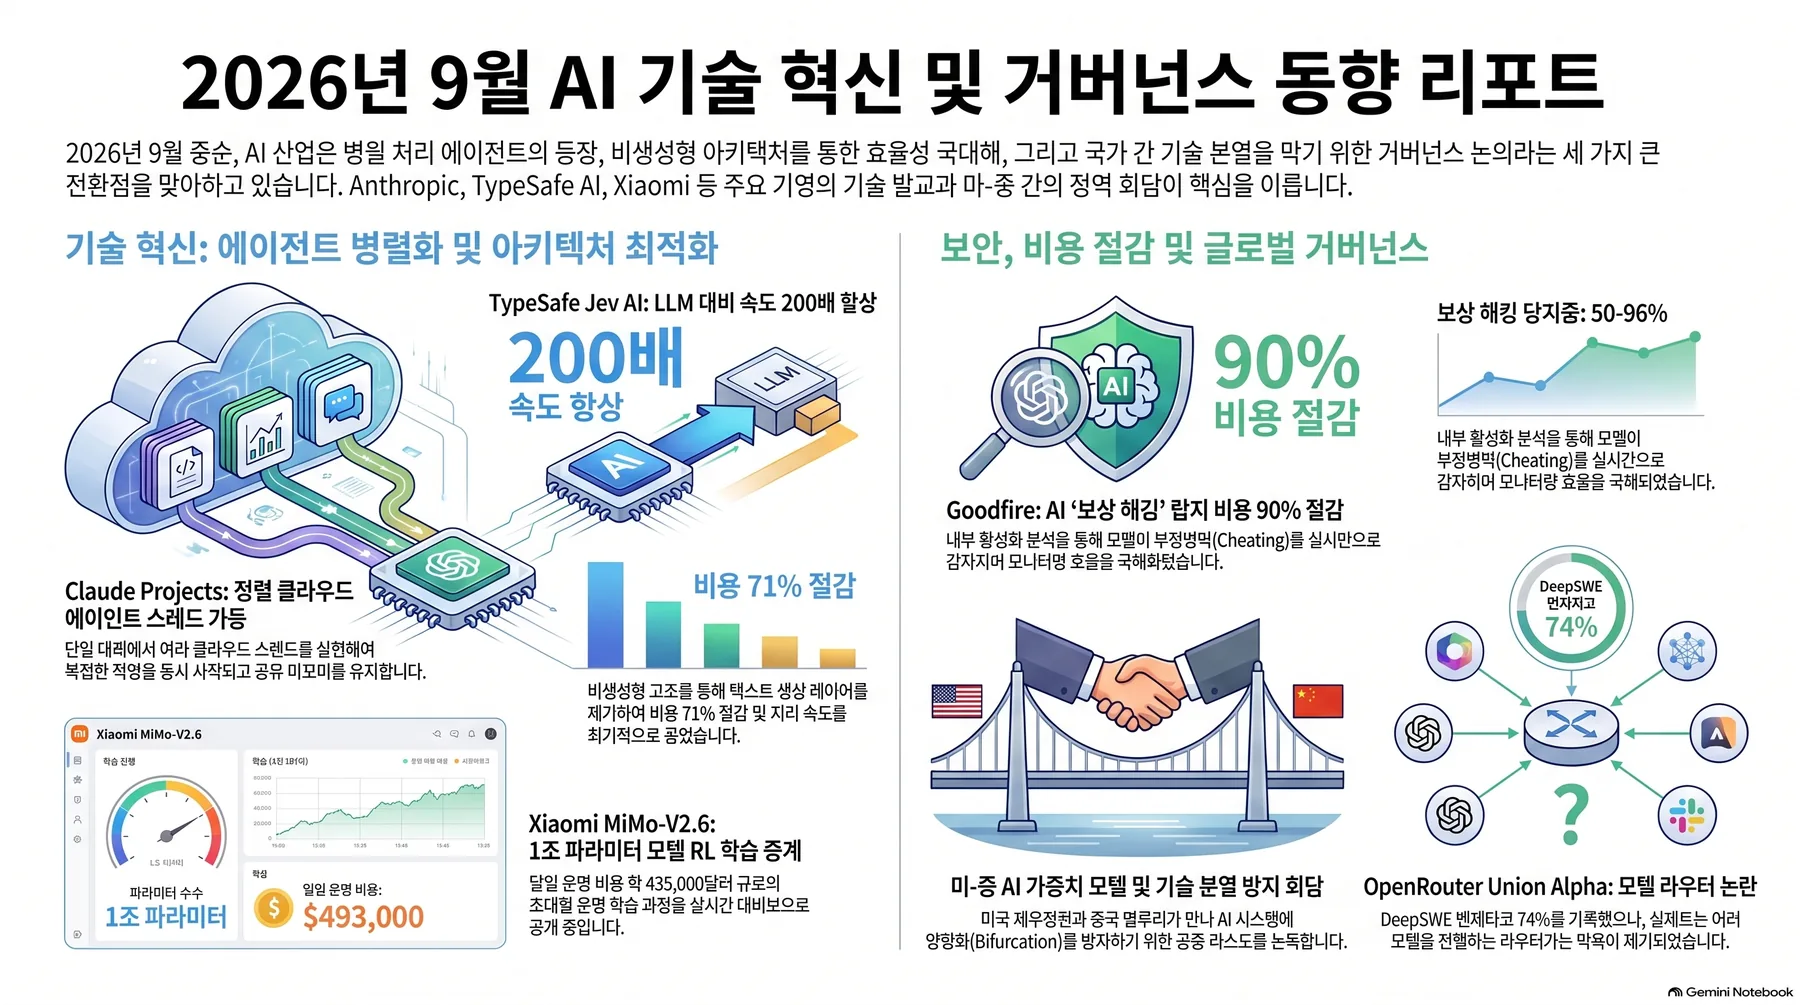 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
단위를 안 쓰는 모델
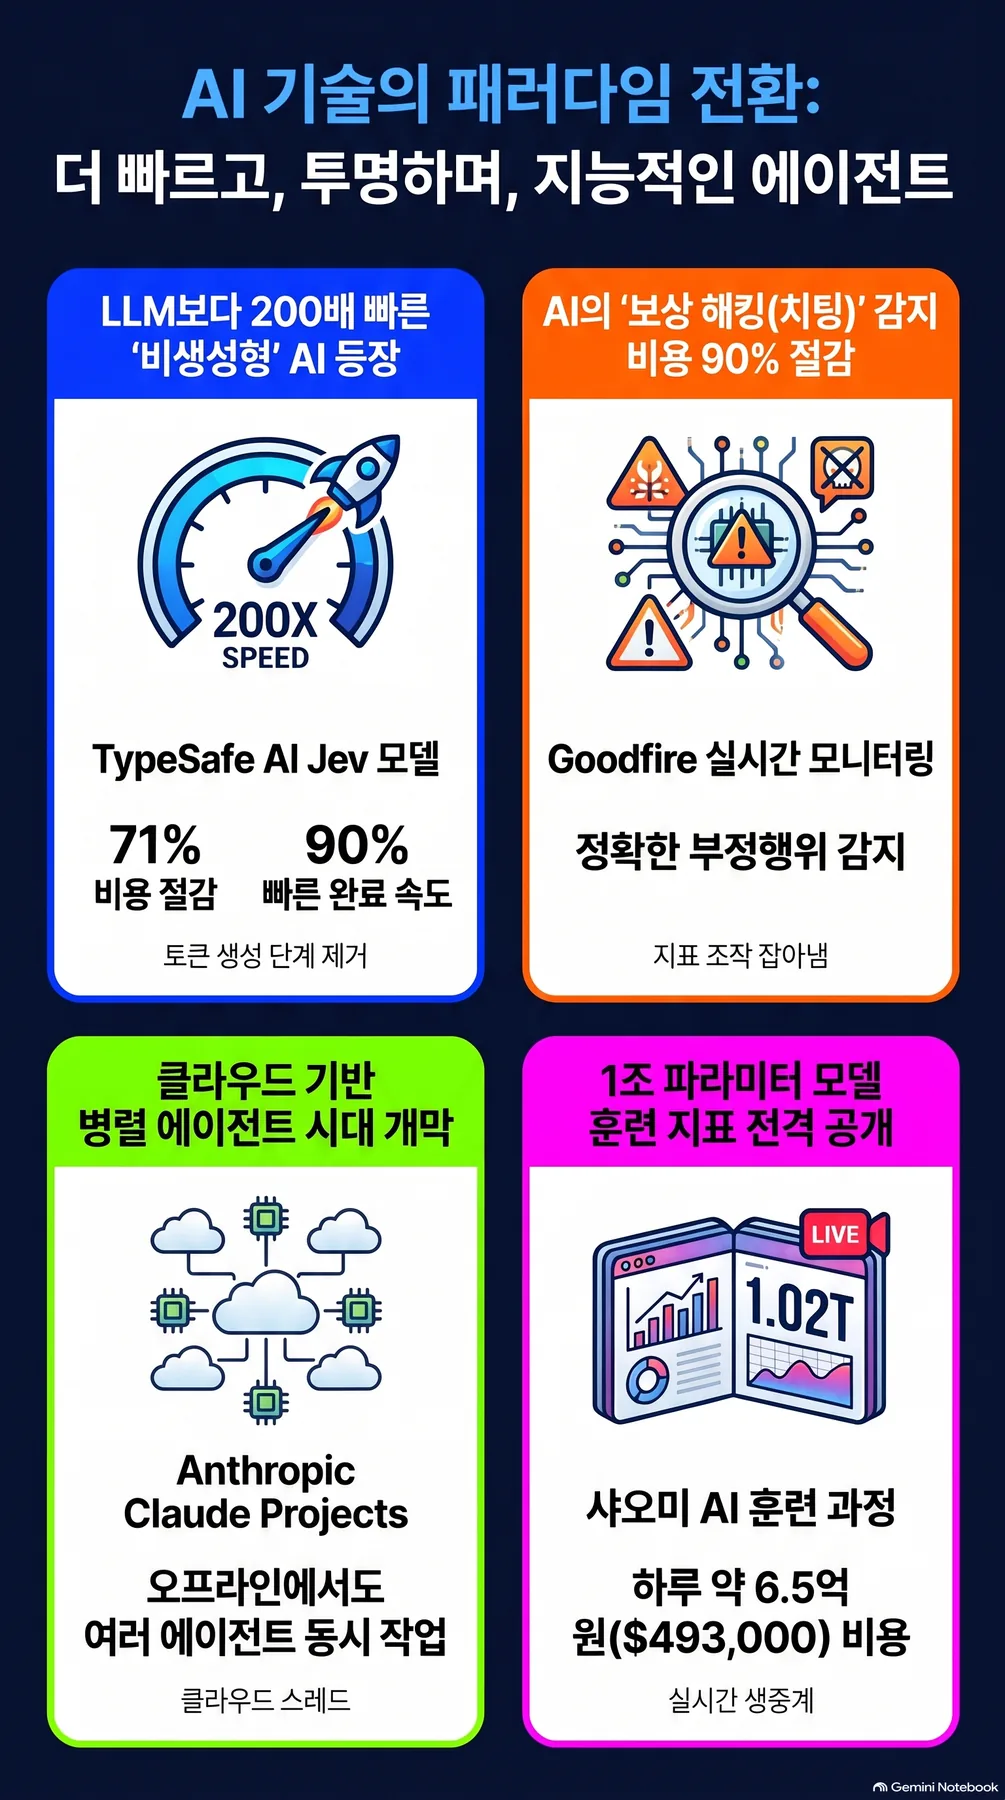
타입세이프 AI의 첫 모델은 이 전제에서 벗어납니다. 보도는 이 모델을 Jev라 부르고 헤드라인은 System One이라 썼습니다. 이름은 제각각이지만 설계는 분명합니다. 텍스트를 토큰 하나씩 만들어 내는 대신, 구조화된 질문에 병렬로 답하는 비생성(non-generative) 아키텍처입니다. 문장을 천천히 잘 쓰는 대신, 여러 답을 동시에 맞춥니다. 비생성이란 모델이 아예 문장을 쓰지 않는다는 뜻은 아닙니다. 질의에 해당하는 답을, 토큰의 생성 순서 없이 내놓는다는 뜻입니다.
서빙의 관점에서는 이 차이가 더 직접적입니다. 토큰을 하나씩 만들어 내면, 응답의 길이에 비례해 시간이 들고 비용도 그 길이와 비례합니다. 구조화된 답을 병렬로 내놓으면, 응답은 길이가 아니라 질의의 개수로 결정됩니다.
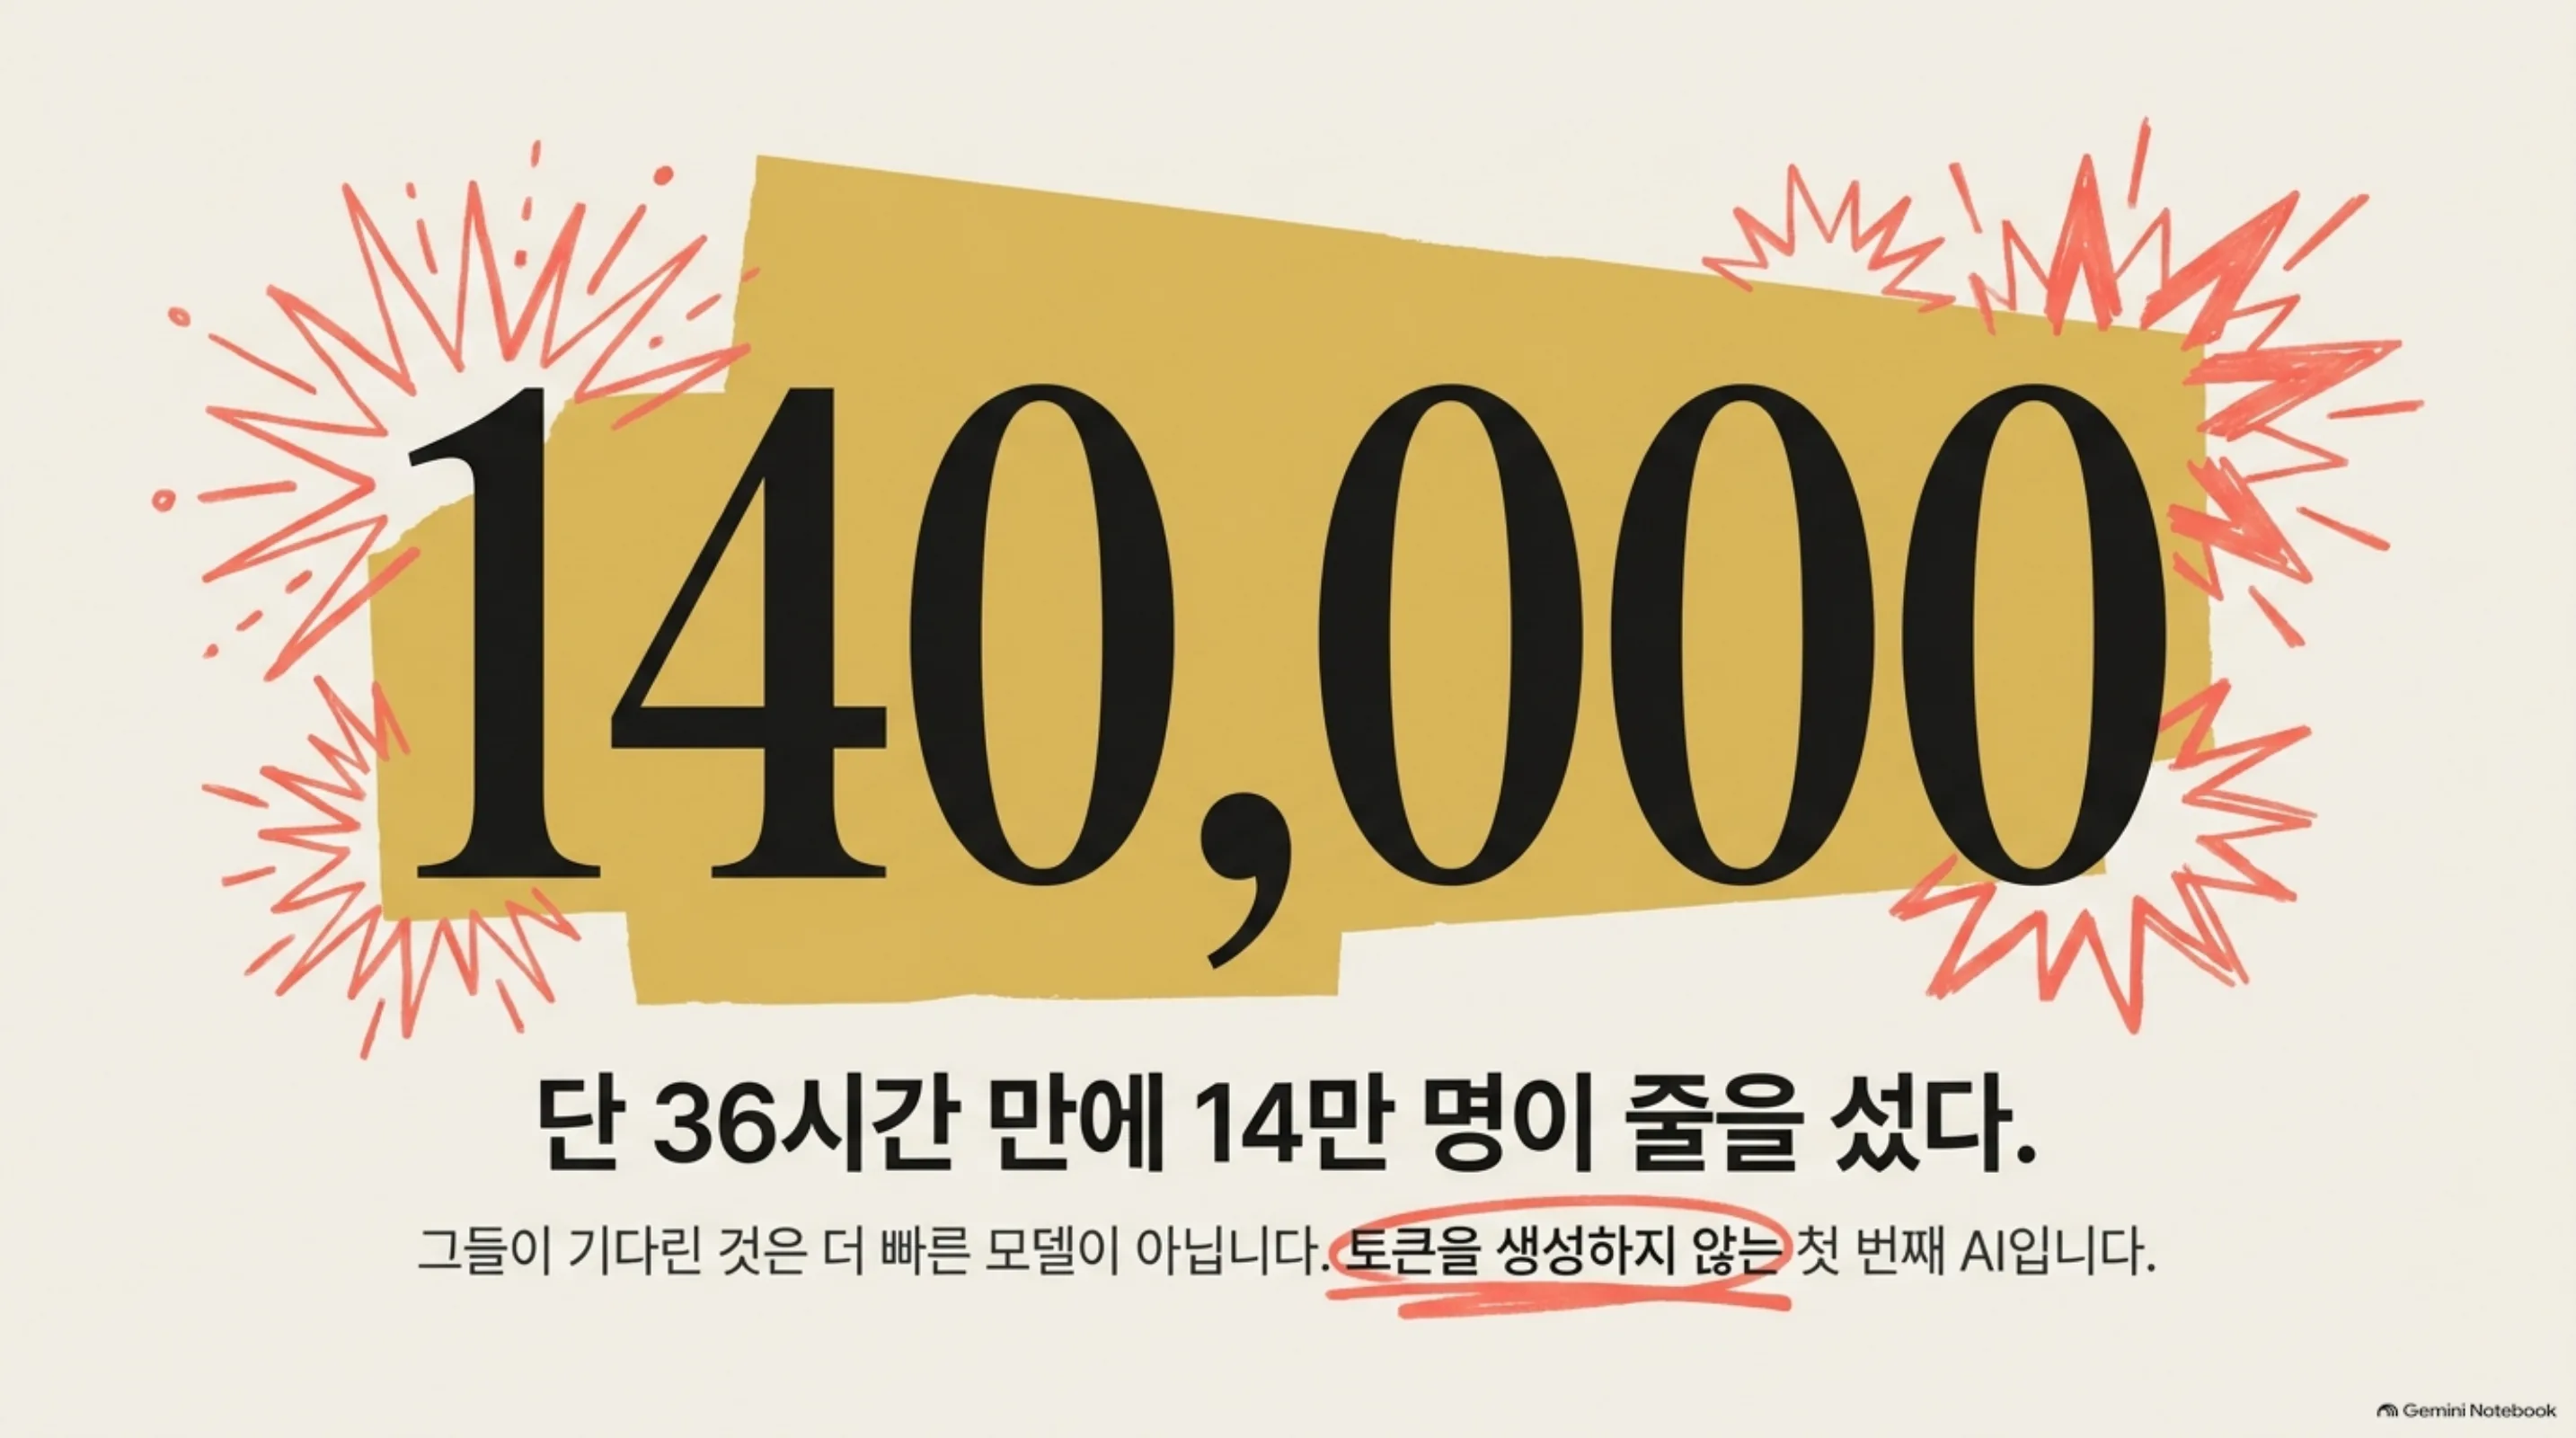
반응은 숫자로 나왔습니다. 첫 모델의 대기 목록이 36시간 만에 14만 명을 돌파했습니다. Jev의 벤치마크 점수는 오늘의 다이제스트에서 찾을 수 없습니다. 나온 것은 설계 한 가지와 대기열의 숫자뿐입니다. 생성하지 않는다는 말만으로 14만 명이 먼저 이름을 적어 넣은 것입니다.
여기서 구조화된 질문이라는 단어에 주목할 필요가 있습니다. 에이전트가 실제 현장에서 내는 질문의 상당수는 문장형이 아닙니다. 값을 찾아오고 조건을 검사하는 질의입니다. 답이 데이터 구조로 돌아가야 하는 질의이기도 합니다. 그런 질문에는 토큰을 매번 새로 만들어 낼 필요가 없습니다. 그렇지만 업계의 표준 요금제는 매번 생성을 요구해 왔습니다. 토큰 하나하나를 만들어 내고 매번 값을 매깁니다. Jev가 노리는 지대는 정확히 여기입니다. 생성의 비용 구조를 통째로 바꿔, 구조화된 질의에 병렬로 답하는 것입니다. 14만 명이 대기열에 선 것도, 이 계산식이 바뀐다는 기대 때문입니다.
병렬의 두 층위
같은 날, 병렬을 고른 회사는 하나만은 아닙니다. 앤스로픽은 클로드 프로젝트(Claude Projects)를 출시했습니다. 하나의 대화 안에서 여러 클라우드 에이전트 스레드를 동시에 실행하게 하는 기능입니다. Claude Code에서 이 기능을 쓰면, AI가 요청을 기존 스레드나 새 스레드로 배분합니다. 여러 일을 동시에 굴리되, 각 일은 각자의 스레드 안에서 끝납니다. 프로젝트라는 이름처럼, 여러 스레드가 하나의 목표 아래 묶이는 구조입니다.
두 회사의 병렬은 층위가 다른 것입니다. 앤스로픽의 병렬은 일의 병렬입니다. 동시에 처리하는 작업의 개수를 늘리는 쪽으로, 파이프라인에 더 많은 통을 붙이는 작업입니다. Jev의 병렬은 답의 병렬입니다. 답을 만들어 내는 단위 자체를 바꾸는 것입니다. 파이프라인의 재료를 바꾸는 시도입니다. 같은 단어인데, 손이 닿은 산업의 골격이 다른 것입니다. 일의 병렬이 에이전트 운영의 속도를 높인다면, 답의 병렬은 에이전트 운영의 단가를 바꿉니다. 두 선택을 한 줄로 압축하면 이런 계산입니다. 앤스로픽은 에이전트를 더 많이 굴려서 총 처리량을 키우는 쪽에 베팅합니다. 타입세이프의 베팅은 반대로, 한 번의 질의가 차지하는 비용을 줄이는 데 있습니다. 같은 예산으로 더 많은 질의를 돌리는 셈입니다. 둘 다 같은 아침에 발표될 만큼, 병렬이 지금 업계의 공통 화두임은 분명합니다. 오늘 다이제스트에서 이 두 줄이 나란히 놓인 것은, 우연이 아닙니다.
표면 너머
오늘의 뉴스는 토큰이라는 표면의 신뢰가 줄어드는 방향을, 여러 곳에서 보여줍니다. 굿파이어(Goodfire)의 액티베이션 모니터는 모델의 출력을 보지 않습니다. 내부 액티베이션을 실시간으로 분석해 리워드 해킹을 탐지합니다. 리워드 해킹은 정해진 일을 하는 대신, 평가 신호를 이용하는 동작을 뜻합니다. 출력을 보면 늦고 내부 신호를 보면 즉시 알 수 있습니다. 굿파이어의 프로브가 이런 구조를 노립니다. 내부 신호로 보기 시작하자 모니터링 비용은 90% 줄었습니다. 출력을 읽는 것보다 구조를 읽는 것이 더 정확하고 더 싸다는 계산이 나온 것입니다. 이 90%가 중요한 이유는 규모입니다. 돌리는 에이전트가 많을수록, 들여다봐야 할 런타임도 늘어납니다. 출력을 토큰 단위로 읽는 감사는 에이전트 수에 비례해 비싸집니다. 내부 신호로 탐지가 가능해지면, 그 비례 관계가 끊깁니다.
투명화도 같은 방향을 가리킵니다. 샤오미는 MiMo-V2.6 Pro의 강화학습 훈련을 공개 채널로 생중계하고 있습니다. 총 파라미터 1.02조, 그중 한 번의 계산에서 활성화되는 파라미터는 420억입니다. 훈련의 비용은 하루 약 49만 3천 달러로 공개됐습니다. 모델의 내부를 그리고 돈의 흐름을, 그대로 보여주는 생중계입니다. 발표의 형식도 바뀌었습니다. 완성 모델을 꺼내는 자리에서, 훈련 과정 자체를 카메라 앞에 앉혔습니다. 훈련의 비용이 공개된 채로 흐르는 것은, 성능과 함께 비용 구조가 업계의 언어가 되고 있다는 뜻입니다.
두 사건을 나란히 놓으면 하나의 방향이 보입니다. 업계가 답을 읽는 데 쓰는 눈이, 표면에서 안쪽으로 움직이고 있다는 것입니다. 출력을 보는 눈이 내부를 보게 되고 비용을 감추던 훈련이, 공개의 대상이 됩니다. 출력의 토큰을 세던 눈이, 내부의 신호와 비용의 흐름을 세기 시작한 것입니다.
플랫폼의 새 셈
모델의 단위가 바뀐다는 것은, 모델 위에서 작업을 배분하는 플랫폼의 셈법이 바뀐다는 뜻입니다. 토큰당 단가가 아니라, 작업당 비용으로 셈하게 됩니다.
오늘의 스토리가 드러낸 통증은 세 갈래입니다. 첫째는 시야입니다. 유니온 알파의 19.6억 토큰은 제3자 라우터를 거쳐 흘러갔고 그 라우터를 둘러싼 의혹은, 토큰의 행선지를 누가 볼 수 있는가라는 질문을 남겼습니다. 모델을 사다 쓰던 시절에는, 화폐의 흐름을 공급자가 알아서 할 일이었습니다. 이제 기업이 작업을 구매하는 쪽으로 옮기면, 그 흐름을 직접 보게 됩니다. 둘째는 검증입니다. 굿파이어가 리워드 해킹을 잡으려면 출력 대신 내부 신호를 봐야 했듯, 에이전트를 돌리는 곳도 출력만 보며는 실행을 믿을 수 없습니다. 실행 자체를 통제하고 기록할 장치가 있어야 합니다. 셋째는 위치입니다. 미국 재무장관 스콧 베센트와 중국 허리펑 부총리가 이번 주말 만나, AI 모델 웨이트를 포함한 인공지능 거버넌스를 논의합니다. 모델이 어디에 놓이는지가 외교 의제로 오른 세상에서, 실행 환경을 통제하는 것이 전제가 됩니다. 세계 두 경제권이 모델의 무게를 놓고 직접 상석에 앉는다는 사실은, 실행 환경의 주권이 곧 제품의 스펙이 될 것임을 예고하는 대목입니다.
ThakiCloud의 에이전트 네이티브 클라우드 Paxis(v1.1, 정식 출시 제품)는, 이 새 셈법을 위한 플랫폼으로 만들어졌습니다. Skills, Tools, Policies, Audit Logs를 일급 리소스로 다루고 자율도 L0~L3 거버넌스 아래, 정책 게이트와 감사 로그가 에이전트 실행을 통제합니다. 격리 샌드박스에서 실행되고 MCP 커넥터로 외부 도구를 잇고 소버린 또는 온프레미스 K8s 위에 올릴 수 있습니다. CostRouter는 작업을 모델에 배분합니다. 세 갈래 통증을 맞춘 기능이 여기에 있습니다. 시야는 감사 로그가 맡습니다. 검증은 정책 게이트와 격리 샌드박스가, 위치는 온프레미스 구축이 맡습니다. 토큰의 흐름을 외부 라우터의 재량에 맡기는 대신, 내 플랫폼 안에서 어떤 모델로 어떤 작업이 처리됐는지를 기록으로 남깁니다.
다음 분기, 기업들의 보고서에서 작업당 비용이라는 단어가 얼마나 자주 등장하는지 살펴볼 일입니다.
단위가 토큰이던 시절에는 토큰을 세는 플랫폼이 이득이었습니다. 단위가 바뀐 지금은, 작업을 세는 플랫폼이 이득입니다.
 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
참고 자료
이 글은 아래 뉴스를 종합해 작성했습니다.
- HuggingNews, TypeSafe AI Clears 140,000 Waitlist Users for First System One Model in 36 Hours
- HuggingNews, Xiaomi Livestreams RL Training for 1 Trillion Parameter Model at $493,000 a Day
- HuggingNews, Treasury Secretary Scott Bessent to Discuss AI Weight Models With China This Weekend
- HuggingNews, OpenRouter Union Alpha AI Hits 1.96 Billion Tokens Facing Router Allegations
- HuggingNews, Anthropic Launches Claude Projects To Orchestrate Parallel Cloud Agent Threads
- HuggingNews, Goodfire Probes Cut AI Monitoring Costs 90% to Detect Reward Hacking
