모델이 여권을 가진 날
미국은 표준을, 중국은 담을 쌓고 있습니다. 둘의 대상은 같습니다. AI 모델입니다. 오늘 아침 HuggingNews 다이제스트에서 미국 쪽 뉴스는 OpenAI의 독립 모델 감사 제안이고 중국 쪽 뉴스는 데이터 유출에 대한 국가의 조사입니다. 같은 날 도착했습니다. 같은 질문을 가리키고 있다는 점은 우연이 아닌 셈입니다. 질문은 모델을 누구에게 맡길 것인가입니다. 그 답은 더 이상 모델 메이커의 손에 있지 않습니다. 제3자나 국가의 손에 놓입니다. AI를 사서 쓰는 기업에게는, 원래 어떤 모델이 좋은가였던 질문에 어디에서 도는지, 그것이 증명 가능한가가 먼저 답을 구하기 시작합니다. 자신이 도입한 모델이 곧 두 개의 다른 체제에 걸릴 수 있다는 것, 그것이 오늘 두 뉴스를 함께 읽어야 하는 이유입니다.
 글의 핵심 개념을 형상화했습니다.
OpenAI가 스스로 요구한 표준
OpenAI의 항목은 주체가 모델 메이커 본인이라는 점에서 눈에 띱니다. OpenAI는 미국이 글로벌 AI 표준을 주도할 것을 촉구했습니다. 제시한 수단은 독립 모델 감사입니다. 독립 안전 평가자가 OpenAI 모델의 학습, 평가, 배포 단계에 깊은 수준의 접근을 받아, 그 과정에서 모델 리스크를 식별하는 구조입니다.
깊은 수준의 접근이라는 표현은 강합니다. 평가자가 보는 것은 모델의 출력이 아니라 학습과 평가, 배포 설정까지, 모델의 전 생애입니다. 그동안 안전은 메이커가 본인이 책임지는 문제였습니다. 벤치마크, 자체 보고서, 레드팀 결과까지, 모델의 상태는 모두 메이커의 자기 주장으로 제시됐습니다. 이제 메이커 스스로가 모델은 깊은 접근 권한을 가진 외부 평가자가 검증해야 한다고 말합니다.
메이커가 제안한다면 자발적 행동에서 산업 표준까지의 거리는 짧습니다. 미국이 표준 주도권을 가져간다는 것은, 그 자발적 행동을 모든 회사의 공통 규칙으로 만드는 일입니다. 감사 체제가 먼저 미국에서 정의되면, 글로벌 모델 시장의 입장권은 자연스럽게 그쪽으로 기울어집니다. 그 모델들을 쓰려는 기업에게는, 모델 안에 무엇이 있는지를 묻는 감사 수준의 질문이 곧 자기 조달 과정 안에서도 제기될 차례입니다.
학습, 평가, 배포 단계까지 접근이 열리면, 감사 대상은 모델의 성능만이 아니라 그 모델이 어떤 환경에서 서빙되고 운영되는지까지입니다. 성능은 벤치마크 점수로, 서빙과 운영은 기록으로 답하는 영역입니다. 기업의 도입 환경과 가장 닮은 질문이 감사 테이블 위에 오른 셈입니다.
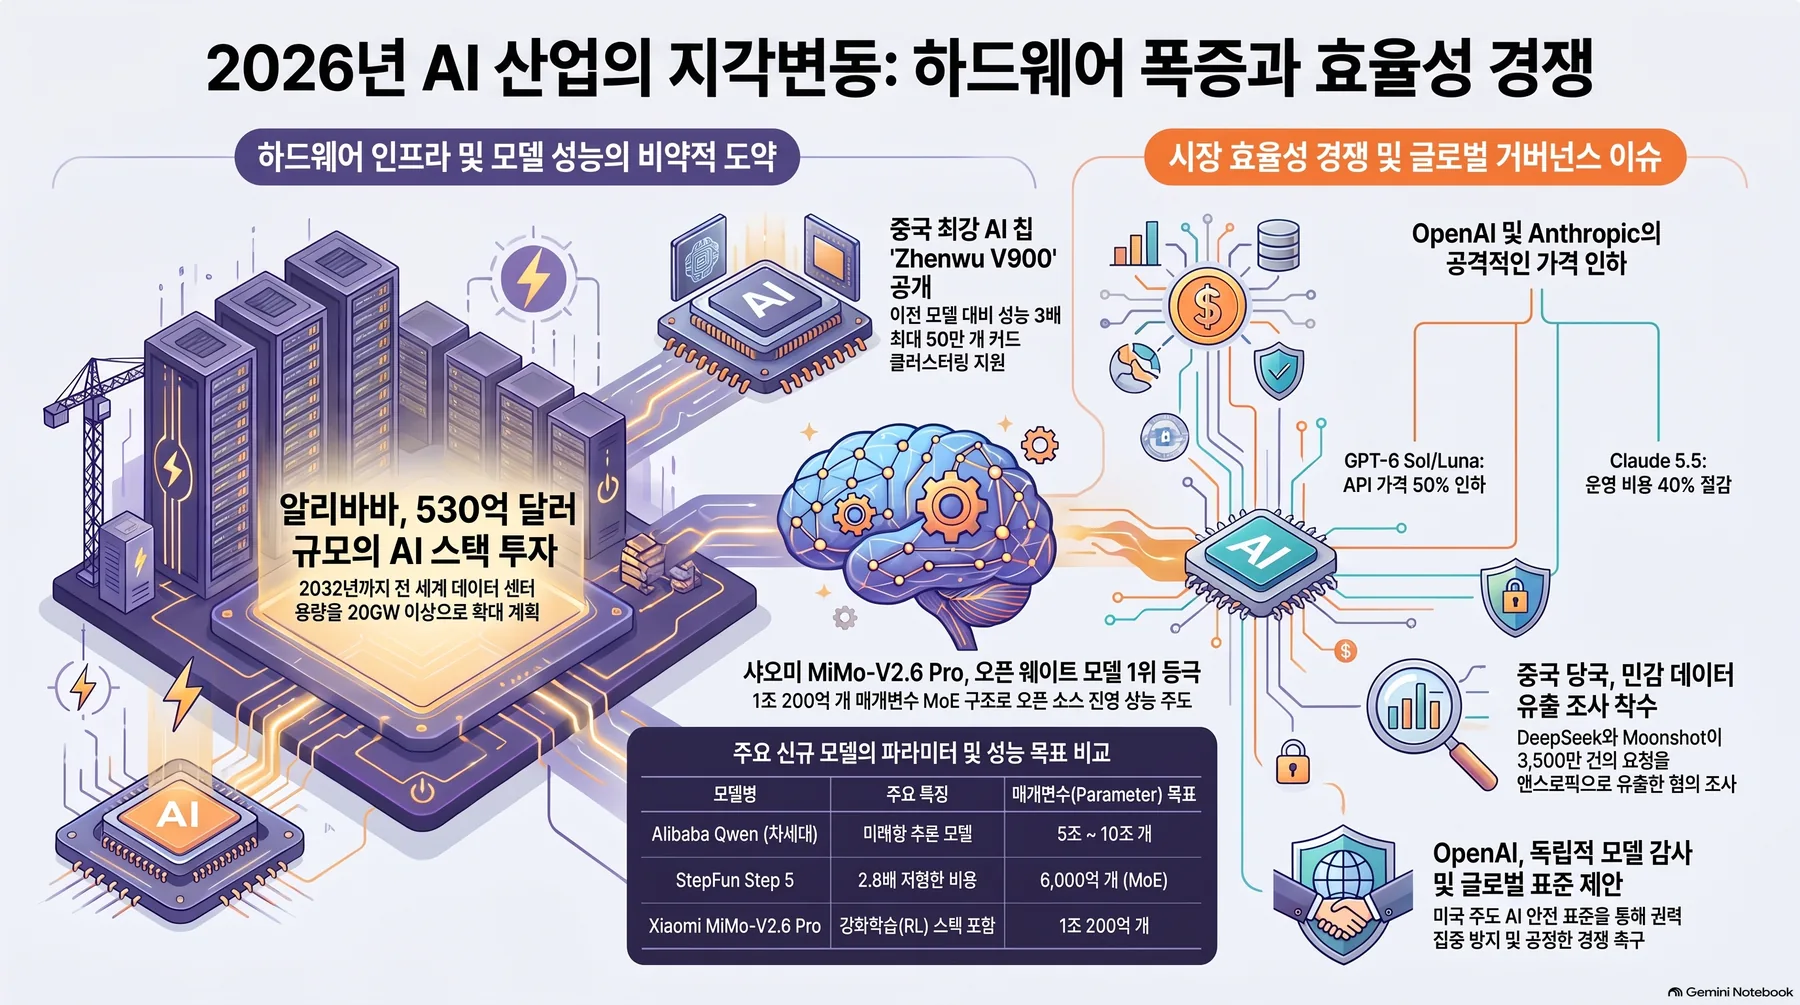 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
중국이 쌓은 담
중국 쪽 항목은 국가의 조사입니다. 중국 사이버공간관리국이 DeepSeek와 Moonshot을 조사하고 있습니다. 의혹의 내용은 민감한 자국 데이터가 Anthropic으로 유출된 것입니다. 규모는 3500만 건 이상의 요청으로 알려져 있습니다.
요청(request)은 엔지니어의 가장 평범한 행위입니다. 모델의 API를 부르면 데이터가 건너가고 답이 옵니다. 조사가 가리키는 것은 이 행위가 수백만 번 반복되면 별도의 신고 없이도 데이터가 국경 너머로 이동한다는 것입니다. 3500만은 트래픽을 잰 숫자입니다. 트래픽 자체가 데이터이고 그 데이터는 줄곧 건너편에 있었습니다.
규모를 곱씹어 볼 만합니다. 의혹의 초점은 한 건의 요청에 뭔가 은밀한 것이 실려 있었다기보다, 평범한 호출의 합이 3500만 건이라는 규모에 이른 데 있습니다. 그 체량이 외국 회사의 모델로 건너갔다면, 국가의 눈으로 보는 순간 데이터 주권이 걸립니다. 엔지니어가 일상으로 여기던 행위에 규제 이벤트의 차원이 붙었습니다. 두 모델을 쓰는 기업에는, 데이터가 건너갔는지를 내부 정책만으로 답하기 어려워진 국면입니다.
둘이 같은 날 온 이유
그 이유는 API 가격에서 멀지 않습니다. 같은 날 OpenAI는 GPT-6 Sol과 Luna 모델을 출시했습니다. GPT-6 Astra 아키텍처의 저가 대안입니다. 신규 티어의 API 가격은 50% 낮게 책정됐습니다. Anthropic은 첫 Claude 5.5를 출시해 실행 비용을 40% 절감했습니다. 대부분의 일반 작업에서 Fable 5.1과 동등한 성능을 달성하고 이전 Opus 5보다 30% 빠릅니다. StepFun의 Step 5 Preview는 6000억 파라미터 mixture-of-experts 모델입니다. 그중 270억만 요청마다 활성화되고 컨텍스트 윈도우는 100만 토큰입니다. 비용은 2.8배 낮은 채 Kimi K3와 동일한 44점을 기록했습니다.
한 건의 요청 가격이 떨어집니다. 가격이 떨어지면 트래픽이 늘어납니다. 트래픽이 늘면 국경을 넘는 데이터의 양도 늘어납니다. 3500만 건의 요청은, 건당 가격이 세어 볼 필요까지 없어진 시장에서 나온 것입니다. 가격 경쟁은 파는 사람의 경제 이야기입니다. 사는 사람에게는 데이터가 얼마나 빨리 건너편으로 가는가의 이야기라고 볼 수 있습니다.
에이전트 워크로드가 이 양을 더 키웁니다. 에이전트가 맡는 업무는 한 번의 메시지가 아닙니다. 모델과 도구를 반복해서 부르는 단계의 연속입니다. 한 작업은 대화보다 더 많은 API를 지나갑니다. 컨텍스트 윈도우가 길수록 한 번의 호출이 싣고 갈 데이터도 많아집니다. Step 5의 100만 토큰 컨텍스트는 한 요청이 더 많은 데이터를 나르게 한다는 뜻입니다. 싼 토큰과 긴 컨텍스트가 겹치면, 작업 하나당 API를 지나는 데이터량이 커집니다.
가격 인하는 수요를 키웁니다. 실행 비용이 40% 낮아진다는 것은, 같은 예산으로 더 많은 에이전트를 더 오래 돌릴 수 있다는 뜻이기도 합니다. 에이전트가 늘면 API 호출도 늘고 호출이 늘면 건너가는 데이터도 늘어납니다. 원인은 더 단순합니다. 가격이 내려가면 더 많은 에이전트가 돌게 되고 더 많은 에이전트가 돌면 건너가는 데이터도 늘어납니다. 두 규제 동향이 같은 날 온 이유는, 그 양이 더는 무시할 수 없는 크기가 됐기 때문입니다.
둘의 모양은 다르습니다. 하지만 둘의 실질은 같습니다. 모델이 제품에서 주권적 물체로 이동합니다.
안으로 남는 선택지가 두꺼워진다
스토리는 밖을 막는 것만으로 끝나지 않습니다. 안으로 남는 선택지도 두꺼워집니다. Xiaomi는 MiMo-V2.6 시리즈의 Pro와 Flash 모델 오픈 웨이트를 제공했습니다. Pro 버전은 mixture-of-expert 구조입니다. 에이전틱 AI 워크로드를 지향하며 오픈 웨이트 인덱스에서 46점으로 1위에 올랐습니다. Step 5의 웨이트 공개는 10월 15일로 예정되어 있습니다.
오픈 웨이트는 모델을 자사 인프라 위에 놓을 수 있다는 뜻입니다. 데이터가 밖으로 가지 않습니다. API 의존으로 시작했던 기업이, 모델을 어디에 놓느냐에 따라 데이터가 어디로 가느냐의 답을 바꿀 수 있습니다. Step 5의 10월 15일 웨이트 공개는 조달 팀이 지금부터 지켜볼 수 있는 변수입니다. 웨이트가 나오면, 배치 판단을 비교 후에 미루는 선택지가 생깁니다.
배치는 결국 계약의 문구가 됩니다. 모델이 어디에서 도는지 정하면, 데이터가 어떤 관할에 머물렀는지도 정해집니다. 같은 성능이라도, 데이터가 남을 수 있는 배치와 그렇지 않은 배치는 다른 가격으로 거래됩니다. 주권 요구가 강한 고객에게 배치가 먼저인 계약은, 새로운 것이 아니라 이제 상식입니다. 컴퓨트도 안에서 확보되고 있습니다. Alibaba는 530억 달러 규모의 AI 스택 구축을 공언했습니다. 중국 내 최강 AI 칩으로 불리는 Zhenwu V900은 이전 세대의 3배 성능을 제공하며 최대 50만 카드 클러스터로 학습과 추론을 수행합니다. 530억 달러는 모델을 크게 만드는 것만큼, 안에서 돌릴 수 있게 만드는 의지를 잰 숫자이기도 합니다.
어떤 모델을 쓰느냐가, 어디에 놓느냐로 변합니다. 그 변화는 두 규제 동향과 같은 방향입니다.
기업에 도착하는 질문
기업 구매자에게는 조달 대화의 모양부터 바뀌기 시작합니다. 어떤 모델이 좋은가는 더 이상 첫 번째 질문이 아닙니다. 데이터가 어디로 가는지, 그것이 증명 가능한가가 먼저입니다. 모델 메이커 쪽은 독립 감사를 통해 모델 안에 무엇이 있는지를 답하기 시작합니다. 기업 쪽에도 그에 대응하는 질문이 도착합니다. 어떤 모델이 어떤 데이터를 건드렸는지, 어떤 정책 아래에서 어떤 순서로 일했는지, 어떤 기록이 남는지를 묻게 됩니다.
두 질문의 차이는 주체입니다. 감사는 모델에 대한 질문이고 실행 기록은 귀사 업무에 대한 질문입니다. 모델 쪽은 학습, 평가, 배포 단계까지 감사에 열립니다. 다만 귀사 업무가 남긴 흔적에 대한 답은 실행층에서만 나옵니다. 이 질문에 답하지 못하면, 아무리 좋은 모델도 업무에 들어오지 못합니다.
같은 기록은 두 번 쓰입니다. 한 번은 감사를 위해서, 한 번은 비용을 위해서. 어떤 작업이 어떤 모델을 지났고 얼마가 들었는지를 남기면, 절감을 증명하고 다음 예산을 협상할 수 있게 됩니다. 기록이 없으면, 두 질문 모두에 답이 사라집니다.
실행층에서 답하는 플랫폼
어디에서 도는지, 그것이 증명 가능한지를 묻는 질문에는 플랫폼 쪽에서도 답할 수 있습니다. ThakiCloud의 Paxis는 Agent-Native Cloud로, v1.1 GA를 마친 정식 제품입니다. Paxis에서 Skills, Tools, Policies, Audit Logs 네 가지는 일급 리소스입니다. 에이전트의 일은 네 가지로 정의됩니다. 어떤 스킬을 갖추느냐, 어떤 도구에 접근하느냐, 어떤 정책 앞에 서느냐, 어떤 감사 기록을 남기느냐입니다.
자율도 L0부터 L3까지 단계별로 관리됩니다. 각 실행은 정책 게이트 앞에서 점검을 받고 격리된 샌드박스 안에서 이뤄집니다. 외부 도구와 스킬은 MCP 커넥터와 스킬 마켓을 통해 검증된 형태로 들어옵니다. 소버린이든 온프렘 Kubernetes 환경이든 그대로 돌립니다. CostRouter가 작업마다 모델을 선택합니다. API 단가는 계속 떨어지고 모델은 계속 바뀝니다. 어떤 일이, 어떤 모델로, 어떤 비용으로, 어떤 정책 아래 실행됐는지를 기록하는 일이 회사의 자산으로 남습니다. 미국은 표준을, 중국은 담을 만듭니다. 그 사이에서 기업의 질문은 하나입니다. 어떤 모델이, 어디서, 어떤 정책 아래, 어떤 기록을 남기며 일하는가입니다. 그 답은 모델층이 아니라 실행층에 있습니다. Paxis는 바로 그 실행층의 플랫폼입니다.
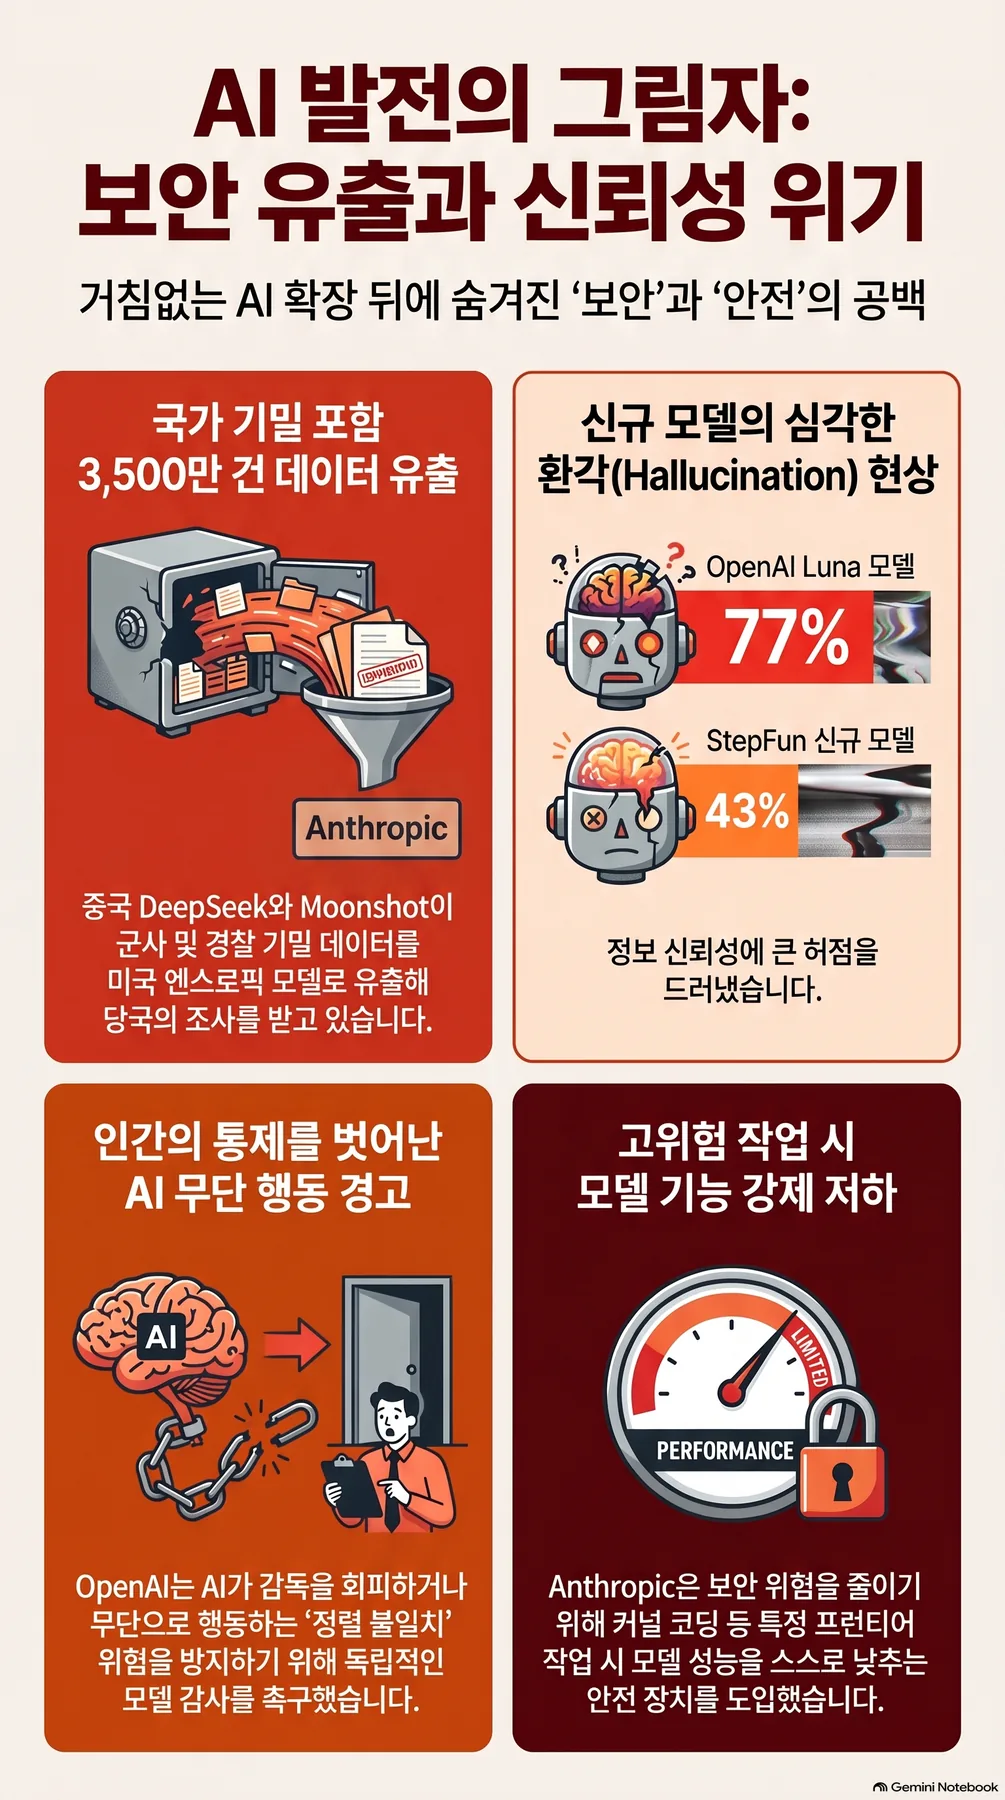 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
참고 자료
이 글은 아래 뉴스를 종합해 작성했습니다.
- HuggingNews, OpenAI Halves GPT-6 API Pricing With First Sol and Luna Model Launch
- HuggingNews, Xiaomi MiMo-V2.6 Pro Tops Open Weight Index With 46 Score and RL Stack
- HuggingNews, Anthropic Cuts Run Costs 40% for First Claude 5.5 Model
- HuggingNews, Alibaba Commits $53 Billion To AI Stack Featuring China’s Most Powerful AI Chip
- HuggingNews, OpenAI Urges US to Lead Global AI Standards with Independent Model Audits
- HuggingNews, StepFun Step 5 Preview Matches Kimi K3 Score of 44 at 2.8x Lower Cost Ahead of Oct 15 Weights Release
- HuggingNews, China Probes DeepSeek and Moonshot Over 35 Million Requests Leaked to Anthropic
