27B 모델 하나로 답변 생성과 근거 판단을 같이 돌렸습니다: 마지막 4개 층만 갈라지는 공유 백본
검색 기반 에이전트를 운영하면 큰 모델이 두 번 필요해 보입니다. 하나는 답을 쓰고 다른 하나는 찾은 문서만으로 답해도 되는지 판단합니다. 저희 판단 모델은 원본 27B 모델의 앞쪽 44개 층을 그대로 쓰기 때문에, 두 모델을 따로 올리면 같은 계산을 두 번 하는 셈입니다.
그래서 27B 모델을 한 번만 올리고 같은 서빙 엔진에서 두 일을 함께 처리했습니다. 답변 생성은 원본 엔진을 반복 실행할 때 생기는 차이 이상으로 흔들리지 않았고 근거 판단 256건은 전용 판단 엔진과 하나도 다르지 않았습니다. 사내 모델 서빙 비용을 고민하는 분, 그리고 서빙 엔진에 기능을 덧붙이다 결과가 미묘하게 달라진 경험이 있는 분께 이 글을 권합니다.
 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
식당 주방을 떠올려 보겠습니다. 손님 주문이 두 종류 들어옵니다. 하나는 요리를 내 달라는 주문이고 다른 하나는 이 재료로 요리를 내도 되는지 검수해 달라는 주문입니다.
두 주문의 재료 손질은 거의 같습니다. 씻고 썰고 밑간을 하는 과정이 똑같습니다. 다른 것은 마지막 조리대에서 무엇을 하느냐뿐입니다. 그런데 지금까지는 손질 담당을 두 팀 두고 같은 일을 두 번 시켰습니다.
저희가 바꾼 것은 손질을 한 팀에 맡기고 검수 주문만 마지막 조리대 직전에 옆 조리대로 넘기는 구조입니다. 조건은 하나입니다. 요리 주문의 맛이 예전과 같아야 합니다. 같은 요리사가 같은 레시피로 두 번 만들 때 생기는 소금 한 알 정도의 차이는 허용하지만 그 이상 달라지면 안 됩니다.
NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
무엇을 해봤나
갈라지는 지점
기반 모델은 Qwen3.8-27B이고 서빙 엔진은 vLLM 0.28.0입니다. 근거 판단 모델은 이전 글에서 소개한 판정표로, 원본 0~43층을 그대로 쓰고 44~47층에만 작은 LoRA를 붙였습니다. 그러니 0~43층 계산은 생성과 판단이 완전히 같습니다.
판단 요청은 44층 입구에서 중간값을 복사해 옆 가지로 갑니다. 생성 요청은 원본 경로를 그대로 지나갑니다. GPU 1장에 27B 가중치는 한 번만 올라갑니다.
엔진은 하나이고 요청이 한 묶음으로 섞여 들어옵니다. 판단 요청은 정해진 문장 형식으로 끝나므로 엔진이 이를 보고 가지로 보냅니다. 판단 결과는 세 행동의 점수로 돌아오고 기존 판정표와 같은 문턱값으로 행동을 고릅니다.
판정 규칙을 먼저 정했습니다
결과를 보기 전에 판정 규칙을 문서로 고정했습니다. 생성 요청 64개를 원본 엔진과 공유 엔진에서 각각 돌리고 토큰이 하나라도 다르게 나온 요청 수를 셉니다. 이것을 원본 엔진을 두 번 돌렸을 때의 차이와 비교합니다. 공유 엔진의 차이가 원본의 반복 차이보다 많지 않아야 통과입니다.
처음에는 원본과 토큰 하나까지 똑같아야 통과로 하려 했습니다. 그런데 원본 엔진도 같은 입력을 두 번 넣으면 어떤 날은 0건, 어떤 날은 1건이 달랐습니다. 원본조차 못 지키는 기준으로는 판정할 수 없으므로, 그 기준은 판정 불능으로 남기고 반복 차이를 기준선으로 삼았습니다.
판단 요청을 섞었을 때 생성이 흔들리는지도 따로 봤습니다. 가지가 없는 엔진에서도 요청을 섞으면 묶음 구성이 달라져 차이가 생깁니다. 그래서 가지가 없는 엔진의 차이를 기준선으로 두고 그보다 더 흔들리는지만 봤습니다.
나온 결과
두 번 실패하고 세 번째에 통과했습니다
같은 규칙으로 세 번 판정했고 앞의 두 번은 실패했습니다. 실패 결과도 원장에 그대로 남겼습니다.
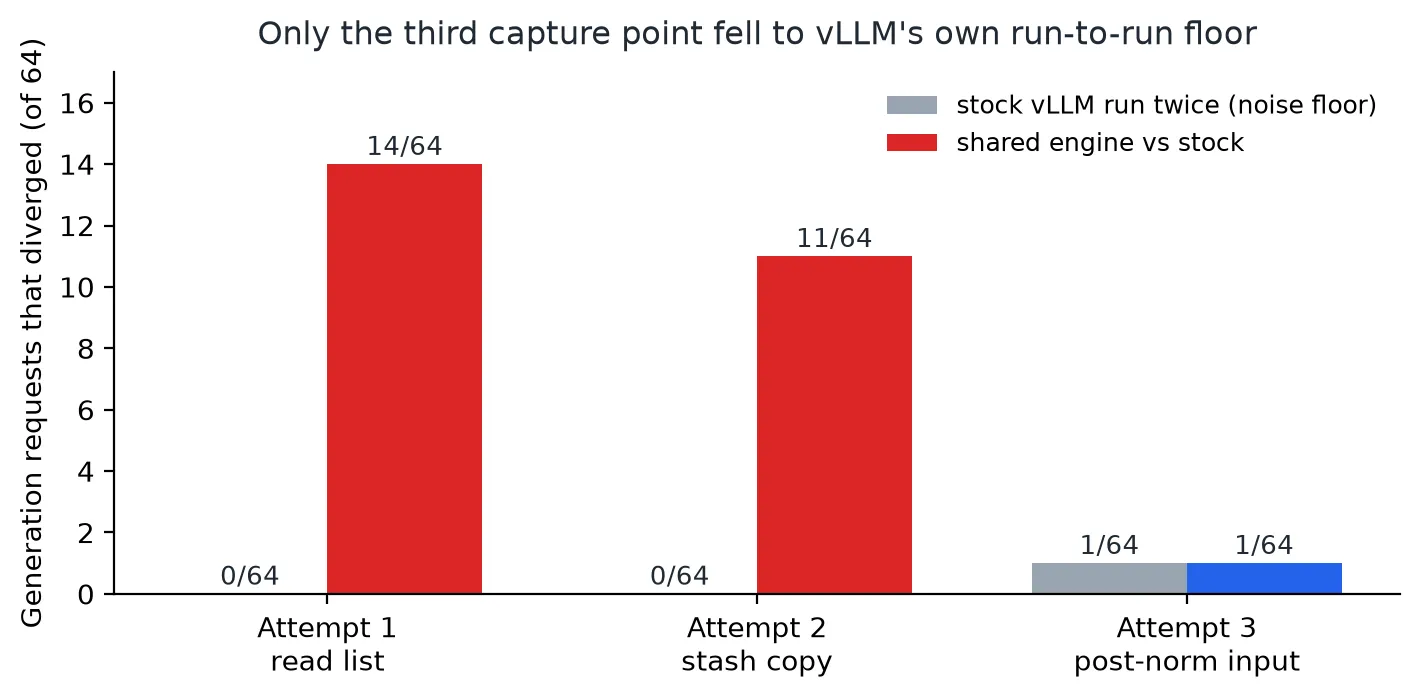 회색은 같은 실행에서 원본 엔진을 두 번 돌렸을 때의 차이, 색 막대는 공유 엔진과 원본의 차이입니다. 64개 생성 요청 기준, H200 1장, vLLM 0.28.0.
1차에서는 44층 중간값을 엔진이 원래 제공하는 방식으로 꺼냈습니다. 원본 반복 차이는 0건인데 공유 엔진은 14건이 달랐습니다. 2차에서는 중간값을 별도 버퍼에 복사하는 방식으로 바꿨지만 11건이었습니다.
원인을 나눠 보려고 진단 실행을 따로 했습니다. 가지를 끈 채 같은 코드로 돌리면 원본과 다른 요청이 한 건도 없었습니다. 반면 중간값을 꺼내기만 하고 가지 계산은 하지 않아도 13건이 달랐습니다. 가지 계산이 아니라 중간값을 읽는 행위 자체가 생성을 흔들었습니다.
유력한 설명은 컴파일러입니다. vLLM은 여러 연산을 하나로 묶어 빠르게 실행합니다. 그 한가운데에서 값을 꺼내면 묶는 방식이 달라지고 bf16 반올림이 일어나는 지점도 바뀝니다. 다만 커널이 실제로 어떻게 묶였는지 직접 확인하지는 않았으므로 아직은 가설입니다.
3차에서는 꺼내는 지점을 옮겼습니다. 44층 정규화 연산의 입력은 원래도 메모리에 따로 만들어지는 값이라, 거기서 복사하면 묶음을 건드리지 않을 것이라고 봤습니다. 정규화는 가지 쪽에서 다시 계산합니다. 결과는 64건 중 1건이었고 같은 실행에서 원본 반복 차이도 1건이었습니다. 두 1건은 같은 요청의 같은 22번째 토큰이었습니다.
즉, 사람 말로는 공유 엔진이 원본 엔진과 다른 정도가 원본 엔진이 자기 자신과 다른 정도와 같아졌습니다.
판단은 전용 엔진과 같았습니다
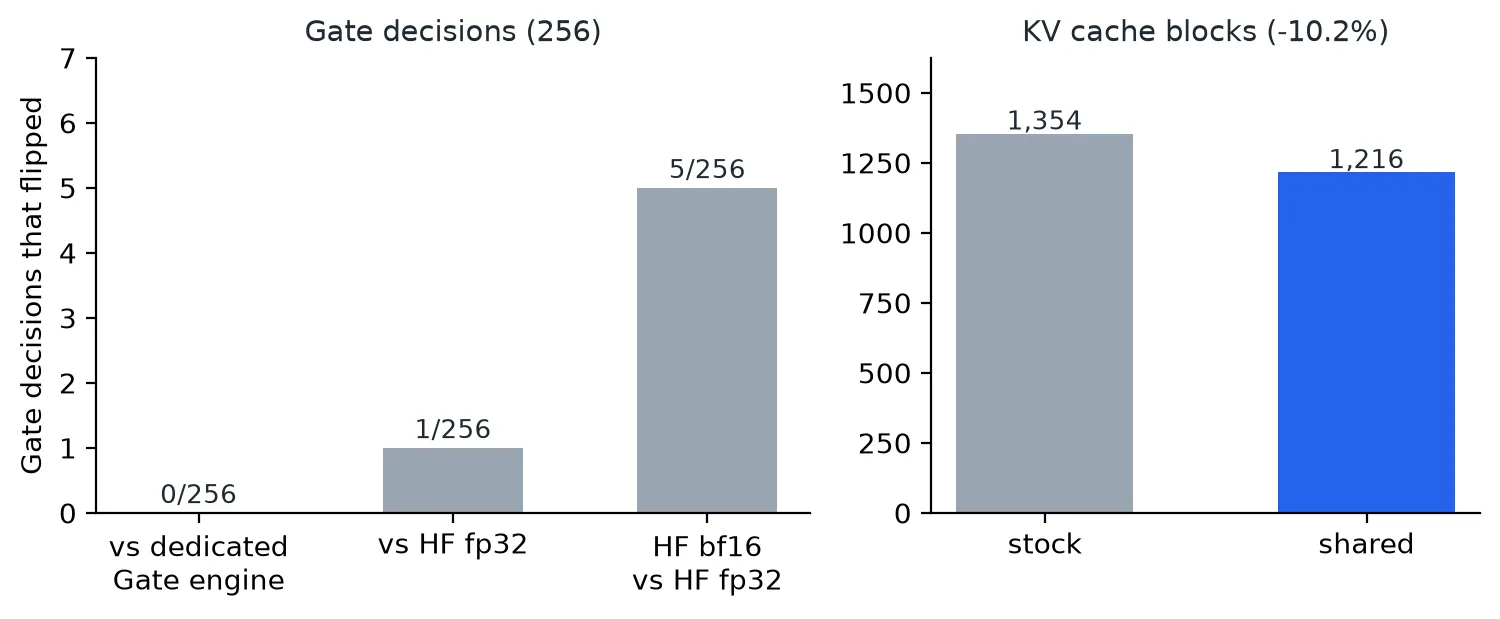 판단 비교 기준은 전용 판단 엔진, HF fp32, 그리고 참고용 HF bf16과 HF fp32의 차이입니다. KV 블록은 같은 메모리 설정(0.85)에서 엔진이 잡은 수입니다.
판단 요청 256건을 공유 엔진에 넣고 기존 전용 판단 엔진과 비교했습니다. 행동이 뒤집힌 경우는 0건이었고 확률 차이는 최대 0.02였습니다. 32비트 기준 구현과 비교하면 1건이 뒤집혔는데 16비트 구현끼리 비교해도 5건이 뒤집히는 수준이라 수치 정밀도 범위 안입니다.
판단 요청을 섞었을 때 생성이 흔들리는 정도도 기준선 안이었습니다. 가지가 있는 엔진은 64건 중 2건, 가지가 없는 엔진은 3건이 달라졌습니다.
대가는 KV 캐시입니다
공짜는 아니었습니다. 같은 메모리 설정에서 KV 캐시 블록이 1,354개에서 1,216개로 10.2% 줄었습니다. 가지용 층과 복사 버퍼가 자리를 차지하기 때문입니다. 동시에 처리할 수 있는 긴 대화 수가 그만큼 줄어든다는 뜻입니다.
그래서 무엇을 바꾸면 되나
판단 모델이 원본의 앞부분을 그대로 쓴다면 별도 엔진을 띄우기 전에 한 엔진 안의 가지로 만들 수 있는지 먼저 보시기 바랍니다. 같은 가중치를 두 번 올리지 않아도 되고 판단 요청이 없을 때 판단용 엔진이 놀고 있는 일도 없습니다.
서빙 엔진 안에서 중간값을 꺼내는 기능을 만든다면 꺼내는 지점부터 신중히 고르셔야 합니다. 같은 값이라도 컴파일된 연산 묶음의 한가운데에서 읽으면 결과가 바뀔 수 있습니다. 저희 경우 정규화 연산의 입력처럼 원래 따로 만들어지는 값에서 읽자 문제가 사라졌습니다.
검증 기준은 원본 엔진의 반복 차이로 잡는 편이 현실적입니다. 토큰 하나까지 같아야 한다는 기준은 깔끔해 보이지만 원본도 지키지 못하면 아무것도 판정할 수 없습니다. 그리고 그 기준선은 실행마다 0건이기도 1건이기도 하므로 같은 실행 안에서 함께 재야 합니다.
ThakiCloud에서는 이 구조를 Paxis 에이전트가 검색 결과로 답할지 정하는 단계에 쓰려고 합니다. Metis 추론 엔드포인트 하나에서 답변과 판단을 함께 처리하면 에이전트 한 단계마다 GPU를 하나 더 붙이지 않아도 됩니다.
NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
못 믿을 부분
먼저 이번 검증은 기능 검증입니다. 같은 엔진에서 둘 다 처리된다는 것과 결과가 유지된다는 것을 확인했을 뿐입니다. 처리량, 지연, GPU 비용 절감은 재지 않았습니다. 장시간 운영과 최대 메모리 사용량도 확인하지 않았습니다.
둘째, 범위가 좁습니다. 생성 요청은 64개, 판단 요청은 256개였고 GPU 1장에서 한 가지 설정으로만 돌렸습니다. 판단 모델은 공개한 네 시드 중 한 시드만 검증했습니다.
셋째, 토큰 단위 완전 일치는 판정 불능입니다. 원본 엔진도 반복 실행에서 1건이 달랐기 때문에, 공유 엔진이 원본과 비트 단위로 같은지는 이 환경에서 말할 수 없습니다. 실패 원인으로 든 컴파일러 설명도 직접 확인한 것이 아니라 가장 그럴듯한 설명입니다.
넷째, 아직 서비스 형태가 아닙니다. 생성과 판단을 HTTP API 두 개로 열고 재시작 뒤 복구까지 확인하는 배포 검증은 진행 중입니다. 서빙 코드와 통합 패키지도 그 검증이 끝난 뒤 공개할 예정이며 판단 모델 가중치는 Hugging Face의 ECP-Q12-27B-Research-Preview에 있습니다.
이 글의 수치는 저희 H200 GPU에서 실제로 잰 값이며 연구 원장에 기록된 결과만 인용했습니다.