Mirai Labs의 uzu, Apple Silicon에서 llama.cpp보다 4배 빠른 로컬 LLM 추론
왜 읽어야 하나
맥에서 로컬 LLM을 돌리거나, 온프렘·엣지에 작은 모델을 배치하는 플랫폼 엔지니어라면 이 글을 읽어야 합니다. 핵심 결론을 먼저 적습니다. 로컬 추론의 병목은 칩이 아니라 디코딩 구조였습니다. Mirai Labs가 오픈소스로 내놓은 uzu는 패스당 여러 토큰을 한꺼번에 검증하는 트리 추측 디코딩으로, base M5 MacBook Pro(유니파이드 메모리 16GB)에서 Qwen3.5 9B를 llama.cpp 22.0 t/s, MLX 25.1 t/s에 비해 92.1 t/s로 실행합니다. 공식 발표 벤치마크 기준 약 4.2배입니다.
개요
Mirai Labs(trymirai)는 10월 27일경 오픈소스 인퍼런스 엔진 uzu를 공개했습니다. MIT 라이선스이고 핵심은 Rust로 작성된 엔진에 Metal 커널을 얹은 구조입니다. Swift(SPM), Python(PyPI), TypeScript(NPM), Rust 네 방향의 바인딩을 함께 내고 OpenAI 호환 HTTP 서버 모드를 기본으로 갖춥니다. 모델 체크포인트는 자사 포맷으로 4-bit 양자화해 함께 배포하며 예컨대 trymirai/Qwen3.5-9B-M 같은 이름을 씁니다.
화제의 중심은 숫자입니다. 공개와 함께 돌린 벤치마크에서 base M5 MacBook Pro(16GB)의 Qwen3.5 9B 추론 속도가 llama.cpp와 MLX의 약 4배로 나왔기 때문입니다. 두 엔진 모두 동일한 하드웨어 위에서 메모리 대역폭 상한에 붙어 있는 상태에서, uzu만 그 상한을 넘었습니다.
Mirai Labs의 포지셔닝도 여기서 나옵니다. 온디바이스 AI를 응답 지연 제로, 데이터 프라이버시, 인퍼런스 비용 제로로 앞세우는 방향이고 그 전면에 Apple Silicon을 놓습니다. MacBook뿐 아니라 iPhone·iPad를 포함한 애플 하드웨어 전체가 대상이며 webgpu 백엔드로 브라우저 경로도 열려 있습니다. “클라우드에 못 올리는 데이터를 로컬에서 추론한다”는 시나리오의 엔진 후보로 올라온 것입니다.
이 기술은 무엇인가
먼저 맥락을 세웁니다. 로컬 추론의 속도가 이슈가 된 이유는, 모델이 로컬에 머물러도 워크로드가 더 이상 “한 번의 질문”이 아니게 됐기 때문입니다. 코딩 에이전트 한 세션은 파일 읽기, 코드 생성, 테스트 실행, 결과 해석을 반복하며 수십에서 수백 번의 추론 호출을 합산합니다. 이 구간에서 t/s가 2배가 되면 같은 작업을 마치는 시간도 절반이 됩니다. 로컬 하드웨어의 추론 속도는 이제 편의 기능이 아니라 에이전트 실행 비용의 단위가 됐습니다.
기준선은 여기서 시작합니다. 자기회귀 디코딩에서는 토큰 하나를 내는 데마다 전체 가중치를 메모리에서 읽습니다. base M5의 메모리 대역폭이 153 GB/s이고 4-bit Qwen3.5 9B 체크포인트가 5.2GB라면 이론 상한은 153을 5.2로 나눈 약 29 t/s입니다. llama.cpp가 22.0, MLX가 25.1로 이 상한 바로 아래에 붙어 있는 것은 우연이 아닙니다. 두 엔진 모두 이 구조의 한계에 근접해 있는 것으로 봐야 합니다.
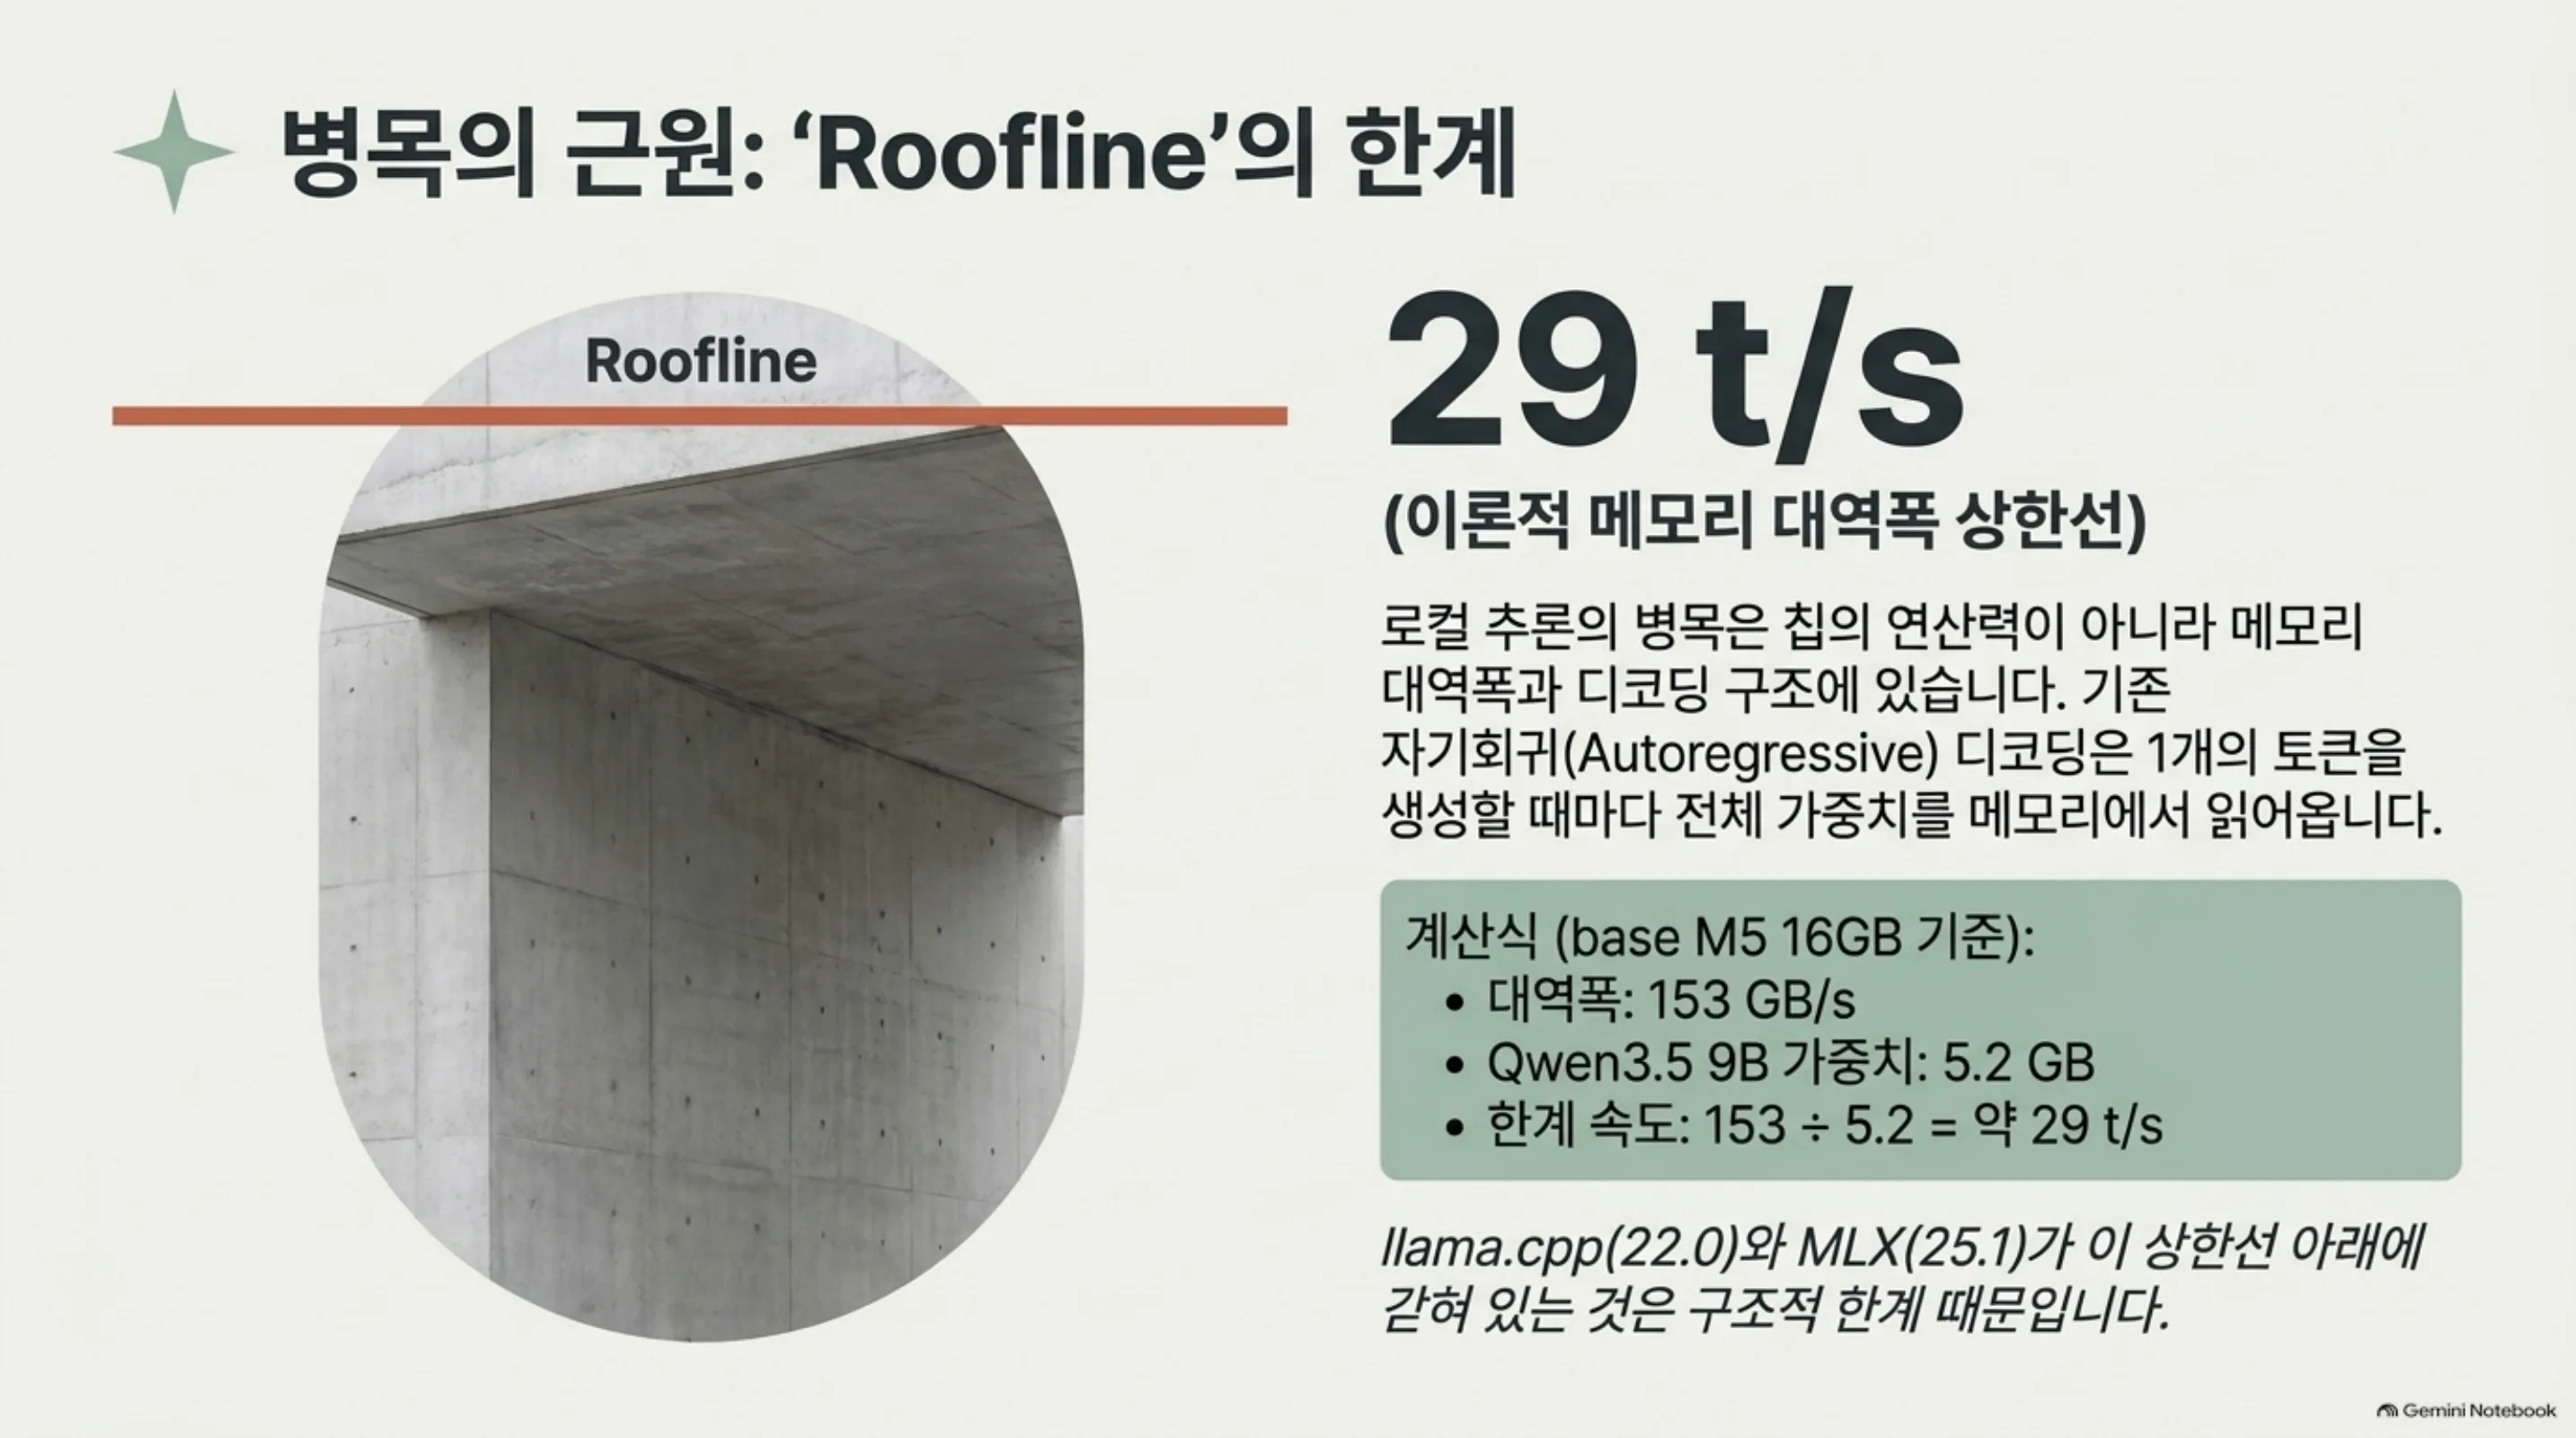
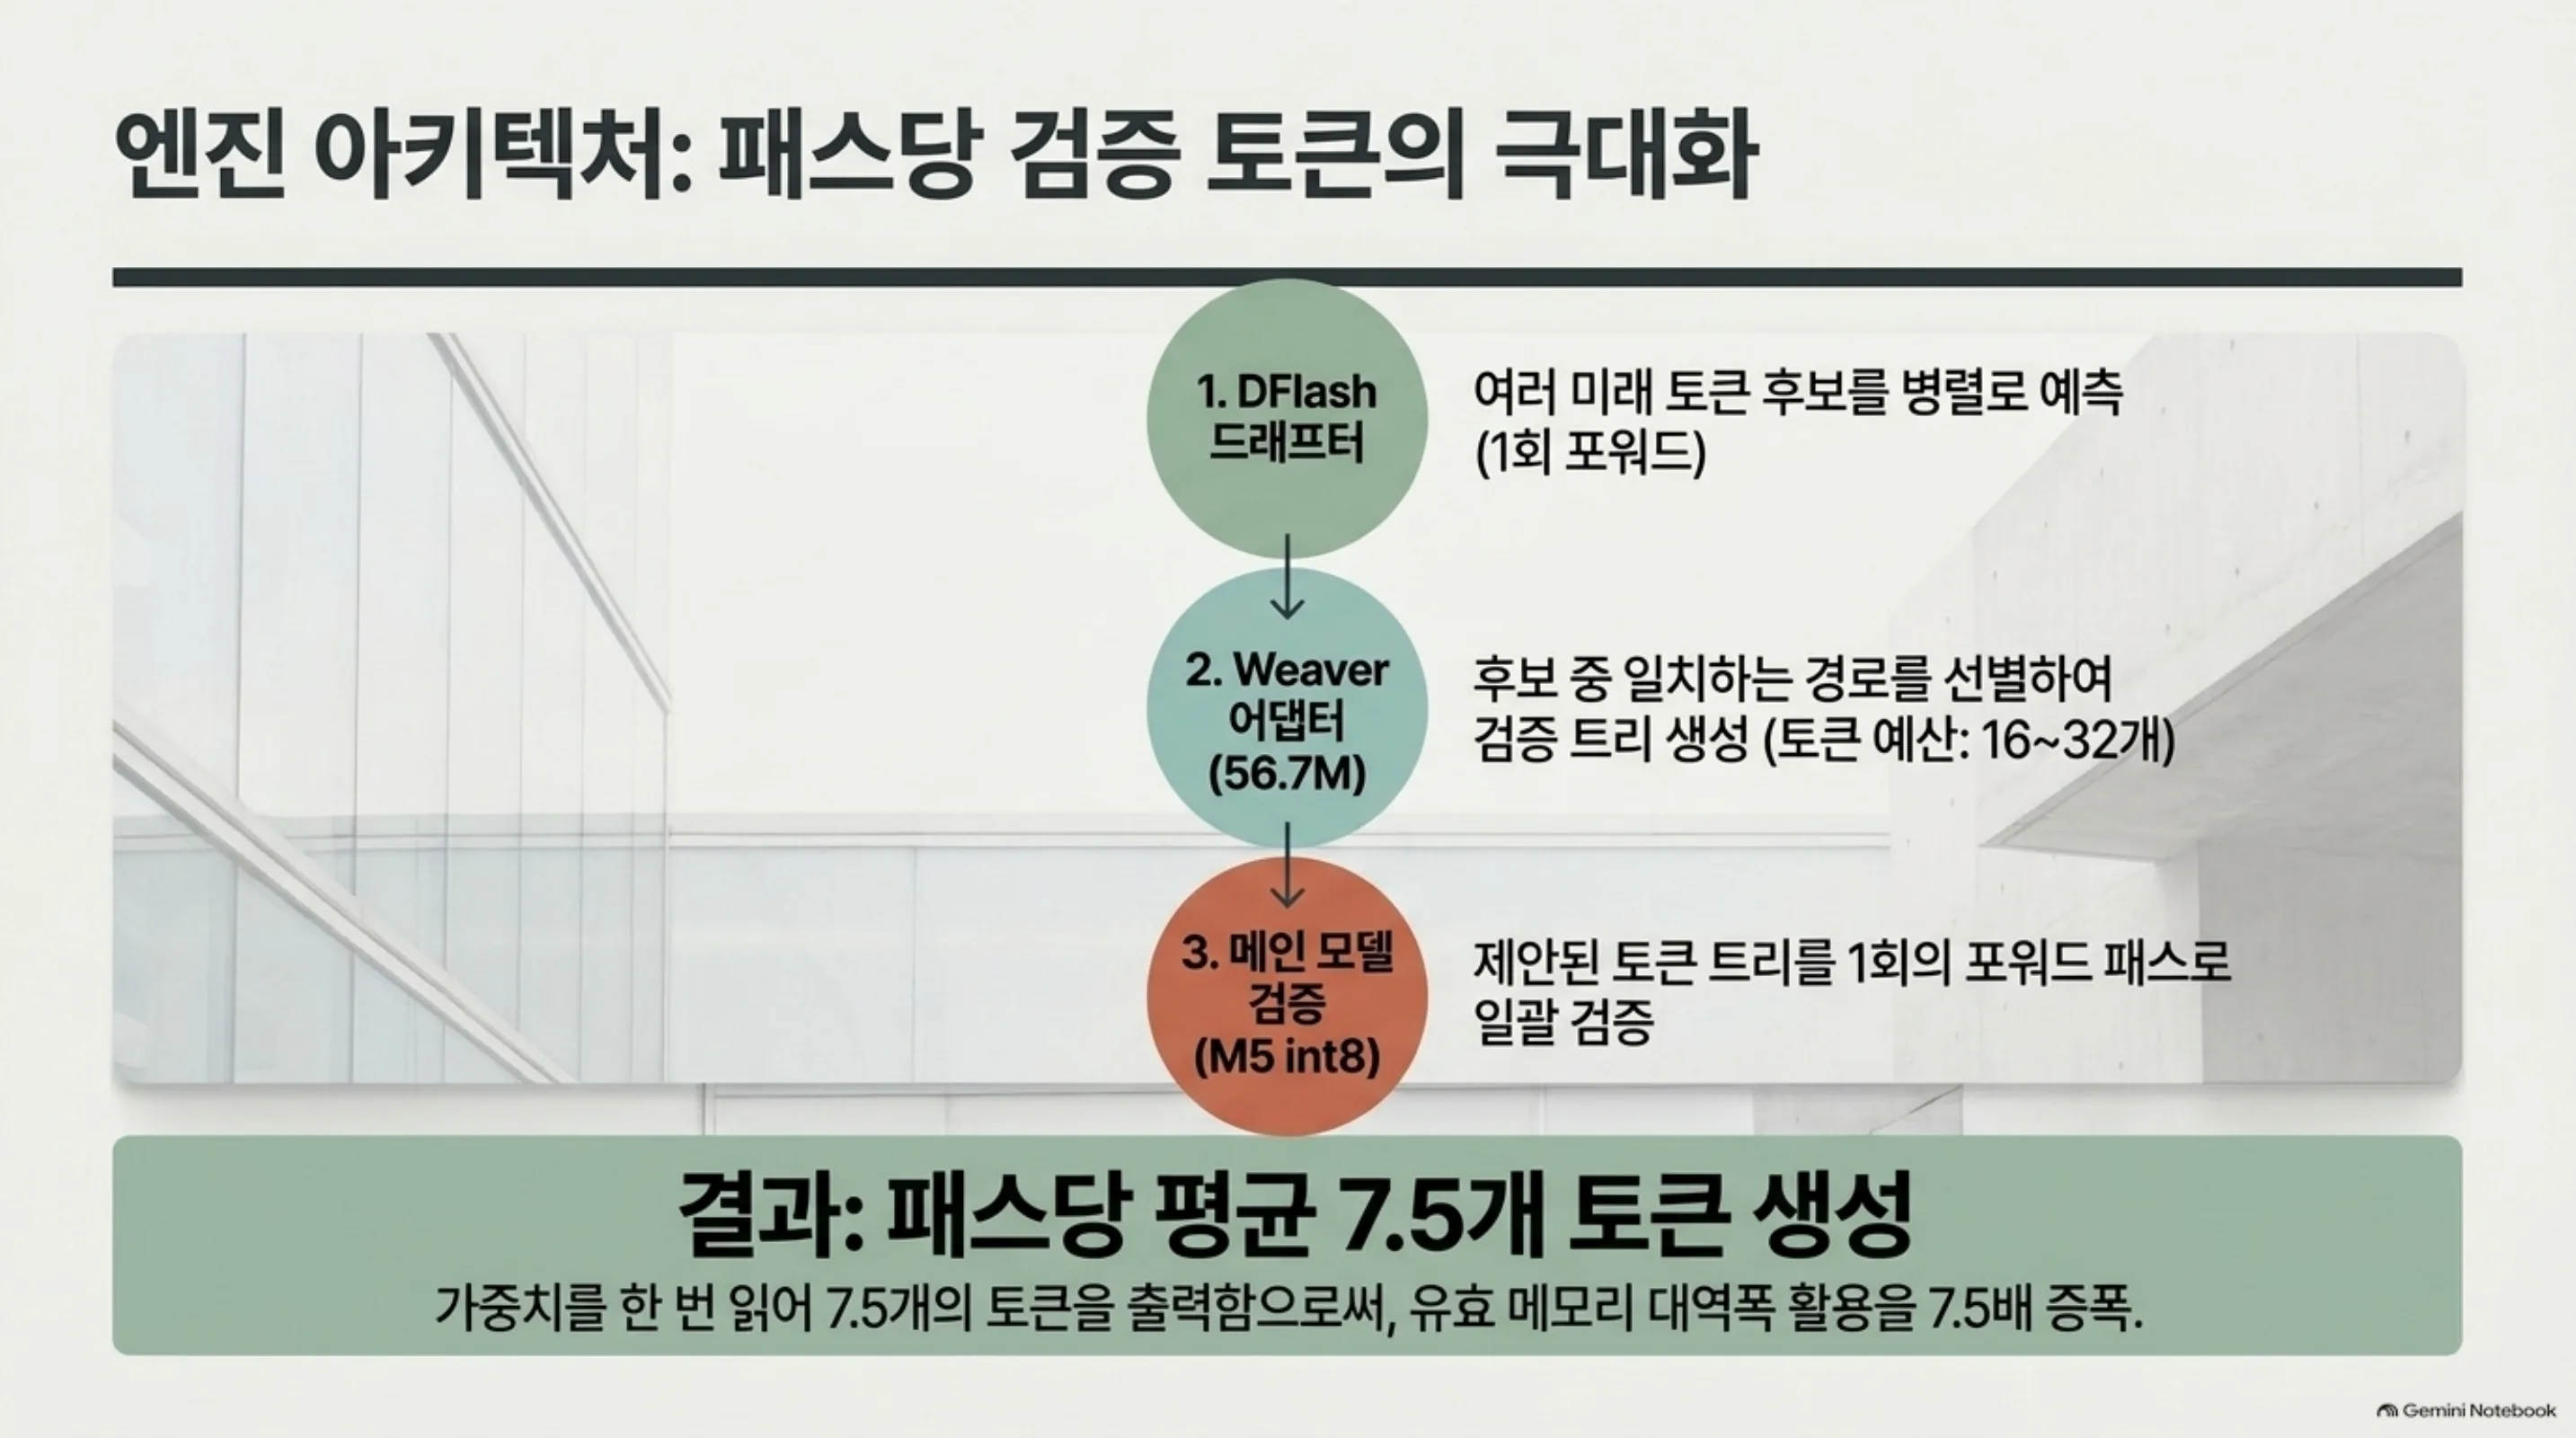
uzu가 이 상한을 넘는 방식은 패스당 내는 토큰 수를 늘리는 것입니다. 구조는 세 부분으로 나뉩니다.
첫째, DFlash 드래프터입니다. 작은 드래프트 모델이 다음에 올 여러 미래 토큰 후보를 병렬로 예측합니다. 한 번의 포워드로 한 줄의 후보 경로를 뽑습니다.
둘째, Weaver 어댑터입니다. 56.7M 파라미터의 자기회귀 어댑터가 그 후보 목록에서 서로 일치하는 경로를 골라 검증 트리를 만듭니다. 트리 예산은 16에서 32개 토큰입니다.
셋째, 메인 모델의 1회 검증입니다. Qwen3.5 9B 본체가 제안된 토큰 트리를 한 번의 포워드 패스로 검증하는데 이 단계가 M5의 하드웨어 가속 int8 매트릭스 경로로 실행됩니다. 검증이 통과한 토큰은 패스당 평균 7.5개(보고된 구간은 7.5에서 9.6)가 나갑니다.
계산은 단순해집니다. 가중치 5.2GB를 읽는 비용은 패스당 한 번인데 그 패스가 7.5개 토큰을 내면 유효 대역폭 활용은 자기회귀 대비 7.5배로 커집니다. roofline의 약 29 t/s 상한은 패스당 1개 토큰을 전제로 한 수치이고, uzu가 그 전제를 깨는 것입니다. 공식 발표 기준 uzu는 표준 자기회귀 디코딩 대비 4.37배, 최적화한 DFlash 베이스라인 대비 24.7퍼센트 빠르게 측정되었습니다.
한계선을 계산하면 구조가 더 명확해집니다. 패스당 7.5개 토큰을 전제로 하면 이론 상한은 약 29 t/s의 7.5배, 200 t/s 넘게까지 열립니다. 실측 92.1 t/s는 그 이론의 절반 미만이고 차이는 검증 자체의 비용입니다. 드래프터와 Weaver의 포워드는 물론, 메인 모델이 트리를 한 번에 검증할 때 후보 토큰 수만큼 늘어나는 계산과 메모리 트래픽이 실립니다. 즉 uzu는 대역폭 상한을 없앤 것이 아니라 상한을 7.5배로 끌어올린 뒤 그 안에서 검증 비용을 치르는 엔진입니다. 패스당 수락 토큰이 7.5에서 9.6으로 클수록 이론 상한에 가까워지고 반대로 내용이 예측하기 어려우면 수락률이 떨어져 자기회귀 수준까지 내려올 수 있습니다.
같은 계열의 llama.cpp MTP 모드가 밀리는 이유는 무엇일까요. MTP는 한 번에 3, 4개 토큰만 드래프트하는 좁은 트리를 씁니다. uzu의 16에서 32개 예산과 비교하면 패스당 기대 토큰 수가 다릅니다.
참고로 Qwen3.5와 Qwen3.6은 Gated DeltaNet이라는 상태 유지 레이어를 포함하는데 9B 모델의 32개 레이어 중 24개가 이 타입입니다. 상태가 붙은 레이어를 패스당 여러 토큰 검증 구조와 함께 처리하는 것도 이 엔진이 설계한 구간입니다.
체크포인트 양자화도 구체적입니다. Medium(M) 체크포인트는 가중치를 4-bit 비대칭 정수 양자화로 저장하고 실행 중 액티베이션은 8-bit 대칭으로 바뀝니다. 블록은 32개 원소 묶음입니다. L(Large) 체크포인트도 같은 체계로 나옵니다.
설치 및 통합
README에 명시된 설치 경로는 아래 네 가지입니다.
# Python
uv add uzu==0.6.13

# Swift (SPM)
.package(url: "https://github.com/trymirai/uzu.git", from: "0.6.13")

# TypeScript (NPM)
pnpm add @trymirai/uzu@0.6.13

# CLI (Rust)
cargo run --release -p cli
Python 최소 예시는 엔진을 만들고 모델을 내려받은 뒤 채팅 세션을 여는 것입니다.
engine = await Engine.create(engine_config)
model = await engine.model("alibaba:qwen3.5:0.8b:mirai:mirai-m:4")
session = await engine.chat(model, ChatConfig.create())
replies = await session.reply(messages, ChatReplyConfig.create())
OpenAI 호환 서버 모드는 별도 설정 없이 올립니다.
cargo run --release -p cli -- server --model trymirai/Qwen3.5-4B-M
# 127.0.0.1:8000, POST /v1/chat/completions, GET /v1/models
백엔드는 metal, webgpu, cpu 세 가지로 나옵니다. 애플 계열 하드웨어가 주 타깃이고 webgpu와 cpu는 일부 경로가 진행 중입니다.
모델 카탈로그는 벤더:모델:크기:계열:양자 레벨 같은 주소 체계를 씁니다. alibaba:qwen3.5:0.8b:mirai:mirai-m:4처럼 벤더, 모델, 파라미터 규모, 체크포인트 계열, 양자 레벨이 한 줄에 붙습니다. 엔진은 해당 주소를 받아 체크포인트를 내려받고 로드합니다. README에 명시된 또 다른 기능은 추적 가능한 계산입니다. 추론 결과를 원 모델 구현과 대조해 검증하는 경로인데, 자사 양자화 체크포인트를 쓴 경우 “원본과 같은 답을 내는지”를 확인하는 데 쓰는 도구입니다.
직접 재현은 끝까지 가지 못했습니다. 격리 실험 환경을 만들고 공유 가상 환경에 패키지를 설치하는 단계에서, 이번 작성 환경의 보안 설정이 설치 명령을 차단해서 라이브 벤치마크는 확보하지 못했습니다. 그 기록은 실험 결과 섹션에 그대로 옮깁니다. 이 글의 모든 수치는 공식 발표에서 검증한 것입니다.
실제 실험 결과
공식 발표가 측정한 구간은 base M5 MacBook Pro(16GB, macOS 26.6.2), Qwen3.5 9B 4-bit, 컨텍스트 8192입니다. 프롬프트는 “정렬된 두 리스트를 합치는 python 함수를 쓰시오”였다고 합니다. 세 엔진을 8000, 8001, 8002 포트에 각각 열고 같은 조건으로 실행했습니다.
| 엔진 | 체크포인트 · 모드 | Qwen3.5 9B t/s |
|---|---|---|
| uzu | trymirai/Qwen3.5-9B-M (4-bit) | 92.1 |
| MLX | mlx-community/Qwen3.5-9B-4bit | 25.1 |
| llama.cpp | unsloth Q4_K_S + draft-mtp 3 | 22.0 |
| roofline 이론 상한 | 153 GB/s ÷ 5.2 GB | 약 29 |
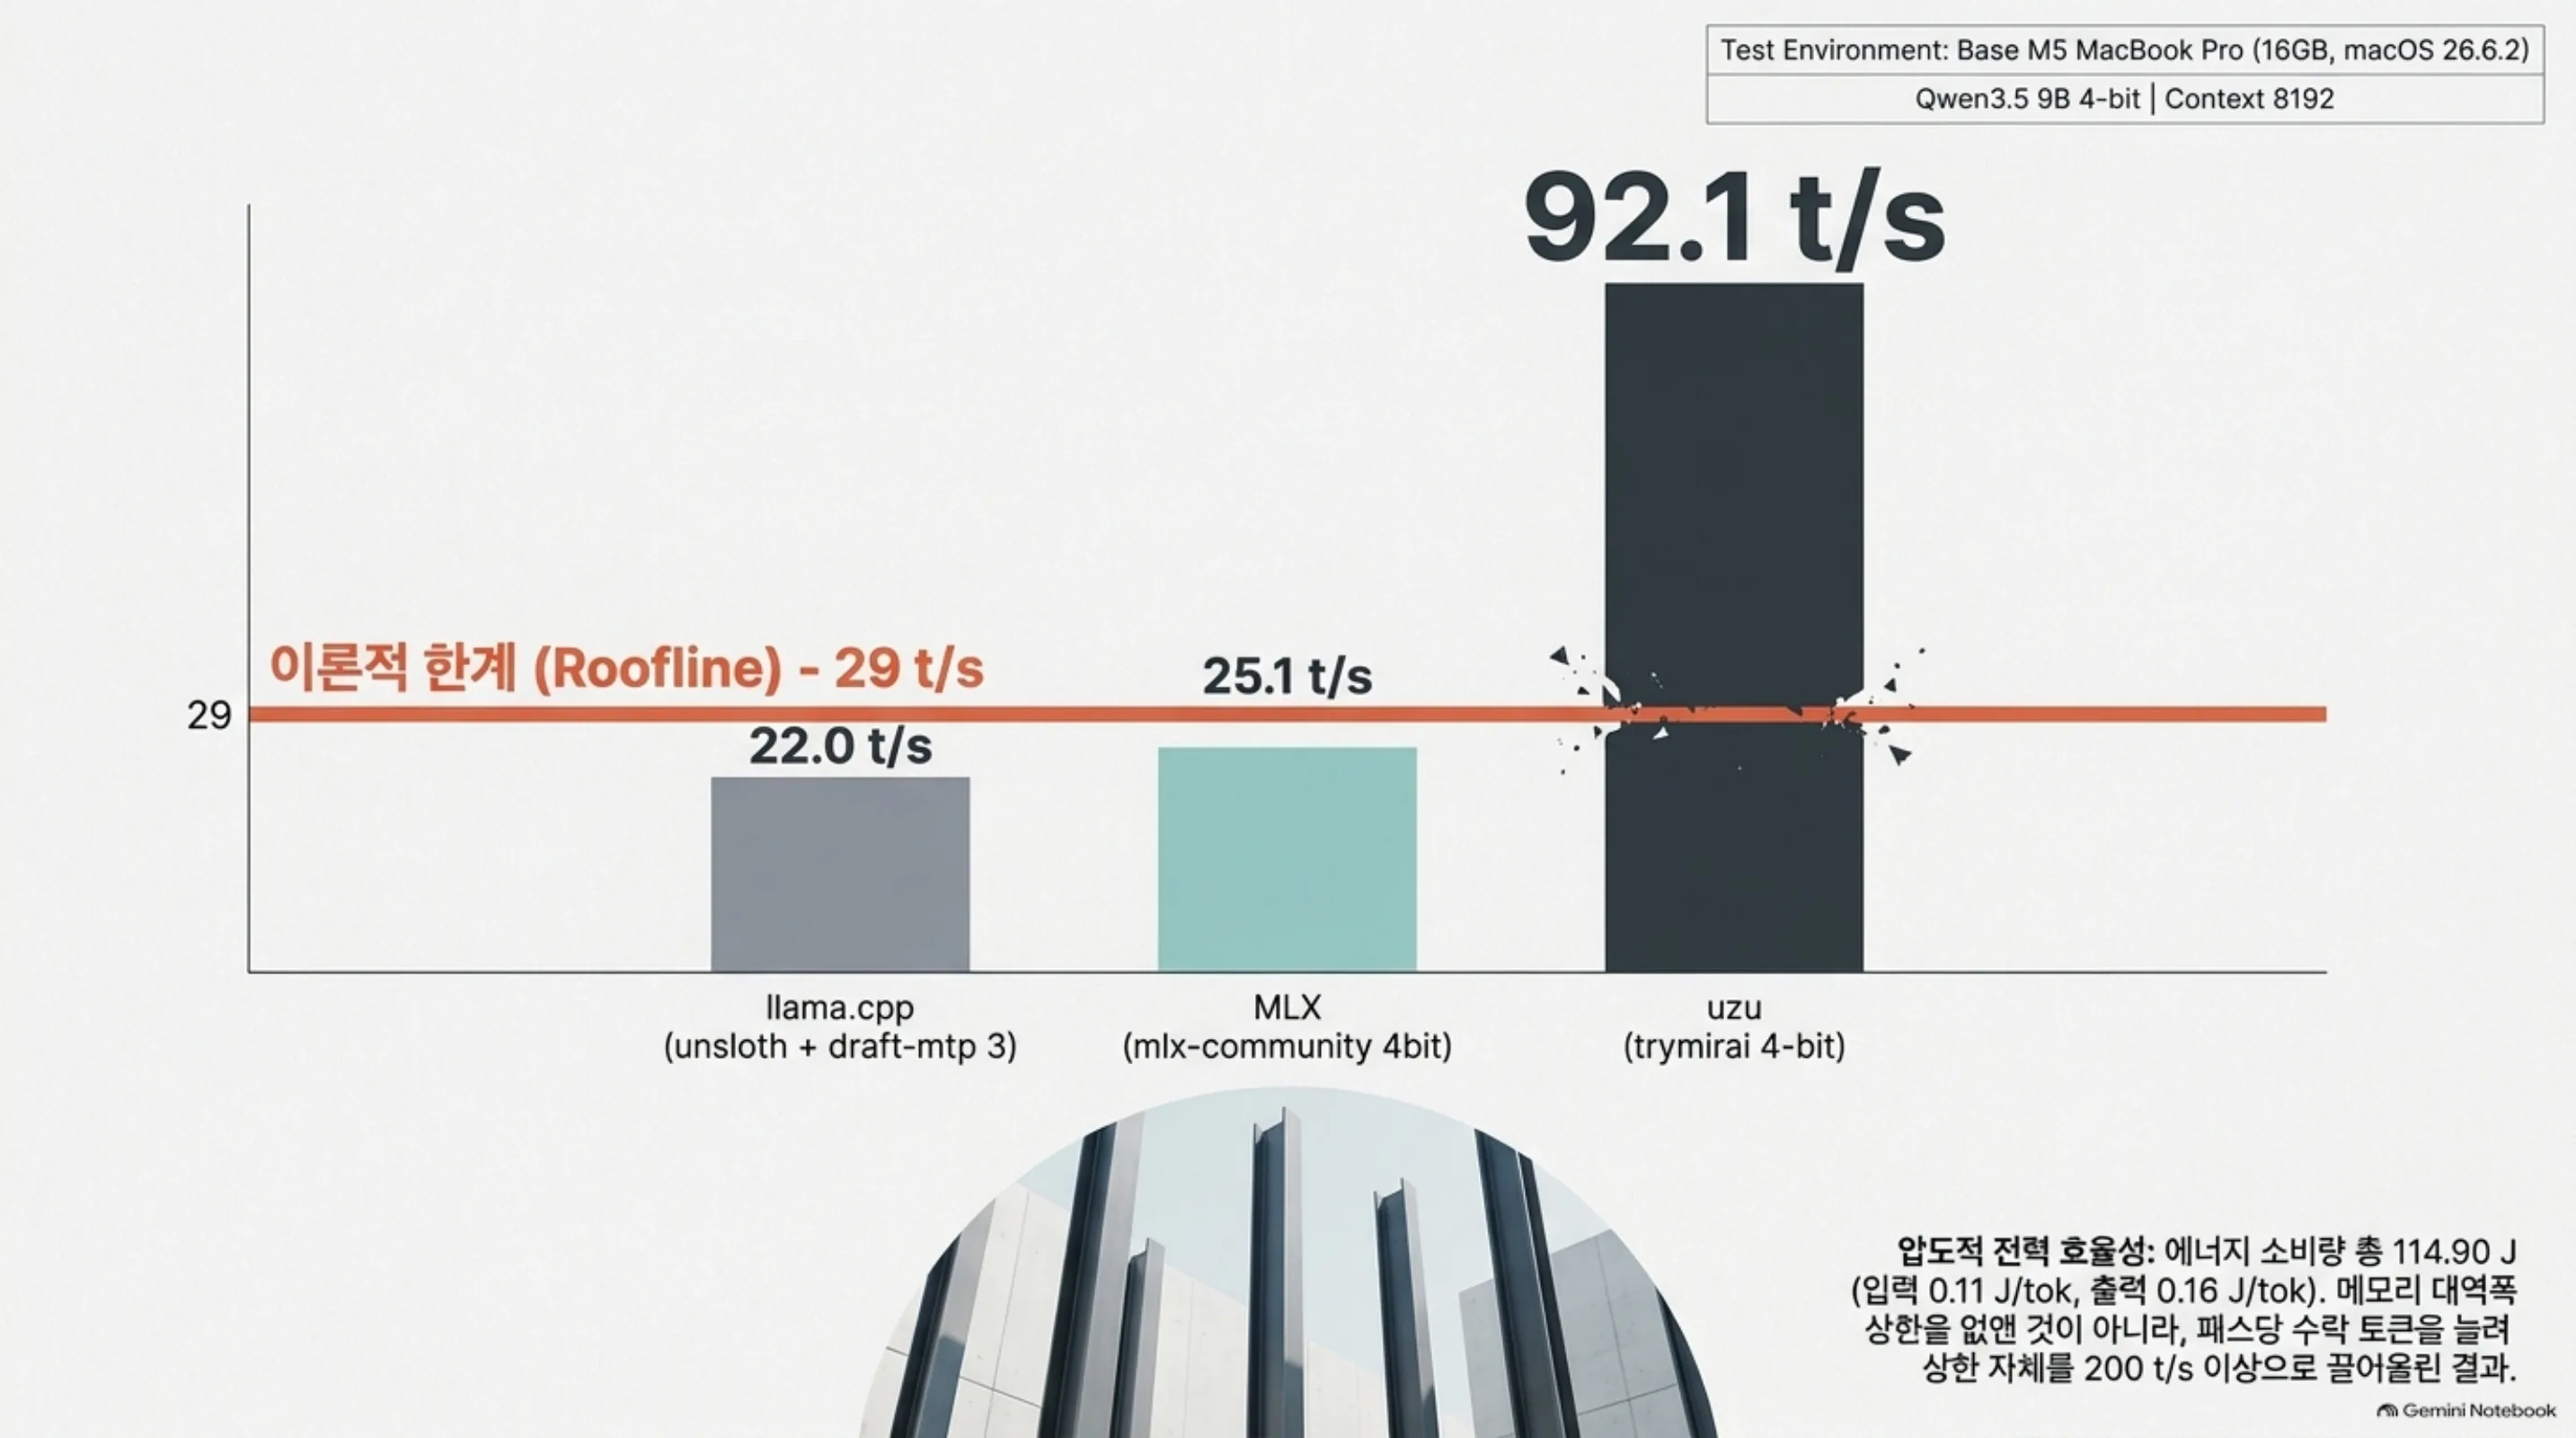
uzu 측 상세 수치도 발표에 적혀 있습니다. 첫 토큰까지 0.12초, 프리필 161.11 t/s, 생성 98.10 t/s, 포워드 패스당 8.39개 토큰, 메모리 5.77GB, 총 에너지 114.90 J(입력 0.11 J/tok, 출력 0.16 J/tok), 전체 구간 7.36초입니다. 16GB 머신에서 9B 모델을 5.8GB 정도로 담고 이 속도를 낸다는 것이, 메모리 대역폭이 아니라 패스당 토큰 수가 병목이었다는 논증을 숫자로 보여 줍니다.
모델을 키우면 어떤 결과가 나올까요. Qwen3.6 27B(체크포인트 15.6GB)를 M5 Max 128GB에서 돌린 결과 uzu는 114 t/s, MTP를 쓴 llama.cpp(MTPLX)는 35.54 t/s로 3.2배 차이가났습니다. 큰 모델에서도 구조적 우위가 유지되는 쪽으로 나온 것입니다.
에너지 수치도 함께 발표됐습니다. 같은 구간에서 총 114.90 J, 입력 토큰당 0.11 J, 출력 토큰당 0.16 J입니다. 배터리로 돌아가는 기기에서 로컬 추론을 계산할 때 t/s와 함께 보는 두 번째 수치입니다.
재현 기록을 그대로 남깁니다. 재현 시도 중 실패: 작성 환경의 보안 설정이 패키지 설치 명령(uv pip install, pip install)을 차단했고 이 환경에서는 설치 승인을 받을 경로가 없었습니다. 설치 전 가상 환경 확인 결과 uzu 패키지는 이미 존재하지도 않았습니다. 그래서 이번 글은 라이브 벤치마크 없이 공식 발표 수치를 출처와 함께 인용하는 형식으로 끝냅니다.
ThakiCloud 제품 적용 시사점
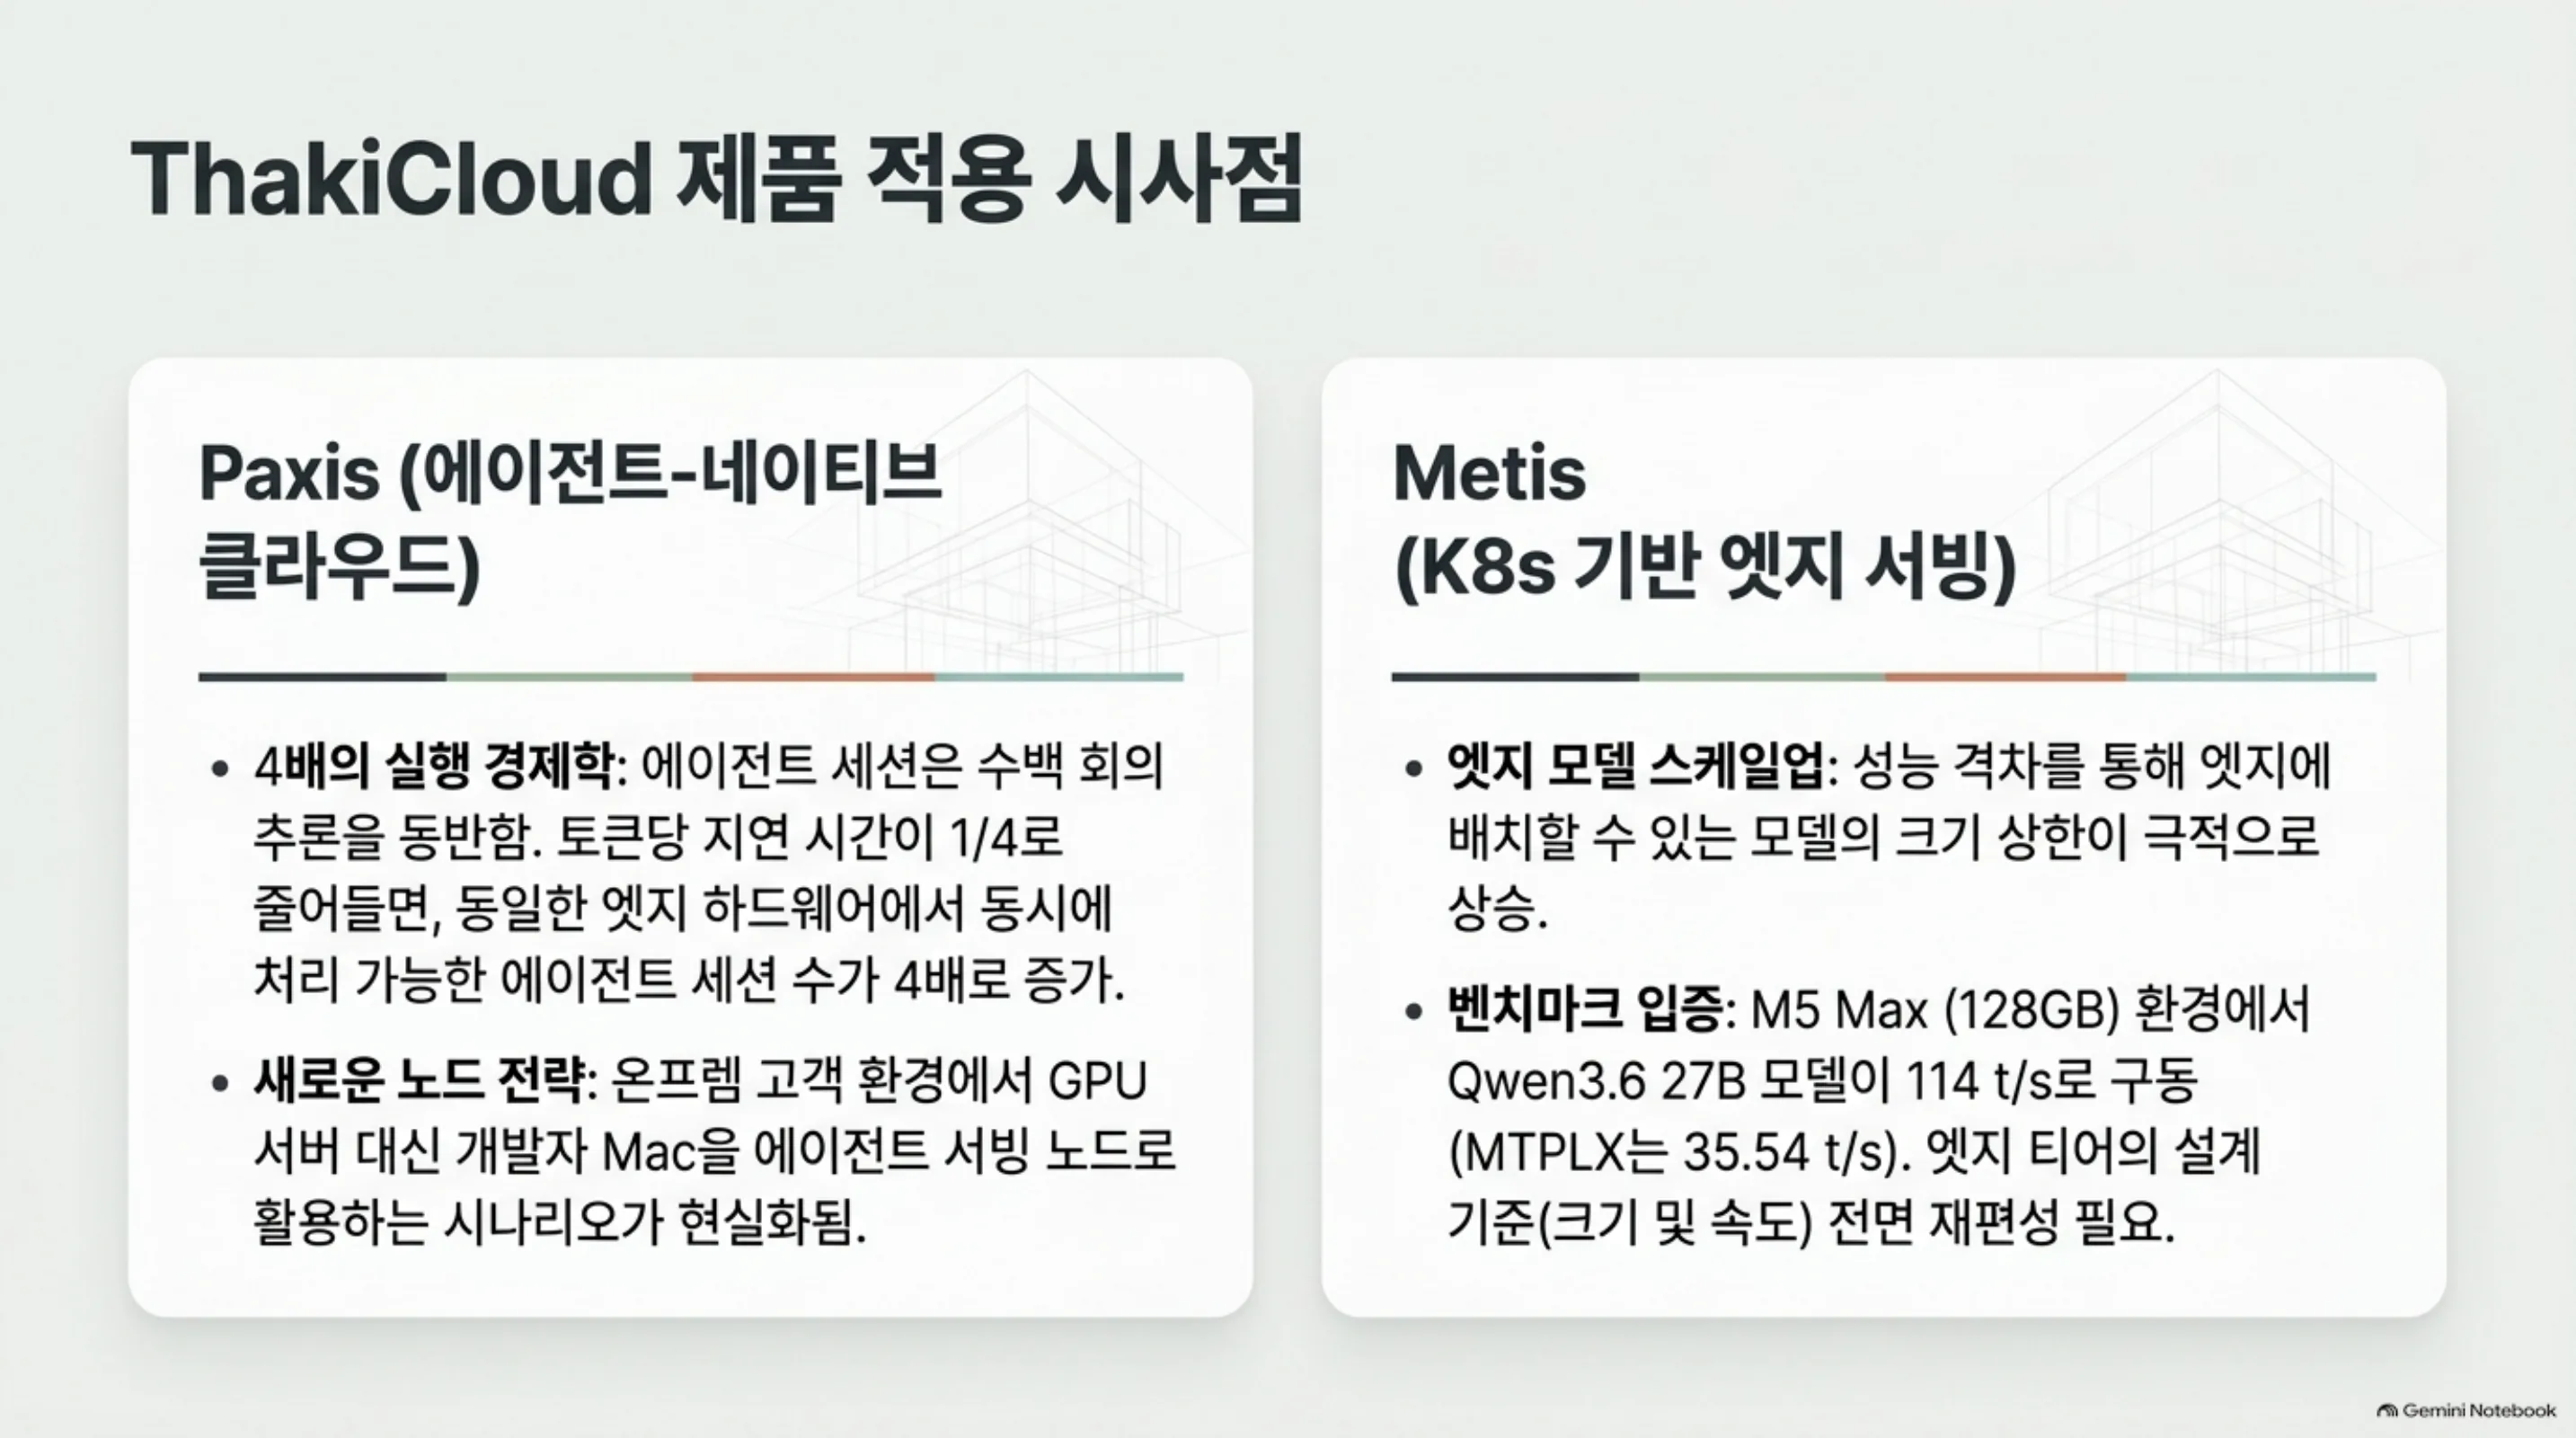
이 결과가 다키클라우드 제품에서 만나는 지점은 두 곳입니다.
첫째, Paxis(에이전트-네이티브 클라우드)의 실행 경제학입니다. Paxis는 에이전트 워크로드를 격리 샌드박스에서 돌리는데 에이전트 한 세션은 수백에서 수천 회의 추론 호출을 합산합니다. 그 호출의 단위가 되는 토큰당 지연이 4배로 줄면 같은 엣지 하드웨어에서 돌아가는 에이전트 세션 수도 4배로 늘 수 있는 구조입니다. 온프렘 고객 환경에서 “GPU 서버 대신 개발자 맥”이 에이전트 서빙 노드가 되는 시나리오에 이 엔진은 현실적인 옵션이 됩니다.
둘째, Metis(K8s 기반 모델 서빙)의 온프렘·엣지 배치입니다. Metis는 클러스터 GPU에서 모델을 서빙하는 구조이고 애플 실리콘 엣지 노드는 그 클러스터 바깥의 또 다른 서빙 지점입니다. 로컬 추론 엔진의 성능 격차가 4배 수준이면 엣지에 배치할 모델 크기의 상한이 올라갑니다. base M5(16GB)에서 9B가 92 t/s로 움직이고 M5 Max(128GB)에서 27B가 114 t/s로 움직인다는 것은 엣지 하드웨어 세대 안에서 배치할 수 있는 모델 크기와 속도가 함께 열린다는 뜻입니다. Metis의 온프렘 고객이 엣지 티어를 설계할 때, “얼마나 큰 모델을 어디까지 내릴 수 있는가”의 답을 다시 쓰게 됩니다.
한계 및 반론
숫자의 출처를 먼저 짚습니다. 이 벤치마크를 돌린 쪽이 엔진 제조사(Mirai Labs)입니다. llama.cpp나 MLX 쪽에서 같은 조건·같은 프롬프트로 재확인한 독립 벤치마크는 이 시점에서 공개된 것이 없고 llama.cpp 커뮤니티 논의에 언급이 있을 뿐입니다. 제조사 발표라는 점을 잊지 말아야 합니다.
두째, 측정 구간이 좁습니다. 컨텍스트 8192, 짧은 코딩 프롬프트 하나, 단일 실행입니다. 장문 컨텍스트, 동시 요청, 대화 유지 구간에서 4배가 그대로 유지되는지는 발표에 없습니다. roofline 논증도 패스당 토큰 수가 안정적으로 7.5 이상이어야 성립하는데 모델이나 워크로드가 바뀌면 수락률이 달라집니다.
셋째, 메모리 비용이 붙습니다. 검증 트리는 후보 토큰 16에서 32개 분기의 상태를 한 패스에 담아 두고 드래프터와 Weaver의 계산도 실립니다. 9B 본체 5.77GB에 이 구조가 붙어도 16GB에 들어갔지만 모델이 커지거나 컨텍스트가 길어지면 트리 예산과 메모리 여력의 균형은 다시 계산해야 합니다. 발표는 8192 컨텍스트 기준이므로 장문 구간 메모리 행동은 별도로 봐야 합니다.
넷째, 대상 모델이 Qwen3.5·Qwen3.6 계열에 맞춰져 있습니다. DFlash 드래프터와 Weaver 어댑터가 이 계열의 Gated DeltaNet 구조를 전제로 설계되었고 자사 4-bit 체크포인트와 짝을 이룹니다. 다른 모델에 적용할 때 같은 구조가 얼마나 옮겨 가는지 즉 드래프터와 어댑터를 어떻게 준비하는지 문서는 아직 구체적으로 답하지 않습니다.
다섯째, 체크포인트 포맷이 자사 전용입니다. 4-bit M·L 체크포인트는 Mirai의 포맷으로 나옵니다. GGUF나 MLX 포맷의 기존 모델을 그대로 쓰는 것이 아니라 자사 카탈로그의 체크포인트를 내려받아야 합니다. 모델을 바꾸면 검증 트리 설계와 양자 설정을 다시 맞출 수 있는지가 핵심이고 이 유연성은 문서가 아직 짧게 다룹니다.
여섯째, 하드웨어 범위입니다. base M5, M5 Pro, M5 Max 실측과 M1부터 M4까지 동작을 발표했지만 세대별 수치는 base M5 하나뿐입니다. int8 매트릭스 경로가 M5 계열 하드웨어 가속을 전제로 한 만큼 이전 세대 성능은 별도로 확인해야 합니다.
정리
로컬 LLM 추론에서 “이 칩에서는 최대 이 정도”라는 roofline을 계산해본 분이라면 이번 결과는 전제가 달라진 경우입니다. 패스당 1개 토큰을 전제로 한 대역폭 상한을 패스당 7.5개 토큰으로 깨면 base M5에서도 9B가 92 t/s로 움직입니다. 다음 행동은 단순합니다. 맥에서 로컬 추론을 돌리고 있다면 uzu를 한 번 세워 보세요. MIT 라이선스에 OpenAI 호환 서버, 자사 4-bit 체크포인트까지 갖춰 있으니 설치부터 벤치마크까지 하루 안에 결론을 낼 수 있습니다. 그리고 제조사 발표라는 점을 기억해 두세요. 독립 재현이 나오기 전까지는 4배라는 숫자를 설계 근거로는 쓰고, 의사결정 근거로는 신중히 쓰는 것이 정석입니다.
