말로 하는 예약·주문을 명령으로 읽는 두 모델, Voice2Policy v0.1을 공개합니다
동네 치과나 카페에 전화로 예약과 주문을 받는 음성 비서를 붙이려는 개발자께 드리는 글입니다. 손님의 말을 들은 시스템이 가장 먼저 답해야 할 질문은 “이 말이 무슨 명령인가”입니다. 예약인지, 주문인지, 방금 잡은 예약을 확정하는지, 아니면 그냥 질문인지를 가려야 합니다.
다키클라우드는 이 첫 판단만 맡는 작은 모델 두 개를 공개합니다. 하나는 받아 적은 글을 읽고, 다른 하나는 받아쓰기 없이 소리를 바로 읽습니다. 두 모델 모두 판단만 하고 무엇도 실행하지 않습니다.
먼저 분명히 해 둘 점이 있습니다. 소리를 바로 읽는 쪽은 연구용 alpha입니다. 같은 시험에서 “받아쓰기 뒤 글을 읽는” 저희 기준 경로가 더 정확하고 더 빨랐습니다. 그래서 이 모델은 제품용이 아니라 연구 결과로 내놓습니다.
두 모델의 이름은 Voice2Policy Text Router v0.1과 Voice2Policy Audio Reader v0.1-alpha입니다. 이 글에서는 줄여서 텍스트 라우터, 오디오 리더라고 부르겠습니다.
쉽게 말하면
가게 전화기 옆에 놓인 메모지를 떠올려 보시면 됩니다. 메모지에는 칸이 몇 개 있습니다. 예약인지 주문인지, 확정인지 취소인지, 손님이 시간이나 전화번호를 말했는지를 체크하는 칸입니다. 전화를 받은 직원은 이 칸만 표시합니다. 실제로 예약 장부에 적을지는 사장님이 메모지를 보고 정합니다.
텍스트 라우터는 받아 적은 통화 내용을 보고 메모지에 체크하는 직원입니다. 오디오 리더는 받아 적지 않고 들으면서 바로 체크하는 직원입니다. 두 직원 모두 장부에 손대지 않습니다. 장부에 쓰는 일은 뒤에 있는 정책 엔진, 곧 사장님 몫입니다.
이 분업이 Voice2Policy의 핵심입니다. 메모지 칸은 작고 정해져 있으니 작은 모델로도 채울 수 있습니다. 대신 메모지만 보고 장부를 고치면 어떻게 되겠습니까? 사고가 납니다.
Voice2Policy는 어떤 경로인가
Voice2Policy는 한국어 업무 음성 명령을 다루는 다키클라우드의 연구 경로입니다. 순서는 ASR, 텍스트 라우터, 이름 해석기, 도구 인자 검사, 정책 엔진입니다. 라우터가 메모지를 채우면 이름 해석기가 “스케일링”이 가게에 등록된 서비스인지 찾습니다. 인자 검사는 도구에 필요한 값이 다 있는지 봅니다. 마지막으로 정책 엔진이 실행할지, 되물을지, 직원에게 넘길지를 정합니다.
대상은 소상공인 11개 업종입니다. 의원, 카페, 음식점, 네일숍 같은 가게의 예약, 주문, 확정, 취소, 문의, 직원 연결 요청을 다룹니다.
텍스트 라우터: 0.84MB 메모지 직원
텍스트 라우터는 문자 n-gram TF-IDF와 로지스틱 회귀로 만든 분류기입니다. 신경망도, 언어 모델도, 음성 모델도 아닙니다. 파라미터는 104,603개이고 가중치 파일은 0.84MB입니다. 한 문장을 CPU에서 약 0.7ms에 처리합니다. 추론에는 numpy와 safetensors만 있으면 되고 pickle이나 scikit-learn은 필요 없습니다.
출력은 메모지 칸과 같습니다. intent는 업무 도구 요청(tool), 명령 아님(no_command), 직원 연결(delegate) 가운데 하나입니다. 도구 요청이면 action이 예약, 주문, 확정, 취소 가운데 하나로 나옵니다. kind는 확정하거나 취소할 대상이 예약인지 주문인지를 가리킵니다. slot_mentioned는 시간, 날짜, 전화번호를 말했는지를 뜻합니다.
tool_hint라는 칸도 있지만 이것을 바로 실행하면 안 됩니다. 등록된 메뉴 이름, 지금 대기 중인 항목, 도구의 필수 인자를 이 모델은 보지 못합니다. 그 판단은 뒤 단계가 맡습니다.
학습 데이터는 합성 업무 명령 10,682문장입니다. 언어 모델이 정형화된 명령 표현을 보고 문장을 썼습니다. 레이블은 언어 모델이 아니라 그 표현에서 규칙으로 계산했습니다. 고객 데이터, 녹음, 개인정보는 쓰지 않았고 데이터셋은 공개하지 않습니다. 학습은 CPU에서 11초 걸렸습니다.
공개 파일이 원래 scikit-learn 모델과 같은지도 확인했습니다. 5,613문장에서 명령 틀과 시간 언급 판단이 모두 같았습니다. 확률 값은 소수 넷째 자리 반올림만큼만 다릅니다.
숫자가 좋은 곳과 나쁜 곳
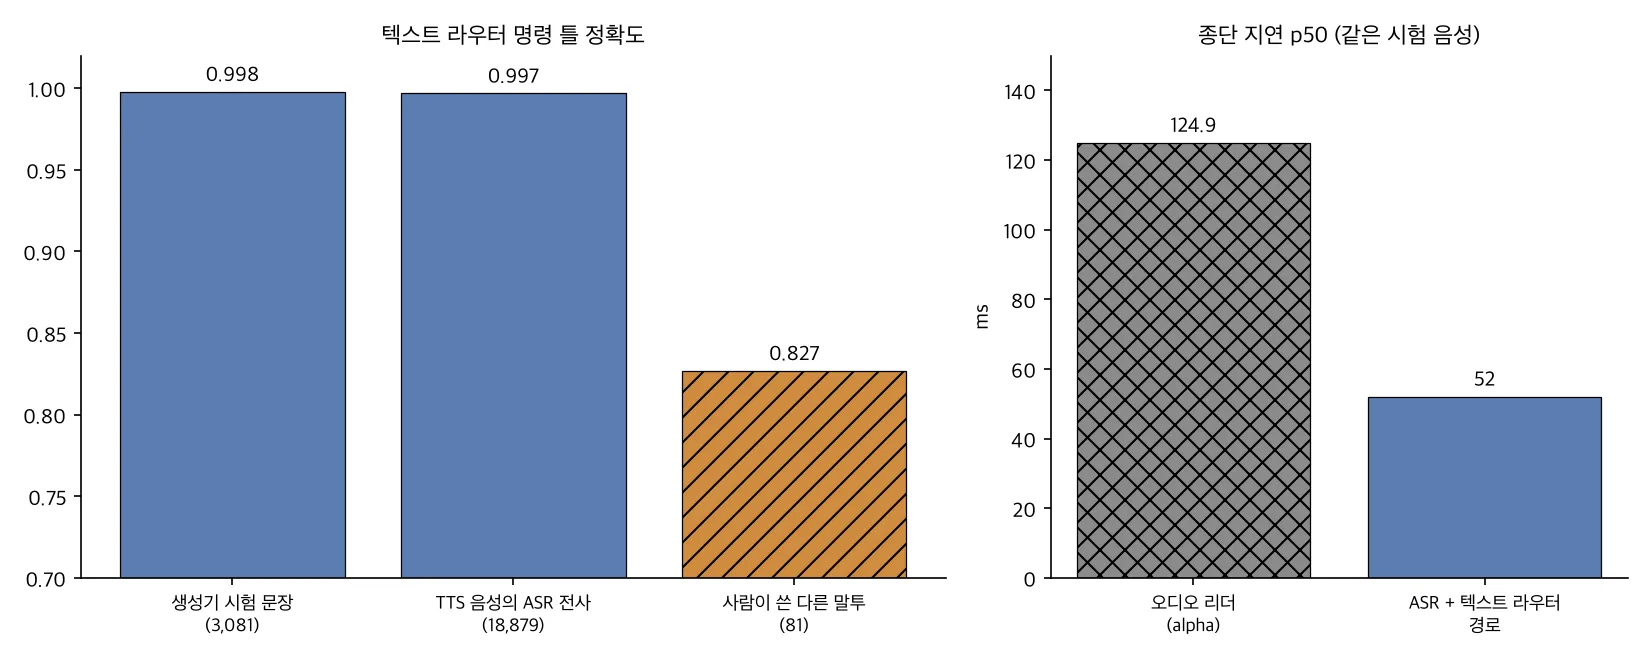 왼쪽 축은 0.70부터 시작합니다. 수치는 모두 두 모델 카드에 공개된 값입니다.
생성기가 만든 시험 문장 3,081개에서 명령 틀 정확도는 99.8%입니다. 같은 시험 문장을 TTS 음성으로 읽혀 ASR로 받아 적은 전사 18,879개에서도 99.7%입니다. 받아쓰기 오류가 섞여도 메모지 칸은 거의 그대로 채워졌습니다.
그렇다면 이 숫자를 그대로 믿어도 되겠습니까? 그렇지 않습니다. 두 숫자는 낙관적입니다. 시험 문장이 학습 문장과 같은 생성기에서 나와 말투를 공유하기 때문입니다. 다른 말투로 사람이 직접 쓴 81문장에서는 82.7%로 떨어집니다. 81문장이라 한 문장이 약 1.2%p에 해당하는 점도 감안해 주십시오.
자주 틀리는 유형은 세 가지입니다. 직원을 언급하지 않은 환불 요청을 명령 아님으로 읽습니다. “예약 취소하지 말아 주세요” 같은 부정 요청을 취소 자체로 읽습니다. “그거 해 주세요”처럼 지시어만 있으면 취소로 추측합니다. 글자 조각의 빈도만 보는 모델이라 부정이나 지시의 범위를 모릅니다.
이 빈틈은 정책 엔진이 메웁니다. 엔진은 도구 동사에 붙은 부정을 확인합니다. 확정이나 취소에는 그 동작을 말했다는 근거를 요구합니다. 직원 연결 신호도 따로 봅니다. 이 계층까지 거치면 같은 81문장에서 결정 76개가 맞고 위험한 실행은 없었습니다. 메모지 직원이 실수해도 사장님이 장부에 쓰기 전에 걸러 낸 셈입니다.
오디오 리더: 받아쓰지 않고 듣는 직원
오디오 리더는 ASR 없이 소리에서 바로 메모지를 채웁니다. 구조는 두 층입니다. 아래는 Google의 EmbeddingGemma 2 오디오 타워입니다. 304.8M 파라미터를 얼려 두고 12번째 층의 출력을 씁니다. 그 위에 저희가 학습한 3.47M 파라미터, 13.9MB짜리 작은 리더를 얹었습니다. 인코더는 저장소에 들어 있지 않고 원래 저장소의 고정된 리비전에서 받습니다.
리더는 메모지 칸 외에도 몇 가지를 더 냅니다. 동작이 얼마나 모호한지를 clear, ambiguous, nontool, neg_unsupported 확률로 줍니다. 가게의 등록 이름 후보를 함께 넘기면 어느 이름을 말했는지 자모 CTC 정렬로 찾습니다. 결과는 LINK, AMBIG, NONE 가운데 하나입니다. 보조 결정 칸(decision_aux)도 있지만 실행 허가가 아닙니다.
합성 음성 시험 18,879클립에서 의도와 동작 정확도는 99.6%, 시간 언급 정확도는 99.5%입니다. 업무 정책과 이름 연결까지 거친 결정과 도구 정확도는 98.9%입니다. 학습에 없던 TTS 엔진으로 만든 2,357클립에서는 95.9%로 내려갑니다. 등록 이름 연결은 이름이 들어 있는 5,941클립에서 98.8%입니다.
왜 alpha에 머물렀나
같은 클립에서 저희 기준 경로와 나란히 놓으면 이유가 보입니다. 기준 경로는 등록 이름을 문맥으로 넣은 Qwen3-ASR-1.7B, 텍스트 라우터, 이름 해석기, 정책 검사를 차례로 거칩니다.
| 같은 시험 클립 기준 | 오디오 리더 alpha | ASR + 텍스트 라우터 경로 |
|---|---|---|
| 결정 + 도구 정확도 | 98.9% | 99.4% |
| 실행하면 안 되는 클립에 실행 제안 | 108건 (8,721건 중 1.24%) | 0건 |
| 종단 지연 p50 | 124.9ms | 52ms |
오디오 리더 지연은 B200 한 장, 배치 1, PyTorch eager에서 특징 추출부터 이름 점수까지 잰 값입니다. p95는 215.2ms입니다. 받아쓰기를 생략했는데도 더 느렸고 더 부정확했습니다.
그렇다면 가장 무거운 숫자는 무엇이겠습니까? 실행 제안 108건입니다. 이 가운데 94건은 같은 원인입니다. 등록되지 않은 긴 이름 안에 등록된 짧은 이름이 들어 있으면 그 짧은 이름에 연결해 버립니다. 메모지 직원이 “치아 미백 패키지”를 듣고 등록된 “치아 미백”에 체크하는 식입니다. 뒤 단계 검사 없이는 쓰면 안 되는 이유입니다.
재현성도 확인했습니다. 공개 패키지로 고정 리비전의 인코더를 받아 300클립을 다시 돌렸습니다. 의도, 대상 종류, 시간 언급, 연결 이름이 300개 모두 원래 학습 결과와 같았습니다. 동작은 원래 경로처럼 업무 외 동작을 UNKNOWN으로 묶으면 같습니다. 다만 GPU 없이 8코어 CPU에서 돌리면 한 클립에 p50 7.3초가 걸립니다. 대화형으로 쓰시려면 GPU가 필요합니다.
Ko-Voice-Command-Reader와의 관계
10월 18일에 먼저 공개한 Ko-Voice-Command-Reader v0.1은 같은 계열의 형제 모델입니다. 같은 EmbeddingGemma 2 오디오 타워를 얼려 쓰고, 3.47M 파라미터의 4층 Transformer 리더와 자모 CTC 이름 연결을 씁니다. 다만 다루는 말이 다릅니다. Ko-Voice-Command-Reader는 “알파 노드”, “번역 서버” 같은 인프라 자원에 대한 명령을 24개 도구 체계로 읽습니다.
오디오 리더 alpha는 저희 인프라 명령 리더에서 출발해 인프라 명령과 소상공인 명령을 함께 학습했습니다. 그래서 출력 칸에 restart, scale 같은 인프라 동작이 아직 남아 있습니다. 인프라 명령 시험에서는 결정 정확도 89.4%, 이름 연결 81.6%였고 모호한 명령 6건을 실행했습니다.
두 카드를 나란히 읽으면 한 줄기가 보입니다. Ko-Voice-Command-Reader 카드는 한계로 “모호한 동작을 추측한다”를 적고, 다음 버전에 동작 모호성 칸을 더하겠다고 했습니다. 오디오 리더 alpha에는 그런 칸(action_ambiguity)이 들어 있습니다. 그래도 모호한 지시와 부정은 아직 믿을 만큼 다루지 못합니다.
직접 써 보기
텍스트 라우터는 설치가 가벼우니 먼저 시험해 보십시오.
pip install numpy safetensors huggingface_hub
from huggingface_hub import snapshot_download
import sys
d = snapshot_download("ThakiCloud/Voice2Policy-Text-Router-v0.1")
sys.path.insert(0, d)
from predict import TextRouter

r = TextRouter(d)
print(r.predict("내일 오후 세 시에 스케일링 예약해 주세요"))
# {'intent': 'tool', 'action': 'book', 'kind': None, 'frame_score': 0.9991, ..., 'slot_mentioned': True, 'slot_score': ..., 'tool_hint': 'update_slots'}
명령줄에서는 python predict.py "콜드브루 라떼 두 잔 주세요" --json으로 부를 수 있습니다.
오디오 리더는 16kHz 모노, 30초 이하 음성을 받습니다. 30초를 넘으면 특징 추출기가 조용히 잘라 내기 때문에 predict가 입력을 거부합니다.
pip install "transformers==5.19.0" "huggingface_hub>=1.0,<2.0" safetensors torch soundfile numpy
from huggingface_hub import snapshot_download
import sys, soundfile as sf
d = snapshot_download("ThakiCloud/Voice2Policy-Audio-Reader-v0.1-alpha")
sys.path.insert(0, d)
from v2p_audio import AudioReader

r = AudioReader(d)  # google/embeddinggemma-2 @ 914f7f8 인코더를 받습니다
wav, sr = sf.read("command.wav", dtype="float32")
print(r.predict(wav, candidate_names=["스케일링", "충치 치료", "치아 미백"]))
쓰기 전에 알아 둘 한계
두 모델 모두 합성 데이터로만 학습하고 평가했습니다. 텍스트 라우터는 실제 손님의 말투로 측정하지 않았습니다. 오디오 리더는 TTS 음성으로만 측정했고 실제 화자, 소음, 원거리 음성은 재지 않았습니다. 학습에 없던 TTS 엔진에서 이미 정확도가 내려가므로 실제 음성에서는 더 낮다고 보십시오.
텍스트 라우터의 점수는 정답일 확률로 보정되지 않았습니다. 한국어 소상공인 예약과 주문 어휘에 맞춰져 있어 다른 분야는 다시 학습해야 합니다. 오디오 리더는 단일 시드로 학습했고 출력은 예측일 뿐 실행 허가가 아닙니다.
라이선스도 다릅니다. 텍스트 라우터는 Apache-2.0입니다. 오디오 리더는 학습 음성인 Supertonic-3을 따라 BigScience Open RAIL-M이고 같은 용도 제한이 붙습니다. 평가에만 쓴 piper ko_KR-kss 음성은 공개하지 않습니다.
다키클라우드가 이 작업에서 본 것
Voice2Policy의 설계는 다키클라우드의 업무 자동화 플랫폼 Paxis가 따르는 원칙과 같습니다. 모델은 판단을 제안하고, 실행은 정책 게이트를 통과한 뒤에만 일어납니다. 81문장 결과가 그 이유를 보여 줍니다. 라우터 혼자서는 82.7%이지만 정책 계층을 더하면 위험한 실행이 없었습니다. 다만 두 모델은 아직 어떤 제품에도 통합되지 않았습니다.
오디오 리더에서 배운 것도 있습니다. 받아쓰기를 빼면 빨라질 것이라는 기대는 이번 측정에서 맞지 않았습니다. 작은 리더 아래 300M급 인코더가 놓이니 ASR 경로보다 느렸습니다. 소리에서 바로 이름을 연결하는 방식은 짧은 이름이 긴 이름에 숨어 있을 때 약했습니다. 그래서 같은 기능이라면 지금은 받아쓰기와 가벼운 라우터 조합을 권합니다.
공개한 것
| 저장소 | 상태 | 라이선스 |
|---|---|---|
| ThakiCloud/Voice2Policy-Text-Router-v0.1 | v0.1 | Apache-2.0 |
| ThakiCloud/Voice2Policy-Audio-Reader-v0.1-alpha | 연구용 alpha | Open RAIL-M |
| ThakiCloud/Ko-Voice-Command-Reader-v0.1 | v0.1 (10월 18일 공개) | Open RAIL-M |
세 저장소는 Ko-Voice-Command 컬렉션에 함께 묶여 있습니다. 소상공인 응대를 텍스트 대화로 다룬 MerchantDesk v0.1도 함께 보시면 좋습니다.
메모지 직원은 작아도 됩니다. 칸이 정해져 있고, 장부를 고치는 사람이 따로 있다면 말입니다.
수치 출처: 각 모델 카드(2026-10-24 기준)에 공개된 값만 인용했습니다. 모두 합성 데이터 기반 개발 비교이며 단일 학습 런 결과입니다.

