화장품 포장에서 제품명 고르기: 실사진 E2E F1 0.605, 검수 후보 모델을 공개했습니다
개념도입니다. 실제 화장품 포장이나 데이터셋 이미지가 아닙니다.
포장 사진에서 읽어 낸 글자 줄 가운데 어느 것이 제품명인지 자동으로 고르려는 분께 결론부터 드립니다. 실사진을 검출, OCR, 제품명 선택 순서로 끝까지 통과시킨 평가에서 배포용 작은 트리 모델은 F1 0.605(95% 신뢰구간 0.599~0.612)를 냈습니다. 같은 조건에서 글자가 가장 큰 줄을 고르는 규칙은 0.161이었습니다. 평가셋 21,044장을 한 번만 열어 잰 값이고 사전에 정한 세 기준을 모두 통과했습니다.
그래도 이 모델은 제품명을 자동으로 뽑는 수준이 아닙니다. 사진 전체에서 제품명을 모두 맞힌 비율은 0.196입니다. 그래서 제품의 기본 출력은 계속 NOT_EXTRACTED이고, 이 모델은 사람이 확인할 후보를 추천하는 데까지만 씁니다. 라벨 통계가 필요 없는 두 모델은 Hugging Face ThakiCloud/BeautyProductName-KO로 공개했습니다.
쉽게 말하면
서점 진열대에서 책 제목을 찾는 일에 비유할 수 있습니다. “글씨가 가장 큰 것이 제목”이라는 규칙은 그럴듯하지만, 표지에는 출판사 로고나 띠지 문구처럼 큰 글씨가 많습니다. 실제로 표지마다 이 규칙이 고르는 후보는 수십 개인데 진짜 제목은 두 개 남짓입니다.
그래서 크기만 보지 않고 위치, 글자 종류, 읽기 신뢰도까지 함께 보는 점원을 훈련했습니다. 흐릿하게 읽힌 표지가 섞인 실제 진열대에서도 이 점원은 규칙보다 훨씬 나았습니다. 하지만 표지 다섯 장 가운데 한 장꼴로만 제목을 빠짐없이 맞혔습니다. 그래서 점원이 고른 후보를 사람이 확인하는 방식으로 씁니다.
왜 규칙이 실패했나
앞선 화장품 포장 OCR 작업에서 우리는 제품명을 뽑지 않고 NOT_EXTRACTED로 돌려주기로 했습니다. 줄 높이 기반 규칙의 제품명 정밀도가 0.044였기 때문입니다. 원인을 나눠 보니 문제는 규칙이 너무 많이 고른다는 데 있었습니다.
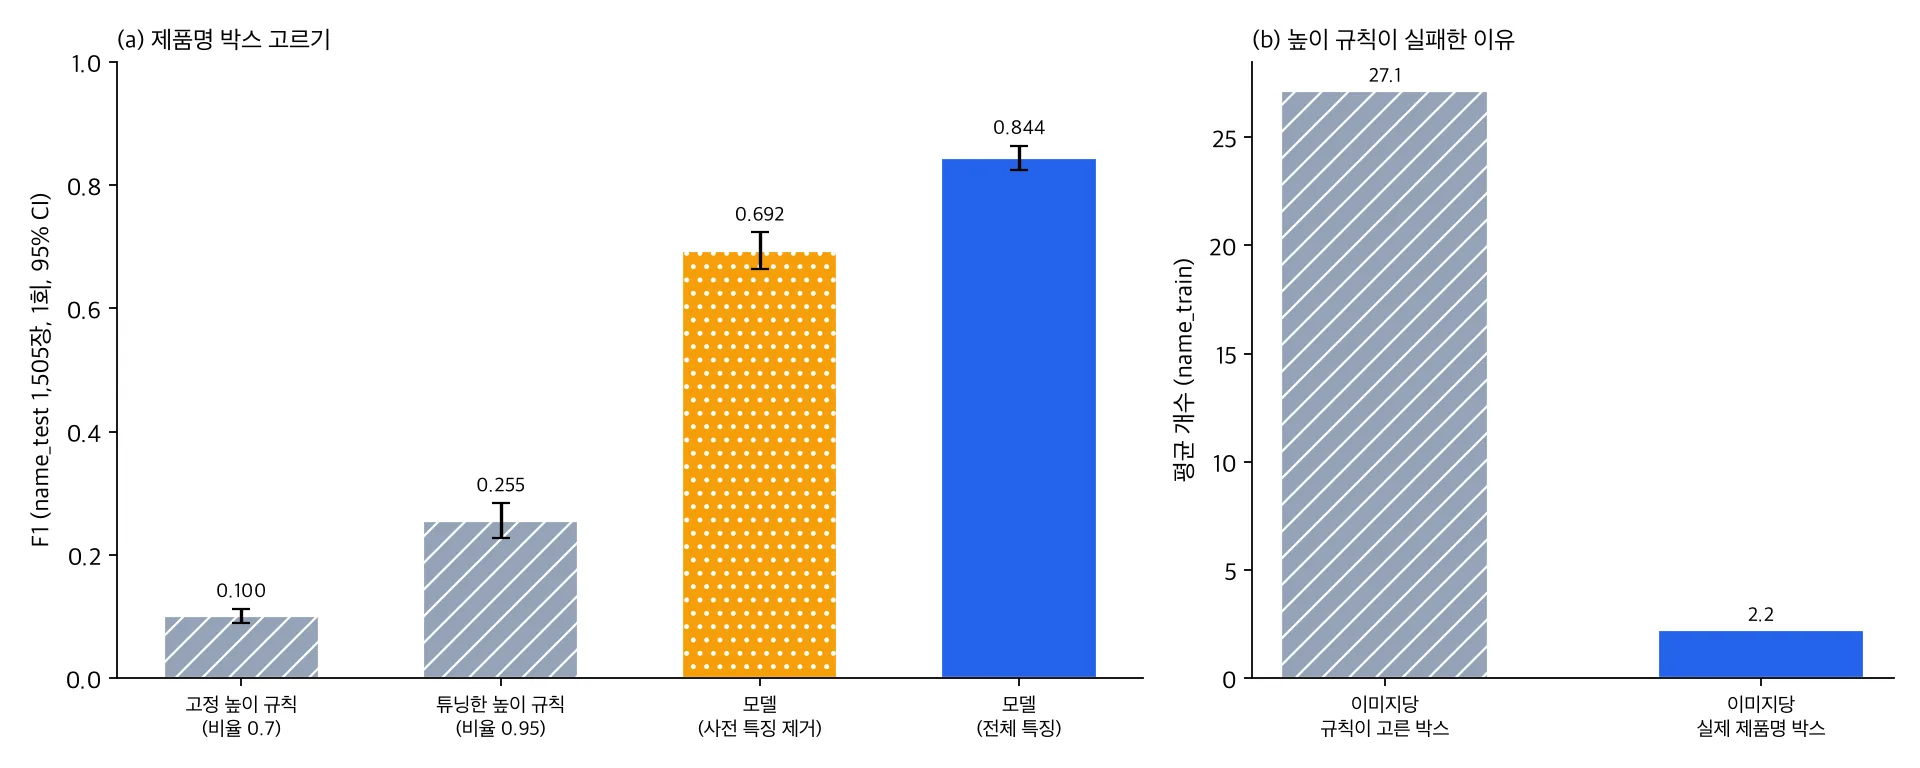
데이터는 AI 허브(AI-Hub)의 화장품·의약품 패키지 OCR(633)입니다. 라벨에서 제품명에 해당하는 유형은 이미지당 평균 2.2개인데, 높이 규칙은 이미지당 평균 27.1개 박스를 골랐습니다. 이미지의 51.2%에는 제품명 박스가 아예 없었습니다. 잘못 고른 박스의 44%는 유형 5, 27.5%는 유형 2, 22%는 유형 4였습니다. 비교 기준을 바꿔도 결론은 같았습니다. 라벨의 메타 제품명 문자열과 겹치는지로 채점해도 정밀도는 0.052였습니다.
무엇을 만들었나
박스 하나하나에 대해 “이것이 제품명인가”를 맞히는 이진 분류기입니다. 픽셀은 쓰지 않고 박스 좌표와 크기, 같은 줄의 박스 수, 글자 종류 비율, 단위나 날짜 모양 여부 같은 특징만 씁니다. 모델은 scikit-learn의 HistGradientBoosting입니다.
처음 만든 모델은 35개 특징을 썼습니다. 그중에는 그 문자열이 학습 데이터에서 제품명으로 쓰인 비율을 세는 사전 특징이 있었습니다. 학습은 7만 2,542장에서 뽑은 박스 약 804만 개로 B200 노드의 CPU 12코어에서 했고 GPU는 쓰지 않았습니다. 학습부터 평가까지 전체 잡은 219초가 걸렸습니다.
분할은 제품 묶음 단위로 나눠 학습 20,978개, 개발 564개, 시험 547개 묶음이 서로 겹치지 않게 했습니다. 판정 임계값은 개발 분할에서만 골랐고 판정 기준과 비교 대상은 측정 전에 파일로 고정해 커밋했습니다.
결과: 정답 텍스트가 주어졌을 때
먼저 정답 박스와 정답 텍스트를 입력으로 준 조건입니다. 시험 분할 1,505장을 한 번 열어 잰 결과입니다.
| 방법 (name_test, 1회) | 정밀도 | 재현율 | F1 (95% 신뢰구간) |
|---|---|---|---|
| 고정 높이 규칙 (비율 0.7) | 0.055 | 0.566 | 0.100 (0.090~0.112) |
| 튜닝한 높이 규칙 (비율 0.95) | 0.282 | 0.232 | 0.255 (0.227~0.284) |
모델, 사전 특징 제외 (공개, no_lex) |
0.730 | 0.659 | 0.692 (0.664~0.723) |
| 모델, 전체 특징 (비공개) | 0.875 | 0.816 | 0.844 (0.825~0.864) |
튜닝한 규칙과의 짝 차이는 F1 +0.590(0.563~0.618)이었습니다. 화장품 996장과 의약품 509장으로 나눠 봐도 F1은 0.844와 0.846으로 비슷했습니다. 사전 특징을 빼면 F1이 0.692로 내려갔고 짝 차이는 +0.152(0.131~0.174)였습니다.
이 표는 OCR이 글자를 틀리지 않는다고 가정한 상한에 가깝습니다. 실제 제품에서 얼마나 쓸 수 있는지는 다음 절의 실사진 결과로 판단해야 합니다.
결과: 실사진을 끝까지 통과시켰을 때
두 번째 평가는 실사진에서 시작합니다. 글자 영역 검출기와 글자 인식기를 고정해 두고 그 출력 위에서 제품명 줄을 고릅니다. 평가셋 VS1은 21,044장(13,549개 묶음)이고 한 번만 열었습니다. 이 평가셋은 앞선 크롭 인식 판정에도 썼던 것을 다른 주장으로 다시 연 것입니다. 판정 임계값, 규칙의 높이 비율, 배포할 모델, 후보를 확정으로 묶는 점수 기준은 모두 별도의 개발 분할 4,457장에서만 정했습니다.
배포용 모델은 사전 특징을 빼고 OCR 출력으로 다시 학습했고 검출 점수와 인식 신뢰도를 특징으로 더했습니다. 사전 특징은 라벨에서 뽑은 문자열 통계라 배포하거나 공개할 수 없기 때문입니다.
| 조건 (VS1, 1회) | 정밀도 | 재현율 | F1 (95% 신뢰구간) |
|---|---|---|---|
| 튜닝한 높이 규칙 (비율 0.9) | 0.127 | 0.218 | 0.161 (0.156~0.166) |
배포용 모델 (공개, ocr_conf) |
0.618 | 0.593 | 0.605 (0.599~0.612) |
| 배포용 모델, 근접중복 제거 2,403장 | 0.539 | 0.504 | 0.521 (0.496~0.545) |
| 배포용 모델, 학습에 없던 제품 1,433장 | 0.644 | 0.528 | 0.580 (0.557~0.602) |
| 배포용 모델, 학습에 없던 제품이면서 비중복 169장 | 0.539 | 0.373 | 0.441 (0.357~0.520) |
| 참고: 사전 특징 모델 (연구용, 비공개) | 0.738 | 0.713 | 0.725 (0.720~0.731) |
배포용 모델과 규칙의 짝 차이는 F1 +0.444(0.437~0.452)였습니다. 사전에 정한 세 기준은 점추정 F1 0.50 이상과 정밀도 0.60 이상, F1 신뢰구간 하한 0.45 이상, 규칙 대비 짝 차이 하한 0 초과였습니다. 셋 다 통과해 판정은 통과(GO)입니다. 사진 한 장에서 제품명 박스를 빠짐없이 맞힌 비율은 0.196(0.188~0.205)입니다.
앞 절의 0.844는 정답 텍스트를 준 다른 조건, 다른 분할의 값이라 이 표와 바로 비교하면 안 됩니다. 사전 특징 모델이 0.725로 더 높은 이유도 학습에서 본 문자열을 기억하는 효과가 크기 때문으로 봅니다. 이 모델은 연구 비교용으로만 남깁니다.
손실이 어디서 생기는지도 나눠 봤습니다. 배포용 모델에 정답 박스와 정답 텍스트를 줘도 F1은 0.623입니다. 그래서 완벽한 입력 대비 손실 0.377은 이름 줄 선택 단계의 몫입니다. OCR 문자 오류가 더한 손실은 0.013, 검출이 더한 손실은 0.005였습니다. 개선할 곳은 검출이나 인식이 아니라 제품명 줄을 고르는 모델입니다.
점수가 0.90 이상인 후보만 높은 점수 묶음으로 모으면 정밀도는 0.916(후보 6,725개)입니다. 다만 이 묶음은 맞힌 후보의 22.2%이고, 전체 제품명 줄로 따지면 약 13%만 덮습니다. 나머지 후보의 정밀도는 0.566이라 사람 검수로 넘깁니다. 이 묶음은 검수 순서를 정하는 신호이지 자동 승인 규칙이 아닙니다.
지연은 4 vCPU, 8 GiB로 제한한 환경에서 사진 100장으로 쟀습니다. 처음 측정에서는 제품명 후보를 켰을 때 중앙값 1,618ms, p95 3,653ms로 p95 3,000ms 조건을 넘었습니다. 원인을 따로 재 보니 스레드 수가 아니라 onnxruntime 작업 스레드의 스핀 대기가 CPU 쿼터를 써 버리는 것이었습니다. 스핀을 끄고 다시 재자 중앙값 992ms, p95 2,483ms로 조건을 통과했고 105장의 출력은 바이트 단위로 같았습니다. 여유는 약 17%이고 100장짜리 측정 한 번의 결과라 고객 하드웨어에서는 다시 재야 합니다. 피크 메모리는 3.76 GiB로 6 GiB 조건 안이었습니다.
이 숫자가 증명하지 않는 것
가장 강한 반론은 평가셋이 학습 데이터와 너무 닮았다는 점입니다. VS1의 88.6%가 학습 사진과 근접중복이고 제품의 93.2%가 학습에 있었습니다. 그래서 0.605는 같은 촬영 방식, 이미 본 제품을 대상으로 잰 성능에 가깝습니다.
실제로 근접중복을 빼면 F1이 0.521로, 학습에 없던 제품이면서 중복도 아닌 169장에서는 0.441로 떨어집니다. 이 169장의 점추정은 사전 기준 0.50보다 낮고 신뢰구간도 넓습니다. 처음 보는 제품이라면 성능을 이 정도 범위로 보는 것이 안전합니다.
이 평가셋은 모두 같은 데이터셋의 실내 단일 제품 사진입니다. 한 사진에 여러 제품이 있는 경우, 반사와 곡면과 흐림이 강한 사진, 고객 매장이나 창고 사진은 한 장도 없어 평가하지 못했습니다.
ThakiCloud 제품 적용 시사점
Paxis의 서류·사진 처리 흐름에서 제품명은 사람이 확인할 필드 후보로 제시하는 것이 맞습니다. 기본 출력은 NOT_EXTRACTED 그대로 둡니다. 설정을 켠 경우에만 “미검증” 표시와 검수 필요 표시가 붙은 후보를 돌려줍니다. 자동 승인 경로는 없습니다.
이 모델은 GPU 없이 CPU에서 학습되고 픽셀을 보지 않으므로 Aegis 같은 사내 설치 환경에 얹기 쉽습니다. 큰 비전 언어 모델 대신 도메인 데이터로 작은 분류기를 학습하는 방식은 Maxis의 소형 도메인 모델 흐름과 같습니다. 4 vCPU 지연 조건은 스핀 대기를 끈 설정에서 통과했지만, 후보 기능을 켜는 것은 고객 실사진 실증 뒤로 미룹니다.
Hugging Face 공개: BeautyProductName-KO
제품명 고르기는 OCR 모델 안에 넣지 않고 별도 모델로 뺐습니다. 손실의 대부분이 글자 인식이 아니라 줄 선택에서 나왔고, 줄 선택은 픽셀 없이 상자와 글자만으로 가볍게 다시 학습할 수 있기 때문입니다. 흐름은 세 단계입니다. ThakiCloud/BeautyPackOCR-KO가 글자 줄을 찾아 읽고, ThakiCloud/BeautyProductName-KO가 줄마다 점수를 매기고, 사람이 제품명을 확정합니다.
저장소에는 두 변형이 있습니다. 기본 ocr_conf는 OCR 출력으로 학습한 실사진 E2E 0.605 모델이고, no_lex는 정답 텍스트 조건 0.692 모델입니다. 둘 다 트리 300개를 숫자만 담은 JSON으로 옮겼고 numpy만으로 돌아갑니다. 공개 파일로 같은 분할을 다시 채점한 결과는 원장 값과 똑같았습니다(0.60529, 0.69238). 체크포인트 sha256은 ocr_conf 7789f00db297831e…, no_lex 4325603cad8af34e…이고, 공개 커밋은 d34abcff입니다.
pip install numpy huggingface_hub
hf download ThakiCloud/BeautyProductName-KO --local-dir BeautyProductName-KO
cd BeautyProductName-KO
python productname.py --selftest
python productname.py examples/synthetic_ocr_output.json   # 가상 예시, BeautyPackOCR-KO 출력 JSON을 그대로 넣어도 됩니다
출력은 점수 순 후보 목록이고 모든 결과에 review_required: true가 붙습니다. 후보는 완성된 제품명이 아니라 라벨 단위의 줄 조각입니다. 라이선스는 Apache-2.0입니다. 저장소에는 가중치와 코드, 손으로 지어낸 예시만 있고 사진, 크롭, 라벨, 제품명 목록, 문자열 빈도표는 하나도 없습니다. 고객 사진으로는 시험하지 않았다는 점도 모델 카드에 적었습니다.
한계 및 반론
라벨의 제품명 유형은 평균 3.1자 단위의 토막이라 메타데이터의 제품명 글자 중 32.7%만 덮습니다. 이 단위가 고객이 원하는 제품명과 같은지도 확인하지 않았습니다.
판정의 층위도 구분해야 합니다. 이번 GO는 연구 완료와 데이터셋 내부 독립 평가의 통과이지, 제품명 자동 추출의 근거가 아닙니다. 기본값을 바꾸려면 고객 실사진으로 따로 사전등록한 평가의 통과, 고객 데이터에서 확정 정밀도 0.90 이상, 검토 화면에서 사람이 승인하는 흐름이 필요합니다. 고객 실증이 남아 있으므로 상용화 판정은 내리지 않았습니다.
정리
제품명을 고르는 일은 글자 크기만으로는 풀리지 않았습니다. 위치, 글자 종류, 읽기 신뢰도를 함께 보는 작은 트리 모델은 실사진 E2E에서 F1 0.605로 규칙(0.161)보다 크게 나았고 사전 기준을 통과했습니다.
그래도 사진 다섯 장 중 네 장은 사람이 고쳐야 하고 처음 보는 제품에서는 0.44~0.58 범위로 떨어집니다. 손실의 대부분은 OCR이 아니라 이름 줄 선택에서 나옵니다. 지금 수준은 자동 추출이 아니라 사람 검수를 돕는 후보 추천입니다. 쓰려면 고객 실사진 실증이 먼저 필요합니다.
공개한 것은 사전 특징이 없는 두 모델입니다. 사전 특징을 쓴 0.844 모델은 라벨 문자열 빈도표 없이는 돌지 않으므로 앞으로도 공개하지 않습니다.
데이터 출처: AI 허브(AI-Hub), 화장품·의약품 패키지 OCR(633). 데이터는 재배포하지 않으며 신청자 본인의 내부 학습·평가에만 사용했습니다. 이 글에는 집계 수치만 실었고 사진, 크롭, 라벨 값은 싣지 않았습니다. 그림은 원장 수치로 그린 차트와 개념도입니다.
