The Concurrency Tax: 동시성을 올리면 function-calling 정확도가 내리는 세금, 그리고 안전 동시성 상한의 closed form
self-hosted GPU(H200 class) 위에서 에이전틱 tool-calling 워크로드를 서빙하거나 그 서빙의 비용 청구서를 책임지는 국내 클라우드/AI 엔지니어라면 이 글이 답하는 질문이 곧 운영의 문제입니다. GPU utilization을 올리면 토큰당 비용은 내려갑니다. 그런데 정확도가 함께 내려가는 워크로드가 있고 구조를 계약으로 채점하는 function calling은 그 대표적 후보입니다. ThakiCloud의 논문 “The Concurrency Tax: Measuring the Accuracy-Drift-versus-Utilization Cost-Quality Frontier of Agentic Tool-Calling in Self-Hosted H200 Serving”는 fixed model, fixed precision, temperature-zero harness에서 serving concurrency를 경량 부하에서 포화까지 올리며 function-calling 워크로드가 잃는 정확도 점수인 concurrency tax의 크기와 방향을 formalize합니다. 그리고 그 세금이 토큰당 절전을 넘어서는 지점인 안전 동시성 상한을 closed form으로 줍니다. 이 논문은 분석 논문입니다. 모든 그림은 선언된 가정에 대한 closed-form 예측이며 그 예측을 측정으로 채우는 falsifiable 프로토콜이 함께 등록되어 있습니다.
문제의식: 시리즈의 모든 frontier는 경량 부하에서만 잰 값
self-hosted inference factory는 utilization로 sizing됩니다. 고정 accelerator 위에서 에이전틱 tool-call 워크로드를 돌리는 운영자는 몇 개의 요청을 동시에 in-flight로 두느냐를 결정해야 하고 각 in-flight 요청은 throughput을 사고 토큰당 달러와 kWh를 깎아 줍니다. serving stack이 포화할 때까지 계속됩니다. 반증이 없다면 자연스러운 운영점은 최대 동시성, 최대 utilization, 토큰당 최소 비용입니다.
저희 cost-quality frontier 시리즈는 그 결정을 네 개의 레버로 가격 매겨 왔고 각 레버는 경량 부하에서 잰 값입니다. weight-precision 레버는 구조적 툴콜의 accuracy tax tau_q와 cliff ratio kappa_q를 시리즈의 89.6% NVFP4 reference row에 앵커해 가격 매겼습니다. (model, precision) 쌍은 FrugalGPT cascade를 effective passing throughput E = tQ/ℓ 위의 2차원 frontier로 upgrade하고 judge-free 게이트 g = 0.85 아래에서 가격 매겼습니다. sampling 레버는 한 accuracy point를 sample 비용으로 가격 매겨 어떤 retry budget도 넘지 못하는 silent floor와 gate 대 majority crossover를 주었습니다. context 레버는 세타(T^2)로 복리 계산되는 bill을 가격 매겼습니다. 이 모든 레버에서 serving concurrency는 경량 부하에 고정되어 있었고 암묵적인 상수였습니다.
serving 문헌은 load를 throughput이나 latency 변수로 읽습니다. continuous batching과 paged KV attention이 throughput을 in-flight concurrency의 함수로 만들고 goodput과 SLO-aware latency budget과 cost-quality-latency Pareto atlas까지 나온 것이 이 쪽입니다. 그런데 이 쪽은 전부 per-request timing target에 throughput을 조건화할 뿐입니다. end-task correctness에 조건화하는 논문이 없고 agentic evaluation에서 load를 accuracy 변수로 읽는 논문도 없습니다. 이 논문이 채우는 gap이 바로 그 지점입니다.
이 논문은 Tool-Call Cliff의 명시적 upgrade입니다. Precision Ladder가 FrugalGPT cascade를 upgrade한 의미 그대로 utilization 축을 추가합니다. fixed model, fixed weight precision, temperature-zero harness에서 serving concurrency가 경량 부하에서 포화까지 이동하며 function-calling 정확도가 얼마나 드리프트하는지, 그리고 그 세금이 토큰당 절전을 넘어서는 지점인 안전 동시성 상한이 어디인지를 묻습니다. 이 upgrade가 cliff 시리즈를 완성합니다. precision cliff와 utilization tax가 합성되어 double cliff가 되고 거기서 load-induced drift는 low-bit checkpoint를 더 일찍, 더 멀리 덮칩니다.
load 축이 정확도를 움직인다는 믿음이 어디에서 오나, serving nondeterminism 문헌이 답합니다. prompt, weight, sampling이 전부 고정되어 있어도 serving context가 출력을 바꿉니다. batch shape는 bf16에서 최대 56.7 percentage points의 확률 질량을 이동시킵니다. server-level prompt-cache 설정은 run-to-run divergence를 움직이고 precision이 16-bit에서 4-bit로 내려가면 agent episode의 36.2%에서 75.0%까지 올라갑니다. cache-disabled 실행은 bit-identical입니다. 이 논문은 정확히 이 효과들을 가격 매깁니다. nondeterminism은 reproducibility hazard가 아니라 accuracy tax의 substrate입니다.
설계: concurrency tax, noise floor, 부하 의존 비용 모델
플랫폼과 harness를 고정해 concurrency가 유일하게 sweep되는 변수가 되도록 둡니다. serving은 단일 NVIDIA H200 뒤의 vLLM OpenAI-compatible endpoint에서 돌고 –max-num-seqs 256, –max-model-len 8192, –gpu-memory-utilization 0.90이며 base configuration에서 prefix caching은 꺼져 있습니다. cache-on은 별도 attribution arm입니다. sampling은 greedy, temperature 0, top-p 1입니다. model m과 weight precision q는 전체에서 고정됩니다. concurrency level C는 in-flight 요청을 세고 saturation capacity C_max = 256, utilization u = C/C_max, 경량 부하 reference u_min = 1/C_max입니다. 워크로드는 고정 60-item BFCL-v3 서브셋으로 single-call 30개와 parallel-call 30개를 한 번 seeding해 고정합니다. single-turn function-calling completion을 judge-free exact match로 채점하므로 quality는 serving state의 함수뿐입니다.
중심 정의는 concurrency tax tau_u = Q_ref - Q(u)입니다. 경량 부하에서 utilization u로 이동하며 워크로드가 잃는 정확도 점수입니다. 시리즈와의 비유는 직접적입니다. cliff paper의 precision tax tau_q는 fixed load에서 weight-precision 축을 따라 잃는 정확도를 가격 매기고 tau_u는 fixed precision에서 load 축을 따라 잃는 정확도를 가격 매깁니다. 같은 frontier의 직교하는 두 축에 걸린 두 세금을 합성하는 것이 double cliff입니다.
드리프트 주장에는 noise floor를 넘어야 합니다. d(u)를 item-flip distance, 곧 첫 경량 부하 run 대비 pass/fail status가 뒤집힌 item 수라고 둡니다. same-session C=1 repeat이 reference run을 반복하면 null flip distance F가 나옵니다. level u의 드리프트 주장은 d(u) > max(1, F)일 때만 significant합니다. null은 same session에서 reference level의 물리적 반복이므로 F는 load에 의존하지 않는 모든 드리프트 원인을 하나의 숫자로 포착합니다. 60-item set의 item-majority granularity은 1/60, 약 1.67 percentage points입니다.
비용 모델이 그 축을 가격 매깁니다. r을 선언된 self-hosted rate, t(u)를 utilization u의 aggregate output throughput(tokens per second, non-decreasing하고 saturating)이라고 둡니다. ℓ을 item set 위에서 대략 일정인 tool call 당 output token 수라고 하면 c(u) = r/t(u)이고 cost per passed call은 beta(u) = c(u)ℓ/Q(u)입니다. effective passing throughput E(u) = t(u)Q(u)/ℓ는 wall time당 통과한 호출 수이고 Precision Ladder의 metric을 load-dependent로 만든 것입니다. ℓ과 r은 상수이므로 모든 load dependence는 t(u)와 Q(u)에 걸치고 beta(u) = r/E(u)는 두 개의 falling curve의 ratio입니다. 다음 섹션이 제어하는 대상이 이 ratio의 모양입니다.
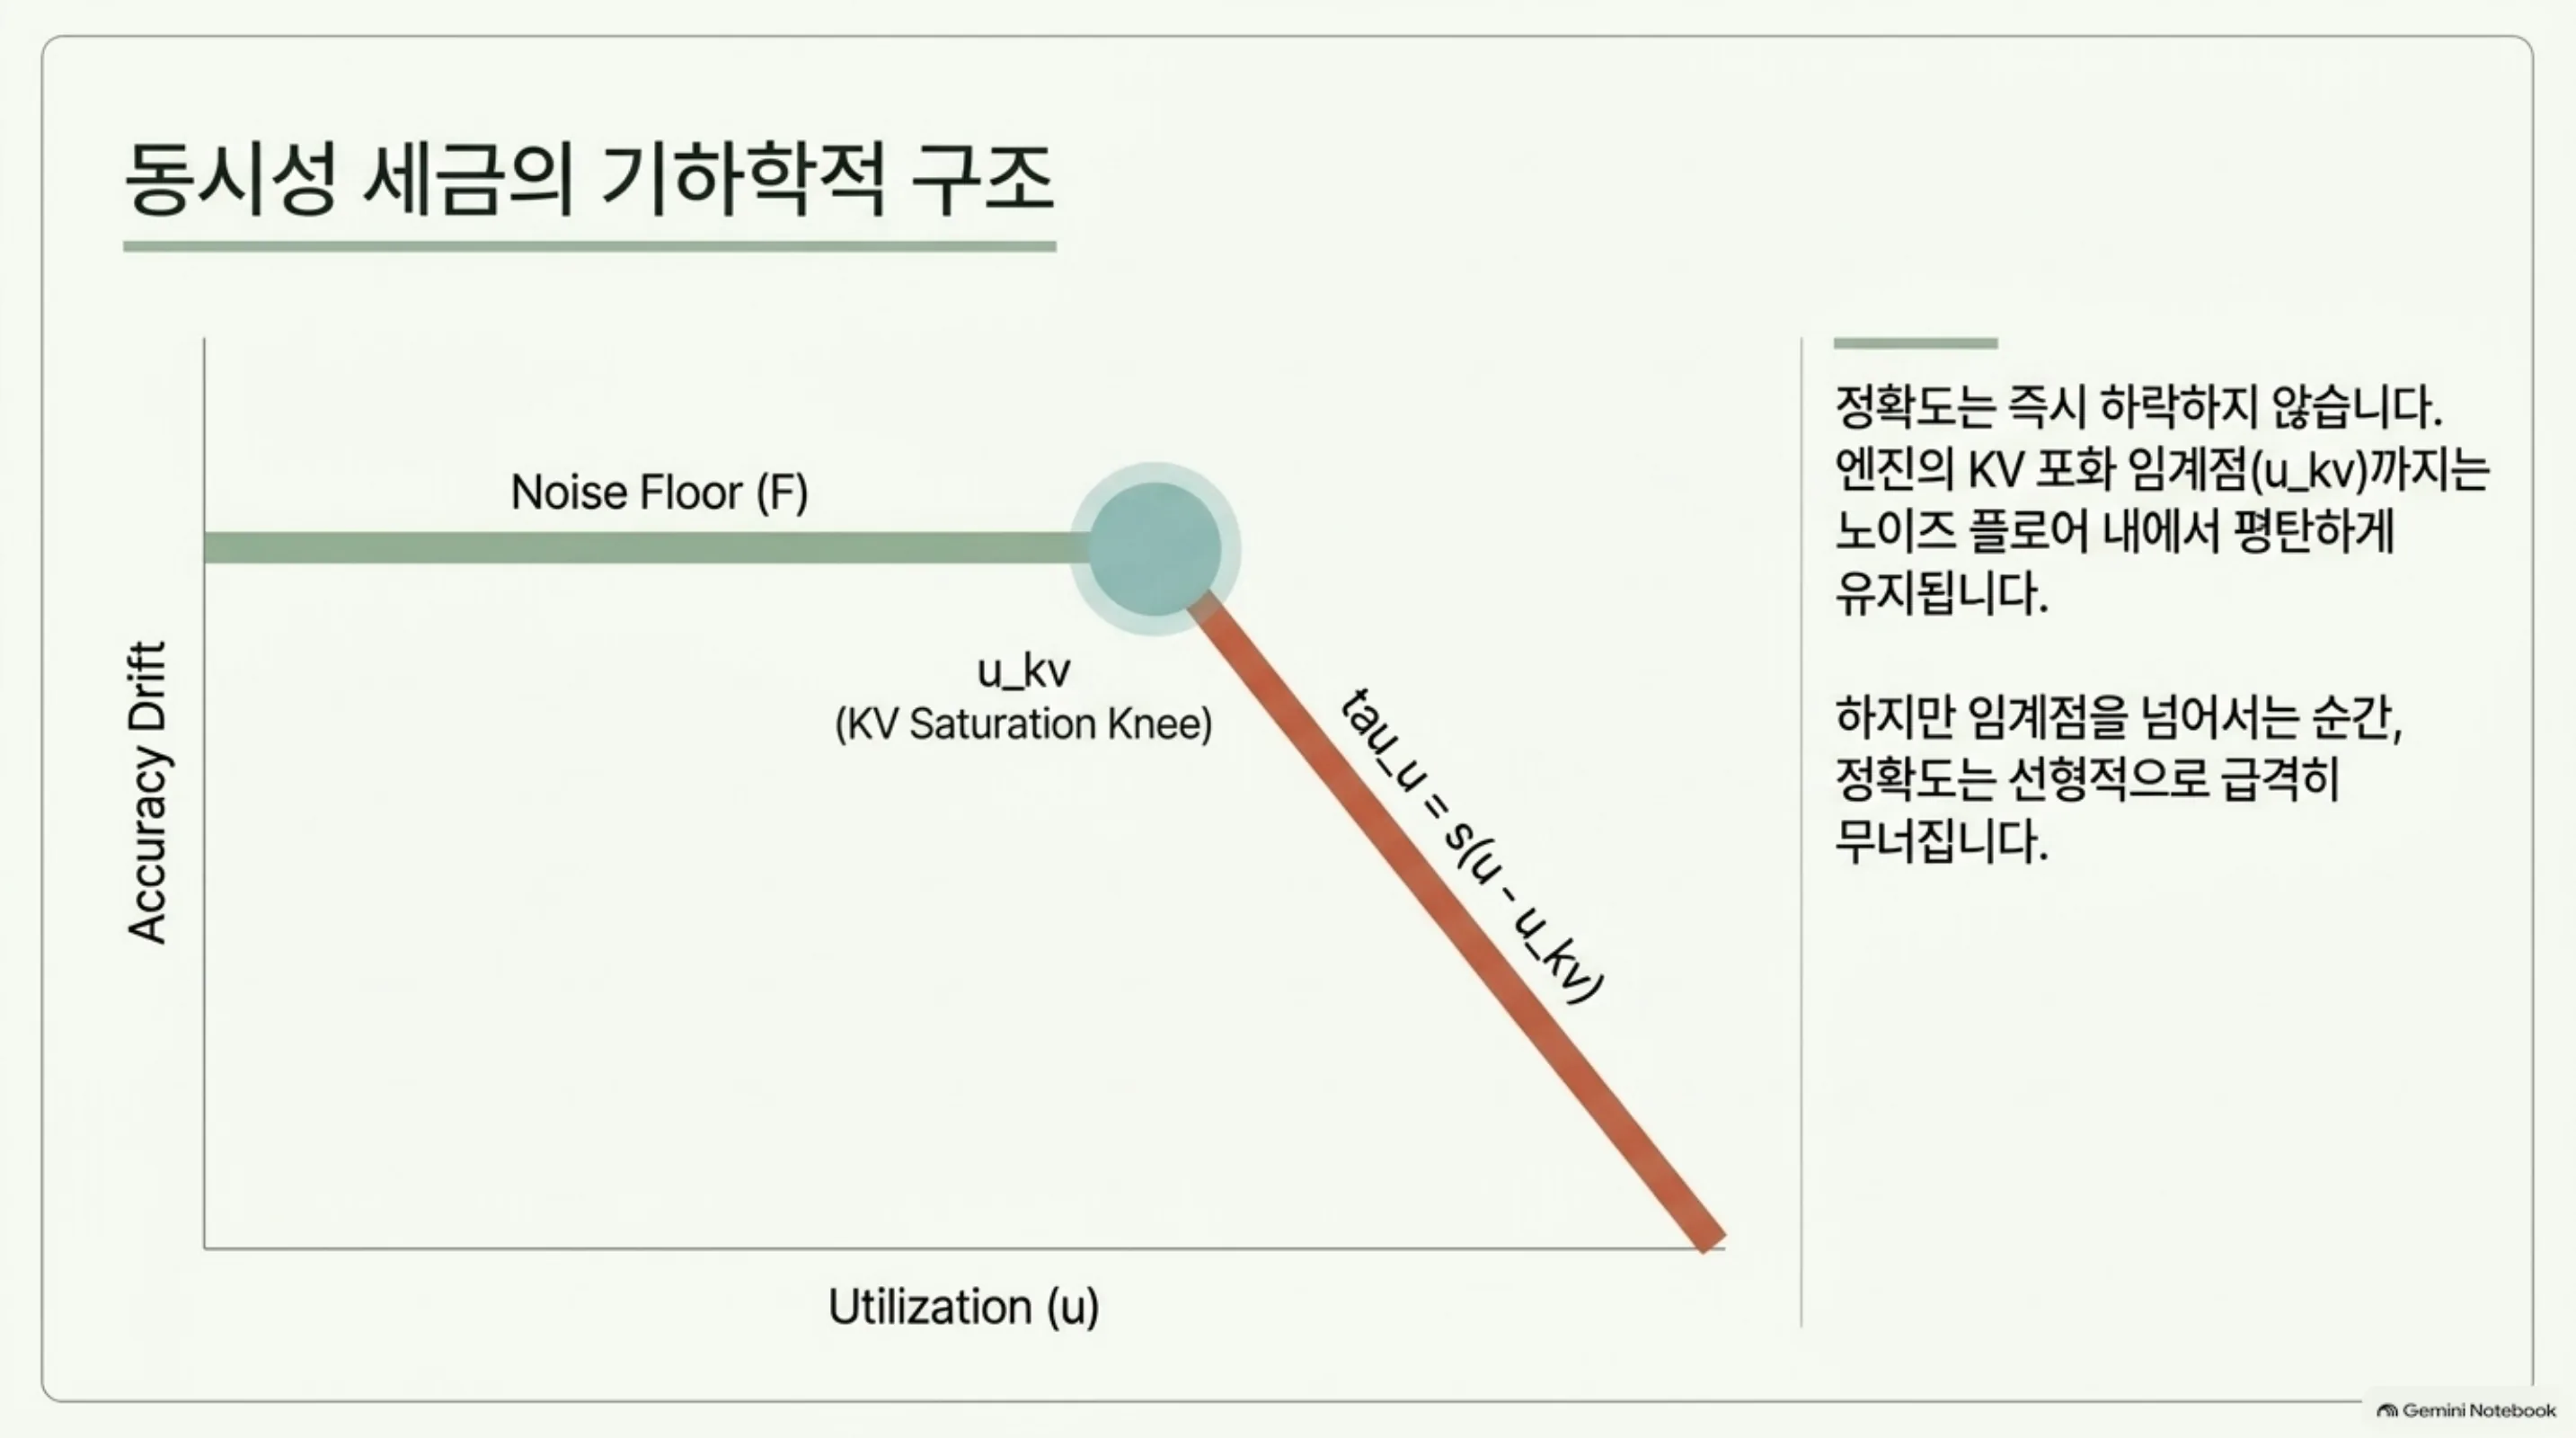
두 regime의 형태는 단순합니다. aggregate throughput은 saturating(hill) law t(u) = t_sat*u/(u + K_u)를 따릅니다. continuous batching은 in-flight work를 거의 선형으로 올리고 KV와 scheduling 압력이 그 곡률을 굽히면 성장률이 꺾이는 형태입니다. 정확도 드리프트는 KV saturation knee u_kv까지 없고 그 이후에는 선형으로 자랍니다. tau(u) = s(u - u_kv)입니다. knee는 capacity-planning quantity이며 engine metrics에서 읽는 값이지 throughput knee가 아닙니다. 이 구분을 프로토콜의 첫 번째 예측이 등록합니다. s는 unit utilization 당 드리프트 가격, 워크로드 클래스 매개변수입니다.
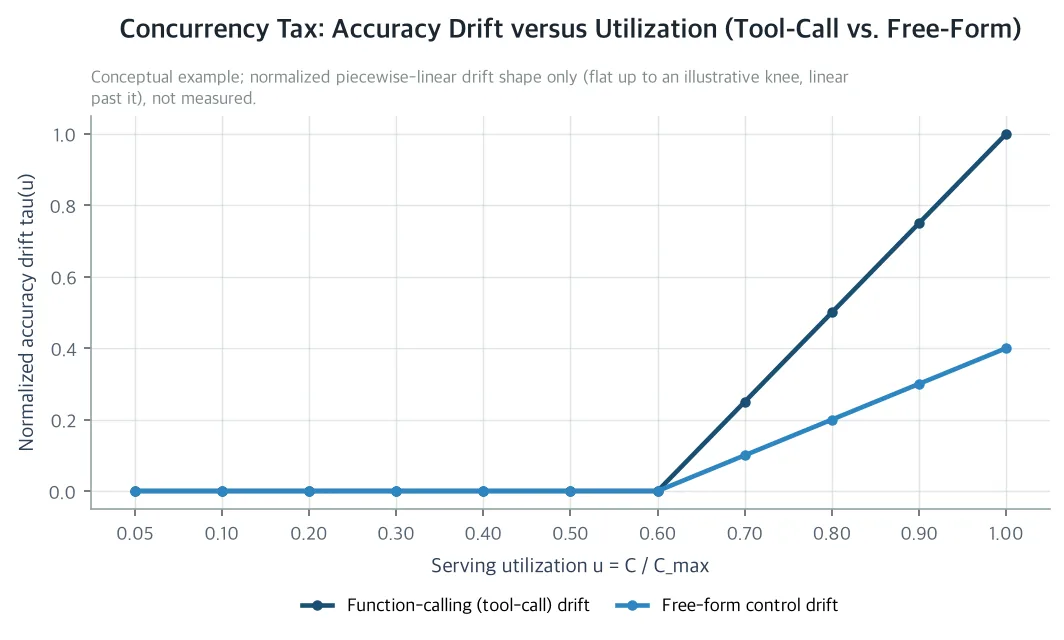 KV 포화 knee까지 툴콜 정확도 드리프트는 noise floor 안에서 평탄하고 그 이후에는 free-form control보다 빠르게 선형으로 자라 concurrency cliff ratio가 1을 넘습니다. (분석 모델, 실측이 아닙니다.)
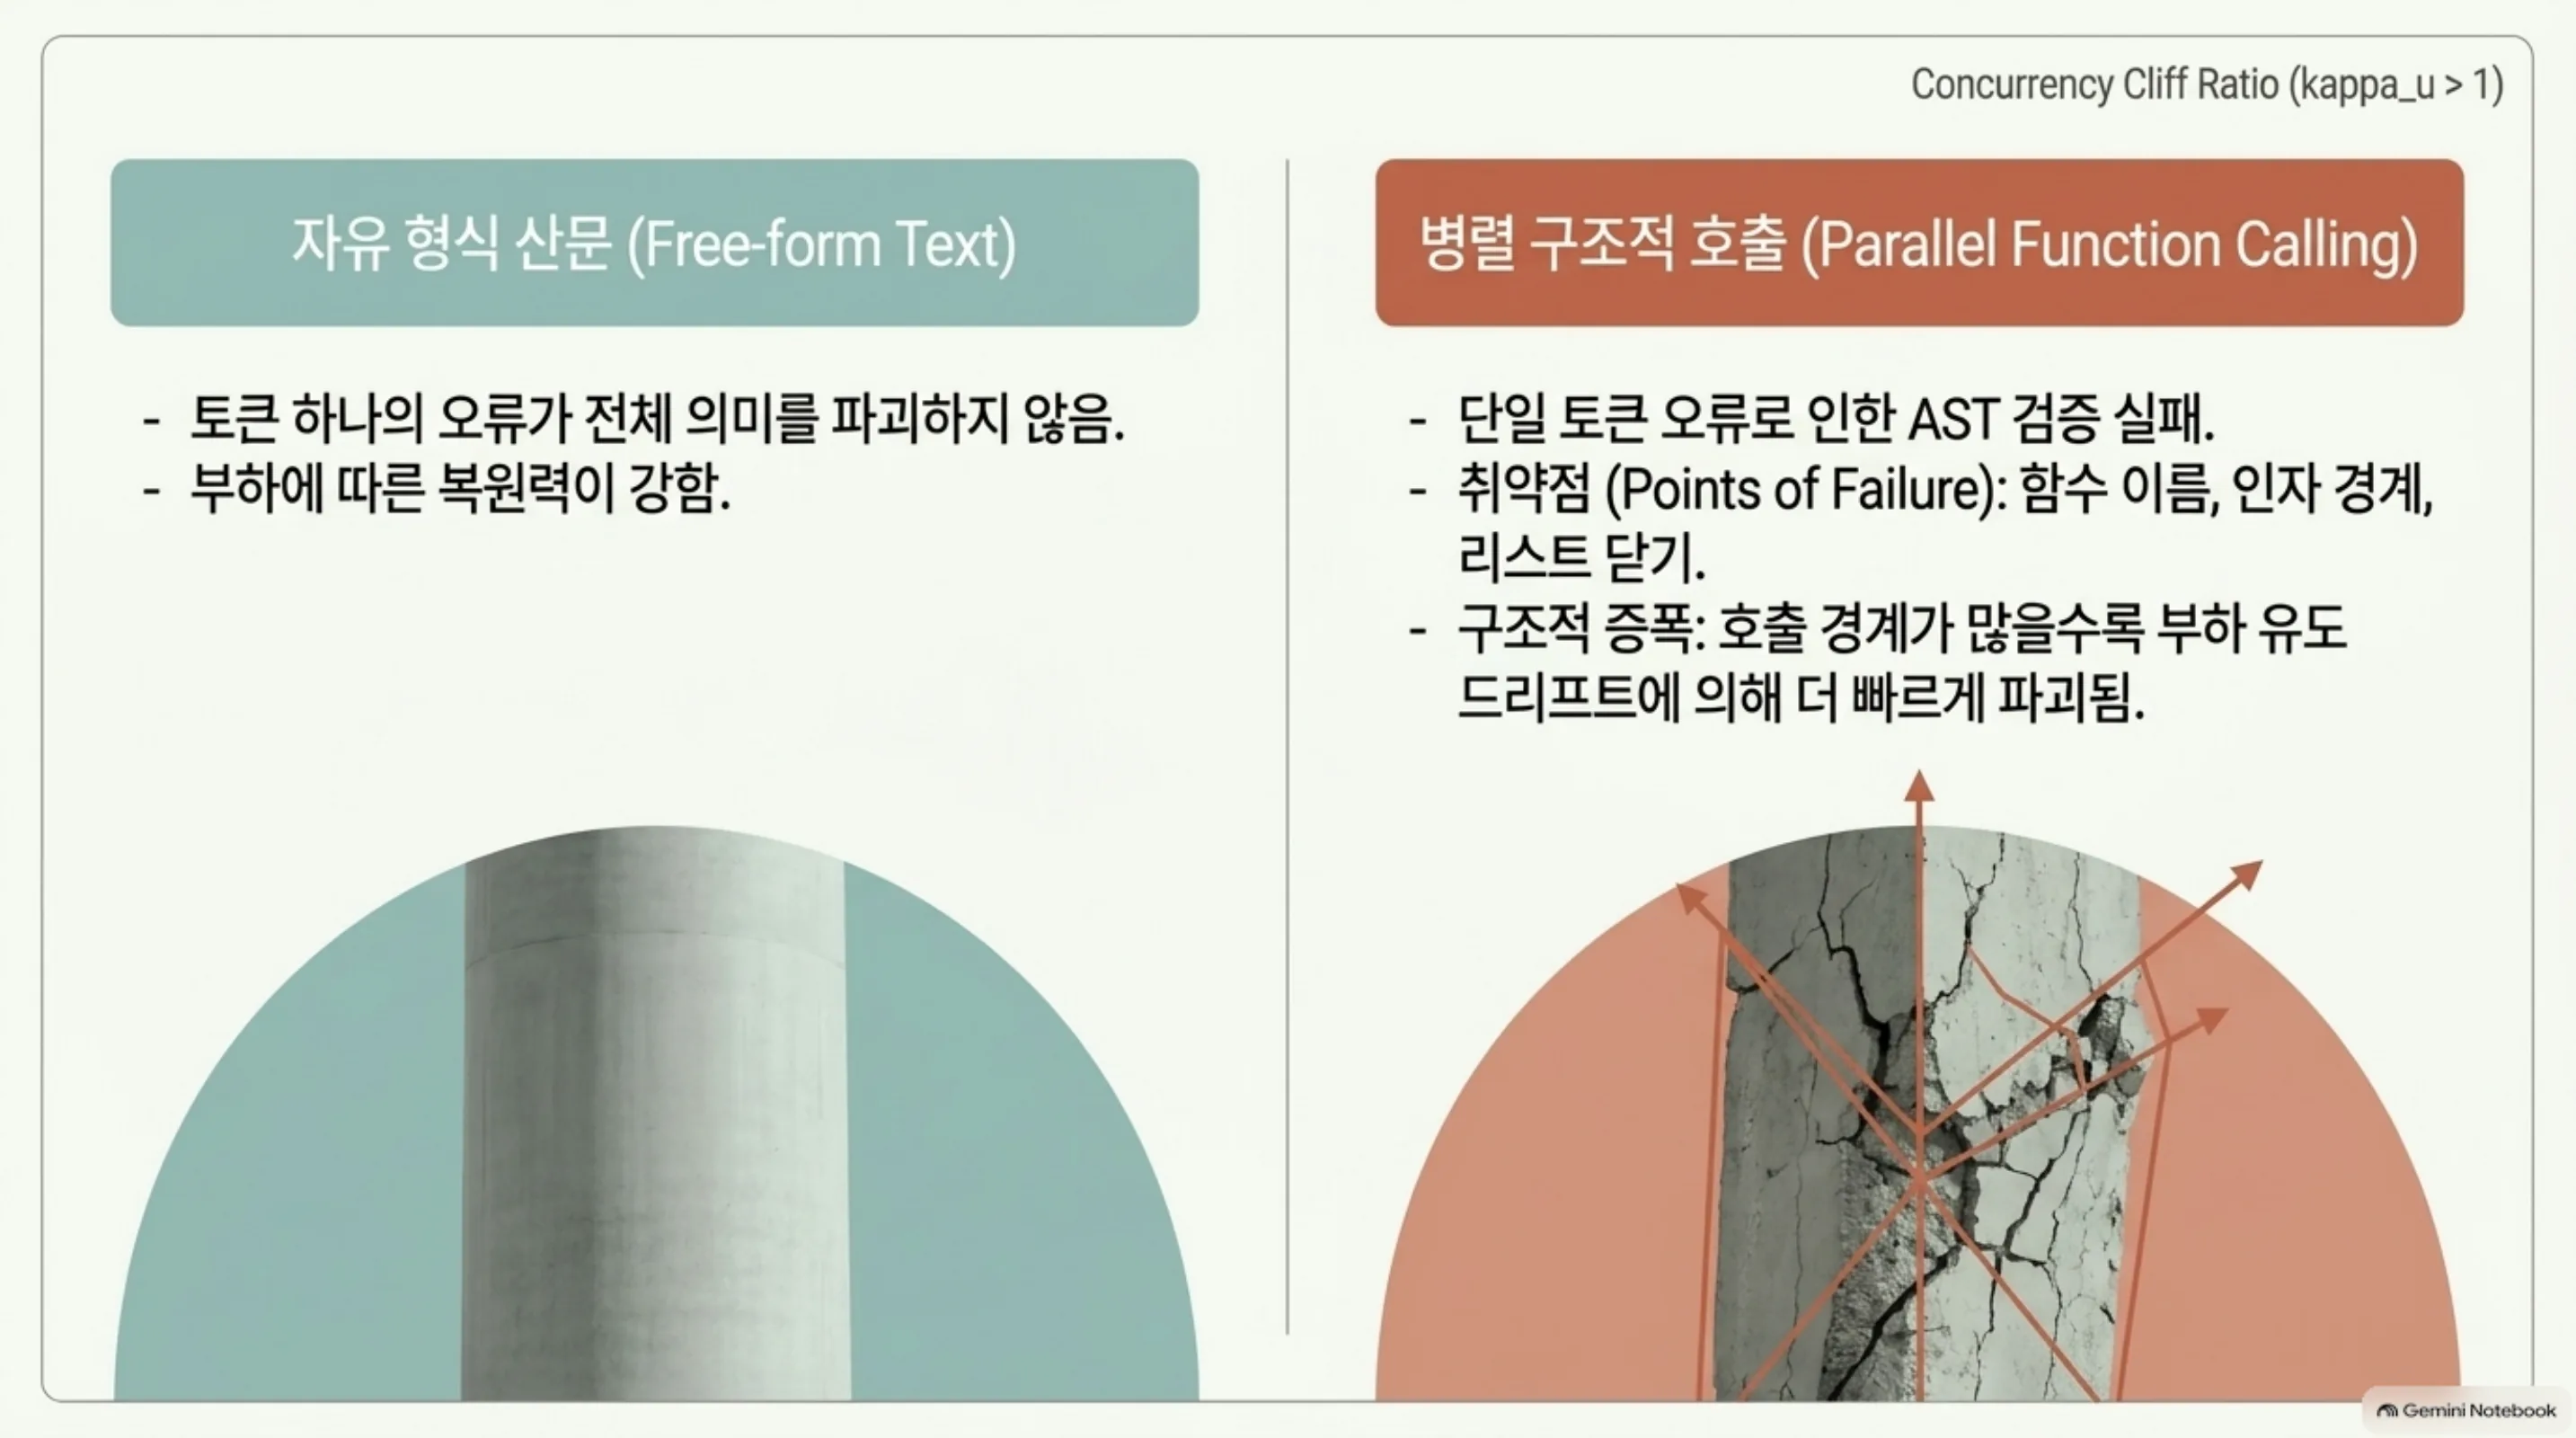
마지막으로 concurrency cliff ratio kappa_u = tau_u^(tc) / max(tau_u^(ff), eps_0)가 load 축이 구조적 툴콜을, 같은 내용을 대신 실어 나를 free-form 산문보다 더 세게 tax하는지를 묻습니다. cliff paper의 kappa_q의 load analogue입니다. kappa_u > 1이 기대되는 메커니즘은 structural amplification이기 때문입니다. parallel-call item은 필수 구조 디코드 단계가 더 많습니다. 각 호출 경계가 function name, argument boundary, list close를 하나씩 더 요구하므로 같은 load drift가 더 많은 단계를 뒤집습니다.
결과: utilization illusion, maximum utilization을 지배하는 closed form
주 정리가 E(u)의 모양을 줍니다. (0, u_kv]에서 E는 strictly increasing입니다. throughput이 오르는데 정확도는 건드리지 않기 때문입니다. knee 이후에서 E’(u)는 많아야 하나의 zero를 갖고 그 zero는 존재할 때 strict global maximum입니다. s_crit = K_uQ_ref / (1 + K_u(2 - u_kv))라고 두면 E는 s > s_crit일 때만 (0,1]의 내부점 u* < 1에서 최대값을 갖고 그 경우 E(u) > E(1)입니다. s <= s_crit이면 maximizer는 u = 1입니다. maximum utilization이 항상 최적인 법은 없습니다. 드리프트 경사가 closed-form 임계값을 넘으면 포화 운영은 엄격히 지배됩니다.
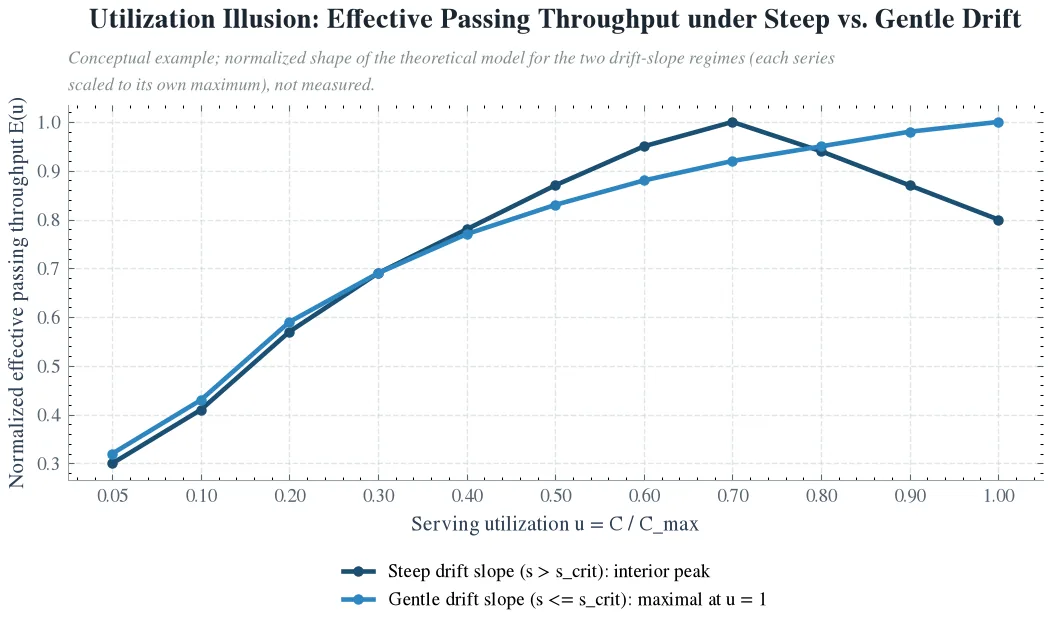 드리프트 경사가 가팔라면 effective passing throughput은 full load 아래에서 내부 최대점에 도달하고 완만하면 최대점이 포화에 머물러 있습니다. (분석 모델, 실측이 아닙니다.)
corollary가 바로 이 논문의 namesake economics입니다. u* 대신 u = 1에서 운영하면 cost per passed call이 H = E(u)/E(1) > 1배가 듭니다. beta(u) = r/E(u)이기 때문입니다. H는 (K_u, u_kv, s, Q_ref)의 closed-form 함수이며 throughput scale t_sat, call length ℓ, 선언된 rate r은 전부 cancel됩니다. safe concurrency ceiling은 C = floor(u* C_max)이고 gate floor가 아래로 refine합니다. 논문의 슬로건 “headroom is priced, not assumed”이 이 corollary입니다. 정확도를 지키는 여유에 가격이 매겨지는 것입니다. 같은 ratio는 energy cost의 상한이기도 하고 request-level energy attribution이 batch context에 의존하기 때문입니다.
sizing rule은 frontier를 읽고 가정을 세우지 않습니다. 워크로드 클래스별로 선언된 level을 sweep하고 knee를 engine metrics에서 읽습니다. frontier curve에서 Q_ref, s, K_u를 추정합니다. s > s_crit이면 C <= min(C*, C_safe)에서 운영해 headroom을 그 가격 H을 부담하며 carries하고 s <= s_crit이면 sweep 상단에서 운영합니다. s는 mix의 속성이므로 워크로드 클래스가 바뀔 때마다 re-audit합니다. 이 rule이 “run at maximum GPU utilization”을 cost-per-accuracy 결정으로 바꿉니다. 두 항은 전부 dollars per passed call로 청구됩니다.
sampling 레버도 load 아래에서 일관되게 변형됩니다. validator의 silent floor는 load drift의 undetectable share만큼 내려갑니다. load-induced wrong call 중 schema/AST validation을 통과한 채로 남는 부분인 phi_s(u)tau_u는 어떤 retry budget으로도 회복 불가능한 부분입니다. post-gate quality ceiling은 경량 부하 ceiling보다 적어도 phi_s(u)tau_u/(1 - p_d(0)) 아래로 내려갑니다. 배당은 factory가 바쁠수록 쪼개집니다. 한 quality point를 회복하는 marginal wall-clock 가격 Pi(u) = c_s(u) / (delta_eff(u) * q_bar)는 knee 이후 non-decreasing입니다. resample 비용 c_s(u)가 queueing으로 오르는 동안 effective detectable fraction delta_eff(u) = delta(1 - phi_s(u))은 내려가기 때문입니다. gate 대 majority crossover는 위쪽으로 이동합니다. q(u) > 3/4인 레짐에서 crossover detectable fraction p_d*(q(u))는 load에 대해 non-decreasing이고 utilization이 높을수록 gate는 더 높은 detectable fraction에서만 k-sample consensus를 이깁니다. 두 레버는 draw마다 같은 queueing 비용을 치릅니다. gate의 배당만 silent share에 잠식되고 consensus의 quality gain은 그렇지 않으니까 factory가 바쁠수록 consensus voting은 상대적으로 싸집니다.
double cliff: low-bit checkpoint가 더 일찍, 더 멀리 내리는 이유
precision 축과 load 축은 구조적 메커니즘에서 만납니다. cliff paper의 low-margin structural-step 가정을 가져옵니다. 필수 구조 디코드 단계(function name, argument boundary, list close)는 결정 margin m_struct이 있고 그 아래로는 logit perturbation에 뒤집힙니다. step당 flip 확률은 p_flip = Phi(-m_struct/sigma_eff)이고 sigma_eff = sqrt(sigma_q^2 + eps_u^2)입니다. sigma_q는 weight-quantization noise, precision 축이고 eps_u는 load-dependent logit perturbation입니다. batch shape와 batch composition 수치, quantization이 증폭하는 prefix-cache divergence, silent shape-dependent GEMM effect가 여기에 걸칩니다. 필수 구조 단계 r_s개를 가진 item은 load 아래에서 tau_u(q) = 1 - (1 - p_flip)^r_s 확률로 실패합니다. 결과는 monotone입니다. tau_u(q)는 모든 u에서 sigma_q에 대해 non-decreasing이고 드리프트 knee는 sigma_q에 대해 non-increasing, endpoint tax는 non-decreasing입니다. low-bit checkpoint가 16-bit보다 더 일찍, 더 멀리 드리프트한다는 뜻입니다.
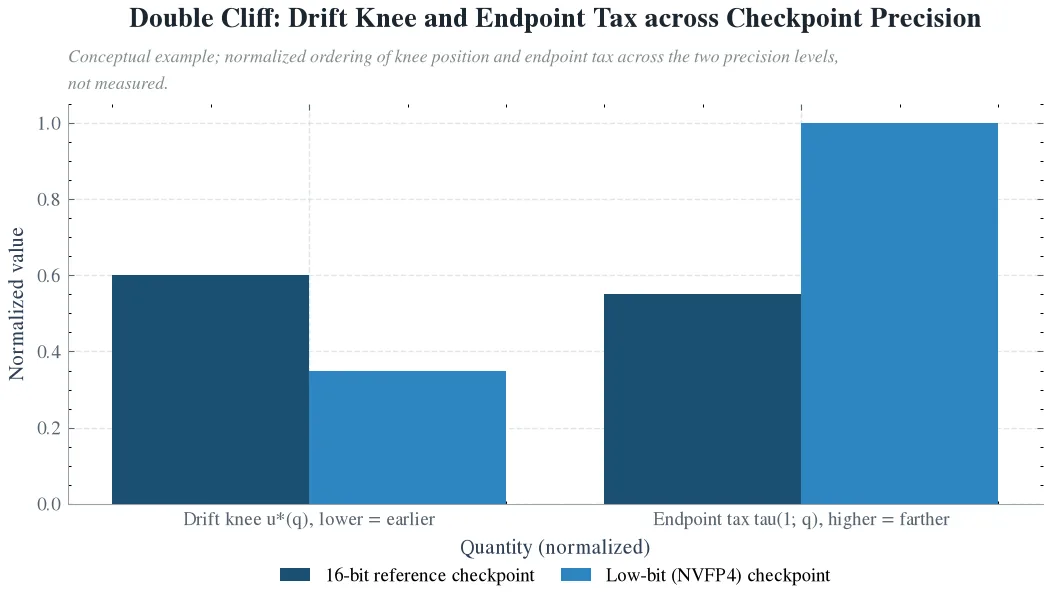 같은 item set에서 low-bit checkpoint의 드리프트 knee가 16-bit 기준보다 앞당겨지고 endpoint tax가 더 큽니다. low-bit 체크포인트가 더 일찍, 더 멀리 내린다는 double cliff입니다. (분석 모델, 실측이 아닙니다.)
routing implication이 시리즈 게이트를 부하를 아는 3차원 조건으로 upgrade합니다. 카테고리별 routing 조건, (model, precision) 쌍이 judge-free 게이트 Q(m,q) >= g, g = 0.85를 경량 부하 quality로 통과할 때에만 태스크 카테고리로 라우트한다,는 것은 factory의 operating utilization에서 Q(m,q,u) >= g으로 서야 합니다. 경량 부하에서 게이트를 통과한 쌍이 operating point에서 실패할 수 있습니다. routing table은 (model, precision), sampling, load의 세 축으로 index됩니다. cliff paper의 load-free row, 800-case BFCL-style suite 위의 89.6% NVFP4 reference는 surface의 u = u_min slice일 뿐입니다. factory behavior의 point estimate가 아니라는 뜻입니다.
드리프트는 어디서 옵니까. load를 정확도로 나르는 채널이 네 개 있고 각 채널은 프로토콜에서 attribution arm을 받습니다. 수치와 batch composition: continuous batching이 kernel이 보는 shape을 바꾸고 floating-point 비결합성이 결과를 shape-dependent하게 만듭니다. batch-shape effect는 bf16에서 56.7 percentage points까지 quantified되어 있습니다. KV memory와 preemption: knee 이후에 KV cache working set이 더 이상 안 들어맞고 engine은 preempt, evict, recompute합니다. recompute pass는 원래와 다른 batch composition을 보게 됩니다. prefix-cache 채널은 precision-conditional이고 cache-on/off divergence가 16-bit에서 4-bit로 올라가며 cache-disabled 실행은 bit-identical입니다. wall time과 harness: 모든 토큰이 정확해도 TTFT/TPOT 팽창이 per-episode wall budget을 갉아 먹고 timeout과 retry가 느린 요청을 틀린 trajectory로 만듭니다. co-tenant와 interference: host는 격리되어 있지 않고 co-located CPU 워크로드가 long tail을 증폭합니다. unprotected co-location이 throughput을 78.8% 깎고 TTFT를 429.5% 팽창시킨 실측이 있고 gateway-level cross-tenant effect가 채널을 완성합니다. 분해 tau_u = sum_c tau_c(u) + interaction 항은 메커니즘의 account이며 각 채널의 측정 share를 주장하지는 않습니다. 그래서 attribution arm은 채널을 켜고 끕니다. 합이 분리된다는 가정을 세우지 않습니다.
의미: 회사, 사회, 과학에 남는 것
ThakiCloud의 H200 token factory에는 워크로드 클래스별(agentic tool-calling 대 free-form) 실측 accuracy-tax curve가 남습니다. “run at max GPU utilization”이 cost-per-accuracy sizing 결정으로 바뀌고 safe concurrency ceiling이 BFCL-validated 27B NVFP4 router baseline을 silent load-induced drift로부터 지킵니다. 시리즈의 세 레버가 이제 하나의 surface를 index합니다. precision ladder가 gate 아래 카테고리별 (model, precision)을 고르고 validator’s dividend가 (category, load)별 sampling policy를 고르며 이 논문이 워크로드 클래스별 operating utilization을 고릅니다. 결합 조건은 3차원 게이트 Q(m,q,u) >= g이고 routing table은 (model, precision, load) triple입니다.
사회로는 self-hosted inference economics가 honest해집니다. 경량 부하에서 잰 cost-per-token 비교는 utilization이 사는 quality erosion을 구조적으로 과소평가합니다. 공개된 load-aware methodology는 over-provisioned headroom과, 정확도를 지키려고 GPU를 유휴로 두는 데 쓰는 energy를 함께 줄입니다. 이제 정확도를 지키는 여유에는 가격이 매겨집니다.
과학으로는 serving load, continuous batching과 paged-KV 수치, KV pressure 아래 preemption, wall-time erosion을 agentic LLM evaluation의 hidden variable로 본 controlled characterization의 첫 결과입니다. precision(tool-call cliff)과 model-tier/quantization(precision ladder) frontier 위에 utilization 축을 추가해 cliff 시리즈를 완성하고 utilization illusion(closed-form 내부 최대점)과 double cliff(precision interaction)을 주 결과로 둡니다.
한계: 실측이 아니라 실측을 등록한 논문
이 논문은 analytical paper이며 positional paper입니다. formalization, closed-form 조건, load-induced drift가 어디서 오는지에 대한 channel-decomposition account, pre-registered falsifiable 프로토콜이 전부입니다. 새로운 measurement는 없고 모든 그림은 선언된 가정에 대한 closed-form 예측입니다.
scope은 설계상 좁습니다. 단일 accelerator(H200), 단일 model family(Qwen3 series checkpoints), single-turn 60-item BFCL-v3 서브셋입니다. multi-turn trajectory와 token-wise replay discipline은 base protocol 밖입니다. MoE routing, speculative decoding, distributed scheduling은 future axis이고 이론에는 t(u)와 eps_u로만 들어옵니다. 선언된 self-hosted rate인 input 1.50달러, output 0.60달러 per MTok은 시리즈 상수지 market quote가 아닙니다. H는 rate-invariant ratio이고 beta(u)의 level만 선형으로 rescale됩니다.
frontier를 측정으로 채우는 역할을 pre-registered 프로토콜이 담당합니다. 선언된 H200 플랫폼에서 1:1 refutation criterion을 지닌 네 개의 예측입니다. P1은 engine metrics에서 읽은 KV knee까지 Q(u)가 noise floor 안에서 평탄하고 그 이후에 감소한다고 하고 flat region이 u_kv/2 아래에서 끝나거나 C=4에서 평탄 지역 없이 Q가 monotone 감소하면 반증됩니다. P2는 knee 이후 parallel 카테고리 드리프트가 simple 카테고리보다 큼(kappa_u > 1)을 주장하고 noise floor를 넘는 어떤 level에서 simple 드리프트가 parallel 드리프트 이상이면 반증됩니다. P3은 같은 item set에서 low-bit checkpoint의 드리프트 knee가 16-bit보다 앞당겨지고 endpoint tax가 더 크다고 하고 primary comparison은 precision이 model size와 confound되지 않도록 same-size precision pair인 27B bf16 대 27B NVFP4이며 base sweep checkpoint는 Qwen3-8B bf16입니다. P4는 validation-gated resampling이 load u에서 유도된 드리프트의 적어도 delta_eff(u) = delta(1 - phi_s(u))를 회복한다고 하고 silent share phi_s는 측정하는 값이지 가정이 아닙니다. concurrency sweep는 C = {1, 2, 4, 8, 16, 32, 64, 128, 256} 수준, 곧 1에서 256까지, 고정 60-item function-calling 서브셋 위에서 돌고 level마다 in-flight 요청이 C 이상으로 유지되도록 반복됩니다.
프레임 자체에도 registered falsifier가 있습니다. 드리프트가 sweep 전체에서 noise floor 안에서 평탄하면 utilization 축은 이 플랫폼과 워크로드 클래스에서 null result입니다. tau_u는 0이고 내부 최대점은 assumed tax shape의 artifact입니다. throughput law가 hill form에서 이탈하면 s_crit의 form은 바뀌지만 beta(u) = r/E(u)와 headroom-price 구조는 E의 모양만으로 살아남습니다. phi_s가 negligible이면 gate proposition은 load-free dividend로 퇴화하고 crossover는 이동하지 않습니다. 채워진 frontier의 모든 드리프트 주장은 run-to-run null인 d(u) > max(1, F)를 넘겨야 하고 flat-region test(P1)는 load 축에 적용된 같은 discipline입니다.
프로토콜이 frontier에서 읽는 safe concurrency ceiling이 factory의 operating number입니다. knee를 조금 지난 아래에서 운영하며 headroom을 다른 모든 것과 같은 화폐로 지불합니다.
이 글의 세 장은 전부 분석 모델의 closed-form 예측이며 실측이 아닙니다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있습니다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-13-concurrency-tax-agentic-tool-calling