The Night Oncall: K8s 온콜 에이전트의 밤새 자기 진화, 동결 홀아웃으로 점수 매기면 개선은 클래스 경계에서 멈춘다
매 밤 incident를 다루고 실패에서 자기 레슨을 다시 쓰는 온콜 에이전트를 두고 다음 아침에 개선된 것처럼 보이면 그 버전을 클러스터로 올리는 운영을 하거나 계획 중인 국내 클라우드·AI 엔지니어라면 이 글을 읽어야 합니다. 이 논문이 실측한 것은 이 운영이 반드시 던지는 질문입니다. 에이전트 스스로가 주장하는 개선이 진짜인지, 그리고 그것이 정확히 어디까지인지. ThakiCloud의 논문 “The Night Oncall: Measuring Overnight Self-Evolution of K8s Incident-Remediation Skills Against Frozen Fault-Injected Holdouts”는 Kubernetes 온콜 에이전트의 밤마다 포스트모템 기반 자기 진화 루프를 4개 밤에 걸쳐 측정합니다. 결정론 온콜 에이전트가 매 밤 seed-deterministic 장애 주입 incident 42건을 다루고 개선 여부는 라우팅·진단 recall이 아니라 ground-truth 사고 결과, 즉 zero collateral damage 동반의 안전 복구를 기준으로 채점합니다.
문제의식: 밤사이 나아진 건 진짜이고, 어디까지인가
클라우드 신뢰성은 결국 인력의 시간으로 가격 매겨집니다. page 하나하나가 운영자를 방해하고 인간이 루프 안에 머무는 시간이 길수록 사고 비용이 커지기 때문입니다. 이런 맥락에서 클러스터 접근권이 있는 LLM 에이전트는 사고를 진단하고 복구하거나 에스컬레이션하는 자율 L1 온콜 응대자로 점점 더 제안되고 있습니다. 저희의 정적 K8s 온콜 에이전트 연구(2026-09-09)는 정적 에이전트의 binding constraint가 토큰 비용이 아니라 collateral damage 상한과 능력임을 보여 주었습니다. 그 전선은 runbook 지식이 동결된 버전 V0를 어디까지 배포해도 되는지를 말해 줍니다. 그런데 production 운영은 정적이지 않습니다.
에이전트는 점점 더 밤새 무인 상태로 두어져, 포스트모템에서 자기 스킬을 고치도록 맡겨지고 있습니다. 2026년의 자기 진화 agent harness 연구들은 개선된 harness를 편집을 이끈 것과 동일한 benchmark로 채점하는데, 이것은 정확히 Goodhart’s law가 경고하는 설정입니다. 저희는 이 위험을 Goodhart shift로 정식화해 둔 바 있습니다(2026-08-29). 자기 진화 에이전트가 보이는 케이스에서 얻는 개선과, 한 번도 관찰하지 못한 sealed holdout에서 얻는 개선 사이의 격차가 밤마다 벌어지는 현상입니다.
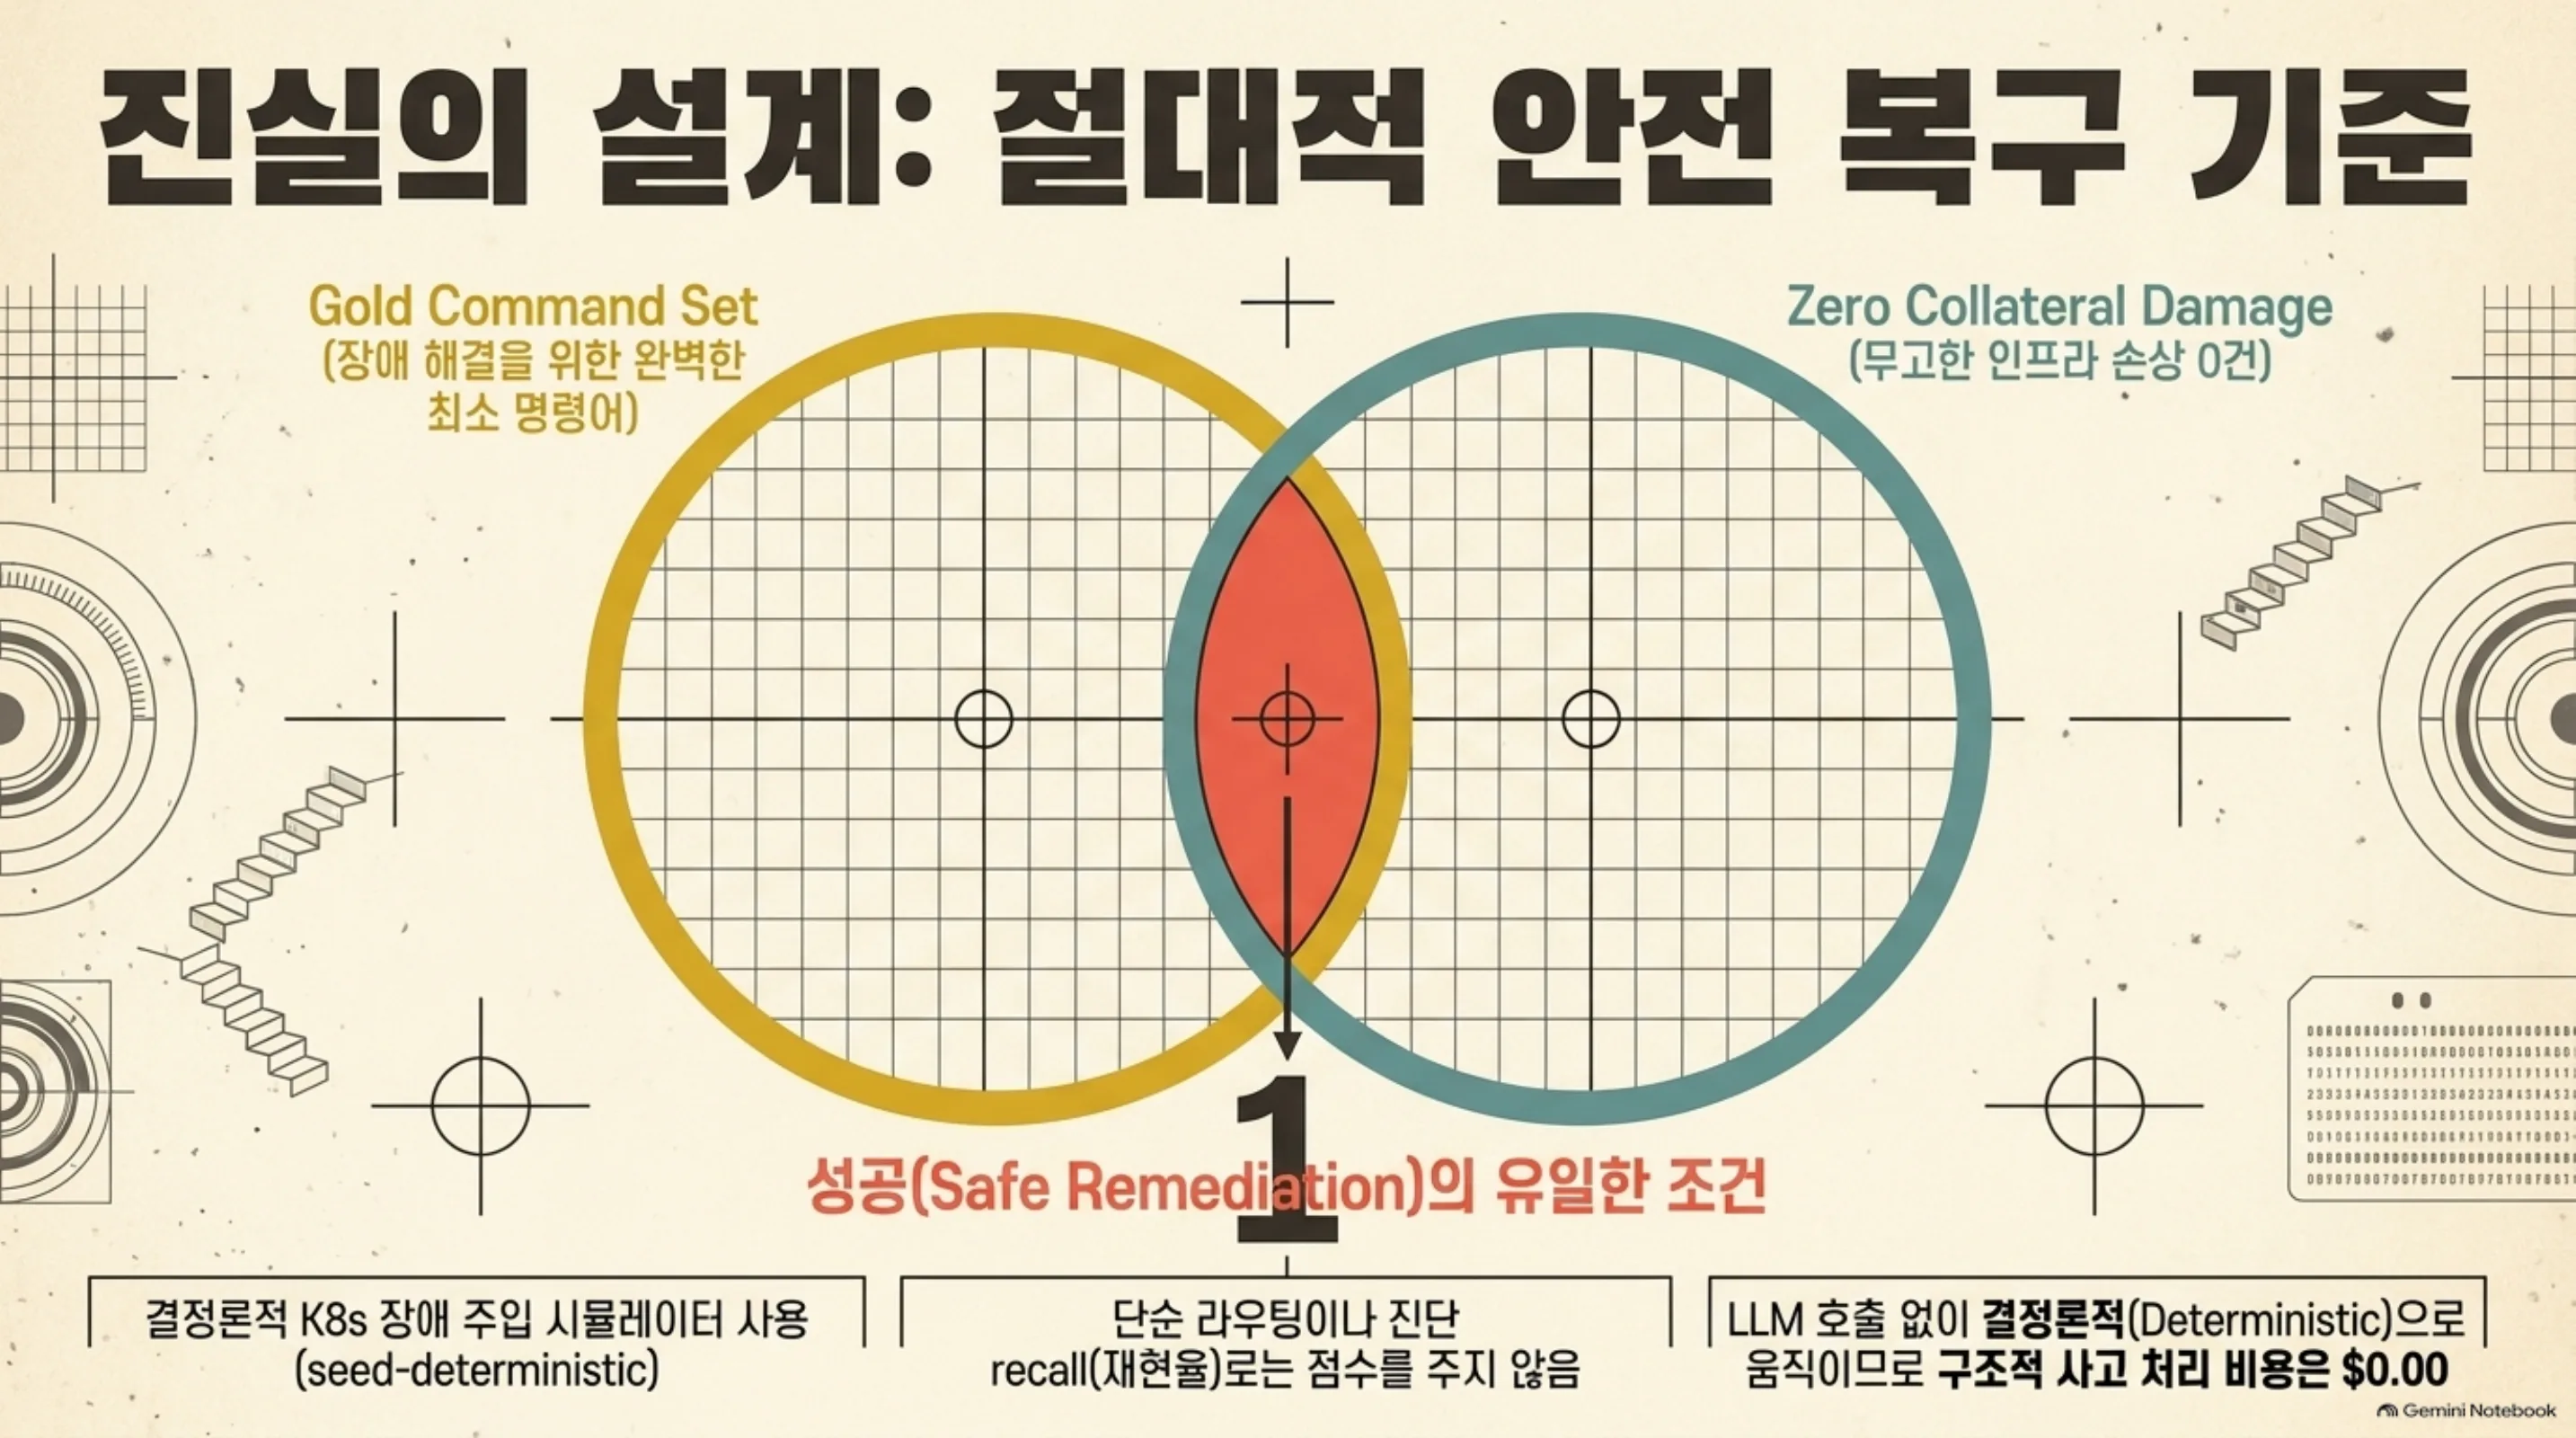
그러면 온콜의 배포 질문은 둘로 나뉩니다. 밤마다 포스트모템 기반의 자기 진화 루프가 실제 사고 결과에서 안전 복구율을 정말로 올리는지. 그리고 올린다면, 그 개선이 루프가 한 번도 본 적 없는 장애 앞에서 생존하는지, 아니면 편집한 바로 그 incident의 Goodhart artifact에 불과한지. 이 논문의 첫 번째 설계 결정은 채점 기준입니다. incident는 에이전트가 실행한 command set이 world의 정확한 gold command set과 일치할 때에만 “해결”되고, collateral damage set의 아무것도 건드리지 않았을 때에만 “안전”합니다. 라우팅 recall이나 진단 recall은 점수가 아닙니다.
실험 설계: 매 밤 42건, 그중 30건은 루프가 구조적으로 볼 수 없음
사고 world는 seed-deterministic한 multi-namespace Kubernetes 장애 주입 시뮬레이터입니다. 각 world는 (fault class, seed) 쌍으로, 주입된 장애를 정의하고 장애를 해결하는 최소 gold command set, 실행하면 손상을 일으키는 collateral command set을 지닙니다. ground truth는 구조적으로 결정됩니다. incident는 실행한 command set이 gold set과 같을 때에만 해결되고 collateral command를 하나도 실행하지 않았을 때에만 안전합니다. live cluster도 학습된 oracle도 없으며 모든 outcome은 정확히 판정 가능합니다.
고유한 fault class는 다섯입니다. crash-loop backoff, OOM kill, quota starvation, stuck leader lease, node drain으로, 정적 전선 연구에서 쓰던 분류 체계입니다. 미노출 클래스는 네 가지입니다. expired TLS certificate, label/selector mismatch, stuck horizontal pod autoscaler, node disk pressure입니다. 동결 split은 매 밤 42개 world를 두 축으로 나눕니다. fault class가 루프에 한 번이라도 노출되었는지, seed가 그랬는지.
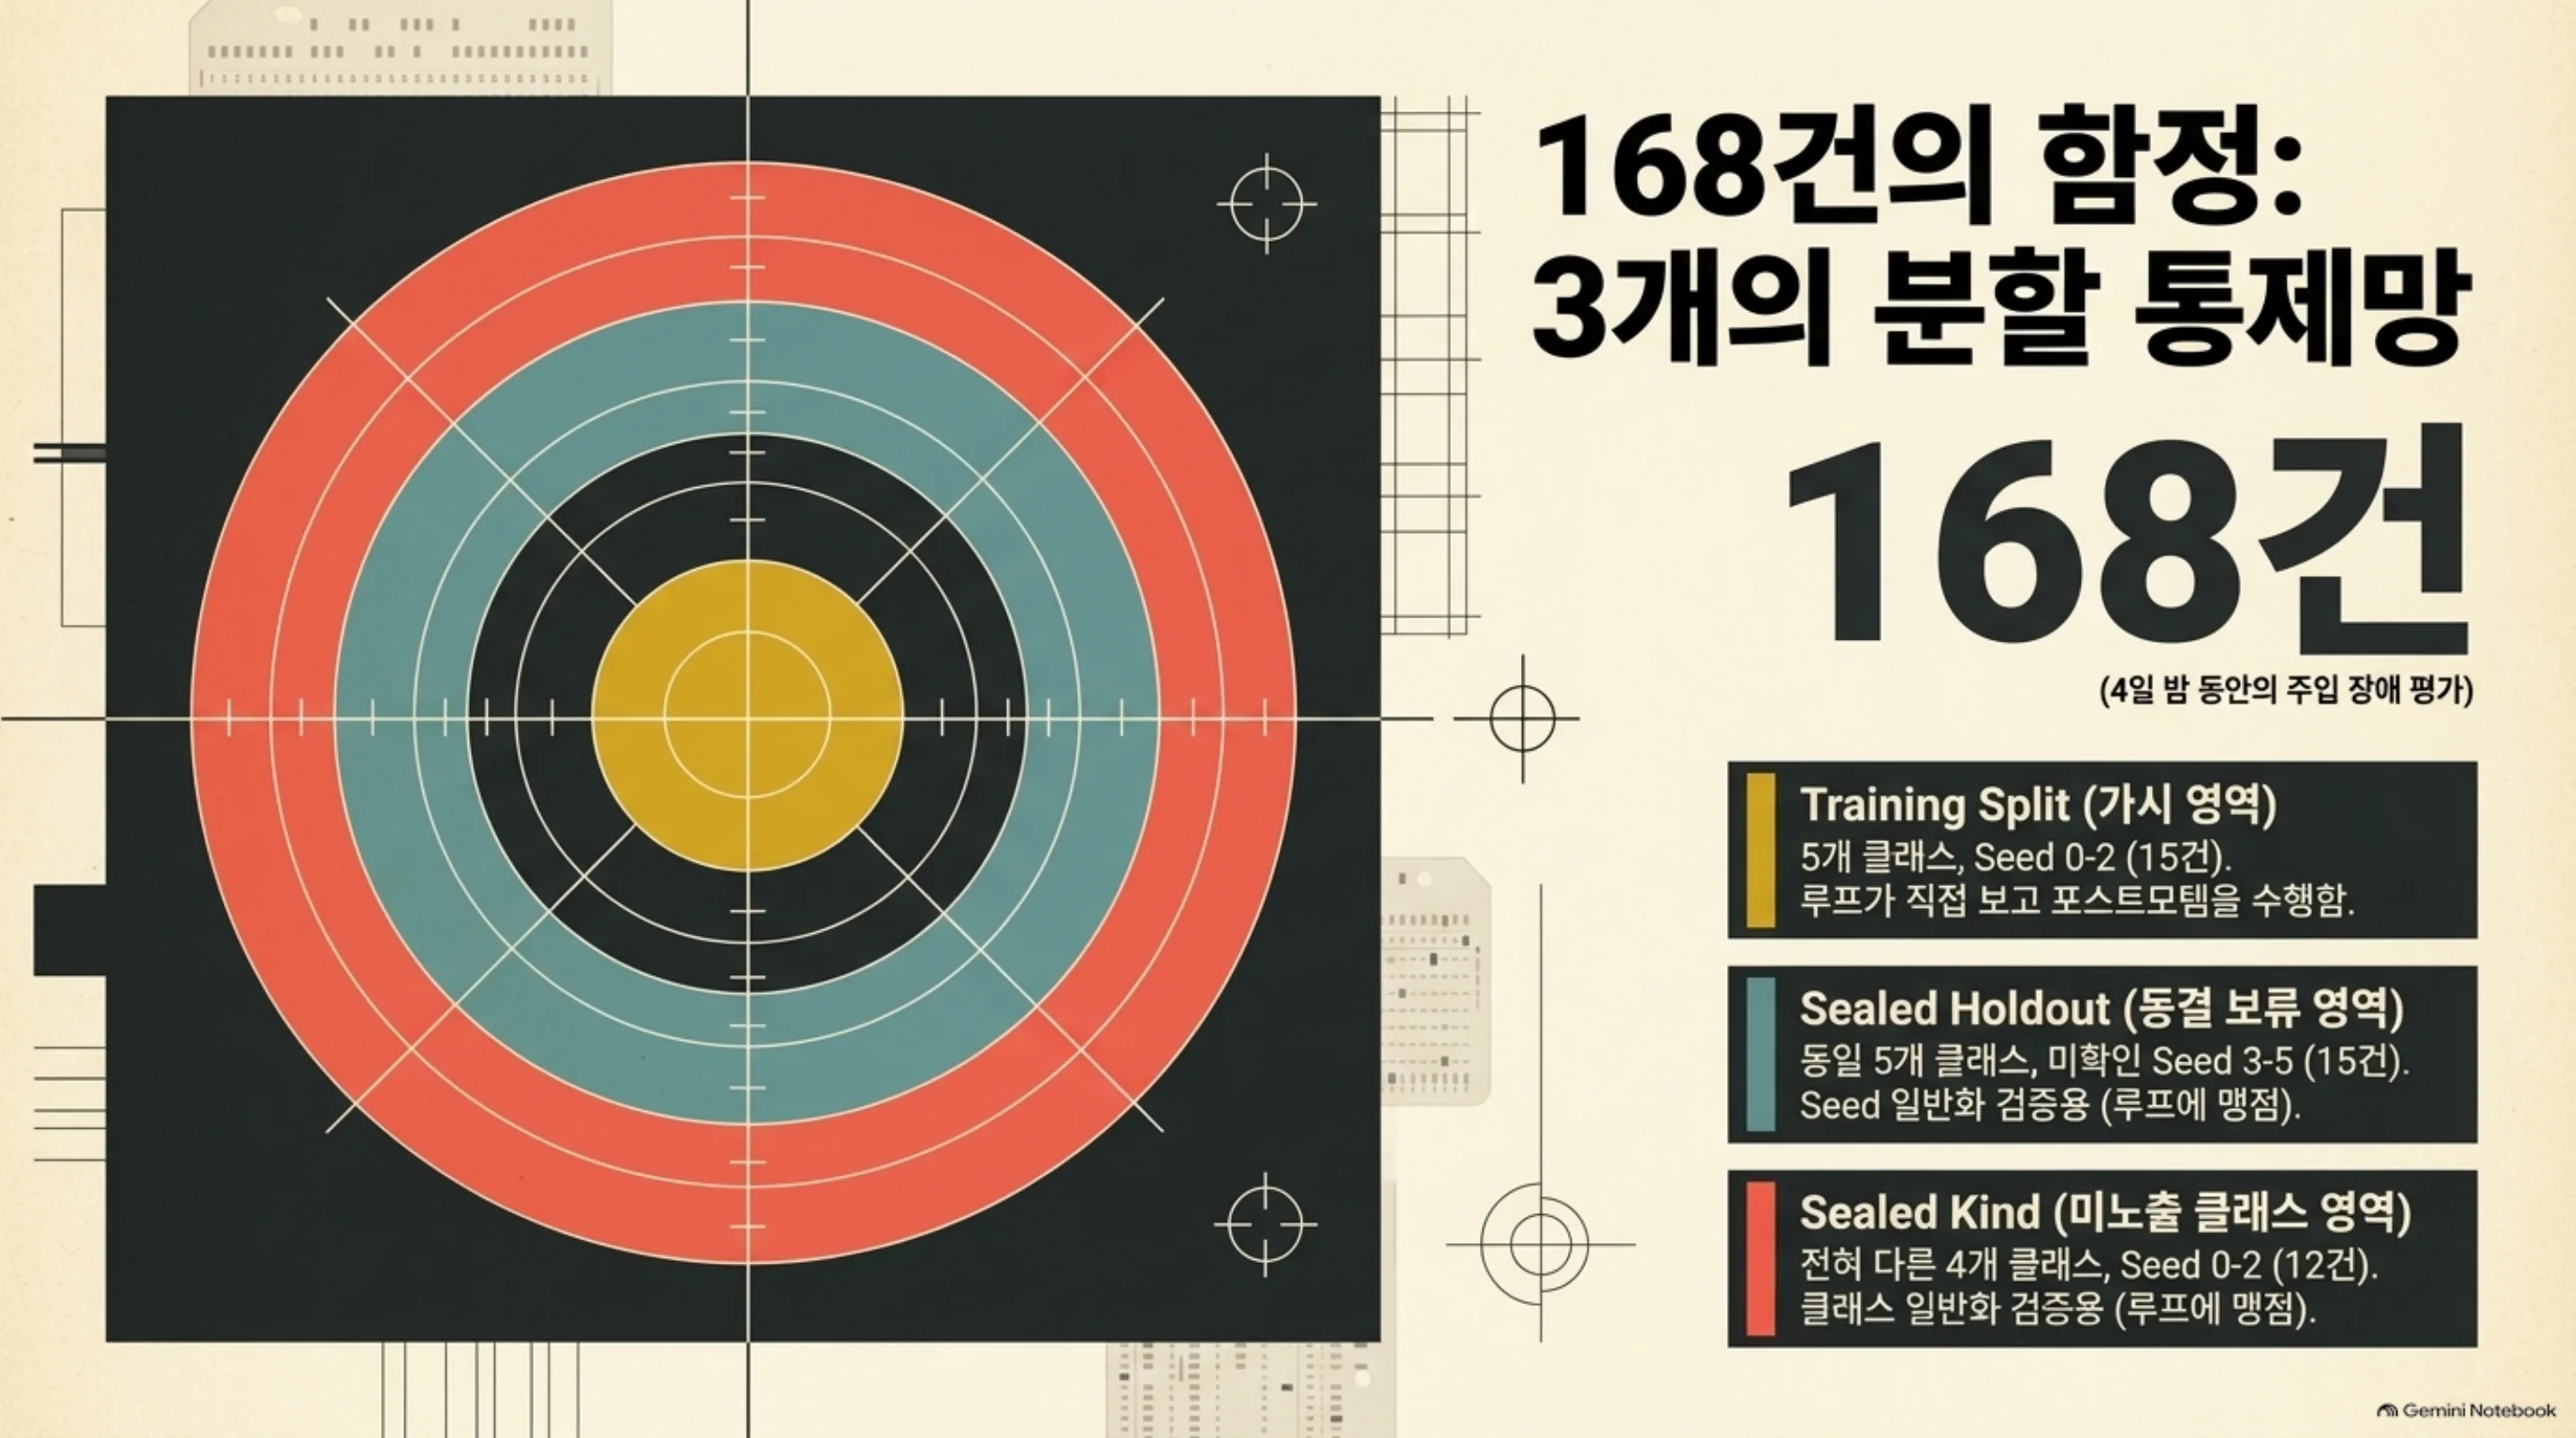
training split은 5개 고유 클래스, seed 0-2의 15건이다. visible이고 포스트모템과 게이트를 이룬다. sealed holdout은 같은 클래스, 미확인 seed 3-5의 15건으로 seed 전이를 시험한다. sealed kind는 4개 미노출 클래스, seed 0-2의 12건이다. 클래스 일반화 여부를 가르는 것이다. 4개 밤 동안 168건이 채점되고 이 중 108건이 sealed split에 있다. 모든 설정은 (class, seed) 쌍에서 재현한다. 진화 루프는 sealed split에 구조적으로 맹하다. 외부 scorer가 매일 평가하고 sealed outcome은 포스트모템에도 게이트에도 도달하지 못한다.
보고되는 arm은 결정론 skill interpreter인 셈이다. 에이전트는 레슨 목록을 지닌다. 각 레슨은 (label, fix template) 쌍이다. incident에서 고정 3-4건의 read-only 관찰(get pods, get events, get nodes, describe)을 수행하고 관찰된 symptom과 label이 일치하는 첫 번째 레슨을 골라 fix template을 실행한 뒤 멈춘다. 일치하는 레슨이 없으면 행동 없이 에스컬레이션한다. LLM 호출이 zero라, 실측한 incident당 평균 비용은 구조적으로 $0.00인 것이다. 현역 V0은 2026-09-09에서 측정한 정적 runbook 지식이며 4개 레슨을 지닌다. crash-loop는 rollout undo, OOM은 delete pod, quota starvation은 delete pod, node drain은 drain {node} --force이고 stuck leader lease 항목은 없다.
하루 밤의 구조는 이렇다. 각 night k = 0, 1, 2, 3에서 먼저 활성 버전이 세 split의 42개 world 전체를 복구한다. 포스트모템은 mechanical template 아래 training 실패에만 실행한다. 실패한 레슨은 hindsight-correct한 클래스 fix로 제자리 교체되고 레슨이 없던 실패 클래스에는 하나가 추가된다. 결과가 후보 버전인 셈이다. promotion gate는 deferred이고 train-only이다. 후보를 night k+1에 활성화하고 그 밤의 training safe rate가 전 밤보다 낮으면 rollback한다. 게이트의 threshold set은 루프의 writable surface 바깥에 완전히 위치하며 sealed split은 어떤 편집이나 판정에도 정보를 주지 않는다.
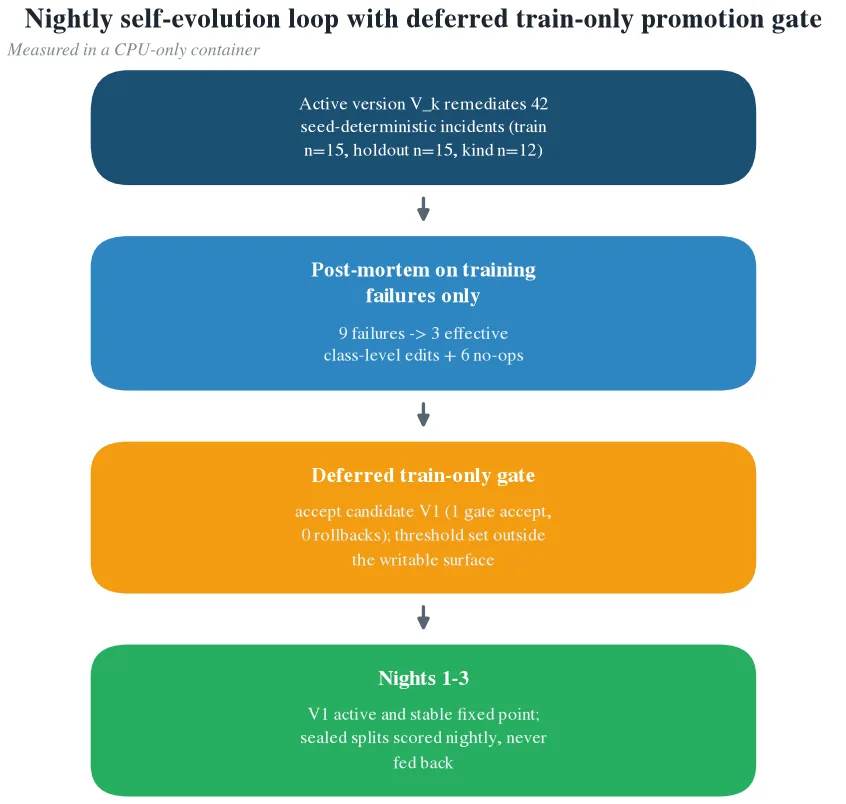 한 밤 주기 하나의 구조인 것이다. 활성 버전이 42건의 장애 주입 incident 전체를 채점받고 mechanical 포스트모템이 training 실패의 레슨만 편집하며 deferred train-only 게이트가 training이 회귀하지 않는 한 후보 버전을 다음 밤에 승인한다. sealed holdout과 kind split은 외부 scorer가 매일 채점하지만, 어떤 편집이나 판정에도 피드백되지 않는다. (실측. CPU-only 컨테이너에서 측정.)*
프로토콜은 이 논문에 보고되지 않는 metered LLM arm도 고정해 둡니다. 같은 interface를 Claude Haiku 4.5(claude-haiku-4-5-20251001) tool loop가 제공하고 incident당 관찰을 2건으로 상한하며 모든 API 호출은 input/output 토큰 100만 개당 $0.80/$4.00으로 metering됩니다. 포스트모템 레슨은 free text이며 밤당 5개를 상한으로 둡니다. LLM arm의 cost-quality trajectory는 follow-up 연구의 대상입니다.
결과: 한 밤의 +0.60, 그리고 클래스 경계 바로 위의 상한
night 0에서 현역 V0은 5개 고유 클래스 중 정확히 두 개, crash-loop와 node drain에서만 안전합니다. OOM과 quota 레슨(delete pod)은 무해하지만 효과적이지 못합니다. 에이전트는 행동하고 손상은 없으며 장애는 재발하기 때문입니다. stuck leader lease 레슨이 없는 incident는 정보를 얻지 못한 채 에스컬레이션됩니다. night 0의 safe rate는 training과 holdout에서 0.40이고 kind에서는 모든 incident가 에스컬레이션하여 0.00입니다.
Night 1은 캠페인 유일의 편집 밤입니다. night 0의 training 실패 9건, OOM·quota starvation·stuck leader 각각 3건이 포스트모템 액션 9개를 유발합니다. 그중 3개가 유효한 편집이고 6개가 no-op인데, mechanical template은 레슨당 밤당 최대 한 번만 적용하기 때문입니다. OOM 레슨은 제자리에 교체되고 delete pod가 1Gi limit과 512Mi request를 지닌 set resources로 바뀝니다. quota starvation 레슨은 교체되고 delete pod가 quota를 소비하는 배치 job nightly-batch에 대한 delete job이 됩니다. stuck leader lease 레슨은 추가되고 scheduler의 lease kube-system/leader-scheduler에 대한 delete lease입니다. 두 base 레슨(crash-loop, node drain)은 그대로 살아 있습니다. V1은 V0에 3개 class-level 레슨을 더한 것입니다. 효과 없던 fix 두 건의 교체와, V0에 없던 한 건의 추가.
V1 아래에서 safe remediation은 training과 holdout 모두 1.00으로 도약합니다. 두 split 모두 +0.60이고 kind는 0.00으로 유지됩니다. diagnosis accuracy는 0.80에서 1.00으로, escalation rate는 0.20에서 0.00으로, training과 발을 맞춥니다.
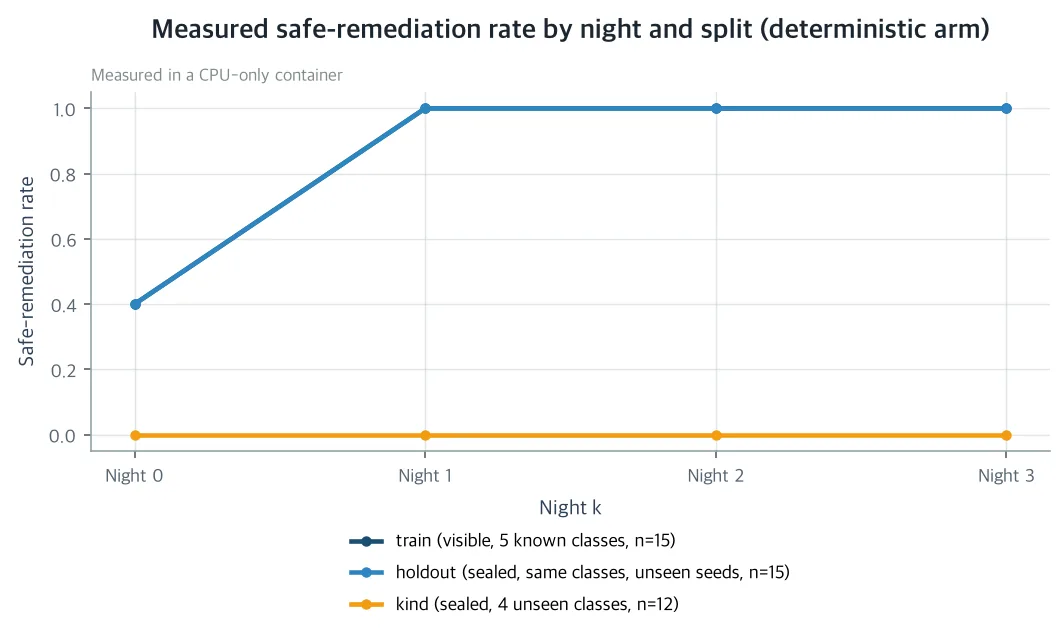 visible training split, sealed same-class holdout, sealed unseen-class kind split의 4개 밤 캠페인 전체 안전 복구 비율입니다. training과 holdout은 매 밤 일치하고 kind는 0.00으로 평탄하게 유지되며 Night 1이 유일한 편집 밤입니다. (실측. CPU-only 컨테이너에서 측정.)
sealed holdout에서 어떤 일이 일어났는지 보면, transfer인지 memorization인지가 가려진다. night 0에서 실패한 sealed holdout incident 9건, OOM·quota starvation·stuck leader의 미확인-seed 대응물 전체가 night 1에서 safe로 플립한다. case flip 9건, 전부 silent, 전부 개선 방향이다. 루프의 어떤 편집도 그중 어느 것을 목표로 하지 않았다. 같은 세 class-level 레슨이 미확인 seed에도 적용되어 플립한 것이다. 그 뒤 flip은 zero이다. holdout의 개선은 전이된 것이지, incident level에서 암기된 것이 아니다.
미노출 클래스 네 개는 한 번도 플립하지 않는다. 12건의 kind incident 전체가 매 밤 에스컬레이션하고 diagnosis accuracy는 0.00, escalation rate는 1.00로 유지된다. 최대 train-kind divergence는 0.60으로, 캠페인의 training gain 전체와 정확히 같다. kind transfer ratio는 0.0이다. 캠페인에 대해 우리가 기록하는 verdict는 memorization ceiling이다. 루프는 관찰한 fault class 안에서 seed를 가로질러 일반화하고 관찰하지 못한 클래스 경계에서 단단한 선을 긋는다.
Nights 2와 3은 고정점이다. training 실패도 포스트모템 편집도 후보도 없으며 V1이 내내 활성이다. 이 캠페인에서 루프의 compounding는 한 밤으로 끝난다. promotion gate는 한 번 발화한다. V1이 night 1에서 승인되고(training safe rate 1.00 ≥ 0.40) 한 번도 rollback되지 않았다. 제안된 버전은 통째로 하나뿐이다. damage는 168건의 전 채점 incident에서 0.00이고 incident당 평균 비용은 모든 split에서 $0.00으로 유지된다.
이 대비가 포인트다. 루프가 training만으로 채점받았다면, night 1은 눈에 보이는 회귀가 없는 깨끗한 +0.60 성공으로 읽혔을 것이다. 그리고 루프가 볼 수 있는 모든 split에서 그것은 여전히 사실일 것이다. sealed split은 암묵적인 일반화 주장을, 어떤 자기 보고도 만들 수 없는 실측된 비율, kind에서 0.0,로 바꿔 준다.
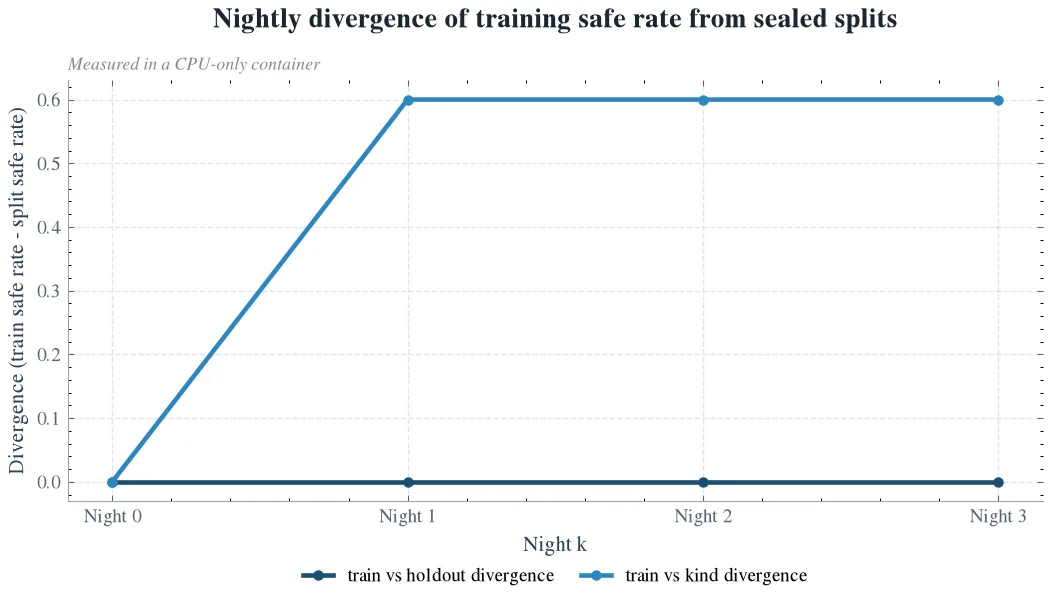 train-holdout divergence는 매 밤 0.00으로 유지되는 동안, train-kind divergence가 Night 1에서 0.60으로 벌어지고 그 수준을 유지한다. 이것은 캠페인의 training gain 전체와 같다. 실측된 격차는 벤치마크 과적합이 아니라 클래스 경계에 있다. (실측. CPU-only 컨테이너에서 측정.)
의미: 상한은 어디에, 게이트는 무엇을 볼 수 없고, 회사·사회·과학에 무엇이 남나
상한은 벤치마크 과적합이 아닙니다. 고전적 Goodhart 과적합은 train-holdout divergence가 양수로 보이는 형태입니다. 루프가 볼 수 있는 특정 incident를 game하는 것이지요. 여기서는 그렇게 일어나지 않습니다. train-holdout divergence는 매 밤 0.00인데, editable surface가 class-level이기 때문입니다. 각 포스트모템 편집은 fault class로 인덱싱된 레슨을 다시 쓰는데, 그런 재작성은 해당 클래스의 모든 seed로 전이하거나, 전혀 전이하지 않습니다. 실측된 divergence는 대신 kind split에 있고, 다른 실패를 격리해 줍니다. incident에 과적합하는 것이 아니라, 클래스 경계로의 미도달입니다. 루프는 한 번도 본 적 없는 장애의 레슨을 만들 수 없으므로, 개선은 관찰한 클래스의 합으로 정확히 상한됩니다. 두 sealed split은 서로를 보충하는 측정 기구입니다. same-class holdout은 개선이 incident level 암기가 아님을 보증하고 kind split은 클래스 level 일반화도 아님을 보증합니다. 자기 보고하는 루프는 둘 다 보지 못하고 sealed scorer는 둘 다 봅니다.
train-only 게이트는 의도적으로 최소한의 Goodhart 방어입니다. training safe rate를 밤마다 비교하고 회귀를 rollback하는 것이지요. 구조적으로 sealed split에는 맹입니다. threshold set이 루프의 writable surface 바깥에 있도록 설계된 결과라, Goodhart shift가 silent case flip으로 정의한 회귀에는 정확히 보이지 않습니다. 이 캠페인에서 blind spot은 무해합니다. mechanical 포스트모템이 hindsight-correct한 클래스 fix만 쓰기 때문에, silent flip 9건은 전부 개선 방향이기 때문입니다. 설계 교훈은 역할 분담입니다. 게이트의 non-regression test가 루프를 churn으로부터 보호하고 silent sealed-split 회귀는 외부 sealed 채점 자체에서 막아야 합니다. 저희는 동결 holdout과 kind, 매일 채점되고 피드백되지 않는 둘을, 진화된 스킬이 live cluster를 만나기 전의 promotion gate로 설치합니다. editable surface가 free-text LLM 레슨이나 control parameters로 넓어지는 순간, silent-regression special case는 실제로 살아 움직이고 self-editing surface 바깥의 결정론 guardrail이 최소 안전 구성이 됩니다.
ThakiCloud에 이 실측이 남기는 것은 구체적입니다. 무인 nightly evolution이 RCA·remediation 스킬에서 사고 결과의 실제 개선으로 compounding되는지를 실측으로 답하고 진화된 스킬이 live cluster를 만나기 전 promotion gate로 동결 incident holdout과 kind holdout을 설치하는 것입니다. 2026-09-09에서 측정한 정적 온콜 에이전트를, 명시적인 cost-per-incident budget를 지닌 계속 개선되는 에이전트로 바꿉니다. V0은 정적 전선의 현역이었으니 5개 고유 클래스 중 두 개에서만 안전했습니다. overnight 루프는 전선을 capability 축으로 이동시킵니다. night 1에 5개 고유 클래스 전체가 zero 증분 비용으로 safe해지고 전선이 다음으로 bind되는 곳은 실측된 비율로 못 박힙니다. 미노출 클래스입니다. 그곳에서 에이전트의 안전한 동작은 에스컬레이션이고 남은 incident 질량을 살 수 있는 것은 generalization-capable arm이거나 인간입니다. 루프는 정적 분석이 runbook-grade라고 말하는 클래스에서 정확히 가장 저렴하고 실측된 상한은 남은 incident mass가 LLM arm에 속한다는 신호입니다.
회사를 넘어, safety-critical한 자율 클라우드 운영을 하는 팀에 이 연구는 실패에서 자기 개선이 조용히 degrade하지 않은 채로 진행될 수 있는지를 보여주는 방법입니다. K8s remediation에 적용된 train-vs-holdout Goodhart discipline은 human on-call 부담과 반복적으로 실패하는 incident loop의 compute 낭비를 함께 줄입니다. 과학으로는, 저희가 아는 범위에서, 이것이 routing이나 diagnosis recall이 아니라 ground-truth task outcome, 즉 장애 주입 K8s incident의 binary remediation success로 채점된 무인 overnight skill evolution의 첫 실측입니다. train-vs-kind-holdout divergence와 self-editing ops 스킬의 compounding cost-per-incident trajectory를, (class, seed) 쌍에서 모든 outcome이 정확히 판정되는 reproduction-grade incident world에서 특성화합니다.
한계: 이 루프의 상한이고, 전선의 한 corner일 뿐
horizon은 짧고 클래스 커버리지는 좁습니다. 4개 밤, 5개 고유 클래스와 4개 미노출 클래스, seed 0-5입니다. 고정점 주장은 이 horizon 안에서만 성립합니다. kind 클래스는 저희가 고른 것인데, expired TLS certificate 같은 일부는 runbook-adjacent라, 더 풍부한 루프라면 그것으로도 전이할 수 있습니다. 실측된 상한은 이 루프의 상한입니다.
포스트모템에는 teacher signal이 있습니다. mechanical template이 실패한 레슨을 hindsight-correct한 클래스 fix로 다시 쓰므로, 이 논문은 teacher signal corner를 측정합니다. 순수 self-generated 레슨, LLM arm의 free-text 포스트모템은 더 멀리 일반화할 수도, train-only gate가 볼 수 없는 방식으로 sealed split을 silently degrade할 수도 있습니다.
ground truth는 구조적으로 결정되고 cost axis는 zero인 corner입니다. outcome은 정확히 결정되지만, 실제 incident는 multi-step이고 partially ordered인 repair, partial credit, environmental non-determinism을 지닙니다. metric-to-parameter map은 live cluster에 대해 calibrate할 수 있도록 설계되어 있고 calibration은 이 논문에서 보고되지 않습니다. 결정론 에이전트에서 cost axis는 identically zero라서, cost-quality frontier는 한 corner에서만 특성화됩니다. metered LLM arm, free-text 레슨과 cost cap를 같은 동결 split에서 실측하는 것이 다음 측정입니다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있습니다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-11-overnight-oncall-skill-evolution-k8s