The Parallelism Dividend: 무인 에이전트 루프의 병렬 호출 배당, 벽시간과 토큰 두 단위로 가격 매기면 바닥은 harness에, 천장은 model에 속한다
국내 클라우드/AI 엔지니어 중, self-hosted GPU(H200 class) 위에서 무인(multi-step, unattended) 에이전트 루프를 돌리거나 돌릴 계획이 있는 분이 이 글을 읽으면 됩니다. 읽어야 하는 이유는 루프 안의 병렬화를 model에게 맡길지 harness가 대신할지에 대한 선택의 비용이 이 글의 주제이기 때문. 툴 호출 하나하나가 벽시간과 토큰 청구로 청구되는 루프를 운영한다면 답은 window 길이와 그 model의 병렬 호출 갭에 의존합니다. ThakiCloud의 논문 “The Parallelism Dividend: Measuring Wall-Time and Token Cost Savings of Harness-Flattened Parallel Tool-Calling at Fixed Task Accuracy in Unattended Agent Loops on Self-Hosted H200”는 이 의존을 fixed task accuracy에서 벽시간과 billed token 두 단위로 closed form에 가격 매깁니다. 이 논문은 분석 논문입니다. 모든 숫자는 선언된 nominal 가정에 대한 closed-form 예측이거나 인용 참조로 귀속된 실측 결과입니다. pre-registered 반증 기준을 지닌 falsifiable 3-arm 프로토콜이 함께 붙습니다.
문제의식: 무인 루프는 독립적인 호출을 직렬로 막고, model의 병렬 호출은 별개의 스킬
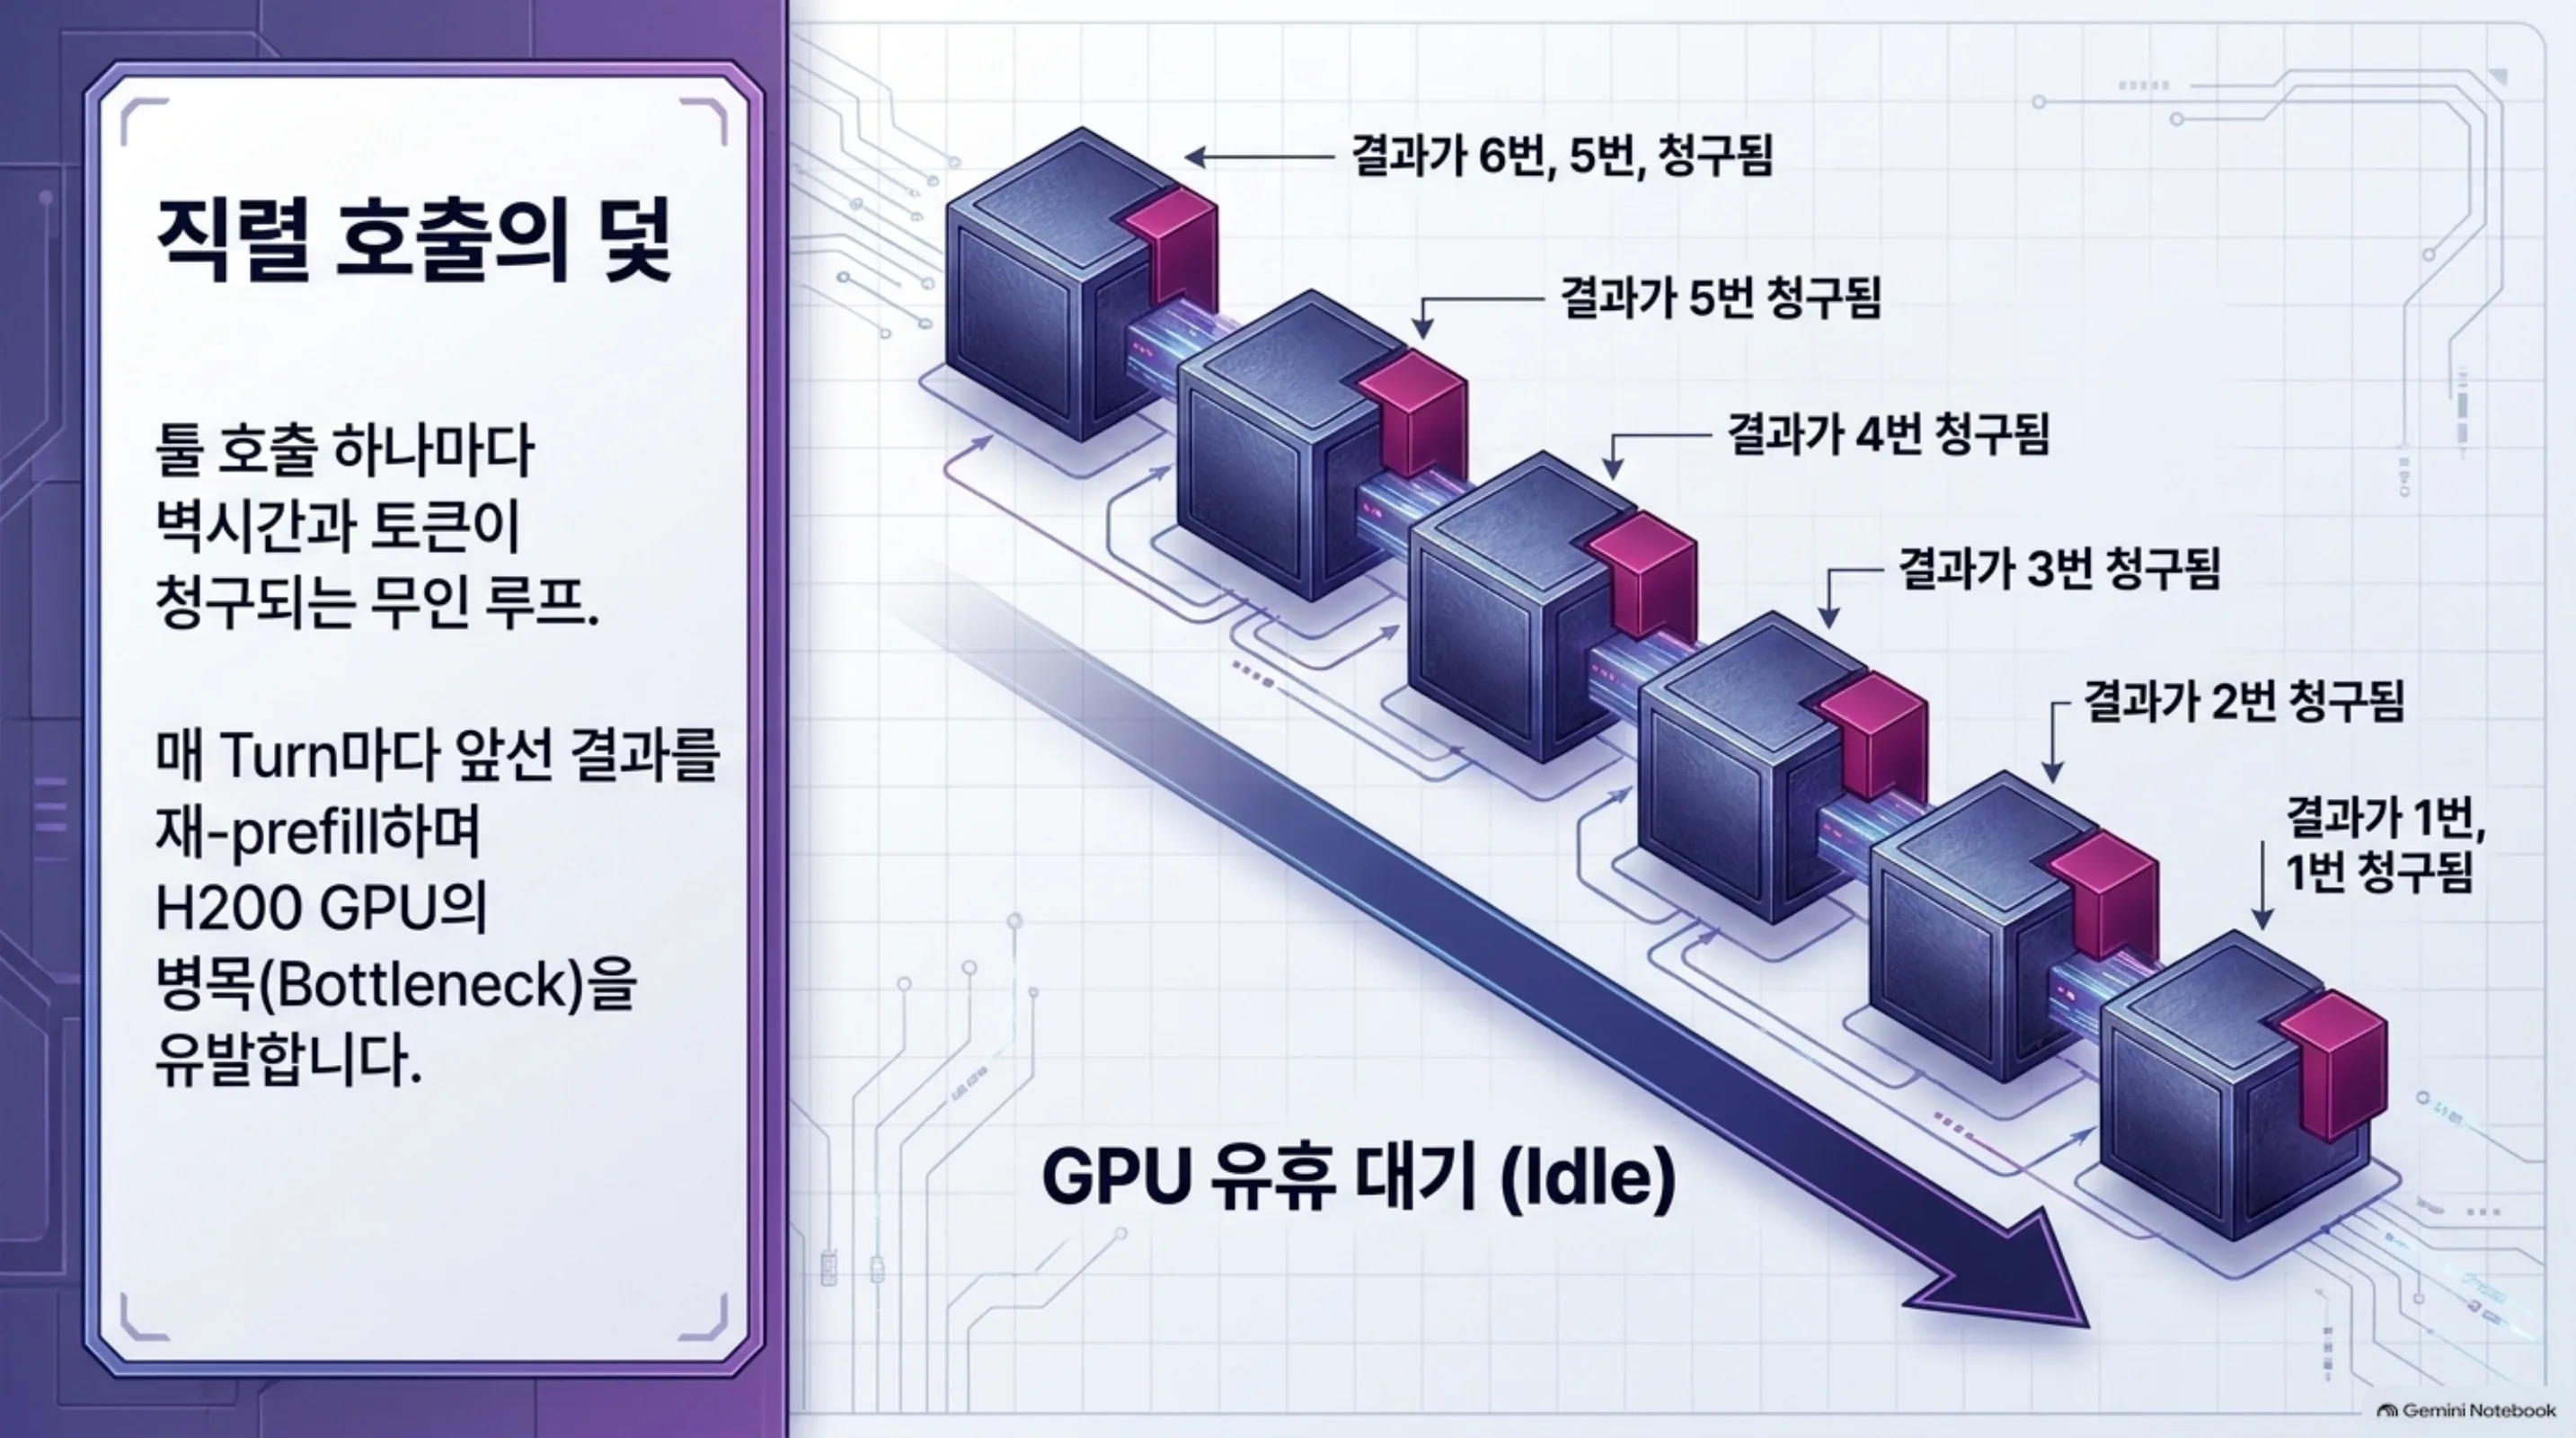
기본 에이전트 harness가 ReAct 스타일이라면 model turn 하나에 tool call 하나를 내보내고 tool 결과에 block한 뒤 축적된 결과를 context로 다시 넣습니다. 그래서 fan-out 단계의 매 turn은 그 앞의 모든 결과를 재-prefill합니다. 6개 호출의 gather phase에서는 결과가 6번, 5번, 4번, 3번, 2번, 1번 청구되고 GPU는 window 안의 tool latency 하나마다 유휴로 섭니다.
한편 model이 한 메시지에 여러 호출을 내보내는 능력은 하나의 호출을 내보내는 능력과 별개의 스킬입니다. Berkeley Function Calling Leaderboard(BFCL)는 이를 별도 category로 보고하고 parallel 점수는 simple 아래에 있습니다. 저희 serving 환경의 27B NVFP4 checkpoint에서도 이 격차가 보이며 simple 90.8% 대 parallel 88.0%, 갭 g = 2.8pp(선언된 nominal)입니다.
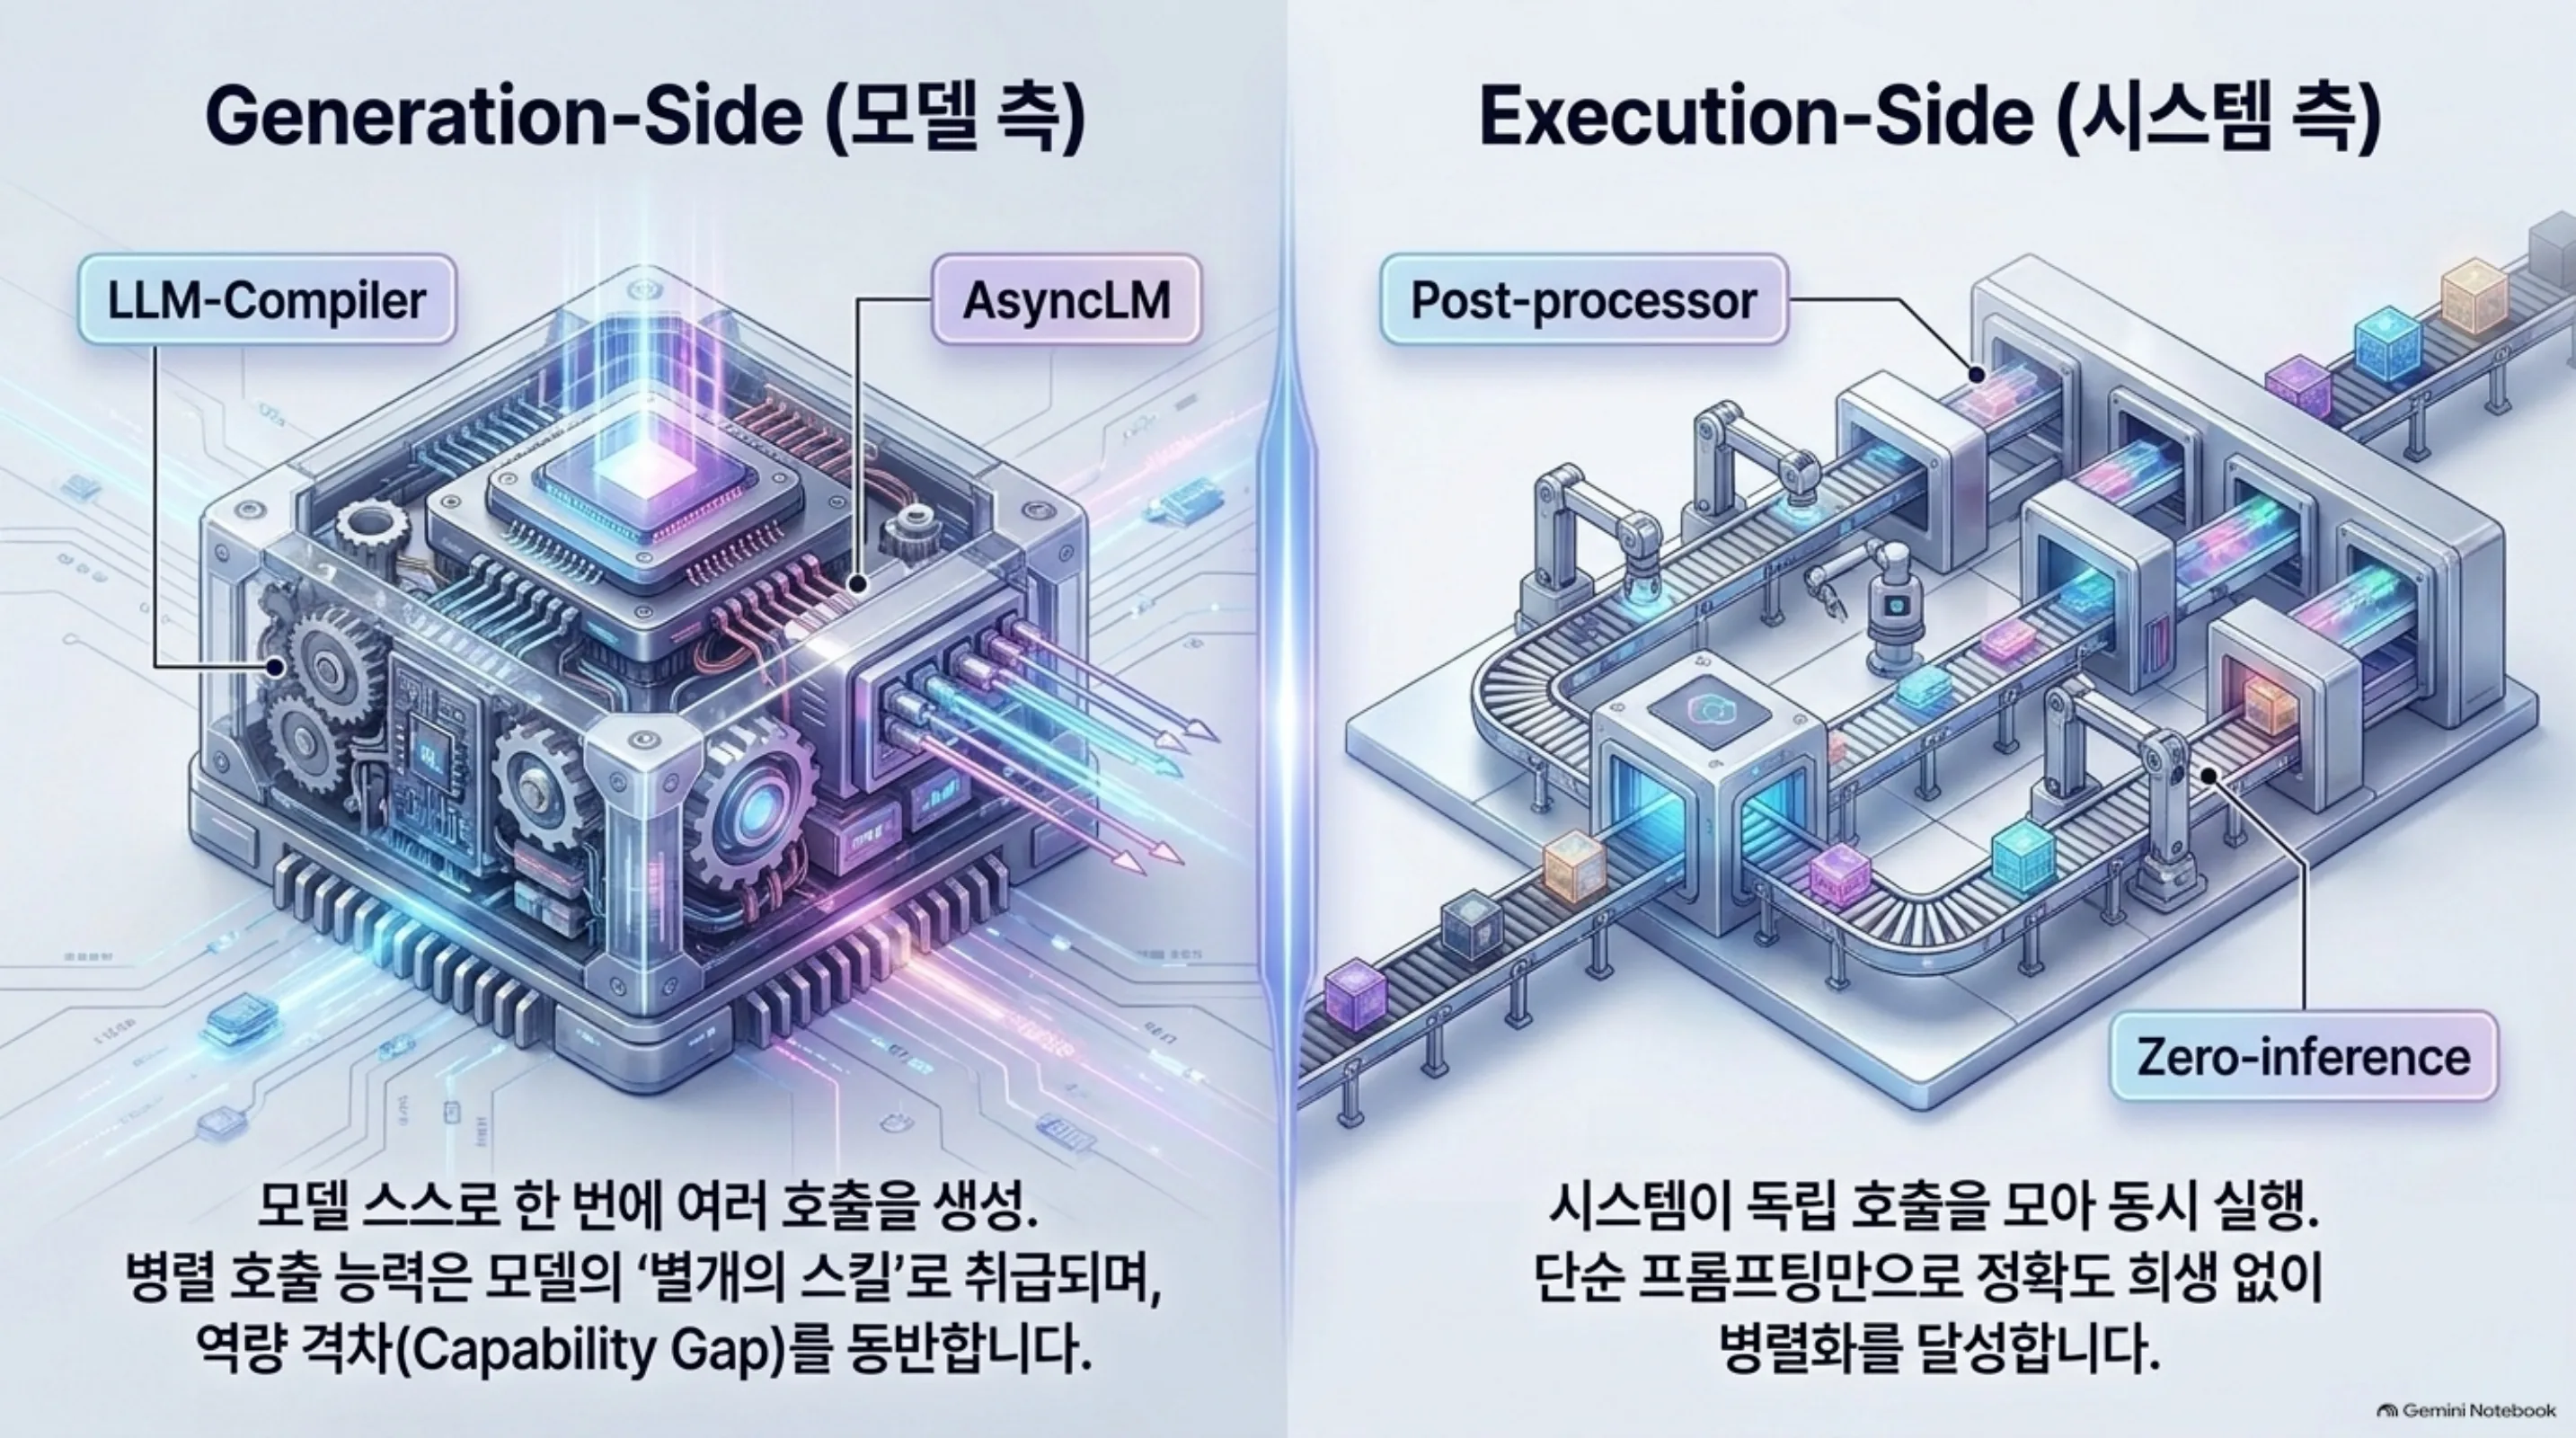
두 병렬성 레버가 혼동되어 왔고 그 혼동이 더 싼 쪽을 숨깁니다. generation-side 병렬성은 model이 한 메시지에 batch를 내보내는 쪽입니다. plan을 parallel execution으로 컴파일하는 LLM-Compiler 계열, interrupt semantics를 fine-tune하는 AsyncLM, 그리고 AgentSpec, SPORK, SAGA 같은 최근 agentic serving system이 여기에 속합니다. 이들은 모두 model이 생성하는 내용이나 클러스터가 스케줄하는 방식을 바꾸고 model의 병렬 호출 capability를 주어진 것으로 취급합니다. execution-side 병렬성은 다릅니다. model은 늘 그랬던 그대로 simple prompting으로 turn당 호출 하나를 생성하고 결정론적 harness post-processor가 인증된 독립 호출을 찾아 window가 닫힐 때까지 결과를 context에서 withhold한 뒤 window를 concurrently 실행합니다. post-processor는 inference call을 하나도 추가하지 않고 fine-tuning도 predictor도 쓰지 않으며 parallel 대 simple의 capability 갭도 치르지 않습니다.
이 논문은 저희가 고정 prefix를 가격 매긴 Manifest Order의 명시적 upgrade입니다. 그 논문은 매 turn 재전송되는 고정 prefix P를 가격 매겼고 이 논문은 rolling accumulation, 즉 serial harness가 모든 후속 turn에서 재-prefill하는 중간 결과를 가격 매깁니다. zero-inference post-processor가 그것을 없애며 dividend는 prefix-cache dividend와 compose되고 cache contention이 가장 큰 레짐에서 그도 가장 큽니다.
설계: 인증된 fan-out window 위의 arm, 추가 추론은 제로
플랫폼은 H200 Tensor GPU 1대(141 GB HBM3e)입니다. 27B NVFP4 agentic checkpoint를 automatic prefix caching(exact-match prefix semantics, LRU eviction)을 지닌 vLLM 스타일 paged KV로 서빙하고 K개의 concurrent loop가 엔진을 공유합니다. nominal 레짐은 K = 8입니다.
fan-out window는 read/gather phase와 disjoint writes 같은 구조에서 생기는 연속 turn n개의 최대 블록입니다. window 안에서는 각 호출의 인수가 prefix, task 입력, 앞선 호출들에만 의존해야 하고 앞선 결과에 의존해서는 안 됩니다. window는 absorb turn에서 닫히며 그 turn에서 window 전체, 모든 호출과 모든 결과가 한 번에 context에 들어옵니다. 모든 arm에서 동일합니다.
결정론적 harness post-processor는 세 조건으로 window를 인증합니다. D1은 window 안의 모든 tool이 read-only/멱등이거나 write target이 pairwise disjoint인 것을 요구합니다. D2는 어떤 argument도 window 결과를 참조하지 않는 것을, argument template에 결과 placeholder가 없다는 schema level로 확인합니다. D3은 phase signal이 window를 fan-out으로 표시하는 것을 요구하며 skill-manifest phase annotation이거나 slot-closure signal입니다. false fill은 실제로 위반된 인증, 즉 window 안의 dependent edge입니다. schema-sound detector는 구조적으로 false-fill 확률이 0이고, phase-heuristic detector는 선언된 nominal 0.03입니다.
비교 arm은 네 개입니다. S(serial baseline)는 turn당 호출 하나, 각 결과에 block합니다. F(harness-flattened)는 동일한 serial prompting을 쓰고 인증된 window 안에서만 결과를 window가 닫힐 때까지 context에서 withhold합니다. n개 호출이 concurrently 실행되고 absorb turn은 window 전체를 그대로 받습니다. F는 추가 inference call이 없고 S와 정확히 같은 n개 generation call에 같은 absorb turn을 수행할 뿐입니다. P(native-parallel)는 model이 window의 n개 호출을 한 메시지에 내보내는 BFCL parallel 레짐이며 capability 갭 g를 치릅니다. P+V는 free deterministic validator가 window를 gate하고 resampling으로 g를 사 오는 P입니다.
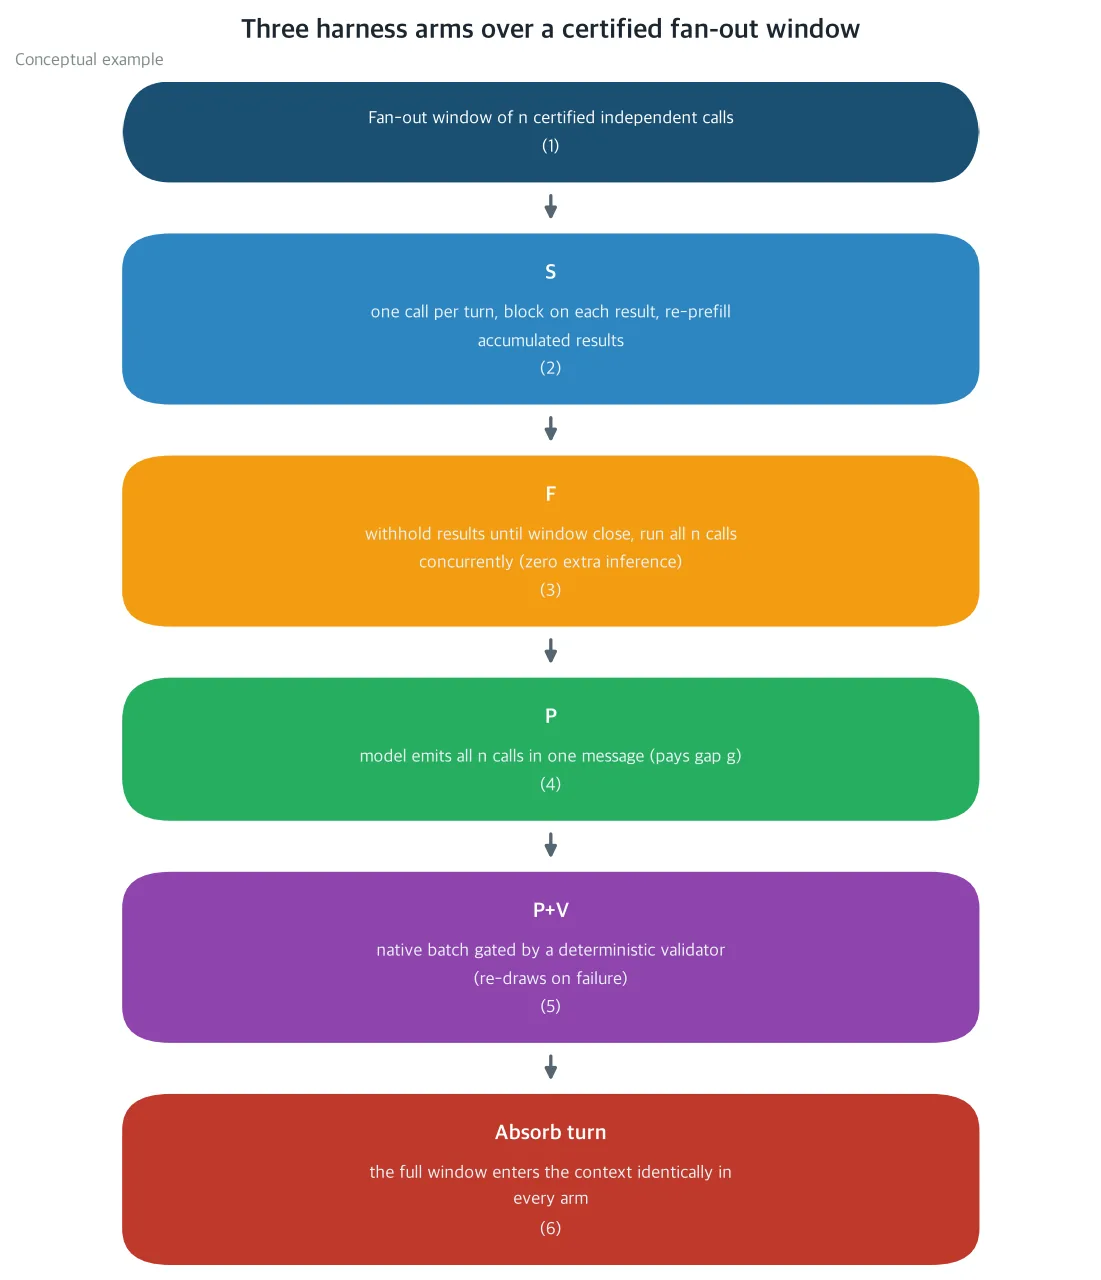 n개의 인증된 독립 호출로 이루어진 fan-out window 위에서 각 arm의 구조. S는 각 결과에 block하며 축적된 결과를 재-prefill하고 F는 결과를 withhold한 채 인증된 window를 제로 추가 추론으로 concurrently 실행하며 P 계열은 model 스스로 batch를 emit하는 데 의존하고 capability 갭 g를 치릅니다. window가 닫히면 absorb turn에서 전체 window가 모든 arm에서 동일하게 context에 들어옵니다. (개념 다이어그램, 실측이 아닙니다.)
nominal 레짐의 매개변수는 이렇습니다. 고정 prefix P가 4096 tok이고 turn당 평균 호출 토큰 c가 64, 평균 결과 토큰 r이 192, serial stride s = c + r가 256, absorb turn 출력 a가 128입니다. marginal prefill latency가 1.5 ms/tok이고 decode latency가 5.0 ms/tok, per-call serving overhead가 0.1 s, 평균 tool latency L이 0.5 s입니다. steady-state prefix hit fraction h가 0.80이고 retention 거리가 짧은 rolling-stride hit fraction h_R은 0.50으로 선언됩니다. harness accuracy budget ε이 1.0pp이고 task당 기대 인증 window 수 w가 2입니다.
결과: 바닥은 capability-invariant, 천장은 갭-가격
harness flattening의 wall-time dividend는 closed form입니다. n ≥ 2 호출의 인증 window마다 serial arm 비용은 T_S(n) = n T_0 + t_pf (1-h_R) s n(n-1)/2 + nL + T_abs(n)이고 harness-flattened arm 비용은 T_F(n) = T_S(n) - Δ_T^F이며 dividend는
Δ_T^F = (n-1) L + t_pf (1-h_R) r n(n-1)/2 > 0
으로, 모든 인증 window에서 엄격히 양수입니다. 두 성분은 window가 concurrently 돌 때 겹치는 (n-1)개의 tool latency와, withhold된 결과의 재-prefill입니다. generation 토큰 수가 변하지 않으므로 정확도나 청구 항목은 들어오지 않으며, dividend는 capability-invariant입니다. serving과 tool 매개변수에만 의존하고, model의 병렬 호출 갭 g에는 의존하지 않는 셈입니다.
nominal 값에서는 n = 6에서 F dividend가 4.66 s, T_S = 18.89 s의 24.7%이고 n = 10에서 10.98 s, 32.3%입니다. native arm P는 raw wall time에서 지배합니다. n = 6에서 12.02 s(63.6%), n = 10에서 25.11 s(73.8%)를 아끼며 n-1개의 turn 전체를 없애고 window 안에서 재-prefill이 전혀 없기 때문입니다. 다만 그 지배는 capability 갭 g를 치르는 대가를 지닙니다. 그 가격을 매기는 것이 다음 섹션입니다.
token dividend는 실재하지만 nominal cache 온도에서는 작습니다. serial arm과 F arm의 billed window 토큰 차는 D_tok^F = r n(n-1)/2이고 정확히 withhold된 중간 결과의 재-prefill입니다. Manifest Order의 고정 prefix 재전송에 대응하는 rolling-stride 버전입니다. nominal n = 6 window에서 window 청구의 8.3%입니다. 레짐 구조는 깨끗합니다. rolling stride가 cache-cold(h_R → 0)일 때 dividend가 최대가 되며 이것은 Manifest Order의 고정 prefix dividend도 최대가 되는 high-contention 레짐(큰 K, 짧은 retention)과 정확히 일치합니다. 두 dividend는 같은 retention 매개변수로 가격 매겨집니다. flattening은 cache-friendly이기도 합니다. window마다 (n-1)개의 stride 재-prefill을 KV inflow에서 없애 retention을 늘리므로 두 레버 사이에 positive coupling이 생깁니다.
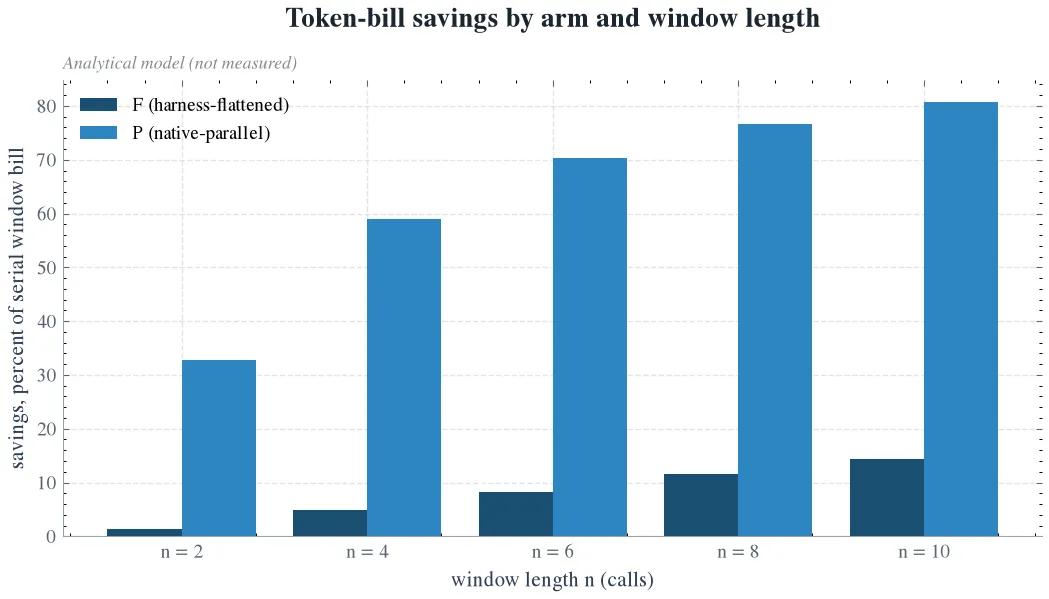 선언된 nominal 레짐에서, serial arm의 billed window 토큰 중 F arm(중간 결과 withhold)와 P arm(고정 prefix와 stride withhold)가 아끼는 비율입니다. F dividend는 window 길이에 대해 2차적으로 크지만 modest하고 P dividend는 훨씬 크되 capability 갭 g를 치릅니다. (분석 모델, 실측이 아닙니다.)
두 arm은 다른 방식으로 실패하고 그 실패가 가격을 정한다. P는 generation에서 실패한다. parallel prompting 레짐은 model의 structured-output 행동을 바꿔 Format Tax의 prompt-side cost가 발생하고 resampling이나 더 강한 model만이 되찾을 수 있는 g 점을 잃는다. F는 certification에서 실패한다. window 밖의 generation은 S와 bit-identical이고 false fill만이 행동을 바꾼다. schema-sound detector는 그 사건을 null로 만든다. 이것이 F dividend가 capability-invariant이고 P dividend가 그렇지 않은 이유다. F는 고정 정확도 budget ε = 1.0pp를 지킨다. schema-sound detector는 φ = 0으로 equality를 맞추고 phase heuristic은 nominal에서 0.03 × 2 × 0.9 = 0.54pp로 budget 안에 있다. false fill은 dependent edge의 flattening, 즉 ParaRecover가 문서화한 cascade seed이며 schema-level validator로 검출된다. 잔여 비용은 repair이지 silent error가 아니다.
전선: 선언된 갭에서 wall time 전략은 window n ≈ 8에서 뒤집힌다
validation-gated resampling으로 native arm의 갭 g를 두 단위에서 가격 매기면 두 crossover 갭이 나온다. 재도 가격은 point당 window redraw 한 번으로, Validator’s Dividend의 가격과 일치한다. wall time 재도 A_T(n) = P̂ + t_dec n c, token 재도 A_B(n) = P(1-h) + n c이다. P+V가 F보다 net-better인 필요충분 조건은 갭이 crossover 아래라는 것이며, crossover 갭은 wall time에서 g_T^(n), token에서 g_B^(n)이다.
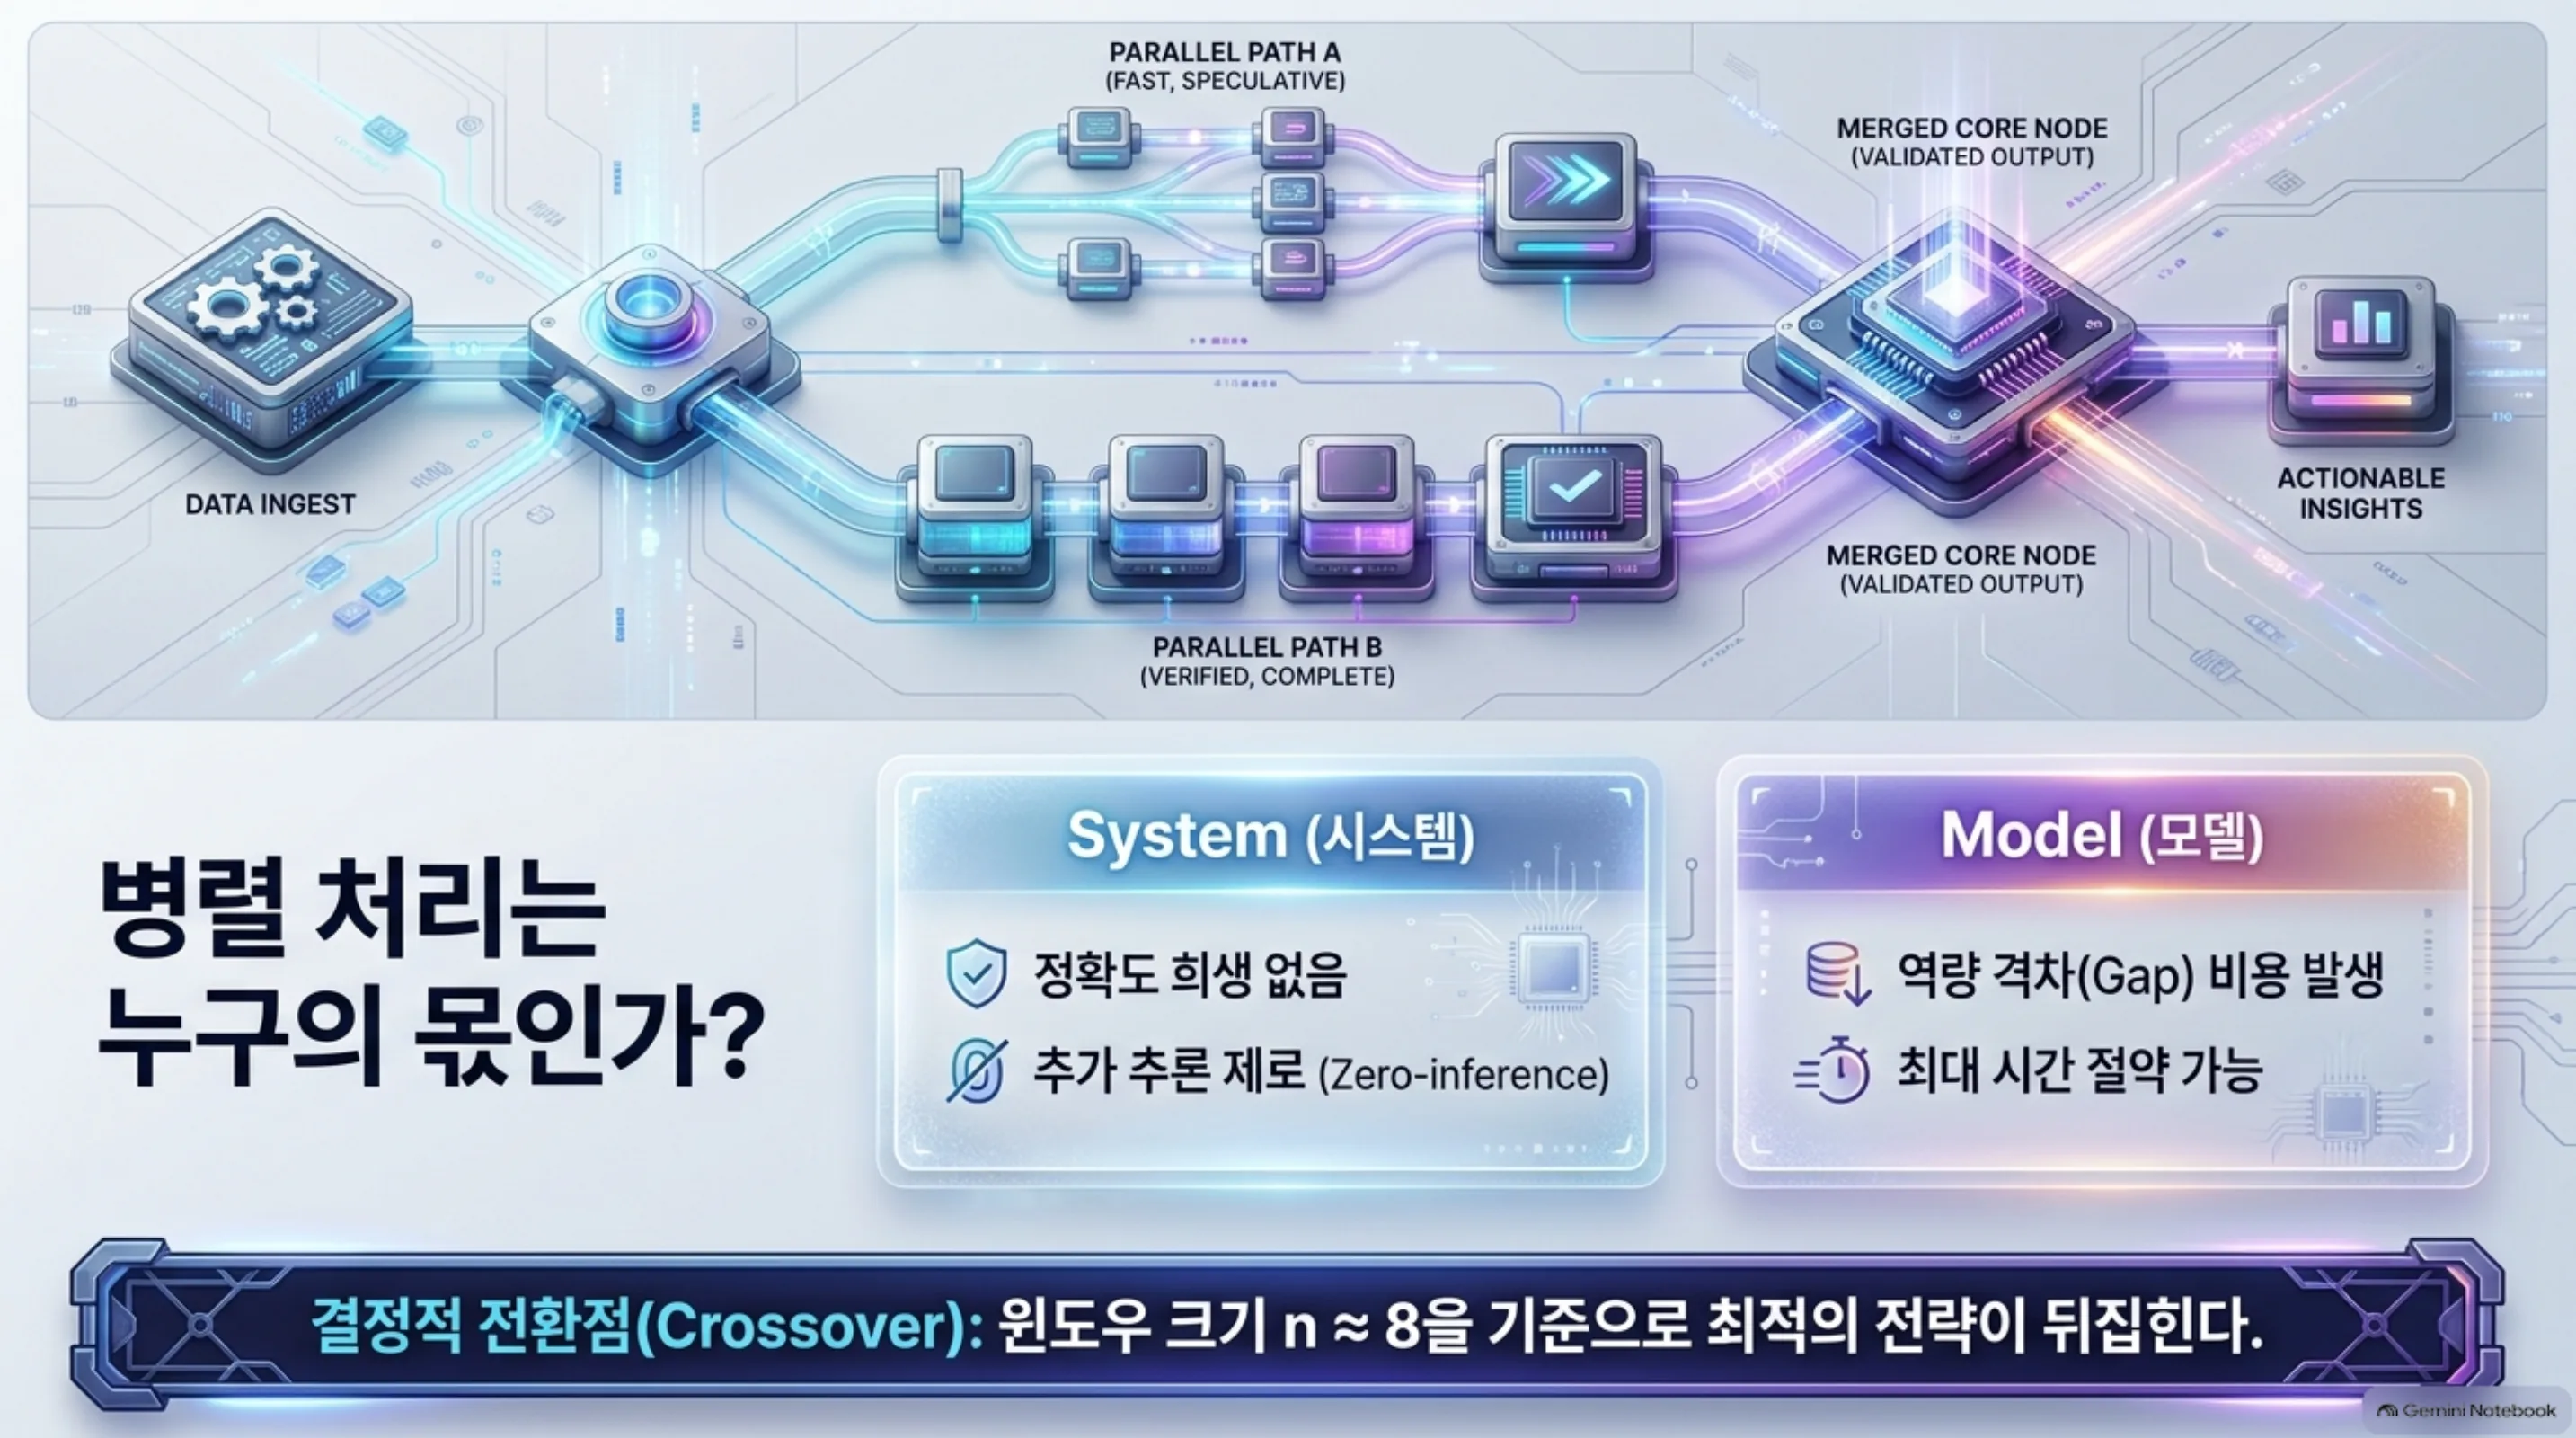
nominal 레짐에서 g_T^는 0.74pp(n = 2)에서 2.34pp(n = 6)를 거쳐 2.81pp(n = 8)까지 오르고 g_B^는 4.39pp(n = 2)에서 17.8pp(n = 6)까지 오르는 것이다. 선언된 갭 g = 2.8pp에서는 wall time에서 P+V가 net-better인 policy는 window n ≥ 8뿐이고, n ≤ 7에서는 harness flattening이 지배한다. crossover window는 n* ≈ 8이며 T_P+V(n) = T_F(n)을 풀면 n* = 7.96이 나온다. token bill에서는 P+V가 모든 n ≥ 2에서 net-better인 셈이다. g_B^*는 n = 2에서 최소화되고 4.39pp로, 선언된 갭보다 높다.
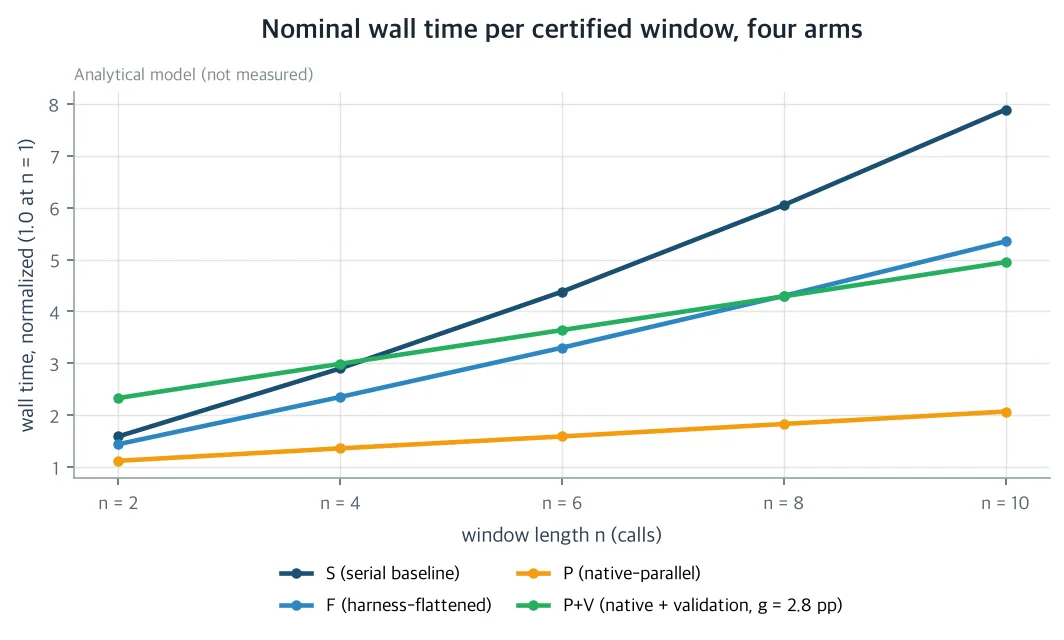 선언된 nominal 레짐에서 인증 window당 wall time, n = 1 공통 값으로 정규화했습니다. serial arm S가 가장 빠르게 자라고 native arm P가 가장 느리게 자라며 validation으로 갭을 사 온 P+V arm이 F arm 아래로 내려가는 교차점이 n = 8 부근에 있다. (분석 모델, 실측이 아닙니다.)
여기서 구조가 결과입니다. 병렬성 dividend에는 capability-invariant 바닥(F)과 갭-가격 천장(P+V)이 있고 wall time에서 그 둘을 가르는 것이 g_T^*(n)입니다. 바닥은 harness에 속하고, 천장은 model의 병렬 갭을 accuracy point로 치러야 하므로 갭이 crossover 아래일 때에만 도달 가능합니다. 강한 parallel caller를 지닌 운영자, 즉 g가 작은 large model이나 fine-tuned checkpoint를 쓰는 운영자는 천장 위에 살고 모든 window 길이에서 native parallel + validation을 씁니다. 선언된 27B class 갭을 지닌 운영자는 n ≈ 8 이하 window에서 바닥 영역에 있으며 이 구간은 loop count를 지배하는 바로 그 작은 gather phase입니다. 여기서 flattening이 맞습니다. n ≈ 8 이상에서는 P의 prefix-turn 절감이 validation cost를 이깁니다. 뒤집힘은 model 선택이 아니라 window 길이 선택입니다. 단일 harness가 두 arm을 모두 쓰며 짧은 인증 window는 flatten하고 긴 window는 validator를 path에 두고 native로 prompting합니다. 운영 규칙은 “model이 parallel로 낼 여유가 없는 것은 flatten하라(flatten what the model cannot afford to emit in parallel)”입니다.
의미: 회사·사회·과학에 남는 것
ThakiCloud의 agent platform에는 zero-extra-inference post-processor가 남습니다. H200에서 loop wall time과 중복 prefix 토큰을 줄이고 model-side native 병렬성과 harness-side call flattening 중 무엇을 쓸지 고르는 비용/지연-정확도 frontiers를 제공합니다. 고정 정확도에서 busy 상태의 단일 H200 wall time은 선언된 750 W로 energy로 환산됩니다. n = 6에서 F dividend는 4.66 × 750 ≈ 3.5 kJ/window이며 선언된 w = 2에서 task당 ≈ 1.9 Wh입니다. task마다 작고 fleet-hour마다 material이며 window에 대해 super-linear입니다.
사회로는 무인 작업 자동화가 task당 더 빠르고 더 저렴해집니다. serial tool-call overhead를 결정론적 post-processing으로 제거하되 추가 LLM inference를 쓰지 않기 때문입니다. 어떤 self-hosted agent model이든 BFCL parallel 점수와 무관하게 window마다 (n-1)L의 tool-latency 겹침과 withhold 결과 재-prefill을 고정 task accuracy에서 거두는 capability-invariant 바닥이 그것입니다. self-hosted GPU를 쓰는 small-team automation의 energy cost가 내려가는 것은 이 바닥 덕분입니다.
과학으로는 model-side parallel function-calling capability와 harness-side parallelism enforcement를 고정 정확도로 가격 매긴 첫 분리입니다. 두 crossover 갭 g_T^(n), g_B^(n)이 native-parallel-plus-validation이 harness flattening을 이기는 시점을 운영자에게 알려 줍니다. wall time에서는 nominal n ≥ 8, token에서는 선언된 갭에서 모든 n입니다. 프로토콜은 BFCL의 parallel category를 capability 측정에서 serving economics로 확장하며 leaderboard의 단일 갭 숫자가 frontier가 되고 “native로 갈지 flatten할지”의 질문이 folklore에서 끝나지 않게 됩니다.
falsifiable 3-arm 프로토콜은 어떤 formula도 바꾸지 않고 모든 closed form을 measurement로 바꿉니다. arm S, F, P, P+V 사이에 model weight, harness, prefix가 동일하고 F는 schema-sound detector를 뛰며 phase heuristic은 보고용 control로 붙습니다. workload는 typed read/write toolset 위의 48개 deterministic seeded loop task(16 fan-out, 16 chain, 16 mixed)이며 gold success label은 deterministic construction으로 만들어집니다. g를 앵커하기 위해 temperature 0에서 seeded BFCL-v3 simple 32개와 parallel 32개가 추가됩니다. chain task는 window를 하나도 인증하지 않아 null arm을 이루며 어떤 arm도 그 위에서 noise를 넘어 S를 이길 수 없습니다. pre-registered 반증 기준은 네 개입니다. R1은 n ≥ 6 window에서 measured Δ_T^F가 nominal 점에서 closed form의 절반 이상이어야 한다는 것이며 위반되면 homogeneous-L 가정이나 overlap efficiency가 틀렸다는 뜻이고 E[max_i L_i] 보정을 보고합니다. R2는 measured D_tok^F가 음수가 아니어야 한다는 것이며 음수가 나오면 withhold-result context의 position sensitivity가 accounting을 깨뜨렸거나 re-decoding을 유발한 것입니다. R3는 measured a_F - a_S가 gold task에서 -1.0pp를 넘지 않아야 한다는 것이며 넘으면 real toolset에서 detector soundness가 위반된 것으로 φ̂, ê_v를 보고해 accuracy 정리를 다시 계산합니다. R4는 temperature 0의 measured BFCL simple 대 parallel 갭이 g ± 1.5, 즉 [1.3, 4.3]pp 안에 있어야 한다는 것이며 밖으로 나가면 nominal 갭이 불안정한 것으로 formula는 바꾸지 않고 매개변수만 다시 계산합니다.
한계: dividend가 제로인 곳, 그리고 이 논문이 재단하지 않는 것
이 논문은 분석적이며 positional하다는 점을 명시합니다. 새로운 measurement가 없습니다. 모든 그림은 선언된 nominal 가정에 대한 closed-form 예측이거나 인용 참조로 귀속된 실측 결과입니다. 위 프로토콜은 formula를 바꾸지 않고 frontier에 measurement를 채우는 것이 존재 이유입니다.
모든 window에 dependent edge가 있는 write-heavy loop에서는 dividend가 0입니다. detector가 거절하고, F는 log overhead를 남긴 채 S로 degrade됩니다. n = 2 같은 작은 window는 nominal에서 (n-1)L = 0.5 s만을 번습니다. 실재하지만 P+V 갭의 validation cost 아래입니다. non-homogeneous latency에서는 L이 E[max_i L_i]로 대체되고 concurrent window 비용은 L + σ_L κ_n(κ_n → √(2 ln n))입니다. dividend는 평균보다 가장 느린 tool에 더 민감하며 σ_L ≤ 0.3L 선언 시 nominal에서 n ≥ 2 모든 window에서 여전히 양수입니다.
결과를 withhold하면 window 안에서 model이 보는 입력이 바뀝니다. context는 load-bearing이고 plan signal이 한 step에서 4.1배로 줄어드는 것이 withhold가 인증 window 안에서만 안전하고 absorb turn이 window 전체를 verbatim로 다시 첨부하는 이유입니다. 정보는 잃지 않고 지연만 됩니다. 두 방어가 리스크를 bound합니다. 인증 window가 입력이 다른 유일한 장소이므로 틀린 인증은 silent drift가 아니라 R3의 false fill로 가격 매겨집니다.
선언된 갭 g = 2.8pp는 저희 serving 환경의 nominal input이며 R4가 nominal 갭이 안정적인 범위를 pre-register해 둡니다. energy 환산은 선언된 750 W 평균 busy draw를 쓰고 net-cost 환산은 concurrency-aware입니다. dividend 크기는 선언된 cache hit fraction h = 0.80과 h_R = 0.50에 의존하며 두 dividend가 모두 가장 큰 high-contention, short-retention 레짐은 선언된 hit fraction이 가장 불확실한 레짐이기도 합니다.
무인 agent loop의 대기에는 두 owner가 있고 청구서가 다릅니다. model은 capability 갭 g를 소유하고 native 병렬성은 harness와 무관하게 모든 window에서 그것을 칩니다. harness는 serialization을 소유하고 인증 window마다 (n-1)개의 tool latency와 r n(n-1)/2개의 재-prefill된 결과를 냅니다. 결정론적 zero-inference flattener는 g에 의존하지 않고 그것을 없앱니다. 병렬성 dividend는 모든 self-hosted checkpoint가 거둘 수 있는 바닥이고 강한 parallel caller만 도달하는 천장입니다. 짧은 window는 flatten하고 긴 window는 validator를 path에 두고 native로 prompting하며 retention 매개변수가 각 dividend의 얼마를 cache가 돌려줄지 정합니다.
논문 원문과 수반 자료는 Hugging Face에서 볼 수 있습니다.
https://huggingface.co/datasets/thaki-AI/daily-paper-2026-10-12-parallelism-dividend-tool-calling-harness