문항 1만 개, 독립 단위는 5개: RAG 평가에서 독립성 정의가 표본 수를 정합니다
평가셋의 크기를 말할 때 보통 문항 수를 셉니다. 저희도 검색 판단 모델을 독립적으로 검증할 평가셋을 두 번 만들려고 했습니다. 한 번은 위키백과에서, 한 번은 한국 법령에서였습니다. 두 번 다 문항은 충분히 만들 수 있었지만 두 번 다 멈췄습니다. 문항끼리 서로 기대고 있었기 때문입니다.
평가셋을 직접 만들거나, 남이 만든 평가셋의 숫자를 믿어도 되는지 판단해야 하는 분께 이 글을 권합니다. 이 글은 평가셋을 만드는 데 실패한 기록이지만, 무엇이 실패를 불렀는지는 다른 평가에도 그대로 적용됩니다.
 글의 핵심 개념을 형상화했습니다.
쉽게 말하면
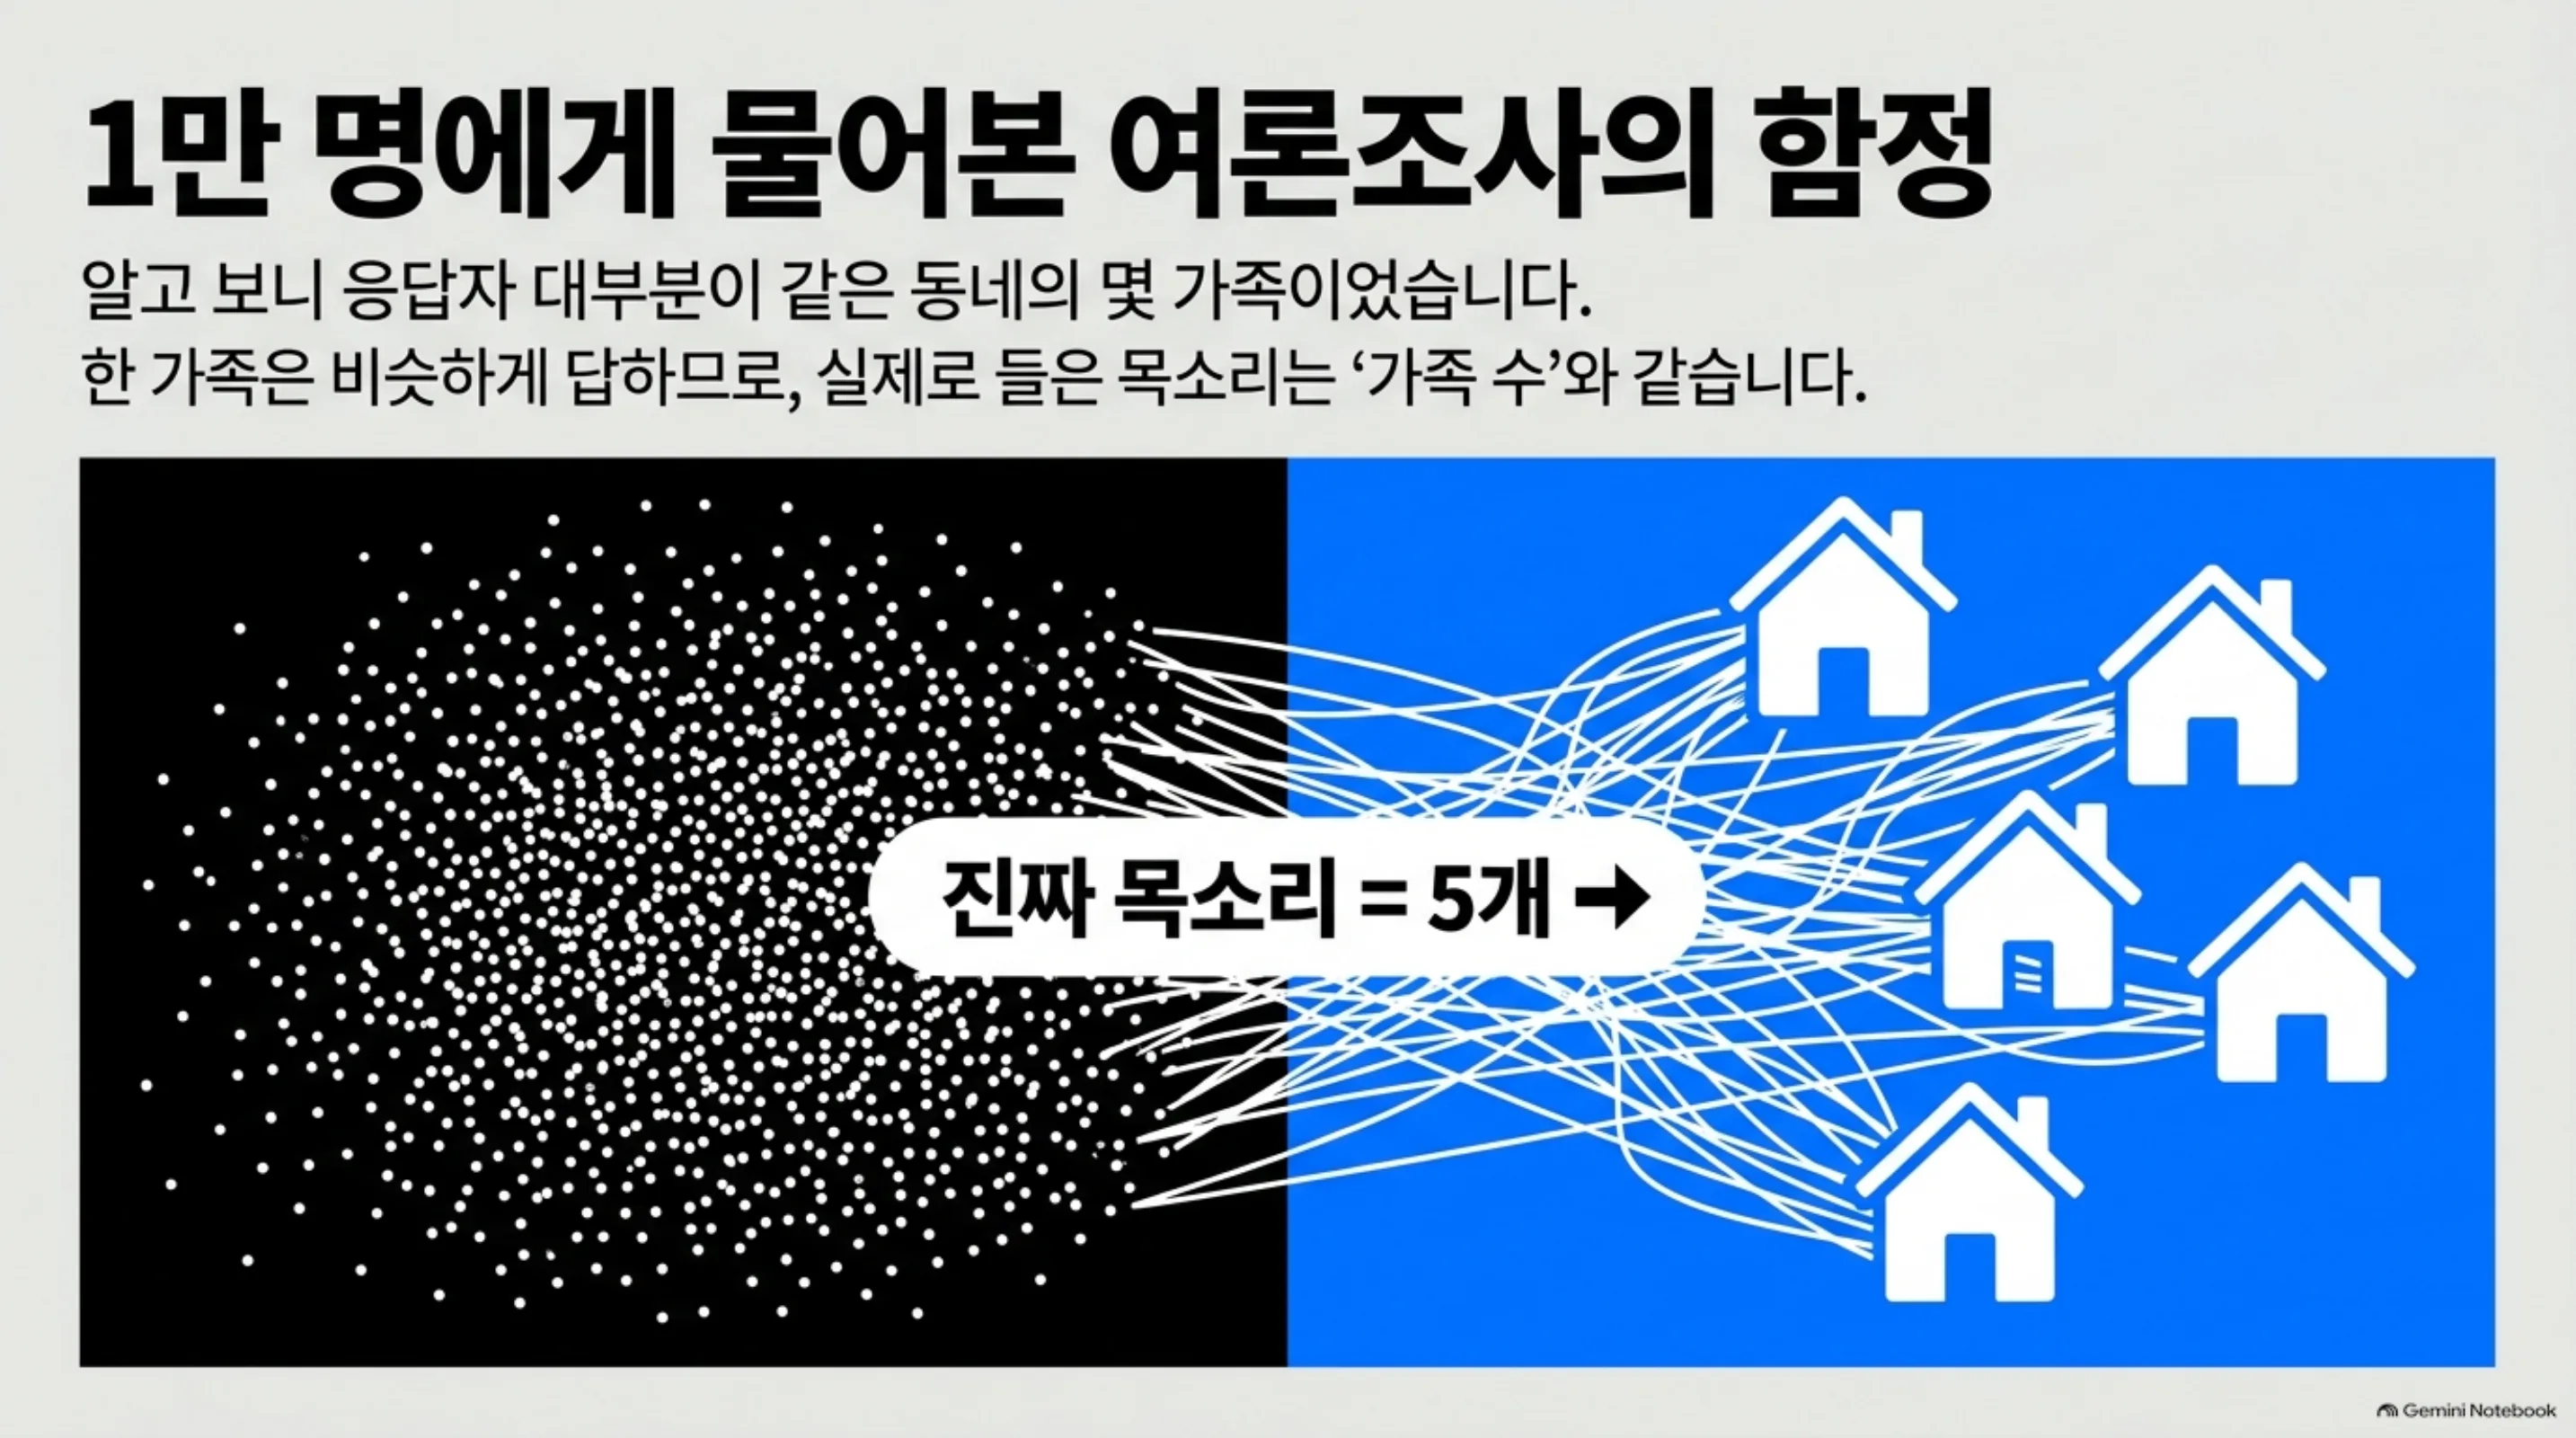
여론조사를 1만 명에게 했다고 해 보겠습니다. 그런데 알고 보니 응답자 대부분이 같은 동네의 몇 가족이었습니다. 한 가족은 비슷하게 답하니, 1만 명에게 물었어도 실제로 들은 목소리는 가족 수만큼입니다.
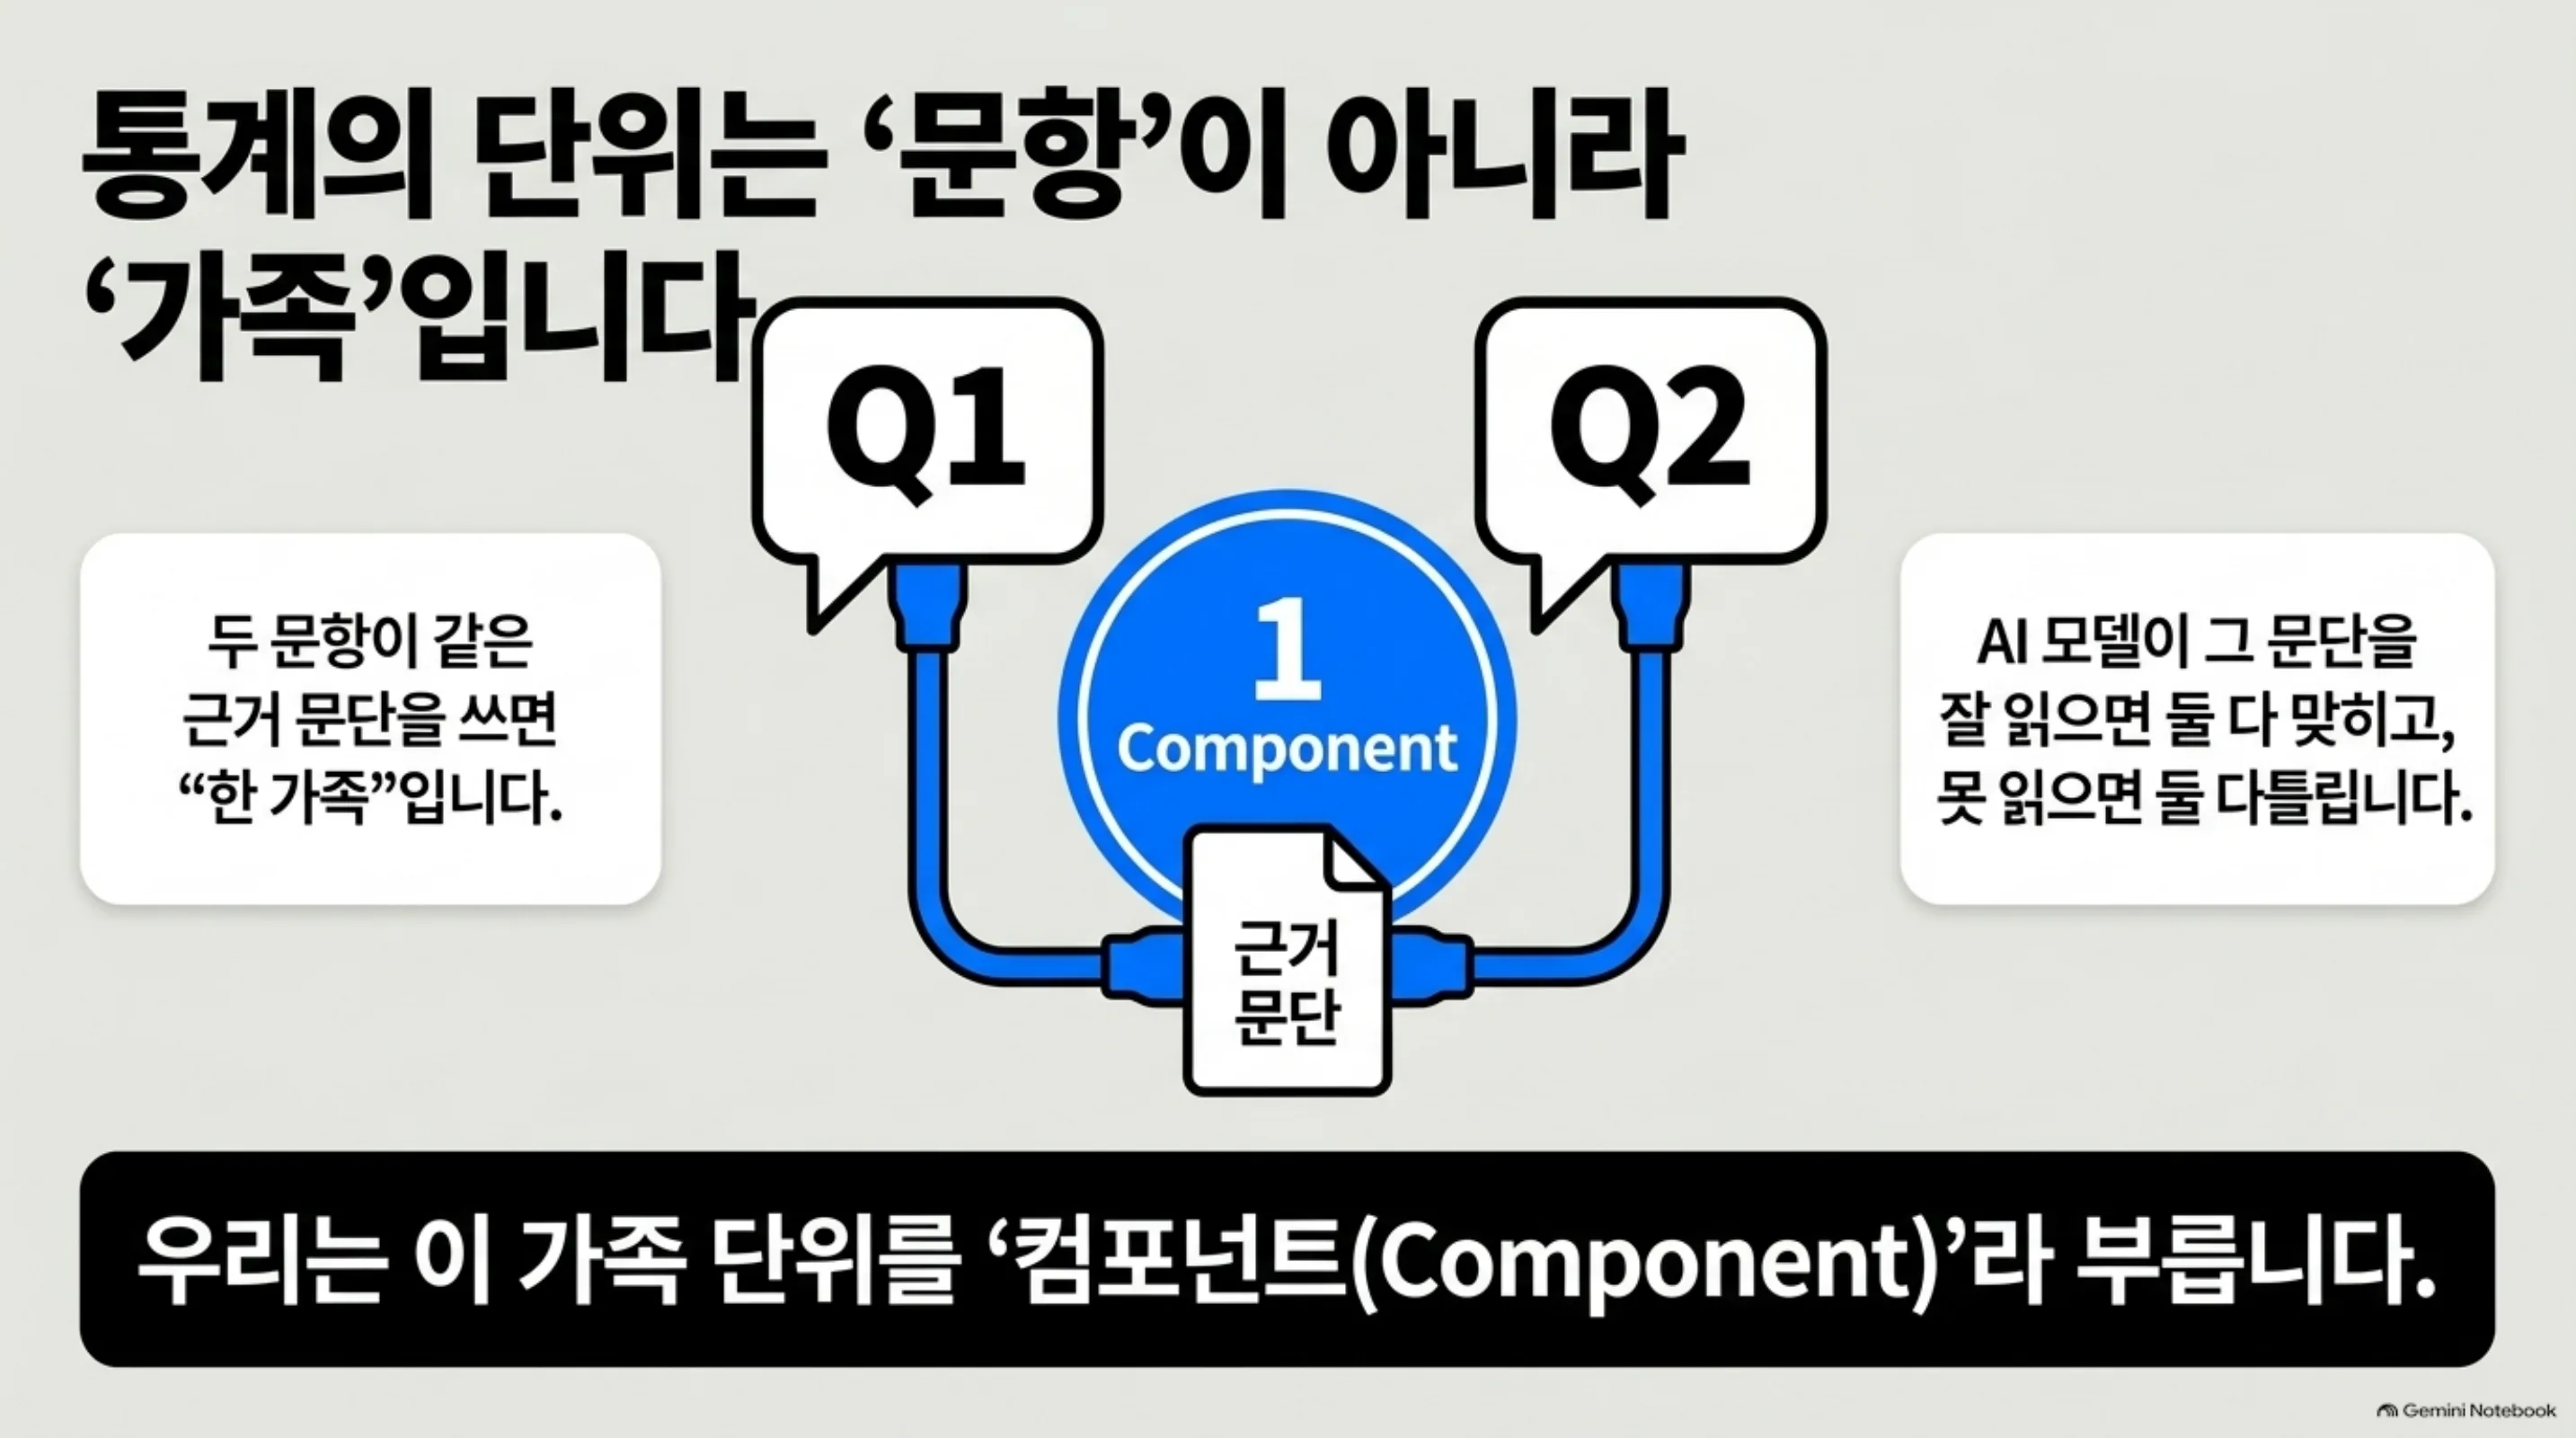
평가 문항도 마찬가지입니다. 두 문항이 같은 문단을 근거로 쓰면 한 가족입니다. 모델이 그 문단을 잘 읽으면 두 문항을 다 맞히고 못 읽으면 다 틀립니다. 그래서 통계를 낼 때는 문항이 아니라 가족을 한 단위로 세야 합니다. 저희는 이 가족을 컴포넌트라고 부릅니다.
문제는 누구와 누구를 한 가족으로 볼지 정하는 규칙입니다. 규칙이 촘촘할수록 가족은 커지고 가족 수는 줄어듭니다.
무엇을 해봤나
왜 새 평가셋이 필요했나
지난 글에서 쓴 실험들은 모두 같은 개발용 평가 묶음을 반복해서 썼습니다. 개선처럼 보이는 결과가 일반화인지, 그 묶음에 맞춘 것인지 가르려면 처음 보는 독립 평가셋이 필요했습니다.
평가셋을 만들기 전에 통과선을 먼저 정했습니다. 정확도 차이 3%p를 검출할 수 있어야 한다는 기준입니다. 이 검정력은 문항 수가 아니라 컴포넌트 수로 계산하고 한 컴포넌트에서 최대 4문항까지만 셉니다. 이 기준으로 최종 평가용 261개, 조정용 168개 컴포넌트가 필요했습니다.
첫 번째 시도: 위키백과 기반 다단계 질문
첫 시도는 2WikiMultihopQA라는 위키백과 기반 데이터에서 출발했습니다. 오염 검사를 통과한 질문 후보가 5,184개였습니다.
그런데 문단 단위 검사에서 5,142개가 걸렸습니다. 답을 찾는 데 쓰는 근거 문단은 대부분 깨끗했습니다. 문제는 방해 문단이었습니다. 이 데이터의 학습용과 검증용이 같은 위키백과 문단 묶음에서 방해 문단을 뽑아 쓰고 있었고 방해 문단의 87%가 따로 봉인해 둔 검증 데이터와 겹쳤습니다. 살아남은 질문은 20개였습니다.
미리 정한 규칙대로 기준을 낮추지 않고 오염된 방해 문단만 깨끗한 문단으로 바꾸는 시도를 딱 한 번 더 했습니다. 바꿀 수 있는 질문은 381개였고 모든 검사를 통과한 것은 237개였습니다. 최종 평가용으로 배정된 159개로는 검출할 수 있는 차이가 4.4%p로, 목표 3%p에 못 미쳤습니다. 게다가 문서만 보는 분류기가 바꾼 문단을 AUC 0.61로 구별해 냈습니다. 바꾼 흔적이 남아 있었다는 뜻입니다. 이 경로는 여기서 닫았습니다.
두 번째 시도: 한국 법령의 조문 인용
두 번째는 위키백과와 무관한 원천을 골랐습니다. 한국 법령입니다. 어떤 조문이 같은 법의 다른 조문을 인용하는 구조를 다단계 질문으로 썼습니다.
작은 사전 감사에서 이미 경고가 나왔습니다. 고른 128개 문항 중 45개가 양벌규정처럼 법마다 거의 똑같이 쓰이는 상투 조문으로 서로 얽혀 있었습니다. 이것들을 빼고 남긴 83개 중 82개는 법령 사이 인용 관계로 이어진 한 덩어리 안에 있었습니다.
그래서 문항을 더 어렵게 바꾼 새 설계를 세웠습니다. 인용된 조문 대신 같은 번호의 다른 법령 조문을 디코이로 넣는 방식입니다. 그리고 실제로 만들기 전에 얼마나 만들 수 있는지부터 세었습니다. 가족을 묶는 규칙은 미리 문서로 고정했습니다. 같은 문단을 공유하거나, 거의 같은 조문을 가졌거나, 디코이로 쓰인 법령은 한 가족입니다.
나온 결과
만들 수 있는 문항은 충분했습니다. 시행 중인 법령 1,656개에서 디코이를 붙일 수 있는 문항 후보가 10,702개 나왔습니다.
그런데 규칙대로 가족을 묶으니 컴포넌트는 5개뿐이었습니다. 가장 큰 컴포넌트 하나에 법령 1,566개와 후보 문항의 98.9%가 들어갔습니다. 목표 261개와 168개에 한참 못 미쳤고 미리 정한 중단 조건대로 여기서 멈췄습니다.
연결 규칙을 하나씩 더해 보면 어디서 가족이 커졌는지 보입니다.
| 연결 규칙 | 컴포넌트 수 | 가장 큰 컴포넌트 |
|---|---|---|
| 완전히 같은 문단만 | 1,357 | 법령 44개 |
| 거의 같은 조문까지 | 737 | 법령 845개 |
| 디코이로 쓰인 법령까지 | 5 (후보 문항이 있는 컴포넌트 기준) | 법령 1,566개 |
거의 같은 조문은 글자 5개 단위 조각의 겹침 비율(Jaccard)이 0.8 이상인 조문입니다. 앞의 두 줄은 판정 뒤에 원인을 보려고 계산한 진단값입니다.
연결 규칙이 더해지며 컴포넌트가 수축하는 과정을 도표로 정리했습니다.
flowchart TB
    A["후보 문항 10,702개<br/>시행 중 법령 1,656개"] --> B["완전히 같은 문단만 묶음<br/>컴포넌트 1,357개"]
    B --> C["거의 같은 조문까지 묶음<br/>컴포넌트 737개"]
    C --> D["디코이 법령까지 묶음<br/>컴포넌트 5개"]
완전히 같은 문단만 따지면 법령은 1,357개 덩어리로 나뉩니다. 거의 같은 조문을 더하자 845개 법령짜리 덩어리가 생겼습니다. 같은 번호의 디코이 연결이 나머지를 거의 다 이었습니다.
즉, 사람 말로는 1만 명에게 물을 수 있었지만, 같은 가족으로 묶어 보니 사실상 다섯 집에 물은 셈이었습니다.
두 시도의 공통점
두 원천은 전혀 달랐지만 같은 모양으로 실패했습니다. 위키백과에서는 방해 문단을 같은 문단 묶음에서 나눠 쓴 것이 문제였습니다. 법령에서는 법마다 반복되는 상투 조문과, 문항을 어렵게 만들려고 넣은 디코이가 문항끼리 잇는 다리가 됐습니다. 두 경우 모두 문항을 만드는 방식 자체가 문항 사이에 연결을 만들었습니다.
그래서 무엇을 바꾸면 되나
첫째, 평가셋 크기를 문항 수가 아니라 독립 단위 수로 보고하는 편이 정직합니다. 이번 경우 문항 1만여 개와 독립 단위 5개는 2,000배가 넘는 차이입니다.
둘째, 독립성 규칙은 데이터를 보기 전에 정하고 만들기 전에 셉니다. 법령 평가셋은 모델을 한 번도 돌리지 않고 CPU 계산만으로 멈출 수 있었습니다. 문항을 다 만들고 모델 결과를 본 뒤에 알았다면, 규칙을 느슨하게 바꾸고 싶은 유혹이 훨씬 컸을 것입니다.
셋째, 문항을 어렵게 만드는 장치가 독립성을 깎지 않는지 확인합니다. 디코이와 방해 문단은 난도를 올리지만, 여러 문항이 같은 디코이 원천을 나눠 쓰면 그 자체가 연결이 됩니다.
ThakiCloud 관점에서 이 교훈은 Paxis의 에이전트 품질 평가로 이어집니다. 고객 업무 문서로 에이전트를 평가하면 같은 사내 규정이나 양식 문단이 수많은 질문에 반복해서 나옵니다. 질문 수가 많아 보여도, 같은 문단을 공유하는 질문끼리 묶어 세지 않으면 평가 결과를 실제보다 훨씬 확신하게 됩니다.
못 믿을 부분
가장 큰 반론은 저희 독립성 정의가 지나치게 보수적일 수 있다는 점입니다. 거의 같은 조문을 공유한다고 해서 정답 정보가 새는 것은 아닙니다. 양벌규정이 여러 법에 똑같이 있다고 한 법의 문항을 풀면 다른 법의 문항이 저절로 풀리지는 않습니다. 더 느슨한 규칙을 쓰면 컴포넌트는 훨씬 많아집니다.
그래서 이 결과는 “법령 1,656개가 통계적으로 5개의 표본뿐”이라는 뜻이 아닙니다. 저희가 미리 정한 연결 규칙으로 그래프를 만들면 5개 덩어리가 된다는 뜻입니다. 원천 데이터의 실패가 아니라 이번 평가 구성의 실패입니다. 다만 결과를 본 뒤에 규칙을 느슨하게 바꿔 이 평가셋을 살리지는 않았습니다. 그렇게 하면 무엇을 검증하는지가 흐려지기 때문입니다.
둘째, 컴포넌트 단위로 세는 방식도 하나의 선택입니다. 군집을 고려한 다른 분산 추정이나, 연결 강도에 가중치를 주는 방식이면 다른 숫자가 나옵니다.
셋째, 이 결과를 모든 RAG 평가로 넓힐 수는 없습니다. 위키백과 기반 다단계 질문과 한국 법령 인용이라는 두 사례일 뿐입니다. 문단을 공유하지 않는 원천이라면 같은 문제가 생기지 않을 수 있습니다.
참고 자료
- Ho, Nguyen, Sugawara, Aizawa, Constructing A Multi-hop QA Dataset for Comprehensive Evaluation of Reasoning Steps (2WikiMultihopQA 논문, arXiv:2011.01060)
- Alab-NII/2wikimultihop: 2WikiMultihopQA 공식 데이터셋 저장소 (GitHub)
- Jaccard index (위키백과): ‘거의 같은 조문’ 규칙의 5글자 조각 겹침 비율(0.8 이상) 기준
- Design effect (위키백과): 문항끼리 묶이면 유효 표본 수가 줄어드는 통계 원리
이 글의 수치는 저희가 직접 계산한 값이며 연구 원장에 기록된 결과만 인용했습니다.