TPU v2부터 Ironwood까지: 5세대로 본 구글 트레이닝 슈퍼컴퓨터의 진화
대규모 AI 모델을 학습시키는 인프라는 어떻게 진화해왔을까요. 구글이 arXiv에 공개한 논문 “Google’s Training Supercomputers from TPU v2 to Ironwood”(arXiv:2606.15870, 2026년 6월 14일 제출)는 TPU 5세대의 진화를 아키텍처 안정성, 규모, 회복탄력성, 전력 효율, 지속가능성이라는 다섯 축으로 정리합니다. 단일 칩 성능이 아니라 시스템 전체를 어떻게 키워왔는지를 다룬다는 점에서, AI 인프라를 운영하는 팀에게 직접적인 교훈을 줍니다.
저희 ThakiCloud는 K8s 기반 AI/ML SaaS 플랫폼에서 GPU 워크로드와 학습 인프라를 다룹니다. 이 논문이 왜 데이터 과학자와 인프라 엔지니어 모두에게 유용한지 짚어보겠습니다.
📄 심층 리뷰 전문(DOCX): 이 논문의 상세 피어리뷰를 Google Drive에서 다운로드할 수 있습니다.
다섯 축으로 보는 진화
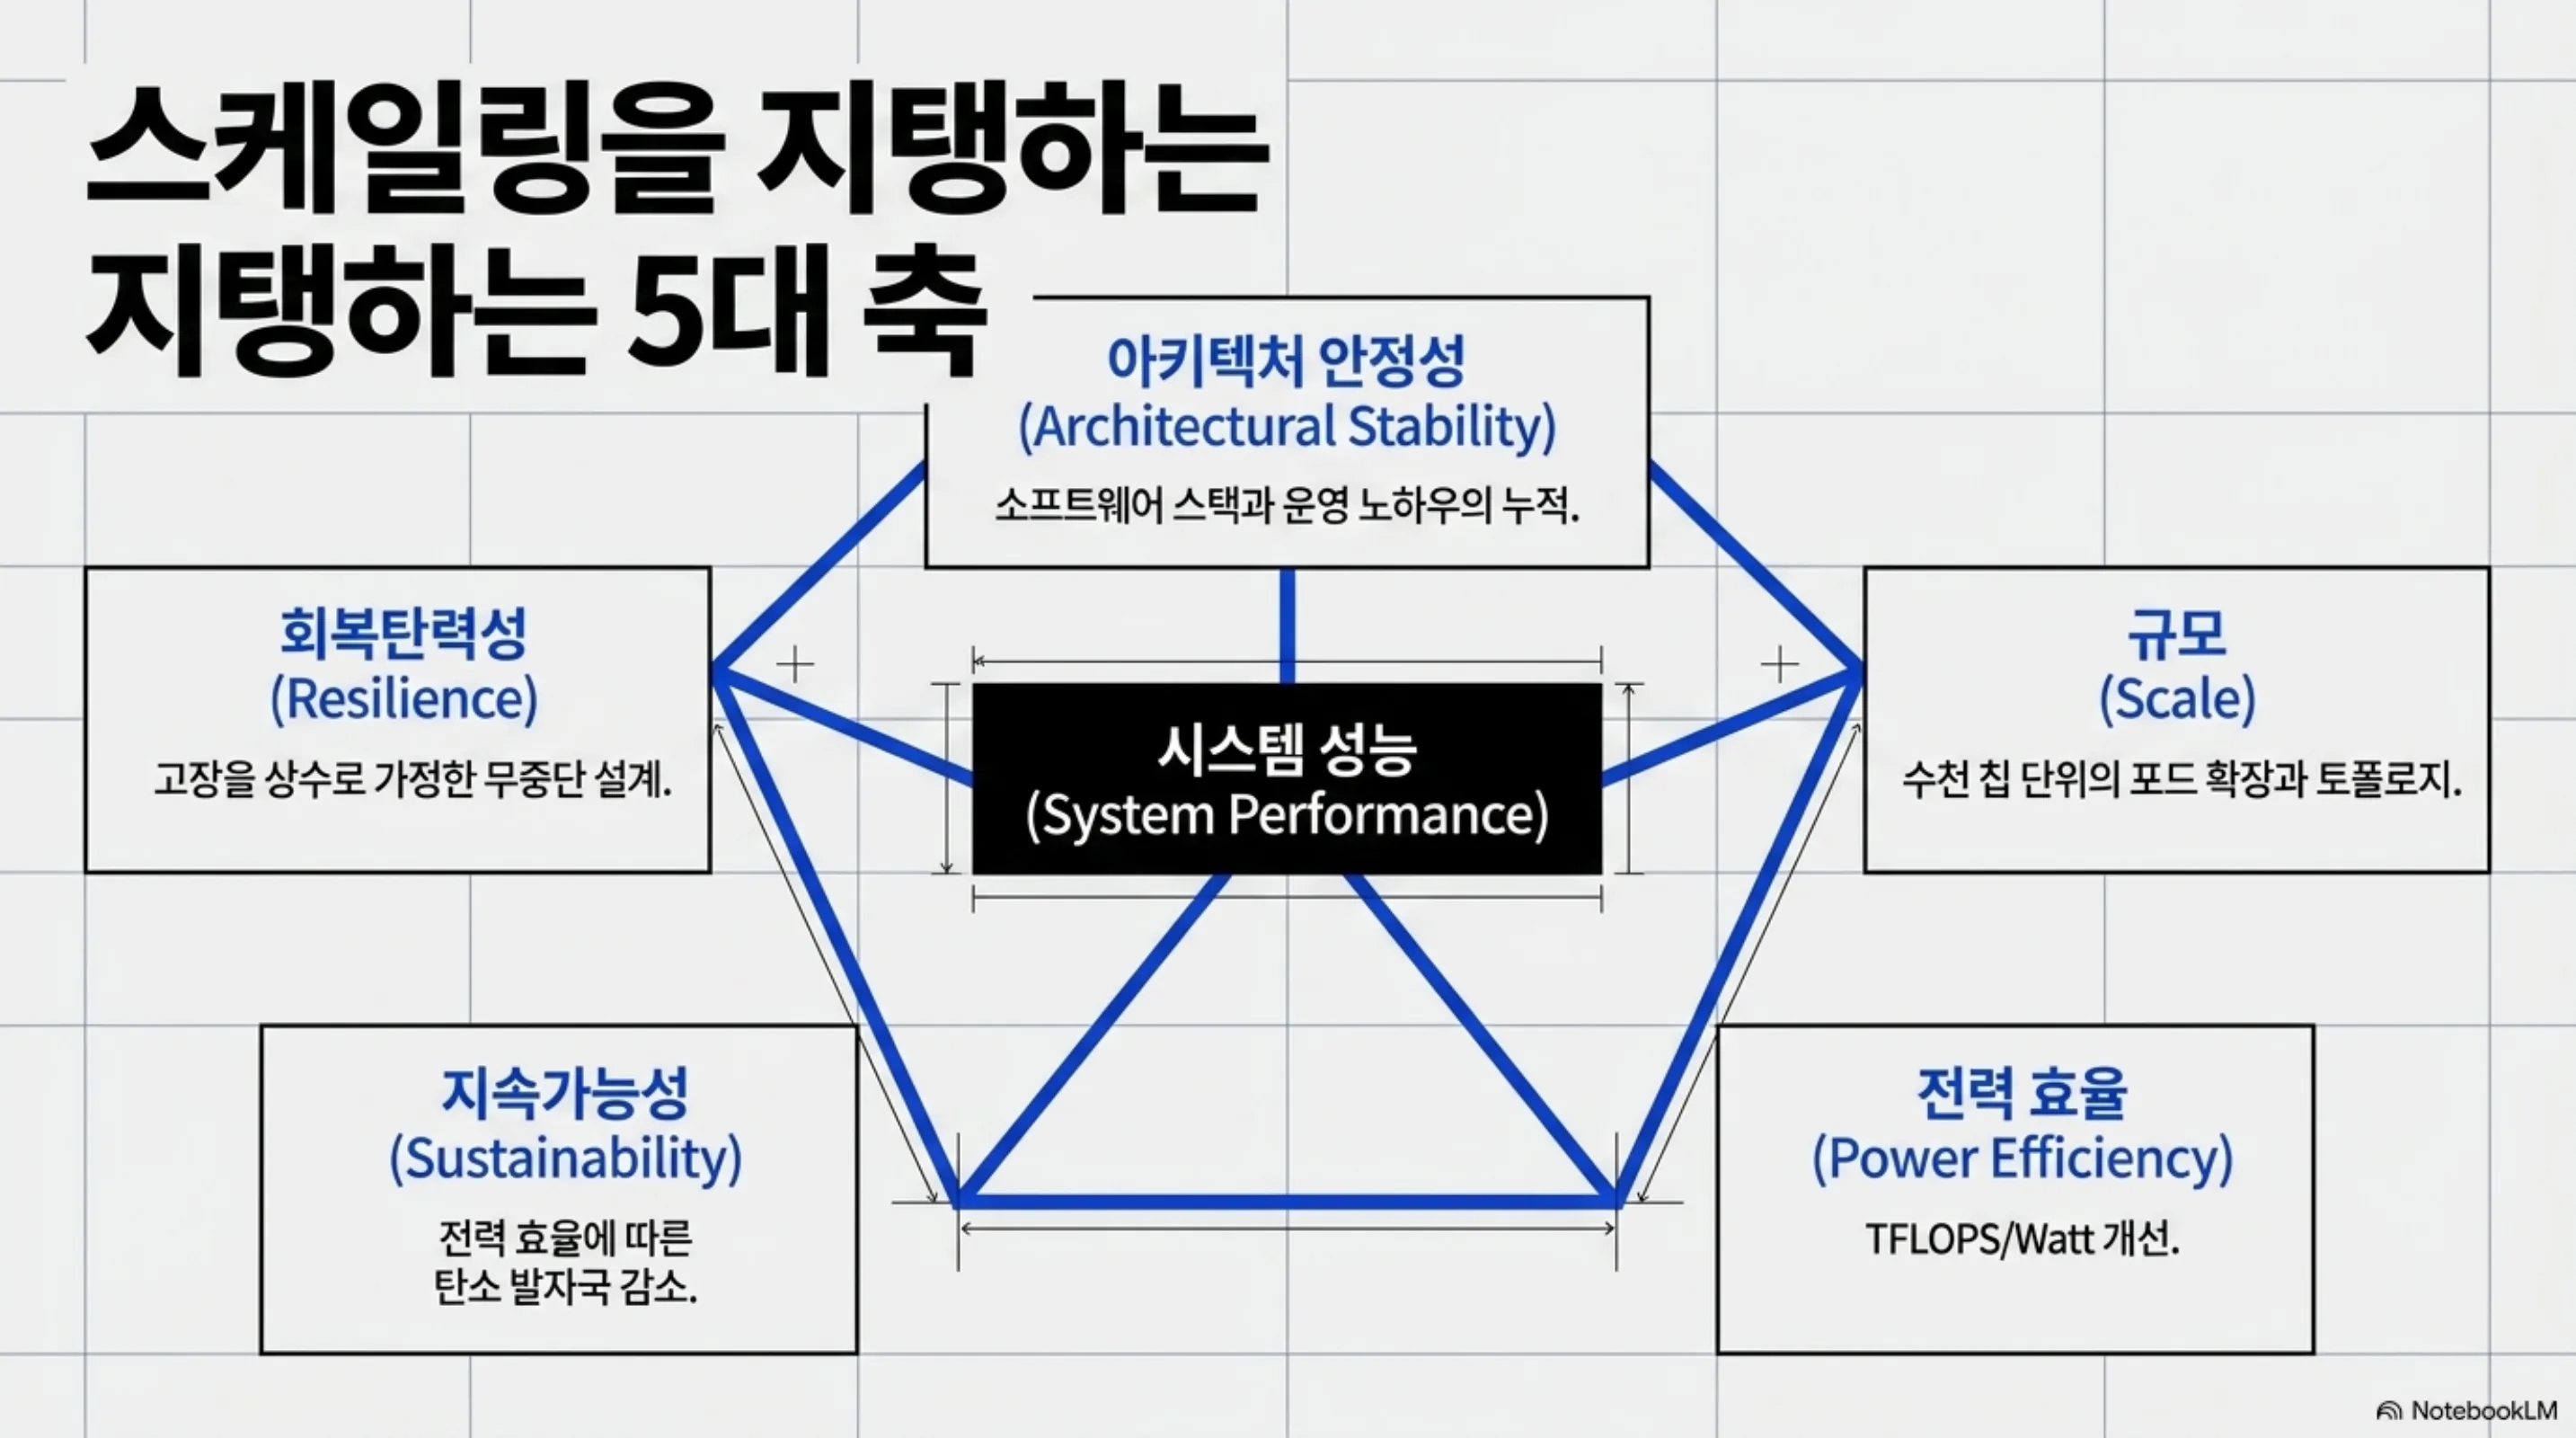
논문이 5세대를 평가하는 다섯 축은 그 자체로 대규모 학습 인프라의 평가 프레임입니다.
- 아키텍처 안정성(Architectural Stability): 세대가 바뀌어도 프로그래밍 모델과 아키텍처의 핵심을 유지해, 소프트웨어 스택과 운영 노하우가 누적되게 합니다. 매 세대 처음부터 다시 배우지 않게 하는 것이 규모의 경제입니다.
- 규모(Scale): 수천 칩 규모의 포드로 확장하며 칩 간 인터커넥트와 토폴로지가 핵심이 됩니다.
- 회복탄력성(Resilience): 수천 칩 규모에서는 고장이 상수입니다. 일부 칩이 죽어도 학습이 계속되게 하는 설계가 필수입니다.
- 전력 효율(Power Efficiency): TFLOPS/Watt 개선이 세대별 핵심 지표입니다. 같은 일을 더 적은 전력으로 하는 것이 운영 비용과 직결됩니다.
- 지속가능성(Sustainability): 전력 효율은 곧 탄소 발자국 문제이기도 합니다.
데이터 과학자가 가져갈 교훈
이 논문이 하드웨어 논문을 넘어 방법론적으로 유용한 이유는 이렇습니다.
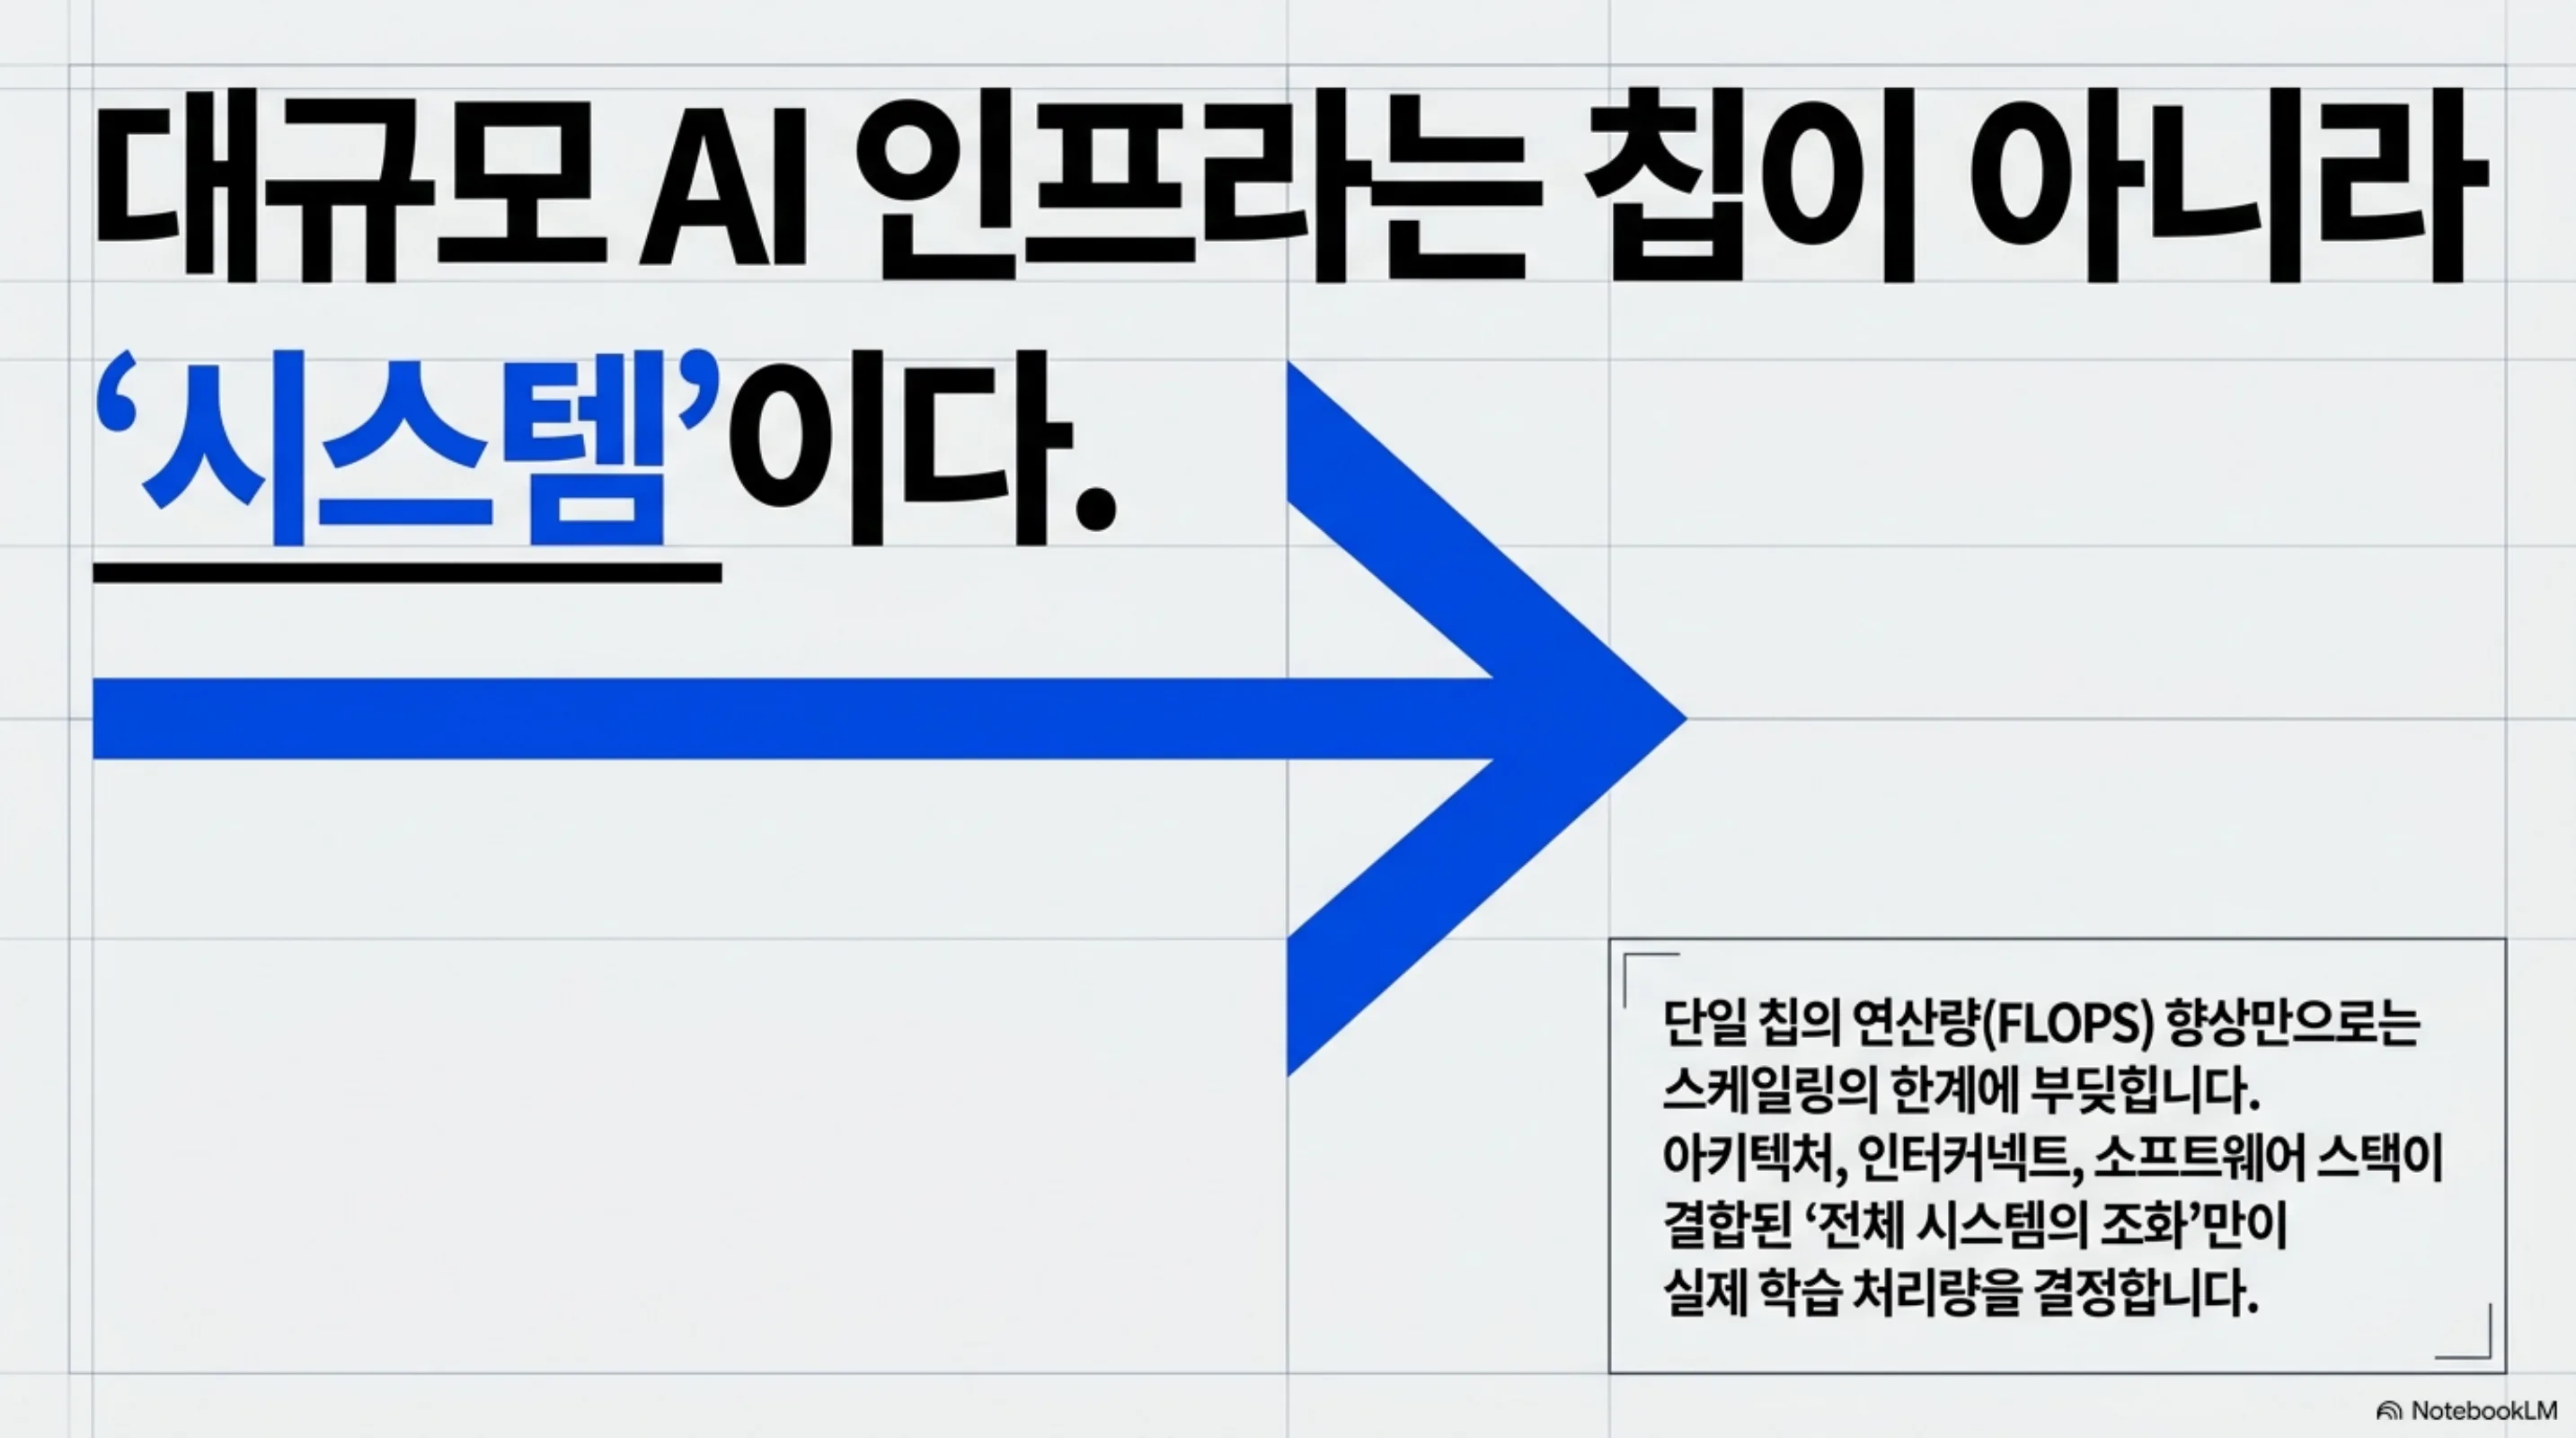
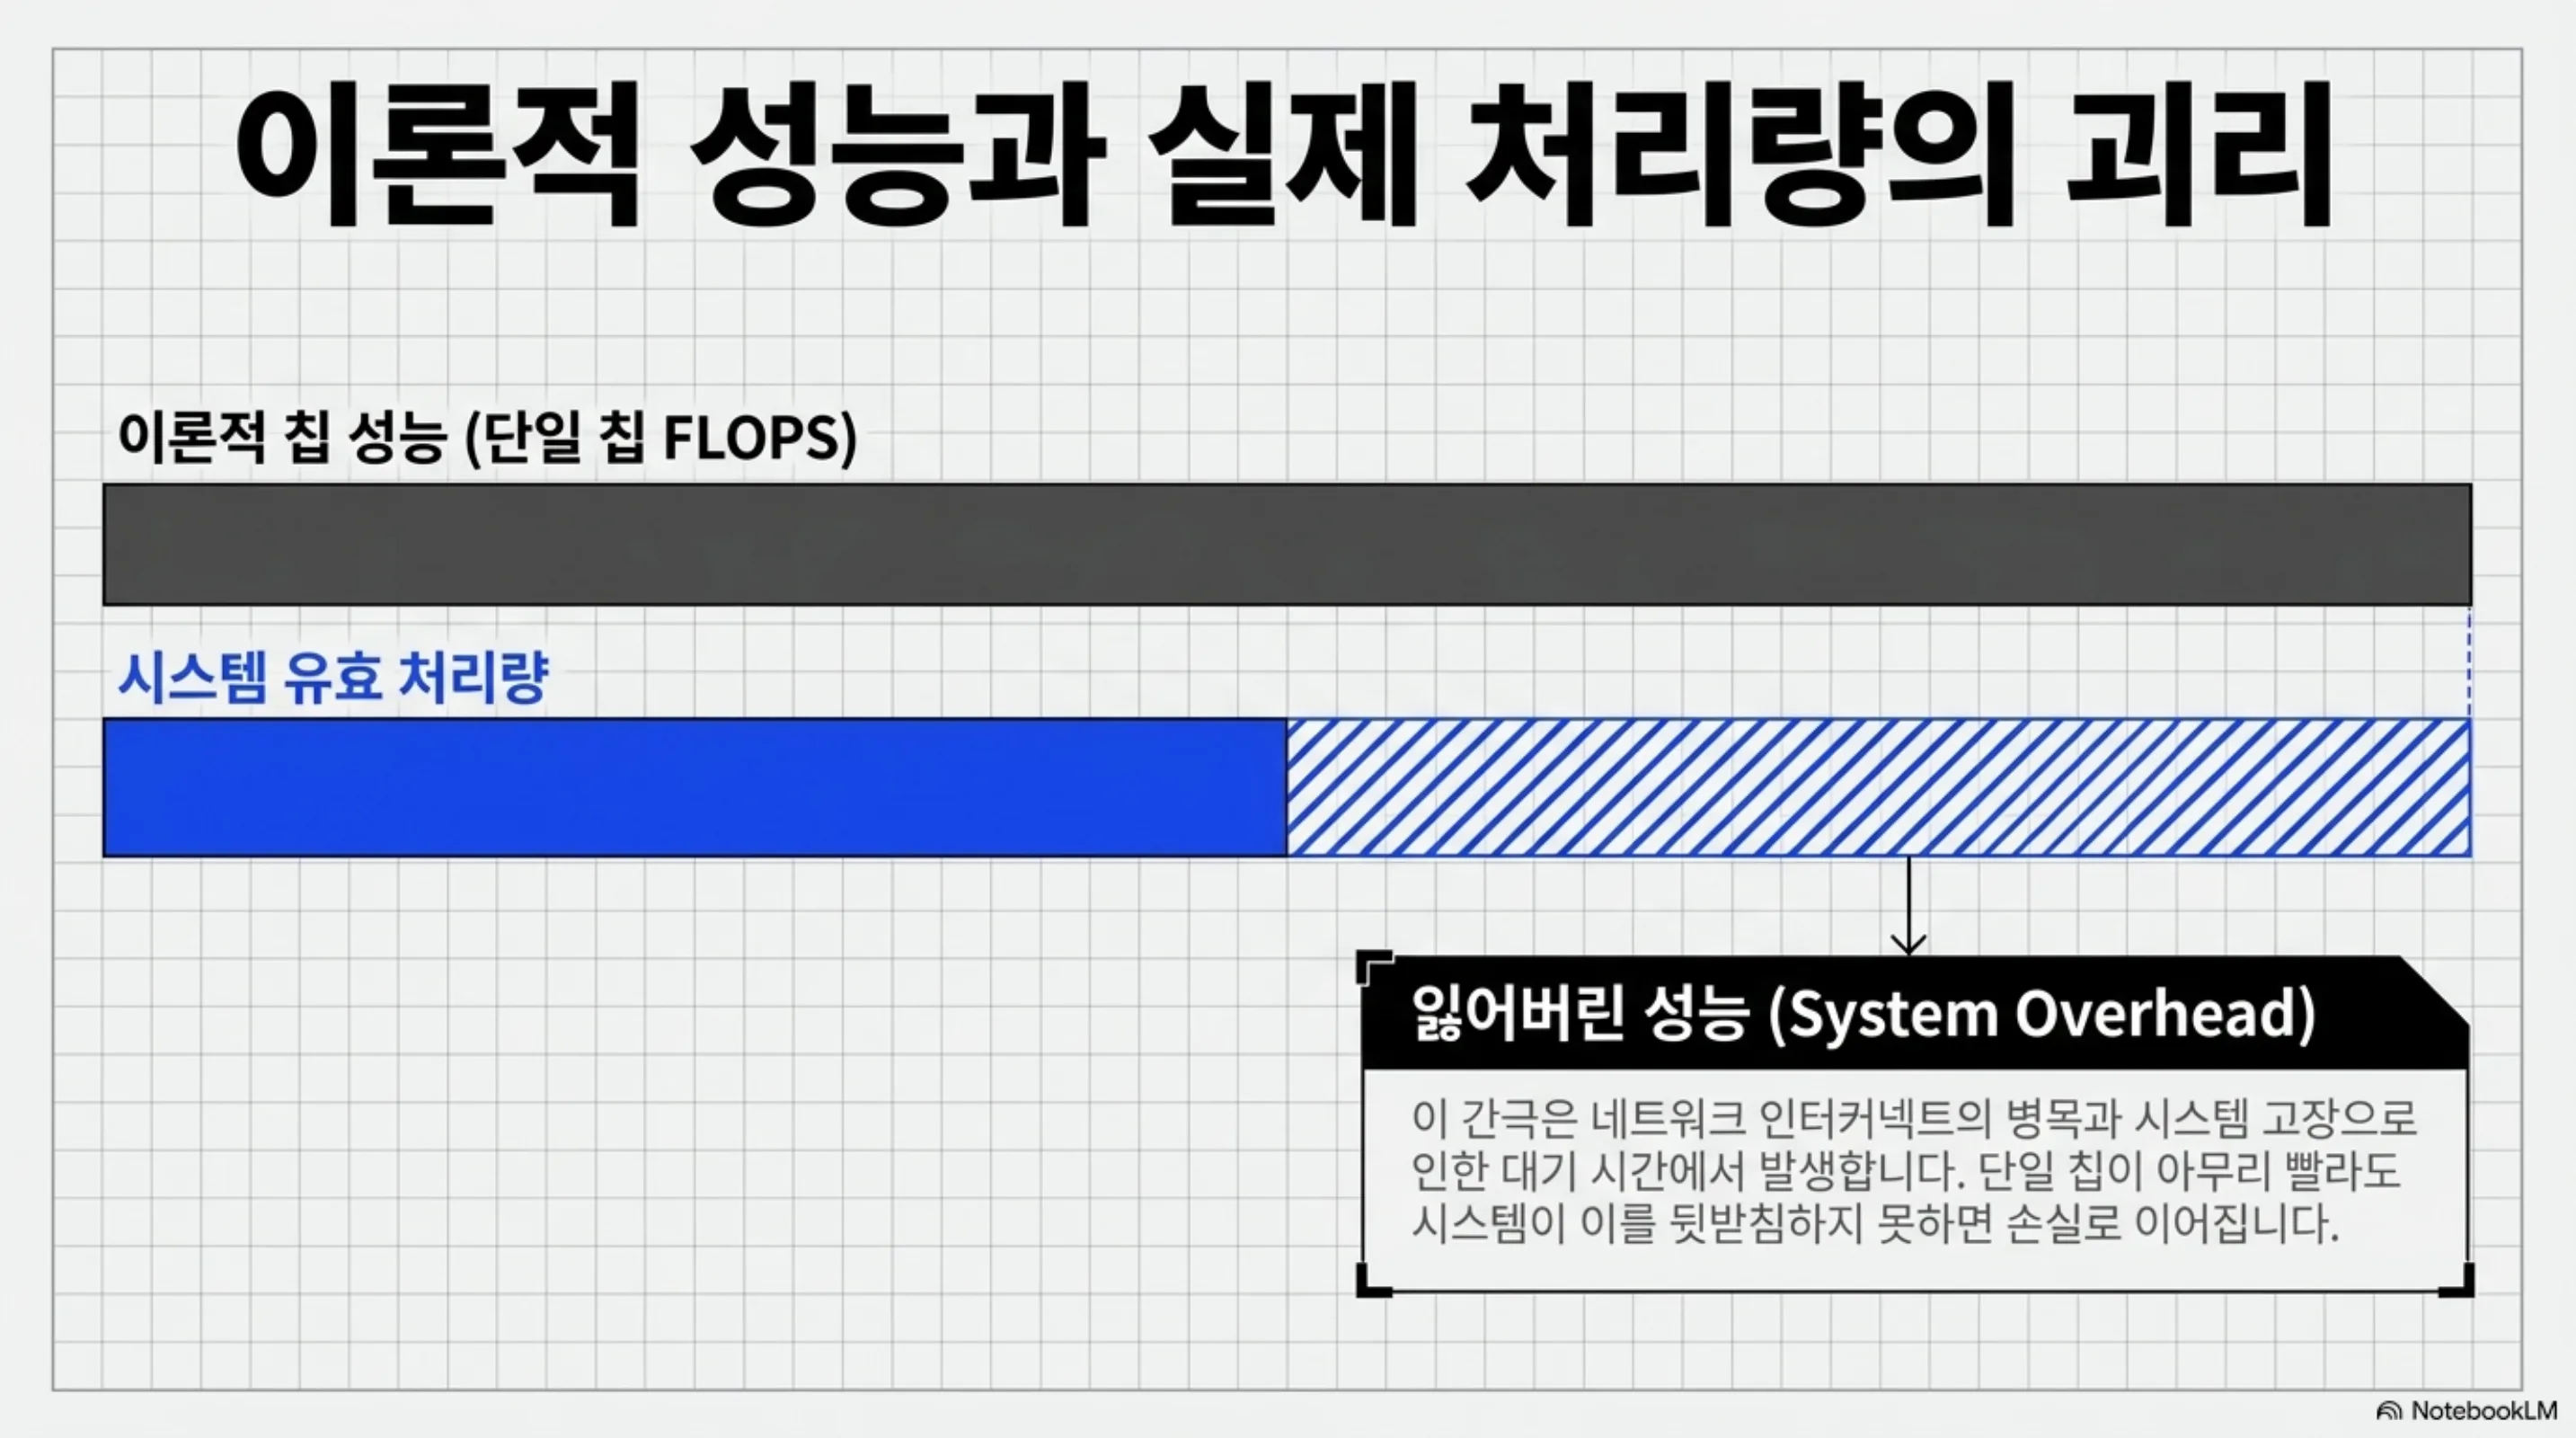
- 시스템 성능 vs 칩 성능: 단일 칩 FLOPS만 보면 진짜 향상을 놓칩니다. 인터커넥트, 토폴로지, 소프트웨어 스택을 포함한 시스템 전체 성능을 보아야 학습 처리량의 실제 개선이 보입니다. 이는 추론 서빙에서도 똑같이 적용됩니다. GPU 한 장의 처리량이 아니라 클러스터 전체의 유효 처리량을 보아야 합니다.
- 회복탄력성이 곧 처리량: 대규모 학습에서 고장 복구 설계가 없으면, 실효 처리량이 급격히 떨어집니다. 체크포인팅과 부분 고장 허용은 옵션이 아니라 처리량 그 자체입니다.
- 전력 효율을 1급 지표로: TFLOPS/Watt를 핵심 지표로 추적하는 것은, 비용을 1급 시민으로 다루는 운영 철학입니다.
ThakiCloud 관점: 대규모 인프라 설계 원칙의 이식
저희는 TPU 같은 전용 슈퍼컴퓨터를 만들지는 않지만 이 논문의 설계 원칙은 K8s 기반 GPU 플랫폼에 그대로 이식됩니다. 아키텍처 안정성은 표준화된 서빙·학습 인터페이스로, 회복탄력성은 Kueue 기반 작업 재시도와 체크포인팅으로, 전력 효율은 GPU 활용률 모니터링과 워크로드 패킹으로 나타납니다.
수천 칩 규모의 교훈을 수십~수백 GPU 규모의 멀티테넌트 플랫폼에 적용하는 것이 저희가 다루는 영역입니다. 고장을 상수로 가정하고 시스템 전체 처리량을 보며 전력·비용을 1급 지표로 다루는 운영 철학은 규모와 무관하게 옳습니다.
마치며
구글의 TPU 5세대 논문은 “대규모 AI 인프라는 칩이 아니라 시스템”이라는 메시지를 데이터로 보여줍니다. 아키텍처 안정성으로 누적하고 회복탄력성으로 처리량을 지키며 전력 효율을 1급 지표로 다루십시오. 이 원칙은 GPU 클러스터를 운영하는 모든 팀에 적용됩니다.
출처: “Google’s Training Supercomputers from TPU v2 to Ironwood: Architectural Stability, Scale, Resilience, Power Efficiency, and Sustainability Across Five Generations”, arXiv:2606.15870 (2026-06-14). https://arxiv.org/abs/2606.15870
📄 심층 리뷰 전문(DOCX): 이 논문의 상세 피어리뷰를 Google Drive에서 다운로드할 수 있습니다.