The Mint Frontier: 태스크가 레지스트리 분포에서 벗어날 때, 새 스킬을 만들어야 할지 기존 스킬에 라우팅해야 할지를 가르는 경계가 OOD 거리에 가격 매겨집니다
셀프호스트 H200 위에서 에이전트 플릿을 돌리거나, 스킬 2,000개 이상의 레지스트리를 키우는 국내 클라우드/AI 엔지니어라면 무감시 루프에서 이 삼중 결정에 부딪힙니다. 들어오는 태스크마다 기존 슂� 중 가장 가까운 것에 라우팅할지, 포기를 선언하고 사람이나 상위 티어로 에스컬레이션할지, 아니면 레지스트리에 없는 새 스킬을 만들어낼지를 결정해야 합니다. ThakiCloud의 분석 논문 The Mint Frontier는 이 결정의 경계에 가격을 매깁니다. 이 글은 경계 자체와, 경계를 보정해서 루프에 넣는 방법을 소개합니다.
먼저 성격을 짚겠습니다. 이 논문은 분석 논문입니다. 새 측정을 보고하지 않습니다. 이 글에 나오는 모든 수는 선언된 nominal 가정에 대한 폐쇄형 예측입니다. 그림 두 장 모두 분석 모델의 산출물입니다. 논문의 이름이 곧 비어 있던 칸입니다. 민트할 때와 라우팅할 때의 경계, 즉 frontier입니다.
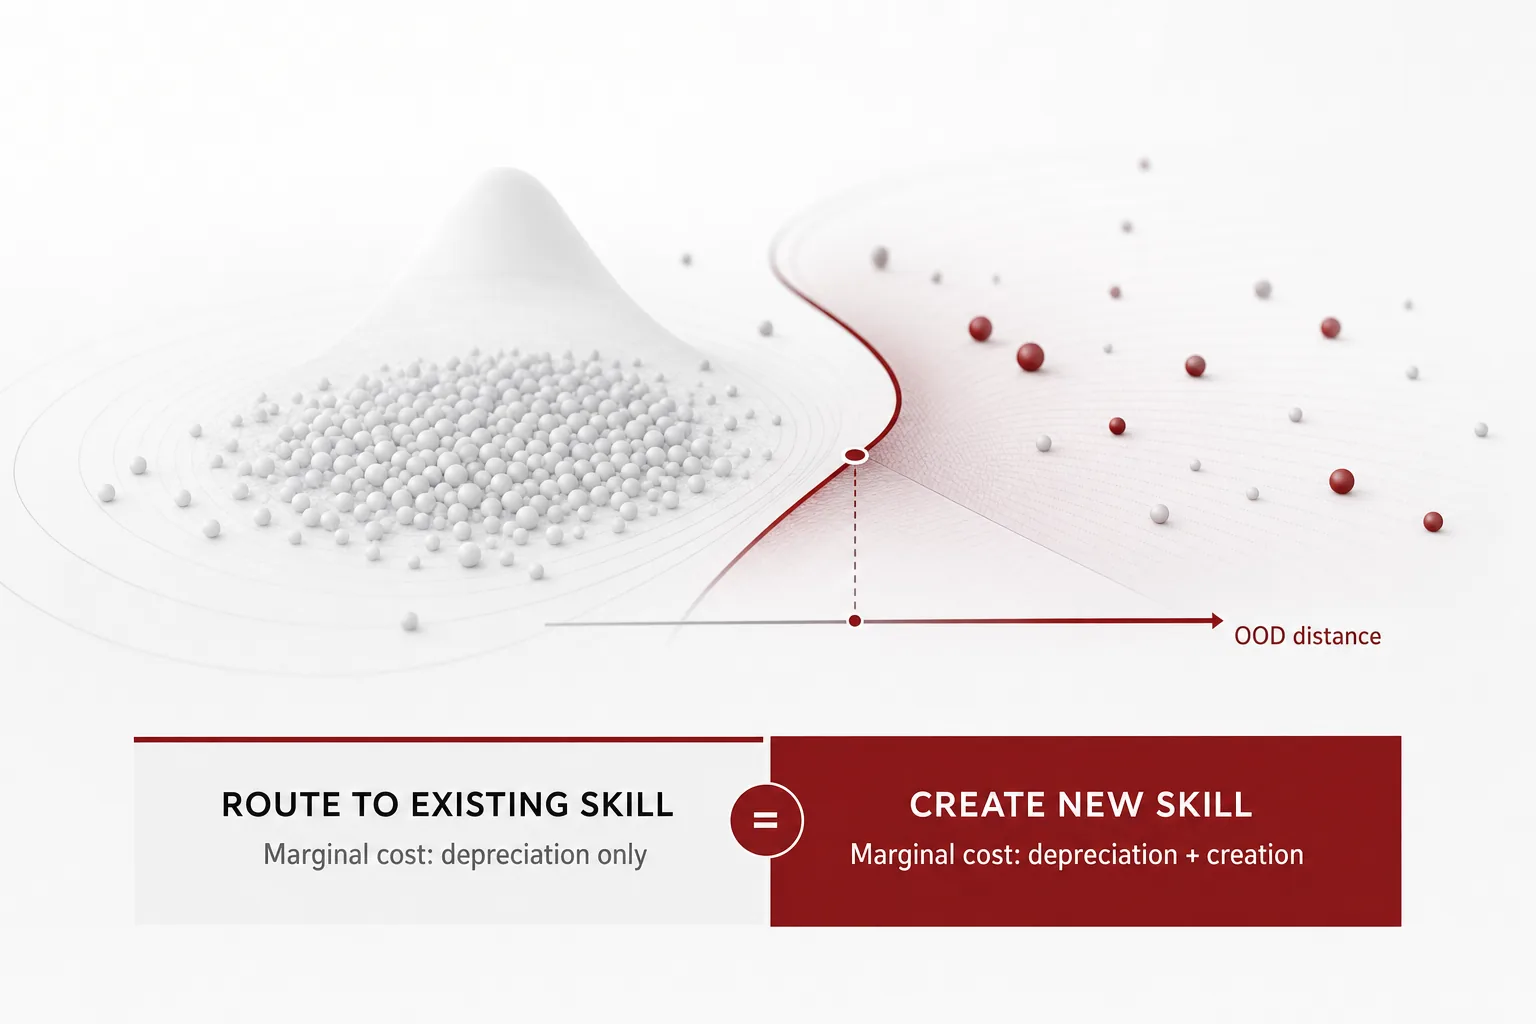 글의 핵심 개념을 형상화했습니다.
문제의식: 라우팅 쪽과 생존 쪽은 가격이 있는데, 경계만 비어 있다
생산 에이전트 하네스의 기본 패턴은 스킬 라우팅입니다. 무감시 루프가 추론과 행동을 번갈아 돌립니다. 들어오는 태스크마다 처음부터 다시 계획하지 않고 가장 가까운 기존 스킬을 붙입니다. 스킬 라이브러리가 계속 자라면, 이 루프는 태스크마다 두 가지를 더 결정해야 하는 자기 진화 시스템이 됩니다. 레지스트리가 덮지 않는 새 스킬을 만들 시점과, 포기를 선언하고 상위 티어나 사람에게 넘길 시점입니다. 후자는 선택지가 아닙니다. 절대 아니라고 말하지 못하는 도구는 누락을 숨깁니다.
이 결정의 조각을 가격 매기는 문헌이 세 갈래 있습니다. 라우팅 쪽은 miss multiplier와 break-even 라우팅 정확도로 가격이 매겨져 왔습니다. 검증된 trace를 재사용 routine으로 상각하는 경제학도 따로 있습니다. 만들어진 스킬의 생존 쪽은 held-out 일반화, 능력 기반 벤치마킹, 크로스 하네스 보존률로 가격이 매겨져 왔습니다. 그런데 이 동작들의 경계를 가격 매긴 연구는 없습니다.
이 논문이 묻는 것은 이겁니다. 레지스트리 분포로부터 out-of-distribution(OOD) 거리 d가 멀어지고 같은 태스크 패밀리의 향후 재출현 수(재귀성) λ가 커질 때, 새 스킬을 만드는 쪽이 SLO-허용 비용 argmin이 되는 지점은 어디입니까. 라우팅이 SLO를 지킬 수 있을 때는 라우팅보다 싼 것이어야 하고, 지킬 수 없을 때는 포기를 선언하는 것보다 싼 것이어야 한다. 세 갈래 문헌을 잇는 OOD 거리 좌표가 정확히 비어 있던 칸이다.
Effective mint frontier: (d, λ) 평면에서 삼중 의사결정
논문은 비용 모델을 두 개의 상태 좌표 위에 세운다. OOD 거리 d(0은 분포 안, 1은 최대 이탈)와 패밀리 재귀성 λ(수평선 W 안의 같은 패밀리 향후 인스턴스 기대 개수)다. d는 보정된 라우터 게이트 g_c로 d = 1 - g_c가 된다.
거리 d에서 라우팅은 인젝션, 실행 시도 하나, 그리고 miss 가산료를 낸다. 붙은 스킬이 틀릴 확률은 q(d)다. 틀리면 (m(d) - 1)회분의 추가 시도가 들며 그 중 ρ(d)만 회수된다. 알려진 분포 안 스킬의 라우팅은 SLO에 고정되어 있어 C_R(0) = C_S가 된다. 민트는 드래프트와 검증의 기대 비용 (C_draft + c_V) / p_gen(d)에, 거리 d에서 만든 슂�을 들여받길 때 생기는 플릿 오염 비용 η(d)을 더한다. 태스크의 유발 비용은 모든 팔에 공통이라 비교에서 빠진다.
손익분기는 단순하다. 패밀리 수평선 위에서 λ ≥ λ(d) = C_M(d) / (C_R(d) - C_S)이면 민트가 라우팅을 이긴다. λ ≥ λ_A(d) = C_M(d) / (c_A - C_S)이면 민트가 포기를 선언하는 것보다 낫다. 결정 공간을 누르는 경계가 두 개 있다. SLO 바닥 d_S(라우팅의 품질 1 - q(d)가 선언된 SLO를 지킬 수 있는 최대 거리)와 생성 도달 수평선 d_max(드래프트 통과율 p_gen(d)가 바닥 p_floor를 지킬 수 있는 최대 거리)다.
d_S 아래에서는 경쟁이 민트 대 라우팅이다. c_A ≥ C_R(1)이므로 포기를 선언하는 것이 라우팅보다 비싸다. 여기서 포기가 이기는 경우는 없다. d_S 위에서는 라우팅이 SLO-불허용 상태가 된다. 경쟁의 무대는 민트 대 포기가 된다. d_max를 넘으면 포기가 유일한 허용 팔이다. 두 조각을 이어붙인 것이 piecewise effective frontier λ_eff(d)다. 의사결정 규칙은 d ≤ d_max이고 λ ≥ λ_eff(d)일 때 민트다.
흥미로운 형상 결과가 하나 있다. 하위 frontier λ(d)는 단조하지 않고 unimodal이다. d가 0에 가까워지면 무한대로 발산한다. 구간 안의 유일한 최소점 d에서 꺾여 다시 올라간다. 그래서 λ의 수준 집합은 반직선이 아니라 밴드 [d_1, d_2]가 된다. 재귀성 λ가 최소점 아래면 어떤 거리에서도 민트는 생기지 않는다. 재귀성이 클수록 밴드는 양쪽으로 넓어진다.
선언된 nominal rate card(C_S = $1.02, c_A = $5.00, SLO = 0.90, 검증 커버리지 v = 0.80, W = 30일)에서 frontier는 구체적인 값을 얻는다. d_S ≈ 0.229, d_max ≈ 0.923, d* ≈ 0.806, λ의 최소값 ≈ 23.1, 그리고 λ_A(d_max) ≈ 6.31이다. 마지막 숫자의 뜻은 이겁니다. 재귀성이 6.31 이상인 패밀리는 라우팅이 SLO-불허용인 (d_S, d_max] 전체 구간에서 민트가 이기게 됩니다. 왼쪽(민트 대 라우팅) 조각은 λ ≈ 178 이상에서 처음 나타납니다.
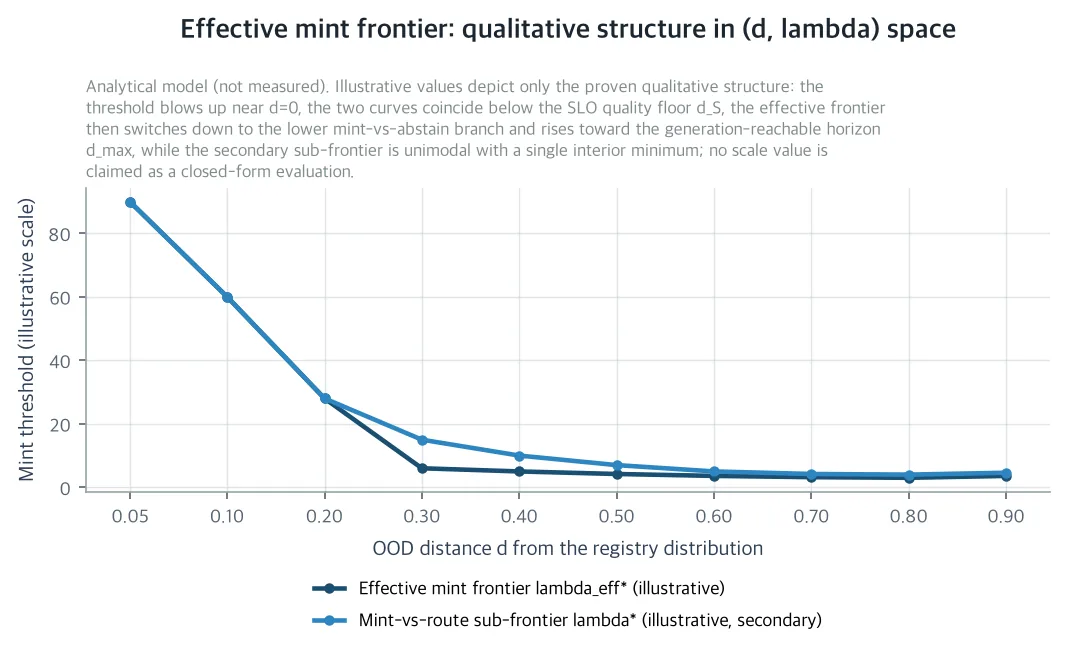 SLO-허용 비용 argmin 하의 piecewise effective mint frontier λ_eff(d). SLO 바닥 d_S 아래는 민트 대 라우팅 break-even λ(d), 그 위는 민트 대 포기 break-even λ_A(d)입니다. 얇은 점선 곡선은 unimodal 하위 frontier λ(d)의 정성적 형상입니다. 색칠된 영역은 route/mint/abstain 각자의 승리가 나는 지역입니다. 분석 모델의 예시이며 실측이 아닙니다.
Verification-side dominance: 경계를 그리는 것은 검증기, 생성기가 아니다
두 번째 결과는 민트 frontier의 위치가 검증 쪽에서 정해진다는 것입니다. 완전한 민트 문턱 λ(d)에서 순수 상각화 break-even λ_0(d)(오염 항이 없는 compiled-routine 형태)를 빼면, 항등식이 나옵니다. λ(d) - λ_0(d) = η(d) / (C_R(d) - C_S). 이 추가량에는 생성 비용 C_draft도 검증 비용 c_V도 들어 있지 않습니다. 생성 비용은 frontier 전체를 승수로 재스케일할 뿐인 셈입니다. 추가량을 정하는 것은 플릿 오염 η(d)입니다. η(d) = η_0(1 - v)(1 + d)이고 좌표는 기초 오염 레벨 η_0과 검증 커버리지 v가 정합니다.
생성기를 아무리 잘 고쳐도 오염 때문에 frontier에 붙는 excess는 바뀌지 않는다는 뜻입니다. 경계 레벨을 정하는 레버는 검증 커버리지입니다. 파생으로 hard cap이 나옵니다. 플릿 보험 경계가 허용하는 최대 premium π_cap을 선언해 두면, π(d) ≥ π_cap인 들여받기는 재귀성 λ와 무관하게 금지됩니다. λ는 π에 들어가지 않으므로 이 금지는 모든 재귀성 레벨에서 성립합니다. 상시 자기 진화 루프는 거리 d로 들여받기에 상한을 둘 수밖에 없는 것입니다.
선언된 nominal 값에서는 v = 0.80이라 relative premium π는 0.24%에서 1.68% 사이입니다. d가 어디를 가나 작습니다. 크기는 레짐 의존입니다. 이 명제는 레벨 주장이 아니라 항등식입니다. robust한 부분은 hard cap입니다.
운영 규칙으로 번역하면 한 줄입니다. 생성기보다 먼저, 검증기에 투자하는 것입니다. 검증 커버리지 v의 한 점과 기초 오염 레벨 η_0의 감소는 λ(d)와 λ_A(d)를 모두 내립니다.
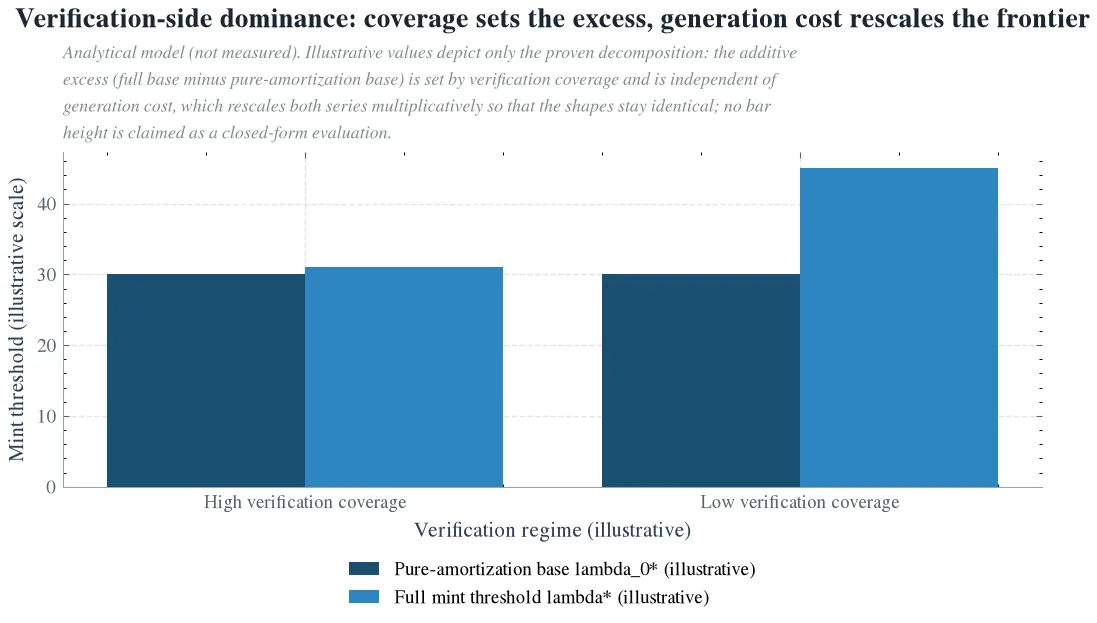 높은 검증 커버리지와 낮은 커버리지 아래, 순수 상각화 기반 λ_0(d)와 완전한 민트 문턱의 비교 예시입니다. 추가량 λ* - λ_0는 커버리지 (η_0, v)가 정하고 생성 비용과 무관합니다. 생성 비용은 frontier 전체를 승수로 재스케일합니다. 분석 모델의 예시이며 실측이 아닙니다.
의사결정 보정: raw gate에서 action-Brier까지
frontier는 입력 d̂과 λ̂이 좋을 만큼만 좋습니다. ThakiCloud의 앞선 생산 지표에 따르면, 라우터의 raw 신호는 분리력은 있으나 보정이 안 된 상태입니다. 2,283개 entry의 production index에서 라우터 자신의 compositeness 신호는 gold 태스크의 91.23%에 불면서 no-skill 태스크 10개 중 0개에만 불었습니다. 분리력은 있지만 점수에는 결정 등급의 뜻이 없습니다.
논문의 수단은 ladder 보정입니다. OOD ladder(실제 워크플로 템플릿 12개에 표면 변이를 단계별로 적용한 변형, 그리고 gold 스킬이 없는 진정 신규 패밀리 팔 하나)에서는 표면 변이의 깊이가 거리 d를 정합니다. raw gate g에서 d̂ = Φ(g)로 가는 단조 map(temperature나 Platt 계열, 단조성에는 isotonic 회귀)을 동작 레벨 리스크를 최소화하도록 맞춥니다. ladder는 보정을 검사하는 실제 거리 축의 역할을 합니다.
3-방향 동작은 proper action-Brier 점수로 점수 매겨집니다. 목표 y는 (d, λ)에서 SLO-허용 비용 argmin이 민트인지의 0/1 변수입니다. 모델이 주는 민트 확률 ŷ는 (d, λ) 층별로 reliability diagram과 함께 보고합니다. 잘 보정된 규칙은 d̂ ≤ d_max이고 λ̂ ≥ λ_eff*(d̂) + margin일 때 민트를 선택합니다. margin은 action-Brier로 튜닝되는 자유 초매개변수입니다. λ̂은 harness 로그에서 향후 패밀리 인스턴스에 대한 지수 패밀리 rate로 직접 읽어 오므로, 추가 계장 없이 선언된 회계만으로 동작합니다.
선택 예측 보정이 답 대 포기의 2-방향에서 3-방향 동작 선택으로 확장되는 것이 이 부분입니다.
그래서 무엇을 주나: 회사, 사회, 과학
ThakiCloud의 스킬 생태계 팀에 이 논문은 야간 자기 진화 루프에 측정 가능한 결정 경계를 줍니다. 언제 새 스킬을 만들지, 언제 기존에 라우팅할지, 언제 에스컬레이션할지가 직감이 아니라 frontier 위의 좌표가 됩니다. 재귀하지 않는 패밀리 스킬을 만들어내는 토큰 낭비를 줄입니다. OOD 태스크를 잘못 스킬에 끼워 넣는 것에서 오는 품질 퇴보도 막습니다.
무감시 자율 에이전트 시스템 전체로는, 능력을 늘릴 때와 재사용할 때를 정량화해 자기 진화를 더 싸고 안전하게 만듭니다. 모든 민트 뒤에 사람이 서 있을 여력이 없는 작은 팀에도, 새 스킬을 들여받을 가치가 있는 순간을 비용으로 정당화하는 규칙이 생깁니다.
스킬 라우팅 문헌에는 측정되지 않던 축이 하나 늘었습니다. 이전 연구는 라우팅 팔(miss multiplier, break-even 정확도), 상각화(재귀성 break-even), 생존(held-out 일반화, 크로스 하네스 보존률)을 따로따로 가격 매겼습니다. 동작 사이 경계를 OOD 거리의 함수로 가격 매긴 것은 이번이 처음입니다. route/abstain/mint 동작 공간과 보정된 비용-품질 break-even은 abstention-only 연구와 survival-only 연구의 한 단계 업그레이드입니다.
논문은 동결 팩토리얼 측정 프로토콜과 사전 등록된 반증 기준 F1-F5를 함께 둡니다. 이것은 기기에 속합니다. 결과는 아닙니다. 프로토콜이 고정하는 것은 셀프호스트 H200 위 2,288-entry 레지스트리 스냅샷 하네스가 각 주장이 성립하려면 무엇을 관찰해야 하는지입니다. q(d)가 d의 증가와 함께 줄지 않는지, p_gen(d)가 줄어드는지, 실측 break-even이 폐쇄형과 ×/÷1.5 안에서 일치하는지, 보정된 게이트가 raw 게이트의 action-Brier를 이기는지, 플릿 보험 경계가 지켜지는지가 기준입니다.
한계: 이 논문이 주장하지 않는 것
모든 instantiated 값은 선언된 nominal 가정입니다. 프로토콜은 사전 등록된 계기이지 수행된 작업의 기록이 아닙니다. 형상 결과(내부 하위 frontier 밴드와 verification-side 항등식)는 대수적이고 rate card 불변입니다. 다만 문턱 레벨과 밴드 위치 [d_1, d_2]는 선언된 2차/선형 working form에 의존합니다. d→0+ 발산, 추가량 항등식, SLO 바닥 아래의 포기 불가 특성은 form-robust합니다. 위치는 form-dependent입니다.
OOD 거리는 구성된 표면 거리(패러프레이즈 깊이, 도구 치환 수)입니다. 진정 novelty가 아닙니다. 진정 신규 팔이 표면 거리와 의미 novelty를 분리합니다. 스킬은 유지보수와 자기 진화로 변하므로 frontier는 움직이는 레지스트리의 스냅샷입니다. registry가 자라는 조건이 drift가 들어오는 곳입니다.
오염 기초 레벨 η_0은 rate card 값이고 측정값이 아닙니다. F5가 유일한 플릿 측 가드입니다. F5가 깨지면 hard cap이 바인딩됩니다. frontier 전체는 셀프호스트 H200 서빙 regime으로 서술됩니다. 클라우드 API 하네스와 다른 엔진 계열은 범위 밖입니다.
논문 원문과 수반 자료는 여기에서 볼 수 있습니다: The Mint Frontier 데이터셋
본문의 모든 수는 선언된 nominal 가정에 대한 분석 모델의 예측이며 실측이 아닙니다. 그림 두 장은 분석 모델의 정성적 형상입니다.
