스킬 선택의 브레이크이븐: 인덱싱과 리랭킹이 처음 자기 비용을 회수하는 레지스트리 크기
무인 에이전트 하네스를 돌리거나, 그 추론 비용을 책임지는 엔지니어라면 이 글이 곧 오늘 일입니다. 스킬 N개를 지닌 레지스트리 위에서 매 쿼리는 시작 전에 하나의 스킬로 라우팅되어야 하고 그 호출은 모든 쿼리의 핫패스에 서서 토큰과 지연을 서빙 비용에 그대로 더합니다. 이 라우팅 호출을 두고 두 아키텍처가 경쟁합니다. 첫 번째는 전체 매니페스트, 곧 N개 스킬 설명을 이어 붙인 텍스트를 시스템 프롬프트에 넣고 LLM이 직접 고르는 인-컨텍스트 선출입니다. 두 번째는 인덱스를 만들어 쿼리마다 상위 k개 쇼트리스트를 검색한 뒤 그 안에서 고르는 검색 기반 라우팅이고 선택적으로 LLM 리랭커를 끼우는 세 번째 팔도 있습니다. 이 논문은 둘을 같은 비용-품질 축 위에 올려 아직 아무도 답하지 않은 질문을 줍니다. 레지스트리 크기 N이 어느 정도인지에서 인덱싱과 리랭킹이 처음 자기 비용을 회수하는가. 이전 연구들은 전부 고정된 단일 규모에서 검색 품질만 잰 것이고 그 경계는 열려 있습니다. 모든 수치는 명시한 전제에서 유도한 해석 모델의 예측이기 때문입니다. 논문은 그 예측을 뒤집기 위한 측정 프로토콜과 반증 기준까지 미리 적어 둡니다.
 글의 핵심 개념을 형상화했습니다.
고정 규모 평가가 남긴 빈 칸
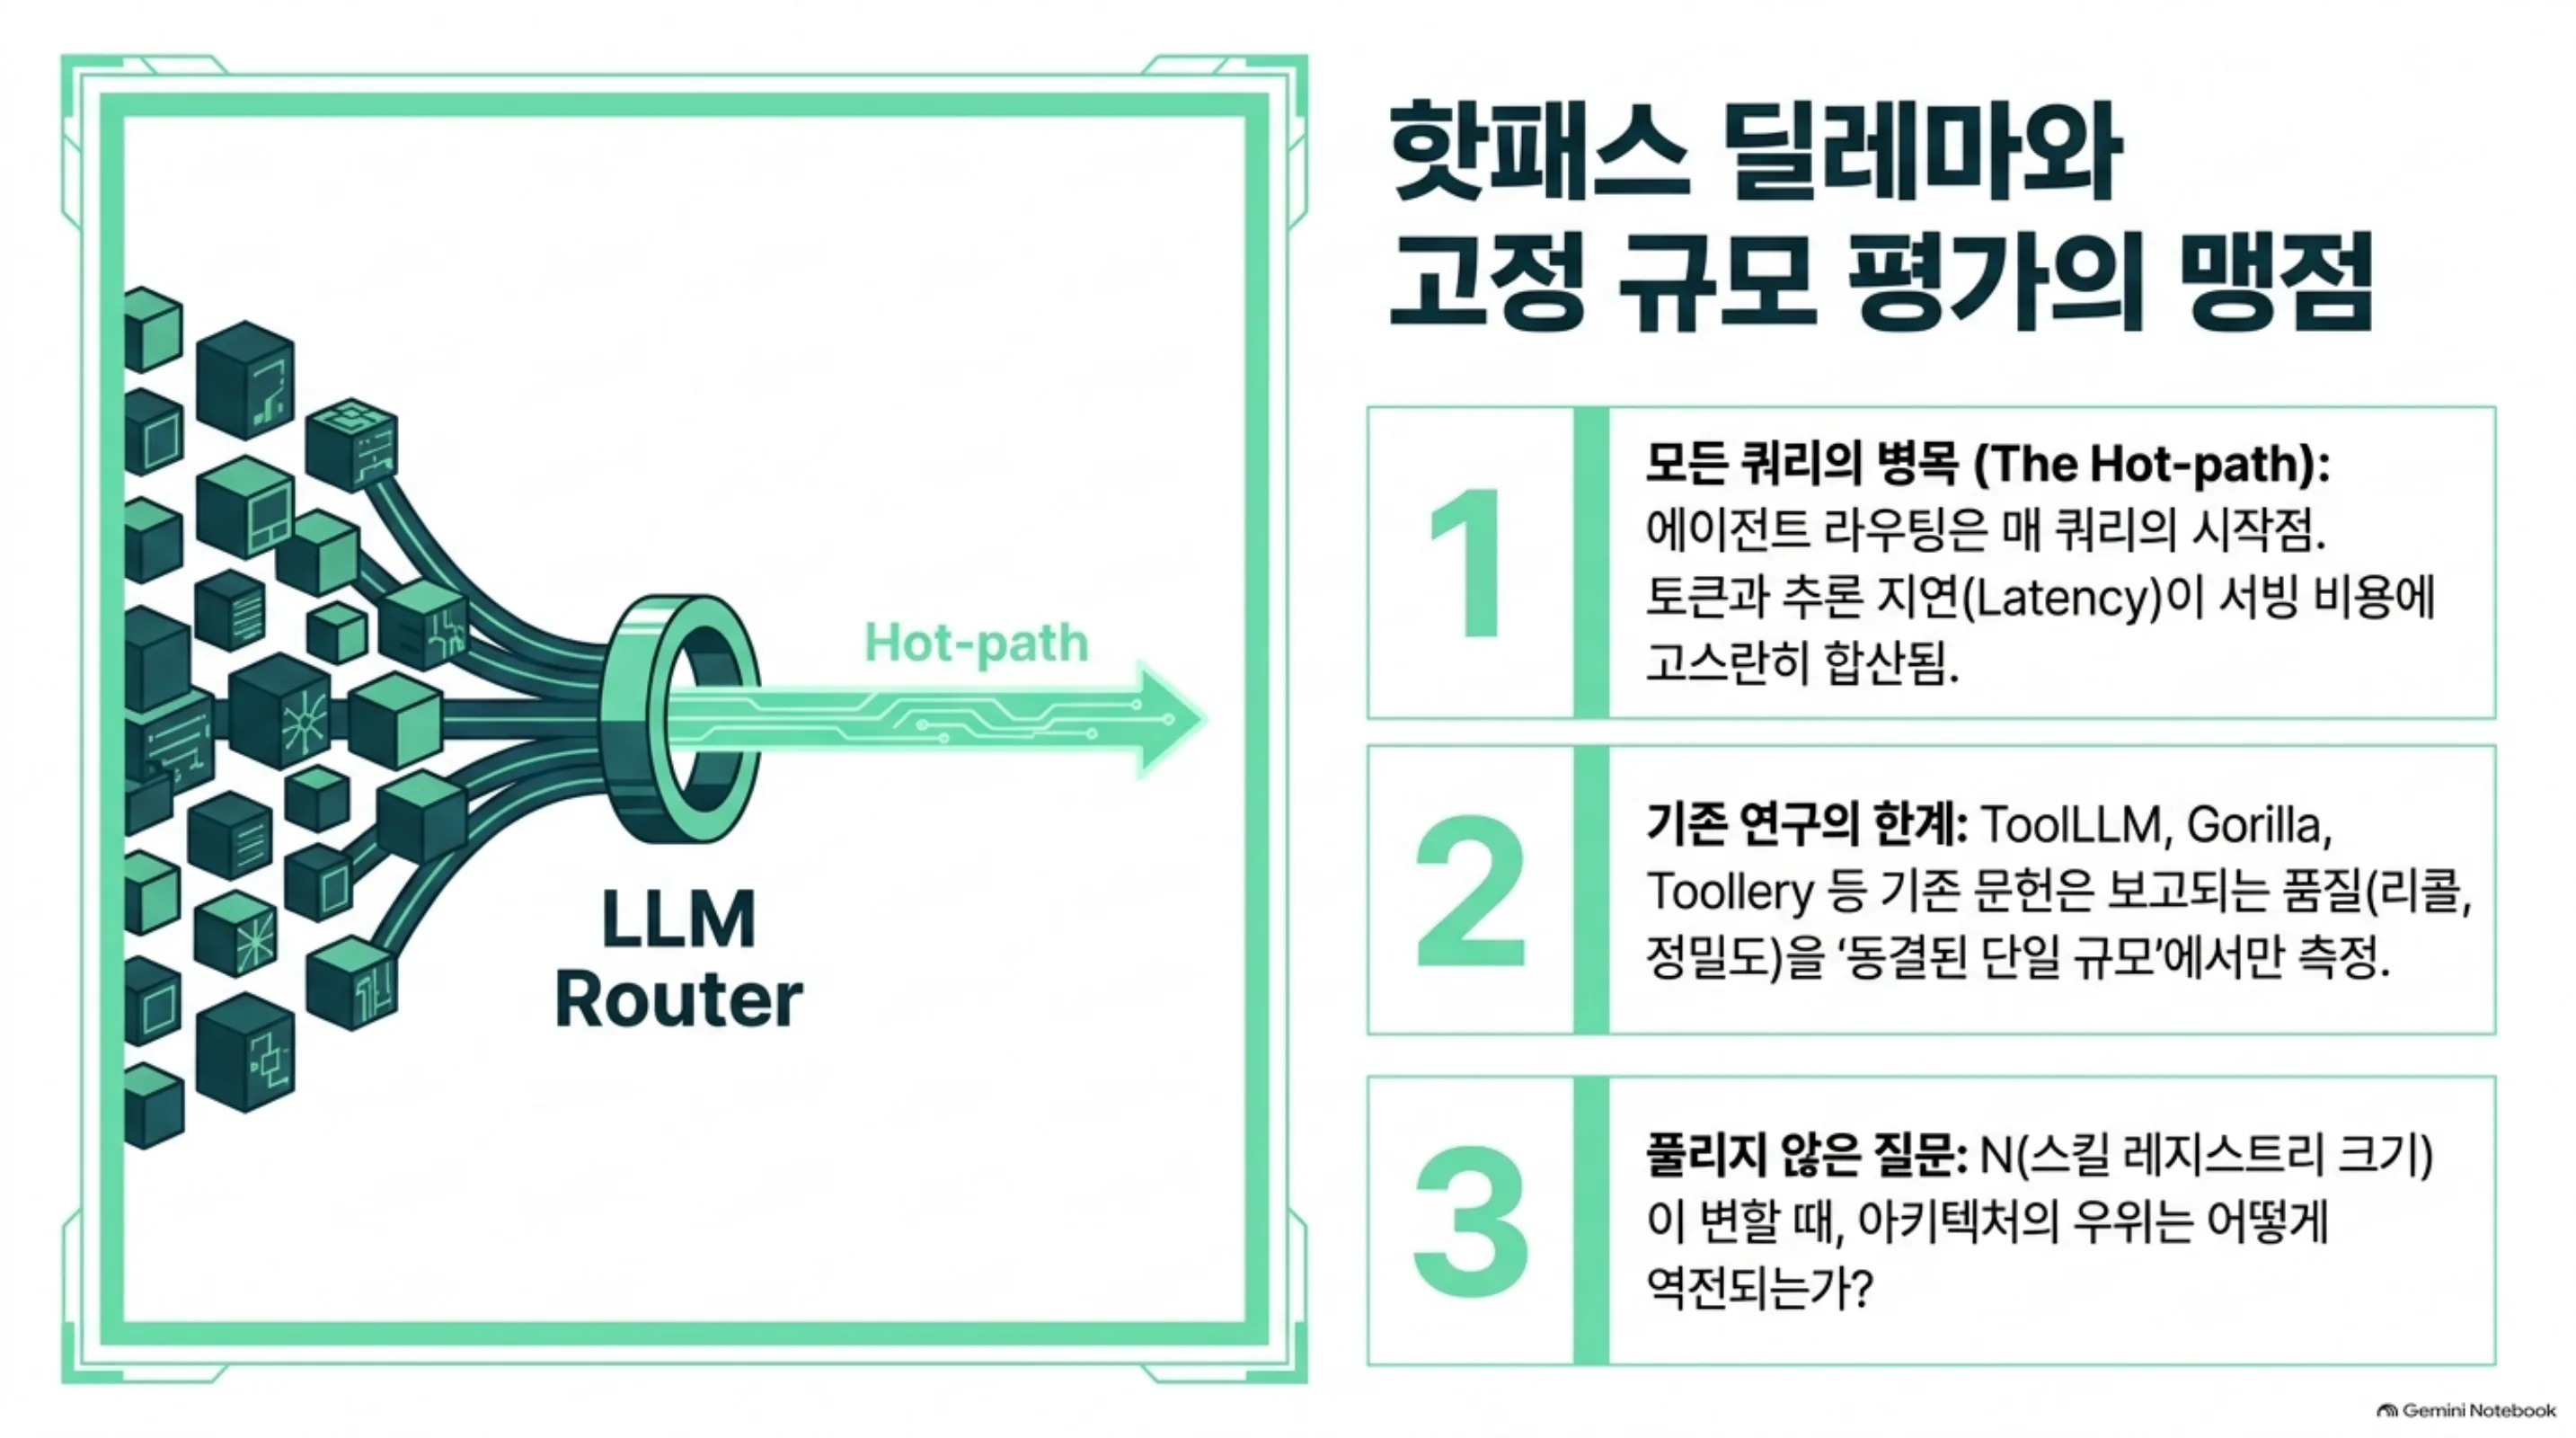
도구 선택 문헌은 두 팔을 따로따로, 그리고 고정된 규모에서 연구해 왔습니다. ToolLLM은 16,000개 이상의 실세계 API에서 검색 기반 도구 선택을 돌렸고 Gorilla는 거대 API 코퍼스를 RAG로 연결했습니다. PORTS는 LLM이 큰 도구 집단을 다루기 힘들어 한다는 전제에서 선호 최적화 리트리버를 훈련했고 Toollery는 라이브러리가 수백에서 수만 개의 기능으로 커지면 전체 프롬프팅이 비용과 지연, 신뢰성 모두에서 무너진다는 것을 보여 주며 훈련 없이 후보를 압축하는 방법을 만들었습니다. 34,396개 스킬에 이르는 생산 스킬 라우터도 문서화되어 있습니다. 공통점은 하나입니다. 보고되는 품질, 리콜과 정밀도와 선출 정확도는 전부 단일이고 동결된 레지스트리 크기에서 잰 것입니다.
그래서 아키텍처의 브레이크이븐 질문은 열려 있습니다. N이 충분히 작으면 검색 인프라의 오버헤드가 단일 매니페스트 호출보다 비쌀 수 있고 충분히 크면 매니페스트 호출이 비용과 품질 양쪽에서 무너집니다. 고정 규모 평가는 그 경계를 찾는 용도로 설계되지 않았습니다.
이 논문은 그 평가를 한 단계 올립니다. 레지스트리 크기 N을 스윕하고 전체 매니페스트에 대한 직접 인-컨텍스트 선출을 비용-품질 프런티어 위의 일급 경쟁자로 승격시킵니다. 검색 팔과 같은 축, 쿼리당 비용과 오루트 페널티 가중치된 품질로 심판하는 것입니다.
ThakiCloud의 이전 세 연구도 같은 맥락에 섭니다. 1,600여 스킬의 생산 하네스에서는 구성형 스킬 라우팅의 한계를, 하이브리드 BM25+임베딩 라우터에서는 밀도 측 양자화 오류와 융합 가중치의 관계를, 라우터 추론에서는 스테이지별 비용-품질 프런티어를 각각 정립했습니다. 세 연구는 모두 검색 라우팅이 이미 갖춰진 것을 전제로 하고 잘 돌리는 법만 물었습니다. 이 논문은 세 연구보다 앞선 질문을 겁니다. 검색 라우팅을 아예 갖출 가치가 있는가. 답이 N에 따라 달라지는가.
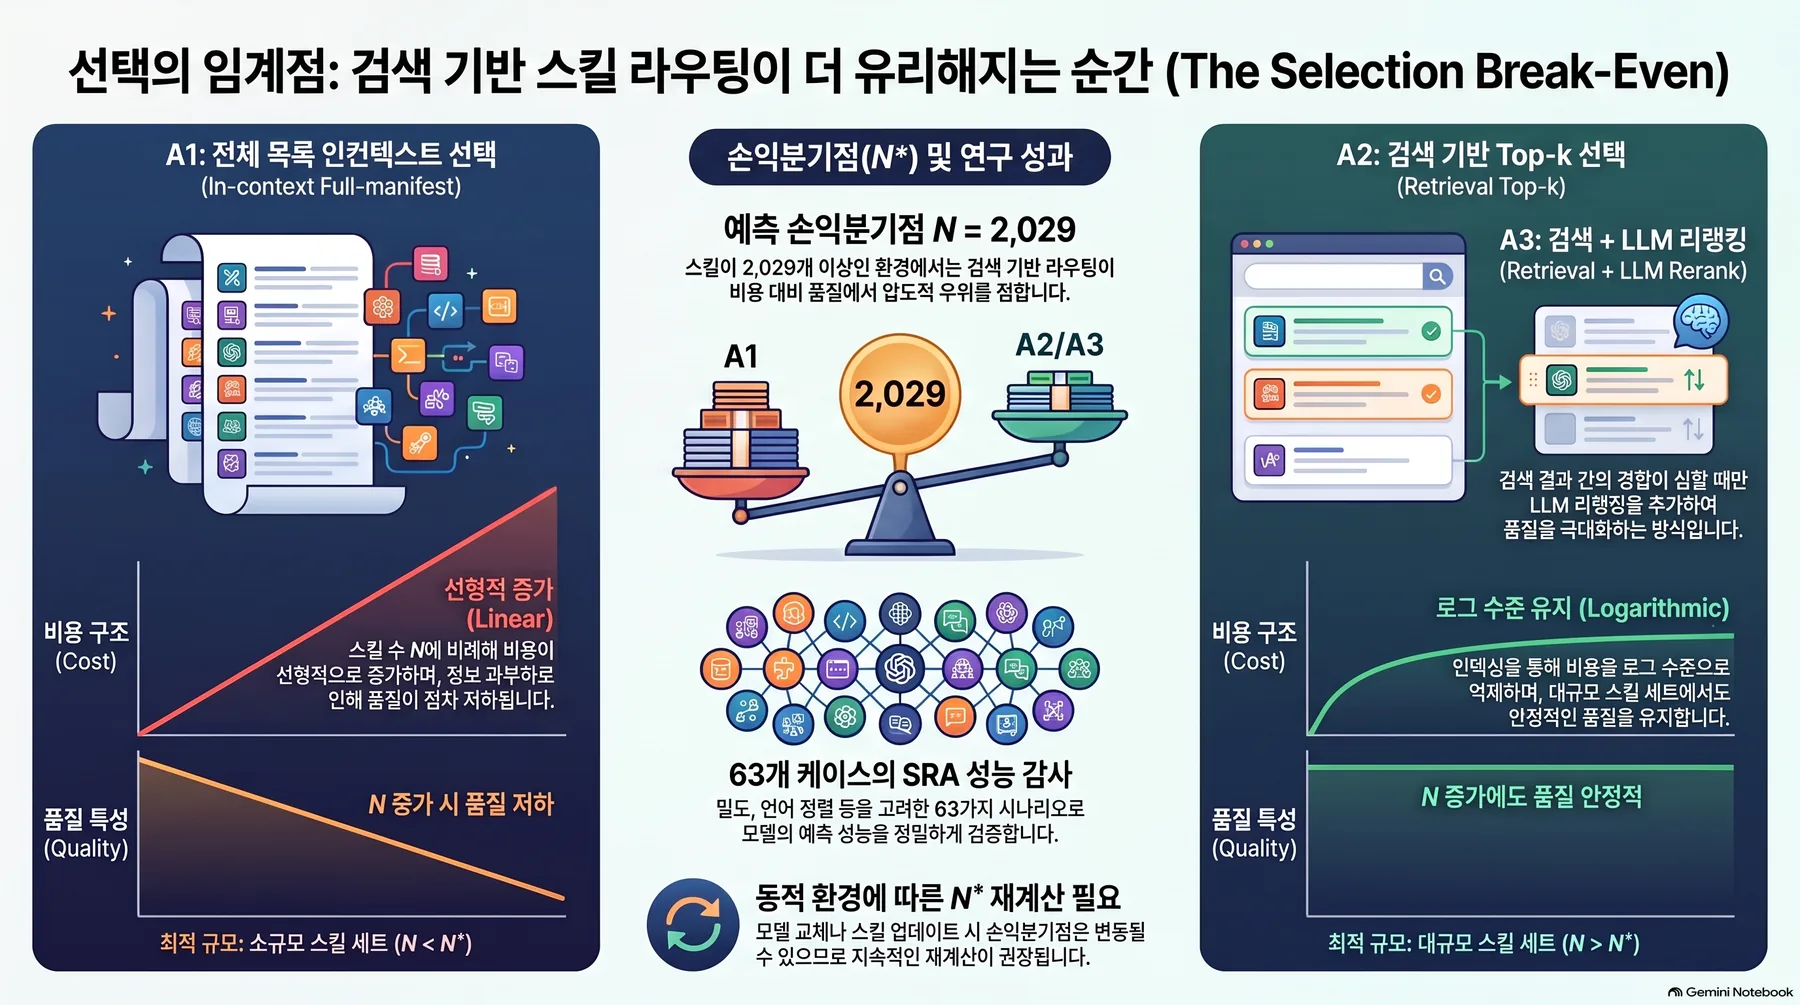
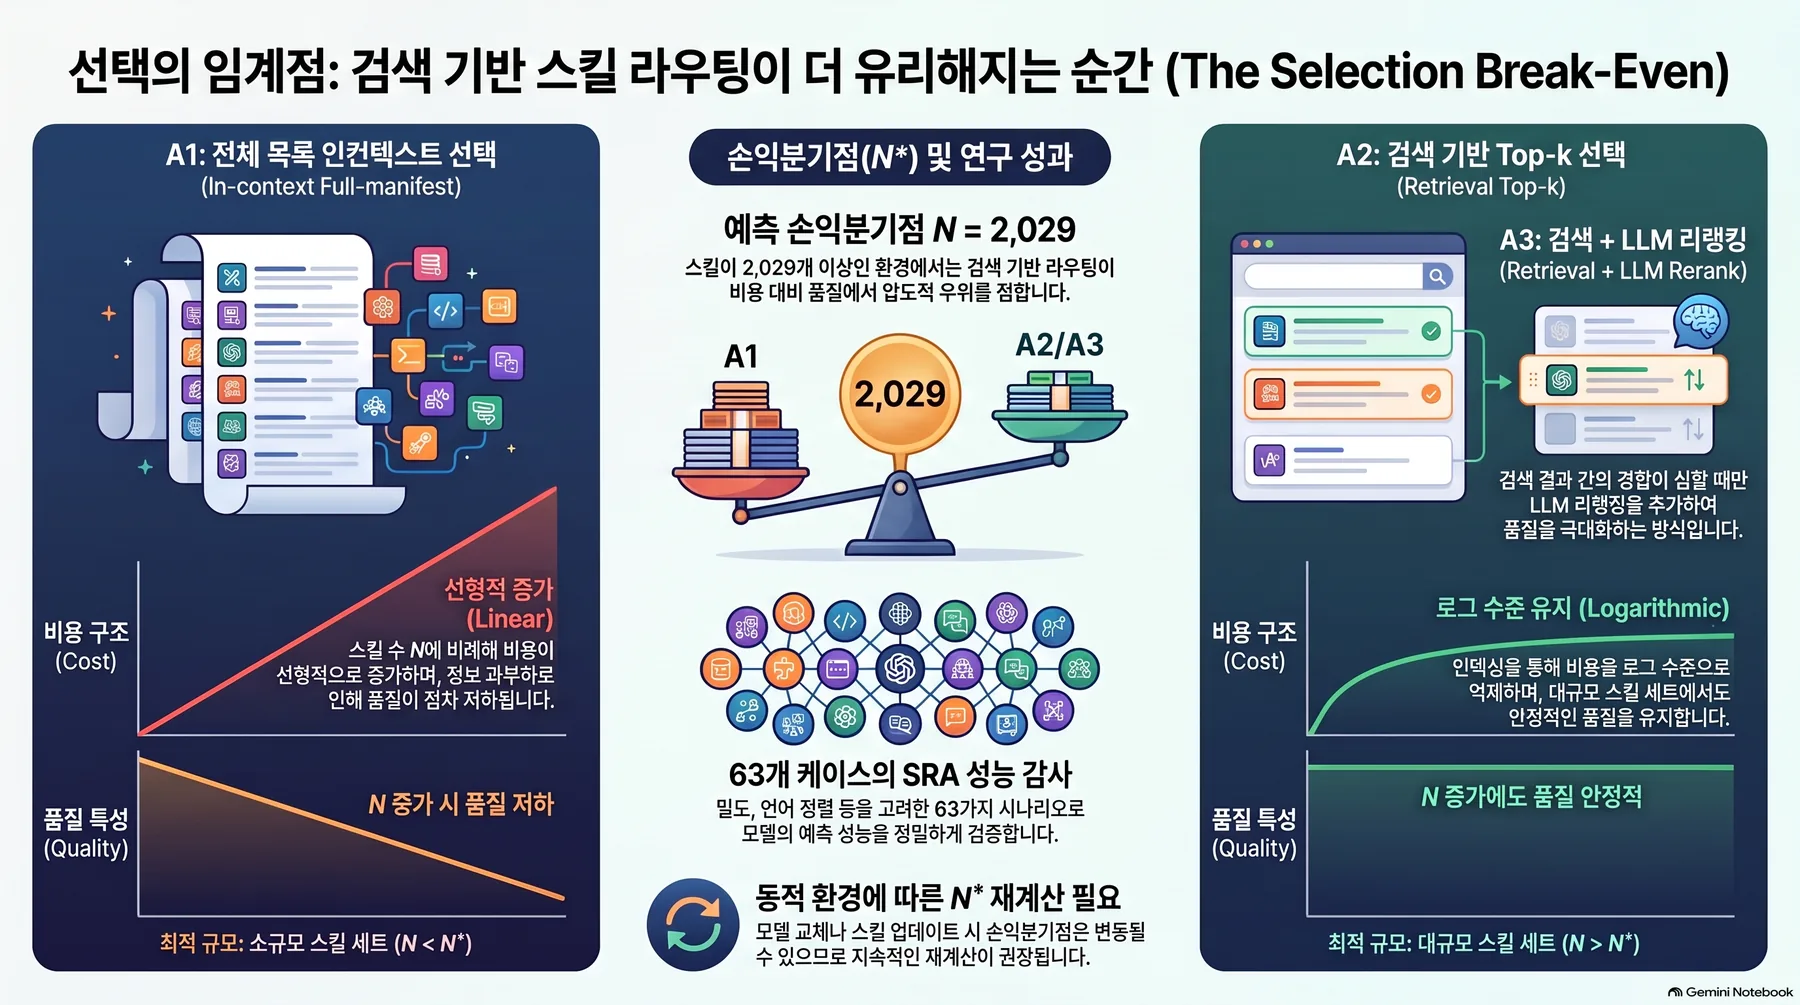 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
세 팔의 비용-품질 모델, 그리고 두 교차점
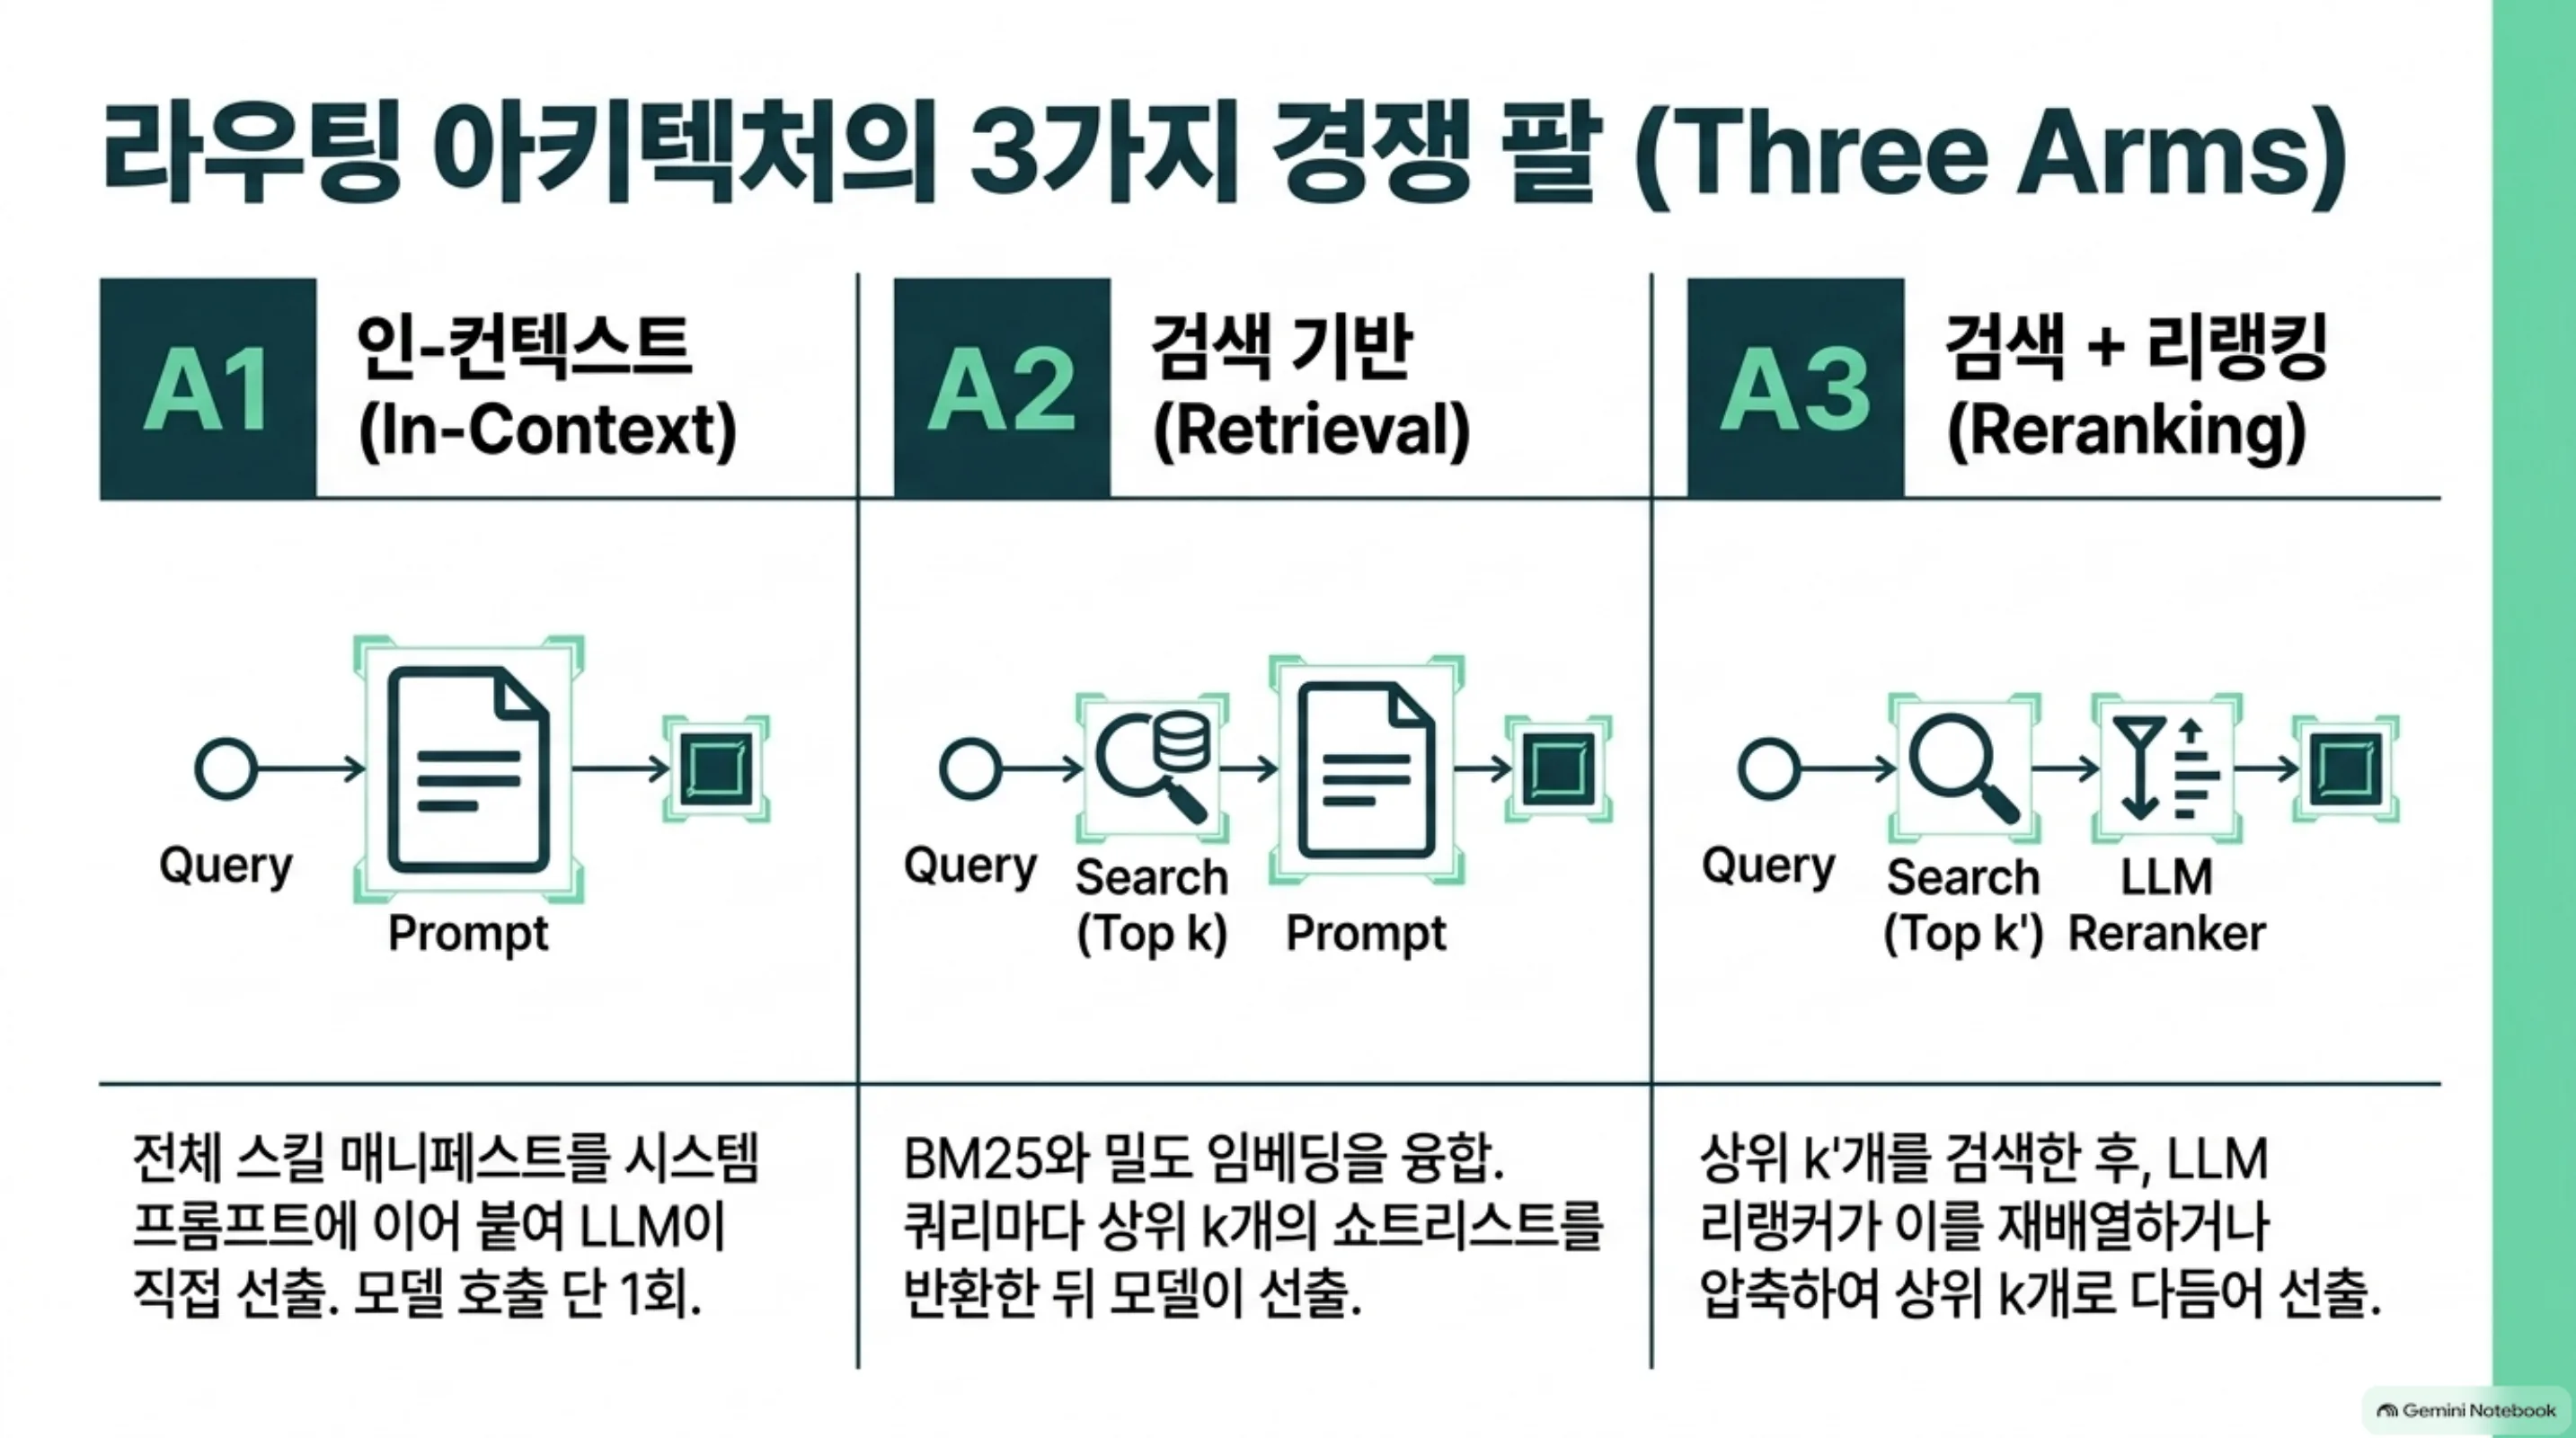
팔을 먼저 정합니다. A1 인-컨텍스트는 매니페스트 M_N을 담은 시스템 프롬프트로 모델 호출 한 번에 끝납니다. A2 검색은 BM25 사전 점수와 밀도 임베딩 유사도를 융합한 리트리버가 쿼리마다 상위 k개 쇼트리스트 S_k(q)를 반환하고 모델은 그 안에서 고릅니다. A3는 리트리버가 상위 k’(k’≥k)개를 반환하면 LLM 리랭커가 이를 재배열하거나 압축해 상위 k개로 다듬고 모델이 고릅니다.
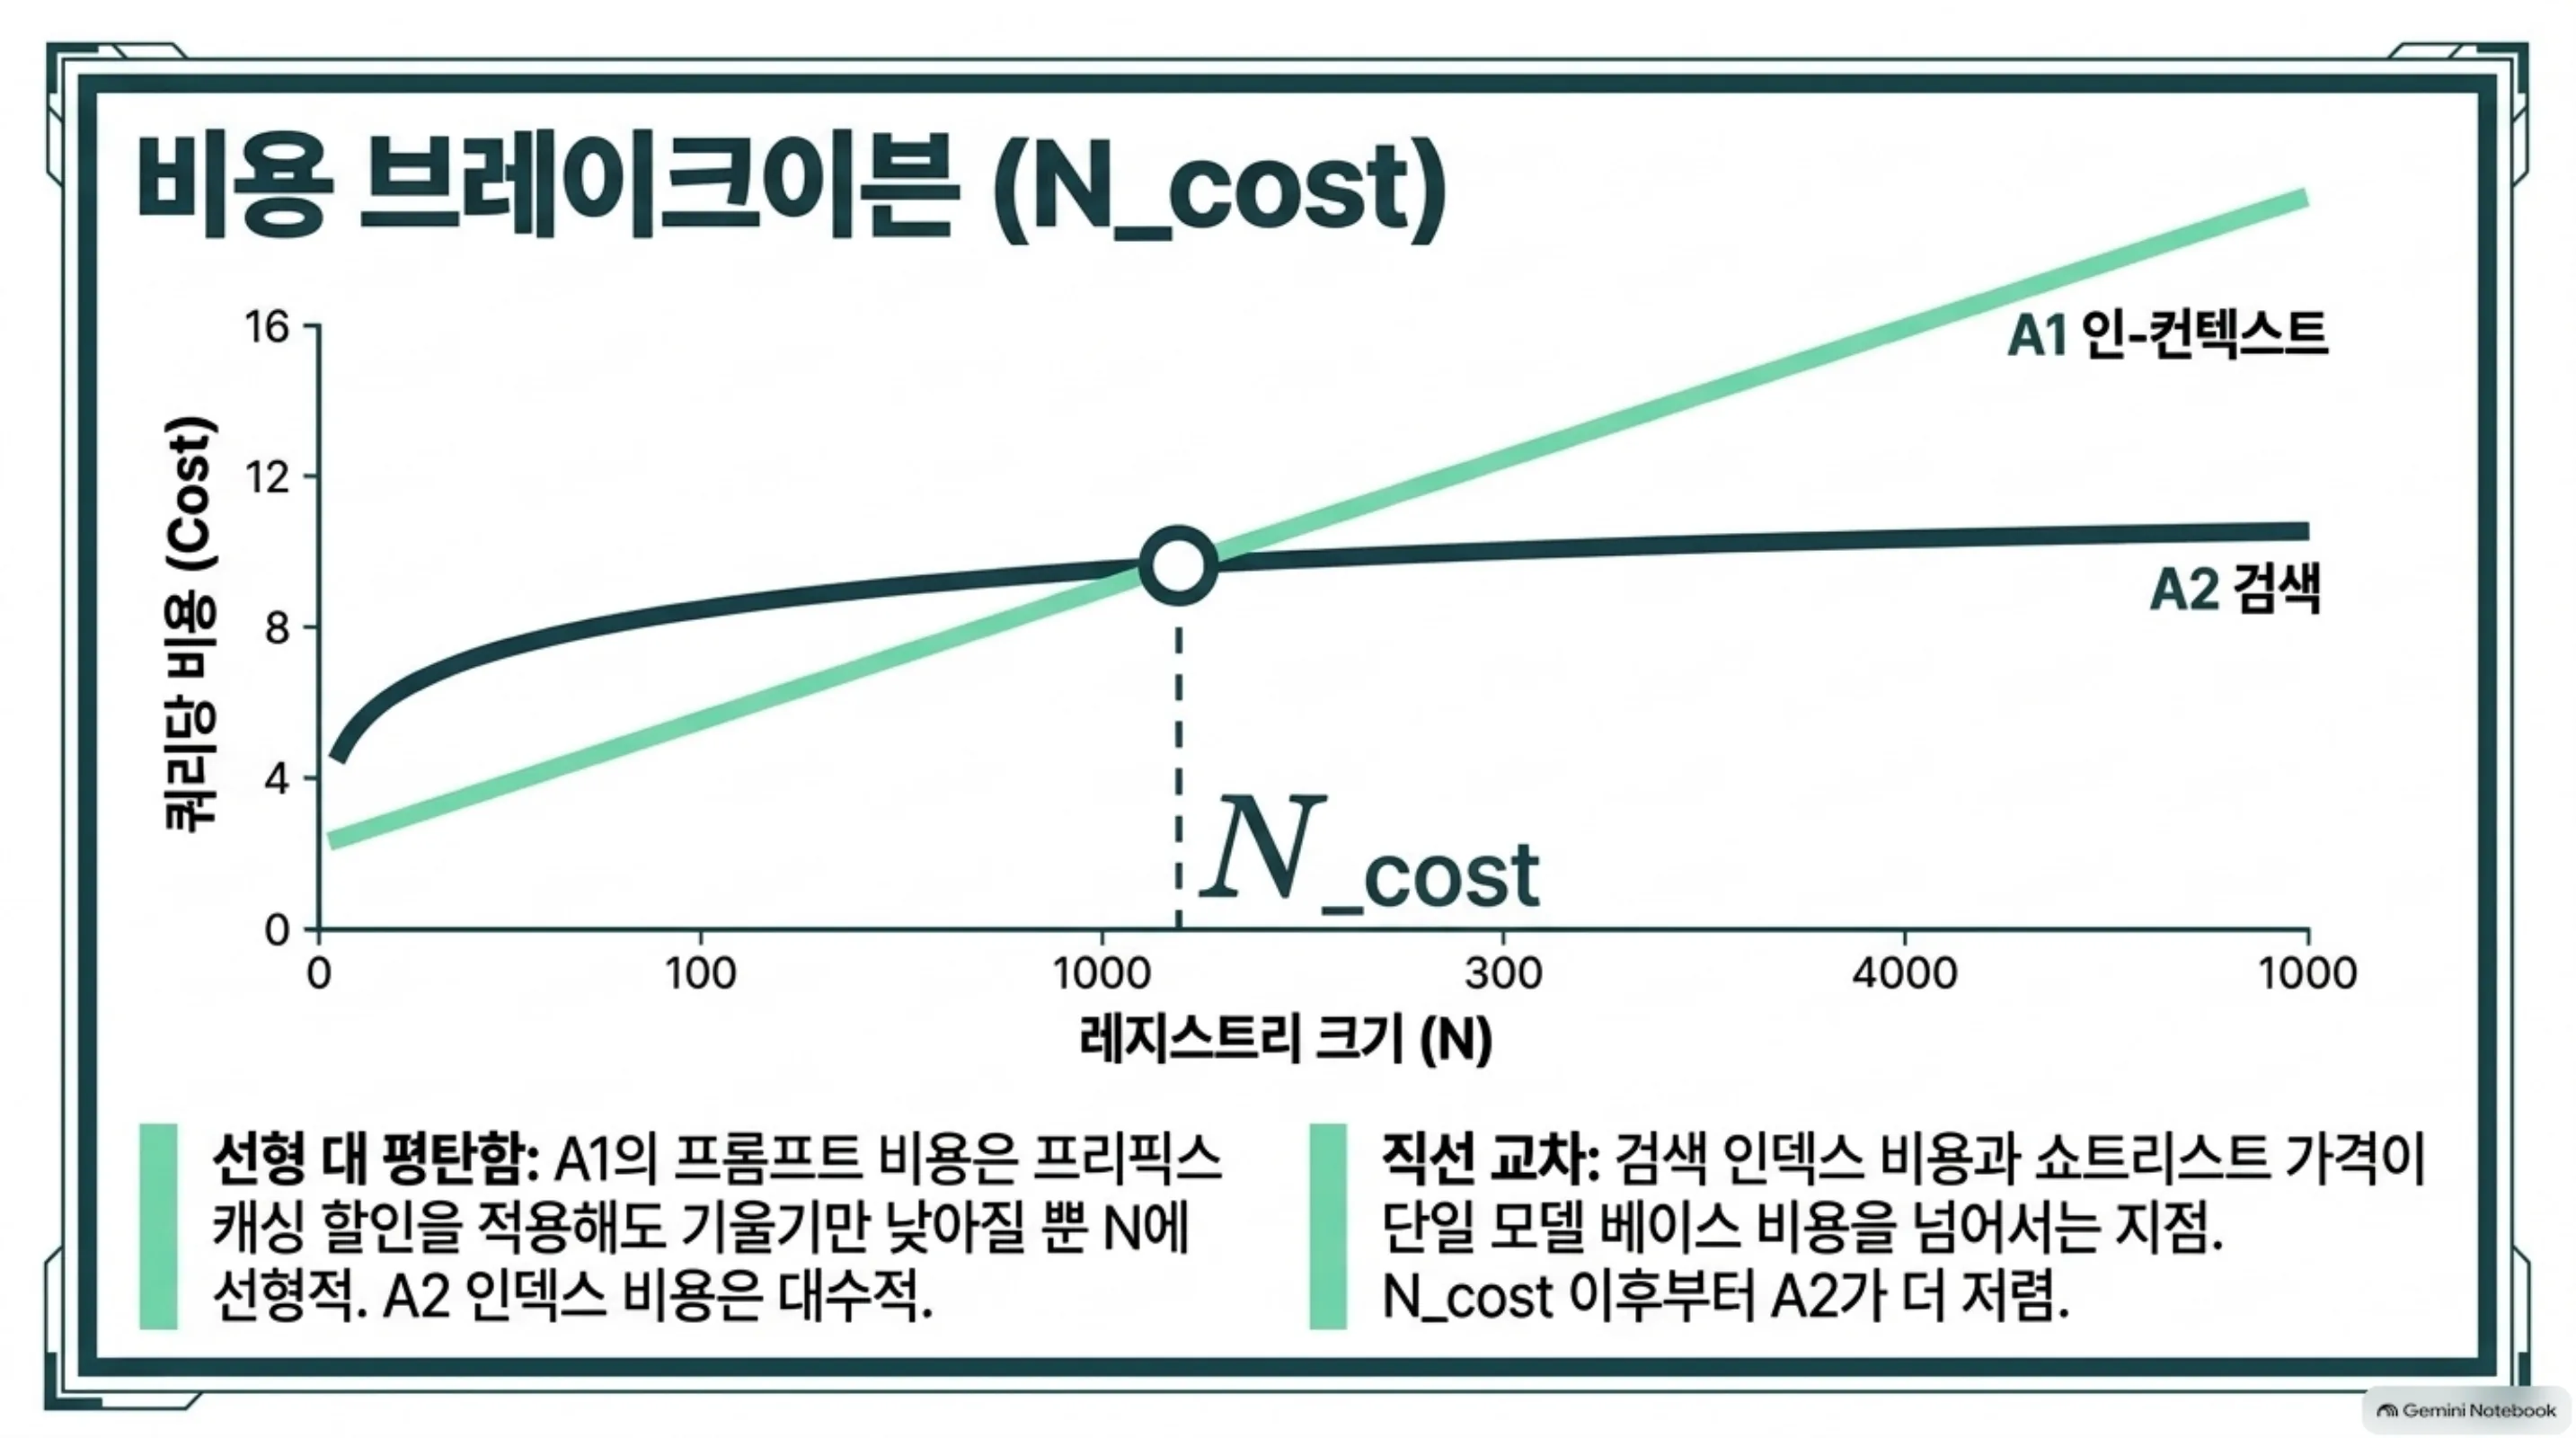
비용 모델은 이 셋을 N의 함수로 씁니다. A1의 쿼리당 비용은 C1(N)=b1+p1·N입니다. b1은 단일 모델 호출의 베이스 비용이고 p1은 스킬 하나당 유효 매니페스트 토큰 가격입니다. 매니페스트는 쿼리 사이에 정적이므로 프리픽스 캐싱 서빙은 캐시된 입력을 할인율 ρ로 깎아 줍니다. p1=(1-ρ)·ℓ·p_in이 됩니다. 캐싱은 선형성을 바꾸지 못하고 기울기만 낮춥니다. A2의 비용은 C2(N,k)=b2+p2·k+r(N)+a(N)입니다. p2·k는 쿼리마다 달라 캐시할 수 없는 쇼트리스트 토큰 가격이고 r(N)은 쿼리 임베딩, 역색인 BM25 스캔, 하이브리드 융합의 쿼리당 검색 비용으로 조율된 인덱스에서 N에 대해 거의 대수적입니다. a(N)은 O(N log N) 인덱스 구축 비용을 리빌드 사이 쿼리 수로 지수화한 값에 스킬 첨가와 삭제, 설명 편집의 유지비 몫을 더한 것입니다. A3는 여기에 리랭커 호출 p3·k’+b3를 더할 뿐입니다. k’로 검색해도 r(N)과 a(N)은 1차 근사에서 그대로입니다.
A2와 A1의 비용 교차는 닫힌 형태로 나옵니다. 가동 레짐에서 A2의 N 의존부가 거의 대수이고 인덱스 비용이 지수화되어 상수로 읽히면, 쇼트리스트 가격과 검색 비용, 지수화 인덱스 비용의 합을 r0로 쓰면 N_cost=(b2+r0-b1)/p1에서 A2가 A1보다 싸집니다. 교차는 직선 교차입니다. 선형인 A1과 거의 평탄한 A2가 N_cost에서 만납니다. p1이 낮을수록, b2와 r0가 클수록 N_cost는 오른쪽으로 밀리고 프리픽스 캐싱 할인율 ρ가 높으면 p1이 낮아져 매니페스트 호출이 더 큰 N까지 경쟁할 수 있습니다. k’는 A3에만 들어가고 A2 대 A1 교차에는 관여하지 않습니다.
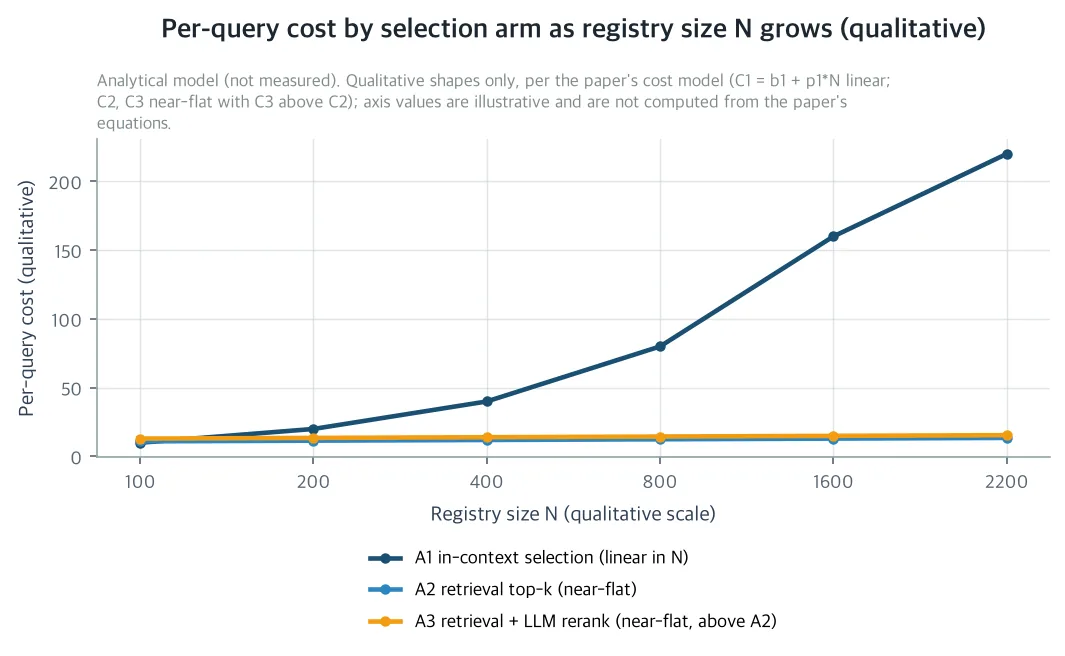 레지스트리 크기 N이 커짐에 따른 팔별 쿼리당 비용. 인-컨텍스트 팔의 비용 C1(N)은 N에 대해 선형이고 검색 팔은 거의 평탄한 채 N_cost에서 선형 매니페스트 호출 곡선을 교차합니다. 해석 모델 곡선이며 실측이 아닙니다.
품질 모델은 각 팔의 오차를 N의 함수로 씁니다. A1의 선출 오차는 세 채널의 합입니다. 읽기 혼란 η_readout, 디스트랙터와 어휘 경쟁 질량 η_distractor, 위치 편향 η_positional입니다. 세 채널 모두 N과 함께 자랍니다. 읽기 혼란의 근거는 선출 실패의 위치를 가리킵니다. 실 도구 선패 실패에서 후보별 어텐션 argmax는 80퍼센트의 비율로 정답 도구에 이미 떨어져 있고 우연은 21퍼센트입니다. 모델은 보고도 고르지 못합니다. 프롬프트 쪽 수리, 정답 도구 순서 바꾸기나 복제는 그런 실패의 23퍼센트를 회복하는 데 그치고 읽기 쪽 개입은 59에서 91퍼센트를 회복합니다. 실패를 가시성 탓으로 돌리면 틀린 셈입니다. 병목은 결정 읽기에 있습니다. 디스트랙터 질량은 레지스트리의 근접 복제 밀도와 함께 자랍니다. 스킬 설명을 전부 프롬프트에 노출한다고 도움이 되는 것은 아닙니다. 부분 노출은 유사한 설명 사이의 어휘 경쟁을 만들어 정답 선출을 눌러 앉히는 효과가 있습니다. 라이브러리 규모가 수백에서 수만으로 커지면 추가 후보마다 새 디스트랙터가 붙어 신뢰성이 무너진다는 실측도 있습니다. 위치 편향은 두 가지 길이 효과의 합입니다. 롱컨텍스트 사용은 위치에 대해 U자형이고 같은 태스크라도 입력 길이가 길어지면 추론 성능이 떨어집니다. 긴 매니페스트 깊은 곳에 묻힌 설명은 위치도 불리하고 추론도 불리합니다.
A2의 품질은 두 인자의 곱입니다. Q2(N,k)=R@k(N)·S(k). S(k)는 정답이 k개 목록 안에 있을 때 고를 확률, 쇼트리스트 선출 신뢰도입니다. k가 작으면 거의 포화인 셈입니다. 소규모 풀에서 어텐션이 이미 정답을 국지화한다는 근거와 일치합니다. R@k(N)은 전체 레지스트리 리콜이고 상한은 알고리즘이 아니라 레지스트리 자체의 디스크리밍 한계 B(N)입니다. 한 한계는 언어 간 격차입니다. 1,600여 스킬에 한국어-영어 혼합 쿼리를 얹은 ThakiCloud의 이전 생산 하네스에서는 완전한 수작업 분해 ORACLE조차 63.6퍼센트 스텝커버리지에 머물렀습니다. 리트리버의 언어 간 어휘 다리가 리콜을 함께 묶는 것이 그 상한이기 때문입니다. 이 수치는 그 하네스의 실측이며 이 논문은 N=2,029로 이관하는 작동 가정을 씁니다. SRA 프로토콜은 정확히 그 전제를 시험합니다. 두 번째 한계는 기능적 중복입니다. 근접 복제 스킬은 어떤 단일 정답 표현도 달성할 수 없는 리콜을 만듭니다.
A3의 이득은 근접 타이에서만 납니다. 리랭커가 사는 정밀도는 R@k’(N)·S(k)에 Δ_rerank를 더한 값이고 Δ_rerank ≤ Δ_tie·τ(k’)으로 상한이 잡힙니다. Δ_tie는 정답과 현재 1위가 모두 타이 밴드에 있을 때의 쿼리당 최대 품질 상승이고 τ(k’)은 상위 k’ 목록 안에서 정답과 1위가 둘 다 타이 밴드에 있을 기대 확률입니다. 리트리버 점수가 클리프나 의미 경계에서 깨끗이 갈라지면 순서는 이미 맞아서 그 지점의 동적 top-K가 더 적은 토큰으로 대부분 정밀도를 잡습니다. 잔존 가치는 기본 리트리버가 타이 밴드에 남긴 질량뿐입니다. 그 대가는 측정 가능합니다. LLM 리랭커는 쿼리 1,000개당 대략 0.2에서 0.3달러, 테일 지연 대략 1초를 더합니다. 학습된 쿼리별 컨트롤러는 51퍼센트의 리랭킹 호출을 생략하고 그 대가로 헬드아웃 커버리지 1.2포인트를 내며 생략이 해로울 쿼리는 명시적으로 회계합니다.
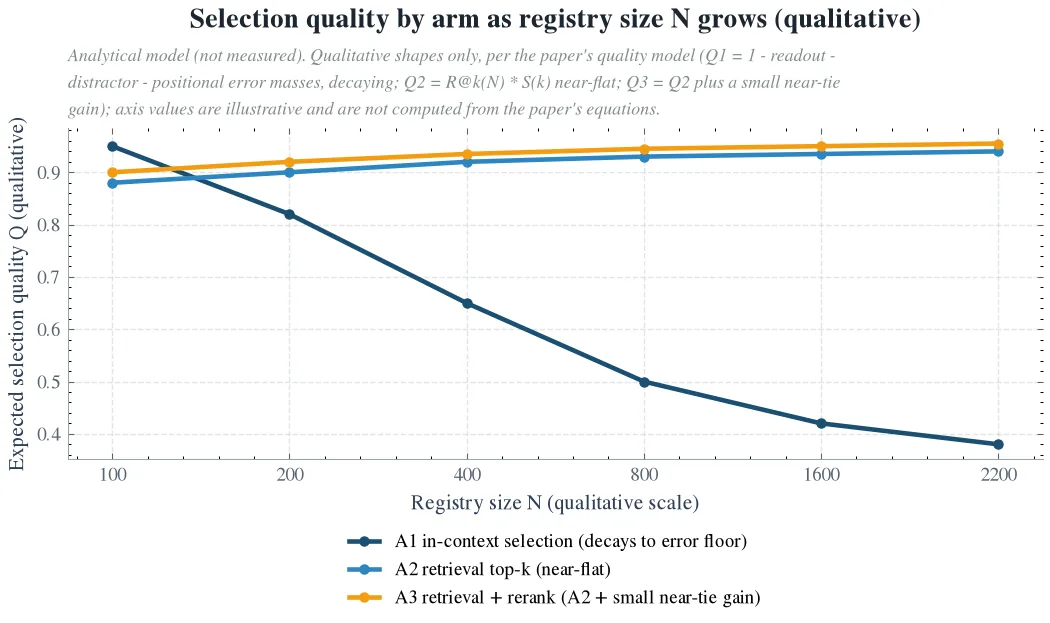 레지스트리 크기 N이 커짐에 따른 팔별 선출 품질. 인-컨텍스트 품질 Q1(N)은 양의 오차 바닥으로 하락하고 검색 품질 Q2(N)은 거의 평탄해서 한 번 N_qual에서 교차한 뒤 검색 팔이 우세합니다. 해석 모델 곡선이며 실측이 아닙니다.
품질 교차도 유일하게 나옵니다. Q1(N)이 N에 대해 비증가이고 양의 오차 바닥이 있으며 두 팔의 오차 격차 e2(N)-e1(N)이 N에 대해 비감소이고 작은 N0에서 A1가 앞서는 데 구간 끝에서 오차 바닥이 검색 오차를 넘으면, Q2가 Q1를 넘는 유일한 N_qual이 존재합니다. N_qual 미만에서는 작은 매니페스트가 거의 자명하게 선출되므로 A1가 우세하고 그 이상에서는 검색 팔이 우세합니다.
브레이크이븐 N*와 배포 규칙
두 교차점을 합치면 브레이크이븐 N가 나옵니다. δ(N)=μ·(Q2-Q1)(N)-(C2-C1)(N)이고 N는 δ(N)이 0을 넘는 가장 작은 N입니다. 여기서 μ는 오루트 페널티로, 오루트 한 번의 downstream 기대 품질 하락과 실행 비용의 곱으로 매겨집니다. 오루트는 그 즉시 비용을 실행이 만들어야 할 가치만큼 곱해서 씁니다. N이 N_cost와 N_qual 모두를 넘으면 δ의 두 항이 동시에 플러스이고 둘 미만이면 둘 다 마이너스입니다. 관련 함수가 그 사이에서 단조이면 N는 min(N_cost, N_qual)과 max(N_cost, N_qual) 사이의 윈도우 안에 있고 N를 찾는 일은 레지스트리 크기의 1차원 스윕으로 떨어집니다. μ가 매우 작아 μ(Q2-Q1)이 C2-C1을 고려 구간에서 건드리지 못하면 N*는 그 구간에 존재하지 않고 매니페스트 호출이 끝까지 순이익 선택입니다.
N이 N_qual을 넘으면 δ는 μ에 대해 증가합니다. μ가 클수록 N*가 내려가는 셈입니다. 높은 이해관계의 라우팅은 인덱스를 더 일찍 사게 되어 있습니다. 브레이크이븐은 레지스트리의 속성일 뿐 아니라, 그 레지스트리가 짊어지는 이해관계의 속성입니다.
리랭킹에는 잔여-k 규칙이 붙습니다. A3가 A2를 이기는 것은 그 순이익 δ_r이 플러스일 때이고 리랭 이득에 상한 Δ_tie·τ(k’)이 걸려 있으니 호출이 자기값보다 먼저 되려면 τ(k’)·Δ_tie·μ > p3·k’+b3+λ가 필요합니다. λ는 리랭커 테일 지연의 가격입니다. 생산 LLM 리랭커의 테일 지연은 대략 1초입니다. 부등식이 역으로 성립하면 호출을 생략해도 되는 충분 조건입니다. 실무 프록시는 두 개입니다. 하나는 리트리버 점수 클리프와 의미 경계를 모니터링해 타이 질량이 낮은 곳에서 호출을 생략하는 것입니다. 다른 하나는 기대 이득이 마이너스인 쿼리에서 호출을 빼는 쿼리별 제어입니다. 후자의 한 생산 설정에서 51퍼센트의 리랭 호출이 1.2포인트 헬드아웃 커버리지 대가로 생략됩니다.
이를 배포 규칙으로 압축하면 네 줄입니다. N ≤ N이면 인덱스를 만들지 말고 전체 매니페스트에 단일 LLM 호출로 라우팅합니다. N > N이면 인덱스를 만들고 상위 k개를 검색한 뒤 선출하는 2단 라우팅을 씁니다. LLM 리랭킹은 상위 목록의 잔존 중복이 잔여-k 임계값을 넘는 경우에만, 쿼리별 점수 클리프 모니터링으로 켭니다. 그리고 N*는 레지스트리가 10배씩 커질 때마다, 모델이 바뀔 때마다 다시 계산해야 합니다. p1, p2, η 항은 모델과 서빙에 의존합니다.
2,029 스킬 레지스트리에 대입하면 예측이 나옵니다. 하이브리드 BM25+밀도 라우터, H200 셀프호스티드 양자화 서빙으로 모든 팔이 동일한 모델을 공유합니다. 설명 하나당 40에서 120 토큰이면 2,029개 매니페스트는 호출당 대략 80k에서 250k 입력 토큰이 됩니다. 입력 길이 성능 저하와 U자형 위치 활용, 읽기 혼란의 근거가 신뢰할 수 없는 직접 선출을 예측하는 레짐입니다. 검색 팔의 리콜은 이전 하네스의 63.6퍼센트 ORACLE 스텝커버리지를 이관한 상한에 묶입니다. 모델은 이 크기에서 2단 팔 A2가 A1를 지배한다고 예측하고 그 마진은 μ와 함께 자라며 리랭킹 가치는 근접 복제가 빽빽한 레지스트리 구간, 타이 질량이 큰 구간에 집중합니다. 이 모든 것은 모델 예측이며 이 논문의 실측이 아닙니다. SRA 프로토콜이 확인하거나 뒤집는 대상입니다.
63건 SRA 감사와 사전 등록 반증
예측을 실측으로 넘기는 설계가 SRA, Selection-Retrieval Audit입니다. 63건 분층 감사입니다. 이 논문은 프로토콜 규격만 제시하며 실측을 보고하지 않습니다.
63건은 근접 복제 밀도 3층, 낮음/중간/높음, 각 21건으로 나뉘고 η_distractor와 리랭 타이 질량 항을 집중적으로 시험합니다. 층 안에서는 12건이 단일 스킬 골드, 9건이 구성형 골드 멀티 스킬 태스크입니다. 후자는 F1 채점으로, 다양성 인지 리랭킹의 세트 선출 행동을 시험합니다. 14건은 언어 간 케이스로 영어 레지스트리 대비 한국어 쿼리 7건, 한국어 주석 구간 대비 영어 쿼리 7건입니다. 나머지 7건은 단어입니다. 모든 건에 밀도, 골드 유형, 언어 정렬 라벨이 붙습니다.
세 팔은 모두 H200 셀프호스티드 양자화 서빙의 동일한 모델로 63건 전체를 돌립니다. 매니페스트 프리픽스는 캐시 가능하므로 캐시/미캐시 토큰을 팔별로 기록하고 p1은 실측 캐시 할인율 ρ로 C1, C2, C3 공식을 그대로 써서 쿼리당 비용을 계산합니다. 건별 (C_a, Q_a) 점을 건으로 집계해 팔별 프런티어를 추정하고 신뢰 구간은 층 부트스트랩으로 얻습니다.
분석적 주장 세 개는 한 모델에 한 개씩 사전 등록 반증 예측으로 묶였습니다. 첫째는 중심 예측 P1입니다. N=2,029에서 A2가 A1를 지배한다는 예측은 실측 브레이크이븐이 N* > 2,029, 동등하게 δ(2,029) ≤ 0이면 뒤집힙니다. 둘째는 품질 순서 P2입니다. Q1(2,029) < Q2(2,029) 예측은 실측 Q̂1 ≥ Q̂2이고 실측 R@k가 모델이 내는 디스크리밍 상한을 넘어 순서가 리콜로 설명되지 않으면 η 바닥이 틀렸다고 판정합니다. 셋째는 비용 교차 P3입니다. 선형 비용 모델은 실측 A1/A2 비용 교차가 명시한 대수 섭동을 넘어서 N에 대해 비선형이면 뒤집힙니다. 실측 캐시 할인율에서도 매니페스트 호출 비용이 N에 대해 비선형인 경우입니다.
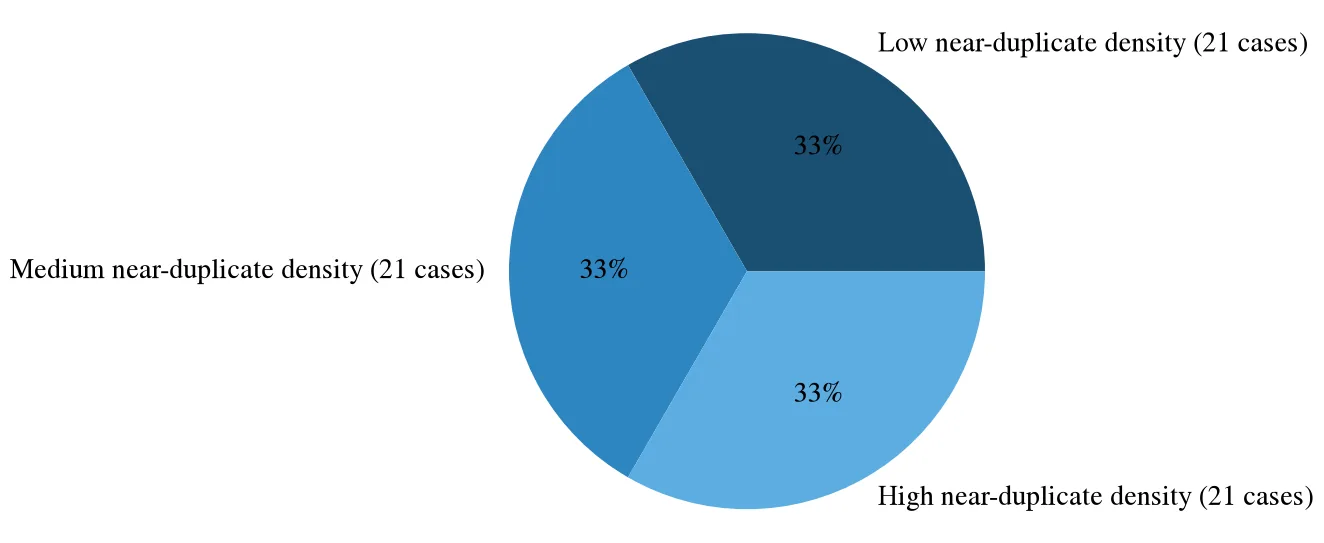 63건 Selection-Retrieval 감사의 근접 복제 밀도 층별 건 수 배분. 3층(낮음/중간/높음) 각 21건이 디스트랙터 질량과 리랭 타이 질량 항을 시험하는 설계입니다. 해석 모델의 설계 다이어그램이며 실측이 아닙니다.
회사와 사회, 과학에 남는 것
ThakiCloud에게는 이 규칙이 바로 배포 기준이 됩니다. 2,029 스킬 레지스트리는 2단 라우팅 구간으로 예상되며 마진은 오루트 페널티와 함께 자라고 리랭킹은 잔여-k 조건에서만 켭니다. 토큰 팩토리 라우터 구성의 의사결정 규칙은 한 줄로 압축됩니다. N* 이하면 단일 LLM 호출, N* 이상이면 2단 라우팅, 리랭킹은 타이 질량이 임계값을 넘을 때만입니다.
사회적으로는 작은 조직의 에이전트 스킬 생태계 장벽을 낮춥니다. 이 규칙은 음의 정보입니다. N*를 넘을 때까지 인덱스와 검색 스택과 리랭커를 만들 필요는 없습니다. 그 아래에서는 단일 LLM 호출이 순이익 아키텍처이고 스킬 라우팅은 시스템 공학 문제가 아니라 프롬프트 설계 문제입니다. 레지스트리가 그 임계값을 넘는 순간까지, 이 분석이 그 임계값 자체를 줍니다.
과학적으로는 고정 규모의 도구/스킬 검색 평가 패러다임을 한 단계 올립니다. 단일 동결 크기에서 잰 검색 품질은 인덱스를 지을 가치가 있었는지를 말해 주지 못합니다. 브레이크이븐은 정확히 그것을 말하는 양입니다. 이 논문은 N을 스윕하고 인-컨텍스트 선출과 검색, 검색+리랭킹의 통제된 헤드투헤드와 N* 곡선을 같은 비용-품질 프런티어 위에 세웁니다.
믿지 말아야 할 부분
이 논문은 분석적이며, 실측을 하나도 보고하지 않습니다. 모든 수치는 명시된 파라미터에서 유도한 값입니다.
첫째, N는 파라미터 민감합니다. p1, ρ, η 기울기에 불확실성이 있으면 N는 점으로 읽을 수 없습니다. 구간으로 읽어야 합니다. 배포 규칙은 그 구간의 보수 끝에서 읽어야 합니다. 둘째, 대입은 단일 하네스입니다. 레지스트리 하나, 서빙 스택 하나이며 다른 하네스로 옮기려면 모델과 서빙에 의존하는 항을 다시 추정해야 하고 이관된 언어 간 상한도 포함됩니다. 셋째, 레지스트리는 움직입니다. 스킬 설명의 staleness와 churn이 r(N)과 a(N), 디스크리밍 한계를 움직이므로 N*는 표류합니다. 재계산 트리거는 주석으로 밀어둘 수 없는 설계의 일부입니다.
논문 상세 페이지는 여기에서 볼 수 있습니다: The Selection Break-Even: Measuring the Registry Size at Which Retrieval-Based Skill Routing Beats Direct In-Context LLM Selection on the Cost-Quality Frontier
이 글의 그림 세 장은 모두 해석 모델 곡선과 분층 설계 다이어그램이며 실측을 담지 않습니다. 본문에 인용된 63.6퍼센트 ORACLE 스텝커버리지는 이전 생산 하네스(1,600여 스킬)의 실측 값이며 2,029 스킬에서 잴 실측이 아니라 작동 가정에 기반한 이관입니다.
 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.