Jev가 사내 규정집을 만나면: 기업 정책 결정 모델 27B 공개
사내 규정에 따라 행동을 고르는 자리를 만들고 계신다면 결론을 먼저 드립니다. 그 결정을 문장으로 만들어 낼 필요는 없습니다. 다만 규정집이 바뀌는 자리에서는 모델이 생각할 시간을 빼앗으면 안 됩니다.
이 두 가지는 보통 한 덩어리로 취급됩니다. 비용을 줄일 때 같이 끄고, 품질이 떨어지면 그때 떠오른 쪽을 범인으로 지목합니다. 저희는 둘을 따로 떼서 재 봤고, 결과는 서로 반대 방향이었습니다. 익숙한 규정에서는 문장을 만들어 내는 과정이 값만 치르고 얻는 것이 없었습니다. 처음 보는 규정에서는 생각이 성적의 거의 전부를 갈랐습니다.
다키클라우드는 그 측정에 쓴 사내 규정 결정 모델 27B와 채점용 문제집을 함께 공개했습니다. 모델은 Qwen3.8-27B-Human-KO-Enterprise 계열입니다.
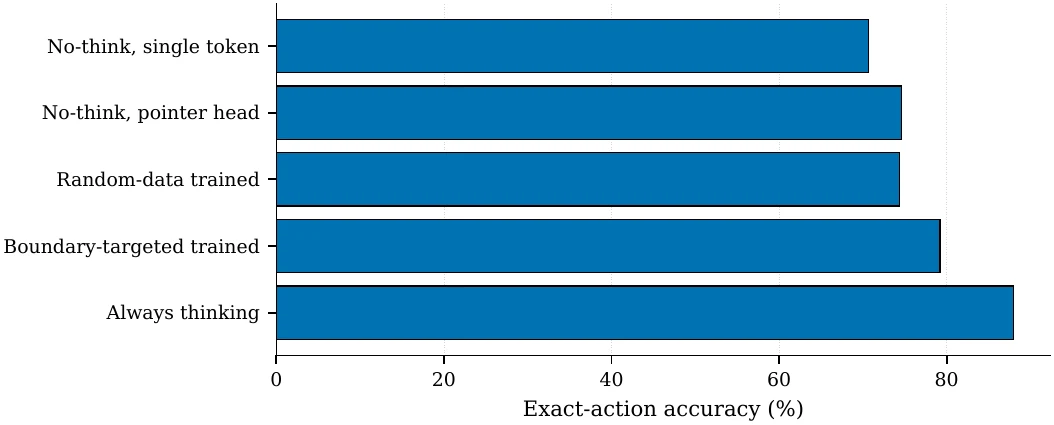 같은 모델을 설정만 바꿔 가며 새 규정 위에서 재 봤습니다. 맨 아래 칸만 생각을 켠 설정입니다.
왜 읽어야 하나
지난 글에서 타입드 질문에 생성 없이 확률로 답하는 계통을 다뤘습니다. Jev와 그 오픈웨이트판인 Lev가 그 계통이고, 핵심은 출력 토큰을 0으로 만들어 결정을 빠르고 다루기 쉽게 바꾸는 것이었습니다.
저희가 궁금했던 것은 그 다음입니다. 티켓을 에스컬레이션할지 묻는 예/아니오 질문과, 사내 규정집 한 권을 던져 주고 일곱 가지 행동 중 하나를 고르게 하는 일은 같은 종류일까요. 같은 방식이 그대로 통할까요.
재 보니 절반만 통했습니다. 생성을 버리는 부분은 그대로 통했고, 오히려 기대보다 좋았습니다. 하지만 처음 보는 규정집 앞에서는 생성이 아니라 생각이 변수였습니다. 그래서 이 글은 모델 소개이면서, System One 방식이 어디까지 가고 어디서 멈추는지에 대한 측정 보고이기도 합니다.
쉽게 말하면
은행 창구 직원으로 바꿔 보겠습니다. 오래 일한 직원은 규정집을 외우고 있어서, 손님 말이 끝나기 전에 처리 방향이 정해집니다. 잔액을 바로 알려 줄지, 본인 확인을 더 받을지, 상급자에게 넘길지가 몸에 뱄습니다.
같은 직원을 처음 보는 규정집이 있는 지점으로 보내면 이야기가 달라집니다. 외운 것이 없으니 읽고 따져 봐야 합니다. 능력이 줄어든 게 아니라 상황이 바뀐 것입니다.
모델도 똑같았습니다. 그리고 기업 도입에서 중요한 질문은 “우리 모델이 똑똑한가”가 아니라 “지금 이 자리가 외운 규정집인가, 처음 보는 규정집인가”입니다.
이 모델이 하는 일
모델은 사내 규정 문서, 호출 가능한 도구 목록, 지금까지 확인된 사실, 그리고 사용자 발화를 받습니다. 그리고 일곱 가지 중 하나를 고릅니다.
| 행동 | 언제 고르나 |
|---|---|
| 규정대로 답하기 | 문서만으로 답이 나오는 경우 |
| 되묻기 | 꼭 필요한 사실이 빠졌고 사용자가 줄 수 있는 경우 |
| 확인받기 | 부작용이 있어 사용자 동의가 필요한 경우 |
| 도구 한 번 쓰기 | 실시간 상태를 봐야 하는 경우 |
| 도구 여러 번 쓰기 | 두 개 이상의 조회가 필요한 경우 |
| 사람에게 넘기기 | 사람 검토가 규정상 요구되는 경우 |
| 거절하기 | 규정이 금지한 경우 |
말을 하기 전에 이 선택이 먼저 끝나야 합니다. 여기서 틀리면 그 뒤의 문장이 유창할수록 더 위험합니다.
읽어 내는 방식은 세 가지를 다 재 봤습니다. 작은 문서를 생성해 내는 방식, 일곱 개로 제한된 어휘에서 글자 하나만 읽는 방식, 그리고 Jev·Lev와 같은 모양인 포인터 헤드입니다.
생성은 버려도 됩니다
익숙한 규정 2,800문항에서 두 방식의 정확도는 사실상 같았습니다. 문서 생성이 93.5%, 1토큰이 94.1%입니다.
차이는 다른 데서 났습니다. 서버를 재시작하고 같은 문항을 다시 물으면 문서 생성 쪽은 100건 중 3건꼴로 결정이 바뀌었고, 1토큰 쪽은 1000건 중 3건꼴이었습니다. 응답 지연도 거의 사라집니다.
운영 입장에서 이 숫자가 뜻하는 바는 분명합니다. 같은 티켓을 어제와 오늘 다르게 처리하는 일이 열 배 가까이 줄어듭니다. 감사 로그를 받는 쪽에서는 이게 정확도보다 중요한 경우가 많습니다.
그런데 추론은 못 버립니다
새 규정집 300문항을 따로 만들어 봉인했습니다. 이 문제집의 정답은 사람이 쓴 게 아니라 숨은 규정을 프로그램이 돌려 계산한 것입니다. 왜 그렇게 만들었는지는 논문 소개 글에 적었습니다.
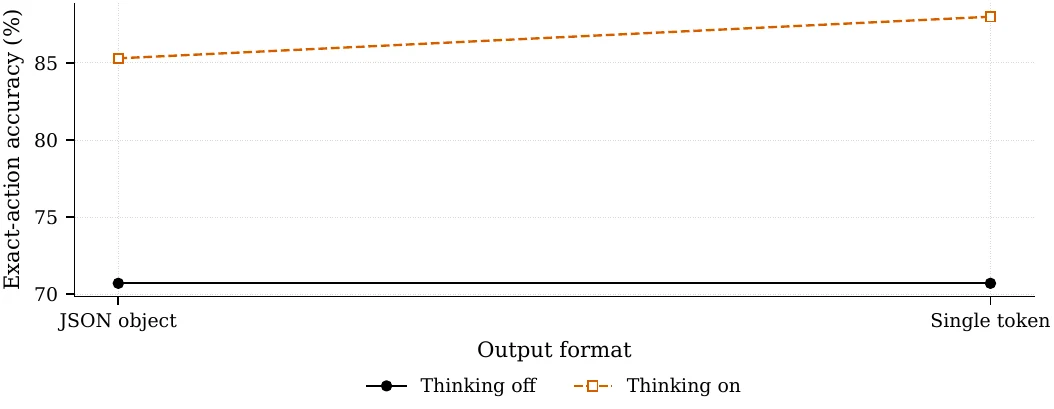 위아래 간격이 생각의 효과이고, 좌우 기울기가 출력 방식의 효과입니다.
여기서 생각을 켜면 70.7%에서 88.0%로 올랐습니다. 반대로 출력 방식을 바꾼 효과는 0.0%p였습니다. 처음 보는 규정 앞에서 결정을 좌우한 것은 전부 생각이었습니다.
한 가지 더 말씀드릴 것이 있습니다. 포인터 헤드는 정확도는 옮겨 오지만 보정을 잃습니다. 저희 측정에서 확신도의 신뢰성이 1토큰 방식보다 세 배 나빴습니다. System One 계통의 매력이 “교정된 확률”이라는 점을 생각하면 이건 그냥 넘길 수치가 아닙니다. 확률을 그대로 임계값에 쓰시려면 본인 데이터로 다시 보정하셔야 합니다.
가르치면 나아집니다, 가르친 데까지만
생각이 필요한 이유가 두 가지로 갈립니다. 정말 따져 보는 과정이 필요해서일 수도 있고, 단지 그 경계를 배운 적이 없어서일 수도 있습니다.
그래서 경계만 집어서 가르친 모델과, 같은 분량의 평범한 데이터를 준 모델을 비교했습니다. 비교 기준은 결과를 보기 전에 적어 두고 봉인했습니다.
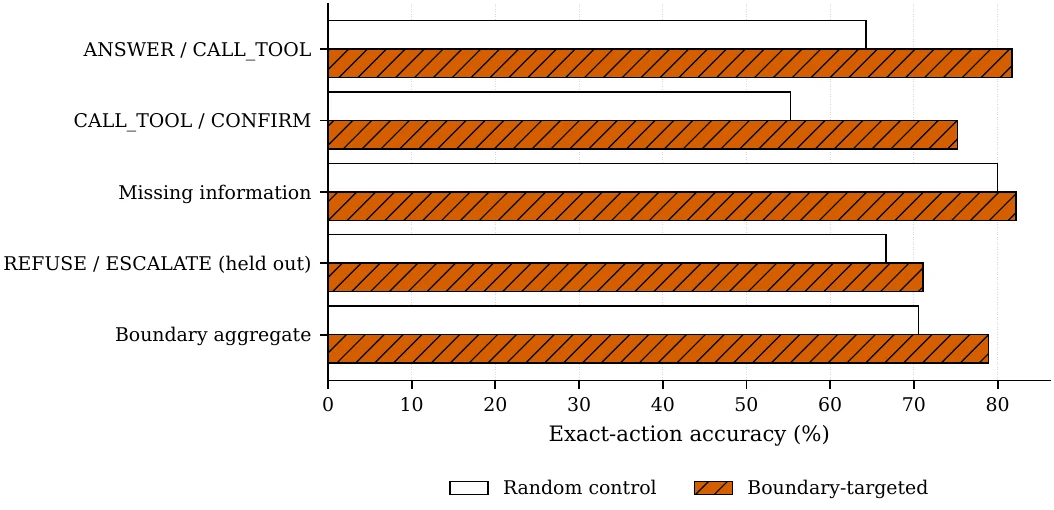 가르친 경계 둘은 벌어지고, 손대지 않은 맨 아래 경계는 붙어 있습니다.
가르친 경계는 확실히 올랐습니다. 답할지 도구를 쓸지 가르는 자리에서 17.5%p, 도구를 쓸지 확인받을지 가르는 자리에서 20.0%p입니다. 도구를 써야 하는데 놓치는 비율은 24.8% 줄었습니다.
반면 일부러 안 가르친 경계는 4.4%p 올랐는데 오차 범위가 0을 품습니다. 올랐다고 말할 수 없는 크기입니다. 전체 성적은 79.2%까지 왔고, 같은 모델이 생각을 켜면 88.0%이니 8.8%p가 남아 있습니다.
기업에서 어떻게 쓰면 되나
1. 익숙한 규정 위의 분류·라우팅은 1토큰으로
사내 경비 규정, 반복되는 고객 문의 유형, 승인 워크플로처럼 규정이 안정적이고 학습 데이터가 있는 자리입니다. 여기서는 생성을 쓰지 마십시오. 1토큰 결정이 같은 정확도에 훨씬 빠르고 덜 흔들립니다. 저희 추론 제품인 메티스(Metis) 에 올리면 이 설정이 그대로 서빙됩니다.
판정 기준은 간단합니다. 이 자리의 규정 문서가 지난 분기에 바뀌었습니까? 안 바뀌었다면 이 패턴입니다.
2. 규정이 자주 바뀌는 자리는 생각을 켜 두기
고객사마다 규정이 다른 자리, 신규 고객 온보딩, 규제 개정이 잦은 영역입니다. 여기서 추론을 끄고 아끼는 비용은 틀린 결정으로 돌아옵니다. 저희 측정에서는 그 차이가 17%p였습니다.
확신이 낮은 문항에만 생각을 켜는 절충도 재 봤습니다. 절반만 켜서 85.7%였습니다. 아끼기는 하지만 기대만큼은 아닌데, 이유가 분명합니다. 처음 보는 경계에서 모델은 확신에 차서 틀립니다. 확신이라는 신호로는 걸러지지 않습니다.
3. 경계가 반복해서 틀리면 그 경계만 데이터로 가르치기
운영 로그에서 특정 경계가 반복해서 틀린다면, 그 경계만 집어서 대조 쌍 데이터를 만드십시오. 한쪽만 다른 두 상황을 짝지어 주는 방식입니다. 저희 측정에서는 이 방식이 같은 분량의 평범한 데이터보다 확실히 나았습니다.
다만 덮은 경계만 나아집니다. 그래서 어느 경계를 덮을지 미리 고르는 일이 데이터를 더 모으는 일보다 중요합니다. 업무 자동화 제품인 팍시스(Paxis) 에서는 이 선택이 그대로 운영 설계로 내려옵니다.
쓰면 안 되는 자리
생명·안전·금전에 직결되면서 규정이 자주 바뀌는 자리에는 아직 권하지 않습니다. 가르치지 않은 경계에서 전이 증거가 없다는 것이 저희 측정 결과이고, 그 사실을 숨기면서 팔 생각은 없습니다. 그런 자리에는 사람 검토를 붙이시고, 모델은 사람에게 넘기기 를 잘 고르는지로만 평가하십시오.
공개한 것과 공개하지 않은 것
가중치는 병합된 전체 모델로 공개합니다. 어댑터만 주면 쓰는 쪽이 베이스 버전과 라이브러리 버전을 전부 맞춰야 하기 때문에, 바로 로드되는 형태로 올렸습니다. 결정 헤드도 같이 넣었습니다.
채점에 쓴 문제집 300문항은 정답 근거와 함께 전부 공개합니다. 검증기도 같이 넣었으니 저희 말을 믿지 않고 직접 돌려 보실 수 있습니다.
학습에 쓴 데이터는 공개하지 않습니다. 내부 문서와 라이선스가 걸린 출처에서 나왔기 때문에 재배포할 수 있는 위치가 아닙니다.
모델은 ThakiCloud 조직 페이지, 문제집은 EnterpriseOps-KO Blind-A에 있습니다. 측정 방법과 한계는 논문 소개 글에 적었습니다.